
Jag blindtestade 10 AI-modeller på mitt fotobibliotek med 142,000 bilder: GPT-6.1 Sol slog Claude Opus
Sammanfattning
Jag använder Claude Opus 5.5 varje dag för kod och arbetsflöden, och för det arbetet tycker jag att den är snabbare och bättre än GPT-6. Jag antog att den också skulle vara bäst på att beskriva foton, så jag testade det. Jag körde tio konfigurationer: Claude Haiku, Sonnet och Opus 5.5, plus OpenAI:s GPT-6.1 Sol, GPT-6 Astra och GPT-6 Luna på flera ansträngningsnivåer. Var och en titulerade, beskrev, nyckelordade och arkiverade 50 riktiga foton från mitt bibliotek på 142,521 bilder och flaggade de foton den tyckte jag borde radera. Två blinda granskare från olika leverantörer, Claude Fable 5.1 och GPT-6 Astra, poängsatte alla 500 svar på fakta, påhittade detaljer, raderingsbedömning, albumpassning och användbarhet. GPT-6.1 Sol fick högst med 9.72 av 10. Opus fick 8.57, och Sonnet och Haiku hamnade på 7.7 till 7.8. Ultra-nivån var inte bättre än max. Till officiella Batch API-priser skulle det kosta ungefär $240 att beskriva hela biblioteket med Sol på medium (9.56), $661 med Opus och $11 till $20 med Luna, som ändå slog Haiku.
Varför jag testade detta
Det mesta av min dag går till kod, agentarbetsflöden och automatisering, och Claude Opus 5.5 är den modell jag tar till. För den typen av arbete har den känts snabbare och bättre för mig än GPT-6. Så när jag bestämde mig för att låta AI beskriva och tagga mitt fotobibliotek valde jag Opus utan att tveka.
Biblioteket är 25 år av mitt liv: 142,521 foton, från tidiga digitalkamerabilder till förra veckans mobilbilder, plus fler än 16,000 skärmdumpar. Nästan ingen av dem har en bildtext. Jag vill att varje foto ska ha en titel, en bildtext, sökbara nyckelord, ett vettigt album och en ärlig flagga när det är en dubblett eller skräp. Innan jag betalar för att bearbeta 142,000 foton ville jag veta vilken modell som gör detta bäst och vad skillnaden kostar.
Jag förväntade mig att Opus skulle vinna. På dessa 50 foton fick GPT-6.1 Sol mer än en poäng högre.
Resultat i korthet
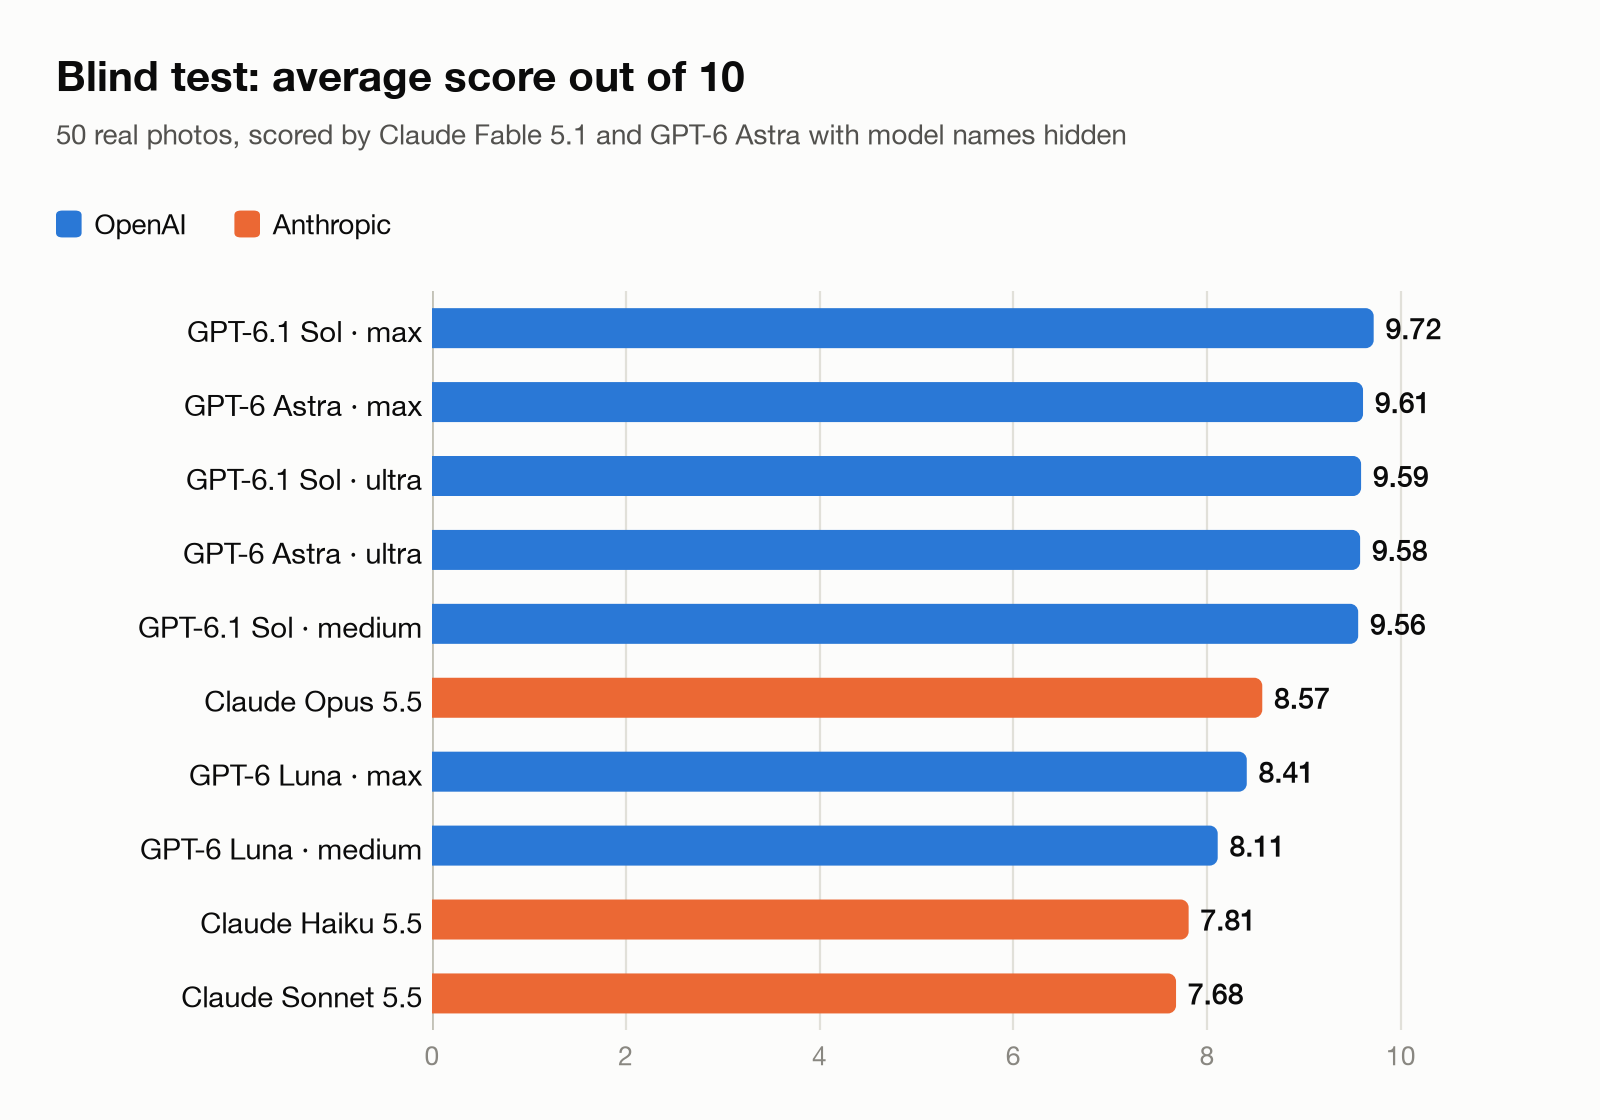 Figur 1. Genomsnittlig poäng från två blinda granskare, av 10.
| Rank | Modell och ansträngning | Poäng (av 10) | Hela biblioteket, Batch API | Hela biblioteket, standard API |
|---|---|---|---|---|
| 1 | GPT-6.1 Sol, max | 9.72 | $563 | $1,126 |
| 2 | GPT-6 Astra, max | 9.61 | $2,987 | $5,973 |
| 3 | GPT-6.1 Sol, ultra | 9.59 | $468 | $937 |
| 4 | GPT-6 Astra, ultra | 9.58 | $2,156 | $4,313 |
| 5 | GPT-6.1 Sol, medium | 9.56 | $240 | $479 |
| 6 | Claude Opus 5.5 | 8.57 | $661 | $1,323 |
| 7 | GPT-6 Luna, max | 8.41 | $20 | $40 |
| 8 | GPT-6 Luna, medium | 8.11 | $11 | $22 |
| 9 | Claude Haiku 5.5 | 7.81 | $18 | $36 |
| 10 | Claude Sonnet 5.5 | 7.68 | $334 | $668 |
Kostnaden gäller alla 142,521 foton till varje leverantörs officiella API-pris.
Vad jag skulle använda, baserat på detta test:
- Om jag bara brydde mig om poängen, GPT-6.1 Sol på max-nivå.
- För mitt eget bibliotek, GPT-6.1 Sol på medium. Den fick 98% av toppresultatet för $240, ungefär en tredjedel av vad Opus skulle kosta.
- Med en tajt budget, GPT-6 Luna på max. För $20 slog den Haiku, som kostar lika mycket per token, och Sonnet, som skulle kosta ungefär 17 gånger så mycket för det här biblioteket.
- Inte Claude Sonnet 5.5. Den är mellanprissatt och hade lägst poäng.
Modellerna
| Leverantör | Modell | Testad ansträngning | Positionering |
|---|---|---|---|
| Anthropic | Claude Opus 5.5 | standard (medium) | Flaggskepp för dagligt bruk |
| Anthropic | Claude Sonnet 5.5 | standard | Mellanskikt |
| Anthropic | Claude Haiku 5.5 | standard | Snabb, låg kostnad |
| OpenAI | GPT-6 Astra | max, ultra | Frontmodell |
| OpenAI | GPT-6.1 Sol | medium, max, ultra | Arbetshäst |
| OpenAI | GPT-6 Luna | medium, max | Snabb, låg kostnad |
Priserna ligger i linje mellan de två leverantörerna. GPT-6.1 Sol kostar lika mycket per token som Claude Sonnet 5.5, GPT-6 Astra lika mycket som Claude Fable 5.1, och GPT-6 Luna lika mycket som Claude Haiku 5.5. Claude Opus 5.5 ligger mellan Sol och Astra. Så när två modeller nedan hamnar på olika kostnad beror det mest på att en av dem använde fler tokens för samma jobb.
Claude-modellerna körde en gång var med sina standardinställningar, vilket för Opus betyder medium-ansträngning. GPT-modellerna testade jag på flera ansträngningsnivåer. Den närmaste rättvisa jämförelsen är GPT-6.1 Sol på medium mot Claude Opus 5.5 på medium: 9.56 mot 8.57.
Testet
Jag använde de 50 senaste fotona i mitt bibliotek vid tillfället, utan videor. Det är en vanlig vecka ur min kamerarulle: familjestunder hemma och under en shoppingtur, stadsvyer från en hög våning, ett minneskort på mitt skrivbord, produktbladsskärmdumpar av elektroniska komponenter, skärmdumpar av order-spårning, ett inlägg i sociala medier, en QR-skylt för parkeringsrabatt och en etikett på en elbilsladdare.
Varje modell hade fem uppgifter för varje foto. Den skrev en kort titel och en bildtext på en till tre meningar på kinesiska, gav 5 till 12 nyckelord på kinesiska och engelska och valde det bästa albumet bland mina befintliga album, eller inget. Sedan gav den ett kvalitetspoäng och sa om fotot skulle behållas eller raderas, och letade efter dubbletter, misslyckade bilder, utgångna skärmdumpar och foton utan bestående värde. Varje modell fick samma instruktioner och samma kontext för varje foto, tio foton åt gången.
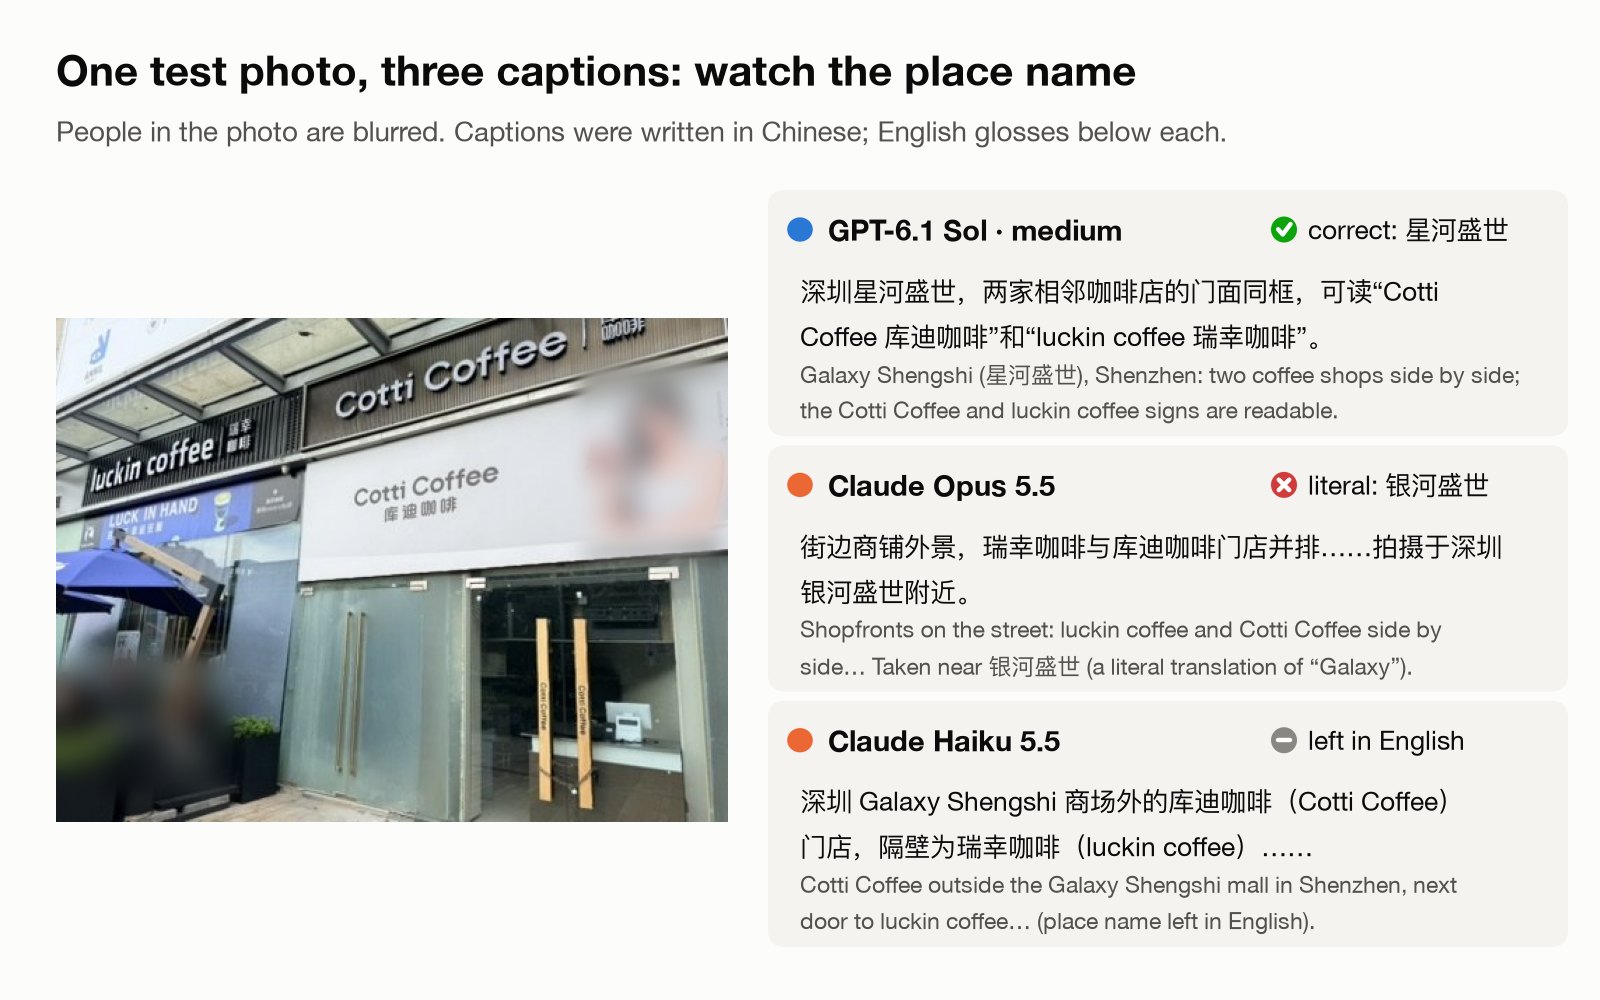 Figur 2. Ett av de 50 testfotona, med tre av bildtexterna. Lägg märke till hur varje modell hanterar ortnamnet; jag återkommer till det nedan. Personer på fotot är suddade.
Hur jag poängsatte
Jag poängsatte inte svaren själv. Jag hade redan valt en vinnare före testet, och jag använder Claude varje dag, så jag var inte neutral.
I stället blandade jag varje fotos tio svar och märkte dem A till J, med en ny slumpmässig ordning för varje foto. Två granskare poängsatte sedan alla 500 svar oberoende av varandra medan de tittade på fotona. Den ena var Claude Fable 5.1, Anthropics mest kapabla modell. Den andra var GPT-6 Astra på xhigh-ansträngning, OpenAI:s frontmodell.
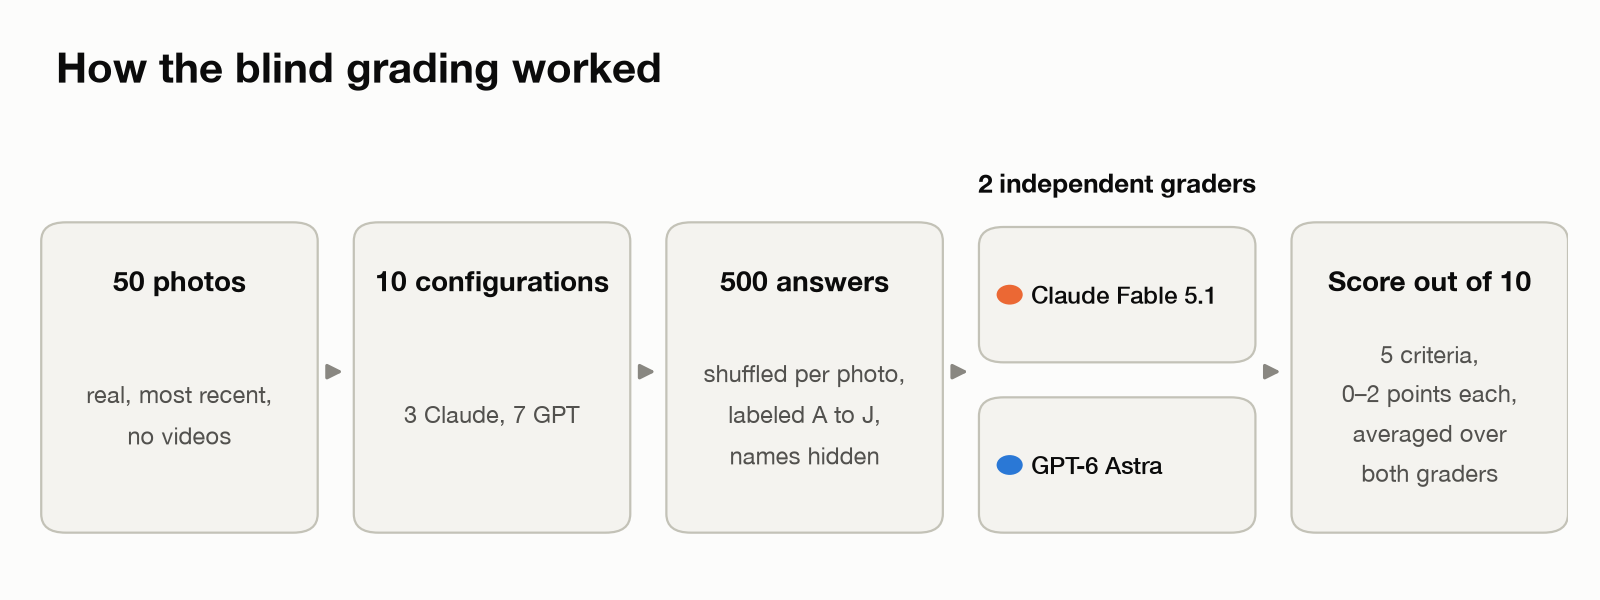 Figur 3. Hur den blinda poängsättningen gick till.
Varje svar poängsattes på fem kriterier, 0 till 2 poäng var, totalt 10:
| Kriterium | Vad granskaren kontrollerade |
|---|---|
| Fakta | Stämmer motiv, plats och all läsbar text, inklusive lokala ortnamn? |
| Inga påhittade detaljer | Undviker svaret att hävda något som fotot inte visar? |
| Raderingsbedömning | Är behålla eller radera rimligt? Att radera ett bra foto ger 0. |
| Albumpassning | Är albumet rätt? Ett fel gammalt album ger 0; inget album är en acceptabel 1. |
| Användbarhet | Skulle titel, bildtext och nyckelord hjälpa mig att hitta och minnas fotot senare? |
Jag valde en granskare från varje leverantör för att se om någon skulle gynna sina egna modeller. De var mestadels överens. Korrelationen över de 500 parade poängen var 0.71, och båda satte samma fem GPT-konfigurationer i topp. Claude-granskaren rankade också GPT-6.1 Sol och GPT-6 Astra över Claude Opus. GPT-granskaren var överlag strängare, och strängast mot Claude-modellerna.
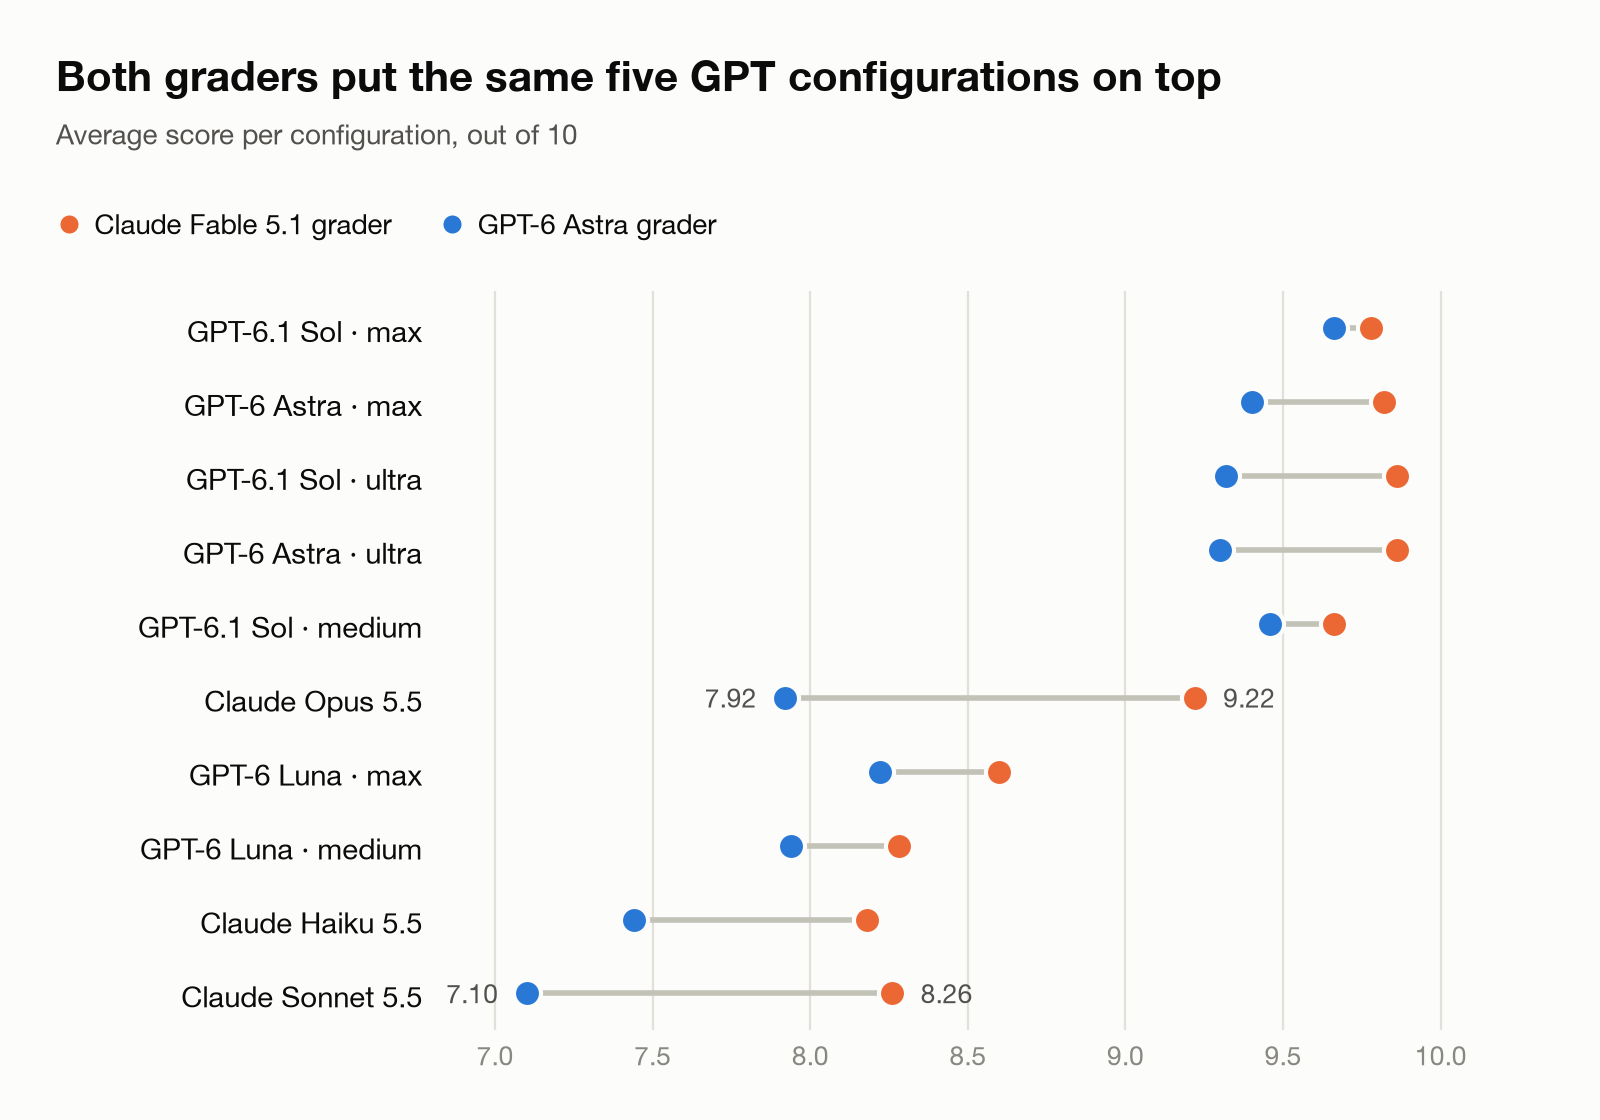 Figur 4. Varje granskares genomsnittliga poäng per konfiguration.
Resultat
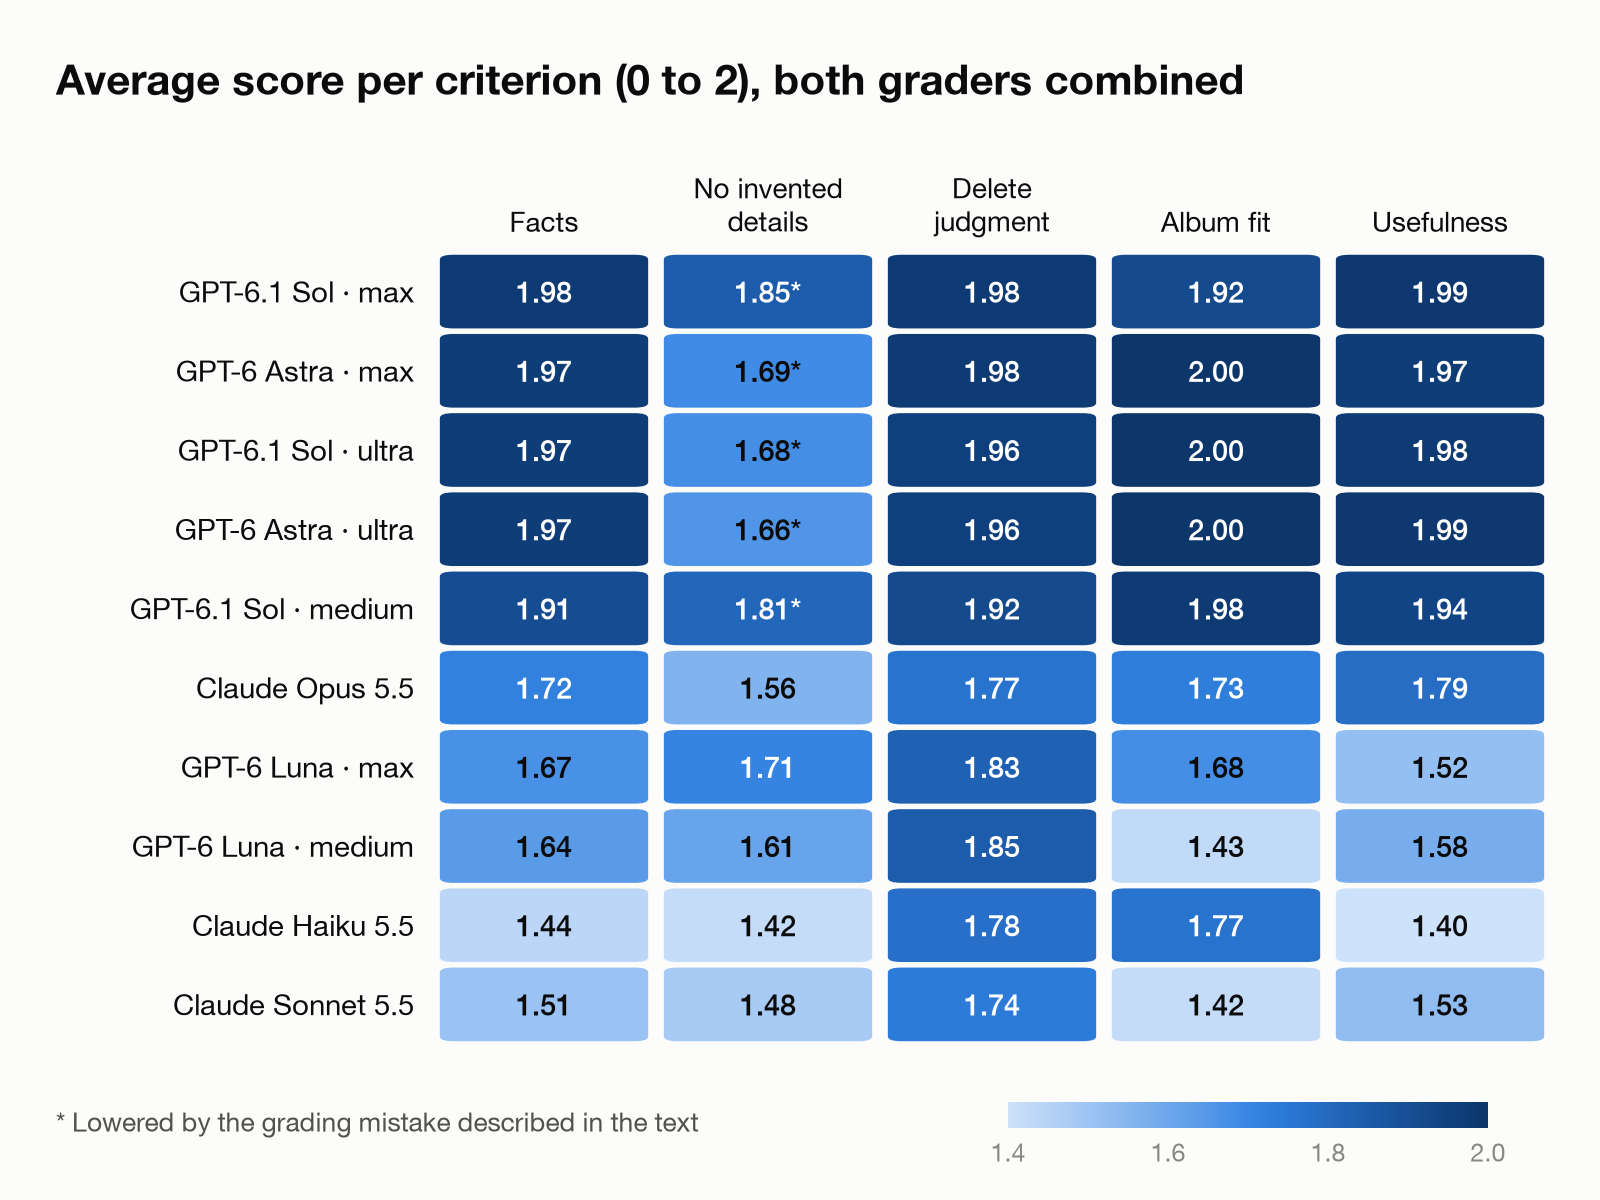 Figur 5. Genomsnittlig poäng per kriterium, båda granskarna sammanräknade. En asterisk markerar poäng som sänkts av poängsättningsfelet jag beskriver nedan.
GPT-6.1 Sol och GPT-6 Astra
Sol och Astra läste texten korrekt och begränsade mestadels sina bildtexter till vad fotona visade. De var också bäst på lokala ortnamn, vilket spelar roll för foton tagna i Kina.
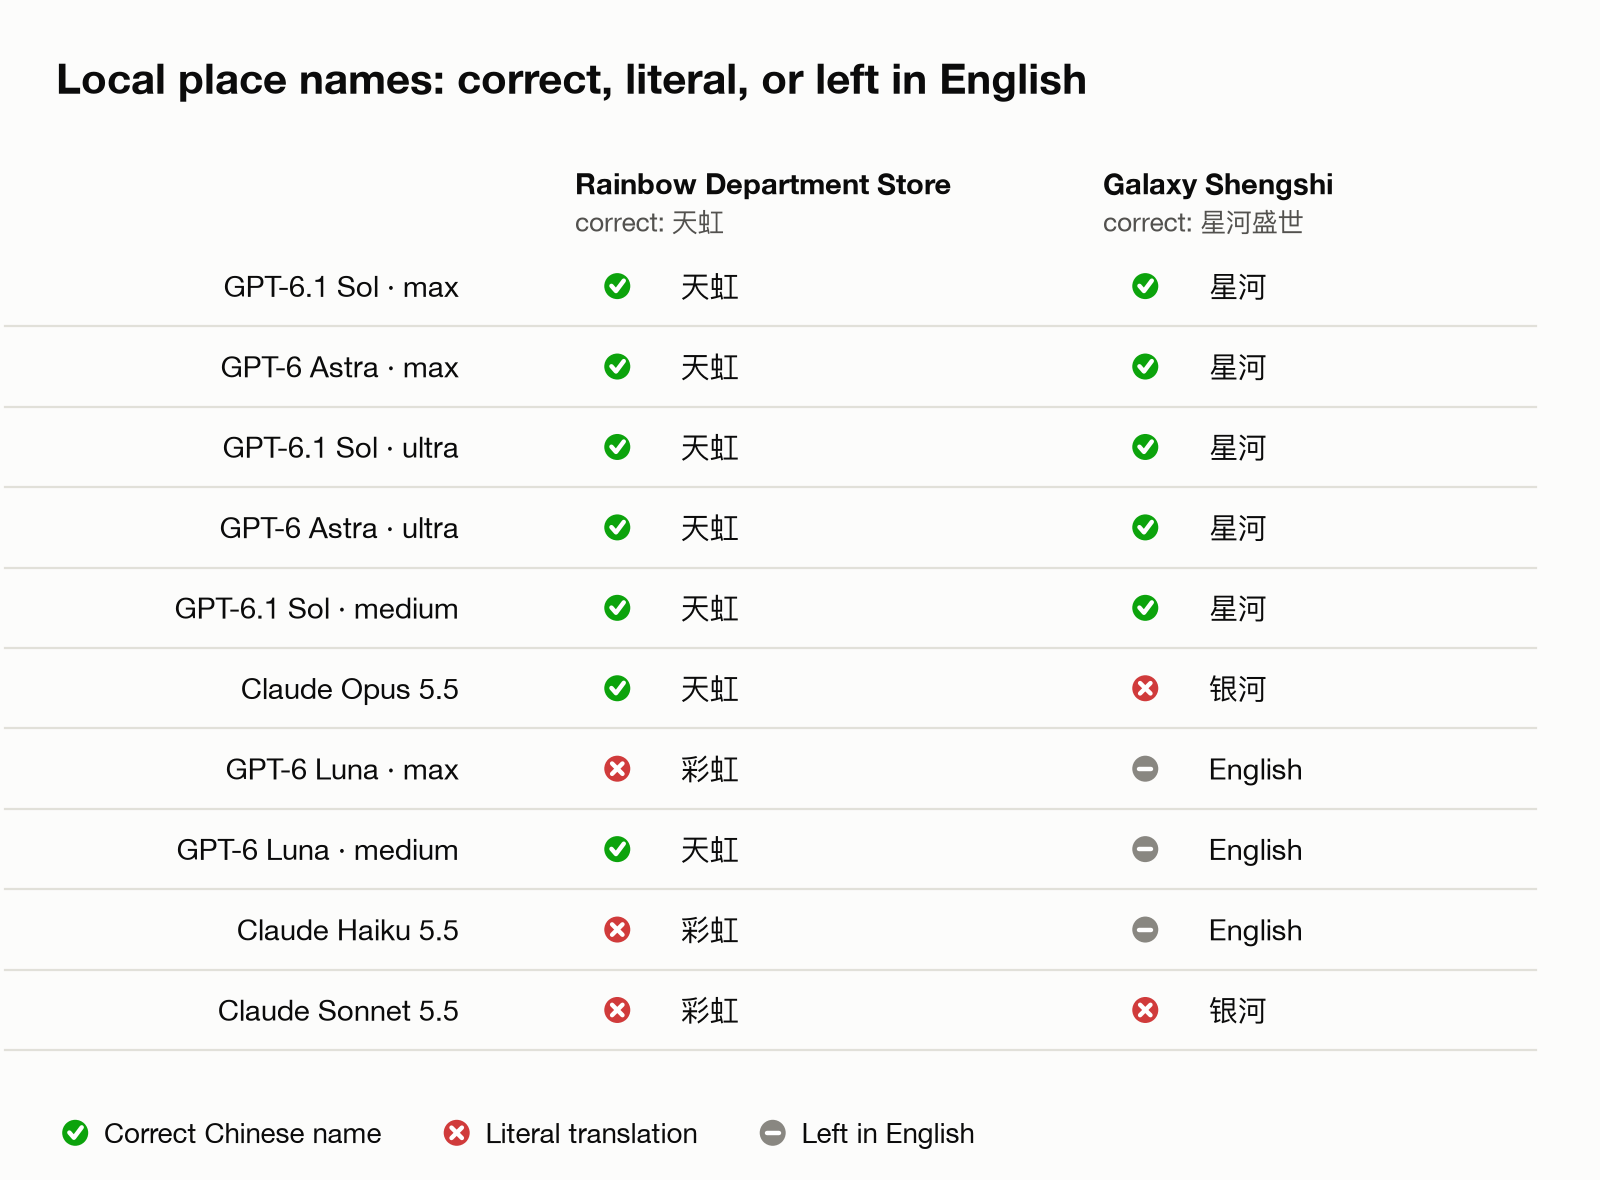 Figur 6. Två test med lokala namn. En bock betyder rätt kinesiskt namn, ett kryss en bokstavlig översättning och EN betyder att namnet lämnats på engelska.
Flera foton taggades med platsen «Rainbow Department Store». Det är det engelska namnet på varuhuskedjan i Shenzhen 天虹. En ord-för-ord-översättning ger 彩虹百货, vilket är fel. Varje Sol- och Astra-konfiguration fick detta rätt, liksom Opus och Luna på medium. Haiku, Sonnet och Luna på max använde den bokstavliga översättningen. Kaféfotot i figur 2 taggades som «Galaxy Shengshi», vars kinesiska namn är 星河盛世. Varje Sol- och Astra-konfiguration skrev 星河. Opus och Sonnet översatte det bokstavligt som 银河, och Haiku och båda Luna-konfigurationerna lämnade det på engelska.
Sol och Astra var också försiktiga med radering. De föreslog att radera 4 till 6 av de 50 fotona. Uppsättningen innehöll åtta produktbladsskärmdumpar av elektroniska komponenter, och GPT-modellerna behöll nästan alla; en Sol-konfiguration flaggade en enda skärmdump som nästan-dubblett. Claude-modellerna flaggade två till fyra var. Båda granskarna höll med om att behålla dem, eftersom sidorna innehöll pinouts, mått och kretskortsfoton jag skulle vilja slå upp senare.
Claude Opus 5.5
Opus skrev ibland in saker i en bildtext som fotot ensamt inte kan visa. Den beskrev relationer som bilden ensam inte kan bevisa, som syskon eller förälder och barn. Den fick också vissa poser fel. På ett foto stod ett barn bakom en vuxen, och Opus skrev att barnet satt på den vuxnes rygg. Båda granskarna drog poäng för detta.
Detta överraskade mig. Före blindtestet hade jag sett igenom svaren och berömt Opus för att den korrekt gissade att två barn var syskon. Jag känner min familj; det gör inte granskaren. Men med 142,000 foton kan jag inte kontrollera varje bildtext själv, och en bildtext som påstår något fotot inte visar är ett problem.
Opus föreslog också flest raderingar, 13 av de 50 fotona. Tre av dem var produktbladsskärmdumpar som den kallade utgångna, trots att de innehöll referensinformation jag skulle behålla. Den var den enda modell som ville radera QR-skylten för parkeringsrabatt som värdelös. Den lade också flera foton av en enda person i ett album för «familjeporträtt».
Claude Sonnet 5.5 och Haiku 5.5
Dessa två gjorde flest faktafel, inklusive den bokstavliga översättningen 彩虹. Sonnet gjorde de svagaste albumvalen och arkiverade vardagsfoton i ett gammalt album från en orelaterad händelse. Haiku hittade på en detalj som ledde till ett dåligt raderingsbeslut. I en serie nästan identiska bilder beskrev den den bästa bilden som någon som tittar ned, vilket är motsatsen till vad fotot visar, och föreslog att radera den.
GPT-6 Luna
Luna kostar lika mycket per token som Haiku men fick högre poäng på båda ansträngningsnivåerna: 8.41 och 8.11, mot Haikus 7.81. På max-nivå slog den också Sonnet, som skulle kosta ungefär 17 gånger så mycket att beskriva samma bibliotek. Luna tappade flest poäng på användbarhet och albumval. Dess bildtexter var plattare och dess album mindre exakta.
Ansträngningsnivåer
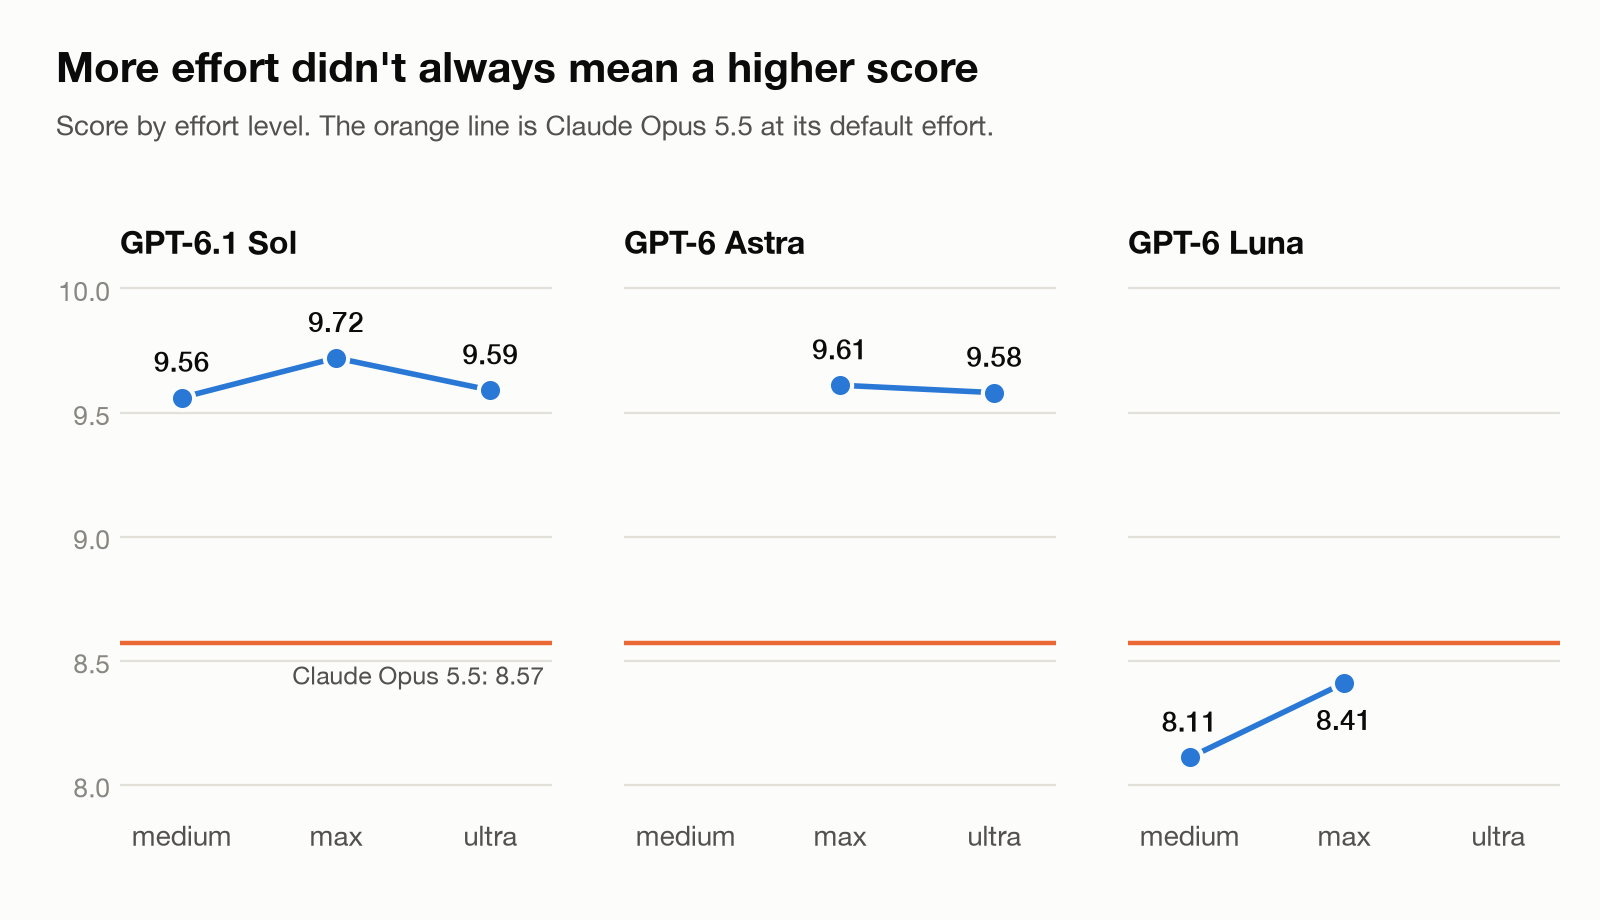 Figur 7. Poäng per ansträngningsnivå. Den orangea linjen är Claude Opus 5.5 på sin standardnivå.
Ultra var inte bättre än max för någon av modellerna. Sol fick 9.59 på ultra och 9.72 på max; Astra fick 9.58 och 9.61. I detta test producerade ultra till och med färre utdatatokens än max. För Sol kom medium nära med 9.56, för mindre än hälften av kostnaden för max. Högre ansträngning betydde inte alltid mer exakta detaljer: Luna på medium fick 天虹 rätt, och Luna på max gjorde det inte.
Ett fel i min poängsättning
Efter poängsättningen märkte jag att granskarna inte fått varje fotos fångstdatum och tid, trots att beskrivningsmodellerna fått det. Så GPT-6 Astra-granskaren behandlade bildtexter som nämnde exakt datum eller tid som påhittade detaljer. De bästa GPT-konfigurationerna nämnde datum oftast, så deras poäng på «inga påhittade detaljer» blev lägre än de borde.
Om jag bara ger tillbaka poängen som förlorats över datum stiger de fyra bästa GPT-konfigurationerna till mellan 9.84 och 9.90, vilket i praktiken är oavgjort, och Opus stannar på 8.58. Jag har behållit de ursprungliga poängen i detta inlägg. Nästa gång ger jag granskarna allt modellerna såg.
Hastighet
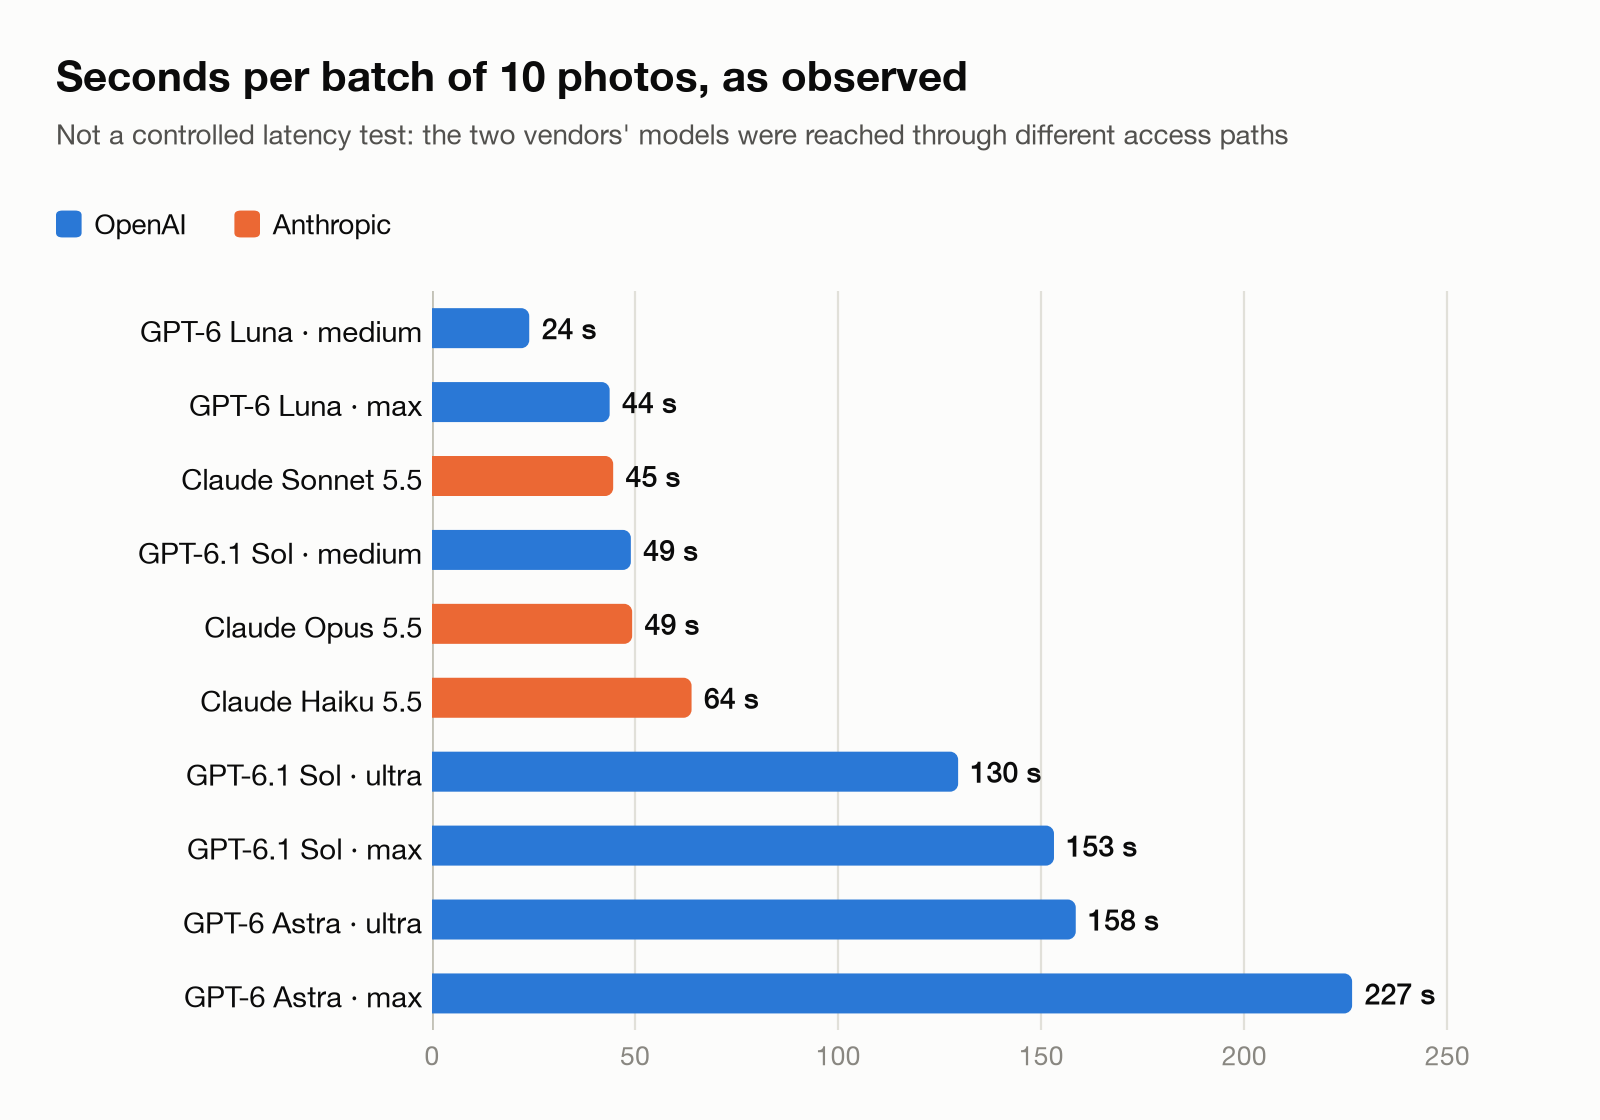 Figur 8. Sekunder per omgång om 10 foton, som observerat. Detta är inte ett kontrollerat latenstest, eftersom de två leverantörernas modeller nåddes via olika åtkomstvägar.
Detta stämmer med hur Opus känns i mitt dagliga arbete: den är snabb, ungefär tre gånger snabbare än Sol på max. Sol på medium var dock lika snabb som Opus, och fick ungefär en poäng högre.
Vad det kostar
Jag prissatte varje konfiguration till leverantörernas officiella API-priser. Att behandla ett abonnemangs inkluderade användning som gratis skulle få vissa modeller att framstå som bättre än de är.
Officiella priser per miljon tokens, standardnivå:
| Modell | Input | Output |
|---|---|---|
| Claude Opus 5.5 | $4.00 | $20.00 |
| Claude Sonnet 5.5 | $2.00 | $10.00 |
| Claude Haiku 5.5 | $0.10 | $0.50 |
| GPT-6 Astra | $10.00 | $50.00 |
| GPT-6.1 Sol | $2.00 | $10.00 |
| GPT-6 Luna | $0.10 | $0.50 |
Båda leverantörernas Batch API:er kostar 50% mindre, vilket passar ett jobb som detta som inte behöver omedelbara svar. Jag tog priserna från Anthropics prissida (claude.com/pricing) och OpenAI:s API-prissida (developers.openai.com/api/docs/pricing) den 20 oktober 2026.
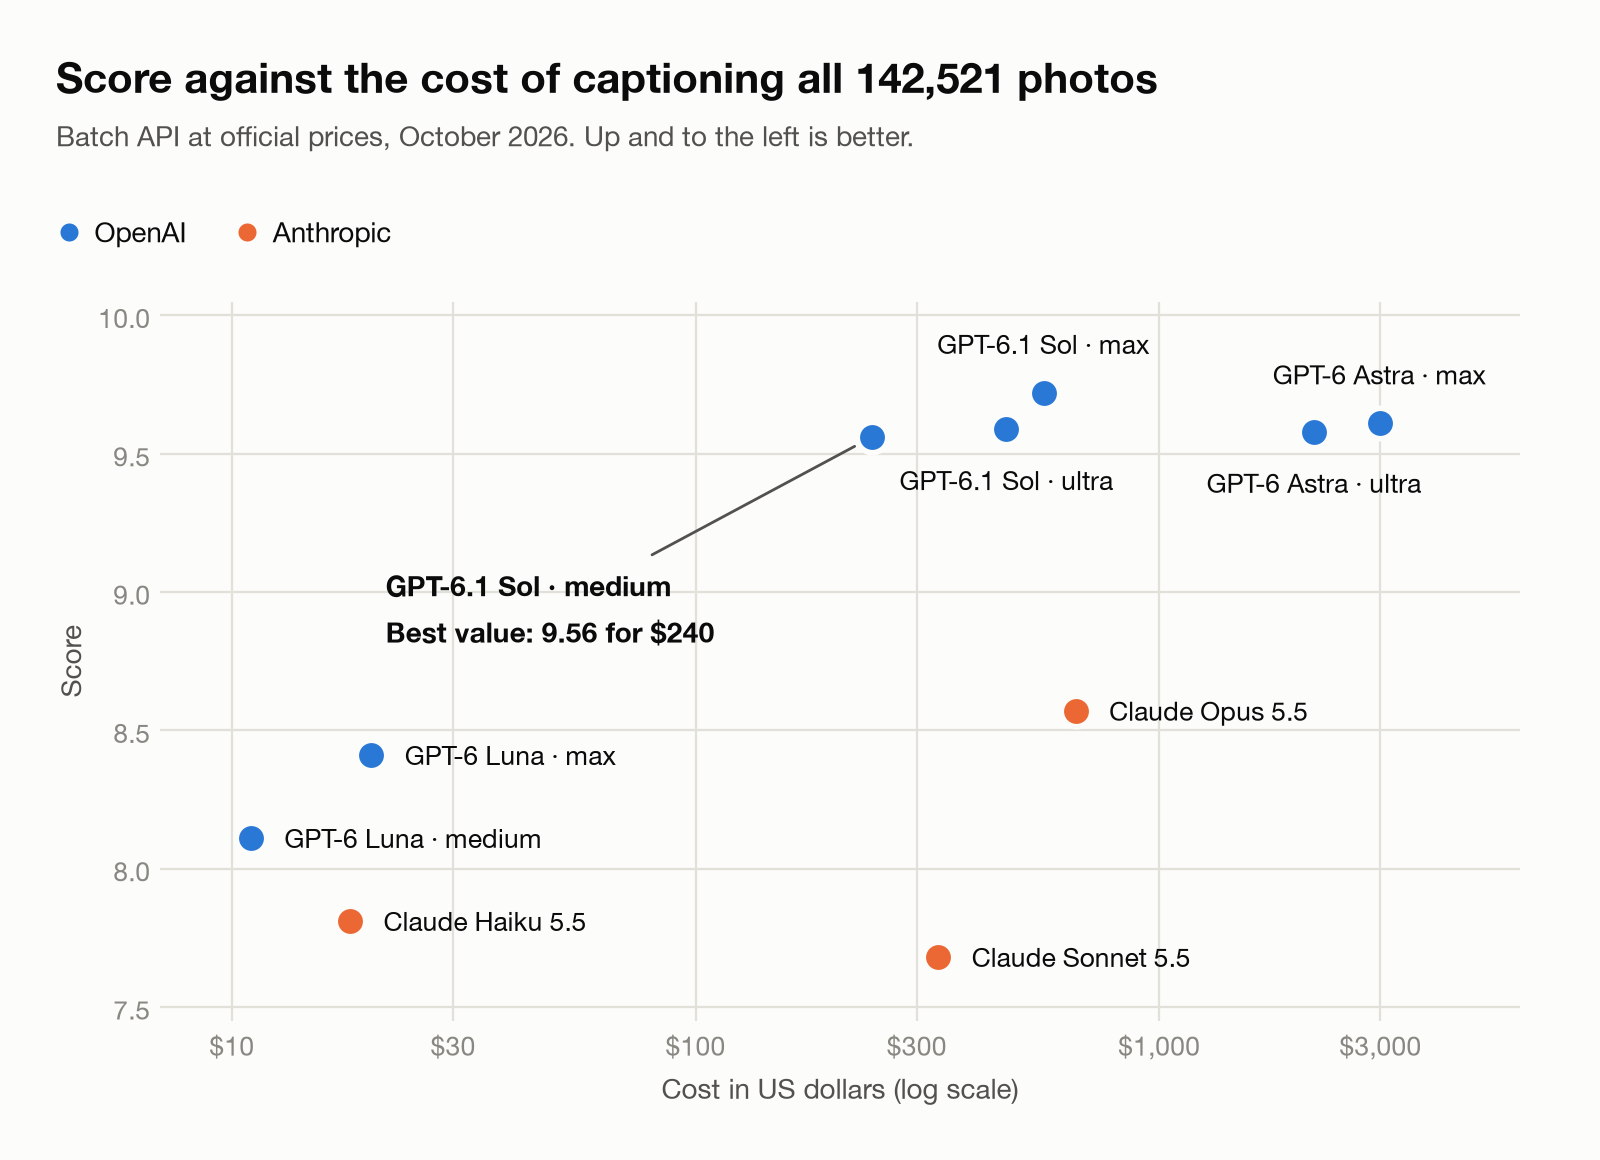 Figur 9. Poäng mot kostnaden för att beskriva hela biblioteket till Batch-priser. Kostnadsaxeln är logaritmisk.
| Modell och ansträngning | Utdatatokens per foto | Standard | Batch | Poäng |
|---|---|---|---|---|
| GPT-6.1 Sol, medium | 193 | $479 | $240 | 9.56 |
| GPT-6.1 Sol, ultra | 514 | $937 | $468 | 9.59 |
| GPT-6.1 Sol, max | 647 | $1,126 | $563 | 9.72 |
| Claude Opus 5.5 | ~292 | $1,323 | $661 | 8.57 |
| Claude Sonnet 5.5 | ~297 | $668 | $334 | 7.68 |
| GPT-6 Astra, ultra | 462 | $4,313 | $2,156 | 9.58 |
| GPT-6 Astra, max | 695 | $5,973 | $2,987 | 9.61 |
| GPT-6 Luna, medium | 163 | $22 | $11 | 8.11 |
| Claude Haiku 5.5 | ~330 | $36 | $18 | 7.81 |
| GPT-6 Luna, max | 419 | $40 | $20 | 8.41 |
Sol på medium fick 98% av toppresultatet för 36% av vad Opus skulle kosta och 43% av Sol på max. Astra matchade Sols kvalitet men kostar ungefär fem gånger så mycket, eftersom dess pris per token är fem gånger högre. Opus kostade mer än Sol på max och fick lägre poäng. Den körde redan på medium, men dess pris per token är dubbelt så högt som Sols. Luna skulle beskriva hela biblioteket för $11 till $20 och ändå slå Haiku och Sonnet.
Metodnot: GPT-tokenantal mättes från körningarna, och Claude-tokenantal uppskattades från körloggarna. Vissa Claude-resonemangstokens var inte synliga, så Claude-kostnaderna kan vara något underskattade. Inga rabatter utöver Batch, såsom prompt-cache, tillämpades på någon modell.
Vad jag lärde mig
Jag valde Opus innan jag hade några blinda poäng, mest för att den redan var mitt standardval för kod. Jag föredrar fortfarande Claude Opus 5.5 för kod och arbetsflöden, där den är snabbare och starkare enligt min erfarenhet. Att beskriva riktiga foton kräver en annan färdighet: att läsa vad som faktiskt finns i bilden utan att fylla i poser eller relationer. GPT-6.1 Sol gjorde det bättre. Om jag hade gått på vana och hoppat över blindtestet hade jag betalat mer för sämre bildtexter.
Nästa gång börjar jag blint och ger granskare från olika leverantörer all indata som beskrivningsmodellerna fick. Jag fortsätter också att jämföra till officiella API-priser, och jag antar inte att mer ansträngning är bättre: ultra slog inte max här.
Även de bästa modellerna flaggade användbara foton för radering, så jag kontrollerar varje raderingsflagga själv innan jag tar bort något.
Begränsningar
Detta var ett litet test: 50 nytagna foton från en stad. Jag testade inte äldre foton, skannade dokument, andra språk eller videor. Claude-modellerna körde bara med sina standardinställningar; en Opus med högre ansträngning skulle kunna få högre poäng, till en högre kostnad. Granskarna är AI-modeller, inte människor. De kom väl överens men inte perfekt, och en mänsklig stickprovskontroll skulle göra resultatet starkare. Modeller och priser förändras snabbt, och varje siffra här gäller oktober 2026.
Mitt val
För mitt bibliotek: GPT-6.1 Sol på medium-ansträngning. För kod och arbetsflöden håller jag fast vid Claude Opus 5.5.