
Ho testato alla cieca 10 modelli di IA sulla mia libreria di 142.000 foto: GPT-6.1 Sol ha battuto Claude Opus
Abstract
Uso Claude Opus 5.5 ogni giorno per programmare e per i flussi di lavoro, e per quel lavoro lo trovo più veloce e migliore di GPT-6. Pensavo che sarebbe stato anche il migliore a descrivere le foto, quindi l'ho testato. Ho eseguito dieci configurazioni: Claude Haiku, Sonnet e Opus 5.5, più GPT-6.1 Sol, GPT-6 Astra e GPT-6 Luna di OpenAI a vari livelli di impegno. Ognuna ha intitolato, descritto, etichettato e archiviato 50 foto reali della mia libreria di 142.521 foto, e ha segnalato quelle che secondo lei avrei dovuto eliminare. Due valutatori alla cieca di fornitori diversi, Claude Fable 5.1 e GPT-6 Astra, hanno assegnato un punteggio a tutte le 500 risposte su fatti, dettagli inventati, giudizio di eliminazione, adeguatezza all'album e utilità. GPT-6.1 Sol ha ottenuto il punteggio più alto, 9,72 su 10. Opus ha ottenuto 8,57, e Sonnet e Haiku si sono attestati tra 7,7 e 7,8. L'impegno ultra non è stato migliore di max. Ai prezzi ufficiali della Batch API, descrivere l'intera libreria costerebbe circa $240 con Sol a impegno medio (9,56), $661 con Opus, e da $11 a $20 con Luna, che ha comunque superato Haiku.
Perché l'ho testato
La maggior parte della mia giornata va a programmare, ai flussi di lavoro con agenti e all'automazione, e Claude Opus 5.5 è il modello a cui ricorro. Per quel tipo di lavoro mi è sembrato più veloce e migliore di GPT-6. Così, quando ho deciso di far descrivere ed etichettare la mia libreria di foto da un'IA, ho scelto Opus senza pensarci due volte.
La libreria è 25 anni della mia vita: 142.521 foto, dai primi scatti con la fotocamera digitale alle foto del telefono della scorsa settimana, più di 16.000 screenshot. Quasi nessuna ha una didascalia. Voglio che ogni foto abbia un titolo, una didascalia, parole chiave che posso cercare, un album sensato e una segnalazione onesta quando è un duplicato o spazzatura. Prima di pagare per elaborare 142.000 foto, volevo sapere quale modello lo fa meglio e quanto costa la differenza.
Mi aspettavo che vincesse Opus. Su queste 50 foto, GPT-6.1 Sol ha ottenuto più di un punto in più.
Risultati a colpo d'occhio
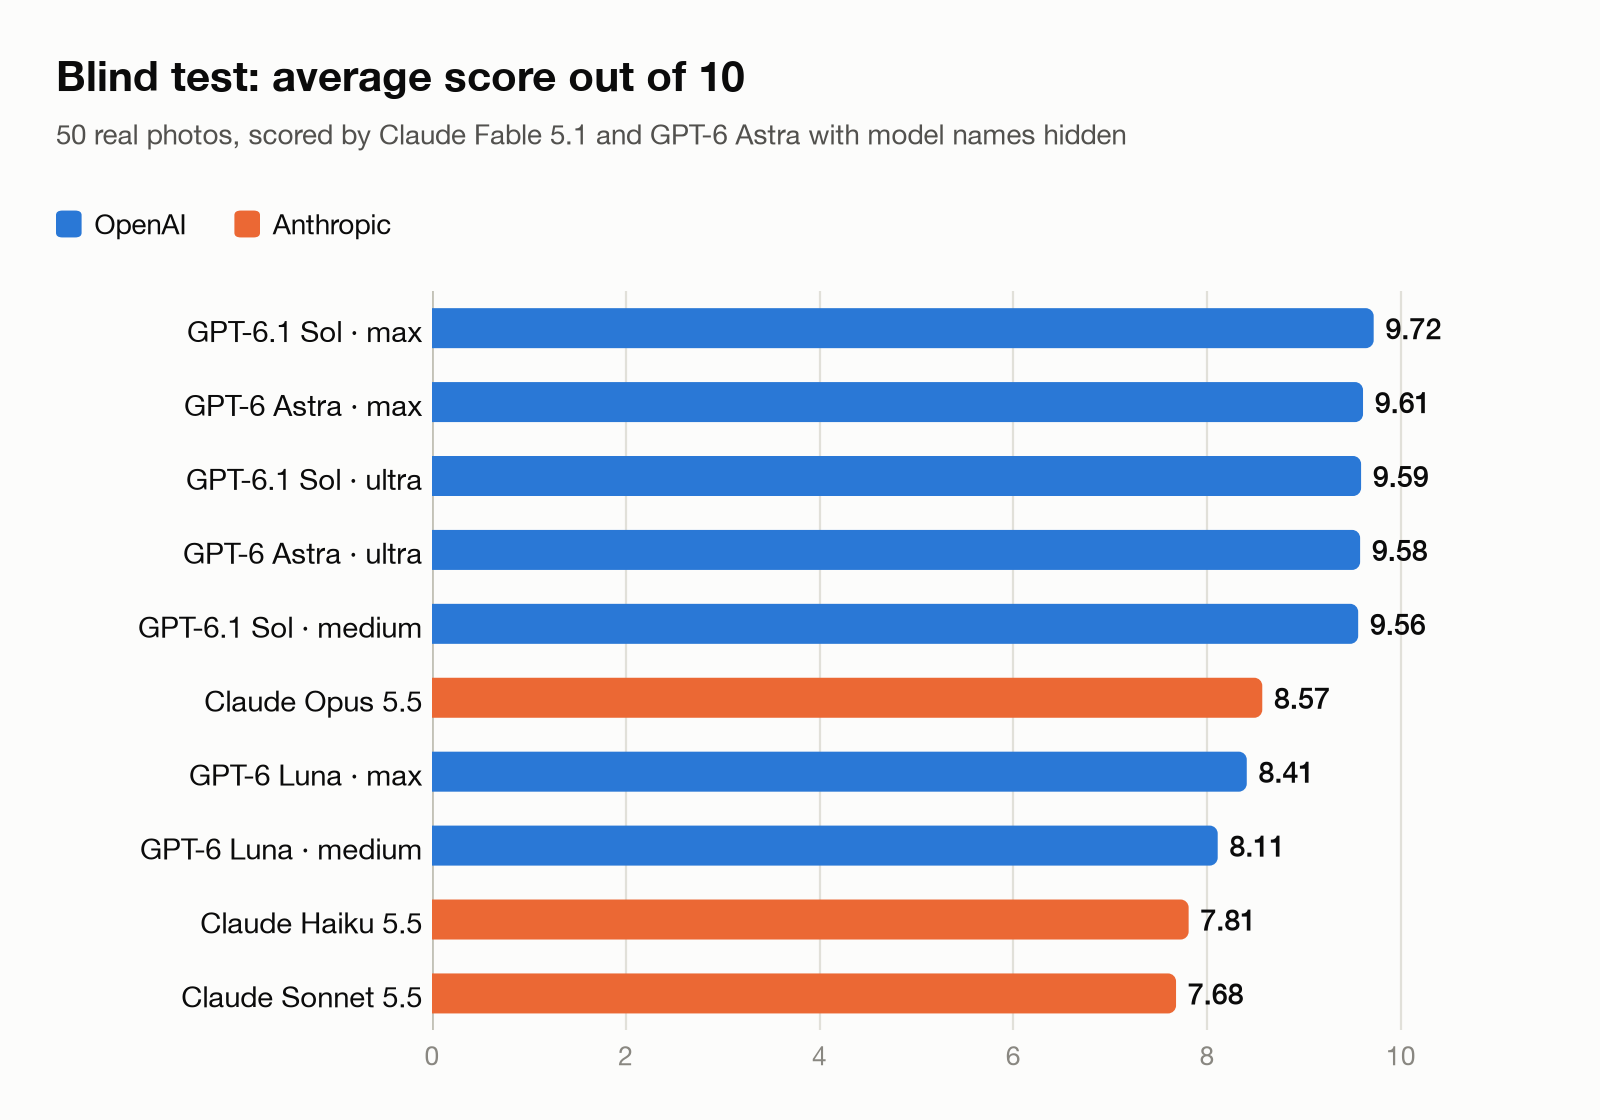 Figura 1. Punteggio medio di due valutatori alla cieca, su 10.
| Posizione | Modello e impegno | Punteggio (su 10) | Intera libreria, Batch API | Intera libreria, API standard |
|---|---|---|---|---|
| 1 | GPT-6.1 Sol, max | 9.72 | $563 | $1,126 |
| 2 | GPT-6 Astra, max | 9.61 | $2,987 | $5,973 |
| 3 | GPT-6.1 Sol, ultra | 9.59 | $468 | $937 |
| 4 | GPT-6 Astra, ultra | 9.58 | $2,156 | $4,313 |
| 5 | GPT-6.1 Sol, medium | 9.56 | $240 | $479 |
| 6 | Claude Opus 5.5 | 8.57 | $661 | $1,323 |
| 7 | GPT-6 Luna, max | 8.41 | $20 | $40 |
| 8 | GPT-6 Luna, medium | 8.11 | $11 | $22 |
| 9 | Claude Haiku 5.5 | 7.81 | $18 | $36 |
| 10 | Claude Sonnet 5.5 | 7.68 | $334 | $668 |
Il costo è per tutte le 142.521 foto al prezzo ufficiale dell'API di ciascun fornitore.
Cosa userei, in base a questo test:
- Se mi importasse solo del punteggio, GPT-6.1 Sol a impegno max.
- Per la mia libreria, GPT-6.1 Sol a medium. Ha ottenuto il 98 % del punteggio migliore per $240, circa un terzo di quanto costerebbe Opus.
- Con un budget ristretto, GPT-6 Luna a max. Per $20 ha battuto Haiku, che costa lo stesso per token, e Sonnet, che costerebbe circa 17 volte tanto per questa libreria.
- Non Claude Sonnet 5.5: ha un prezzo intermedio e il punteggio più basso.
I modelli
| Fornitore | Modello | Impegno testato | Posizionamento |
|---|---|---|---|
| Anthropic | Claude Opus 5.5 | predefinito (medium) | Ammiraglia, uso quotidiano |
| Anthropic | Claude Sonnet 5.5 | predefinito | Fascia media |
| Anthropic | Claude Haiku 5.5 | predefinito | Veloce, a basso costo |
| OpenAI | GPT-6 Astra | max, ultra | Modello di frontiera |
| OpenAI | GPT-6.1 Sol | medium, max, ultra | Cavallo da lavoro |
| OpenAI | GPT-6 Luna | medium, max | Veloce, a basso costo |
I prezzi si allineano tra i due fornitori. GPT-6.1 Sol costa per token quanto Claude Sonnet 5.5, GPT-6 Astra quanto Claude Fable 5.1 e GPT-6 Luna quanto Claude Haiku 5.5. Claude Opus 5.5 si colloca tra Sol e Astra. Quindi, quando due modelli finiscono con costi diversi qui sotto, è soprattutto perché uno dei due ha usato più token per lo stesso lavoro.
I modelli Claude sono stati eseguiti una volta ciascuno con le impostazioni predefinite, il che significa impegno medio per Opus. Ho testato i modelli GPT a vari livelli di impegno. Il confronto più equo è GPT-6.1 Sol a medium contro Claude Opus 5.5 a medium: 9,56 contro 8,57.
Il test
Ho usato le 50 foto più recenti della mia libreria in quel momento, senza video. Sono una settimana normale del mio rullino: momenti in famiglia a casa e durante una spesa, vedute della città da un piano alto, una scheda di memoria sulla mia scrivania, screenshot di pagine prodotto di componenti elettronici, screenshot di tracciamento ordini, un post sui social media, un cartello QR di sconto per il parcheggio e un'etichetta di caricatore per veicoli elettrici.
Ogni modello aveva cinque compiti per ogni foto. Scriveva un titolo breve e una didascalia da una a tre frasi in cinese, forniva da 5 a 12 parole chiave in cinese e inglese e sceglieva il miglior album tra i miei album esistenti, o nessuno. Poi dava un punteggio di qualità e diceva se tenere o eliminare la foto, cercando duplicati, scatti falliti, screenshot scaduti e foto senza valore duraturo. Ogni modello riceveva le stesse istruzioni e lo stesso contesto per ogni foto, dieci foto alla volta.
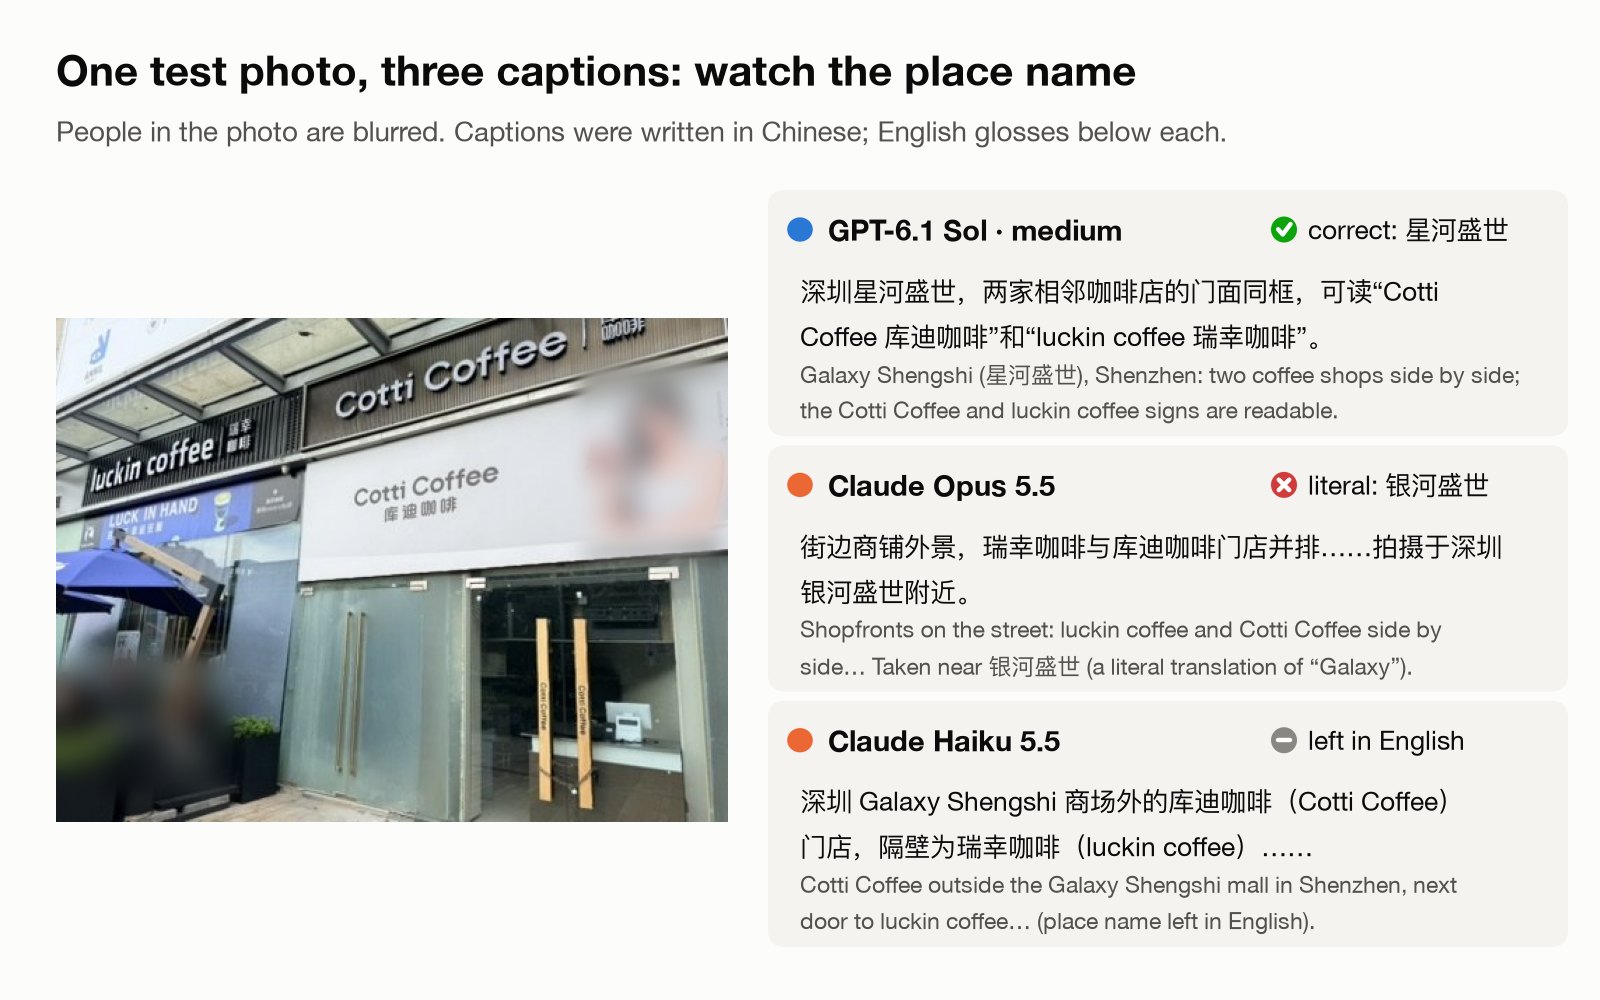 Figura 2. Una delle 50 foto di test, con tre delle didascalie. Guardate come ogni modello tratta il nome del luogo; ci torno più sotto. Le persone nella foto sono sfocate.
Come ho assegnato i punteggi
Non ho assegnato io i punteggi alle risposte. Avevo già scelto un vincitore prima del test, e uso Claude ogni giorno, quindi non ero neutrale.
Invece, ho mescolato le dieci risposte di ogni foto e le ho etichettate da A a J, con un nuovo ordine casuale per ogni foto. Due valutatori hanno poi assegnato un punteggio a tutte le 500 risposte in modo indipendente, guardando le foto. Uno era Claude Fable 5.1, il modello più capace di Anthropic. L'altro era GPT-6 Astra a impegno xhigh, il modello di frontiera di OpenAI.
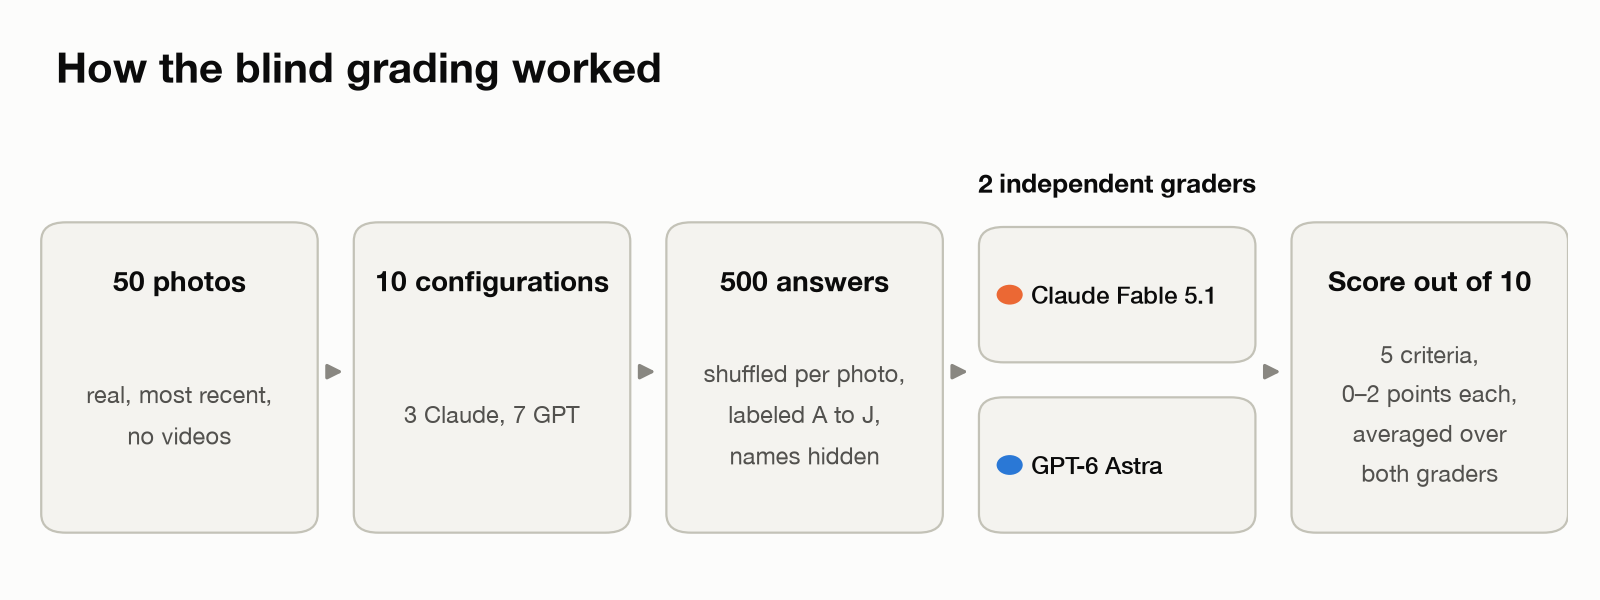 Figura 3. Come funzionava la valutazione alla cieca.
Ogni risposta è stata valutata su cinque criteri, da 0 a 2 punti ciascuno, per un totale di 10:
| Criterio | Cosa controllava il valutatore |
|---|---|
| Fatti | Il soggetto, il luogo e qualsiasi testo leggibile sono corretti, inclusi i nomi di luogo locali? |
| Nessun dettaglio inventato | La risposta evita di affermare qualcosa che la foto non mostra? |
| Giudizio di eliminazione | Tenere o eliminare è ragionevole? Eliminare una buona foto vale 0. |
| Adeguatezza all'album | L'album è giusto? Un vecchio album sbagliato vale 0; nessun album è un 1 accettabile. |
| Utilità | Titolo, didascalia e parole chiave mi aiuterebbero a ritrovare e ricordare questa foto in seguito? |
Ho scelto un valutatore per ciascun fornitore per vedere se uno avrebbe favorito i propri modelli. Erano per lo più d'accordo. La correlazione tra i 500 punteggi accoppiati è stata di 0,71, ed entrambi hanno messo in testa le stesse cinque configurazioni GPT. Il valutatore Claude ha anche classificato GPT-6.1 Sol e GPT-6 Astra sopra Claude Opus. Il valutatore GPT è stato in generale più severo, e severissimo con i modelli Claude.
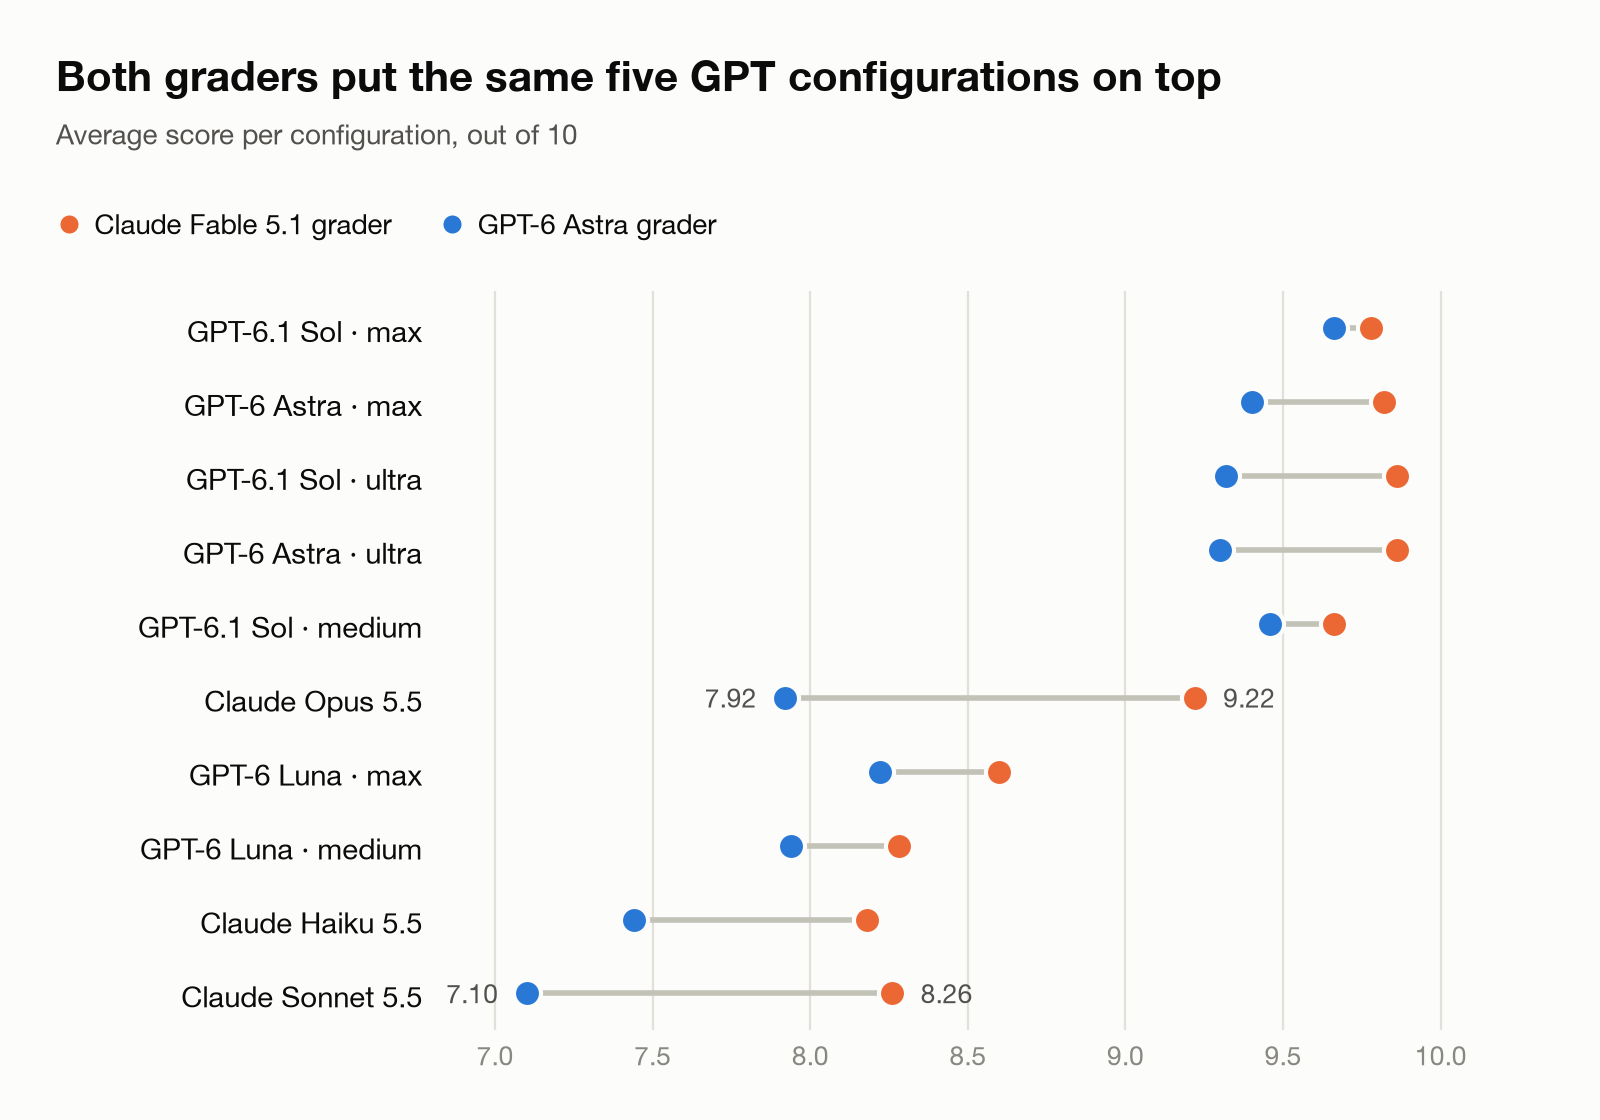 Figura 4. Punteggio medio di ciascun valutatore per configurazione.
Risultati
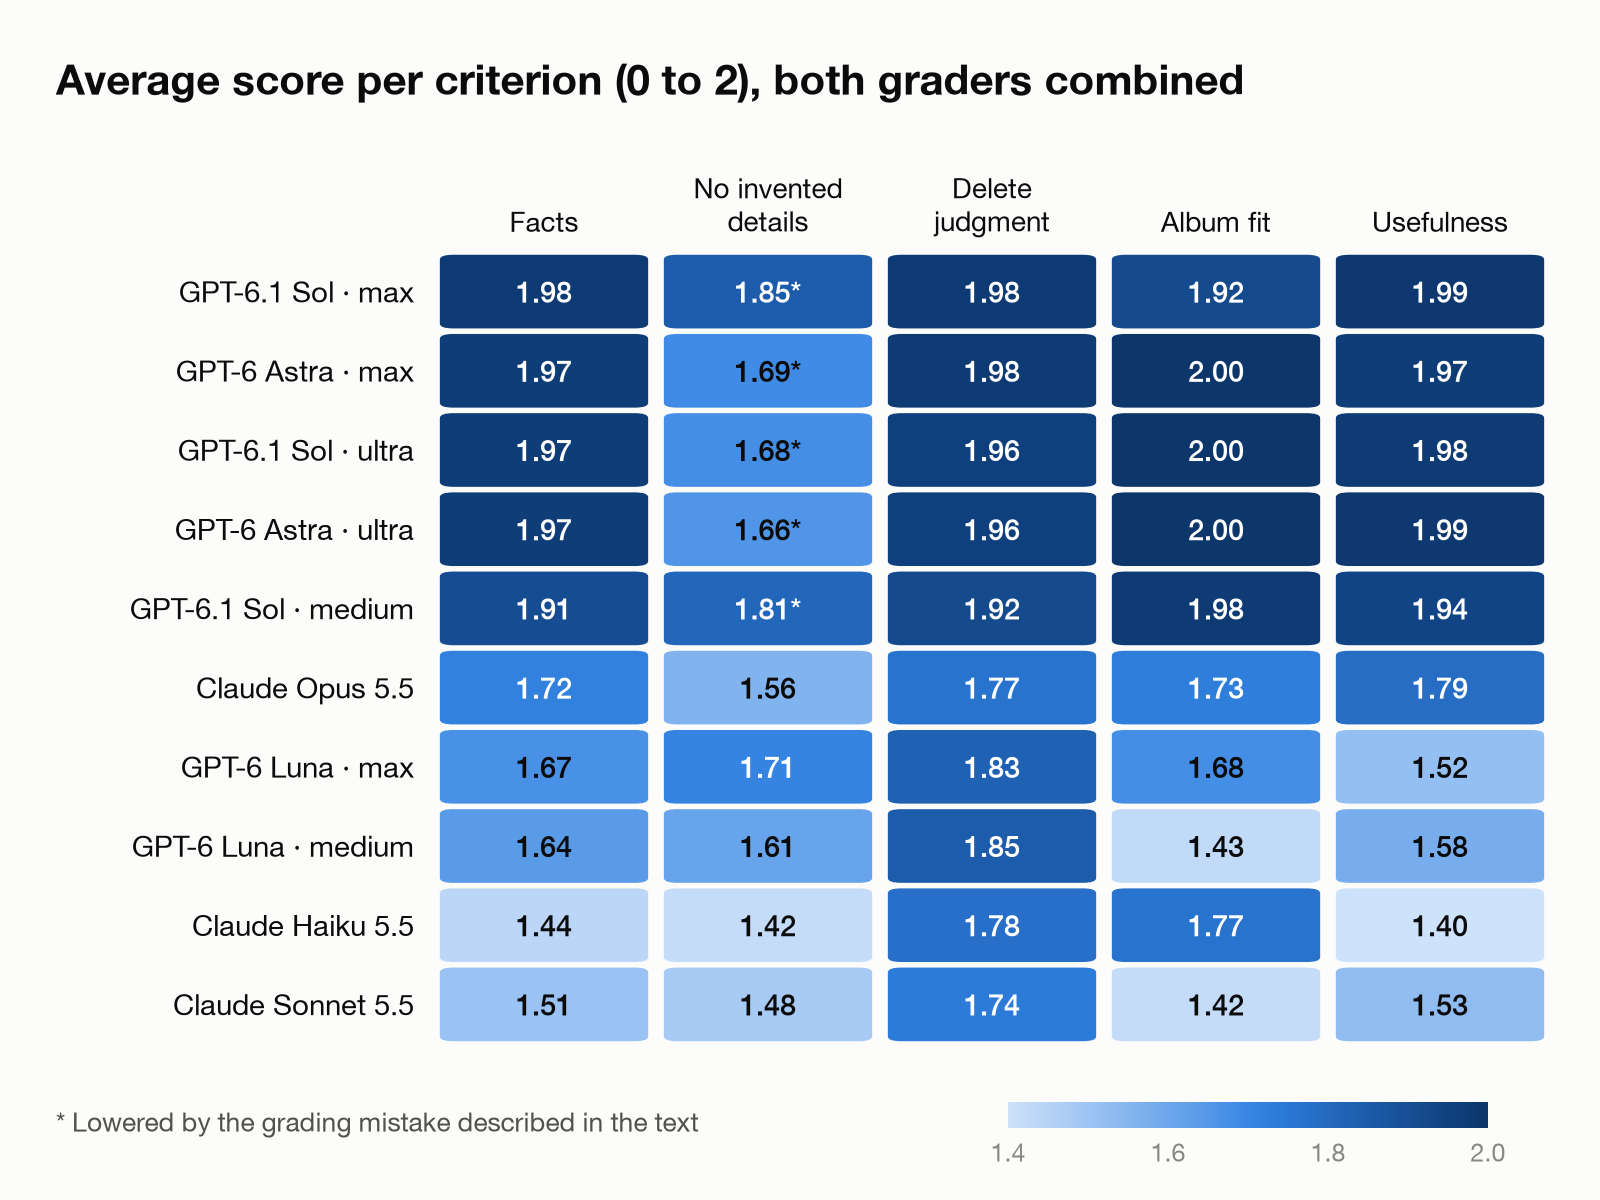 Figura 5. Punteggio medio per criterio, con i due valutatori combinati. Un asterisco segna i punteggi abbassati dall'errore di valutazione che descrivo più sotto.
GPT-6.1 Sol e GPT-6 Astra
Sol e Astra leggevano il testo con precisione e per lo più limitavano le didascalie a ciò che le foto mostravano. Erano anche i migliori con i nomi di luogo locali, il che conta per le foto scattate in Cina.
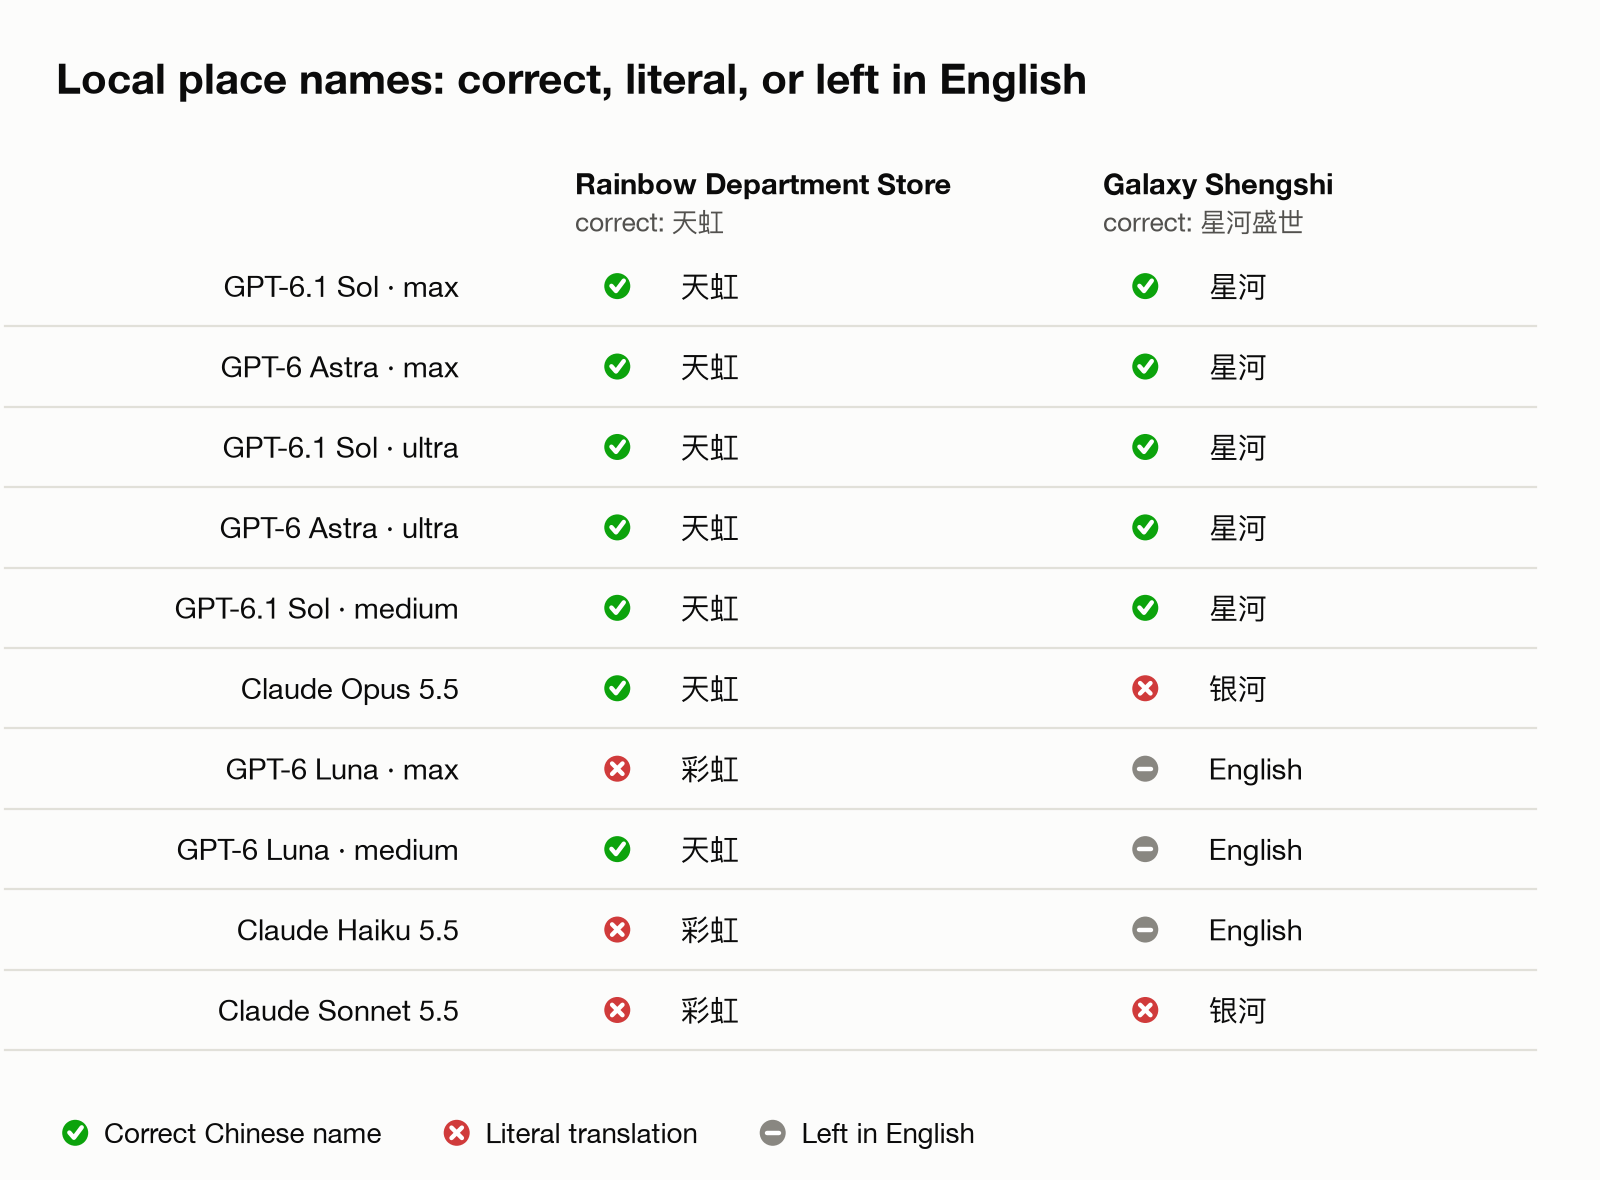 Figura 6. Due test sui nomi locali. Una spunta indica il nome cinese corretto, una croce una traduzione letterale, ed EN significa che il nome è rimasto in inglese.
Diverse foto erano etichettate con il luogo «Rainbow Department Store». È il nome inglese della catena di centri commerciali di Shenzhen 天虹. Una traduzione parola per parola dà 彩虹百货, che è sbagliato. Tutte le configurazioni Sol e Astra hanno azzeccato, così come Opus e Luna a medium. Haiku, Sonnet e Luna a max hanno usato la traduzione letterale. La foto della caffetteria nella Figura 2 era etichettata «Galaxy Shengshi», il cui nome cinese è 星河盛世. Tutte le configurazioni Sol e Astra hanno scritto 星河. Opus e Sonnet l'hanno tradotto letteralmente come 银河, e Haiku ed entrambe le configurazioni Luna l'hanno lasciato in inglese.
Sol e Astra erano anche attenti a eliminare. Suggerivano di eliminare da 4 a 6 delle 50 foto. Il set includeva otto screenshot di pagine prodotto di componenti elettronici, e i modelli GPT ne hanno tenuto quasi tutti; una configurazione Sol ha segnalato un singolo screenshot come quasi duplicato. I modelli Claude ne hanno segnalati da due a quattro ciascuno. Entrambi i valutatori erano favorevoli a tenerli, poiché le pagine contenevano piedinature, dimensioni e foto di schede che vorrei consultare in seguito.
Claude Opus 5.5
Opus a volte scriveva in una didascalia cose che la foto da sola non può mostrare. Descriveva relazioni che l'immagine da sola non può provare, come fratelli o genitore e figlio. Sbagliava anche alcune pose. In una foto, un bambino era in piedi dietro un adulto, e Opus scriveva che il bambino era sulla schiena dell'adulto. Entrambi i valutatori hanno tolto punti per questo.
Questo mi ha sorpreso. Prima del test alla cieca, avevo esaminato le risposte e lodato Opus per aver correttamente indovinato che due bambini erano fratelli. Io conosco la mia famiglia; il valutatore no. Ma con 142.000 foto non posso controllare ogni didascalia da solo, e una didascalia che afferma qualcosa che la foto non mostra è un problema.
Opus suggeriva anche il maggior numero di eliminazioni, 13 delle 50 foto. Tre di esse erano screenshot di pagine prodotto che definiva scaduti, benché contenessero informazioni di riferimento che avrei tenuto. Era l'unico modello che voleva eliminare il cartello QR di sconto per il parcheggio come di scarso valore. Ha anche messo diverse foto di una singola persona in un album «ritratto di famiglia».
Claude Sonnet 5.5 e Haiku 5.5
Questi due hanno commesso il maggior numero di errori fattuali, inclusa la traduzione letterale 彩虹. Sonnet ha fatto le scelte di album più deboli e ha archiviato foto quotidiane in un vecchio album di un evento non correlato. Haiku ha inventato un dettaglio che ha portato a una cattiva decisione di eliminazione. In una raffica di scatti quasi identici, descriveva il fotogramma migliore come qualcuno che guarda in basso, l'opposto di ciò che mostra la foto, e suggeriva di eliminarlo.
GPT-6 Luna
Luna costa per token quanto Haiku ma ha ottenuto punteggi più alti a entrambi i livelli di impegno: 8,41 e 8,11, contro il 7,81 di Haiku. A impegno max ha anche battuto Sonnet, che costerebbe circa 17 volte tanto per descrivere la stessa libreria. Luna ha perso la maggior parte dei punti su utilità e scelta dell'album. Le sue didascalie erano più semplici e i suoi album meno precisi.
Livelli di impegno
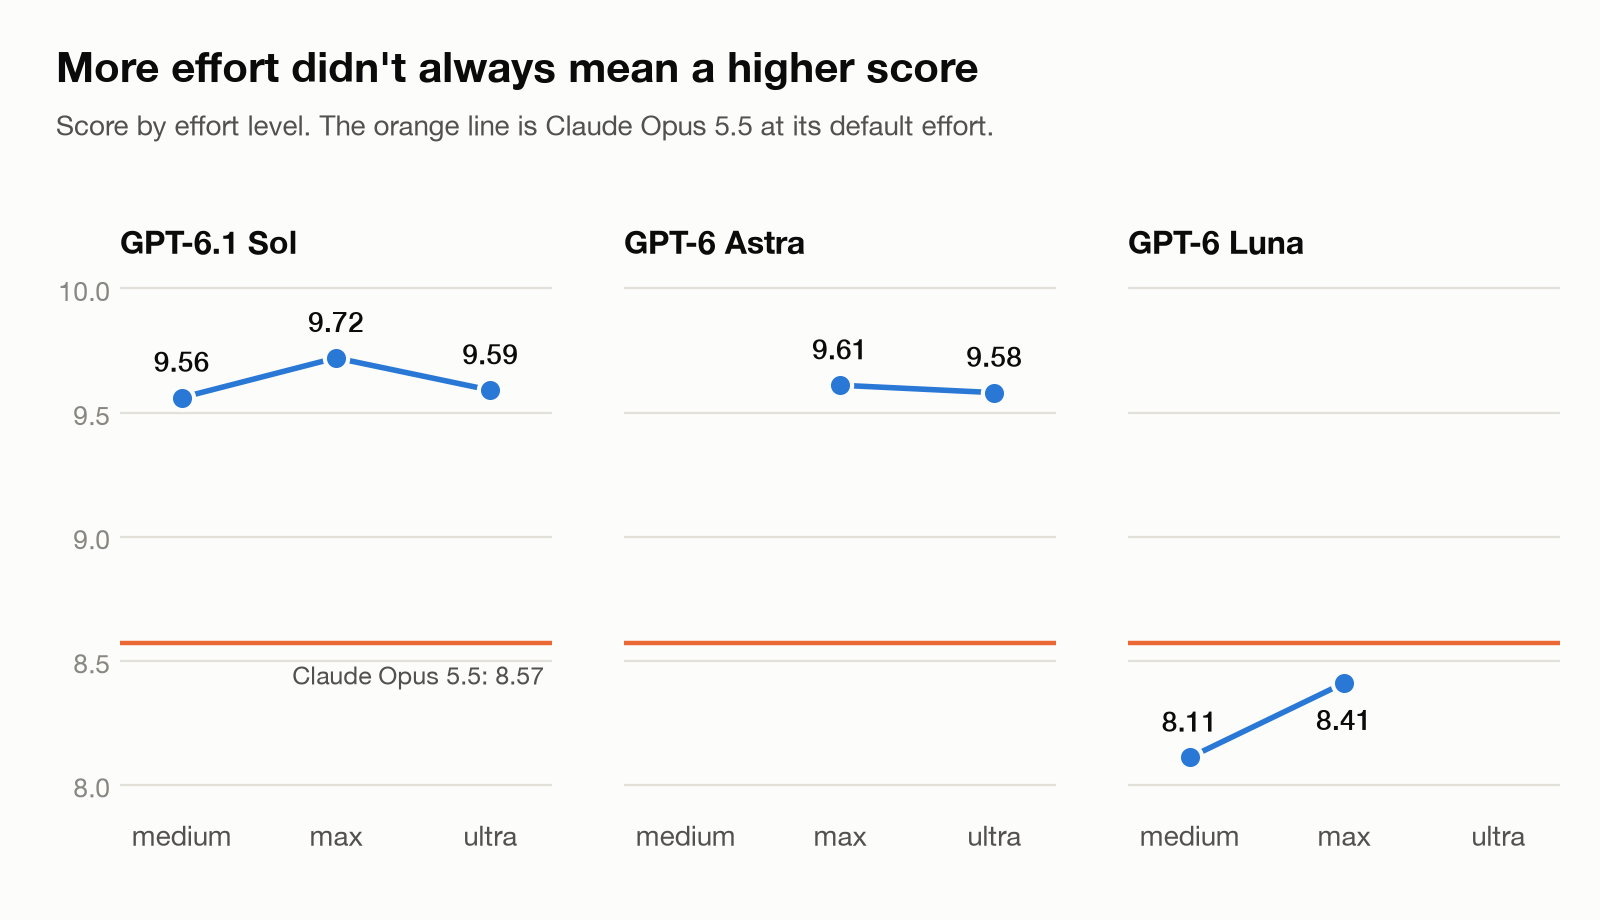 Figura 7. Punteggio per livello di impegno. La linea arancione è Claude Opus 5.5 al suo impegno predefinito.
Ultra non è stato migliore di max per nessuno dei due modelli. Sol ha ottenuto 9,59 a ultra e 9,72 a max; Astra ha ottenuto 9,58 e 9,61. In questo test, ultra ha persino prodotto meno token in uscita di max. Per Sol, medium si è avvicinato con 9,56, per meno della metà del costo di max. Più impegno non significava sempre dettagli più precisi: Luna a medium ha azzeccato 天虹, e Luna a max no.
Un errore nella mia valutazione
Dopo la valutazione, ho notato che ai valutatori non era stata data la data e l'ora di scatto di ogni foto, sebbene i modelli di didascalia le avessero. Così il valutatore GPT-6 Astra ha trattato le didascalie che menzionavano la data o l'ora esatta come dettagli inventati. Le migliori configurazioni GPT menzionavano la data più spesso, quindi i loro punteggi su «Nessun dettaglio inventato» sono risultati più bassi di quanto avrebbero dovuto.
Se restituisco solo i punti persi sulle date, le prime quattro configurazioni GPT salgono a tra 9,84 e 9,90, che è in pratica un pareggio, e Opus resta a 8,58. Ho mantenuto i punteggi originali in questo articolo. La prossima volta darò ai valutatori tutto ciò che i modelli hanno visto.
Velocità
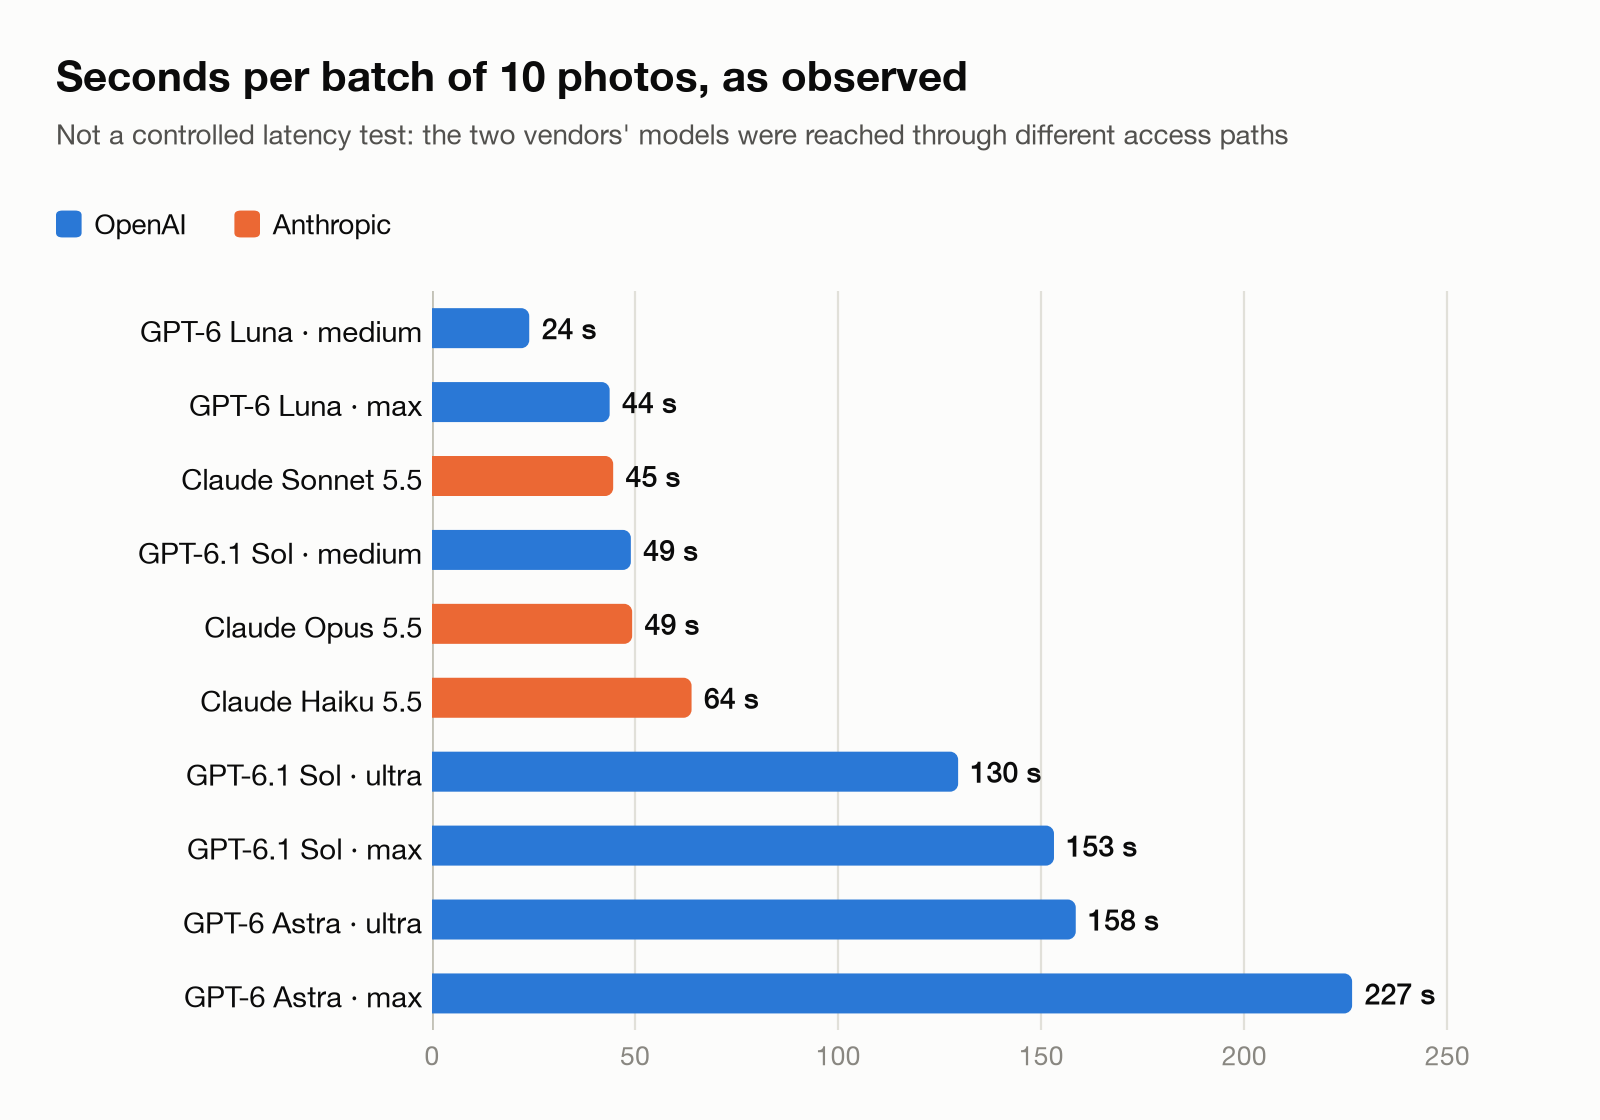 Figura 8. Secondi per lotto di 10 foto, come osservato. Non è un test di latenza controllato, perché i modelli dei due fornitori sono stati raggiunti tramite percorsi di accesso diversi.
Questo corrisponde alla sensazione che Opus mi dà nel lavoro quotidiano: è veloce, circa tre volte più veloce di Sol a max. Sol a medium, però, era altrettanto veloce di Opus e otteneva circa un punto in più.
Quanto costa
Ho prezzato ogni configurazione ai prezzi ufficiali dell'API dei fornitori. Trattare l'uso incluso in un piano di abbonamento come gratuito farebbe sembrare alcuni modelli migliori di quanto siano.
Prezzi ufficiali per milione di token, livello standard:
| Modello | Input | Output |
|---|---|---|
| Claude Opus 5.5 | $4.00 | $20.00 |
| Claude Sonnet 5.5 | $2.00 | $10.00 |
| Claude Haiku 5.5 | $0.10 | $0.50 |
| GPT-6 Astra | $10.00 | $50.00 |
| GPT-6.1 Sol | $2.00 | $10.00 |
| GPT-6 Luna | $0.10 | $0.50 |
Le Batch API di entrambi i fornitori costano il 50 % in meno, il che si adatta a un lavoro come questo che non richiede risposte immediate. Ho preso i prezzi dalla pagina dei prezzi di Anthropic (claude.com/pricing) e dalla pagina dei prezzi dell'API di OpenAI (developers.openai.com/api/docs/pricing) il 20 ottobre 2026.
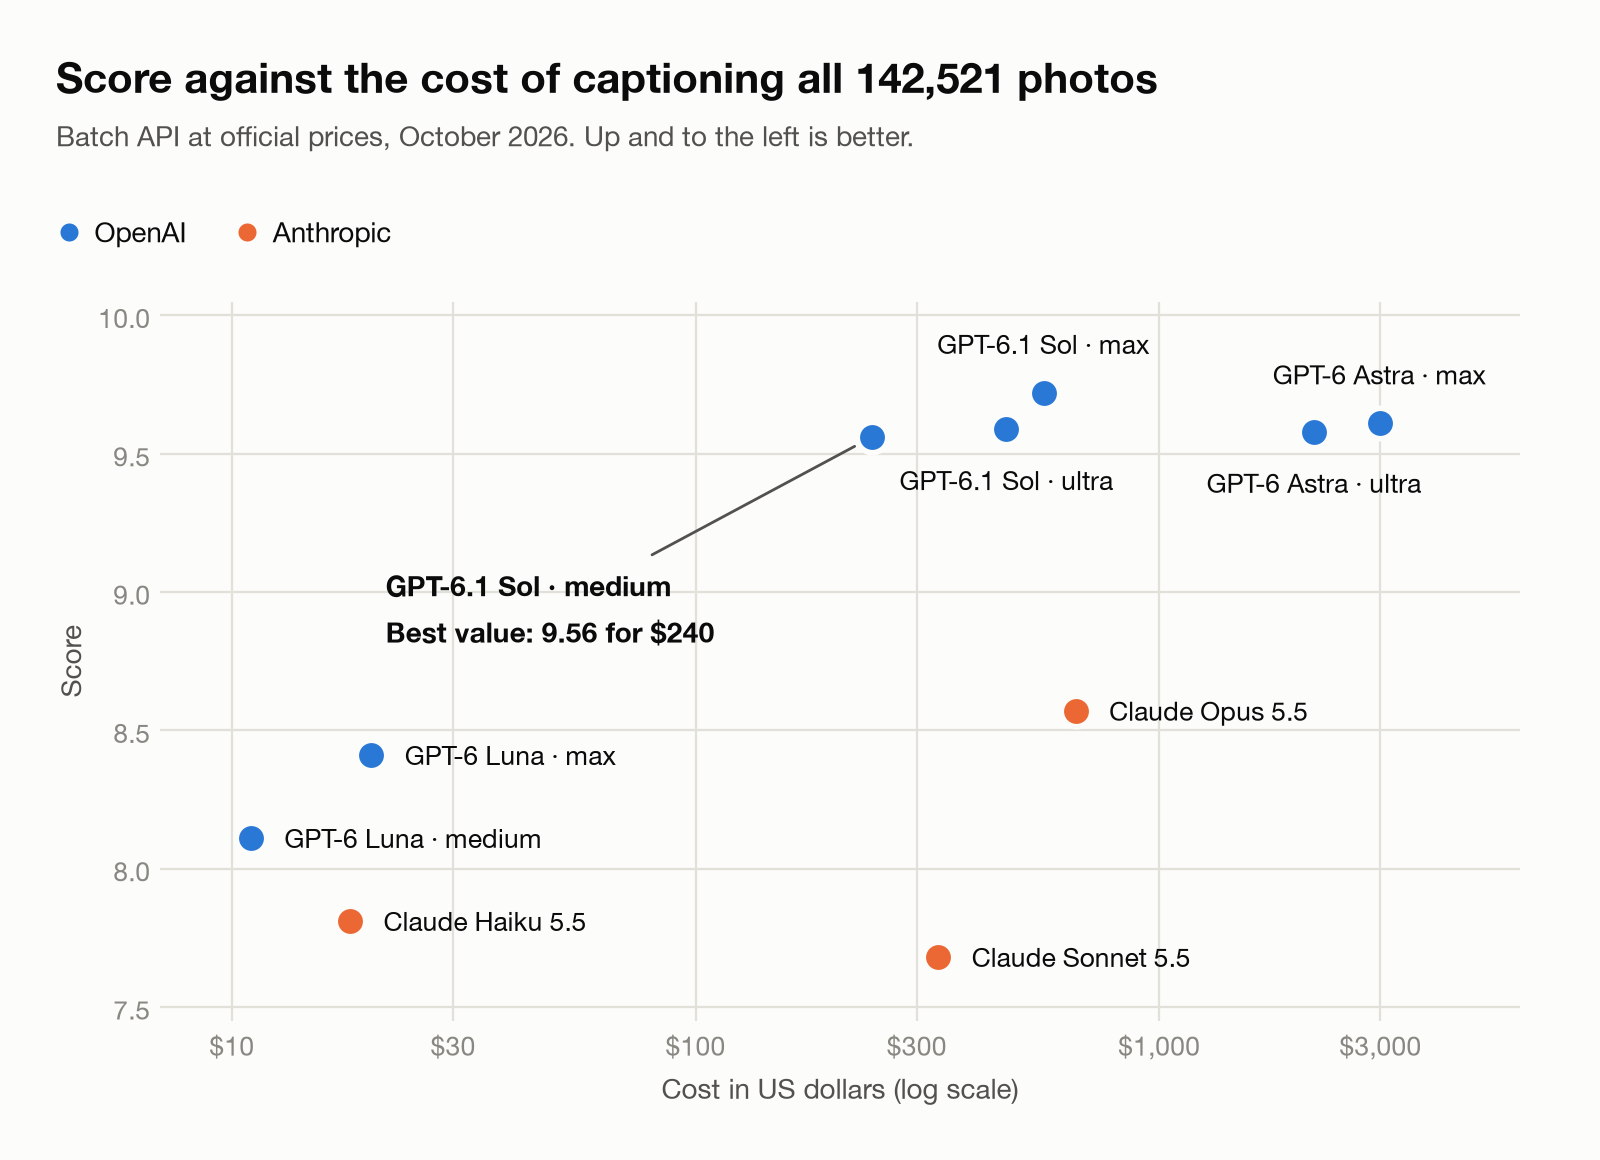 Figura 9. Punteggio rispetto al costo di descrivere l'intera libreria ai prezzi Batch. L'asse dei costi è logaritmico.
| Modello e impegno | Token in uscita per foto | Standard | Batch | Punteggio |
|---|---|---|---|---|
| GPT-6.1 Sol, medium | 193 | $479 | $240 | 9.56 |
| GPT-6.1 Sol, ultra | 514 | $937 | $468 | 9.59 |
| GPT-6.1 Sol, max | 647 | $1,126 | $563 | 9.72 |
| Claude Opus 5.5 | ~292 | $1,323 | $661 | 8.57 |
| Claude Sonnet 5.5 | ~297 | $668 | $334 | 7.68 |
| GPT-6 Astra, ultra | 462 | $4,313 | $2,156 | 9.58 |
| GPT-6 Astra, max | 695 | $5,973 | $2,987 | 9.61 |
| GPT-6 Luna, medium | 163 | $22 | $11 | 8.11 |
| Claude Haiku 5.5 | ~330 | $36 | $18 | 7.81 |
| GPT-6 Luna, max | 419 | $40 | $20 | 8.41 |
Sol a medium ha ottenuto il 98 % del punteggio migliore per il 36 % di quanto costerebbe Opus e il 43 % di Sol a max. Astra ha eguagliato la qualità di Sol ma costa circa cinque volte tanto, perché il suo prezzo per token è cinque volte più alto. Opus è costato più di Sol a max e ha ottenuto un punteggio più basso. Girava già a impegno medium, ma il suo prezzo per token è il doppio di quello di Sol. Luna descriverebbe l'intera libreria per $11–20 e supererebbe comunque Haiku e Sonnet.
Nota di metodo: i conteggi di token di GPT sono stati misurati dalle esecuzioni, e i conteggi di token di Claude sono stati stimati dai log di esecuzione. Alcuni token di ragionamento di Claude non erano visibili, quindi i costi di Claude potrebbero essere leggermente sottostimati. A nessun modello sono stati applicati sconti oltre a Batch, come il caching dei prompt.
Cosa ho imparato
Ho scelto Opus prima di avere qualsiasi punteggio alla cieca, soprattutto perché era già la mia scelta predefinita per programmare. Preferisco ancora Claude Opus 5.5 per programmare e per i flussi di lavoro, dove nella mia esperienza è più veloce e più forte. Descrivere foto reali richiede un'abilità diversa: leggere ciò che c'è davvero nell'inquadratura senza riempire pose o relazioni. GPT-6.1 Sol lo faceva meglio. Se avessi seguito l'abitudine e saltato il test alla cieca, avrei pagato di più per didascalie peggiori.
La prossima volta inizierò alla cieca e darò ai valutatori di fornitori diversi tutti gli input che i modelli di didascalia hanno ricevuto. Continuerò anche a confrontare ai prezzi ufficiali dell'API, e non darò per scontato che più impegno sia meglio: qui ultra non ha battuto max.
Anche i migliori modelli hanno segnalato foto utili per l'eliminazione, quindi controllerò io stesso ogni segnalazione di eliminazione prima di rimuovere qualcosa.
Limiti
È stato un test piccolo: 50 foto recenti di una sola città. Non ho testato foto più vecchie, documenti scansionati, altre lingue o video. I modelli Claude hanno girato solo con le impostazioni predefinite; un Opus a impegno più alto potrebbe ottenere un punteggio migliore, a un costo più alto. I valutatori sono modelli di IA, non persone. Erano d'accordo bene ma non perfettamente, e un controllo a campione umano renderebbe il risultato più solido. Modelli e prezzi cambiano in fretta, e ogni numero qui è di ottobre 2026.
La mia scelta
Per la mia libreria: GPT-6.1 Sol a impegno medium. Per programmare e per i flussi di lavoro, resto con Claude Opus 5.5.