
Le reti neurali plasmano già quasi ogni video che guardiamo, ma a entrambe le estremità di un codec standard, non al suo posto. Ecco dove si usa la codifica neurale nel 2026, quanto costa in silicio e chi guadagna, con il rapporto completo e le slide.
Sommario
La codifica neurale è già diffusa nel 2026, ma lavora attorno ai codec standard anziché sostituirli. Le reti modellano l’immagine prima della codifica, nelle fotocamere degli smartphone e nella pipeline di codifica di Netflix, e la riparano dopo la decodifica, nella Super Resolution di YouTube, in Meta e nei processori dei televisori; il bitstream in mezzo è ancora AV1, HEVC, AVC o VVC, decodificato da hardware a funzione fissa. I codec neurali end-to-end si usano solo in circuiti chiusi in cui un’unica azienda controlla entrambe le estremità: MLVC di Microsoft nelle chiamate Teams, i tokenizer dentro ogni modello vocale e video, le texture neurali in un gioco. La riproduzione di massa di bitstream neurali aspetta H.267, previsto per la fine del 2029, e poi un ciclo del silicio. La ragione sta nel chip: l’unico progetto pubblicato di decoder video neurale richiede circa 12 volte l’energia per pixel di un decoder HEVC misurato, e un codec di ricerca veloce richiede circa 22 TOPS per il 1080p30. Il denaro segue gli standard e le piattaforme; le startup di codec neurali più note sono state acquisite.
Perché me ne sono occupato
Ogni pochi mesi qualcuno mi dice che i codec IA stanno per sostituire H.264, HEVC e AV1. Quasi tutto ciò che leggo in proposito viene o dagli articoli di ricerca, dove si trovano i record di compressione, o dai produttori. Né gli uni né gli altri dicono molto su che cosa arrivi davvero nei prodotti, a chi e a quale costo.
Ho alle spalle molti anni di R&S e di gestione nel settore dei chip fabless, tra cui la progettazione full-custom di datapath ASIC e progetti di chip multimediali per fotocamere come acceleratori di codec video, e quindi ho esaminato il tema come esaminerei un chip: energia per pixel, traffico di memoria, che cosa uno standard consente di fissare nel silicio, e chi paga. Ho letto documenti di standardizzazione e resoconti di riunioni di JVET, MPEG, JPEG, AOMedia e IETF, blog di ingegneria delle aziende, articoli sui chip, tariffari dei pool di brevetti, testi sui controlli all’esportazione e la stampa. Ogni numero che segue è aggiornato al 12 novembre 2026, e gli importi sono in dollari USA. Il rapporto completo, con tutte le fonti, è in fondo.
I risultati in breve
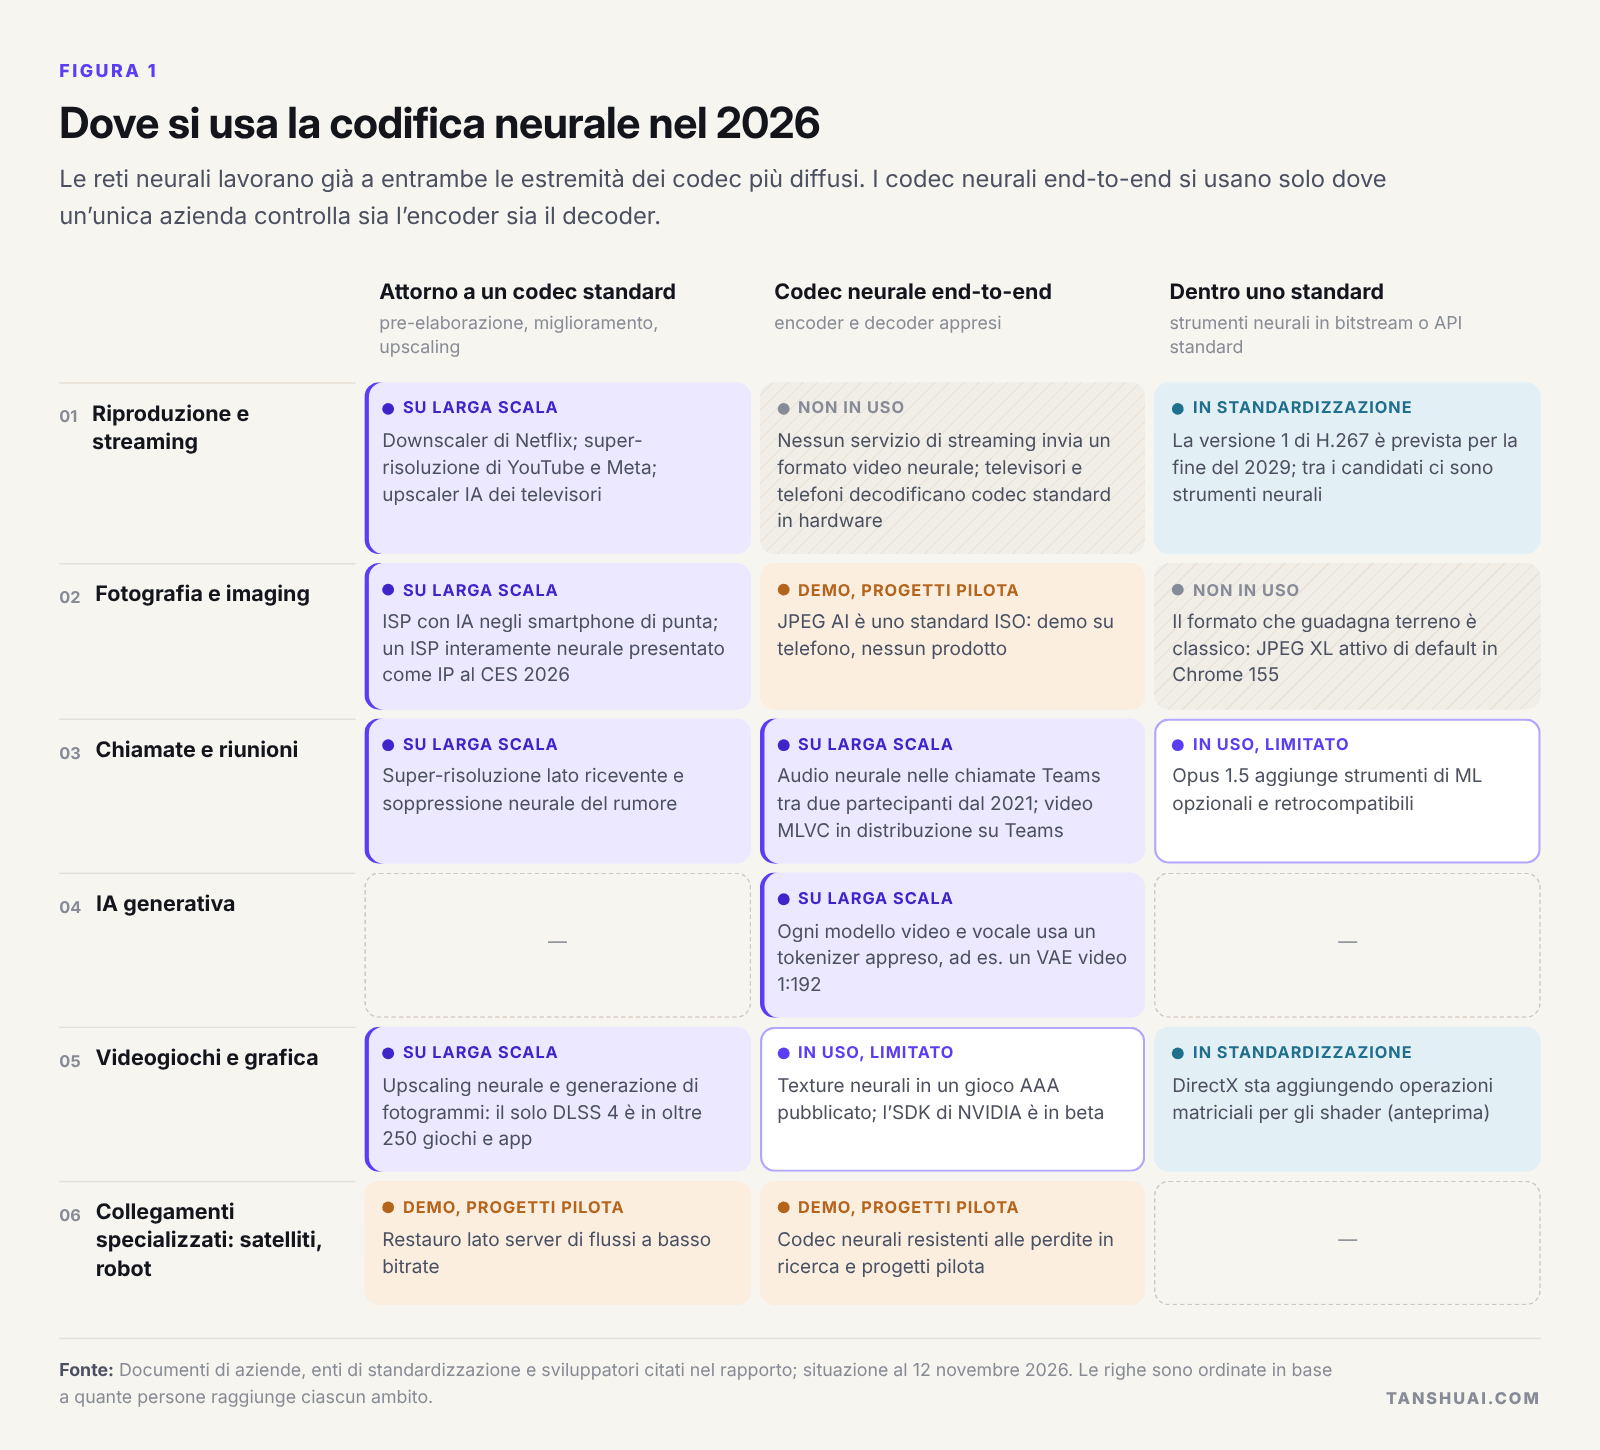 Figura 1. Dove si usa la codifica neurale nel 2026. Le righe sono ordinate in base a quante persone raggiunge ciascun ambito.
| Domanda | Risposta breve |
|---|---|
| Dove si usa la codifica neurale su larga scala? | Attorno al codec: ISP delle fotocamere, downscaling lato codifica, super-risoluzione in riproduzione. End-to-end solo in circuiti chiusi: chiamate, asset di gioco, tokenizer dell’IA generativa |
| I codec neurali sostituiranno AV1, HEVC e VVC nella riproduzione? | Non prima di H.267 (versione 1 alla fine del 2029) e di un ciclo di dispositivi successivo; uso di massa a metà degli anni 2030, secondo la mia stima |
| Quanto costa in silicio? | Circa 12 volte l’energia per pixel di un decoder HEVC hardware, più il traffico di memoria e l’obbligo di una decodifica esatta al bit |
| Chi guadagna? | Le piattaforme si tengono i risparmi; fornitori di IP e pool di brevetti sono pagati per progetto e per dispositivo; le startup di codec neurali sono state acquisite |
| Dove può inserirsi un’azienda? | Pre- e post-elaborazione neurale, prodotti a circuito chiuso, silicio codec più NPU, e il lavoro di valutazione e di standardizzazione che sta in mezzo |
Tre vie d’ingresso
La «codifica neurale» indica tre cose diverse, e gran parte delle discussioni in materia nasce dal confonderle. Una rete può lavorare attorno a un codec standard, elaborando i pixel prima della codifica o dopo la decodifica mentre il bitstream resta standard. Può stare dentro uno standard, come strumento che ogni decoder deve eseguire, il che significa che deve essere specificata in modo esatto. Oppure può sostituire il codec end-to-end, con un encoder e un decoder appresi che funzionano solo in coppia.
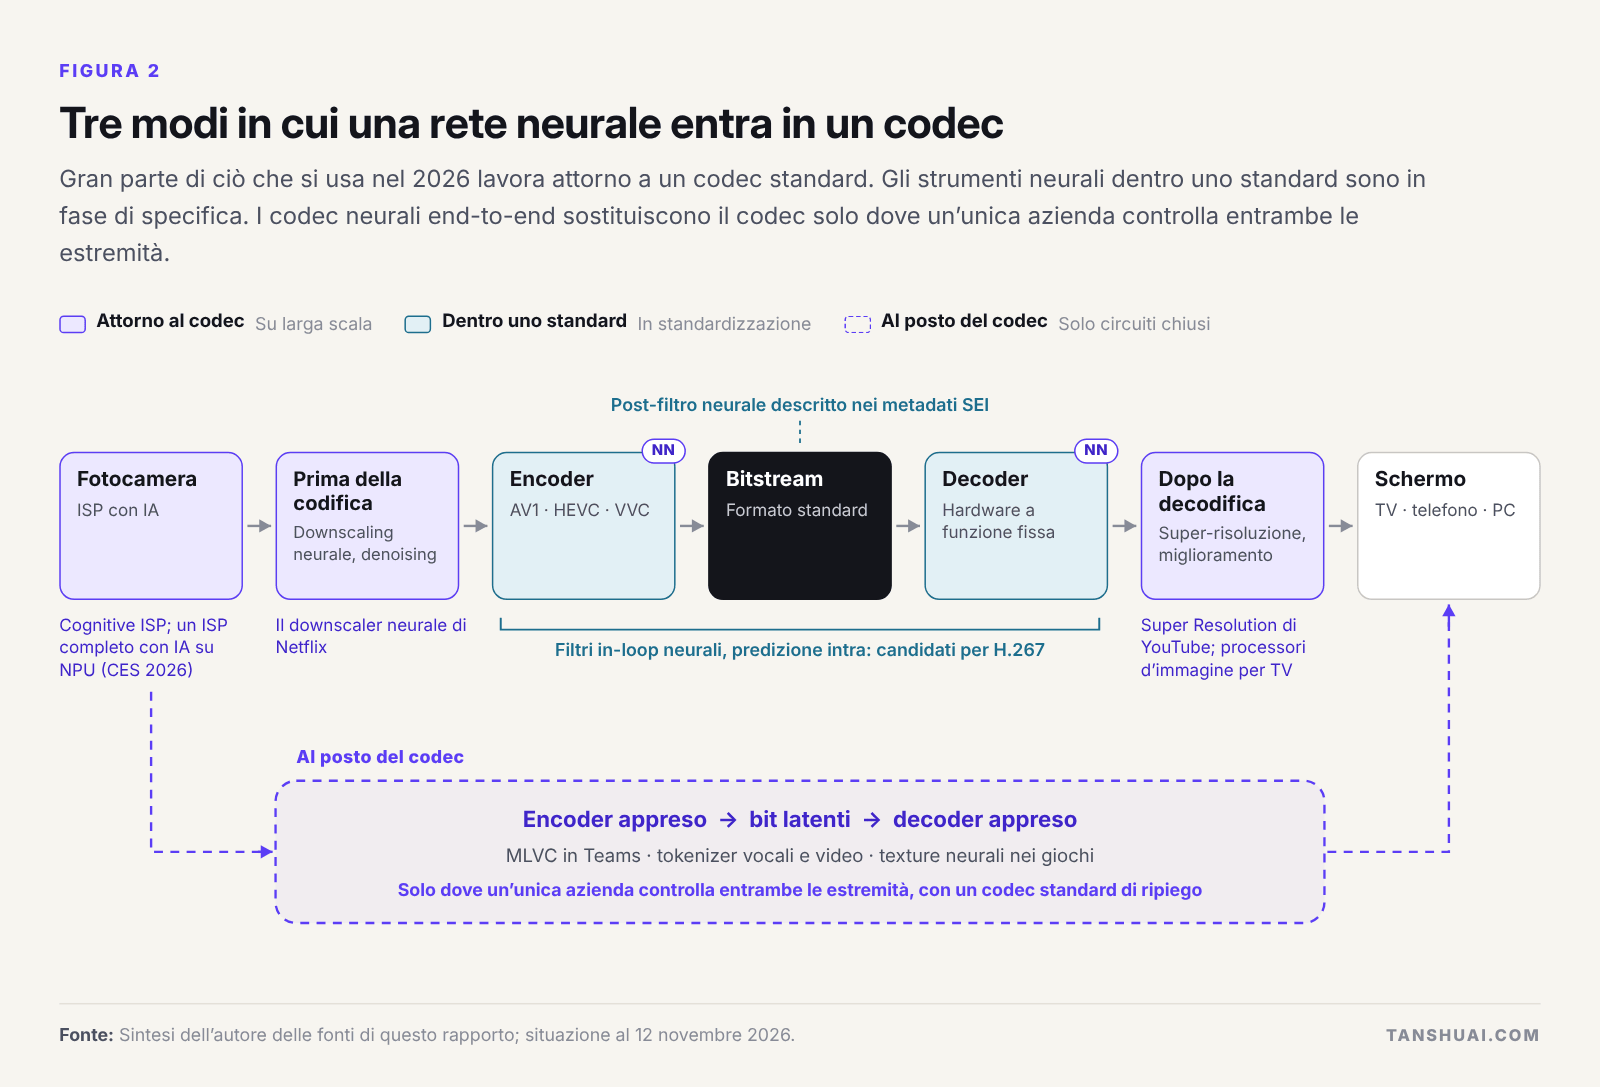 Figura 2. Tre modi in cui una rete neurale entra in un codec. Gran parte di ciò che si usa nel 2026 è del primo tipo.
Il primo non ha bisogno del permesso di nessuno. Il secondo ha bisogno di uno standard. Il terzo ha bisogno del controllo di entrambe le estremità. È l’ordine in cui arrivano alle persone.
Riproduzione e streaming: neurale a entrambe le estremità, standard nel mezzo
I grandi servizi hanno completato una transizione di codec e stanno avviando la successiva, e nessuna delle due coinvolge un decoder neurale. Netflix ha comunicato a dicembre 2025 che AV1 trasportava circa il 30% delle sue visioni; YouTube afferma che più del 90% del suo catalogo, ponderato per tempo di visione, è disponibile in AV1. AV2 è stato finalizzato il 28 maggio 2026 con una compressione migliore di circa il 30% rispetto ad AV1, ed entro tre settimane Chips&Media, Allegro DVT e VeriSilicon avevano annunciato clienti per il decoder AV2. La TV 3.0 brasiliana ha avviato le trasmissioni commerciali in VVC a giugno 2026.
La parte neurale sta a entrambe le estremità. Dal 2022 Netflix usa una piccola rete neurale al posto di un filtro convenzionale per ridurre la risoluzione dei suoi master, il che non richiede modifiche su alcun dispositivo ed è stato preferito da circa il 77% degli spettatori nei test di Netflix. Sui televisori YouTube applica un upscaling basato sull’apprendimento automatico ai video caricati sotto il 1080p, Meta esegue la super-risoluzione sui propri server e sui telefoni, e il processore di punta di Samsung per i televisori dichiara 768 reti di upscaling.
Ciò che non esiste è un bitstream neurale sugli schermi di largo consumo, e la ragione è il tempo. Un formato di riproduzione deve essere decodificabile su ogni dispositivo che lo riprodurrà mai. AV1 ha impiegato quasi otto anni dalla specifica finalizzata al 30% delle visioni su Netflix.
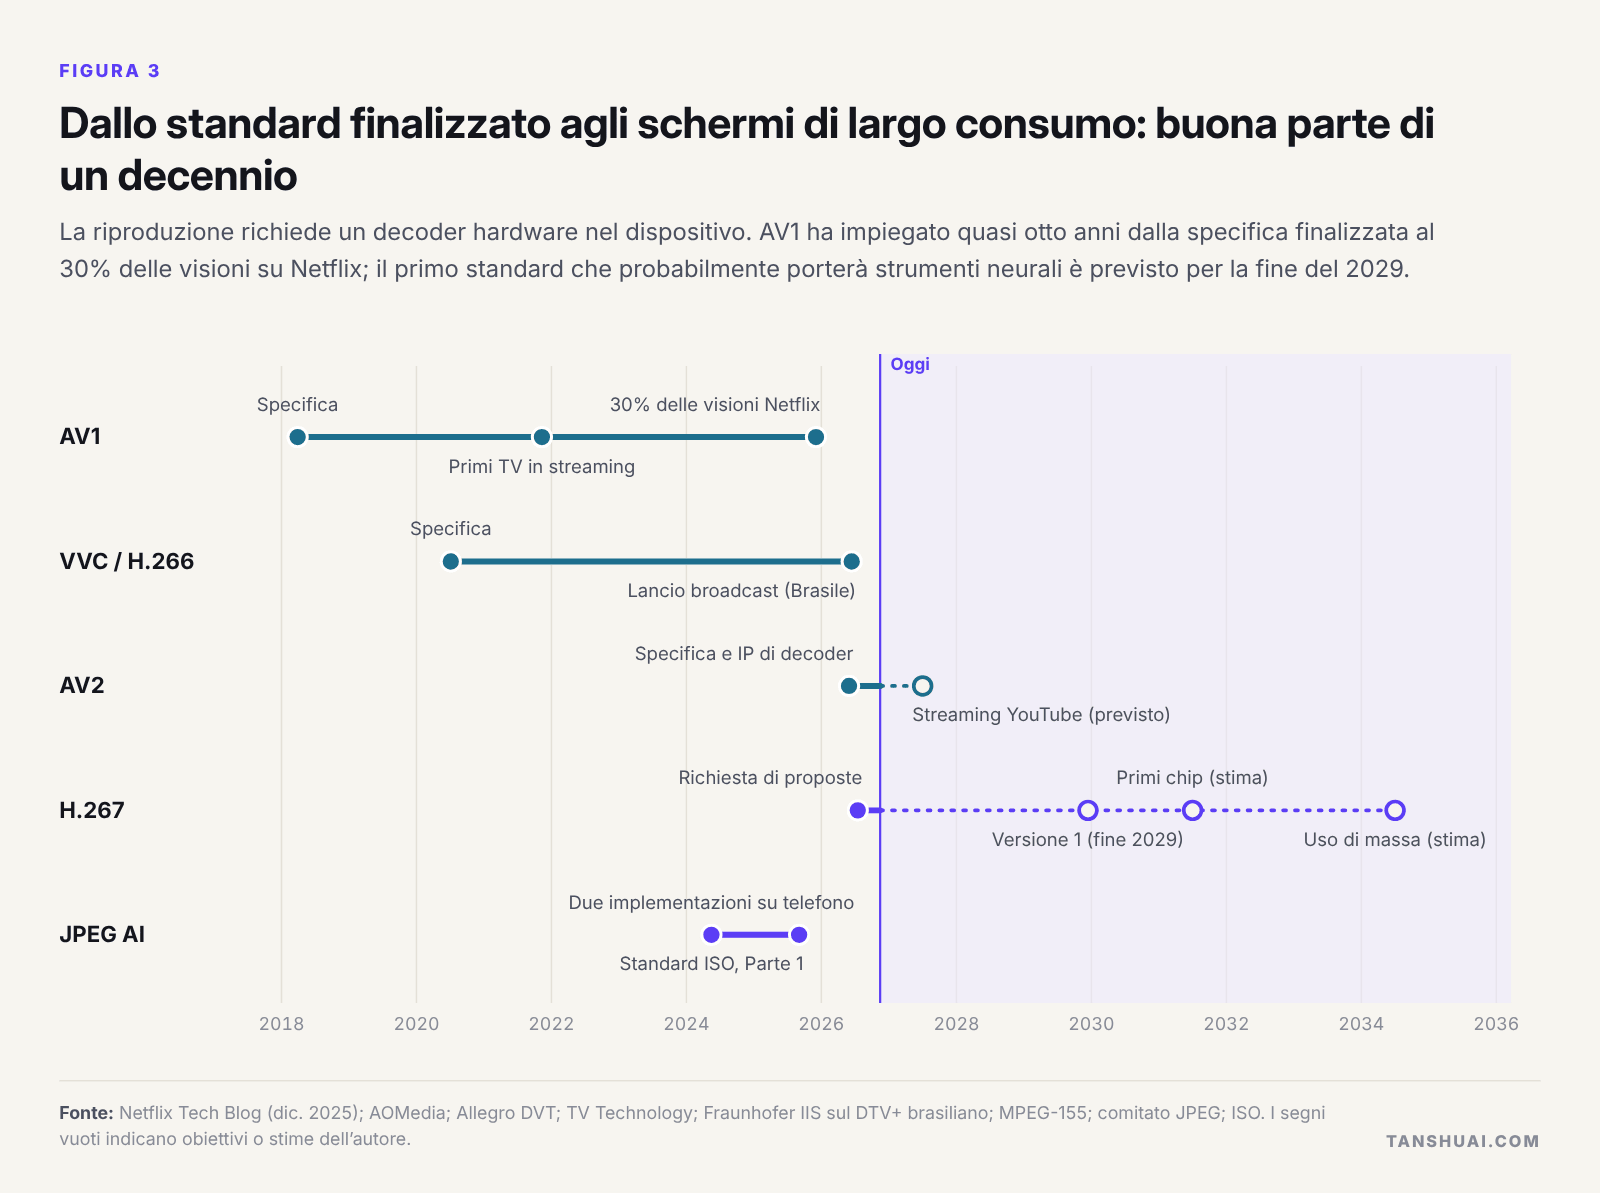 Figura 3. Dallo standard finalizzato agli schermi di largo consumo: buona parte di un decennio.
Lo standard che potrebbe portare strumenti neurali su ogni schermo è H.267, il nome provvisorio del successore di VVC. JVET ha emesso la sua richiesta di proposte a luglio 2026; le risposte saranno valutate a gennaio 2027 e la prima versione è prevista per la fine del 2029. Il filone classico risparmia già circa il 28% rispetto a VVC, mentre i filtri in-loop neurali di JVET risparmiano il 6–14% a un costo di decodifica di 10 mila MAC per pixel e oltre. Mi aspetto un nucleo classico con pochi strumenti neurali, dove i bit risparmiati giustificano il costo.
Fotografia: neurale dentro la fotocamera, classico sul web
Ogni foto scattata da un recente smartphone di punta è passata attraverso reti neurali prima di essere salvata. Il Cognitive ISP di Qualcomm esegue la segmentazione semantica in tempo reale dal 2023, e al CES 2026 Chips&Media e Visionary.ai hanno presentato un ISP completo che gira interamente su una NPU. Poi il risultato viene salvato in JPEG o HEIF.
JPEG AI, il primo standard di codifica appresa delle immagini, è stato pubblicato nel 2025, con guadagni del 12,5–27,9% rispetto alla codifica intra di VVC a costi di decodifica da 7 a 216 mila MAC per pixel. Non ho trovato alcuna fotocamera, app di galleria o browser che lo usi di default. Il formato adottato dal web nel 2026 è classico: Chrome 155 ha attivato JPEG XL il 6 ottobre, con un decoder veloce e memory-safe che gira su qualsiasi CPU. La codifica neurale vince dentro la pipeline di una singola azienda; i formati che devono aprirsi ovunque restano classici.
Chiamate: dove si usano i codec neurali end-to-end
Le chiamate sono un circuito chiuso: entrambe le estremità eseguono la stessa app e possono ripiegare su un codec standard a metà chiamata. Per questo i primi codec neurali end-to-end su larga scala sono lì. Satin, il codec vocale basato sull’IA di Microsoft, è in uso in tutte le chiamate Teams e Skype tra due partecipanti dal 2021. A luglio 2026 Microsoft ha reso open source MLVC, un codec video neurale ora in distribuzione nelle chiamate Teams peer-to-peer.
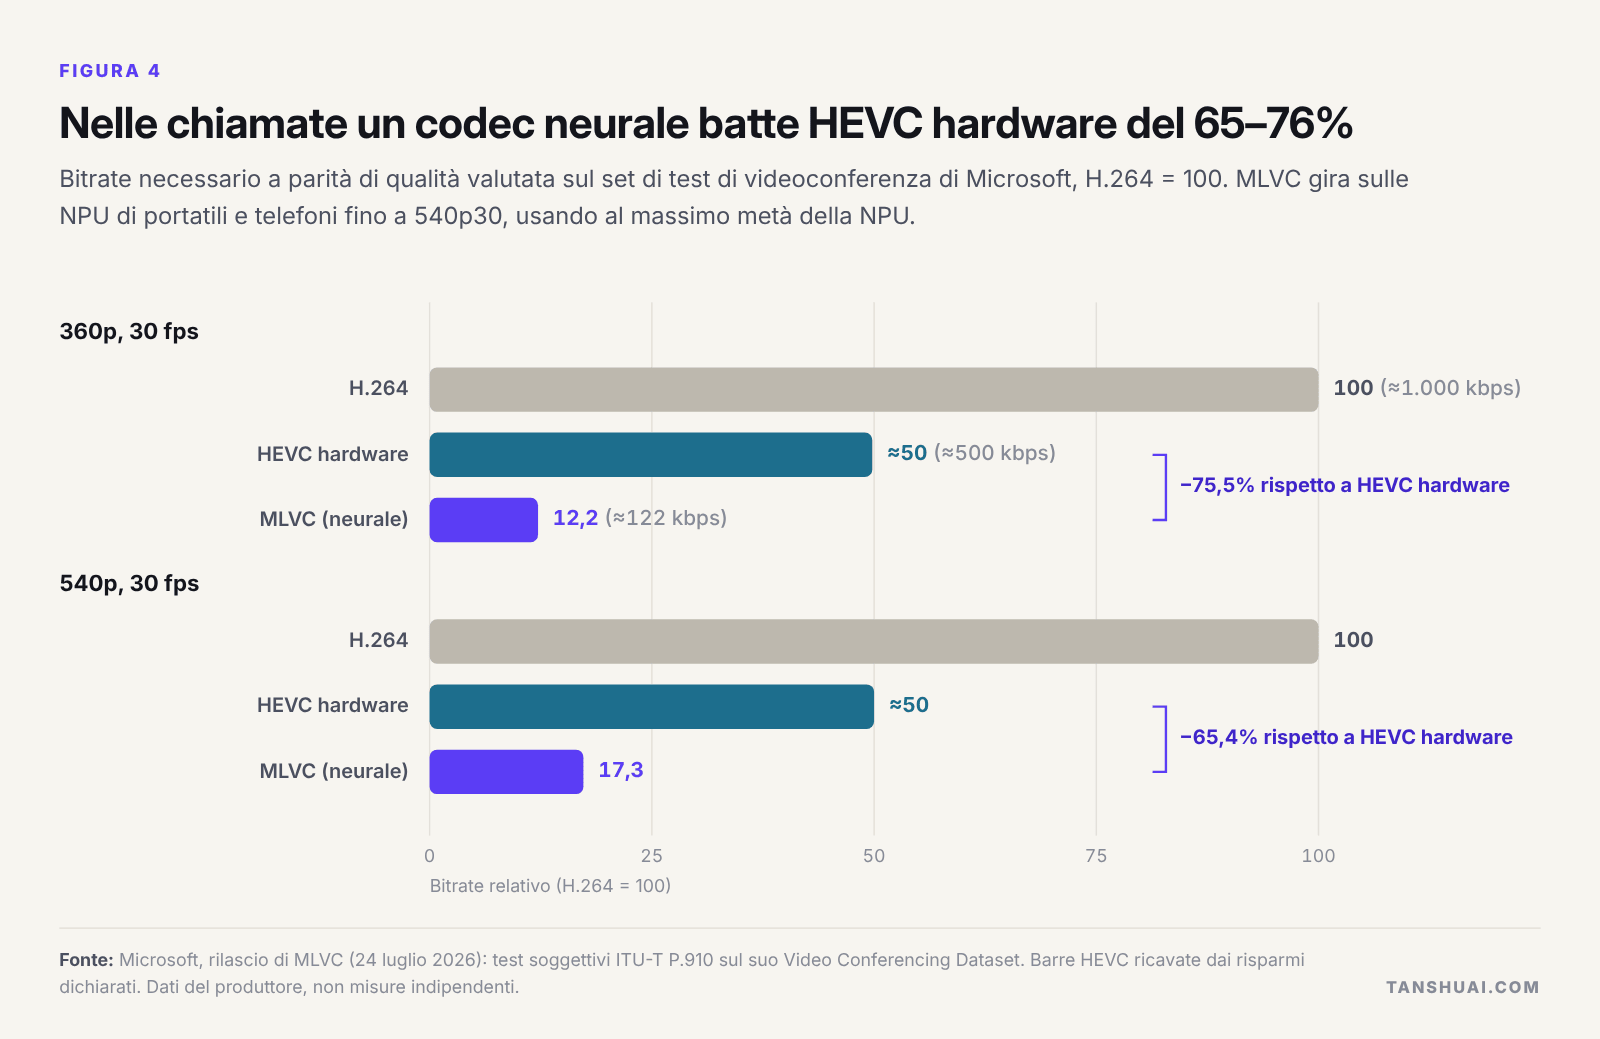 Figura 4. Nelle chiamate un codec neurale batte HEVC hardware del 65–76%, sul set di test della stessa Microsoft.
L’88% che fa notizia è rispetto a H.264; rispetto all’HEVC hardware già presente negli stessi portatili è il 65–76%, comunque molto. MLVC funziona a 540p e 360p usando al massimo metà della NPU, e ha rinunciato a parte della compressione per decodificare in modo identico su hardware che Microsoft non possiede.
Non tutti hanno scelto questa strada. Opus ha aggiunto il deep learning nel 2024 come componenti opzionali e retrocompatibili. Meta ha costruito MLow, un codec vocale classico, perché più del 20% delle sue chiamate avviene su vecchi telefoni ARMv7 e decine di milioni di chiamate WhatsApp al giorno passano da telefoni con più di dieci anni. I codec neurali arrivano prima dove i dispositivi sono nuovi e un solo fornitore controlla entrambe le estremità.
IA generativa: il più grande impiego che nessuno chiama codec
Ogni modello vocale e video si basa su un codec appreso. I modelli vocali leggono e scrivono i token di codec audio neurali come Mimi di Kyutai, a 12,5 frame al secondo e 1,1 kbps. I generatori video lavorano nello spazio latente di autoencoder video come quello di LTX-Video, che comprime 1:192. Nessuno di questi è un formato che qualcun altro decodifichi, ma dimostrano che la compressione appresa funziona su larga scala quando una sola azienda possiede l’encoder, il decoder e l’hardware. Per chiunque eroghi video generativo, l’efficienza del tokenizer è una voce di costo diretta.
Videogiochi: la ricostruzione neurale è diffusa, gli asset neurali sono agli inizi
Il DLSS di NVIDIA renderizza meno pixel e meno fotogrammi e lascia che una rete ricostruisca il resto. La compressione neurale delle texture è arrivata in Assassin’s Creed Mirage, usata solo su asset selezionati a causa del suo costo in esecuzione.
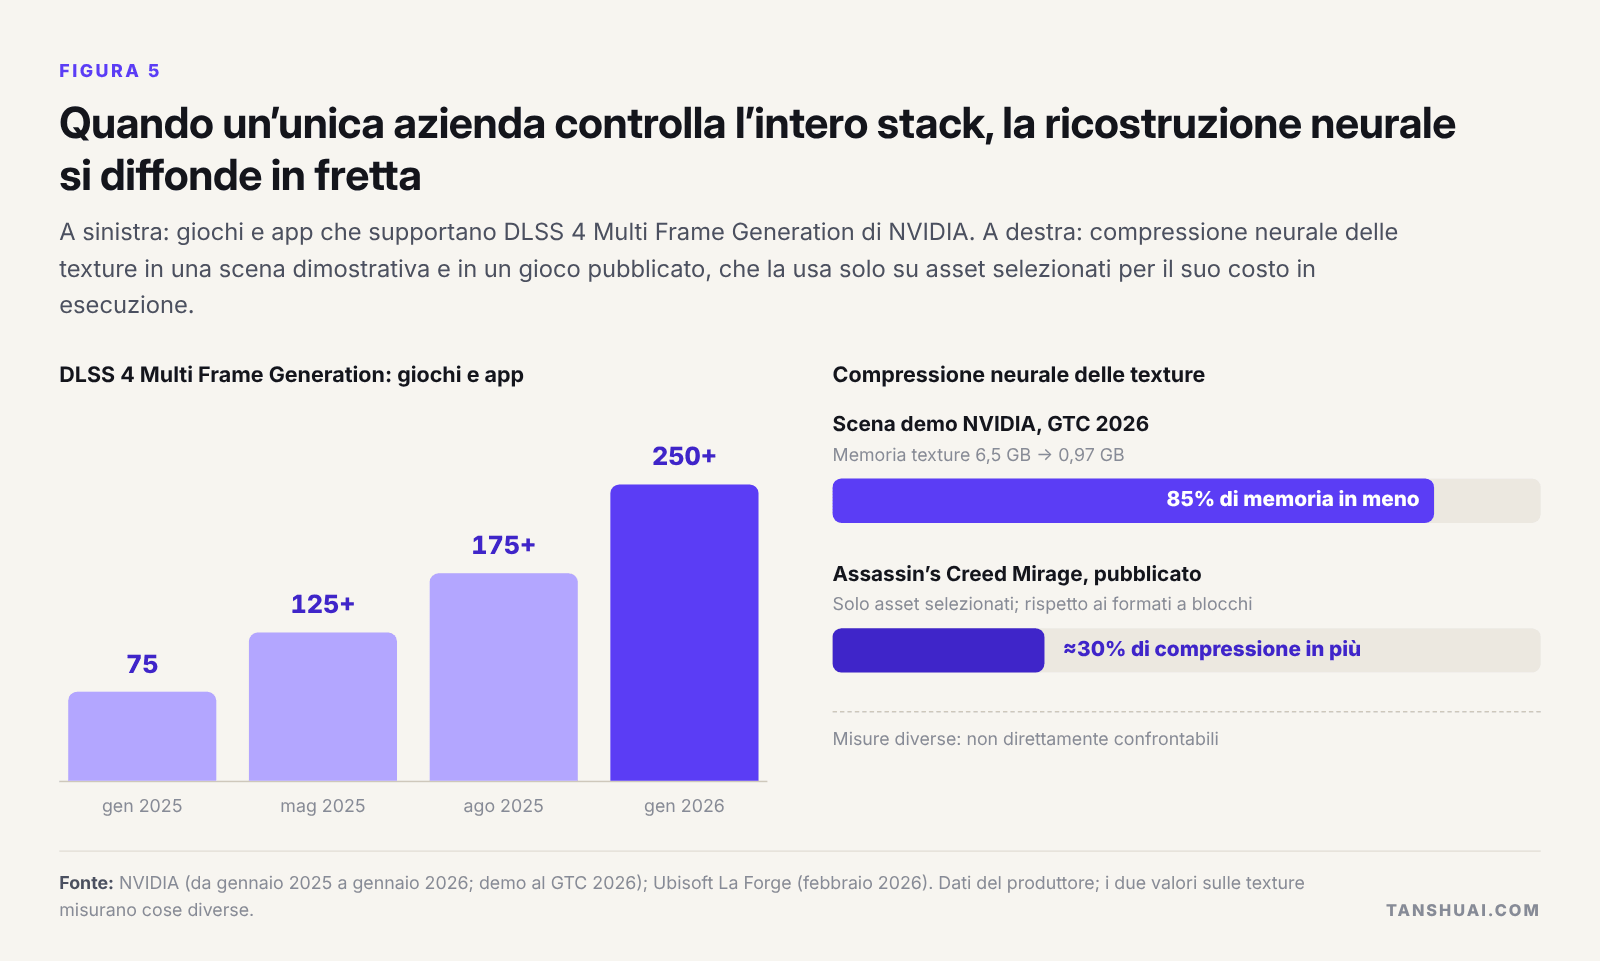 Figura 5. Quando un’unica azienda controlla l’intero stack, la ricostruzione neurale si diffonde in fretta.
I collegamenti di satelliti, droni e robot sono l’uso tecnicamente più adatto ai codec neurali end-to-end, ma sono un mercato piccolo e sempre più soggetto a controlli all’esportazione da entrambe le parti: le regole cinesi sull’esportazione dei droni in vigore dal 18 novembre 2026 citano persino la compressione semantica delle immagini come soglia.
La prospettiva del silicio
È qui che la mia esperienza conta di più. Un team di chip pone quattro domande su qualsiasi nuovo codec: joule per pixel, traffico DRAM per pixel, porte logiche, e se ogni decoder al mondo calcola esattamente gli stessi bit. Su tutti e quattro i punti, un decoder neurale nel 2026 è dove era HEVC hardware prima dei suoi primi chip.
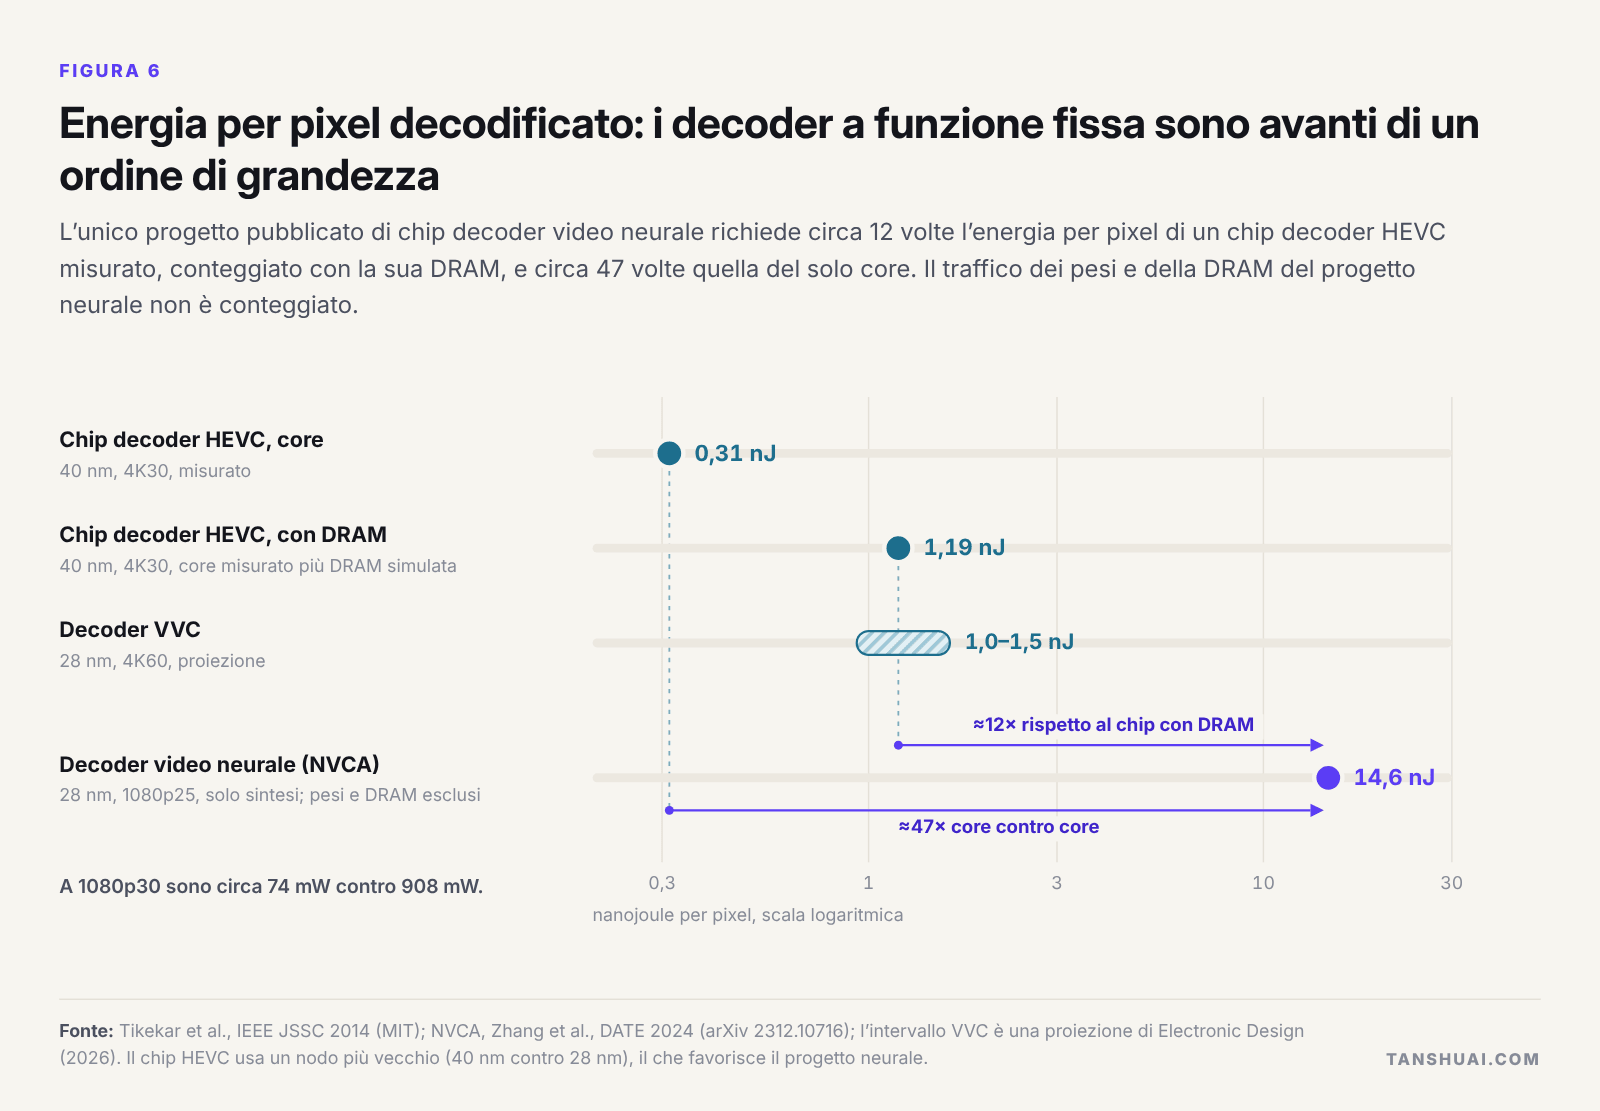 Figura 6. Energia per pixel decodificato: i decoder a funzione fissa sono avanti di un ordine di grandezza.
L’unico progetto pubblicato di chip decoder video neurale, NVCA, richiede 14,6 nJ per pixel; il chip decoder HEVC del MIT richiede 1,19 con la sua DRAM e 0,31 per il core. A 1080p30 significa all’incirca 900 mW contro 74 mW. DCVC-RT, il codec di ricerca veloce di Microsoft, richiede, secondo la mia somma sulla sua stessa tabella per modulo, circa 175 mila MAC per pixel decodificato, ovvero circa 22 TOPS a 1080p30: metà dei 40 TOPS che definiscono un PC con IA, per un solo flusso.
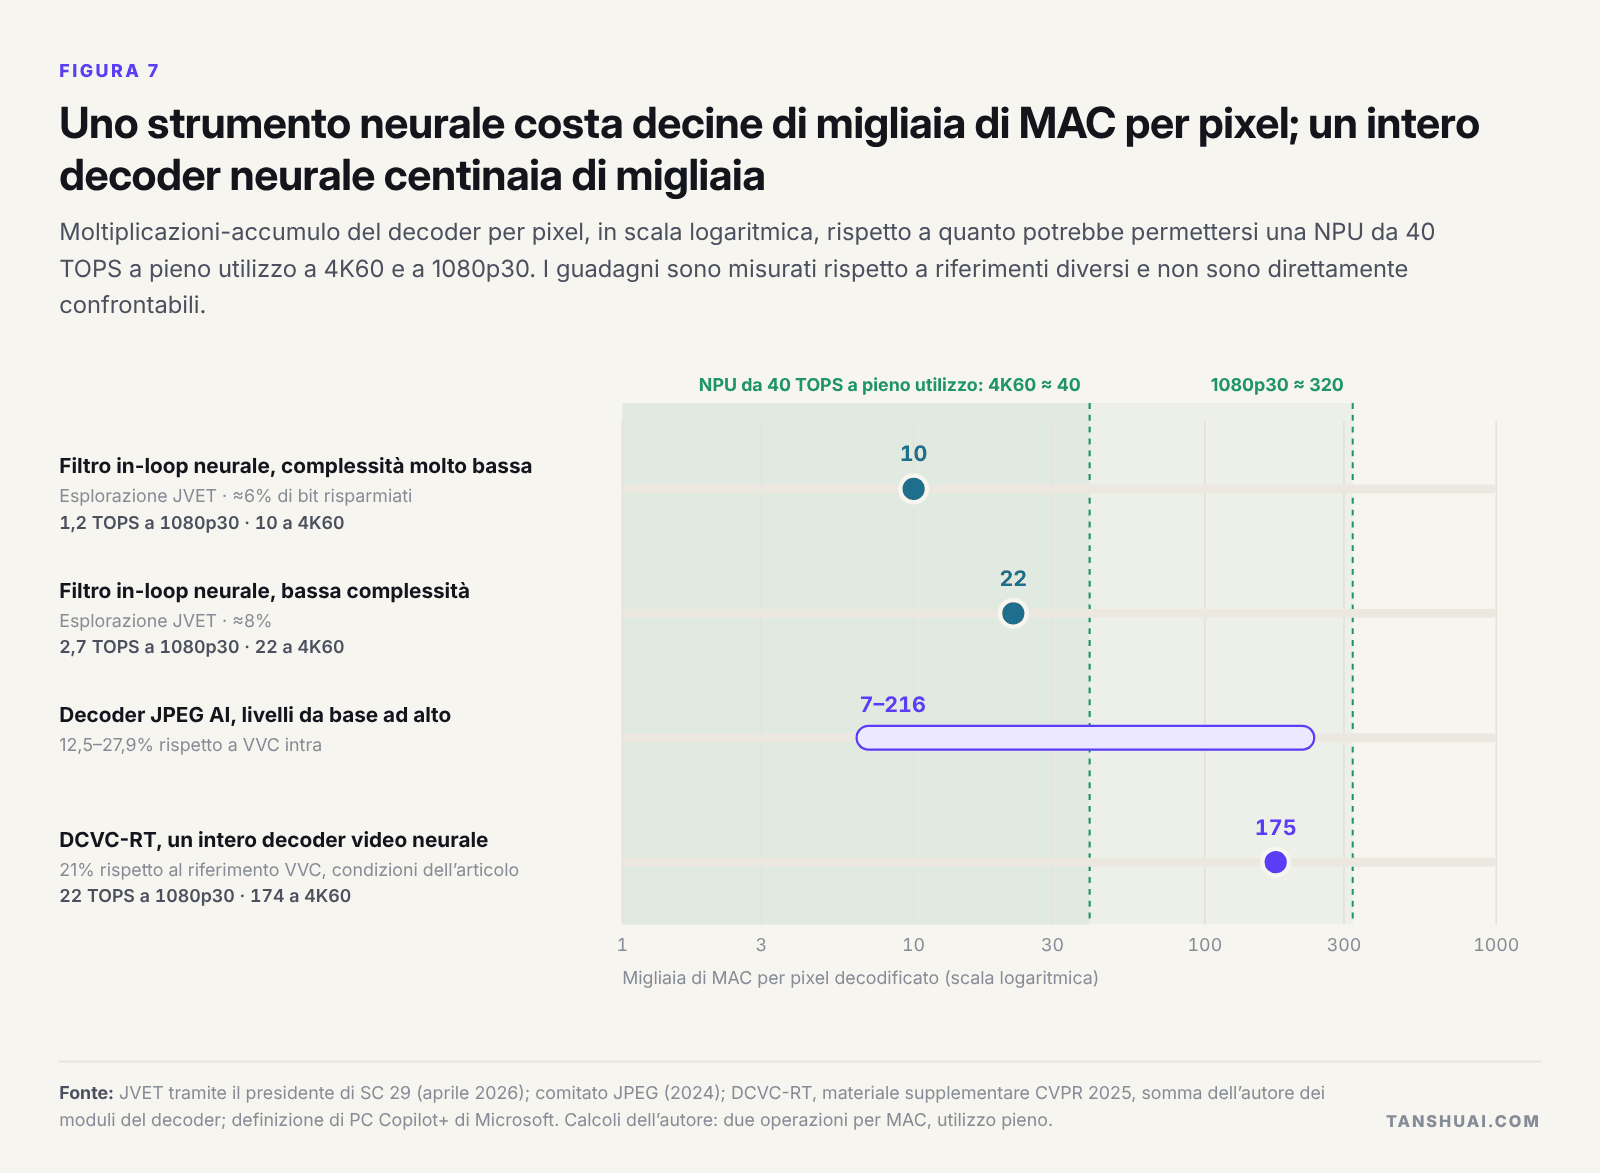 Figura 7. Uno strumento neurale costa decine di migliaia di MAC per pixel; un intero decoder neurale centinaia di migliaia.
Contano altri due costi. La memoria: nel chip del MIT circa tre quarti dell’energia del sistema vanno alla DRAM, e i decoder neurali portano grandi mappe di feature da un fotogramma all’altro. L’esattezza: la decodifica entropica fallisce se due dispositivi calcolano una probabilità in modo diverso, ed è per questo che ogni codec neurale serio usa ora l’aritmetica intera e che MLVC scambia compressione con una decodifica identica.
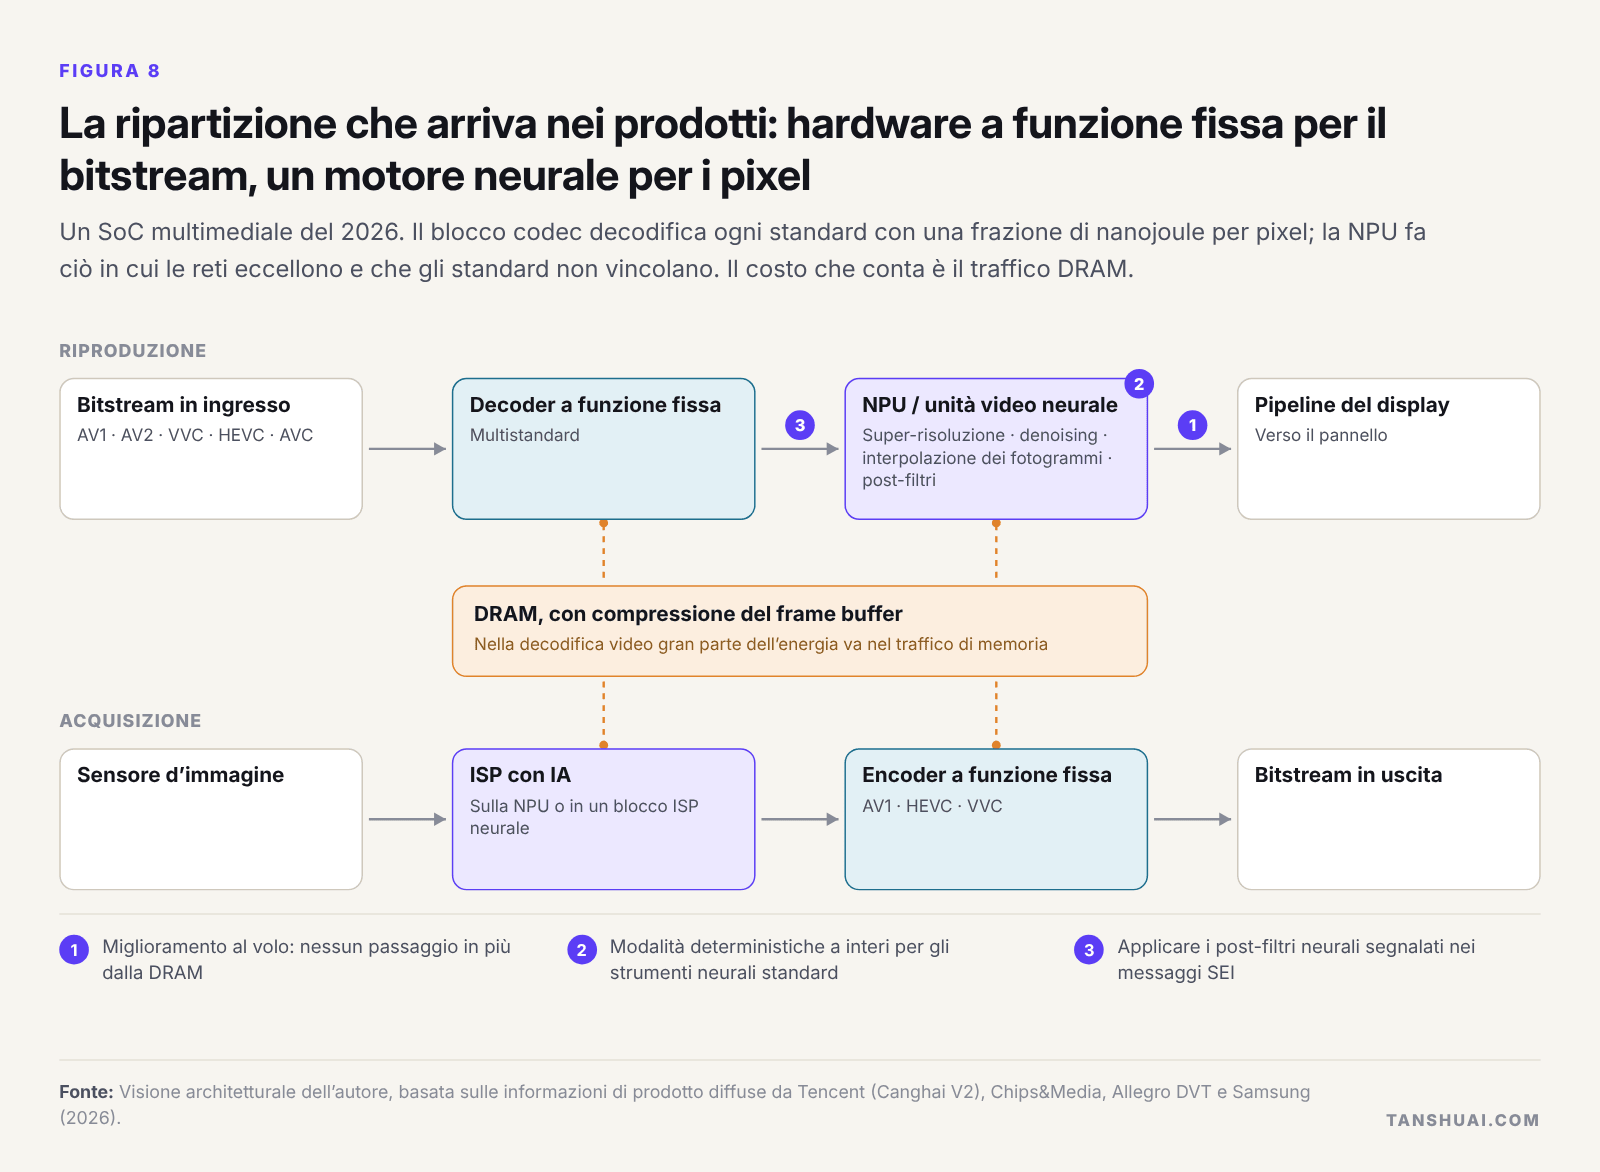 Figura 8. La ripartizione che arriva nei prodotti: hardware a funzione fissa per il bitstream, un motore neurale per i pixel.
Il silicio che si vende abbina le due cose. Tencent ha in uso più di 100.000 chip codec Canghai sviluppati internamente, e la seconda generazione aggiunge H.266 e la super-risoluzione sul chip; i fornitori di IP vendono blocchi codec e NPU video fianco a fianco. Se oggi stessi pianificando un SoC multimediale: decoder a funzione fissa per ogni standard da riprodurre, AV2 compreso; una NPU dimensionata per il miglioramento alla risoluzione del display, senza un passaggio in più attraverso la DRAM; modalità deterministiche a interi; e H.267 come avvio di progetto dopo il 2029.
Chi guadagna, e dove può inserirsi un’azienda
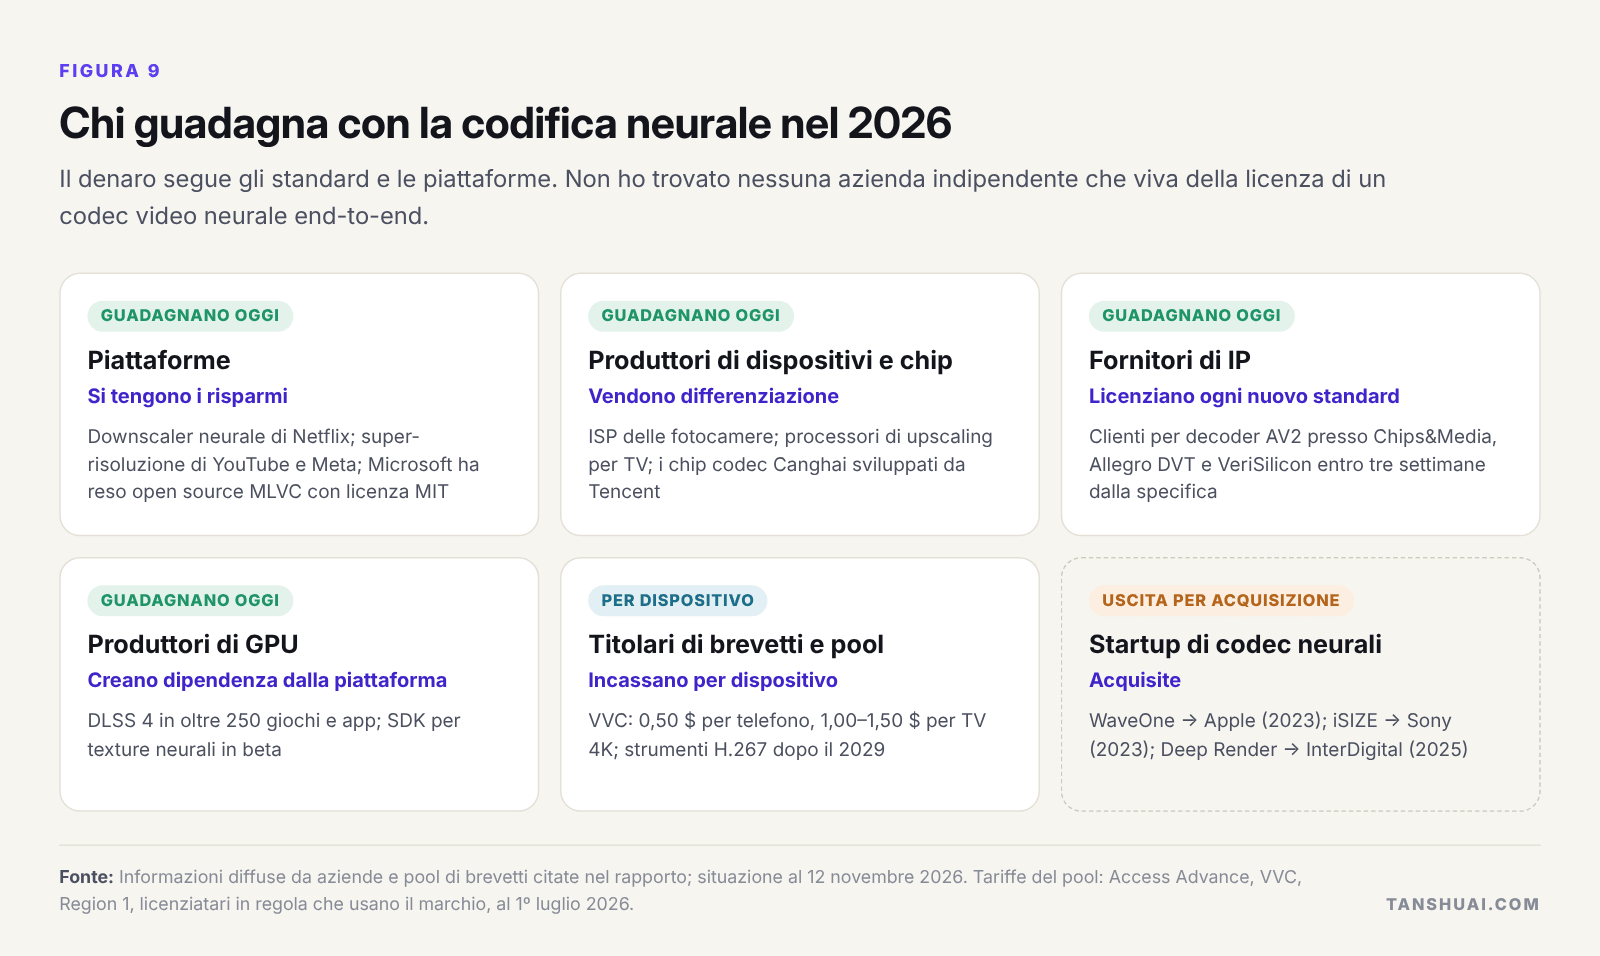 Figura 9. Il denaro segue gli standard e le piattaforme.
Le piattaforme si tengono i risparmi e a volte regalano il codice, come ha fatto Microsoft con MLVC. I fornitori di IP concedono in licenza decoder per ogni nuovo standard. I pool di brevetti incassano per dispositivo: per VVC, 0,50 dollari per telefono e 1,00–1,50 dollari per TV 4K negli Stati Uniti e negli altri mercati della Region 1. WaveOne è andata ad Apple, iSIZE a Sony e Deep Render a InterDigital. Non ho trovato nessuna azienda indipendente che viva della licenza di un codec video neurale end-to-end.
Per un’azienda, le opportunità aperte sono la pre-elaborazione neurale per i servizi video, il miglioramento lato display per i produttori di chip, i codec neurali a circuito chiuso per le videoconferenze e i collegamenti privati, il silicio codec più NPU, e gli strumenti di valutazione e di conformità di cui avrà bisogno chiunque porti strumenti neurali nei prodotti. Il lavoro di standardizzazione su H.267 richiede pazienza e una strategia di licenza.
Affermazioni di cui diffidare, e cosa osservare
Di ogni affermazione su un codec neurale vanno chieste quattro cose: il riferimento, la metrica, la risoluzione e il costo di decodifica. «88% di risparmio» è rispetto a H.264 a 360p; «85–96% di memoria video in meno» è una scena dimostrativa, contro il 30% nel gioco pubblicato; «JPEG AI è uno standard» non ha ancora alcun prodotto alle spalle.
Le date che contano: la valutazione di H.267 a gennaio 2027, i primi stream AV2 di YouTube all’inizio del 2027, il primo modello di test di H.267 nella seconda metà del 2027, se MLVC si diffonderà oltre Teams, il primo prodotto che usa JPEG AI di default, e i budget delle NPU in telefoni e PC. La versione 1 di H.267 alla fine del 2029 avvia il ciclo del silicio per gli strumenti neurali nella riproduzione di massa.
Scarica il rapporto completo e le slide
Il rapporto completo tratta ogni ambito più in dettaglio, insieme ai calcoli sul silicio, agli standard e ai brevetti, a una tabella che mette a confronto le affermazioni con le prove, e a tutte le fonti.
- La codifica neurale nel 2026: rapporto completo (PDF)
- La codifica neurale nel 2026: slide (PDF)
- Edizione inglese: rapporto completo · slide
Questa è una traduzione dell’edizione inglese, che prevale in caso di differenze.
Questioni aperte
Alcune questioni non hanno ancora una risposta pubblica, e sono quelle che trovo più interessanti sul piano tecnico: quanto può avvicinarsi un decoder neurale a un’aritmetica intera esatta al bit su NPU di produttori diversi prima di perdere il suo vantaggio di compressione; quanto costa la post-elaborazione neurale in traffico DRAM per pixel; a quale costo per pixel uno strumento neurale smette di ripagarsi in un decoder H.267; quali sistemi chiusi, oltre alle chiamate, possono adottare per primi i codec neurali end-to-end; e come misurare la fedeltà quando un decoder genera dettagli invece di ricostruirli.
Sono temi che possiamo esplorare insieme nei prossimi anni, attraverso lo scambio tecnico e la collaborazione tecnica: i@tanshuai.com.
L’autore
Tan Shuai è un tecnologo e fondatore con più di vent’anni di lavoro tra chip, hardware e software di sistema, e 20 brevetti concessi. Ha alle spalle molti anni di R&S e di gestione nel settore dei chip fabless, tra cui la progettazione full-custom di datapath ASIC e progetti di chip multimediali per fotocamere come acceleratori di codec video. Il suo lavoro lo ha portato nella Silicon Valley, a New York, a Chicago, a Taiwan, nella Greater Bay Area (Shenzhen e Hong Kong), in Vietnam e in Malesia. Oggi lavora come ricercatore e sviluppatore nel campo dell’IA.
Per discussioni tecniche: i@tanshuai.com.