
Las redes neuronales ya dan forma a casi todos los vídeos que vemos, pero en los dos extremos de un códec estándar, no en su lugar. Aquí explico dónde se despliega la codificación neuronal en 2026, cuánto cuesta en silicio y quién cobra, con el informe completo y las diapositivas.
Resumen
La codificación neuronal ya está generalizada en 2026, pero funciona en torno a los códecs estándar en lugar de sustituirlos. Las redes moldean la imagen antes de codificarla, en las cámaras de los móviles y en la cadena de codificación de Netflix, y la reparan después de decodificarla, en la función Super Resolution de YouTube, en Meta y en los procesadores de los televisores; el flujo de bits intermedio sigue siendo AV1, HEVC, AVC o VVC, decodificado por hardware de función fija. Los códecs neuronales de extremo a extremo solo se despliegan en circuitos cerrados donde una misma empresa controla ambos extremos: MLVC de Microsoft en las llamadas de Teams, los tokenizadores de todos los modelos de voz y de vídeo, las texturas neuronales de un juego. La reproducción masiva de flujos de bits neuronales espera a H.267, previsto para finales de 2029, y a un ciclo de silicio posterior. La razón está en el chip: el único diseño publicado de decodificador de vídeo neuronal necesita unas 12 veces la energía por píxel de un decodificador HEVC medido, y un códec rápido de investigación necesita unos 22 TOPS para 1080p30. El dinero sigue a los estándares y a las plataformas; las startups de códecs neuronales más conocidas fueron adquiridas.
Por qué lo estudié
Cada pocos meses alguien me dice que los códecs de IA están a punto de sustituir a H.264, HEVC y AV1. Casi todo lo que leo al respecto procede de artículos de investigación, donde están los récords de compresión, o de los proveedores. Ni unos ni otros dicen gran cosa sobre lo que de verdad se despliega, para quién y a qué coste.
Tengo detrás muchos años de I+D y de gestión de chips fabless, incluido el diseño full-custom de rutas de datos de ASIC y proyectos de chips multimedia para cámaras, como aceleradores de códecs de vídeo, así que lo analicé como revisaría un chip: energía por píxel, tráfico de memoria, qué permite un estándar fijar en silicio y quién paga. Leí documentos de estándares e informes de reuniones de JVET, MPEG, JPEG, AOMedia y el IETF, blogs de ingeniería de empresas, artículos sobre chips, tarifas de consorcios de patentes, textos de control de exportaciones y prensa. Todas las cifras que siguen son a 12 de noviembre de 2026, y los importes están en dólares estadounidenses. El informe completo, con todas las fuentes, está al final.
Resultados de un vistazo
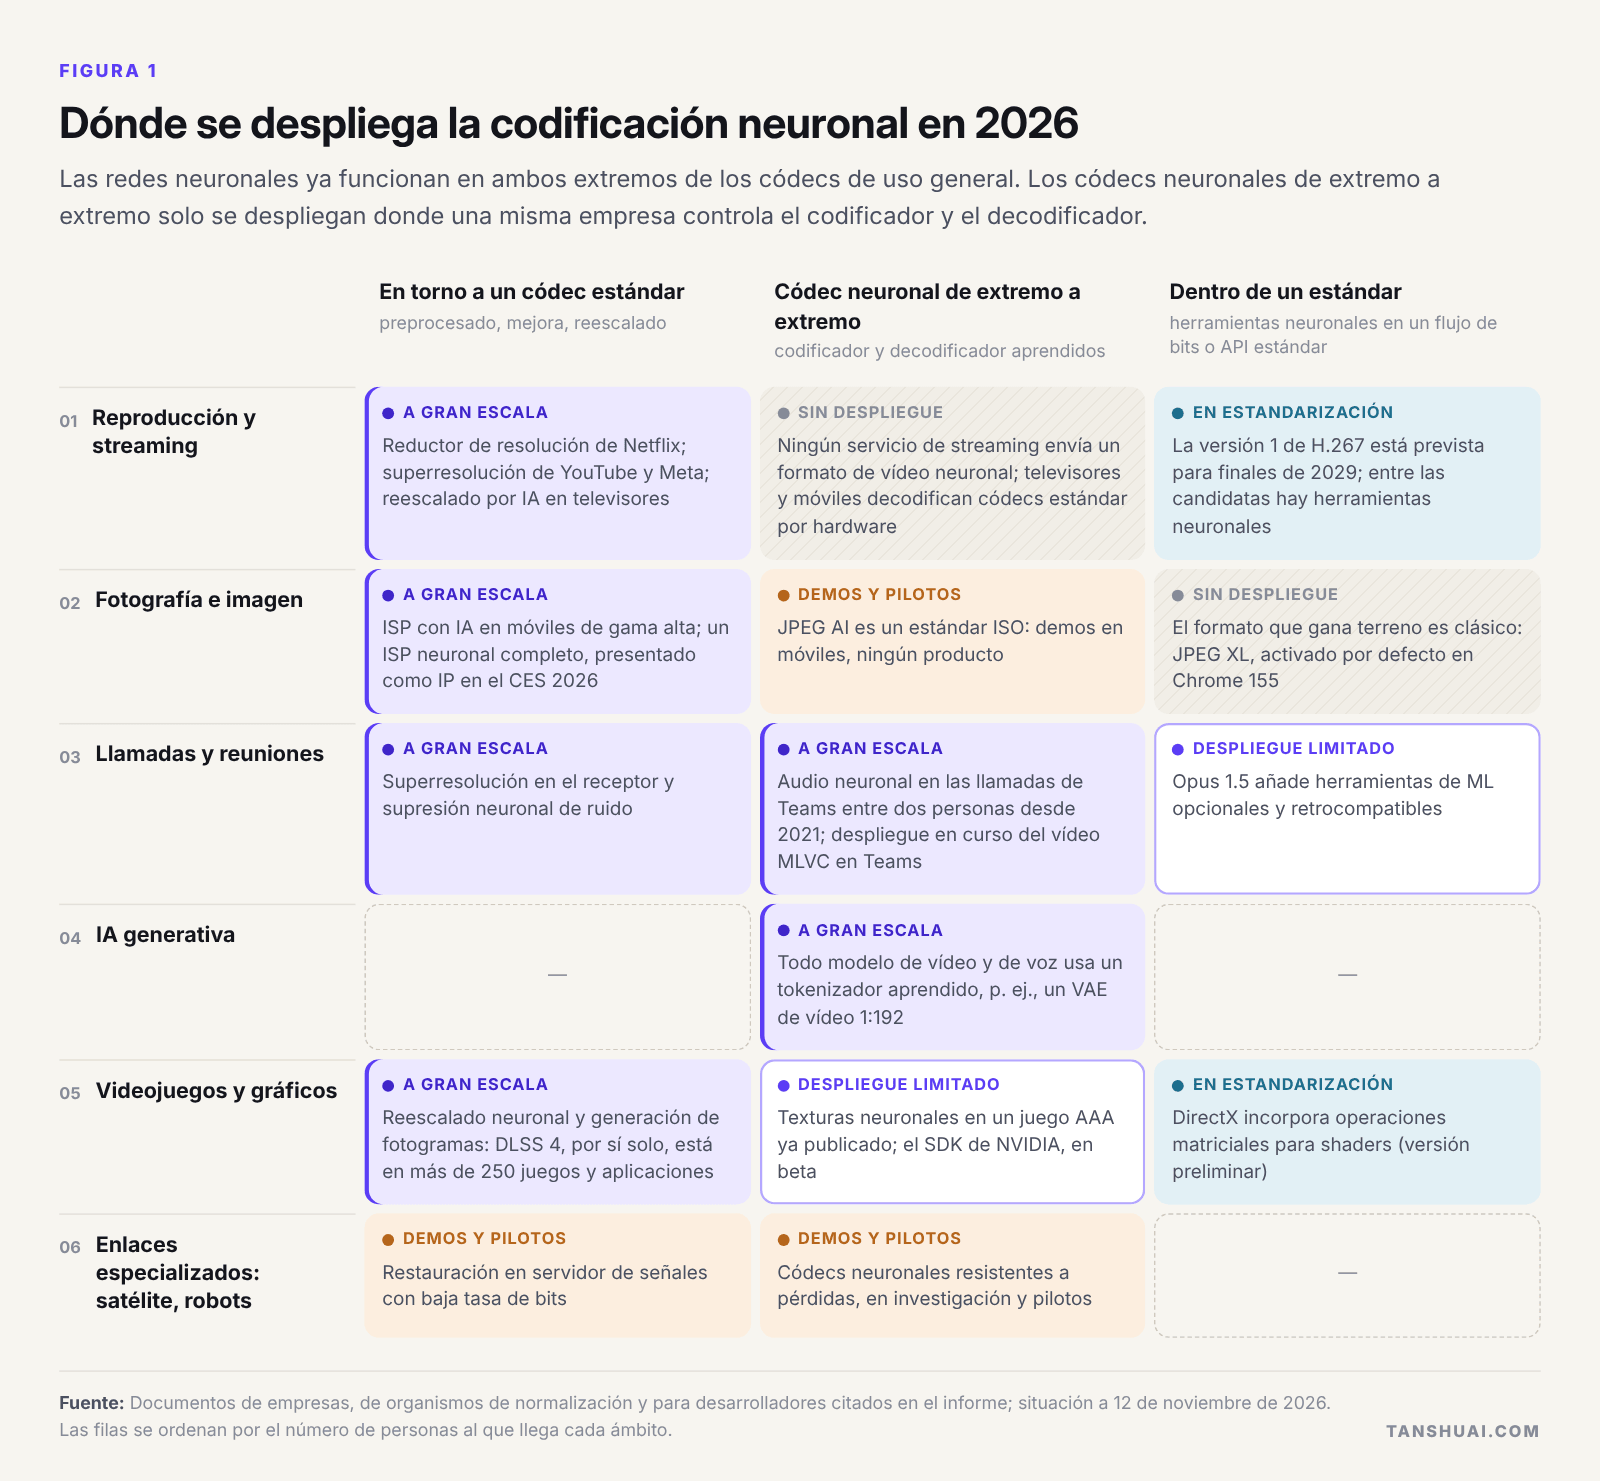 Figura 1. Dónde se despliega la codificación neuronal en 2026. Las filas se ordenan por el número de personas al que llega cada ámbito.
| Pregunta | Respuesta breve |
|---|---|
| ¿Dónde se despliega a gran escala la codificación neuronal? | En torno al códec: ISP de cámara, reducción de resolución al codificar, superresolución al reproducir. De extremo a extremo solo en circuitos cerrados: llamadas, recursos de juegos, tokenizadores de IA generativa |
| ¿Sustituirán los códecs neuronales a AV1, HEVC y VVC en la reproducción? | No antes de H.267 (versión 1 a finales de 2029) y de un ciclo de dispositivos posterior; uso generalizado a mediados de la década de 2030, según mi estimación |
| ¿Cuánto cuesta en silicio? | Unas 12 veces la energía por píxel de un decodificador HEVC por hardware, más el tráfico de memoria y la exigencia de una decodificación exacta bit a bit |
| ¿Quién cobra? | Las plataformas se quedan el ahorro; los proveedores de IP y los consorcios de patentes cobran por diseño y por dispositivo; las startups de códecs neuronales fueron adquiridas |
| ¿Dónde puede competir una empresa? | Preprocesado y posprocesado neuronal, productos de circuito cerrado, silicio de códec más NPU, y el trabajo de evaluación y estandarización que hay entre medias |
Tres vías de entrada
«Codificación neuronal» abarca tres cosas distintas, y la mayoría de las discusiones sobre el tema nacen de confundirlas. Una red puede trabajar en torno a un códec estándar, procesando píxeles antes de codificar o después de decodificar mientras el flujo de bits sigue siendo estándar. Puede estar dentro de un estándar, como una herramienta que todo decodificador debe ejecutar, lo que obliga a especificarla con exactitud. O puede sustituir al códec de extremo a extremo, con un codificador y un decodificador aprendidos que solo funcionan en pareja.
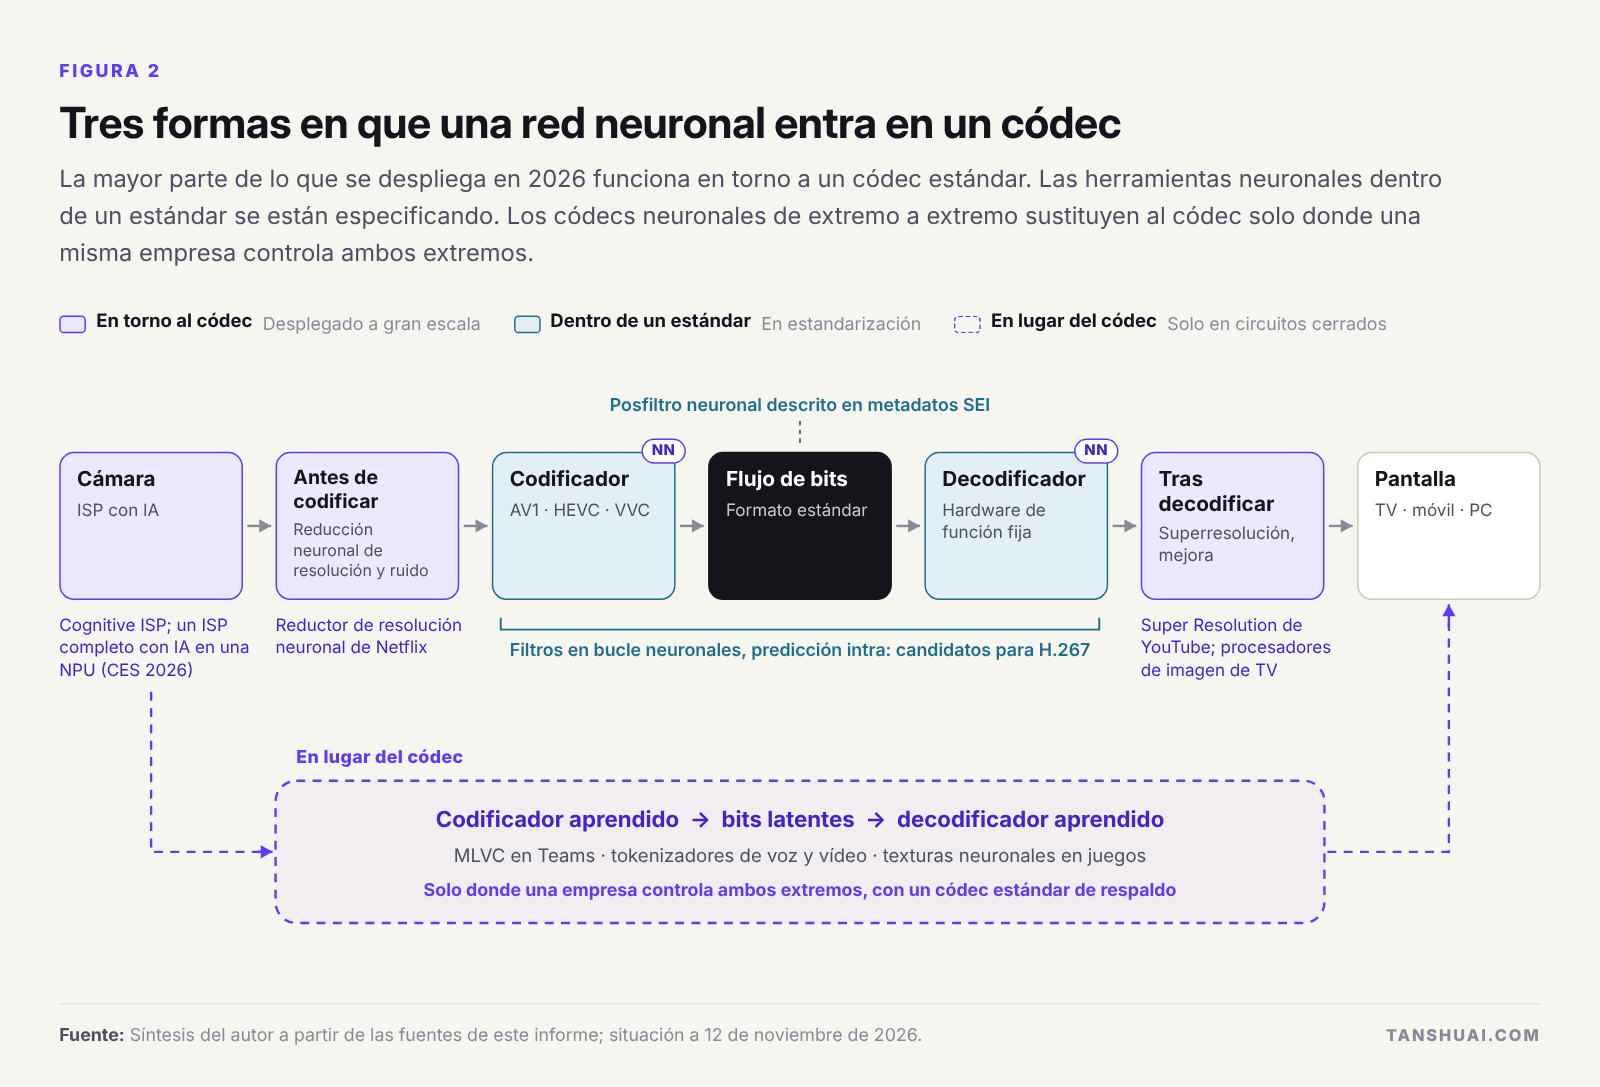 Figura 2. Tres formas en que una red neuronal entra en un códec. La mayor parte de lo que se despliega en 2026 es de la primera.
La primera no necesita permiso de nadie. La segunda necesita un estándar. La tercera necesita controlar ambos extremos. Ese es el orden en que llegan a la gente.
Reproducción y streaming: neuronal en ambos extremos, estándar en el medio
Los grandes servicios han completado una transición de códec y empiezan la siguiente, y ninguna incluye un decodificador neuronal. Netflix informó en diciembre de 2025 de que AV1 transportaba alrededor del 30 % de su visionado; YouTube afirma que más del 90 % de su catálogo, ponderado por tiempo de visualización, está disponible en AV1. AV2 se terminó el 28 de mayo de 2026 con una compresión alrededor de un 30 % mejor que la de AV1, y en menos de tres semanas Chips&Media, Allegro DVT y VeriSilicon ya habían anunciado clientes de decodificadores AV2. La TV 3.0 de Brasil empezó a emitir comercialmente en VVC en junio de 2026.
La parte neuronal está en los dos extremos. Desde 2022 Netflix usa una pequeña red neuronal, en lugar de un filtro convencional, para reducir la resolución de sus másteres; no exige cambios en ningún dispositivo y, en las pruebas de Netflix, la prefirió alrededor del 77 % de los espectadores. YouTube reescala con aprendizaje automático, en los televisores, los vídeos subidos por debajo de 1080p; Meta aplica superresolución en sus servidores y en los móviles, y el procesador insignia de Samsung para televisores anuncia 768 redes de reescalado.
Lo que no existe es un flujo de bits neuronal en las pantallas del gran público, y el motivo es el tiempo. Un formato de reproducción tiene que decodificarse en todos los dispositivos que vayan a reproducirlo. AV1 tardó casi ocho años desde la especificación terminada hasta el 30 % del visionado de Netflix.
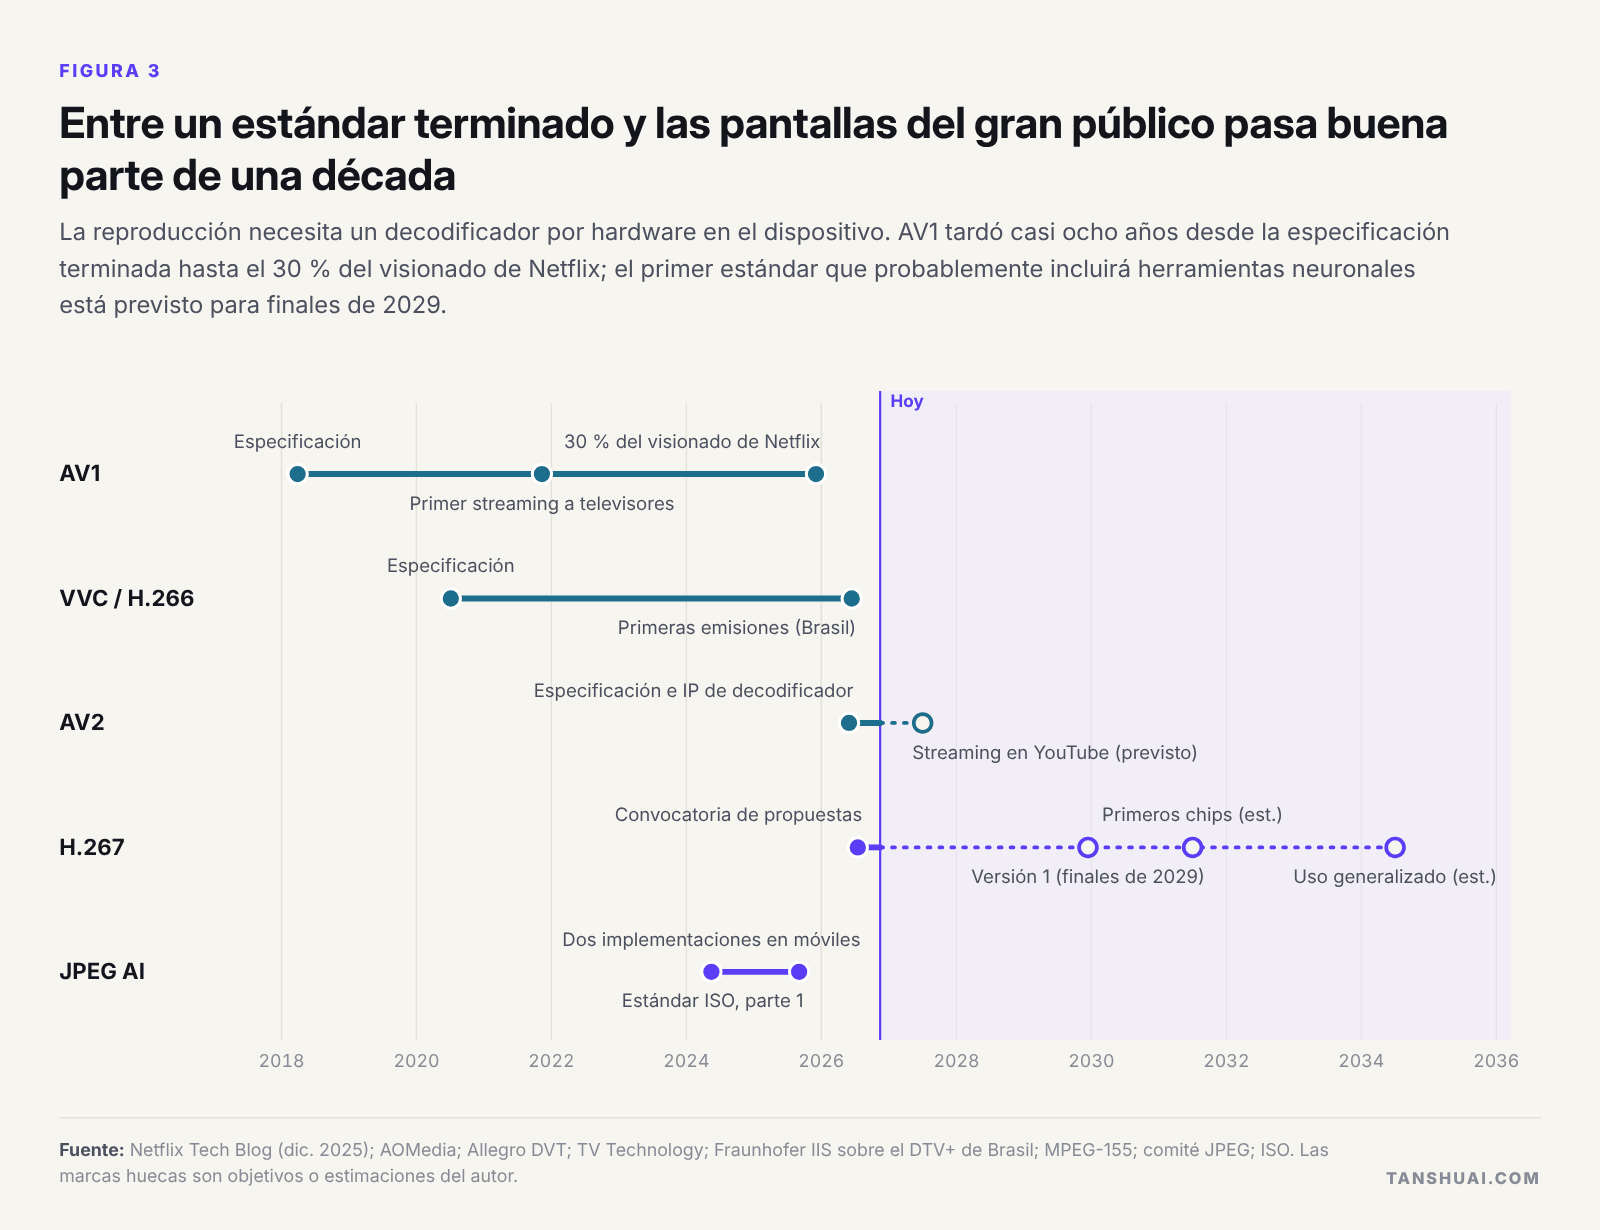 Figura 3. Entre un estándar terminado y las pantallas del gran público pasa buena parte de una década.
El estándar que podría llevar herramientas neuronales a todas las pantallas es H.267, el nombre provisional del sucesor de VVC. JVET publicó su convocatoria de propuestas en julio de 2026; las respuestas se evalúan en enero de 2027 y la primera versión está prevista para finales de 2029. La vía clásica ya ahorra alrededor de un 28 % frente a VVC, mientras que los filtros en bucle neuronales de JVET ahorran un 6–14 % con un coste de decodificación de 10.000 MAC por píxel o más. Espero un núcleo clásico con algunas herramientas neuronales allí donde los bits ahorrados justifiquen el coste.
Fotografía: neuronal dentro de la cámara, clásica en la web
Toda foto de un móvil insignia reciente ha pasado por redes neuronales antes de guardarse. El Cognitive ISP de Qualcomm aplica segmentación semántica en tiempo real desde 2023, y en el CES 2026 Chips&Media y Visionary.ai mostraron un ISP completo que funciona íntegramente en una NPU. Después, el resultado se guarda como JPEG o HEIF.
JPEG AI, el primer estándar de imagen aprendido, se publicó en 2025, con ganancias del 12,5–27,9 % frente a la codificación intra de VVC y costes de decodificación de entre 7000 y 216.000 MAC por píxel. No encontré ninguna cámara, aplicación de galería ni navegador que lo use por defecto. El formato que la web adoptó en 2026 es clásico: Chrome 155 activó JPEG XL el 6 de octubre, con un decodificador rápido y con seguridad de memoria que funciona en cualquier CPU. La codificación neuronal gana dentro de la cadena de una sola empresa; los formatos que deben abrirse en todas partes siguen siendo clásicos.
Llamadas: donde se despliegan los códecs neuronales de extremo a extremo
Las llamadas son un circuito cerrado: ambos extremos ejecutan la misma aplicación y pueden recurrir a un códec estándar en mitad de la llamada. Por eso los primeros códecs neuronales de extremo a extremo a gran escala están ahí. Satin, el códec de voz con IA de Microsoft, funciona en todas las llamadas de Teams y Skype entre dos personas desde 2021. En julio de 2026 Microsoft liberó como código abierto MLVC, un códec de vídeo neuronal que ya se está desplegando en las llamadas entre pares de Teams.
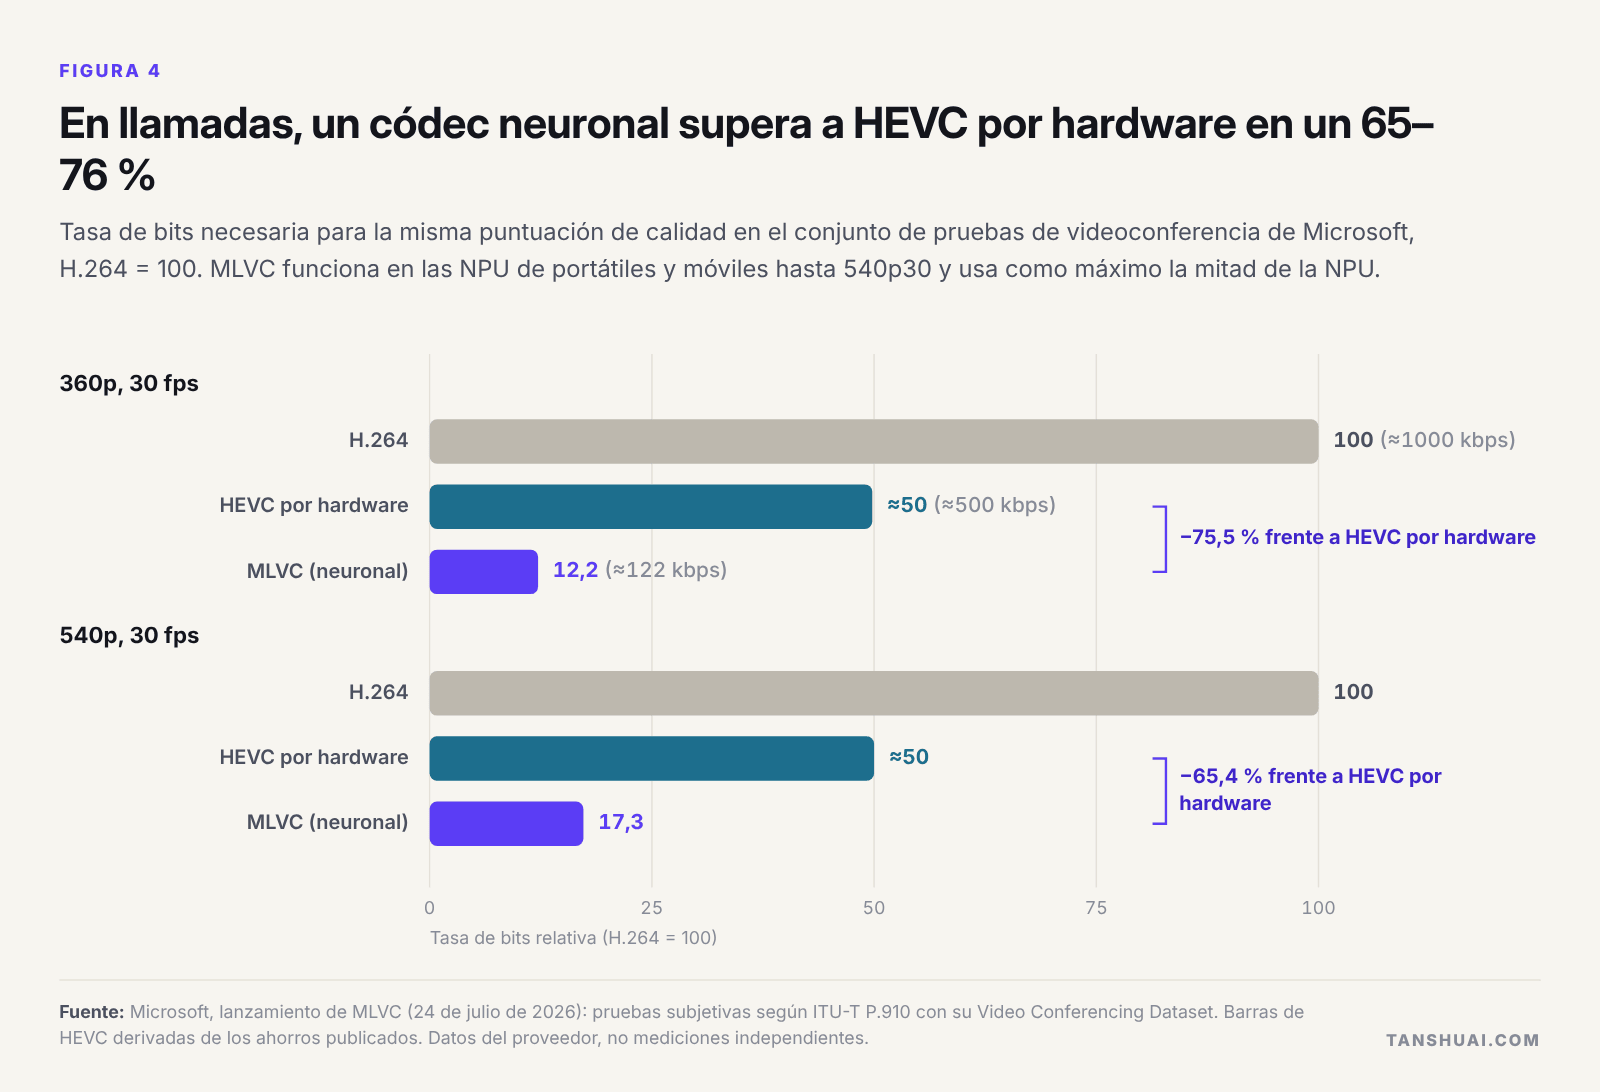 Figura 4. En llamadas, un códec neuronal supera a HEVC por hardware en un 65–76 %, con el propio conjunto de pruebas de Microsoft.
El 88 % del titular es frente a H.264; frente al HEVC por hardware que ya llevan esos mismos portátiles es un 65–76 %, que sigue siendo mucho. MLVC funciona a 540p y 360p usando como máximo la mitad de la NPU, y renunció a parte de la compresión para decodificar de forma idéntica en hardware que no es de Microsoft.
No todos eligieron este camino. Opus añadió aprendizaje profundo en 2024 como extras opcionales y retrocompatibles. Meta creó MLow, un códec de voz clásico, porque más del 20 % de sus llamadas se hacen en móviles ARMv7 antiguos y decenas de millones de llamadas diarias de WhatsApp, en móviles de más de diez años. Los códecs neuronales se despliegan primero donde los dispositivos son nuevos y un solo proveedor controla ambos extremos.
IA generativa: el mayor despliegue que nadie llama códec
Todo modelo de voz y de vídeo funciona sobre un códec aprendido. Los modelos de voz leen y escriben los tokens de códecs de audio neuronales como Mimi, de Kyutai, a 12,5 tramas por segundo y 1,1 kbps. Los generadores de vídeo trabajan en el espacio latente de autocodificadores de vídeo como el de LTX-Video, que comprime 1:192. Ninguno de ellos es un formato que decodifique nadie más, pero demuestran que la compresión aprendida funciona a escala cuando una misma empresa es dueña del codificador, el decodificador y el hardware. Para quien sirve vídeo generativo, la eficiencia del tokenizador es una partida de costes directa.
Videojuegos: la reconstrucción neuronal está generalizada, los recursos neuronales empiezan
DLSS de NVIDIA renderiza menos píxeles y fotogramas y deja que una red reconstruya el resto. La compresión neuronal de texturas llegó a Assassin's Creed Mirage, aplicada solo a algunos recursos por su coste en tiempo de ejecución.
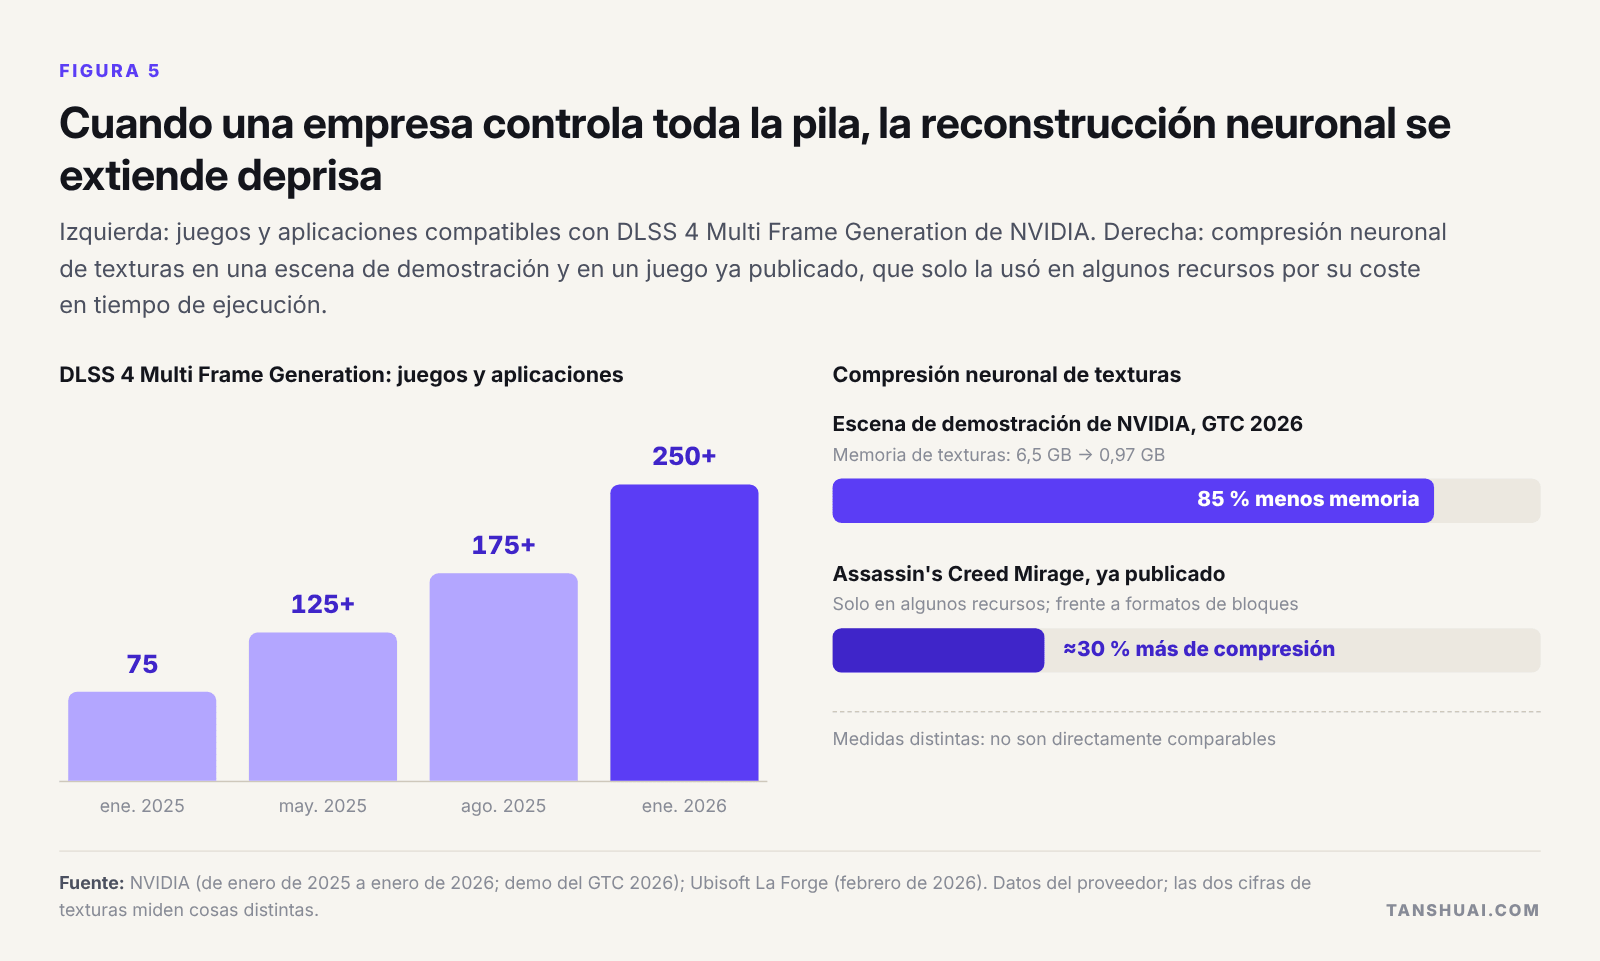 Figura 5. Cuando una empresa controla toda la pila, la reconstrucción neuronal se extiende deprisa.
Los enlaces de satélites, drones y robots son lo que mejor encaja técnicamente con los códecs neuronales de extremo a extremo, pero son un mercado pequeño y cada vez más sometido a controles de exportación por ambas partes: las normas chinas de exportación de drones vigentes desde el 18 de noviembre de 2026 llegan a citar la compresión semántica de imagen como umbral.
La visión desde el silicio
Aquí es donde más pesa mi propia trayectoria. Un equipo de chips se hace cuatro preguntas sobre cualquier códec nuevo: julios por píxel, tráfico de DRAM por píxel, puertas lógicas y si todos los decodificadores del mundo calculan exactamente los mismos bits. En las cuatro, un decodificador neuronal está en 2026 donde estaba HEVC por hardware antes de sus primeros chips.
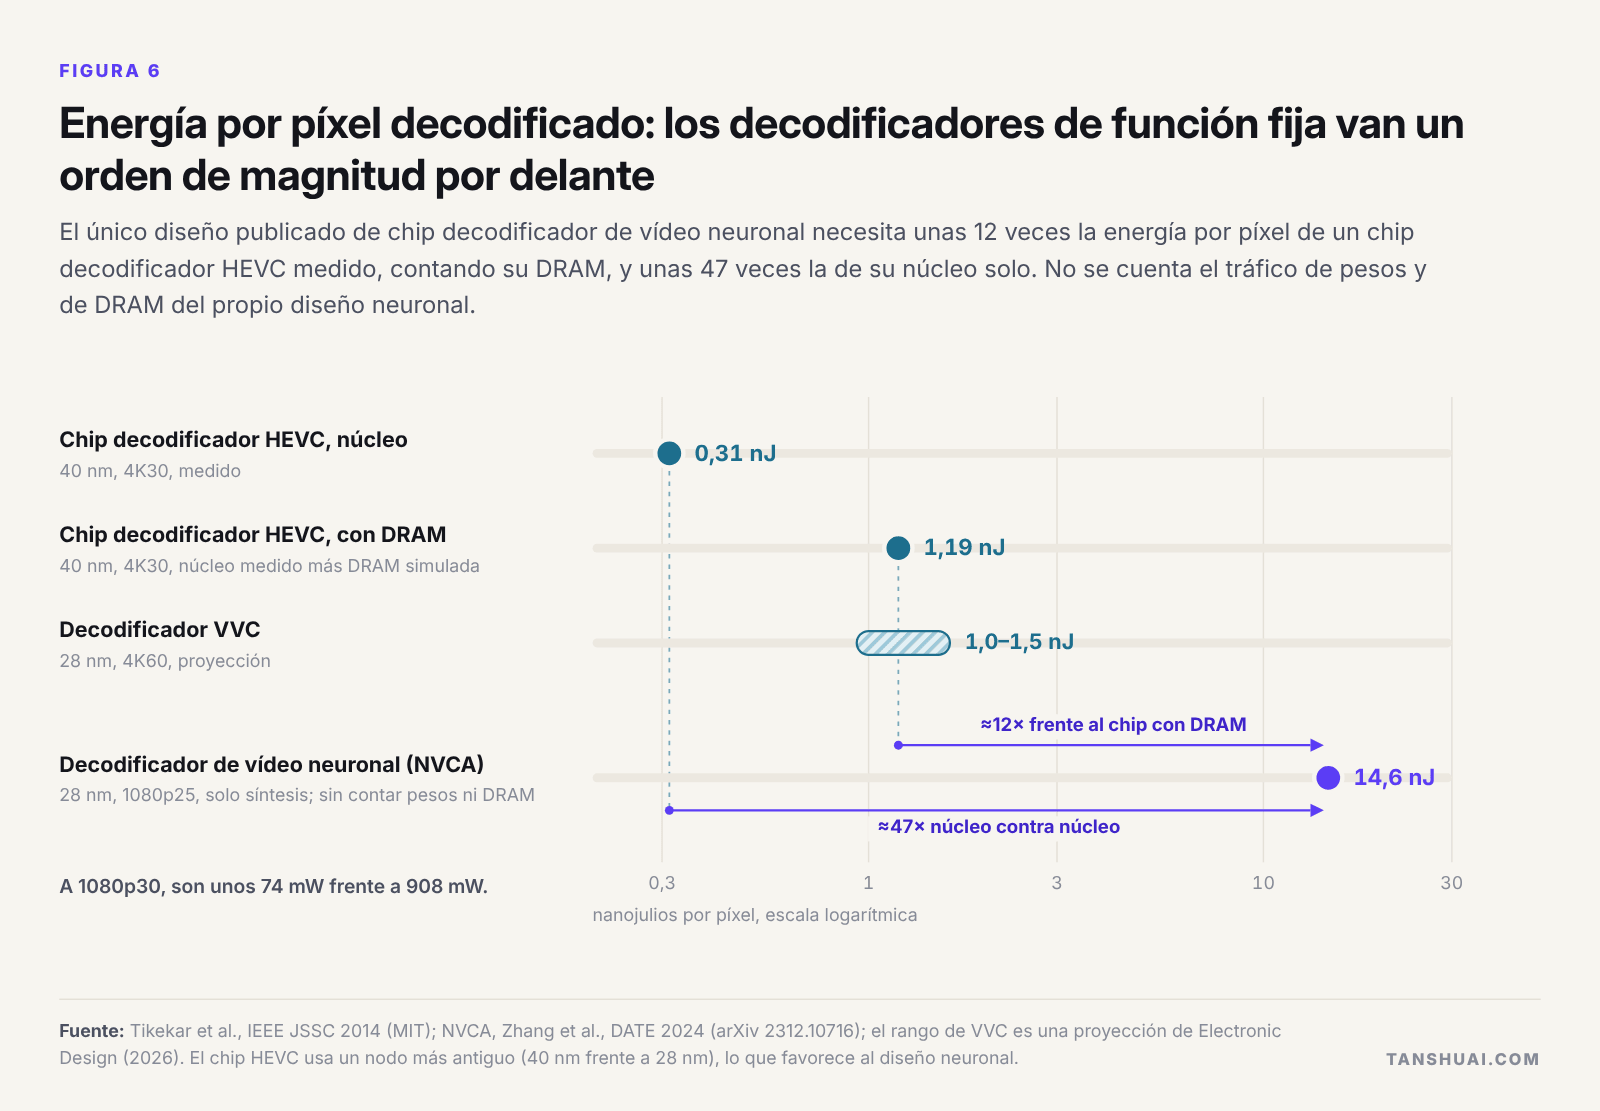 Figura 6. Energía por píxel decodificado: los decodificadores de función fija van un orden de magnitud por delante.
El único diseño publicado de chip decodificador de vídeo neuronal, NVCA, necesita 14,6 nJ por píxel; el chip decodificador HEVC del MIT necesita 1,19 con su DRAM y 0,31 en el núcleo. A 1080p30, eso son unos 900 mW frente a 74 mW. DCVC-RT, el códec rápido de investigación de Microsoft, necesita, según mi suma de su propia tabla por módulos, unos 175.000 MAC por píxel decodificado, o unos 22 TOPS a 1080p30: la mitad de los 40 TOPS que definen un PC con IA, para un solo flujo.
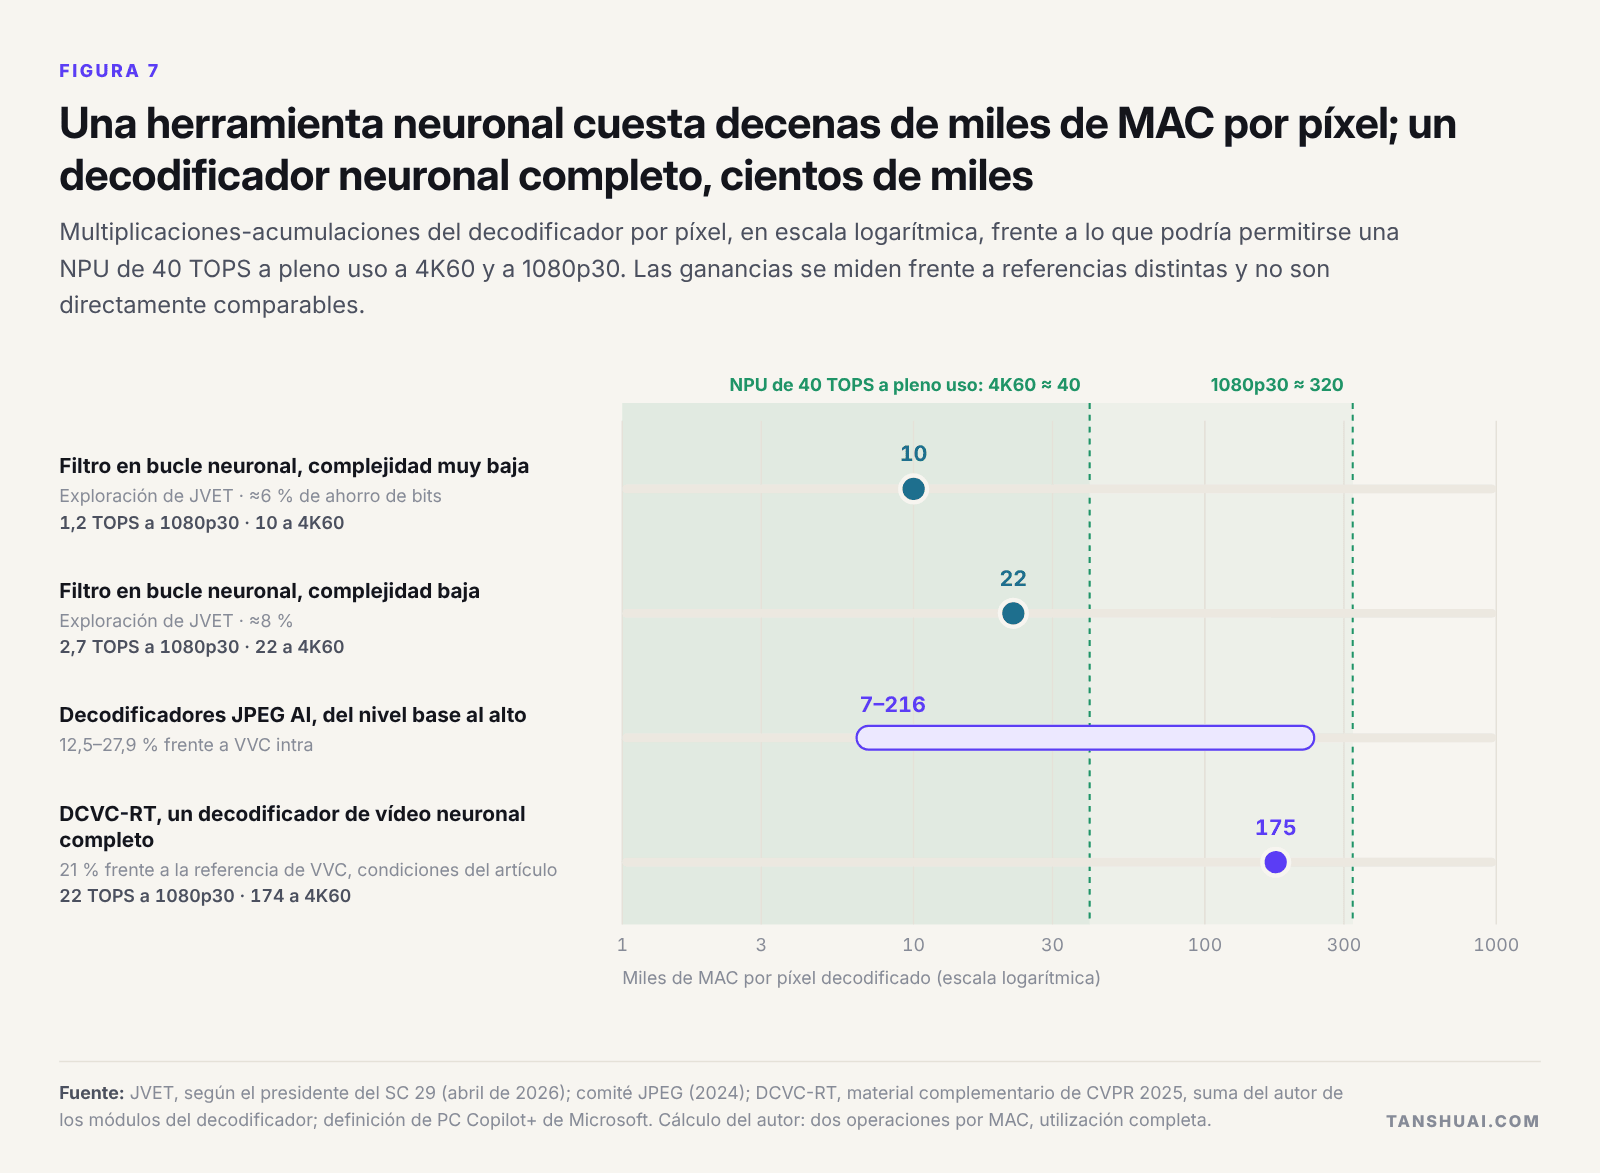 Figura 7. Una herramienta neuronal cuesta decenas de miles de MAC por píxel; un decodificador neuronal completo, cientos de miles.
Importan otros dos costes. La memoria: en el chip del MIT, alrededor de tres cuartas partes de la energía del sistema se van en la DRAM, y los decodificadores neuronales arrastran grandes mapas de características entre fotogramas. La exactitud: la decodificación entrópica falla si dos dispositivos calculan una probabilidad de forma distinta, y por eso todo códec neuronal serio usa hoy aritmética entera y MLVC sacrifica compresión a cambio de una decodificación idéntica.
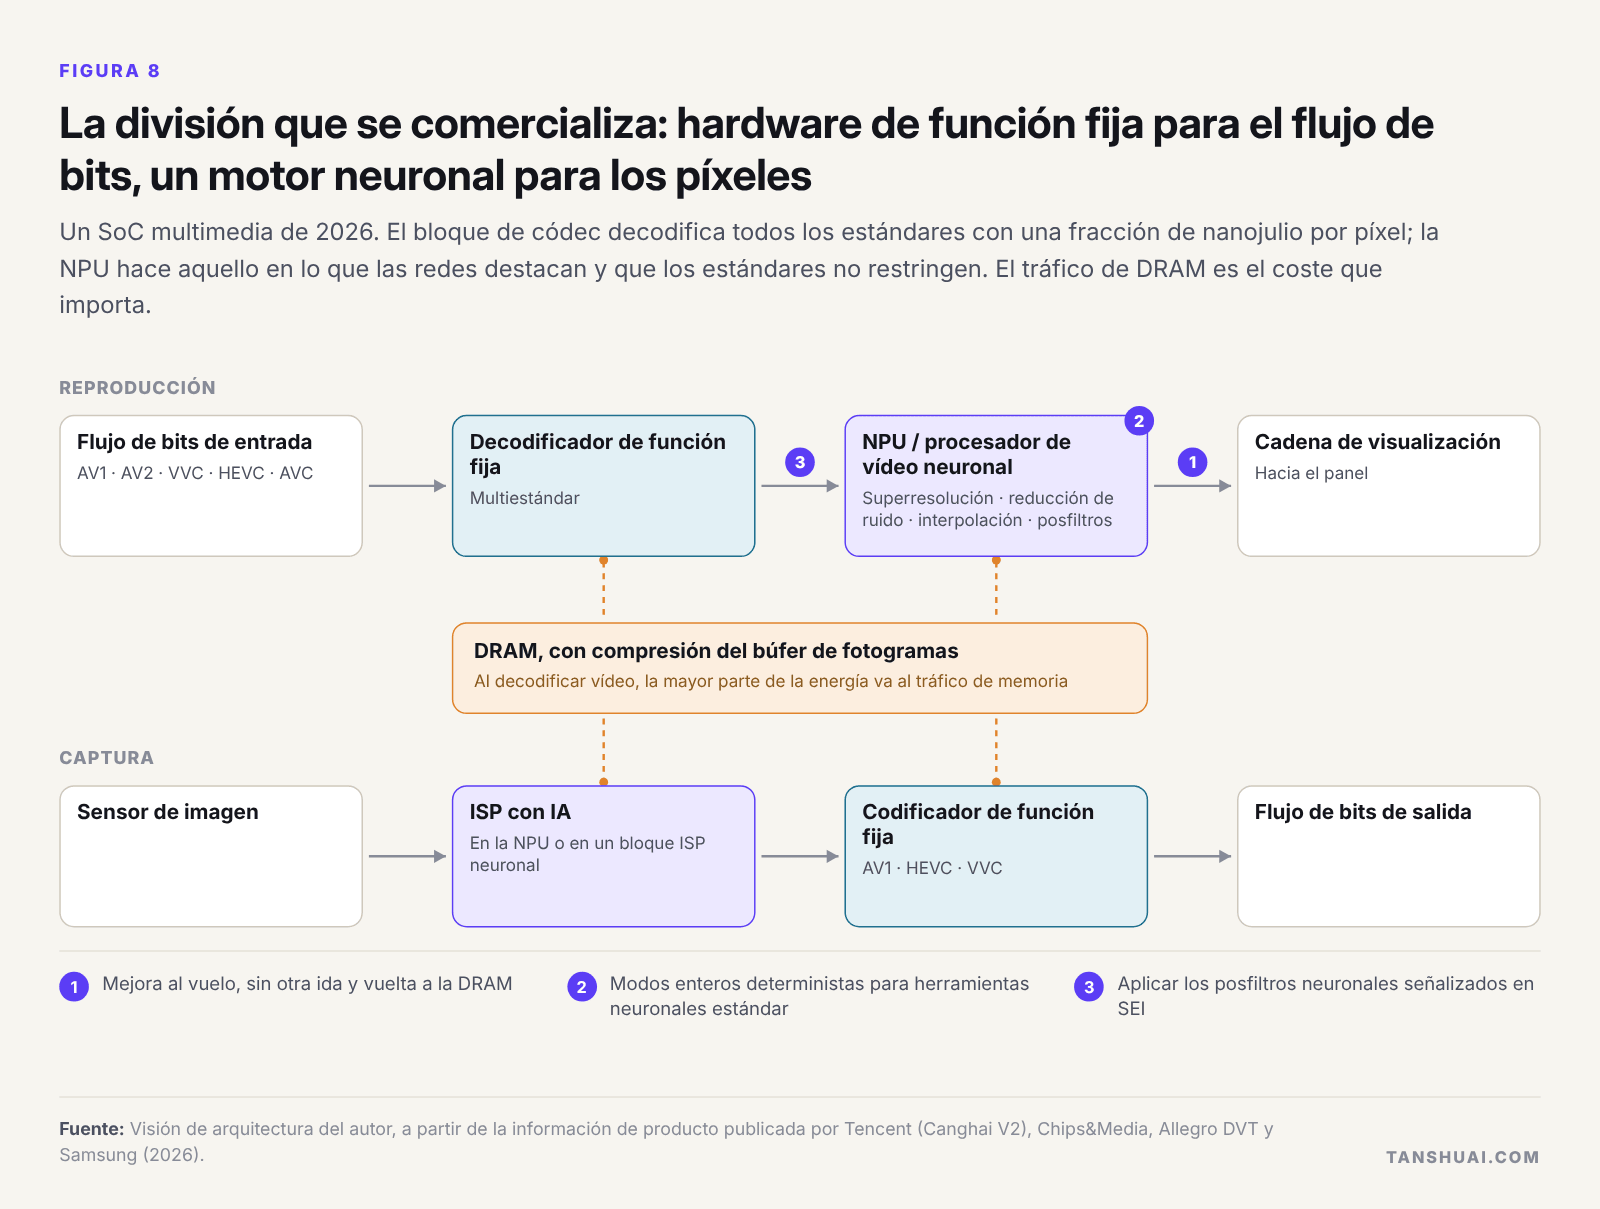 Figura 8. La división que se comercializa: hardware de función fija para el flujo de bits, un motor neuronal para los píxeles.
El silicio que se vende combina ambos. Tencent tiene desplegados más de 100.000 chips de códec Canghai de diseño propio, y la segunda generación añade H.266 y superresolución en el chip; los proveedores de IP venden bloques de códec y NPU de vídeo en paralelo. Si hoy planificara un SoC multimedia: decodificadores de función fija para cada estándar que haya que reproducir, incluido AV2; una NPU dimensionada para la mejora a la resolución de pantalla, sin otro paso por la DRAM; modos enteros deterministas; y H.267 como inicio de diseño después de 2029.
Quién cobra y dónde puede competir una empresa
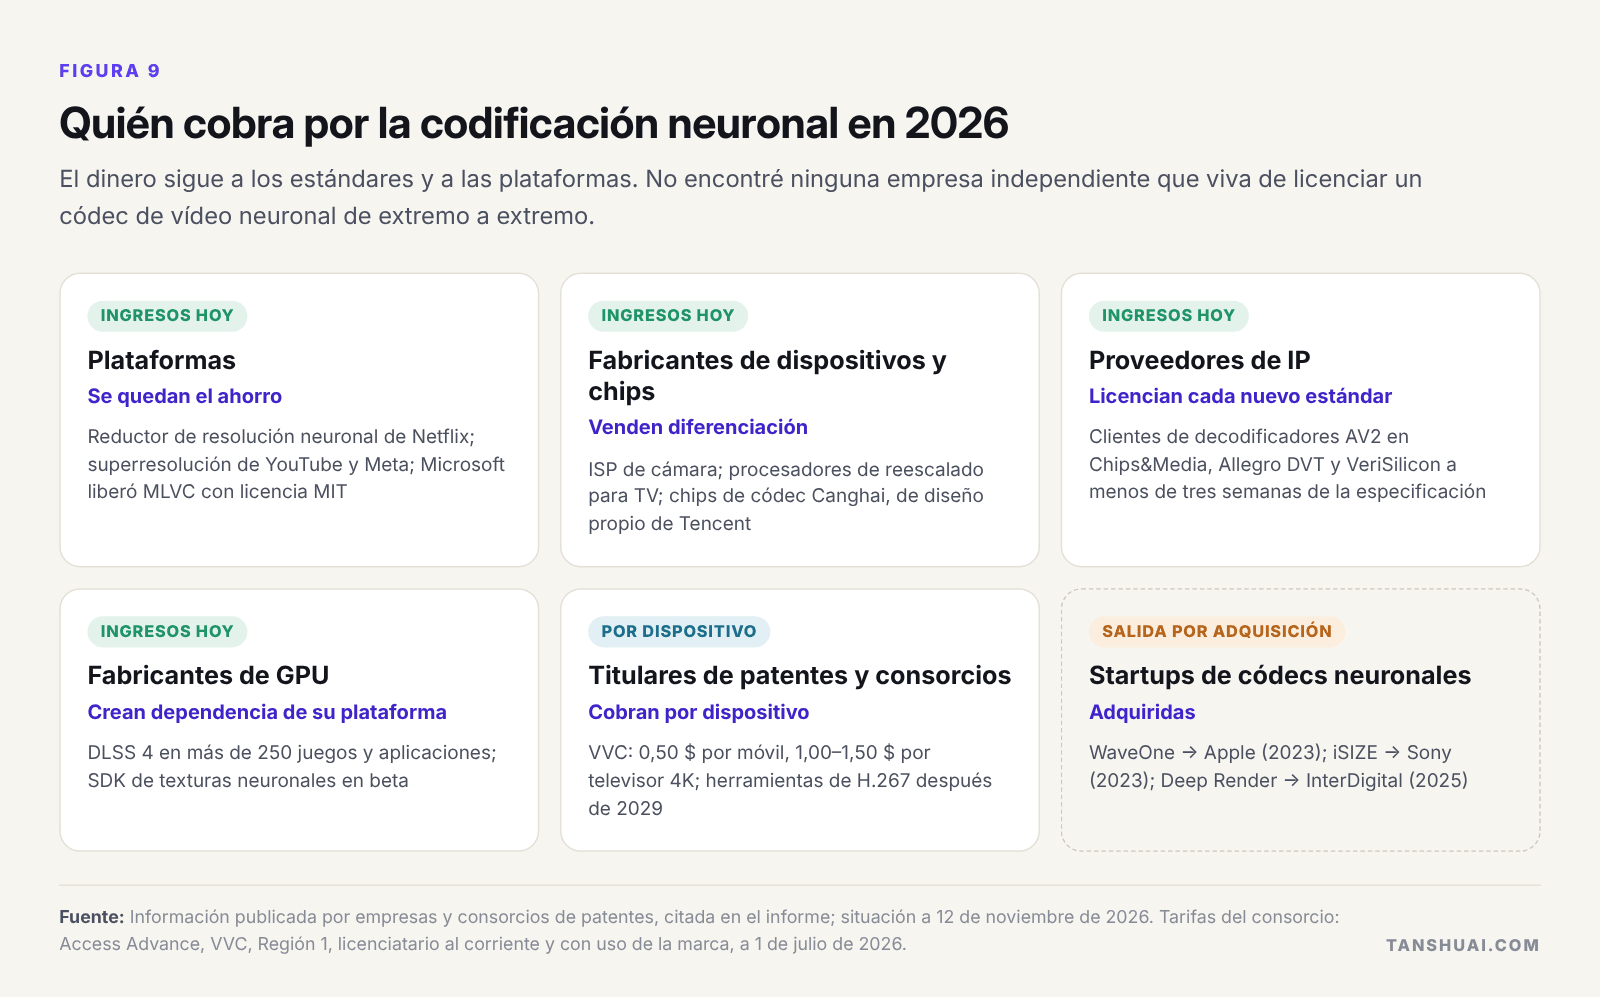 Figura 9. El dinero sigue a los estándares y a las plataformas.
Las plataformas se quedan el ahorro y a veces regalan el código, como hizo Microsoft con MLVC. Los proveedores de IP licencian decodificadores para cada nuevo estándar. Los consorcios de patentes cobran por dispositivo: para VVC, 0,50 dólares por móvil y 1,00–1,50 dólares por televisor 4K en Estados Unidos y otros mercados de la Región 1. WaveOne pasó a Apple, iSIZE a Sony y Deep Render a InterDigital. No encontré ninguna empresa independiente que viva de licenciar un códec de vídeo neuronal de extremo a extremo.
Para una empresa, las apuestas abiertas son el preprocesado neuronal para servicios de vídeo, la mejora de imagen en pantalla para fabricantes de chips, los códecs neuronales de circuito cerrado para videoconferencia y enlaces privados, el silicio de códec más NPU, y las herramientas de evaluación y conformidad que necesitará cualquiera que despliegue herramientas neuronales. El trabajo de estandarización en H.267 exige paciencia y una estrategia de licencias.
Afirmaciones que tomar con cautela, y qué vigilar
A cualquier afirmación sobre códecs neuronales hay que pedirle cuatro cosas: la referencia, la métrica, la resolución y el coste de decodificación. El «ahorro del 88 %» es frente a H.264 a 360p; el «85–96 % menos de memoria de vídeo» es una escena de demostración, frente al 30 % del juego publicado; «JPEG AI es un estándar» todavía no tiene ningún producto detrás.
Las fechas que importan: la evaluación de H.267 en enero de 2027, las primeras emisiones de YouTube en AV2 a principios de 2027, el primer modelo de prueba de H.267 en el segundo semestre de 2027, si MLVC se extiende más allá de Teams, el primer producto que use JPEG AI por defecto y los presupuestos de NPU en móviles y PC. La versión 1 de H.267, a finales de 2029, inicia el ciclo del silicio para las herramientas neuronales en la reproducción para el gran público.
Descarga del informe completo y las diapositivas
El informe completo trata cada ámbito con más detalle, los cálculos de silicio, los estándares y las patentes, una tabla que contrasta afirmaciones con evidencia, y todas las fuentes.
- Codificación neuronal en 2026: informe completo (PDF)
- Codificación neuronal en 2026: diapositivas (PDF)
- Edición en inglés: informe completo · diapositivas
Traducción de la edición en inglés, que prevalece en caso de discrepancia.
Preguntas abiertas
Algunas preguntas aún no tienen respuesta pública, y son las que me resultan más interesantes desde el punto de vista técnico: hasta qué punto puede acercarse un decodificador neuronal a una aritmética entera exacta bit a bit en NPU de distintos fabricantes antes de perder su ventaja de compresión; cuánto cuesta el posprocesado neuronal en tráfico de DRAM por píxel; a partir de qué coste por píxel una herramienta neuronal deja de compensar en un decodificador H.267; qué sistemas cerrados, más allá de las llamadas, pueden adoptar primero los códecs neuronales de extremo a extremo; y cómo medir la fidelidad cuando un decodificador genera detalle en lugar de reconstruirlo.
Son áreas que podemos explorar juntos en los próximos años, mediante el intercambio técnico y la colaboración técnica: i@tanshuai.com.
Sobre el autor
Tan Shuai es tecnólogo y fundador, con más de veinte años de trabajo en chips, hardware y software de sistemas, y 20 patentes concedidas. Tiene detrás muchos años de I+D y de gestión de chips fabless, incluido el diseño full-custom de rutas de datos de ASIC y proyectos de chips multimedia para cámaras, como aceleradores de códecs de vídeo. Su trabajo lo ha llevado por Silicon Valley, Nueva York, Chicago, Taiwán, el Área de la Gran Bahía (Shenzhen y Hong Kong), Vietnam y Malasia. Hoy trabaja como investigador y desarrollador de IA.
Debate técnico: i@tanshuai.com.