
Les réseaux de neurones façonnent déjà presque toutes les vidéos que vous regardez, mais aux deux extrémités d’un codec normalisé, pas à sa place. Voici où le codage neuronal est déployé en 2026, ce qu’il coûte en silicium et qui gagne de l’argent, avec le rapport complet et les diapositives.
Résumé
Le codage neuronal est déjà généralisé en 2026, mais il opère autour des codecs normalisés au lieu de les remplacer. Les réseaux façonnent l’image avant l’encodage, dans les appareils photo des téléphones et dans la chaîne d’encodage de Netflix, et la réparent après le décodage, dans Super Resolution de YouTube, chez Meta et dans les processeurs des téléviseurs ; entre les deux, le flux binaire reste en AV1, HEVC, AVC ou VVC, décodé par du matériel à fonction fixe. Les codecs neuronaux de bout en bout ne sont déployés qu’en boucle fermée, là où une seule entreprise contrôle les deux extrémités : MLVC de Microsoft dans les appels Teams, les tokeniseurs de tous les modèles vocaux et vidéo, les textures neuronales d’un jeu. La lecture de masse de flux binaires neuronaux attend H.267, prévu fin 2029, puis un cycle silicium. La raison tient à la puce : la seule conception publiée de décodeur vidéo neuronal exige environ 12 fois l’énergie par pixel d’un décodeur HEVC mesuré, et un codec de recherche rapide nécessite environ 22 TOPS en 1080p30. L’argent suit les normes et les plateformes ; les start-up de codecs neuronaux les plus connues ont été rachetées.
Pourquoi je me suis penché sur la question
Tous les quelques mois, quelqu’un m’assure que les codecs IA sont sur le point de remplacer H.264, HEVC et AV1. L’essentiel de ce que je lis à ce sujet vient soit d’articles de recherche, où se trouvent les records de compression, soit des fournisseurs. Ni les uns ni les autres ne disent grand-chose de ce qui est réellement déployé, pour qui et à quel coût.
J’ai derrière moi de nombreuses années de R&D et de management dans les puces fabless, dont la conception full-custom de chemins de données d’ASIC et des projets de puces multimédias pour caméras, comme des accélérateurs de codec vidéo ; j’ai donc examiné le sujet comme j’examinerais une puce : énergie par pixel, trafic mémoire, ce qu’une norme permet de figer dans le silicium, et qui paie. J’ai lu des documents de normalisation et des comptes rendus de réunion du JVET, de MPEG, du JPEG, d’AOMedia et de l’IETF, des blogs d’ingénierie d’entreprises, des articles sur des puces, des grilles tarifaires de pools de brevets, des textes sur le contrôle des exportations et la presse. Tous les chiffres ci-dessous sont arrêtés au 12 novembre 2026, et les montants sont en dollars américains. Le rapport complet, avec toutes les sources, se trouve à la fin.
Les résultats en bref
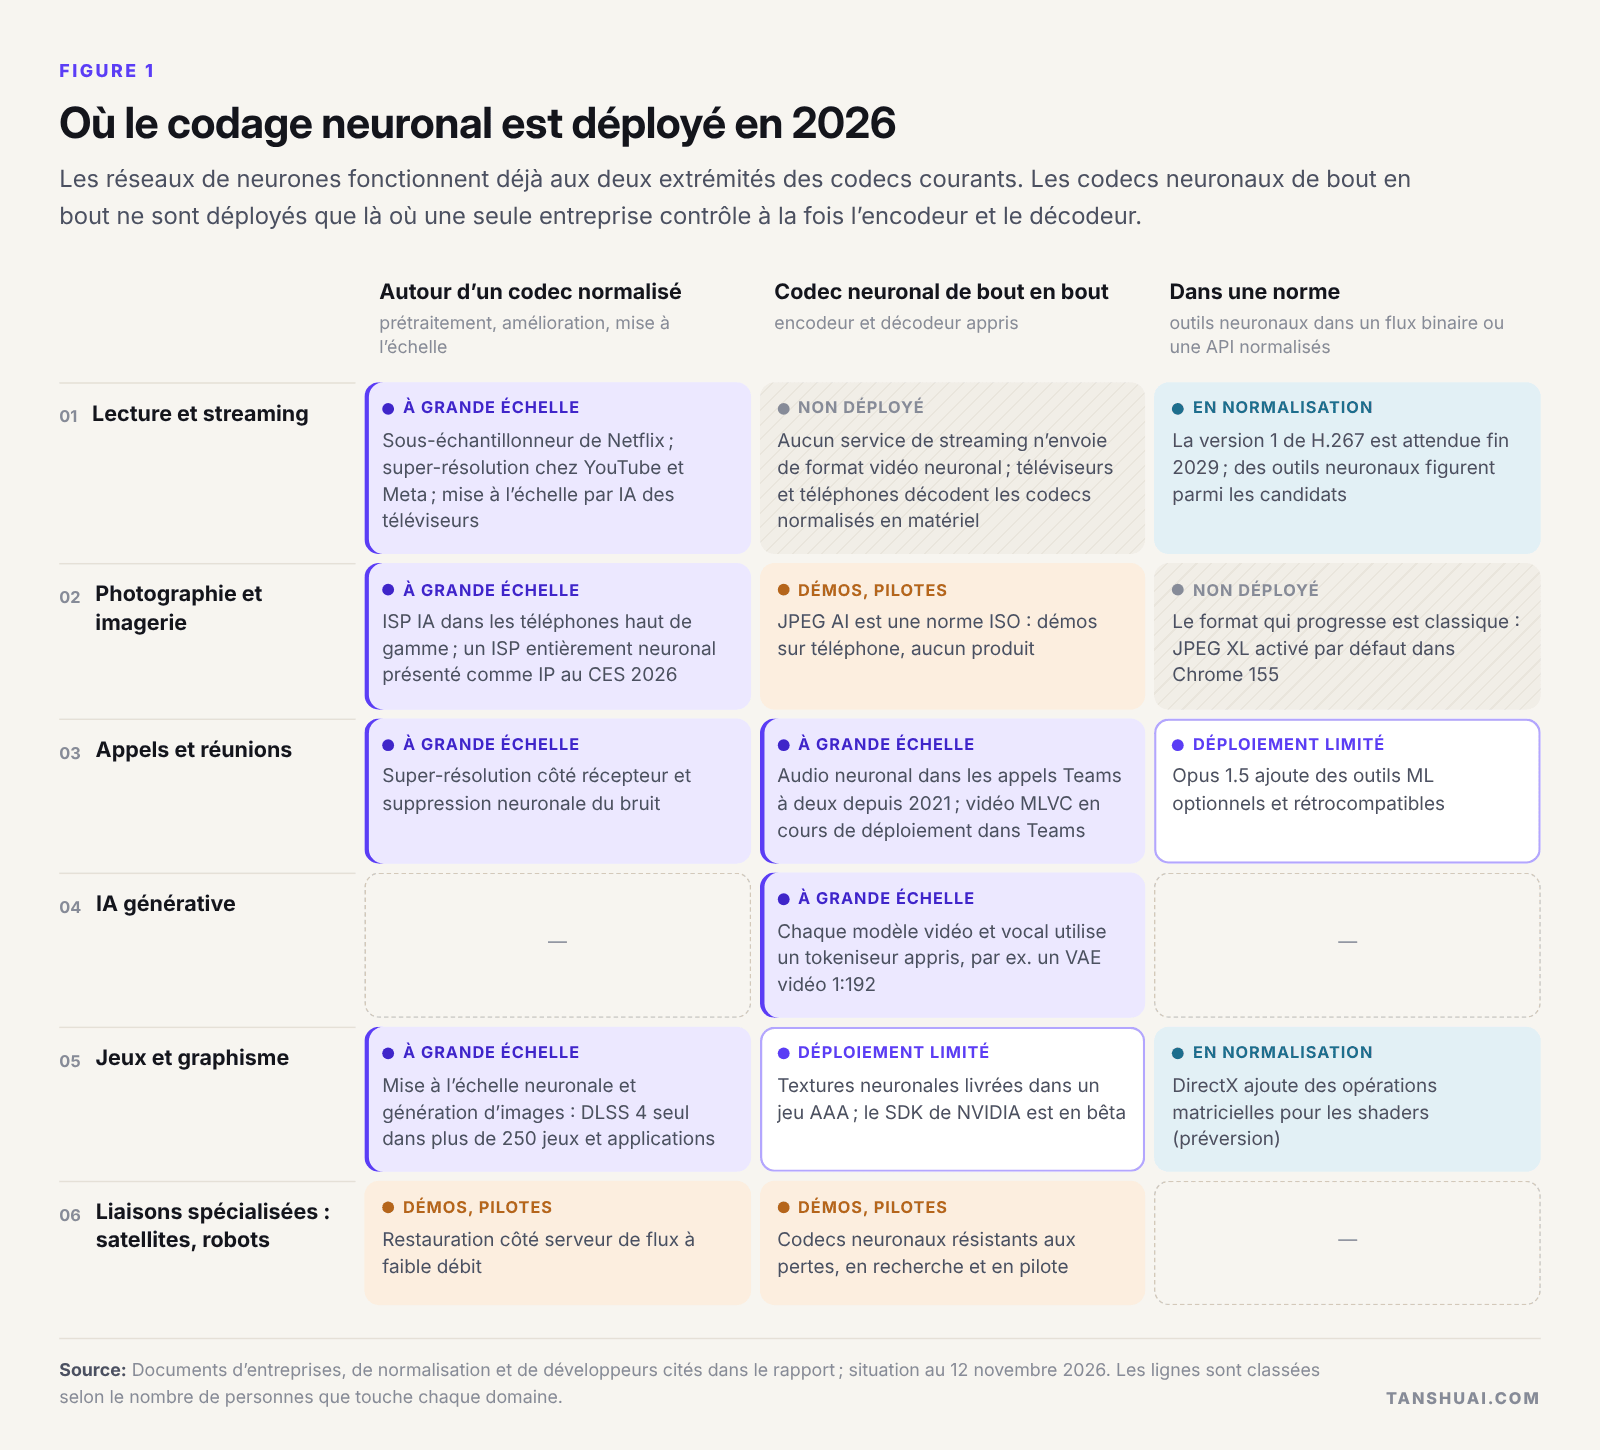 Figure 1. Où le codage neuronal est déployé en 2026. Les lignes sont classées selon le nombre de personnes que touche chaque domaine.
| Question | Réponse courte |
|---|---|
| Où le codage neuronal est-il déployé à grande échelle ? | Autour du codec : ISP des appareils photo, sous-échantillonnage côté encodage, super-résolution à la lecture. De bout en bout uniquement en boucle fermée : appels, assets de jeu, tokeniseurs d’IA générative |
| Les codecs neuronaux remplaceront-ils AV1, HEVC et VVC pour la lecture ? | Pas avant H.267 (version 1 fin 2029) et le cycle d’appareils qui suivra ; usage généralisé au milieu des années 2030 selon mon estimation |
| Que coûte-t-il en silicium ? | Environ 12 fois l’énergie par pixel d’un décodeur HEVC matériel, plus le trafic mémoire et l’exigence d’un décodage exact au bit près |
| Qui gagne de l’argent ? | Les plateformes gardent les économies ; les fournisseurs d’IP et les pools de brevets sont payés par conception et par appareil ; les start-up de codecs neuronaux ont été rachetées |
| Où une entreprise peut-elle se positionner ? | Pré- et post-traitement neuronal, produits en boucle fermée, silicium codec plus NPU, et le travail d’évaluation et de normalisation entre les deux |
Trois voies d’entrée
Le « codage neuronal » recouvre trois choses différentes, et la plupart des débats à son sujet viennent de leur confusion. Un réseau peut travailler autour d’un codec normalisé, en traitant les pixels avant l’encodage ou après le décodage, tandis que le flux binaire reste normalisé. Il peut se loger dans une norme, comme outil que chaque décodeur doit exécuter, ce qui impose de le spécifier exactement. Ou il peut remplacer le codec de bout en bout, avec un encodeur et un décodeur appris qui ne fonctionnent qu’ensemble.
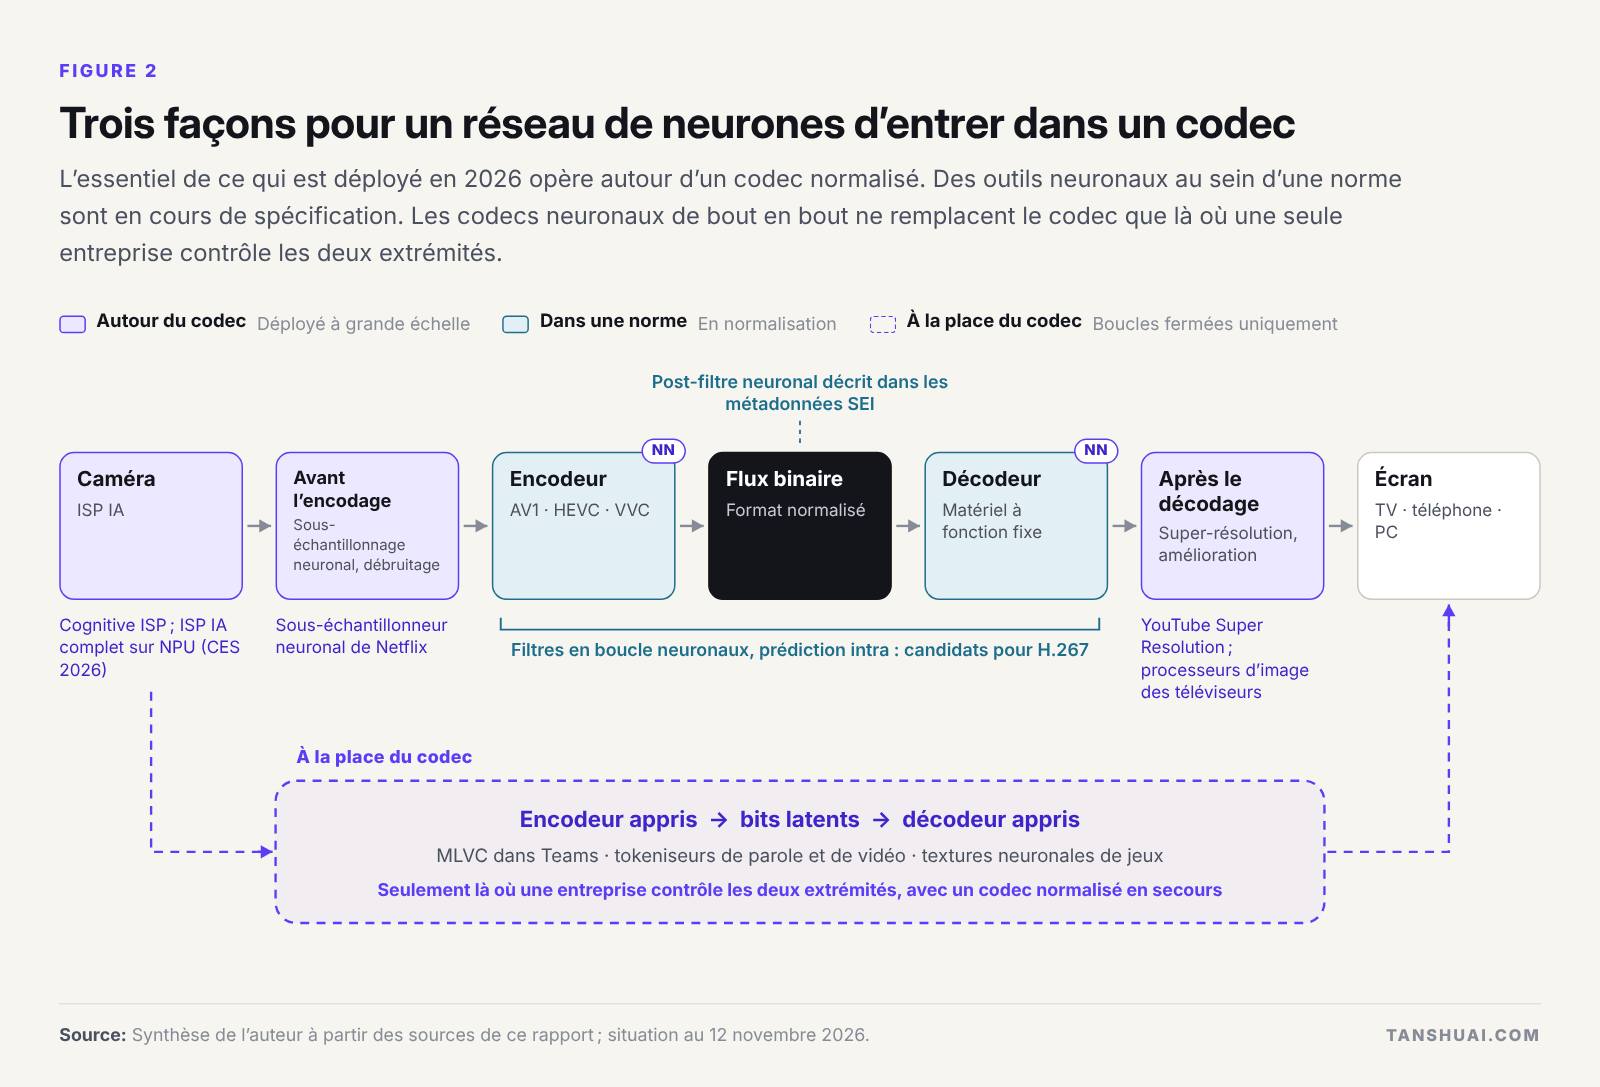 Figure 2. Trois façons pour un réseau de neurones d’entrer dans un codec. L’essentiel de ce qui est déployé en 2026 relève de la première.
La première ne demande la permission de personne. La deuxième exige une norme. La troisième exige de contrôler les deux extrémités. C’est l’ordre dans lequel elles atteignent le public.
Lecture et streaming : neuronal aux deux extrémités, normalisé au milieu
Les grands services ont achevé une transition de codec et entament la suivante, et aucune des deux n’implique de décodeur neuronal. Netflix a indiqué en décembre 2025 que l’AV1 représentait environ 30 % de ses visionnages ; YouTube affirme que plus de 90 % de son catalogue, pondéré par le temps de visionnage, est disponible en AV1. L’AV2 a été finalisé le 28 mai 2026 avec une compression environ 30 % meilleure que celle de l’AV1, et en moins de trois semaines Chips&Media, Allegro DVT et VeriSilicon avaient annoncé des clients pour leurs décodeurs AV2. Au Brésil, la TV 3.0 a lancé la diffusion commerciale en VVC en juin 2026.
La partie neuronale se situe aux deux extrémités. Depuis 2022, Netflix utilise un petit réseau de neurones à la place d’un filtre conventionnel pour sous-échantillonner ses masters, ce qui ne nécessite aucun changement sur les appareils et a été préféré par environ 77 % des spectateurs dans les tests de Netflix. Sur les téléviseurs, YouTube met à l’échelle par apprentissage automatique les vidéos mises en ligne en dessous de 1080p ; Meta applique la super-résolution sur ses serveurs et sur les téléphones ; le processeur TV haut de gamme de Samsung revendique 768 réseaux de mise à l’échelle.
Ce qui n’existe pas, c’est un flux binaire neuronal sur les écrans grand public, et la raison en est le temps. Un format de lecture doit pouvoir être décodé sur chaque appareil qui le lira un jour. Il a fallu près de huit ans à l’AV1 pour passer de la spécification finalisée à 30 % des visionnages Netflix.
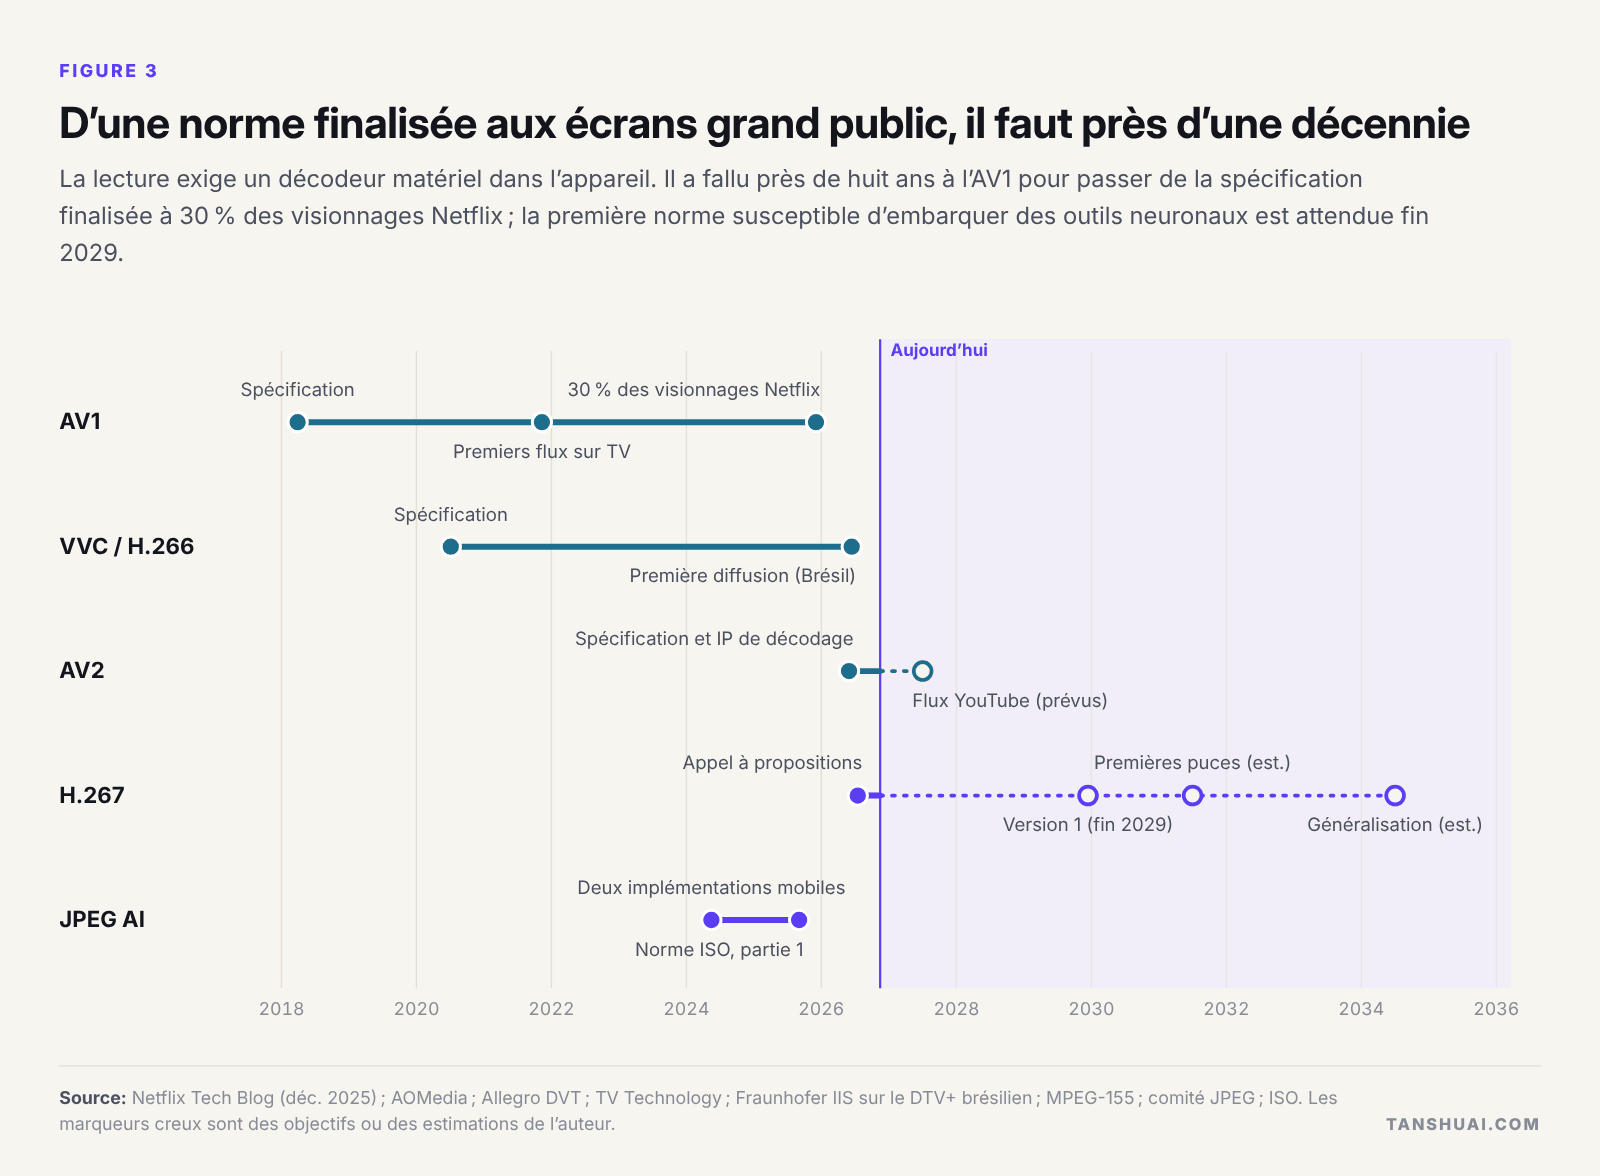 Figure 3. D’une norme finalisée aux écrans grand public, il faut près d’une décennie.
La norme qui pourrait apporter des outils neuronaux à tous les écrans est H.267, le nom de travail du successeur de VVC. Le JVET a lancé son appel à propositions en juillet 2026 ; les réponses seront évaluées en janvier 2027 et la première version est attendue fin 2029. La piste classique économise déjà environ 28 % par rapport à VVC, tandis que les filtres en boucle neuronaux du JVET économisent 6–14 % pour un coût au décodeur de 10 000 MAC par pixel et plus. Je m’attends à un cœur classique doté de quelques outils neuronaux là où les bits économisés justifient le coût.
Photographie : neuronal dans l’appareil photo, classique sur le Web
Chaque photo prise par un téléphone haut de gamme récent est passée par des réseaux de neurones avant d’être enregistrée. Le Cognitive ISP de Qualcomm effectue une segmentation sémantique en temps réel depuis 2023, et, au CES 2026, Chips&Media et Visionary.ai ont présenté un ISP complet qui fonctionne entièrement sur un NPU. Le résultat est ensuite enregistré en JPEG ou en HEIF.
JPEG AI, la première norme d’image apprise, a été publiée en 2025, avec des gains de 12,5–27,9 % par rapport au codage intra de VVC, pour des coûts au décodeur de 7 000 à 216 000 MAC par pixel. Je n’ai trouvé aucun appareil photo, aucune application de galerie ni aucun navigateur qui l’utilise par défaut. Le format adopté par le Web en 2026 est classique : Chrome 155 a activé JPEG XL le 6 octobre, avec un décodeur rapide, à sûreté mémoire, qui fonctionne sur n’importe quel processeur. Le codage neuronal l’emporte à l’intérieur de la chaîne d’une seule entreprise ; les formats qui doivent s’ouvrir partout restent classiques.
Appels : là où les codecs neuronaux de bout en bout sont déployés
Les appels forment une boucle fermée : les deux extrémités exécutent la même application et peuvent se replier sur un codec normalisé en cours d’appel. C’est pourquoi on y trouve les premiers codecs neuronaux de bout en bout déployés à grande échelle. Le codec vocal à IA de Microsoft, Satin, fonctionne dans tous les appels Teams et Skype à deux participants depuis 2021. En juillet 2026, Microsoft a publié en open source MLVC, un codec vidéo neuronal en cours de déploiement dans les appels Teams pair à pair.
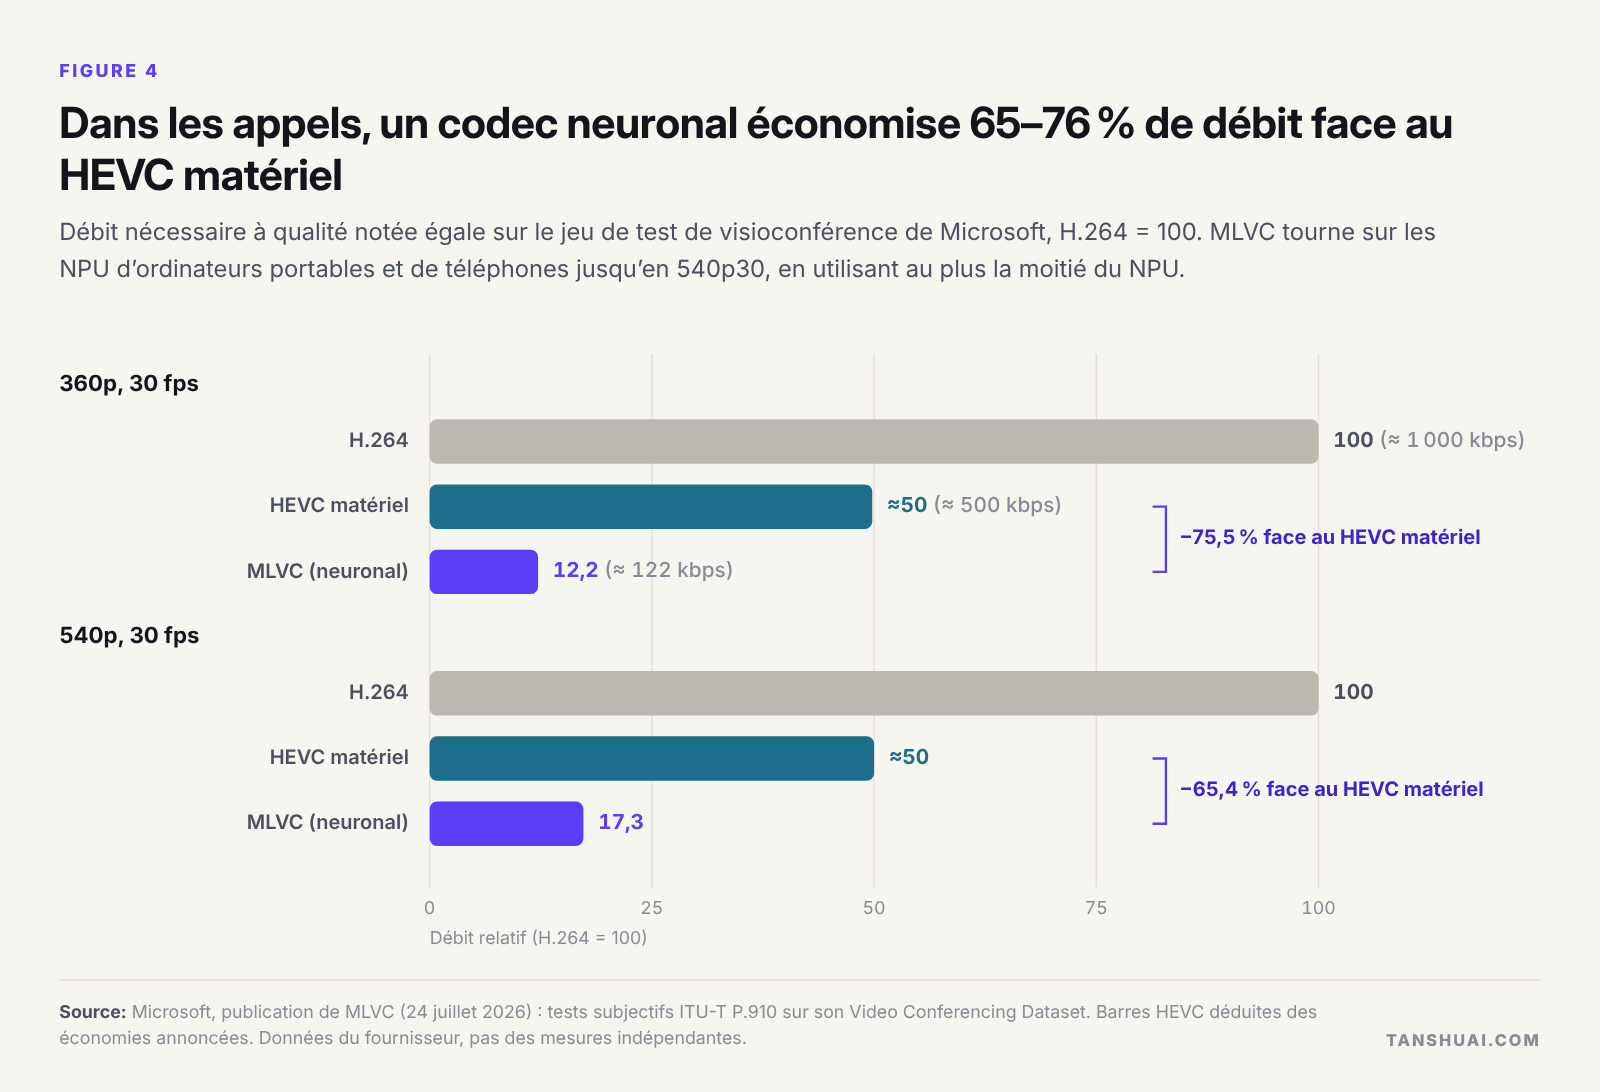 Figure 4. Dans les appels, un codec neuronal économise 65–76 % de débit face au HEVC matériel, sur le propre jeu de test de Microsoft.
Le chiffre de 88 % mis en avant se mesure par rapport à H.264 ; par rapport au HEVC matériel déjà présent dans les mêmes ordinateurs portables, il est de 65–76 %, ce qui reste considérable. MLVC fonctionne en 540p et en 360p en utilisant au plus la moitié du NPU, et il a sacrifié une part de compression pour décoder de façon identique sur du matériel que Microsoft ne possède pas.
Tout le monde n’a pas choisi cette voie. Opus a ajouté l’apprentissage profond en 2024 sous forme de compléments optionnels et rétrocompatibles. Meta a conçu MLow, un codec vocal classique, parce que plus de 20 % de ses appels passent par d’anciens téléphones ARMv7 et que des dizaines de millions d’appels WhatsApp par jour passent par des téléphones de plus de dix ans. Les codecs neuronaux sont déployés d’abord là où les appareils sont récents et où un seul fournisseur contrôle les deux extrémités.
IA générative : le plus grand déploiement, que personne n’appelle un codec
Chaque modèle vocal et vidéo repose sur un codec appris. Les modèles de parole lisent et écrivent les jetons de codecs audio neuronaux comme Mimi de Kyutai, à 12,5 trames par seconde et 1,1 kbps. Les générateurs vidéo travaillent dans l’espace latent d’autoencodeurs vidéo comme celui de LTX-Video, qui compresse dans un rapport de 1:192. Aucun d’eux n’est un format que quelqu’un d’autre décode, mais ils prouvent que la compression apprise fonctionne à grande échelle quand une entreprise possède l’encodeur, le décodeur et le matériel. Pour quiconque fournit de la vidéo générative, l’efficacité du tokeniseur est une ligne de coût directe.
Jeux : la reconstruction neuronale est généralisée, les assets neuronaux démarrent
Le DLSS de NVIDIA effectue le rendu de moins de pixels et d’images et laisse un réseau reconstruire le reste. La compression neuronale de textures a été livrée dans Assassin’s Creed Mirage, utilisée seulement sur certains assets en raison de son coût à l’exécution.
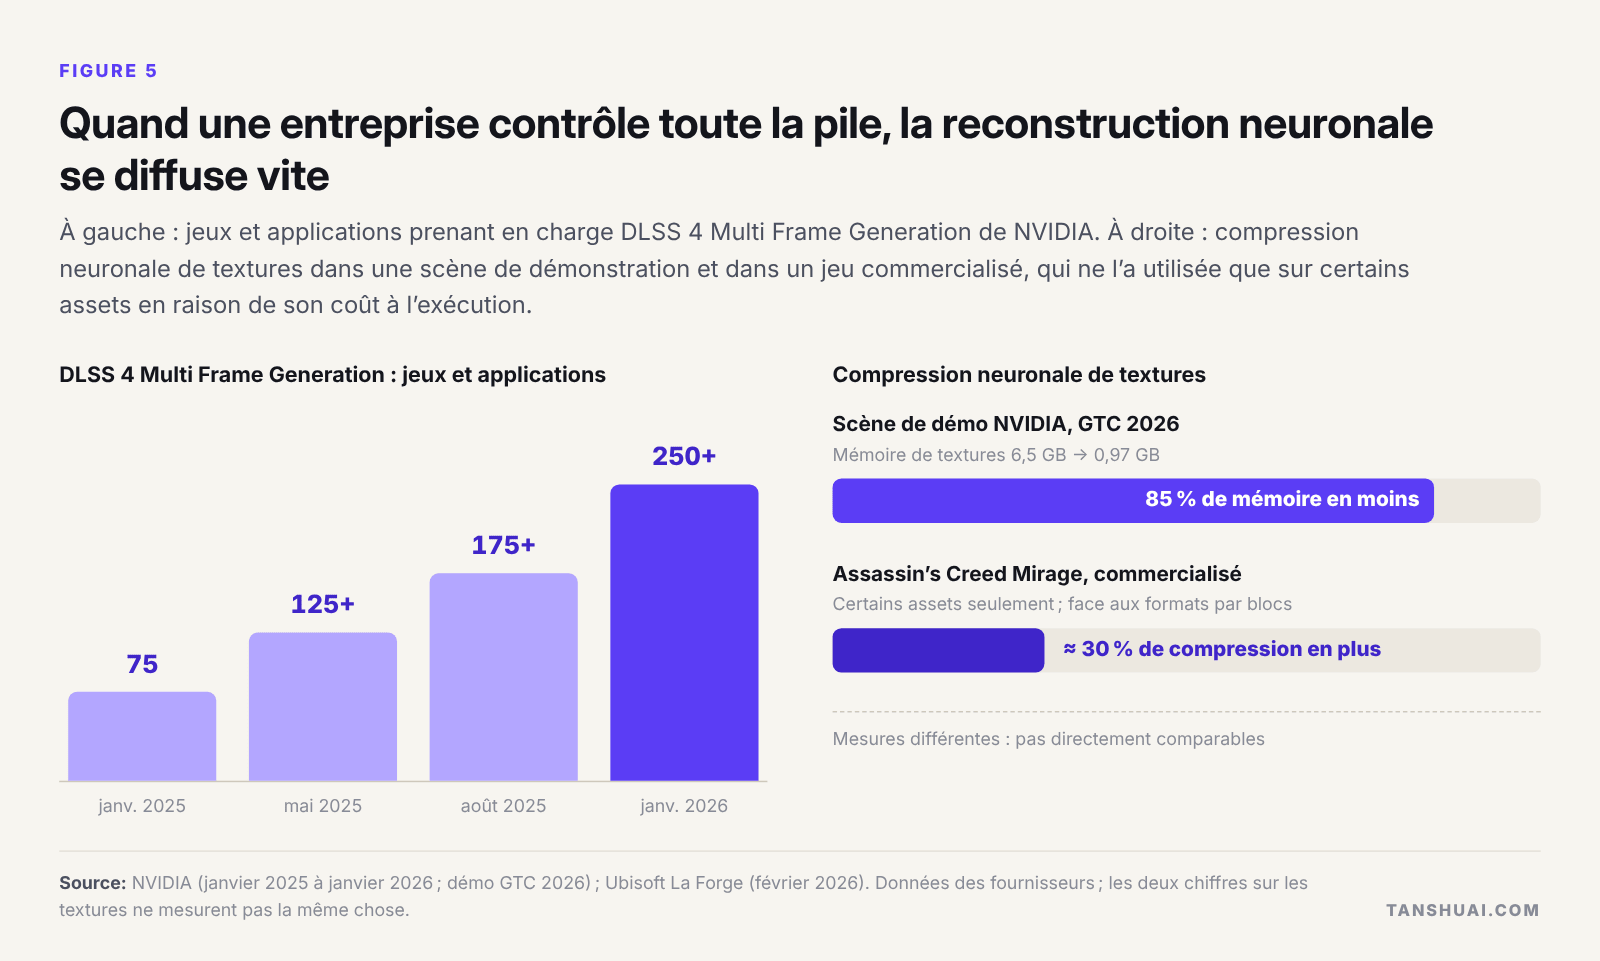 Figure 5. Quand une entreprise contrôle toute la pile, la reconstruction neuronale se diffuse vite.
Les liaisons de satellites, de drones et de robots sont le meilleur terrain technique pour les codecs neuronaux de bout en bout, mais elles représentent un petit marché, de plus en plus soumis au contrôle des exportations des deux côtés : les règles chinoises sur l’exportation de drones applicables à partir du 18 novembre 2026 retiennent même la compression sémantique d’image comme seuil.
Le point de vue du silicium
C’est ici que mon propre parcours compte le plus. Une équipe puce pose quatre questions sur tout nouveau codec : les joules par pixel, le trafic DRAM par pixel, le nombre de portes, et la question de savoir si chaque décodeur au monde calcule exactement les mêmes bits. Sur ces quatre points, un décodeur neuronal en est en 2026 là où en était le HEVC matériel avant ses premières puces.
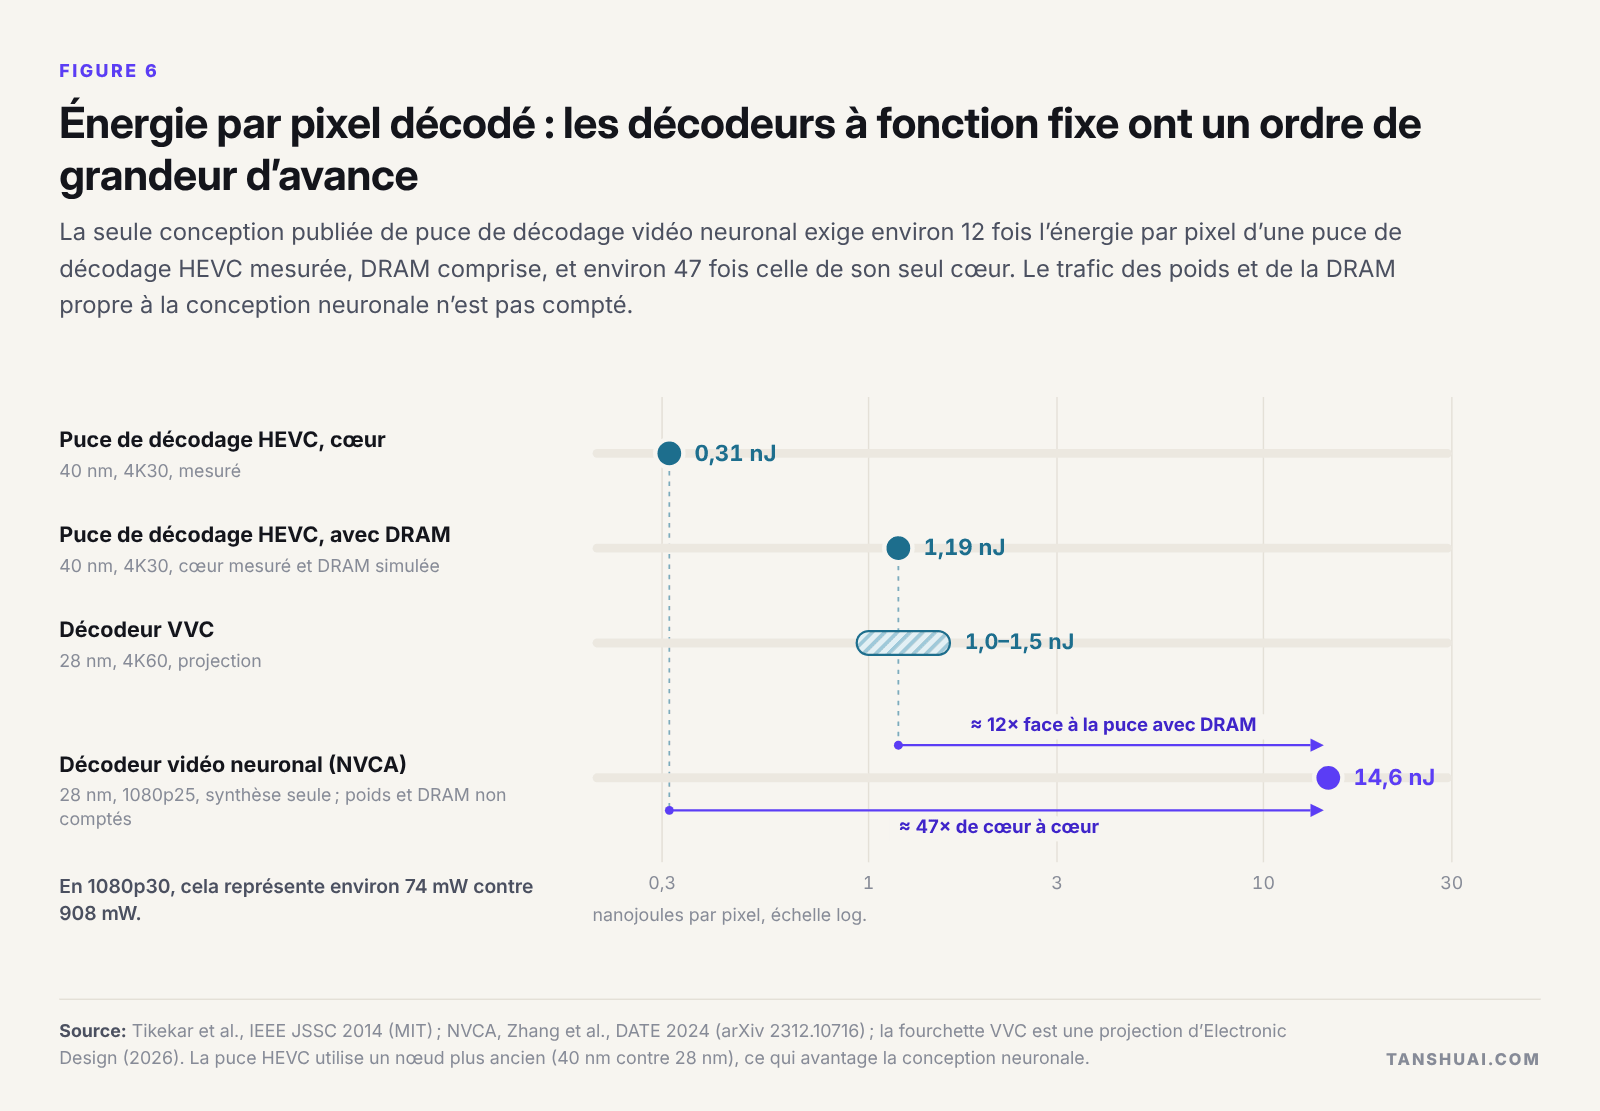 Figure 6. Énergie par pixel décodé : les décodeurs à fonction fixe ont un ordre de grandeur d’avance.
La seule conception publiée de puce de décodage vidéo neuronal, NVCA, nécessite 14,6 nJ par pixel ; la puce de décodage HEVC du MIT nécessite 1,19 avec sa DRAM et 0,31 pour le cœur. En 1080p30, cela représente environ 900 mW contre 74 mW. Selon ma somme des valeurs de son propre tableau par module, le codec de recherche rapide de Microsoft, DCVC-RT, nécessite environ 175 000 MAC par pixel décodé, soit environ 22 TOPS en 1080p30 : la moitié des 40 TOPS qui définissent un PC IA, pour un seul flux.
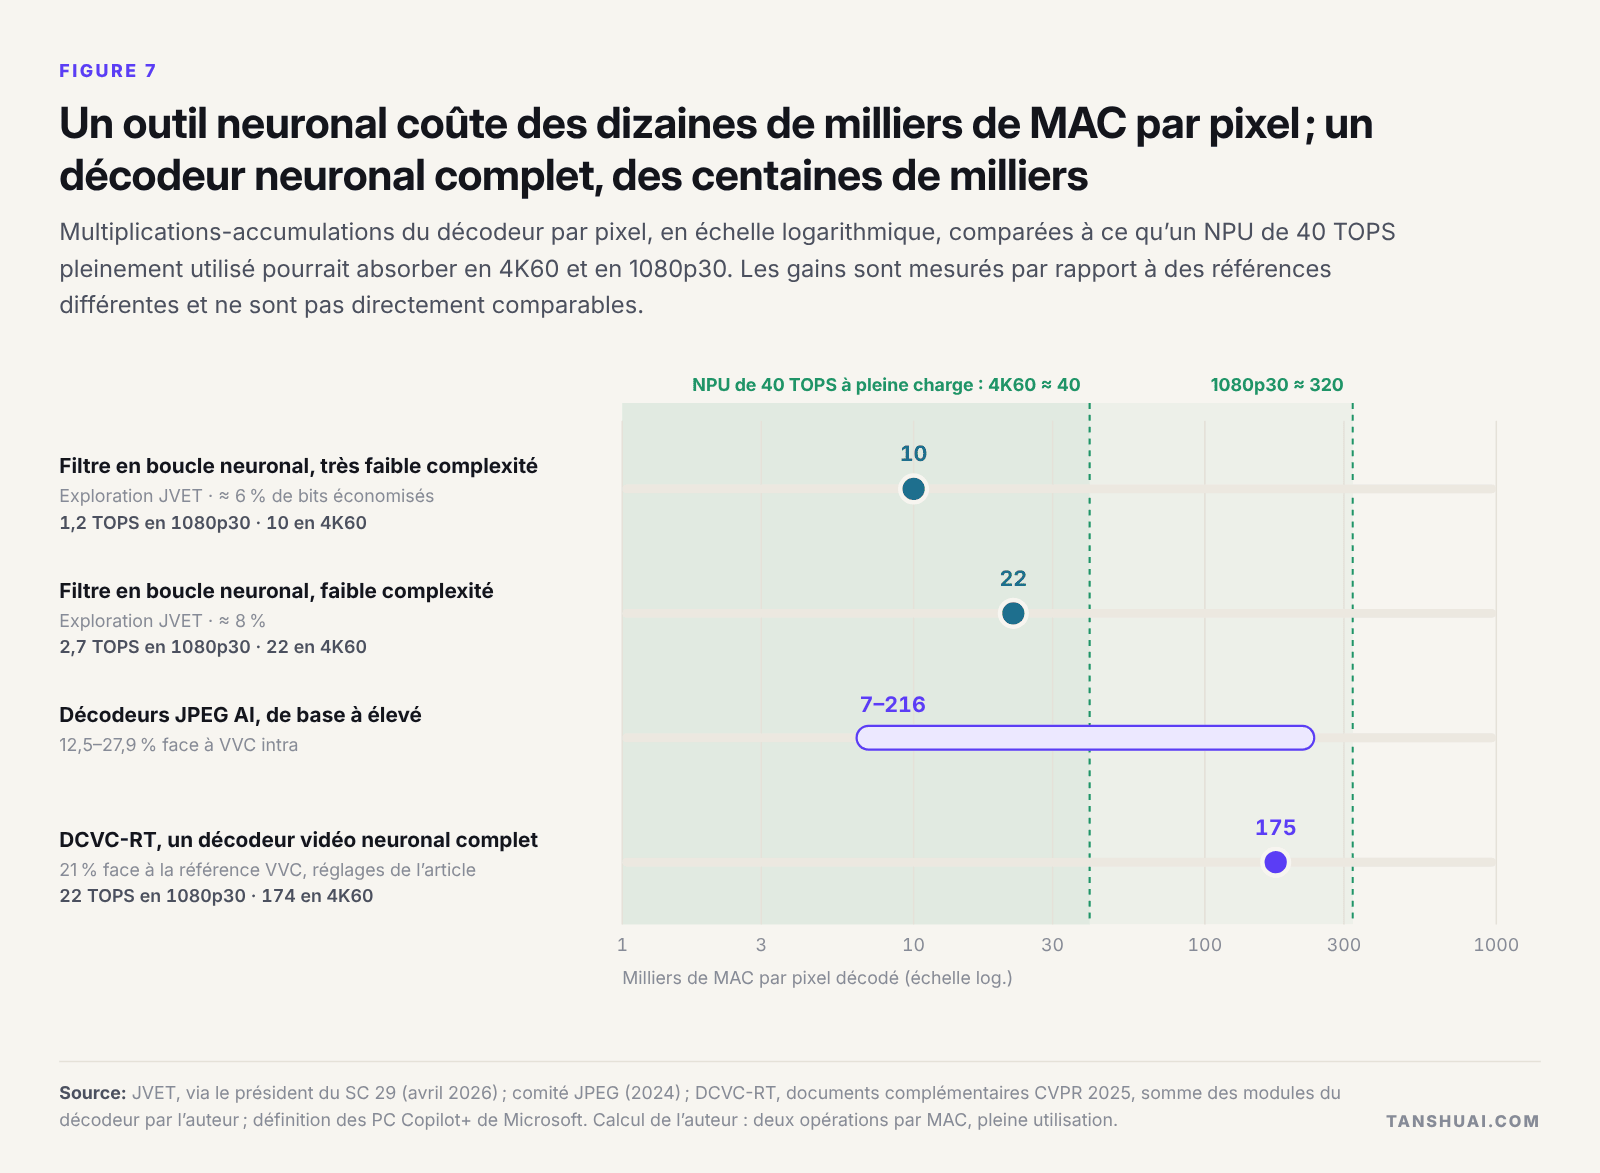 Figure 7. Un outil neuronal coûte des dizaines de milliers de MAC par pixel ; un décodeur neuronal complet, des centaines de milliers.
Deux autres coûts comptent. La mémoire : dans la puce du MIT, environ les trois quarts de l’énergie du système vont à la DRAM, et les décodeurs neuronaux transportent de grandes cartes de caractéristiques d’une image à l’autre. L’exactitude : le décodage entropique échoue si deux appareils calculent une probabilité différemment, ce qui explique pourquoi tout codec neuronal sérieux utilise désormais l’arithmétique entière, et pourquoi MLVC échange de la compression contre un décodage identique.
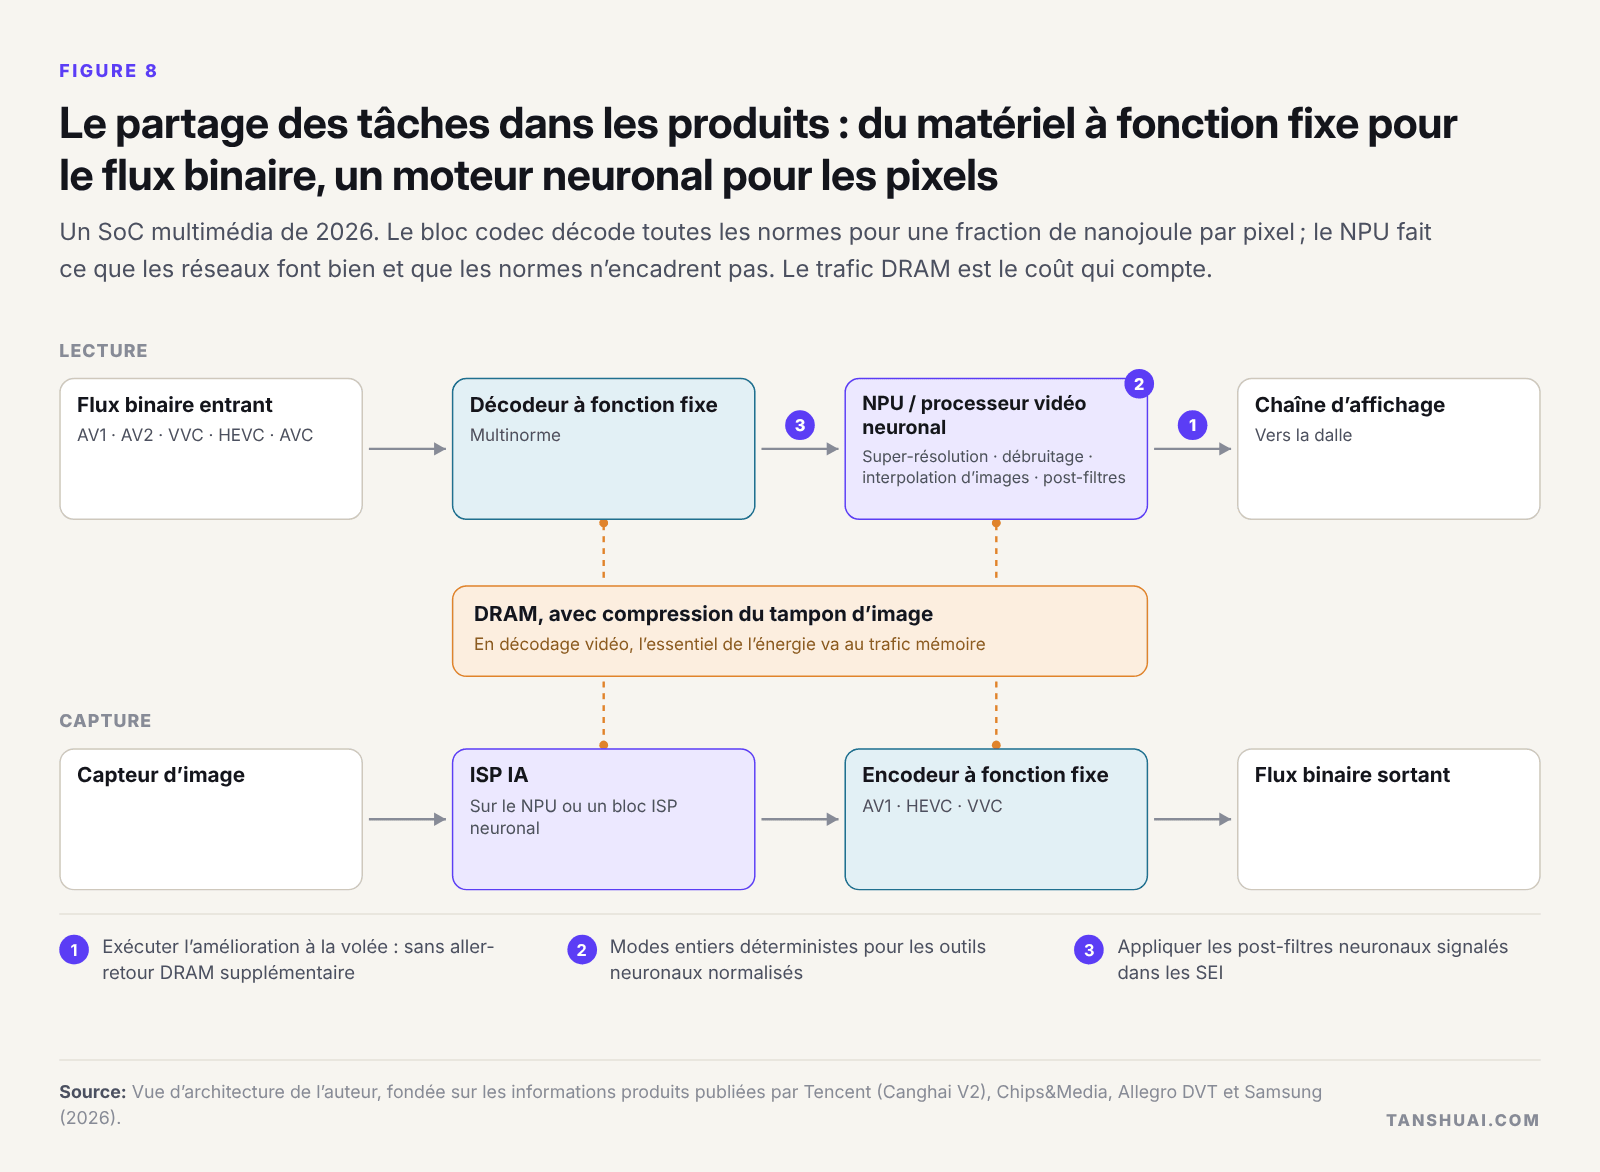 Figure 8. Le partage des tâches dans les produits : du matériel à fonction fixe pour le flux binaire, un moteur neuronal pour les pixels.
Le silicium qui se vend associe les deux. Tencent a déployé plus de 100 000 de ses puces codec maison Canghai, et la deuxième génération ajoute H.266 et la super-résolution sur puce ; les fournisseurs d’IP vendent côte à côte des blocs codec et des NPU vidéo. Si je planifiais un SoC multimédia aujourd’hui : des décodeurs à fonction fixe pour chaque norme que vous devez lire, y compris AV2 ; un NPU dimensionné pour l’amélioration à la résolution d’affichage, sans passage supplémentaire par la DRAM ; des modes entiers déterministes ; et H.267 comme point de départ de conception après 2029.
Qui gagne de l’argent, et où une entreprise peut se positionner
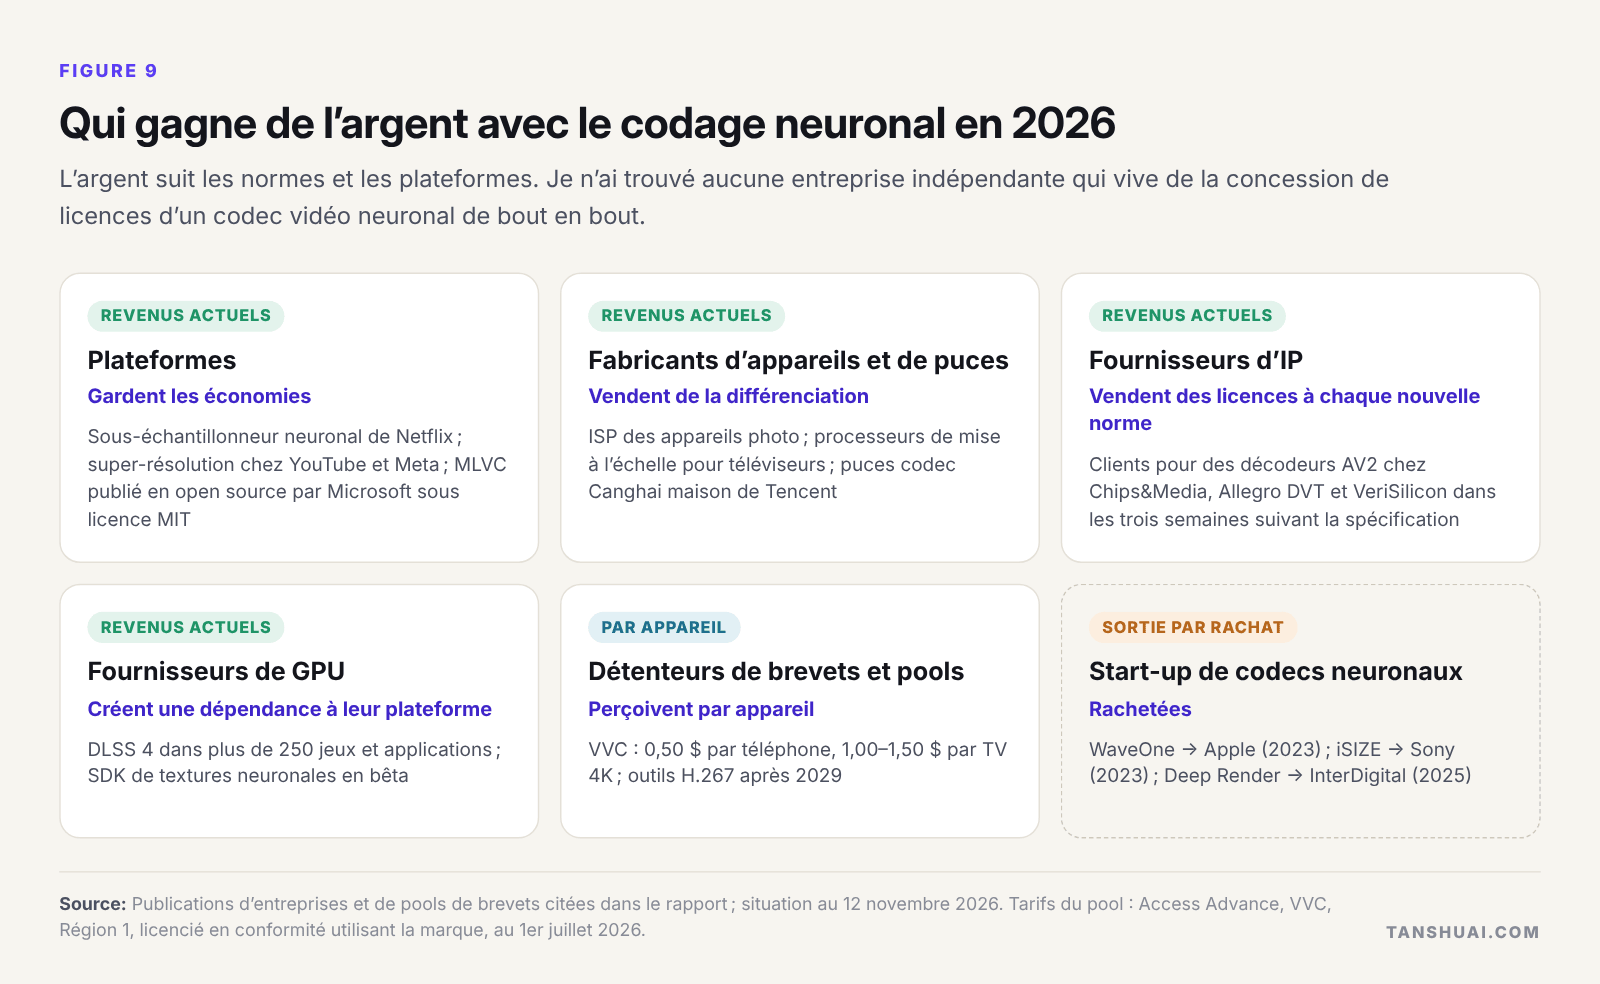 Figure 9. L’argent suit les normes et les plateformes.
Les plateformes gardent les économies et donnent parfois le code, comme Microsoft l’a fait avec MLVC. Les fournisseurs d’IP vendent des licences de décodeurs pour chaque nouvelle norme. Les pools de brevets perçoivent des redevances par appareil : pour VVC, 0,50 dollar par téléphone et 1,00–1,50 dollar par téléviseur 4K aux États-Unis et sur les autres marchés de la Région 1. WaveOne a rejoint Apple, iSIZE Sony et Deep Render InterDigital. Je n’ai trouvé aucune entreprise indépendante qui vive de la concession de licences d’un codec vidéo neuronal de bout en bout.
Pour une entreprise, les créneaux ouverts sont le prétraitement neuronal pour les services vidéo, l’amélioration côté affichage pour les fabricants de puces, les codecs neuronaux en boucle fermée pour la visioconférence et les liaisons privées, le silicium codec plus NPU, ainsi que les outils d’évaluation et de conformité dont aura besoin quiconque livre des outils neuronaux. Le travail de normalisation sur H.267 demande de la patience et une stratégie de licences.
Les affirmations à relativiser, et ce qu’il faut surveiller
Exigez de toute affirmation sur un codec neuronal quatre éléments : la référence, la métrique, la résolution et le coût de décodage. « 88 % d’économie » se mesure par rapport à H.264 en 360p ; « 85–96 % de mémoire vidéo en moins » vaut pour une scène de démonstration, contre 30 % dans le jeu commercialisé ; derrière « JPEG AI est une norme », il n’y a encore aucun produit.
Les dates qui comptent : l’évaluation H.267 en janvier 2027, les premiers flux AV2 de YouTube début 2027, le premier modèle de test de H.267 au second semestre 2027, l’extension éventuelle de MLVC au-delà de Teams, le premier produit utilisant JPEG AI par défaut, et les budgets NPU des téléphones et des PC. La version 1 de H.267, fin 2029, lancera le cycle silicium des outils neuronaux dans la lecture grand public.
Télécharger le rapport complet et les diapositives
Le rapport complet couvre chaque domaine plus en détail, l’arithmétique du silicium, les normes et les brevets, un tableau qui confronte les affirmations aux faits, et toutes les sources.
- Le codage neuronal en 2026 : rapport complet (PDF)
- Le codage neuronal en 2026 : diapositives (PDF)
- Édition anglaise : rapport complet · diapositives
Ceci est une traduction de l’édition anglaise, qui fait foi en cas de divergence.
Questions ouvertes
Quelques questions n’ont pas encore de réponse publique, et ce sont celles que je trouve techniquement les plus intéressantes : jusqu’où un décodeur neuronal peut s’approcher d’une arithmétique entière exacte au bit près sur les NPU de différents fournisseurs avant de perdre son avantage en compression ; ce que coûte le post-traitement neuronal en trafic DRAM par pixel ; à partir de quel coût par pixel un outil neuronal cesse d’être rentable dans un décodeur H.267 ; quels systèmes fermés, au-delà des appels, peuvent adopter les premiers des codecs neuronaux de bout en bout ; et comment mesurer la fidélité lorsqu’un décodeur génère du détail au lieu de le reconstruire.
Ce sont des domaines que nous pouvons explorer ensemble dans les années à venir, par des échanges techniques et une collaboration technique : i@tanshuai.com.
À propos de l’auteur
Tan Shuai est un technologue et fondateur qui compte plus de vingt ans de travail dans les puces, le matériel et le logiciel système, et 20 brevets délivrés. Il a derrière lui de nombreuses années de R&D et de management dans les puces fabless, dont la conception full-custom de chemins de données d’ASIC et des projets de puces multimédias pour caméras, comme des accélérateurs de codec vidéo. Son parcours l’a mené dans la Silicon Valley, à New York, à Chicago, à Taïwan, dans la région de la Grande Baie (Shenzhen et Hong Kong), au Vietnam et en Malaisie. Il travaille aujourd’hui comme chercheur et développeur en IA.
Échanges techniques : i@tanshuai.com.