
你看的几乎每段视频都经过了神经网络处理,但它们在标准编解码器的两端,而不是取而代之。下面是 2026 年神经编码落地在哪里、芯片上要付出什么代价、钱流向了谁,文末附完整报告和演示文稿。
摘要
神经编码在 2026 年已经是主流,但它围绕标准编解码器工作,而不是取代它们。编码之前,神经网络在手机摄像头和 Netflix 的编码流程里塑造画面;解码之后,YouTube 的超分、Meta 和电视画质芯片在修复画面;中间的码流仍是 AV1、HEVC、AVC 或 VVC,由固定功能硬件解码。端到端神经编解码器只在一家公司掌控两端的闭环里上线:Teams 通话里的微软 MLVC、每个语音和视频模型里的 tokenizer、一款游戏里的神经纹理。主流播放的神经码流,要等 2029 年底的 H.267 和其后的一轮芯片周期。原因在芯片上:唯一公开的神经视频解码芯片设计,每像素能耗约为实测 HEVC 解码芯片的 12 倍;一个速度很快的研究型编解码器,1080p30 解码约需 22 TOPS。钱跟着标准和平台走,最知名的几家神经编解码创业公司都被收购了。
为什么研究这个
每隔几个月,就有人告诉我 AI 编解码器即将取代 H.264、HEVC 和 AV1。我读到的相关内容,要么来自追逐压缩纪录的研究论文,要么来自厂商,很少讲清楚什么真正上线了、给了谁、代价多大。
我有多年无晶圆厂芯片研发和管理经验,包括全定制 ASIC 数据通路设计,以及视频编解码加速器等多媒体摄像头芯片项目,所以我用评审一颗芯片的方式来看这件事:每像素能耗、访存流量、标准允许在硅片上固化什么,以及谁来买单。我读了 JVET、MPEG、JPEG、AOMedia 和 IETF 的标准文件与会议报告、公司工程博客、芯片论文、专利池费率表、出口管制文本和新闻报道。下文所有数字截至 2026 年 11 月 12 日;金额以美元为准,括注的人民币按 1 美元兑 6.72 元换算。附全部资料来源的完整报告在文末。
结论一览
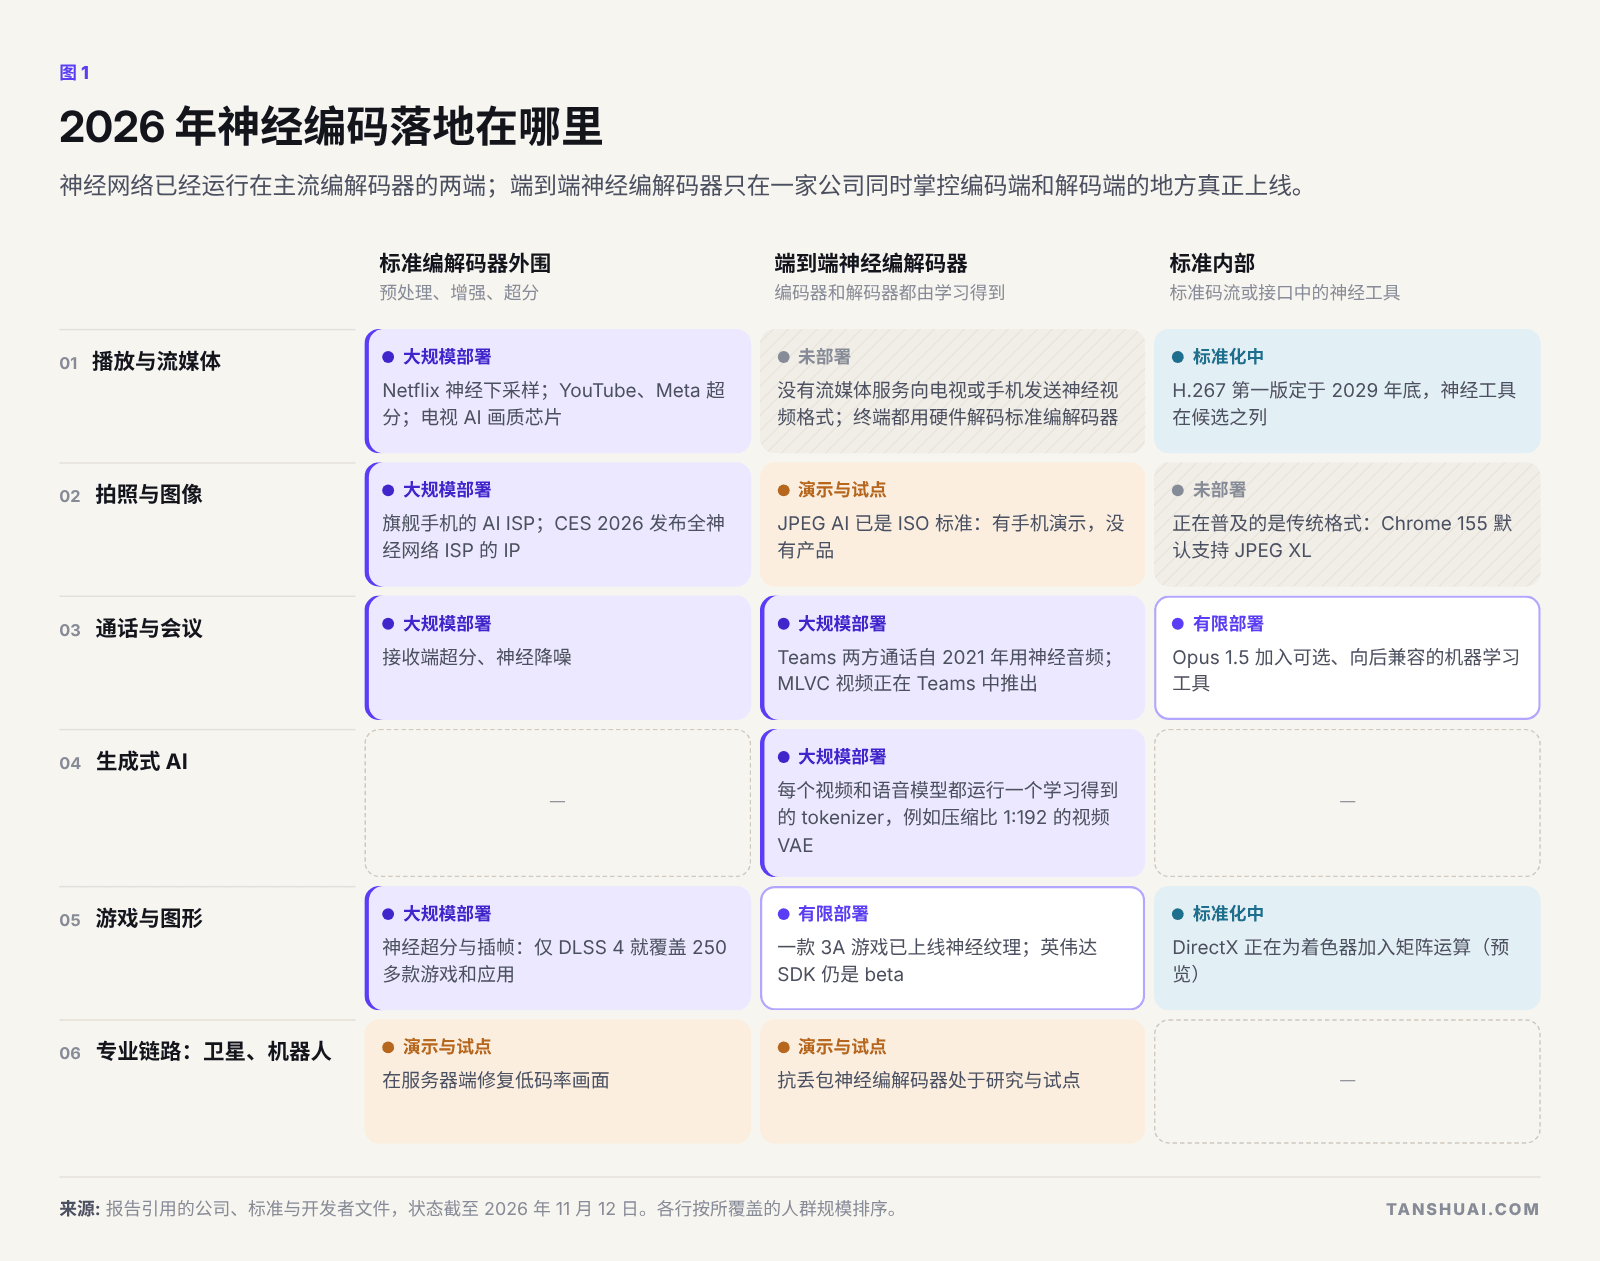 图 1:2026 年神经编码落地在哪里。各行按覆盖人数排序。
| 问题 | 简短回答 |
|---|---|
| 神经编码在哪里大规模落地? | 在编解码器外围:摄像头 ISP、编码端下采样、播放端超分。端到端只在闭环里:通话、游戏资源、生成式 AI 的 tokenizer |
| 神经编解码器会在播放中取代 AV1、HEVC 和 VVC 吗? | 要等 H.267(第一版 2029 年底)和其后一轮设备周期;按我的估计,2030 年代中期才会普及 |
| 芯片上的代价多大? | 每像素能耗约为硬件 HEVC 解码器的 12 倍,还有访存流量和逐比特一致的要求 |
| 钱流向了谁? | 平台留住节省下来的钱;IP 供应商和专利池按设计、按台收费;神经编解码创业公司被收购 |
| 公司可以在哪里切入? | 神经前处理和后处理、闭环产品、编解码器加 NPU 的芯片,以及介于其间的评测和标准工作 |
三条路径
“神经编码”其实是三件不同的事,大多数争论都源于把它们混为一谈。神经网络可以在标准编解码器的外围工作,在编码前或解码后处理像素,码流保持标准;可以进入标准内部,成为每个解码器都必须运行的工具,这意味着它必须被精确规定;也可以端到端取代编解码器,由学习得到的编码器和解码器成对工作。
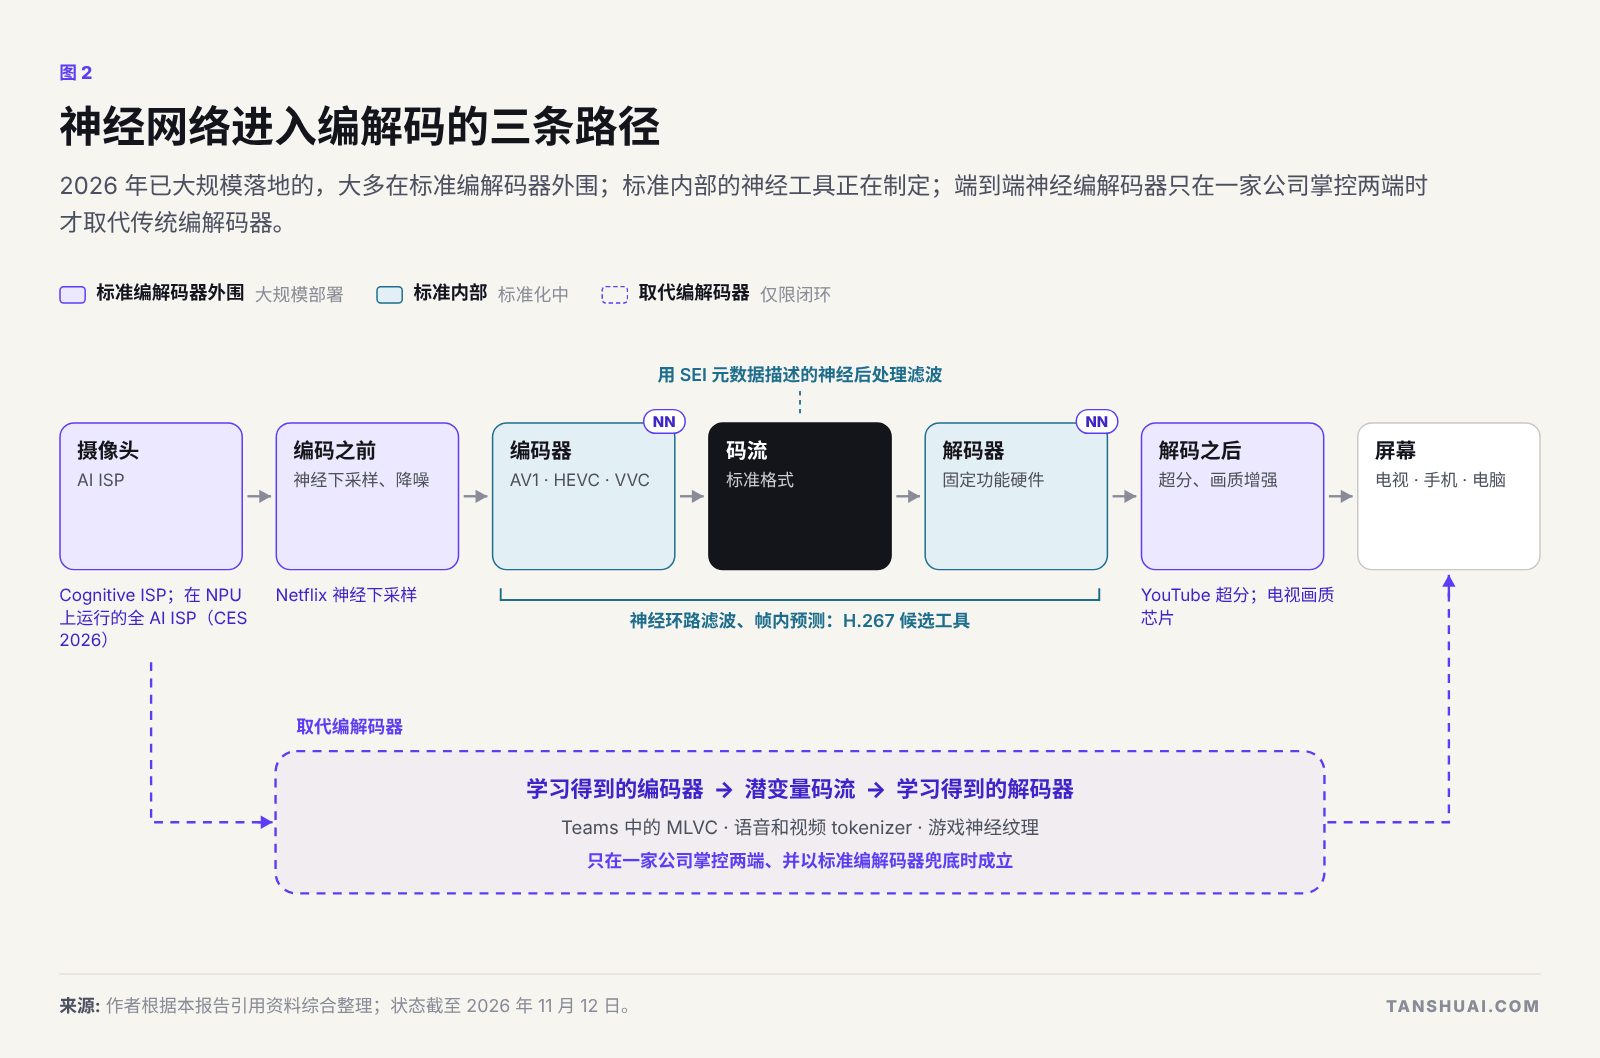 图 2:神经网络进入编解码的三条路径。2026 年已落地的大多是第一条。
第一条不需要任何人许可,第二条需要一个标准,第三条需要掌控两端。这也正是它们触达用户的先后顺序。
播放和流媒体:两端是神经网络,中间是标准
大型视频服务刚完成一次编解码器换代,又开始了下一次,两次都与神经解码器无关。Netflix 在 2025 年 12 月报告,AV1 约占其观看量的 30%;YouTube 表示,按观看时长加权,其内容库 90% 以上已有 AV1 版本。AV2 于 2026 年 5 月 28 日定稿,压缩效率比 AV1 高约 30%;三周之内,Chips&Media、Allegro DVT 和芯原都宣布了 AV2 解码器客户。巴西的 TV 3.0 于 2026 年 6 月开始 VVC 商业广播。
神经网络在两端。自 2022 年起,Netflix 用一个小型神经网络代替传统滤波器对母版做下采样,任何设备都无需改动;在 Netflix 自己的测试中,约 77% 的观众更喜欢它的结果。YouTube 在电视上用机器学习把低于 1080p 上传的视频超分到高清,Meta 在服务器和手机上都运行超分,三星的旗舰电视处理器宣称有 768 个用于超分的神经网络。
真正缺席的,是主流屏幕上的神经码流,原因是时间。播放格式必须能在今后所有要播放它的设备上解码。AV1 从标准定稿到占 Netflix 观看量的 30%,用了将近八年。
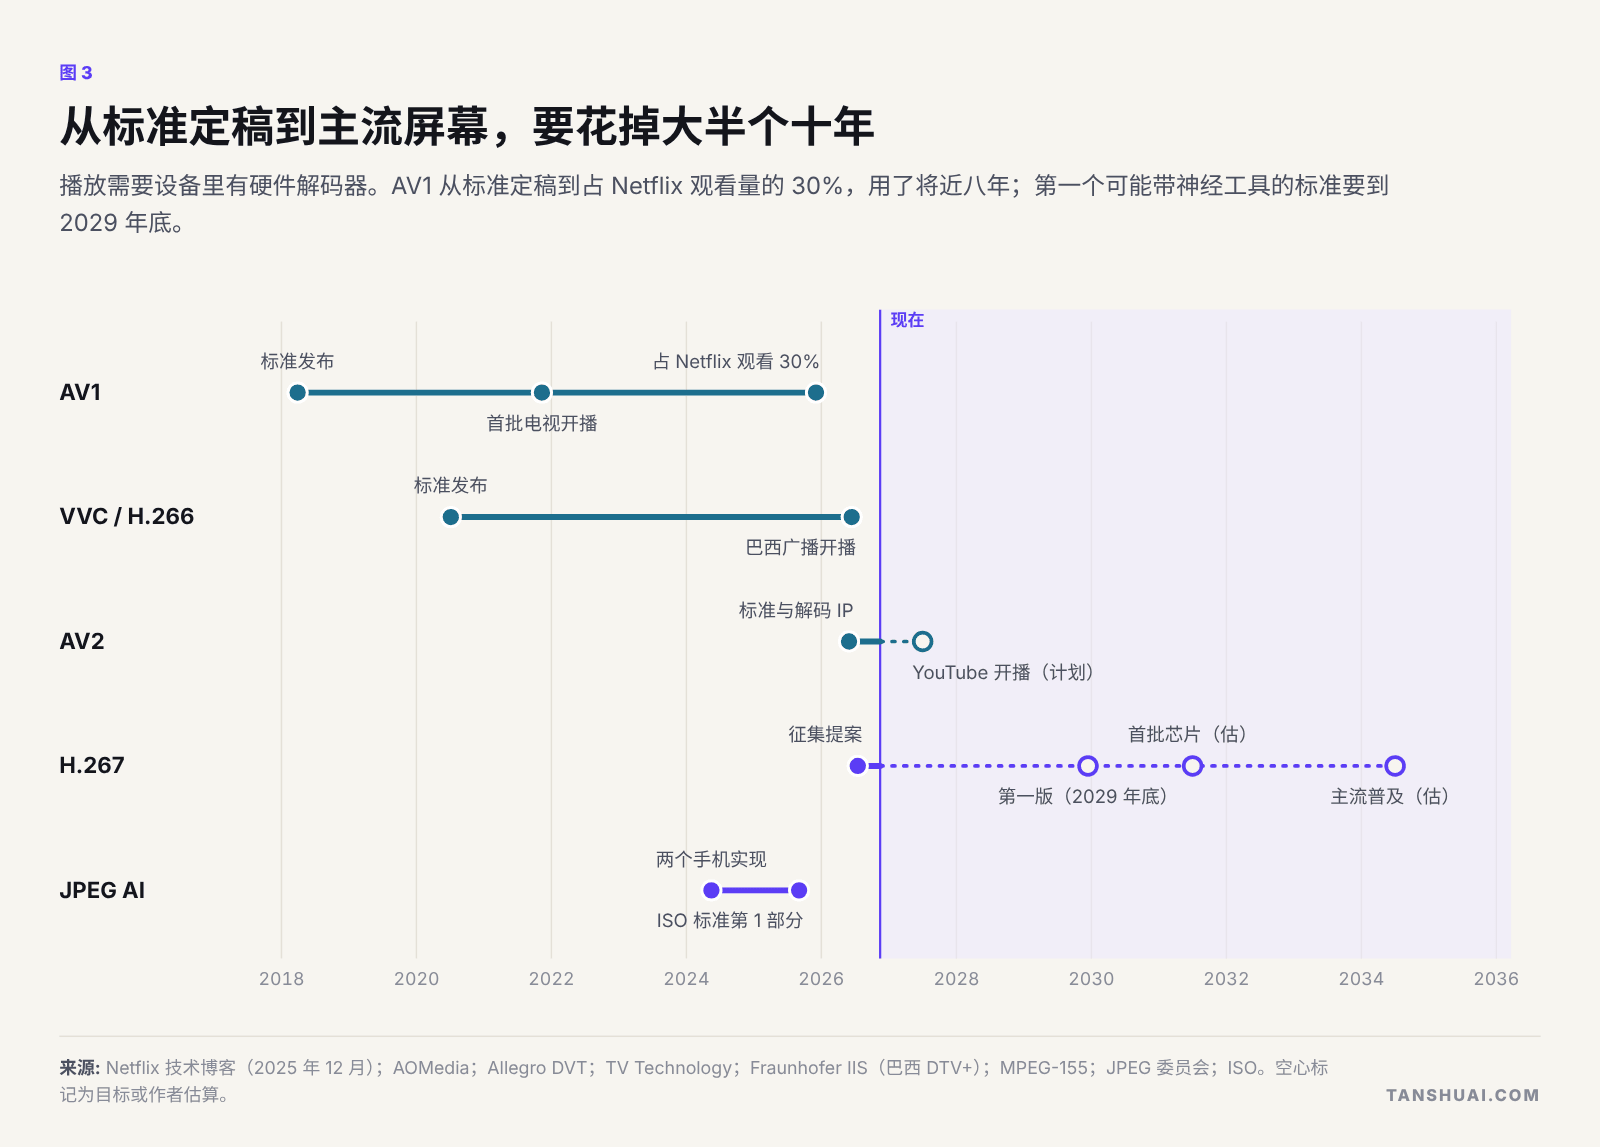 图 3:从标准定稿到主流屏幕,要花掉大半个十年。
能把神经工具带到所有屏幕上的标准,是 VVC 的继任者,工作名 H.267。JVET 于 2026 年 7 月发布征集提案,2027 年 1 月评估提案,第一版定于 2029 年底。传统技术路线已经比 VVC 节省约 28% 码率;JVET 的神经环路滤波节省 6–14%,解码代价从每像素 1 万次乘加起步。我的判断是:H.267 会是传统内核,加上少数节省的码率足以抵消代价的神经工具。
拍照:相机里是神经网络,网页上是传统格式
近几年旗舰手机拍的每张照片,在保存之前都经过了神经网络。高通的 Cognitive ISP 从 2023 年起就在拍摄时实时做语义分割;在 CES 2026 上,Chips&Media 和 Visionary.ai 展示了一个完全运行在 NPU 上的 ISP。然后结果被存成 JPEG 或 HEIF。
第一个学习型图像标准 JPEG AI 于 2025 年发布,解码代价为每像素 7 千到 21.6 万次乘加,比 VVC 帧内编码节省 12.5–27.9%。我没有找到任何默认使用它的相机、相册应用或浏览器。2026 年网页真正采用的是传统格式:Chrome 155 于 10 月 6 日默认启用 JPEG XL,用的是一个能在任何 CPU 上运行、快速且内存安全的解码器。神经编码在一家公司自己的流程里胜出;必须到处都能打开的格式,仍然是传统的。
通话:端到端神经编解码器真正落地的地方
通话是闭环:两端运行同一个应用,通话中途也能退回标准编解码器。所以第一批大规模部署的端到端神经编解码器出现在这里。微软的 AI 语音编解码器 Satin 自 2021 年起用于所有 Teams 和 Skype 双人通话。2026 年 7 月,微软开源了神经视频编解码器 MLVC,正在 Teams 的点对点通话中推广。
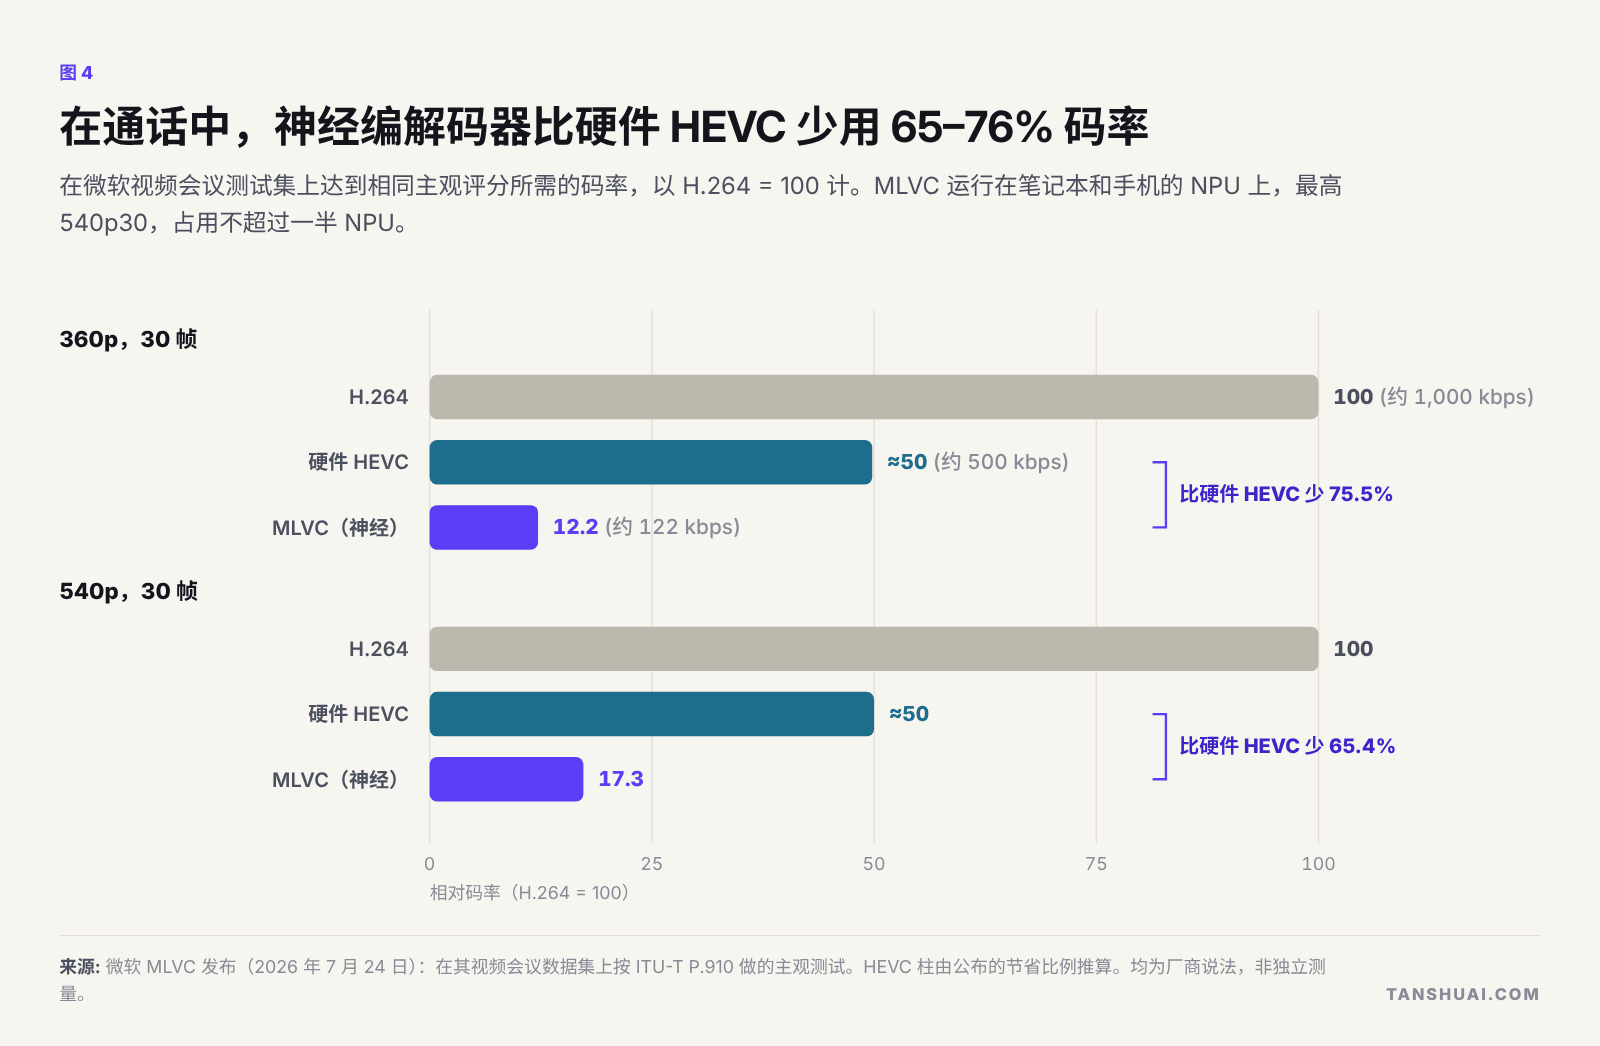 图 4:在通话中,神经编解码器比硬件 HEVC 少用 65–76% 码率(微软自己的测试集)。
88% 这个标题数字是相对 H.264 而言;相对同一台笔记本里已有的硬件 HEVC,是 65–76%,仍然很大。MLVC 运行在 540p 和 360p,最多占用一半 NPU,并且为了在不属于微软的硬件上解码出完全相同的结果,放弃了一部分压缩率。
并非人人都走这条路。Opus 在 2024 年加入深度学习,但都是可选、向后兼容的附加功能。Meta 做了 MLow,一个传统语音编解码器,因为它超过 20% 的通话跑在老旧的 ARMv7 手机上,每天还有数千万次 WhatsApp 通话跑在用了十年以上的手机上。神经编解码器最先落地在设备新、两端都由一家厂商掌控的地方。
生成式 AI:规模最大、却没人称之为编解码器的部署
每个语音和视频模型都运行在学习得到的编解码器上。语音模型读写神经音频编解码器的 token,比如 Kyutai 的 Mimi,每秒 12.5 帧、1.1 kbps。视频生成模型在视频自编码器的潜空间里工作,比如 LTX-Video 的自编码器,压缩比 1:192。这些都不是别人能解码的格式,但它们证明,当一家公司同时拥有编码器、解码器和硬件时,学习型压缩可以大规模运行。对提供生成式视频服务的公司来说,tokenizer 的效率直接就是一项成本。
游戏:神经重建已是主流,神经资源刚刚起步
英伟达的 DLSS 渲染更少的像素和帧,其余由神经网络重建。神经纹理压缩已在《刺客信条:幻景》中上市,但因为运行开销,只用在了部分资源上。
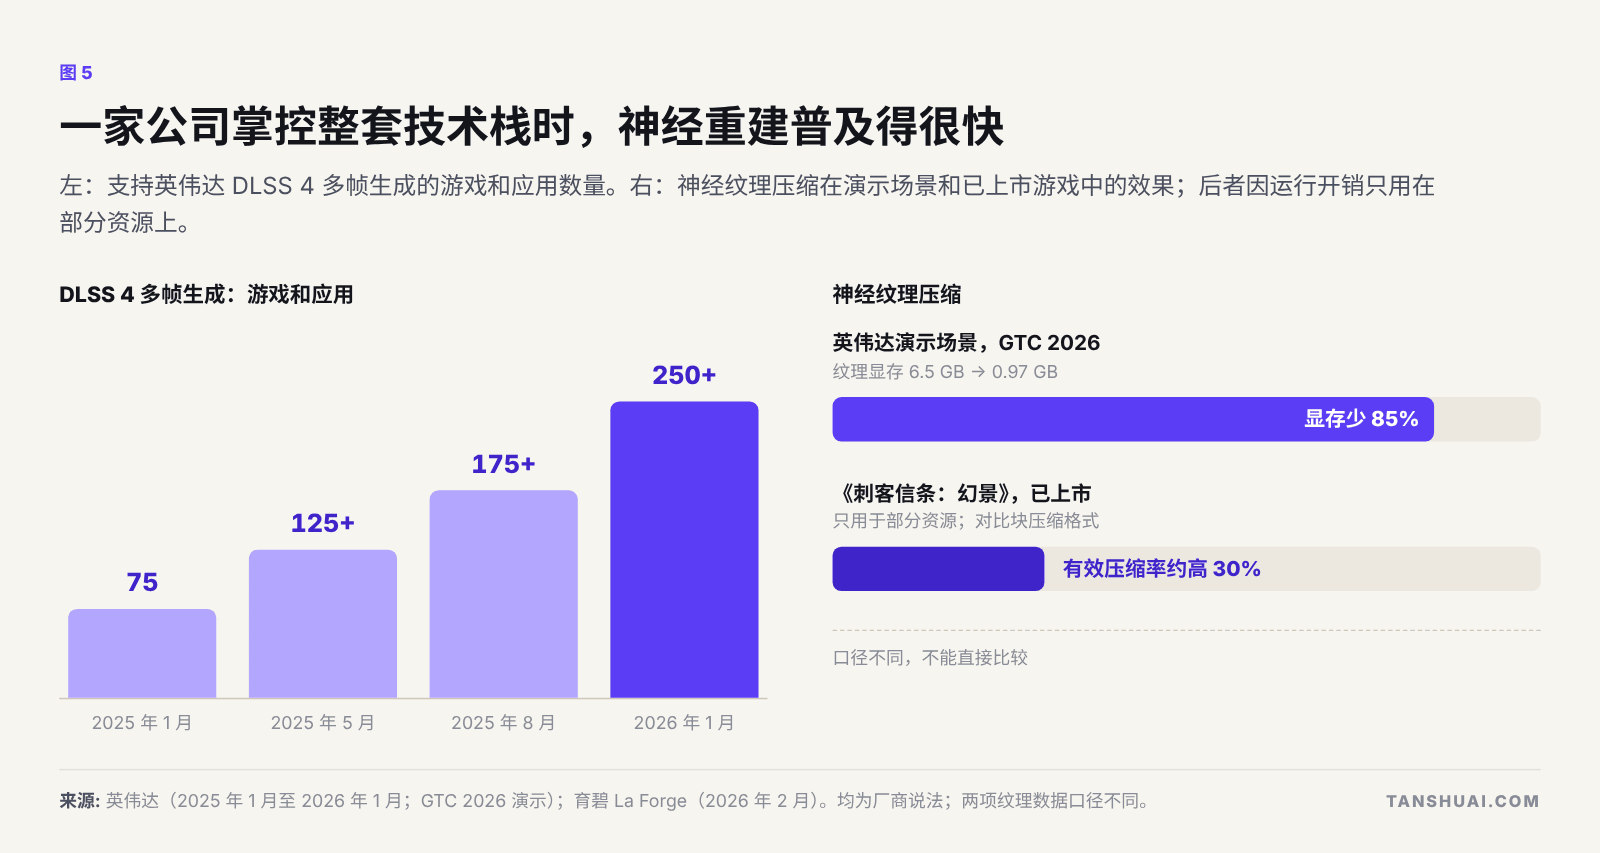 图 5:一家公司掌控整套技术栈时,神经重建普及得很快。
卫星、无人机和机器人链路,是技术上最适合端到端神经编解码器的场景,但市场小,而且受出口管制的约束越来越多:中国自 2026 年 11 月 18 日起施行的无人机相关出口管制,甚至把语义图像压缩列为指标之一。
芯片视角
这是我自己的背景最用得上的地方。芯片团队评估任何新编解码器,都会问四个问题:每像素多少焦耳,每像素多少 DRAM 流量,多少门,以及世界上每个解码器能否算出完全相同的比特。在这四点上,2026 年的神经解码器,相当于硬件 HEVC 第一批芯片出来之前的状态。
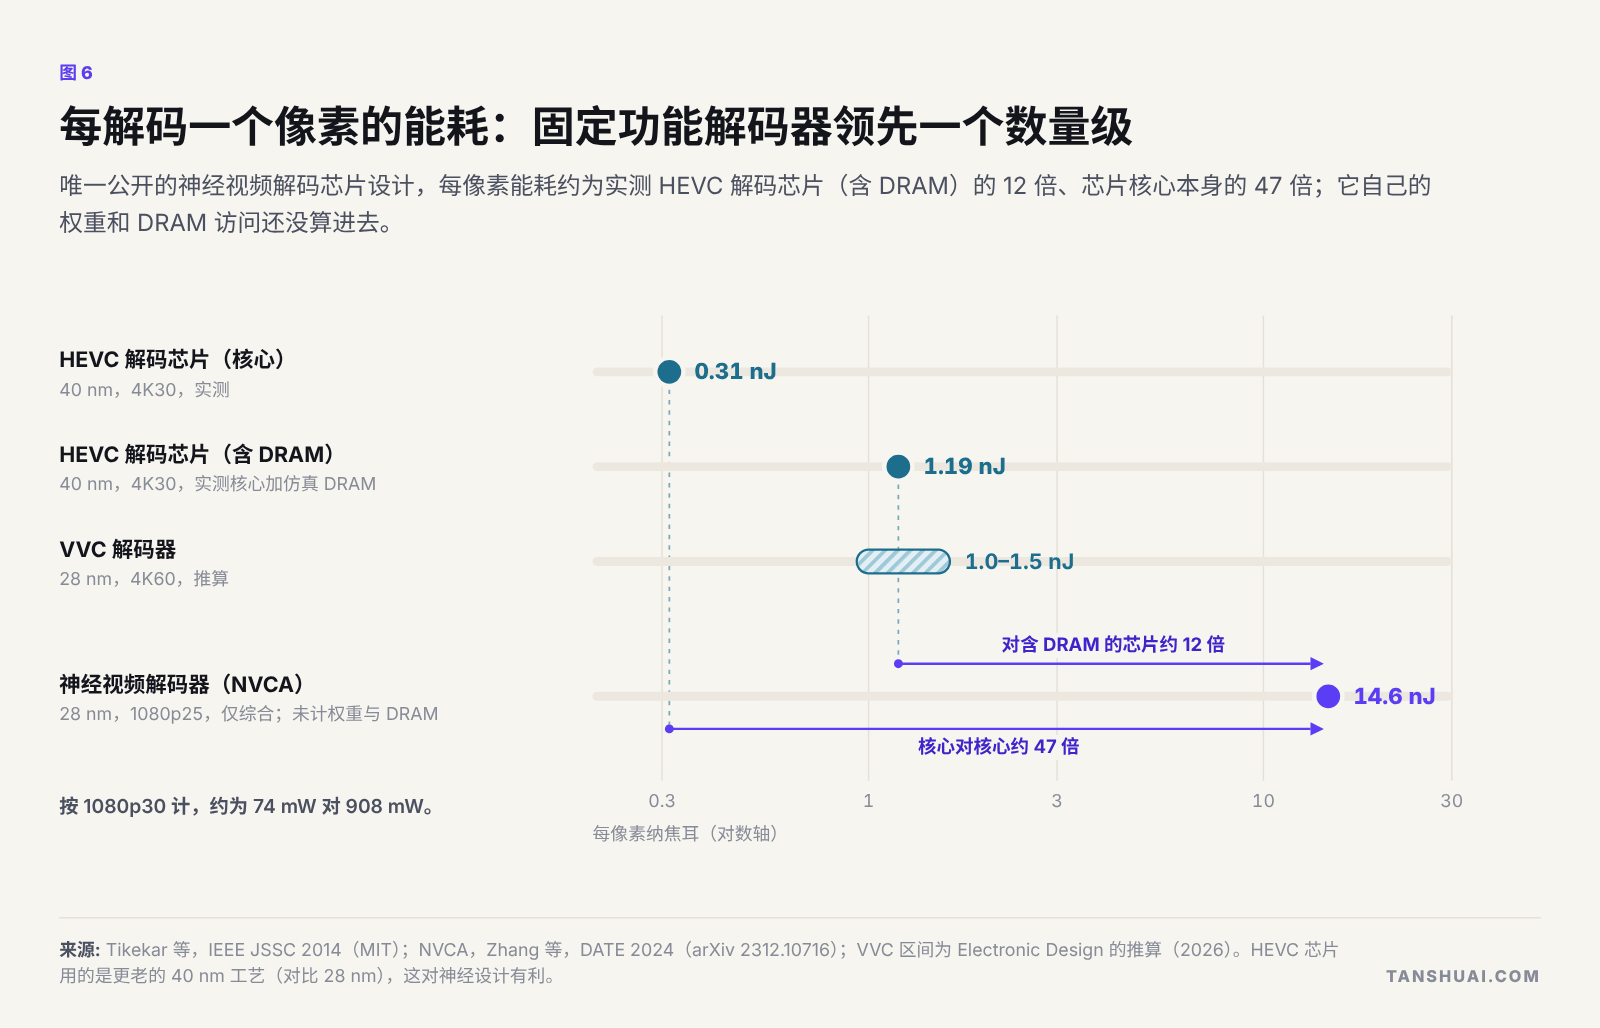 图 6:每解码一个像素的能耗:固定功能解码器领先一个数量级。
唯一公开的神经视频解码芯片设计 NVCA,每像素需要 14.6 纳焦;MIT 的 HEVC 解码芯片含 DRAM 为 1.19 纳焦,芯片核心本身 0.31 纳焦。按 1080p30 算,大约是 900 毫瓦对 74 毫瓦。微软速度很快的研究型编解码器 DCVC-RT,按我对它自己分模块数据的加总,每解码一个像素约需 17.5 万次乘加,1080p30 约需 22 TOPS:超过定义 AI PC 的 40 TOPS 的一半,只为一路视频。
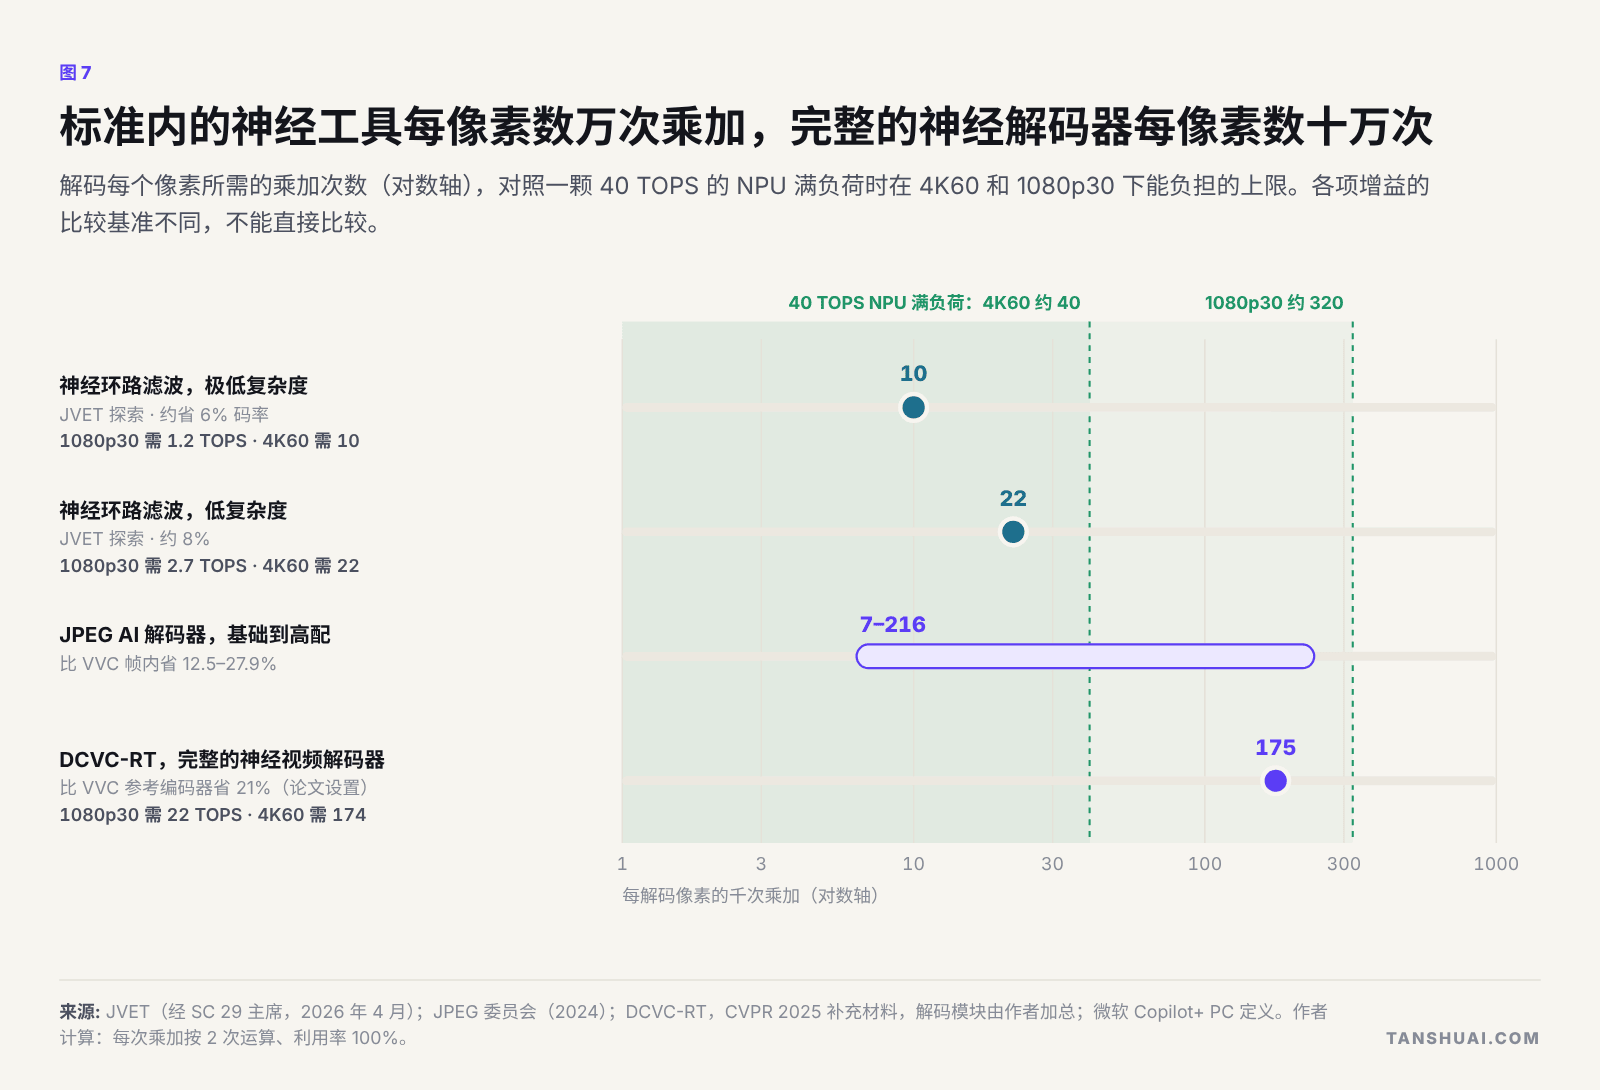 图 7:标准内的神经工具每像素数万次乘加,完整的神经解码器每像素数十万次。
还有两项成本很关键。访存:在 MIT 那颗芯片上,系统能耗约四分之三花在 DRAM 上,而神经解码器要在帧与帧之间保留庞大的特征图。精确性:只要两台设备算出的概率有一点不同,熵解码就会失败,这就是为什么严肃的神经编解码器如今都用整数运算,也是 MLVC 拿压缩率换取解码一致性的原因。
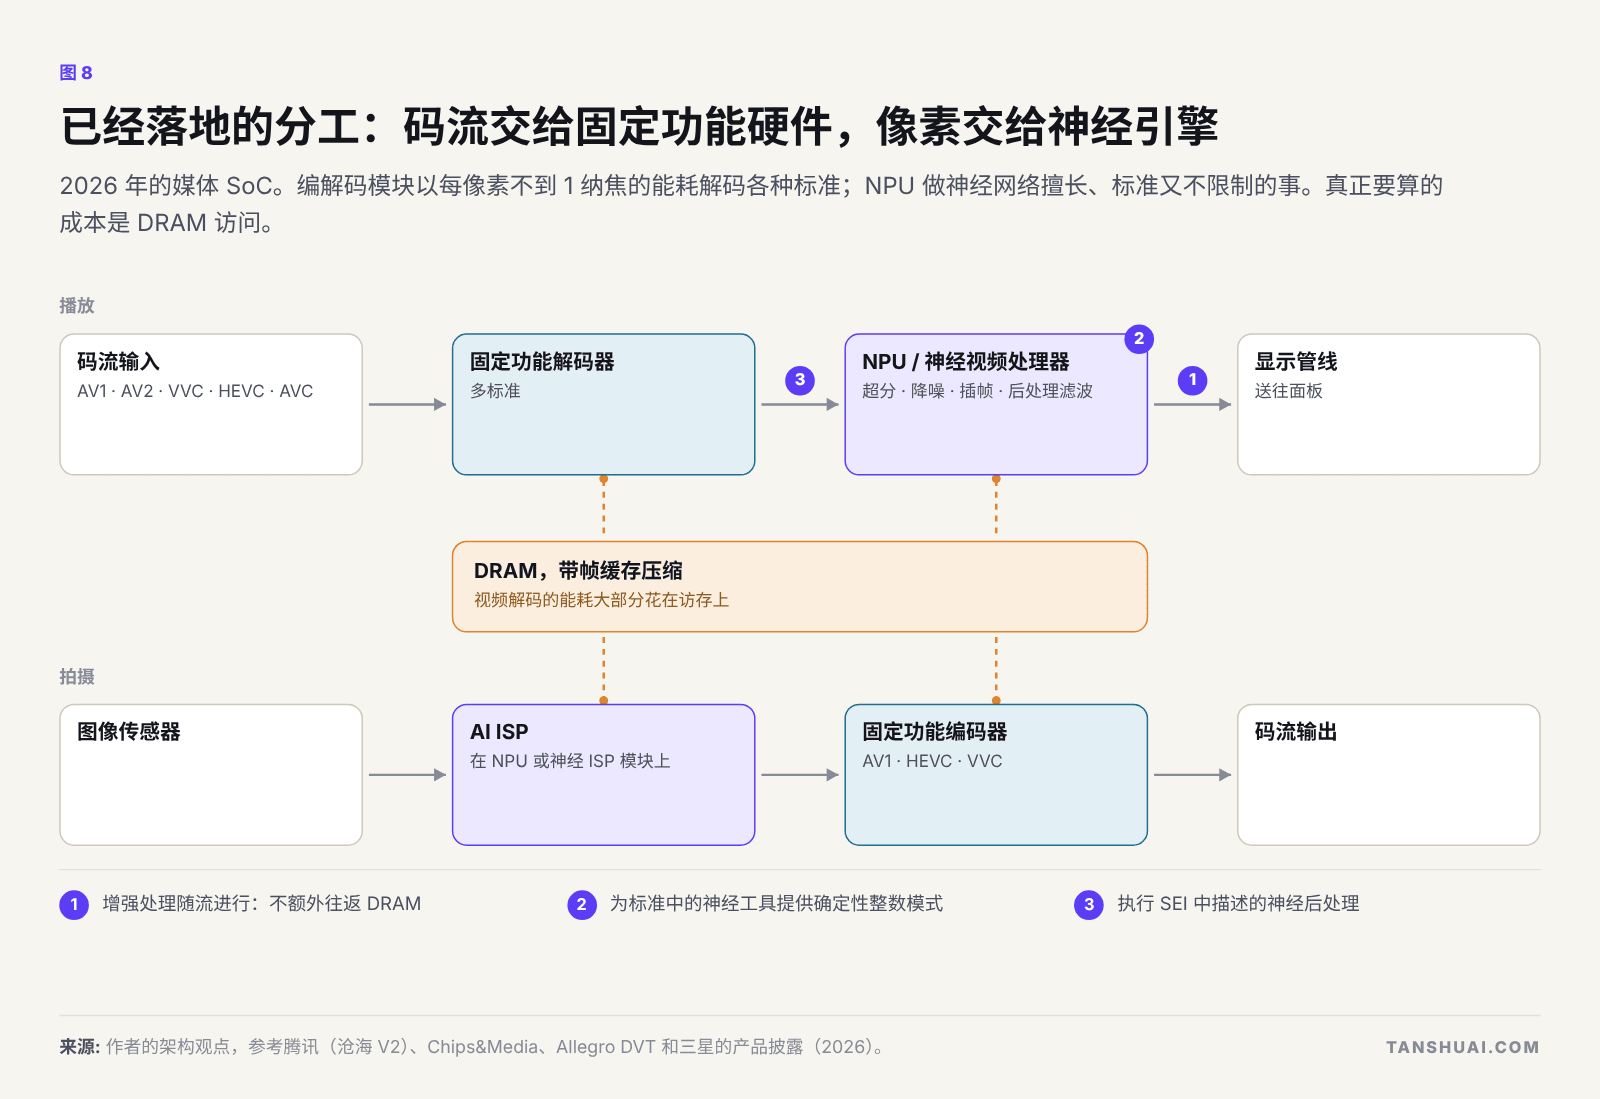 图 8:已经落地的分工:码流交给固定功能硬件,像素交给神经引擎。
卖得出去的芯片把两者配在一起。腾讯自研的沧海编解码芯片已部署超过 10 万片,第二代加入了 H.266 和片上超分;IP 供应商把编解码模块和视频 NPU 放在一起卖。如果现在由我规划一颗媒体 SoC:为每个必须支持的标准(包括 AV2)配固定功能解码器;NPU 按显示分辨率下的增强处理来定规模,并且不额外往返 DRAM;提供确定性的整数模式;把 H.267 当作 2029 年以后才开始的设计。
钱流向了谁,公司可以在哪里切入
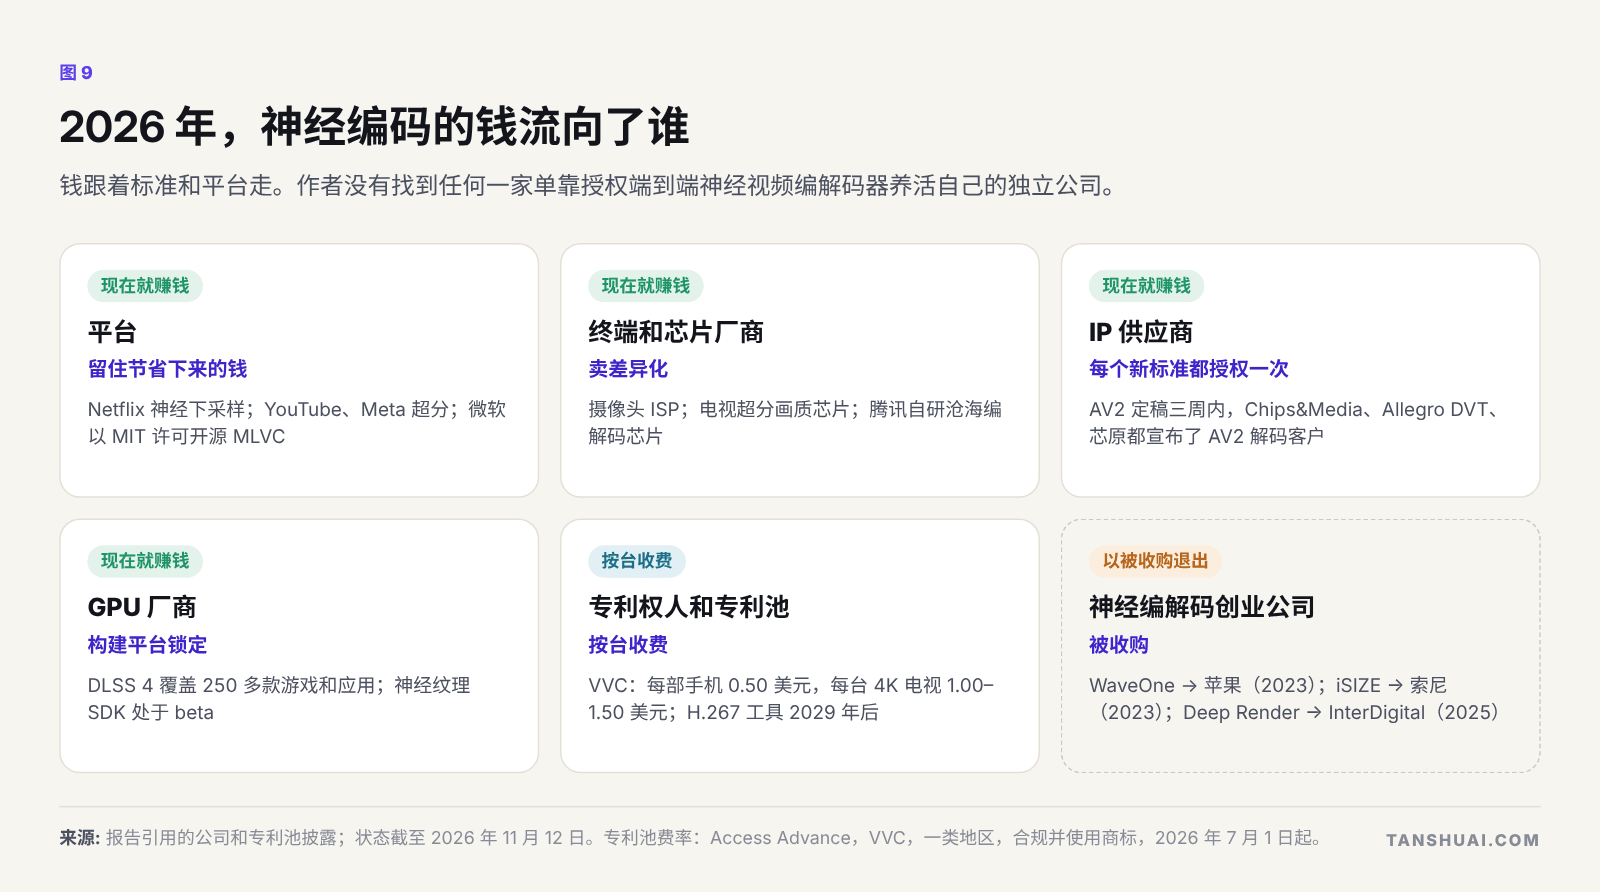 图 9:钱跟着标准和平台走。
平台留住节省下来的钱,有时还把代码送出去,比如微软开源 MLVC。IP 供应商为每个新标准授权解码器。专利池按台收费:VVC 在美国等一类地区,每部手机 0.50 美元(约 3.4 元),每台 4K 电视 1.00–1.50 美元(约 6.7–10.1 元)。WaveOne 被苹果收购,iSIZE 被索尼收购,Deep Render 被 InterDigital 收购。我没有找到任何一家单靠授权端到端神经视频编解码器养活自己的独立公司。
对公司来说,空间在于:为视频服务做神经前处理,为芯片厂做显示端增强,为会议和专网做闭环神经编解码器,做编解码器加 NPU 的芯片,以及所有交付神经工具的公司都需要的评测和一致性工具。参与 H.267 的标准工作,需要耐心和一套授权策略。
哪些说法要打折扣,接下来看什么
对任何神经编解码的说法,都问四件事:比较基准、指标、分辨率和解码代价。“节省 88%”是相对 H.264、在 360p 下;“显存减少 85–96%”是演示场景,已上市的游戏是 30%;“JPEG AI 是标准”,背后还没有产品。
值得关注的时间点:2027 年 1 月的 H.267 提案评估,2027 年初 YouTube 的首批 AV2 流,2027 年下半年 H.267 的第一个测试模型,MLVC 能否走出 Teams,第一个默认使用 JPEG AI 的产品,以及手机和 PC 的 NPU 算力。2029 年底 H.267 第一版发布,才是神经工具进入主流播放的芯片周期的起点。
下载完整报告和演示文稿
完整报告更详细地介绍了每个领域、芯片上的计算、标准和专利、一张说法与证据的对照表,以及全部资料来源。
开放问题
这里有几个问题还没有公开答案,也是我在技术上最感兴趣的:神经解码器要在不同厂商的 NPU 上做到逐比特一致的整数运算,要付出多少压缩优势;神经后处理每像素要占多少 DRAM 流量;一个神经工具的每像素代价到多少,在 H.267 解码器里就不再划算;除了通话,还有哪些闭环系统能最先用上端到端神经编解码器;以及当解码器开始“生成”细节而不是重建细节时,保真度该怎么衡量。
未来在这些领域,我们可以一起探讨,包括技术交流和技术合作:i@tanshuai.com。
关于作者
谭帅,技术专家和创业者,在芯片、硬件和系统软件领域工作二十多年,拥有 20 项授权专利。他有多年无晶圆厂芯片研发和管理经验,包括全定制 ASIC 数据通路设计,以及视频编解码加速器等多媒体摄像头芯片项目。他的工作经历遍及硅谷、纽约、芝加哥、台湾地区、粤港澳大湾区(深圳和香港)、越南和马来西亚。如今他是一名 AI 研发者。
技术交流:i@tanshuai.com。