
โครงข่ายประสาทเทียมมีส่วนกำหนดหน้าตาของวิดีโอเกือบทุกเรื่องที่คุณดูอยู่แล้ว แต่ทำงานที่สองปลายของโคเดกมาตรฐาน ไม่ได้มาแทนโคเดก บทความนี้สรุปว่าการเข้ารหัสแบบนิวรัลใช้งานจริงที่ไหนในปี 2026 ต้นทุนบนซิลิคอนเป็นเท่าไร และใครได้เงิน พร้อมรายงานฉบับเต็มและสไลด์
บทคัดย่อ
ในปี 2026 การเข้ารหัสแบบนิวรัลเป็นกระแสหลักแล้ว แต่ทำงานรอบโคเดกมาตรฐานแทนที่จะมาแทนโคเดกเหล่านั้น โครงข่ายประสาทเทียมปรับแต่งภาพก่อนการเข้ารหัส ทั้งในกล้องโทรศัพท์และในไปป์ไลน์การเข้ารหัสของ Netflix และซ่อมภาพหลังการถอดรหัส ทั้งใน Super Resolution ของ YouTube ที่ Meta และในชิปประมวลผลภาพของทีวี บิตสตรีมที่อยู่ตรงกลางยังคงเป็น AV1, HEVC, AVC หรือ VVC ที่ถอดรหัสด้วยฮาร์ดแวร์ฟังก์ชันตายตัว โคเดกนิวรัลแบบ end-to-end ใช้งานจริงเฉพาะในวงปิดที่บริษัทเดียวควบคุมทั้งสองฝั่ง ได้แก่ MLVC ของ Microsoft ในการโทรผ่าน Teams, tokenizer ภายในโมเดลเสียงพูดและวิดีโอทุกตัว และเท็กซ์เจอร์นิวรัลในเกมหนึ่งเกม การเล่นบิตสตรีมนิวรัลในวงกว้างต้องรอ H.267 ซึ่งมีกำหนดสิ้นปี 2029 และรอบการพัฒนาชิปที่ตามมา เหตุผลอยู่ที่ชิป: การออกแบบตัวถอดรหัสวิดีโอนิวรัลเพียงแบบเดียวที่มีการเผยแพร่ใช้พลังงานต่อพิกเซลราว 12 เท่าของตัวถอดรหัส HEVC ที่วัดจริง และโคเดกเชิงวิจัยที่เร็วตัวหนึ่งต้องใช้ราว 22 TOPS สำหรับ 1080p30 เงินไหลตามมาตรฐานและแพลตฟอร์ม ส่วนสตาร์ตอัปโคเดกนิวรัลที่มีชื่อเสียงที่สุดถูกซื้อกิจการไปแล้ว
ทำไมผมจึงศึกษาเรื่องนี้
ทุก ๆ ไม่กี่เดือนจะมีคนบอกผมว่าโคเดก AI กำลังจะมาแทน H.264, HEVC และ AV1 สิ่งที่ผมอ่านเกี่ยวกับเรื่องนี้ส่วนใหญ่มาจากบทความวิจัย ซึ่งเป็นที่อยู่ของสถิติการบีบอัด ไม่ก็มาจากผู้ขาย ทั้งสองแหล่งแทบไม่บอกว่าอะไรใช้งานจริงแล้ว ใช้กับใคร และด้วยต้นทุนเท่าไร
ผมมีประสบการณ์หลายปีในงานวิจัยและพัฒนาและการบริหารชิปแบบ fabless รวมถึงการออกแบบ datapath ของ ASIC แบบ full-custom และโครงการชิปกล้องมัลติมีเดีย เช่น ตัวเร่งโคเดกวิดีโอ ผมจึงมองเรื่องนี้แบบเดียวกับที่รีวิวชิป: พลังงานต่อพิกเซล ทราฟฟิกหน่วยความจำ สิ่งที่มาตรฐานยอมให้ตรึงไว้ในซิลิคอน และใครเป็นผู้จ่าย ผมอ่านเอกสารมาตรฐานและรายงานการประชุมจาก JVET, MPEG, JPEG, AOMedia และ IETF บล็อกวิศวกรรมของบริษัท บทความวิจัยด้านชิป ตารางอัตราค่าสิทธิของกลุ่มสิทธิบัตร ตัวบทกฎหมายควบคุมการส่งออก และข่าว ตัวเลขทุกตัวด้านล่างเป็นข้อมูล ณ วันที่ 12 พฤศจิกายน 2026 และจำนวนเงินเป็นดอลลาร์สหรัฐ รายงานฉบับเต็มพร้อมแหล่งข้อมูลทั้งหมดอยู่ท้ายบทความ
สรุปผลโดยย่อ
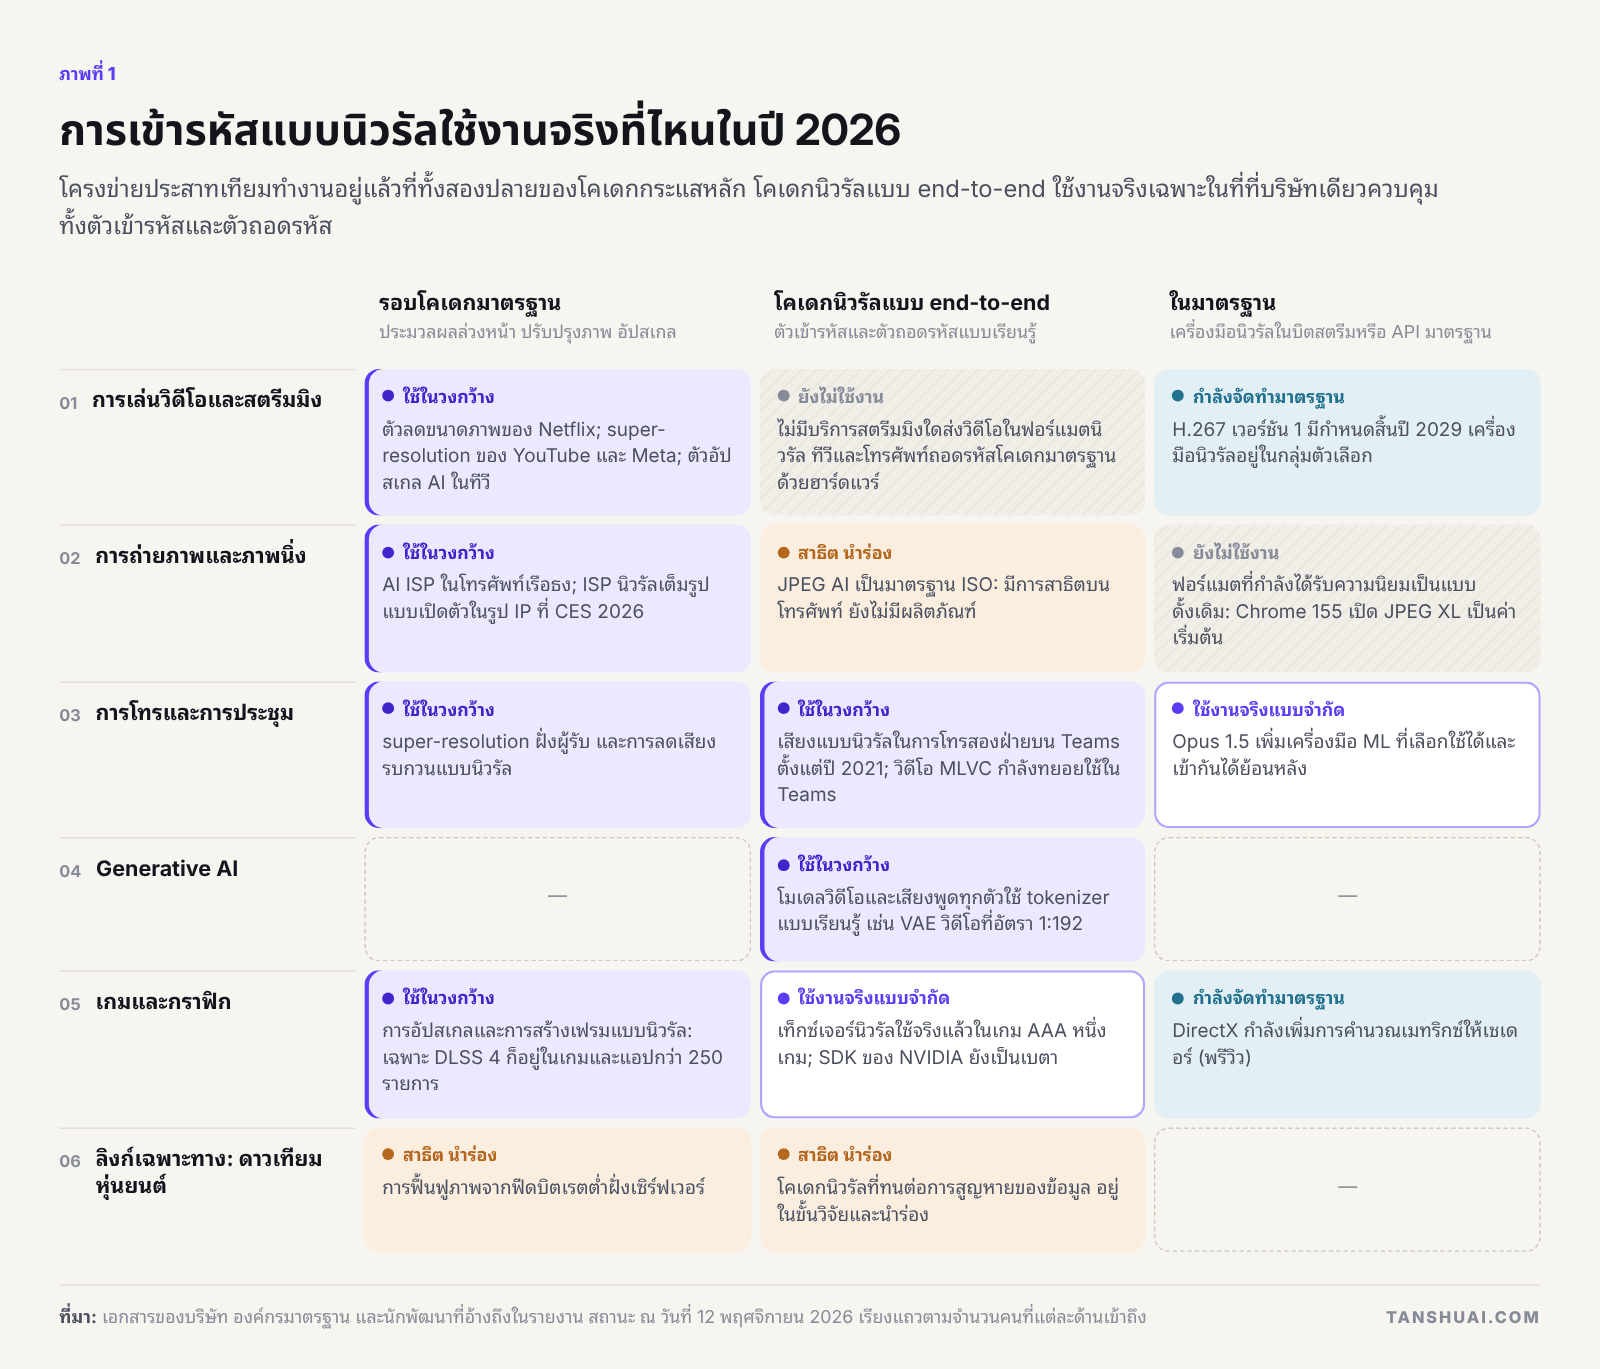 ภาพที่ 1 การเข้ารหัสแบบนิวรัลใช้งานจริงที่ไหนในปี 2026 เรียงแถวตามจำนวนคนที่แต่ละด้านเข้าถึง
| คำถาม | คำตอบสั้น ๆ |
|---|---|
| การเข้ารหัสแบบนิวรัลใช้งานจริงในวงกว้างที่ไหน? | รอบโคเดก: ISP ของกล้อง การลดขนาดภาพฝั่งเข้ารหัส และ super-resolution ฝั่งเล่นวิดีโอ ส่วนแบบ end-to-end มีเฉพาะในวงปิด: การโทร แอสเซตเกม และ tokenizer ของ Generative AI |
| โคเดกนิวรัลจะมาแทน AV1, HEVC และ VVC ในการเล่นวิดีโอหรือไม่? | ไม่ใช่ก่อน H.267 (เวอร์ชัน 1 สิ้นปี 2029) และรอบการเปลี่ยนอุปกรณ์หลังจากนั้น ผมประมาณว่าจะเข้าสู่กระแสหลักในกลางทศวรรษ 2030 |
| ต้นทุนบนซิลิคอนเป็นเท่าไร? | พลังงานต่อพิกเซลราว 12 เท่าของตัวถอดรหัส HEVC แบบฮาร์ดแวร์ บวกทราฟฟิกหน่วยความจำ และข้อกำหนดให้ถอดรหัสได้ตรงกันทุกบิต |
| ใครได้เงิน? | แพลตฟอร์มเก็บส่วนที่ประหยัดได้ไว้เอง ผู้ขาย IP และกลุ่มสิทธิบัตรได้เงินต่อการออกแบบและต่อเครื่อง ส่วนสตาร์ตอัปโคเดกนิวรัลถูกซื้อกิจการ |
| บริษัทจะเข้าไปเล่นตรงไหนได้? | การประมวลผลล่วงหน้าและภายหลังแบบนิวรัล ผลิตภัณฑ์แบบวงปิด ซิลิคอนโคเดกบวก NPU และงานประเมินผลกับงานมาตรฐานที่อยู่ระหว่างกลาง |
สามทางเข้า
“การเข้ารหัสแบบนิวรัล” ครอบคลุมสามเรื่องที่ต่างกัน และข้อถกเถียงส่วนใหญ่เกิดจากการเอาสามเรื่องนี้มาปนกัน โครงข่ายอาจทำงานรอบโคเดกมาตรฐาน คือประมวลผลพิกเซลก่อนการเข้ารหัสหรือหลังการถอดรหัส โดยบิตสตรีมยังเป็นแบบมาตรฐาน อาจอยู่ในมาตรฐาน เป็นเครื่องมือที่ตัวถอดรหัสทุกตัวต้องรัน ซึ่งหมายความว่าต้องกำหนดสเปกไว้อย่างแม่นยำ หรืออาจมาแทนโคเดกแบบ end-to-end ด้วยตัวเข้ารหัสและตัวถอดรหัสแบบเรียนรู้ที่ทำงานได้เฉพาะเมื่อใช้คู่กัน
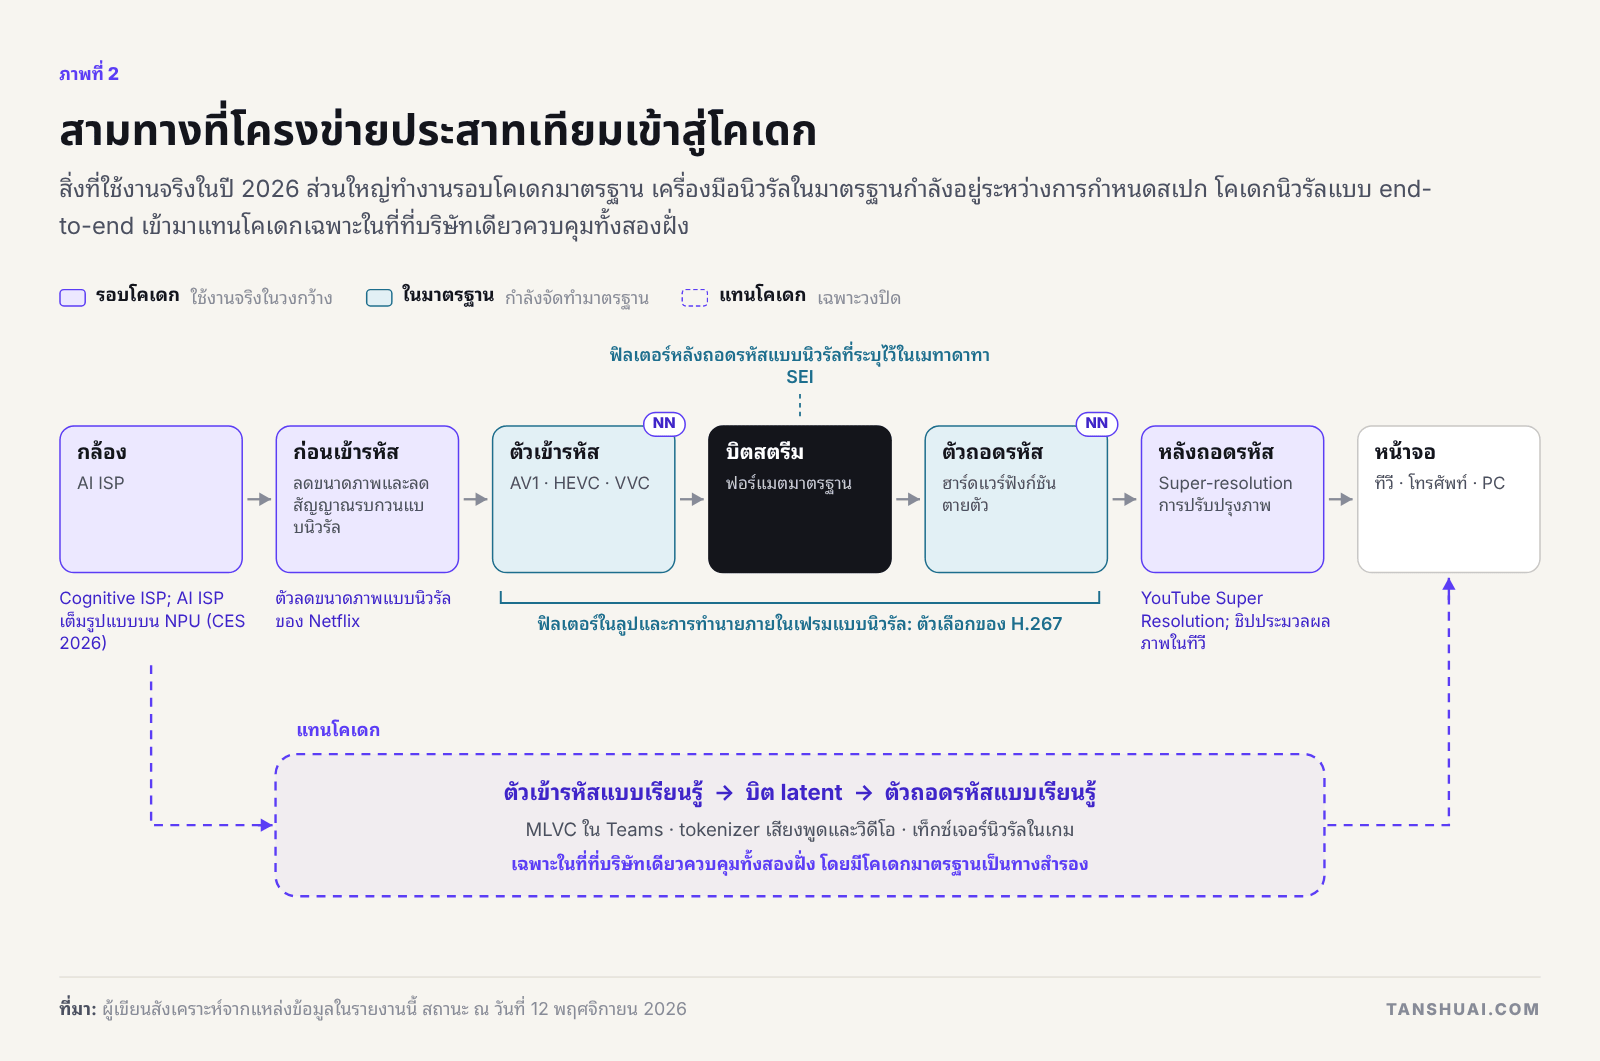 ภาพที่ 2 สามทางที่โครงข่ายประสาทเทียมเข้าสู่โคเดก สิ่งที่ใช้งานจริงในปี 2026 ส่วนใหญ่เป็นแบบแรก
แบบแรกไม่ต้องขออนุญาตใคร แบบที่สองต้องมีมาตรฐาน แบบที่สามต้องควบคุมทั้งสองฝั่ง นี่คือลำดับที่ทั้งสามแบบเข้าถึงผู้คน
การเล่นวิดีโอและสตรีมมิง: นิวรัลที่สองปลาย มาตรฐานตรงกลาง
บริการรายใหญ่เปลี่ยนผ่านโคเดกรอบหนึ่งเสร็จแล้วและกำลังเริ่มรอบถัดไป และไม่มีรอบใดเกี่ยวกับตัวถอดรหัสนิวรัล Netflix รายงานในเดือนธันวาคม 2025 ว่า AV1 รองรับการรับชมราว 30% ของทั้งหมด YouTube ระบุว่าคลังวิดีโอกว่า 90% เมื่อถ่วงน้ำหนักด้วยเวลารับชม มีให้บริการในรูปแบบ AV1 AV2 เสร็จเมื่อวันที่ 28 พฤษภาคม 2026 โดยบีบอัดได้ดีกว่า AV1 ราว 30% และภายในสามสัปดาห์ Chips&Media, Allegro DVT และ VeriSilicon ก็ประกาศว่ามีลูกค้าตัวถอดรหัส AV2 แล้ว TV 3.0 ของบราซิลเริ่มออกอากาศ VVC เชิงพาณิชย์ในเดือนมิถุนายน 2026
ส่วนที่เป็นนิวรัลอยู่ที่ทั้งสองปลาย ตั้งแต่ปี 2022 Netflix ใช้โครงข่ายประสาทเทียมขนาดเล็กแทนฟิลเตอร์แบบเดิมในการลดขนาดภาพต้นฉบับ ซึ่งไม่ต้องเปลี่ยนอะไรบนอุปกรณ์ใดเลย และผู้ชมราว 77% ชอบผลลัพธ์นี้มากกว่าในการทดสอบของ Netflix YouTube อัปสเกลวิดีโอที่อัปโหลดด้วยความละเอียดต่ำกว่า 1080p ด้วยแมชชีนเลิร์นนิงบนทีวี Meta รัน super-resolution ทั้งบนเซิร์ฟเวอร์และบนโทรศัพท์ และชิปประมวลผลภาพในทีวีเรือธงของ Samsung โฆษณาว่ามีโครงข่ายอัปสเกล 768 ชุด
สิ่งที่ยังไม่มีคือบิตสตรีมนิวรัลบนจอกระแสหลัก และเหตุผลคือเวลา ฟอร์แมตสำหรับการเล่นวิดีโอต้องถอดรหัสได้บนทุกอุปกรณ์ที่จะเล่นมัน AV1 ใช้เวลาเกือบแปดปีจากสเปกที่เสร็จสมบูรณ์จนถึงสัดส่วน 30% ของการรับชม Netflix
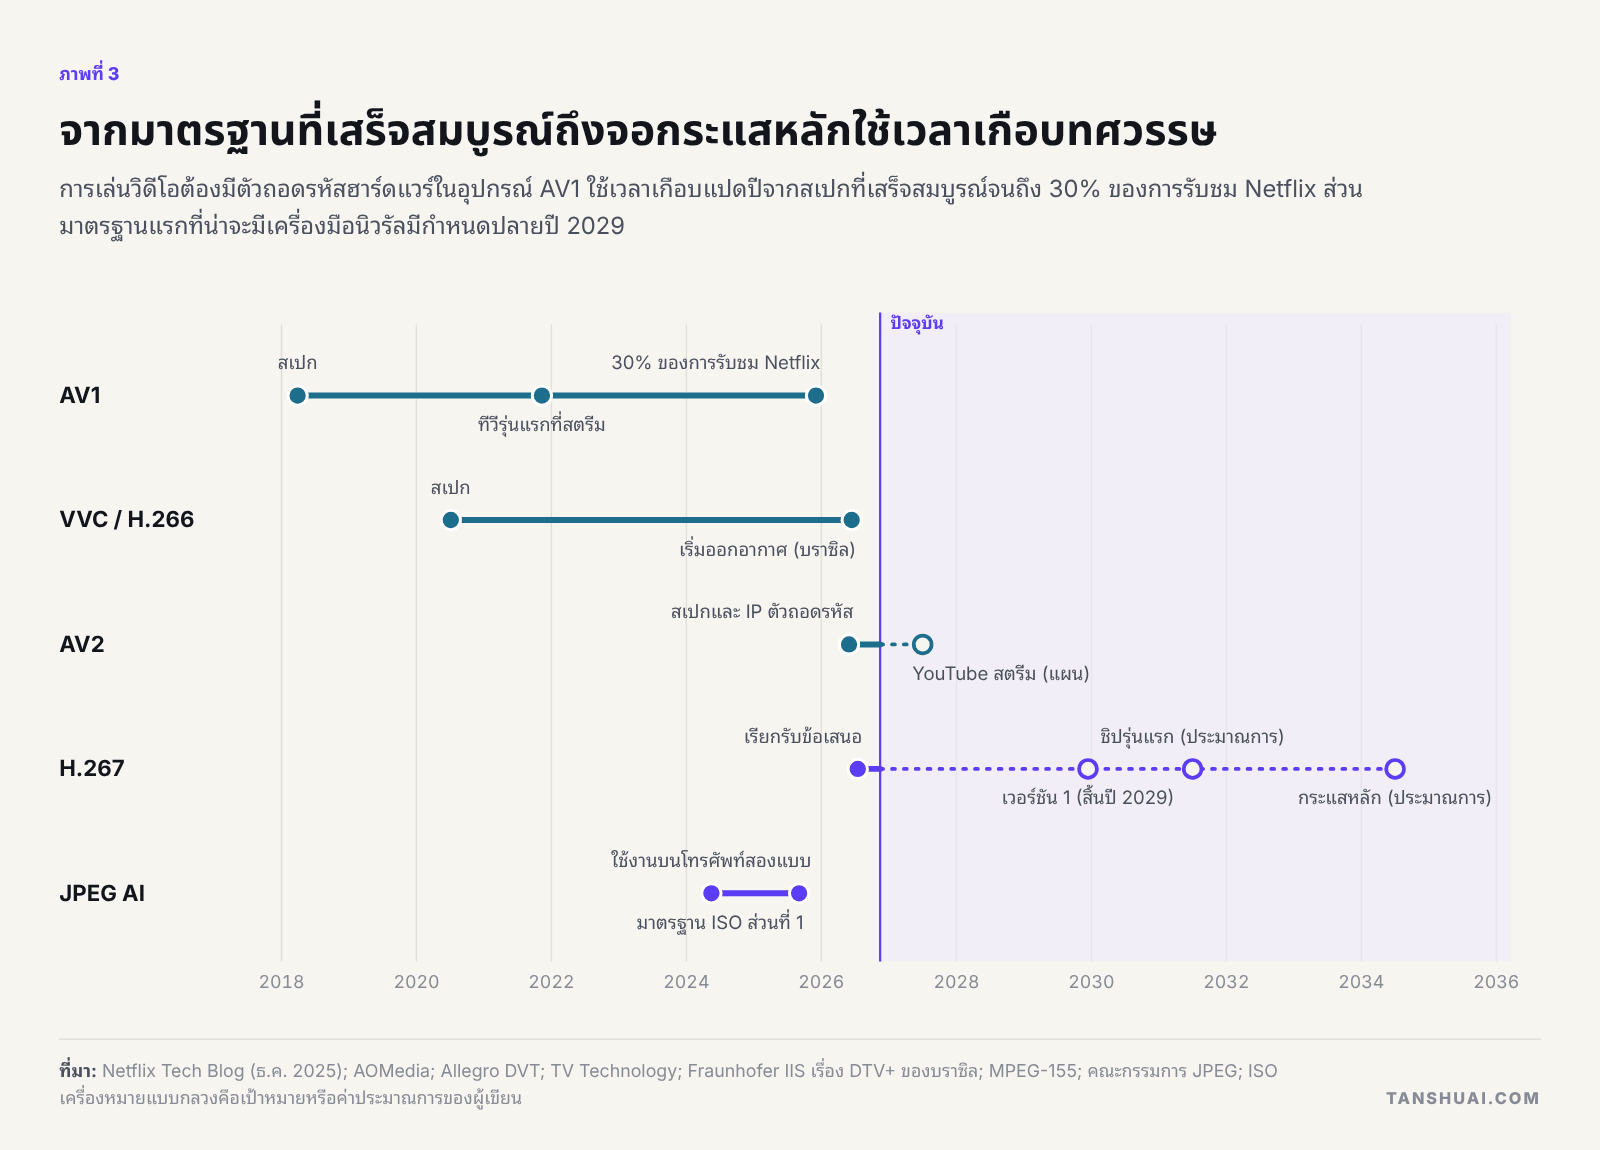 ภาพที่ 3 จากมาตรฐานที่เสร็จสมบูรณ์ถึงจอกระแสหลักใช้เวลาเกือบทศวรรษ
มาตรฐานที่อาจนำเครื่องมือนิวรัลไปสู่ทุกหน้าจอคือ H.267 ชื่อชั่วคราวของมาตรฐานรุ่นถัดจาก VVC JVET ออกประกาศเรียกรับข้อเสนอในเดือนกรกฎาคม 2026 จะประเมินข้อเสนอในเดือนมกราคม 2027 และเวอร์ชันแรกมีกำหนดสิ้นปี 2029 แนวทางแบบดั้งเดิมประหยัดได้ราว 28% เมื่อเทียบกับ VVC อยู่แล้ว ขณะที่ฟิลเตอร์ในลูปแบบนิวรัลของ JVET ประหยัดได้ 6–14% ด้วยต้นทุนของตัวถอดรหัสตั้งแต่ 10,000 MAC ต่อพิกเซลขึ้นไป ผมคาดว่าจะได้แกนแบบดั้งเดิมที่มีเครื่องมือนิวรัลไม่กี่ตัว เฉพาะในจุดที่บิตที่ประหยัดได้คุ้มกับต้นทุน
การถ่ายภาพ: นิวรัลในกล้อง แบบดั้งเดิมบนเว็บ
ภาพถ่ายทุกภาพจากโทรศัพท์เรือธงรุ่นใหม่ ๆ ผ่านโครงข่ายประสาทเทียมมาก่อนจะถูกบันทึก Cognitive ISP ของ Qualcomm ทำการแบ่งส่วนภาพเชิงความหมายแบบเรียลไทม์มาตั้งแต่ปี 2023 และที่ CES 2026 Chips&Media กับ Visionary.ai จัดแสดง ISP เต็มรูปแบบที่รันทั้งหมดบน NPU จากนั้นผลลัพธ์จึงถูกบันทึกเป็น JPEG หรือ HEIF
JPEG AI มาตรฐานภาพแบบเรียนรู้ฉบับแรก เผยแพร่ในปี 2025 โดยบีบอัดได้ดีกว่า VVC แบบ intra 12.5–27.9% ด้วยต้นทุนของตัวถอดรหัส 7,000 ถึง 216,000 MAC ต่อพิกเซล ผมไม่พบกล้อง แอปแกลเลอรี หรือเบราว์เซอร์ใดที่ใช้ JPEG AI เป็นค่าเริ่มต้น ฟอร์แมตที่เว็บเลือกใช้ในปี 2026 เป็นแบบดั้งเดิม: Chrome 155 เปิดใช้ JPEG XL เมื่อวันที่ 6 ตุลาคม พร้อมตัวถอดรหัสที่เร็ว ปลอดภัยด้านหน่วยความจำ และรันได้บน CPU ใดก็ได้ การเข้ารหัสแบบนิวรัลชนะภายในไปป์ไลน์ของบริษัทเดียว ส่วนฟอร์แมตที่ต้องเปิดได้ทุกที่ยังคงเป็นแบบดั้งเดิม
การโทร: ที่ที่โคเดกนิวรัลแบบ end-to-end ใช้งานจริง
การโทรคือวงปิด: ทั้งสองฝั่งรันแอปเดียวกันและถอยกลับไปใช้โคเดกมาตรฐานได้กลางสาย นี่คือเหตุที่โคเดกนิวรัลแบบ end-to-end กลุ่มแรกที่ใช้ในวงกว้างอยู่ตรงนี้ Satin โคเดกเสียงพูด AI ของ Microsoft ใช้ในการโทรสองฝ่ายทั้งหมดบน Teams และ Skype มาตั้งแต่ปี 2021 ในเดือนกรกฎาคม 2026 Microsoft เปิดซอร์ส MLVC โคเดกวิดีโอนิวรัลที่กำลังทยอยใช้ในการโทรแบบ peer-to-peer บน Teams
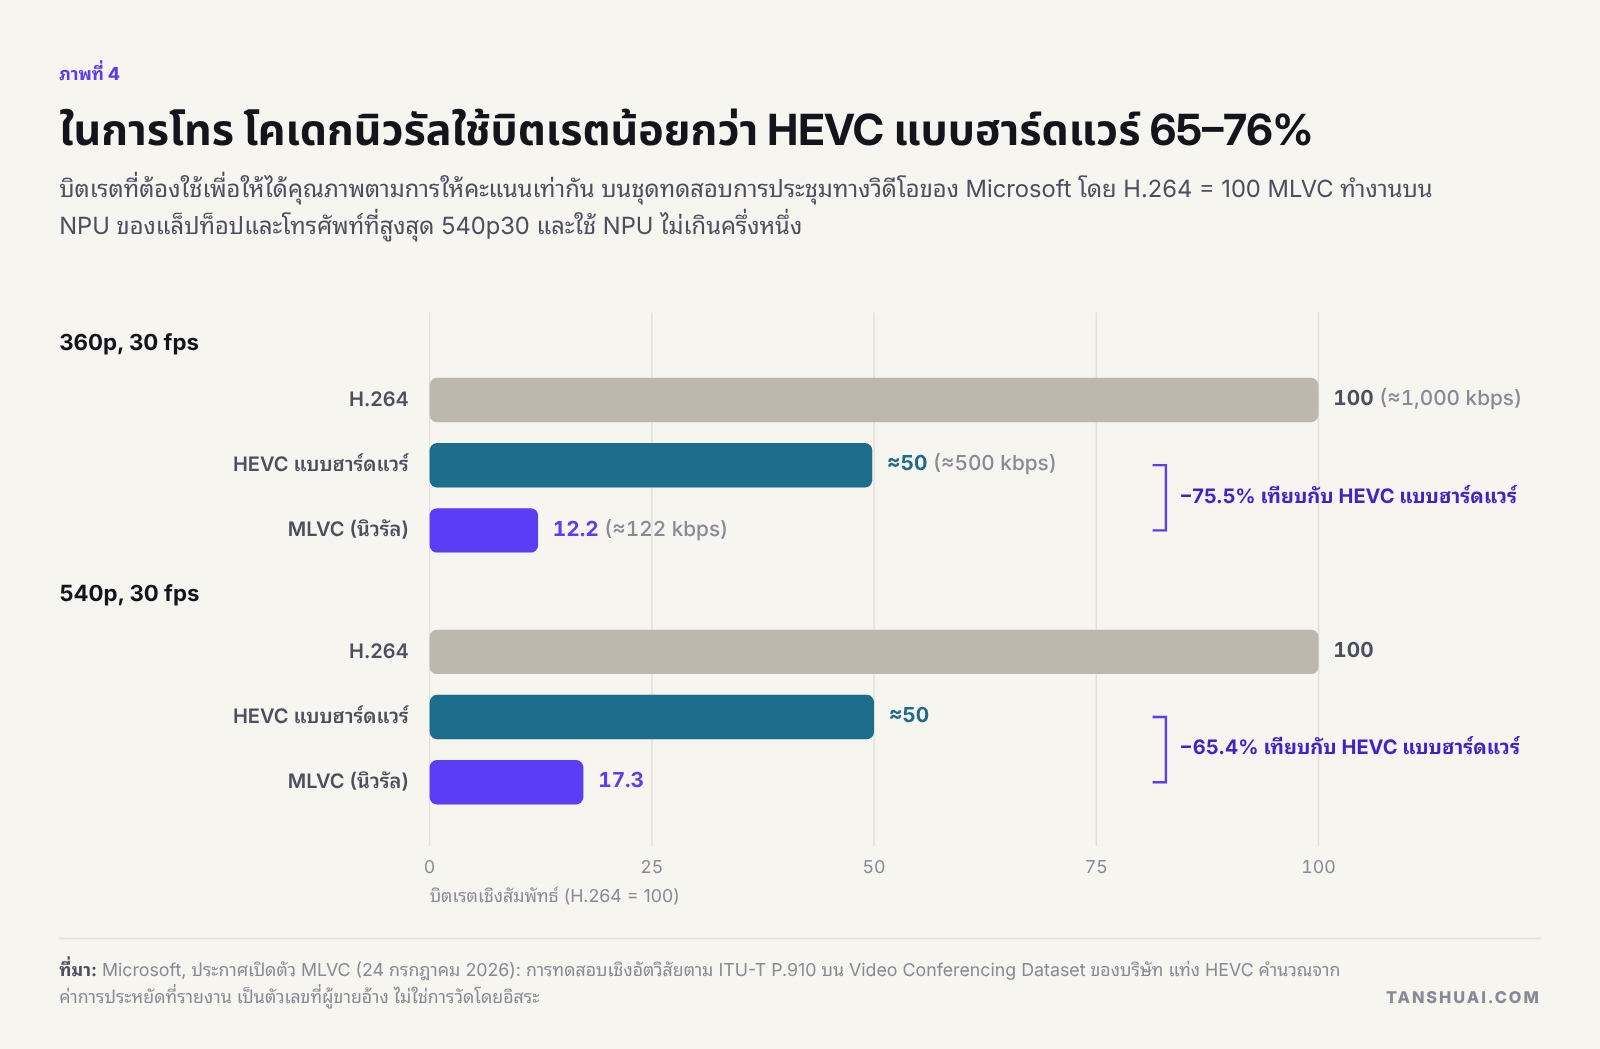 ภาพที่ 4 ในการโทร โคเดกนิวรัลใช้บิตเรตน้อยกว่า HEVC แบบฮาร์ดแวร์ 65–76% บนชุดทดสอบของ Microsoft เอง
ตัวเลขพาดหัว 88% เทียบกับ H.264 หากเทียบกับ HEVC แบบฮาร์ดแวร์ที่มีอยู่แล้วในแล็ปท็อปเครื่องเดียวกัน จะเหลือ 65–76% ซึ่งยังถือว่ามาก MLVC ทำงานที่ 540p และ 360p โดยใช้ NPU ไม่เกินครึ่งหนึ่ง และยอมสละประสิทธิภาพการบีบอัดบางส่วนเพื่อให้ถอดรหัสได้ผลเหมือนกันบนฮาร์ดแวร์ที่ Microsoft ไม่ได้เป็นเจ้าของ
ไม่ใช่ทุกรายที่เลือกเส้นทางนี้ Opus เพิ่มดีปเลิร์นนิงในปี 2024 ในรูปส่วนเสริมที่เลือกใช้ได้และเข้ากันได้ย้อนหลัง Meta สร้าง MLow ซึ่งเป็นโคเดกเสียงพูดแบบดั้งเดิม เพราะการโทรของบริษัทกว่า 20% ทำบนโทรศัพท์ ARMv7 รุ่นเก่า และการโทรผ่าน WhatsApp หลายสิบล้านครั้งต่อวันทำบนโทรศัพท์อายุเกินสิบปี โคเดกนิวรัลจะใช้งานจริงก่อนในที่ที่อุปกรณ์เป็นรุ่นใหม่และผู้ขายรายเดียวควบคุมทั้งสองฝั่ง
Generative AI: การใช้งานที่ใหญ่ที่สุดซึ่งไม่มีใครเรียกว่าโคเดก
โมเดลเสียงพูดและวิดีโอทุกตัวทำงานบนโคเดกแบบเรียนรู้ โมเดลเสียงพูดอ่านและเขียนโทเค็นของโคเดกเสียงแบบนิวรัล เช่น Mimi ของ Kyutai ที่ 12.5 เฟรมต่อวินาทีและ 1.1 kbps ส่วนตัวสร้างวิดีโอทำงานใน latent space ของ video autoencoder เช่นของ LTX-Video ซึ่งบีบอัดที่อัตรา 1:192 ไม่มีตัวใดเป็นฟอร์แมตที่คนอื่นถอดรหัส แต่ทั้งหมดพิสูจน์ว่าการบีบอัดแบบเรียนรู้ใช้ได้ในวงกว้างเมื่อบริษัทเดียวเป็นเจ้าของทั้งตัวเข้ารหัส ตัวถอดรหัส และฮาร์ดแวร์ สำหรับใครก็ตามที่ให้บริการวิดีโอจาก Generative AI ประสิทธิภาพของ tokenizer คือรายการต้นทุนโดยตรง
เกม: การสร้างภาพขึ้นใหม่แบบนิวรัลเป็นกระแสหลักแล้ว แอสเซตนิวรัลกำลังเริ่มต้น
DLSS ของ NVIDIA เรนเดอร์พิกเซลและเฟรมน้อยลง แล้วให้โครงข่ายสร้างส่วนที่เหลือขึ้นใหม่ การบีบอัดเท็กซ์เจอร์แบบนิวรัลใช้งานจริงแล้วใน Assassin's Creed Mirage โดยใช้เฉพาะกับแอสเซตที่เลือกไว้ เพราะต้นทุนขณะรัน
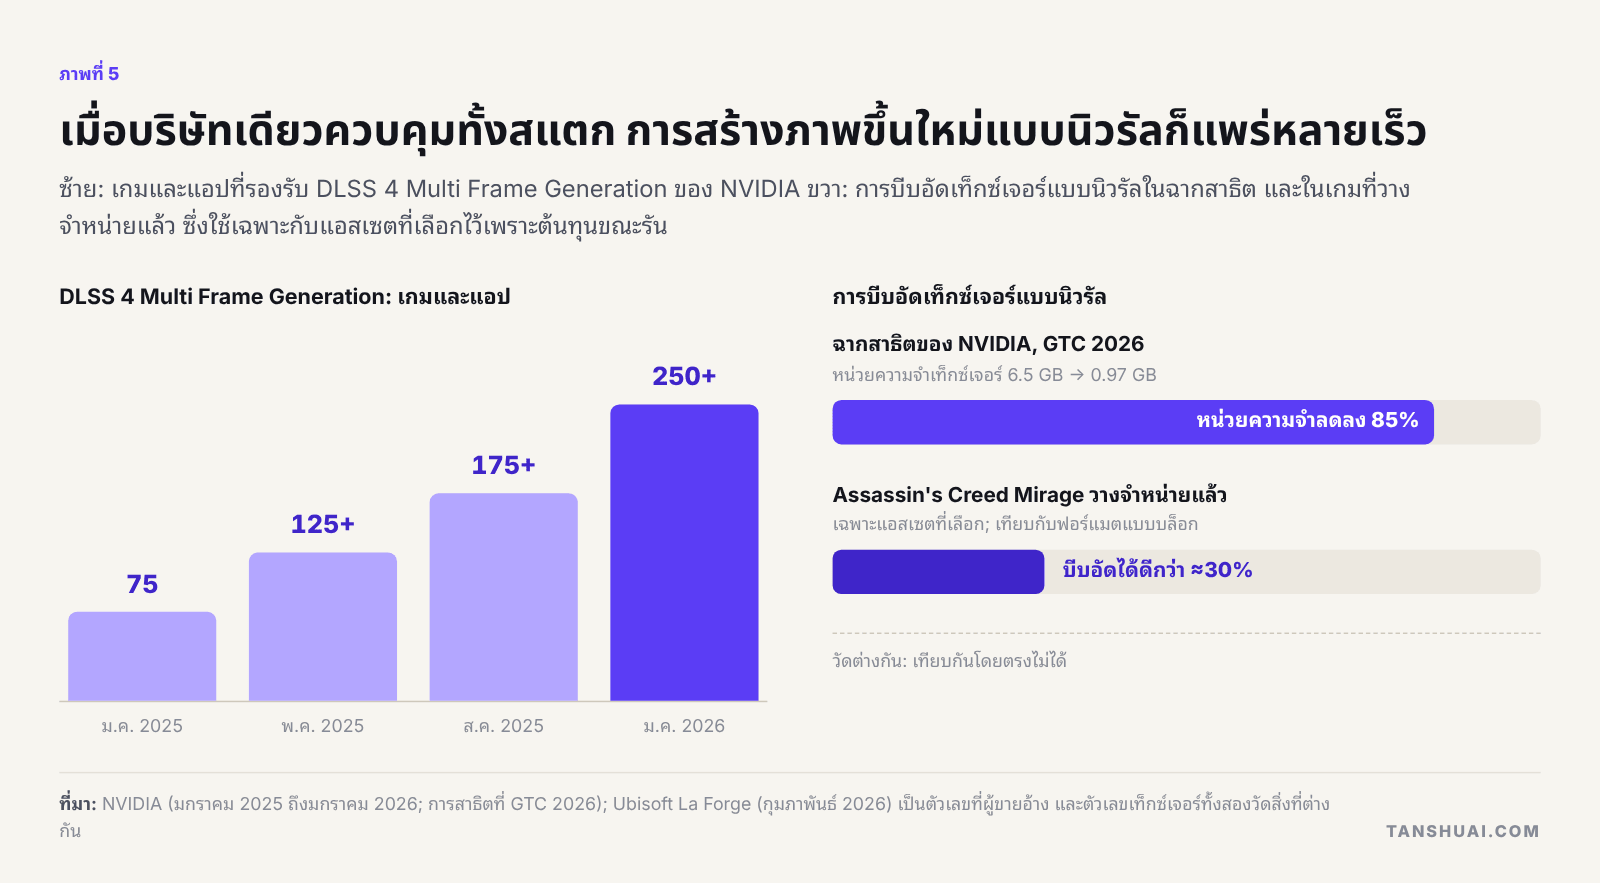 ภาพที่ 5 เมื่อบริษัทเดียวควบคุมทั้งสแตก การสร้างภาพขึ้นใหม่แบบนิวรัลก็แพร่หลายเร็ว
ลิงก์ของดาวเทียม โดรน และหุ่นยนต์เหมาะกับโคเดกนิวรัลแบบ end-to-end ที่สุดในทางเทคนิค แต่เป็นตลาดเล็ก และถูกควบคุมการส่งออกเข้มขึ้นเรื่อย ๆ ทั้งสองฝั่ง: กฎควบคุมการส่งออกโดรนของจีนที่มีผลตั้งแต่วันที่ 18 พฤศจิกายน 2026 ถึงกับระบุการบีบอัดภาพเชิงความหมายเป็นเกณฑ์หนึ่ง
มุมมองด้านซิลิคอน
ตรงนี้คือจุดที่ภูมิหลังของผมมีความหมายมากที่สุด ทีมชิปถามสี่คำถามกับโคเดกใหม่ทุกตัว: กี่จูลต่อพิกเซล ทราฟฟิก DRAM ต่อพิกเซลเท่าไร ใช้กี่เกต และตัวถอดรหัสทุกตัวในโลกคำนวณได้บิตเดียวกันทุกบิตหรือไม่ ในทั้งสี่ข้อ ตัวถอดรหัสนิวรัลในปี 2026 อยู่ในจุดเดียวกับที่ HEVC แบบฮาร์ดแวร์เคยอยู่ก่อนจะมีชิปรุ่นแรก
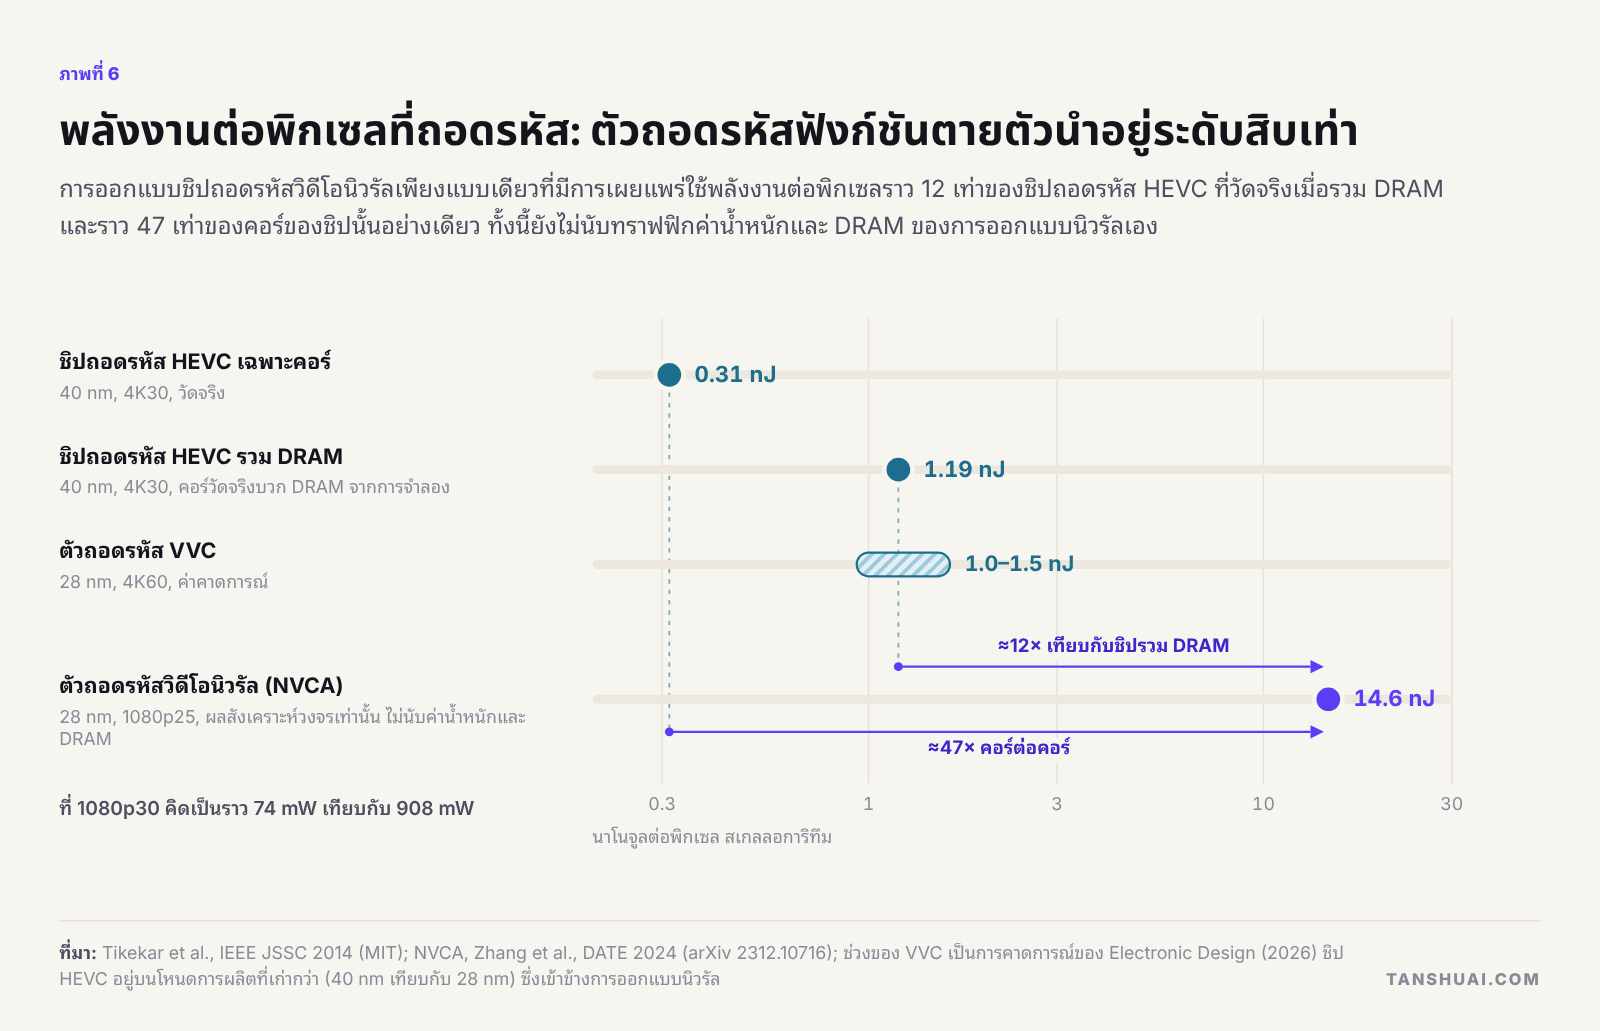 ภาพที่ 6 พลังงานต่อพิกเซลที่ถอดรหัส: ตัวถอดรหัสฟังก์ชันตายตัวนำอยู่ระดับสิบเท่า
NVCA การออกแบบชิปถอดรหัสวิดีโอนิวรัลเพียงแบบเดียวที่มีการเผยแพร่ ใช้ 14.6 nJ ต่อพิกเซล ส่วนชิปถอดรหัส HEVC ของ MIT ใช้ 1.19 เมื่อรวม DRAM และ 0.31 สำหรับคอร์ ที่ 1080p30 คิดเป็นราว 900 mW เทียบกับ 74 mW DCVC-RT โคเดกเชิงวิจัยที่เร็วของ Microsoft ต้องใช้ราว 175,000 MAC ต่อพิกเซลที่ถอดรหัส ตามผลรวมที่ผมคำนวณจากตารางรายโมดูลของผู้พัฒนาเอง หรือราว 22 TOPS ที่ 1080p30: ครึ่งหนึ่งของ 40 TOPS ที่ใช้นิยาม AI PC สำหรับสตรีมเดียว
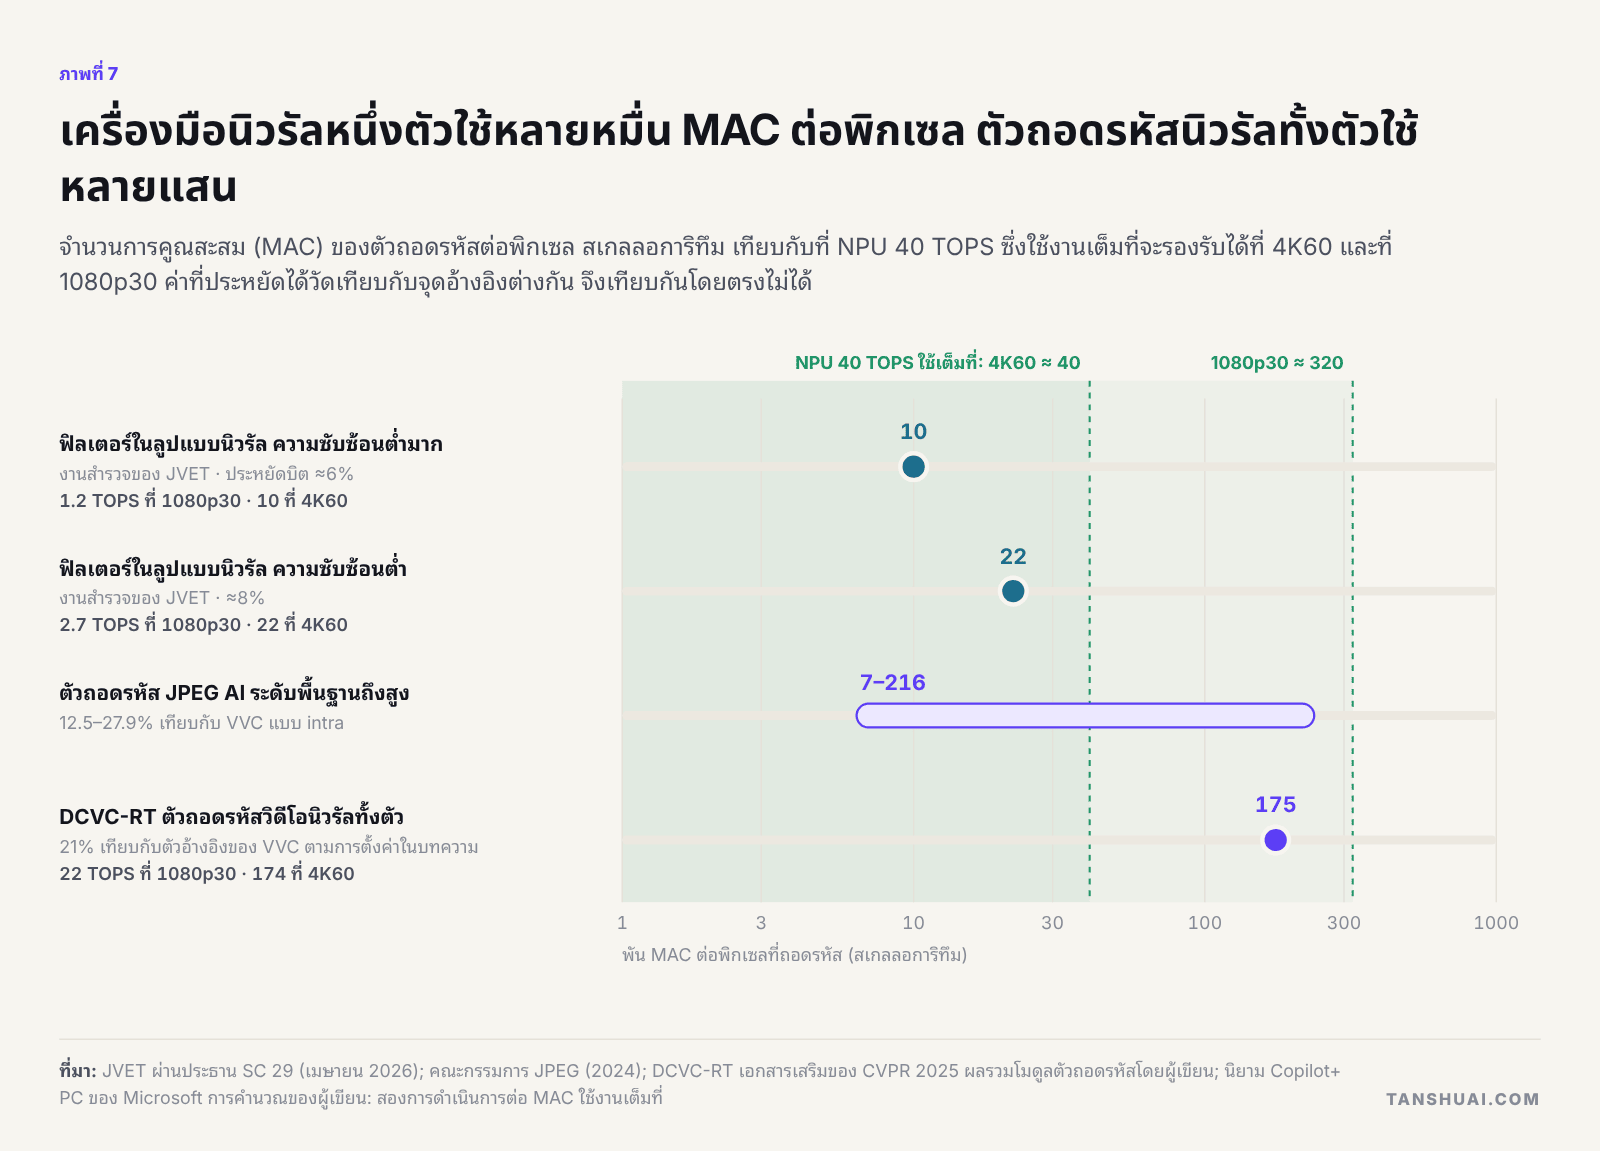 ภาพที่ 7 เครื่องมือนิวรัลหนึ่งตัวใช้หลายหมื่น MAC ต่อพิกเซล ตัวถอดรหัสนิวรัลทั้งตัวใช้หลายแสน
ยังมีอีกสองต้นทุนที่สำคัญ หน่วยความจำ: ในชิปของ MIT พลังงานของระบบราวสามในสี่หมดไปกับ DRAM และตัวถอดรหัสนิวรัลต้องแบก feature map ขนาดใหญ่ไว้ระหว่างเฟรม ความตรงกันทุกบิต: การถอดรหัสเอนโทรปีจะล้มเหลวหากอุปกรณ์สองเครื่องคำนวณความน่าจะเป็นต่างกัน นี่คือเหตุที่โคเดกนิวรัลที่จริงจังทุกตัวในวันนี้ใช้เลขคณิตจำนวนเต็ม และเหตุที่ MLVC ยอมแลกประสิทธิภาพการบีบอัดเพื่อให้ถอดรหัสได้ผลเหมือนกัน
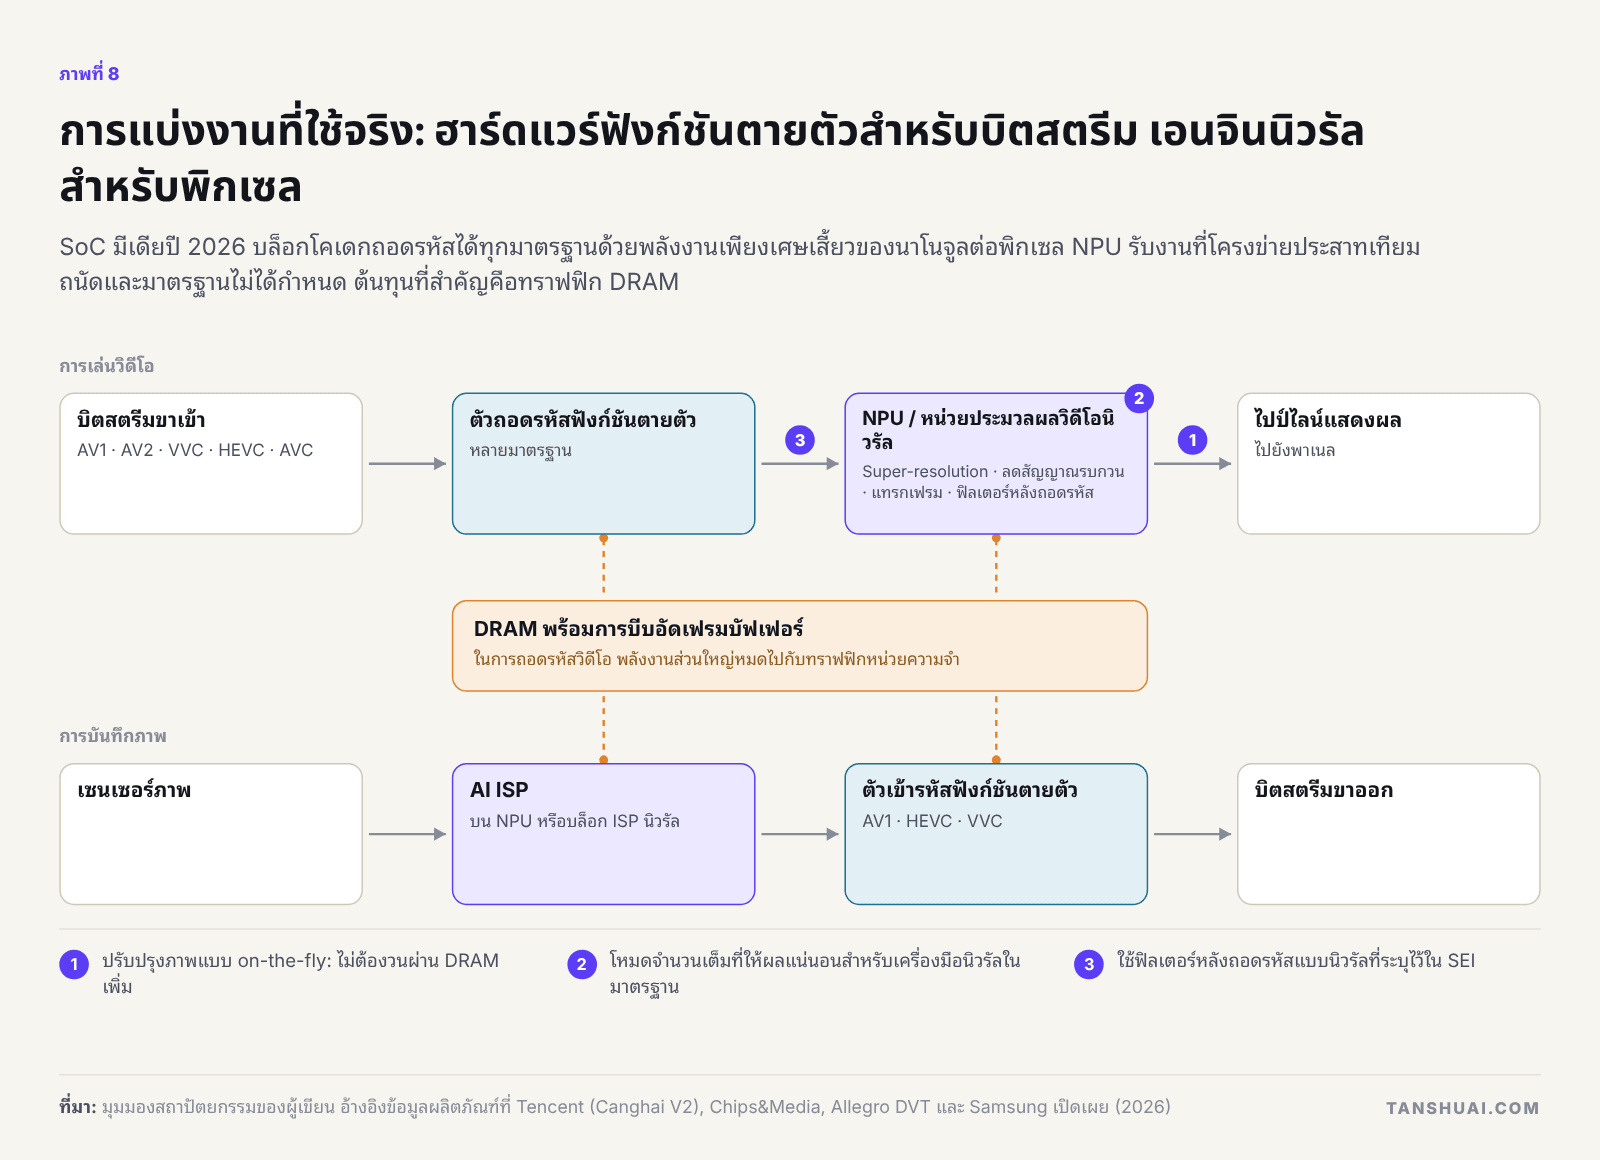 ภาพที่ 8 การแบ่งงานที่ใช้จริง: ฮาร์ดแวร์ฟังก์ชันตายตัวสำหรับบิตสตรีม เอนจินนิวรัลสำหรับพิกเซล
ซิลิคอนที่ขายได้จับคู่ทั้งสองอย่างเข้าด้วยกัน Tencent ใช้งานชิปโคเดก Canghai ที่พัฒนาเองแล้วกว่า 100,000 ชิ้น และรุ่นที่สองเพิ่ม H.266 และ super-resolution บนชิป ผู้ขาย IP ขายบล็อกโคเดกและ NPU สำหรับวิดีโอควบคู่กัน หากผมวางแผน SoC มีเดียในตอนนี้: ตัวถอดรหัสฟังก์ชันตายตัวสำหรับทุกมาตรฐานที่ต้องเล่นได้ รวมถึง AV2 NPU ที่มีขนาดพอสำหรับการปรับปรุงภาพที่ความละเอียดของจอแสดงผลโดยไม่ต้องวนผ่าน DRAM เพิ่ม โหมดจำนวนเต็มที่ให้ผลแน่นอน และเริ่มออกแบบสำหรับ H.267 หลังปี 2029
ใครได้เงิน และบริษัทจะเข้าไปเล่นตรงไหนได้
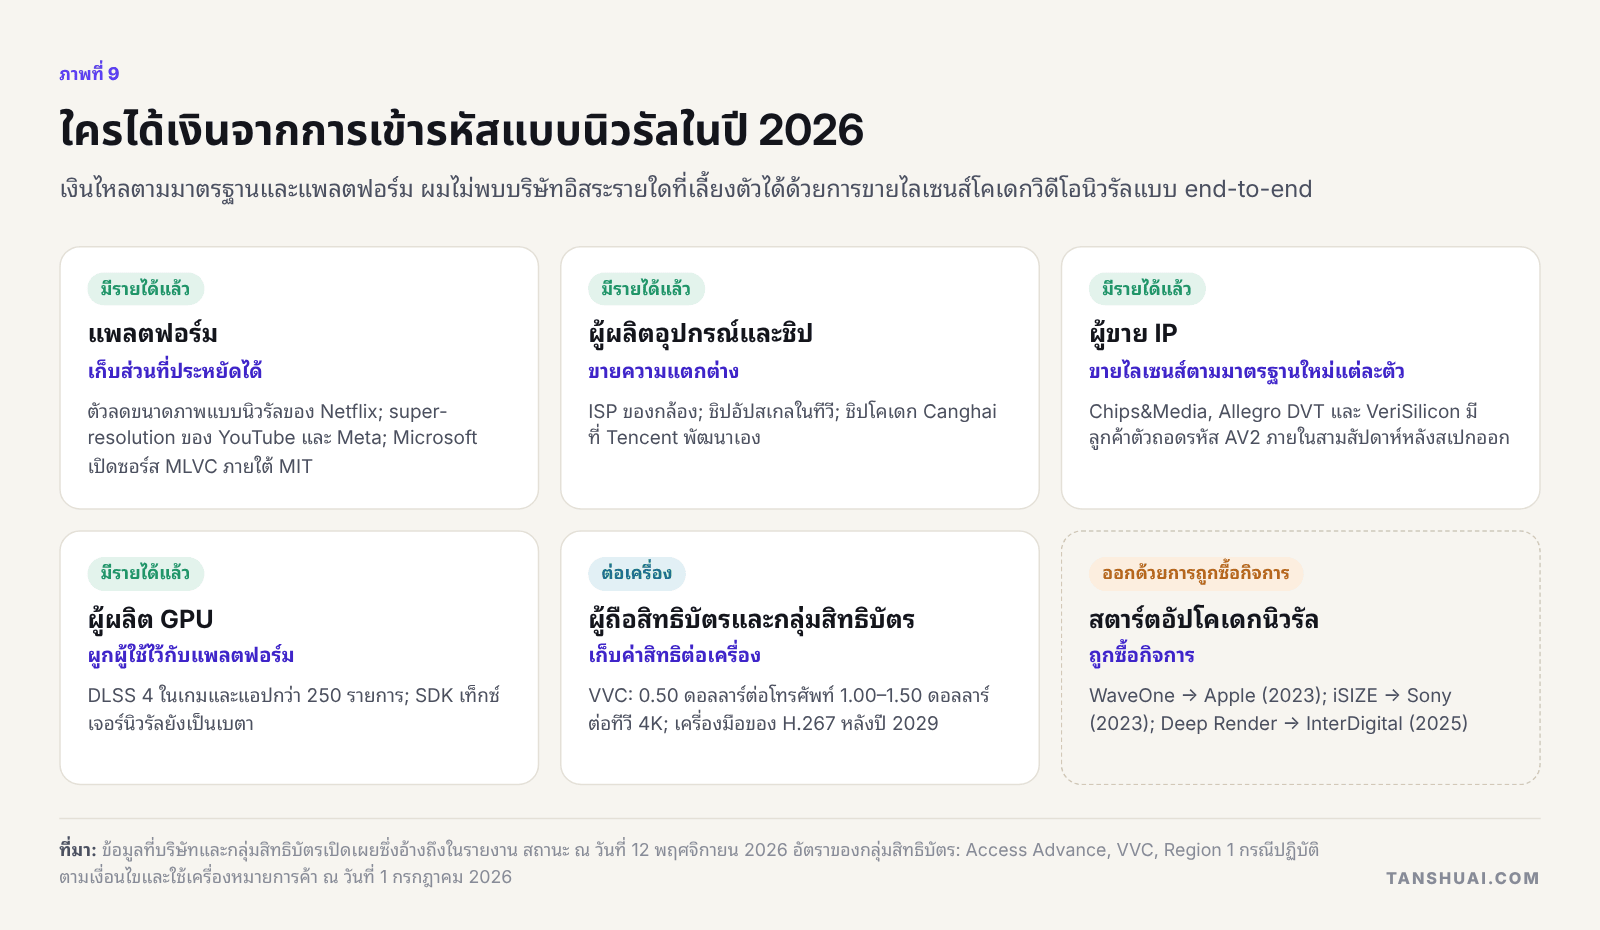 ภาพที่ 9 เงินไหลตามมาตรฐานและแพลตฟอร์ม
แพลตฟอร์มเก็บส่วนที่ประหยัดได้ไว้เอง และบางครั้งก็แจกโค้ดฟรี อย่างที่ Microsoft ทำกับ MLVC ผู้ขาย IP ขายไลเซนส์ตัวถอดรหัสสำหรับทุกมาตรฐานใหม่ กลุ่มสิทธิบัตรเก็บค่าสิทธิต่อเครื่อง: สำหรับ VVC คือ 0.50 ดอลลาร์สหรัฐต่อโทรศัพท์ และ 1.00–1.50 ดอลลาร์สหรัฐต่อทีวี 4K ในสหรัฐฯ และตลาดอื่นใน Region 1 WaveOne ไปอยู่กับ Apple, iSIZE ไปอยู่กับ Sony และ Deep Render ไปอยู่กับ InterDigital ผมไม่พบบริษัทอิสระรายใดที่เลี้ยงตัวได้ด้วยการขายไลเซนส์โคเดกวิดีโอนิวรัลแบบ end-to-end
สำหรับบริษัท ช่องทางที่ยังเปิดอยู่คือการประมวลผลล่วงหน้าแบบนิวรัลสำหรับบริการวิดีโอ การปรับปรุงภาพฝั่งแสดงผลสำหรับผู้ผลิตชิป โคเดกนิวรัลแบบวงปิดสำหรับการประชุมทางไกลและลิงก์ส่วนตัว ซิลิคอนโคเดกบวก NPU และเครื่องมือประเมินผลและทดสอบความสอดคล้องที่ทุกรายซึ่งนำเครื่องมือนิวรัลไปใช้จริงจะต้องมี งานมาตรฐานสำหรับ H.267 ต้องอาศัยความอดทนและกลยุทธ์ด้านไลเซนส์
คำกล่าวอ้างที่ควรฟังหูไว้หู และสิ่งที่ต้องจับตา
ขอสี่สิ่งจากทุกคำกล่าวอ้างเรื่องโคเดกนิวรัล: จุดอ้างอิง ตัวชี้วัด ความละเอียด และต้นทุนการถอดรหัส “ประหยัด 88%” คือเทียบกับ H.264 ที่ 360p “หน่วยความจำวิดีโอลดลง 85–96%” คือฉากสาธิต เทียบกับ 30% ในเกมที่วางจำหน่ายแล้ว ส่วน “JPEG AI เป็นมาตรฐาน” ยังไม่มีผลิตภัณฑ์ใดรองรับ
หมุดหมายที่สำคัญ: การประเมินข้อเสนอ H.267 ในเดือนมกราคม 2027 สตรีม AV2 ครั้งแรกของ YouTube ในต้นปี 2027 โมเดลทดสอบแรกของ H.267 ในครึ่งหลังของปี 2027 MLVC จะขยายเกิน Teams หรือไม่ ผลิตภัณฑ์แรกที่ใช้ JPEG AI เป็นค่าเริ่มต้น และงบ NPU ในโทรศัพท์และ PC เวอร์ชัน 1 ของ H.267 ในสิ้นปี 2029 จะเริ่มรอบการพัฒนาชิปสำหรับเครื่องมือนิวรัลในการเล่นวิดีโอกระแสหลัก
ดาวน์โหลดรายงานฉบับเต็มและสไลด์
รายงานฉบับเต็มลงรายละเอียดของแต่ละด้านมากขึ้น พร้อมการคำนวณด้านซิลิคอน มาตรฐานและสิทธิบัตร ตารางเทียบคำกล่าวอ้างกับหลักฐาน และแหล่งข้อมูลทั้งหมด
- การเข้ารหัสแบบนิวรัลในปี 2026: รายงานฉบับเต็ม (PDF)
- การเข้ารหัสแบบนิวรัลในปี 2026: สไลด์ (PDF)
- ฉบับภาษาอังกฤษ: รายงานฉบับเต็ม · สไลด์
ฉบับนี้แปลจากฉบับภาษาอังกฤษ หากเนื้อหาไม่ตรงกัน ให้ถือฉบับภาษาอังกฤษเป็นหลัก
คำถามที่ยังเปิดอยู่
ยังมีบางคำถามที่ไม่มีคำตอบสาธารณะ และเป็นคำถามที่ผมเห็นว่าน่าสนใจที่สุดในทางเทคนิค: ตัวถอดรหัสนิวรัลจะเข้าใกล้การคำนวณจำนวนเต็มที่ตรงกันทุกบิตบน NPU ของผู้ผลิตต่างรายได้แค่ไหนก่อนจะเสียความได้เปรียบด้านการบีบอัด การประมวลผลภายหลังแบบนิวรัลมีต้นทุนทราฟฟิก DRAM ต่อพิกเซลเท่าไร ที่ต้นทุนต่อพิกเซลระดับใดที่เครื่องมือนิวรัลจะไม่คุ้มอีกต่อไปในตัวถอดรหัส H.267 ระบบปิดใดนอกเหนือจากการโทรที่จะนำโคเดกนิวรัลแบบ end-to-end ไปใช้ได้ก่อน และจะวัดความเที่ยงตรงอย่างไรเมื่อตัวถอดรหัสสร้างรายละเอียดขึ้นเองแทนที่จะสร้างคืน
เหล่านี้คือเรื่องที่เราสำรวจร่วมกันได้ในหลายปีข้างหน้า ผ่านการแลกเปลี่ยนและความร่วมมือทางเทคนิค: i@tanshuai.com
เกี่ยวกับผู้เขียน
ทัน ชว่าย เป็นนักเทคโนโลยีและผู้ก่อตั้ง มีประสบการณ์กว่ายี่สิบปีในงานด้านชิป ฮาร์ดแวร์ และซอฟต์แวร์ระบบ และมีสิทธิบัตรที่ได้รับอนุมัติแล้ว 20 ฉบับ เขามีประสบการณ์หลายปีในงานวิจัยและพัฒนาและการบริหารชิปแบบ fabless รวมถึงการออกแบบ datapath ของ ASIC แบบ full-custom และโครงการชิปกล้องมัลติมีเดีย เช่น ตัวเร่งโคเดกวิดีโอ งานของเขาพาไปทั้งซิลิคอนแวลลีย์ นิวยอร์ก ชิคาโก ไต้หวัน เขตเกรตเตอร์เบย์แอเรีย (เซินเจิ้นและฮ่องกง) เวียดนาม และมาเลเซีย ปัจจุบันเขาทำงานเป็นนักวิจัยและนักพัฒนา AI
พูดคุยเชิงเทคนิค: i@tanshuai.com