
神經網路已經在形塑你看的幾乎每一部影片,但位置是在標準編解碼器的兩端,而不是取而代之。以下說明 2026 年神經編碼在哪裡落地、在晶片上要付出多少代價、誰在賺錢,並附上完整報告與簡報。
摘要
神經編碼在 2026 年已是主流,但它在標準編解碼器周邊運作,而不是取代它們。編碼之前,神經網路在手機相機與 Netflix 的編碼流程中塑造畫面;解碼之後,YouTube 的超解析度、Meta 與電視處理器負責修復畫面;中間的位元串流仍是 AV1、HEVC、AVC 或 VVC,由固定功能硬體解碼。端對端神經編解碼器只在一家公司掌控兩端的封閉迴路中落地:Teams 通話中的微軟 MLVC、每個語音與影片模型內的 tokenizer、一款遊戲中的神經紋理。神經位元串流要大規模用於播放,得等 2029 年底推出的 H.267,以及其後的一輪晶片週期。原因在晶片上:唯一公開的神經視訊解碼器設計,每像素能耗約為實測 HEVC 解碼器的 12 倍;一個速度很快的研究型編解碼器,1080p30 約需 22 TOPS。錢跟著標準與平台走;最知名的幾家神經編解碼新創公司都被收購了。
我為什麼研究這個題目
每隔幾個月,就有人告訴我 AI 編解碼器即將取代 H.264、HEVC 與 AV1。我讀到的相關內容,大多不是來自創下壓縮紀錄的研究論文,就是來自廠商。兩者都很少談到實際上線的是什麼、交到誰手上、代價多少。
我有多年無晶圓廠晶片研發與管理經驗,包括全客製化 ASIC 資料路徑設計,以及視訊編解碼加速器等多媒體相機晶片專案,所以我用審查一顆晶片的方式來看這件事:每像素能耗、記憶體存取流量、標準允許你在晶片上固化什麼,以及誰來付錢。我讀了 JVET、MPEG、JPEG、AOMedia 與 IETF 的標準文件和會議報告、企業工程部落格、晶片論文、專利池費率表、出口管制條文與新聞報導。下文所有數字都以 2026 年 11 月 12 日為準,金額以美元計。附有全部資料來源的完整報告在文末。
結論一覽
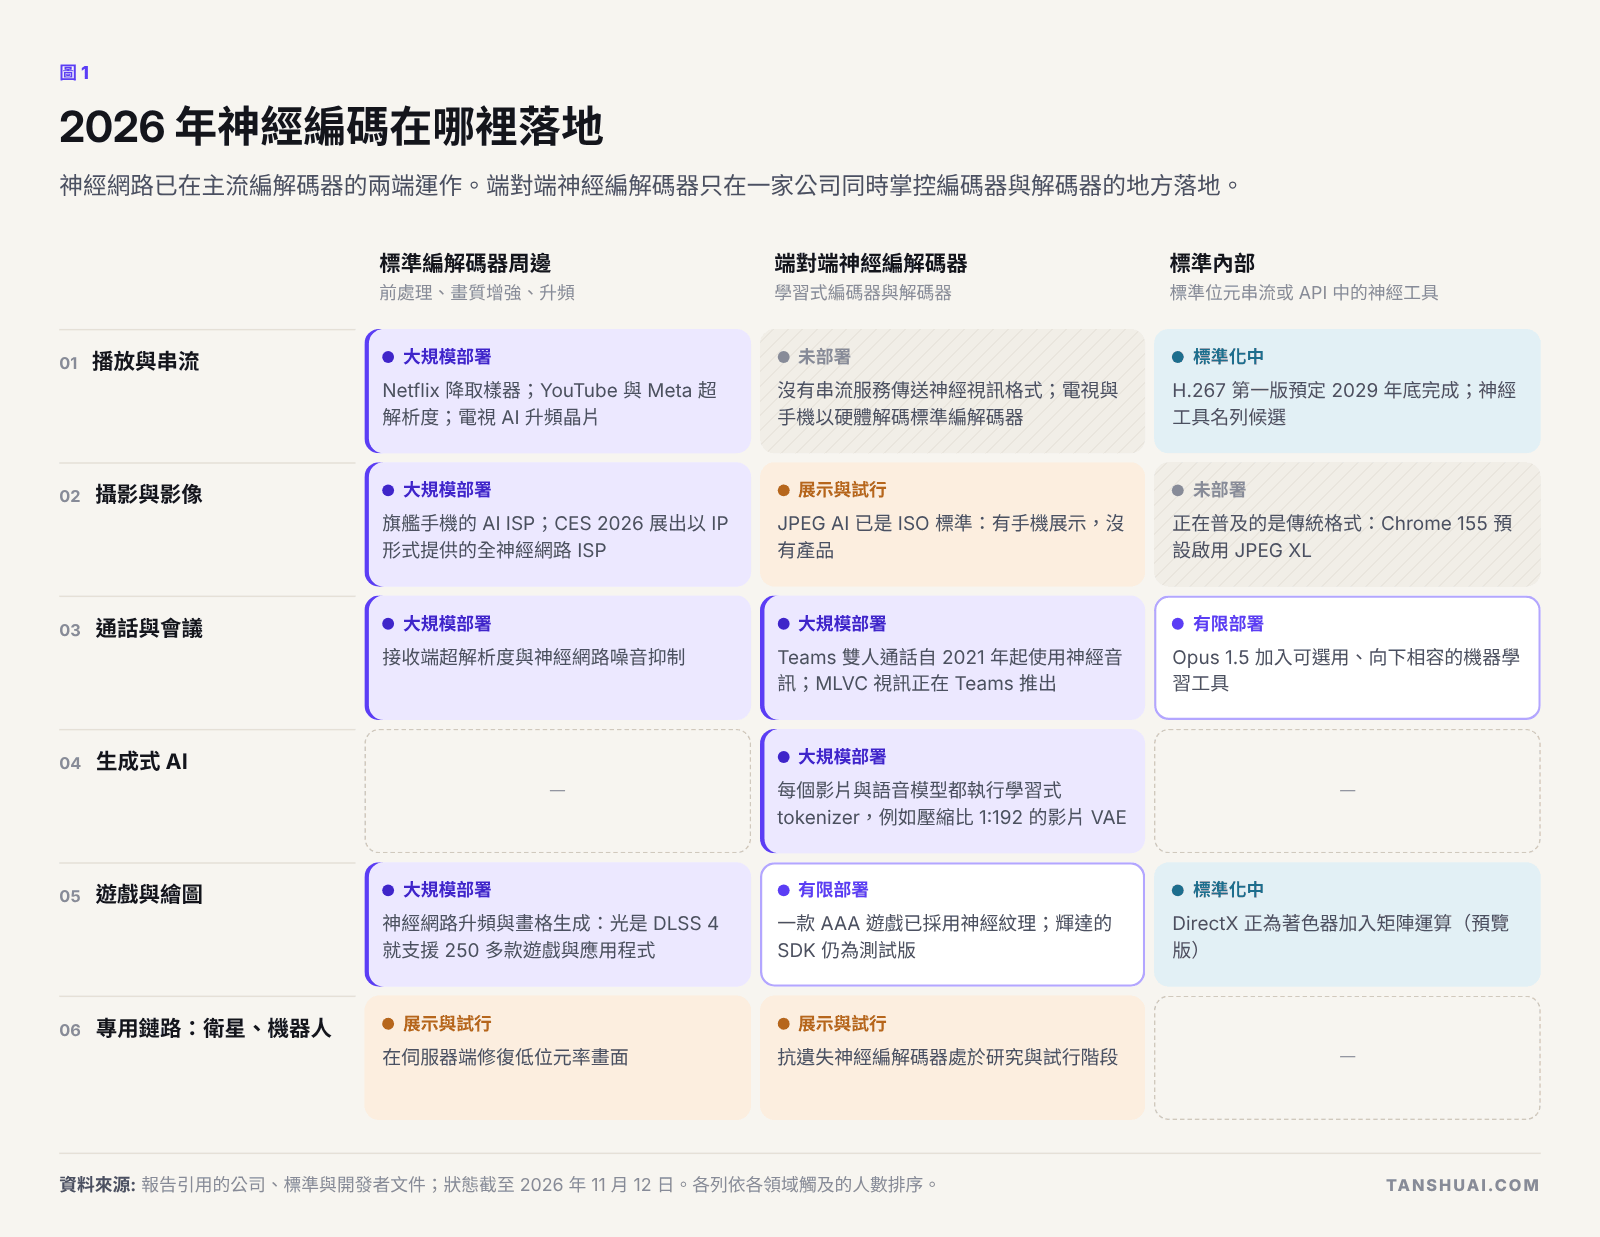 圖 1:2026 年神經編碼在哪裡落地。各列依各領域觸及的人數排序。
| 問題 | 簡短回答 |
|---|---|
| 神經編碼在哪裡大規模落地? | 在編解碼器周邊:相機 ISP、編碼端降取樣、播放端超解析度。端對端只在封閉迴路中:通話、遊戲素材、生成式 AI 的 tokenizer |
| 神經編解碼器會在播放上取代 AV1、HEVC 與 VVC 嗎? | 要等 H.267(第一版在 2029 年底)以及其後的一輪裝置週期;依我的估計,要到 2030 年代中期才會成為主流 |
| 在晶片上要付出多少代價? | 每像素能耗約為硬體 HEVC 解碼器的 12 倍,還有記憶體存取流量,以及逐位元一致解碼的要求 |
| 誰在賺錢? | 平台把省下的成本留給自己;IP 廠商與專利池按設計、按裝置收費;神經編解碼新創公司都被收購了 |
| 企業可以在哪裡切入? | 神經前處理與後處理、封閉迴路產品、編解碼器加 NPU 的晶片,以及介於其間的評測與標準工作 |
三種進入方式
「神經編碼」其實涵蓋三件不同的事,關於它的爭論大多源自把三者混為一談。神經網路可以在標準編解碼器的周邊運作,在編碼前或解碼後處理像素,位元串流則維持標準格式。它可以位於標準內部,成為每個解碼器都必須執行的工具,這代表它必須被精確規範。它也可以端對端取代編解碼器,由只能成對運作的學習式編碼器與解碼器擔綱。
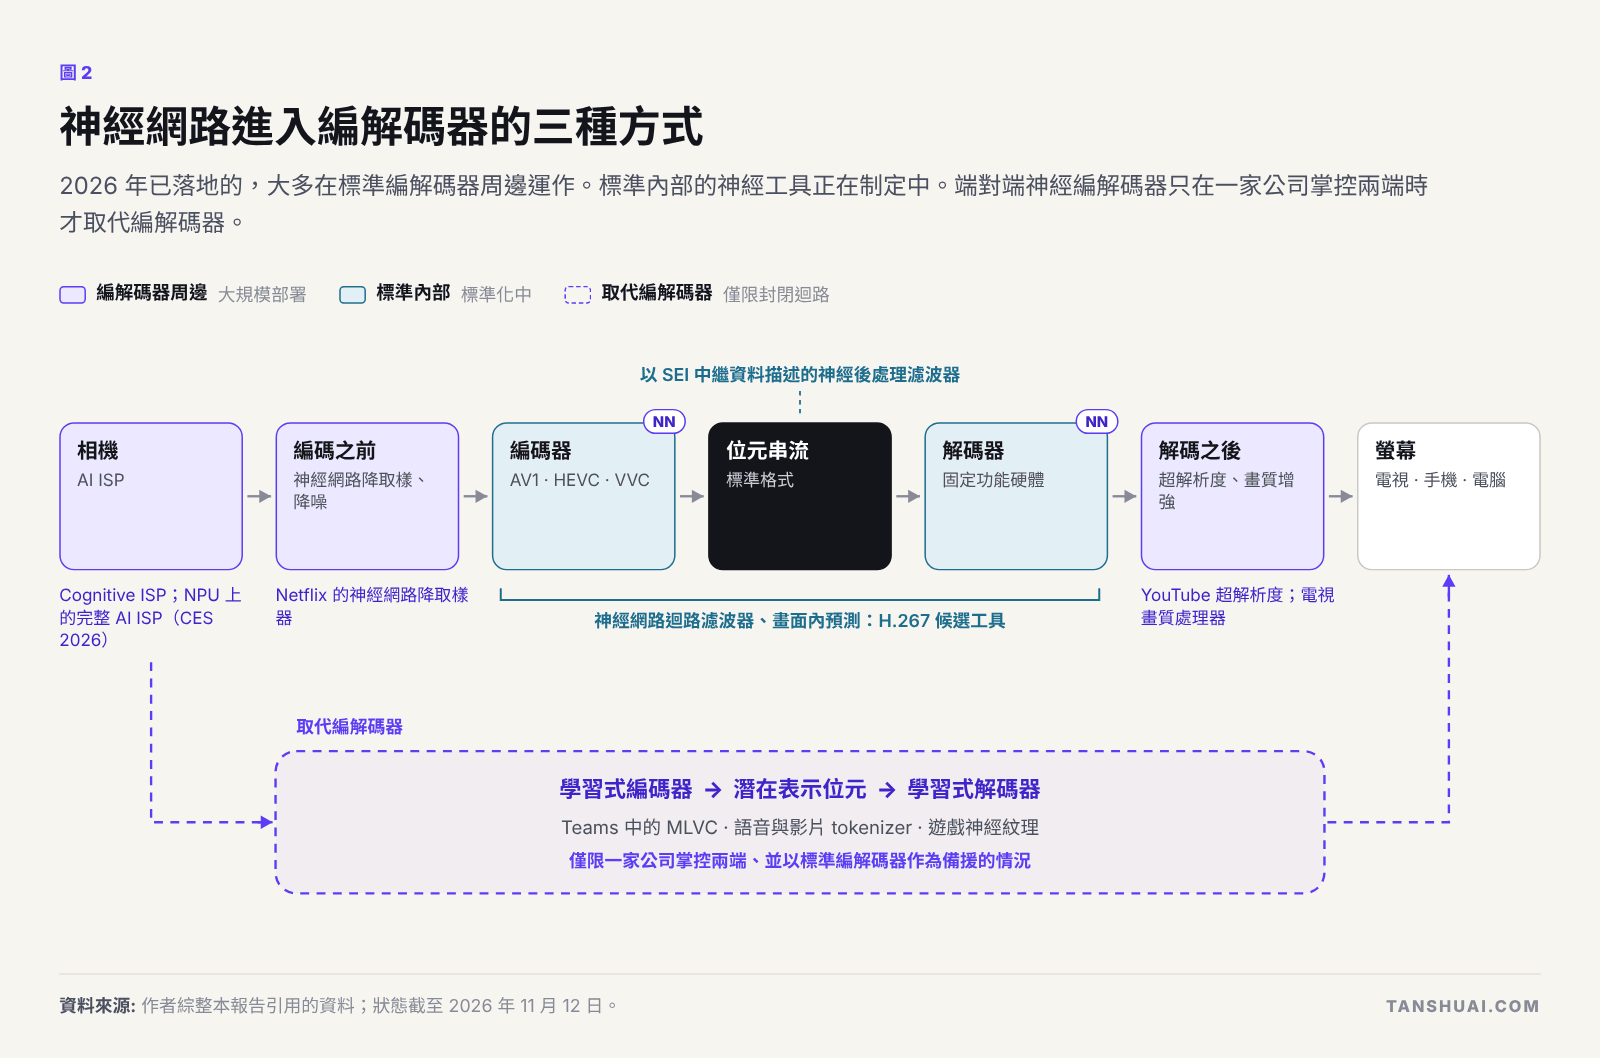 圖 2:神經網路進入編解碼器的三種方式。2026 年已落地的大多屬於第一種。
第一種不需要任何人許可,第二種需要一項標準,第三種需要掌控兩端。這也正是它們觸及大眾的先後順序。
播放與串流:兩端是神經網路,中間是標準
大型影音服務剛完成一次編解碼器換代,又開始了下一次,兩次都與神經解碼器無關。Netflix 在 2025 年 12 月報告,AV1 約占其觀看量的 30%;YouTube 表示,按觀看時數加權,其內容庫有超過 90% 已提供 AV1 版本。AV2 於 2026 年 5 月 28 日定案,壓縮效率比 AV1 高約 30%;三週之內,Chips&Media、Allegro DVT 與 VeriSilicon 都宣布了 AV2 解碼器客戶。巴西的 TV 3.0 於 2026 年 6 月開始以 VVC 進行商業廣播。
神經網路位於兩端。自 2022 年起,Netflix 以一個小型神經網路取代傳統濾波器,為母帶做降取樣;這不需要任何裝置做任何改動,而在 Netflix 的測試中,約 77% 的觀眾偏好它的結果。YouTube 在電視上以機器學習為解析度低於 1080p 的上傳影片升頻,Meta 在伺服器與手機上都執行超解析度,三星的旗艦電視處理器則標榜有 768 個升頻神經網路。
還不存在的,是主流螢幕上的神經位元串流,原因是時間。播放格式必須能在日後所有要播放它的裝置上解碼。AV1 從規格定案到占 Netflix 觀看量的 30%,花了將近八年。
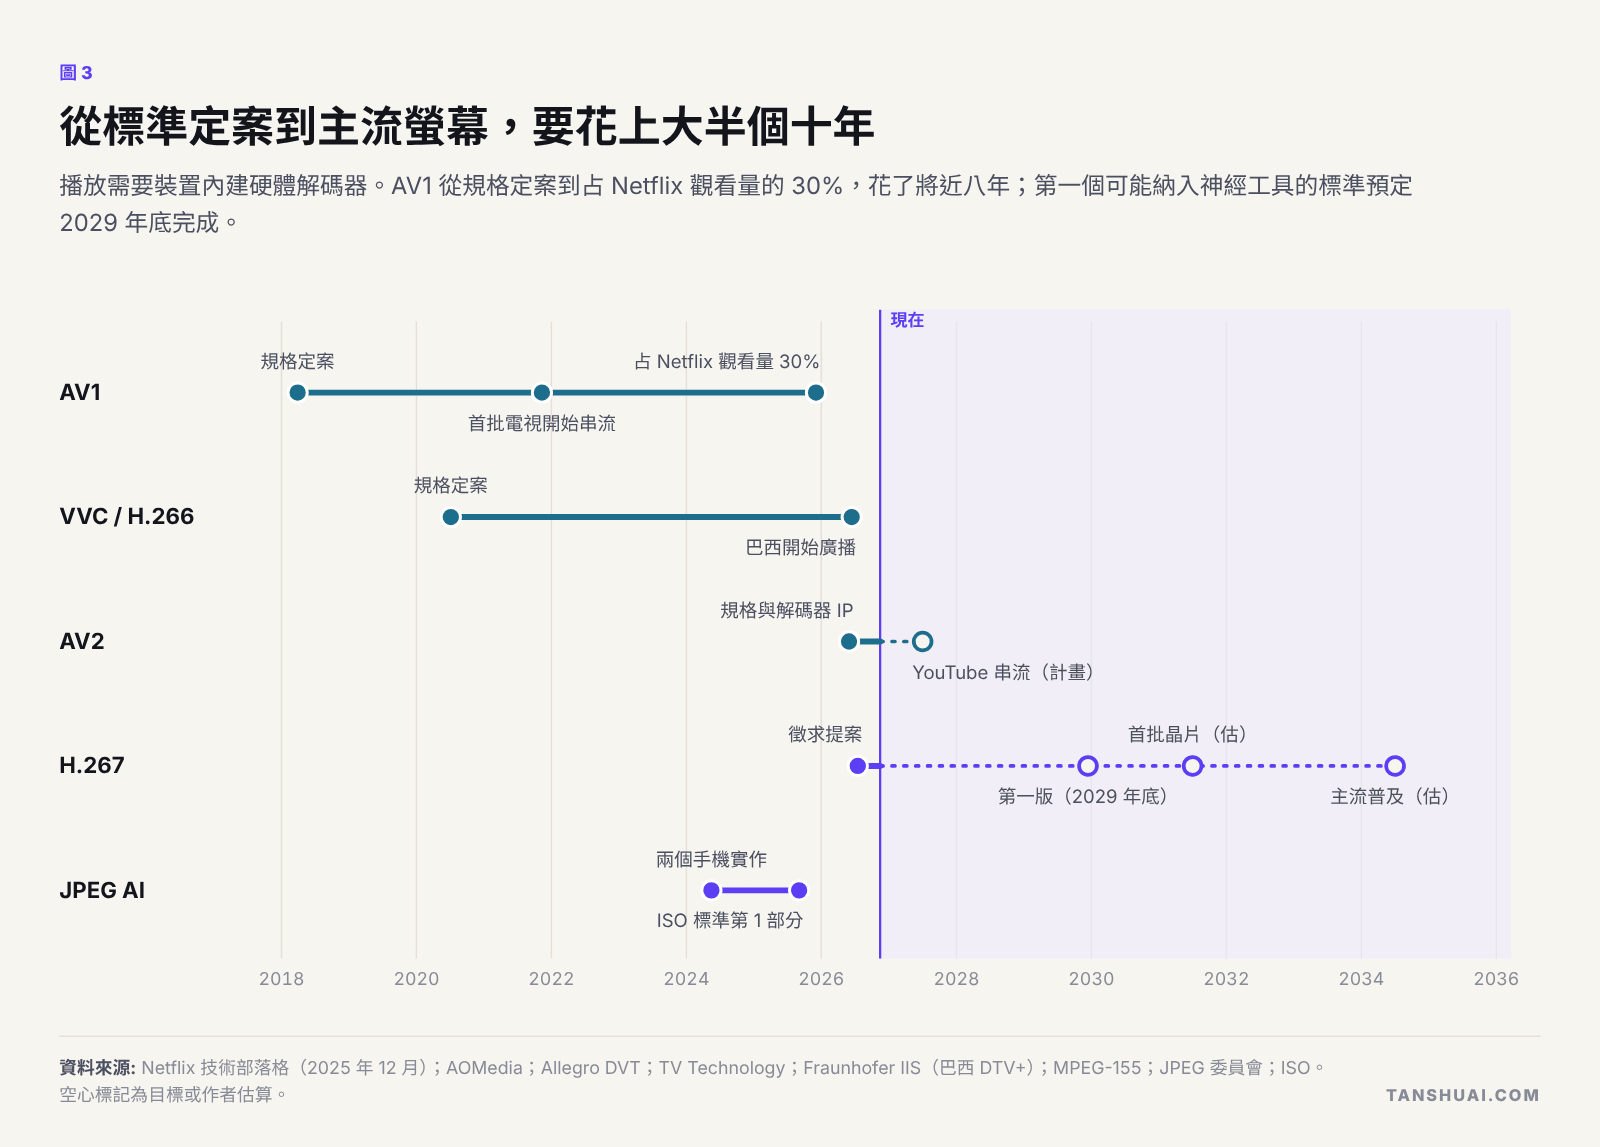 圖 3:從標準定案到主流螢幕,要花上大半個十年。
能把神經工具帶到每一塊螢幕的標準,是 VVC 的後繼者,暫定名稱 H.267。JVET 於 2026 年 7 月發布徵求提案;2027 年 1 月評估回應,第一版預定 2029 年底完成。傳統技術路線已比 VVC 節省約 28%,而 JVET 的神經網路迴路濾波器可節省 6–14%,解碼成本則從每像素 1 萬次 MAC 起跳。我預期這項標準會以傳統工具為核心,只在節省的位元值得付出成本之處加入少數神經工具。
攝影:相機內是神經網路,網頁上是傳統格式
近年旗艦手機拍下的每一張照片,在儲存之前都經過了神經網路。高通的 Cognitive ISP 從 2023 年起就能即時做語意分割;在 CES 2026 上,Chips&Media 與 Visionary.ai 展示了一套完全在 NPU 上執行的完整 ISP。之後,結果才被存成 JPEG 或 HEIF。
第一個學習式影像標準 JPEG AI 於 2025 年發布,在每像素 7 千到 21.6 萬次 MAC 的解碼成本下,比 VVC 畫面內編碼省 12.5–27.9%。我沒有找到任何預設採用它的相機、相簿 App 或瀏覽器。2026 年網頁採用的格式是傳統格式:Chrome 155 於 10 月 6 日啟用 JPEG XL,搭配一個能在任何 CPU 上執行、快速且記憶體安全的解碼器。神經編碼在單一公司的處理流程內勝出;必須在任何地方都能開啟的格式,仍是傳統格式。
通話:端對端神經編解碼器真正落地之處
通話是封閉迴路:兩端執行同一個 App,通話途中也能退回標準編解碼器。所以第一批大規模部署的端對端神經編解碼器就出現在這裡。微軟的 AI 語音編解碼器 Satin 自 2021 年起用於所有 Teams 與 Skype 雙人通話。2026 年 7 月,微軟開源了神經視訊編解碼器 MLVC,目前正在 Teams 點對點通話中推出。
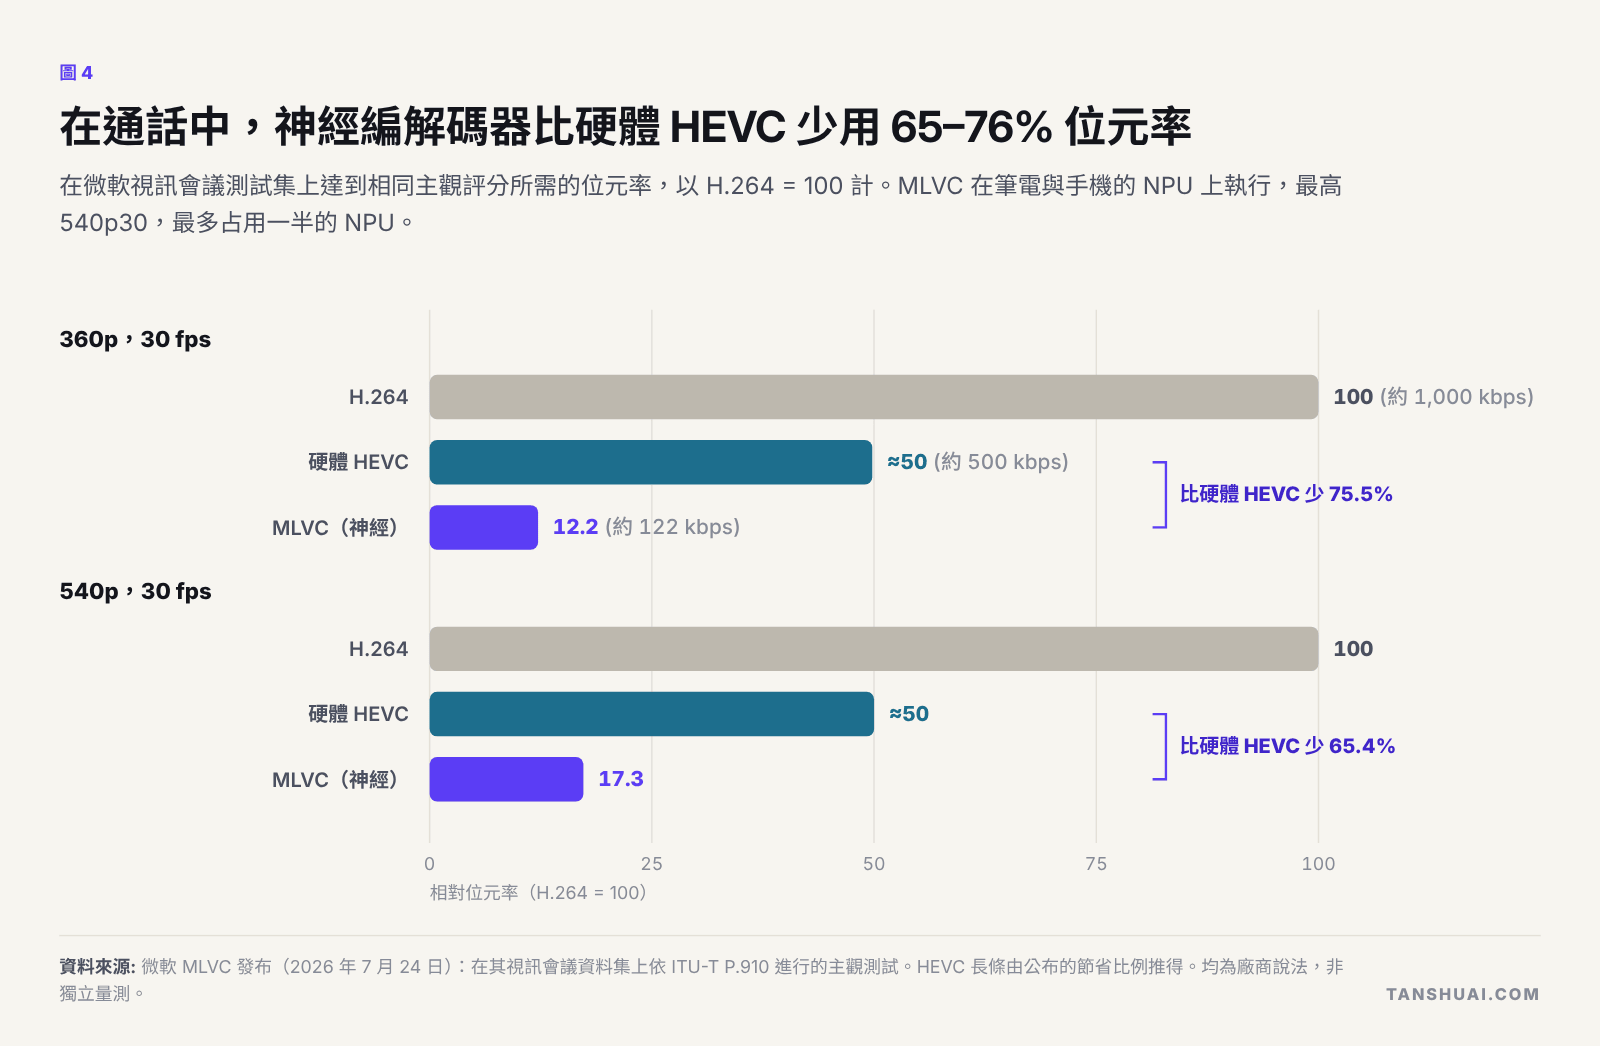 圖 4:在通話中,神經編解碼器比硬體 HEVC 少用 65–76% 位元率(微軟自己的測試集)。
標題上的 88% 是相對 H.264;相對同一台筆電裡既有的硬體 HEVC,是 65–76%,依然可觀。MLVC 以 540p 與 360p 執行,最多占用一半的 NPU,而且為了在不屬於微軟的硬體上解出完全相同的結果,放棄了一部分壓縮率。
並非人人都走這條路。Opus 在 2024 年加入深度學習,但都是可選用、向下相容的附加功能。Meta 打造了傳統語音編解碼器 MLow,因為它有超過 20% 的通話在老舊的 ARMv7 手機上進行,每天還有數千萬通 WhatsApp 通話在用了十年以上的手機上進行。神經編解碼器會先在裝置較新、且由單一廠商掌控兩端的地方落地。
生成式 AI:規模最大、卻沒人稱之為編解碼器的部署
每個語音與影片模型都建立在學習式編解碼器之上。語音模型讀寫神經音訊編解碼器的 token,例如 Kyutai 的 Mimi,每秒 12.5 個音框、1.1 kbps。影片生成模型在影片自編碼器的潛在空間中運作,例如 LTX-Video 的自編碼器,壓縮比 1:192。這些都不是別人會去解碼的格式,但它們證明,只要一家公司同時擁有編碼器、解碼器與硬體,學習式壓縮就能大規模運作。對提供生成式影片服務的業者來說,tokenizer 的效率直接就是一項成本。
遊戲:神經重建已是主流,神經素材剛起步
輝達的 DLSS 只算繪較少的像素與畫格,其餘交給神經網路重建。神經紋理壓縮已在 Assassin's Creed Mirage 中上市,但因為執行成本,只用在部分素材上。
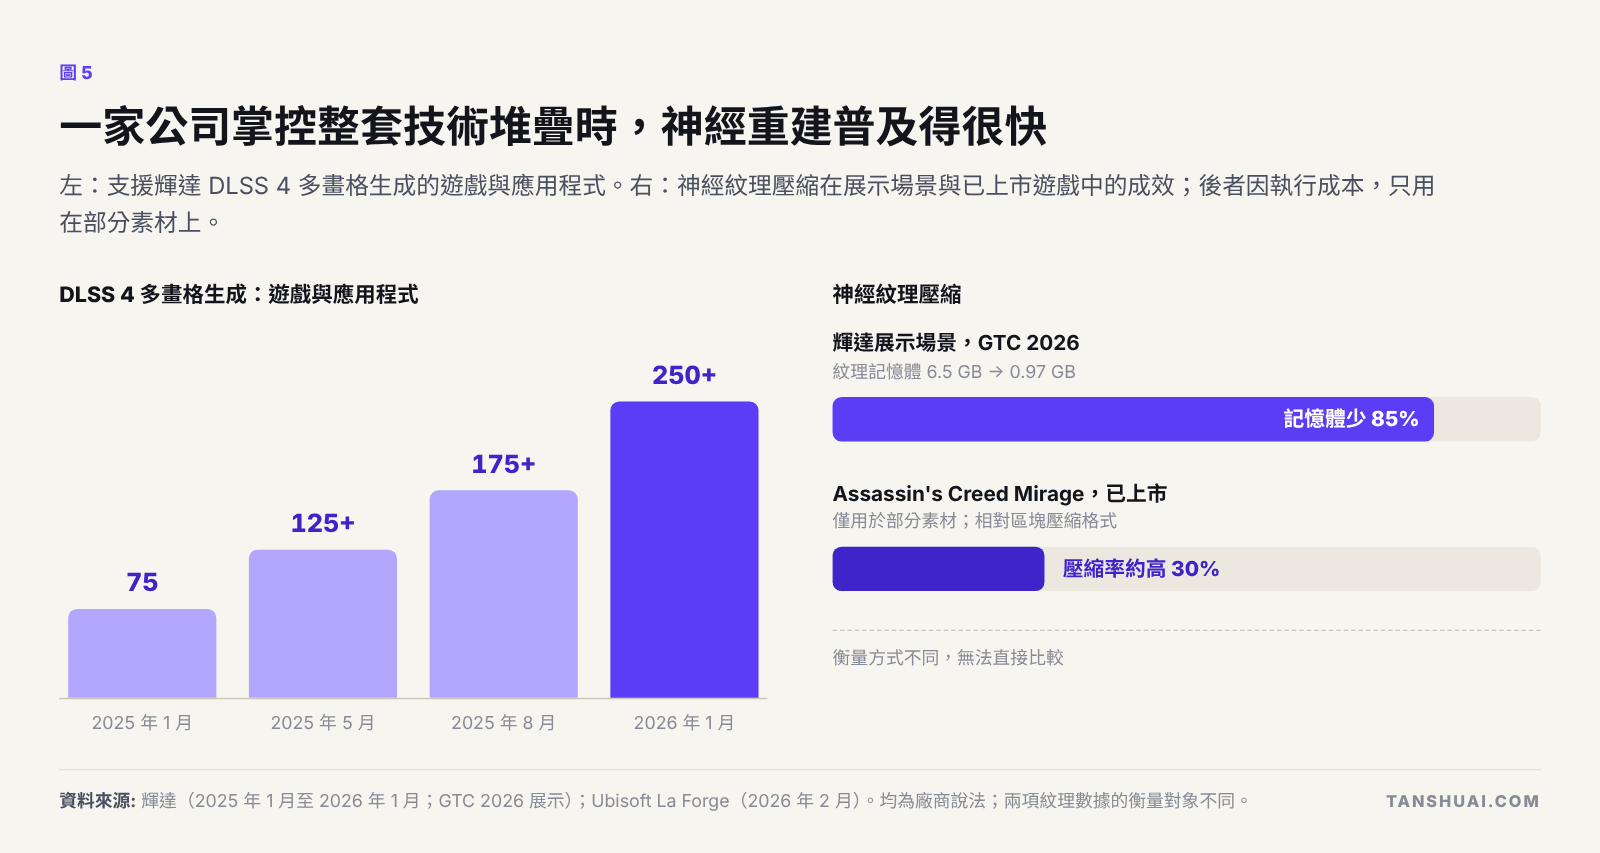 圖 5:一家公司掌控整套技術堆疊時,神經重建普及得很快。
衛星、無人機與機器人鏈路,在技術上最適合端對端神經編解碼器,但市場小,而且雙方的出口管制都愈來愈嚴:中國自 2026 年 11 月 18 日起施行的無人機出口規定,甚至把語意影像壓縮列為門檻指標。
晶片視角
這是我自己的背景最派得上用場的地方。晶片團隊評估任何新的編解碼器,都會問四個問題:每像素多少焦耳、每像素多少 DRAM 存取流量、多少邏輯閘,以及世界上每個解碼器能否算出完全相同的位元。在這四點上,2026 年的神經解碼器,就像第一批晶片問世前的硬體 HEVC。
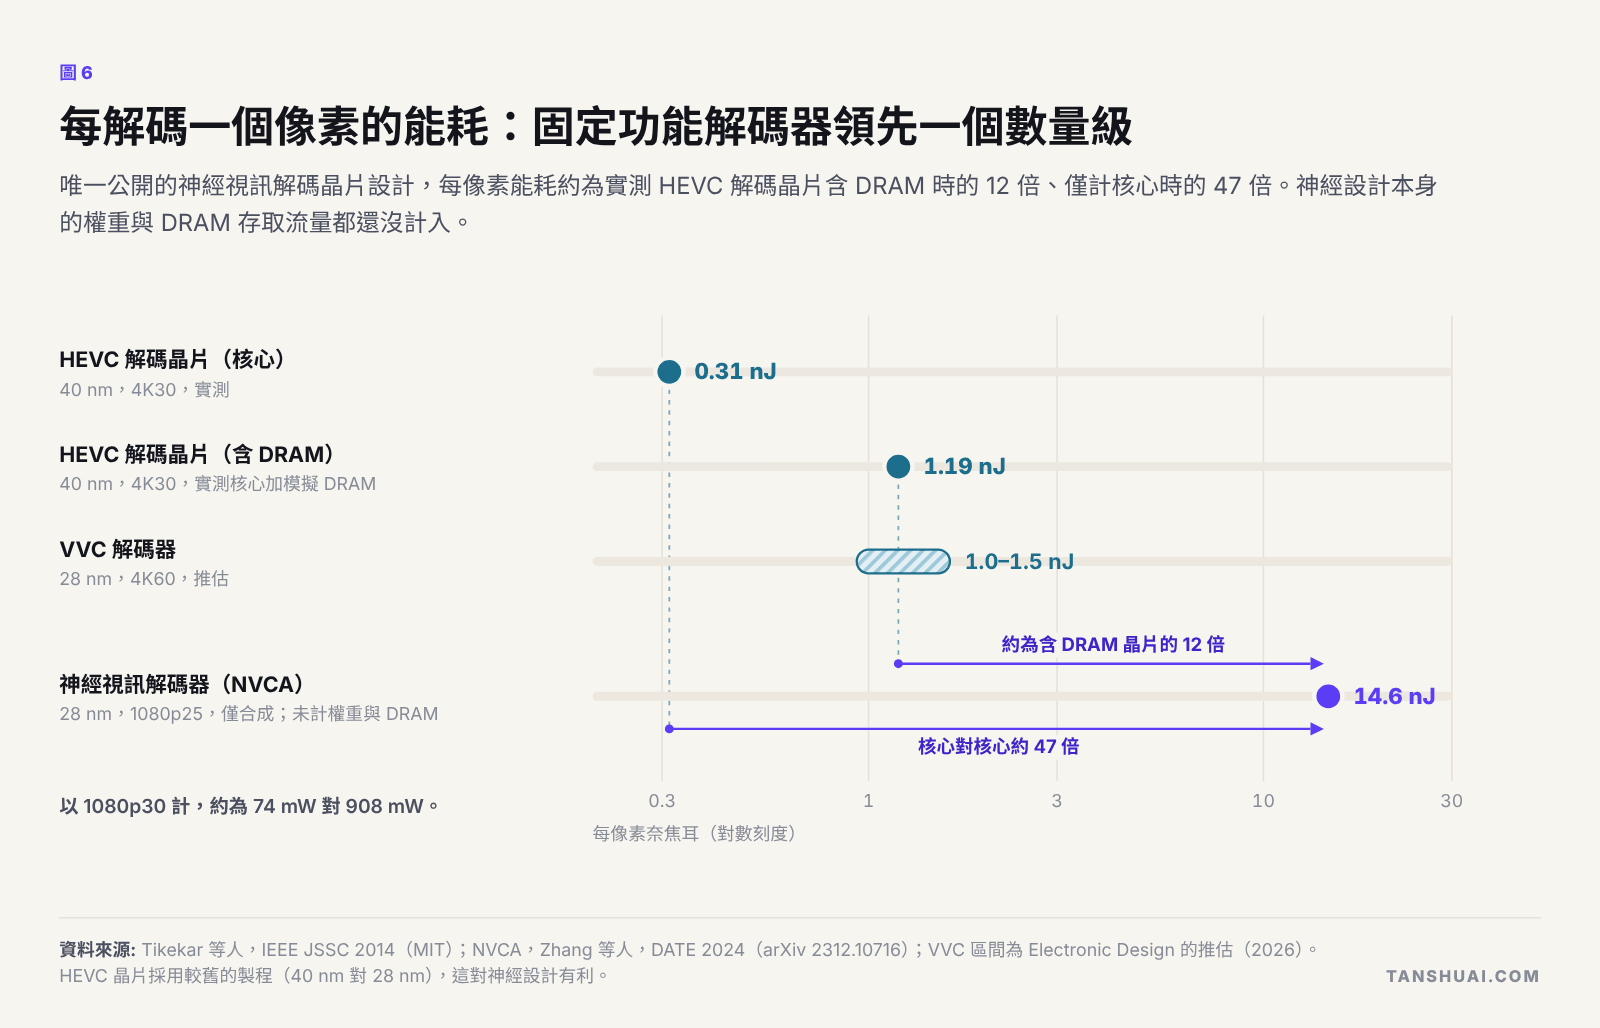 圖 6:每解碼一個像素的能耗:固定功能解碼器領先一個數量級。
唯一公開的神經視訊解碼晶片設計 NVCA,每像素需要 14.6 nJ;MIT 的 HEVC 解碼晶片含 DRAM 為 1.19,核心為 0.31。以 1080p30 計,大約是 900 mW 對 74 mW。微軟速度很快的研究型編解碼器 DCVC-RT,依我對其分模組數據表的加總,每解碼一個像素約需 17.5 萬次 MAC,1080p30 約需 22 TOPS:相當於定義 AI PC 的 40 TOPS 的一半,只為了一路視訊串流。
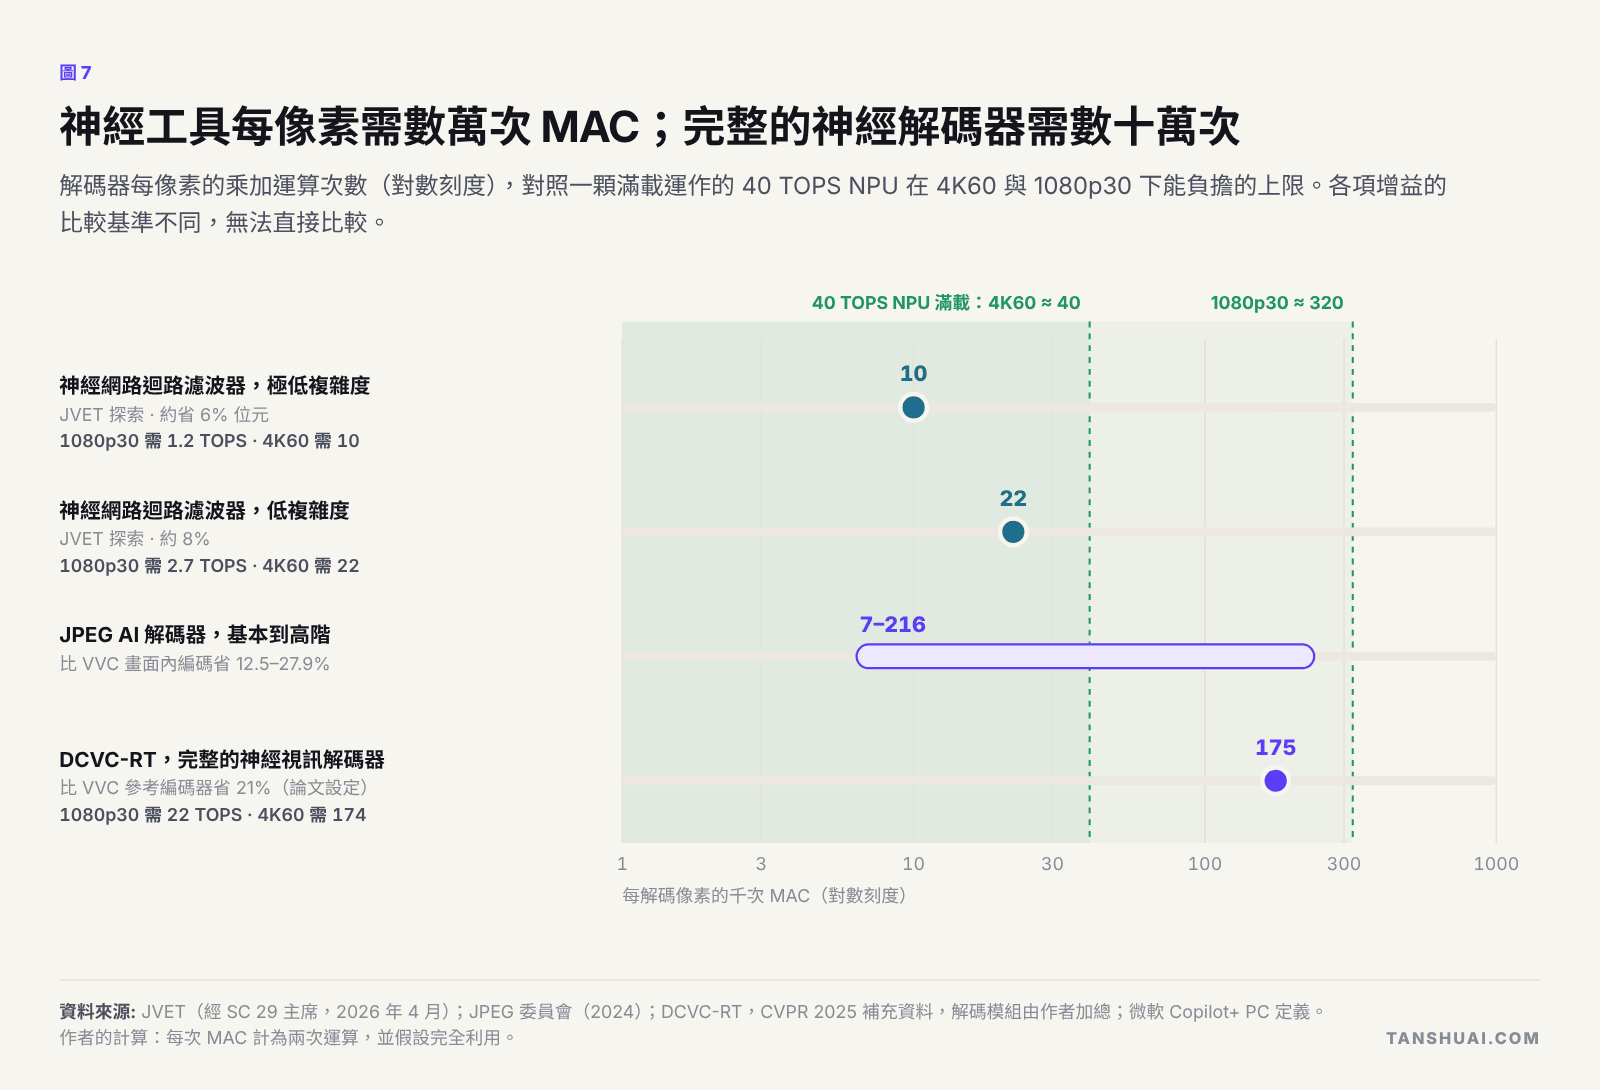 圖 7:神經工具每像素需數萬次 MAC;完整的神經解碼器需數十萬次。
還有兩項成本很關鍵。記憶體:在 MIT 那顆晶片上,系統能耗約有四分之三花在 DRAM,而神經解碼器要在影格之間保留龐大的特徵圖。精確性:只要兩台裝置算出的機率不同,熵解碼就會失敗;這正是如今每個認真的神經編解碼器都採用整數運算的原因,也是 MLVC 以壓縮率換取一致解碼的原因。
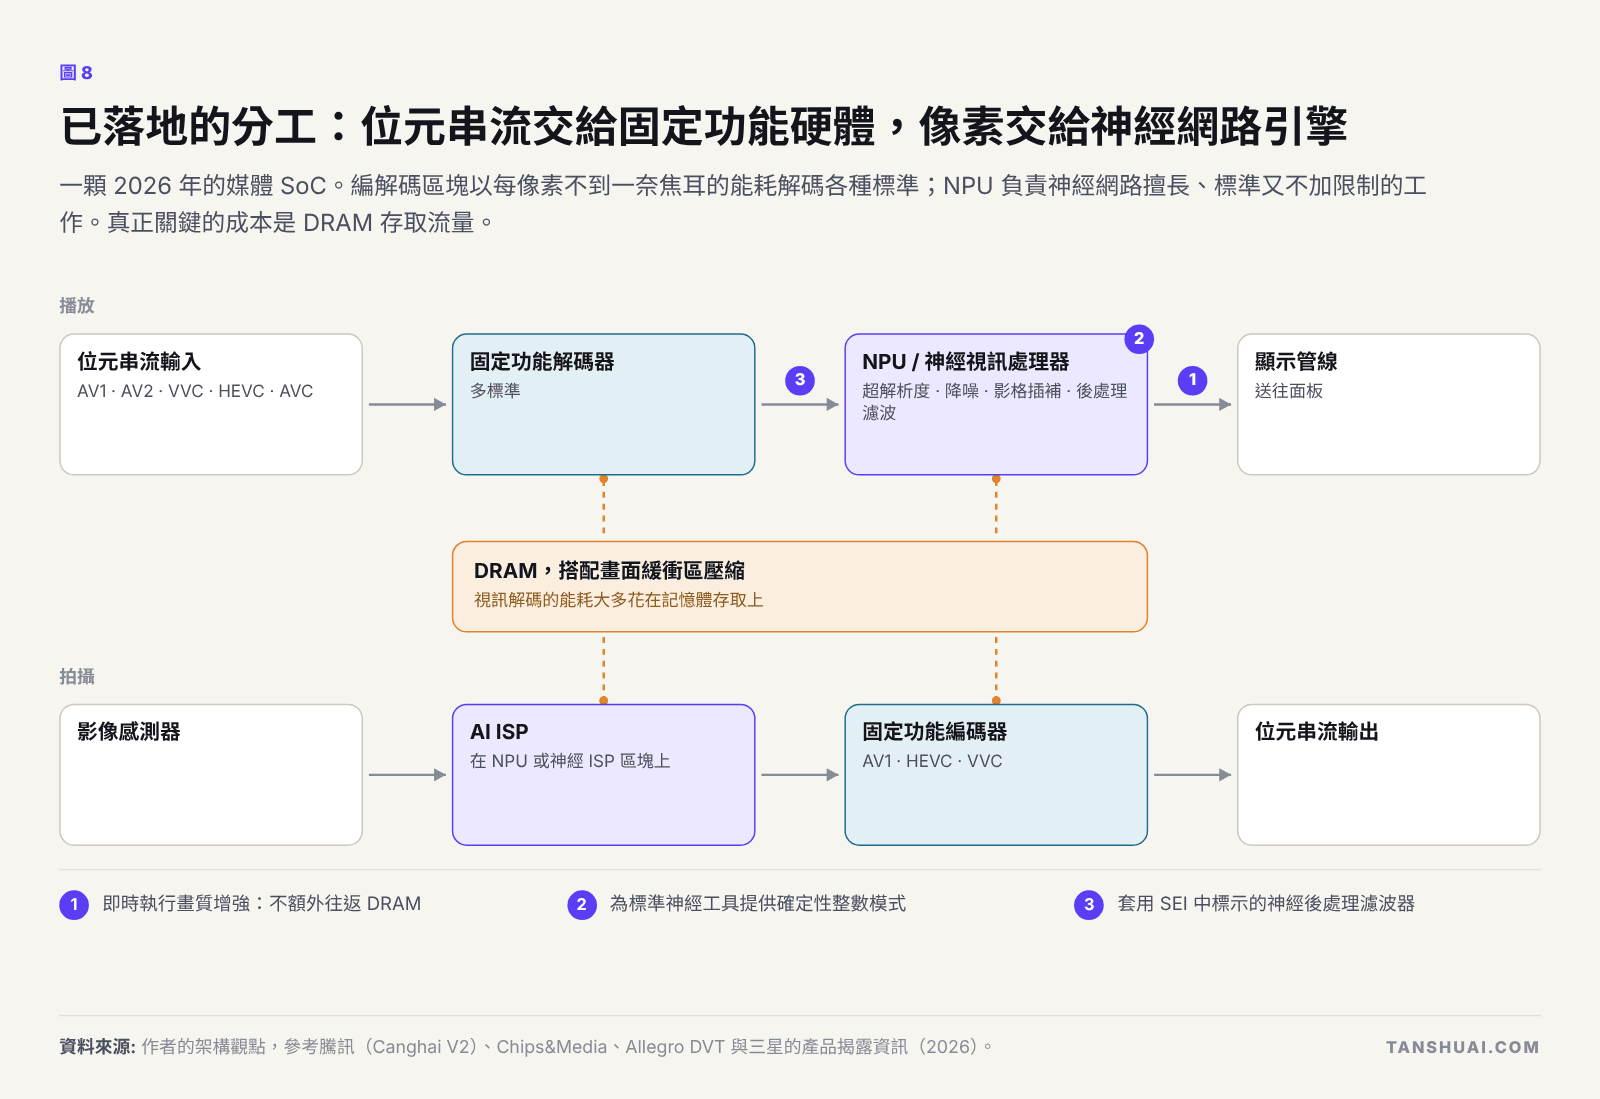 圖 8:已落地的分工:位元串流交給固定功能硬體,像素交給神經網路引擎。
賣得動的晶片把兩者搭在一起。騰訊自研的 Canghai 編解碼晶片已部署超過 10 萬顆,第二代加入了 H.266 與晶片內超解析度;IP 廠商則把編解碼區塊與視訊 NPU 並列銷售。如果現在由我來規劃一顆媒體 SoC:為每個必須支援播放的標準(包括 AV2)配置固定功能解碼器;NPU 依顯示解析度下的畫質增強來定規模,且不額外繞經 DRAM;提供確定性整數模式;並把 H.267 當作 2029 年之後才啟動的設計。
誰在賺錢,企業可以在哪裡切入
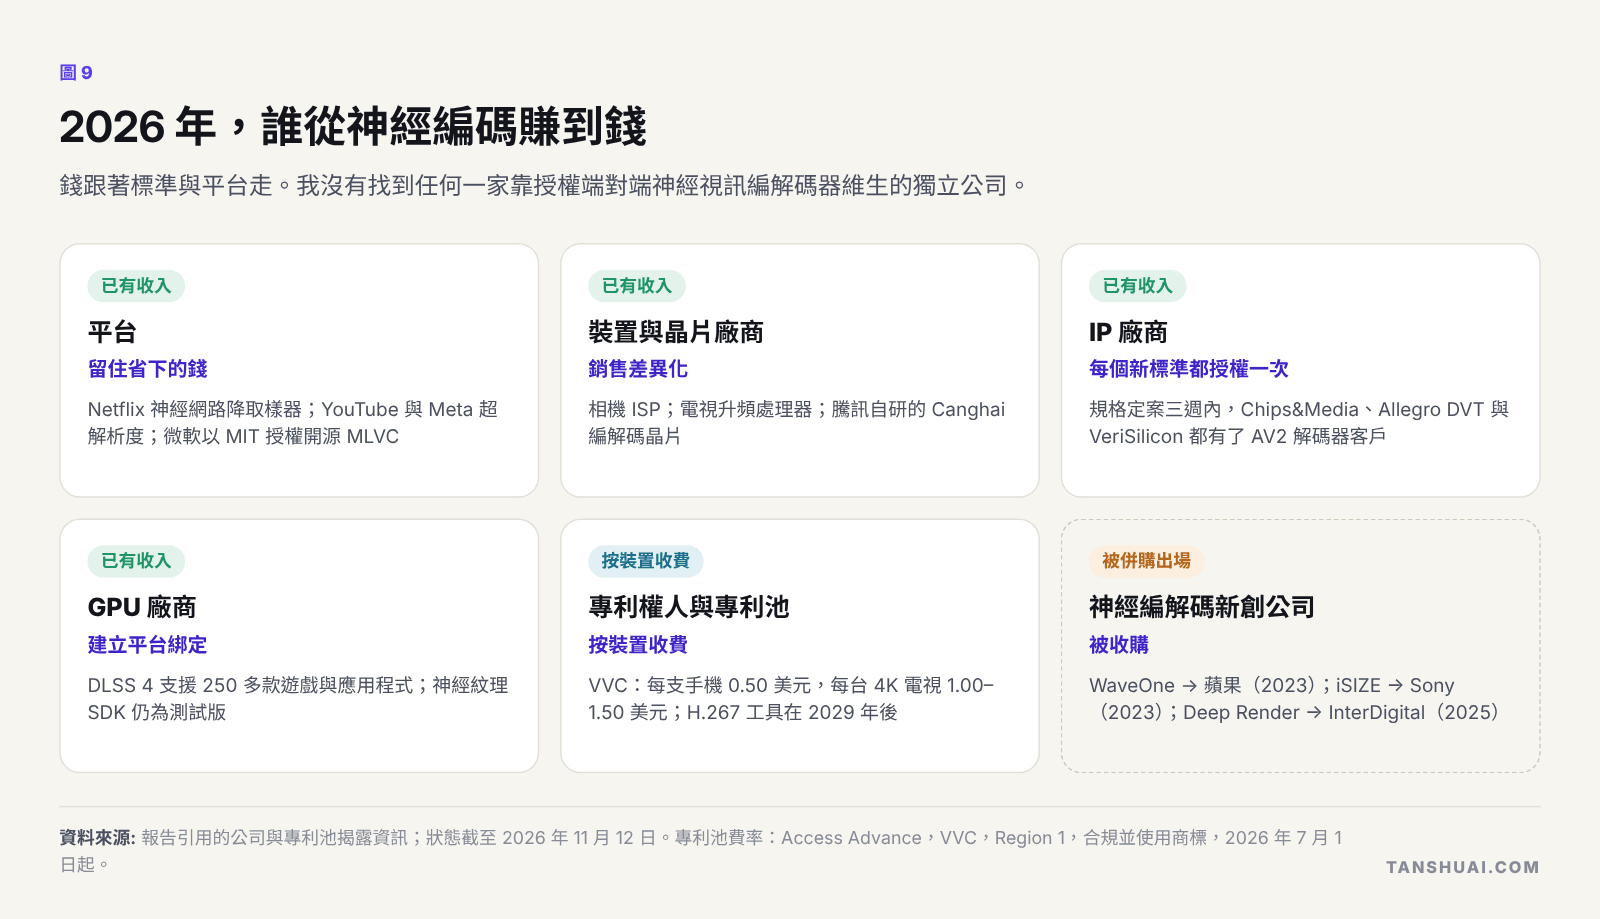 圖 9:錢跟著標準與平台走。
平台把省下的成本留給自己,有時還把程式碼免費送出,就像微軟對 MLVC 的做法。IP 廠商為每個新標準授權解碼器。專利池按裝置收費:VVC 在美國及其他 Region 1 市場,每支手機 0.50 美元,每台 4K 電視 1.00–1.50 美元。WaveOne 歸了蘋果,iSIZE 歸了 Sony,Deep Render 歸了 InterDigital。我沒有找到任何一家靠授權端對端神經視訊編解碼器維生的獨立公司。
對企業來說,仍有空間的切入點包括:為影音服務做神經前處理、為晶片廠商做顯示端畫質增強、為視訊會議與專用鏈路做封閉迴路神經編解碼器、編解碼器加 NPU 的晶片,以及所有出貨神經工具的業者都會需要的評測與一致性工具。參與 H.267 的標準工作,需要耐心與一套授權策略。
哪些說法要打折扣,接下來看什麼
對任何神經編解碼器的說法,都要問四件事:比較基準、指標、解析度與解碼成本。「節省 88%」是在 360p 下相對 H.264;「顯示記憶體減少 85–96%」是展示場景,已上市的遊戲則是 30%;「JPEG AI 是標準」背後還沒有產品。
值得關注的時間點:2027 年 1 月的 H.267 評估、2027 年初 YouTube 首批 AV2 串流、2027 年下半年 H.267 的第一個測試模型、MLVC 能否擴散到 Teams 以外、第一個預設採用 JPEG AI 的產品,以及手機與 PC 的 NPU 預算。2029 年底的 H.267 第一版,將啟動神經工具進入主流播放的晶片週期。
下載完整報告與簡報
完整報告更詳細地說明每個領域、晶片上的計算、標準與專利,並附有一張說法與證據的對照表,以及全部資料來源。
本文譯自英文版;內容如有出入,以英文版為準。
未解問題
這裡有幾個問題還沒有公開的答案,也是我在技術上最感興趣的:神經解碼器在失去壓縮優勢之前,能在不同廠商的 NPU 上多接近逐位元一致的整數運算;神經後處理每像素要耗用多少 DRAM 存取流量;神經工具的每像素成本到多少,在 H.267 解碼器中就不再划算;通話之外,還有哪些封閉系統能最先採用端對端神經編解碼器;以及當解碼器是在生成細節而非重建細節時,該如何衡量保真度。
未來幾年,這些都是我們可以透過技術交流與技術合作一起探索的領域:i@tanshuai.com。
關於作者
譚帥是技術專家與創辦人,在晶片、硬體與系統軟體領域工作超過二十年,擁有 20 項獲准專利。他有多年無晶圓廠晶片研發與管理經驗,包括全客製化 ASIC 資料路徑設計,以及視訊編解碼加速器等多媒體相機晶片專案。他的工作足跡遍及矽谷、紐約、芝加哥、台灣、大灣區(深圳與香港)、越南與馬來西亞。如今他是一名 AI 研發者。
技術交流:i@tanshuai.com。