
現在有一條區塊鏈跑在與 AI 相同的矩陣乘法上,算力約 90 EH/s。我讀了它的程式碼、鏈上資料與周邊的經濟帳,想回答三個問題:AI × 加密貨幣裡哪些東西有付費客戶、什麼時候值得做 ASIC、哪種製程節點適合哪種晶片。附完整報告與簡報。
摘要
Pearl 於 2026 年 4 月上線,是第一條以大規模 AI 式矩陣乘法作為工作量證明的區塊鏈。2026 年 11 月 13 日,其全網算力約 90 EH/s,其中 1 H 是一次 INT7 乘加:約相當於 12.2 萬張 H100 的整數吞吐量。它在工程上可行,但還談不上有用:只有約 1% 的區塊承載真實 AI 工作,因為一張邊提供推論服務邊挖礦的 GPU,只能保有專用礦卡 1% 到 27% 的算力。綜觀 AI × 加密貨幣,可驗證的付費需求出現在三處:賣推論、賣資料、賣隱私;而補貼則是外部收入的 4 到 360 倍。就晶片而言,ASIC 的利潤上限是單位算力收入乘以 (1 − 1/k),所以 k = 5 之後效率再提升也幫助不大;真正起決定作用的是盤子的大小、規則的穩定性與第二市場。目前沒有任何網路三者兼具。合適的製程節點由晶片終生成本中最大的一項決定,而晶片本身應分階段購買,這樣規則一旦改變,損失的只是一個原型,而不是一次投片。
我為什麼研究這個
我花了多年時間設計晶片,包括加密貨幣挖礦用的全客製化 ASIC 資料路徑,現在則投入 AI。當一條鏈出現、它的安全預算真的以張量吞吐量計價時,像我這樣的人自然會問:這份工作有用嗎?專用晶片會勝出嗎?做一顆要花多少錢?
我讀了 Pearl 的程式碼與協議提案、來自獨立全節點的鏈上資料、公司申報文件、密碼學、計算機架構與機器學習的論文、晶圓代工與廠商的價格資料,以及產業媒體。以下每個數字都以 2026 年 11 月 13 日為準,金額單位為美元。這份筆記是我學習這個領域的過程;分享出來,是希望別人能查核它、使用它、與它爭論。附有全部來源的完整報告放在文末。
結果一覽
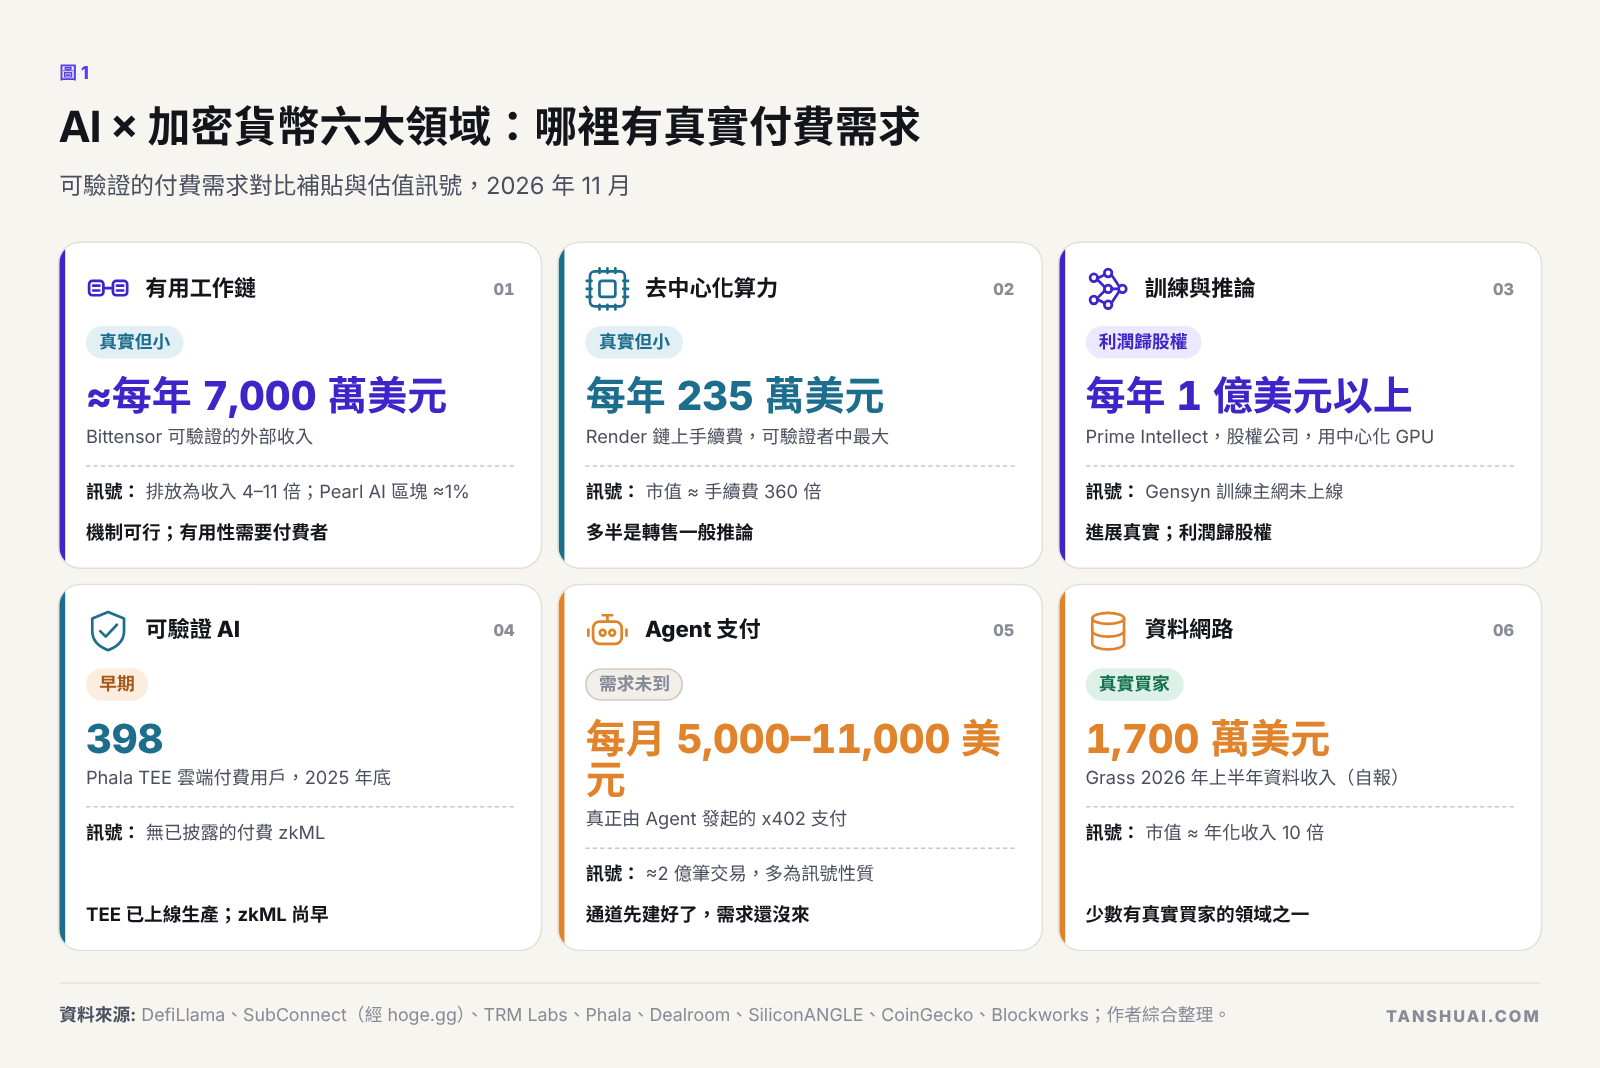 圖 1. AI × 加密貨幣六大領域:哪裡有真實付費需求。
| 問題 | 簡答 |
|---|---|
| Pearl 可行嗎?它的工作有用嗎? | 可行:約 90 EH/s 的矩陣乘法保護著這條鏈。還談不上有用:只有約 1% 的區塊承載 AI 工作 |
| 真實付費需求在哪裡? | 推論、資料與隱私。Agent 支付、zkML 與去中心化訓練仍處於需求出現之前 |
| 值得做 ASIC 嗎? | 只有在盤子大、規則穩、有第二市場時才值得;目前沒有網路三者兼具 |
| 小團隊該做哪些晶片? | 推論優先、也能挖礦的加速器,為已簽約客戶做的推論晶片,提早投入 FHE;不做商用 Bitcoin 礦機或訓練晶片 |
| 第一顆晶片要花多少錢? | 分階段購買:模型、FPGA 與 MPW 約 150 萬美元就能拿到實測的矽,之後才是要價數百萬美元的光罩 |
Pearl:一次乘加就是一次雜湊
Pearl 建立在 Ilan Komargodski 與 Omri Weinstein 2025 年的一項成果上:對任意矩陣乘積的有用工作量證明,成本為乘法本身的 1 + o(1) 倍。礦工對加噪矩陣做乘法,把每個輸出 tile 的累加器雜湊成一張彩券,再以小於 60 KB 的零知識證明證實中獎的 tile。在共識程式碼中,1 H 是一次計入的 INT7 × INT7 → INT32 乘加,因此區塊鏈的安全預算第一次以 AI 加速器的張量吞吐量計價。
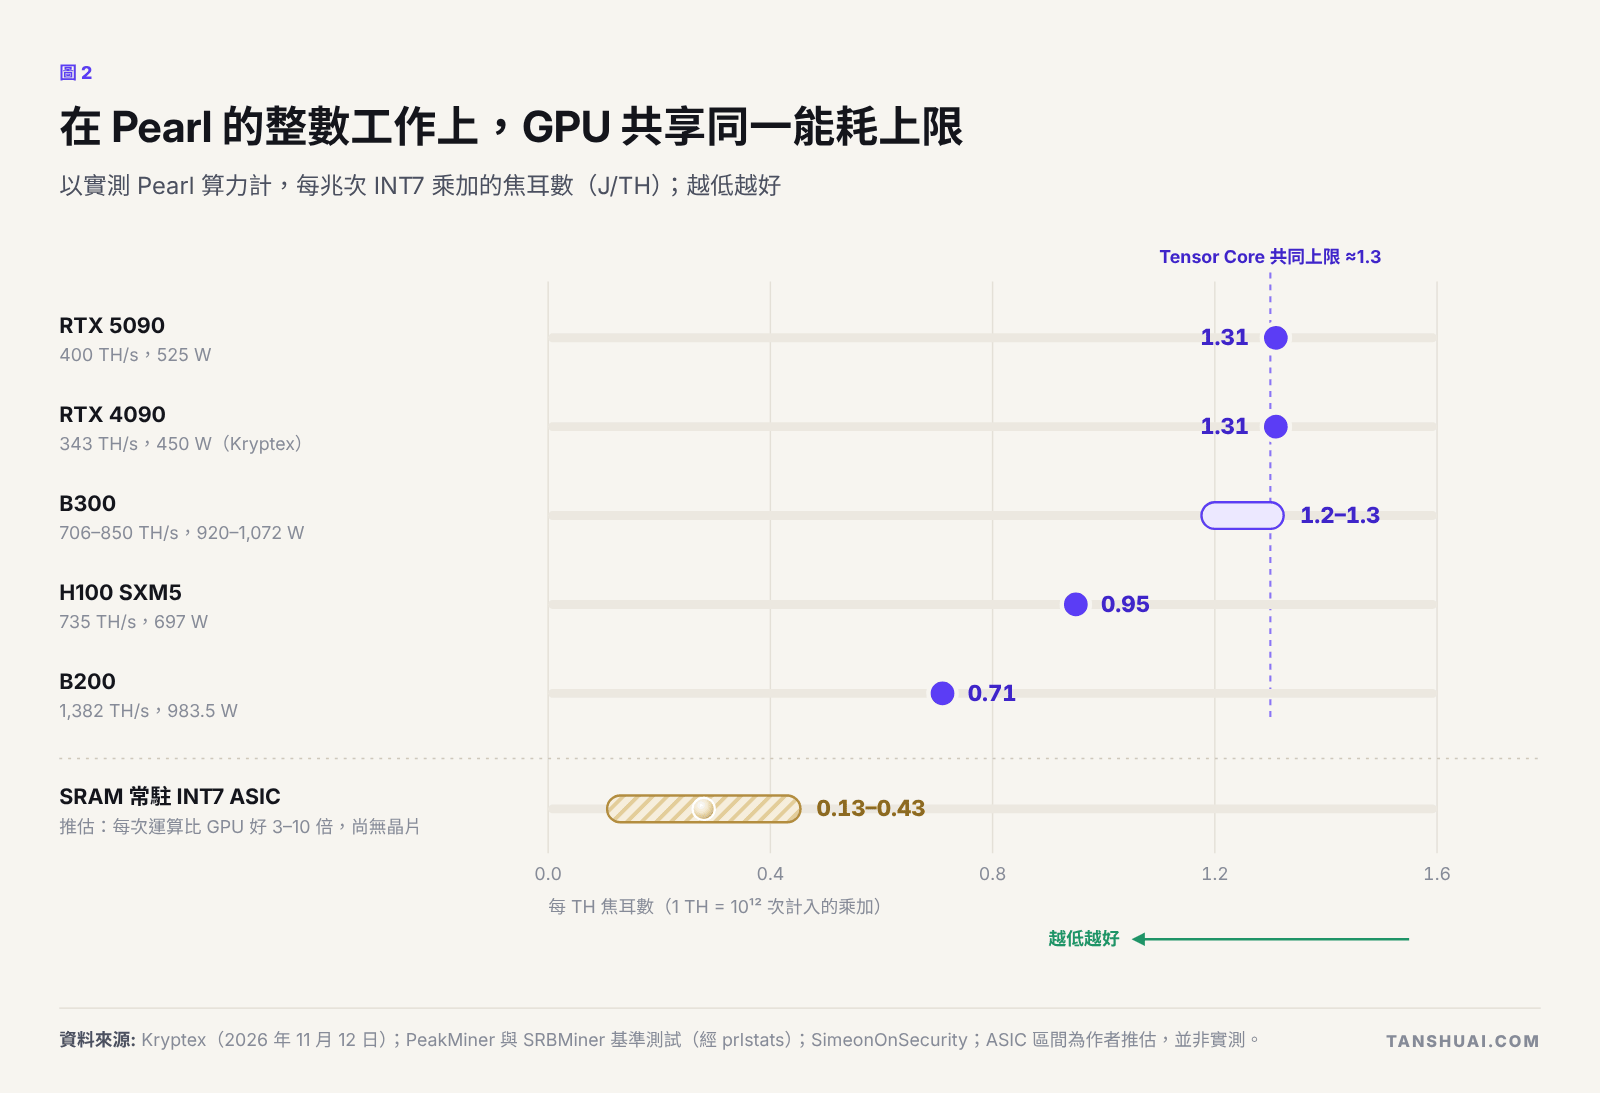 圖 2. 在 Pearl 的整數工作上,GPU 共享同一能耗上限。
遊戲顯示卡與資料中心級的 B300 都落在約 1.3 J/TH,連 B200 也只到 0.71。這個共同上限正是專用晶片可能突破之處:一顆只從晶片內 SRAM 讀取、只做 7 位元整數乘法、沒有 HBM 與通用單元的晶片,有理由在每次運算上好 3 到 10 倍。與此同時,輝達正把最新的晶片從 INT8 轉向 FP8 與 FP4,這也是 Pearl 準備更換其算術的原因。
Pearl 的經濟:定理成立,激勵不成立
Pearl 的算力跟著價格走。全網算力從上線第二天的 0.01 EH/s,成長到 5 月底的 23–26 EH/s;在價格下跌約 86% 的夏季維持在 21–39 EH/s;秋季價格上漲約十倍後,達到約 90 EH/s。前六天挖出約 1.2 億枚幣,約占目前供給的 32%;未來 12 個月供給還將增加約 78%。一張 RTX 5090 現在每天約賺 5–6 美元。
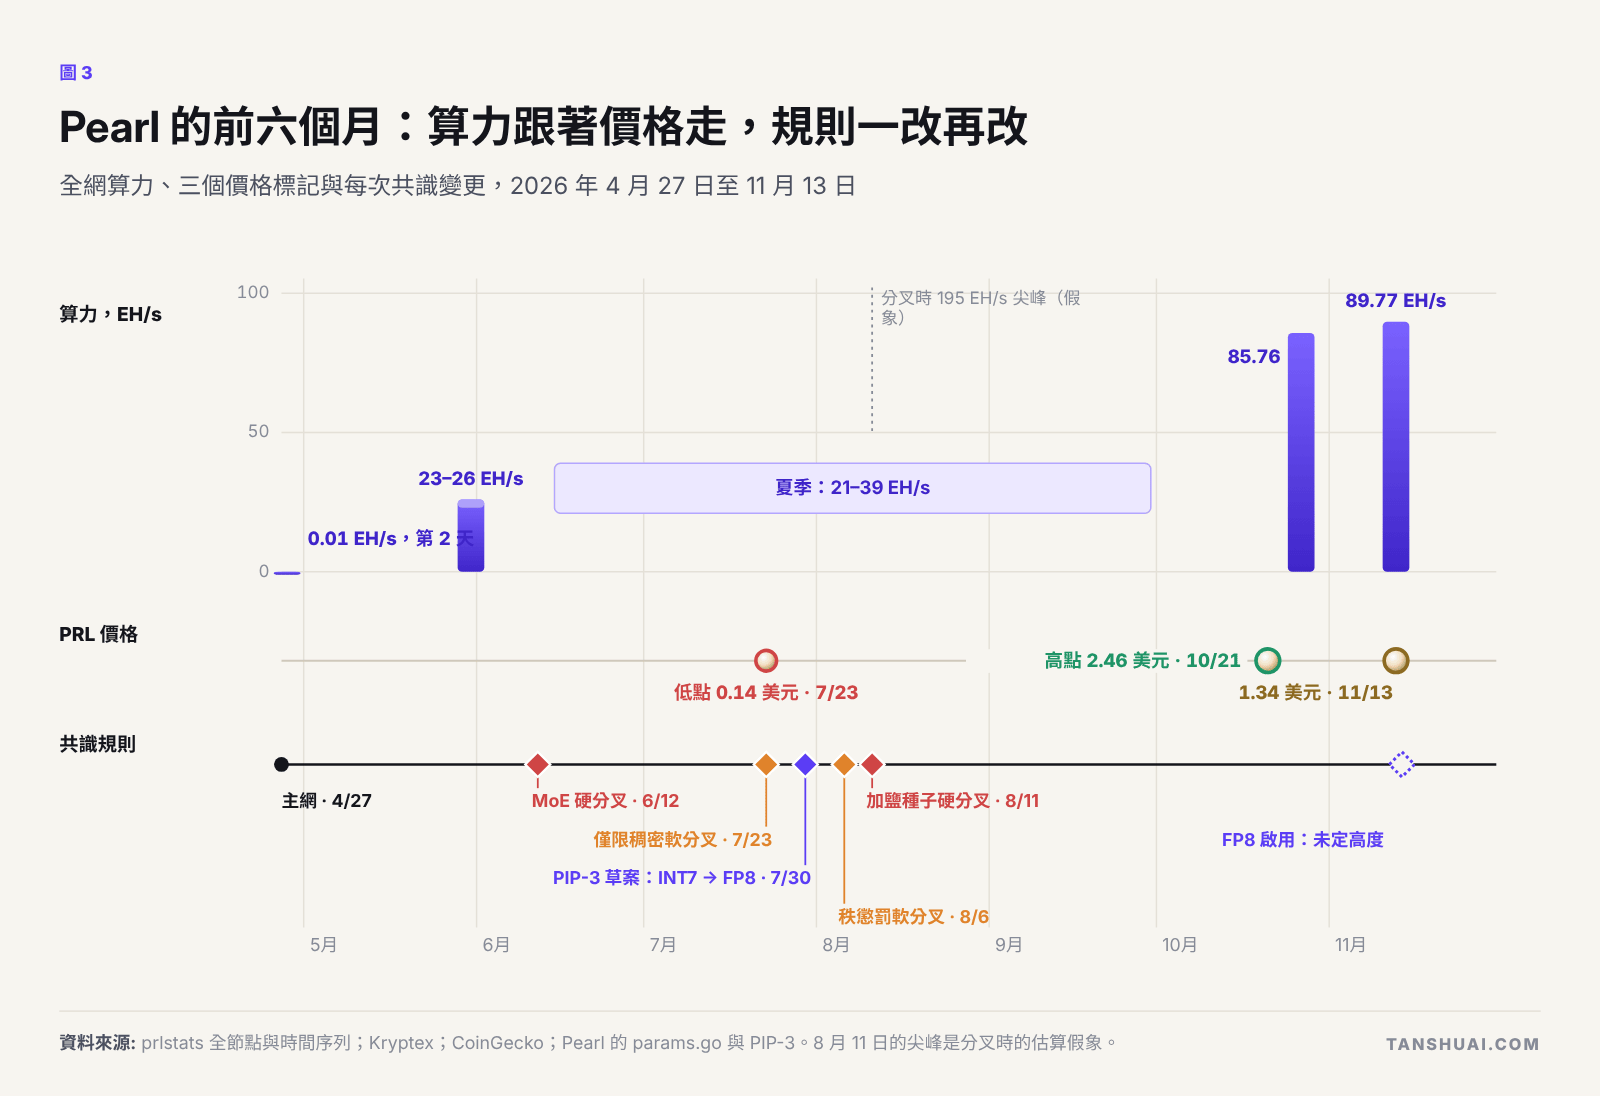 圖 3. Pearl 的前六個月:算力跟著價格走,規則一改再改。
模型恰恰在「有用」這部分出了問題。在真實推論中挖礦,推論端的代價不大,約為吞吐量的 5% 到 9%;但挖礦端的收益也不大:Pearl 的外掛只在長 prefill 批次上挖礦,所以一張跑聊天工作負載的卡,只保有專用礦卡約 5% 的算力。因此理性的礦工會去乘隨機矩陣,而協議分辨不出來。唯一公開的推論合作,已不在其供應商的 serverless API 上提供。Pearl 的有用性是鏈下的商業問題:總得有人為推論付錢。
規則是另一項風險。6 月到 8 月間,實驗室在寫死的區塊高度上啟用了四次共識變更;其 PIP-3 草案把挖礦改為 FP8,且只為兩種輝達架構提供逐位元精確的裝置設定檔。一種數字格式可以對 AI 有用、逐位元可驗證、硬體中立,但三者最多只能兼顧兩項。
綜觀 AI × 加密貨幣:補貼是燃料,不是商業模式
其他有用工作鏈講的是同一個故事。Kaspa 把矩陣乘積放進雜湊,16 個月內還是出現了 ASIC;它最好的機器現在每天賺 0.86 美元。Aleo 的合成證明謎題在五個月內就有了專用硬體,付給證明者的獎勵是其手續費的 175–180 倍。Bittensor 是這群網路中唯一具規模化外部收入者,每年約 7,000 萬美元,對比逾 3 億美元的排放。
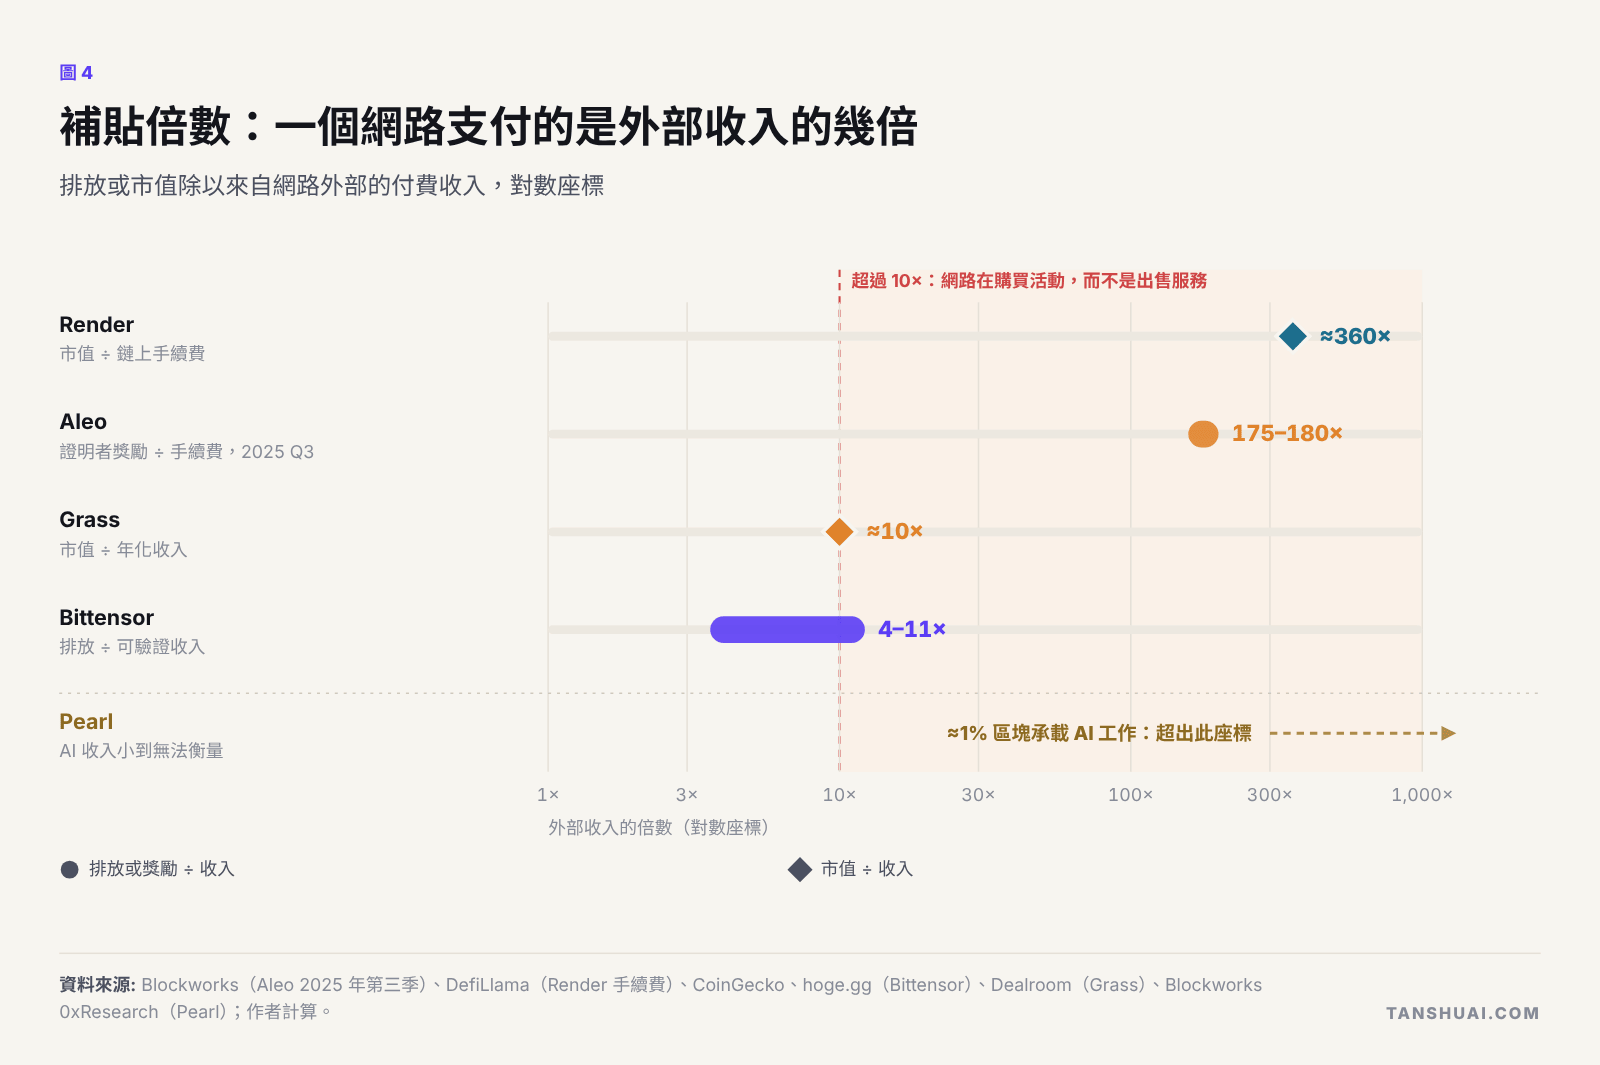 圖 4. 補貼倍數:一個網路支付的是外部收入的幾倍。
在共識之外,整體圖像是規模不大的真實需求。去中心化 GPU 市場販售一般推論,價格勝過超大規模雲端業者,但不及最便宜的新興雲端業者。透過網際網路訓練在 80 到 400 億參數的規模可行,而前沿級訓練則回到了中心化叢集。可信執行環境已在生產環境中執行機密推論;AI 的零知識證明仍停留在實驗室。儘管 Visa、Mastercard、Stripe 與 Google 都建了通道,由 AI Agent 發起的支付每月只有約 5,000–11,000 美元。資料是少數有真實買家的領域之一。與此同時,四家建在中心化基礎設施上的股權公司,價值約等於所有協議層與應用層 AI 代幣的總和:加密貨幣負責分發與結算,利潤則歸股權。
ASIC 何時划算:一條公式,三把尺
當 GPU 決定挖礦的價格時,單位算力收入會趨近其成本,而便宜 k 倍的 ASIC 最多保留 (1 − 1/k) 的收入。這條曲線是凹的:k = 2 時 50%,k = 5 時 80%,k = 10 時 90%。k = 5 之後,效率再提升也增加不了多少利潤;而對只付電費的閒置 GPU,有效的 k 可能只有約 2.5。
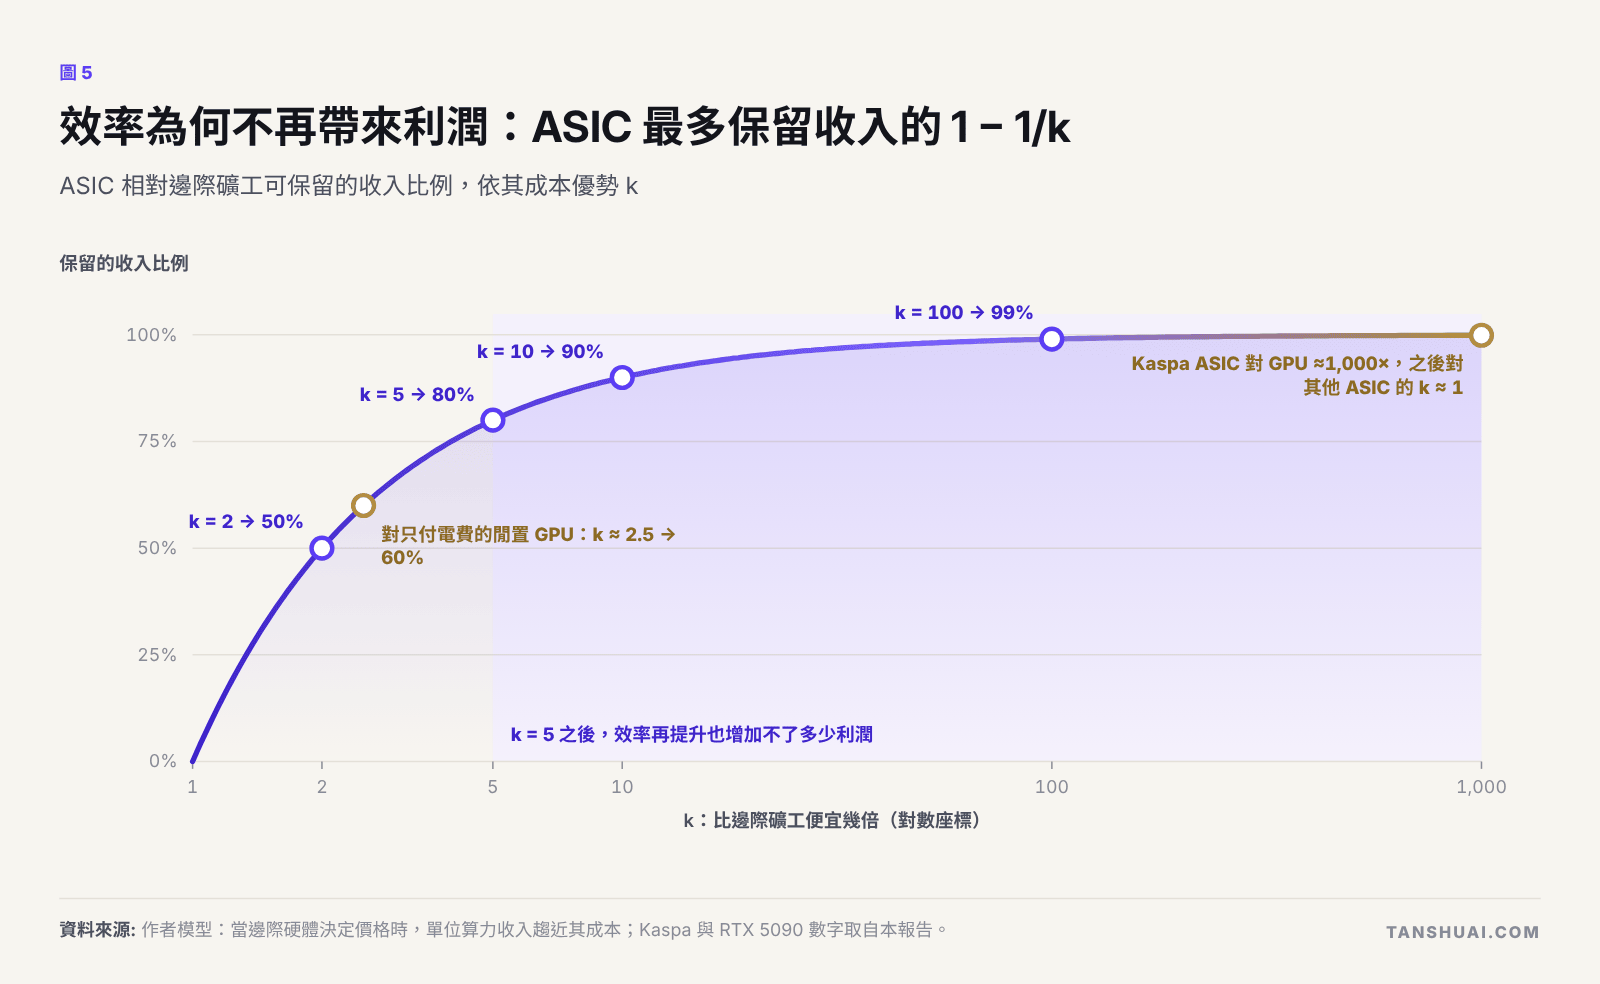 圖 5. 效率為何不再帶來利潤:ASIC 最多保留收入的 1 − 1/k。
接著由三把尺來決定:盤子、回本規模與規則。Bitcoin 礦工每年約賺 115 億美元,Pearl 約 4.6–4.9 億美元,Aleo 約 3,100 萬美元,Kaspa 約 1,800 萬美元,還不到一顆 5/4 nm 晶片設計的低標。就 Pearl 而言,一顆 2,000 萬美元、k = 5 的晶片,若規則維持,需要約 4.9 EH/s 運轉一年才能回本;若規則維持的機率只有五成,則需要兩倍。
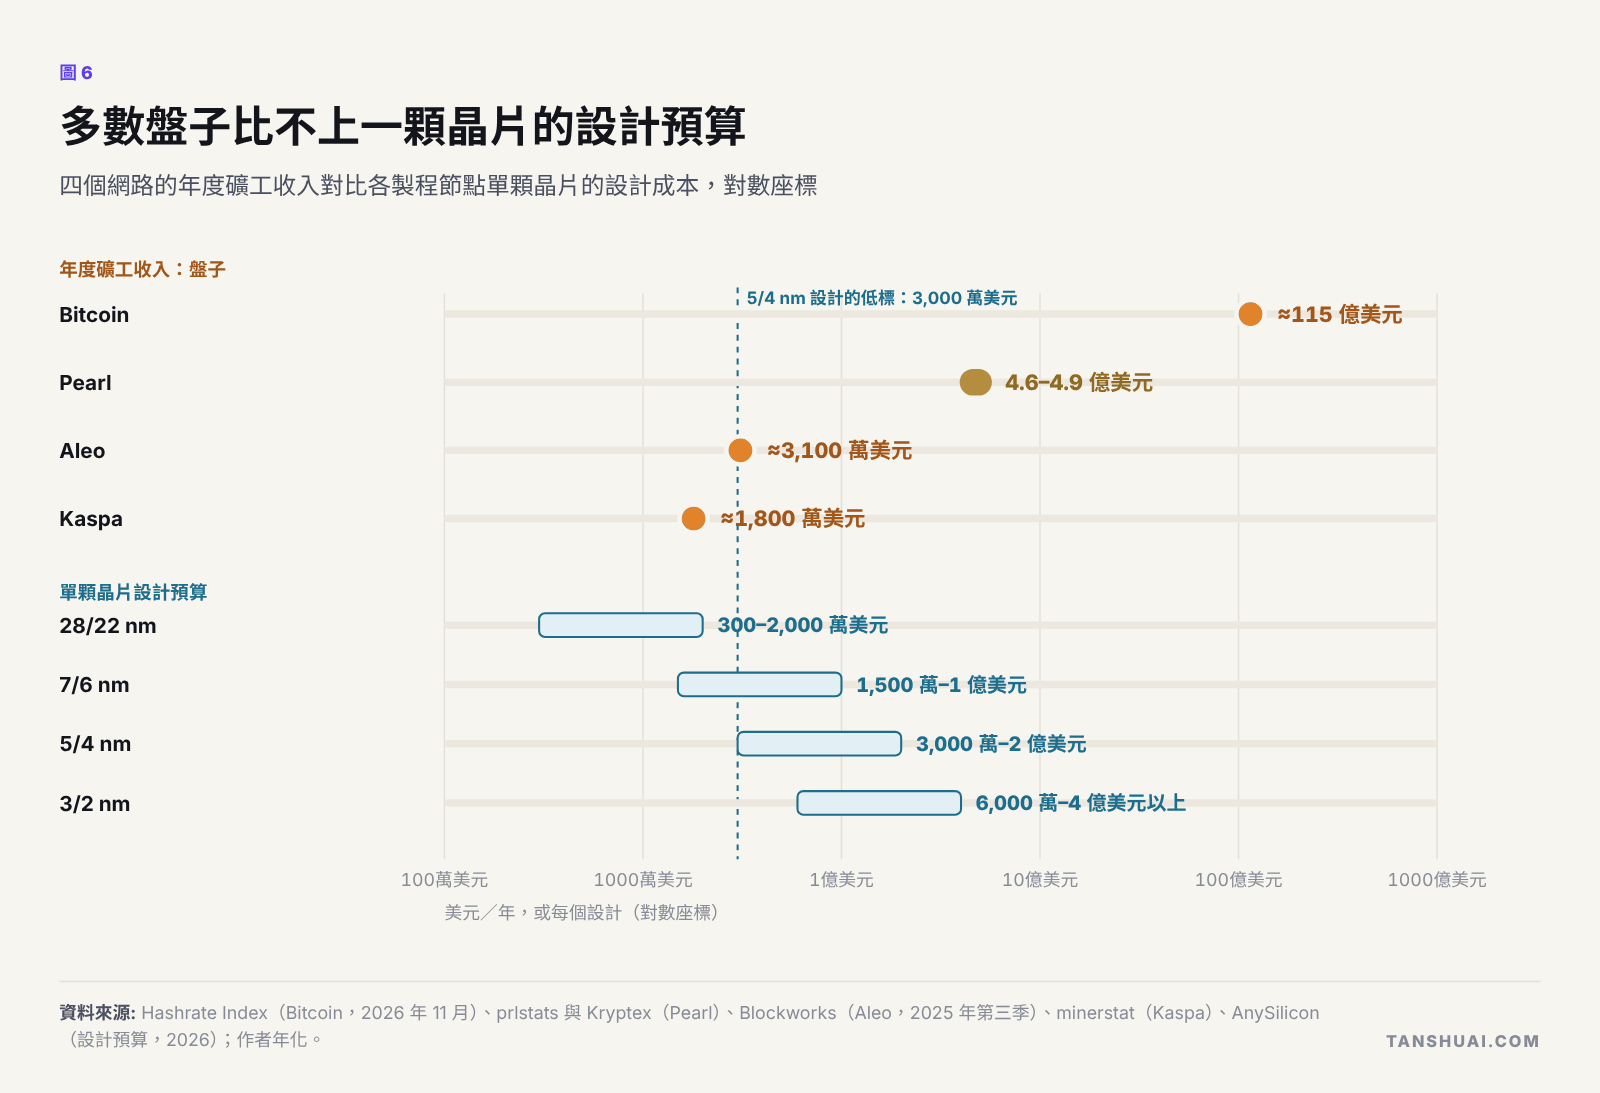 圖 6. 多數盤子比不上一顆晶片的設計預算。
目前沒有任何網路同時具備大盤子、穩定規則與大於 1 的 k:Bitcoin 的 k 屬於既有業者,Pearl 的規則最不穩定,Kaspa 與 Aleo 的盤子太小。
五類晶片,五種答案
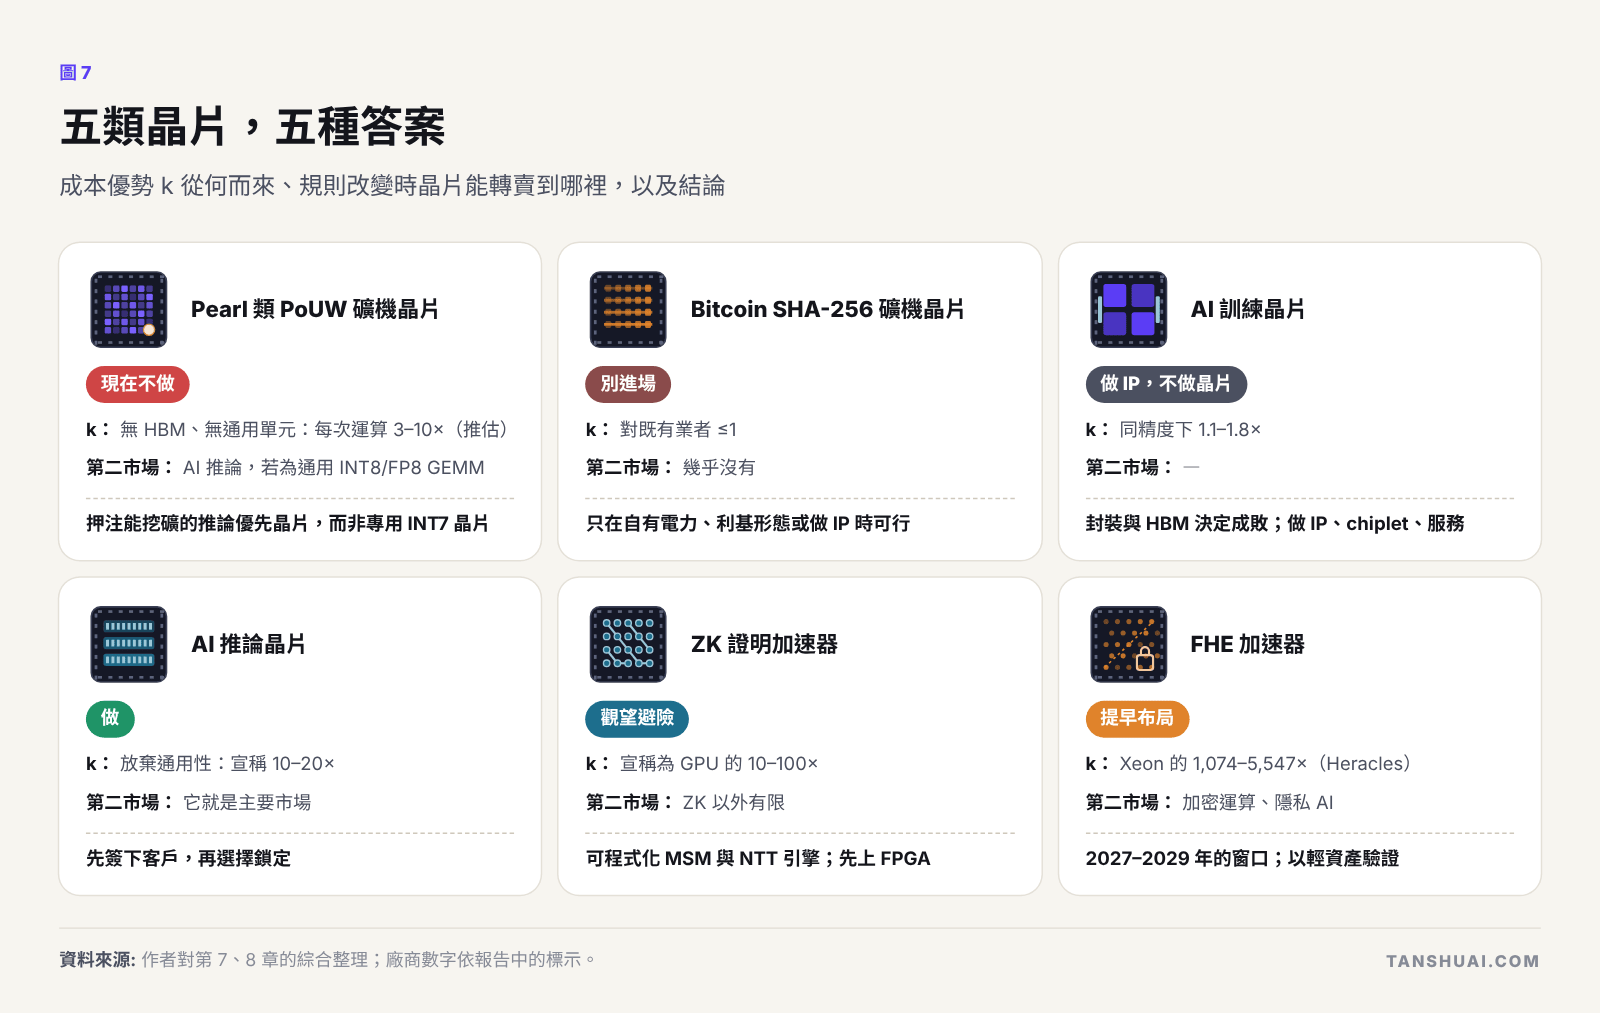 圖 7. 五類晶片,五種答案。
就 Pearl 而言,我現在不會投片做專用 INT7 晶片:新團隊需要 18 到 24 個月,屆時協議可能已改用 FP8。更好的押注是建立在通用 INT8/FP8 GEMM、運算元放在 SRAM 中的推論優先加速器,這樣一旦挖礦之路被關上,晶片仍有第二市場。新團隊應避開商用 Bitcoin 礦機市場:比特大陸出貨的機器已達 8.9 J/TH,挑戰者正在撤退;電力場址如今作為 AI 資料中心比作為礦場更值錢。小團隊不應做獨立的訓練晶片。推論晶片值得為已簽約的客戶而做,ZK 加速器是一種避險,FHE 加速器則是為 2027–2029 年提早布局。
製程節點與分階段預算
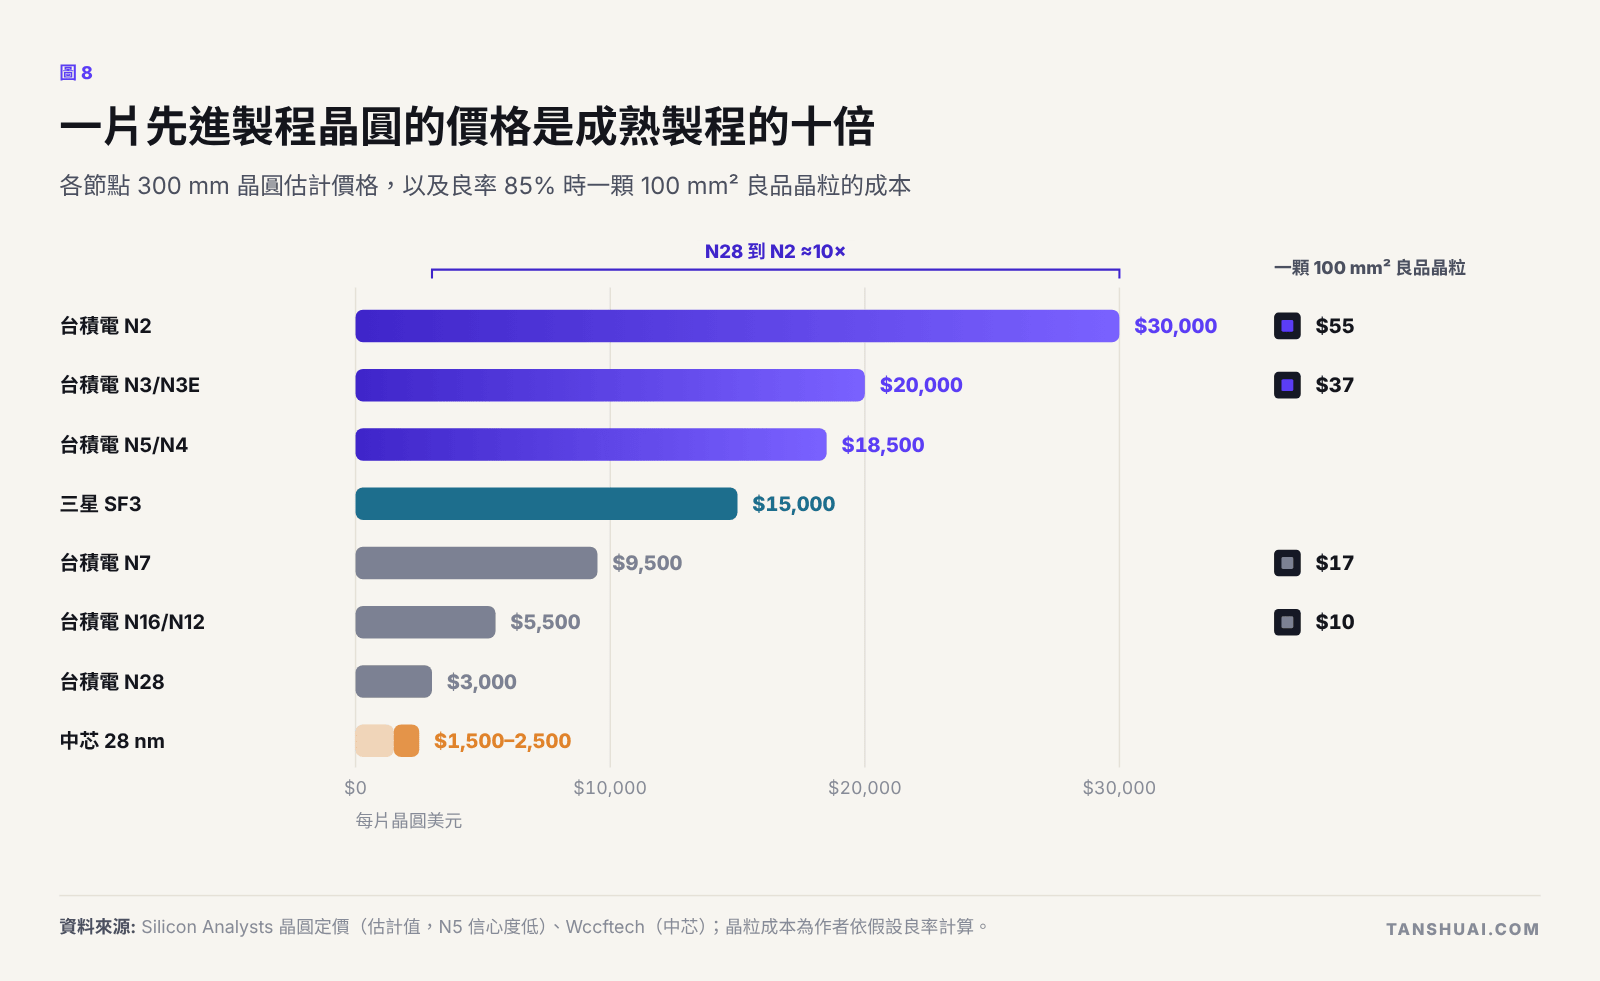 圖 8. 一片先進製程晶圓的價格是成熟製程的十倍。
讓晶片終生成本中最大的一項來選擇節點:全天候運轉的運算晶片看能耗,訓練晶片看封裝與 HBM(約占 H100 成本的 63%),推論晶片看 SRAM 與 HBM 之間的取捨。PoUW 礦機晶片可以先在 28 或 16/12 nm 的多專案晶圓上做原型,等演算法與收入穩定後,再轉到 N7/N6,然後是 N5/N4。
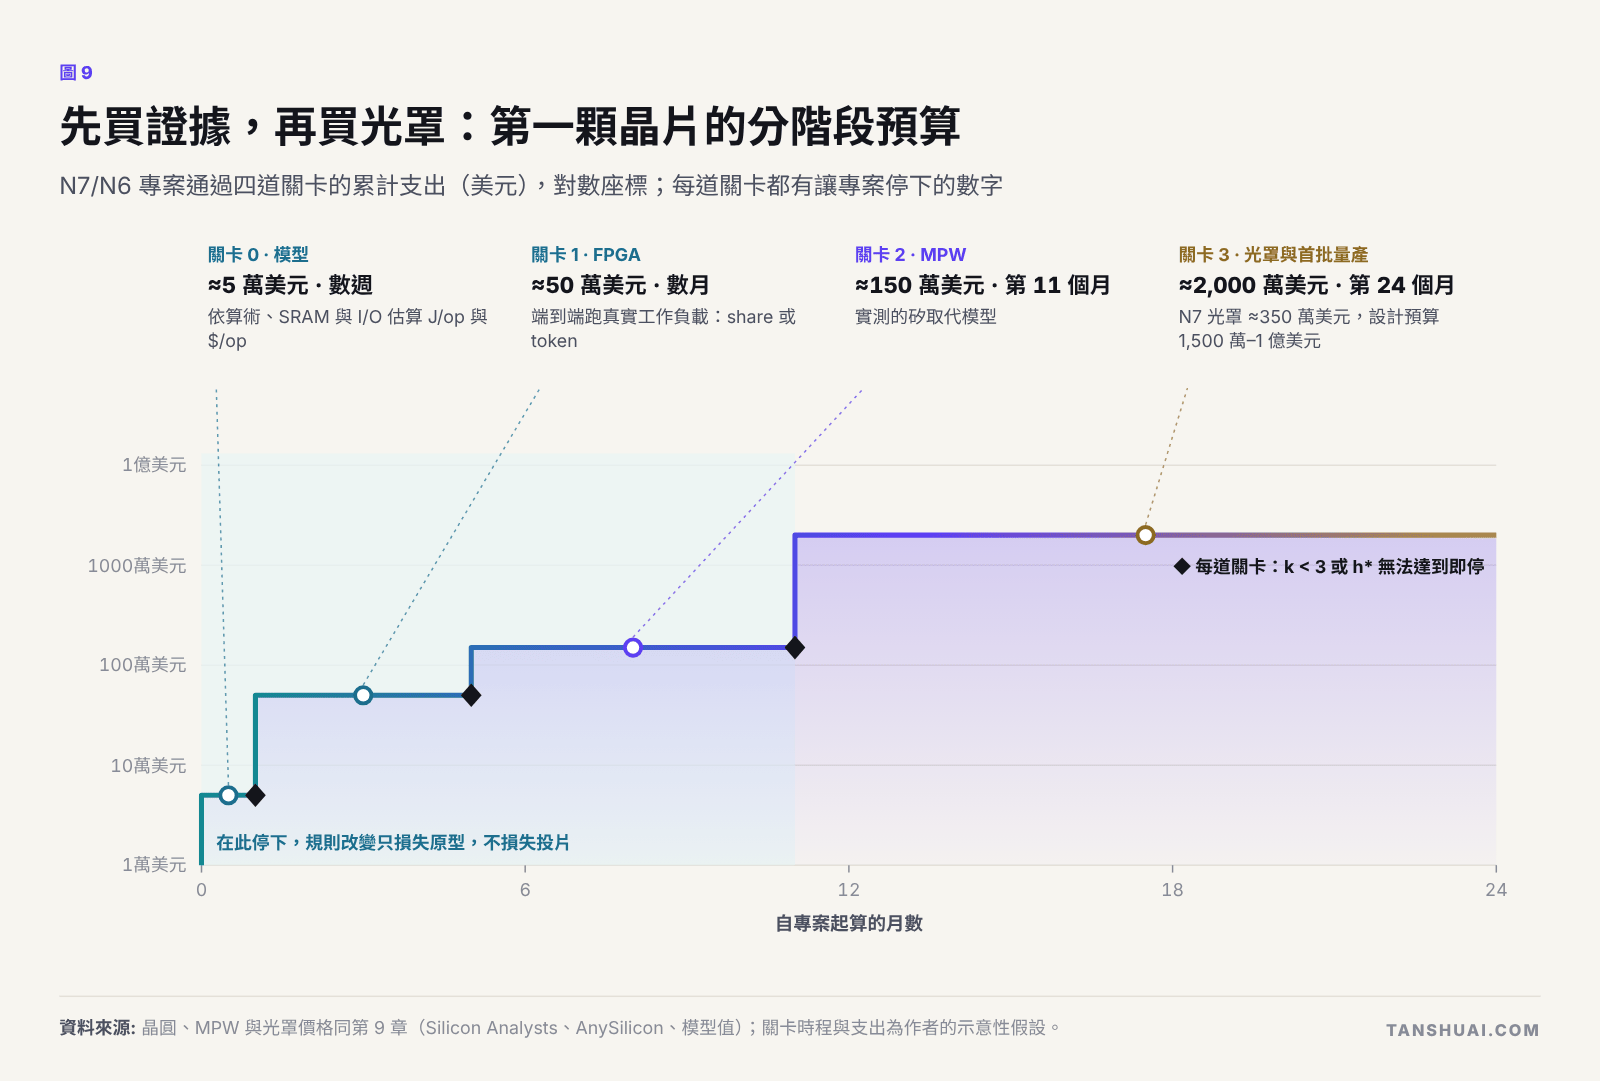 圖 9. 先買證據,再買光罩:第一顆晶片的分階段預算。
第一顆晶片應分四個階段購買,每個階段都有一個讓專案停下的數字:J/op 與 $/op 的模型、跑真實工作負載的 FPGA、多專案晶圓,最後才是光罩組。在 N7/N6 上,前三階段約花 150 萬美元、十一個月;光罩組與第一批量產的花費是其十倍以上 [估算]。如果協議改了算術,或買家走了,停在晶圓階段的團隊損失的是一個原型的價格,而不是一次投片的價格。最便宜的效率來自架構:把運算元放在 SRAM 中、拿掉 HBM,在選定任何節點之前就已去除 GPU 大部分的成本。
我會從哪裡開始
機會在領域交會之處:加密貨幣是第一個客戶,AI 是第二市場。2026 年客製化晶片的需求壓倒性來自 AI,而礦機晶片團隊的能力,低壓陣列、千瓦級供電與快速投片,可以直接移轉。我最多會走三條路,每條都以一小步先行驗證:推論優先、也能挖礦的加速器,從為期四週的 J/op 與 $/op 研究開始;以加密貨幣為第一個客戶的客製化晶片服務,從付費可行性研究開始;以及在設計代幣之前先簽下算力買家的 AI 原生網路。
下載完整報告與簡報
完整報告詳細介紹 Pearl 的機制、經濟與規則,其他有用工作鏈與更廣的 AI × 加密貨幣版圖,ASIC 模型及其回本計算,逐類晶片的結論,節點成本與選擇,第一顆晶片的分階段預算,一份觀察指標清單,以及全部資料來源。
- 算力即共識:完整報告(PDF)
- 算力即共識:簡報(PDF)
- 英文版:完整報告 · 簡報
本文譯自英文版;兩者如有出入,以英文版為準。
你沒問但該問的問題
在把資金或晶片投入任何 AI × 加密貨幣專案之前,我會問:誰控制工作函數;補貼倍數是多少;下一道關卡要花多少、什麼數字會讓你停下;回本算力是多少、p 是多少;晶片的第二市場是什麼;價值落在代幣還是股權;以及第一個付費客戶是誰,請說出名字。
以下是我們可以透過技術交流與技術合作一同探索的領域:用於挖礦、AI 訓練與推論的客製化晶片,以及各類加速器;AI 開發;以及從鏈到節點到晶片的 AI × 加密貨幣系統。歡迎來信 i@tanshuai.com。
關於作者
譚帥是一位技術人與創業者,在晶片、硬體與系統軟體領域累積了二十多年的經驗,擁有 20 項已獲授權的專利。他有多年 fabless 晶片研發與管理經驗,包括加密貨幣礦機晶片的全客製化 ASIC 資料路徑設計,以及多媒體相機晶片。他的工作經歷橫跨矽谷、紐約、芝加哥、台灣、大灣區(深圳與香港)、越南與馬來西亞。如今他是一位 AI 研發者。
技術交流:i@tanshuai.com。