
En blockchain kører nu på den samme matrixmultiplikation som AI, med omkring 90 EH/s. Jeg har læst dens kode, dens kædedata og økonomien omkring den for at besvare tre spørgsmål: hvad i AI × krypto har betalende kunder, hvornår en ASIC er værd at bygge, og hvilken procesnode der passer til hvilken chip. Med hele rapporten og slides.
Sammenfatning
Pearl, lanceret i april 2026, er den første blockchain, hvis proof of work er matrixmultiplikation af AI-typen i stor skala. Den 13. november 2026 kørte netværket med omkring 90 EH/s, hvor én H er én INT7-multiplikation-akkumulering: heltalskapaciteten i omkring 122.000 H100'ere. Det virker som ingeniørarbejde. Det er endnu ikke nyttigt: omkring 1 % af blokkene bærer reelt AI-arbejde, fordi en GPU, der miner, mens den betjener inferens, kun beholder 1 % til 27 % af en dedikeret miners hashrate. På tværs af AI × krypto viser verificerbar betalt efterspørgsel sig tre steder, salg af inferens, salg af data og salg af privatliv, mens subsidierne løber fra 4 til 360 gange den eksterne omsætning. For chips er en ASIC's profitloft omsætningen pr. regneenhed gange (1 − 1/k), så effektivitet ud over k = 5 tilfører lidt; det afgørende er puljens størrelse, reglernes stabilitet og et andet marked. Intet netværk tilbyder alle tre i dag. Den rette procesnode bestemmes af den største post i en chips levetidsomkostning, og selve chippen bør købes i etaper, så en regelændring koster en prototype snarere end en tape-out.
Hvorfor jeg kiggede på dette
Jeg har i mange år designet chips, herunder fuldt specialdesignede ASIC-datapaths til mining af kryptovaluta, og nu arbejder jeg med AI. Da der dukkede en kæde op, hvis sikkerhedsbudget bogstaveligt talt er prissat i tensorkapacitet, var spørgsmålene for en som mig oplagte: er arbejdet nyttigt, ville en dedikeret chip vinde, og hvad ville det koste at bygge en?
Jeg har læst Pearls kode og protokolforslag, kædedata fra en uafhængig fuld node, selskabsindberetninger, artikler inden for kryptografi, computerarkitektur og maskinlæring, prisdata fra foundryer og leverandører samt fagpressen. Hvert tal nedenfor er pr. 13. november 2026, og beløb er i amerikanske dollar. Dette notat er den måde, jeg har lært feltet på; jeg deler det, så andre kan kontrollere det, bruge det og diskutere det. Hele rapporten med alle kilderne findes til sidst.
Resultaterne i overblik
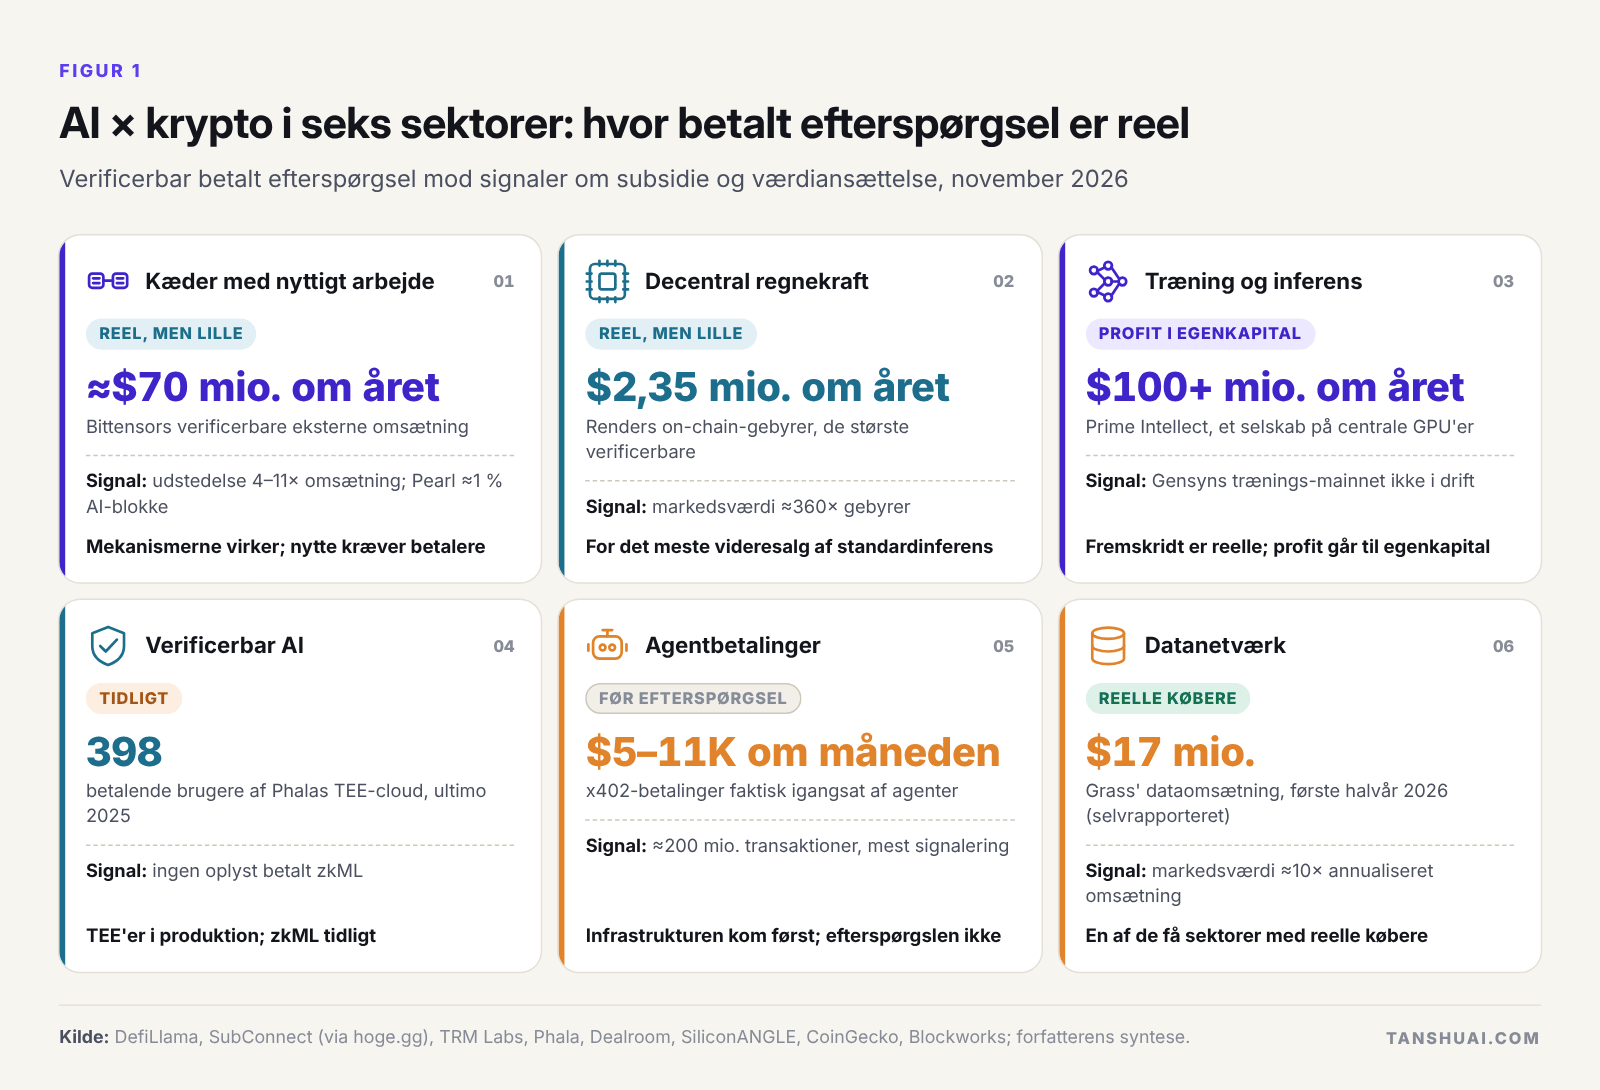 Figur 1. AI × krypto i seks sektorer: hvor betalt efterspørgsel er reel.
| Spørgsmål | Kort svar |
|---|---|
| Virker Pearl, og er dets arbejde nyttigt? | Det virker: omkring 90 EH/s matrixmultiplikation sikrer kæden. Det er endnu ikke nyttigt: omkring 1 % af blokkene bærer AI-arbejde |
| Hvor er den reelle betalte efterspørgsel? | Inferens, data og privatliv. Agentbetalinger, zkML og decentral træning er stadig før efterspørgslen |
| Er en ASIC værd at bygge? | Kun med en stor pulje, stabile regler og et andet marked; intet netværk tilbyder alle tre i dag |
| Hvilke chips bør et lille team bygge? | Inferens-først-acceleratorer, der også kan mine, inferenschips til en kunde, der har skrevet under, tidligt FHE-arbejde; ikke bitcoin-minere til videresalg eller træningschips |
| Hvad koster en første chip? | Køb den i etaper: en model, en FPGA og en MPW når frem til målt silicium for omkring $1,5 mio., før masker, der koster millioner |
Pearl: én multiplikation-akkumulering er én hash
Pearl bygger på et resultat fra 2025 af Ilan Komargodski og Omri Weinstein: et bevis for nyttigt arbejde for ethvert matrixprodukt til 1 + o(1) gange omkostningen ved multiplikationen. Minerne multiplicerer støjfyldte matricer, hasher hver output-flises akkumulator til en lottokupon og beviser den vindende flise med et zero-knowledge-bevis på under 60 KB. I konsensuskoden er én H én krediteret INT7 × INT7 → INT32-multiplikation-akkumulering, så for første gang er en blockchains sikkerhedsbudget prissat i AI-acceleratorers tensorkapacitet.
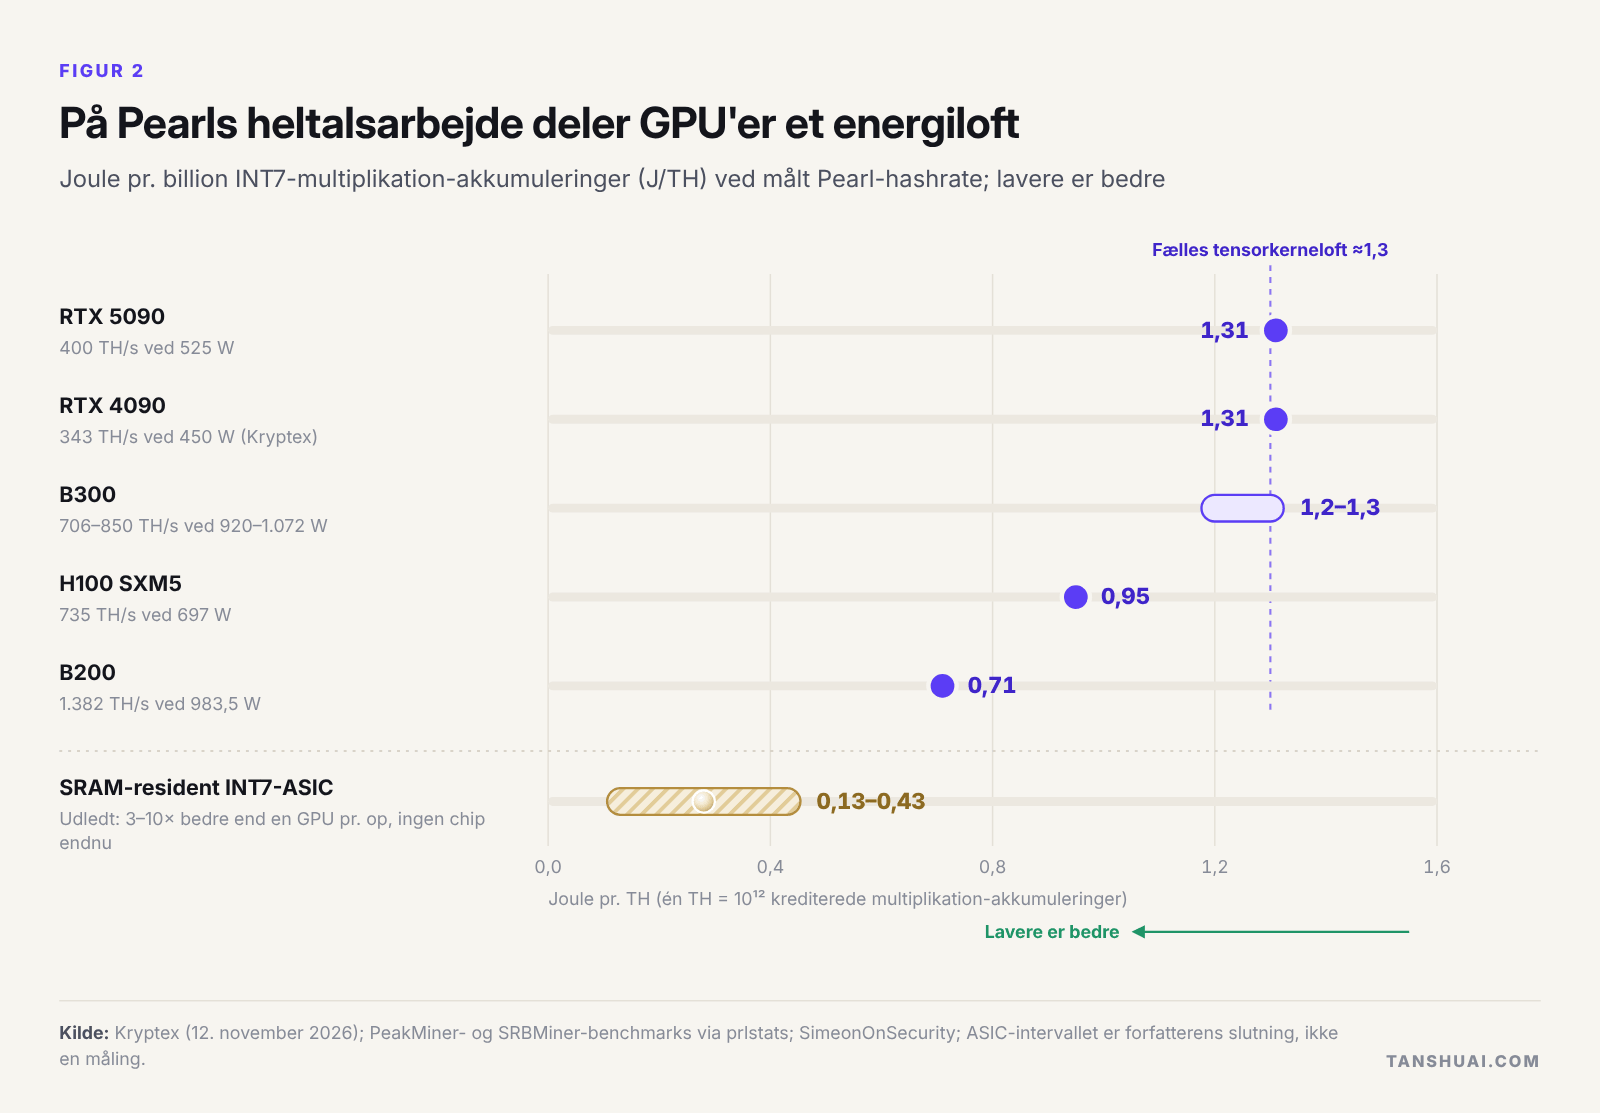 Figur 2. På Pearls heltalsarbejde deler GPU'er et energiloft.
Gamingkort og datacenterkortet B300 mødes ved omkring 1,3 J/TH, og selv B200 når kun 0,71. Netop det fælles loft er, hvad en dedikeret chip kunne bryde: en del, der kun multiplicerer 7-bit-heltal fra on-chip-SRAM, uden HBM eller generelle enheder, kunne plausibelt gøre det 3 til 10 gange bedre pr. operation. Imens flytter NVIDIA sit nyeste silicium væk fra INT8 mod FP8 og FP4, og derfor forbereder Pearl sig på at ændre sin aritmetik.
Pearls økonomi: teoremet holder, incitamentet gør ikke
Pearls hashrate følger prisen. Netværket gik fra 0,01 EH/s på andendagen til 23–26 EH/s ved udgangen af maj, holdt sig på 21–39 EH/s gennem en sommer, hvor prisen faldt omkring 86 %, og nåede omkring 90 EH/s, efter at prisen var steget omkring ti gange i efteråret. Omkring 120 mio. mønter, cirka 32 % af det nuværende udbud, blev udvundet de første seks dage, og udbuddet vil vokse med omkring 78 % de næste 12 måneder. En RTX 5090 tjener nu omkring $5–6 om dagen.
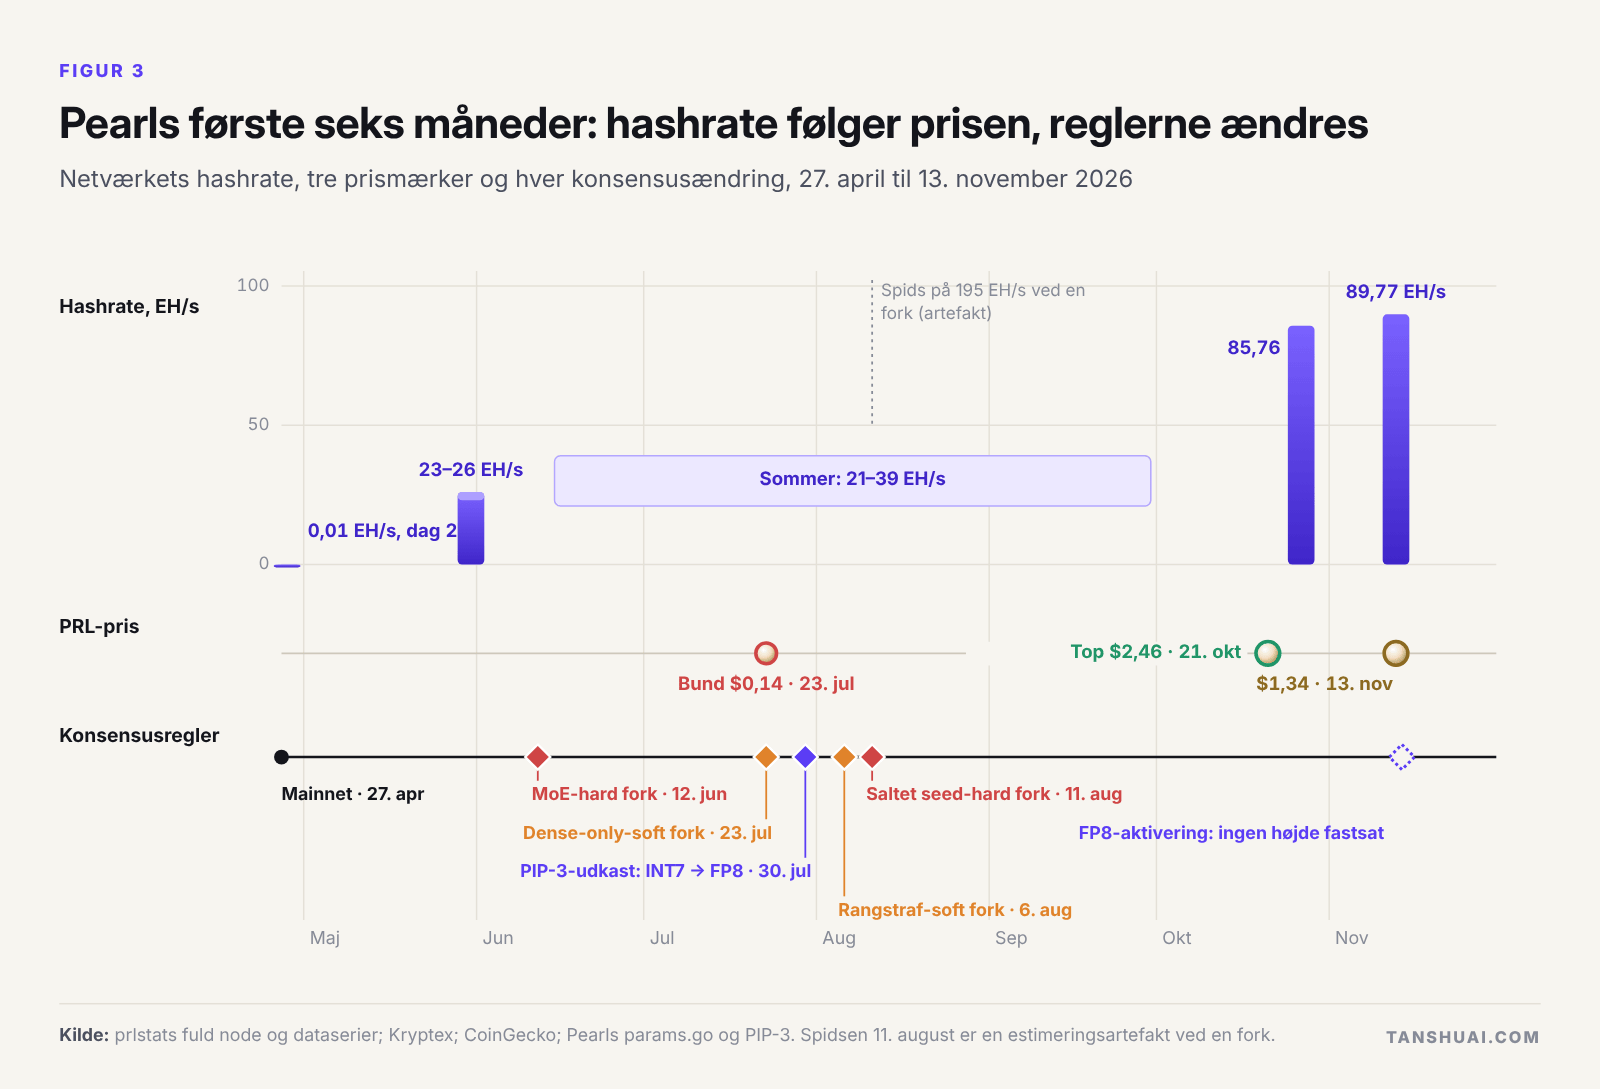 Figur 3. Pearls første seks måneder: hashrate følger prisen, reglerne ændres.
Det nyttige er dér, hvor modellen bryder sammen. Mining inde i reel inferens koster lidt på inferenssiden, omkring 5 % til 9 % af kapaciteten, men tjener lidt på mining-siden: Pearls plug-in miner kun på lange prefill-batches, så et kort, der betjener en chat-arbejdsbyrde, beholder omkring 5 % af en dedikeret miners hashrate. Rationelle minere multiplicerer derfor tilfældige matricer, og protokollen kan ikke se forskel. Det ene offentlige inferenspartnerskab findes ikke længere på udbyderens serverless-API. Pearls nytte er et kommercielt problem uden for kæden: nogen skal betale for inferensen.
Reglerne er den anden risiko. Fra juni til august aktiverede laboratoriet fire konsensusændringer ved hårdkodede højder, og dets udkast PIP-3 flytter mining til FP8 med bit-eksakte enhedsprofiler for kun to NVIDIA-arkitekturer. Et talformat kan være nyttigt for AI, verificerbart bit for bit og hardwareneutralt, men højst to af de tre.
På tværs af AI × krypto: subsidie er brændstof, ikke en forretningsmodel
Andre kæder med nyttigt arbejde fortæller samme historie. Kaspa satte et matrixprodukt ind i sin hash og fik alligevel ASIC'er inden for 16 måneder; dets bedste maskine tjener nu $0,86 om dagen. Aleos syntetiske bevisgåde fik dedikeret hardware på fem måneder og betalte provere 175–180 gange dets gebyrer. Bittensor er det eneste netværk i gruppen med ekstern omsætning i stor skala, omkring $70 mio. om året, mod mere end $300 mio. i udstedelse.
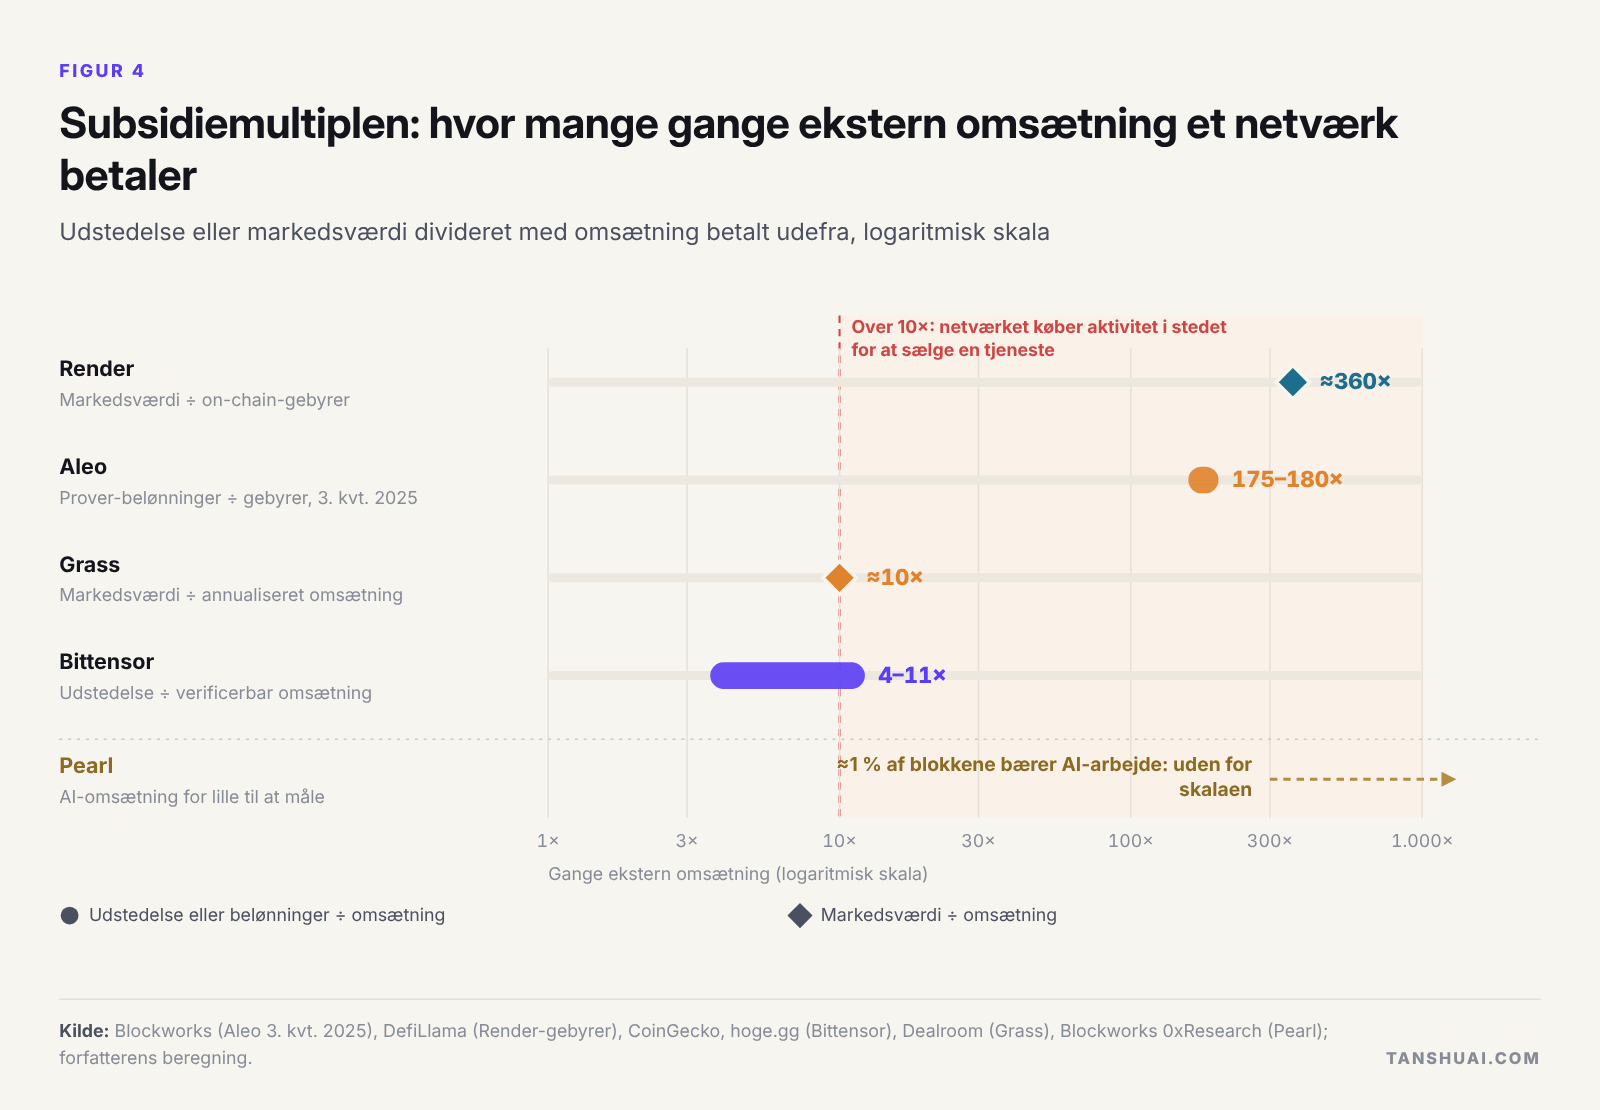 Figur 4. Subsidiemultiplen: hvor mange gange ekstern omsætning et netværk betaler.
Ud over konsensus er billedet reel efterspørgsel i lille skala. Decentrale GPU-markeder sælger standardinferens og slår hyperscalernes priser, men ikke de billigste neoclouds. Træning over internettet virker ved 8 til 40 mia. parametre, mens frontkørsler gik tilbage til centraliserede klynger. Betroede eksekveringsmiljøer kører fortrolig inferens i produktion; zero-knowledge-beviser for AI er stadig i laboratoriet. Betalinger igangsat af AI-agenter beløber sig til omkring $5.000–11.000 om måneden trods infrastruktur bygget af Visa, Mastercard, Stripe og Google. Data er en af de få sektorer med reelle købere. Imens er fire selskaber på centraliseret infrastruktur værd omtrent lige så meget som alle AI-tokens på protokol- og applikationslaget tilsammen: krypto står for distribution og afvikling, og egenkapitalen tager overskuddet.
Hvornår en ASIC betaler sig: én formel, tre målestokke
Når GPU'er sætter prisen på mining, nærmer omsætningen pr. regneenhed sig deres omkostning, og en ASIC, der er k gange billigere, beholder højst (1 − 1/k) af omsætningen. Kurven er konkav: 50 % ved k = 2, 80 % ved k = 5, 90 % ved k = 10. Ud over k = 5 tilfører mere effektivitet lidt profit; og mod ledige GPU'er, der kun betaler for strøm, kan den effektive k være helt nede på omkring 2,5.
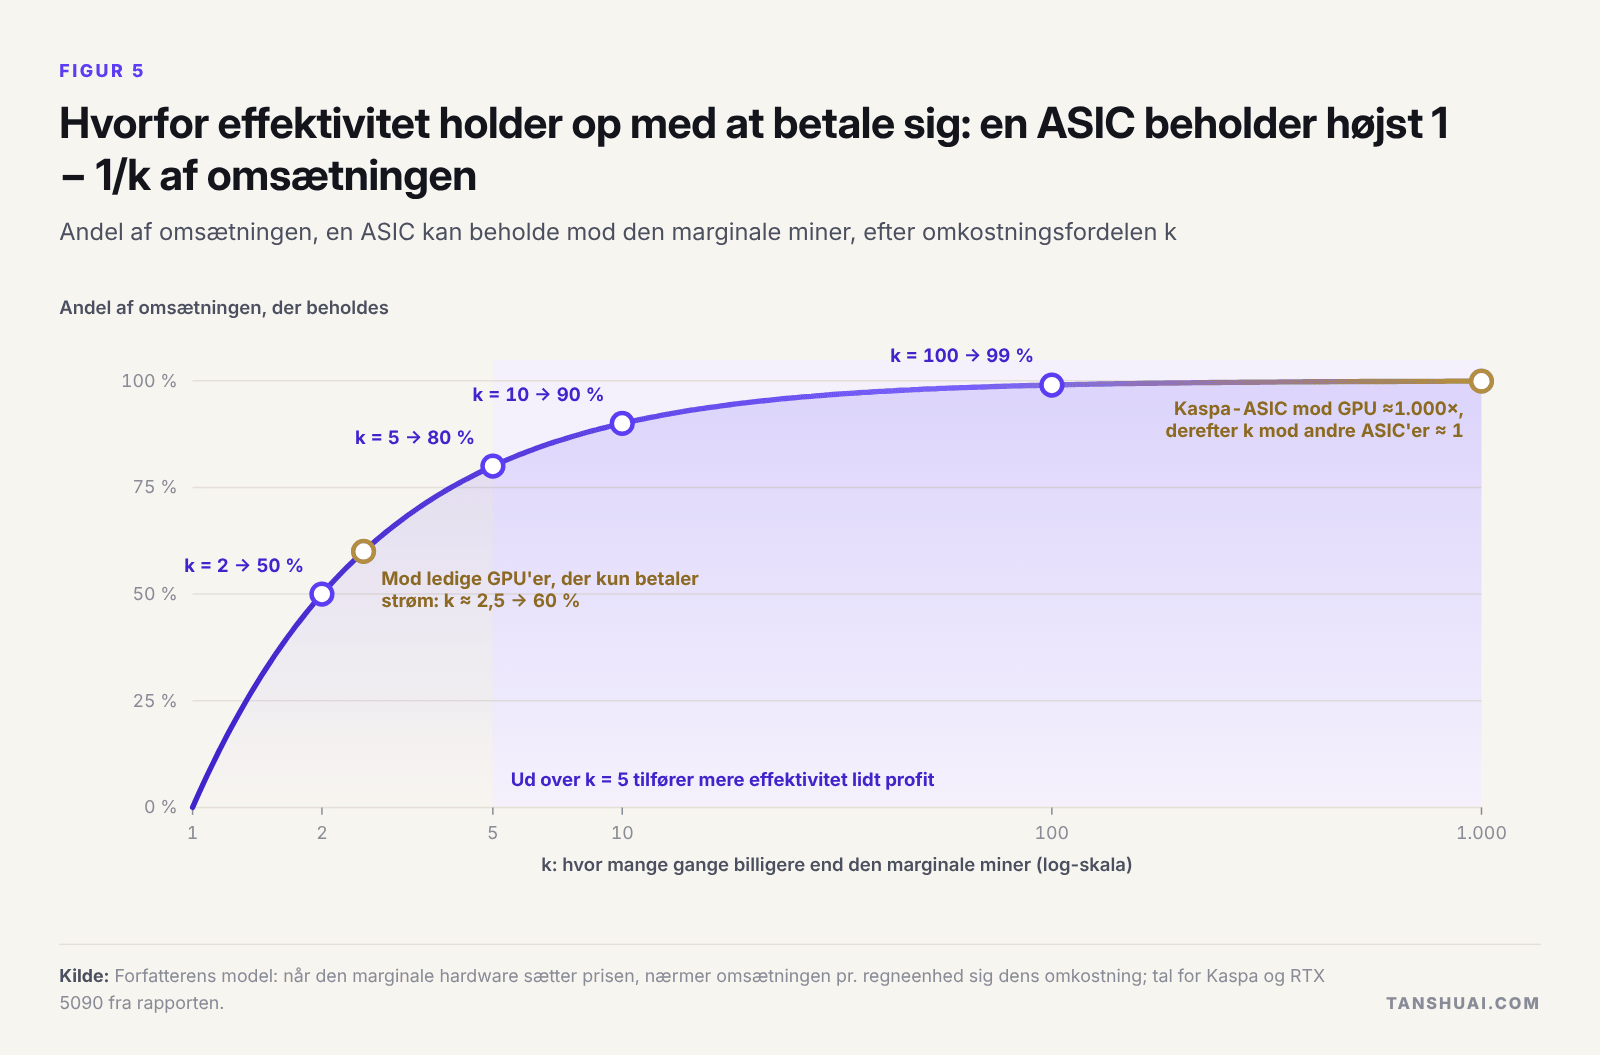 Figur 5. Hvorfor effektivitet holder op med at betale sig: en ASIC beholder højst 1 − 1/k af omsætningen.
Tre målestokke afgør derefter: puljen, tilbagebetalingsskalaen og reglerne. Bitcoin-minere tjener omkring $11,5 mia. om året, Pearls omkring $0,46–0,49 mia., Aleos omkring $31 mio. og Kaspas omkring $18 mio., mindre end den lave ende af ét chipdesign på 5/4 nm. For Pearl har en chip til $20 mio. med k = 5 brug for omkring 4,9 EH/s i drift i et år for at tjene sig hjem, hvis reglerne holder, og det dobbelte, hvis de kun holder med lige odds.
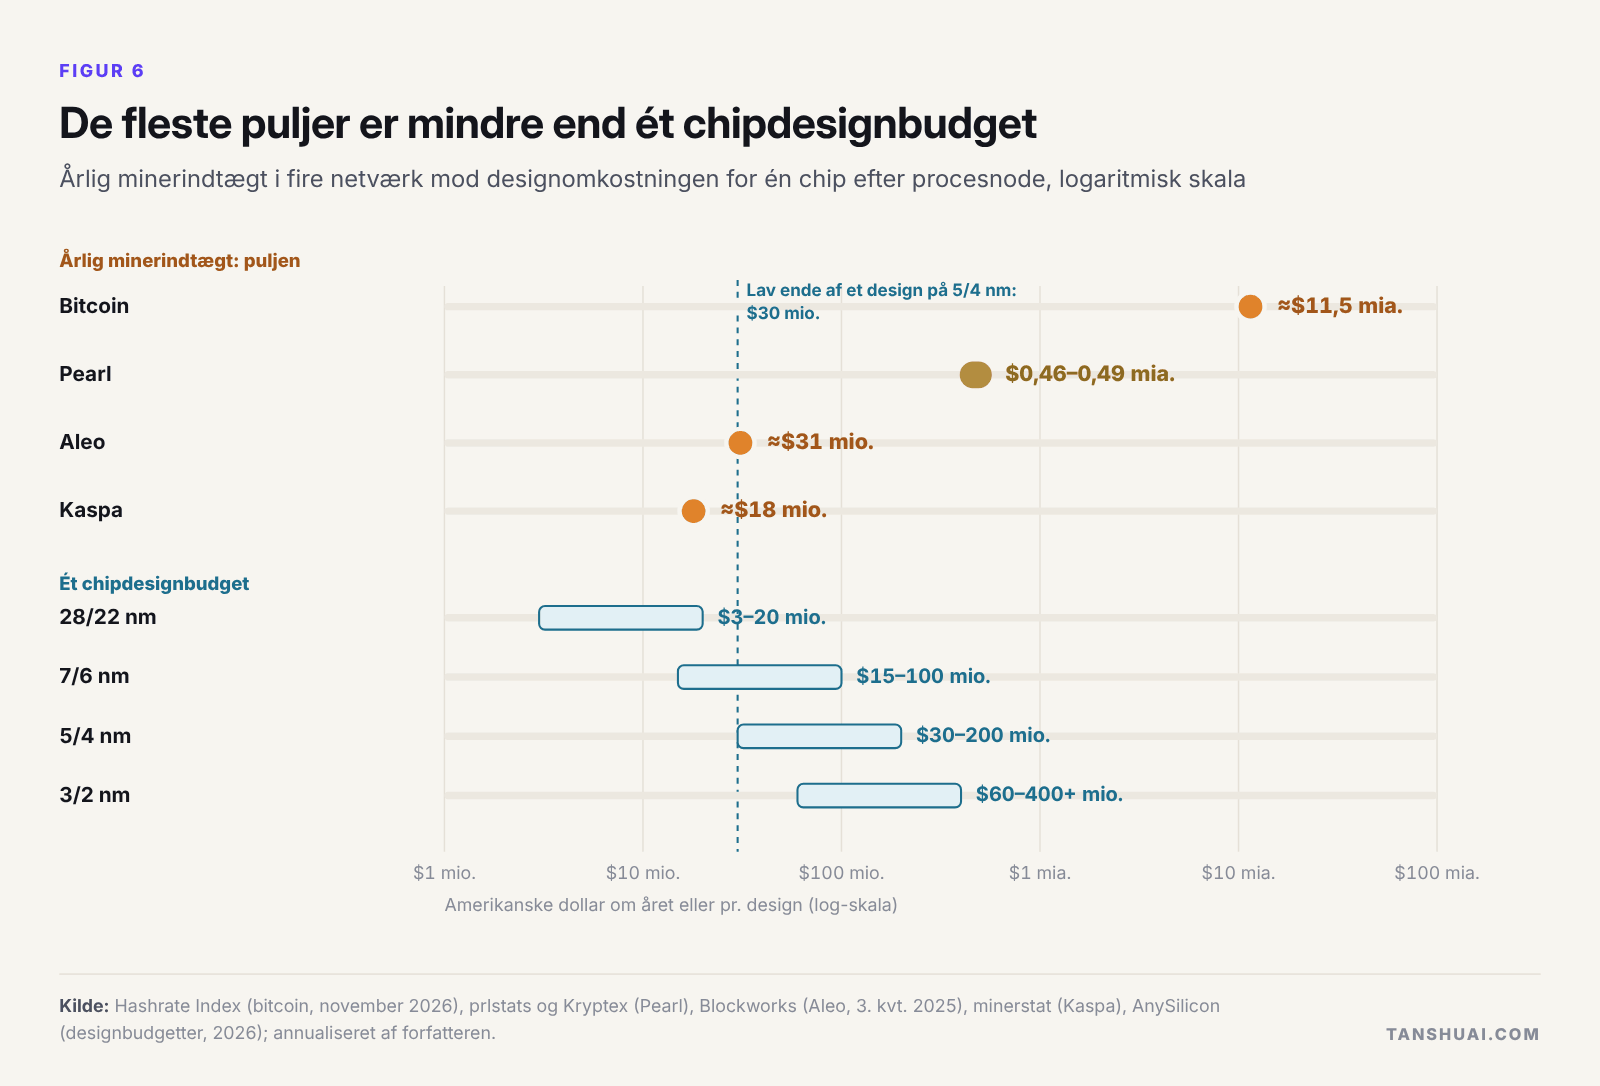 Figur 6. De fleste puljer er mindre end ét chipdesignbudget.
I dag tilbyder intet netværk en stor pulje, stabile regler og k over 1 på samme tid: bitcoins k tilhører de etablerede, Pearls regler er de mindst stabile, og Kaspas og Aleos puljer er for små.
Fem chiptyper, fem svar
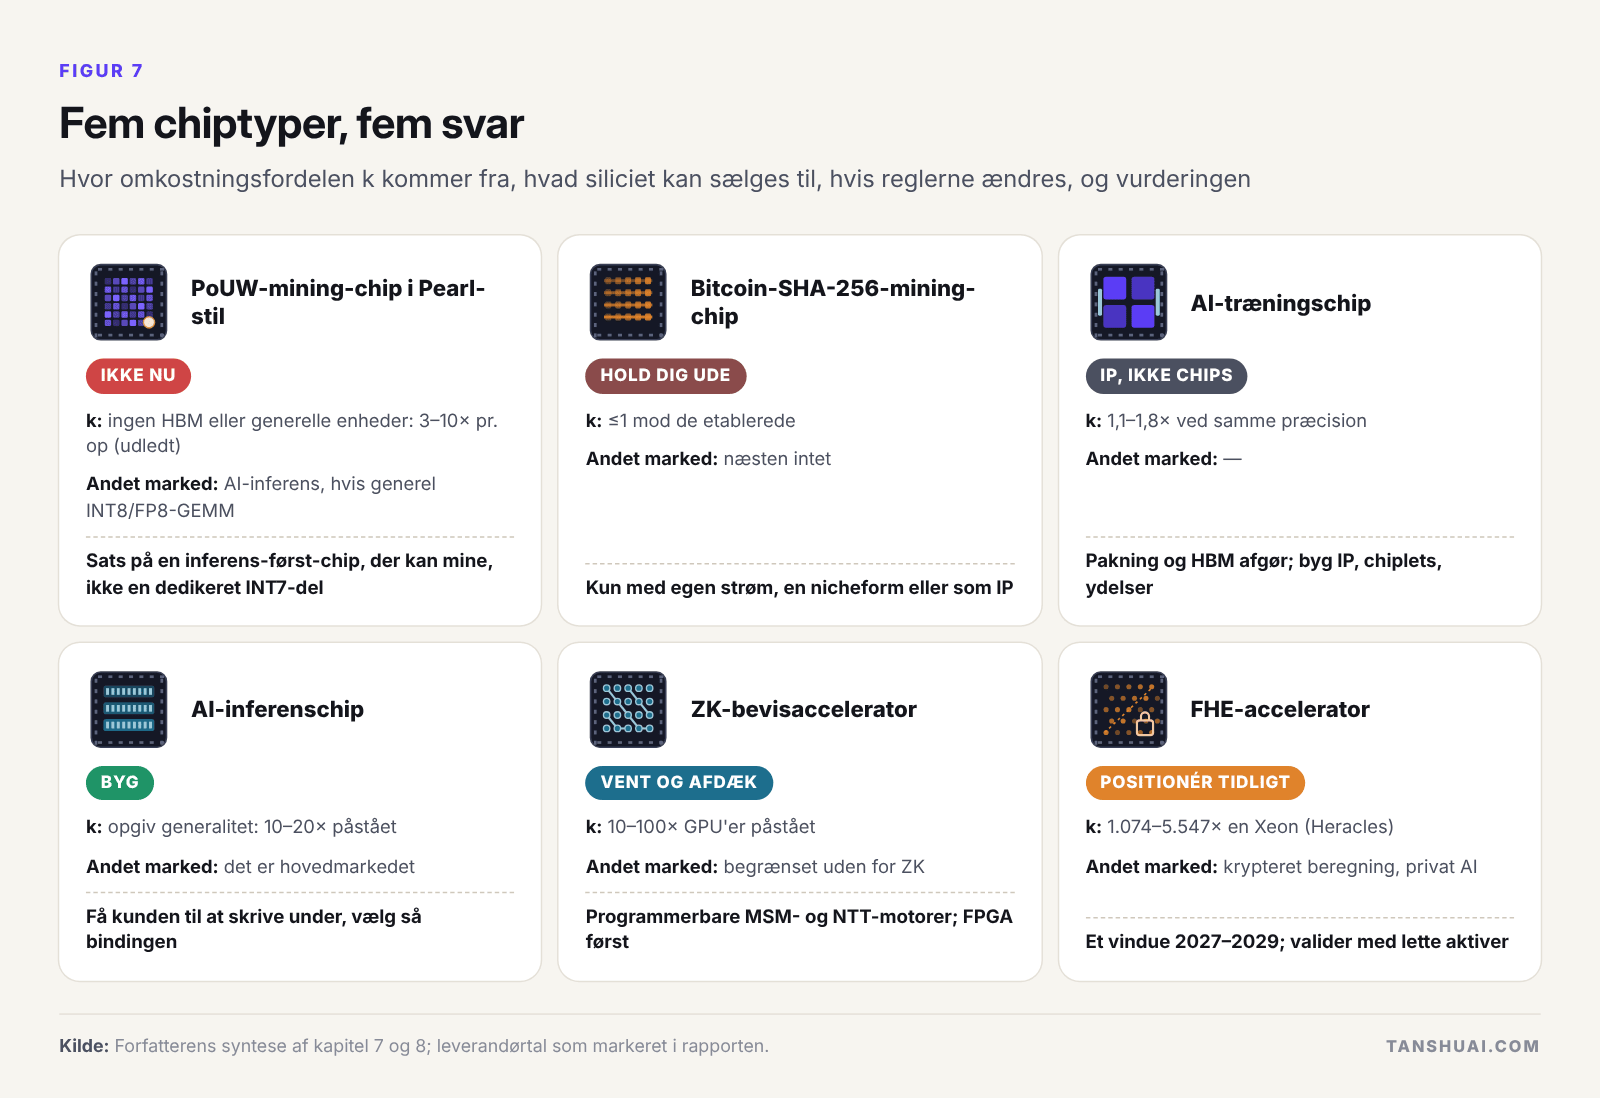 Figur 7. Fem chiptyper, fem svar.
For Pearl ville jeg ikke tape en dedikeret INT7-chip ud nu: et nyt team har brug for 18 til 24 måneder, og protokollen kan til den tid være gået over til FP8. Den bedre satsning er en inferens-først-accelerator bygget på generel INT8/FP8-GEMM med operander i SRAM, så siliciet har et andet marked, hvis adgangen til mining lukkes. Et nyt team bør holde sig ude af markedet for bitcoin-minere til videresalg, hvor Bitmain leverer maskiner på 8,9 J/TH, og udfordrerne trækker sig; strømanlæg er nu mere værd som AI-datacentre end som mining-anlæg. Små teams bør ikke bygge selvstændige træningschips. Inferenschips er værd at bygge til en kunde, der har skrevet under, ZK-acceleratorer er en afdækning, og FHE-acceleratorer er en tidlig position for 2027–2029.
Procesnoder og et budget i etaper
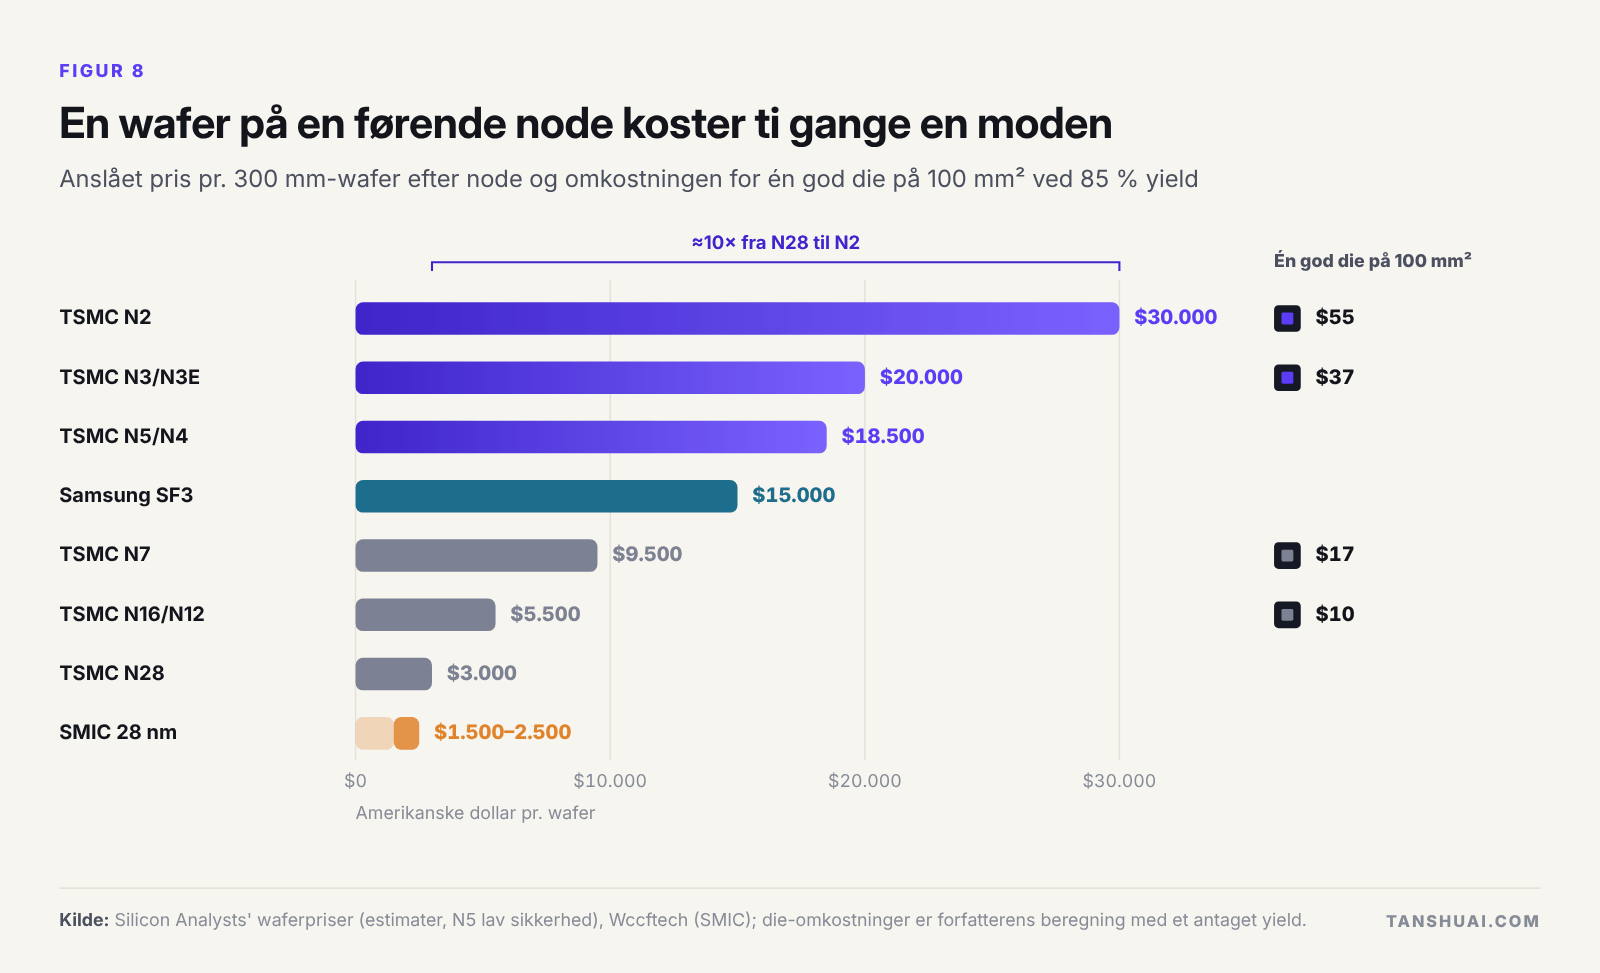 Figur 8. En wafer på en førende node koster ti gange en moden.
Lad den største post i chippens levetidsomkostning vælge noden: energi for compute-chips, der kører døgnet rundt, pakning og HBM for træningschips (omkring 63 % af en H100's omkostning) og valget mellem SRAM og HBM for inferenschips. En PoUW-mining-chip kan laves som prototype på multi-project wafers på 28 eller 16/12 nm og først flytte til N7/N6 og derefter N5/N4, når algoritmen og omsætningen er stabile.
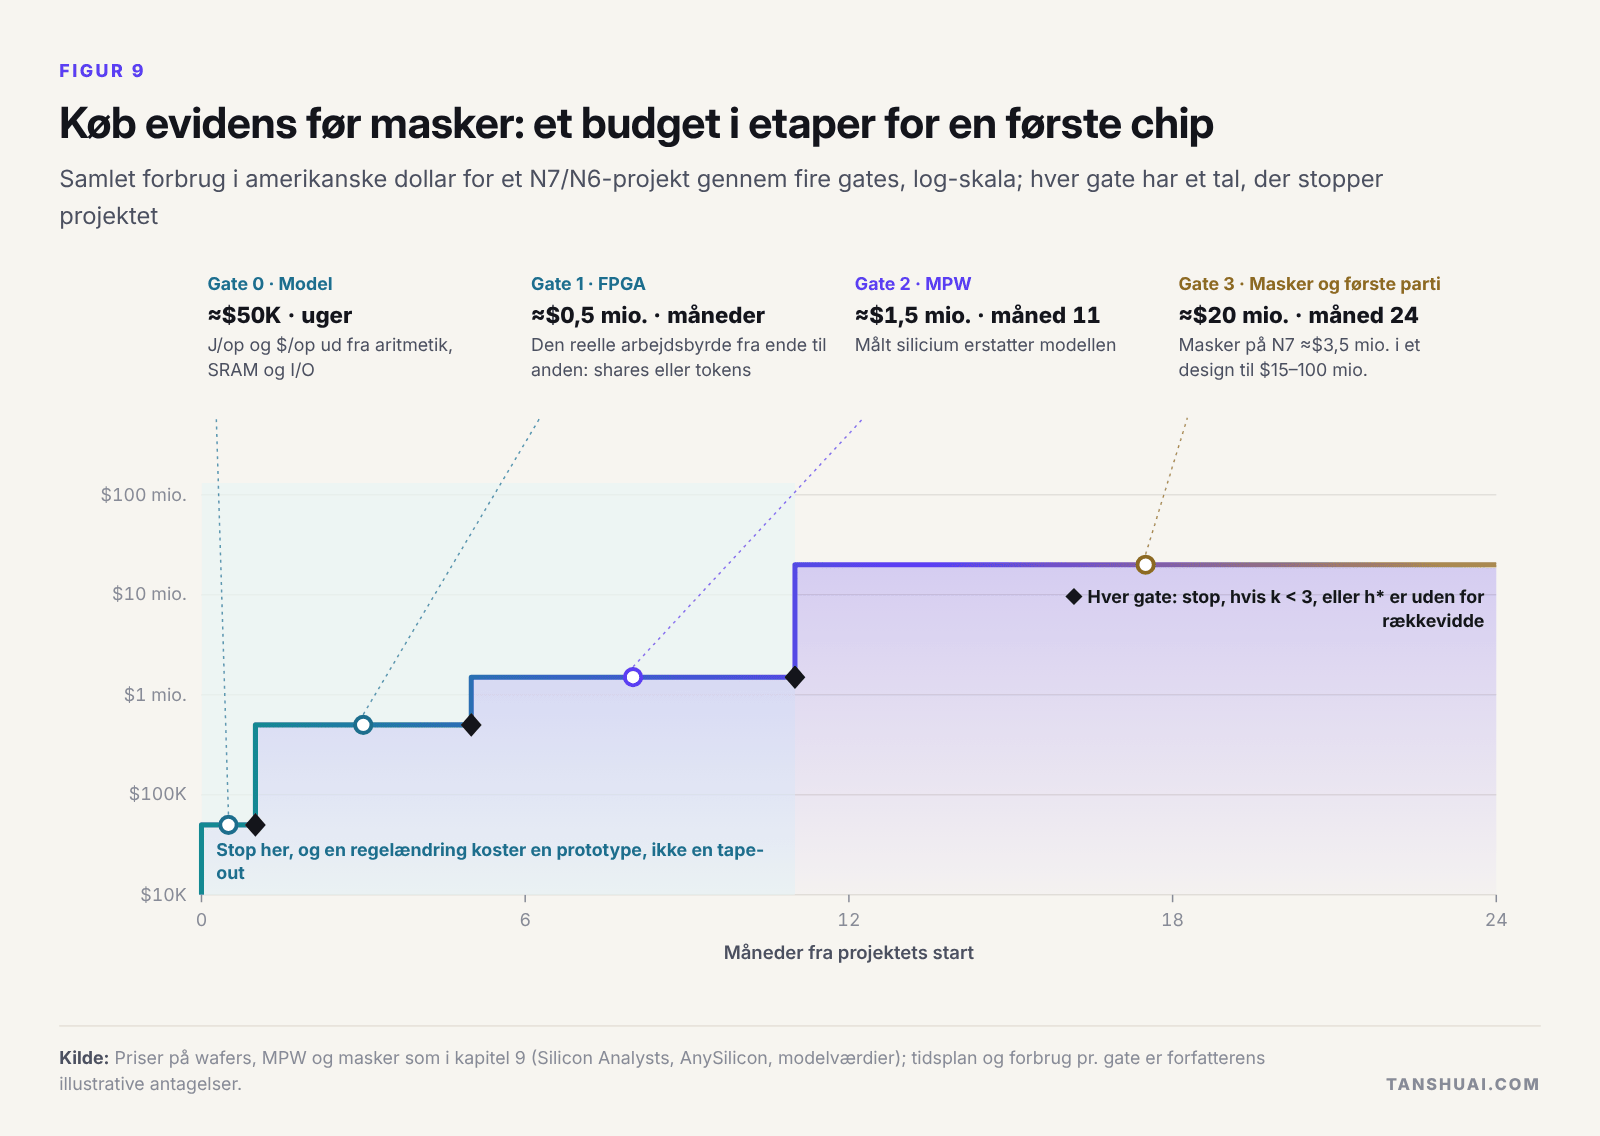 Figur 9. Køb evidens før masker: et budget i etaper for en første chip.
En første chip bør købes i fire etaper, hver med et tal, der stopper projektet: en model af J/op og $/op, en FPGA, der kører den reelle arbejdsbyrde, en multi-project wafer og først derefter et maskesæt. På N7/N6 koster de tre første omkring $1,5 mio. og elleve måneder; maskesættet og det første parti koster mere end ti gange så meget [estimat]. Hvis protokollen ændrer sin aritmetik, eller køberen trækker sig, mister et team, der stoppede ved waferen, prisen for en prototype, ikke for en tape-out. Den billigste effektivitet er arkitektonisk: at holde operanderne i SRAM og udelade HBM fjerner det meste af en GPU's omkostning, før nogen node er valgt.
Hvor jeg ville begynde
Mulighederne ligger, hvor felterne krydser hinanden: krypto som den første kunde, AI som det andet marked. Efterspørgslen efter specialchips i 2026 er overvejende AI, og et mining-chip-teams kompetencer, lavspændings-arrays, strømforsyning i kilowattklassen og hurtige tape-outs, lader sig overføre direkte. Jeg ville gå højst tre veje, hver testet med et lille første skridt: en inferens-først-accelerator, der også kan mine, begyndende med et fireugers studie af J/op og $/op; ydelser inden for specialdesignet silicium med krypto som den første kunde, begyndende med betalte forundersøgelser; og et AI-nativt netværk, der får sin regnekraftkøber til at skrive under, før det designer sit token.
Download hele rapporten og slides
Hele rapporten dækker Pearls mekanisme, økonomi og regler i detaljer, de andre kæder med nyttigt arbejde og det bredere AI × krypto-landskab, ASIC-modellen med dens tilbagebetalingsregnestykke, vurderinger chip for chip, nodeomkostninger og -valg, et budget i etaper for en første chip, en liste over pejlemærker og alle kilderne.
- Regnekraft som konsensus: hele rapporten (PDF)
- Regnekraft som konsensus: slides (PDF)
- Engelsk udgave: hele rapporten · slides
Dette er en oversættelse af den engelske udgave; ved uoverensstemmelser er den engelske udgave gældende.
Spørgsmål, du ikke stillede, men burde have stillet
Før jeg satte penge eller silicium i noget AI × krypto-projekt, ville jeg spørge: hvem kontrollerer arbejdsfunktionen; hvad subsidiemultiplen er; hvad den næste gate koster, og hvilket tal der stopper dig; hvad tilbagebetalings-hashraten er, med p; hvad chippens andet marked er; om værdien lander i tokenet eller i egenkapitalen; og hvem den første betalende kunde er, ved navn.
Det er områder, vi kan udforske sammen gennem teknisk udveksling og teknisk samarbejde: specialchips til mining, AI-træning og -inferens samt acceleratorer; AI-udvikling; og AI × krypto-systemer fra kæde til node til chip. Du kan kontakte mig på i@tanshuai.com.
Om forfatteren
Tan Shuai er teknolog og grundlægger med mere end tyve års arbejde på tværs af chips, hardware og systemsoftware og 20 udstedte patenter. Han har mange års fabless-chipudvikling og ledelse bag sig, herunder fuldt specialdesignede ASIC-datapath-designs til mining-chips for kryptovaluta og multimediechips til kameraer. Hans arbejde har ført ham gennem Silicon Valley, New York, Chicago, Taiwan, Greater Bay Area (Shenzhen og Hongkong), Vietnam og Malaysia. I dag arbejder han som AI-forsker og -udvikler.
Teknisk diskussion: i@tanshuai.com.