
Một blockchain nay chạy trên chính phép nhân ma trận mà AI dùng, ở mức khoảng 90 EH/s. Tôi đã đọc mã nguồn, dữ liệu chuỗi và nền kinh tế xung quanh nó để trả lời ba câu hỏi: điều gì trong AI × crypto có khách hàng trả tiền, khi nào đáng làm một ASIC, và tiến trình nào hợp với loại chip nào. Kèm báo cáo đầy đủ và bản trình chiếu.
Tóm tắt
Pearl, ra mắt tháng 4 năm 2026, là blockchain đầu tiên có bằng chứng công việc là phép nhân ma trận kiểu AI ở quy mô lớn. Ngày 13 tháng 11 năm 2026, mạng của nó chạy ở khoảng 90 EH/s, trong đó một H là một phép nhân-cộng INT7: tương đương thông lượng số nguyên của khoảng 122.000 chiếc H100. Về mặt kỹ thuật, nó vận hành được. Nhưng nó chưa hữu ích: chỉ khoảng 1% số khối chứa công việc AI thật, vì một GPU vừa đào vừa phục vụ suy luận chỉ giữ được 1% đến 27% hashrate của một máy đào chuyên dụng. Trong toàn bộ AI × crypto, nhu cầu trả tiền có thể kiểm chứng xuất hiện ở ba nơi: bán suy luận, bán dữ liệu và bán quyền riêng tư, trong khi trợ cấp gấp từ 4 đến 360 lần doanh thu bên ngoài. Về chip, trần lợi nhuận của một ASIC là doanh thu trên mỗi đơn vị tính toán nhân với (1 − 1/k), nên hiệu quả vượt quá k = 5 chỉ thêm được rất ít; điều quyết định là quy mô quỹ thưởng, sự ổn định của luật lệ và một thị trường thứ hai. Hiện chưa mạng nào hội đủ cả ba. Tiến trình phù hợp do khoản lớn nhất trong chi phí vòng đời của con chip quyết định, và bản thân con chip nên được mua theo từng giai đoạn, để một thay đổi luật lệ chỉ tốn một mẫu thử chứ không phải một lần tape-out.
Vì sao tôi tìm hiểu chuyện này
Tôi đã dành nhiều năm thiết kế chip, trong đó có các đường dữ liệu ASIC full-custom cho chip đào tiền điện tử, và hiện tôi làm về AI. Khi xuất hiện một chuỗi mà ngân sách bảo mật được định giá đúng nghĩa đen bằng thông lượng tensor, những câu hỏi với một người như tôi là hiển nhiên: công việc ấy có hữu ích không, một con chip chuyên dụng có thắng không, và làm ra nó tốn bao nhiêu?
Tôi đã đọc mã nguồn và các đề xuất giao thức của Pearl, dữ liệu chuỗi từ một full node độc lập, hồ sơ công bố của các công ty, các bài báo về mật mã học, kiến trúc máy tính và học máy, dữ liệu giá của xưởng đúc và nhà cung cấp, cùng báo chí chuyên ngành. Mọi con số dưới đây tính đến ngày 13 tháng 11 năm 2026, và tiền tệ tính bằng đô la Mỹ. Ghi chú này là cách tôi học về lĩnh vực; tôi chia sẻ nó để người khác có thể kiểm tra, sử dụng và tranh luận. Báo cáo đầy đủ, với tất cả nguồn, nằm ở cuối bài.
Kết quả tóm lược
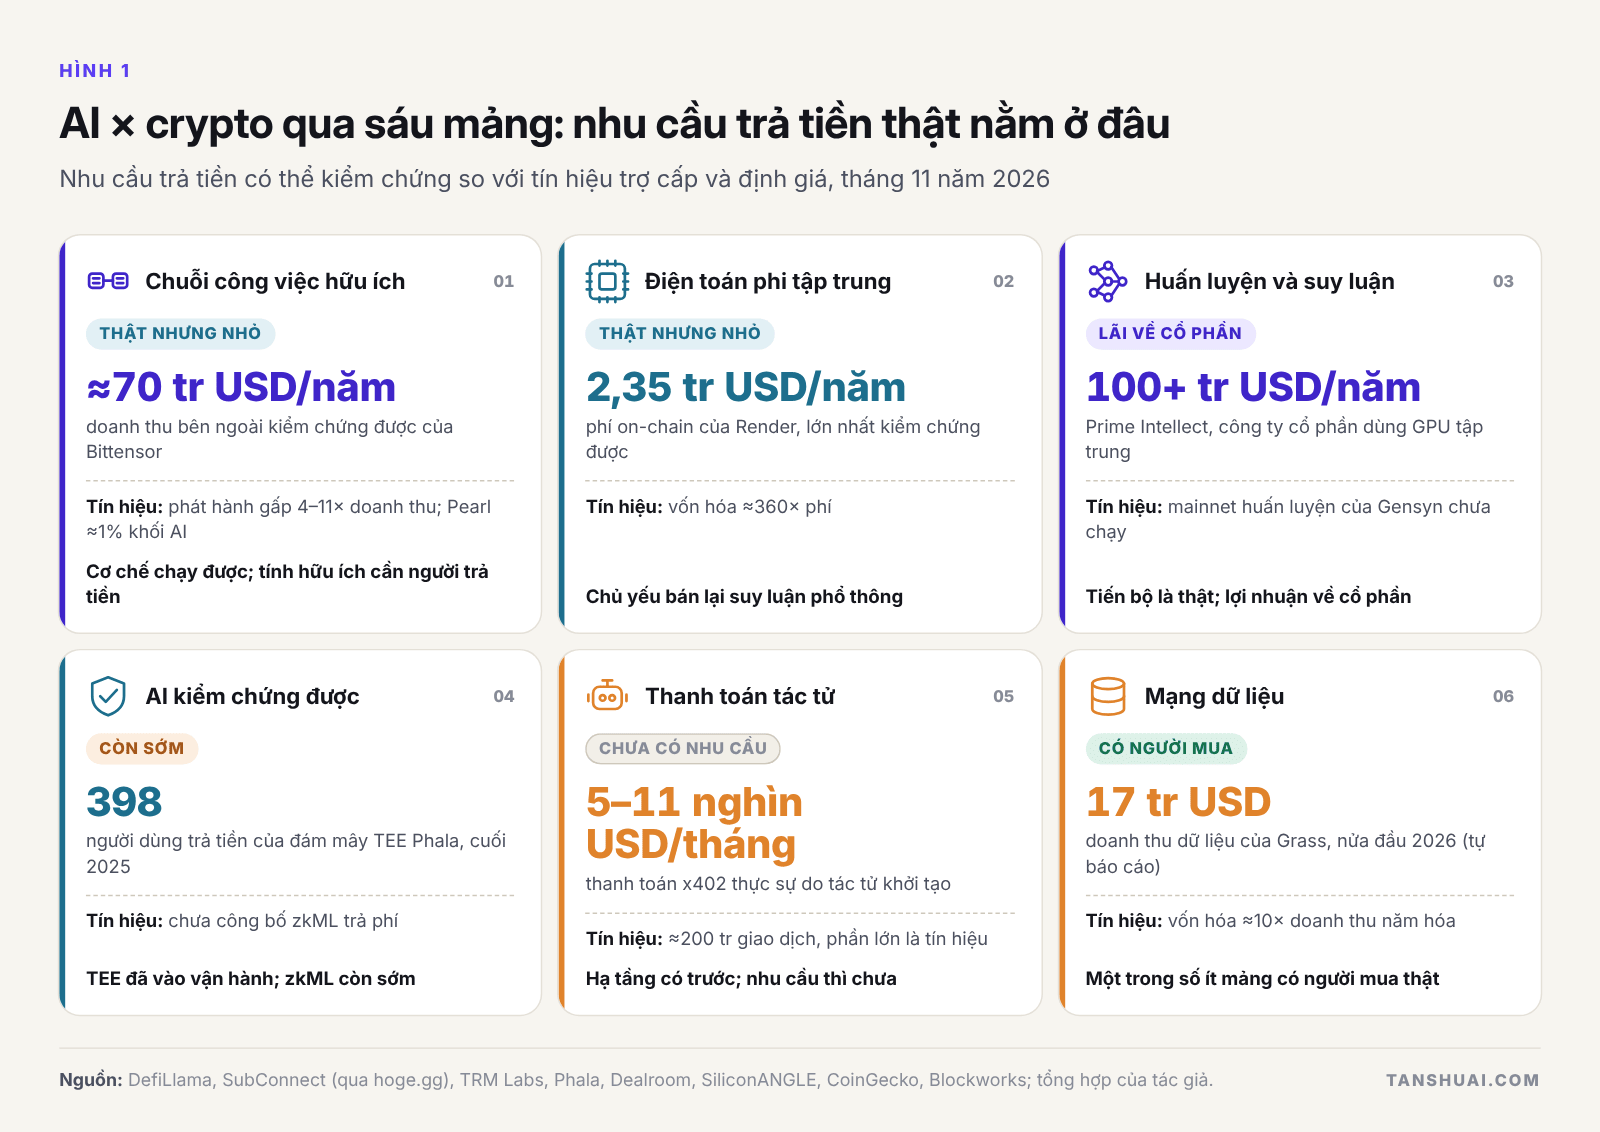 Hình 1. AI × crypto qua sáu mảng: nhu cầu trả tiền thật nằm ở đâu.
| Câu hỏi | Trả lời ngắn |
|---|---|
| Pearl có vận hành được không, và công việc của nó có hữu ích không? | Vận hành được: khoảng 90 EH/s phép nhân ma trận bảo vệ chuỗi. Chưa hữu ích: chỉ khoảng 1% số khối chứa công việc AI |
| Nhu cầu trả tiền thật nằm ở đâu? | Suy luận, dữ liệu và quyền riêng tư. Thanh toán của tác tử, zkML và huấn luyện phi tập trung vẫn chưa có nhu cầu |
| Có đáng làm một ASIC không? | Chỉ khi quỹ thưởng lớn, luật lệ ổn định và có thị trường thứ hai; hiện chưa mạng nào hội đủ cả ba |
| Đội nhỏ nên làm chip gì? | Bộ tăng tốc ưu tiên suy luận và cũng đào được, chip suy luận cho một khách hàng đã ký, công việc FHE sớm; không làm máy đào bitcoin thương mại hay chip huấn luyện |
| Con chip đầu tiên tốn bao nhiêu? | Mua theo từng giai đoạn: mô hình, FPGA và MPW đưa đến silicon đo được với khoảng 1,5 triệu USD, trước khi đến bộ mặt nạ tốn hàng triệu |
Pearl: một phép nhân-cộng là một lần băm
Pearl dựa trên một kết quả năm 2025 của Ilan Komargodski và Omri Weinstein: bằng chứng công việc hữu ích cho mọi tích ma trận, với chi phí bằng 1 + o(1) lần chi phí của phép nhân. Thợ đào nhân các ma trận có nhiễu, băm bộ tích lũy của mỗi ô đầu ra thành một vé số và chứng minh ô trúng bằng một bằng chứng zero-knowledge dưới 60 KB. Trong mã đồng thuận, một H là một phép nhân-cộng INT7 × INT7 → INT32 được ghi nhận, nên lần đầu tiên ngân sách bảo mật của một blockchain được định giá bằng thông lượng tensor của các bộ tăng tốc AI.
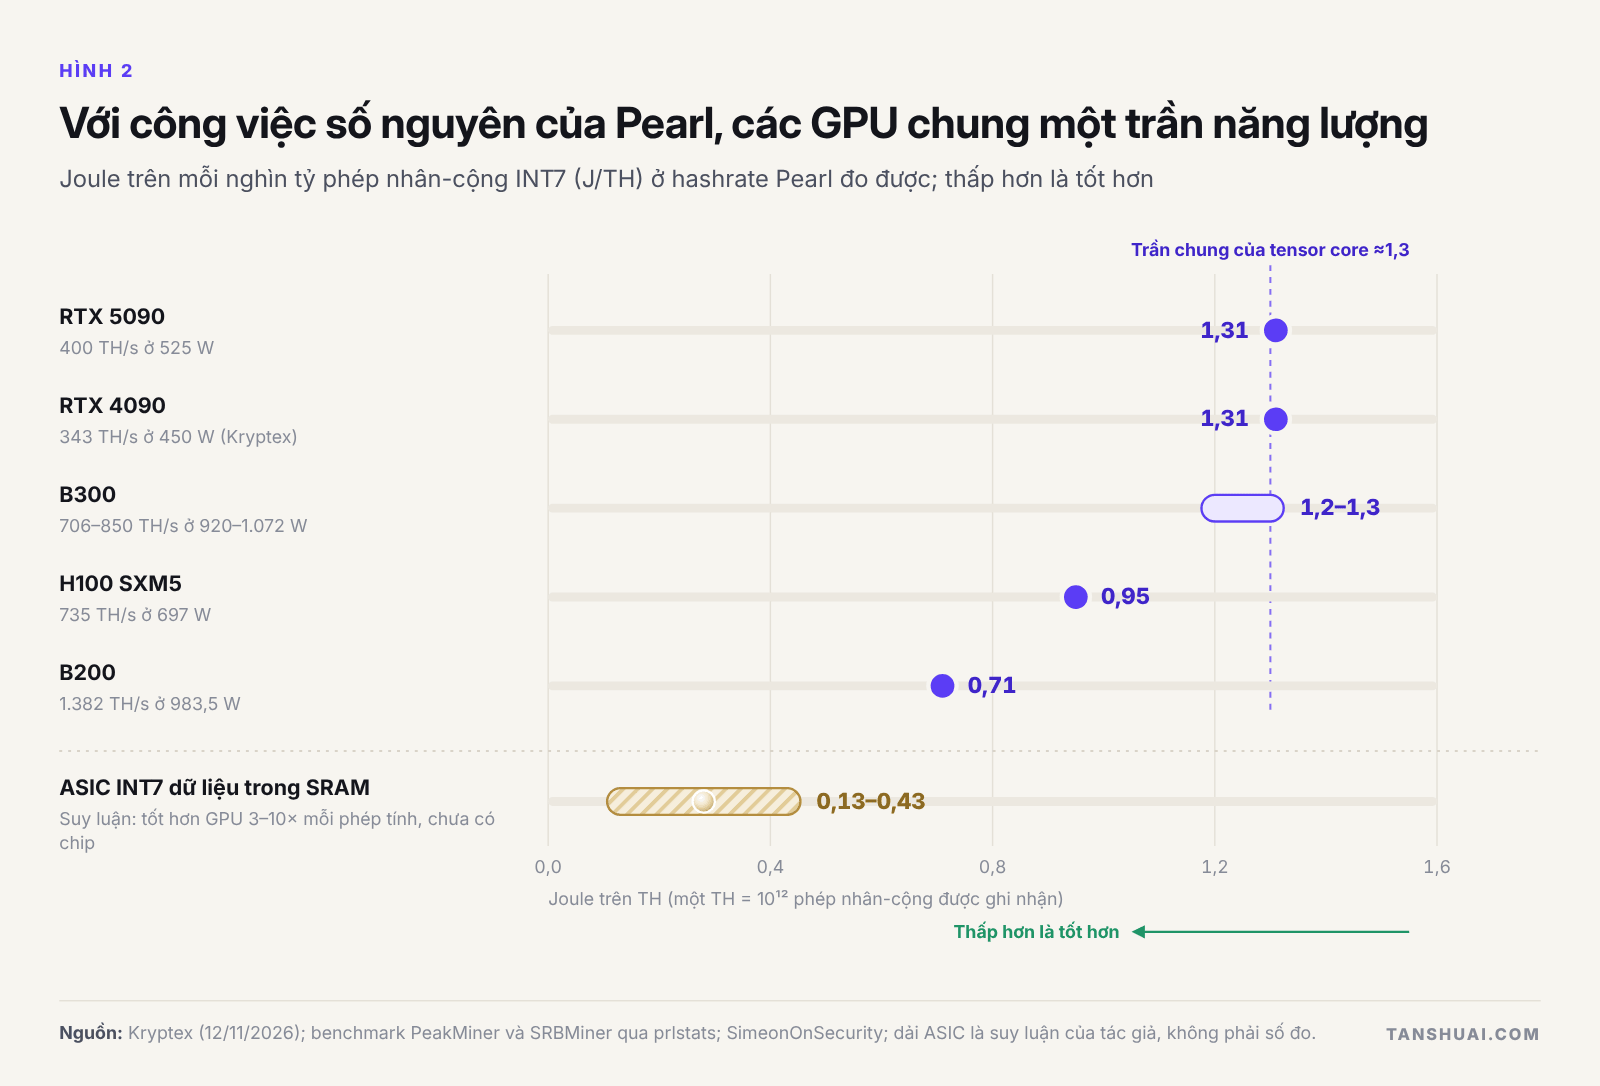 Hình 2. Với công việc số nguyên của Pearl, các GPU chung một trần năng lượng.
Card chơi game và chiếc B300 dành cho trung tâm dữ liệu gặp nhau ở khoảng 1,3 J/TH, và ngay cả B200 cũng chỉ đạt 0,71. Trần chung ấy chính là thứ một con chip chuyên dụng có thể phá vỡ: một linh kiện chỉ nhân số nguyên 7 bit từ SRAM trên chip, không có HBM hay khối đa dụng, có thể tốt hơn 3 đến 10 lần trên mỗi phép tính. Trong khi đó NVIDIA đang đưa silicon mới nhất của mình rời khỏi INT8 để hướng tới FP8 và FP4, và đó là lý do Pearl đang chuẩn bị thay đổi phép tính của mình.
Kinh tế của Pearl: định lý đứng vững, động lực thì không
Hashrate của Pearl đi theo giá. Mạng tăng từ 0,01 EH/s vào ngày thứ hai lên 23–26 EH/s cuối tháng 5, giữ ở 21–39 EH/s suốt một mùa hè mà giá giảm khoảng 86%, và đạt khoảng 90 EH/s sau khi giá tăng khoảng mười lần vào mùa thu. Khoảng 120 triệu đồng coin, xấp xỉ 32% nguồn cung hiện nay, đã được đào trong sáu ngày đầu, và nguồn cung sẽ tăng khoảng 78% trong 12 tháng tới. Một RTX 5090 hiện kiếm khoảng 5–6 USD mỗi ngày.
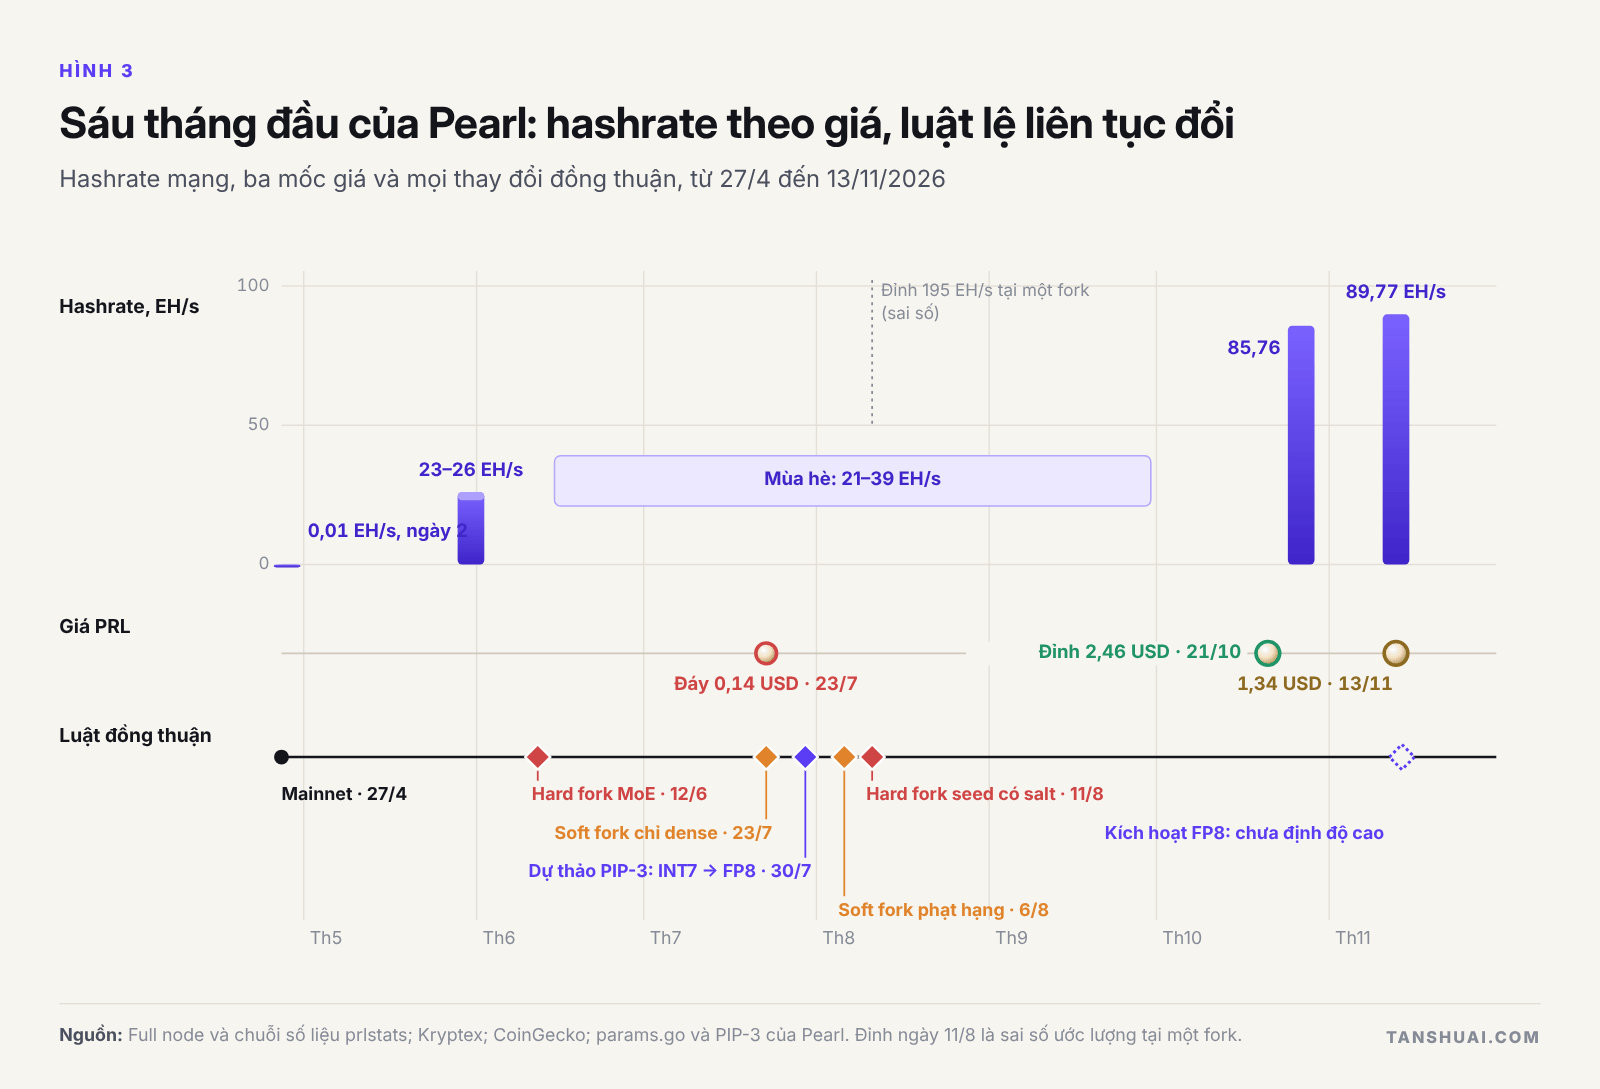 Hình 3. Sáu tháng đầu của Pearl: hashrate theo giá, luật lệ liên tục đổi.
Phần hữu ích là nơi mô hình đổ vỡ. Đào ngay trong suy luận thật tốn ít ở phía suy luận, khoảng 5% đến 9% thông lượng, nhưng kiếm được ít ở phía đào: plug-in của Pearl chỉ đào trên các lô prefill dài, nên một card phục vụ tải chat chỉ giữ được khoảng 5% hashrate của một máy đào chuyên dụng. Do đó thợ đào duy lý nhân các ma trận ngẫu nhiên, và giao thức không phân biệt được. Mối hợp tác suy luận công khai duy nhất nay không còn trên API serverless của nhà cung cấp. Tính hữu ích của Pearl là một bài toán thương mại ngoài chuỗi: phải có người trả tiền cho suy luận.
Luật lệ là rủi ro còn lại. Từ tháng 6 đến tháng 8, phòng thí nghiệm đã kích hoạt bốn thay đổi đồng thuận ở các độ cao được mã hóa cứng, và bản dự thảo PIP-3 chuyển việc đào sang FP8 với hồ sơ thiết bị chính xác từng bit cho chỉ hai kiến trúc NVIDIA. Một định dạng số có thể hữu ích cho AI, kiểm chứng được từng bit và trung lập phần cứng, nhưng chỉ đạt tối đa hai trong ba điều đó.
Trong toàn bộ AI × crypto: trợ cấp là nhiên liệu, không phải mô hình kinh doanh
Các chuỗi công việc hữu ích khác kể cùng một câu chuyện. Kaspa đặt một tích ma trận vào trong hàm băm và vẫn có ASIC trong vòng 16 tháng; máy tốt nhất của nó nay kiếm 0,86 USD mỗi ngày. Câu đố chứng minh tổng hợp của Aleo có phần cứng chuyên dụng sau năm tháng và trả cho prover gấp 175–180 lần phí của nó. Bittensor là mạng duy nhất trong nhóm có doanh thu bên ngoài ở quy mô lớn, khoảng 70 triệu USD mỗi năm, so với hơn 300 triệu USD phát hành.
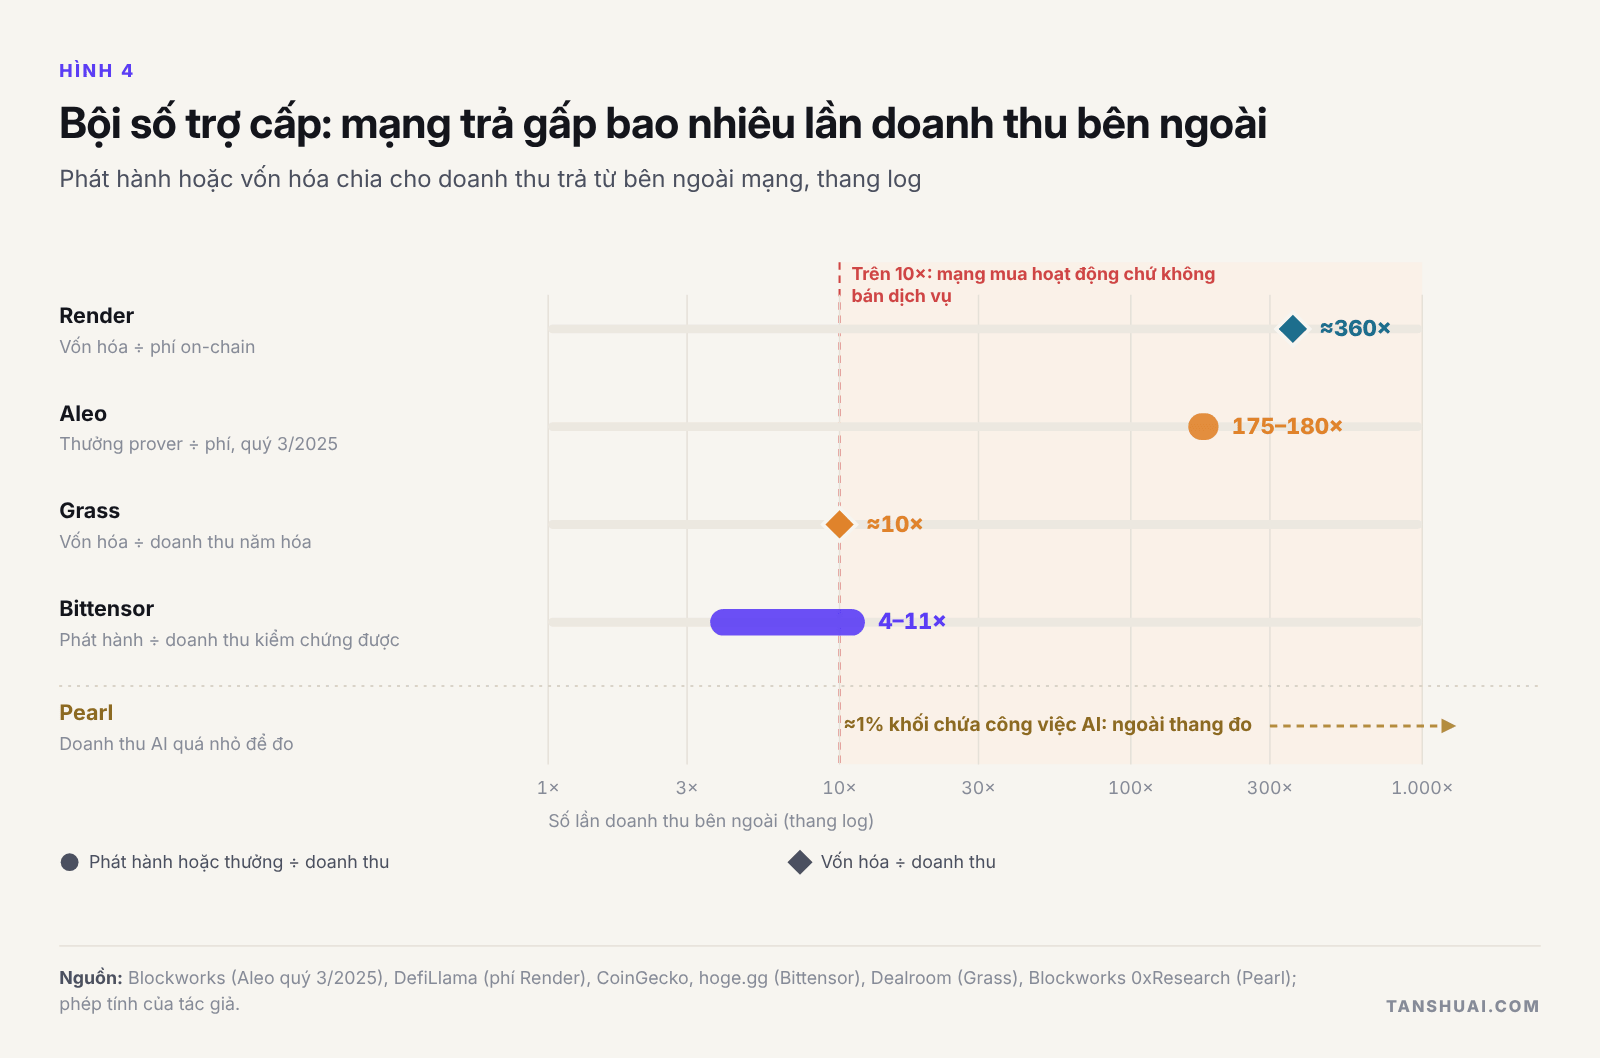 Hình 4. Bội số trợ cấp: mạng trả gấp bao nhiêu lần doanh thu bên ngoài.
Ngoài đồng thuận, bức tranh là nhu cầu thật ở quy mô nhỏ. Các thị trường GPU phi tập trung bán suy luận phổ thông và rẻ hơn giá của các hyperscaler nhưng không rẻ hơn các neocloud rẻ nhất. Huấn luyện qua internet chạy được ở 8 đến 40 tỷ tham số, trong khi các đợt huấn luyện tiên phong đã quay về cụm tập trung. Môi trường thực thi tin cậy chạy suy luận bảo mật trong vận hành thực tế; bằng chứng zero-knowledge cho AI vẫn ở phòng thí nghiệm. Thanh toán do tác tử AI khởi tạo chỉ khoảng 5.000–11.000 USD mỗi tháng, dù Visa, Mastercard, Stripe và Google đã xây hạ tầng. Dữ liệu là một trong số ít mảng có người mua thật. Trong khi đó, bốn công ty cổ phần trên hạ tầng tập trung được định giá xấp xỉ toàn bộ token AI tầng giao thức và tầng ứng dụng cộng lại: crypto lo phân phối và thanh toán, còn cổ phần hưởng lợi nhuận.
Khi nào ASIC sinh lời: một công thức, ba thước đo
Khi GPU định giá việc đào, doanh thu trên mỗi đơn vị tính toán tiến về chi phí của chúng, và một ASIC rẻ hơn k lần giữ được tối đa (1 − 1/k) doanh thu. Đường cong này lõm: 50% ở k = 2, 80% ở k = 5, 90% ở k = 10. Quá k = 5, hiệu quả cao hơn chỉ thêm rất ít lợi nhuận; và so với GPU nhàn rỗi chỉ trả tiền điện, k hiệu dụng có thể chỉ khoảng 2,5.
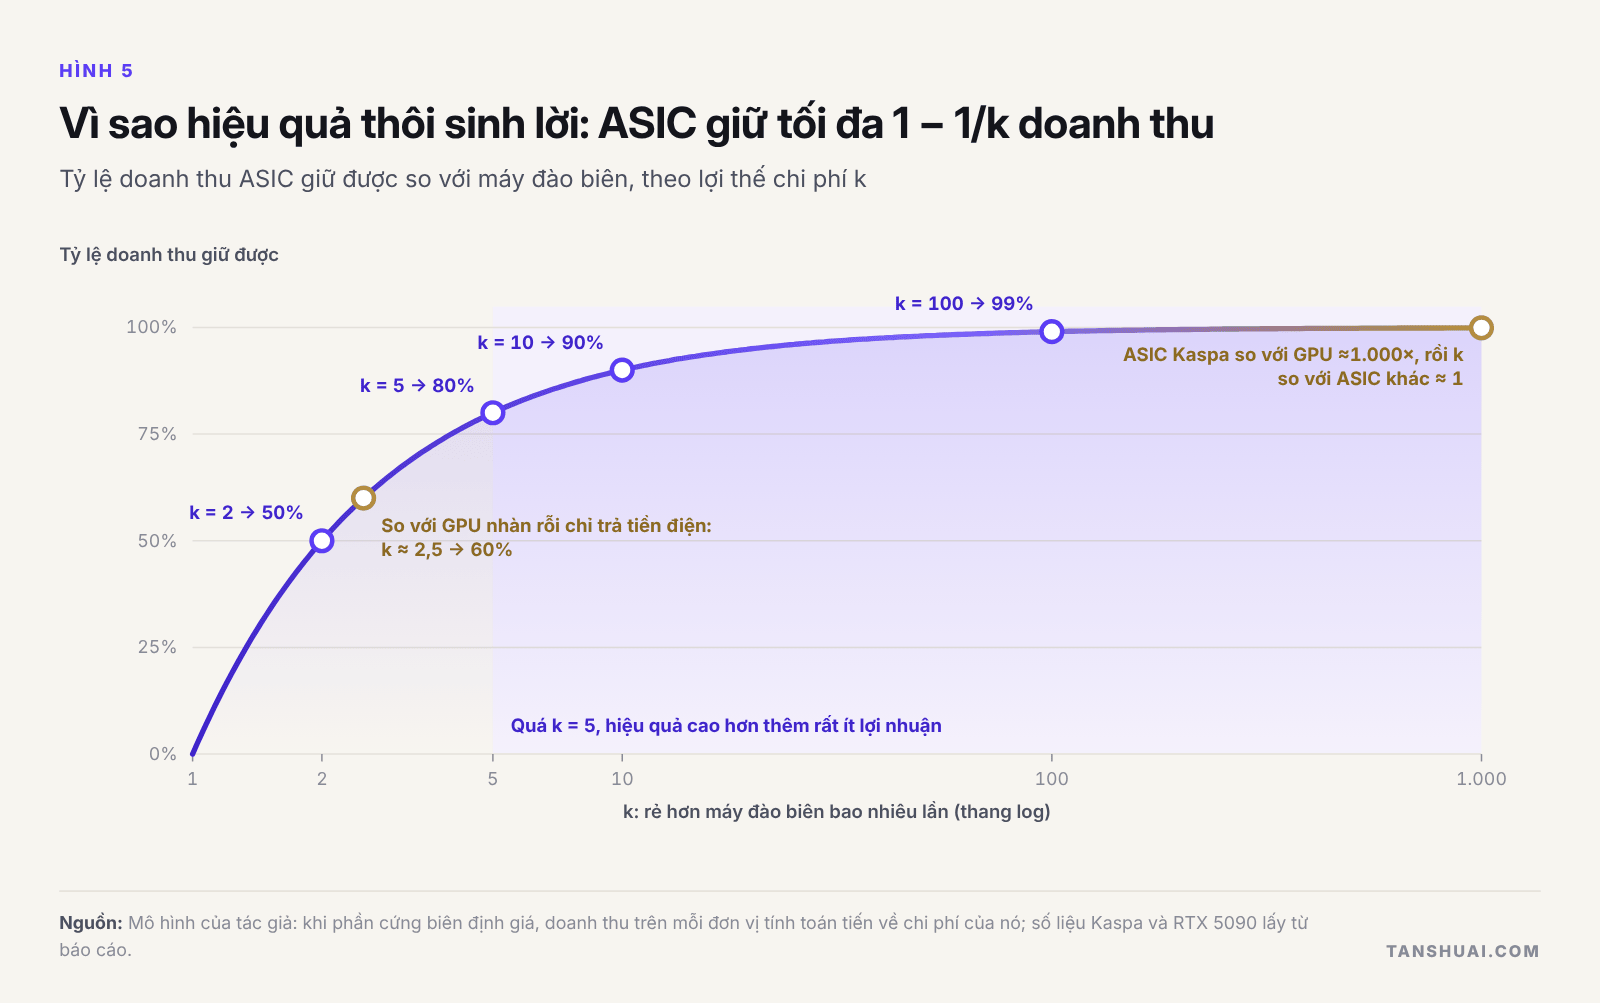 Hình 5. Vì sao hiệu quả thôi sinh lời: ASIC giữ tối đa 1 − 1/k doanh thu.
Sau đó, ba thước đo quyết định: quỹ thưởng, quy mô hoàn vốn và luật lệ. Thợ đào bitcoin kiếm khoảng 11,5 tỷ USD mỗi năm, của Pearl khoảng 0,46–0,49 tỷ USD, của Aleo khoảng 31 triệu USD và của Kaspa khoảng 18 triệu USD, ít hơn mức thấp của một thiết kế chip 5/4 nm. Với Pearl, một con chip 20 triệu USD với k = 5 cần khoảng 4,9 EH/s chạy trong một năm để hoàn vốn nếu luật lệ giữ nguyên, và gấp đôi con số đó nếu xác suất giữ nguyên chỉ là năm ăn năm thua.
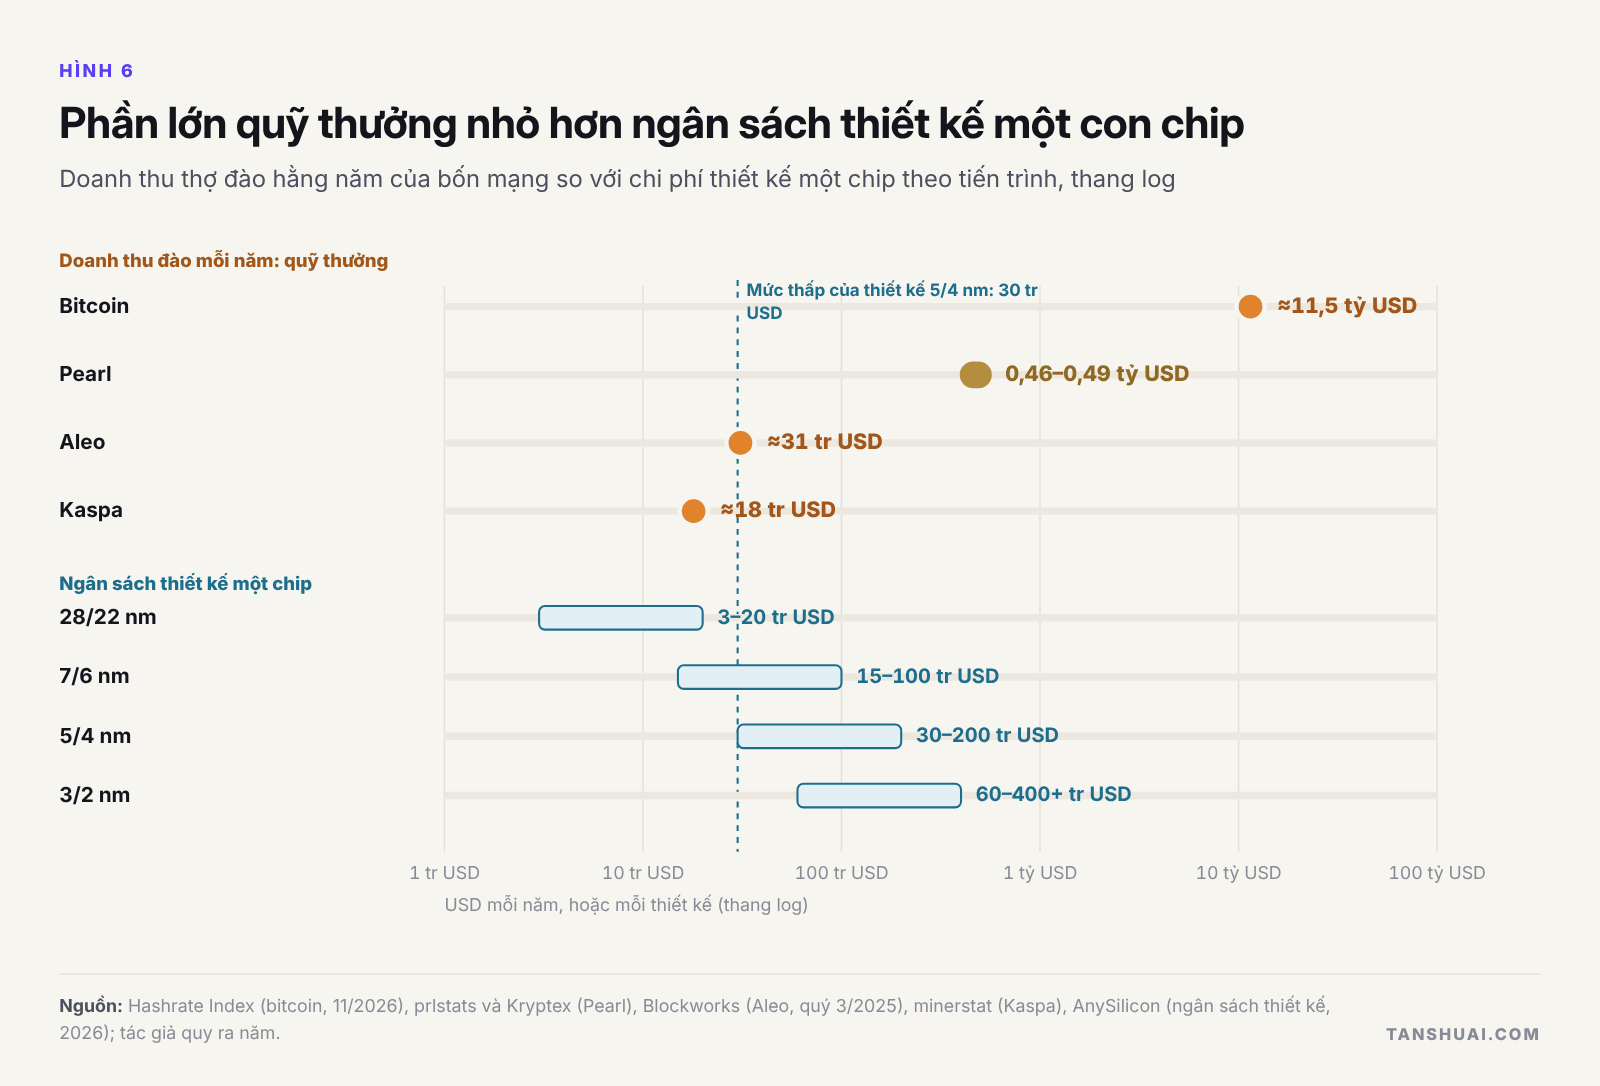 Hình 6. Phần lớn quỹ thưởng nhỏ hơn ngân sách thiết kế một con chip.
Hiện chưa mạng nào đồng thời có quỹ thưởng lớn, luật lệ ổn định và k trên 1: k của bitcoin thuộc về các hãng đương nhiệm, luật của Pearl kém ổn định nhất, còn quỹ thưởng của Kaspa và Aleo quá nhỏ.
Năm loại chip, năm câu trả lời
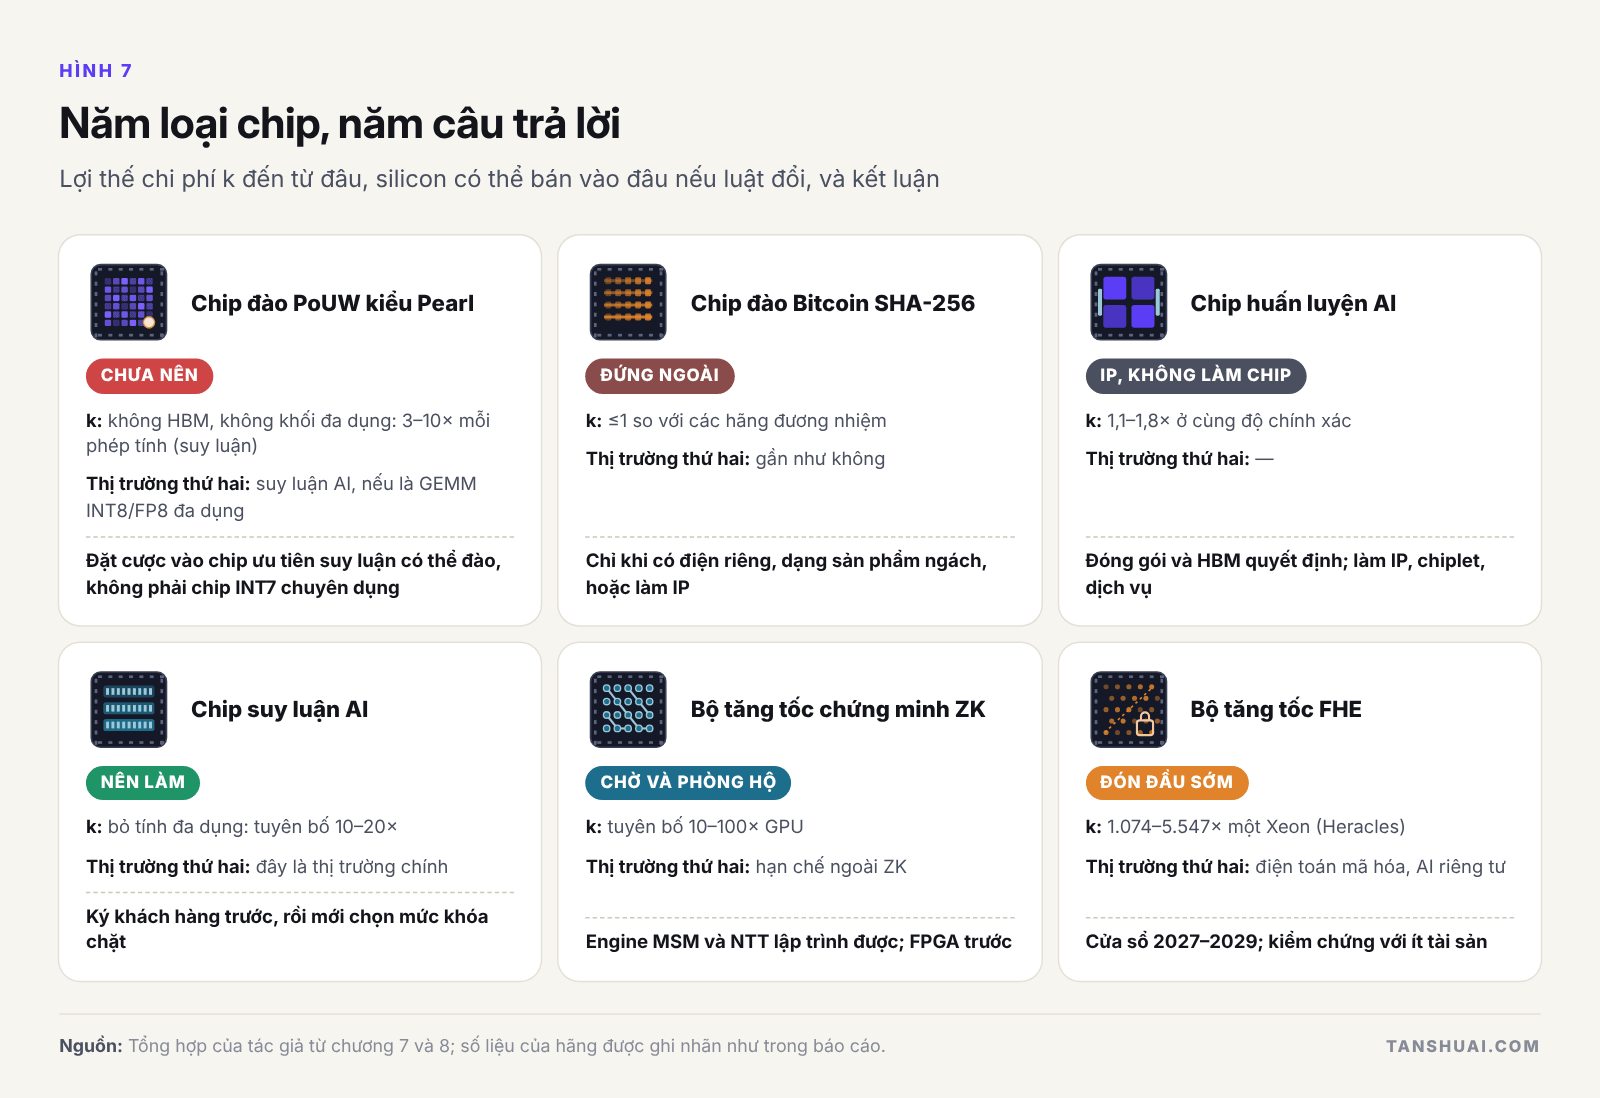 Hình 7. Năm loại chip, năm câu trả lời.
Với Pearl, tôi sẽ không tape-out một chip INT7 chuyên dụng lúc này: một đội mới cần 18 đến 24 tháng, và đến lúc đó giao thức có thể đã chuyển sang FP8. Đặt cược tốt hơn là một bộ tăng tốc ưu tiên suy luận xây trên GEMM INT8/FP8 đa dụng với toán hạng nằm trong SRAM, để silicon có thị trường thứ hai nếu cửa đào bị đóng. Một đội mới nên đứng ngoài thị trường máy đào bitcoin thương mại, nơi Bitmain giao máy 8,9 J/TH và những kẻ thách thức đang rút lui; các địa điểm có nguồn điện nay đáng giá hơn khi làm trung tâm dữ liệu AI so với làm mỏ đào. Đội nhỏ không nên làm chip huấn luyện độc lập. Chip suy luận đáng làm khi có khách hàng đã ký, bộ tăng tốc ZK là một khoản phòng hộ, và bộ tăng tốc FHE là một vị thế đón đầu cho giai đoạn 2027–2029.
Tiến trình và ngân sách theo giai đoạn
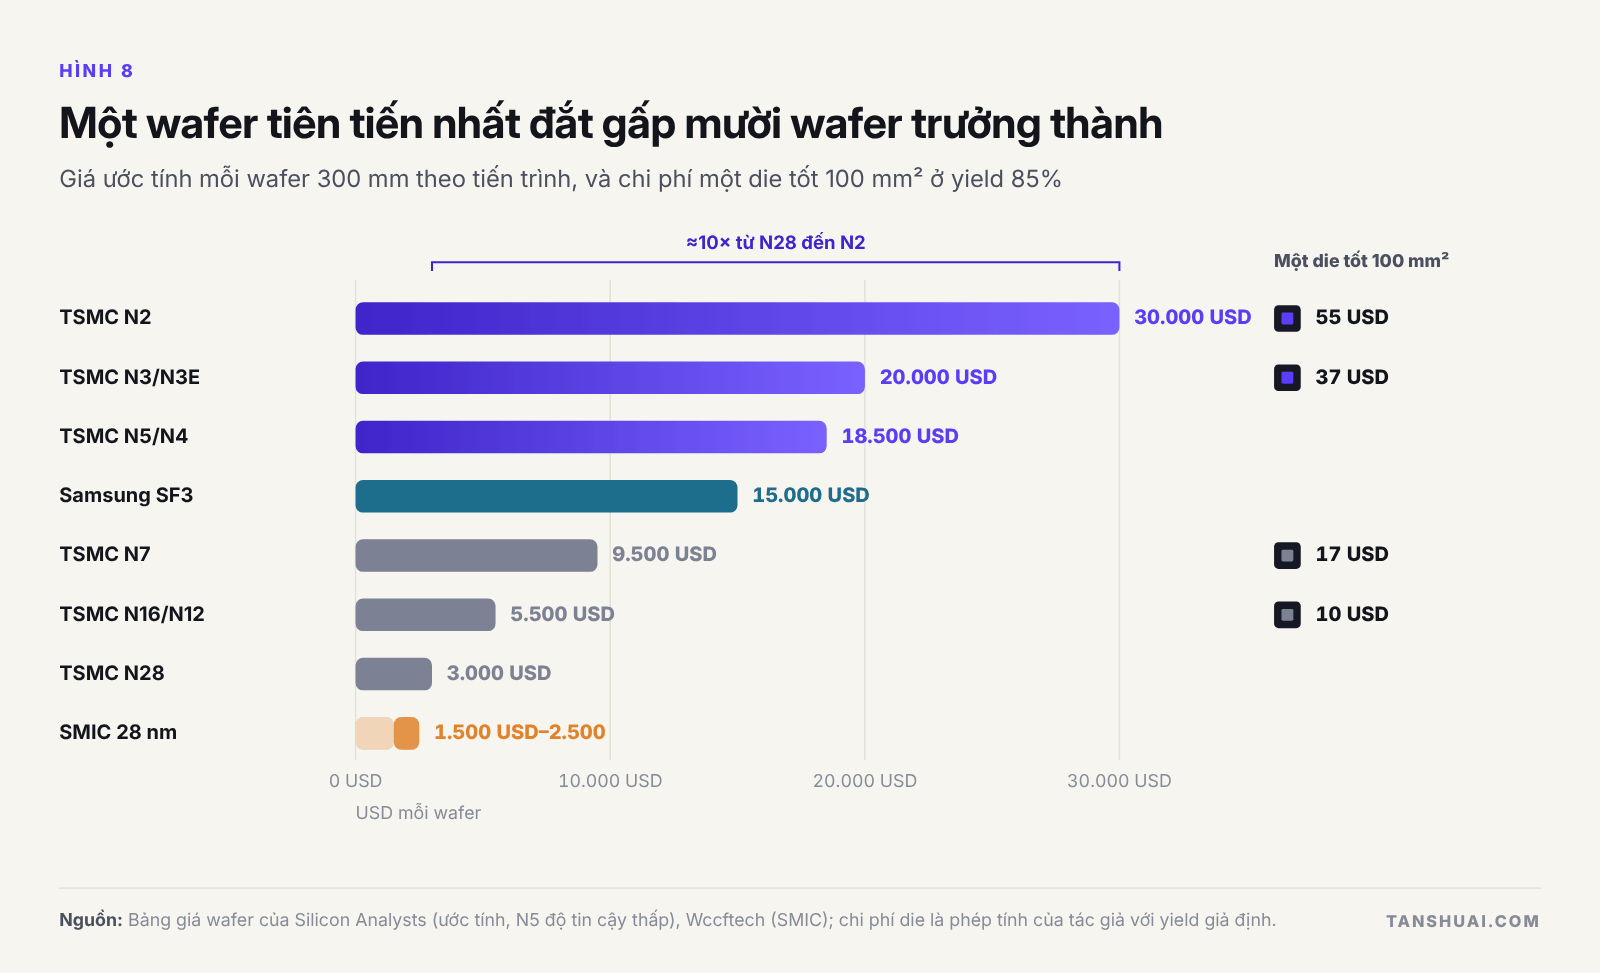 Hình 8. Một wafer tiên tiến nhất đắt gấp mười wafer trưởng thành.
Hãy để khoản lớn nhất trong chi phí vòng đời của con chip chọn tiến trình: năng lượng với chip tính toán chạy suốt ngày đêm, đóng gói và HBM với chip huấn luyện (khoảng 63% chi phí của một H100), và lựa chọn giữa SRAM và HBM với chip suy luận. Một chip đào PoUW có thể làm mẫu trên wafer đa dự án 28 hoặc 16/12 nm và chỉ chuyển sang N7/N6 rồi N5/N4 khi thuật toán và doanh thu đã ổn định.
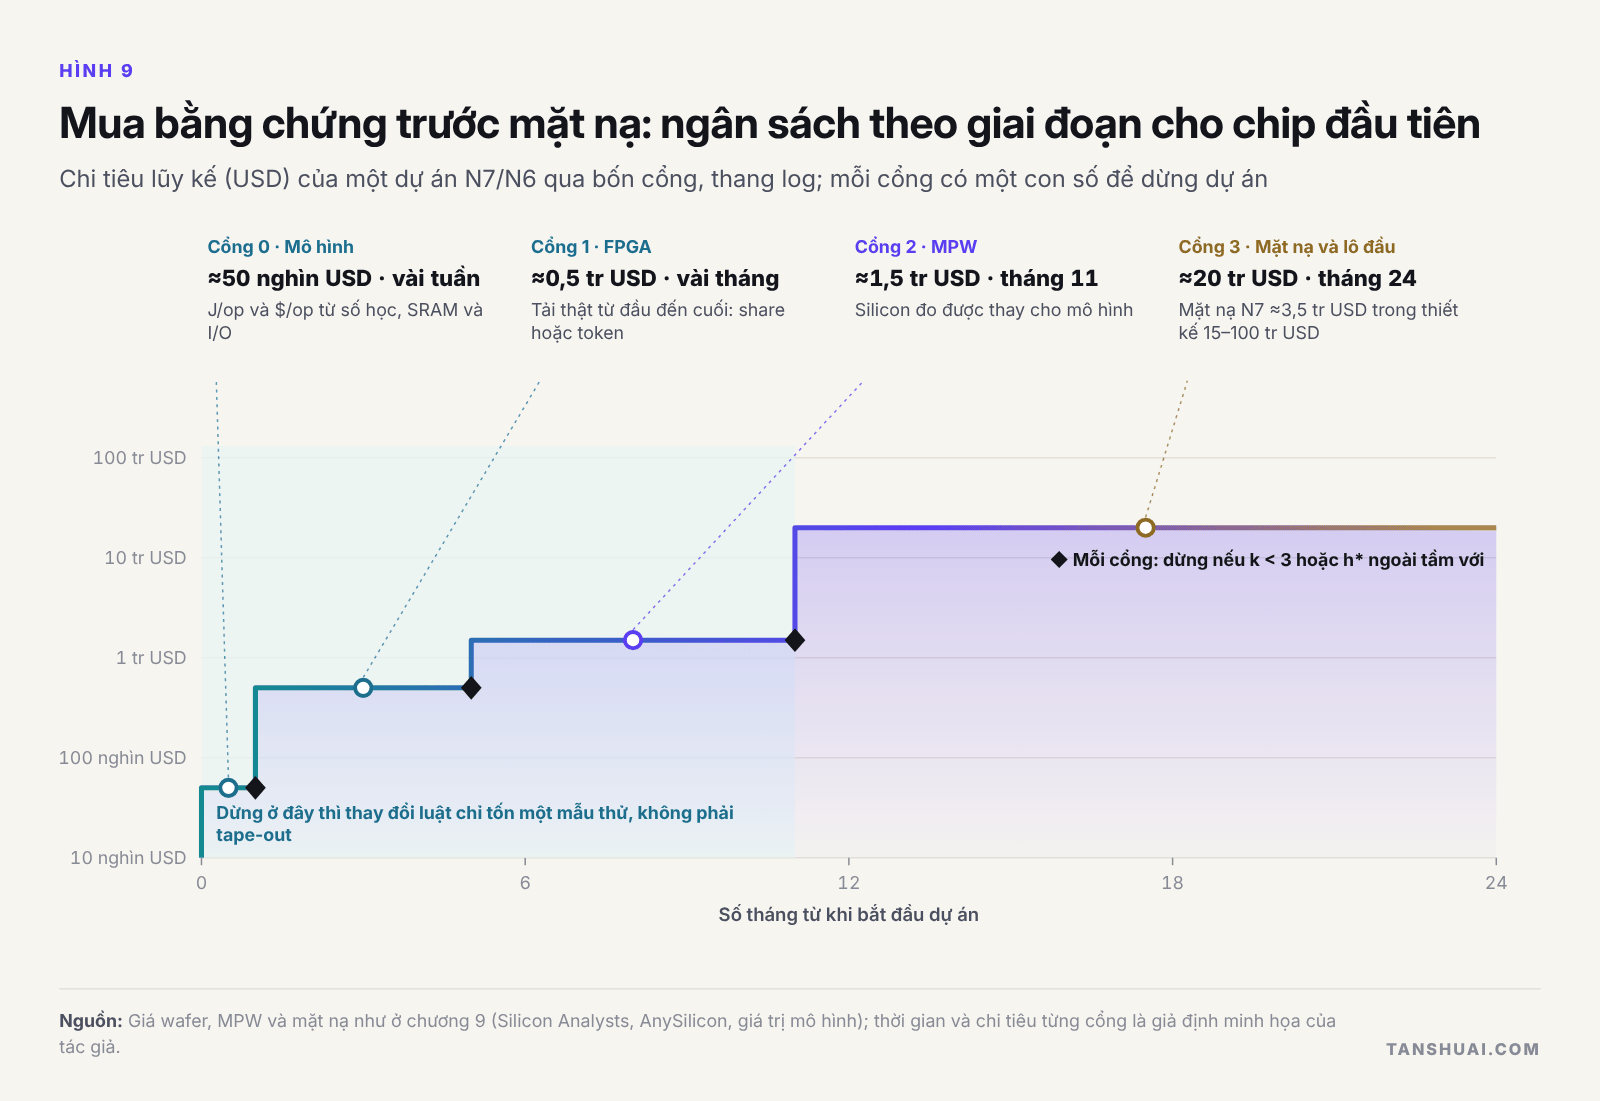 Hình 9. Mua bằng chứng trước khi mua mặt nạ: ngân sách theo giai đoạn cho con chip đầu tiên.
Con chip đầu tiên nên được mua theo bốn giai đoạn, mỗi giai đoạn có một con số khiến dự án dừng lại: một mô hình J/op và $/op, một FPGA chạy khối lượng công việc thật, một wafer đa dự án, và chỉ sau đó mới đến bộ mặt nạ. Trên N7/N6, ba giai đoạn đầu tốn khoảng 1,5 triệu USD và mười một tháng; bộ mặt nạ và lô đầu tiên tốn gấp hơn mười lần [ước tính]. Nếu giao thức thay đổi phép số học hoặc người mua bỏ đi, một đội đã dừng ở wafer chỉ mất giá một mẫu thử, chứ không phải giá một lần tape-out. Hiệu quả rẻ nhất đến từ kiến trúc: giữ toán hạng trong SRAM và bỏ HBM đã loại bỏ phần lớn chi phí của một GPU trước khi chọn bất kỳ tiến trình nào.
Tôi sẽ bắt đầu từ đâu
Cơ hội nằm ở nơi các lĩnh vực giao nhau: crypto là khách hàng đầu tiên, AI là thị trường thứ hai. Nhu cầu chip tùy biến năm 2026 áp đảo đến từ AI, và các kỹ năng của một đội chip đào, mảng điện áp thấp, cấp nguồn kilowatt và tape-out nhanh, chuyển giao trực tiếp được. Tôi sẽ đi tối đa ba hướng, mỗi hướng được thử bằng một bước đầu nhỏ: một bộ tăng tốc ưu tiên suy luận và cũng đào được, bắt đầu bằng một nghiên cứu bốn tuần về J/op và $/op; dịch vụ silicon tùy biến với crypto là khách hàng đầu tiên, bắt đầu bằng các nghiên cứu khả thi có thu phí; và một mạng AI-native ký được người mua sức tính trước khi thiết kế token.
Tải báo cáo đầy đủ và bản trình chiếu
Báo cáo đầy đủ trình bày chi tiết cơ chế, kinh tế và luật lệ của Pearl, các chuỗi công việc hữu ích khác và bức tranh AI × crypto rộng hơn, mô hình ASIC cùng phép tính hoàn vốn, kết luận cho từng loại chip, chi phí và lựa chọn tiến trình, ngân sách theo giai đoạn cho con chip đầu tiên, danh sách dấu hiệu cần theo dõi và toàn bộ nguồn.
- Tính toán là đồng thuận: báo cáo đầy đủ (PDF)
- Tính toán là đồng thuận: bản trình chiếu (PDF)
- Ấn bản tiếng Anh: báo cáo đầy đủ · bản trình chiếu
Đây là bản dịch từ ấn bản tiếng Anh; nếu có khác biệt, ấn bản tiếng Anh được ưu tiên.
Những câu hỏi bạn chưa hỏi nhưng nên hỏi
Trước khi bỏ tiền hay silicon vào bất kỳ dự án AI × crypto nào, tôi sẽ hỏi: ai kiểm soát hàm công việc; bội số trợ cấp là bao nhiêu; cổng tiếp theo tốn bao nhiêu và con số nào khiến bạn dừng lại; hashrate hoàn vốn là bao nhiêu, khi tính cả p; thị trường thứ hai của con chip là gì; giá trị rơi vào token hay vào cổ phần; và khách hàng trả tiền đầu tiên là ai, tên cụ thể.
Đây là những lĩnh vực chúng ta có thể cùng khám phá, qua trao đổi kỹ thuật và hợp tác kỹ thuật: chip tùy biến cho khai thác, huấn luyện và suy luận AI, và các bộ tăng tốc; phát triển AI; và hệ thống AI × crypto từ chuỗi đến node đến chip. Bạn có thể liên hệ tôi qua i@tanshuai.com.
Về tác giả
Tan Shuai là nhà công nghệ và nhà sáng lập với hơn hai mươi năm làm việc trong lĩnh vực chip, phần cứng và phần mềm hệ thống, cùng 20 bằng sáng chế đã được cấp. Ông có nhiều năm nghiên cứu, phát triển và quản lý chip fabless, bao gồm thiết kế đường dữ liệu ASIC full-custom cho chip đào tiền điện tử và chip camera đa phương tiện. Công việc đã đưa ông qua Thung lũng Silicon, New York, Chicago, Đài Loan, Vùng Vịnh Lớn (Thâm Quyến và Hồng Kông), Việt Nam và Malaysia. Hiện ông là nhà nghiên cứu và phát triển AI.
Trao đổi kỹ thuật: i@tanshuai.com.