
En blokkjede kjører nå på den samme matrisemultiplikasjonen som KI, med om lag 90 EH/s. Jeg leste koden, kjededataene og økonomien rundt den for å svare på tre spørsmål: hva innen KI × krypto har betalende kunder, når en ASIC er verdt å bygge, og hvilken prosessnode som passer hvilken brikke. Med hele rapporten og lysbilder.
Sammendrag
Pearl, lansert i april 2026, er den første blokkjeden der arbeidsbeviset er matrisemultiplikasjon av KI-typen i stor skala. 13. november 2026 kjørte nettverket med om lag 90 EH/s, der én H er én INT7-multipliser-akkumuler: heltallsgjennomstrømningen til om lag 122 000 H100. Det virker som ingeniørkunst. Det er ennå ikke nyttig: om lag 1 % av blokkene bærer reelt KI-arbeid, fordi en GPU som utvinner mens den serverer inferens, bare beholder 1 % til 27 % av hashraten til en dedikert utvinner. På tvers av KI × krypto viser verifiserbar betalt etterspørsel seg tre steder, i salg av inferens, salg av data og salg av personvern, mens subsidiene ligger på 4 til 360 ganger ekstern inntekt. For brikker er fortjenestetaket til en ASIC inntekten per regneenhet ganger (1 − 1/k), så effektivitet utover k = 5 gir lite; det som avgjør, er størrelsen på potten, stabiliteten i reglene og et andremarked. Intet nettverk tilbyr alle tre i dag. Riktig prosessnode bestemmes av den største posten i brikkens livstidskostnad, og selve brikken bør kjøpes trinnvis, slik at en regelendring koster en prototyp i stedet for en tape-out.
Hvorfor jeg så på dette
Jeg har i mange år designet brikker, blant annet fullkundetilpassede ASIC-dataveier for utvinning av kryptovaluta, og jeg arbeider nå med KI. Da det dukket opp en kjede der sikkerhetsbudsjettet bokstavelig talt er priset i tensorgjennomstrømning, var spørsmålene for en som meg åpenbare: er arbeidet nyttig, ville en dedikert brikke vinne, og hva ville det koste å bygge en?
Jeg leste Pearls kode og protokollforslag, kjededata fra en uavhengig fullnode, selskapsrapporter, artikler innen kryptografi, datamaskinarkitektur og maskinlæring, prisdata fra støperier og leverandører, og fagpressen. Hvert tall nedenfor gjelder per 13. november 2026, og beløp er i amerikanske dollar. Dette notatet er hvordan jeg lærte meg feltet; jeg deler det slik at andre kan kontrollere det, bruke det og argumentere mot det. Hele rapporten, med alle kildene, ligger til slutt.
Resultatene i korte trekk
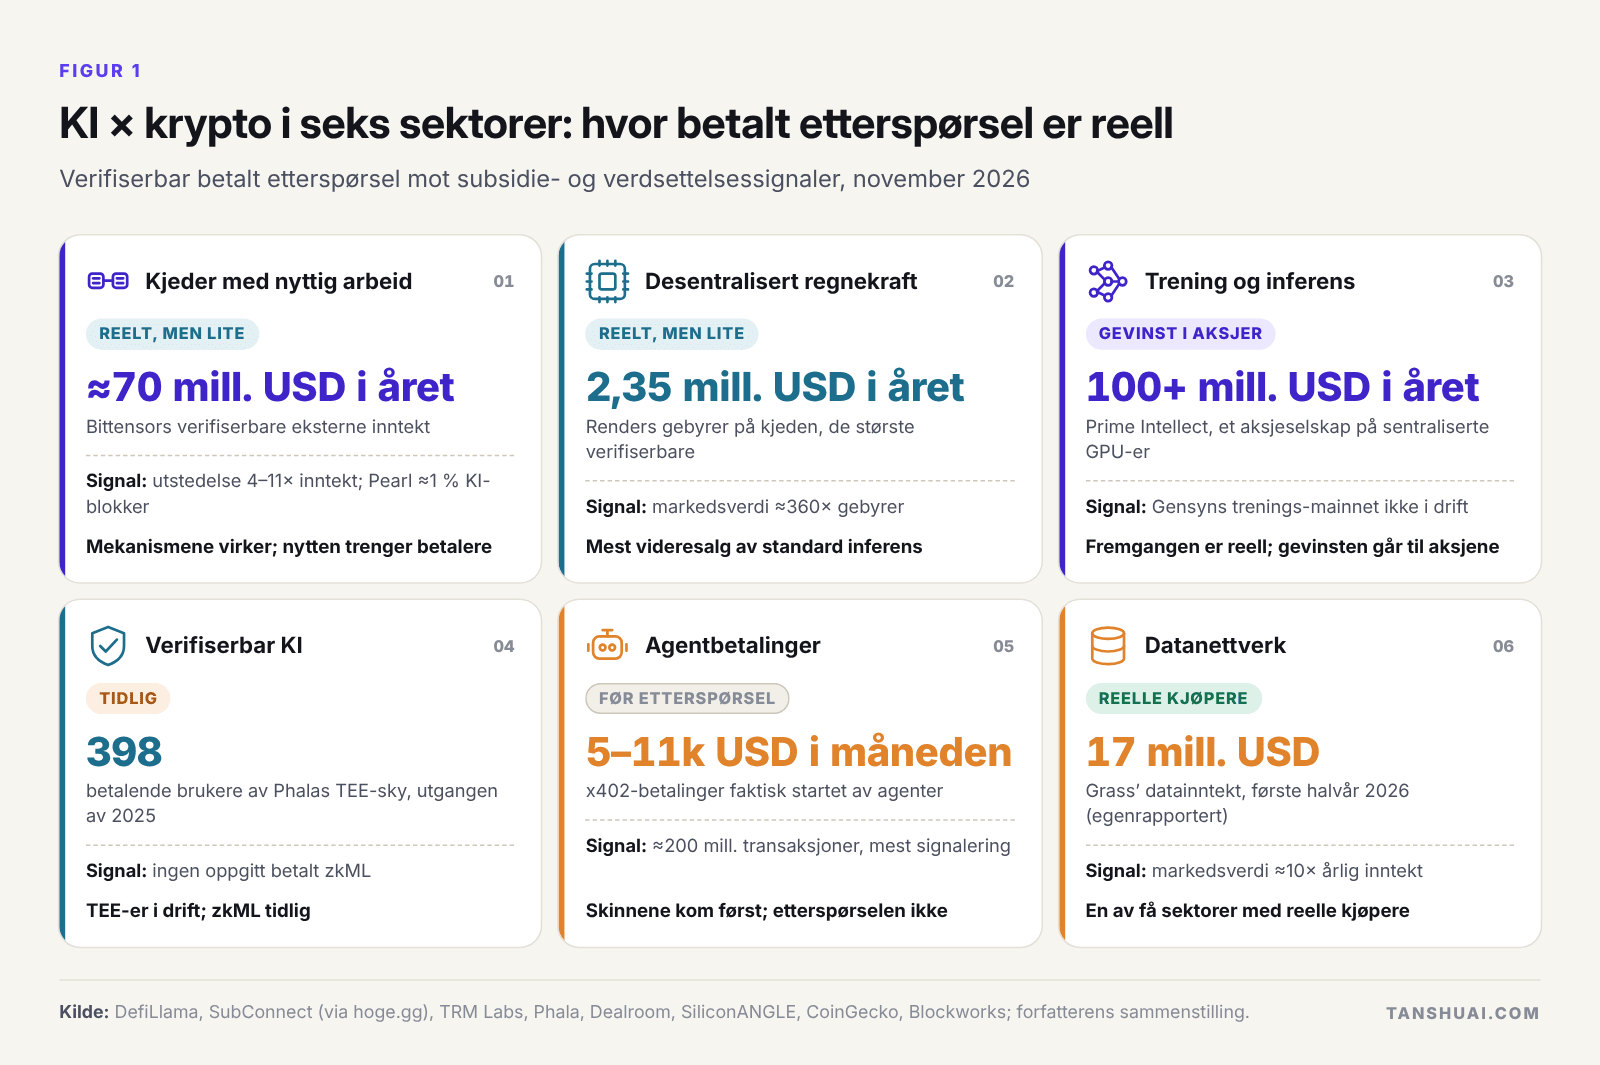 Figur 1. KI × krypto i seks sektorer: hvor betalt etterspørsel er reell.
| Spørsmål | Kort svar |
|---|---|
| Virker Pearl, og er arbeidet nyttig? | Det virker: om lag 90 EH/s matrisemultiplikasjon sikrer kjeden. Det er ennå ikke nyttig: om lag 1 % av blokkene bærer KI-arbeid |
| Hvor er den reelle betalte etterspørselen? | Inferens, data og personvern. Agentbetalinger, zkML og desentralisert trening er fortsatt før etterspørsel |
| Er en ASIC verdt å bygge? | Bare med stor pott, stabile regler og et andremarked; intet nettverk tilbyr alle tre i dag |
| Hvilke brikker bør et lite team bygge? | Inferensakseleratorer som også kan utvinne, inferensbrikker for en signert kunde, tidlig FHE-arbeid; ikke bitcoin-utvinnere for det åpne markedet eller treningsbrikker |
| Hva koster en første brikke? | Kjøp den trinnvis: en modell, en FPGA og en MPW når målt silisium for om lag 1,5 millioner dollar, før masker som koster millioner |
Pearl: én multipliser-akkumuler er én hash
Pearl bygger på et resultat fra 2025 av Ilan Komargodski og Omri Weinstein: et bevis på nyttig arbeid for ethvert matriseprodukt, til 1 + o(1) ganger kostnaden for multiplikasjonen. Utvinnere multipliserer støyfylte matriser, hasher akkumulatoren til hver utdataflis til en lottokupong og beviser den vinnende flisen med et nullkunnskapsbevis på under 60 KB. I konsensuskoden er én H én godskrevet INT7 × INT7 → INT32-multipliser-akkumuler, så for første gang er en blokkjedes sikkerhetsbudsjett priset i tensorgjennomstrømningen til KI-akseleratorer.
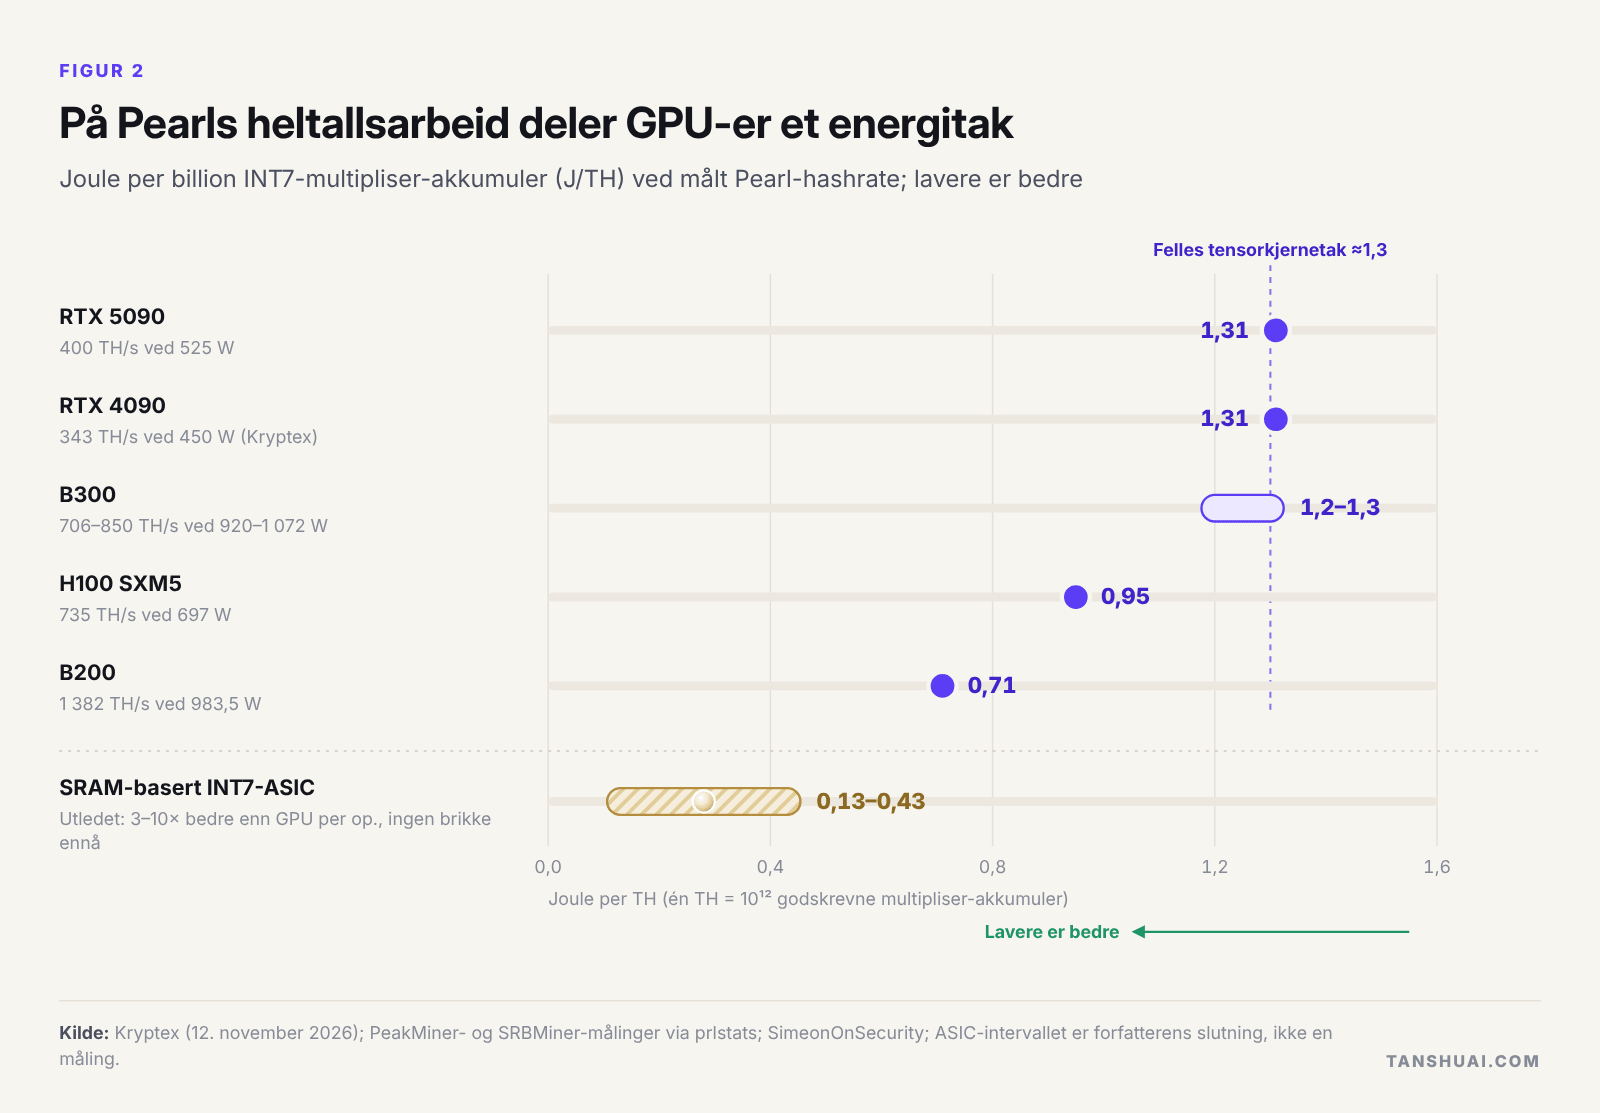 Figur 2. På Pearls heltallsarbeid deler GPU-er et energitak.
Spillkort og datasenterbrikken B300 møtes ved om lag 1,3 J/TH, og selv B200 når bare 0,71. Det felles taket er nettopp det en dedikert brikke kunne bryte: en brikke som bare multipliserer 7-bits heltall fra SRAM på brikken, uten HBM eller generelle enheter, kunne trolig gjort det 3 til 10 ganger bedre per operasjon. Samtidig flytter NVIDIA sitt nyeste silisium bort fra INT8 mot FP8 og FP4, og det er derfor Pearl forbereder seg på å endre aritmetikken.
Pearls økonomi: teoremet holder, insentivet gjør det ikke
Pearls hashrate følger prisen. Nettverket gikk fra 0,01 EH/s på andre dag til 23–26 EH/s i slutten av mai, holdt seg på 21–39 EH/s gjennom en sommer der prisen falt om lag 86 %, og nådde om lag 90 EH/s etter at prisen steg om lag tidobbelt om høsten. Om lag 120 millioner mynter, omtrent 32 % av dagens tilbud, ble utvunnet de første seks dagene, og tilbudet vil vokse med om lag 78 % de neste 12 månedene. Et RTX 5090 tjener nå om lag 5–6 dollar om dagen.
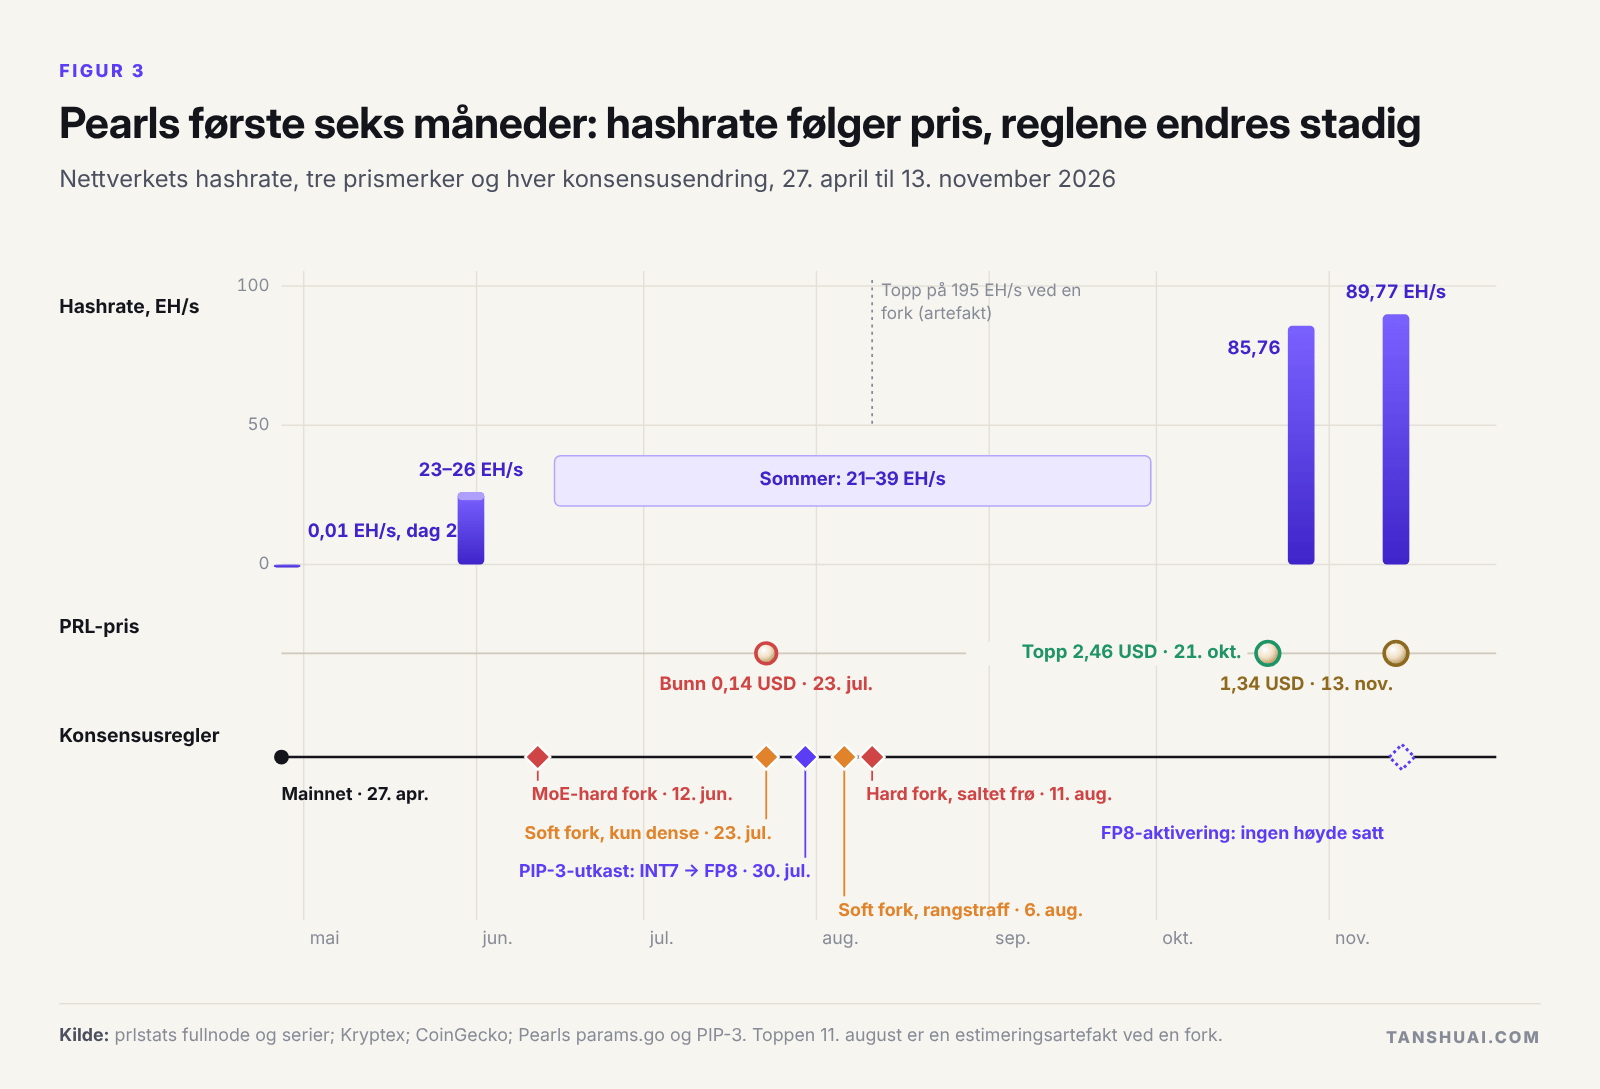 Figur 3. Pearls første seks måneder: hashrate følger pris, reglene endres stadig.
Det er i den nyttige delen modellen bryter sammen. Utvinning inne i reell inferens koster lite på inferenssiden, om lag 5 % til 9 % av gjennomstrømningen, men tjener lite på utvinningssiden: Pearls tillegg utvinner bare på lange prefill-batcher, så et kort som serverer en chat-arbeidslast, beholder om lag 5 % av hashraten til en dedikert utvinner. Rasjonelle utvinnere multipliserer derfor tilfeldige matriser, og protokollen kan ikke se forskjell. Det ene offentlige inferenspartnerskapet finnes ikke lenger på leverandørens serverløse API. Pearls nytte er et kommersielt problem utenfor kjeden: noen må betale for inferensen.
Reglene er den andre risikoen. Fra juni til august aktiverte laben fire konsensusendringer ved hardkodede høyder, og utkastet PIP-3 flytter utvinningen til FP8 med bitnøyaktige enhetsprofiler for bare to NVIDIA-arkitekturer. Et tallformat kan være nyttig for KI, verifiserbart bit for bit og maskinvarenøytralt, men høyst to av de tre.
På tvers av KI × krypto: subsidier er drivstoff, ikke en forretningsmodell
Andre kjeder med nyttig arbeid forteller samme historie. Kaspa la et matriseprodukt inn i hashen sin og fikk ASIC-er innen 16 måneder likevel; den beste maskinen tjener nå 0,86 dollar om dagen. Aleos syntetiske bevispuslespill fikk dedikert maskinvare på fem måneder og betalte provere 175–180 ganger gebyrene. Bittensor er det eneste nettverket i gruppen med ekstern inntekt i stor skala, om lag 70 millioner dollar i året, mot over 300 millioner dollar i utstedelse.
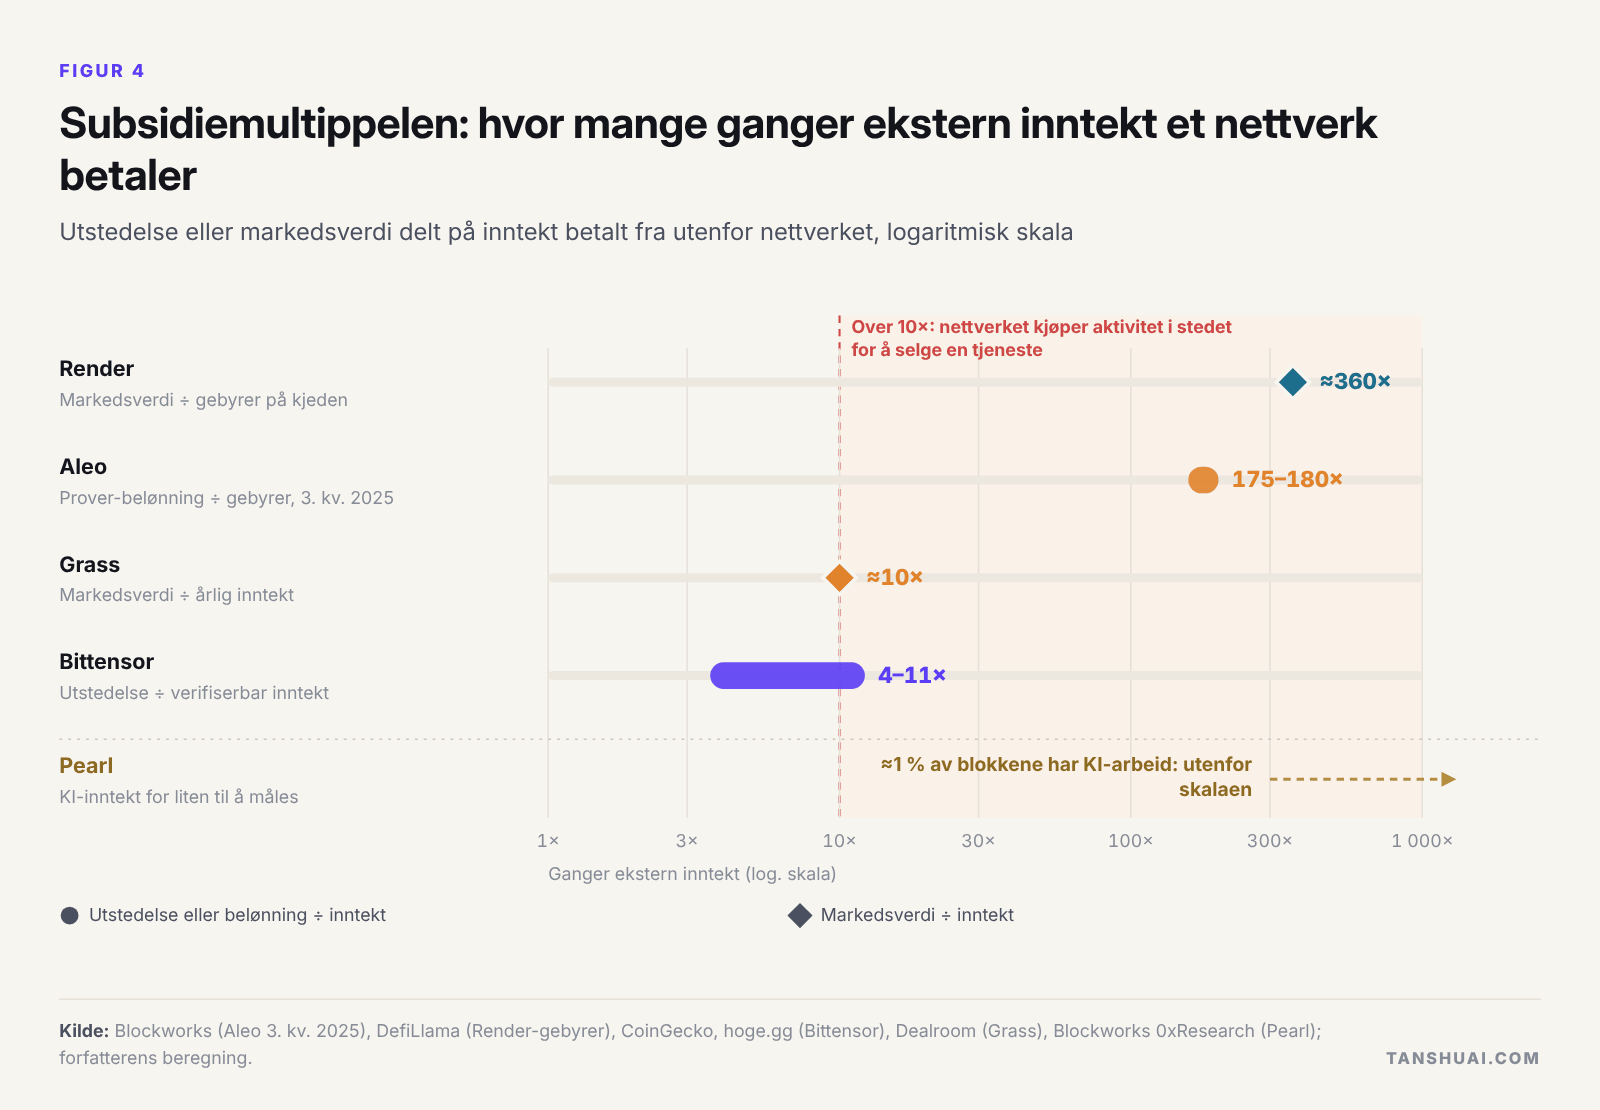 Figur 4. Subsidiemultippelen: hvor mange ganger ekstern inntekt et nettverk betaler.
Utover konsensus er bildet reell etterspørsel i liten skala. Desentraliserte GPU-markeder selger standard inferens og slår prisene til de store skyleverandørene, men ikke de billigste neoskyene. Trening over internett fungerer ved 8 til 40 milliarder parametere, mens kjøringene i fronten gikk tilbake til sentraliserte klynger. Klarerte kjøremiljøer (TEE) kjører konfidensiell inferens i drift; nullkunnskapsbevis for KI er fortsatt i laboratoriet. Betalinger startet av KI-agenter utgjør om lag 5 000–11 000 dollar i måneden, til tross for skinner bygd av Visa, Mastercard, Stripe og Google. Data er en av få sektorer med reelle kjøpere. Samtidig er fire aksjeselskaper på sentralisert infrastruktur verdt omtrent like mye som alle KI-tokener på protokoll- og applikasjonslaget til sammen: krypto står for distribusjon og oppgjør, og aksjene tar gevinsten.
Når en ASIC lønner seg: én formel, tre målestokker
Når GPU-er setter prisen på utvinning, går inntekten per regneenhet mot kostnaden deres, og en ASIC som er k ganger billigere, beholder høyst (1 − 1/k) av inntekten. Kurven er konkav: 50 % ved k = 2, 80 % ved k = 5, 90 % ved k = 10. Utover k = 5 gir mer effektivitet lite fortjeneste; og mot ledige GPU-er som bare betaler for strøm, kan effektiv k være bare om lag 2,5.
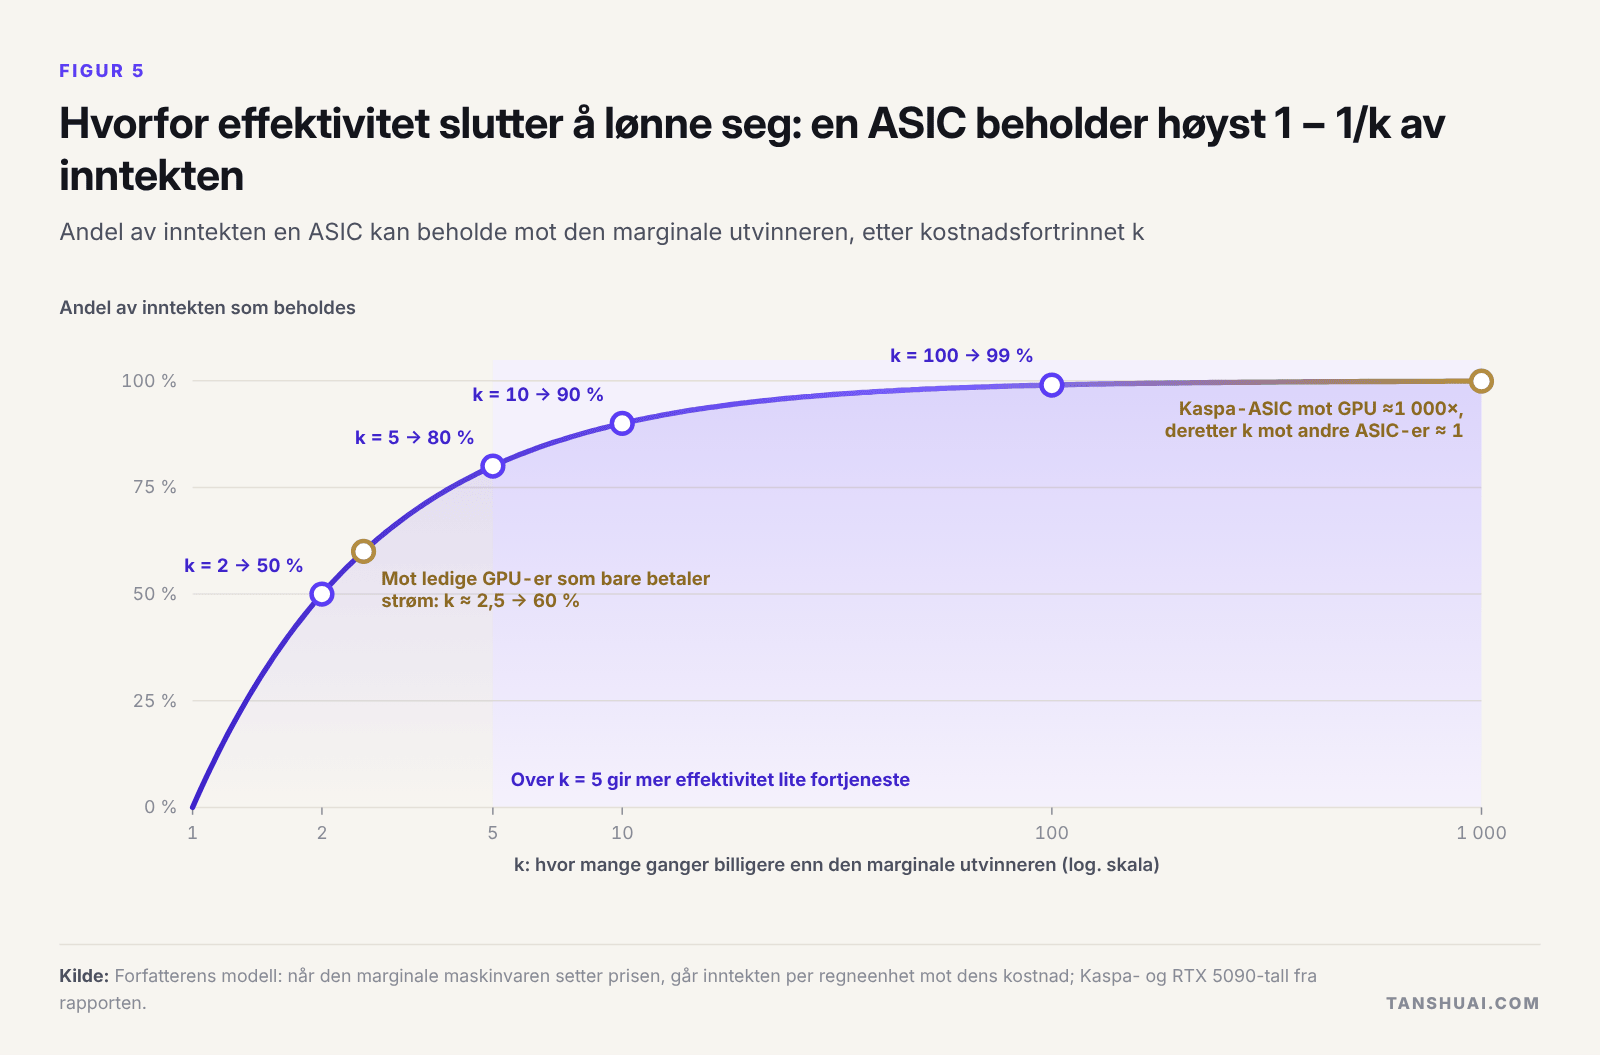 Figur 5. Hvorfor effektivitet slutter å lønne seg: en ASIC beholder høyst 1 − 1/k av inntekten.
Tre målestokker avgjør så: potten, tilbakebetalingsskalaen og reglene. Bitcoin-utvinnere tjener om lag 11,5 milliarder dollar i året, Pearls om lag 0,46–0,49 milliarder, Aleos om lag 31 millioner og Kaspas om lag 18 millioner, mindre enn nedre ende av ett brikkedesign på 5/4 nm. For Pearl trenger en brikke til 20 millioner dollar med k = 5 om lag 4,9 EH/s i drift i et år for å betale seg tilbake hvis reglene holder, og det dobbelte hvis de bare holder med femti prosents sjanse.
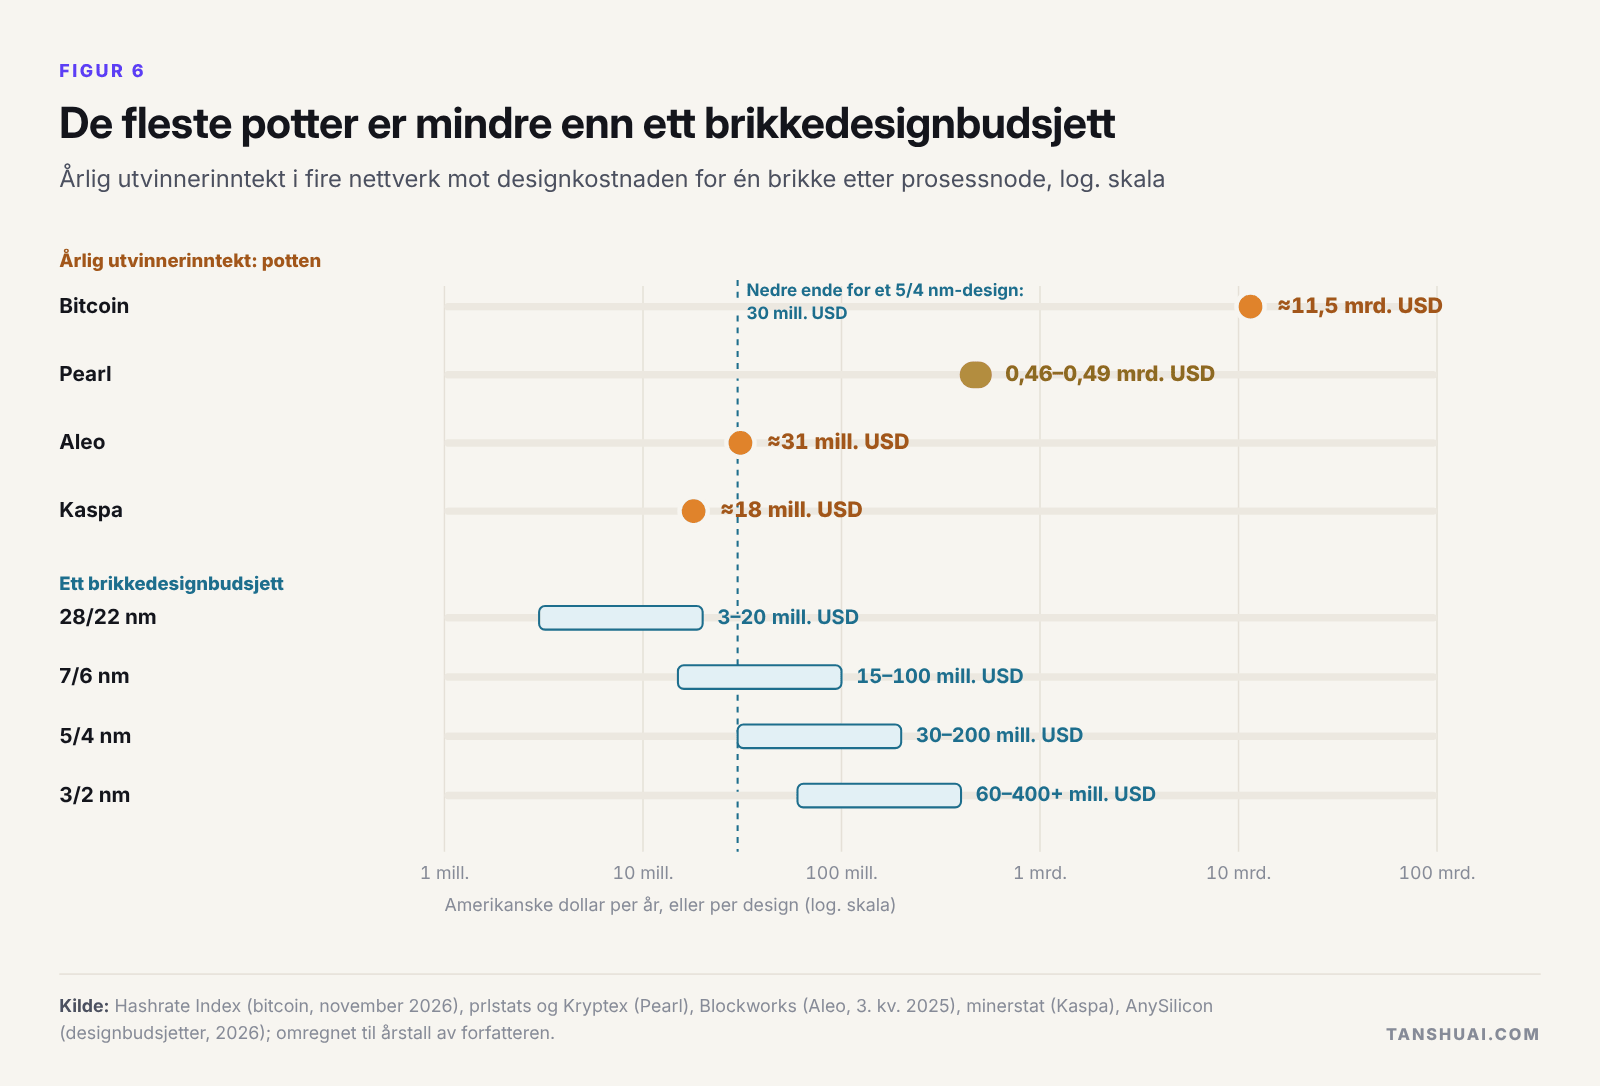 Figur 6. De fleste potter er mindre enn ett brikkedesignbudsjett.
I dag tilbyr intet nettverk stor pott, stabile regler og k over 1 samtidig: bitcoins k tilhører de etablerte, Pearls regler er minst stabile, og Kaspas og Aleos potter er for små.
Fem brikketyper, fem svar
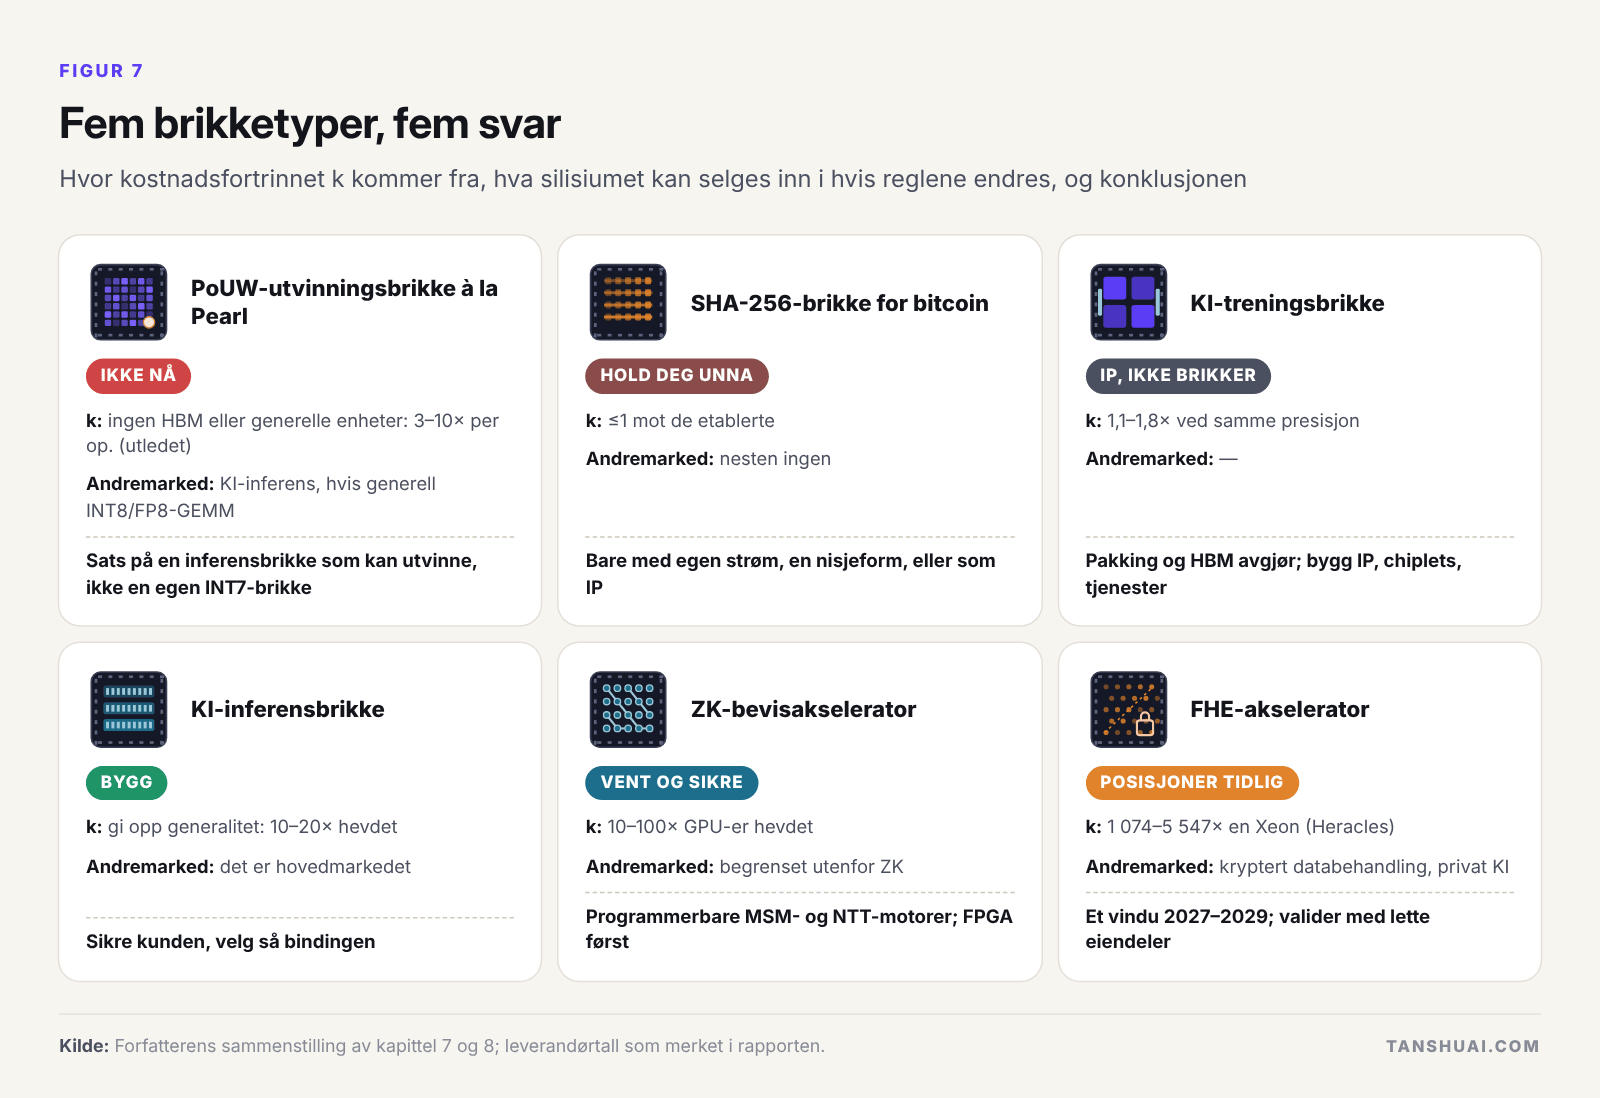 Figur 7. Fem brikketyper, fem svar.
For Pearl ville jeg ikke tatt tape-out av en dedikert INT7-brikke nå: et nytt team trenger 18 til 24 måneder, og protokollen kan ha gått over til FP8 innen da. Det bedre veddemålet er en inferensakselerator bygd på generell INT8/FP8-GEMM med operander i SRAM, slik at silisiumet har et andremarked hvis tilgangen til utvinning stenges. Et nytt team bør holde seg unna det åpne markedet for bitcoin-utvinnere, der Bitmain leverer maskiner på 8,9 J/TH og utfordrerne trekker seg tilbake; kraftlokasjoner er nå mer verdt som KI-datasentre enn som utvinningsanlegg. Små team bør ikke bygge frittstående treningsbrikker. Inferensbrikker er verdt å bygge for en signert kunde, ZK-akseleratorer er en sikring, og FHE-akseleratorer er en tidlig posisjon for 2027–2029.
Prosessnoder og et trinnvis budsjett
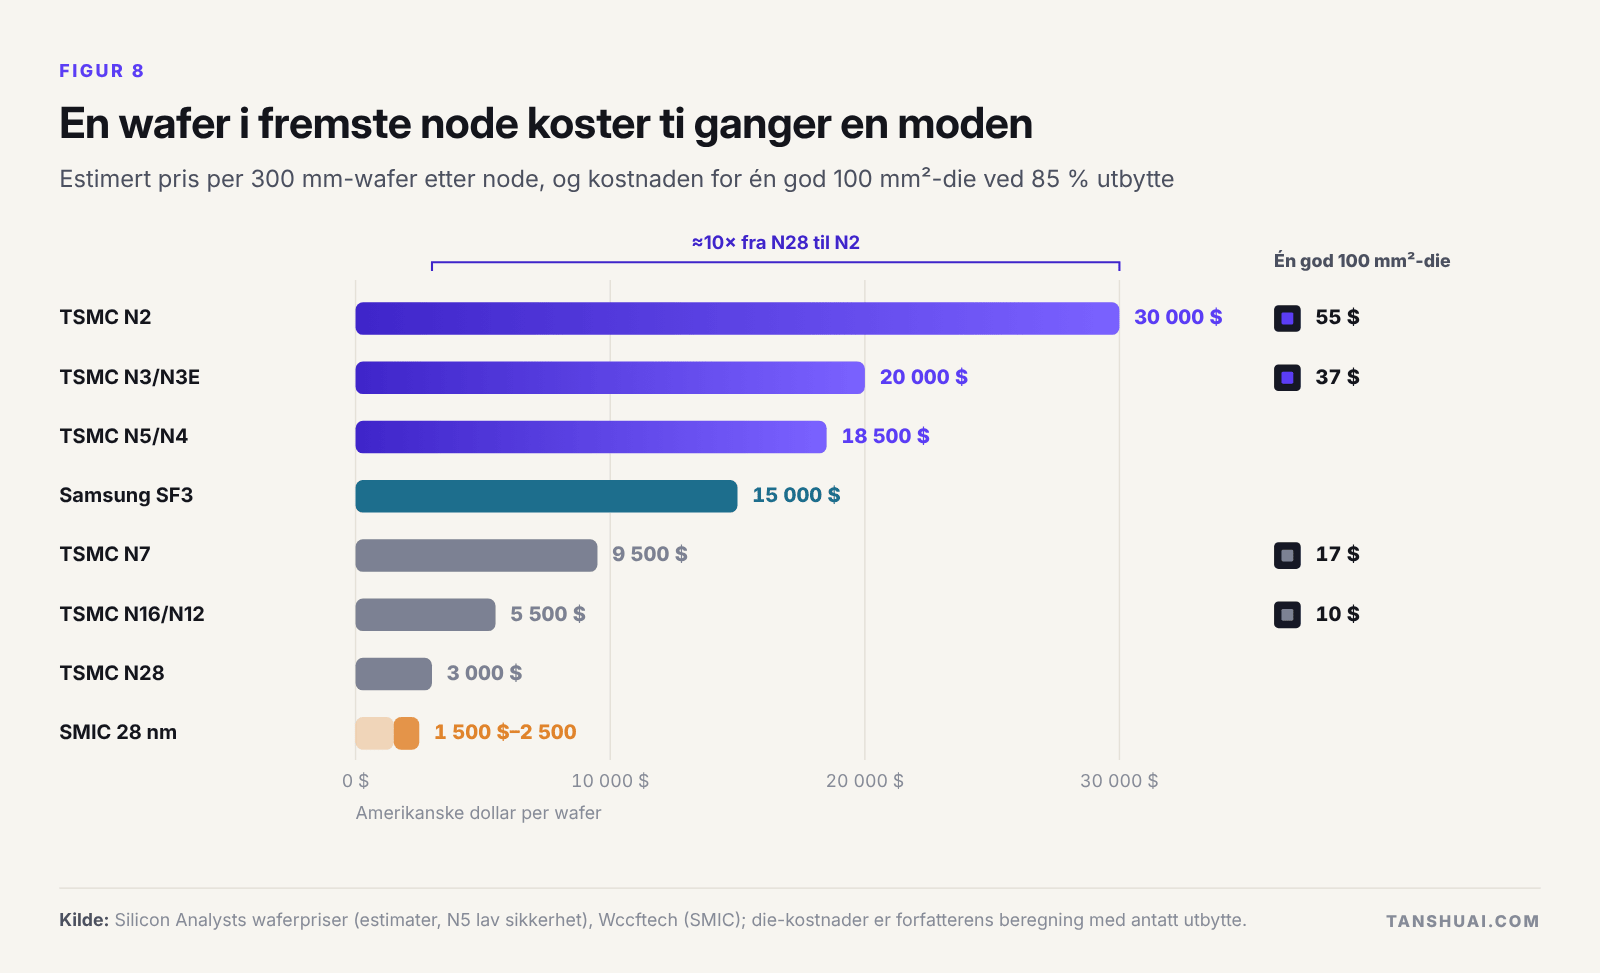 Figur 8. En wafer i fremste node koster ti ganger en moden.
La den største posten i brikkens livstidskostnad velge noden: energi for regnebrikker som går døgnet rundt, pakking og HBM for treningsbrikker (om lag 63 % av kostnaden for en H100), og valget mellom SRAM og HBM for inferensbrikker. En PoUW-utvinningsbrikke kan lages som prototyp på flerprosjektwafere (MPW) på 28 eller 16/12 nm og gå over til N7/N6 og så N5/N4 først når algoritmen og inntekten er stabile.
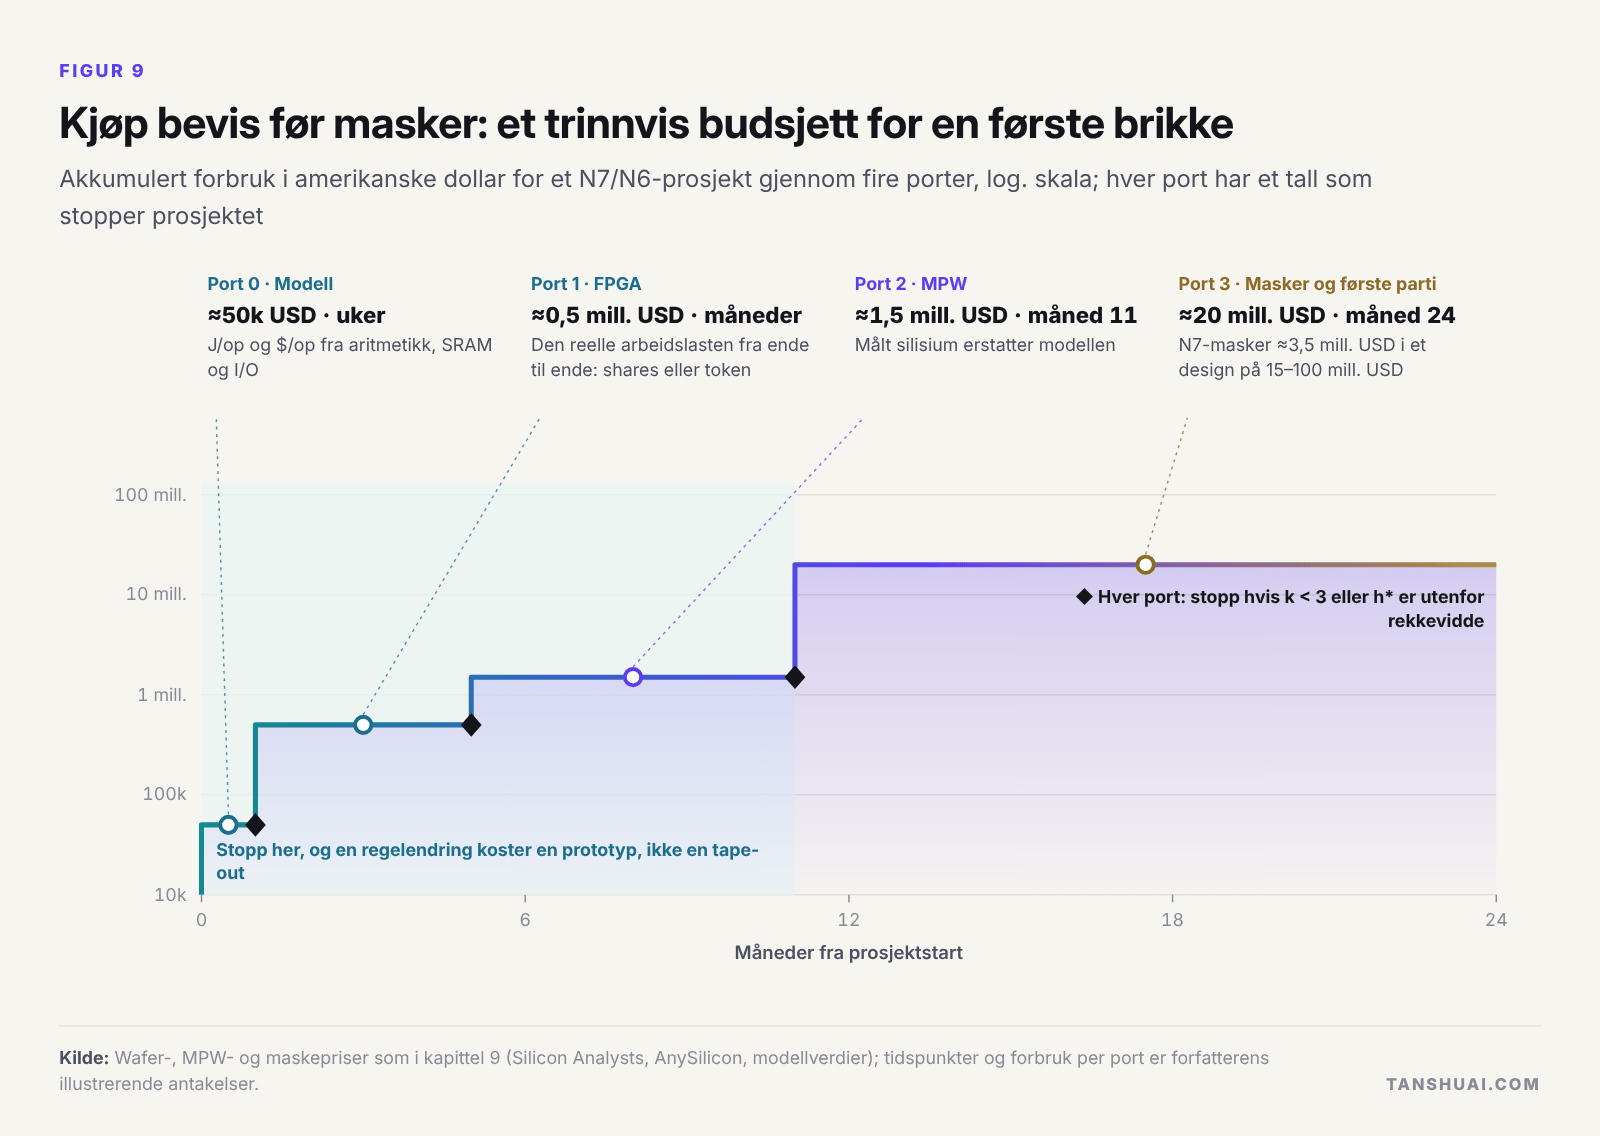 Figur 9. Kjøp bevis før masker: et trinnvis budsjett for en første brikke.
En første brikke bør kjøpes i fire trinn, hvert med et tall som stopper prosjektet: en modell av J/op og $/op, en FPGA som kjører den reelle arbeidslasten, en flerprosjektwafer, og først deretter et maskesett. På N7/N6 koster de tre første om lag 1,5 millioner dollar og elleve måneder; maskesettet og første parti koster over ti ganger så mye [estimat]. Hvis protokollen endrer aritmetikken eller kjøperen trekker seg, taper et team som stoppet ved waferen, prisen for en prototyp, ikke for en tape-out. Den billigste effektiviteten er arkitektonisk: å holde operandene i SRAM og utelate HBM fjerner det meste av kostnaden til en GPU før noen node er valgt.
Hvor jeg ville begynt
Mulighetene ligger der feltene krysser hverandre: krypto som første kunde, KI som andremarked. Etterspørselen etter spesialbrikker i 2026 er overveldende KI, og kompetansen til et team for utvinningsbrikker, lavspenningsarrayer, kraftforsyning i kilowattklassen og raske tape-outs, kan overføres direkte. Jeg ville valgt høyst tre veier, hver testet med et lite første steg: en inferensakselerator som også kan utvinne, med start i en fireukers studie av J/op og $/op; tjenester for spesialsilisium med krypto som første kunde, med start i betalte mulighetsstudier; og et KI-nativt nettverk som signerer kjøperen av regnekraft før det designer tokenet sitt.
Last ned hele rapporten og lysbildene
Hele rapporten dekker Pearls mekanisme, økonomi og regler i detalj, de andre kjedene med nyttig arbeid og det bredere KI × krypto-landskapet, ASIC-modellen med tilbakebetalingsregnestykket, konklusjoner brikke for brikke, nodekostnader og -valg, et trinnvis budsjett for en første brikke, en liste over signaler og alle kildene.
- Regnekraft som konsensus: hele rapporten (PDF)
- Regnekraft som konsensus: lysbilder (PDF)
- Engelsk utgave: hele rapporten · lysbilder
Dette er en oversettelse av den engelske utgaven; ved avvik gjelder den engelske utgaven.
Spørsmål du ikke stilte, men burde ha stilt
Før jeg satte penger eller silisium inn i et KI × krypto-prosjekt, ville jeg spurt: hvem kontrollerer arbeidsfunksjonen; hva subsidiemultippelen er; hva neste port koster og hvilket tall som stopper deg; hva tilbakebetalingshashraten er, med p; hva brikkens andremarked er; om verdien havner i tokenet eller i aksjene; og hvem den første betalende kunden er, ved navn.
Dette er områder vi kan utforske sammen, gjennom teknisk utveksling og teknisk samarbeid: spesialbrikker for utvinning, KI-trening og -inferens, og akseleratorer; KI-utvikling; og KI × krypto-systemer fra kjede til node til brikke. Du når meg på i@tanshuai.com.
Om forfatteren
Tan Shuai er teknolog og gründer med over tjue års arbeid innen brikker, maskinvare og systemprogramvare, og 20 innvilgede patenter. Han har mange år med fabless brikkeutvikling og -ledelse bak seg, blant annet fullkundetilpasset design av ASIC-dataveier for utvinningsbrikker for kryptovaluta og multimediebrikker for kameraer. Arbeidet har tatt ham gjennom Silicon Valley, New York, Chicago, Taiwan, Greater Bay Area (Shenzhen og Hongkong), Vietnam og Malaysia. I dag arbeider han som KI-forsker og -utvikler.
Teknisk diskusjon: i@tanshuai.com.