
Jeg blindtestet 10 AI-modeller på bildebiblioteket mitt med 142,000 bilder: GPT-6.1 Sol slo Claude Opus
Sammendrag
Jeg bruker Claude Opus 5.5 hver dag til koding og arbeidsflyter, og til det arbeidet synes jeg den er raskere og bedre enn GPT-6. Jeg antok at den også ville være best til å beskrive bilder, så jeg testet det. Jeg kjørte ti konfigurasjoner: Claude Haiku, Sonnet og Opus 5.5, pluss OpenAIs GPT-6.1 Sol, GPT-6 Astra og GPT-6 Luna på flere innsatsnivåer. Hver av dem ga tittel, bildetekst, nøkkelord og album til 50 ekte bilder fra biblioteket mitt på 142,521 bilder, og flagget bildene den mente jeg burde slette. To blinde sensorer fra ulike leverandører, Claude Fable 5.1 og GPT-6 Astra, vurderte alle 500 svar på fakta, oppdiktede detaljer, slettevurdering, albumtilpasning og nytteverdi. GPT-6.1 Sol fikk høyest med 9.72 av 10. Opus fikk 8.57, og Sonnet og Haiku havnet på 7.7 til 7.8. Ultra-innsats var ikke bedre enn max. Til offisielle Batch API-priser ville det koste omtrent $240 å beskrive hele biblioteket med Sol på medium innsats (9.56), $661 med Opus, og $11 til $20 med Luna, som likevel slo Haiku.
Hvorfor jeg testet dette
Mesteparten av dagen min går til koding, agentarbeidsflyter og automatisering, og Claude Opus 5.5 er modellen jeg tyr til. Til den typen arbeid har den føltes raskere og bedre for meg enn GPT-6. Så da jeg bestemte meg for å la AI beskrive og tagge bildebiblioteket mitt, valgte jeg Opus uten å nøle.
Biblioteket er 25 år av livet mitt: 142,521 bilder, fra tidlige digitalkamerabilder til forrige ukes mobilbilder, pluss mer enn 16,000 skjermbilder. Nesten ingen av dem har en bildetekst. Jeg vil at hvert bilde skal ha en tittel, en bildetekst, søkbare nøkkelord, et fornuftig album og et ærlig flagg når det er en duplikat eller søppel. Før jeg betaler for å behandle 142,000 bilder, ville jeg vite hvilken modell som gjør dette best og hva forskjellen koster.
Jeg forventet at Opus skulle vinne. På disse 50 bildene fikk GPT-6.1 Sol mer enn ett poeng høyere.
Resultater i korte trekk
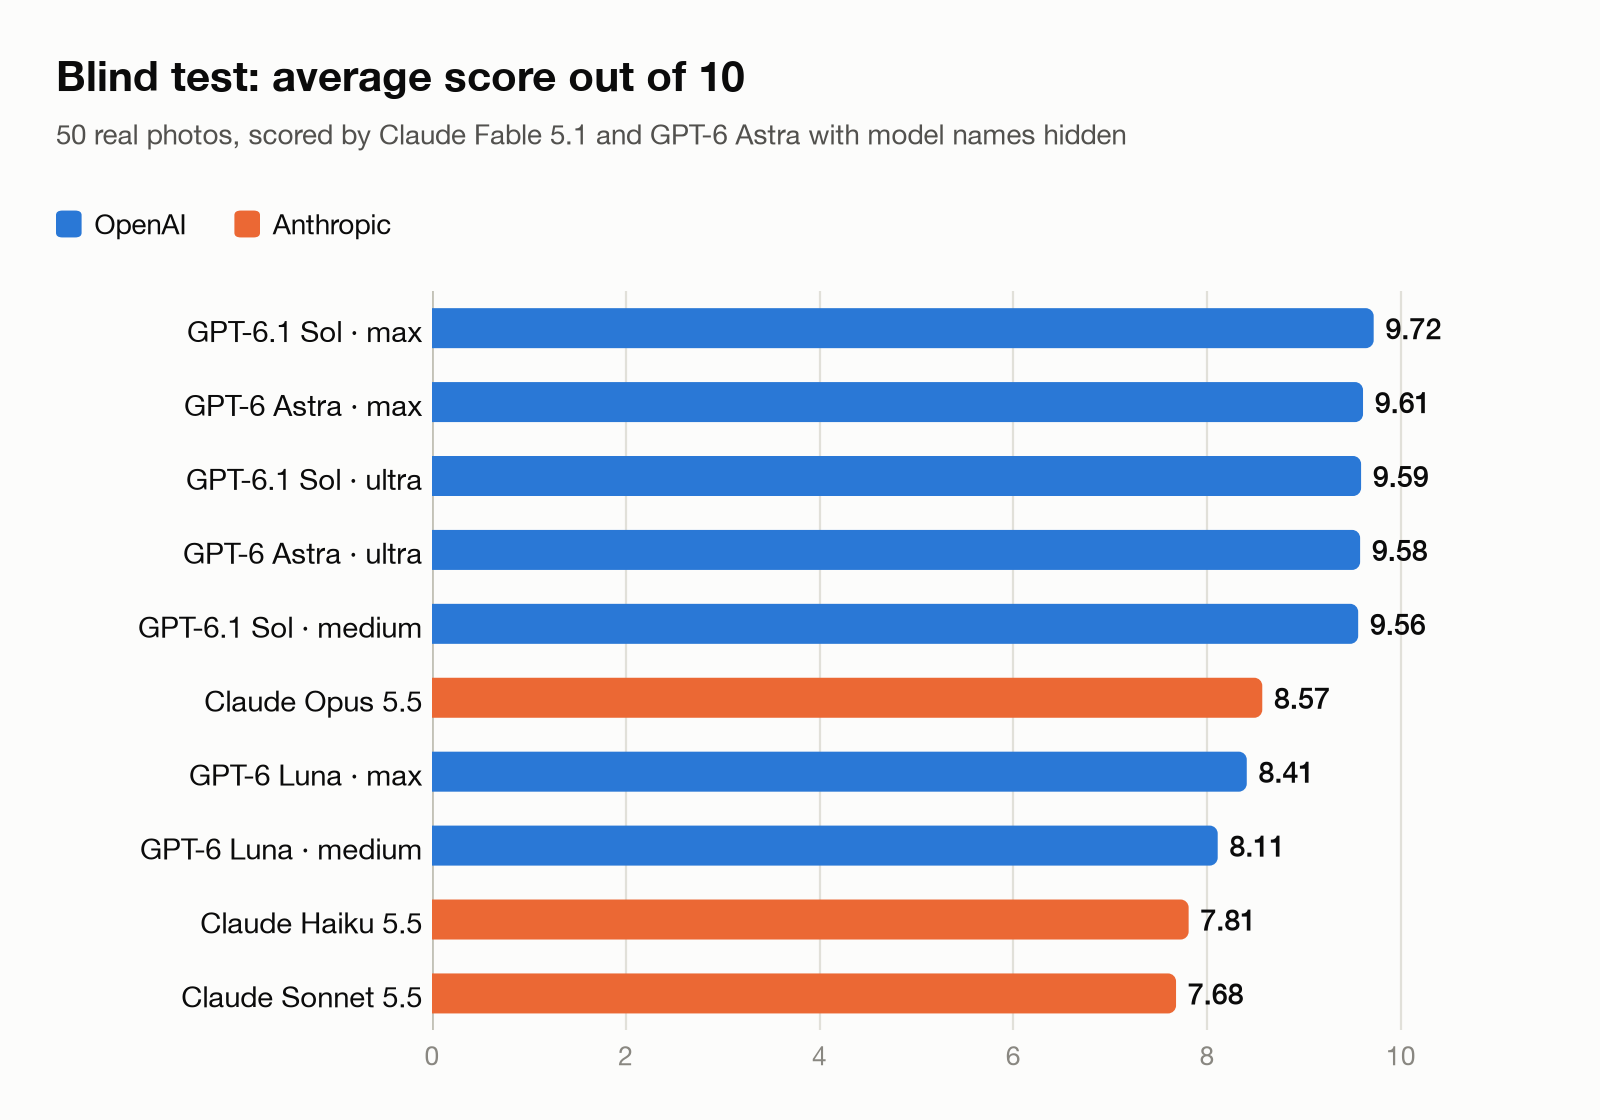 Figur 1. Gjennomsnittsscore fra to blinde sensorer, av 10.
| Rang | Modell og innsats | Score (av 10) | Hele biblioteket, Batch API | Hele biblioteket, standard API |
|---|---|---|---|---|
| 1 | GPT-6.1 Sol, max | 9.72 | $563 | $1,126 |
| 2 | GPT-6 Astra, max | 9.61 | $2,987 | $5,973 |
| 3 | GPT-6.1 Sol, ultra | 9.59 | $468 | $937 |
| 4 | GPT-6 Astra, ultra | 9.58 | $2,156 | $4,313 |
| 5 | GPT-6.1 Sol, medium | 9.56 | $240 | $479 |
| 6 | Claude Opus 5.5 | 8.57 | $661 | $1,323 |
| 7 | GPT-6 Luna, max | 8.41 | $20 | $40 |
| 8 | GPT-6 Luna, medium | 8.11 | $11 | $22 |
| 9 | Claude Haiku 5.5 | 7.81 | $18 | $36 |
| 10 | Claude Sonnet 5.5 | 7.68 | $334 | $668 |
Kostnaden gjelder alle 142,521 bilder til hver leverandørs offisielle API-pris.
Hva jeg ville brukt, basert på denne testen:
- Hvis jeg bare brydde meg om scoren, GPT-6.1 Sol på max-innsats.
- For mitt eget bibliotek, GPT-6.1 Sol på medium. Den fikk 98% av toppscoren for $240, omtrent en tredel av hva Opus ville kostet.
- På et stramt budsjett, GPT-6 Luna på max. For $20 slo den Haiku, som koster det samme per token, og Sonnet, som ville kostet omtrent 17 ganger så mye for dette biblioteket.
- Ikke Claude Sonnet 5.5. Den er mellompriset og hadde den laveste scoren.
Modellene
| Leverandør | Modell | Testet innsats | Posisjonering |
|---|---|---|---|
| Anthropic | Claude Opus 5.5 | standard (medium) | Flaggskip for daglig bruk |
| Anthropic | Claude Sonnet 5.5 | standard | Mellomsjikt |
| Anthropic | Claude Haiku 5.5 | standard | Rask, lav kostnad |
| OpenAI | GPT-6 Astra | max, ultra | Frontmodell |
| OpenAI | GPT-6.1 Sol | medium, max, ultra | Arbeidshest |
| OpenAI | GPT-6 Luna | medium, max | Rask, lav kostnad |
Prisene ligger på linje mellom de to leverandørene. GPT-6.1 Sol koster det samme per token som Claude Sonnet 5.5, GPT-6 Astra det samme som Claude Fable 5.1, og GPT-6 Luna det samme som Claude Haiku 5.5. Claude Opus 5.5 ligger mellom Sol og Astra. Så når to modeller nedenfor ender med ulik kostnad, er det mest fordi én av dem brukte flere tokens på samme jobb.
Claude-modellene kjørte én gang hver med standardinnstillingene sine, noe som for Opus betyr medium innsats. GPT-modellene testet jeg på flere innsatsnivåer. Den nærmeste like-for-like-sammenligningen er GPT-6.1 Sol på medium mot Claude Opus 5.5 på medium: 9.56 mot 8.57.
Testen
Jeg brukte de 50 nyeste bildene i biblioteket mitt på det tidspunktet, uten videoer. Det er en vanlig uke fra kamerarullen min: familiestunder hjemme og på handletur, byutsikter fra en høy etasje, et minnekort på skrivebordet mitt, produktbilder av elektroniske komponenter, skjermbilder av ordresporing, et innlegg i sosiale medier, et QR-skilt for parkeringsrabatt og en etikett på en elbillader.
Hver modell hadde fem oppgaver for hvert bilde. Den skrev en kort tittel og en bildetekst på én til tre setninger på kinesisk, ga 5 til 12 nøkkelord på kinesisk og engelsk, og valgte det beste albumet blant de eksisterende albumene mine, eller ingen. Deretter ga den en kvalitetsscore og sa om bildet skulle beholdes eller slettes, på jakt etter duplikater, mislykkede bilder, utgåtte skjermbilder og bilder uten varig verdi. Hver modell fikk de samme instruksjonene og den samme konteksten for hvert bilde, ti bilder om gangen.
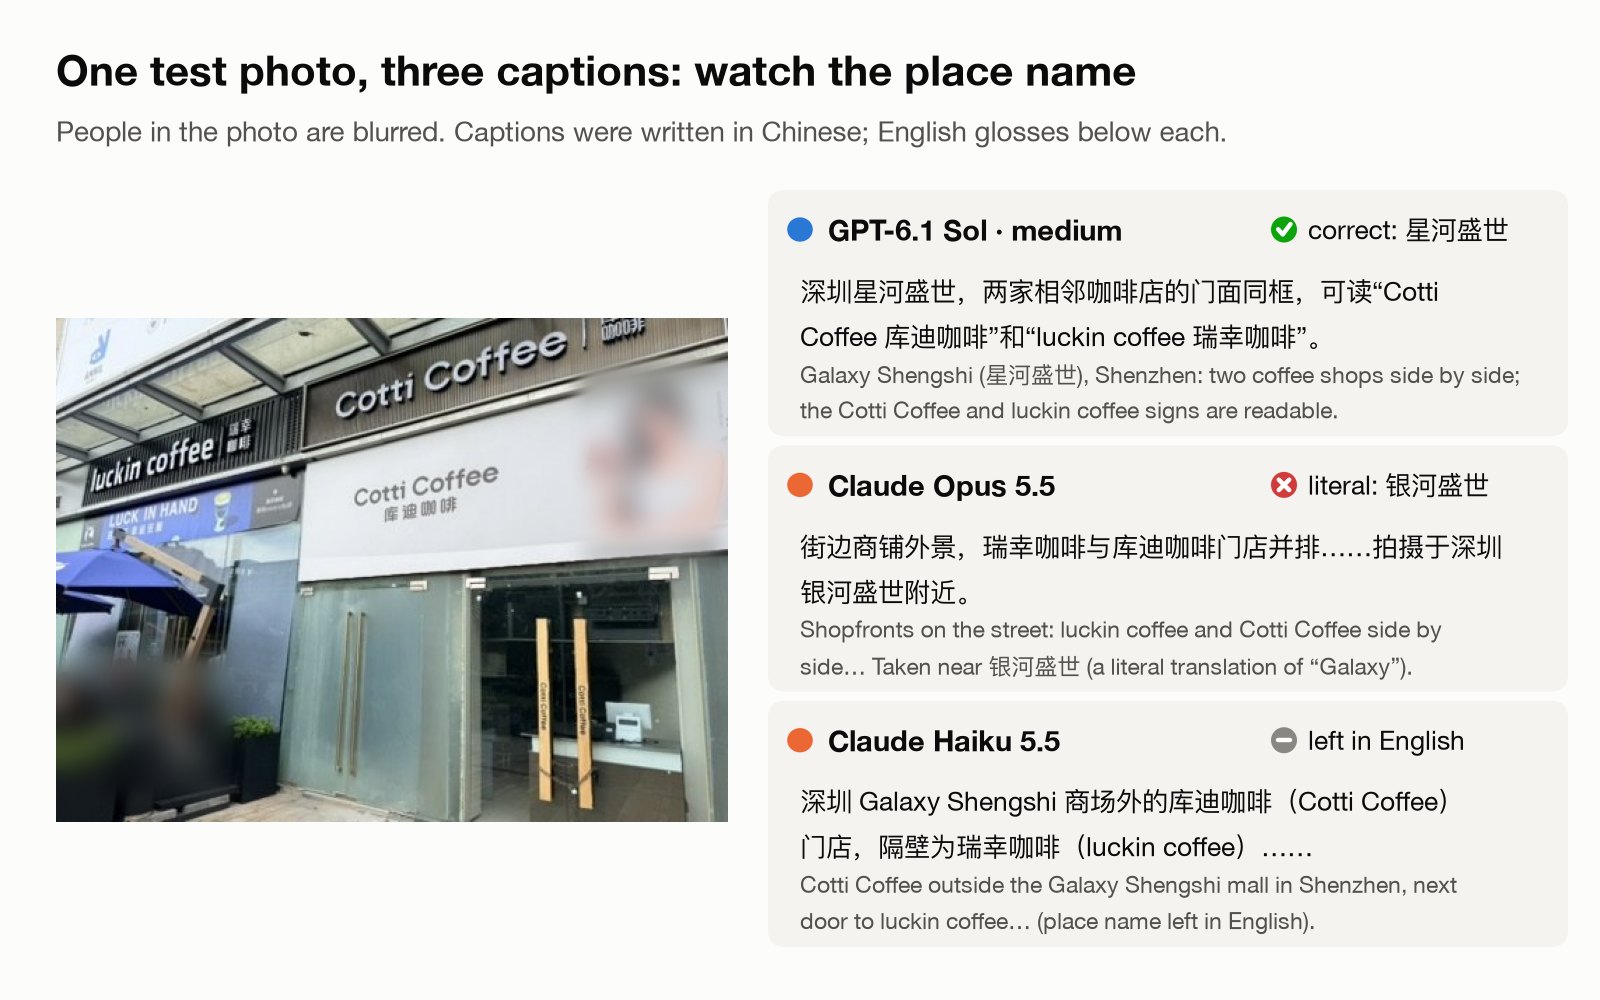 Figur 2. Ett av de 50 testbildene, med tre av bildetekstene. Legg merke til hvordan hver modell håndterer stedsnavnet; jeg kommer tilbake til det nedenfor. Personer på bildet er uskarpet.
Hvordan jeg vurderte
Jeg vurderte ikke svarene selv. Jeg hadde allerede valgt en vinner før testen, og jeg bruker Claude hver dag, så jeg var ikke nøytral.
I stedet stokket jeg hvert bildes ti svar og merket dem A til J, med ny tilfeldig rekkefølge for hvert bilde. To sensorer vurderte deretter alle 500 svar uavhengig mens de så på bildene. Den ene var Claude Fable 5.1, Anthropics mest kapable modell. Den andre var GPT-6 Astra på xhigh-innsats, OpenAIs frontmodell.
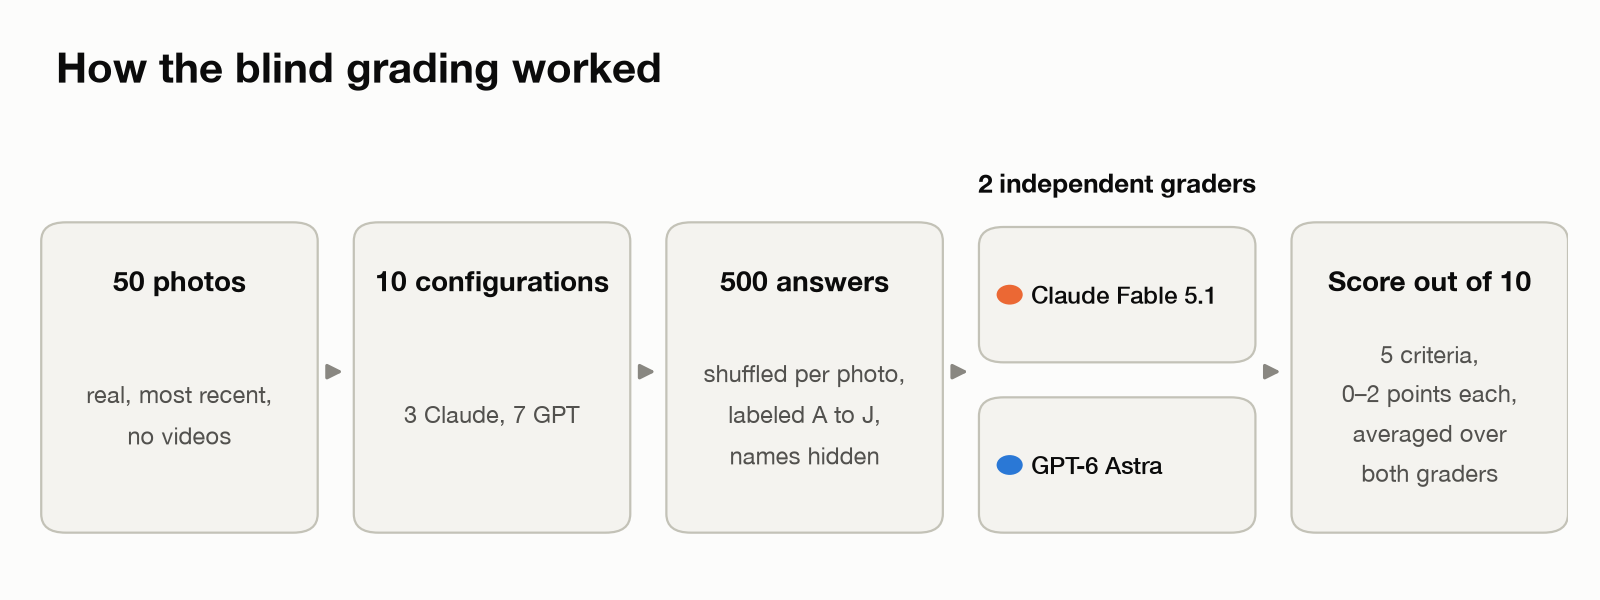 Figur 3. Hvordan blindvurderingen fungerte.
Hvert svar ble vurdert på fem kriterier, 0 til 2 poeng hver, totalt 10:
| Kriterium | Hva sensoren sjekket |
|---|---|
| Fakta | Er motiv, sted og all lesbar tekst riktig, inkludert lokale stedsnavn? |
| Ingen oppdiktede detaljer | Unngår svaret å påstå noe bildet ikke viser? |
| Slettevurdering | Er beholde eller slette rimelig? Å slette et godt bilde gir 0. |
| Albumtilpasning | Er albumet riktig? Et feil gammelt album gir 0; intet album er en akseptabel 1. |
| Nytteverdi | Ville tittel, bildetekst og nøkkelord hjelpe meg å finne og huske dette bildet senere? |
Jeg valgte én sensor fra hver leverandør for å se om noen av dem ville favorisere sine egne modeller. De var stort sett enige. Korrelasjonen over de 500 parede scorene var 0.71, og begge satte de samme fem GPT-konfigurasjonene øverst. Claude-sensoren rangerte også GPT-6.1 Sol og GPT-6 Astra over Claude Opus. GPT-sensoren var generelt strengere, og strengest mot Claude-modellene.
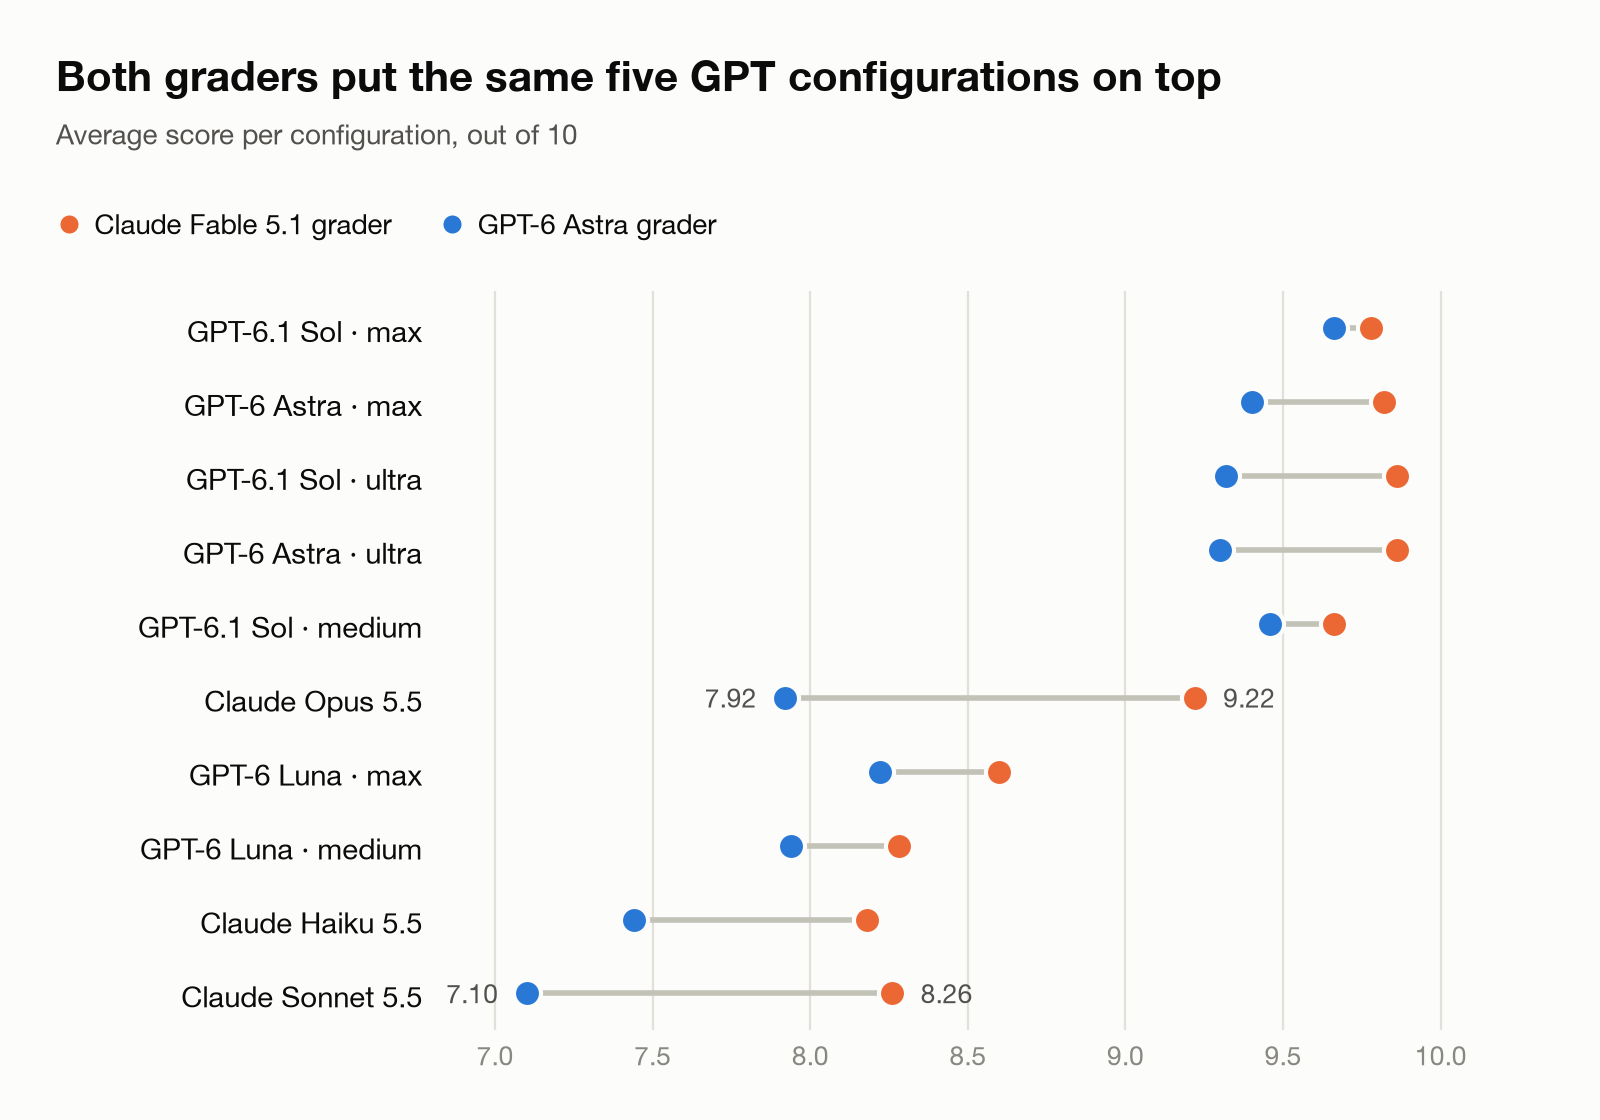 Figur 4. Hver sensors gjennomsnittsscore per konfigurasjon.
Resultater
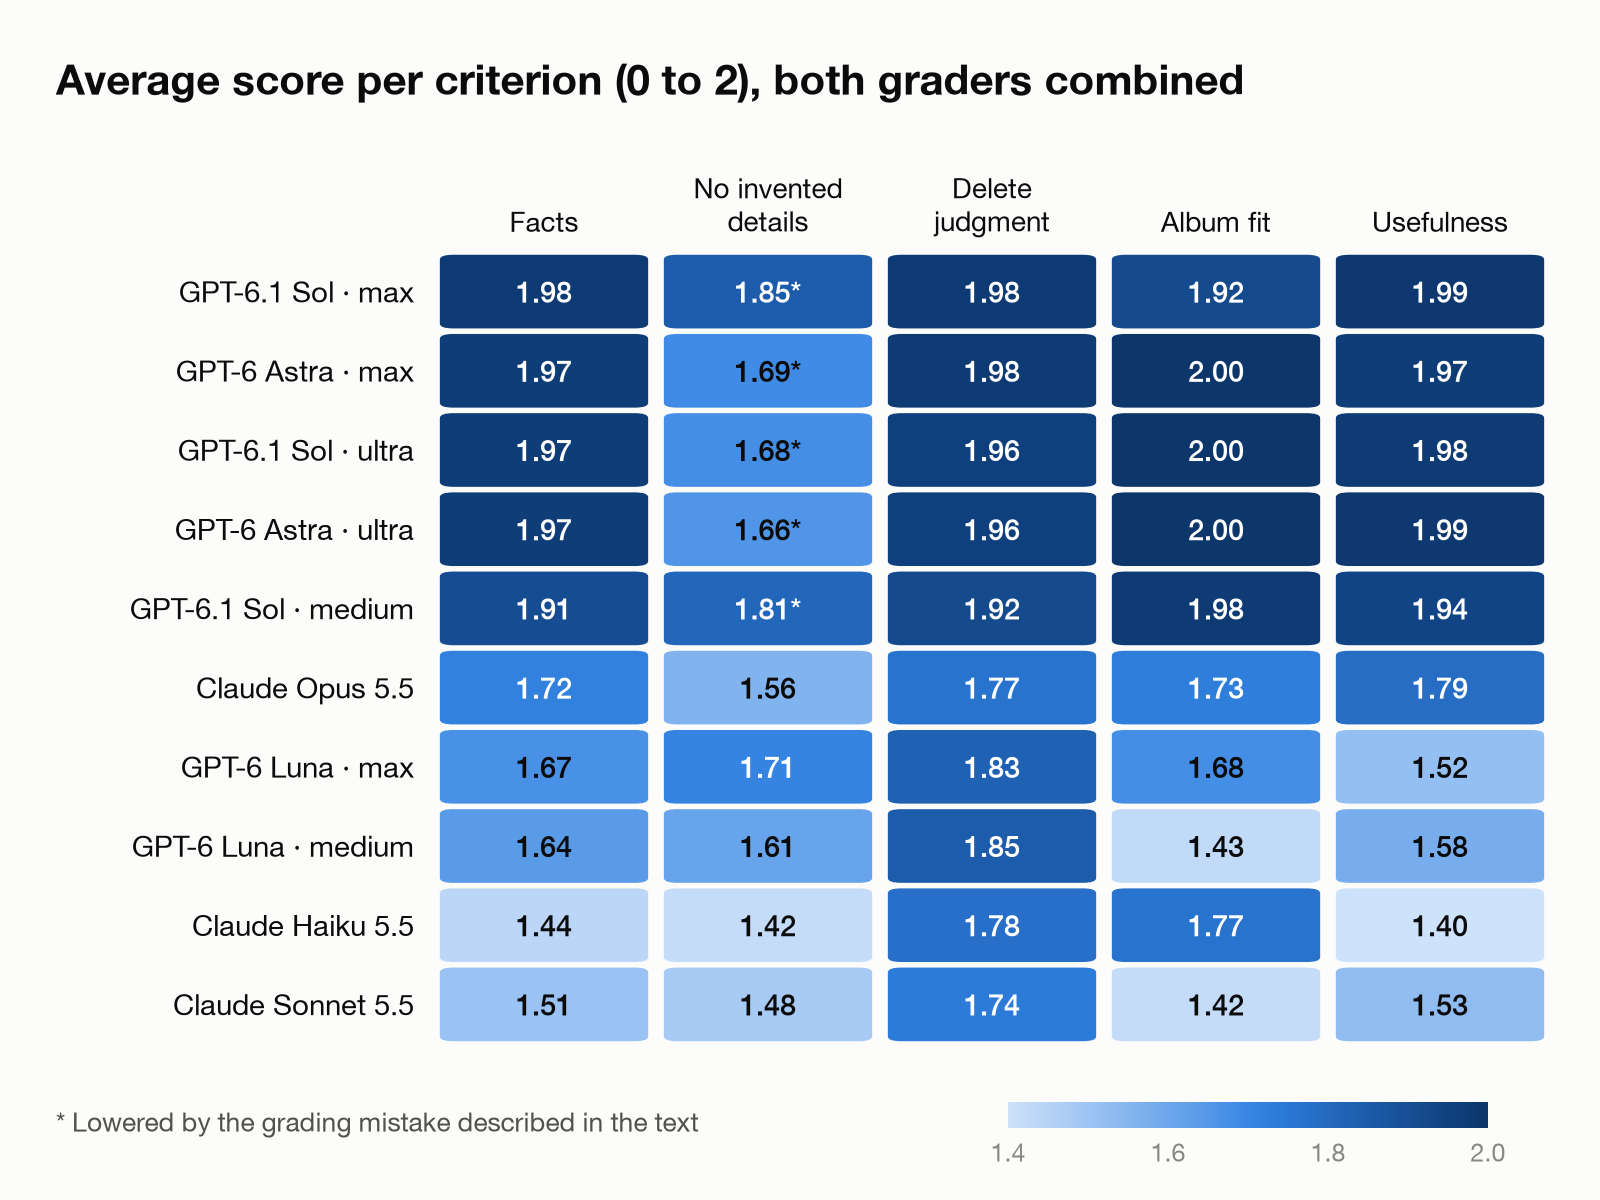 Figur 5. Gjennomsnittsscore per kriterium, begge sensorene slått sammen. En stjerne markerer scorer som er senket av vurderingsfeilen jeg beskriver nedenfor.
GPT-6.1 Sol og GPT-6 Astra
Sol og Astra leste teksten nøyaktig og begrenset stort sett bildetekstene sine til det bildene viste. De var også best på lokale stedsnavn, noe som betyr noe for bilder tatt i Kina.
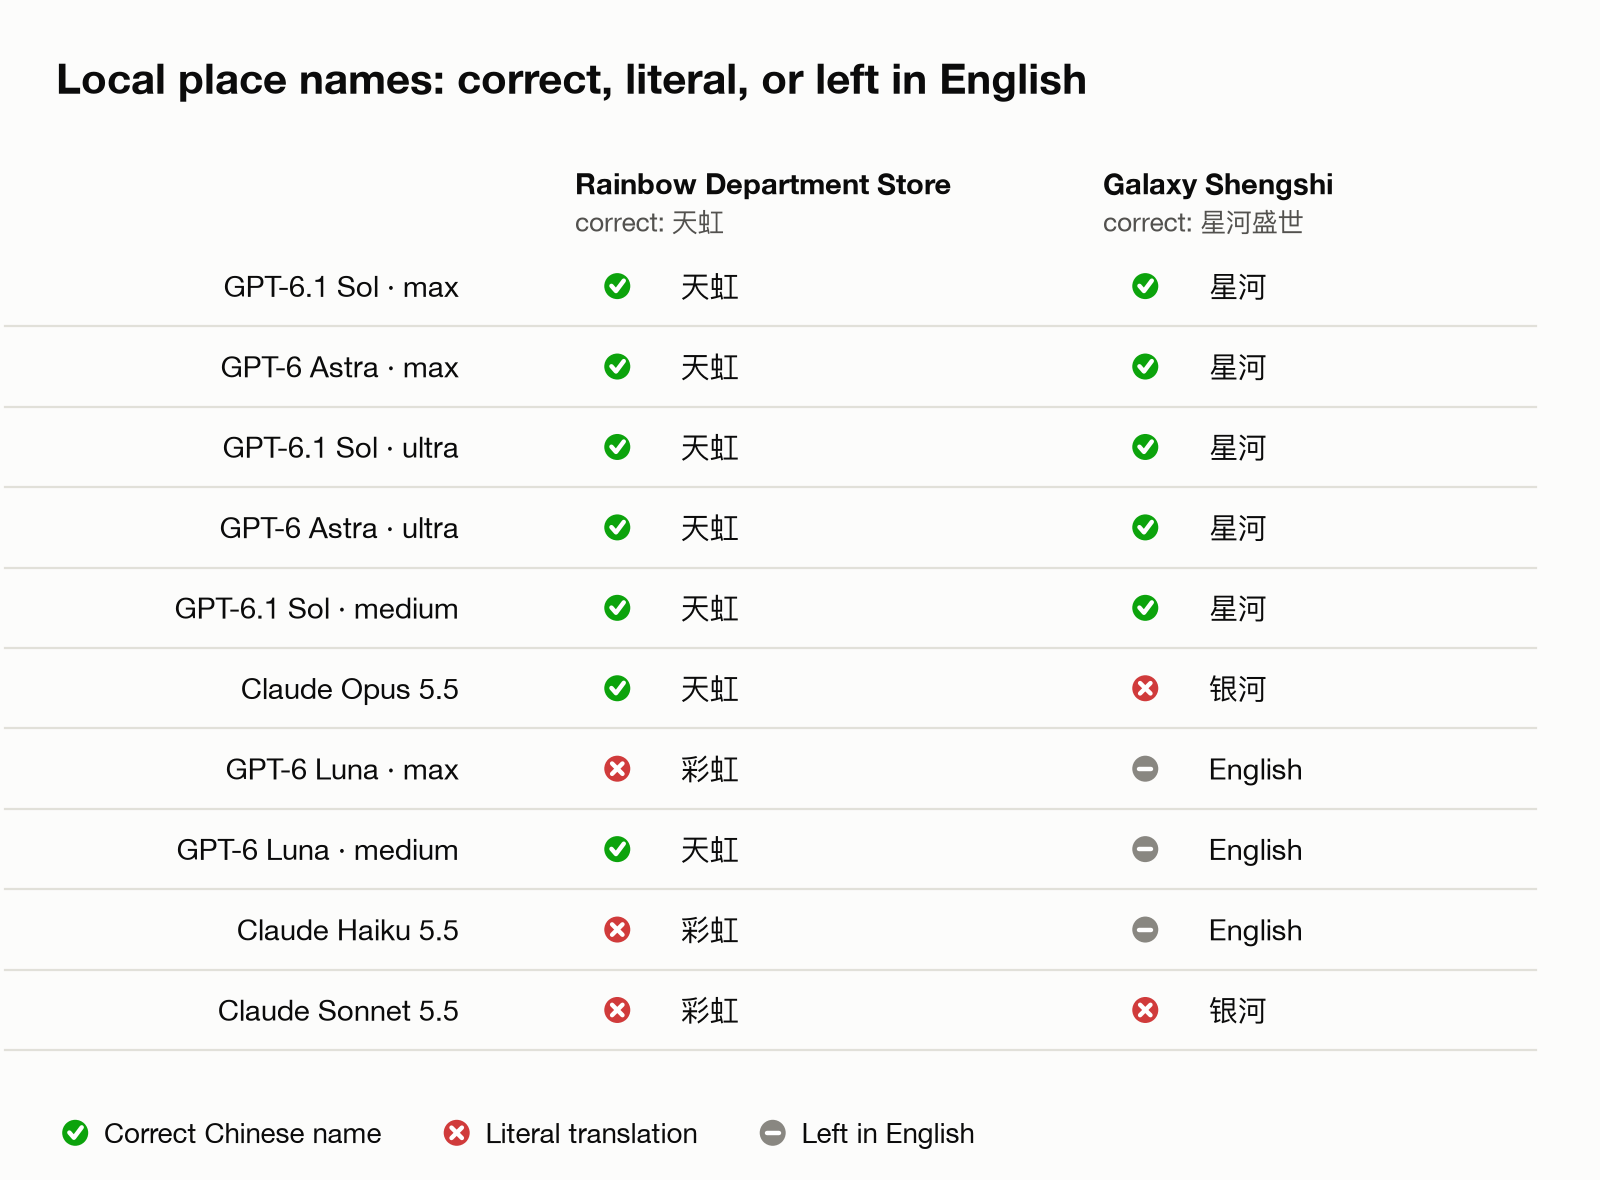 Figur 6. To tester med lokale navn. En hake betyr riktig kinesisk navn, et kryss en bokstavelig oversettelse, og EN betyr at navnet ble stående på engelsk.
Flere bilder ble tagget med stedet «Rainbow Department Store». Det er det engelske navnet på varehuskjeden i Shenzhen 天虹. En ord-for-ord-oversettelse gir 彩虹百货, som er feil. Hver Sol- og Astra-konfigurasjon fikk dette riktig, og det samme gjorde Opus og Luna på medium. Haiku, Sonnet og Luna på max brukte den bokstavelige oversettelsen. Kaffebarbildet i figur 2 ble tagget som «Galaxy Shengshi», hvis kinesiske navn er 星河盛世. Hver Sol- og Astra-konfigurasjon skrev 星河. Opus og Sonnet oversatte det bokstavelig som 银河, og Haiku og begge Luna-konfigurasjonene lot det stå på engelsk.
Sol og Astra var også forsiktige med sletting. De foreslo å slette 4 til 6 av de 50 bildene. Settet inneholdt åtte produktbilder av elektroniske komponenter, og GPT-modellene beholdt nesten alle; én Sol-konfigurasjon flagget ett enkelt skjermbilde som nær-duplikat. Claude-modellene flagget to til fire hver. Begge sensorene holdt med om å beholde dem, siden sidene inneholdt pinouts, mål og kortbilder jeg ville slå opp senere.
Claude Opus 5.5
Opus skrev noen ganger ting inn i en bildetekst som bildet alene ikke kan vise. Den beskrev relasjoner som bildet alene ikke kan bevise, som søsken eller forelder og barn. Den tok også feil på noen positurer. På ett bilde sto et barn bak en voksen, og Opus skrev at barnet satt på den voksnes rygg. Begge sensorene trakk poeng for dette.
Dette overrasket meg. Før blindtesten hadde jeg sett gjennom svarene og rost Opus for å ha gjettet riktig at to barn var søsken. Jeg kjenner familien min; det gjør ikke sensoren. Men med 142,000 bilder kan jeg ikke sjekke hver bildetekst selv, og en bildetekst som påstår noe bildet ikke viser, er et problem.
Opus foreslo også flest slettinger, 13 av de 50 bildene. Tre av dem var produktbilder som den kalte utgåtte, selv om de inneholdt referanseinformasjon jeg ville beholde. Den var den eneste modellen som ville slette QR-skiltet for parkeringsrabatt som verdiløst. Den la også flere bilder av én enkelt person i et album for «familieportrett».
Claude Sonnet 5.5 og Haiku 5.5
Disse to gjorde flest faktafeil, inkludert den bokstavelige oversettelsen 彩虹. Sonnet gjorde de svakeste albumvalgene og arkiverte hverdagsbilder i et gammelt album fra en urelatert hendelse. Haiku diktet opp en detalj som førte til en dårlig slettevurdering. I en serie nesten identiske bilder beskrev den det beste bildet som noen som ser ned, som er det motsatte av hva bildet viser, og foreslo å slette det.
GPT-6 Luna
Luna koster det samme per token som Haiku, men fikk høyere score på begge innsatsnivåene: 8.41 og 8.11, mot Haikus 7.81. På max-innsats slo den også Sonnet, som ville kostet omtrent 17 ganger så mye å beskrive det samme biblioteket. Luna tapte flest poeng på nytteverdi og albumvalg. Bildetekstene dens var enklere og albumene mindre presise.
Innsatsnivåer
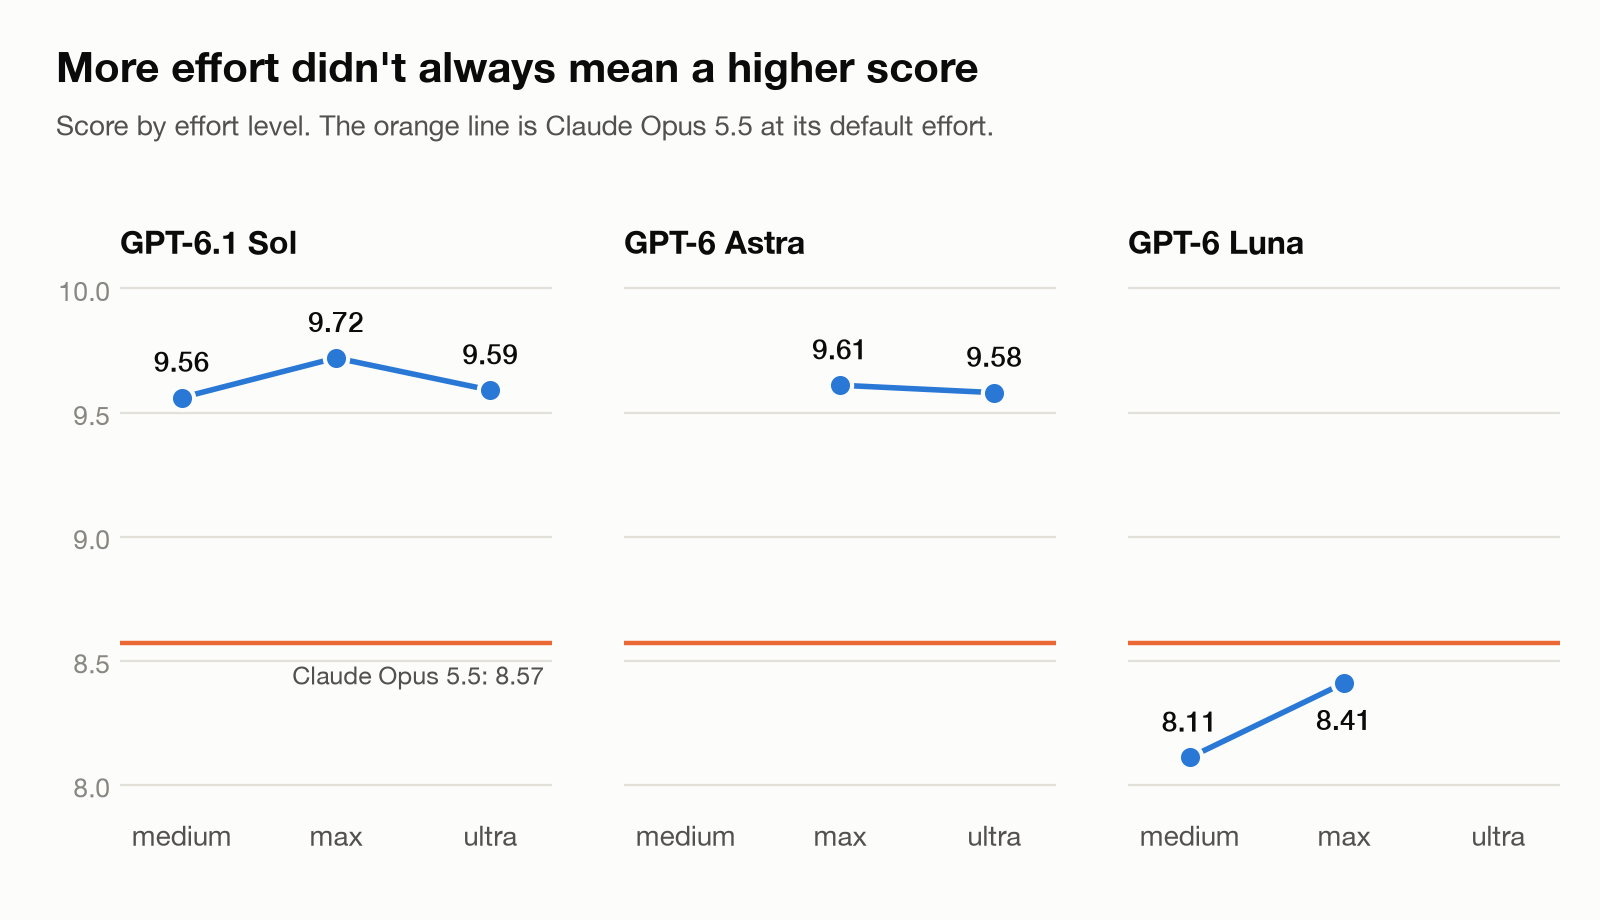 Figur 7. Score per innsatsnivå. Den oransje linjen er Claude Opus 5.5 på standardinnsatsen sin.
Ultra var ikke bedre enn max for noen av modellene. Sol fikk 9.59 på ultra og 9.72 på max; Astra fikk 9.58 og 9.61. I denne testen produserte ultra til og med færre utdatatokens enn max. For Sol kom medium nær med 9.56, for under halvparten av kostnaden til max. Høyere innsats betydde heller ikke alltid mer nøyaktige detaljer: Luna på medium fikk 天虹 riktig, og Luna på max gjorde det ikke.
En feil i vurderingen min
Etter vurderingen la jeg merke til at sensorene ikke hadde fått hvert bildes fangstdato og -tidspunkt, selv om beskrivelsesmodellene hadde fått det. Så GPT-6 Astra-sensoren behandlet bildetekster som nevnte nøyaktig dato eller tidspunkt som oppdiktede detaljer. De beste GPT-konfigurasjonene nevnte datoen oftest, så scorene deres på «ingen oppdiktede detaljer» kom lavere ut enn de burde.
Hvis jeg bare gir tilbake poengene som gikk tapt over datoer, stiger de fire beste GPT-konfigurasjonene til mellom 9.84 og 9.90, som i praksis er uavgjort, og Opus blir stående på 8.58. Jeg har beholdt de opprinnelige scorene i dette innlegget. Neste gang gir jeg sensorene alt modellene så.
Hastighet
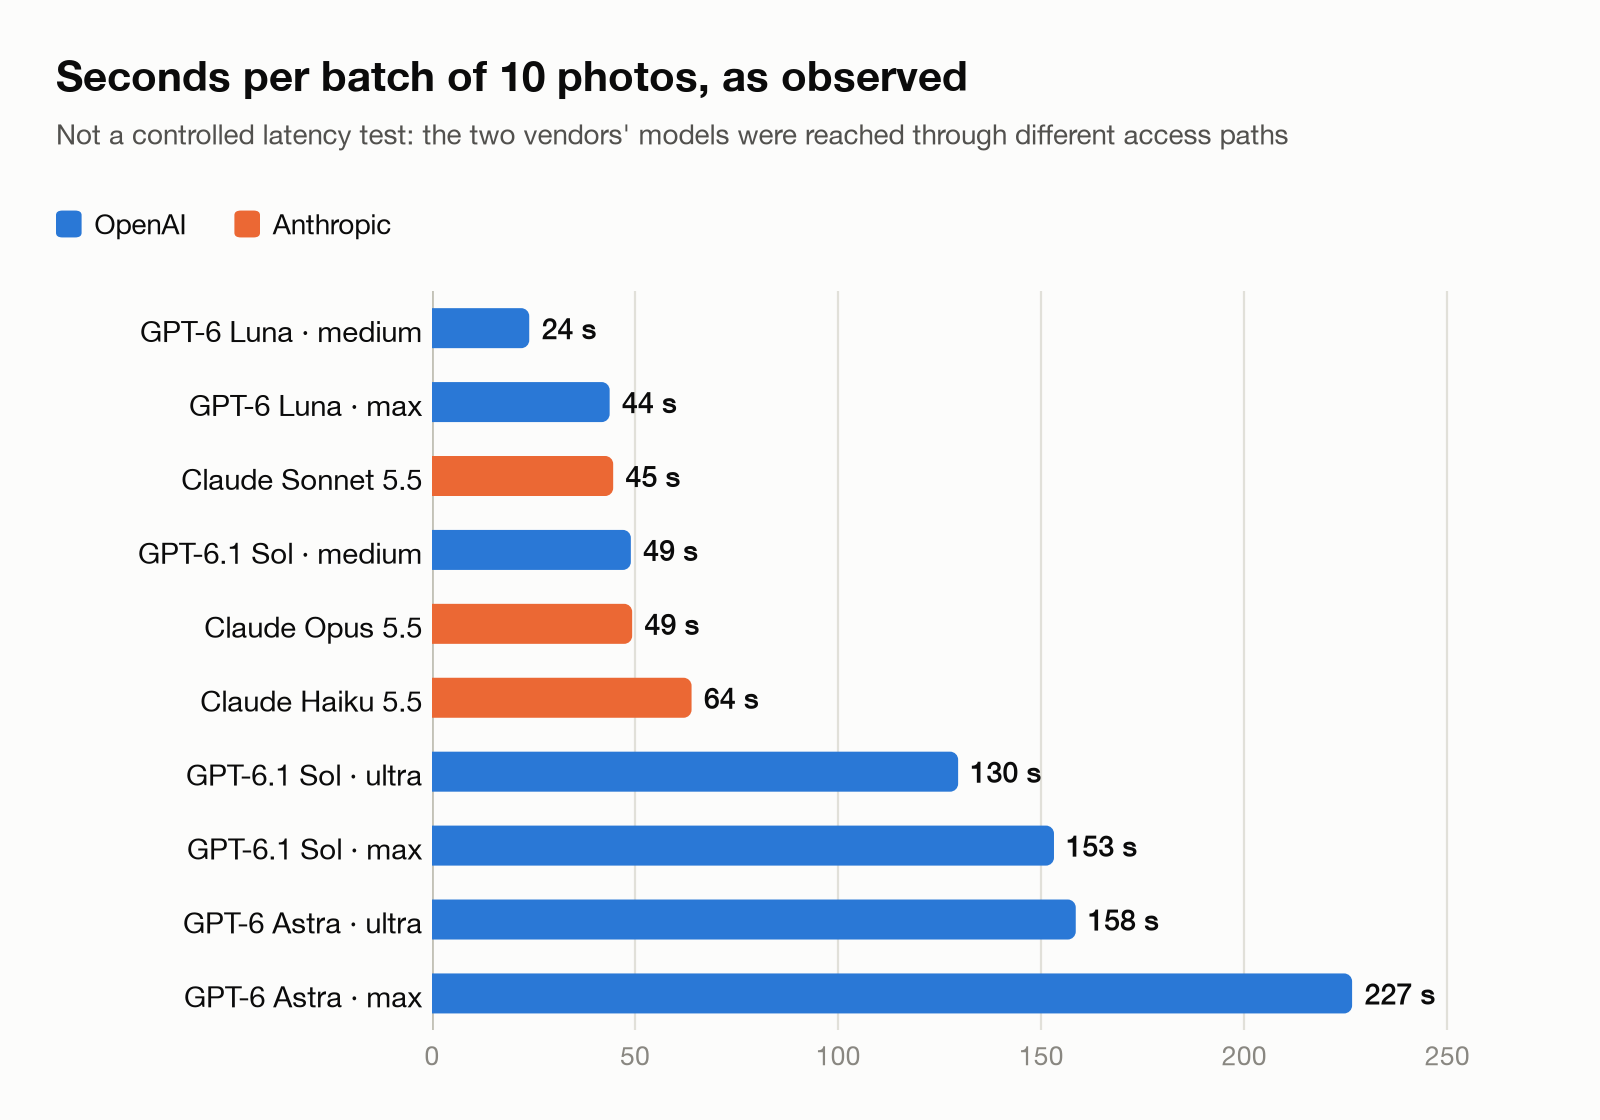 Figur 8. Sekunder per batch på 10 bilder, som observert. Dette er ikke en kontrollert latenstest, fordi de to leverandørenes modeller ble nådd gjennom ulike tilgangsveier.
Dette stemmer med hvordan Opus føles i det daglige arbeidet mitt: den er rask, omtrent tre ganger raskere enn Sol på max. Sol på medium var imidlertid like rask som Opus, og fikk omtrent ett poeng høyere.
Hva det koster
Jeg priset hver konfigurasjon til leverandørenes offisielle API-priser. Å behandle et abonnements inkluderte bruk som gratis ville få noen modeller til å framstå bedre enn de er.
Offisielle priser per million tokens, standardnivå:
| Modell | Input | Output |
|---|---|---|
| Claude Opus 5.5 | $4.00 | $20.00 |
| Claude Sonnet 5.5 | $2.00 | $10.00 |
| Claude Haiku 5.5 | $0.10 | $0.50 |
| GPT-6 Astra | $10.00 | $50.00 |
| GPT-6.1 Sol | $2.00 | $10.00 |
| GPT-6 Luna | $0.10 | $0.50 |
Begge leverandørenes Batch API-er koster 50% mindre, noe som passer en jobb som denne som ikke trenger umiddelbare svar. Jeg tok prisene fra Anthropics prisside (claude.com/pricing) og OpenAIs API-prisside (developers.openai.com/api/docs/pricing) 20. oktober 2026.
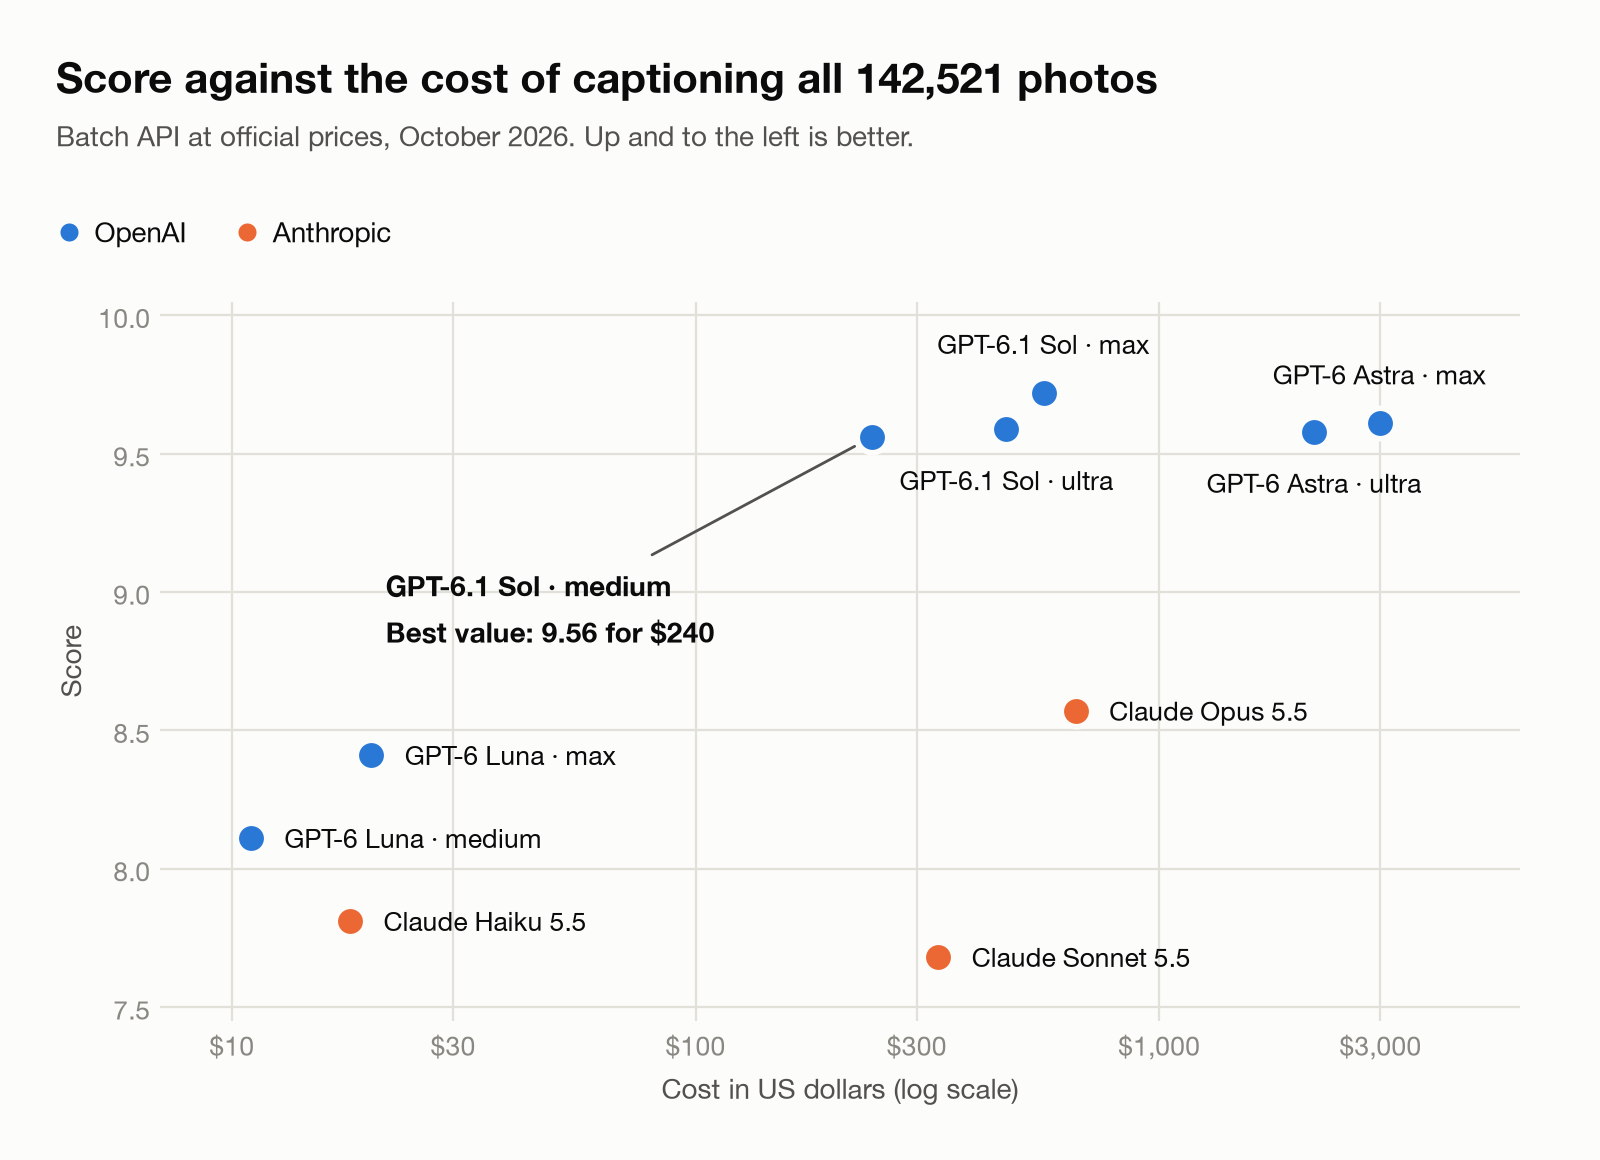 Figur 9. Score mot kostnaden for å beskrive hele biblioteket til Batch-priser. Kostnadsaksen er logaritmisk.
| Modell og innsats | Utdatatokens per bilde | Standard | Batch | Score |
|---|---|---|---|---|
| GPT-6.1 Sol, medium | 193 | $479 | $240 | 9.56 |
| GPT-6.1 Sol, ultra | 514 | $937 | $468 | 9.59 |
| GPT-6.1 Sol, max | 647 | $1,126 | $563 | 9.72 |
| Claude Opus 5.5 | ~292 | $1,323 | $661 | 8.57 |
| Claude Sonnet 5.5 | ~297 | $668 | $334 | 7.68 |
| GPT-6 Astra, ultra | 462 | $4,313 | $2,156 | 9.58 |
| GPT-6 Astra, max | 695 | $5,973 | $2,987 | 9.61 |
| GPT-6 Luna, medium | 163 | $22 | $11 | 8.11 |
| Claude Haiku 5.5 | ~330 | $36 | $18 | 7.81 |
| GPT-6 Luna, max | 419 | $40 | $20 | 8.41 |
Sol på medium fikk 98% av toppscoren for 36% av hva Opus ville kostet og 43% av Sol på max. Astra matchet Sols kvalitet, men koster omtrent fem ganger så mye, fordi prisen per token er fem ganger høyere. Opus kostet mer enn Sol på max og fikk lavere score. Den kjørte allerede på medium innsats, men prisen per token er det dobbelte av Sols. Luna ville beskrevet hele biblioteket for $11 til $20 og likevel slått Haiku og Sonnet.
Metodenotat: GPT-tokenantall ble målt fra kjøringene, og Claude-tokenantall ble estimert fra kjøreloggene. Noen Claude-resonnementstokens var ikke synlige, så Claude-kostnadene kan være litt underestimert. Ingen rabatter utover Batch, som prompt-cache, ble brukt på noen modell.
Hva jeg lærte
Jeg valgte Opus før jeg hadde noen blinde scorer, mest fordi den allerede var standardvalget mitt for koding. Jeg foretrekker fortsatt Claude Opus 5.5 til koding og arbeidsflyter, der den er raskere og sterkere etter min erfaring. Å beskrive ekte bilder krever en annen ferdighet: å lese hva som faktisk er i bildet uten å fylle inn positurer eller relasjoner. GPT-6.1 Sol gjorde det bedre. Hvis jeg hadde gått på vane og hoppet over blindtesten, ville jeg ha betalt mer for dårligere bildetekster.
Neste gang starter jeg blindt og gir sensorer fra ulike leverandører alle inndataene beskrivelsesmodellene fikk. Jeg fortsetter også å sammenligne til offisielle API-priser, og jeg antar ikke at mer innsats er bedre: ultra slo ikke max her.
Selv de beste modellene flagget nyttige bilder for sletting, så jeg sjekker hvert sletteflagg selv før jeg fjerner noe.
Begrensninger
Dette var en liten test: 50 ferske bilder fra én by. Jeg testet ikke eldre bilder, skannede dokumenter, andre språk eller videoer. Claude-modellene kjørte bare med standardinnstillingene sine; en Opus med høyere innsats kunne fått høyere score, til en høyere kostnad. Sensorene er AI-modeller, ikke mennesker. De var godt enige, men ikke perfekt, og en menneskelig stikkprøve ville gjort resultatet sterkere. Modeller og priser endrer seg raskt, og hvert tall her er per oktober 2026.
Mitt valg
For biblioteket mitt: GPT-6.1 Sol på medium innsats. For koding og arbeidsflyter holder jeg meg til Claude Opus 5.5.