
Ich habe 10 KI-Modelle blind an meiner 142.000-Fotos-Bibliothek getestet: GPT-6.1 Sol schlug Claude Opus
Zusammenfassung
Ich nutze Claude Opus 5.5 jeden Tag zum Programmieren und für Workflows, und für diese Arbeit empfinde ich es als schneller und besser als GPT-6. Ich nahm an, es wäre auch beim Beschreiben von Fotos das beste, also habe ich es getestet. Ich ließ zehn Konfigurationen antreten: Claude Haiku, Sonnet und Opus 5.5 sowie OpenAIs GPT-6.1 Sol, GPT-6 Astra und GPT-6 Luna auf mehreren Anstrengungsstufen. Jede davon betitelte, beschriftete, verschlagwortete und sortierte 50 echte Fotos aus meiner 142.521 Fotos umfassenden Bibliothek und markierte die Fotos, die ich ihrer Meinung nach löschen sollte. Zwei blinde Bewerter verschiedener Anbieter, Claude Fable 5.1 und GPT-6 Astra, bewerteten alle 500 Antworten nach Fakten, erfundenen Details, Löschentscheidung, Album-Passung und Nutzen. GPT-6.1 Sol erzielte mit 9,72 von 10 Punkten den höchsten Wert. Opus erreichte 8,57, und Sonnet und Haiku lagen bei 7,7 bis 7,8. Ultra-Anstrengung war nicht besser als max. Zu offiziellen Batch-API-Preisen würde die Beschriftung der gesamten Bibliothek mit Sol auf mittlerer Stufe etwa 240 US-Dollar kosten (9,56), mit Opus 661 US-Dollar und mit Luna 11 bis 20 US-Dollar, das dabei immer noch besser abschnitt als Haiku.
Warum ich das getestet habe
Der Großteil meines Tages geht ins Programmieren, in Agent-Workflows und Automatisierung, und Claude Opus 5.5 ist das Modell, zu dem ich greife. Für diese Art von Arbeit hat es sich für mich schneller und besser angefühlt als GPT-6. Als ich also beschloss, meine Fotobibliothek von KI beschriften und verschlagworten zu lassen, wählte ich Opus ohne zu zögern.
Die Bibliothek sind 25 Jahre meines Lebens: 142.521 Fotos, von frühen Digitalkamera-Aufnahmen bis zu den Handybildern der letzten Woche, dazu mehr als 16.000 Screenshots. Fast keines davon hat eine Beschriftung. Ich möchte, dass jedes Foto einen Titel, eine Beschriftung, durchsuchbare Schlüsselwörter, ein sinnvolles Album und eine ehrliche Markierung bekommt, wenn es sich um ein Duplikat oder Ausschuss handelt. Bevor ich dafür bezahle, 142.000 Fotos zu verarbeiten, wollte ich wissen, welches Modell das am besten kann und was der Unterschied kostet.
Ich hatte erwartet, dass Opus gewinnt. Bei diesen 50 Fotos erzielte GPT-6.1 Sol mehr als einen Punkt mehr.
Ergebnisse auf einen Blick
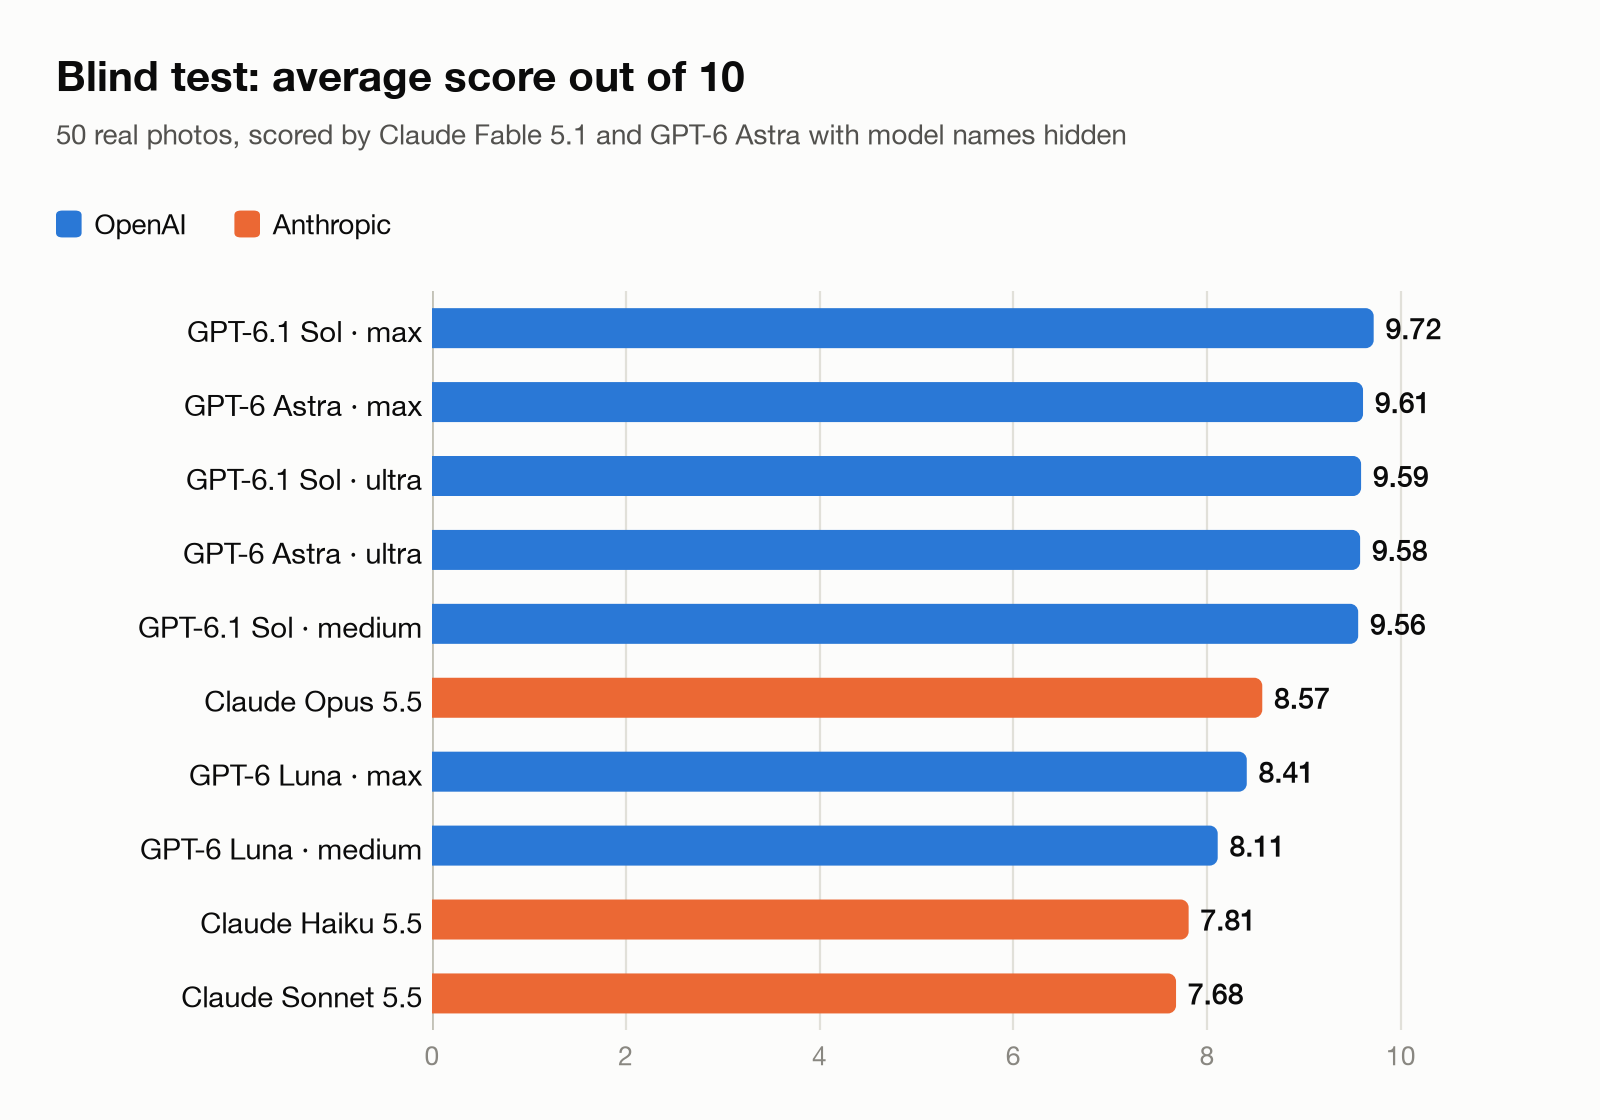 Abbildung 1. Durchschnittswert zweier blinder Bewerter, von 10 Punkten.
| Rang | Modell und Anstrengung | Punktzahl (von 10) | Ganze Bibliothek, Batch-API | Ganze Bibliothek, Standard-API |
|---|---|---|---|---|
| 1 | GPT-6.1 Sol, max | 9.72 | $563 | $1,126 |
| 2 | GPT-6 Astra, max | 9.61 | $2,987 | $5,973 |
| 3 | GPT-6.1 Sol, ultra | 9.59 | $468 | $937 |
| 4 | GPT-6 Astra, ultra | 9.58 | $2,156 | $4,313 |
| 5 | GPT-6.1 Sol, medium | 9.56 | $240 | $479 |
| 6 | Claude Opus 5.5 | 8.57 | $661 | $1,323 |
| 7 | GPT-6 Luna, max | 8.41 | $20 | $40 |
| 8 | GPT-6 Luna, medium | 8.11 | $11 | $22 |
| 9 | Claude Haiku 5.5 | 7.81 | $18 | $36 |
| 10 | Claude Sonnet 5.5 | 7.68 | $334 | $668 |
Die Kosten gelten für alle 142.521 Fotos zu den offiziellen API-Preisen des jeweiligen Anbieters.
Was ich auf Basis dieses Tests verwenden würde:
- Wenn es mir nur um die Punktzahl ginge: GPT-6.1 Sol auf max.
- Für meine eigene Bibliothek: GPT-6.1 Sol auf mittlerer Stufe. Es erreichte 98 % der Höchstpunktzahl für 240 US-Dollar, etwa ein Drittel dessen, was Opus kosten würde.
- Bei knappem Budget: GPT-6 Luna auf max. Für 20 US-Dollar schlug es Haiku, das pro Token genauso viel kostet, und Sonnet, das für diese Bibliothek etwa das 17-Fache kosten würde.
- Nicht Claude Sonnet 5.5: Es liegt preislich in der Mitte und hatte die niedrigste Punktzahl.
Die Modelle
| Anbieter | Modell | Getestete Anstrengung | Positionierung |
|---|---|---|---|
| Anthropic | Claude Opus 5.5 | Standard (medium) | Flaggschiff, täglicher Allrounder |
| Anthropic | Claude Sonnet 5.5 | Standard | Mittelklasse |
| Anthropic | Claude Haiku 5.5 | Standard | Schnell, kostengünstig |
| OpenAI | GPT-6 Astra | max, ultra | Frontier-Modell |
| OpenAI | GPT-6.1 Sol | medium, max, ultra | Arbeitspferd |
| OpenAI | GPT-6 Luna | medium, max | Schnell, kostengünstig |
Die Preise der beiden Anbieter entsprechen einander. GPT-6.1 Sol kostet pro Token so viel wie Claude Sonnet 5.5, GPT-6 Astra so viel wie Claude Fable 5.1 und GPT-6 Luna so viel wie Claude Haiku 5.5. Claude Opus 5.5 liegt zwischen Sol und Astra. Wenn zwei Modelle unten also unterschiedliche Kosten verursachen, liegt das meist daran, dass eines von ihnen für dieselbe Aufgabe mehr Tokens verbraucht hat.
Die Claude-Modelle liefen jeweils einmal mit ihren Standardeinstellungen, was bei Opus der mittleren Anstrengung entspricht. Die GPT-Modelle testete ich auf mehreren Anstrengungsstufen. Der fairste Vergleich ist GPT-6.1 Sol auf medium gegen Claude Opus 5.5 auf medium: 9,56 gegen 8,57.
Der Test
Ich verwendete die zu diesem Zeitpunkt 50 neuesten Fotos meiner Bibliothek, ohne Videos. Sie sind eine gewöhnliche Woche meiner Kamera-Rolle: Familienmomente zu Hause und bei einem Einkaufsbummel, Stadtansichten aus einem hohen Stockwerk, eine Speicherkarte auf meinem Schreibtisch, Produktseiten-Screenshots von elektronischen Bauteilen, Sendungsverfolgungs-Screenshots, ein Social-Media-Beitrag, ein Parkrabatt-QR-Schild und ein Ladeetikett einer Ladesäule.
Jedes Modell hatte fünf Aufgaben pro Foto. Es schrieb einen kurzen Titel und eine ein- bis dreisätzige Beschriftung auf Chinesisch, vergab 5 bis 12 Schlüsselwörter auf Chinesisch und Englisch und wählte das beste Album aus meinen vorhandenen Alben – oder keins. Dann vergab es eine Qualitätsnote und sagte, ob das Foto behalten oder gelöscht werden soll, wobei es nach Duplikaten, misslungenen Aufnahmen, abgelaufenen Screenshots und Fotos ohne bleibenden Wert suchte. Jedes Modell erhielt dieselben Anweisungen und denselben Kontext für jedes Foto, zehn Fotos auf einmal.
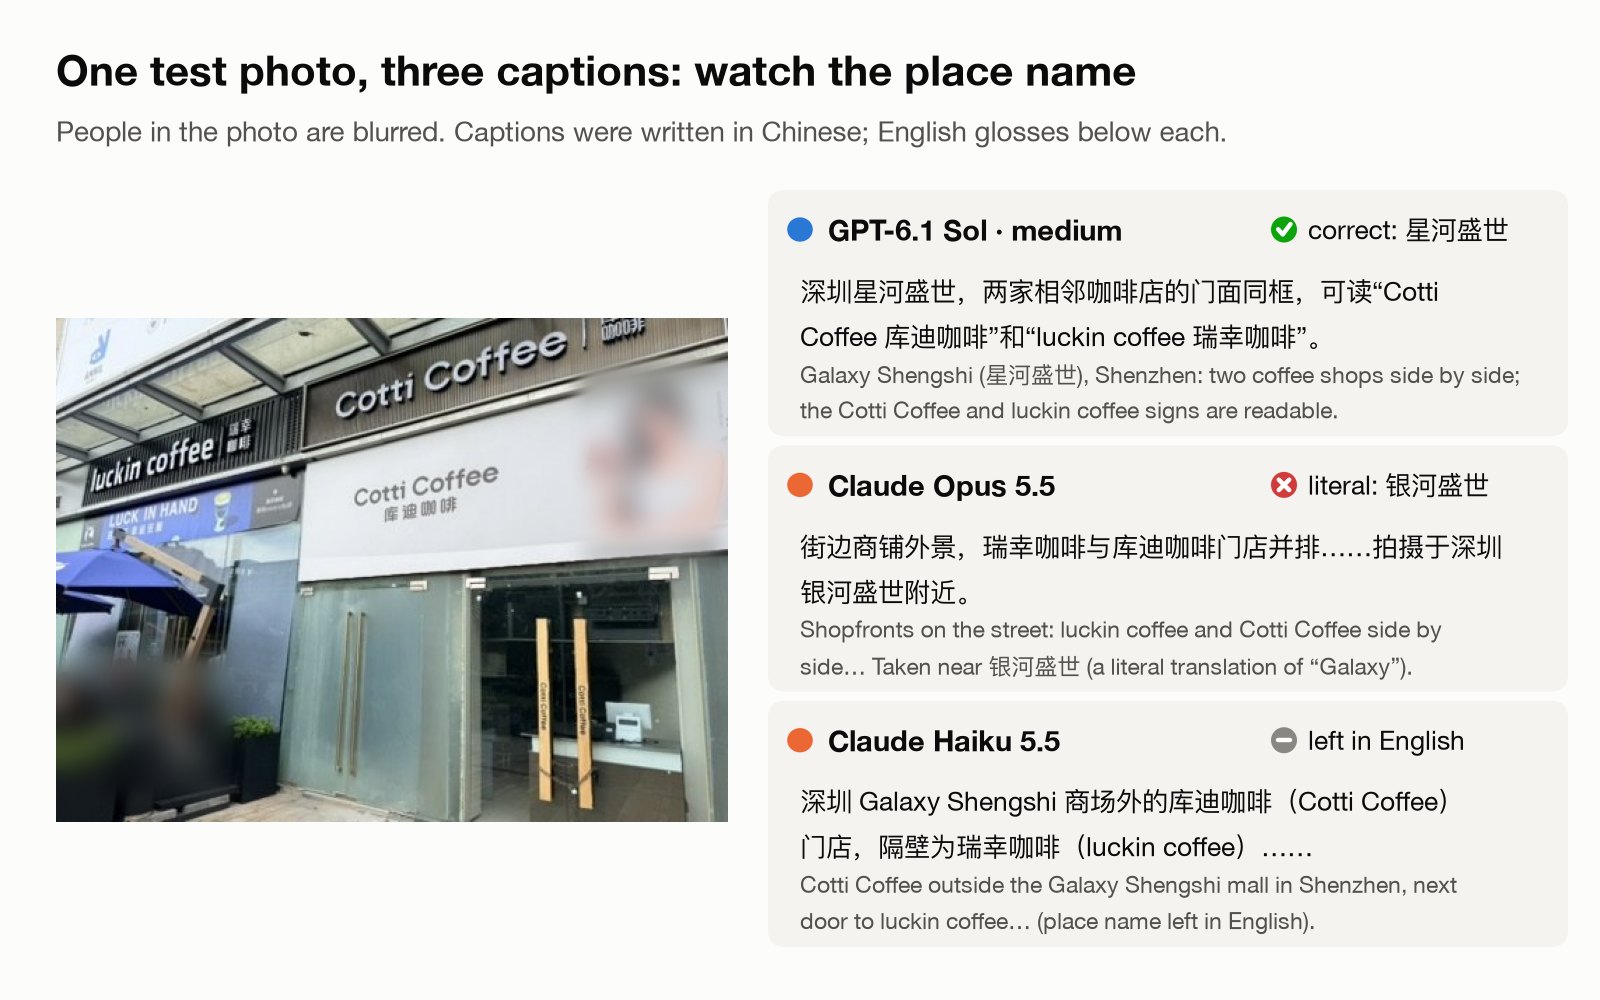 Abbildung 2. Eines der 50 Testfotos, mit drei der Beschriftungen. Achten Sie darauf, wie jedes Modell den Ortsnamen behandelt; ich komme unten darauf zurück. Personen auf dem Foto sind verpixelt.
Wie ich bewertet habe
Ich habe die Antworten nicht selbst bewertet. Ich hatte vor dem Test bereits einen Favoriten gewählt, und ich nutze Claude täglich, war also nicht neutral.
Stattdessen mischte ich die zehn Antworten jedes Fotos und beschriftete sie mit A bis J, mit einer neuen zufälligen Reihenfolge für jedes Foto. Zwei Bewerter bewerteten dann alle 500 Antworten unabhängig voneinander, während sie die Fotos ansahen. Einer war Claude Fable 5.1, das leistungsfähigste Modell von Anthropic. Der andere war GPT-6 Astra auf der Stufe xhigh, das Frontier-Modell von OpenAI.
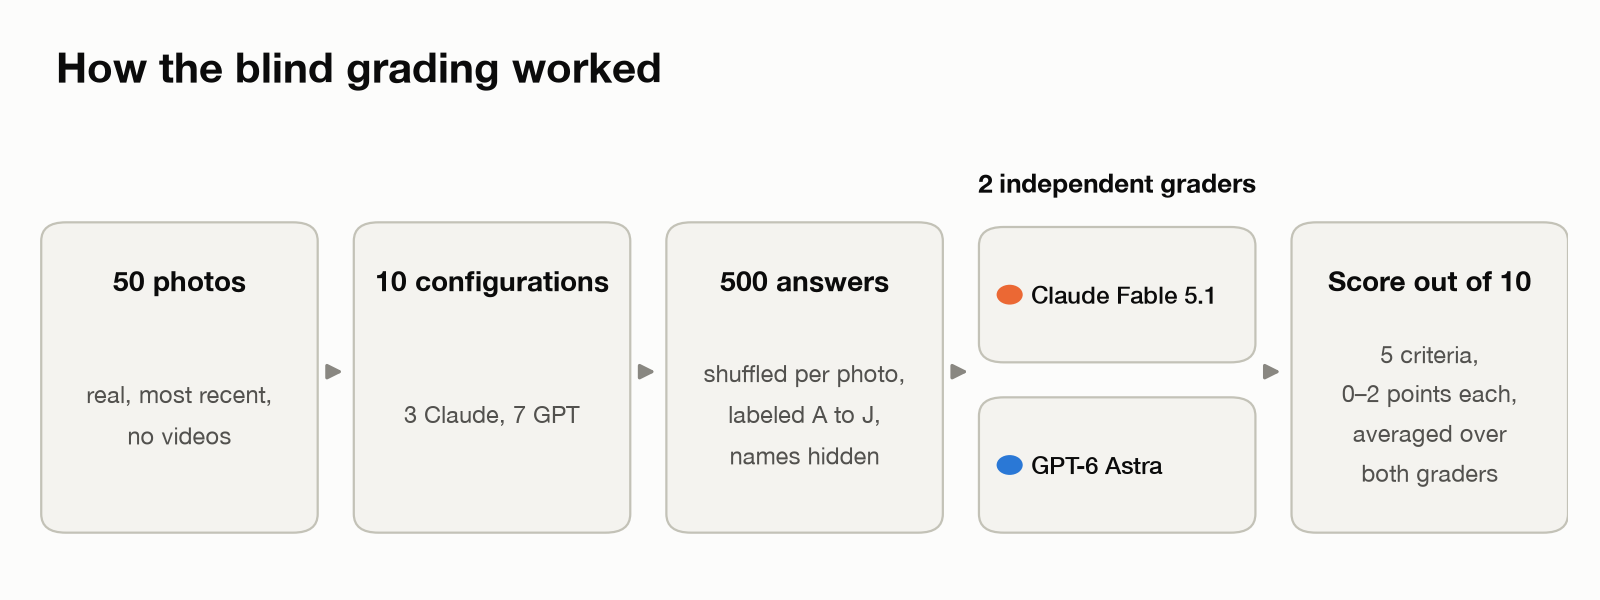 Abbildung 3. Wie die Blindbewertung funktionierte.
Jede Antwort wurde nach fünf Kriterien mit jeweils 0 bis 2 Punkten bewertet, insgesamt 10:
| Kriterium | Was der Bewerter prüfte |
|---|---|
| Fakten | Sind Motiv, Ort und lesbarer Text korrekt, einschließlich lokaler Ortsnamen? |
| Keine erfundenen Details | Vermeidet die Antwort Aussagen, die das Foto nicht zeigt? |
| Löschentscheidung | Ist behalten oder löschen vernünftig? Ein gutes Foto zu löschen ergibt 0 Punkte. |
| Album-Passung | Ist das Album richtig? Ein falsches altes Album ergibt 0 Punkte; kein Album ist eine akzeptable 1. |
| Nutzen | Würden Titel, Beschriftung und Schlüsselwörter mir helfen, dieses Foto später wiederzufinden und mich daran zu erinnern? |
Ich wählte je einen Bewerter von jedem Anbieter, um zu sehen, ob einer seine eigenen Modelle bevorzugen würde. Sie stimmten weitgehend überein. Die Korrelation über die 500 gepaarten Bewertungen lag bei 0,71, und beide setzten dieselben fünf GPT-Konfigurationen an die Spitze. Der Claude-Bewerter stufte GPT-6.1 Sol und GPT-6 Astra ebenfalls über Claude Opus ein. Der GPT-Bewerter war insgesamt strenger und am strengsten bei den Claude-Modellen.
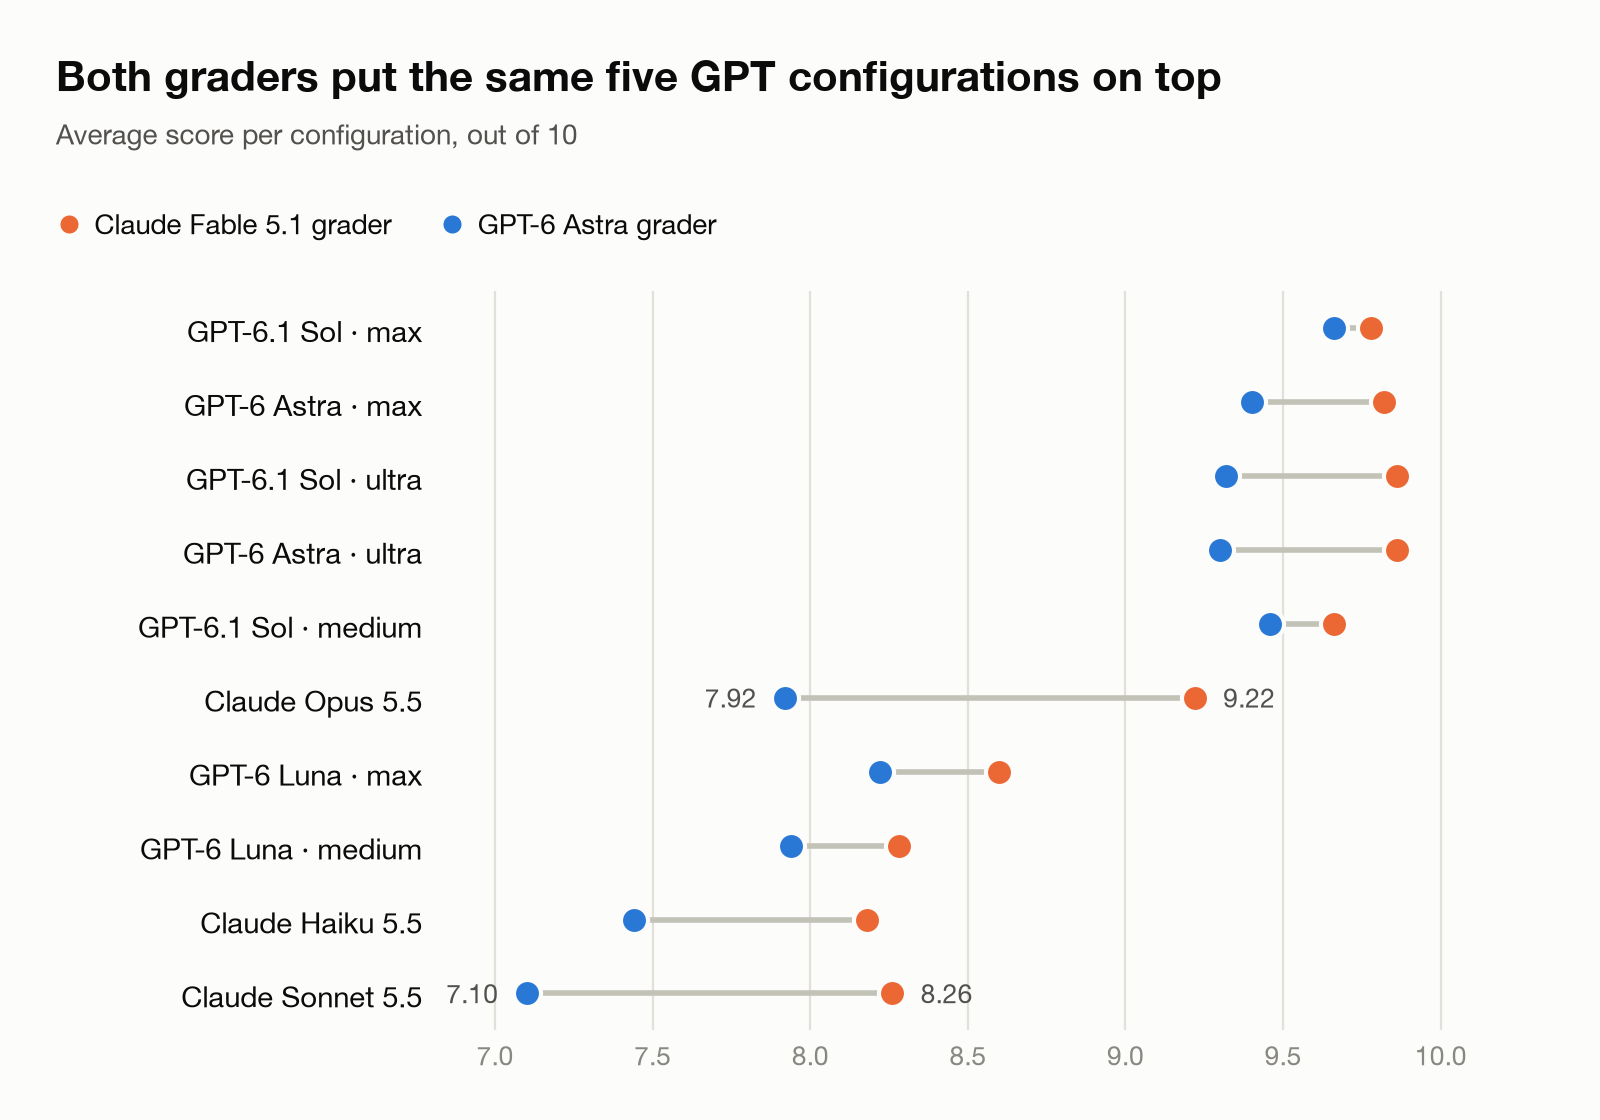 Abbildung 4. Durchschnittliche Punktzahl jedes Bewerters je Konfiguration.
Ergebnisse
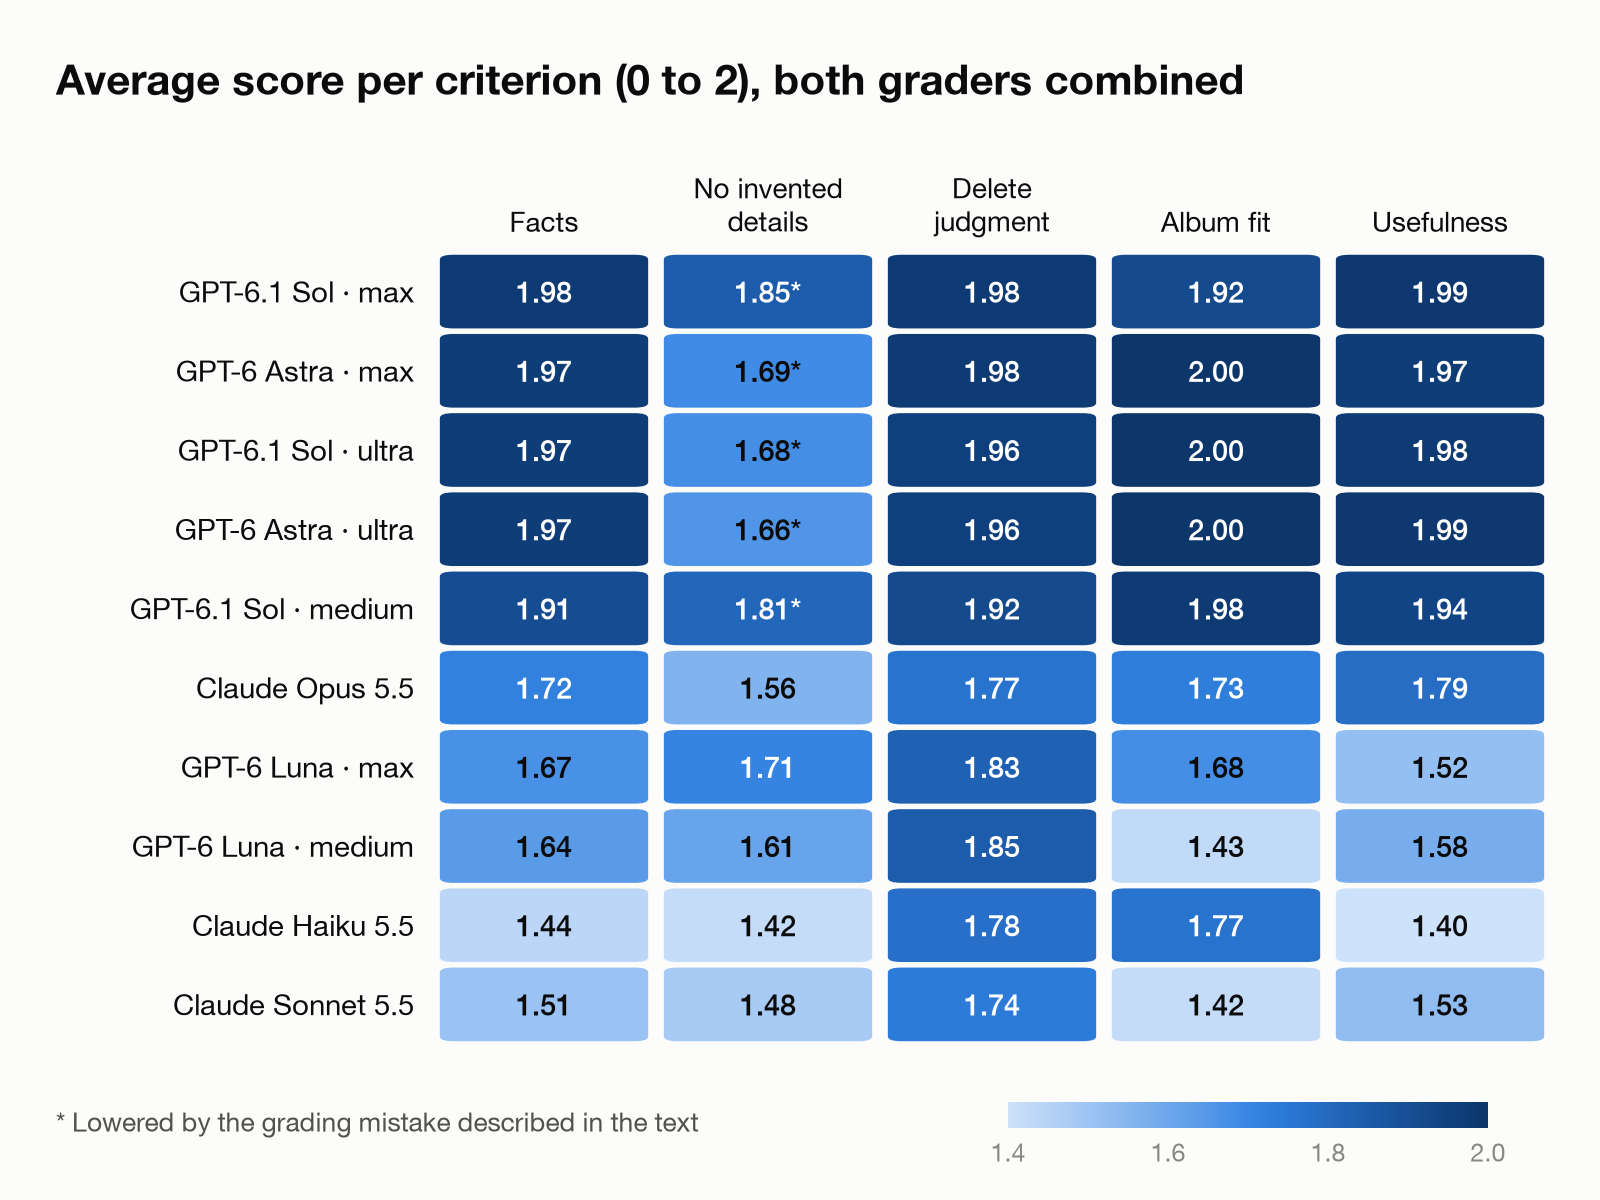 Abbildung 5. Durchschnittliche Punktzahl je Kriterium, beide Bewerter kombiniert. Ein Sternchen markiert Punktzahlen, die durch den unten beschriebenen Bewertungsfehler gesenkt wurden.
GPT-6.1 Sol und GPT-6 Astra
Sol und Astra lasen den Text genau und beschränkten ihre Beschriftungen meist auf das, was die Fotos zeigten. Sie waren auch die besten bei lokalen Ortsnamen, was für in China aufgenommene Fotos wichtig ist.
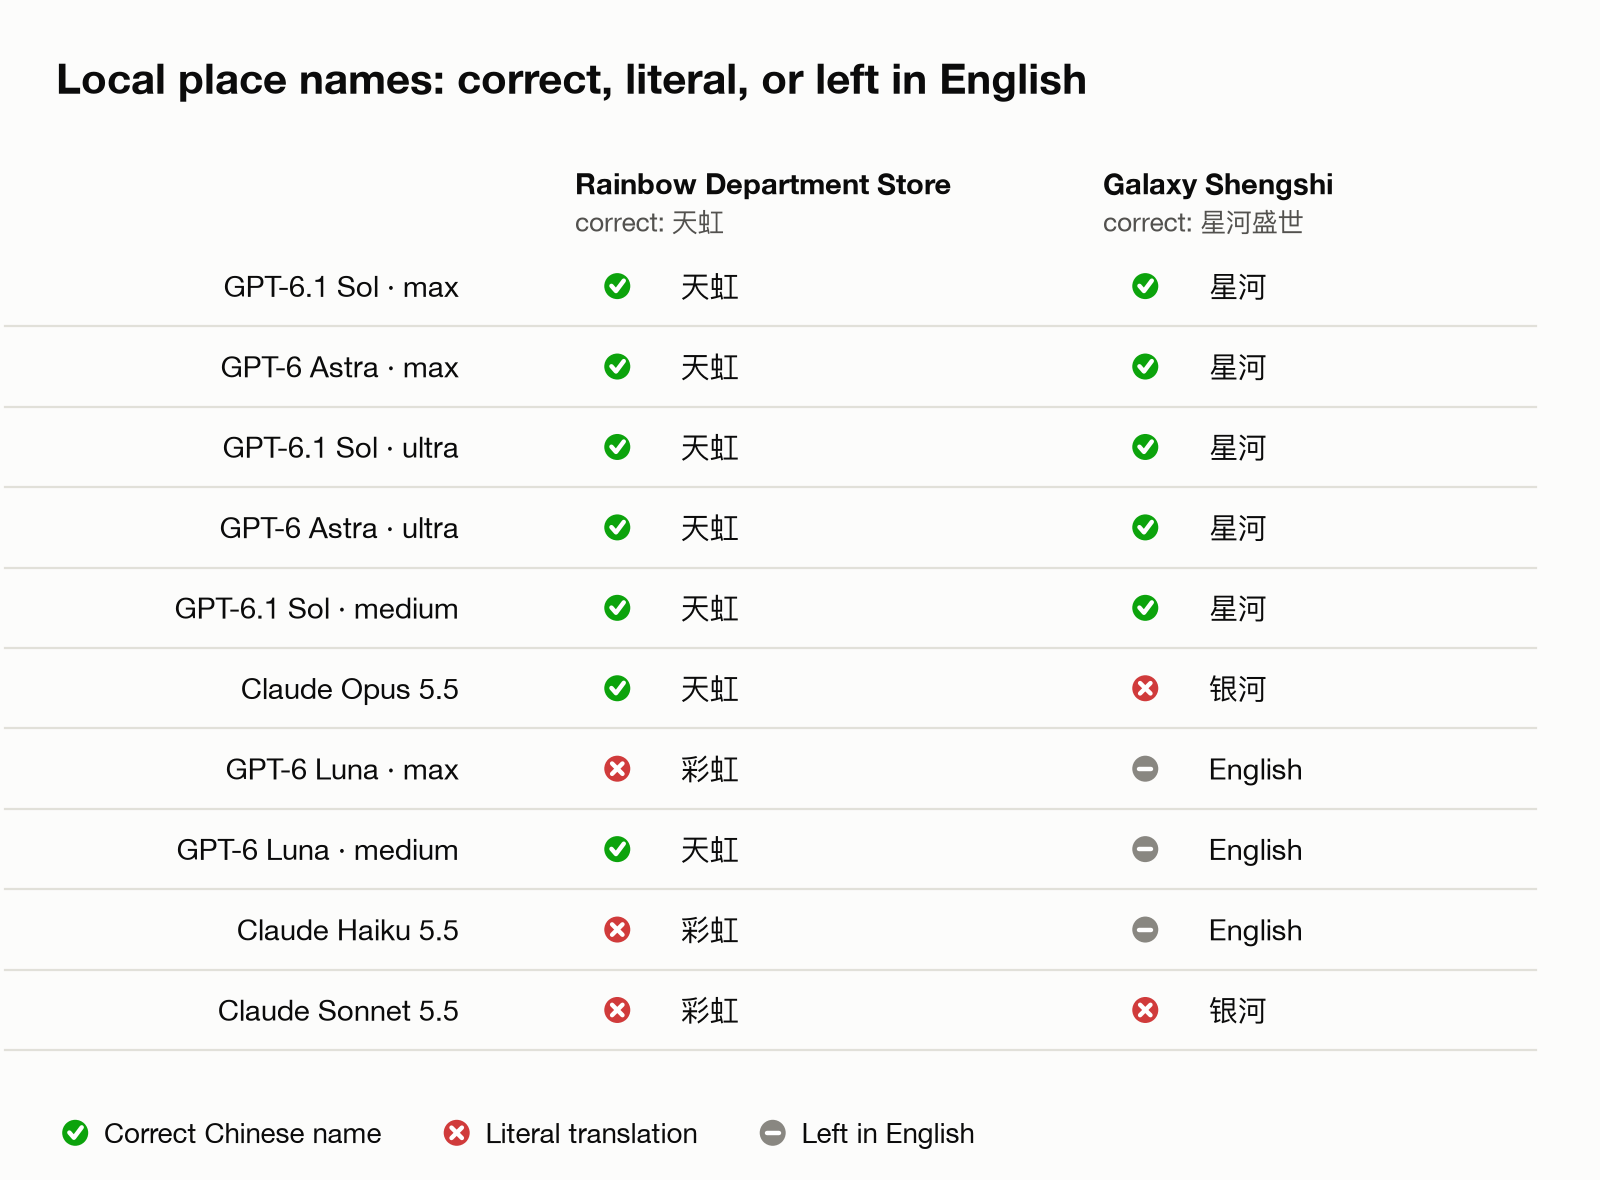 Abbildung 6. Zwei Tests zu lokalen Namen. Ein Häkchen bedeutet der korrekte chinesische Name, ein Kreuz eine wörtliche Übersetzung und EN bedeutet, der Name blieb auf Englisch.
Mehrere Fotos waren mit dem Ort „Rainbow Department Store" getaggt. Das ist der englische Name der Shenzhener Kaufhauskette 天虹. Eine wörtliche Übersetzung ergibt 彩虹百货, was falsch ist. Jede Sol- und Astra-Konfiguration hatte das richtig, ebenso Opus und Luna auf medium. Haiku, Sonnet und Luna auf max verwendeten die wörtliche Übersetzung. Das Kaffeehausfoto in Abbildung 2 war mit „Galaxy Shengshi" getaggt, dessen chinesischer Name 星河盛世 ist. Jede Sol- und Astra-Konfiguration schrieb 星河. Opus und Sonnet übersetzten es wörtlich als 银河, und Haiku sowie beide Luna-Konfigurationen ließen es auf Englisch.
Sol und Astra waren auch beim Löschen vorsichtig. Sie schlugen vor, 4 bis 6 der 50 Fotos zu löschen. Die Menge enthielt acht Produktseiten-Screenshots von elektronischen Bauteilen, und die GPT-Modelle behielten fast alle; eine Sol-Konfiguration markierte einen einzigen Screenshot als Beinahe-Duplikat. Die Claude-Modelle markierten jeweils zwei bis vier. Beide Bewerter sprachen sich für das Behalten aus, da die Seiten Pinbelegungen, Abmessungen und Board-Fotos enthielten, die ich später nachschlagen möchte.
Claude Opus 5.5
Opus schrieb manchmal Dinge in eine Beschriftung, die das Foto allein nicht zeigen kann. Es beschrieb Beziehungen, die das Bild allein nicht belegen kann, etwa Geschwister oder Eltern und Kind. Es verwechselte auch einige Posen. Auf einem Foto stand ein Kind hinter einem Erwachsenen, und Opus schrieb, das Kind säße auf dem Rücken des Erwachsenen. Beide Bewerter zogen dafür Punkte ab.
Das überraschte mich. Vor dem Blindtest hatte ich mir die Antworten angesehen und Opus dafür gelobt, korrekt zu erraten, dass zwei Kinder Geschwister sind. Ich kenne meine Familie; der Bewerter nicht. Aber bei 142.000 Fotos kann ich nicht jede Beschriftung selbst prüfen, und eine Beschriftung, die etwas behauptet, das das Foto nicht zeigt, ist ein Problem.
Opus schlug außerdem die meisten Löschungen vor, 13 der 50 Fotos. Drei davon waren Produktseiten-Screenshots, die es als abgelaufen bezeichnete, obwohl sie Referenzinformationen enthielten, die ich behalten würde. Es war das einzige Modell, das das Parkrabatt-QR-Schild als wertlos löschen wollte. Außerdem steckte es mehrere Fotos einer einzelnen Person in ein „Familienporträt"-Album.
Claude Sonnet 5.5 und Haiku 5.5
Diese beiden machten die meisten Faktenfehler, einschließlich der wörtlichen Übersetzung 彩虹. Sonnet traf die schwächsten Album-Entscheidungen und sortierte alltägliche Fotos in ein altes Album von einem nicht zusammenhängenden Ereignis. Haiku erfand ein Detail, das zu einer falschen Löschentscheidung führte. In einer Serie fast identischer Aufnahmen beschrieb es das beste Bild als jemanden, der nach unten schaut – das Gegenteil von dem, was das Foto zeigt – und schlug vor, es zu löschen.
GPT-6 Luna
Luna kostet pro Token so viel wie Haiku, erzielte aber auf beiden Anstrengungsstufen höhere Punktzahlen: 8,41 und 8,11 gegenüber Haikus 7,81. Auf max schlug es auch Sonnet, das für dieselbe Bibliothek etwa das 17-Fache kosten würde. Luna verlor die meisten Punkte bei Nutzen und Albumwahl. Seine Beschriftungen waren schlichter und seine Alben weniger präzise.
Anstrengungsstufen
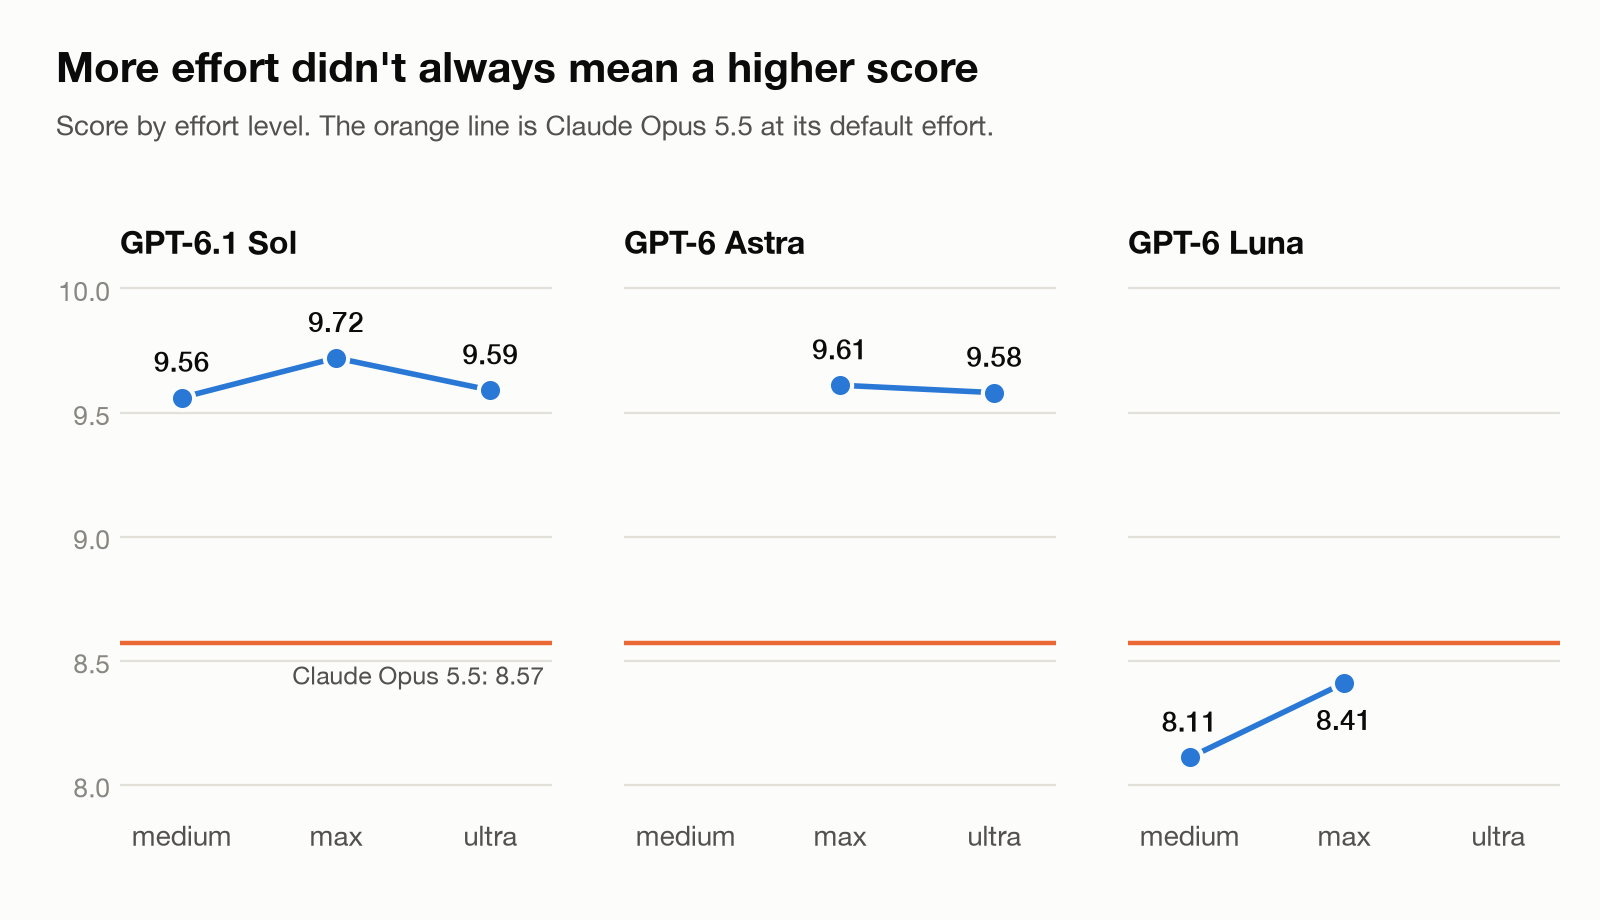 Abbildung 7. Punktzahl je Anstrengungsstufe. Die orangefarbene Linie ist Claude Opus 5.5 bei seiner Standardanstrengung.
Ultra war bei beiden Modellen nicht besser als max. Sol erzielte 9,59 bei ultra und 9,72 bei max; Astra erzielte 9,58 und 9,61. In diesem Test erzeugte ultra sogar weniger Ausgabe-Tokens als max. Bei Sol kam medium mit 9,56 nahe heran, für weniger als die Hälfte der Kosten von max. Mehr Anstrengung bedeutete auch nicht immer genauere Details: Luna auf medium traf 天虹 richtig, Luna auf max nicht.
Ein Fehler in meiner Bewertung
Nach der Bewertung fiel mir auf, dass die Bewerter nicht das Aufnahmedatum und die Aufnahmezeit jedes Fotos erhalten hatten, obwohl die beschriftenden Modelle sie hatten. Der GPT-6-Astra-Bewerter wertete Beschriftungen, die das genaue Datum oder die genaue Zeit erwähnten, daher als erfundene Details. Die führenden GPT-Konfigurationen erwähnten das Datum am häufigsten, daher fielen ihre Werte bei „Keine erfundenen Details" niedriger aus, als sie hätten sein sollen.
Wenn ich nur die durch Datumsangaben verlorenen Punkte zurückgebe, steigen die vier führenden GPT-Konfigurationen auf 9,84 bis 9,90 – praktisch ein Gleichstand – und Opus bleibt bei 8,58. Ich habe in diesem Beitrag die ursprünglichen Punktzahlen beibehalten. Nächstes Mal gebe ich den Bewertern alles, was die Modelle gesehen haben.
Geschwindigkeit
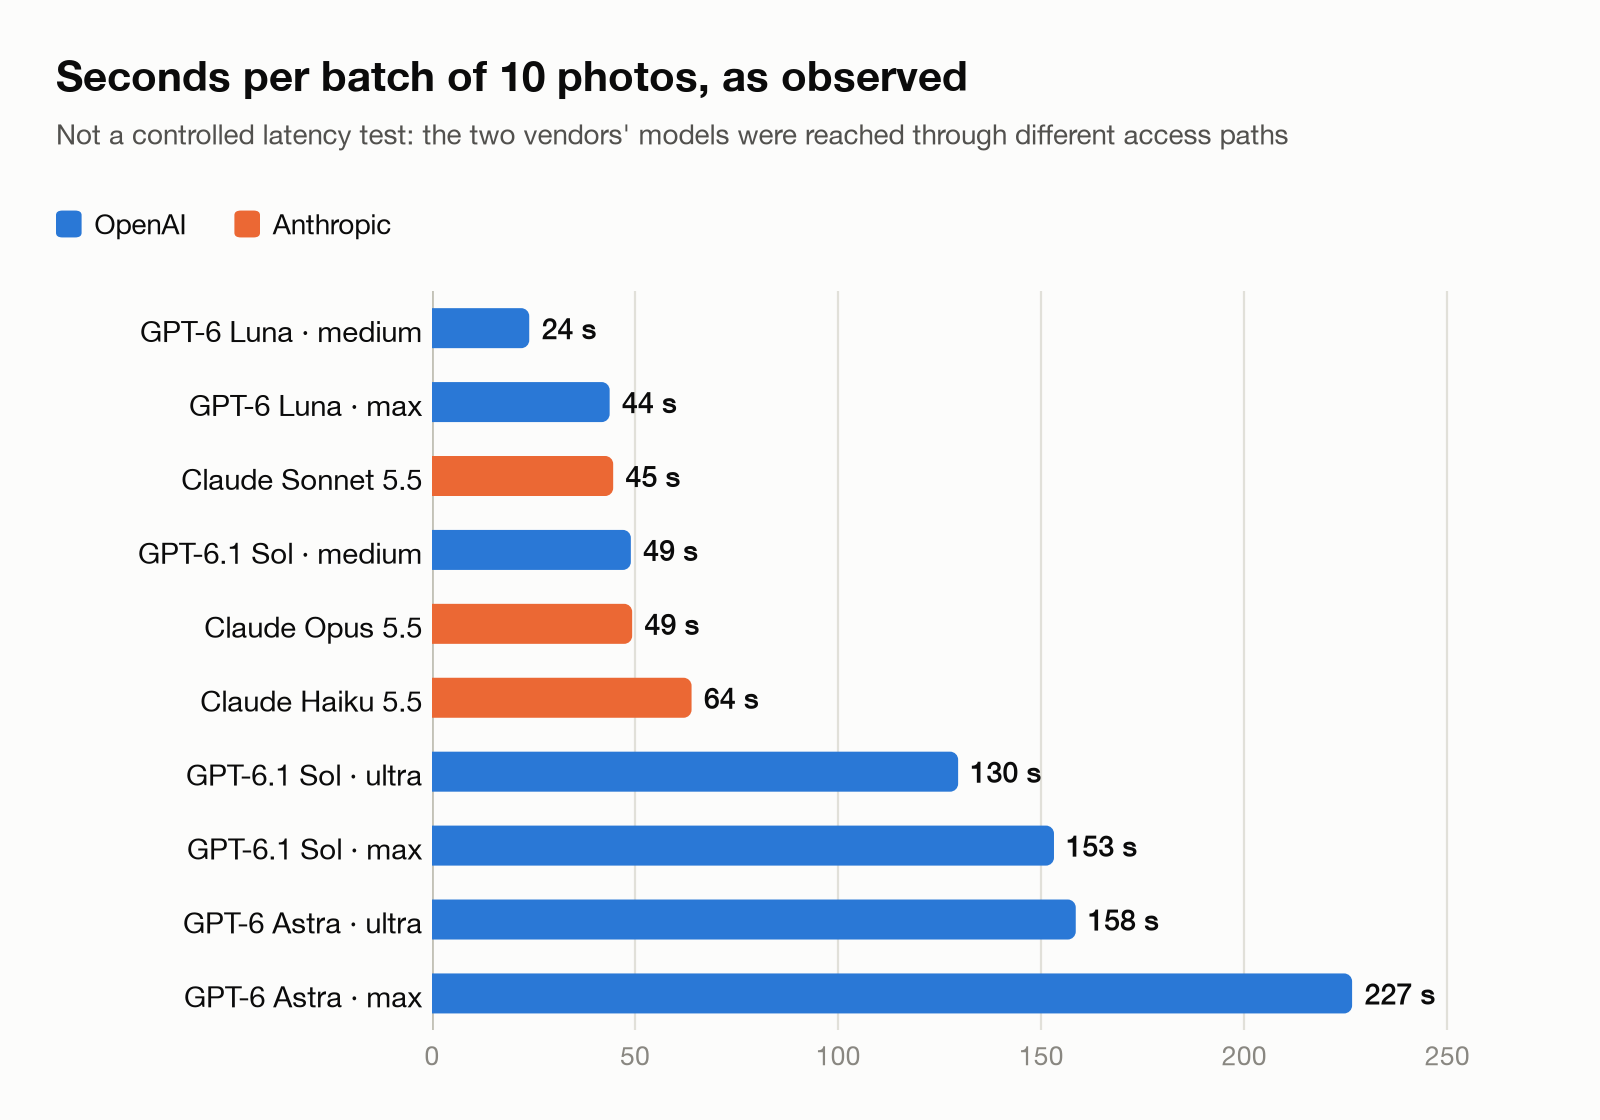 Abbildung 8. Sekunden je Stapel von 10 Fotos, wie beobachtet. Dies ist kein kontrollierter Latenztest, da die Modelle der beiden Anbieter über unterschiedliche Zugangswege erreicht wurden.
Das passt dazu, wie sich Opus in meiner täglichen Arbeit anfühlt: Es ist schnell, etwa dreimal schneller als Sol auf max. Sol auf medium war allerdings genauso schnell wie Opus und erzielte etwa einen Punkt mehr.
Was es kostet
Ich habe jede Konfiguration zu den offiziellen API-Preisen der Anbieter kalkuliert. Die in einem Abo enthaltene Nutzung als kostenlos zu behandeln, würde manche Modelle besser erscheinen lassen, als sie sind.
Offizielle Preise je Million Tokens, Standard-Stufe:
| Modell | Eingabe | Ausgabe |
|---|---|---|
| Claude Opus 5.5 | $4.00 | $20.00 |
| Claude Sonnet 5.5 | $2.00 | $10.00 |
| Claude Haiku 5.5 | $0.10 | $0.50 |
| GPT-6 Astra | $10.00 | $50.00 |
| GPT-6.1 Sol | $2.00 | $10.00 |
| GPT-6 Luna | $0.10 | $0.50 |
Die Batch-APIs beider Anbieter kosten 50 % weniger, was zu einer Aufgabe wie dieser passt, die keine sofortigen Antworten braucht. Die Preise entnahm ich der Preisseite von Anthropic (claude.com/pricing) und der API-Preisseite von OpenAI (developers.openai.com/api/docs/pricing) am 20. Oktober 2026.
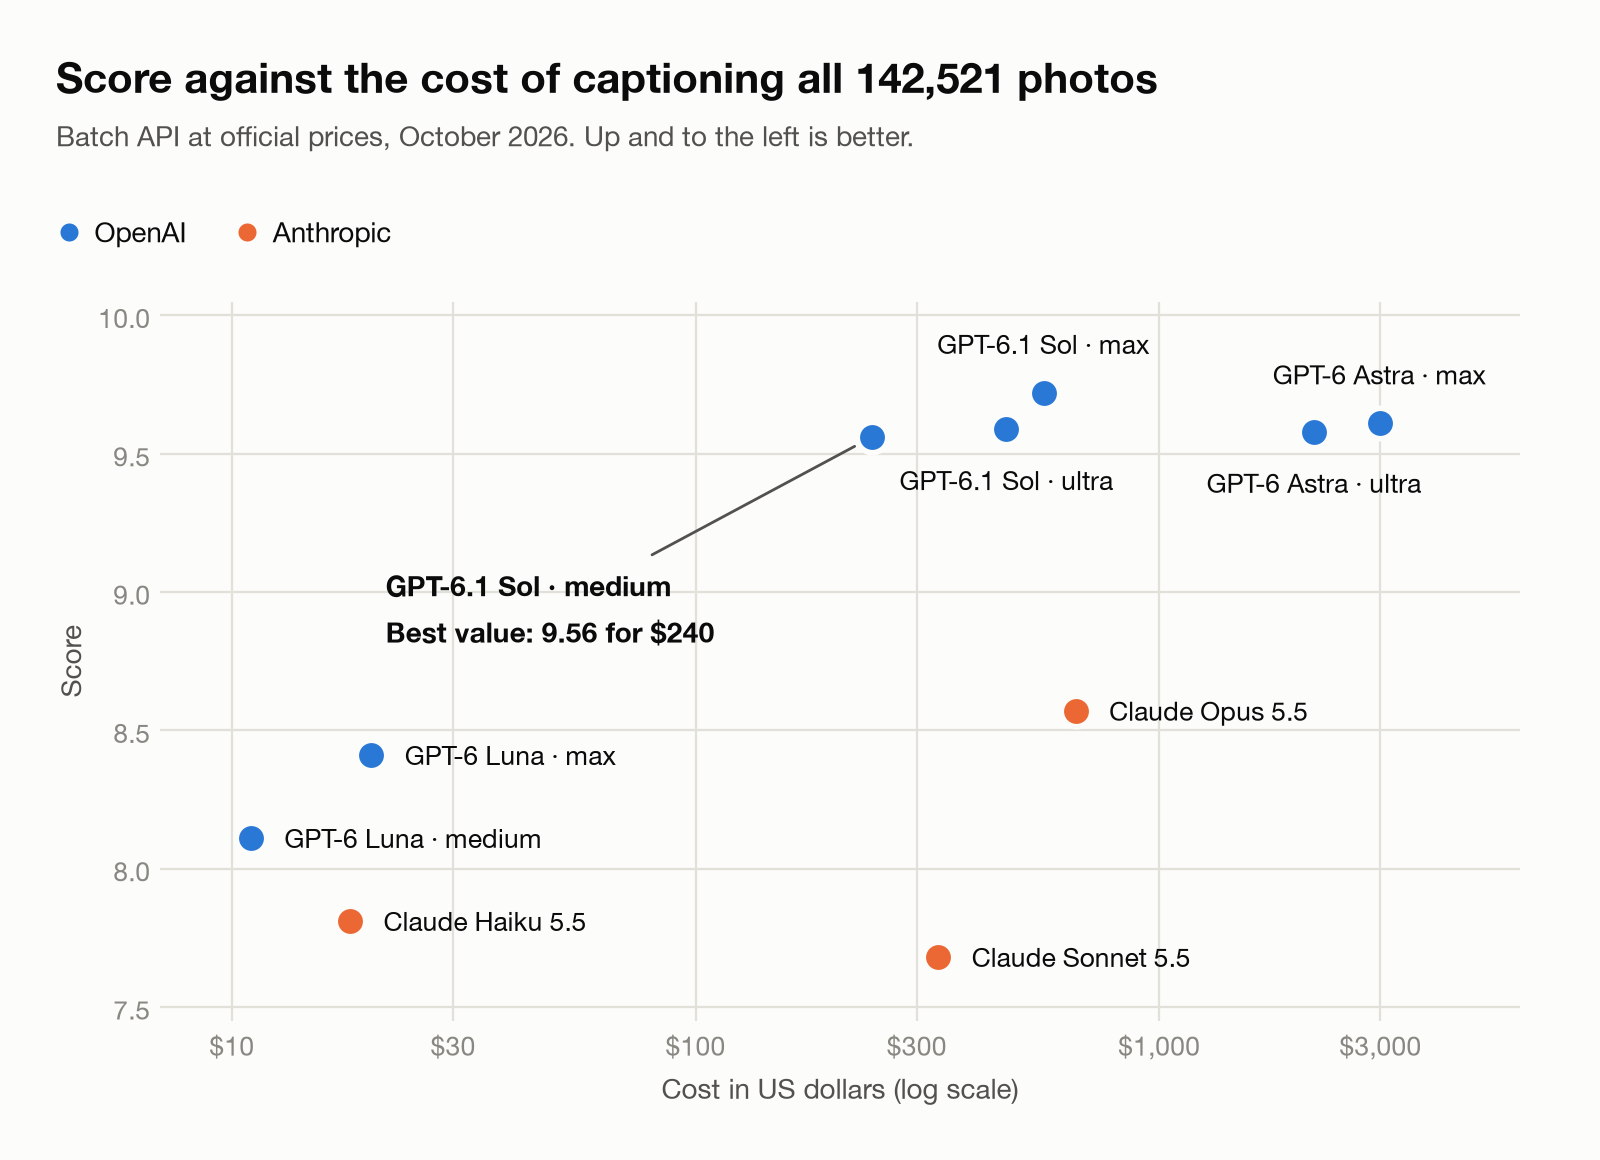 Abbildung 9. Punktzahl gegen die Kosten der Beschriftung der gesamten Bibliothek zu Batch-Preisen. Die Kostenachse ist logarithmisch.
| Modell und Anstrengung | Ausgabe-Tokens je Foto | Standard | Batch | Punktzahl |
|---|---|---|---|---|
| GPT-6.1 Sol, medium | 193 | $479 | $240 | 9.56 |
| GPT-6.1 Sol, ultra | 514 | $937 | $468 | 9.59 |
| GPT-6.1 Sol, max | 647 | $1,126 | $563 | 9.72 |
| Claude Opus 5.5 | ~292 | $1,323 | $661 | 8.57 |
| Claude Sonnet 5.5 | ~297 | $668 | $334 | 7.68 |
| GPT-6 Astra, ultra | 462 | $4,313 | $2,156 | 9.58 |
| GPT-6 Astra, max | 695 | $5,973 | $2,987 | 9.61 |
| GPT-6 Luna, medium | 163 | $22 | $11 | 8.11 |
| Claude Haiku 5.5 | ~330 | $36 | $18 | 7.81 |
| GPT-6 Luna, max | 419 | $40 | $20 | 8.41 |
Sol auf medium erreichte 98 % der Höchstpunktzahl für 36 % dessen, was Opus kosten würde, und 43 % von Sol auf max. Astra erreichte Sols Qualität, kostet aber etwa das Fünffache, weil sein Preis je Token fünfmal höher ist. Opus kostete mehr als Sol auf max und erzielte weniger. Es lief bereits auf medium, aber sein Preis je Token ist doppelt so hoch wie der von Sol. Luna würde die gesamte Bibliothek für 11 bis 20 US-Dollar beschriften und Haiku und Sonnet trotzdem übertreffen.
Methodenhinweis: Die GPT-Token-Zahlen wurden aus den Läufen gemessen, die Claude-Token-Zahlen aus den Laufprotokollen geschätzt. Einige Claude-Reasoning-Tokens waren nicht sichtbar, daher können die Claude-Kosten leicht unterschätzt sein. Über Batch hinaus wurden bei keinem Modell Rabatte wie Prompt-Caching angewendet.
Was ich gelernt habe
Ich wählte Opus, bevor ich irgendwelche Blindbewertungen hatte, vor allem, weil es bereits mein Standard fürs Programmieren war. Fürs Programmieren und für Workflows bevorzuge ich weiterhin Claude Opus 5.5, wo es meiner Erfahrung nach schneller und stärker ist. Echte Fotos zu beschreiben erfordert eine andere Fähigkeit: zu lesen, was tatsächlich im Bild ist, ohne Posen oder Beziehungen hineinzuinterpretieren. GPT-6.1 Sol konnte das besser. Wäre ich meiner Gewohnheit gefolgt und hätte den Blindtest übersprungen, hätte ich mehr für schlechtere Beschriftungen bezahlt.
Nächstes Mal beginne ich blind und gebe Bewertern verschiedener Anbieter alle Eingaben, die die beschriftenden Modelle erhalten haben. Ich werde auch weiterhin zu offiziellen API-Preisen vergleichen und nicht annehmen, dass mehr Anstrengung besser ist: ultra schlug max hier nicht.
Selbst die besten Modelle markierten nützliche Fotos zum Löschen, daher prüfe ich jede Löschmarkierung selbst, bevor ich etwas entferne.
Grenzen
Dies war ein kleiner Test: 50 aktuelle Fotos aus einer Stadt. Ich habe keine älteren Fotos, gescannten Dokumente, anderen Sprachen oder Videos getestet. Die Claude-Modelle liefen nur mit ihren Standardeinstellungen; ein Opus mit höherer Anstrengung könnte besser abschneiden, zu höheren Kosten. Die Bewerter sind KI-Modelle, keine Menschen. Sie stimmten gut, aber nicht perfekt überein, und eine menschliche Stichprobe würde das Ergebnis belastbarer machen. Modelle und Preise ändern sich schnell, und jede Zahl hier gilt für Oktober 2026.
Meine Wahl
Für meine Bibliothek: GPT-6.1 Sol auf mittlerer Anstrengung. Fürs Programmieren und Workflows bleibe ich bei Claude Opus 5.5.