
Probé a ciegas 10 modelos de IA en mi biblioteca de 142 000 fotos: GPT-6.1 Sol superó a Claude Opus
Resumen
Uso Claude Opus 5.5 todos los días para programar y para flujos de trabajo, y para ese trabajo me parece más rápido y mejor que GPT-6. Supuse que también sería el mejor describiendo fotos, así que lo puse a prueba. Probé diez configuraciones: Claude Haiku, Sonnet y Opus 5.5, más GPT-6.1 Sol, GPT-6 Astra y GPT-6 Luna de OpenAI en varios niveles de esfuerzo. Cada una tituló, describió, etiquetó y archivó 50 fotos reales de mi biblioteca de 142 521 fotos, y marcó las que creía que debía borrar. Dos evaluadores a ciegas de proveedores distintos, Claude Fable 5.1 y GPT-6 Astra, puntuaron las 500 respuestas según hechos, detalles inventados, criterio de borrado, encaje en el álbum y utilidad. GPT-6.1 Sol obtuvo la puntuación más alta, 9,72 sobre 10. Opus obtuvo 8,57, y Sonnet y Haiku quedaron entre 7,7 y 7,8. El esfuerzo ultra no fue mejor que max. A precios oficiales de la Batch API, describir toda la biblioteca costaría unos $240 con Sol en esfuerzo medium (9,56), $661 con Opus, y de $11 a $20 con Luna, que aun así superó a Haiku.
Por qué lo probé
La mayor parte de mi día se va en programar, en flujos de trabajo con agentes y en automatización, y Claude Opus 5.5 es el modelo al que recurro. Para ese tipo de trabajo me ha parecido más rápido y mejor que GPT-6. Así que cuando decidí que una IA describiera y etiquetara mi biblioteca de fotos, elegí Opus sin pensarlo dos veces.
La biblioteca son 25 años de mi vida: 142 521 fotos, desde las primeras tomas de cámara digital hasta las fotos del móvil de la semana pasada, más de 16 000 capturas de pantalla. Casi ninguna tiene descripción. Quiero que cada foto tenga un título, una descripción, palabras clave que pueda buscar, un álbum sensato y una marca honesta cuando sea un duplicado o basura. Antes de pagar por procesar 142 000 fotos, quería saber qué modelo lo hace mejor y cuánto cuesta la diferencia.
Esperaba que ganara Opus. En estas 50 fotos, GPT-6.1 Sol sacó más de un punto más.
Resultados de un vistazo
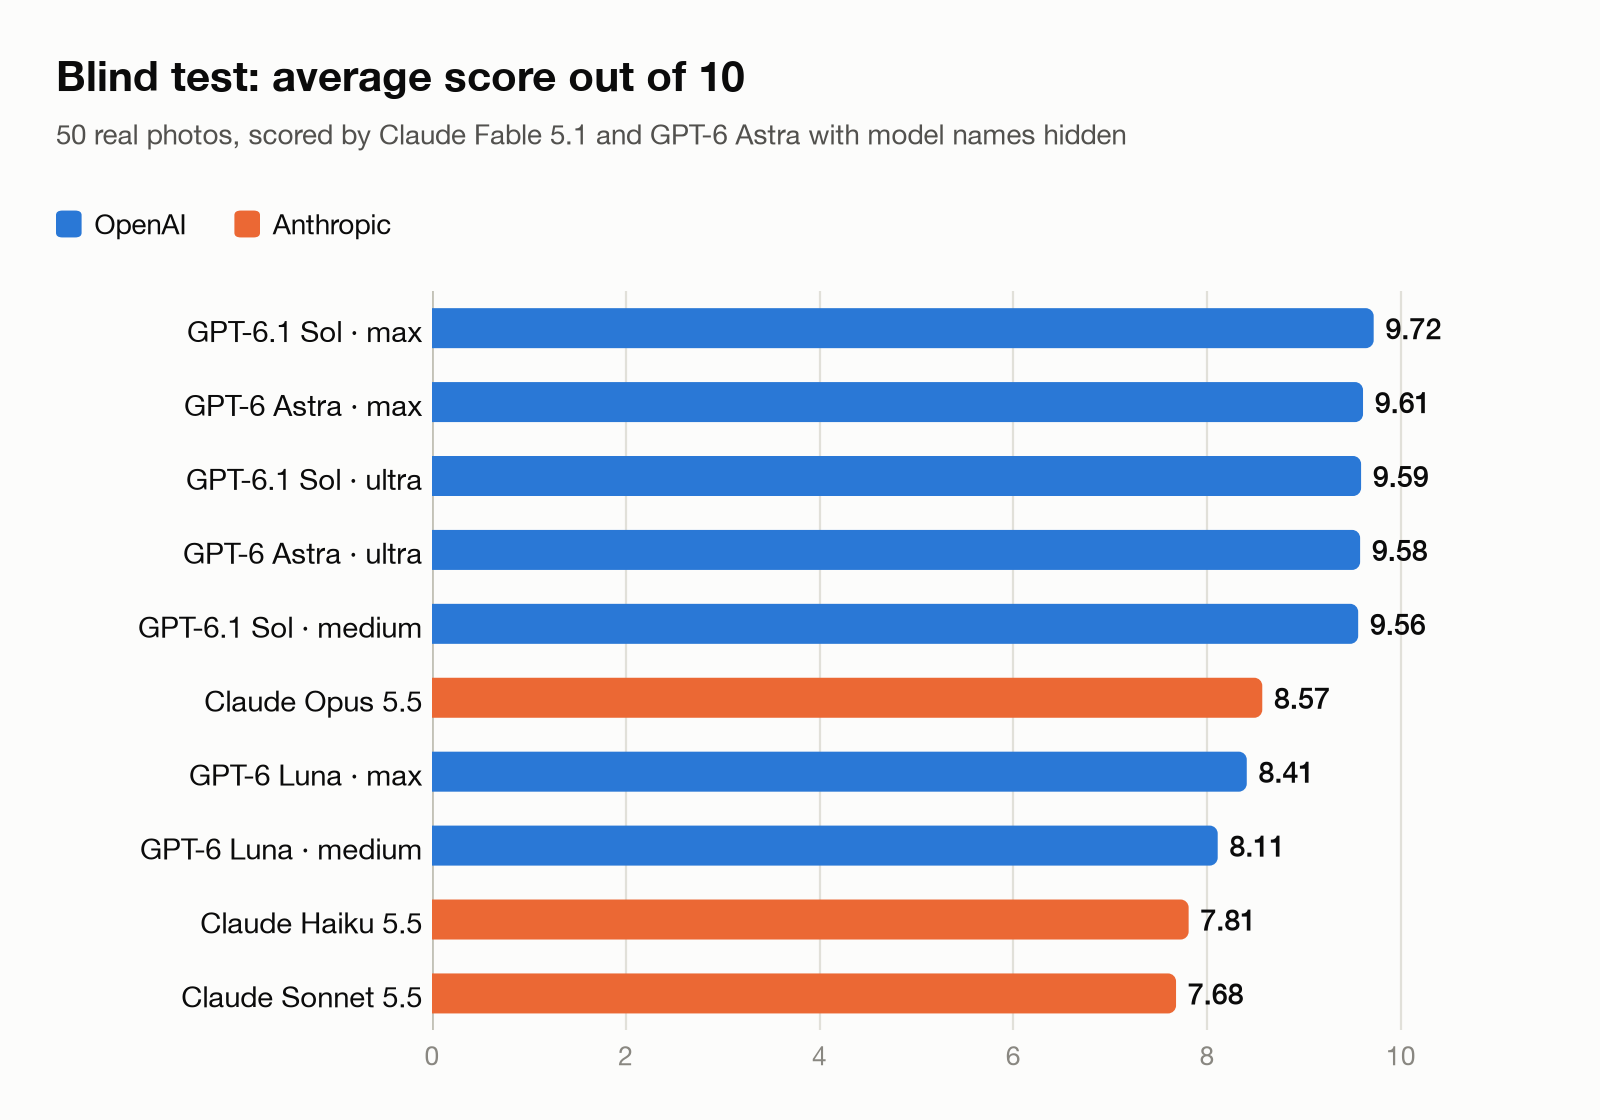 Figura 1. Puntuación media de dos evaluadores a ciegas, sobre 10.
| Puesto | Modelo y esfuerzo | Puntuación (sobre 10) | Toda la biblioteca, Batch API | Toda la biblioteca, API estándar |
|---|---|---|---|---|
| 1 | GPT-6.1 Sol, max | 9.72 | $563 | $1,126 |
| 2 | GPT-6 Astra, max | 9.61 | $2,987 | $5,973 |
| 3 | GPT-6.1 Sol, ultra | 9.59 | $468 | $937 |
| 4 | GPT-6 Astra, ultra | 9.58 | $2,156 | $4,313 |
| 5 | GPT-6.1 Sol, medium | 9.56 | $240 | $479 |
| 6 | Claude Opus 5.5 | 8.57 | $661 | $1,323 |
| 7 | GPT-6 Luna, max | 8.41 | $20 | $40 |
| 8 | GPT-6 Luna, medium | 8.11 | $11 | $22 |
| 9 | Claude Haiku 5.5 | 7.81 | $18 | $36 |
| 10 | Claude Sonnet 5.5 | 7.68 | $334 | $668 |
El coste es para las 142 521 fotos al precio oficial de la API de cada proveedor.
Lo que usaría, según esta prueba:
- Si solo me importara la puntuación, GPT-6.1 Sol en esfuerzo max.
- Para mi propia biblioteca, GPT-6.1 Sol en medium. Obtuvo el 98 % de la mejor puntuación por $240, aproximadamente un tercio de lo que costaría Opus.
- Con presupuesto ajustado, GPT-6 Luna en max. Por $20 superó a Haiku, que cuesta lo mismo por token, y a Sonnet, que costaría unas 17 veces más para esta biblioteca.
- No Claude Sonnet 5.5: tiene un precio medio y la puntuación más baja.
Los modelos
| Proveedor | Modelo | Esfuerzo probado | Posicionamiento |
|---|---|---|---|
| Anthropic | Claude Opus 5.5 | por defecto (medium) | Buque insignia, uso diario |
| Anthropic | Claude Sonnet 5.5 | por defecto | Gama media |
| Anthropic | Claude Haiku 5.5 | por defecto | Rápido, de bajo coste |
| OpenAI | GPT-6 Astra | max, ultra | Modelo de frontera |
| OpenAI | GPT-6.1 Sol | medium, max, ultra | Caballo de batalla |
| OpenAI | GPT-6 Luna | medium, max | Rápido, de bajo coste |
Los precios se alinean entre los dos proveedores. GPT-6.1 Sol cuesta lo mismo por token que Claude Sonnet 5.5, GPT-6 Astra lo mismo que Claude Fable 5.1, y GPT-6 Luna lo mismo que Claude Haiku 5.5. Claude Opus 5.5 se sitúa entre Sol y Astra. Así que cuando dos modelos acaban con costes distintos abajo, es sobre todo porque uno de ellos usó más tokens para el mismo trabajo.
Los modelos de Claude se ejecutaron una vez cada uno con sus ajustes por defecto, lo que significa esfuerzo medium para Opus. Probé los modelos de GPT en varios niveles de esfuerzo. La comparación más justa es GPT-6.1 Sol en medium contra Claude Opus 5.5 en medium: 9,56 contra 8,57.
La prueba
Usé las 50 fotos más recientes de mi biblioteca en ese momento, sin vídeos. Son una semana corriente de mi carrete: momentos familiares en casa y de compras, vistas de la ciudad desde un piso alto, una tarjeta de memoria en mi escritorio, capturas de páginas de producto de componentes electrónicos, capturas de seguimiento de pedidos, una publicación en redes sociales, un cartel QR de descuento de aparcamiento y una etiqueta de cargador de coche eléctrico.
Cada modelo tenía cinco tareas por foto. Escribía un título corto y una descripción de una a tres frases en chino, daba de 5 a 12 palabras clave en chino e inglés, y elegía el mejor álbum de entre mis álbumes existentes, o ninguno. Luego daba una nota de calidad y decía si conservar o borrar la foto, buscando duplicados, tomas fallidas, capturas caducadas y fotos sin valor duradero. Cada modelo recibía las mismas instrucciones y el mismo contexto para cada foto, diez fotos a la vez.
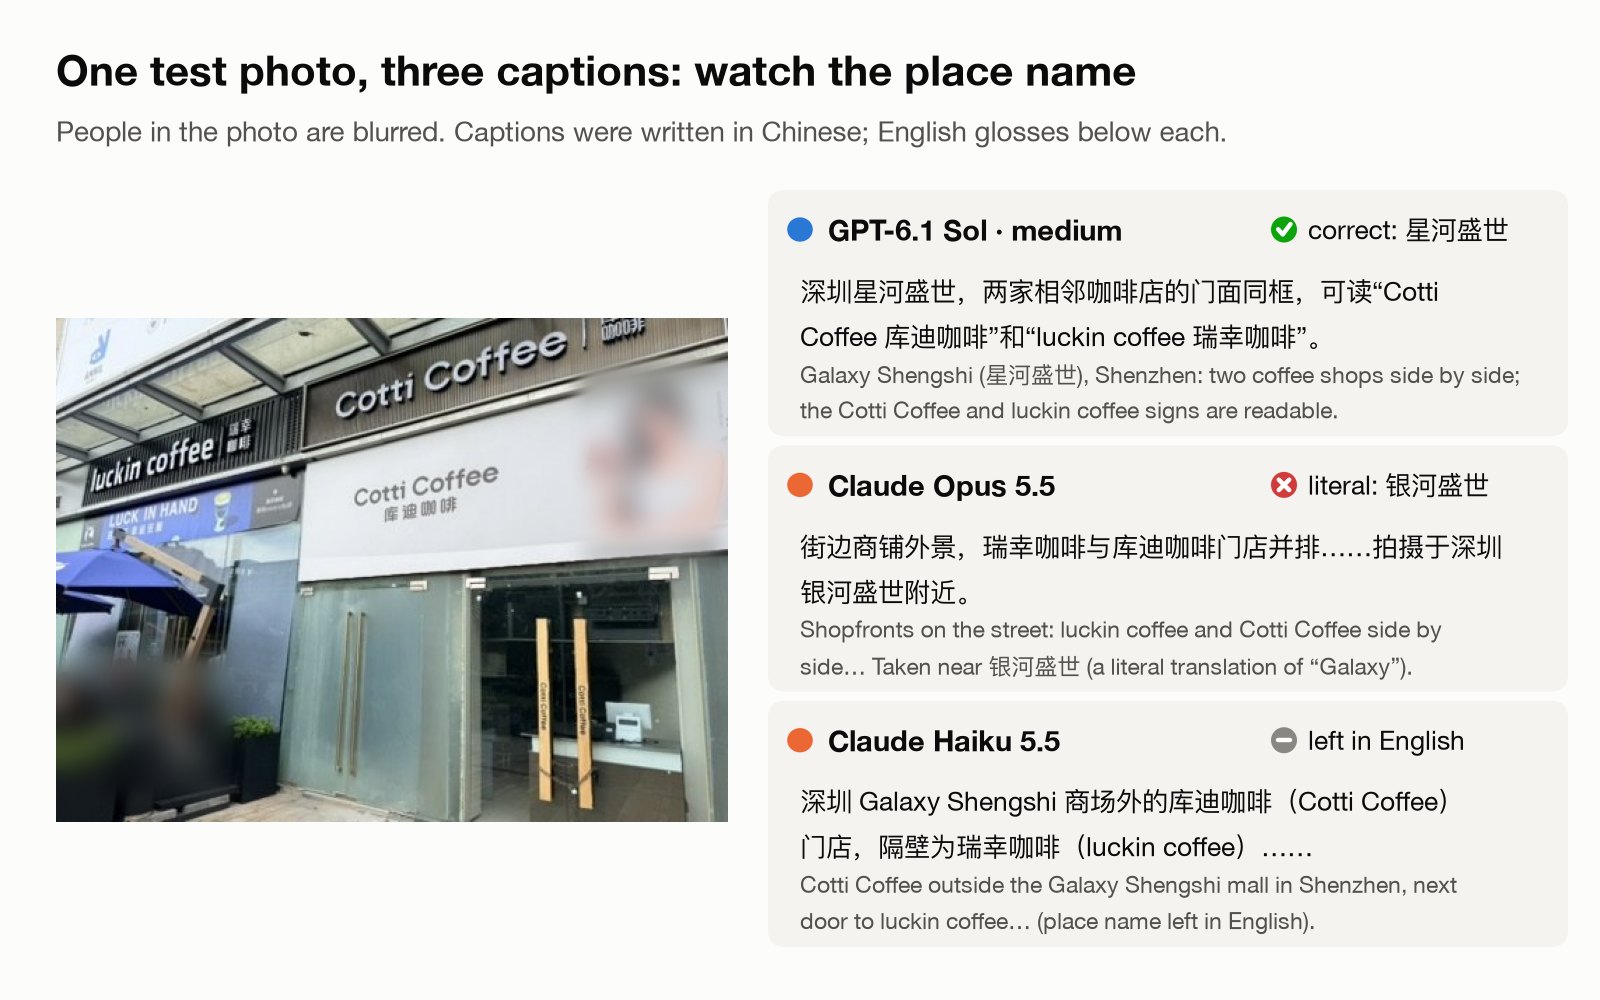 Figura 2. Una de las 50 fotos de prueba, con tres de las descripciones. Fíjese en cómo cada modelo trata el nombre del lugar; vuelvo a ello más abajo. Las personas de la foto están difuminadas.
Cómo lo puntué
No puntué las respuestas yo mismo. Ya había elegido un ganador antes de la prueba, y uso Claude a diario, así que no era neutral.
En su lugar, barajé las diez respuestas de cada foto y las etiqueté de la A a la J, con un orden aleatorio nuevo para cada foto. Dos evaluadores puntuaron entonces las 500 respuestas de forma independiente mientras miraban las fotos. Uno era Claude Fable 5.1, el modelo más capaz de Anthropic. El otro era GPT-6 Astra en esfuerzo xhigh, el modelo de frontera de OpenAI.
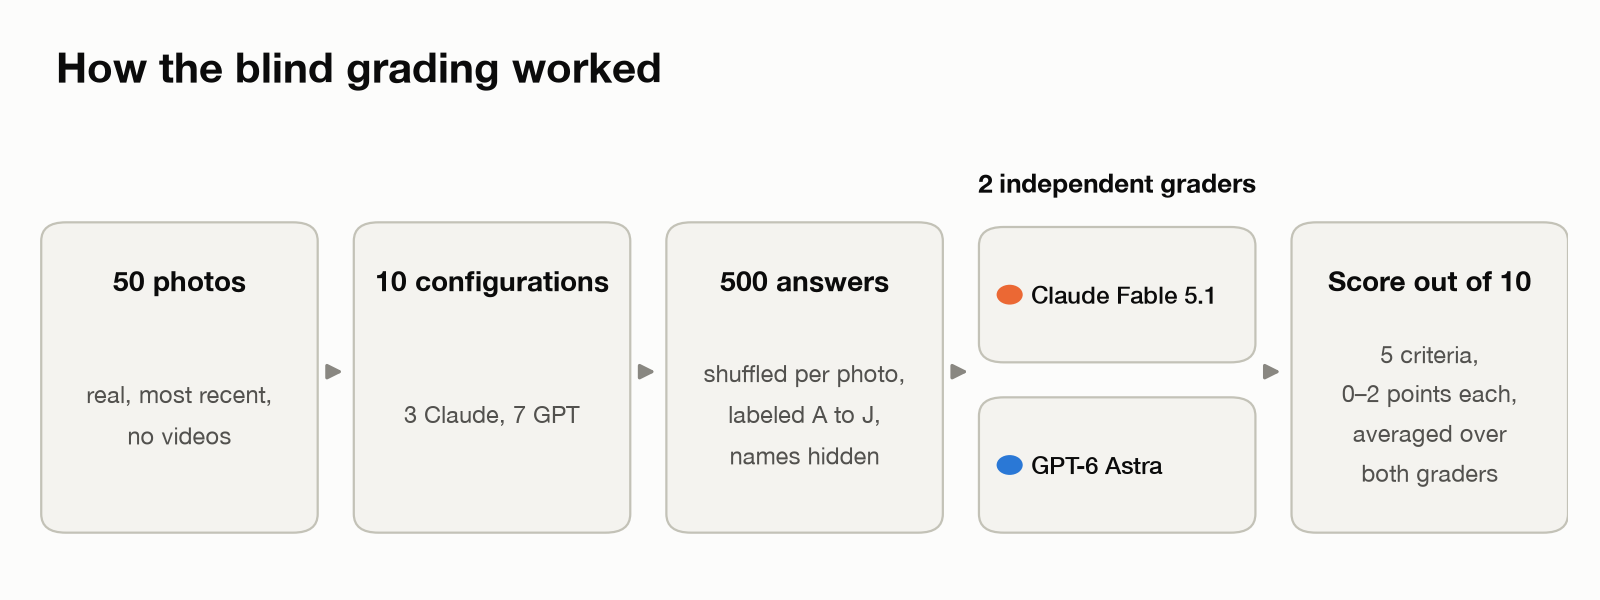 Figura 3. Cómo funcionaba la puntuación a ciegas.
Cada respuesta se puntuaba según cinco criterios, de 0 a 2 puntos cada uno, para un total de 10:
| Criterio | Qué comprobaba el evaluador |
|---|---|
| Hechos | ¿Son correctos el sujeto, el lugar y cualquier texto legible, incluidos los nombres de lugares locales? |
| Sin detalles inventados | ¿Evita la respuesta afirmar algo que la foto no muestra? |
| Criterio de borrado | ¿Es razonable conservar o borrar? Borrar una buena foto puntúa 0. |
| Encaje en el álbum | ¿Es correcto el álbum? Un álbum viejo equivocado puntúa 0; ningún álbum es un 1 aceptable. |
| Utilidad | ¿Me ayudarían el título, la descripción y las palabras clave a encontrar y recordar esta foto más tarde? |
Elegí un evaluador de cada proveedor para ver si alguno favorecería a sus propios modelos. Estuvieron bastante de acuerdo. La correlación entre las 500 puntuaciones emparejadas fue de 0,71, y ambos pusieron las mismas cinco configuraciones de GPT arriba. El evaluador de Claude también clasificó a GPT-6.1 Sol y GPT-6 Astra por encima de Claude Opus. El evaluador de GPT fue en general más estricto, y más estricto aún con los modelos de Claude.
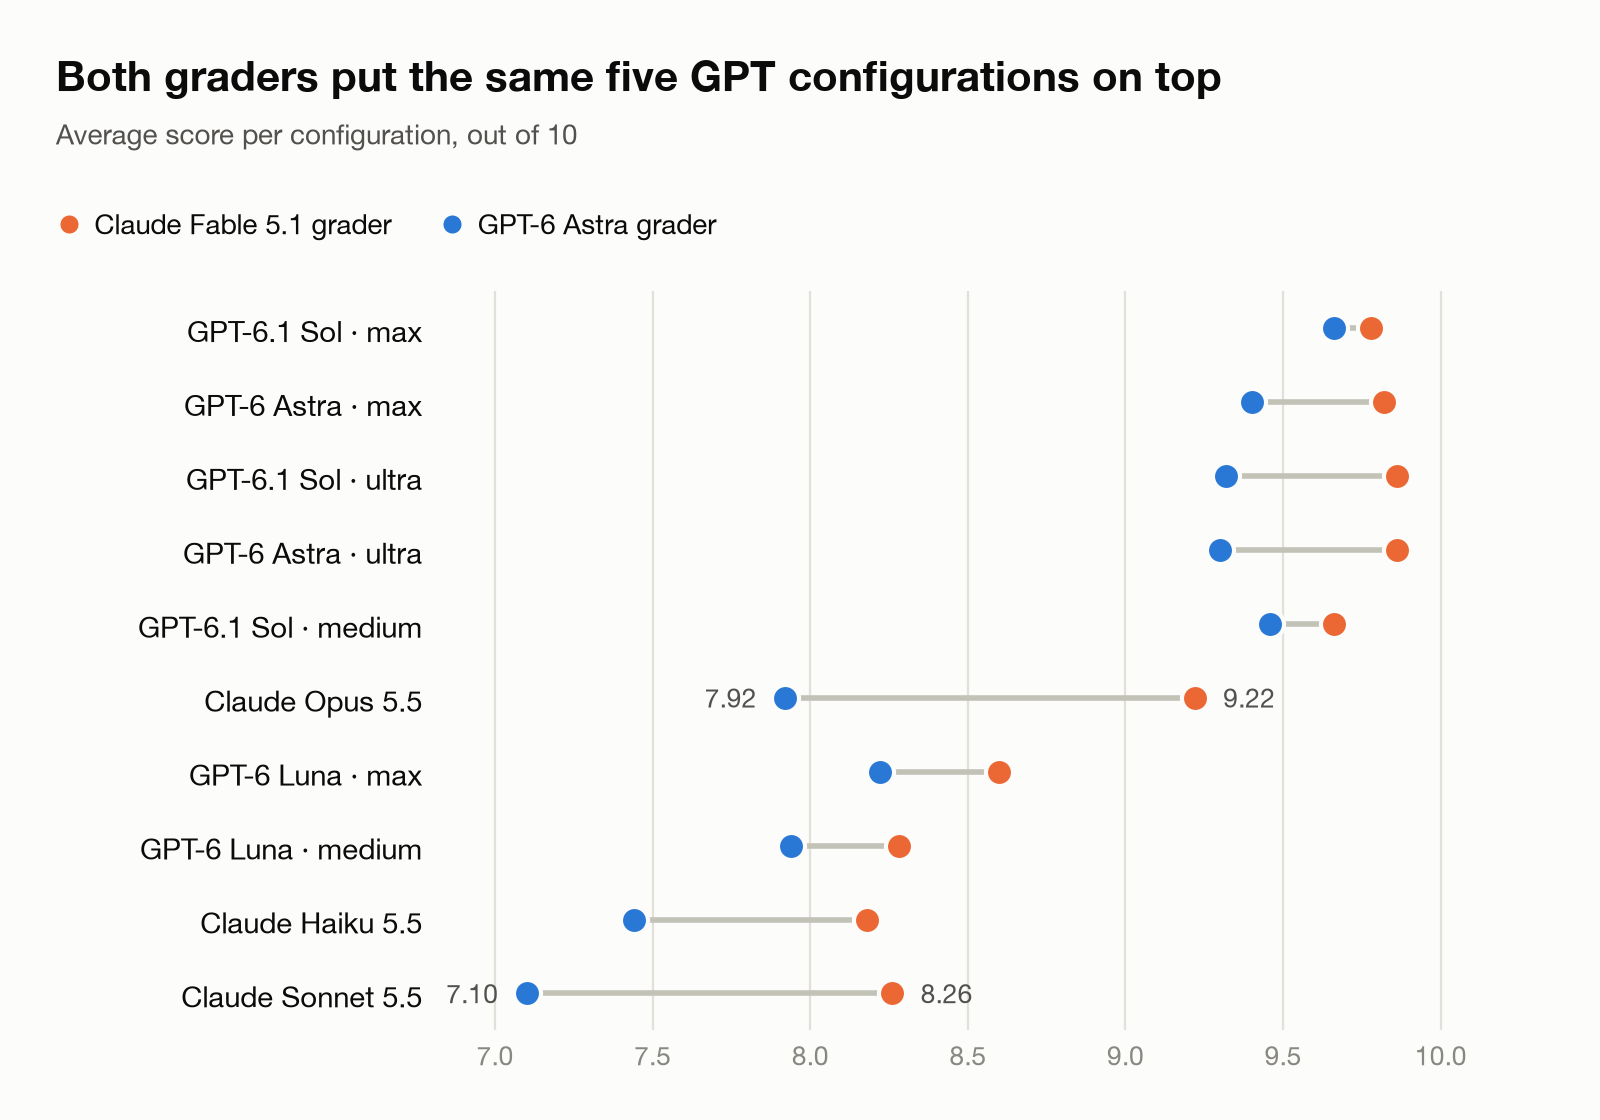 Figura 4. Puntuación media de cada evaluador por configuración.
Resultados
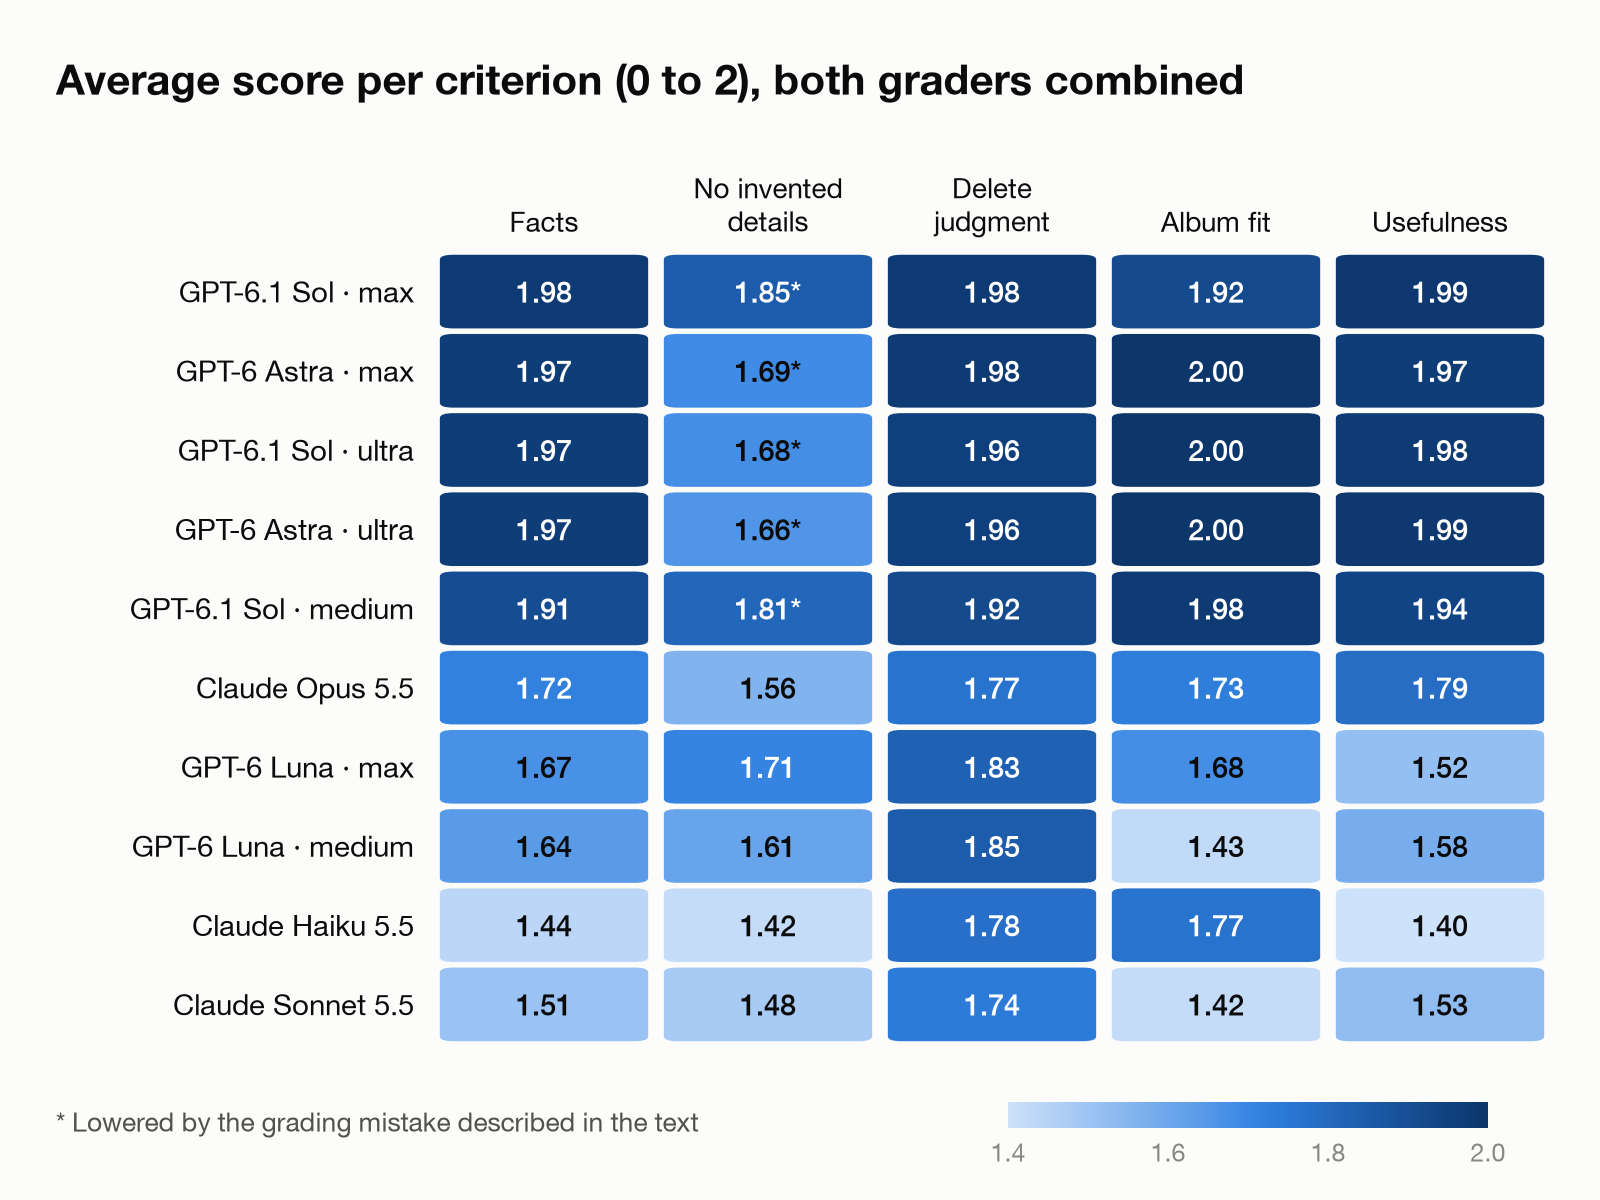 Figura 5. Puntuación media por criterio, ambos evaluadores combinados. Un asterisco marca las puntuaciones rebajadas por el error de puntuación que describo más abajo.
GPT-6.1 Sol y GPT-6 Astra
Sol y Astra leyeron el texto con precisión y en su mayoría limitaron sus descripciones a lo que mostraban las fotos. También fueron los mejores con los nombres de lugares locales, lo que importa para las fotos tomadas en China.
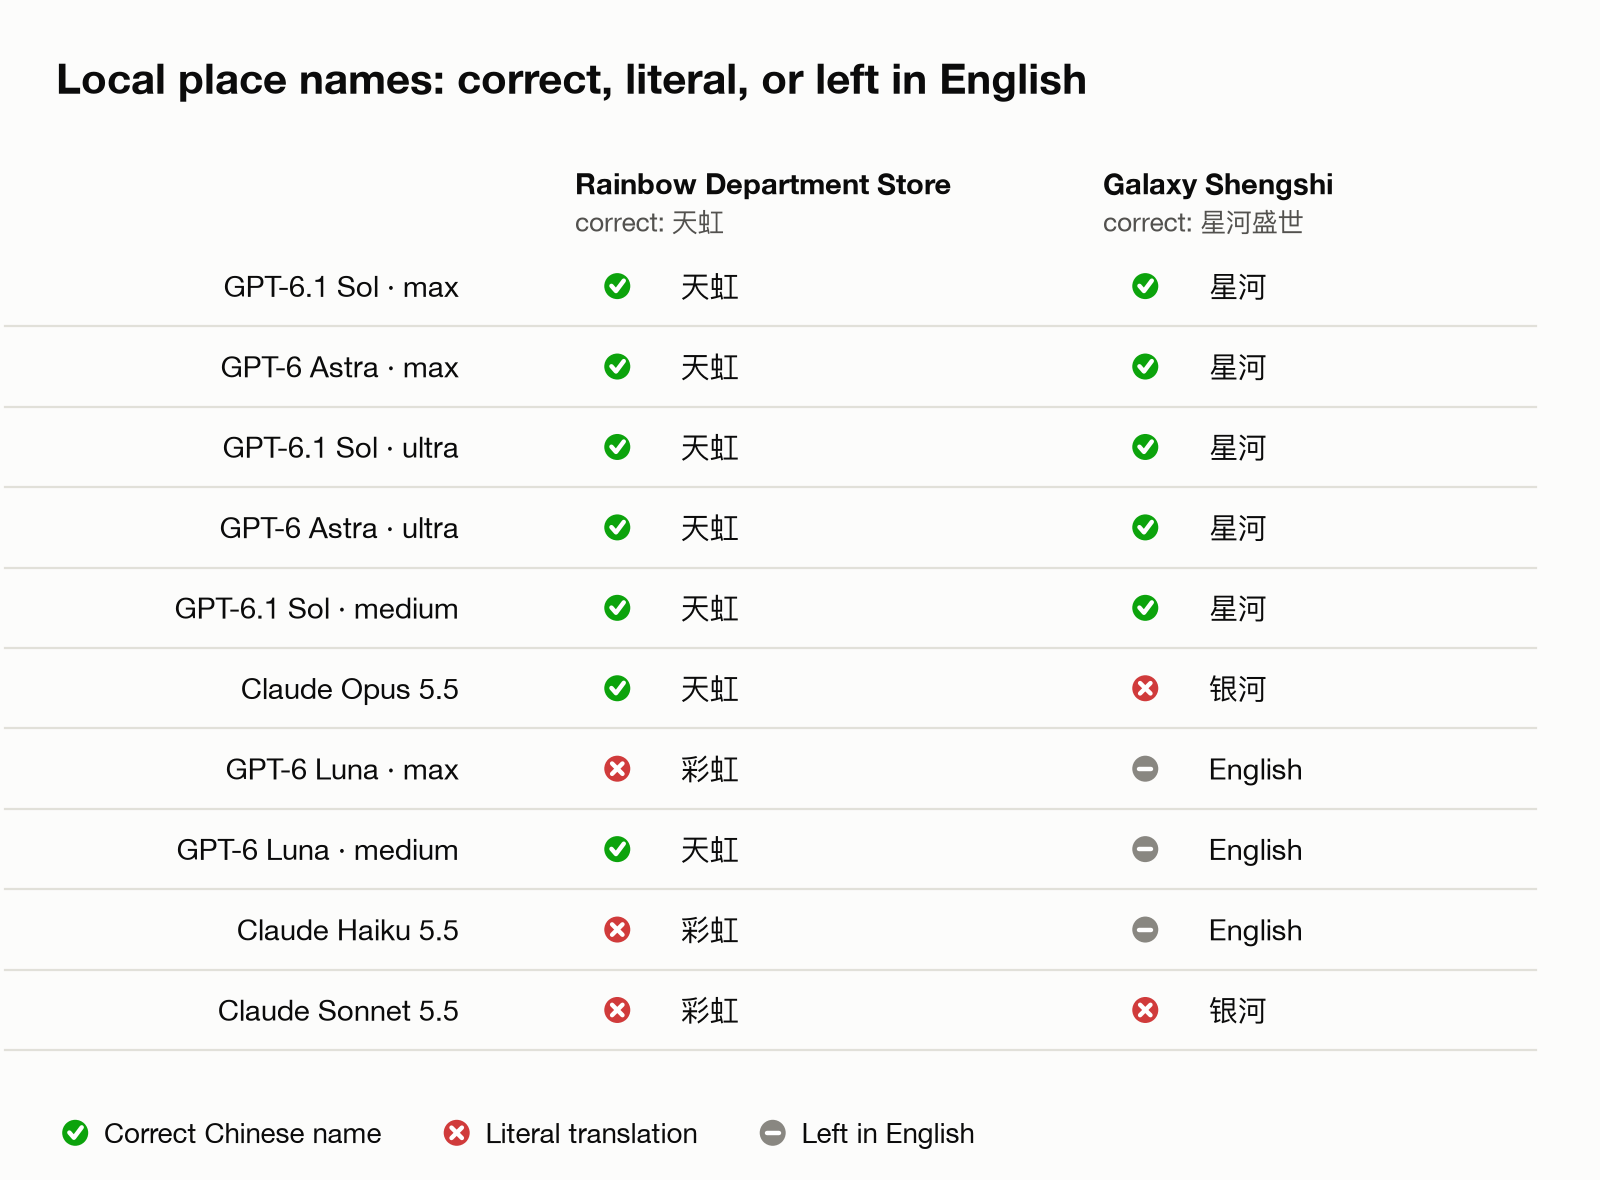 Figura 6. Dos pruebas de nombres locales. Una marca significa el nombre chino correcto, una cruz una traducción literal, y EN significa que el nombre se dejó en inglés.
Varias fotos estaban etiquetadas con el lugar «Rainbow Department Store». Es el nombre en inglés de la cadena de centros comerciales de Shenzhen 天虹. Una traducción palabra por palabra da 彩虹百货, que es incorrecto. Todas las configuraciones de Sol y Astra acertaron, al igual que Opus y Luna en medium. Haiku, Sonnet y Luna en max usaron la traducción literal. La foto de la cafetería de la Figura 2 estaba etiquetada como «Galaxy Shengshi», cuyo nombre chino es 星河盛世. Todas las configuraciones de Sol y Astra escribieron 星河. Opus y Sonnet lo tradujeron literalmente como 银河, y Haiku y ambas configuraciones de Luna lo dejaron en inglés.
Sol y Astra también fueron cuidadosos con el borrado. Sugirieron borrar de 4 a 6 de las 50 fotos. El conjunto incluía ocho capturas de páginas de producto de componentes electrónicos, y los modelos de GPT conservaron casi todas; una configuración de Sol marcó una única captura como casi duplicada. Los modelos de Claude marcaron de dos a cuatro cada uno. Ambos evaluadores estuvieron a favor de conservarlas, ya que las páginas contenían pines, dimensiones y fotos de placas que querré consultar más adelante.
Claude Opus 5.5
Opus a veces escribía en una descripción cosas que la foto por sí sola no puede mostrar. Describía relaciones que la imagen sola no puede probar, como hermanos o padre e hijo. También se equivocaba con algunas poses. En una foto, un niño estaba de pie detrás de un adulto, y Opus escribió que el niño estaba a la espalda del adulto. Ambos evaluadores restaron puntos por ello.
Esto me sorprendió. Antes de la prueba a ciegas, había repasado las respuestas y elogiado a Opus por adivinar correctamente que dos niños eran hermanos. Yo conozco a mi familia; el evaluador no. Pero con 142 000 fotos, no puedo comprobar cada descripción yo mismo, y una descripción que afirma algo que la foto no muestra es un problema.
Opus también sugirió la mayor cantidad de borrados, 13 de las 50 fotos. Tres de ellas eran capturas de páginas de producto que calificó de caducadas, aunque contenían información de referencia que yo conservaría. Fue el único modelo que quiso borrar el cartel QR de descuento de aparcamiento por ser de poco valor. También metió varias fotos de una sola persona en un álbum de «retrato de familia».
Claude Sonnet 5.5 y Haiku 5.5
Estos dos cometieron la mayoría de los errores factuales, incluida la traducción literal 彩虹. Sonnet hizo las peores elecciones de álbum y archivó fotos cotidianas en un álbum viejo de un evento sin relación. Haiku inventó un detalle que llevó a una mala decisión de borrado. En una ráfaga de tomas casi idénticas, describió el mejor encuadre como alguien que mira hacia abajo, lo contrario de lo que muestra la foto, y sugirió borrarlo.
GPT-6 Luna
Luna cuesta lo mismo por token que Haiku, pero puntuó más alto en ambos niveles de esfuerzo: 8,41 y 8,11, frente al 7,81 de Haiku. En esfuerzo max también superó a Sonnet, que costaría unas 17 veces más para describir la misma biblioteca. Luna perdió la mayoría de sus puntos en utilidad y elección de álbum. Sus descripciones eran más sencillas y sus álbumes menos precisos.
Niveles de esfuerzo
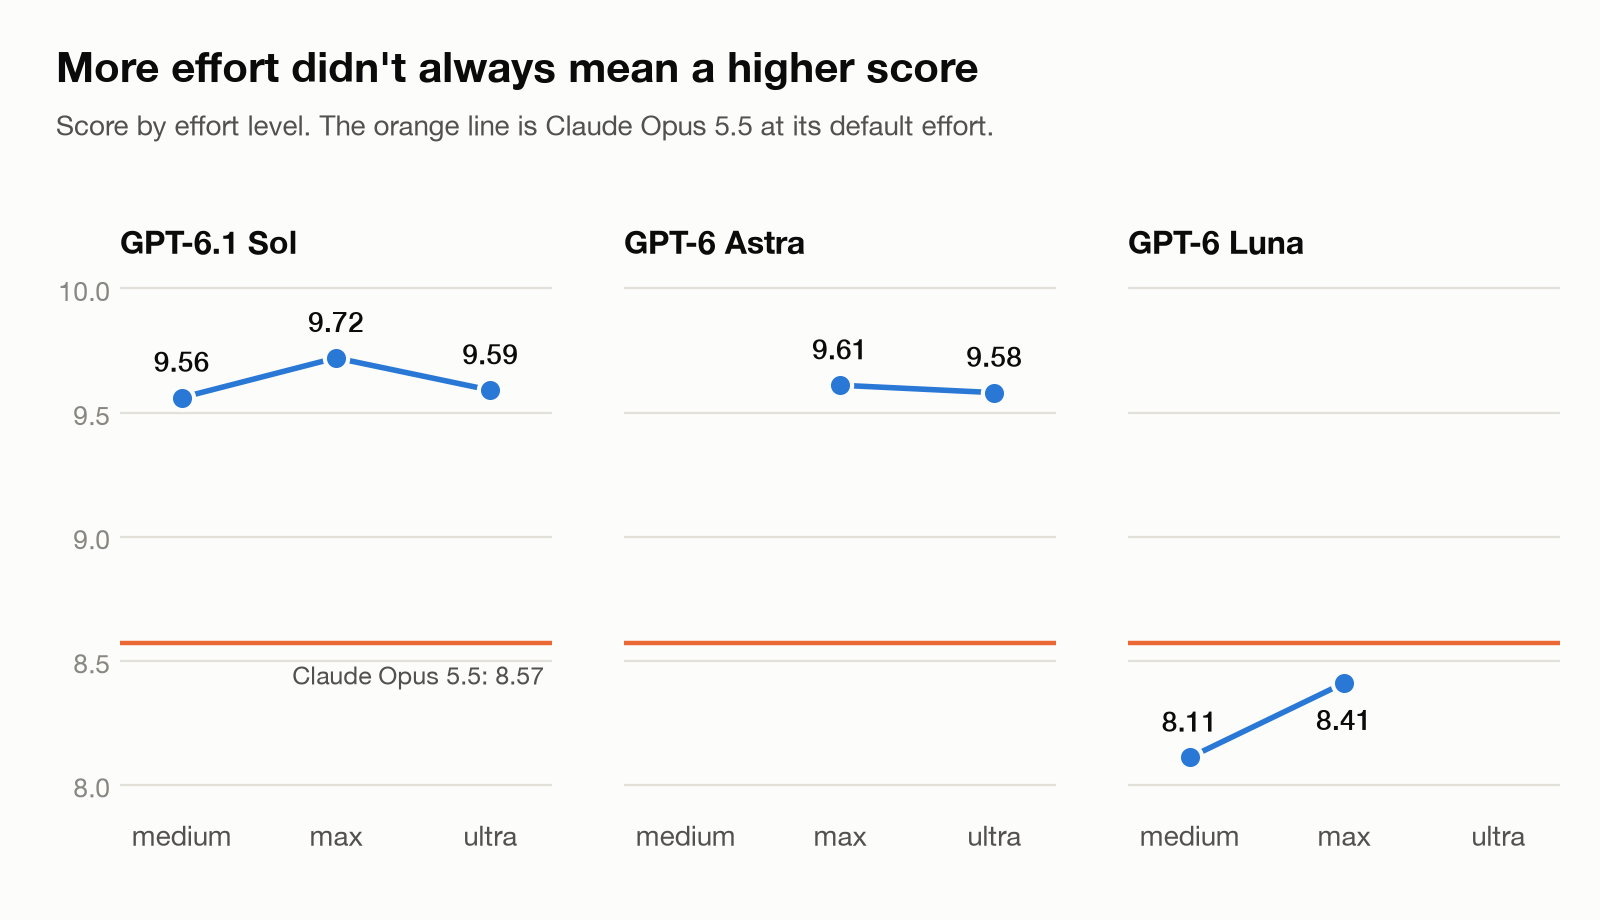 Figura 7. Puntuación por nivel de esfuerzo. La línea naranja es Claude Opus 5.5 en su esfuerzo por defecto.
Ultra no fue mejor que max para ninguno de los dos modelos. Sol puntuó 9,59 en ultra y 9,72 en max; Astra puntuó 9,58 y 9,61. En esta prueba, ultra incluso produjo menos tokens de salida que max. Para Sol, medium se quedó cerca con 9,56, por menos de la mitad del coste de max. Más esfuerzo tampoco significó siempre detalles más precisos: Luna en medium acertó 天虹, y Luna en max no.
Un error en mi puntuación
Después de puntuar, me di cuenta de que a los evaluadores no se les había dado la fecha y la hora de captura de cada foto, aunque los modelos de descripción sí las tenían. Así que el evaluador GPT-6 Astra trató las descripciones que mencionaban la fecha o la hora exacta como detalles inventados. Las mejores configuraciones de GPT mencionaban la fecha con más frecuencia, así que sus puntuaciones de «Sin detalles inventados» salieron más bajas de lo que deberían.
Si devuelvo solo los puntos perdidos por las fechas, las cuatro mejores configuraciones de GPT suben a entre 9,84 y 9,90, lo que en la práctica es un empate, y Opus se queda en 8,58. He mantenido las puntuaciones originales en este artículo. La próxima vez daré a los evaluadores todo lo que vieron los modelos.
Velocidad
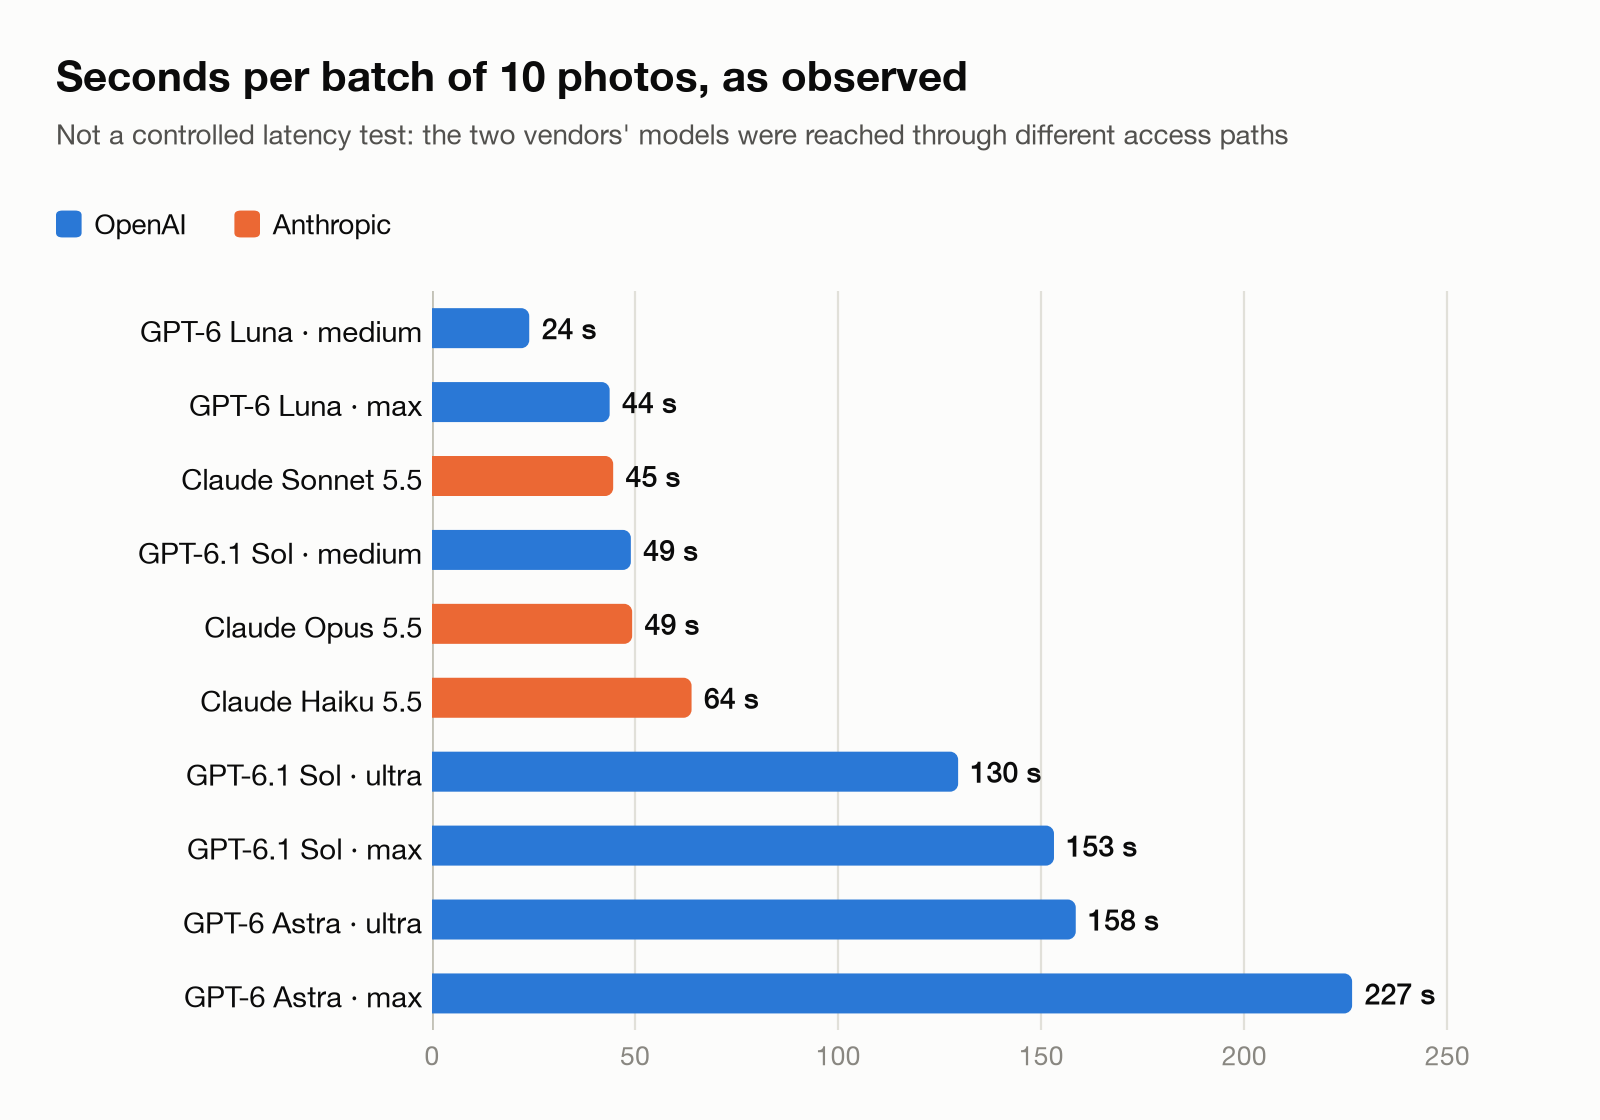 Figura 8. Segundos por lote de 10 fotos, tal como se observó. No es una prueba de latencia controlada, porque los modelos de los dos proveedores se alcanzaron por vías de acceso distintas.
Esto coincide con la sensación que me da Opus en mi trabajo diario: es rápido, unas tres veces más rápido que Sol en max. Sol en medium, sin embargo, era igual de rápido que Opus y puntuaba alrededor de un punto más.
Cuánto cuesta
Puse precio a cada configuración según los precios oficiales de la API de los proveedores. Tratar el uso incluido en un plan de suscripción como gratis haría parecer algunos modelos mejores de lo que son.
Precios oficiales por millón de tokens, nivel estándar:
| Modelo | Entrada | Salida |
|---|---|---|
| Claude Opus 5.5 | $4.00 | $20.00 |
| Claude Sonnet 5.5 | $2.00 | $10.00 |
| Claude Haiku 5.5 | $0.10 | $0.50 |
| GPT-6 Astra | $10.00 | $50.00 |
| GPT-6.1 Sol | $2.00 | $10.00 |
| GPT-6 Luna | $0.10 | $0.50 |
Las Batch API de ambos proveedores cuestan un 50 % menos, lo que conviene a una tarea como esta que no necesita respuestas instantáneas. Tomé los precios de la página de precios de Anthropic (claude.com/pricing) y de la página de precios de la API de OpenAI (developers.openai.com/api/docs/pricing) el 20 de octubre de 2026.
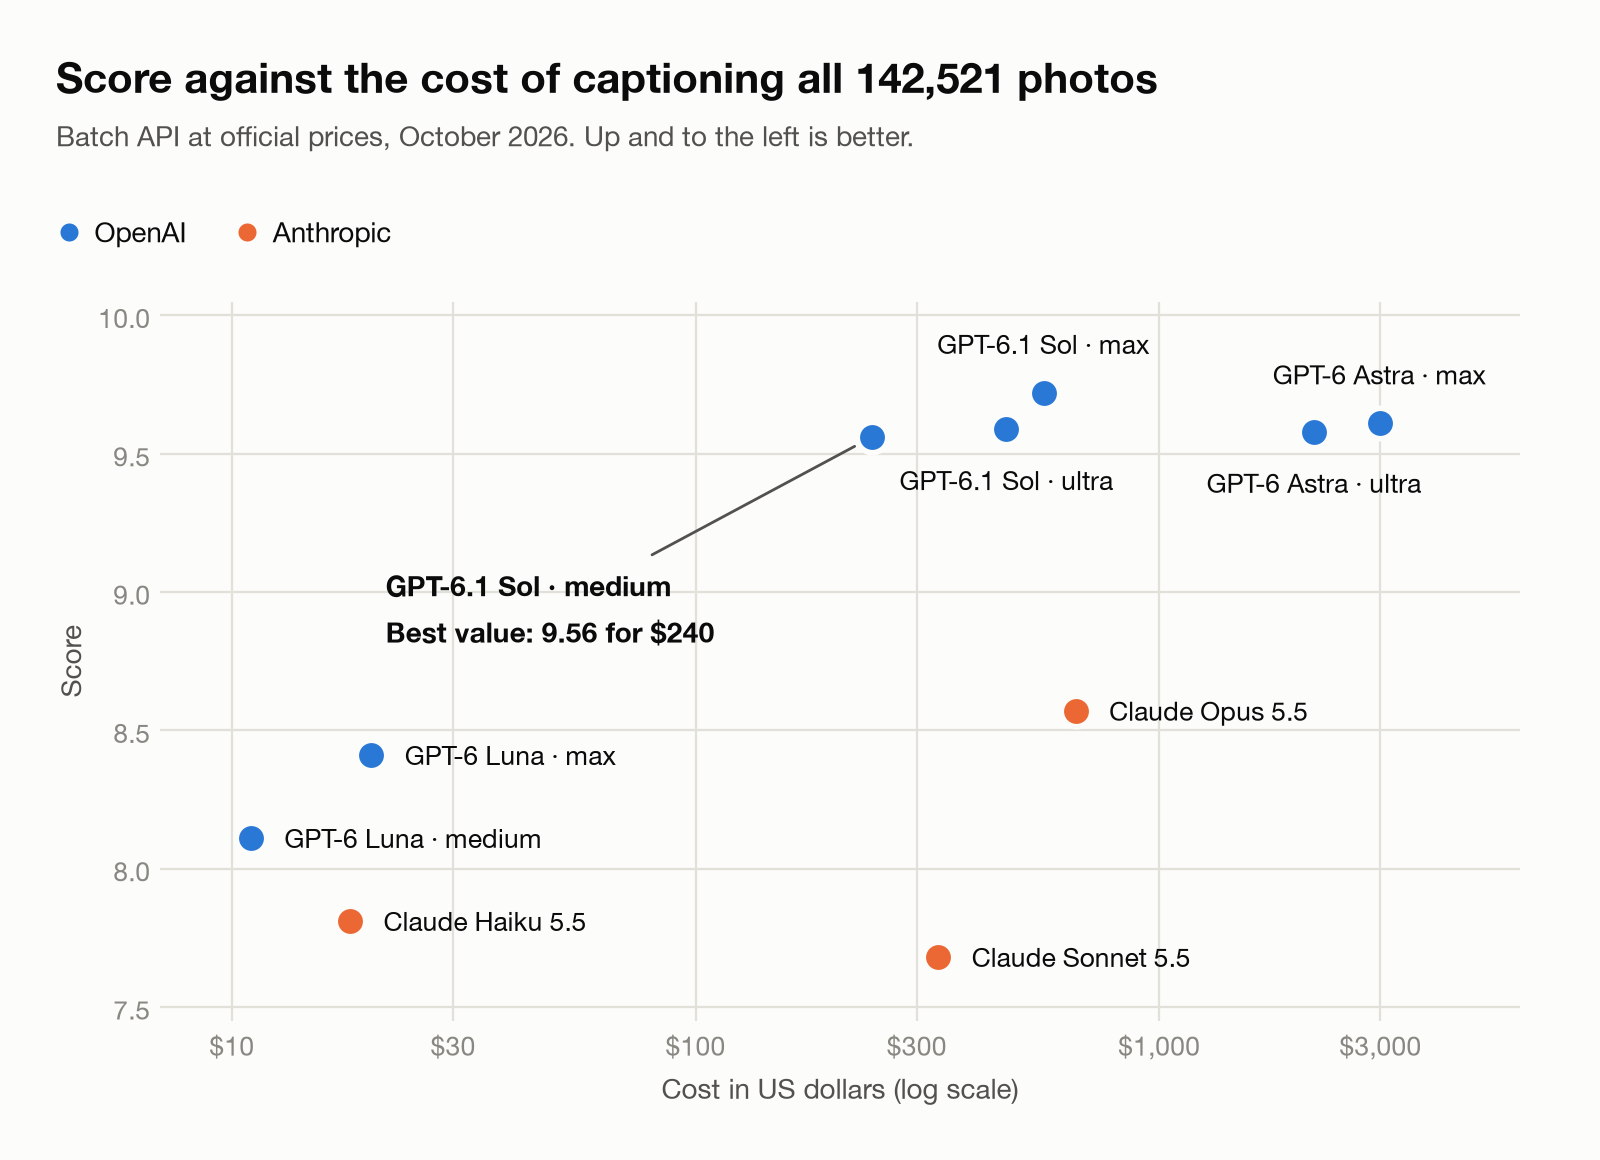 Figura 9. Puntuación frente al coste de describir toda la biblioteca a precios Batch. El eje de coste es logarítmico.
| Modelo y esfuerzo | Tokens de salida por foto | Estándar | Batch | Puntuación |
|---|---|---|---|---|
| GPT-6.1 Sol, medium | 193 | $479 | $240 | 9.56 |
| GPT-6.1 Sol, ultra | 514 | $937 | $468 | 9.59 |
| GPT-6.1 Sol, max | 647 | $1,126 | $563 | 9.72 |
| Claude Opus 5.5 | ~292 | $1,323 | $661 | 8.57 |
| Claude Sonnet 5.5 | ~297 | $668 | $334 | 7.68 |
| GPT-6 Astra, ultra | 462 | $4,313 | $2,156 | 9.58 |
| GPT-6 Astra, max | 695 | $5,973 | $2,987 | 9.61 |
| GPT-6 Luna, medium | 163 | $22 | $11 | 8.11 |
| Claude Haiku 5.5 | ~330 | $36 | $18 | 7.81 |
| GPT-6 Luna, max | 419 | $40 | $20 | 8.41 |
Sol en medium obtuvo el 98 % de la mejor puntuación por el 36 % de lo que costaría Opus y el 43 % de Sol en max. Astra igualó la calidad de Sol pero cuesta unas cinco veces más, porque su precio por token es cinco veces mayor. Opus costó más que Sol en max y puntuó más bajo. Ya funcionaba en esfuerzo medium, pero su precio por token es el doble que el de Sol. Luna describiría toda la biblioteca por $11 a $20 y aun así superaría a Haiku y Sonnet.
Nota de método: los recuentos de tokens de GPT se midieron a partir de las ejecuciones, y los de Claude se estimaron a partir de los registros de ejecución. Algunos tokens de razonamiento de Claude no eran visibles, por lo que los costes de Claude pueden estar ligeramente subestimados. No se aplicó a ningún modelo ningún descuento más allá de Batch, como el almacenamiento en caché de prompts.
Lo que aprendí
Elegí Opus antes de tener ninguna puntuación a ciegas, sobre todo porque ya era mi opción por defecto para programar. Sigo prefiriendo Claude Opus 5.5 para programar y para flujos de trabajo, donde en mi experiencia es más rápido y más fuerte. Describir fotos reales exige una habilidad distinta: leer lo que realmente hay en el encuadre sin rellenar poses ni relaciones. GPT-6.1 Sol lo hacía mejor. Si hubiera seguido la costumbre y me hubiera saltado la prueba a ciegas, habría pagado más por peores descripciones.
La próxima vez empezaré a ciegas y daré a los evaluadores de distintos proveedores todas las entradas que recibieron los modelos de descripción. También seguiré comparando a precios oficiales de la API, y no asumiré que más esfuerzo es mejor: ultra no superó a max aquí.
Incluso los mejores modelos marcaron fotos útiles para borrar, así que comprobaré cada marca de borrado yo mismo antes de eliminar nada.
Limitaciones
Esta fue una prueba pequeña: 50 fotos recientes de una sola ciudad. No probé fotos más antiguas, documentos escaneados, otros idiomas ni vídeos. Los modelos de Claude solo funcionaron con sus ajustes por defecto; un Opus con más esfuerzo podría puntuar mejor, a un coste mayor. Los evaluadores son modelos de IA, no personas. Estuvieron de acuerdo bien pero no perfectamente, y una verificación puntual humana haría el resultado más sólido. Los modelos y los precios cambian rápido, y cada cifra aquí es de octubre de 2026.
Mi elección
Para mi biblioteca: GPT-6.1 Sol en esfuerzo medium. Para programar y flujos de trabajo, me quedo con Claude Opus 5.5.