
Ik testte 10 AI-modellen blind op mijn bibliotheek van 142,000 foto's: GPT-6.1 Sol versloeg Claude Opus
Samenvatting
Ik gebruik Claude Opus 5.5 dagelijks voor code en workflows, en voor dat werk vind ik hem sneller en beter dan GPT-6. Ik nam aan dat hij ook het beste zou zijn in het beschrijven van foto's, dus testte ik het. Ik draaide tien configuraties: Claude Haiku, Sonnet en Opus 5.5, plus OpenAI's GPT-6.1 Sol, GPT-6 Astra en GPT-6 Luna op meerdere inspanningsniveaus. Elk daarvan gaf 50 echte foto's uit mijn bibliotheek van 142,521 foto's een titel, bijschrift, trefwoorden en een album, en markeerde de foto's die volgens hem weg konden. Twee blinde beoordelaars van verschillende leveranciers, Claude Fable 5.1 en GPT-6 Astra, scoorden alle 500 antwoorden op feiten, verzonnen details, verwijderoordeel, albumkeuze en bruikbaarheid. GPT-6.1 Sol scoorde het hoogst met 9.72 op 10. Opus scoorde 8.57, en Sonnet en Haiku kwamen uit op 7.7 tot 7.8. Ultra-inspanning was niet beter dan max. Tegen officiële Batch API-prijzen kost het ondertitelen van de hele bibliotheek ongeveer $240 met Sol op medium-inspanning (9.56), $661 met Opus en $11 tot $20 met Luna, die Haiku nog steeds overtrof.
Waarom ik dit testte
Het grootste deel van mijn dag gaat naar code, agent-workflows en automatisering, en Claude Opus 5.5 is het model waar ik naar grijp. Voor dat soort werk voelt hij voor mij sneller en beter dan GPT-6. Dus toen ik besloot om AI mijn fotobibliotheek te laten ondertitelen en taggen, koos ik zonder aarzelen voor Opus.
De bibliotheek is 25 jaar van mijn leven: 142,521 foto's, van vroege digitale-camerabeelden tot telefoonfoto's van vorige week, plus meer dan 16,000 schermafbeeldingen. Bijna geen enkele heeft een bijschrift. Ik wil dat elke foto een titel heeft, een bijschrift, trefwoorden waarop ik kan zoeken, een zinnig album en een eerlijke markering als het een duplicaat of rommel is. Voordat ik betaal voor het verwerken van 142,000 foto's, wilde ik weten welk model dit het beste doet en wat het verschil kost.
Ik verwachtte dat Opus zou winnen. Op deze 50 foto's scoorde GPT-6.1 Sol meer dan een punt hoger.
Resultaten in één oogopslag
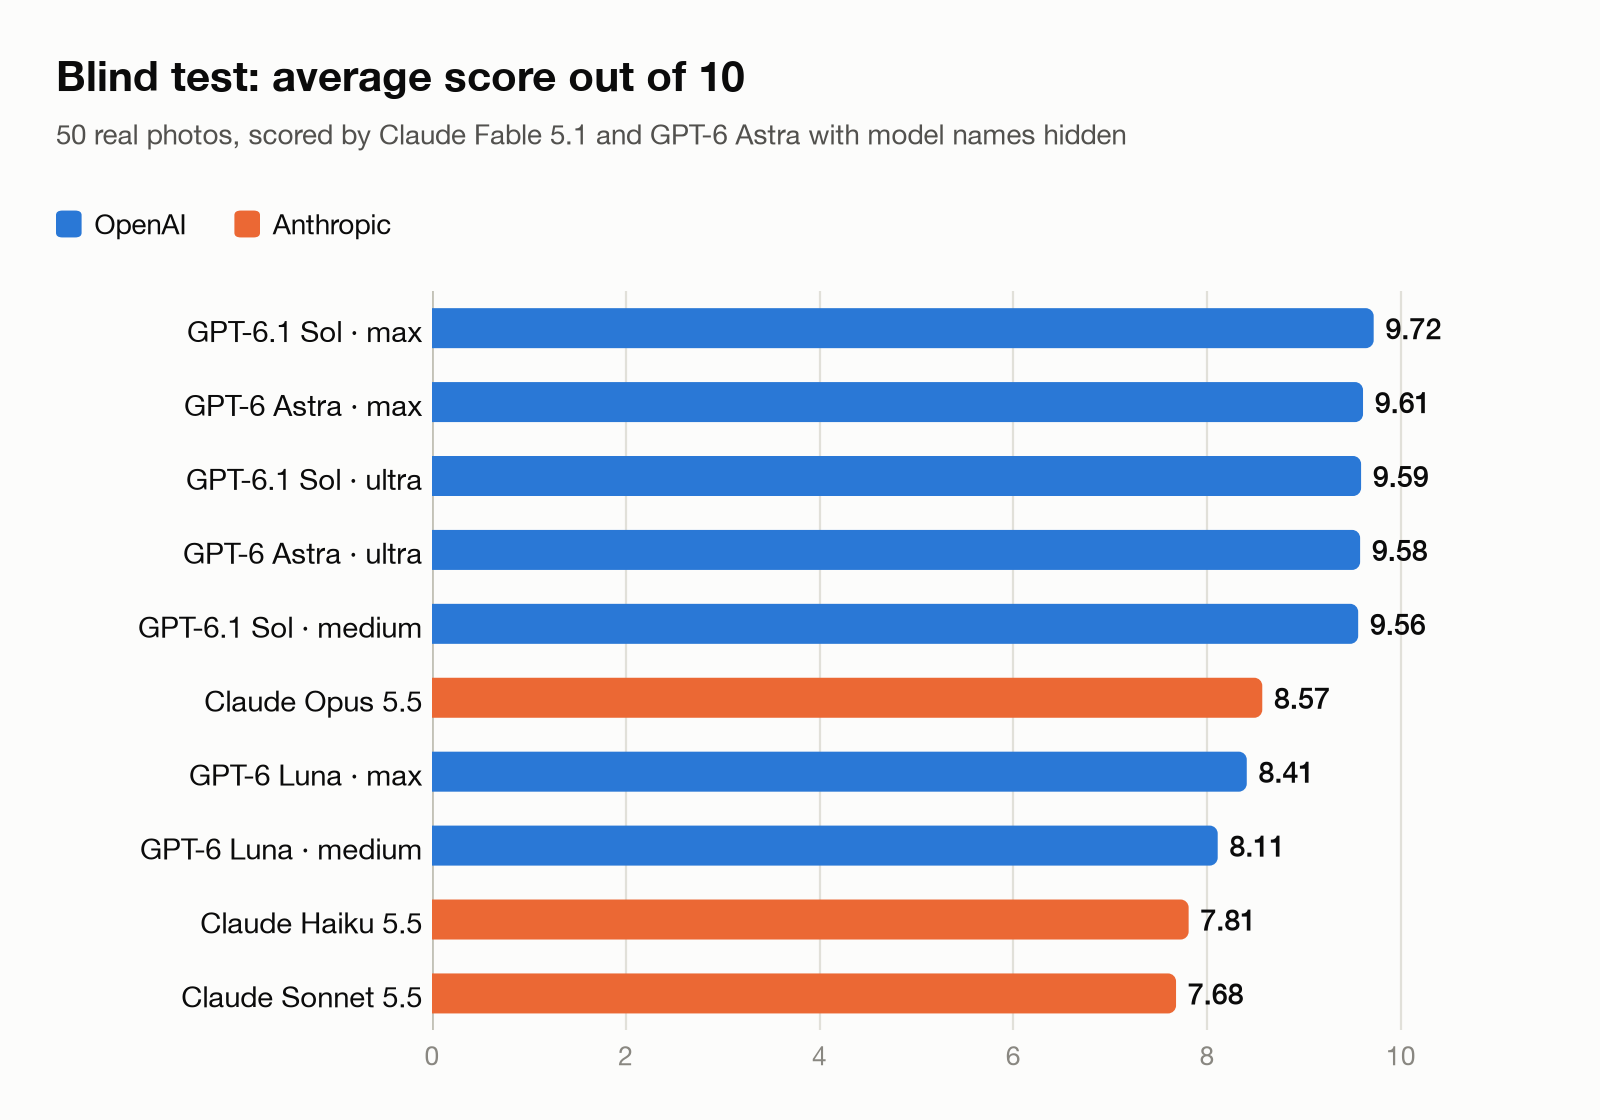 Figuur 1. Gemiddelde score van twee blinde beoordelaars, op 10.
| Rang | Model en inspanning | Score (op 10) | Hele bibliotheek, Batch API | Hele bibliotheek, standaard API |
|---|---|---|---|---|
| 1 | GPT-6.1 Sol, max | 9.72 | $563 | $1,126 |
| 2 | GPT-6 Astra, max | 9.61 | $2,987 | $5,973 |
| 3 | GPT-6.1 Sol, ultra | 9.59 | $468 | $937 |
| 4 | GPT-6 Astra, ultra | 9.58 | $2,156 | $4,313 |
| 5 | GPT-6.1 Sol, medium | 9.56 | $240 | $479 |
| 6 | Claude Opus 5.5 | 8.57 | $661 | $1,323 |
| 7 | GPT-6 Luna, max | 8.41 | $20 | $40 |
| 8 | GPT-6 Luna, medium | 8.11 | $11 | $22 |
| 9 | Claude Haiku 5.5 | 7.81 | $18 | $36 |
| 10 | Claude Sonnet 5.5 | 7.68 | $334 | $668 |
Kosten voor alle 142,521 foto's tegen de officiële API-prijs van elke leverancier.
Wat ik zou gebruiken, op basis van deze test:
- Als ik alleen om de score gaf, GPT-6.1 Sol op max-inspanning.
- Voor mijn eigen bibliotheek, GPT-6.1 Sol op medium. Die haalde 98% van de topscore voor $240, ongeveer een derde van wat Opus zou kosten.
- Met een krap budget, GPT-6 Luna op max. Voor $20 versloeg hij Haiku, die evenveel per token kost, en Sonnet, die voor deze bibliotheek ongeveer 17 keer zoveel zou kosten.
- Niet Claude Sonnet 5.5. Die is middelhoog geprijsd en had de laagste score.
De modellen
| Leverancier | Model | Geteste inspanning | Positionering |
|---|---|---|---|
| Anthropic | Claude Opus 5.5 | standaard (medium) | Vlaggenschip voor dagelijks gebruik |
| Anthropic | Claude Sonnet 5.5 | standaard | Middensegment |
| Anthropic | Claude Haiku 5.5 | standaard | Snel, lage kosten |
| OpenAI | GPT-6 Astra | max, ultra | Frontiermodel |
| OpenAI | GPT-6.1 Sol | medium, max, ultra | Werkpaard |
| OpenAI | GPT-6 Luna | medium, max | Snel, lage kosten |
De prijzen van de twee leveranciers lopen gelijk. GPT-6.1 Sol kost evenveel per token als Claude Sonnet 5.5, GPT-6 Astra evenveel als Claude Fable 5.1 en GPT-6 Luna evenveel als Claude Haiku 5.5. Claude Opus 5.5 zit tussen Sol en Astra in. Dus als twee modellen hieronder op verschillende kosten uitkomen, komt dat vooral doordat een van beide meer tokens gebruikte voor hetzelfde werk.
De Claude-modellen draaiden elk één keer op hun standaardinstellingen, wat voor Opus medium-inspanning betekent. De GPT-modellen testte ik op meerdere inspanningsniveaus. De dichtstbijzijnde gelijke vergelijking is GPT-6.1 Sol op medium tegen Claude Opus 5.5 op medium: 9.56 tegen 8.57.
De test
Ik gebruikte de 50 meest recente foto's in mijn bibliotheek op dat moment, zonder video's. Het is een gewone week uit mijn camerarol: familiemomenten thuis en tijdens het winkelen, stadsgezichten vanaf een hoge verdieping, een geheugenkaart op mijn bureau, productpagina-screenshots van elektronische onderdelen, screenshots van order-tracking, een socialmediapost, een QR-bord voor parkeerkorting en een label van een EV-lader.
Elk model had vijf taken voor elke foto. Het schreef een korte titel en een bijschrift van één tot drie zinnen in het Chinees, gaf 5 tot 12 trefwoorden in het Chinees en Engels en koos het beste album uit mijn bestaande albums, of geen. Daarna gaf het een kwaliteitsscore en zei het of de foto bewaard of verwijderd moest worden, op zoek naar duplicaten, mislukte opnamen, verlopen schermafbeeldingen en foto's zonder blijvende waarde. Elk model kreeg dezelfde instructies en dezelfde context voor elke foto, tien foto's tegelijk.
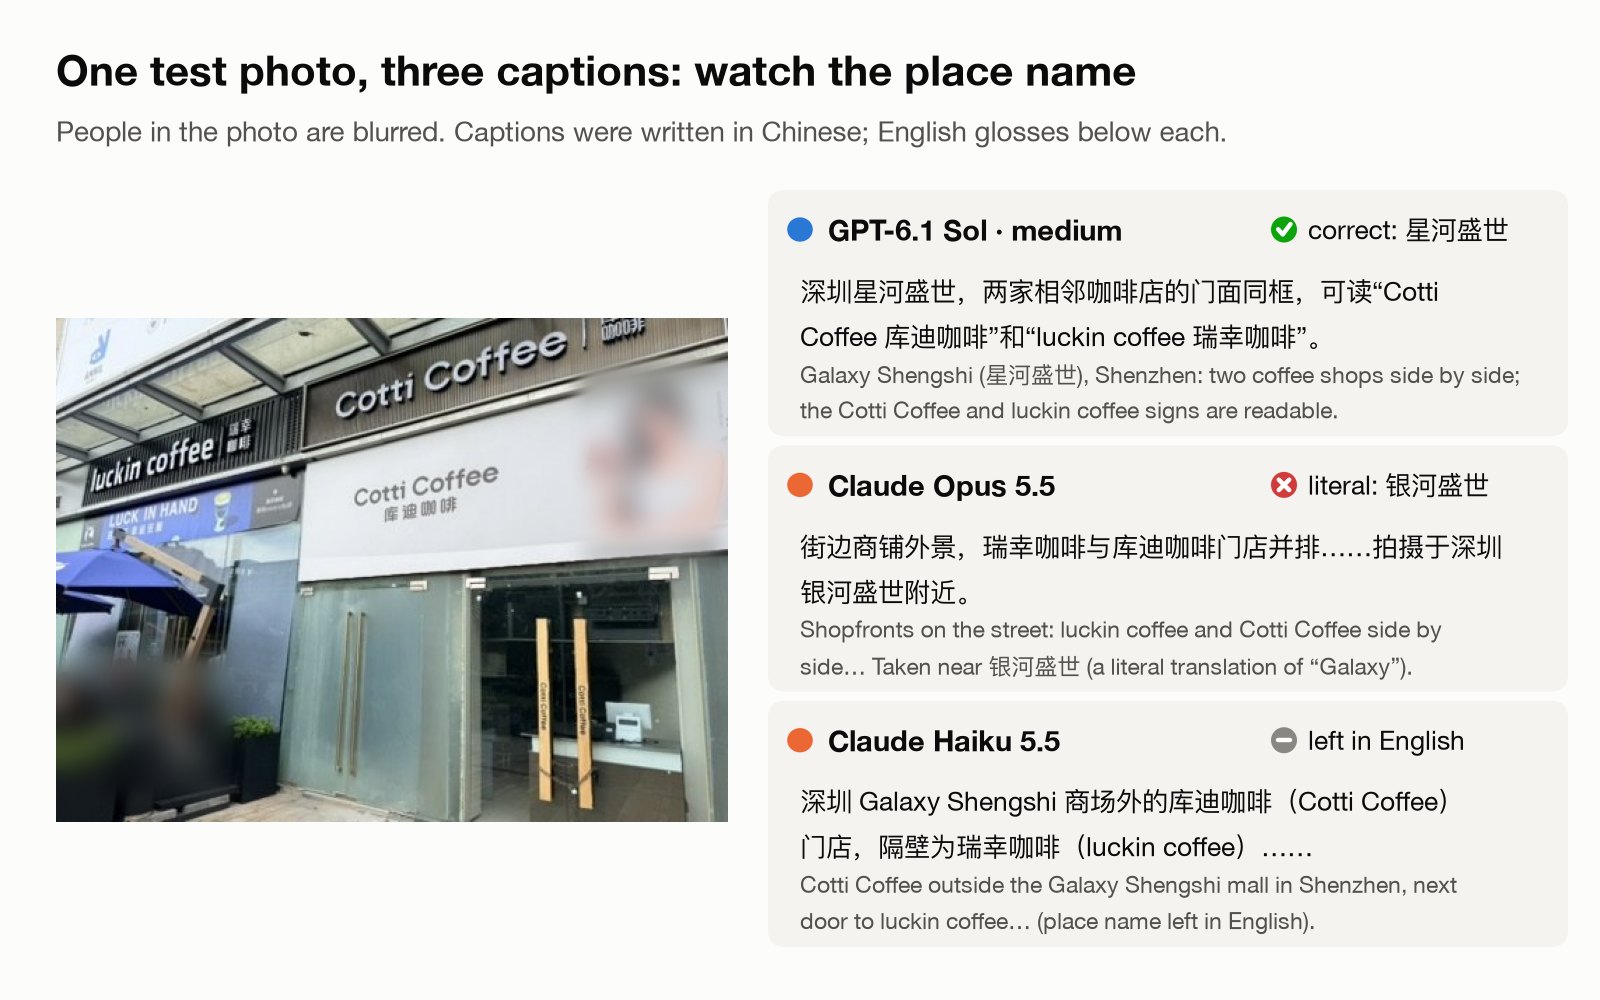 Figuur 2. Een van de 50 testfoto's, met drie van de bijschriften. Let op hoe elk model omgaat met de plaatsnaam; daar kom ik hieronder op terug. Mensen op de foto zijn vervaagd.
Hoe ik beoordeelde
Ik beoordeelde de antwoorden niet zelf. Ik had vóór de test al een winnaar gekozen en gebruik Claude dagelijks, dus ik was niet neutraal.
In plaats daarvan schudde ik de tien antwoorden van elke foto door elkaar en labelde ze A tot en met J, met een nieuwe willekeurige volgorde voor elke foto. Twee beoordelaars scoorden vervolgens alle 500 antwoorden onafhankelijk, terwijl ze naar de foto's keken. De ene was Claude Fable 5.1, het krachtigste model van Anthropic. De andere was GPT-6 Astra op xhigh-inspanning, het frontiermodel van OpenAI.
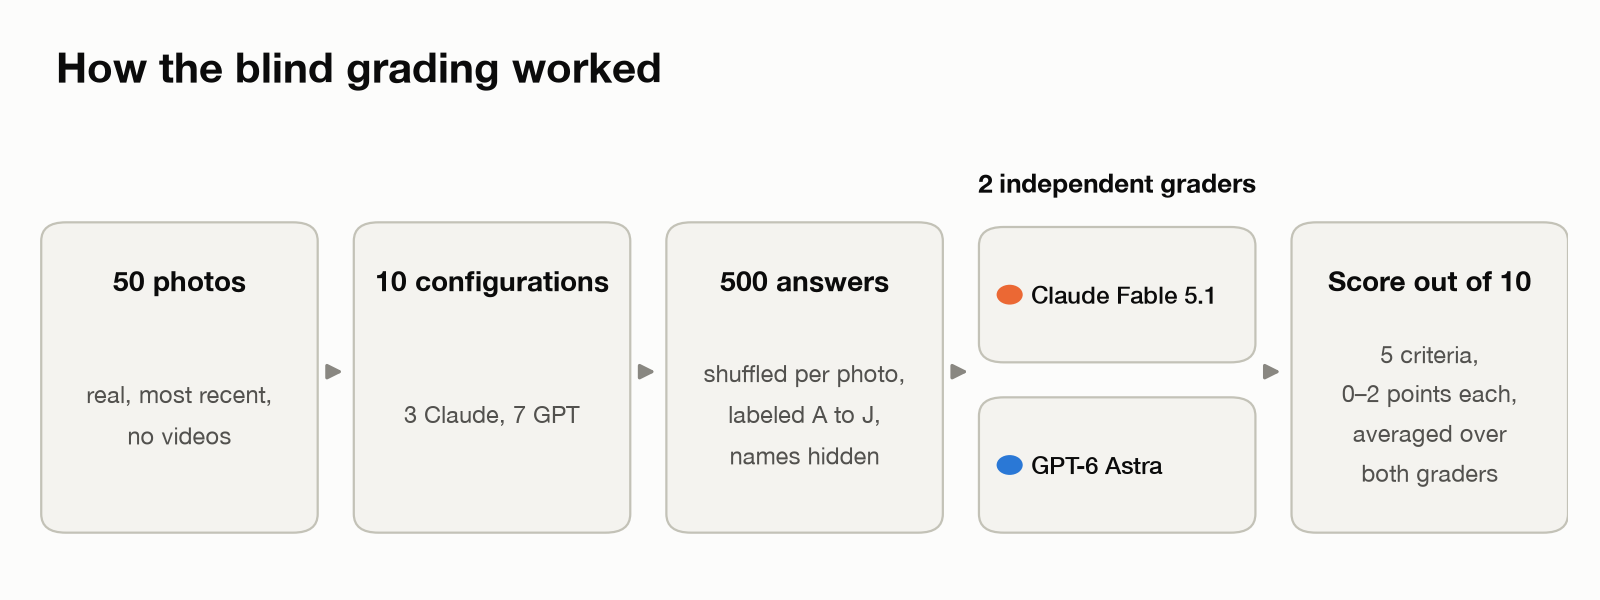 Figuur 3. Hoe de blinde beoordeling werkte.
Elk antwoord werd gescoord op vijf criteria, elk 0 tot 2 punten, in totaal 10:
| Criterium | Wat de beoordelaar controleerde |
|---|---|
| Feiten | Kloppen het onderwerp, de plaats en eventuele leesbare tekst, inclusief lokale plaatsnamen? |
| Geen verzonnen details | Vermijdt het antwoord iets te beweren dat de foto niet toont? |
| Verwijderoordeel | Is bewaren of verwijderen redelijk? Een goede foto verwijderen scoort 0. |
| Albumkeuze | Is het album juist? Een verkeerd oud album scoort 0; geen album is een acceptabele 1. |
| Bruikbaarheid | Zouden de titel, het bijschrift en de trefwoorden me later helpen deze foto te vinden en te herinneren? |
Ik koos één beoordelaar per leverancier om te zien of een van beide zijn eigen modellen zou bevoordelen. Ze waren het grotendeels eens. De correlatie over de 500 gepaarde scores was 0.71, en beiden zetten dezelfde vijf GPT-configuraties bovenaan. De Claude-beoordelaar zette GPT-6.1 Sol en GPT-6 Astra ook boven Claude Opus. De GPT-beoordelaar was over het algemeen strenger, en het strengst voor de Claude-modellen.
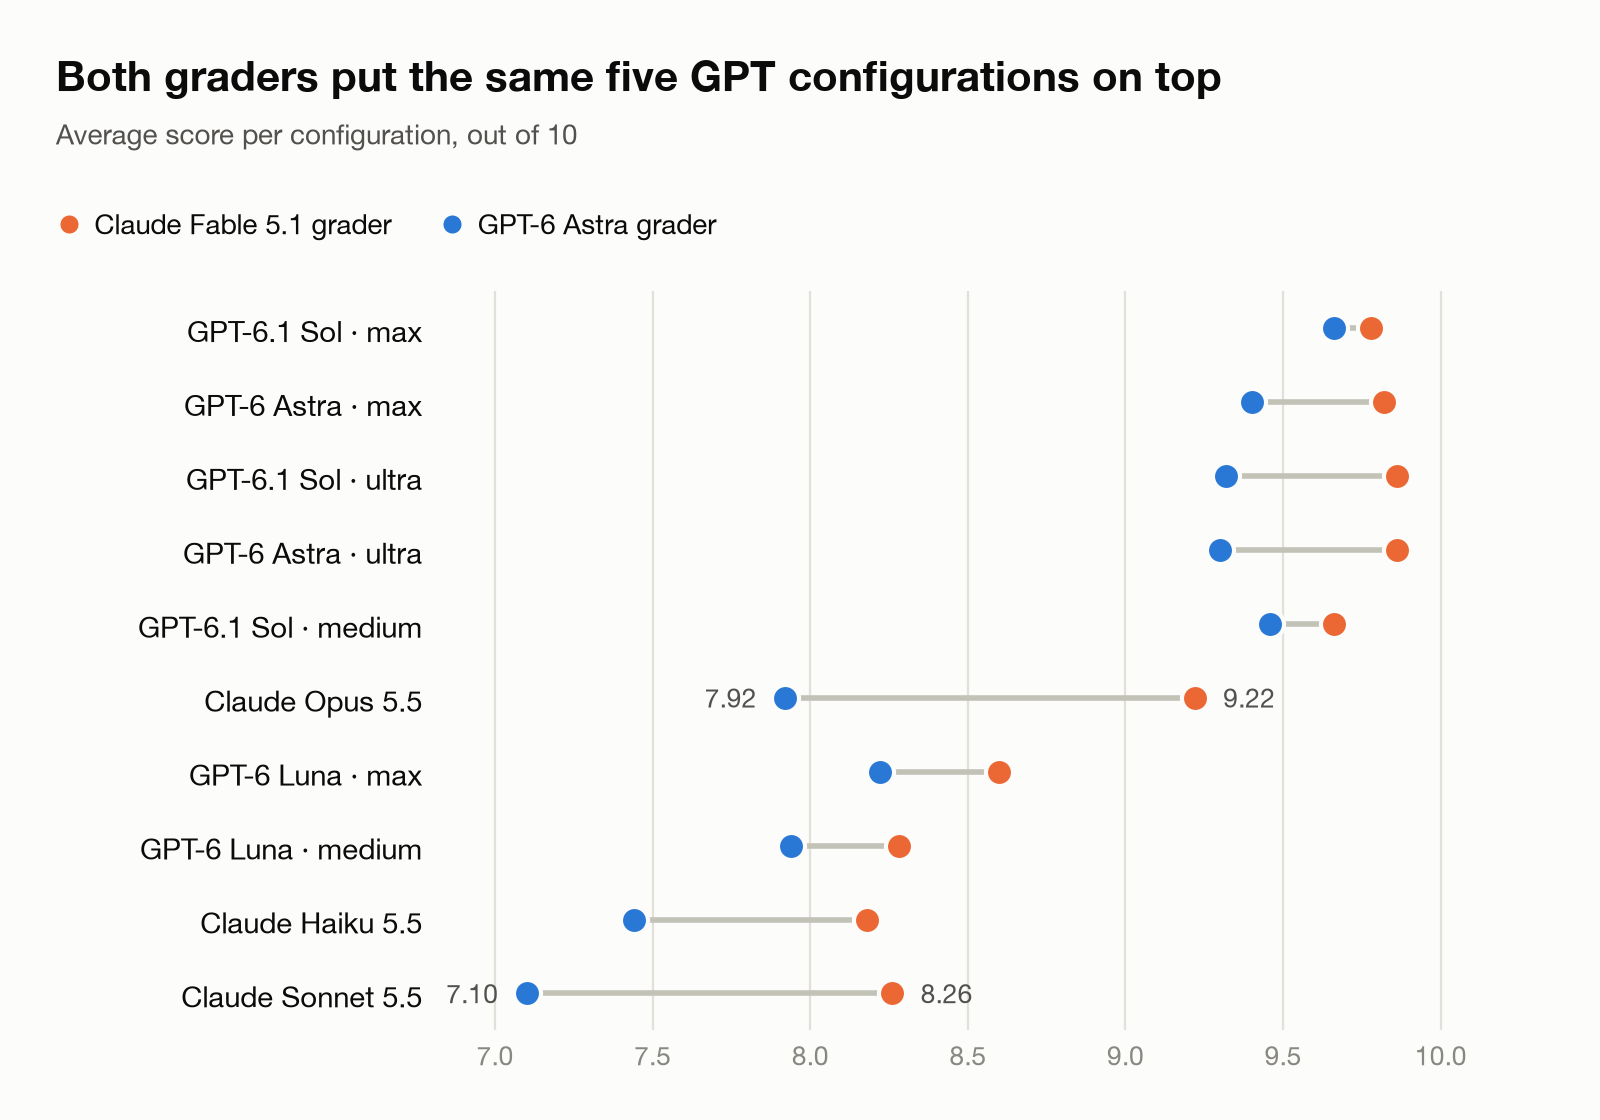 Figuur 4. De gemiddelde score van elke beoordelaar per configuratie.
Resultaten
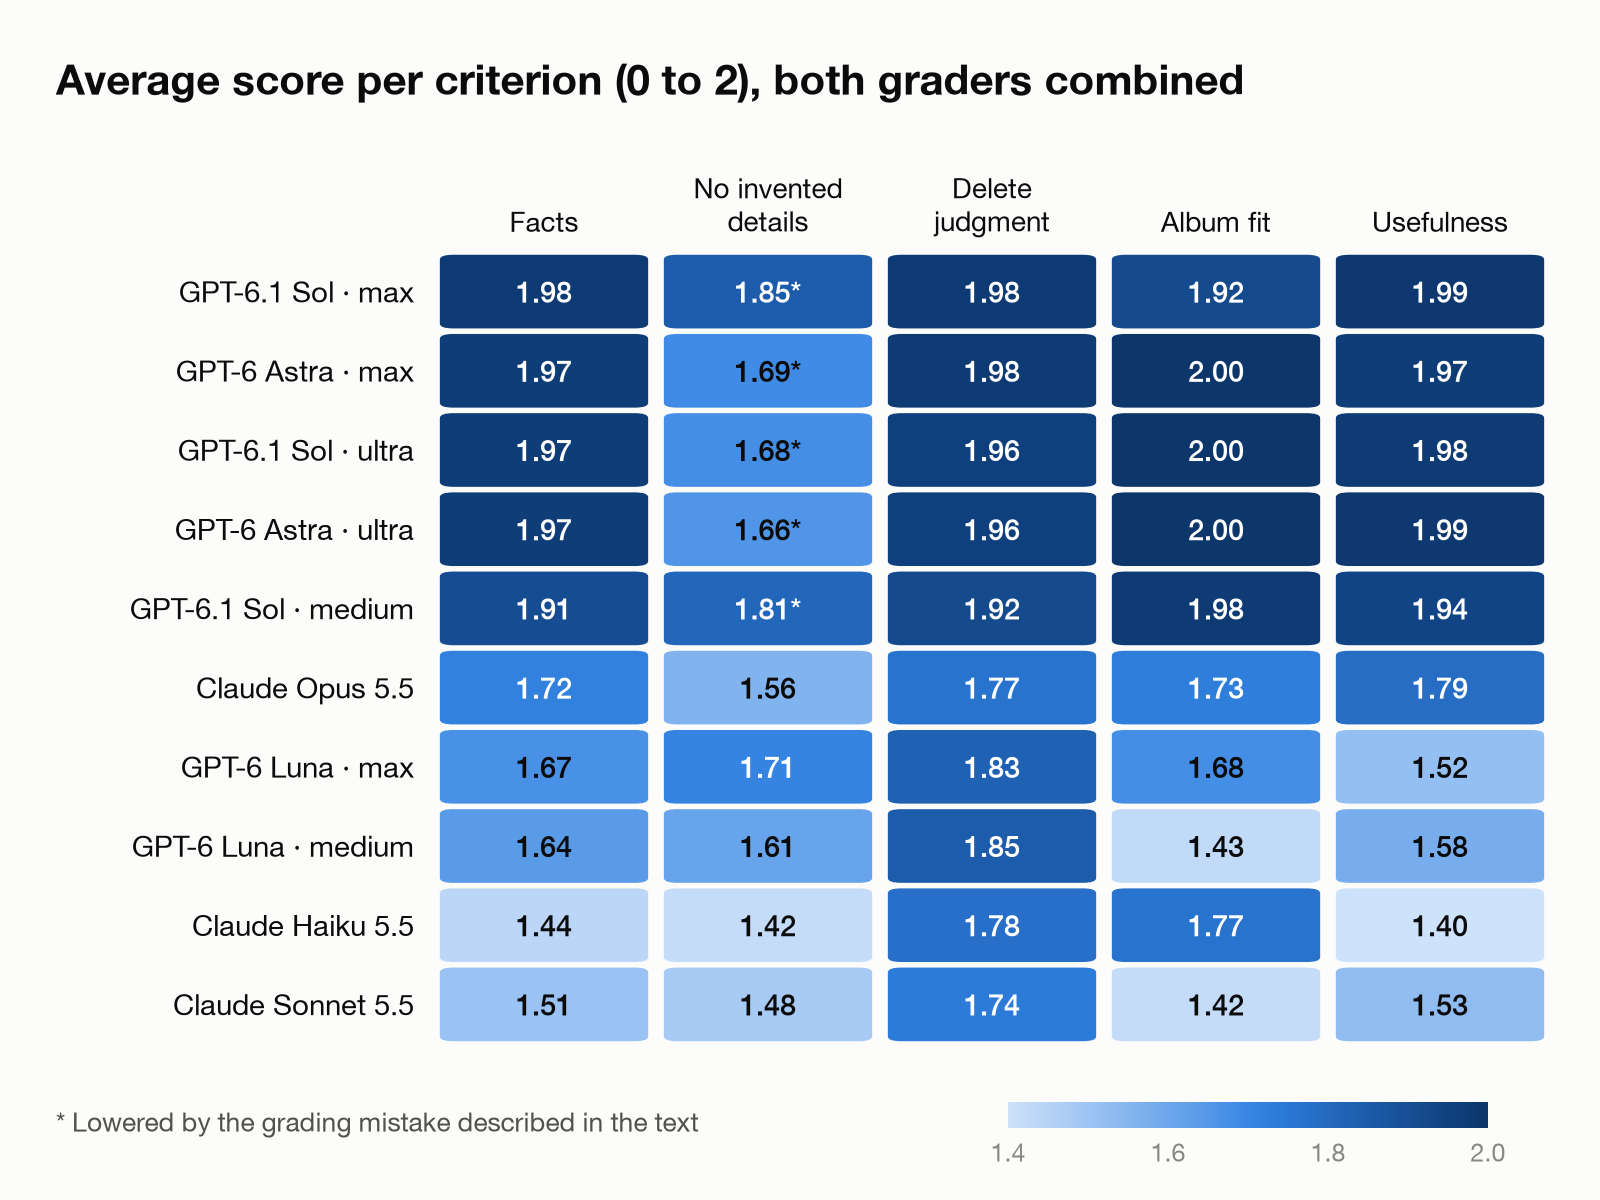 Figuur 5. Gemiddelde score per criterium, beide beoordelaars samen. Een asterisk markeert scores die verlaagd zijn door de beoordelingsfout die ik hieronder beschrijf.
GPT-6.1 Sol en GPT-6 Astra
Sol en Astra lazen de tekst nauwkeurig en beperkten hun bijschriften grotendeels tot wat de foto's toonden. Ze waren ook het beste met lokale plaatsnamen, wat ertoe doet voor foto's die in China zijn gemaakt.
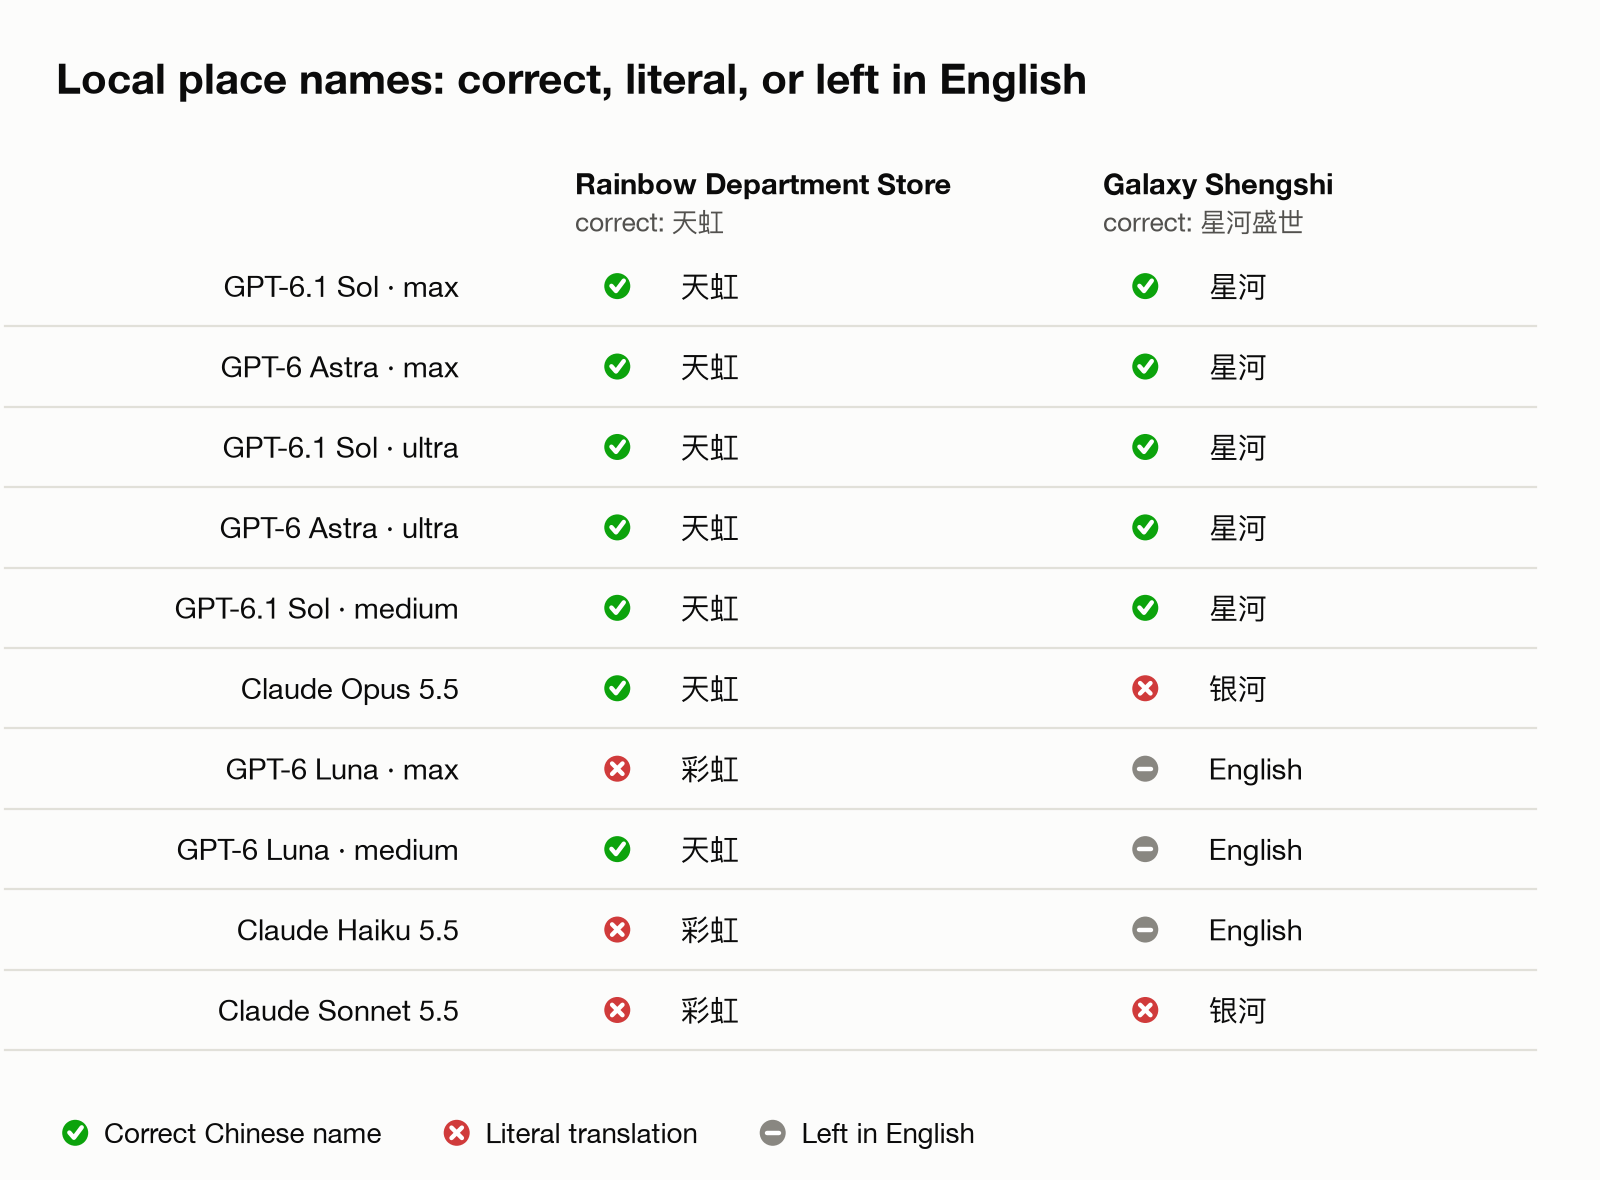 Figuur 6. Twee tests met lokale namen. Een vinkje betekent de correcte Chinese naam, een kruisje een letterlijke vertaling en EN betekent dat de naam in het Engels is gelaten.
Verschillende foto's werden getagd met de locatie «Rainbow Department Store». Dat is de Engelse naam van de Shenzhen-winkelketen 天虹. Een woord-voor-woordvertaling geeft 彩虹百货, wat fout is. Elke Sol- en Astra-configuratie had dit goed, net als Opus en Luna op medium. Haiku, Sonnet en Luna op max gebruikten de letterlijke vertaling. De koffiezaakfoto in figuur 2 werd getagd als «Galaxy Shengshi», waarvan de Chinese naam 星河盛世 is. Elke Sol- en Astra-configuratie schreef 星河. Opus en Sonnet vertaalden het letterlijk als 银河, en Haiku en beide Luna-configuraties lieten het in het Engels.
Sol en Astra waren ook voorzichtig met verwijderen. Ze stelden voor om 4 tot 6 van de 50 foto's te verwijderen. De set bevatte acht productpagina-screenshots van elektronische onderdelen, en de GPT-modellen bewaarden ze bijna allemaal; één Sol-configuratie markeerde één screenshot als bijna-duplicaat. De Claude-modellen markeerden er elk twee tot vier. Beide beoordelaars kozen ervoor ze te bewaren, aangezien de pagina's pinouts, afmetingen en boardfoto's bevatten die ik later zou willen opzoeken.
Claude Opus 5.5
Opus schreef soms dingen in een bijschrift die de foto alleen niet kan tonen. Hij beschreef relaties die het beeld alleen niet kan bewijzen, zoals broers en zussen of ouder en kind. Hij had ook enkele houdingen fout. Op één foto stond een kind achter een volwassene, en Opus schreef dat het kind op de rug van de volwassene zat. Beide beoordelaars trokken hiervoor punten af.
Dat verraste me. Vóór de blinde test had ik de antwoorden bekeken en Opus geprezen omdat hij correct raadde dat twee kinderen broer en zus waren. Ik ken mijn familie; de beoordelaar niet. Maar met 142,000 foto's kan ik niet elk bijschrift zelf controleren, en een bijschrift dat iets beweert dat de foto niet toont, is een probleem.
Opus stelde ook de meeste verwijderingen voor, 13 van de 50 foto's. Drie daarvan waren productpagina-screenshots die hij verlopen noemde, hoewel ze referentie-informatie bevatten die ik zou bewaren. Hij was het enige model dat het QR-bord voor parkeerkorting wilde verwijderen als waardeloos. Hij plaatste ook meerdere foto's van één persoon in een album «familieportret».
Claude Sonnet 5.5 en Haiku 5.5
Deze twee maakten de meeste feitelijke fouten, waaronder de letterlijke vertaling 彩虹. Sonnet maakte de zwakste albumkeuzes en plaatste alledaagse foto's in een oud album van een niet-gerelateerd evenement. Haiku verzon een detail dat leidde tot een slecht verwijderoordeel. In een reeks vrijwel identieke opnamen beschreef hij het beste beeld als iemand die naar beneden kijkt, het tegenovergestelde van wat de foto toont, en stelde voor die te verwijderen.
GPT-6 Luna
Luna kost evenveel per token als Haiku maar scoorde hoger op beide inspanningsniveaus: 8.41 en 8.11, tegen 7.81 voor Haiku. Op max-inspanning versloeg hij ook Sonnet, die ongeveer 17 keer zoveel zou kosten om dezelfde bibliotheek te ondertitelen. Luna verloor de meeste punten op bruikbaarheid en albumkeuze. Zijn bijschriften waren platter en zijn albums minder precies.
Inspanningsniveaus
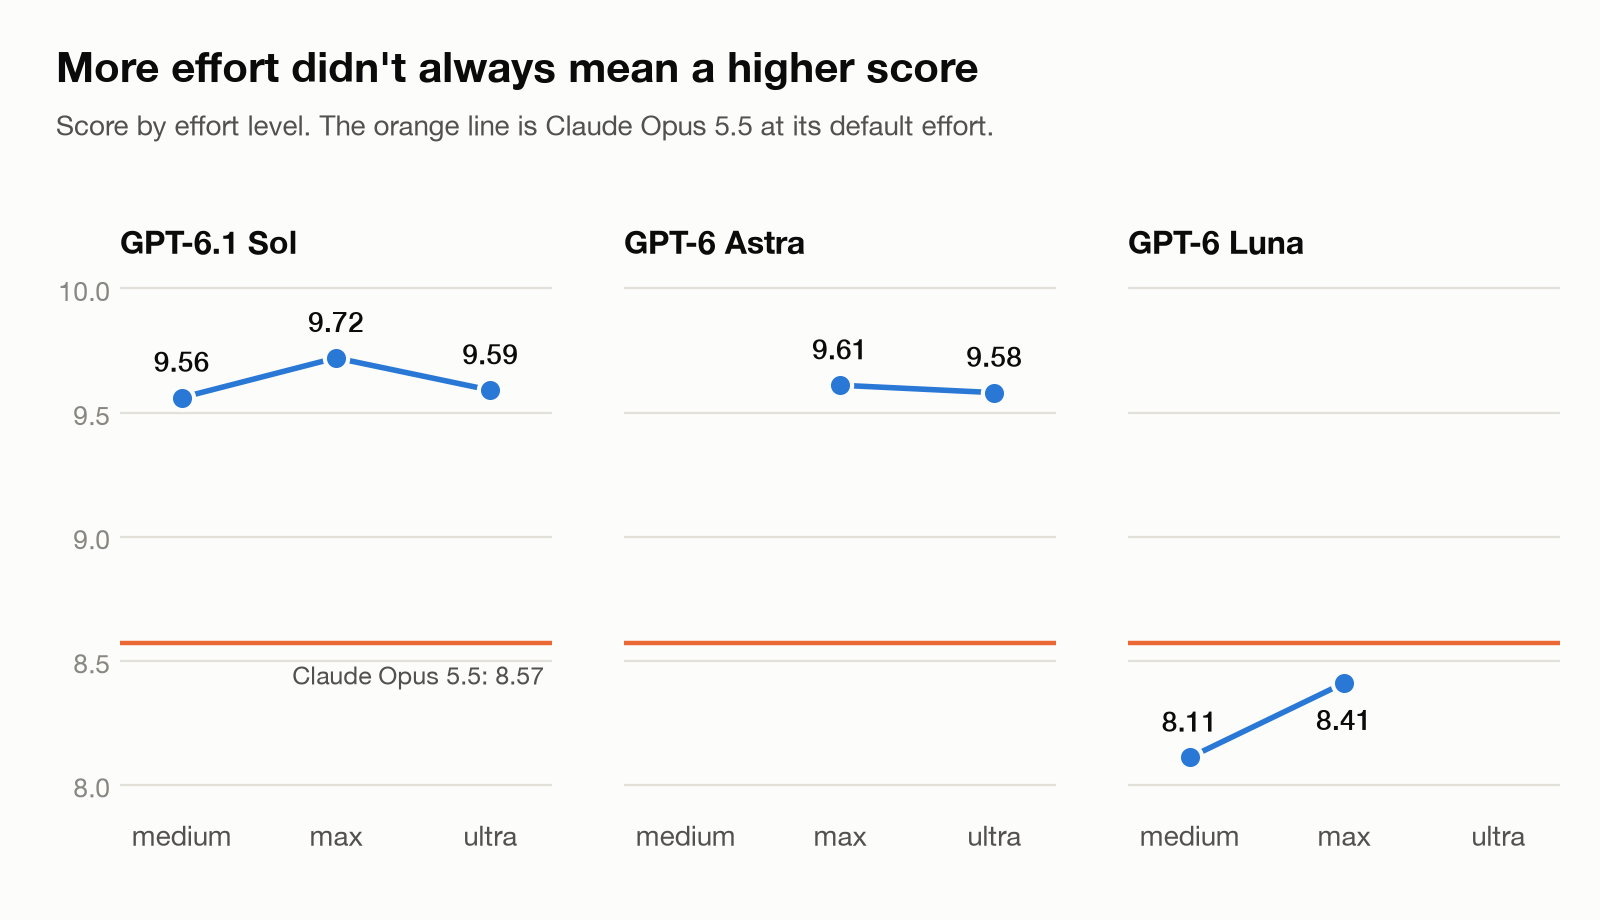 Figuur 7. Score per inspanningsniveau. De oranje lijn is Claude Opus 5.5 op zijn standaardinspanning.
Ultra was voor geen van beide modellen beter dan max. Sol scoorde 9.59 op ultra en 9.72 op max; Astra scoorde 9.58 en 9.61. In deze test leverde ultra zelfs minder output-tokens op dan max. Voor Sol kwam medium dichtbij met 9.56, voor minder dan de helft van de kosten van max. Meer inspanning betekende ook niet altijd nauwkeurigere details: Luna op medium had 天虹 goed, en Luna op max niet.
Een fout in mijn beoordeling
Na het beoordelen merkte ik dat de beoordelaars niet de opnamedatum en -tijd van elke foto hadden gekregen, terwijl de ondertitelingsmodellen die wel hadden. Dus behandelde de GPT-6 Astra-beoordelaar bijschriften die de exacte datum of tijd noemden als verzonnen details. De beste GPT-configuraties noemden de datum het vaakst, dus hun scores op «geen verzonnen details» kwamen lager uit dan ze hadden moeten zijn.
Als ik alleen de punten teruggeef die verloren gingen over datums, stijgen de top vier GPT-configuraties naar tussen 9.84 en 9.90, wat feitelijk een gelijke stand is, en Opus blijft op 8.58. Ik heb de oorspronkelijke scores in dit bericht gehouden. Volgende keer geef ik de beoordelaars alles wat de modellen zagen.
Snelheid
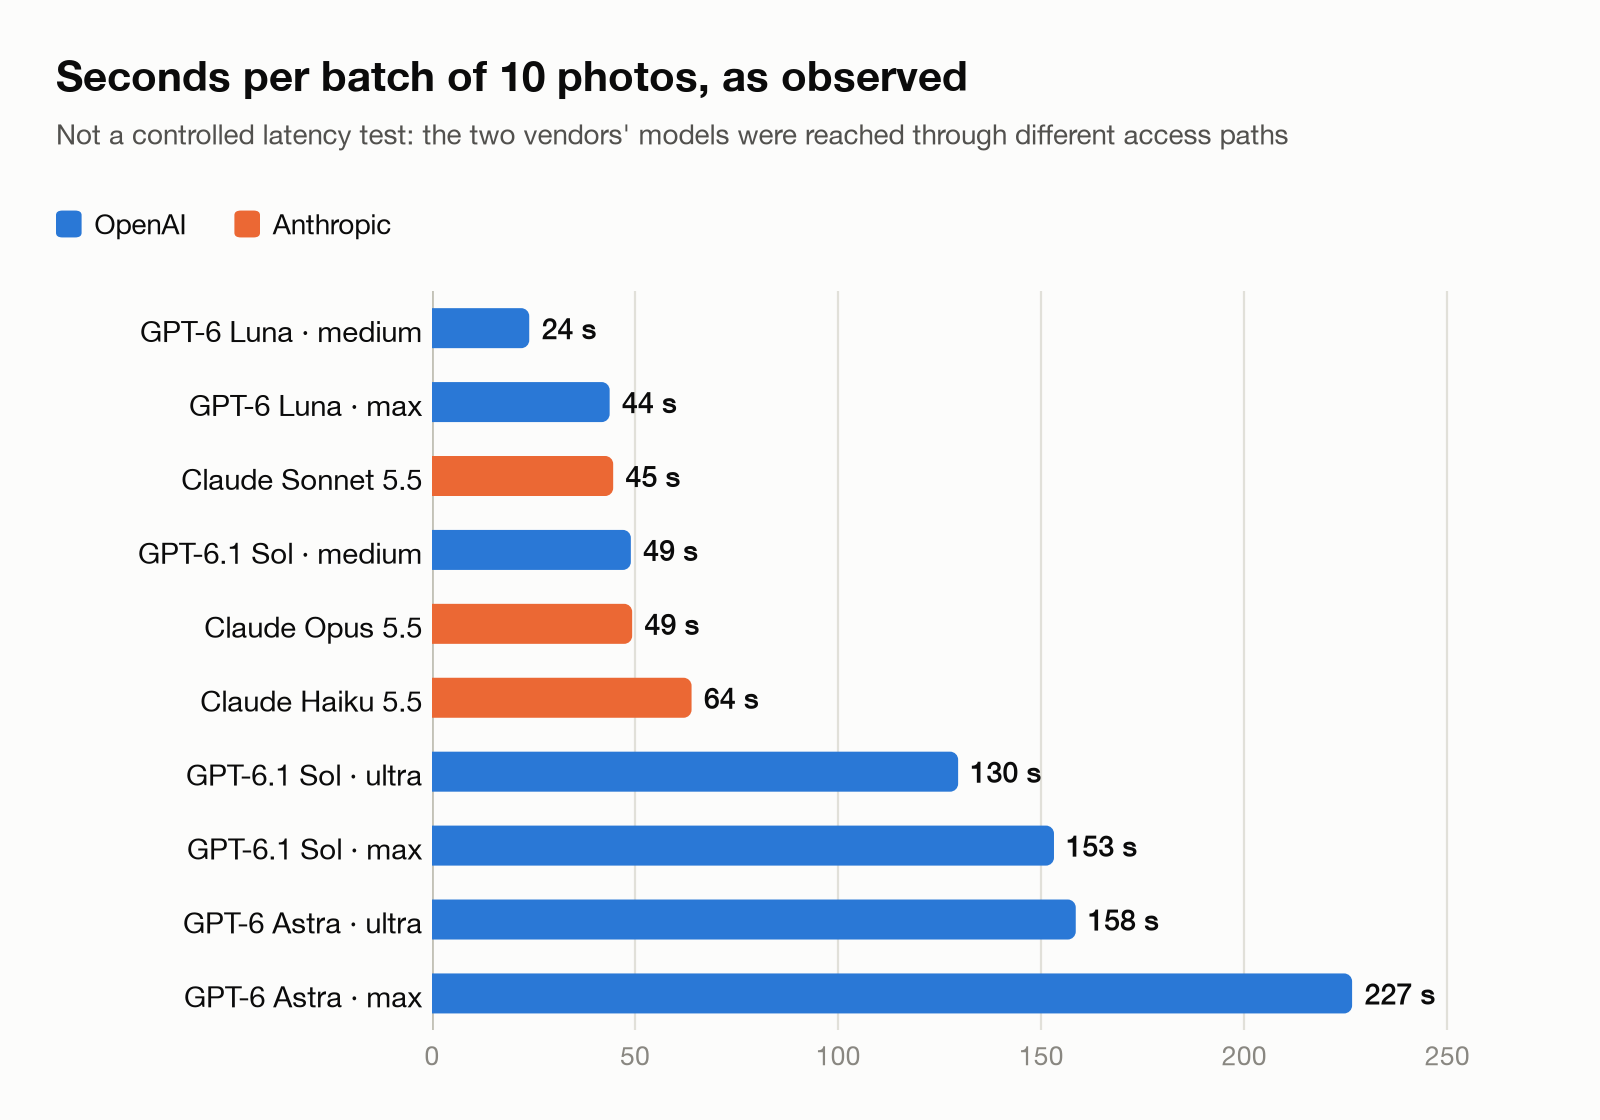 Figuur 8. Seconden per batch van 10 foto's, zoals waargenomen. Dit is geen gecontroleerde latentietest, omdat de modellen van de twee leveranciers via verschillende toegangswegen werden bereikt.
Dit komt overeen met hoe Opus aanvoelt in mijn dagelijkse werk: hij is snel, ongeveer drie keer sneller dan Sol op max. Sol op medium was echter net zo snel als Opus, en scoorde ongeveer een punt hoger.
Wat het kost
Ik beprijsde elke configuratie tegen de officiële API-prijzen van de leveranciers. Het inbegrepen gebruik van een abonnement als gratis behandelen zou sommige modellen beter laten lijken dan ze zijn.
Officiële prijzen per miljoen tokens, standaardniveau:
| Model | Input | Output |
|---|---|---|
| Claude Opus 5.5 | $4.00 | $20.00 |
| Claude Sonnet 5.5 | $2.00 | $10.00 |
| Claude Haiku 5.5 | $0.10 | $0.50 |
| GPT-6 Astra | $10.00 | $50.00 |
| GPT-6.1 Sol | $2.00 | $10.00 |
| GPT-6 Luna | $0.10 | $0.50 |
De Batch API's van beide leveranciers zijn 50% goedkoper, wat past bij een klus als deze die geen directe antwoorden vereist. Ik haalde de prijzen van de prijspagina van Anthropic (claude.com/pricing) en de API-prijspagina van OpenAI (developers.openai.com/api/docs/pricing) op 20 oktober 2026.
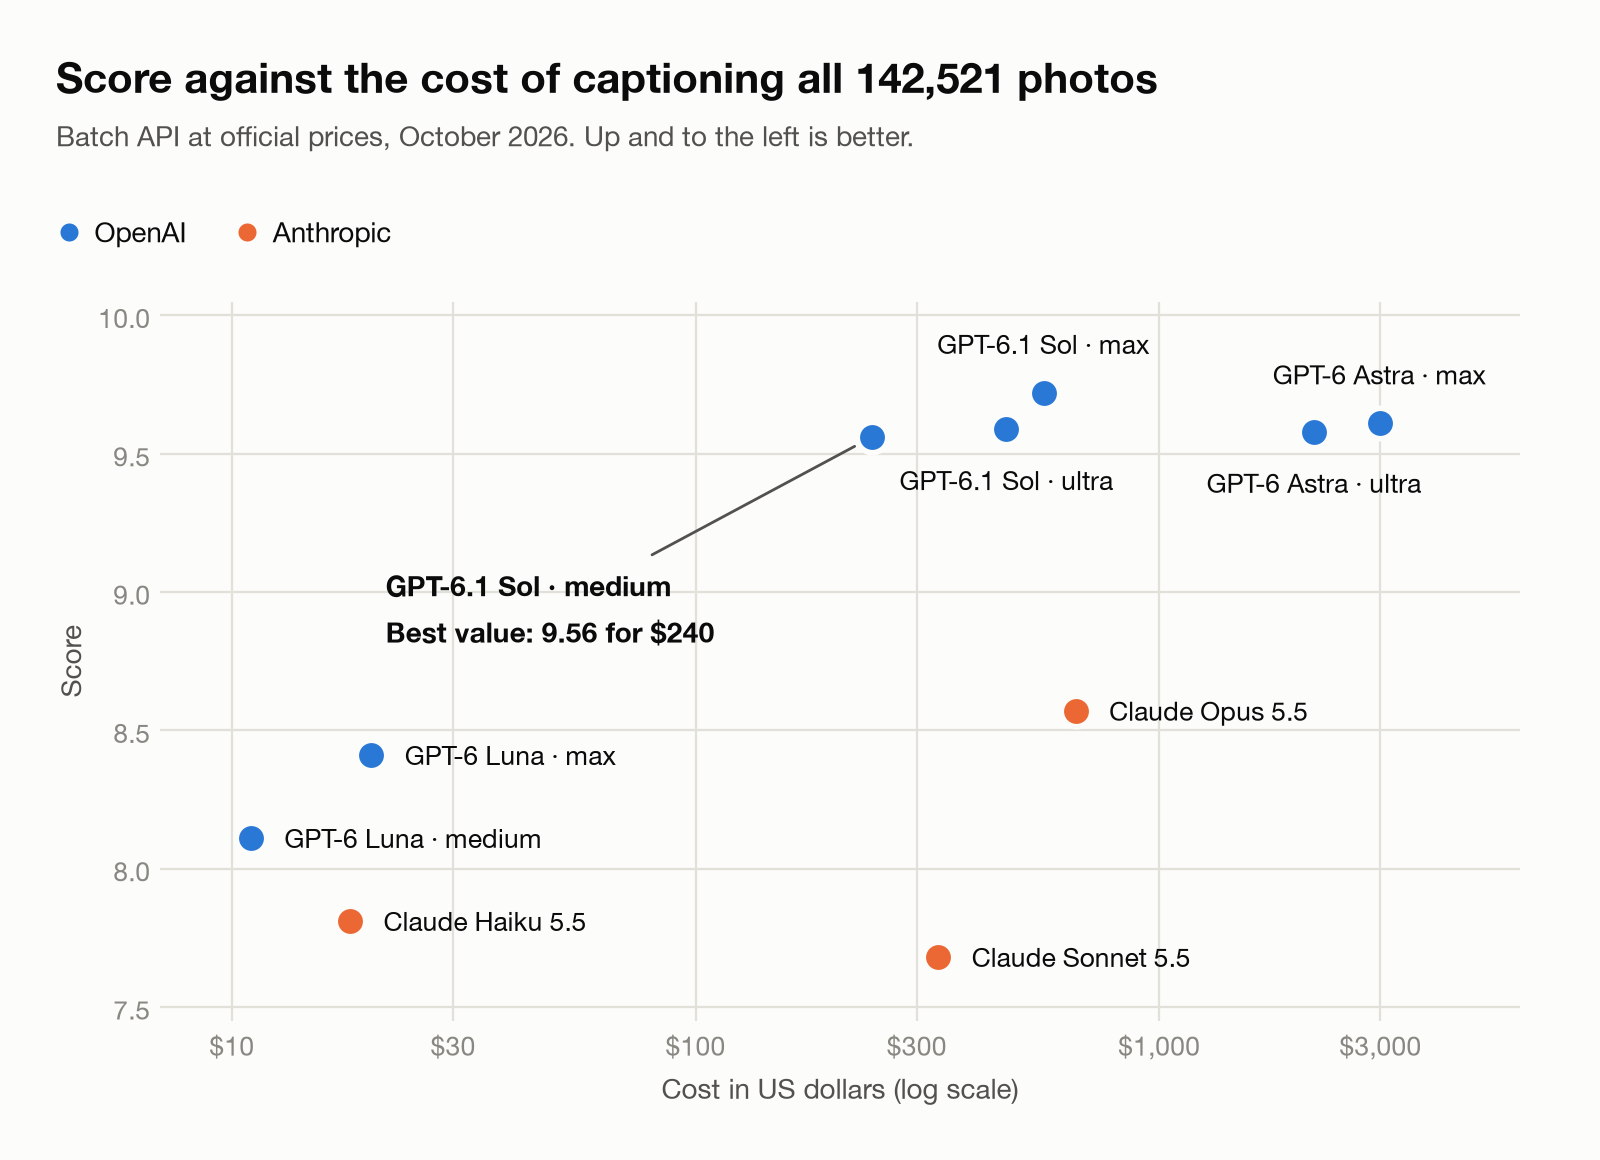 Figuur 9. Score tegen de kosten van het ondertitelen van de hele bibliotheek tegen Batch-prijzen. De kostenas is logaritmisch.
| Model en inspanning | Output-tokens per foto | Standaard | Batch | Score |
|---|---|---|---|---|
| GPT-6.1 Sol, medium | 193 | $479 | $240 | 9.56 |
| GPT-6.1 Sol, ultra | 514 | $937 | $468 | 9.59 |
| GPT-6.1 Sol, max | 647 | $1,126 | $563 | 9.72 |
| Claude Opus 5.5 | ~292 | $1,323 | $661 | 8.57 |
| Claude Sonnet 5.5 | ~297 | $668 | $334 | 7.68 |
| GPT-6 Astra, ultra | 462 | $4,313 | $2,156 | 9.58 |
| GPT-6 Astra, max | 695 | $5,973 | $2,987 | 9.61 |
| GPT-6 Luna, medium | 163 | $22 | $11 | 8.11 |
| Claude Haiku 5.5 | ~330 | $36 | $18 | 7.81 |
| GPT-6 Luna, max | 419 | $40 | $20 | 8.41 |
Sol op medium haalde 98% van de topscore voor 36% van wat Opus zou kosten en 43% van Sol op max. Astra evenaarde de kwaliteit van Sol maar kost ongeveer vijf keer zoveel, omdat zijn prijs per token vijf keer hoger ligt. Opus kostte meer dan Sol op max en scoorde lager. Hij draaide al op medium-inspanning, maar zijn prijs per token is het dubbele van die van Sol. Luna zou de hele bibliotheek ondertitelen voor $11 tot $20 en nog steeds Haiku en Sonnet verslaan.
Methodenoot: GPT-tokenaantallen werden gemeten uit de runs, en Claude-tokenaantallen geschat uit de runlogs. Sommige Claude-redeneertokens waren niet zichtbaar, dus de Claude-kosten kunnen licht onderschat zijn. Op geen enkel model werden kortingen bovenop Batch toegepast, zoals prompt-caching.
Wat ik leerde
Ik koos Opus voordat ik blinde scores had, vooral omdat hij al mijn standaardkeuze voor code was. Ik geef nog steeds de voorkeur aan Claude Opus 5.5 voor code en workflows, waar hij in mijn ervaring sneller en sterker is. Het beschrijven van echte foto's vereist een andere vaardigheid: lezen wat er daadwerkelijk in het beeld staat zonder houdingen of relaties in te vullen. GPT-6.1 Sol deed dat beter. Als ik op gewoonte was afgegaan en de blinde test had overgeslagen, had ik meer betaald voor slechtere bijschriften.
Volgende keer begin ik blind en geef ik beoordelaars van verschillende leveranciers alle input die de ondertitelingsmodellen kregen. Ik blijf ook vergelijken tegen officiële API-prijzen en neem niet aan dat meer inspanning beter is: ultra versloeg hier max niet.
Zelfs de beste modellen markeerden nuttige foto's voor verwijdering, dus ik controleer elke verwijderingsmarkering zelf voordat ik iets verwijder.
Beperkingen
Dit was een kleine test: 50 recente foto's uit één stad. Ik testte geen oudere foto's, gescande documenten, andere talen of video's. De Claude-modellen draaiden alleen op hun standaardinstellingen; een Opus met hogere inspanning zou beter kunnen scoren, tegen hogere kosten. De beoordelaars zijn AI-modellen, geen mensen. Ze kwamen goed overeen maar niet perfect, en een steekproef door een mens zou het resultaat sterker maken. Modellen en prijzen veranderen snel, en elk getal hier is per oktober 2026.
Mijn keuze
Voor mijn bibliotheek: GPT-6.1 Sol op medium-inspanning. Voor code en workflows blijf ik bij Claude Opus 5.5.