
Sokkotestasin 10 tekoälymallia 142,000 kuvan kirjastollani: GPT-6.1 Sol päihitti Claude Opusin
Tiivistelmä
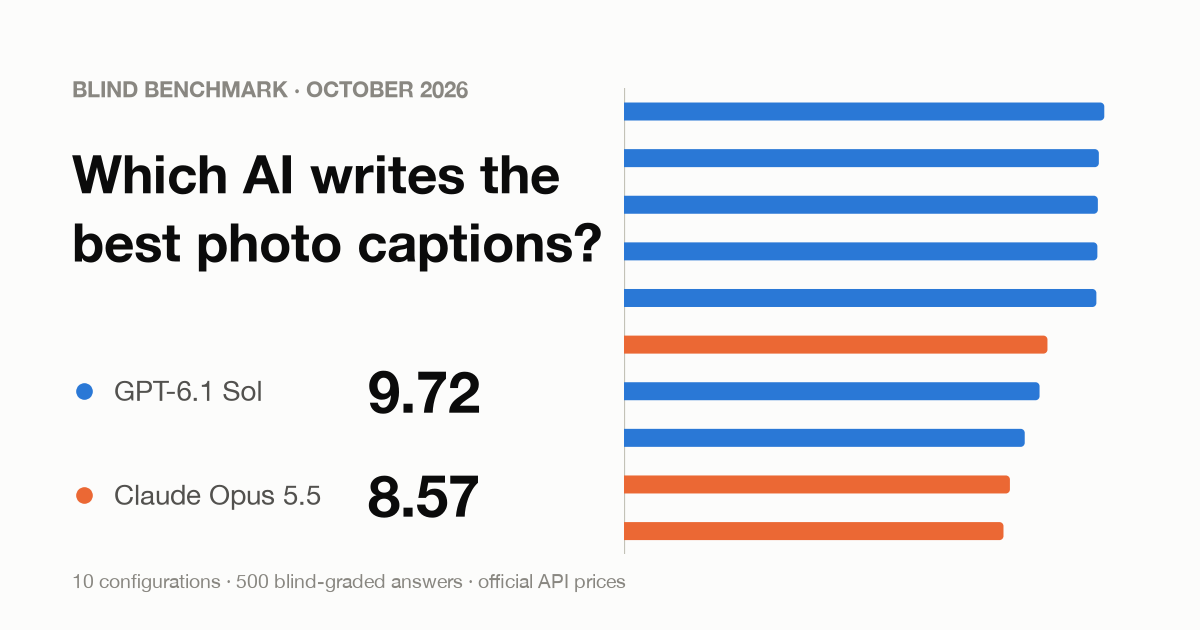
Käytän Claude Opus 5.5:tä päivittäin koodaukseen ja työnkulkuihin, ja siinä työssä pidän sitä nopeampana ja parempana kuin GPT-6:ta. Oletin, että se olisi paras myös kuvien kuvailussa, joten testasin asian. Ajoin kymmenen konfiguraatiota: Claude Haiku, Sonnet ja Opus 5.5 sekä OpenAI:n GPT-6.1 Sol, GPT-6 Astra ja GPT-6 Luna useilla panostustasoilla. Kukin otsikoi, kuvaili, avainsanoitti ja arkistoi 50 oikeaa kuvaa 142,521 kuvan kirjastostani ja merkitsi ne kuvat, jotka sen mielestä pitäisi poistaa. Kaksi sokkoutettua arvioijaa eri toimittajilta, Claude Fable 5.1 ja GPT-6 Astra, pisteytti kaikki 500 vastausta faktojen, keksittyjen yksityiskohtien, poistoarvion, albumin sopivuuden ja hyödyllisyyden osalta. GPT-6.1 Sol sai korkeimman tuloksen, 9.72 kymmenestä. Opus sai 8.57, ja Sonnet ja Haiku ylsivät 7.7–7.8:aan. Ultra-panostus ei ollut maxia parempi. Virallisilla Batch API -hinnoilla koko kirjaston kuvailu maksaisi noin $240 Solilla medium-panostuksella (9.56), $661 Opusilla ja $11–$20 Lunalla, joka silti päihitti Haikun.
Miksi testasin tätä
Suurin osa päivästäni kuluu koodaukseen, agenttityönkulkuihin ja automatisointiin, ja Claude Opus 5.5 on malli, johon tartun. Siihen työhön se on tuntunut minusta nopeammalta ja paremmalta kuin GPT-6. Joten kun päätin antaa tekoälyn kuvata ja tagata kuvakirjastoni, valitsin Opusin epäröimättä.
Kirjasto on 25 vuotta elämästäni: 142,521 kuvaa, varhaisista digikamerakuvista viime viikon puhelinkuviin, sekä yli 16,000 kuvakaappausta. Lähes yhdessäkään ei ole kuvatekstiä. Haluan, että jokaisessa kuvassa on otsikko, kuvateksti, haettavia avainsanoja, järkevä albumi ja rehellinen merkintä, kun kyseessä on kaksoiskappale tai roska. Ennen kuin maksan 142,000 kuvan käsittelystä, halusin tietää, mikä malli tekee tämän parhaiten ja mitä ero maksaa.
Odotin Opusin voittavan. Näillä 50 kuvalla GPT-6.1 Sol sai yli pisteen korkeamman tuloksen.
Tulokset yhdellä silmäyksellä
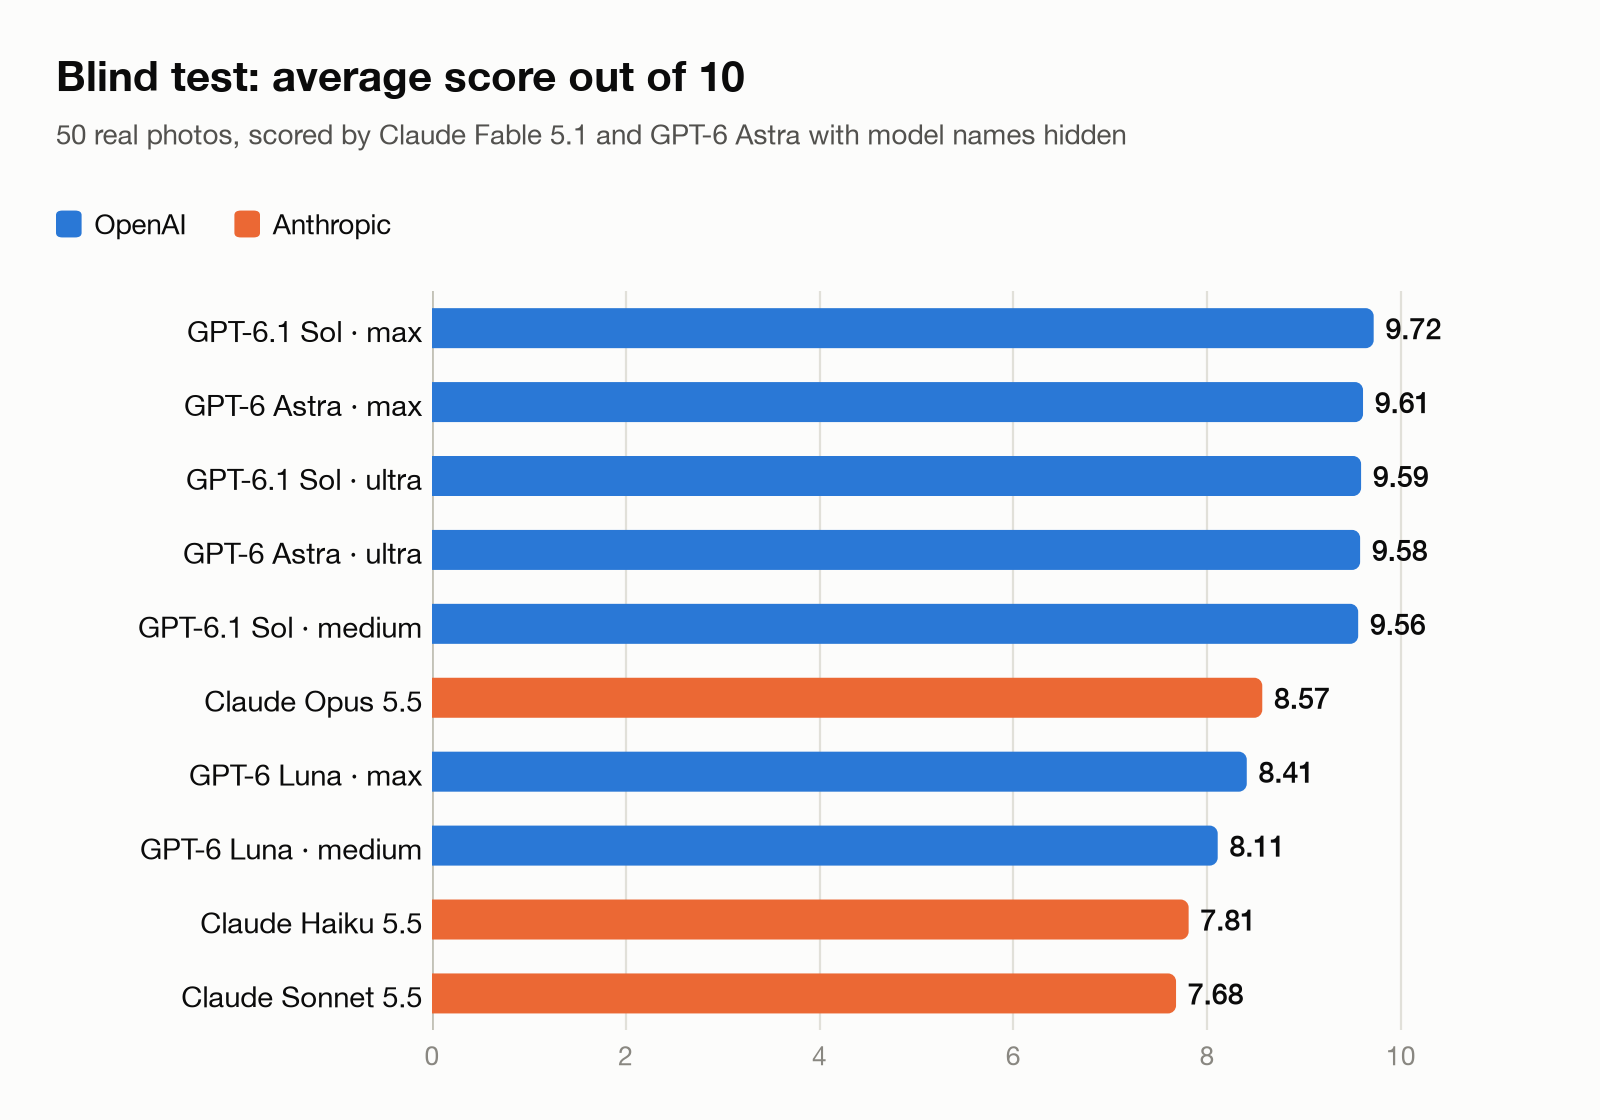 Kuva 1. Kahden sokkoutetun arvioijan keskiarvopisteet, maksimi 10.
| Sija | Malli ja panostus | Pisteet (10:stä) | Koko kirjasto, Batch API | Koko kirjasto, standardi API |
|---|---|---|---|---|
| 1 | GPT-6.1 Sol, max | 9.72 | $563 | $1,126 |
| 2 | GPT-6 Astra, max | 9.61 | $2,987 | $5,973 |
| 3 | GPT-6.1 Sol, ultra | 9.59 | $468 | $937 |
| 4 | GPT-6 Astra, ultra | 9.58 | $2,156 | $4,313 |
| 5 | GPT-6.1 Sol, medium | 9.56 | $240 | $479 |
| 6 | Claude Opus 5.5 | 8.57 | $661 | $1,323 |
| 7 | GPT-6 Luna, max | 8.41 | $20 | $40 |
| 8 | GPT-6 Luna, medium | 8.11 | $11 | $22 |
| 9 | Claude Haiku 5.5 | 7.81 | $18 | $36 |
| 10 | Claude Sonnet 5.5 | 7.68 | $334 | $668 |
Kustannus koskee kaikkia 142,521 kuvaa kunkin toimittajan virallisella API-hinnalla.
Mitä käyttäisin tämän testin perusteella:
- Jos välittäisin vain pisteistä, GPT-6.1 Sol max-panostuksella.
- Omalle kirjastolleni GPT-6.1 Sol medium-panostuksella. Se sai 98% kärkituloksesta hintaan $240, noin kolmanneksen siitä, mitä Opus maksaisi.
- Tiukalla budjetilla GPT-6 Luna max-panostuksella. Hinnalla $20 se päihitti Haikun, joka maksaa saman verran tokenia kohden, ja Sonnetin, joka maksaisi tälle kirjastolle noin 17 kertaa enemmän.
- Ei Claude Sonnet 5.5:tä. Se on keskihintainen ja sai alhaisimmat pisteet.
Mallit
| Toimittaja | Malli | Testattu panostus | Asemointi |
|---|---|---|---|
| Anthropic | Claude Opus 5.5 | oletus (medium) | Lippulaiva päivittäiskäyttöön |
| Anthropic | Claude Sonnet 5.5 | oletus | Keskiluokka |
| Anthropic | Claude Haiku 5.5 | oletus | Nopea, edullinen |
| OpenAI | GPT-6 Astra | max, ultra | Kärkimalli |
| OpenAI | GPT-6.1 Sol | medium, max, ultra | Työjuhta |
| OpenAI | GPT-6 Luna | medium, max | Nopea, edullinen |
Hinnat asettuvat samaan linjaan kahden toimittajan välillä. GPT-6.1 Sol maksaa saman verran tokenia kohden kuin Claude Sonnet 5.5, GPT-6 Astra saman kuin Claude Fable 5.1 ja GPT-6 Luna saman kuin Claude Haiku 5.5. Claude Opus 5.5 asettuu Solin ja Astran väliin. Joten kun kaksi mallia alla päätyvät eri kustannuksiin, se johtuu enimmäkseen siitä, että toinen käytti enemmän tokeneita samaan työhön.
Claude-mallit ajettiin kerran kukin oletusasetuksillaan, mikä Opusille tarkoittaa medium-panostusta. GPT-malleja testasin useilla panostustasoilla. Lähin vertailukelpoinen vertailu on GPT-6.1 Sol medium-panostuksella vastaan Claude Opus 5.5 medium-panostuksella: 9.56 vastaan 8.57.
Testi
Käytin kirjastoni 50 uusinta kuvaa sillä hetkellä, ilman videoita. Ne ovat tavallinen viikko kamerarullastani: perhehetkiä kotona ja ostosreissulla, kaupunkinäkymiä korkeasta kerroksesta, muistikortti työpöydälläni, elektroniikkaosien tuotesivujen kuvakaappauksia, tilauksen seurannan kuvakaappauksia, somepäivitys, pysäköintialennuksen QR-kyltti ja sähköauton laturin etiketti.
Jokaisella mallilla oli viisi tehtävää jokaista kuvaa kohden. Se kirjoitti lyhyen otsikon ja yhden–kolmen lauseen kuvatekstin kiinaksi, antoi 5–12 avainsanaa kiinaksi ja englanniksi sekä valitsi parhaan albumin olemassa olevista albumeistani tai ei mitään. Sitten se antoi laatupisteen ja kertoi, pitäisikö kuva säilyttää vai poistaa, etsien kaksoiskappaleita, epäonnistuneita otoksia, vanhentuneita kuvakaappauksia ja kuvia, joilla ei ole pysyvää arvoa. Jokainen malli sai samat ohjeet ja saman kontekstin jokaista kuvaa varten, kymmenen kuvaa kerrallaan.
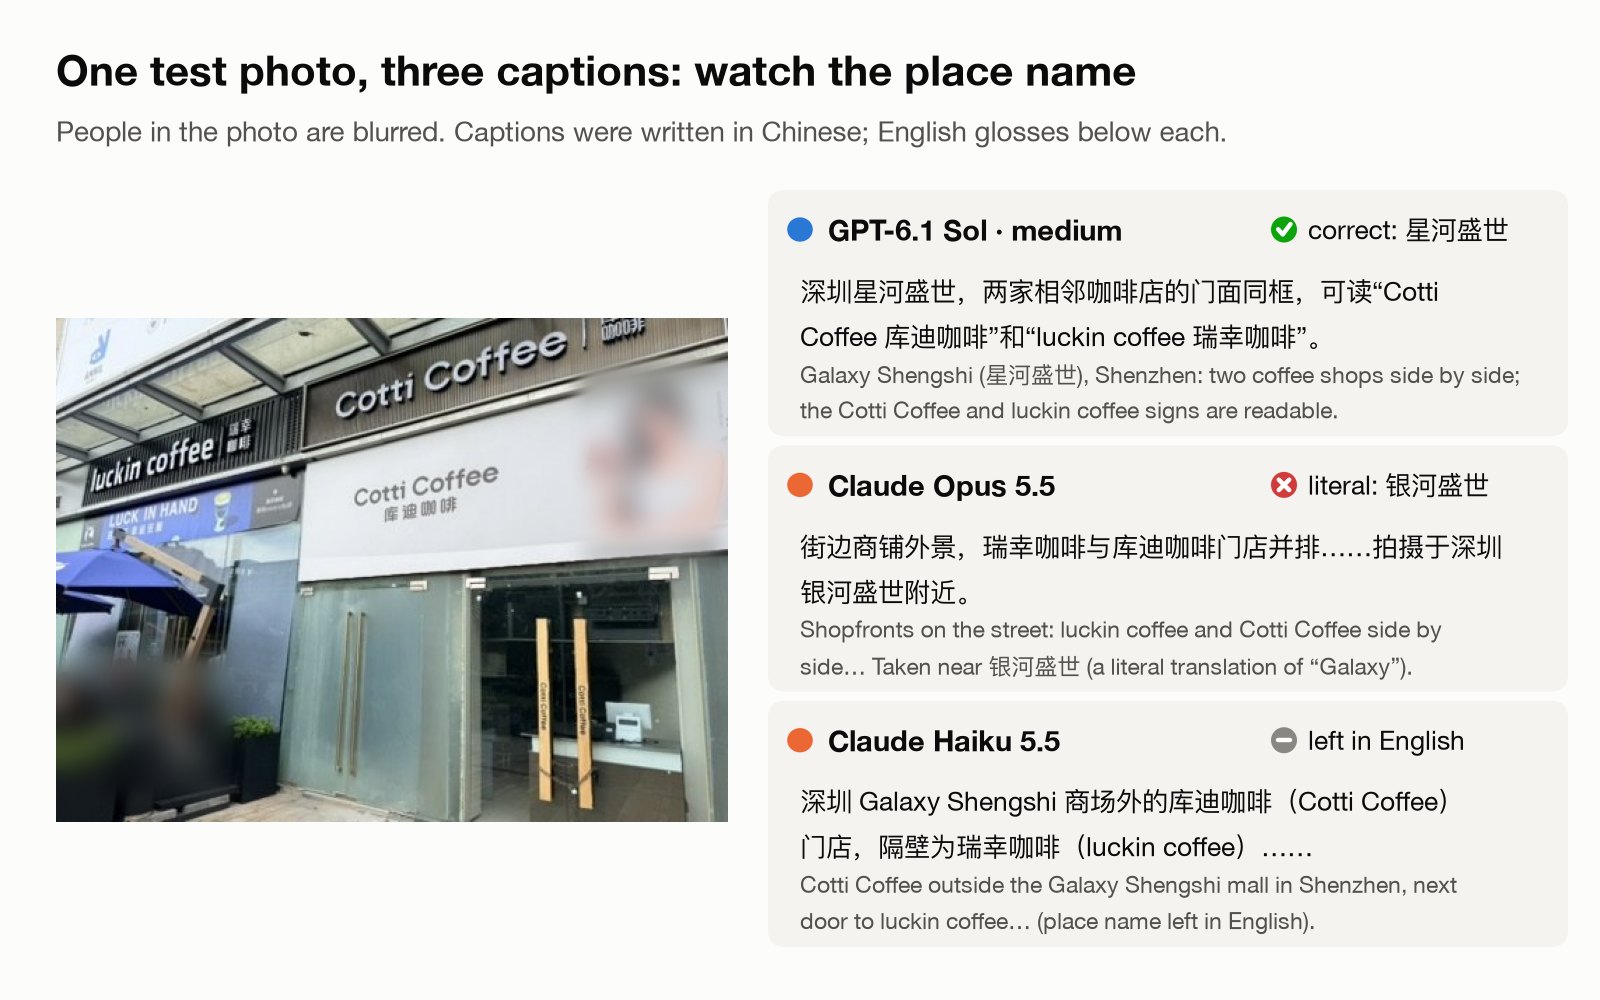 Kuva 2. Yksi 50 testikuvasta, mukana kolme kuvatekstiä. Huomaa, miten kukin malli käsittelee paikannimen; palaan siihen alla. Kuvassa olevat henkilöt on sumennettu.
Miten pisteytin
En pisteyttänyt vastauksia itse. Olin jo valinnut voittajan ennen testiä, ja käytän Claudea päivittäin, joten en ollut puolueeton.
Sen sijaan sekoitin kunkin kuvan kymmenen vastausta ja merkitsin ne kirjaimin A–J, uudella satunnaisella järjestyksellä jokaista kuvaa varten. Kaksi arvioijaa pisteytti sitten kaikki 500 vastausta itsenäisesti katsellen kuvia. Toinen oli Claude Fable 5.1, Anthropicin kyvykkäin malli. Toinen oli GPT-6 Astra xhigh-panostuksella, OpenAI:n kärkimalli.
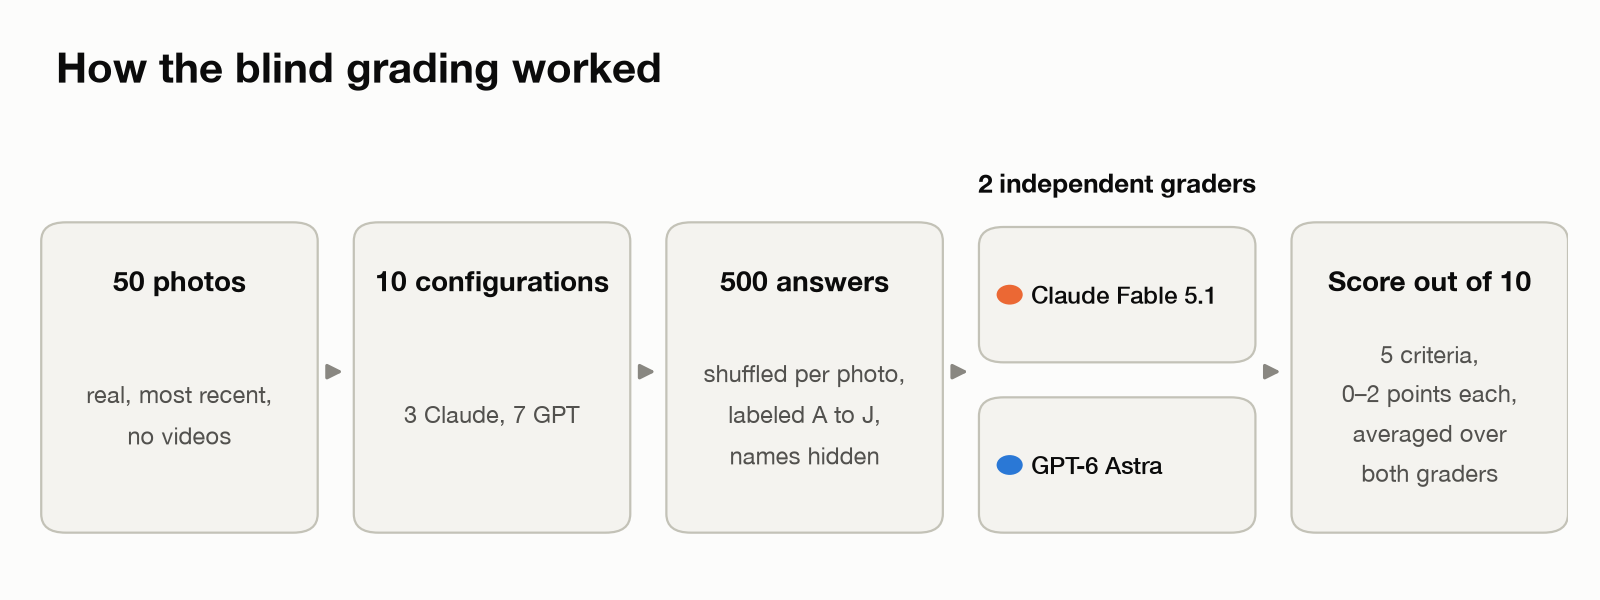 Kuva 3. Miten sokkoutettu pisteytys toimi.
Jokainen vastaus pisteytettiin viidellä kriteerillä, kukin 0–2 pistettä, yhteensä 10:
| Kriteeri | Mitä arvioija tarkisti |
|---|---|
| Faktat | Ovatko kohde, paikka ja mahdollinen luettava teksti oikein, mukaan lukien paikalliset paikannimet? |
| Ei keksittyjä yksityiskohtia | Välttääkö vastaus väittämästä mitään, mitä kuva ei näytä? |
| Poistoarvio | Onko säilytä tai poista järkevä? Hyvän kuvan poistaminen antaa 0. |
| Albumin sopivuus | Onko albumi oikea? Väärä vanha albumi antaa 0; ei albumia on hyväksyttävä 1. |
| Hyödyllisyys | Auttaisivatko otsikko, kuvateksti ja avainsanat minua löytämään ja muistamaan tämän kuvan myöhemmin? |
Valitsin yhden arvioijan kummaltakin toimittajalta nähdäkseni, suosiiko jompikumpi omia mallejaan. He olivat enimmäkseen samaa mieltä. Korrelaatio 500 paripisteen välillä oli 0.71, ja molemmat asettivat samat viisi GPT-konfiguraatiota kärkeen. Claude-arvioija rankkasi myös GPT-6.1 Solin ja GPT-6 Astran Claude Opusin edelle. GPT-arvioija oli kaikkiaan tiukempi ja tiukin Claude-malleja kohtaan.
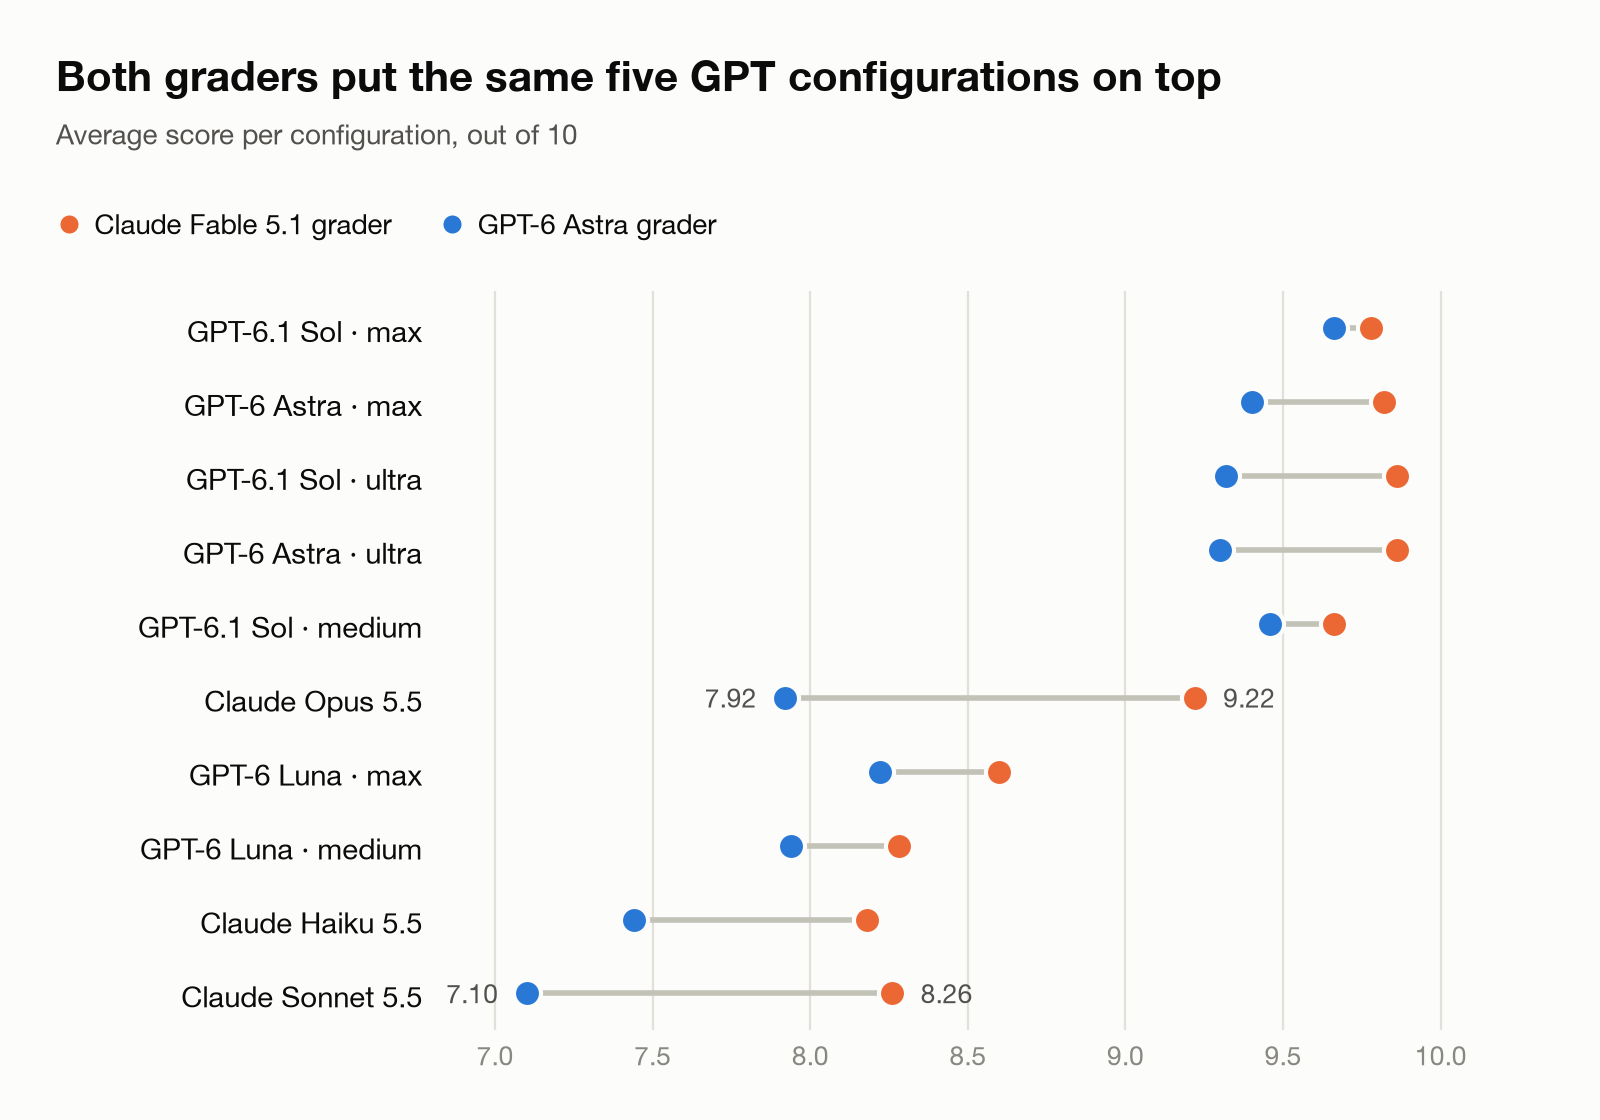 Kuva 4. Kunkin arvioijan keskiarvopisteet konfiguraatiota kohden.
Tulokset
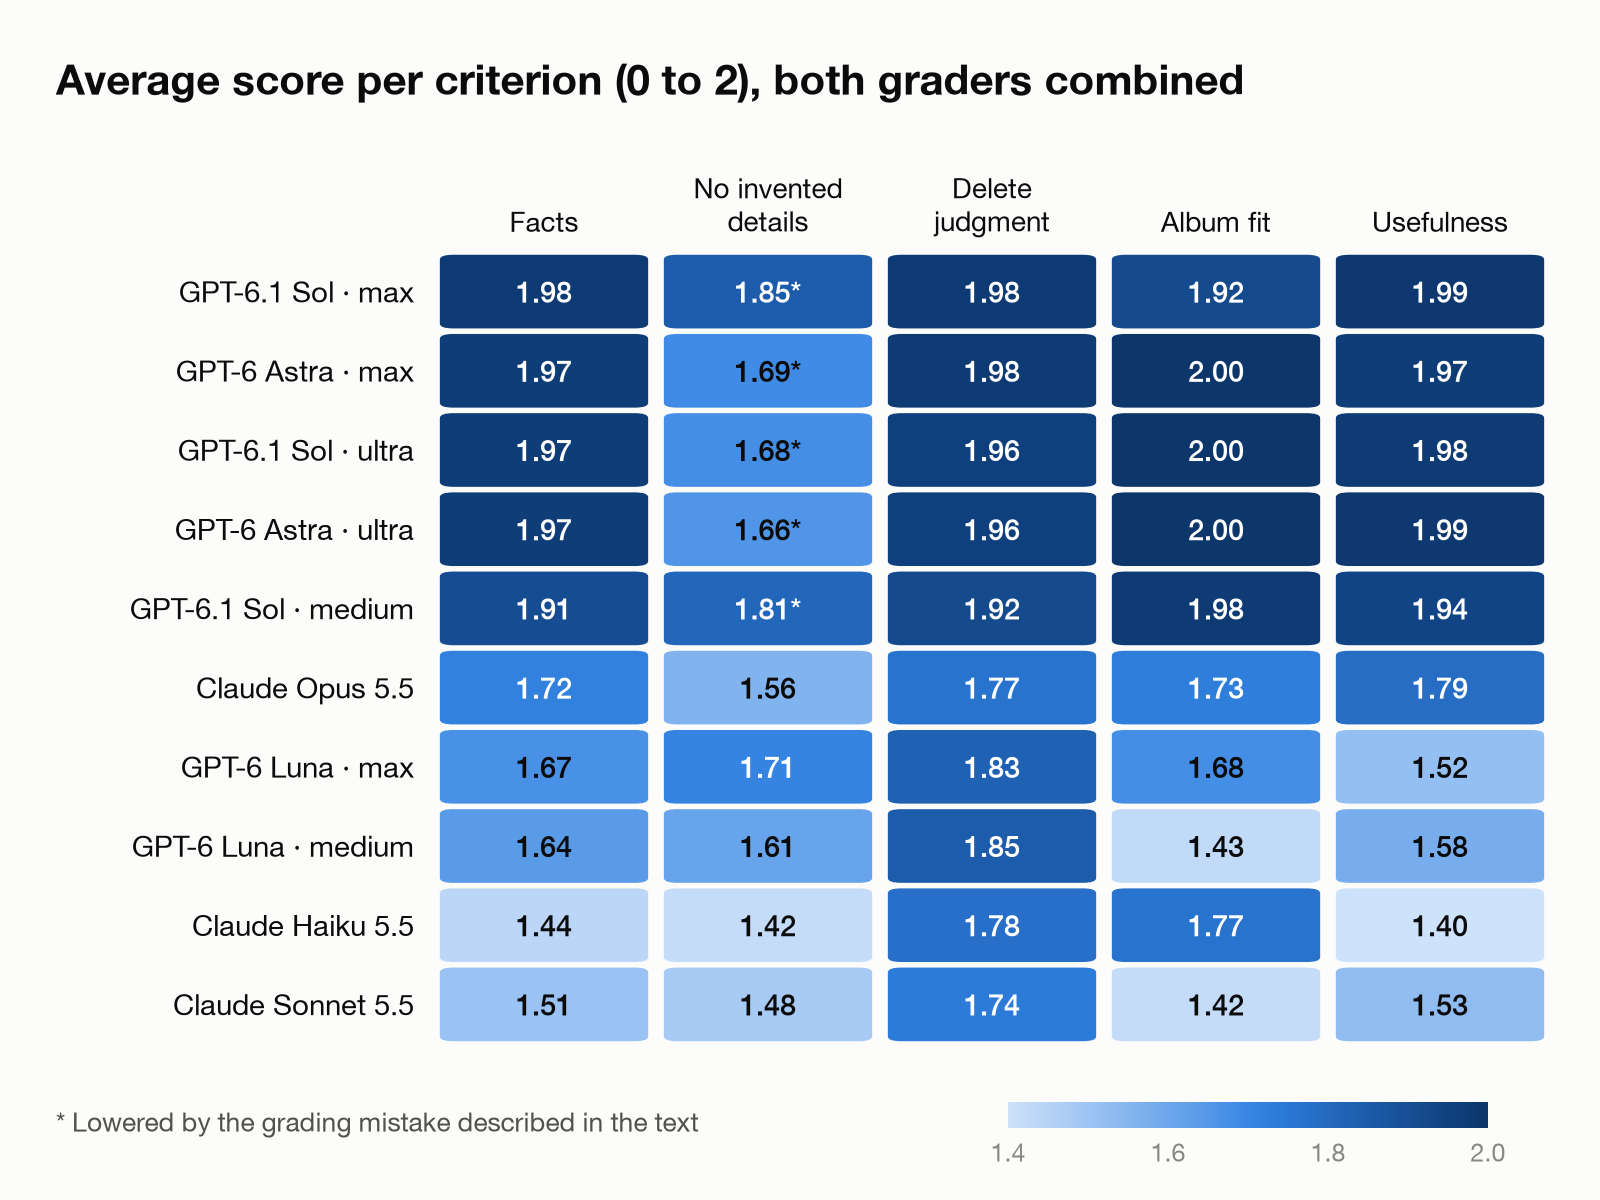 Kuva 5. Keskiarvopisteet kriteeriä kohden, molemmat arvioijat yhdistettynä. Tähti merkitsee pisteitä, joita alla kuvaamani pisteytysvirhe laski.
GPT-6.1 Sol ja GPT-6 Astra
Sol ja Astra lukivat tekstin tarkasti ja rajoittivat kuvatekstinsä enimmäkseen siihen, mitä kuvat näyttivät. Ne olivat myös parhaita paikallisten paikannimien kanssa, mikä merkitsee Kiinassa otetuille kuville.
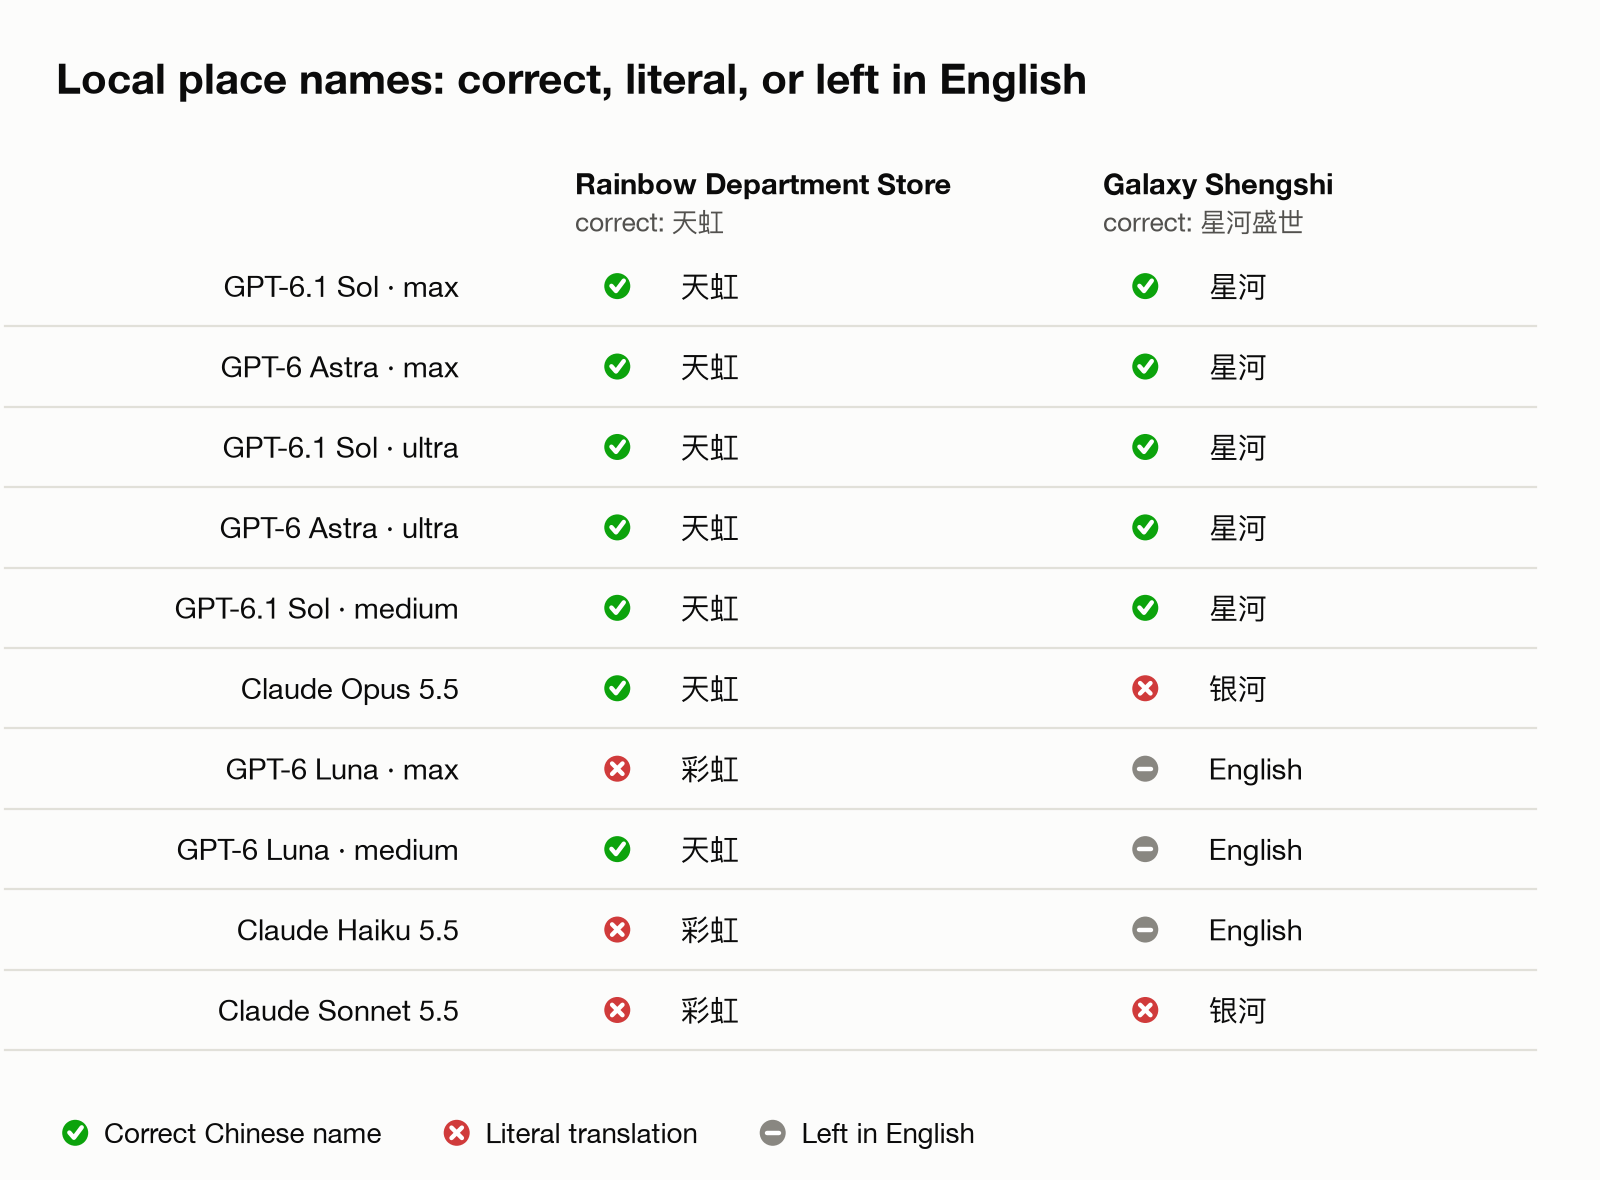 Kuva 6. Kaksi paikallisten nimien testiä. Rasti tarkoittaa oikeaa kiinalaista nimeä, rasti kirjaimellista käännöstä ja EN sitä, että nimi jätettiin englanniksi.
Useampi kuva tagattiin sijainnilla «Rainbow Department Store». Se on Shenzhenin tavarataloketjun 天虹 englanninkielinen nimi. Sanasanainen käännös antaa 彩虹百货, mikä on väärin. Jokainen Sol- ja Astra-konfiguraatio sai tämän oikein, samoin Opus ja Luna mediumilla. Haiku, Sonnet ja Luna maxilla käyttivät kirjaimellista käännöstä. Kahvilakuva kuvassa 2 tagattiin nimellä «Galaxy Shengshi», jonka kiinalainen nimi on 星河盛世. Jokainen Sol- ja Astra-konfiguraatio kirjoitti 星河. Opus ja Sonnet käänsivät sen kirjaimellisesti muotoon 银河, ja Haiku sekä molemmat Luna-konfiguraatiot jättivät sen englanniksi.
Sol ja Astra olivat myös varovaisia poistamisessa. Ne ehdottivat 4–6 kuvan poistamista 50:stä. Joukko sisälsi kahdeksan elektroniikkaosien tuotesivujen kuvakaappausta, ja GPT-mallit säilyttivät lähes kaikki; yksi Sol-konfiguraatio merkitsi yhden kuvakaappauksen lähes-kaksoiskappaleeksi. Claude-mallit merkitsivät kukin kaksi–neljä. Molemmat arvioijat olivat säilyttämisen kannalla, koska sivuilla oli pinnijärjestyksiä, mittoja ja levykuvia, joita haluaisin katsoa myöhemmin.
Claude Opus 5.5
Opus kirjoitti joskus kuvatekstiin asioita, joita pelkkä kuva ei voi näyttää. Se kuvaili suhteita, joita pelkkä kuva ei voi todistaa, kuten sisaruksia tai vanhempaa ja lasta. Se myös arvioi joitakin asentoja väärin. Yhdessä kuvassa lapsi seisoi aikuisen takana, ja Opus kirjoitti, että lapsi oli aikuisen selässä. Molemmat arvioijat vähensivät tästä pisteitä.
Tämä yllätti minut. Ennen sokkotestiä olin katsonut vastauksia läpi ja kehunut Opusia siitä, että se arvasi oikein kahden lapsen olevan sisaruksia. Minä tunnen perheeni; arvioija ei. Mutta 142,000 kuvalla en voi tarkistaa jokaista kuvatekstiä itse, ja kuvateksti, joka väittää jotain, mitä kuva ei näytä, on ongelma.
Opus ehdotti myös eniten poistoja, 13 kuvaa 50:stä. Kolme niistä oli tuotesivujen kuvakaappauksia, joita se kutsui vanhentuneiksi, vaikka ne sisälsivät viitetietoja, jotka säilyttäisin. Se oli ainoa malli, joka halusi poistaa pysäköintialennuksen QR-kyltin arvottomana. Se myös laittoi useita yhden henkilön kuvia «perhekuva»-albumiin.
Claude Sonnet 5.5 ja Haiku 5.5
Nämä kaksi tekivät eniten faktavirheitä, mukaan lukien kirjaimellisen 彩虹-käännöksen. Sonnet teki heikoimmat albumivalinnat ja arkistoi arkikuvia vanhaan albumiin epäolennaisesta tapahtumasta. Haiku keksi yksityiskohdan, joka johti huonoon poistopäätökseen. Lähes identtisten otosten sarjassa se kuvaili parasta otosta henkilöksi, joka katsoo alaspäin, mikä on päinvastoin kuin kuva näyttää, ja ehdotti sen poistamista.
GPT-6 Luna
Luna maksaa saman verran tokenia kohden kuin Haiku, mutta sai korkeammat pisteet molemmilla panostustasoilla: 8.41 ja 8.11 vastaan Haikun 7.81. Max-panostuksella se päihitti myös Sonnetin, joka maksaisi noin 17 kertaa enemmän saman kirjaston kuvailusta. Luna menetti eniten pisteitä hyödyllisyydessä ja albumivalinnassa. Sen kuvatekstit olivat pelkistetympiä ja albumit epätarkempia.
Panostustasot
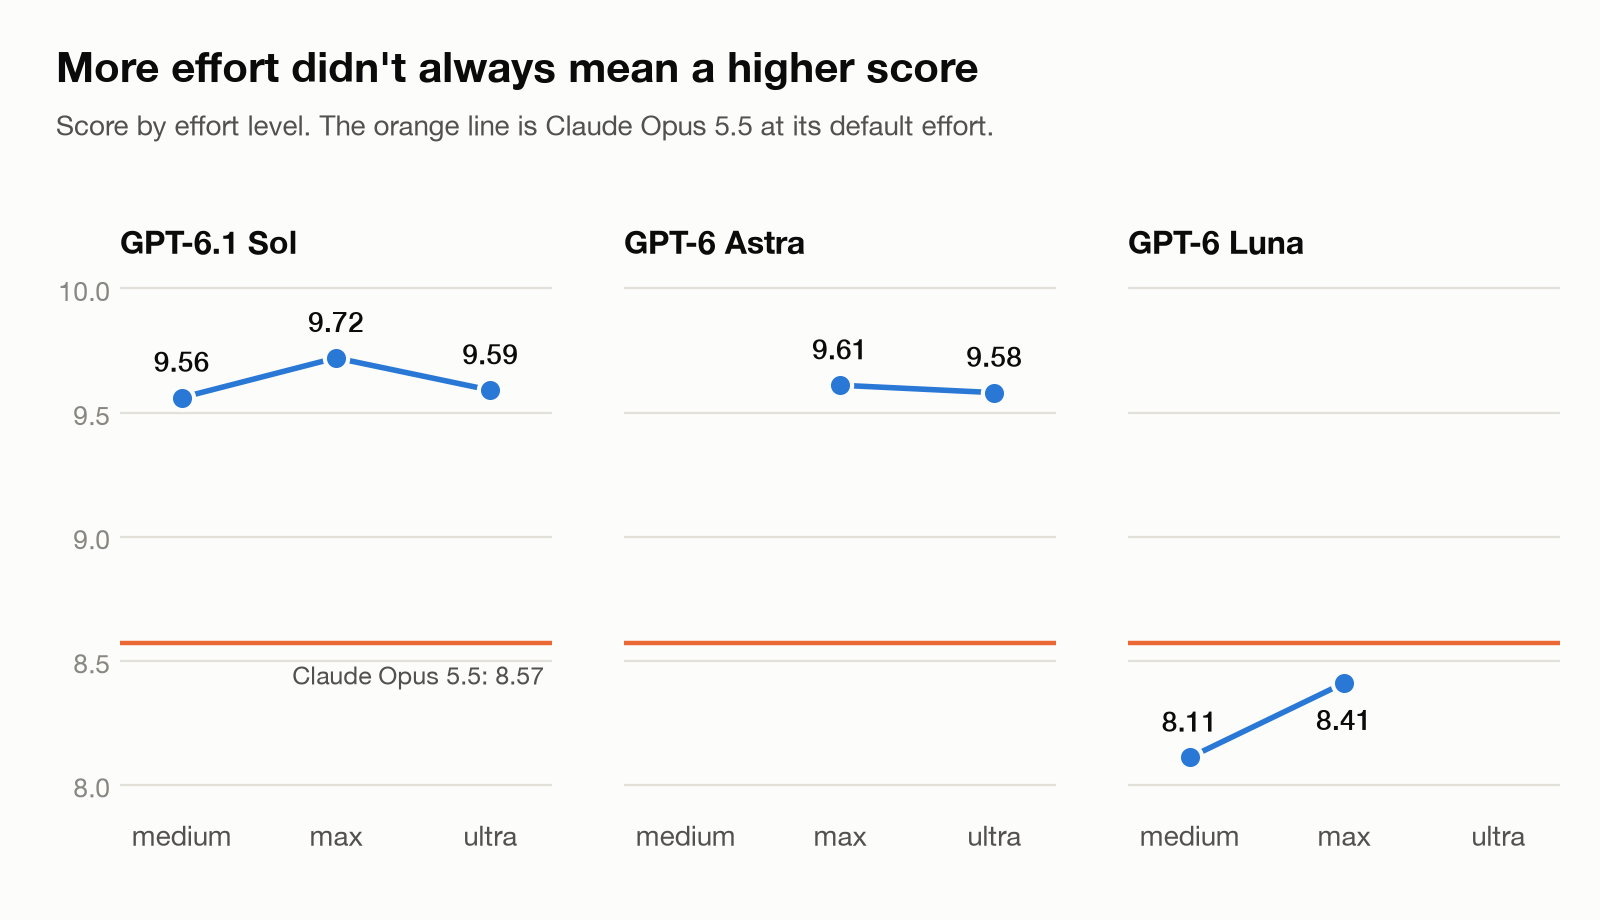 Kuva 7. Pisteet panostustason mukaan. Oranssi viiva on Claude Opus 5.5 oletuspanostuksellaan.
Ultra ei ollut maxia parempi kummallakaan mallilla. Sol sai 9.59 ultralla ja 9.72 maxilla; Astra sai 9.58 ja 9.61. Tässä testissä ultra tuotti jopa vähemmän tulostokeneita kuin max. Solille medium tuli lähelle arvolla 9.56, alle puolella maxin hinnasta. Suurempi panostus ei aina tarkoittanut tarkempia yksityiskohtia: Luna mediumilla sai 天虹:n oikein, Luna maxilla ei.
Virhe pisteytyksessäni
Pisteytyksen jälkeen huomasin, että arvioijille ei ollut annettu kunkin kuvan kuvauspäivää ja -aikaa, vaikka kuvailumallit olivat saaneet ne. Niinpä GPT-6 Astra -arvioija piti kuvatekstejä, jotka mainitsivat tarkan päivämäärän tai ajan, keksittyinä yksityiskohtina. Kärki-GPT-konfiguraatiot mainitsivat päivämäärän useimmin, joten niiden pisteet «ei keksittyjä yksityiskohtia» -kriteerissä jäivät alemmiksi kuin olisi pitänyt.
Jos palautan vain päivämääristä menetetyt pisteet, neljä parasta GPT-konfiguraatiota nousee 9.84–9.90:een, mikä on käytännössä tasapeli, ja Opus pysyy 8.58:ssa. Olen säilyttänyt alkuperäiset pisteet tässä kirjoituksessa. Ensi kerralla annan arvioijille kaiken, mitä mallit näkivät.
Nopeus
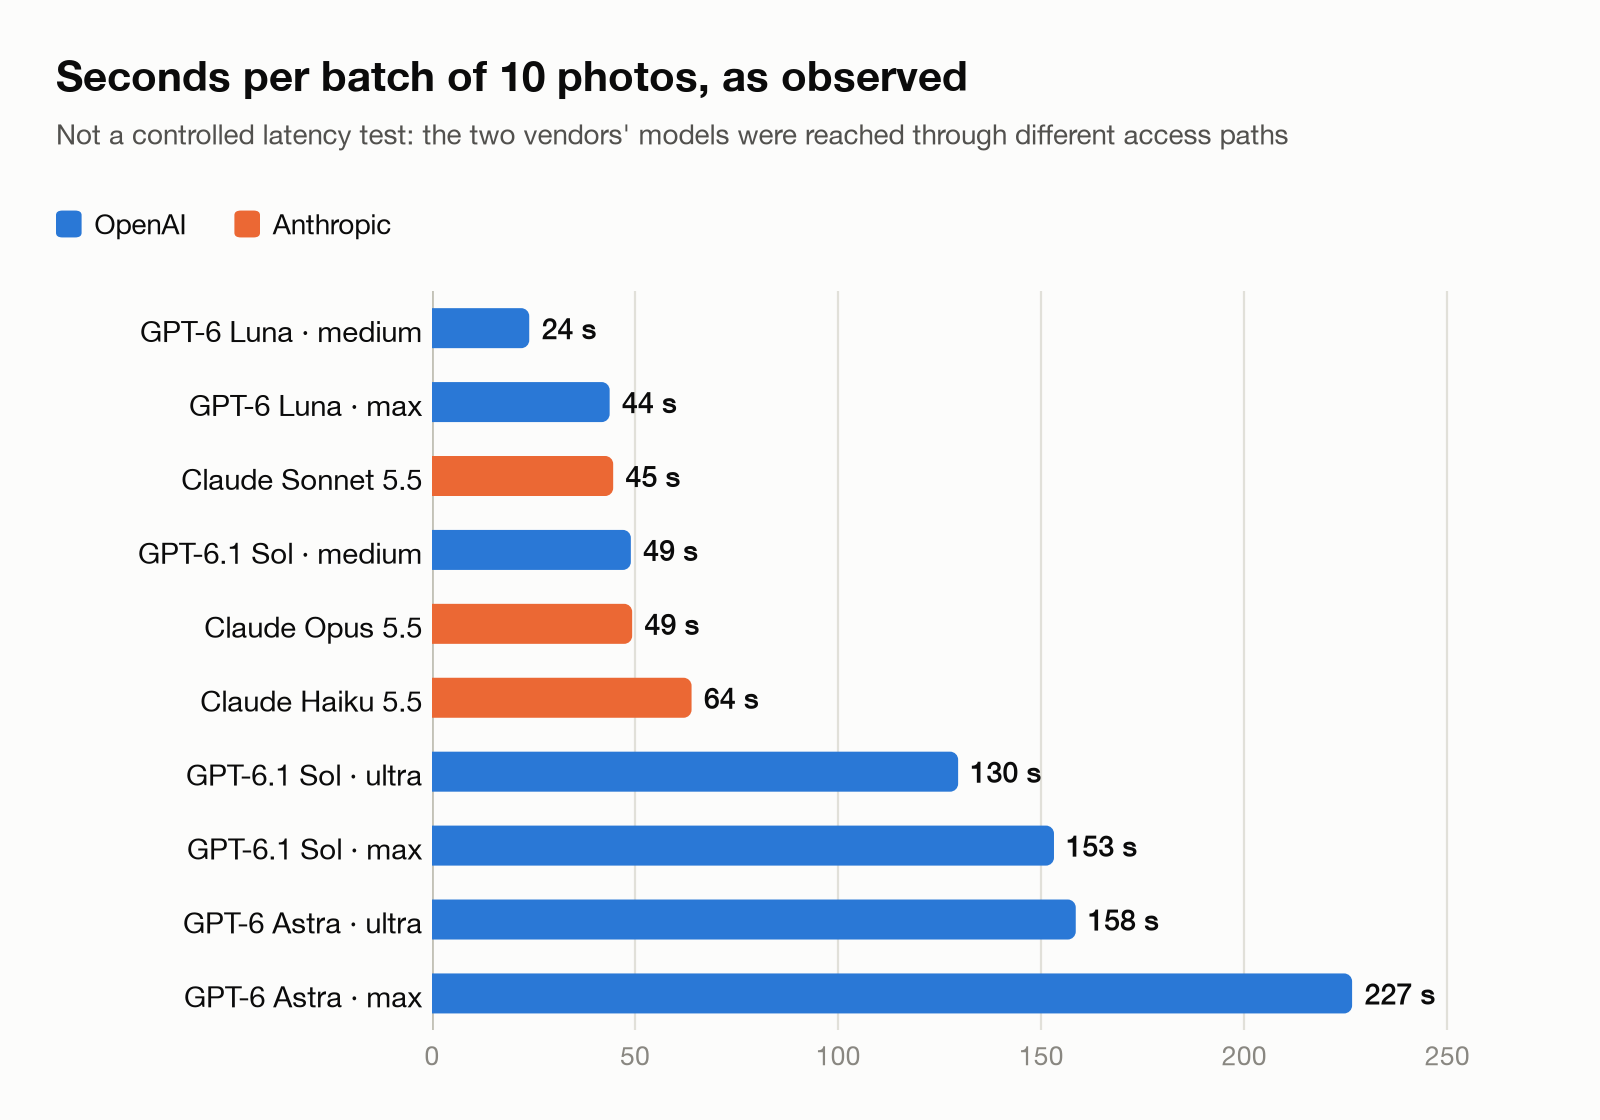 Kuva 8. Sekunnit 10 kuvan erää kohden, havaintojen mukaan. Tämä ei ole kontrolloitu viivetesti, koska kahden toimittajan malleja käytettiin eri reittejä pitkin.
Tämä vastaa sitä, miltä Opus tuntuu päivittäisessä työssäni: se on nopea, noin kolme kertaa nopeampi kuin Sol maxilla. Sol mediumilla oli kuitenkin yhtä nopea kuin Opus ja sai noin pisteen korkeammat pisteet.
Mitä se maksaa
Hinnoittelin jokaisen konfiguraation toimittajien virallisilla API-hinnoilla. Tilauspaketin sisältyvän käytön käsitteleminen ilmaisena saisi jotkin mallit näyttämään paremmilta kuin ne ovat.
Viralliset hinnat miljoonaa tokenia kohden, vakiotaso:
| Malli | Syöte | Tuloste |
|---|---|---|
| Claude Opus 5.5 | $4.00 | $20.00 |
| Claude Sonnet 5.5 | $2.00 | $10.00 |
| Claude Haiku 5.5 | $0.10 | $0.50 |
| GPT-6 Astra | $10.00 | $50.00 |
| GPT-6.1 Sol | $2.00 | $10.00 |
| GPT-6 Luna | $0.10 | $0.50 |
Molempien toimittajien Batch API:t maksavat 50% vähemmän, mikä sopii tällaiseen työhön, joka ei vaadi välittömiä vastauksia. Otin hinnat Anthropicin hintasivulta (claude.com/pricing) ja OpenAI:n API-hintasivulta (developers.openai.com/api/docs/pricing) 20. lokakuuta 2026.
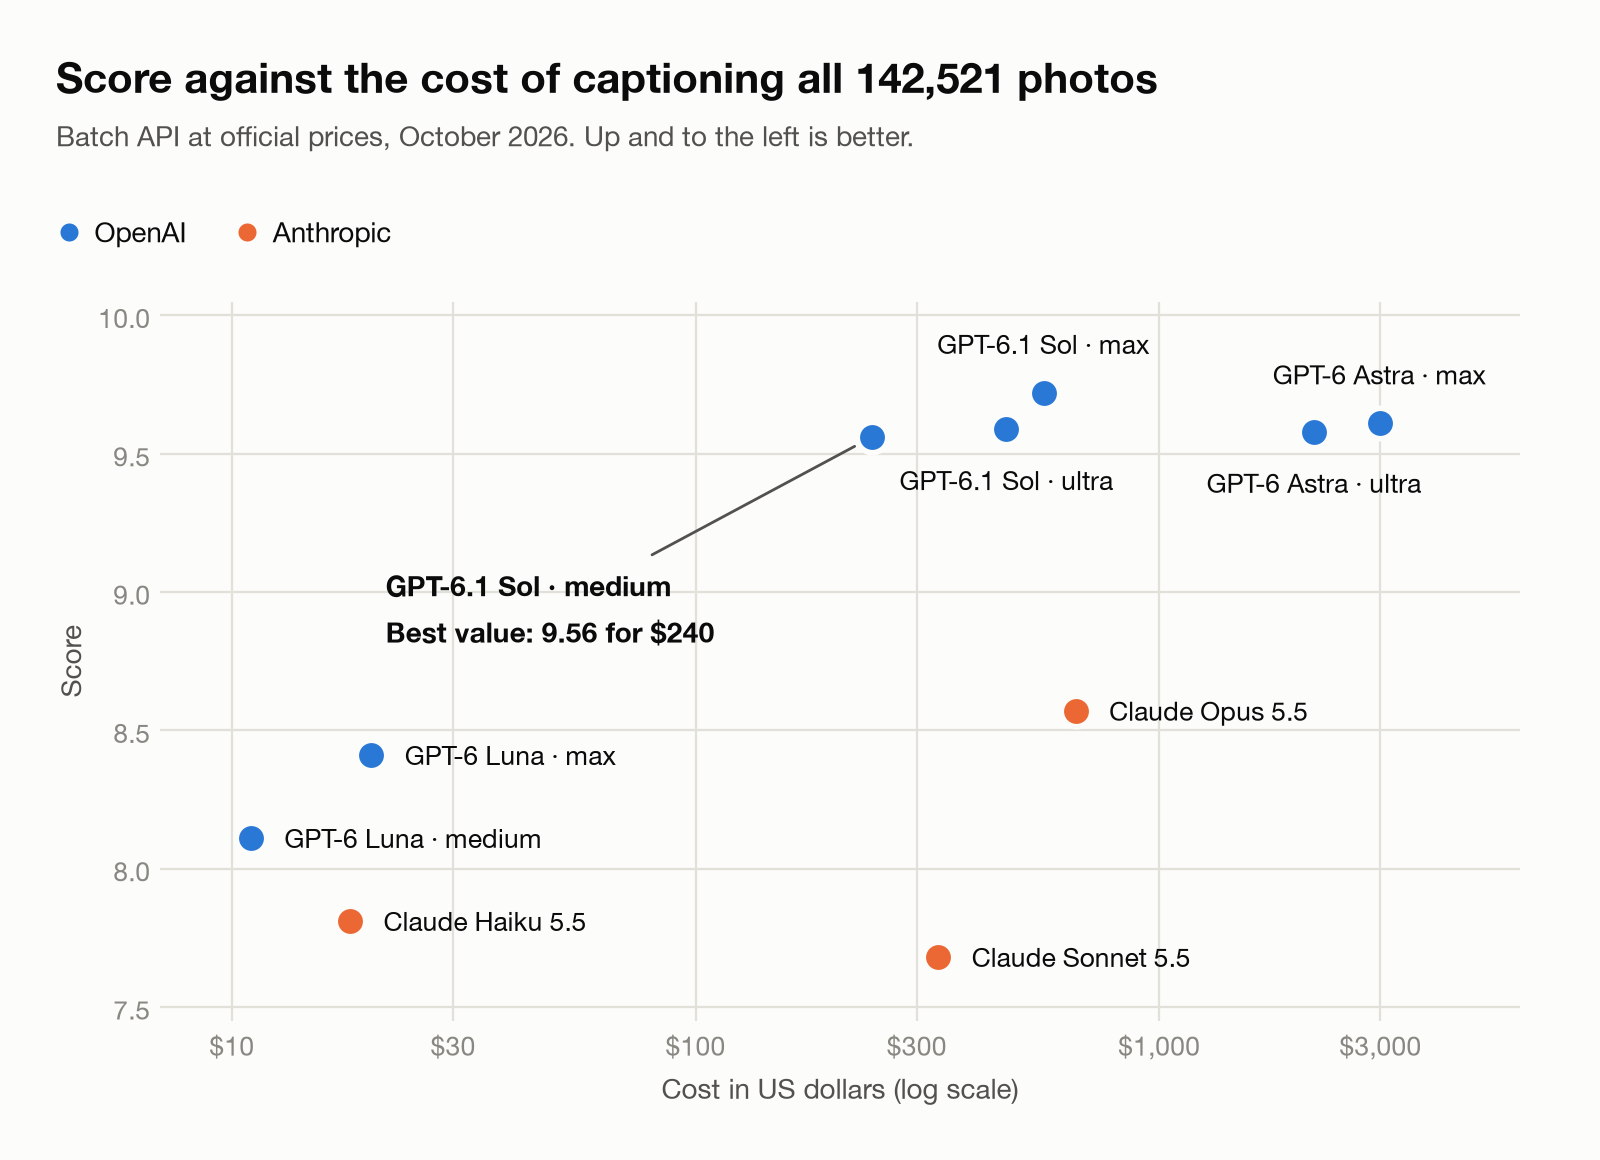 Kuva 9. Pisteet vastaan koko kirjaston kuvailun kustannus Batch-hinnoilla. Kustannusakseli on logaritminen.
| Malli ja panostus | Tulostokenit kuvaa kohden | Standardi | Batch | Pisteet |
|---|---|---|---|---|
| GPT-6.1 Sol, medium | 193 | $479 | $240 | 9.56 |
| GPT-6.1 Sol, ultra | 514 | $937 | $468 | 9.59 |
| GPT-6.1 Sol, max | 647 | $1,126 | $563 | 9.72 |
| Claude Opus 5.5 | ~292 | $1,323 | $661 | 8.57 |
| Claude Sonnet 5.5 | ~297 | $668 | $334 | 7.68 |
| GPT-6 Astra, ultra | 462 | $4,313 | $2,156 | 9.58 |
| GPT-6 Astra, max | 695 | $5,973 | $2,987 | 9.61 |
| GPT-6 Luna, medium | 163 | $22 | $11 | 8.11 |
| Claude Haiku 5.5 | ~330 | $36 | $18 | 7.81 |
| GPT-6 Luna, max | 419 | $40 | $20 | 8.41 |
Sol mediumilla sai 98% kärkituloksesta 36%:lla siitä, mitä Opus maksaisi, ja 43%:lla Solista maxilla. Astra vastasi Solin laatua mutta maksaa noin viisi kertaa enemmän, koska sen tokenihinta on viisi kertaa korkeampi. Opus maksoi enemmän kuin Sol maxilla ja sai vähemmän pisteitä. Se ajoi jo medium-panostuksella, mutta sen tokenihinta on kaksinkertainen Soliin verrattuna. Luna kuvailisi koko kirjaston hintaan $11–$20 ja päihittäisi silti Haikun ja Sonnetin.
Menetelmähuomautus: GPT-tokenmäärät mitattiin ajoista, ja Claude-tokenmäärät arvioitiin ajolokeista. Osa Clauden päättelytokeneista ei ollut näkyvissä, joten Clauden kustannukset voivat olla hieman aliarvioituja. Minkään mallin kohdalla ei sovellettu Batchin lisäksi muita alennuksia, kuten kehotteen välimuistitusta.
Mitä opin
Valitsin Opusin ennen kuin minulla oli sokkoutettuja pisteitä, lähinnä siksi, että se oli jo oletusvalintani koodaukseen. Pidän edelleen Claude Opus 5.5:tä parempana koodaukseen ja työnkulkuihin, joissa se on kokemukseni mukaan nopeampi ja vahvempi. Oikeiden kuvien kuvailu vaatii eri taitoa: sen lukemista, mitä kuvassa todella on, täyttämättä asentoja tai suhteita. GPT-6.1 Sol teki sen paremmin. Jos olisin edennyt tottumuksesta ja jättänyt sokkotestin väliin, olisin maksanut enemmän huonommista kuvateksteistä.
Ensi kerralla aloitan sokkoutetusti ja annan eri toimittajien arvioijille kaikki ne syötteet, jotka kuvailumallit saivat. Jatkan myös vertailua virallisilla API-hinnoilla, enkä oleta, että suurempi panostus on parempi: ultra ei päihittänyt maxia tässä.
Parhaatkin mallit merkitsivät hyödyllisiä kuvia poistettaviksi, joten tarkistan jokaisen poistomerkinnän itse ennen kuin poistan mitään.
Rajoitukset
Tämä oli pieni testi: 50 tuoretta kuvaa yhdestä kaupungista. En testannut vanhempia kuvia, skannattuja asiakirjoja, muita kieliä tai videoita. Claude-mallit ajoivat vain oletusasetuksillaan; suuremmalla panostuksella Opus voisi saada paremmat pisteet, korkeammalla hinnalla. Arvioijat ovat tekoälymalleja, eivät ihmisiä. Ne olivat hyvin samaa mieltä mutta eivät täydellisesti, ja ihmisen pistokoe tekisi tuloksesta vahvemman. Mallit ja hinnat muuttuvat nopeasti, ja jokainen luku tässä on lokakuulta 2026.
Valintani
Kirjastolleni: GPT-6.1 Sol medium-panostuksella. Koodaukseen ja työnkulkuihin pysyn Claude Opus 5.5:ssä.