
제 142,000장짜리 사진 라이브러리에서 AI 모델 10개를 블라인드 테스트했습니다: GPT-6.1 Sol이 Claude Opus를 이겼습니다
요약
저는 코딩과 워크플로에 매일 Claude Opus 5.5를 사용하며, 그 작업에서는 GPT-6보다 빠르고 낫다고 느낍니다. 사진 설명에서도 가장 뛰어날 것이라고 생각해 테스트해 보았습니다. 구성 10가지를 돌렸습니다. Claude Haiku, Sonnet, Opus 5.5, 그리고 OpenAI의 GPT-6.1 Sol, GPT-6 Astra, GPT-6 Luna를 여러 추론 강도로. 각 구성은 제 142,521장짜리 라이브러리에서 실제 사진 50장에 제목을 붙이고, 캡션을 쓰고, 키워드를 달고, 앨범에 정리했으며, 삭제해야 한다고 생각하는 사진에 플래그를 달았습니다. 서로 다른 벤더의 블라인드 채점자 2명, Claude Fable 5.1과 GPT-6 Astra가 사실, 지어낸 내용, 삭제 판단, 앨범 적합성, 유용성의 다섯 기준으로 답변 500개를 모두 채점했습니다. GPT-6.1 Sol이 10점 만점에 9.72점으로 최고점을 받았습니다. Opus는 8.57점, Sonnet과 Haiku는 7.77.8점이었습니다. ultra는 max보다 낫지 않았습니다. 공식 Batch API 가격 기준으로 라이브러리 전체에 캡션을 다는 데는 medium(9.56점)의 Sol로 약 $240, Opus로 $661, Luna로 $11$20이 들며, Luna는 Haiku를 앞섰습니다.
왜 이 테스트를 했나
제 하루의 대부분은 코딩, 에이전트 워크플로, 자동화에 쓰이고, 제가 찾는 모델은 Claude Opus 5.5입니다. 그런 작업에서는 GPT-6보다 빠르고 낫다고 느껴 왔습니다. 그래서 AI로 사진 라이브러리에 캡션과 태그를 달기로 했을 때, 저는 망설임 없이 Opus를 골랐습니다.
이 라이브러리는 제 25년의 인생입니다. 초창기 디지털카메라 사진부터 지난주 휴대폰 사진까지 142,521장에, 스크린샷만 16,000장이 넘습니다. 거의 어느 사진에도 캡션이 없습니다. 저는 모든 사진에 제목, 캡션, 검색할 수 있는 키워드, 적절한 앨범, 그리고 중복이나 쓰레기일 때 정직한 플래그가 붙기를 원합니다. 142,000장을 처리하는 데 돈을 내기 전에, 어떤 모델이 이 일을 가장 잘하는지, 그 차이에 얼마의 비용이 드는지 알고 싶었습니다.
저는 Opus가 이길 것이라고 예상했습니다. 이 50장의 사진에서는 GPT-6.1 Sol이 1점 이상 더 높았습니다.
결과 한눈에 보기
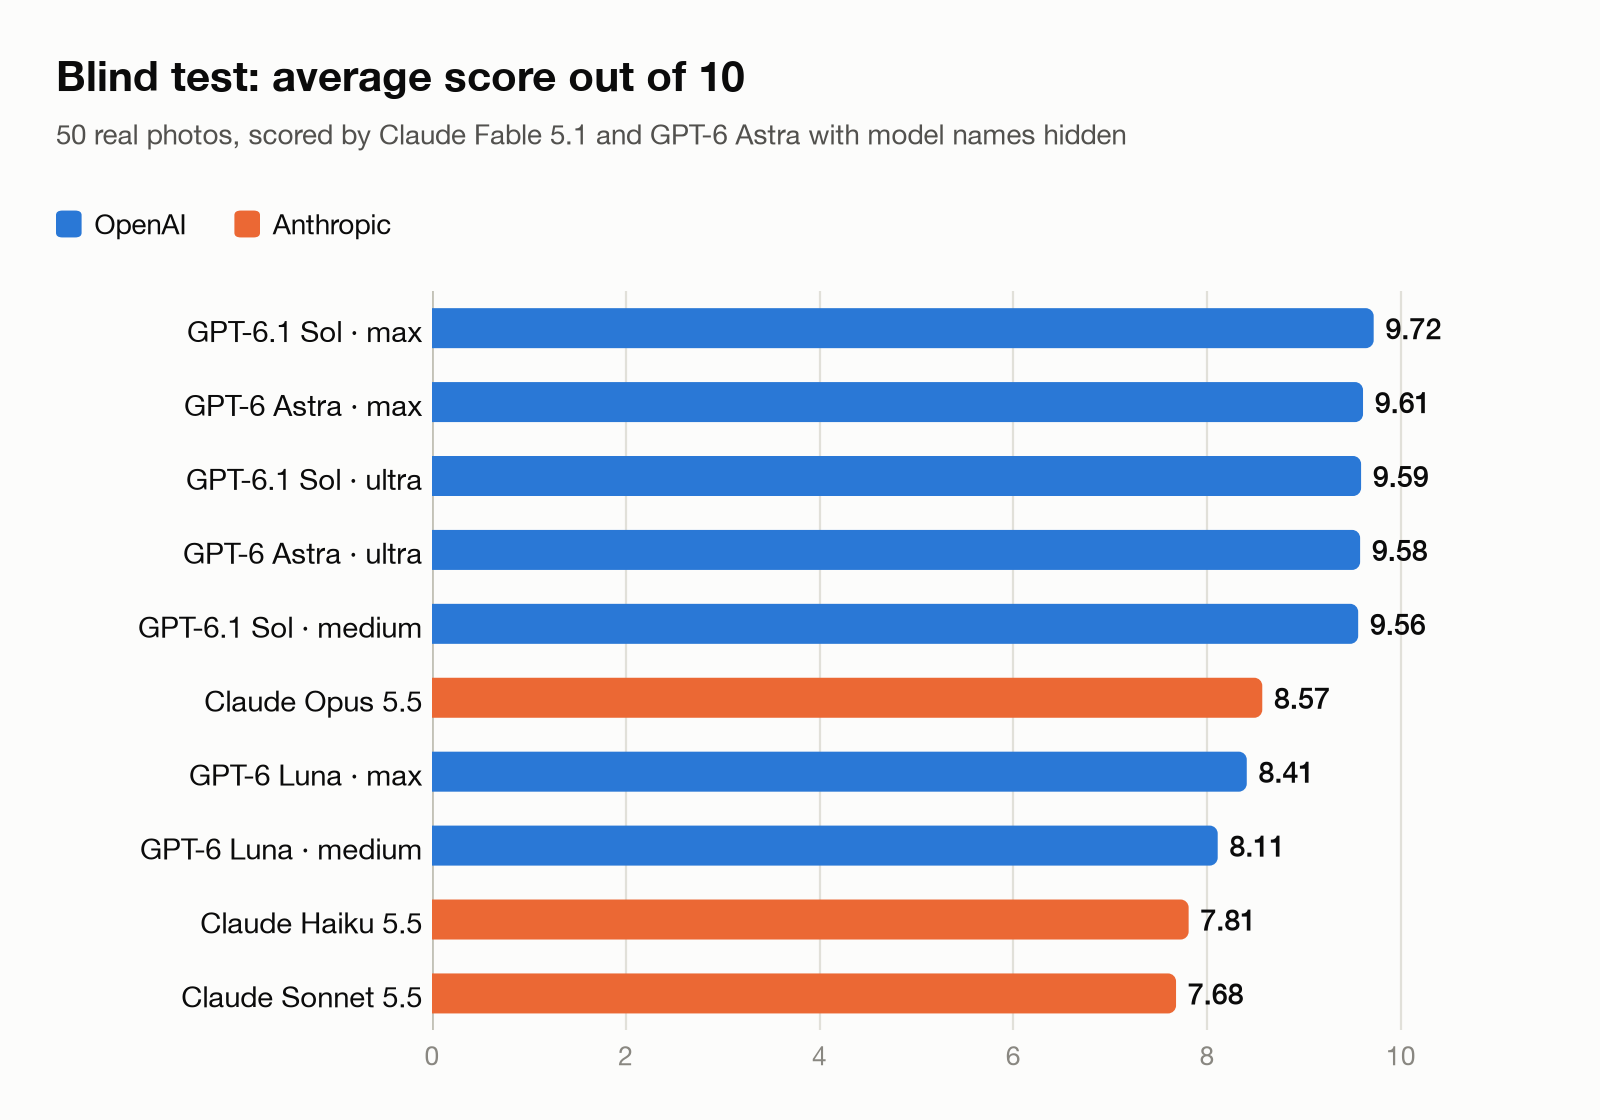 그림 1. 블라인드 채점자 2명의 평균 점수, 10점 만점.
| 순위 | 모델과 추론 강도 | 점수(10점 만점) | 전체 라이브러리, Batch API | 전체 라이브러리, 표준 API |
|---|---|---|---|---|
| 1 | GPT-6.1 Sol, max | 9.72 | $563 | $1,126 |
| 2 | GPT-6 Astra, max | 9.61 | $2,987 | $5,973 |
| 3 | GPT-6.1 Sol, ultra | 9.59 | $468 | $937 |
| 4 | GPT-6 Astra, ultra | 9.58 | $2,156 | $4,313 |
| 5 | GPT-6.1 Sol, medium | 9.56 | $240 | $479 |
| 6 | Claude Opus 5.5 | 8.57 | $661 | $1,323 |
| 7 | GPT-6 Luna, max | 8.41 | $20 | $40 |
| 8 | GPT-6 Luna, medium | 8.11 | $11 | $22 |
| 9 | Claude Haiku 5.5 | 7.81 | $18 | $36 |
| 10 | Claude Sonnet 5.5 | 7.68 | $334 | $668 |
비용은 142,521장 전체를 각 벤더의 공식 API 가격으로 처리했을 때의 값입니다.
이 테스트를 바탕으로 제가 쓸 것은:
- 점수만 따진다면, GPT-6.1 Sol의 max.
- 제 라이브러리에는 GPT-6.1 Sol의 medium. $240에 최고 점수의 98%를 얻었고, 이는 Opus 비용의 약 3분의 1입니다.
- 예산이 빠듯하다면, GPT-6 Luna의 max. $20에 토큰 단가가 같은 Haiku를, 이 라이브러리 기준으로 약 17배 비싼 Sonnet을 앞섰습니다.
- Claude Sonnet 5.5는 아닙니다. 중간 가격인데 점수가 가장 낮았습니다.
테스트한 모델
| 벤더 | 모델 | 테스트한 추론 강도 | 포지셔닝 |
|---|---|---|---|
| Anthropic | Claude Opus 5.5 | 기본값(medium) | 플래그십 일상 주력 |
| Anthropic | Claude Sonnet 5.5 | 기본값 | 중간 등급 |
| Anthropic | Claude Haiku 5.5 | 기본값 | 빠르고 저비용 |
| OpenAI | GPT-6 Astra | max, ultra | 프런티어 모델 |
| OpenAI | GPT-6.1 Sol | medium, max, ultra | 주력 |
| OpenAI | GPT-6 Luna | medium, max | 빠르고 저비용 |
가격은 두 벤더가 서로 대응합니다. GPT-6.1 Sol은 Claude Sonnet 5.5와, GPT-6 Astra는 Claude Fable 5.1과, GPT-6 Luna는 Claude Haiku 5.5와 토큰 단가가 같고, Claude Opus 5.5는 Sol과 Astra 사이에 있습니다. 그래서 아래에서 두 모델의 비용이 달라진다면, 그 대부분은 같은 일에 한쪽이 더 많은 토큰을 썼기 때문입니다.
Claude 모델은 각각 기본 설정으로 한 번씩 돌렸는데, Opus에게 기본값은 medium을 뜻합니다. GPT 모델은 여러 추론 강도로 테스트했습니다. 가장 근접한 동일 조건 비교는 medium의 GPT-6.1 Sol과 medium의 Claude Opus 5.5입니다. 9.56 대 8.57입니다.
테스트 방법
당시 라이브러리에서 가장 최근의 사진 50장을, 동영상은 빼고 사용했습니다. 제 카메라 롤의 평범한 한 주입니다. 집과 쇼핑 나들이에서의 가족 순간, 고층에서 바라본 도시 풍경, 책상 위의 메모리 카드, 전자 부품 상품 페이지 스크린샷, 주문 추적 스크린샷, 소셜 미디어 게시물, 주차 할인 QR 간판, EV 충전기 라벨.
각 모델은 사진마다 다섯 가지 일을 했습니다. 짧은 제목과 한 문장에서 세 문장까지의 중국어 캡션을 쓰고, 중국어와 영어로 키워드 5~12개를 달고, 기존 앨범에서 가장 알맞은 것을 고르거나 고르지 않았습니다. 그런 다음 품질 점수를 매기고, 중복, 실패한 촬영, 만료된 스크린샷, 지속적 가치가 없는 사진을 찾아 사진을 보관할지 삭제할지 말했습니다. 모든 모델은 사진마다 같은 지시와 같은 맥락을 받았고, 한 번에 10장씩 처리했습니다.
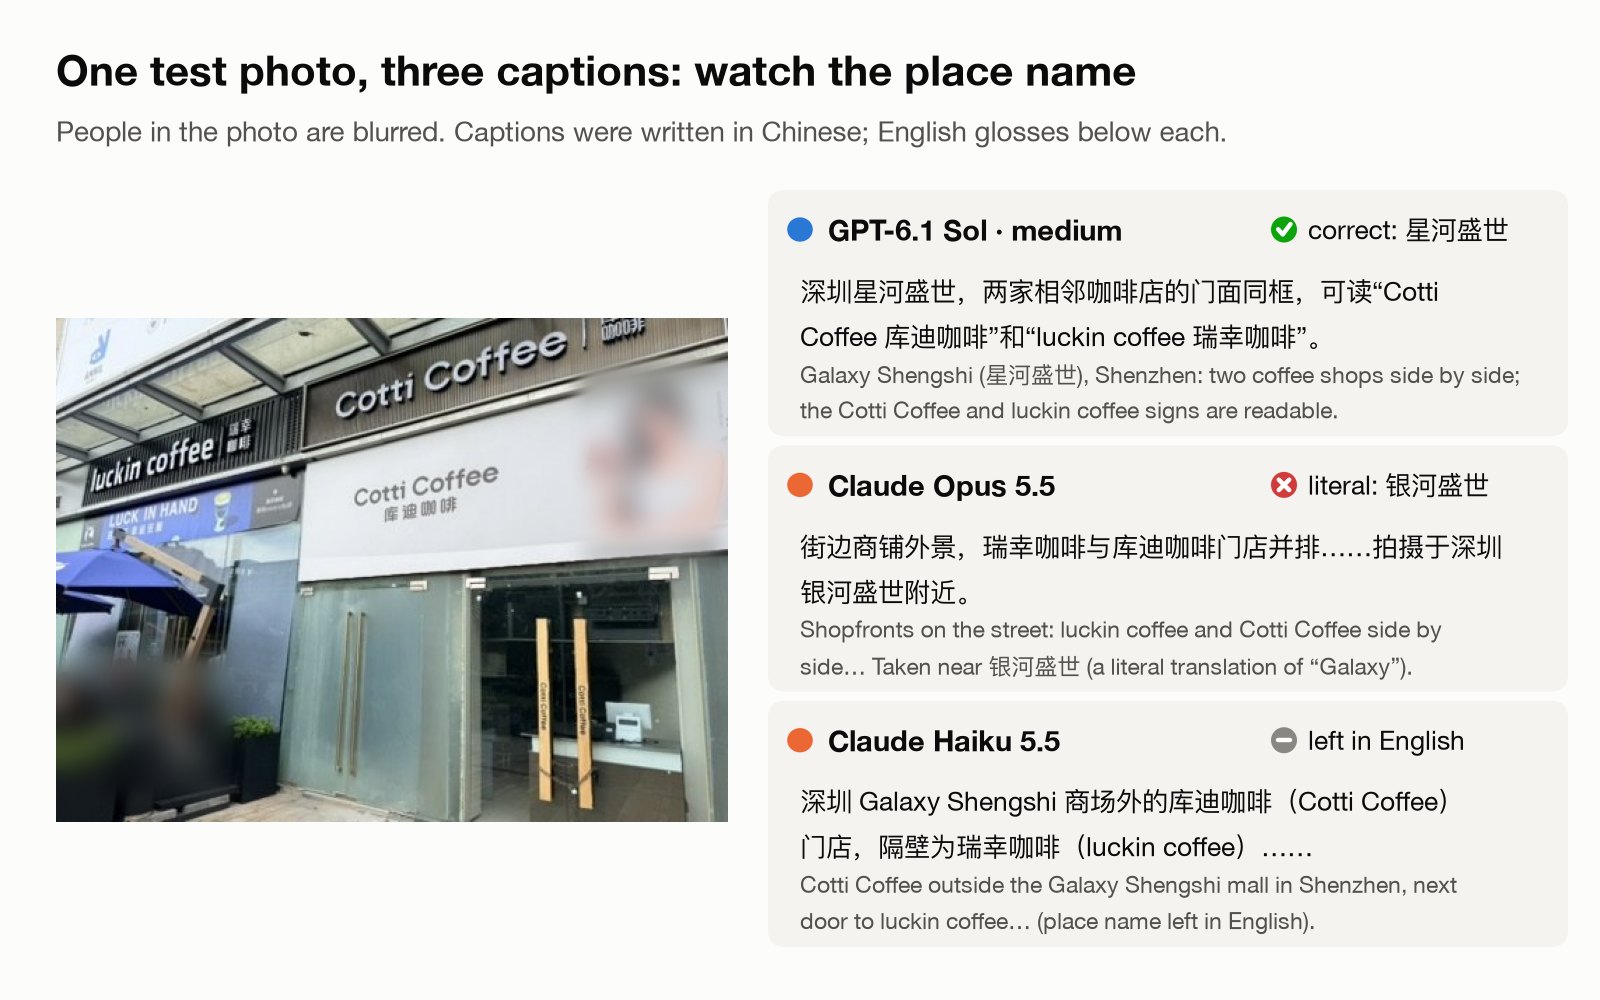 그림 2. 테스트 사진 50장 중 하나와 캡션 세 개. 각 모델이 지명을 어떻게 다루는지 보세요. 아래에서 다시 다룹니다. 사진 속 인물은 흐리게 처리했습니다.
채점 방법
답변은 제가 직접 채점하지 않았습니다. 테스트 전에 이미 승자를 정해 두었고, 매일 Claude를 쓰기 때문에 중립적이지 않았기 때문입니다.
대신, 각 사진의 답변 10개를 섞어 A부터 J까지 라벨을 붙이고, 사진마다 새로운 무작위 순서를 썼습니다. 그런 다음 채점자 2명이 사진을 보면서 답변 500개를 모두 독립적으로 채점했습니다. 한 명은 Anthropic의 가장 유능한 모델인 Claude Fable 5.1, 다른 한 명은 OpenAI의 프런티어 모델인 xhigh의 GPT-6 Astra였습니다.
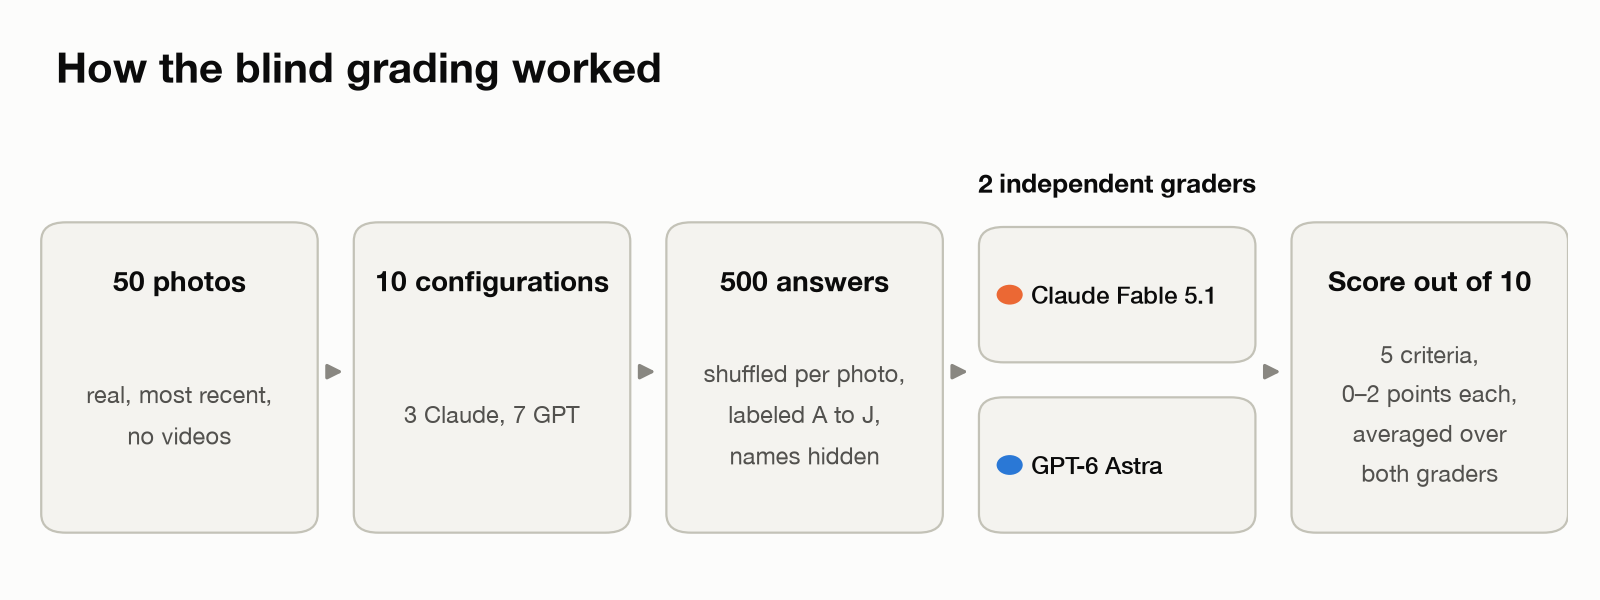 그림 3. 블라인드 채점이 어떻게 이뤄졌는지.
각 답변은 다섯 기준으로, 기준마다 0~2점, 총 10점으로 채점되었습니다:
| 기준 | 채점자가 확인한 것 |
|---|---|
| 사실 | 피사체, 장소, 읽을 수 있는 모든 텍스트가 현지 지명을 포함해 정확한가? |
| 지어낸 내용 없음 | 사진에 보이지 않는 것을 주장하지 않는가? |
| 삭제 판단 | 보관 또는 삭제가 합리적인가? 좋은 사진을 삭제하면 0점. |
| 앨범 적합성 | 앨범이 올바른가? 엉뚱한 옛 앨범은 0점, 앨범 없음은 허용되는 1점. |
| 유용성 | 제목, 캡션, 키워드가 나중에 이 사진을 찾고 기억하는 데 도움이 되는가? |
각 벤더에서 한 명씩 채점자를 뽑은 것은 어느 쪽이 자사 모델을 편애하는지 보기 위해서였습니다. 두 명은 대체로 일치했습니다. 500쌍 점수의 상관관계는 0.71이었고, 둘 다 같은 GPT 구성 5개를 상위에 놓았습니다. Claude 채점자도 GPT-6.1 Sol과 GPT-6 Astra를 Claude Opus보다 높게 매겼습니다. GPT 채점자는 전반적으로 더 엄격했고, Claude 모델에 가장 엄격했습니다.
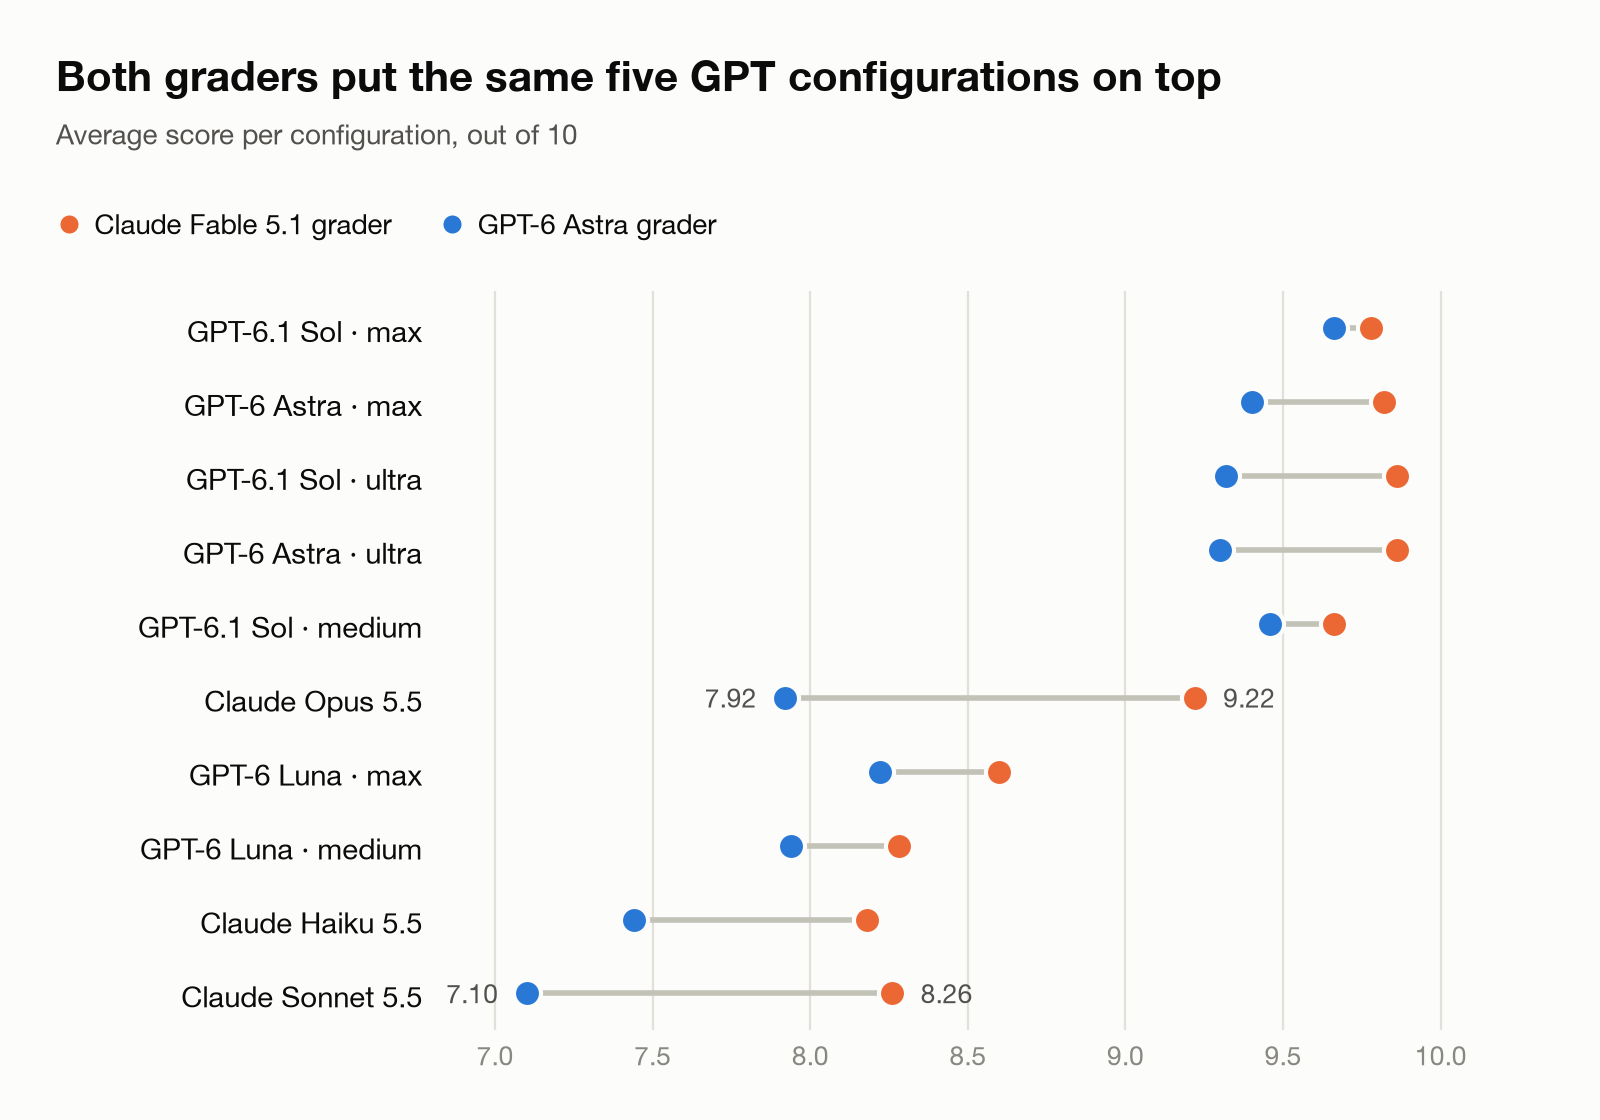 그림 4. 구성별 각 채점자의 평균 점수.
결과
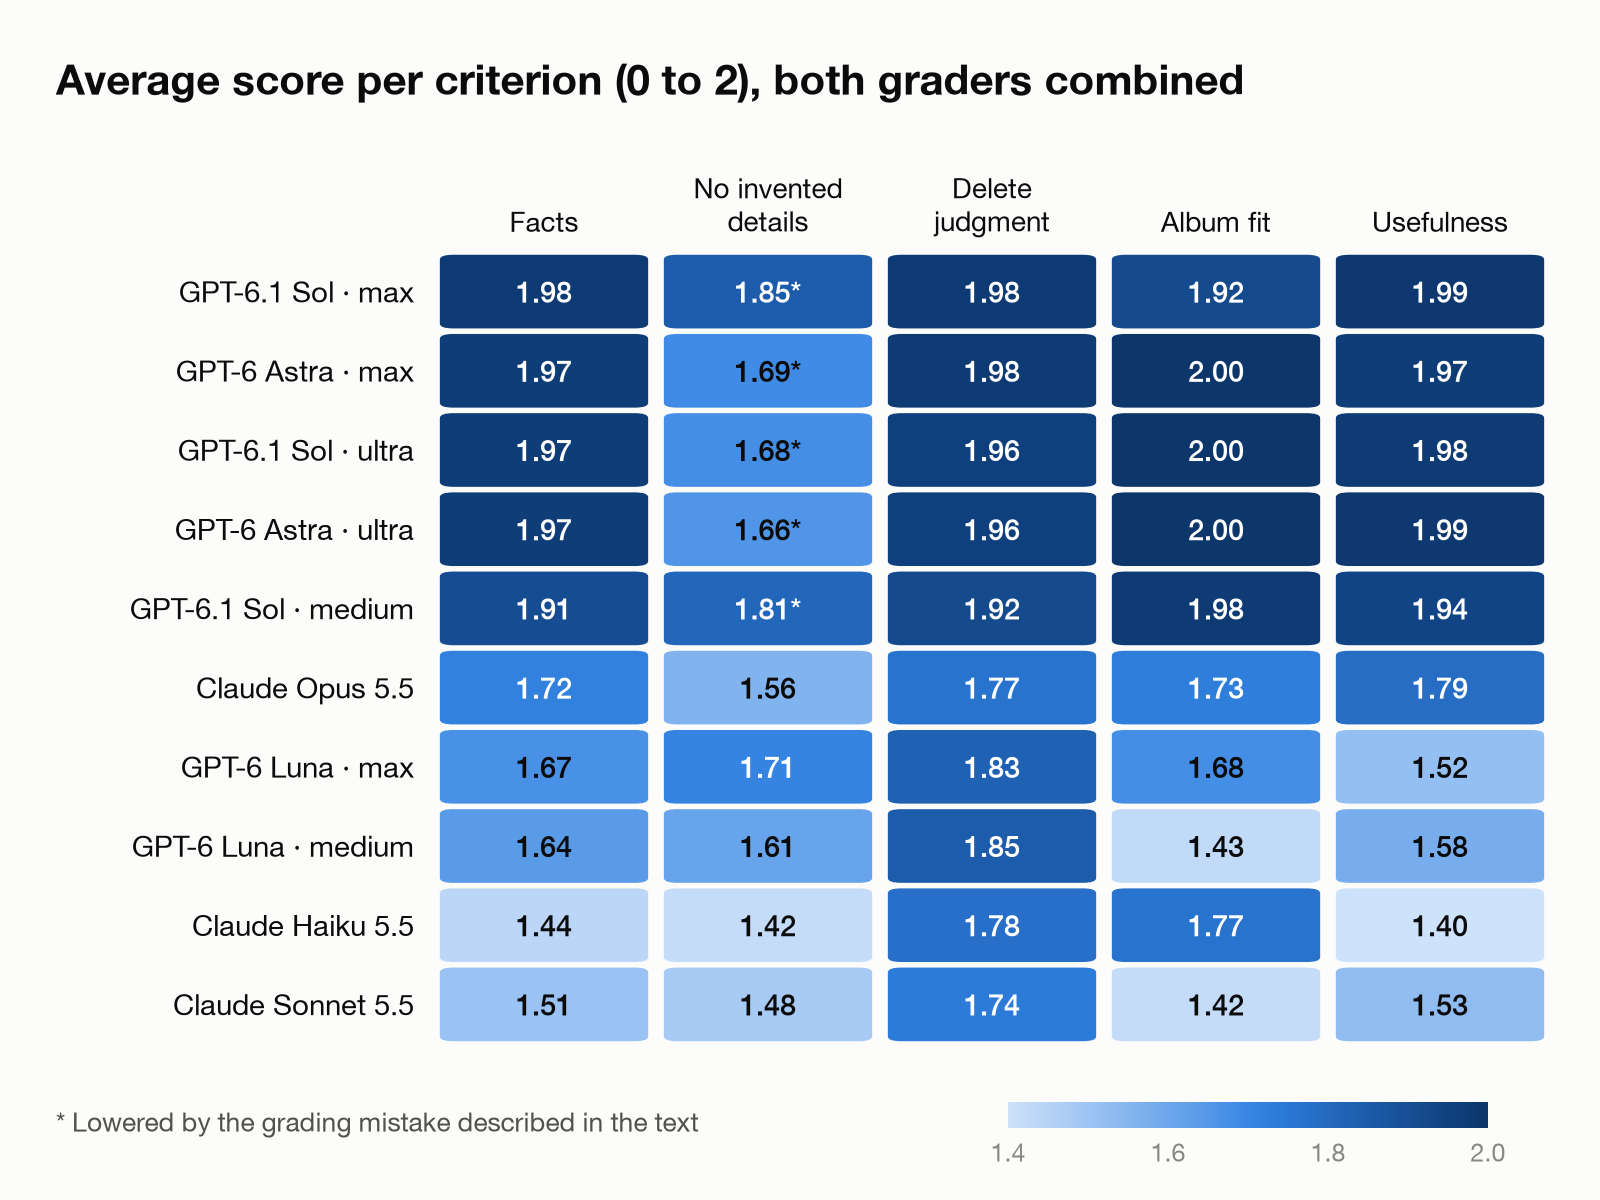 그림 5. 기준별 평균 점수, 두 채점자 합산. 별표는 아래에서 설명하는 채점 실수로 낮아진 점수를 표시합니다.
GPT-6.1 Sol과 GPT-6 Astra
Sol과 Astra는 텍스트를 정확하게 읽었고, 캡션을 사진에 보이는 내용으로 대체로 한정했습니다. 현지 지명에서도 가장 뛰어났는데, 이는 중국에서 찍은 사진에 중요합니다.
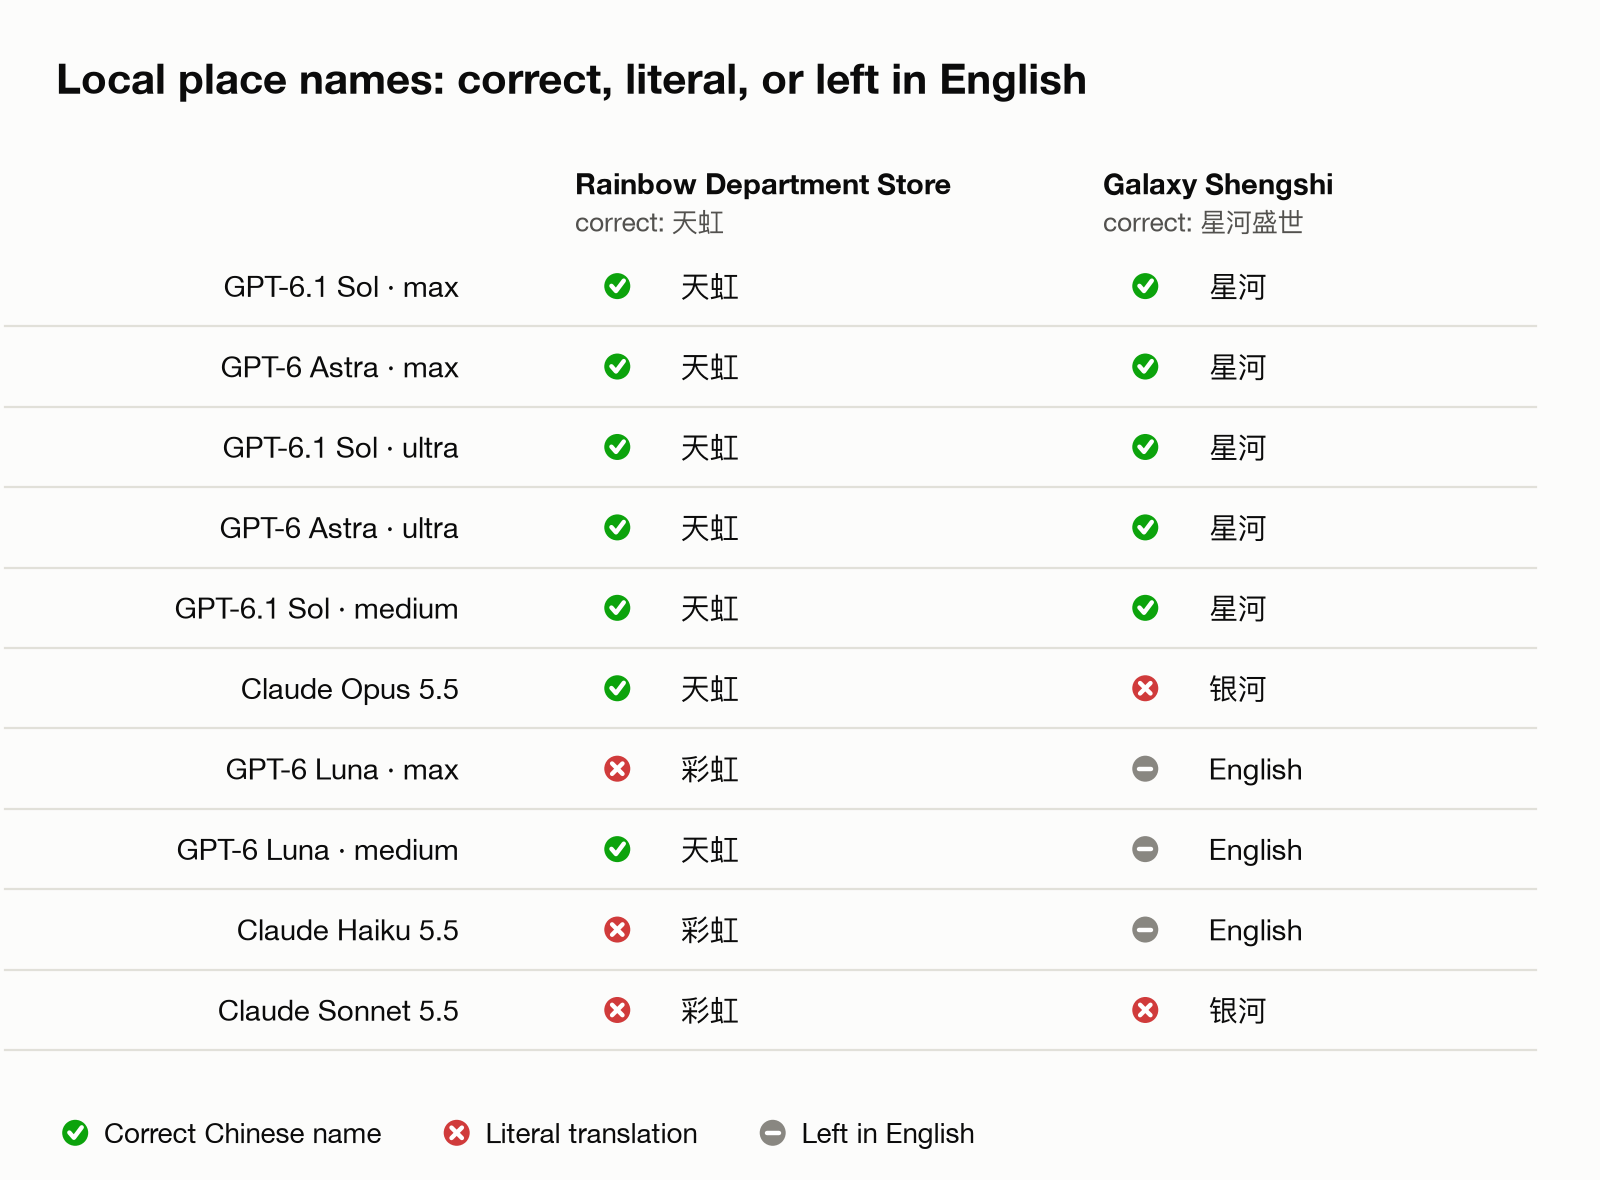 그림 6. 지명 테스트 두 개. 체크는 올바른 중국어 이름, 엑스는 직역, EN은 영어로 남은 것을 뜻합니다.
여러 사진에 "Rainbow Department Store"라는 위치가 태그되었습니다. 이는 선전의 쇼핑몰 체인 天虹의 영어 이름입니다. 낱말 그대로 옮기면 彩虹百貨가 되는데, 이는 틀립니다. 모든 Sol과 Astra 구성이 이를 맞혔고, Opus와 medium의 Luna도 맞혔습니다. Haiku, Sonnet, max의 Luna는 직역을 썼습니다. 그림 2의 커피숍 사진에는 "Galaxy Shengshi"로 태그되었고, 그 중국어 이름은 星河盛世입니다. 모든 Sol과 Astra 구성은 星河으로 썼습니다. Opus와 Sonnet은 銀河로 직역했고, Haiku와 두 Luna 구성은 영어로 남겼습니다.
Sol과 Astra는 삭제에서도 신중했습니다. 50장 중 46장의 삭제를 제안했습니다. 세트에는 전자 부품 상품 페이지 스크린샷 8장이 있었는데, GPT 모델은 거의 모두 보관했습니다. 한 Sol 구성만 스크린샷 한 장을 거의 중복으로 플래그했습니다. Claude 모델은 각각 24장을 플래그했습니다. 두 채점자 모두 보관하는 쪽에 찬성했는데, 그 페이지에는 나중에 다시 찾아볼 핀 배치, 치수, 기판 사진이 있었기 때문입니다.
Claude Opus 5.5
Opus는 사진만으로는 알 수 없는 것을 캡션에 써 넣을 때가 있었습니다. 형제자매나 부모와 자식처럼 이미지만으로는 증명할 수 없는 관계를 묘사했습니다. 포즈도 몇 개 틀렸습니다. 한 사진에서는 아이가 어른 뒤에 서 있었는데, Opus는 아이가 어른 등에 업혀 있다고 썼습니다. 두 채점자 모두 이 때문에 감점했습니다.
이는 놀라웠습니다. 블라인드 테스트 전에 답변을 훑어보고, 두 아이가 형제라고 정확히 추측한 Opus를 칭찬하기까지 했습니다. 저는 제 가족을 알지만 채점자는 모릅니다. 하지만 사진 142,000장을 두고 모든 캡션을 제가 직접 확인할 수는 없고, 사진에 없는 것을 말하는 캡션은 문제입니다.
Opus는 삭제 제안도 가장 많아 50장 중 13장이었습니다. 그중 3장은 상품 페이지 스크린샷으로, 보관하고 싶은 참고 정보가 있었는데도 만료됐다고 했습니다. 주차 할인 QR 간판을 가치가 낮다며 삭제하려 한 유일한 모델이기도 했습니다. 또 한 사람이 나온 사진 여러 장을 "가족사진" 앨범에 넣었습니다.
Claude Sonnet 5.5와 Haiku 5.5
이 둘은 天虹의 직역 "彩虹"을 포함해 사실 오류가 가장 많았습니다. Sonnet은 앨범 선택이 가장 약했고, 일상 사진을 무관한 과거 행사의 옛 앨범에 넣었습니다. Haiku는 잘못된 삭제 판단으로 이어지는 세부 내용을 지어냈습니다. 거의 같은 연사에서 가장 좋은 프레임을 "누군가 아래를 보고 있다"고 설명했는데, 이는 사진과 정반대였고, 삭제를 제안했습니다.
GPT-6 Luna
Luna는 Haiku와 토큰 단가가 같지만 두 추론 강도 모두에서 Haiku보다 높은 점수를 받았습니다. 8.41과 8.11로, Haiku는 7.81입니다. max에서는 같은 라이브러리에 캡션을 다는 데 약 17배가 드는 Sonnet도 앞섰습니다. Luna는 유용성과 앨범 선택에서 가장 많이 잃었습니다. 캡션이 더 수수하고 앨범도 덜 정확했습니다.
추론 강도
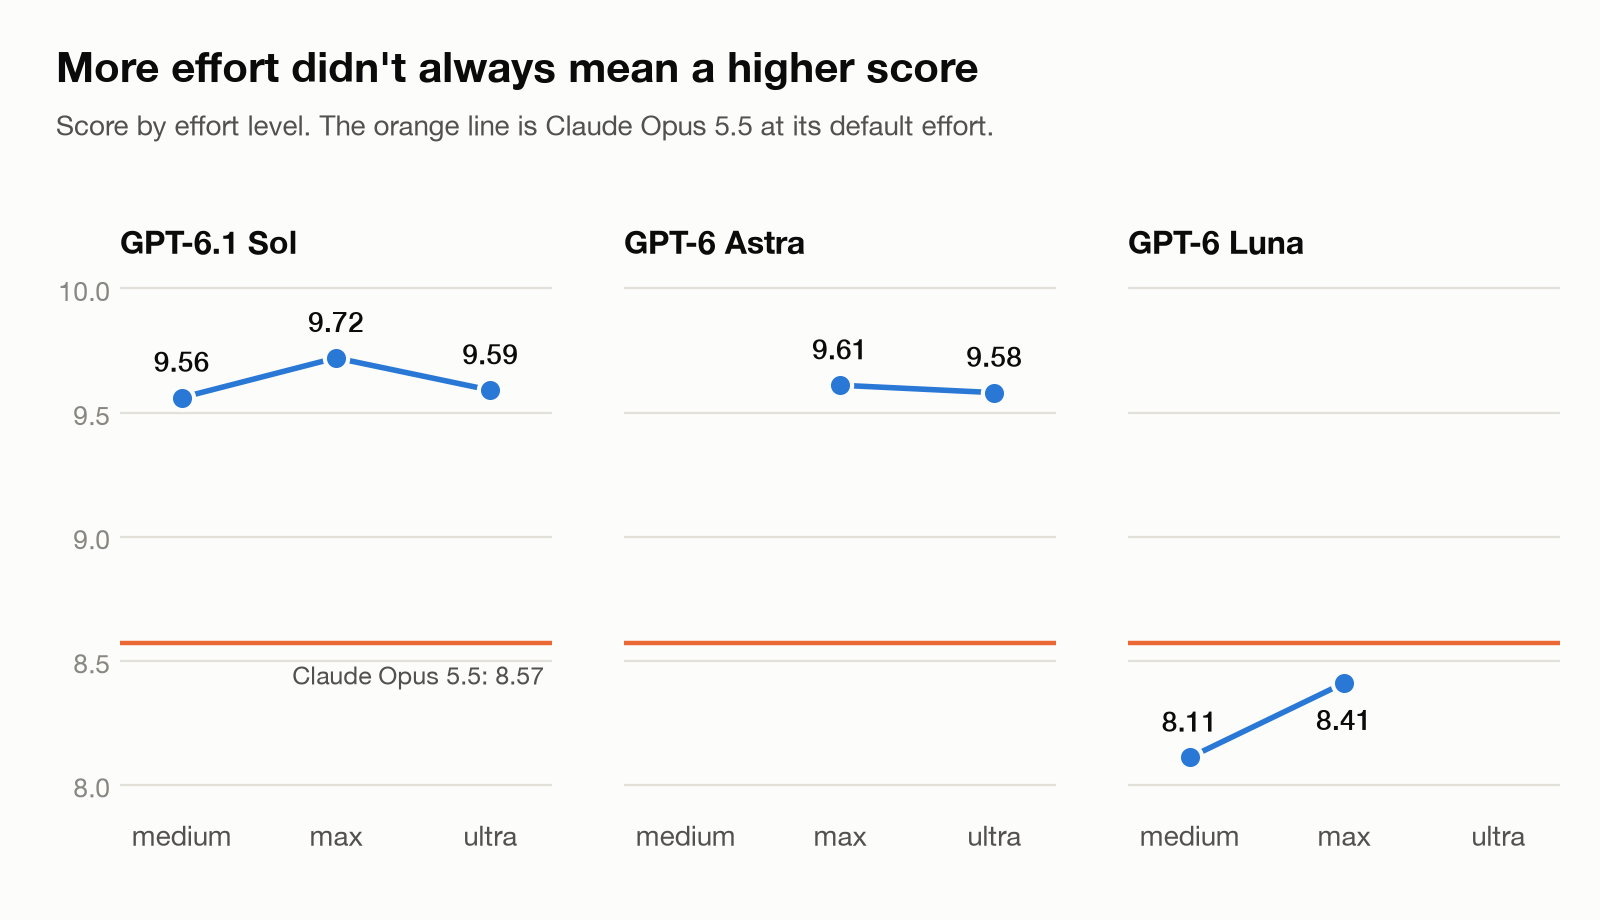 그림 7. 추론 강도별 점수. 주황선은 기본 추론 강도의 Claude Opus 5.5입니다.
ultra는 어느 모델에서도 max보다 낫지 않았습니다. Sol은 ultra에서 9.59, max에서 9.72점이었고, Astra는 9.58과 9.61점이었습니다. 이 테스트에서는 ultra가 max보다 출력 토큰이 오히려 적었습니다. Sol의 경우 medium이 9.56점으로 근접했고, 비용은 max의 절반 미만이었습니다. 추론 강도가 높다고 세부 내용이 항상 정확한 것도 아니었습니다. medium의 Luna는 天虹을 맞혔지만 max의 Luna는 틀렸습니다.
채점의 실수 하나
채점 후에, 캡션 모델에는 각 사진의 촬영 날짜와 시간이 주어졌는데 채점자에게는 주어지지 않았다는 것을 알아차렸습니다. 그래서 GPT-6 Astra 채점자는 정확한 날짜나 시간을 언급한 캡션을 지어낸 내용으로 취급했습니다. 상위 GPT 구성이 날짜를 가장 자주 언급했기 때문에, 그 "지어낸 내용 없음" 점수가 마땅한 것보다 낮게 나왔습니다.
날짜로 잃은 점수만 되돌려도 상위 GPT 구성 4개는 9.84~9.90으로 올라가 사실상 동점이 되고, Opus는 8.58에 머뭅니다. 저는 이 글에서 원래 점수를 유지했습니다. 다음에는 모델이 본 모든 것을 채점자에게도 줄 것입니다.
속도
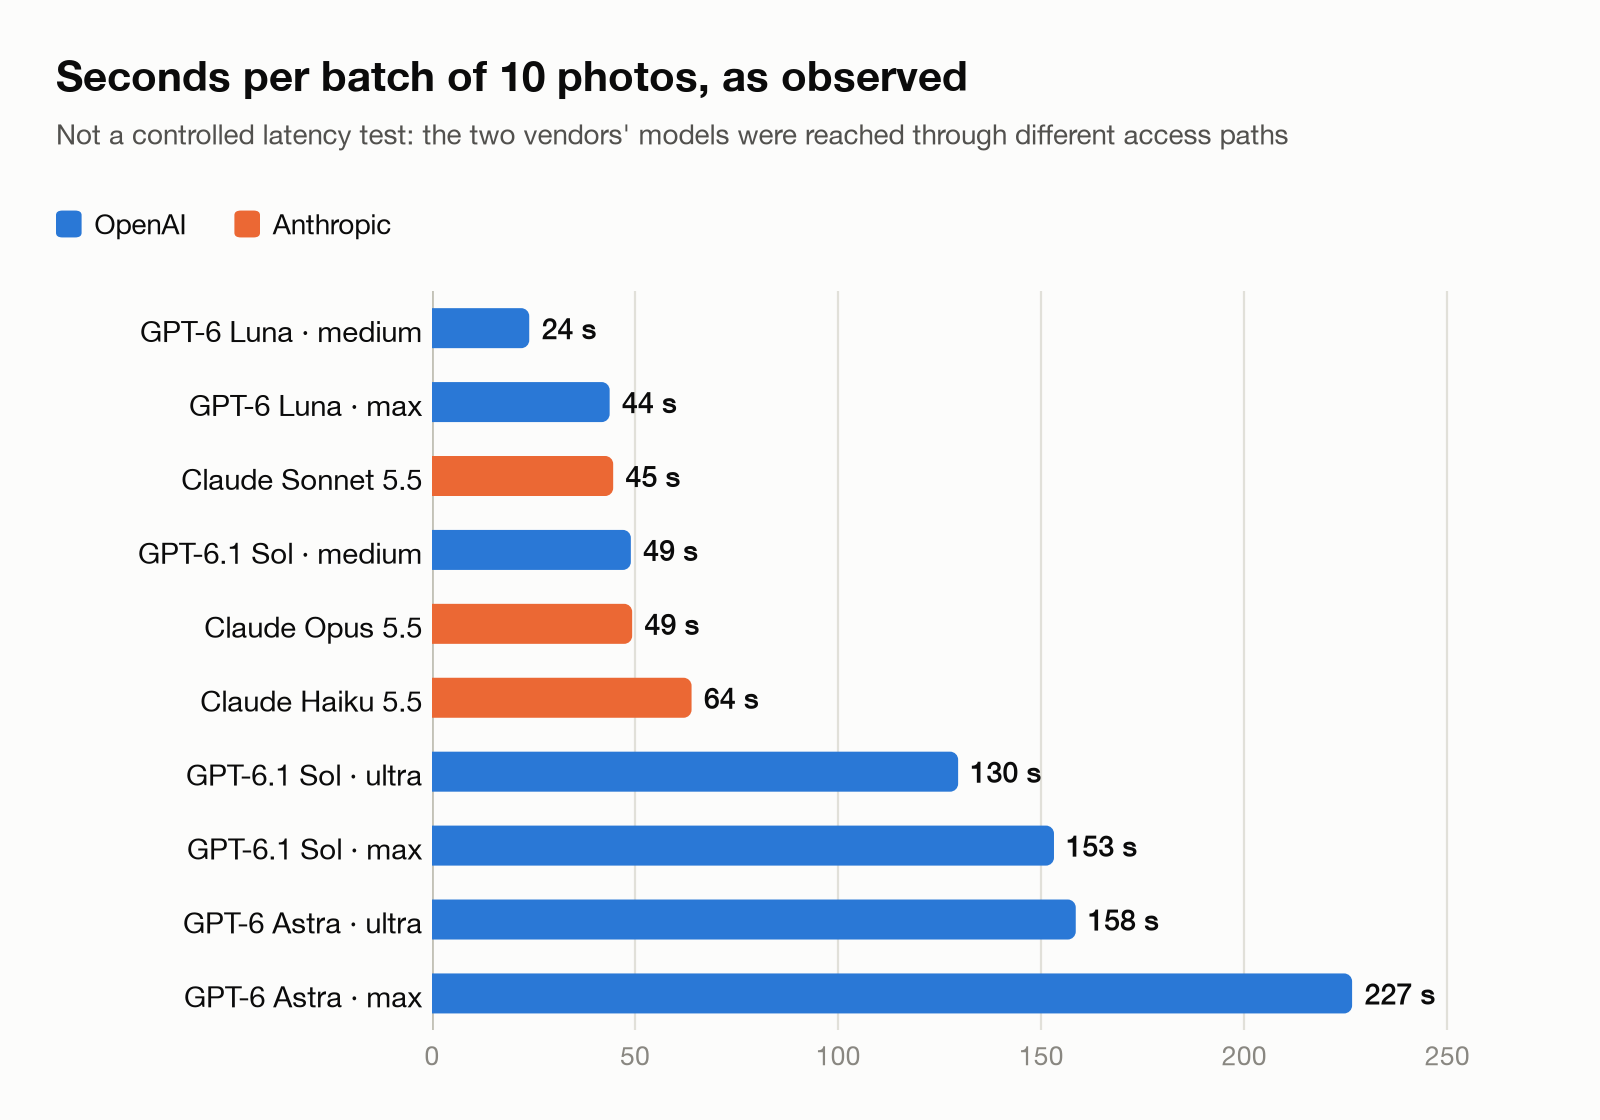 그림 8. 관찰된 사진 10장 묶음당 초. 이는 통제된 지연 테스트가 아닙니다. 두 벤더의 모델을 서로 다른 접근 경로로 호출했기 때문입니다.
이는 제가 매일 느끼는 Opus와 일치합니다. 빠르며, max의 Sol보다 약 3배 빠릅니다. 다만 medium의 Sol은 Opus만큼 빨랐고, 점수는 약 1점 더 높았습니다.
비용
모든 구성을 각 벤더의 공식 API 가격으로 책정했습니다. 구독 플랜에 포함된 사용량을 무료로 취급하면 일부 모델이 실제보다 좋아 보입니다.
100만 토큰당 공식 가격, 표준 티어:
| 모델 | 입력 | 출력 |
|---|---|---|
| Claude Opus 5.5 | $4.00 | $20.00 |
| Claude Sonnet 5.5 | $2.00 | $10.00 |
| Claude Haiku 5.5 | $0.10 | $0.50 |
| GPT-6 Astra | $10.00 | $50.00 |
| GPT-6.1 Sol | $2.00 | $10.00 |
| GPT-6 Luna | $0.10 | $0.50 |
두 벤더의 Batch API는 50% 저렴하며, 즉시 답이 필요 없는 이런 작업에 알맞습니다. 가격은 2026년 10월 20일에 Anthropic 가격 페이지(claude.com/pricing)와 OpenAI API 가격 페이지(developers.openai.com/api/docs/pricing)에서 가져왔습니다.
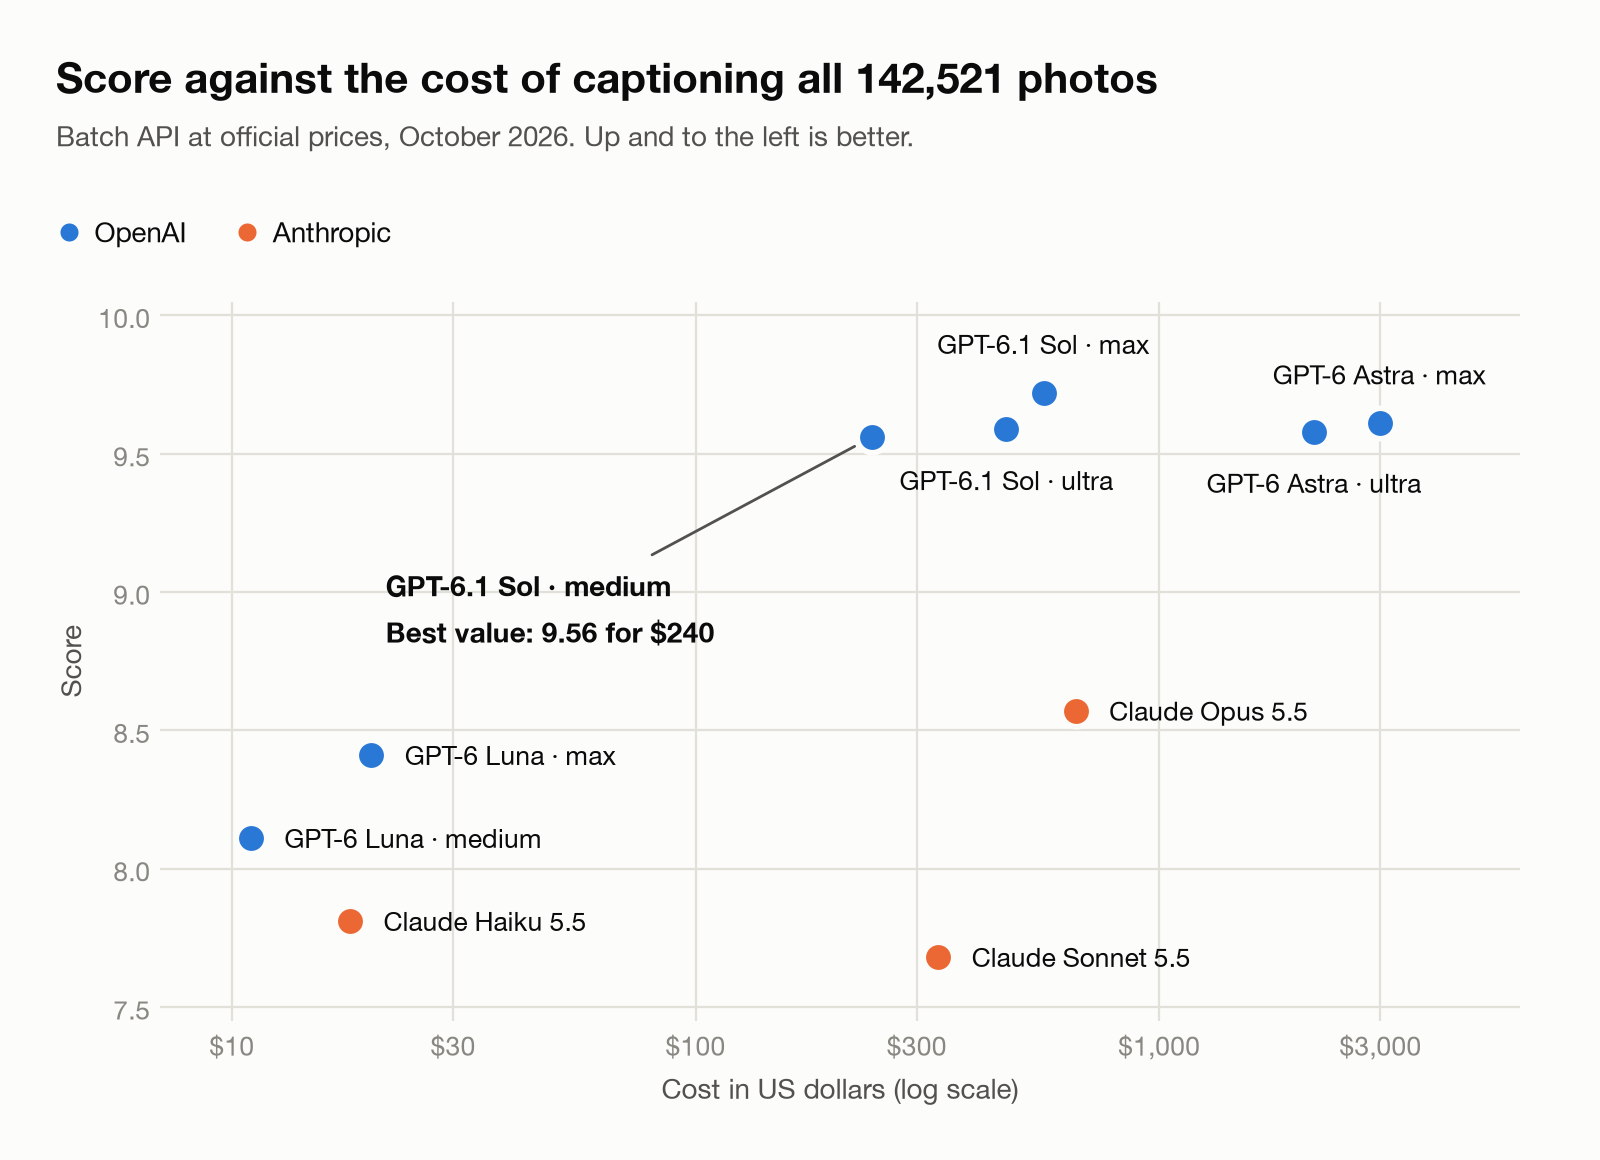 그림 9. Batch 가격으로 라이브러리 전체에 캡션을 다는 비용에 대한 점수. 비용 축은 로그입니다.
| 모델과 추론 강도 | 사진당 출력 토큰 | 표준 | Batch | 점수 |
|---|---|---|---|---|
| GPT-6.1 Sol, medium | 193 | $479 | $240 | 9.56 |
| GPT-6.1 Sol, ultra | 514 | $937 | $468 | 9.59 |
| GPT-6.1 Sol, max | 647 | $1,126 | $563 | 9.72 |
| Claude Opus 5.5 | ~292 | $1,323 | $661 | 8.57 |
| Claude Sonnet 5.5 | ~297 | $668 | $334 | 7.68 |
| GPT-6 Astra, ultra | 462 | $4,313 | $2,156 | 9.58 |
| GPT-6 Astra, max | 695 | $5,973 | $2,987 | 9.61 |
| GPT-6 Luna, medium | 163 | $22 | $11 | 8.11 |
| Claude Haiku 5.5 | ~330 | $36 | $18 | 7.81 |
| GPT-6 Luna, max | 419 | $40 | $20 | 8.41 |
medium의 Sol은 최고 점수의 98%를 Opus 비용의 36%, max Sol의 43%로 얻었습니다. Astra는 Sol과 품질이 비슷하지만 토큰 단가가 5배라서 비용은 약 5배입니다. Opus는 max의 Sol보다 비용이 더 들고 점수는 낮았습니다. 이미 medium으로 돌렸지만 토큰 단가가 Sol의 2배입니다. Luna는 라이브러리 전체에 $11~$20에 캡션을 달고도 Haiku와 Sonnet을 앞섭니다.
방법 참고: GPT 토큰 수는 실행에서 측정했고, Claude 토큰 수는 실행 로그에서 추정했습니다. 일부 Claude 추론 토큰은 보이지 않았으므로 Claude 비용은 약간 과소평가되었을 수 있습니다. 프롬프트 캐싱 등 Batch 외 할인은 어떤 모델에도 적용하지 않았습니다.
배운 점
저는 블라인드 점수를 받기 전에 Opus를 골랐는데, 주로 그것이 이미 제 코딩 기본값이었기 때문입니다. 코딩과 워크플로에서는 여전히 Claude Opus 5.5를 선호합니다. 제 경험상 그쪽이 더 빠르고 강합니다. 실제 사진을 설명하는 것은 다른 기술을 요구합니다. 포즈나 관계를 채워 넣지 않고 프레임에 실제로 있는 것을 읽는 일입니다. GPT-6.1 Sol이 그걸 더 잘했습니다. 습관을 따라 블라인드 테스트를 건너뛰었다면, 더 많은 돈을 내고 더 나쁜 캡션을 얻었을 것입니다.
다음에는 블라인드로 시작해, 서로 다른 벤더의 채점자에게 캡션 모델이 받은 모든 입력을 주겠습니다. 비용 비교도 공식 API 가격으로 계속하고, 추론 강도가 높을수록 낫다고 가정하지도 않겠습니다. 이번에는 ultra가 max를 이기지 못했습니다.
최고의 모델도 유용한 사진을 삭제 대상으로 플래그했으므로, 무엇이든 지우기 전에 모든 삭제 플래그를 제가 직접 확인하겠습니다.
한계
이는 작은 테스트입니다. 한 도시의 최근 사진 50장입니다. 오래된 사진, 스캔 문서, 다른 언어, 동영상은 테스트하지 않았습니다. Claude 모델은 기본 설정으로만 돌렸고, 더 높은 추론 강도의 Opus는 더 높은 비용으로 더 나은 점수를 받았을 수 있습니다. 채점자는 사람이 아니라 AI 모델입니다. 잘 일치했지만 완벽하지는 않았고, 사람이 표본 검토하면 결과가 더 단단해집니다. 모델과 가격은 빠르게 변하며, 여기 모든 숫자는 2026년 10월 기준입니다.
제 선택
제 라이브러리에는: GPT-6.1 Sol의 medium. 코딩과 워크플로에는 Claude Opus 5.5를 계속 씁니다.