
اختبرت بشكل أعمى 10 نماذج ذكاء اصطناعي على مكتبة الصور الخاصة بي البالغة 142,000 صورة: تفوّق GPT-6.1 Sol على Claude Opus
الملخص
أستخدم Claude Opus 5.5 يوميًا في البرمجة وسير العمل، وأجده في هذا النوع من العمل أسرع وأفضل من GPT-6. افترضت أنه سيكون الأفضل أيضًا في وصف الصور، لذا اختبرته. شغّلت عشرة إعدادات: Claude Haiku وSonnet وOpus 5.5، بالإضافة إلى GPT-6.1 Sol وGPT-6 Astra وGPT-6 Luna من OpenAI عند مستويات جهد متعددة. كتب كلٌّ منها عنوانًا ووصفًا وكلمات مفتاحية وأرشفة لـ 50 صورة حقيقية من مكتبتي التي تضم 142,521 صورة، وعلّم الصور التي يرى أنني يجب أن أحذفها. قام مُقيّمان أعميان من جهتين مختلفتين — Claude Fable 5.1 وGPT-6 Astra — بتقييم الإجابات الخمسمئة كلها من حيث الدقة والتفاصيل الملفقة وقرار الحذف وملاءمة الألبوم والفائدة. سجّل GPT-6.1 Sol أعلى درجة: 9.72 من 10. سجّل Opus 8.57، وجاء Sonnet وHaiku بين 7.7 و7.8. لم يكن جهد ultra أفضل من max. وبأسعار Batch API الرسمية، ستكلّف كتابة أوصاف المكتبة كلها نحو 240 دولارًا مع Sol عند جهد medium (9.56)، و661 دولارًا مع Opus، ومن 11 إلى 20 دولارًا مع Luna الذي تفوّق مع ذلك على Haiku.
لماذا اختبرت هذا
يذهب معظم يومي إلى البرمجة وسير عمل الوكلاء والأتمتة، وClaude Opus 5.5 هو النموذج الذي ألجأ إليه. في هذا النوع من العمل بدا لي أسرع وأفضل من GPT-6. لذا عندما قررت أن أجعل الذكاء الاصطناعي يكتب أوصافًا ووسومًا لمكتبة الصور الخاصة بي، اخترت Opus دون تردد.
المكتبة هي 25 عامًا من حياتي: 142,521 صورة، من لقطات الكاميرا الرقمية المبكرة إلى صور الهاتف الأسبوع الماضي، بالإضافة إلى أكثر من 16,000 لقطة شاشة. لا يوجد وصف لأيٍّ منها تقريبًا. أريد أن يكون لكل صورة عنوان ووصف وكلمات مفتاحية أستطيع البحث بها وألبوم مناسب، وإشارة صادقة عندما تكون مكررة أو غير مفيدة. قبل أن أدفع مقابل معالجة 142,000 صورة، أردت أن أعرف أي نموذج يقوم بذلك على أفضل وجه وكم تبلغ تكلفة الفرق.
توقعت أن يفوز Opus. في هذه الصور الخمسين، سجّل GPT-6.1 Sol أكثر من نقطة إضافية.
النتائج في لمحة
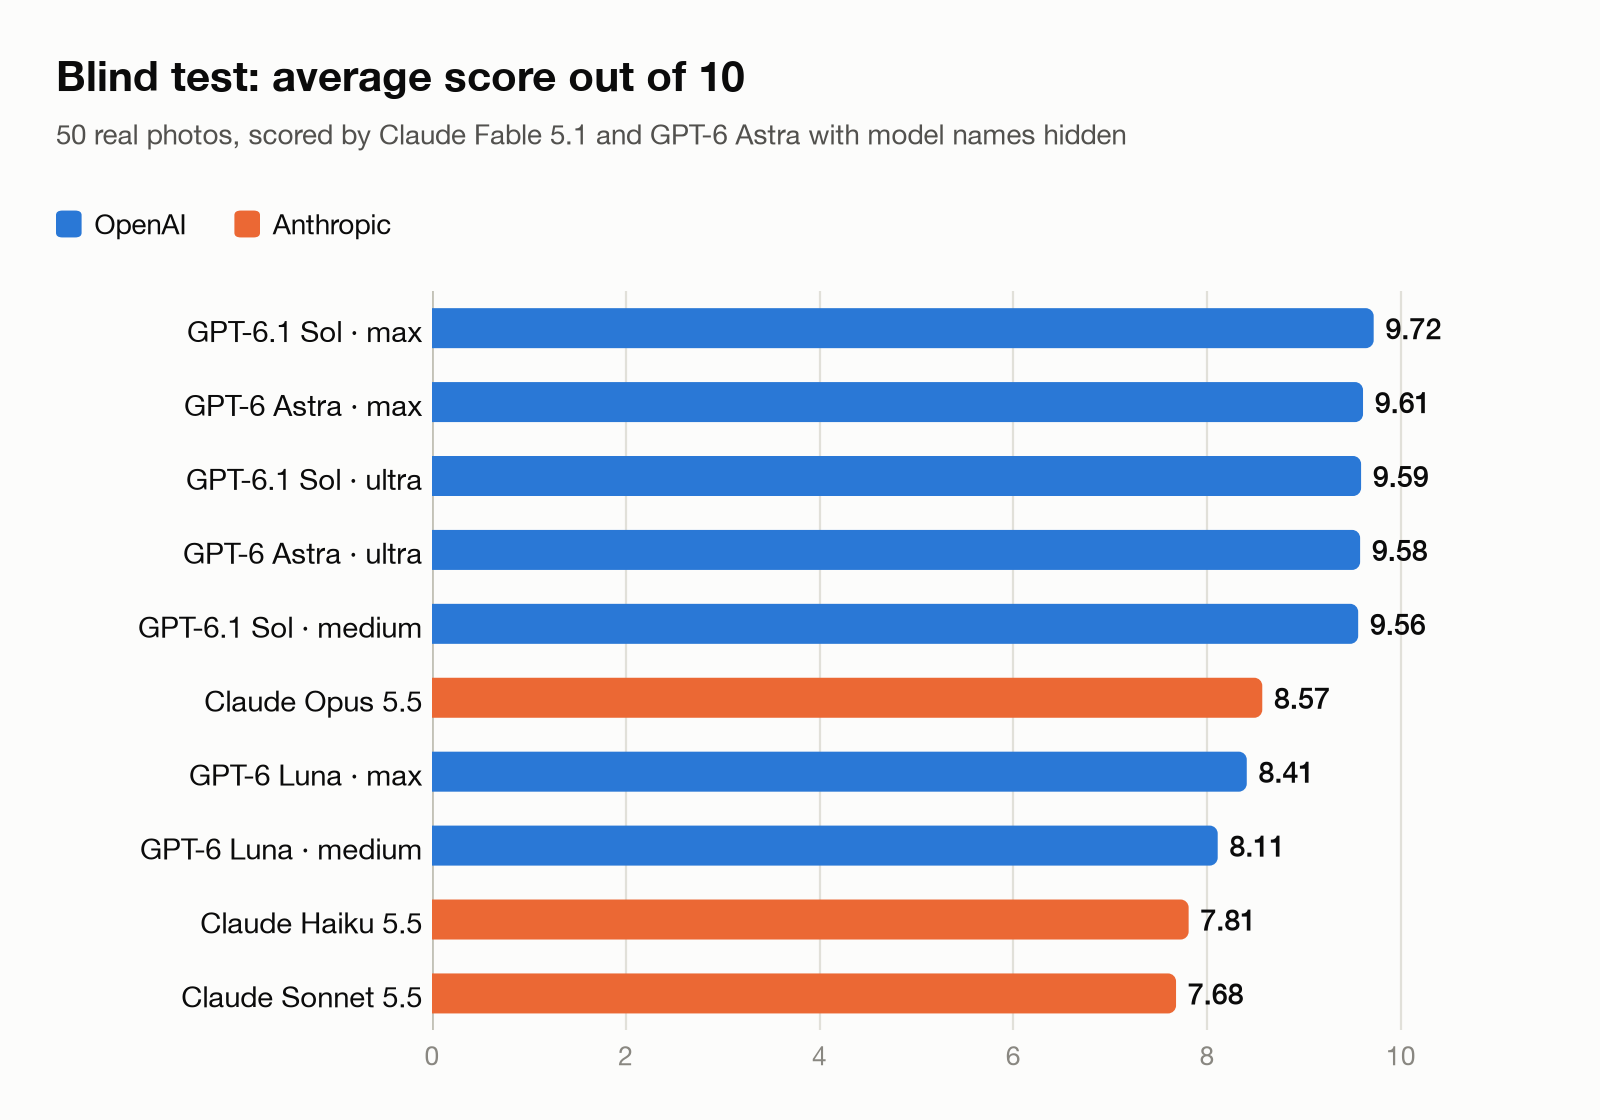 الشكل 1. متوسط الدرجة من مُقيّمين أعميين، من 10.
| الترتيب | النموذج والجهد | الدرجة (من 10) | المكتبة كاملة، Batch API | المكتبة كاملة، API القياسي |
|---|---|---|---|---|
| 1 | GPT-6.1 Sol، max | 9.72 | $563 | $1,126 |
| 2 | GPT-6 Astra، max | 9.61 | $2,987 | $5,973 |
| 3 | GPT-6.1 Sol، ultra | 9.59 | $468 | $937 |
| 4 | GPT-6 Astra، ultra | 9.58 | $2,156 | $4,313 |
| 5 | GPT-6.1 Sol، medium | 9.56 | $240 | $479 |
| 6 | Claude Opus 5.5 | 8.57 | $661 | $1,323 |
| 7 | GPT-6 Luna، max | 8.41 | $20 | $40 |
| 8 | GPT-6 Luna، medium | 8.11 | $11 | $22 |
| 9 | Claude Haiku 5.5 | 7.81 | $18 | $36 |
| 10 | Claude Sonnet 5.5 | 7.68 | $334 | $668 |
التكلفة محسوبة لكل الصور البالغ عددها 142,521 صورة وفق السعر الرسمي لواجهة برمجة التطبيقات لدى كل جهة.
ما سأستخدمه، بناءً على هذا الاختبار:
- إذا كان ما يهمني هو الدرجة فقط، فسأختار GPT-6.1 Sol عند جهد max.
- لمكتبتي الخاصة، GPT-6.1 Sol عند جهد medium. حصل على 98% من أعلى درجة مقابل 240 دولارًا، أي نحو ثلث ما سيكلفه Opus.
- بميزانية ضيقة، GPT-6 Luna عند جهد max. مقابل 20 دولارًا تفوّق على Haiku، الذي يكلف السعر نفسه لكل رمز (token)، وعلى Sonnet الذي سيكلف نحو 17 ضعفًا لهذه المكتبة.
- وليس Claude Sonnet 5.5. سعره متوسط وكان صاحب أدنى درجة.
النماذج
| الجهة | النموذج | الجهد المختبر | الموقع |
|---|---|---|---|
| Anthropic | Claude Opus 5.5 | الافتراضي (medium) | الرائد للاستخدام اليومي |
| Anthropic | Claude Sonnet 5.5 | الافتراضي | الفئة المتوسطة |
| Anthropic | Claude Haiku 5.5 | الافتراضي | سريع ومنخفض التكلفة |
| OpenAI | GPT-6 Astra | max وultra | نموذج متقدم (frontier) |
| OpenAI | GPT-6.1 Sol | medium وmax وultra | نموذج العمل الرئيسي |
| OpenAI | GPT-6 Luna | medium وmax | سريع ومنخفض التكلفة |
تتطابق الأسعار بين الجهتين. يكلف GPT-6.1 Sol السعر نفسه لكل رمز مثل Claude Sonnet 5.5، ويكلف GPT-6 Astra مثل Claude Fable 5.1، ويكلف GPT-6 Luna مثل Claude Haiku 5.5. ويقع Claude Opus 5.5 بين Sol وAstra. لذا عندما ينتهي نموذجان بتكاليف مختلفة أدناه، فذلك غالبًا لأن أحدهما استخدم رموزًا أكثر للمهمة نفسها.
عُملت نماذج Claude مرة واحدة لكلٍّ منها بإعداداتها الافتراضية، ما يعني جهد medium بالنسبة إلى Opus. واختبرت نماذج GPT عند مستويات جهد متعددة. أقرب مقارنة مباشرة هي GPT-6.1 Sol عند medium مقابل Claude Opus 5.5 عند medium: 9.56 مقابل 8.57.
الاختبار
استخدمت أحدث 50 صورة في مكتبتي في ذلك الوقت، من دون مقاطع فيديو. إنها أسبوع عادي من ألبوم الكاميرا لديّ: لحظات عائلية في المنزل وأثناء التسوق، مناظر للمدينة من طابق مرتفع، بطاقة ذاكرة على مكتبي، لقطات شاشة لصفحات منتجات قطع إلكترونية، لقطات شاشة لتتبع الطلبات، منشور على وسائل التواصل الاجتماعي، لافتة رمز QR لخصم مواقف السيارات، وملصق شاحن سيارة كهربائية.
كان لكل نموذج خمس مهام لكل صورة. كتب عنوانًا قصيرًا ووصفًا من جملة إلى ثلاث جمل باللغة الصينية، وأعطى من 5 إلى 12 كلمة مفتاحية بالصينية والإنجليزية، واختار أفضل ألبوم من ألبوماتي الحالية أو لم يختر أيًا منها. ثم أعطى درجة جودة وقال ما إذا كان يجب الاحتفاظ بالصورة أو حذفها، باحثًا عن المكرر واللقطات الفاشلة ولقطات الشاشة المنتهية الصلاحية والصور التي لا قيمة دائمة لها. حصل كل نموذج على التعليمات نفسها والسياق نفسه لكل صورة، عشر صور في كل مرة.
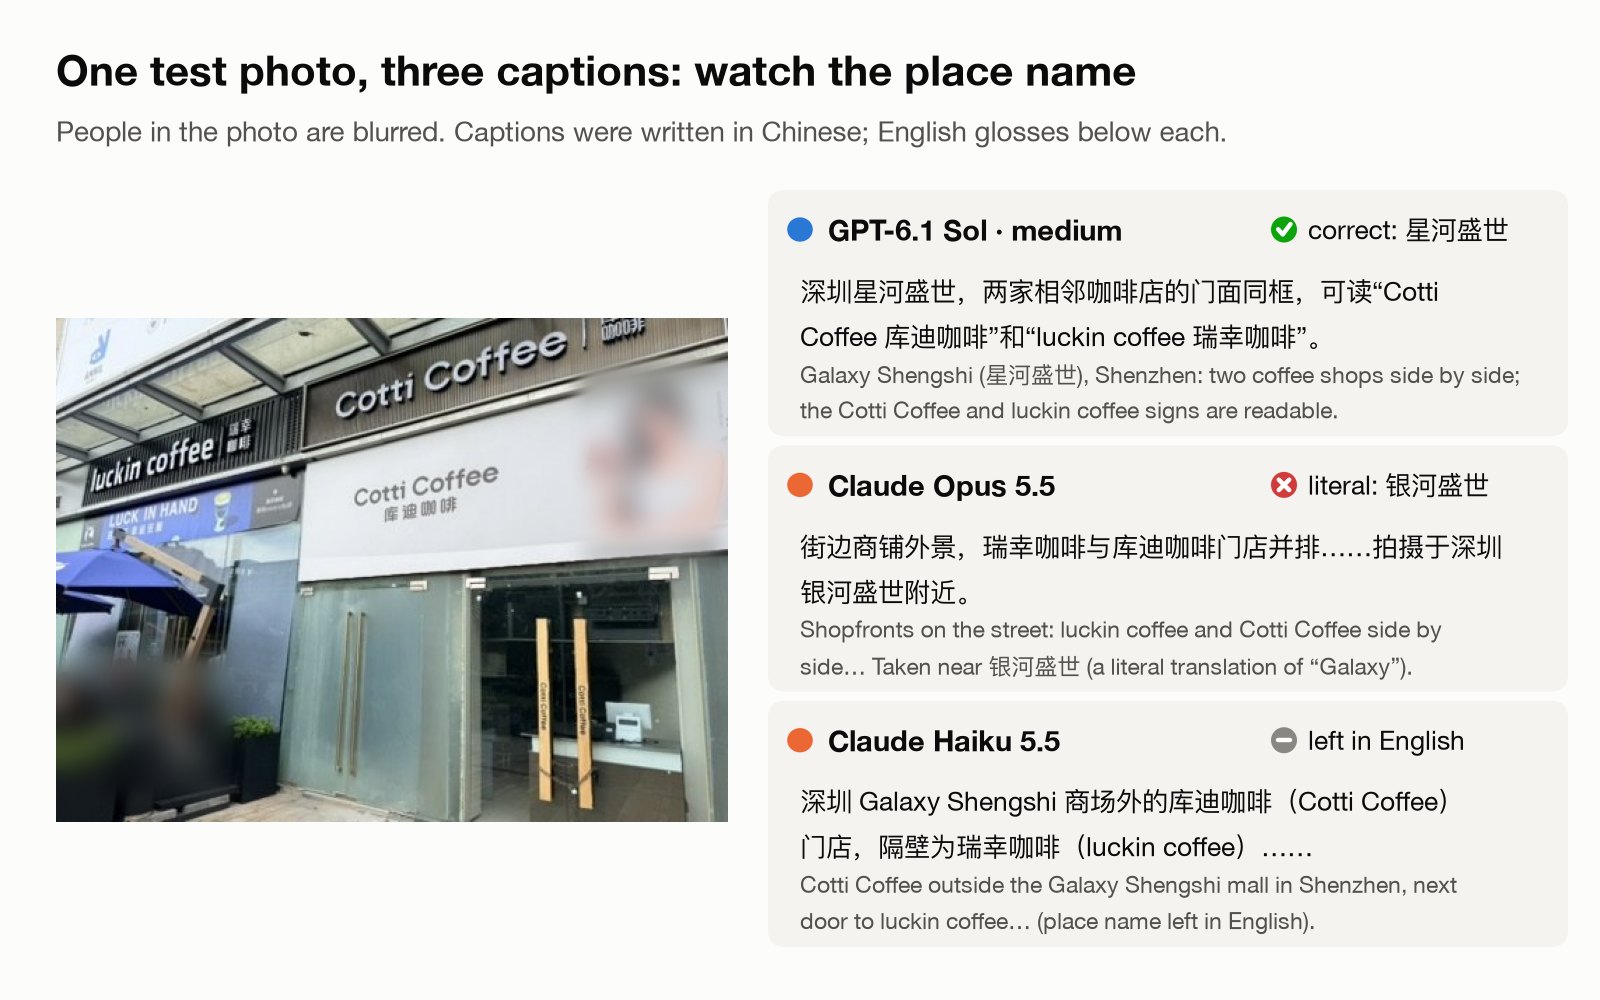 الشكل 2. إحدى صور الاختبار الخمسين، مع ثلاثة من الأوصاف. انظر كيف يتعامل كل نموذج مع اسم المكان؛ سأعود إليه أدناه. الأشخاص في الصورة مطموسون.
كيف قيّمت
لم أقيّم الإجابات بنفسي. كنت قد اخترت فائزًا قبل الاختبار، وأستخدم Claude كل يوم، لذا لم أكن محايدًا.
بدلًا من ذلك، خلطت إجابات كل صورة العشر ووسمتها من A إلى J، بترتيب عشوائي جديد لكل صورة. ثم قيّم مُقيّمان الإجابات الخمسمئة كلها بشكل مستقل أثناء النظر إلى الصور. كان أحدهما Claude Fable 5.1، أقدر نموذج لدى Anthropic. والآخر GPT-6 Astra عند جهد xhigh، نموذج OpenAI المتقدم.
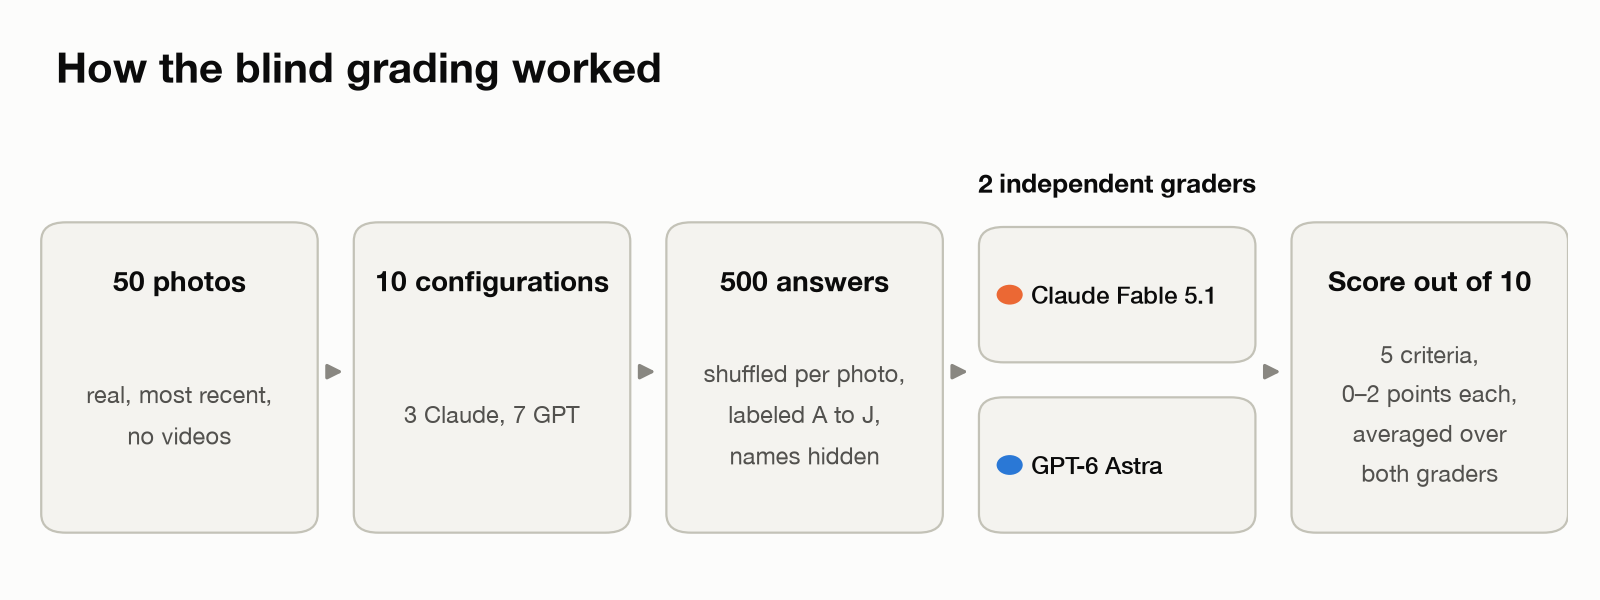 الشكل 3. كيف جرى التقييم الأعمى.
قُيّمت كل إجابة وفق خمسة معايير، من 0 إلى 2 نقطة لكلٍّ منها، بمجموع 10:
| المعيار | ما يفحصه المقيّم |
|---|---|
| الدقة | هل الموضوع والمكان وأي نص مقروء صحيح، بما في ذلك أسماء الأماكن المحلية؟ |
| لا تفاصيل ملفقة | هل تتجنب الإجابة الادعاء بأي شيء لا تظهره الصورة؟ |
| قرار الحذف | هل قرار الاحتفاظ أو الحذف معقول؟ حذف صورة جيدة يساوي 0. |
| ملاءمة الألبوم | هل الألبوم صحيح؟ الألبوم القديم الخاطئ يساوي 0؛ عدم اختيار ألبوم هو 1 مقبول. |
| الفائدة | هل يساعد العنوان والوصف والكلمات المفتاحية في العثور على هذه الصورة وتذكرها لاحقًا؟ |
اخترت مقيّمًا واحدًا من كل جهة لأرى ما إذا كان أيٌّ منهما سيحابي نماذجه. اتفقا في الغالب. بلغ الارتباط عبر الدرجات الخمسمئة المزدوجة 0.71، ووضع كلاهما إعدادات GPT الخمسة نفسها في القمة. كما رتّب المقيّم من Claude نموذجي GPT-6.1 Sol وGPT-6 Astra فوق Claude Opus. كان المقيّم من GPT أكثر صرامة عمومًا، وأشد صرامة مع نماذج Claude.
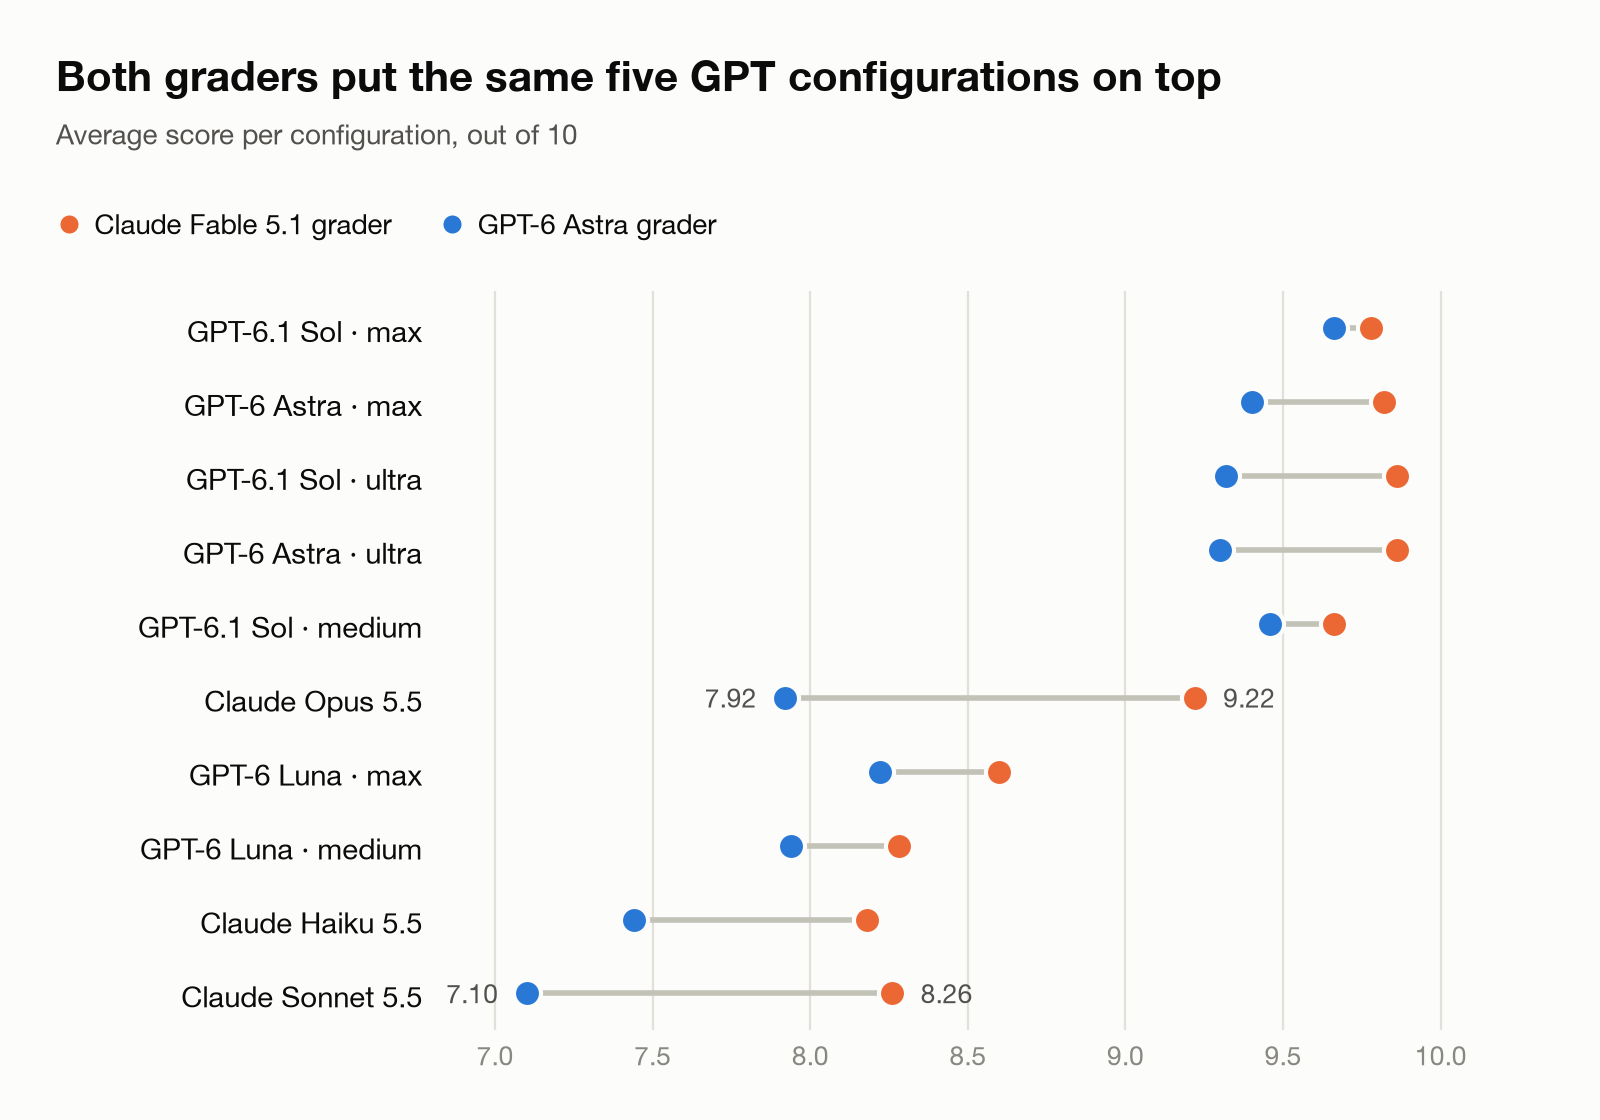 الشكل 4. متوسط درجة كل مقيّم لكل إعداد.
النتائج
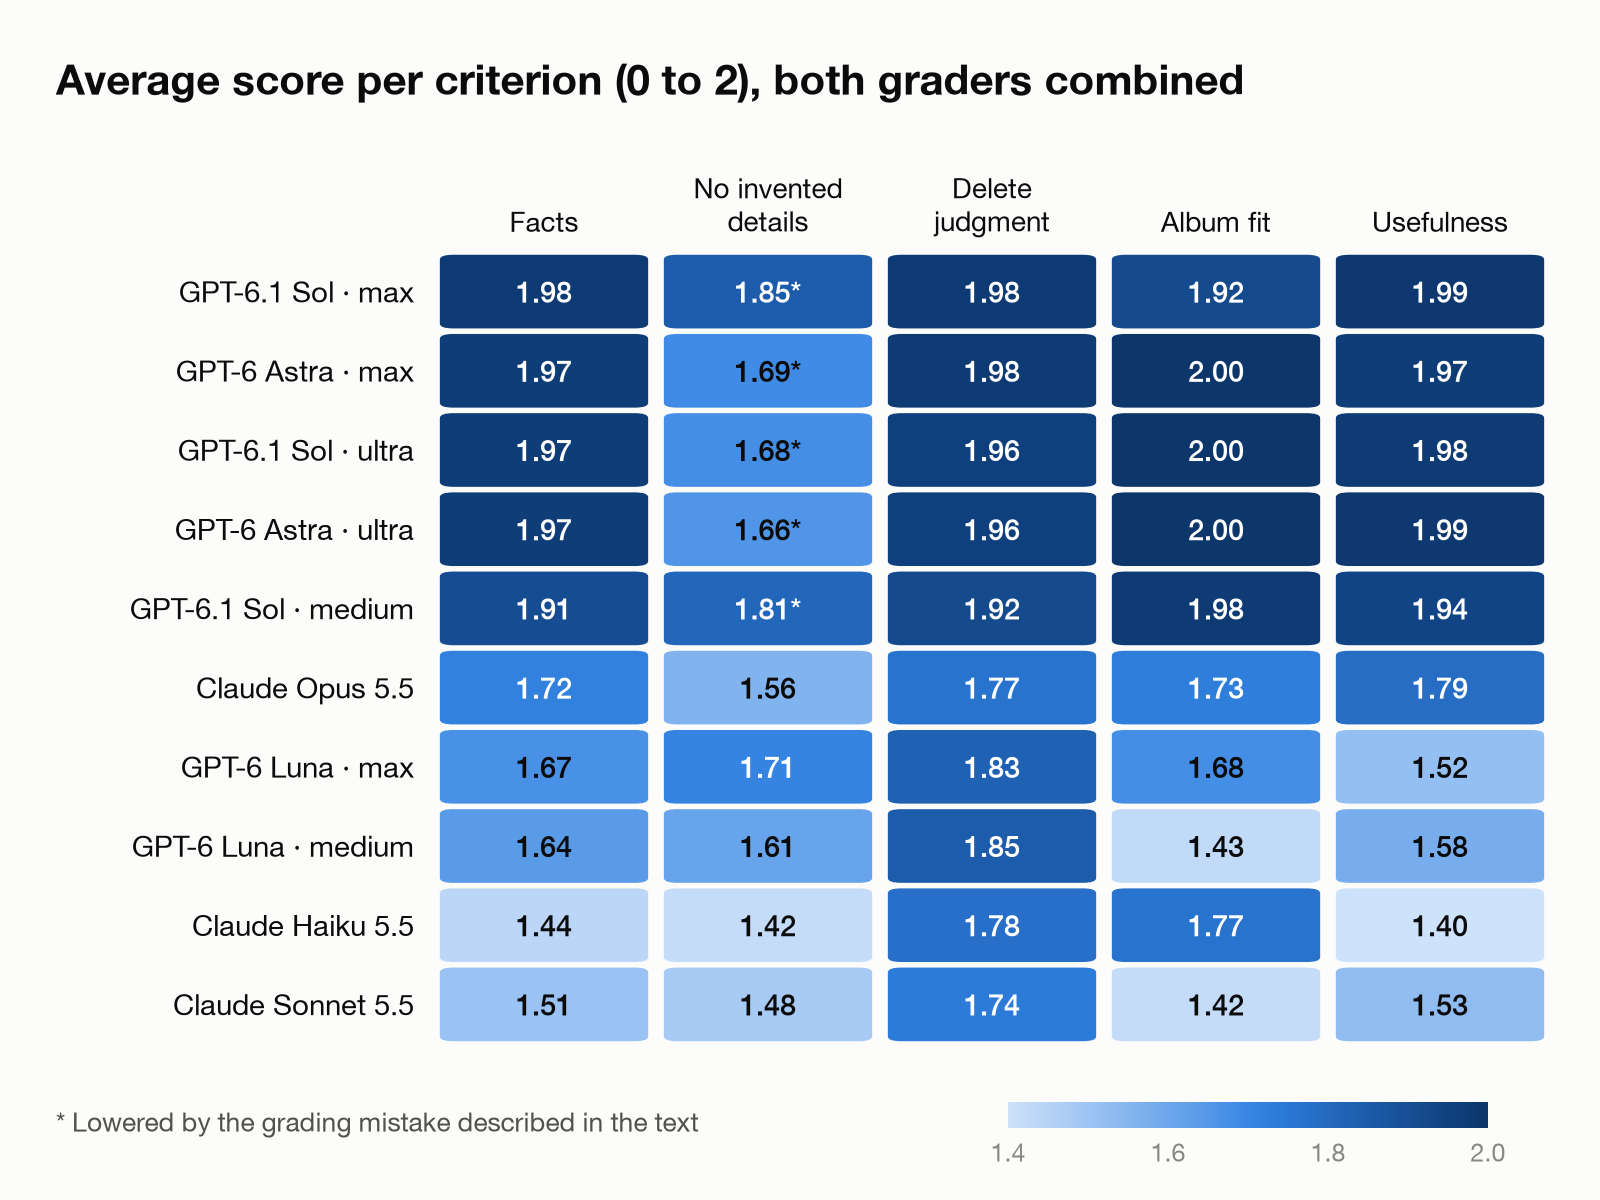 الشكل 5. متوسط الدرجة لكل معيار، مع دمج المقيّمين. تشير النجمة إلى الدرجات التي خُفضت بسبب خطأ التقييم الذي أصفه أدناه.
GPT-6.1 Sol وGPT-6 Astra
قرأ Sol وAstra النصوص بدقة وقصرا أوصافهما في الغالب على ما تظهره الصور. وكانا أيضًا الأفضل في أسماء الأماكن المحلية، وهو أمر مهم للصور الملتقطة في الصين.
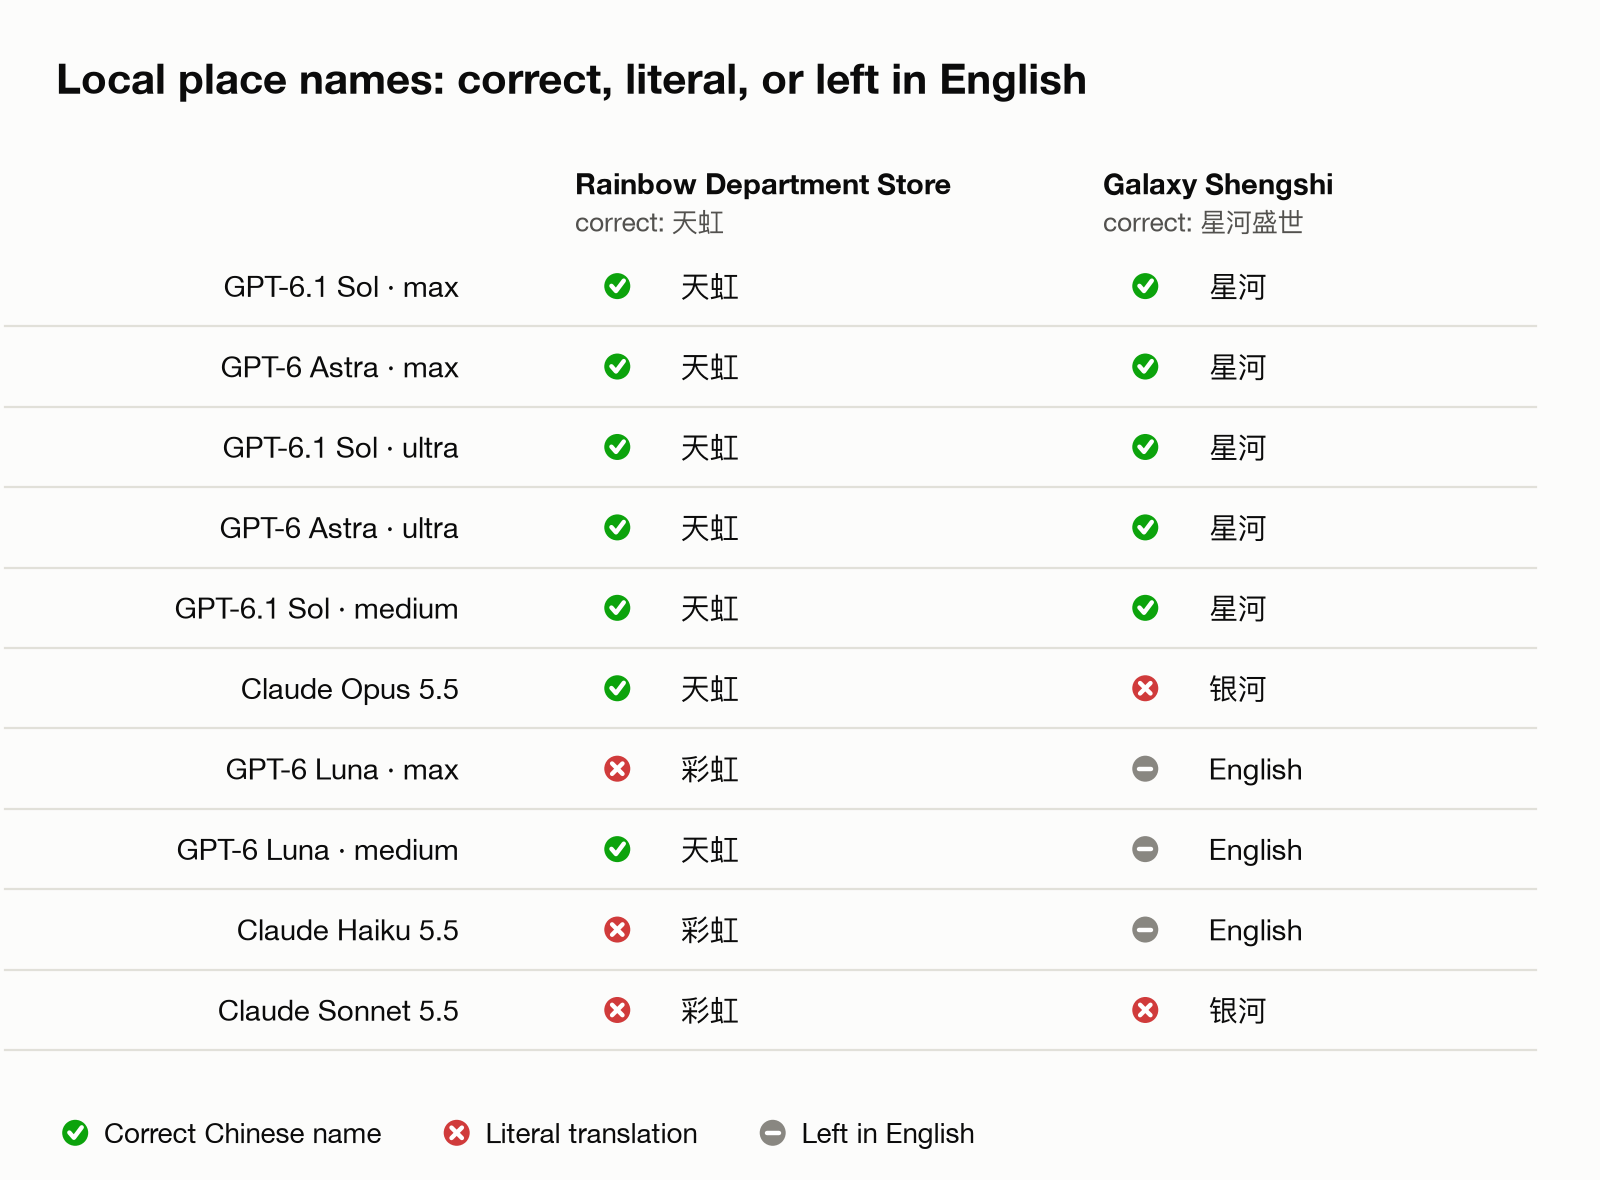 الشكل 6. اختبارا اسم محلي. تعني علامة الصح الاسم الصيني الصحيح، وتعني علامة الخطأ ترجمة حرفية، وتعني EN أن الاسم تُرك بالإنجليزية.
وُسمت عدة صور بموقع «Rainbow Department Store». هذا هو الاسم الإنجليزي لسلسلة مراكز التسوق 天虹 في شنجن. تعطي الترجمة الحرفية 彩虹百货 وهذا خطأ. كتب كل إعداد من Sol وAstra هذا الاسم صحيحًا، وكذلك Opus وLuna عند جهد medium. استخدم Haiku وSonnet وLuna عند max الترجمة الحرفية. وُسمت صورة المقهى في الشكل 2 باسم «Galaxy Shengshi» واسمها الصيني 星河盛世. كتب كل إعداد من Sol وAstra الاسم 星河. ترجمه Opus وSonnet حرفيًا إلى 银河، وتركه Haiku وإعدادا Luna بالإنجليزية.
كان Sol وAstra حريصين أيضًا في الحذف. اقترحا حذف 4 إلى 6 صور من الخمسين. ضمّت المجموعة ثماني لقطات شاشة لصفحات منتجات قطع إلكترونية، واحتفظت نماذج GPT بكل هذه الصور تقريبًا؛ علّم إعداد واحد من Sol لقطة شاشة واحدة فقط باعتبارها شبه مكررة. علّمت نماذج Claude من صورتين إلى أربع لكلٍّ منها. كان المقيّمان مع الاحتفاظ بها، لأن الصفحات تضم مخططات الأطراف والأبعاد وصور اللوحات التي سأريد الرجوع إليها لاحقًا.
Claude Opus 5.5
كتب Opus أحيانًا في الوصف أشياء لا يمكن للصورة وحدها إظهارها. وصف علاقات لا يمكن للصورة وحدها إثباتها، مثل الأشقاء أو الوالد والطفل. وأخطأ أيضًا في بعض الوضعيات. في إحدى الصور كان طفل يقف خلف شخص بالغ، فكتب Opus أن الطفل على ظهر الشخص البالغ. خصم المقيّمان نقاطًا لهذا.
فاجأني هذا. قبل الاختبار الأعمى، كنت قد اطلعت على الإجابات وأثنيت على Opus لتخمينه الصحيح أن طفلين شقيقان. أنا أعرف عائلتي؛ والمقيّم لا يعرفها. لكن مع 142,000 صورة لا أستطيع التحقق من كل وصف بنفسي، والوصف الذي يذكر شيئًا لا تظهره الصورة يمثل مشكلة.
اقترح Opus أيضًا أكبر عدد من الحذف: 13 صورة من الخمسين. ثلاث منها كانت لقطات شاشة لصفحات منتجات وصفها بأنها منتهية الصلاحية، رغم أنها تضم معلومات مرجعية سأحتفظ بها. وكان النموذج الوحيد الذي أراد حذف لافتة رمز QR لخصم مواقف السيارات باعتبارها منخفضة القيمة. كما وضع عدة صور لشخص واحد في ألبوم «صورة عائلية».
Claude Sonnet 5.5 وHaiku 5.5
ارتكب هذان النموذجان أكبر عدد من الأخطاء الواقعية، بما في ذلك الترجمة الحرفية 彩虹. قام Sonnet بأضعف اختيارات الألبومات وأرشف صورًا يومية في ألبوم قديم من مناسبة لا صلة لها. اختلق Haiku تفصيلة أدت إلى قرار حذف سيئ. في سلسلة لقطات شبه متطابقة، وصف أفضل لقطة بأن شخصًا ينظر إلى الأسفل، وهو عكس ما تظهره الصورة، واقترح حذفها.
GPT-6 Luna
يكلف Luna السعر نفسه لكل رمز مثل Haiku لكنه سجل درجات أعلى عند مستويي الجهد: 8.41 و8.11 مقابل 7.81 لـ Haiku. وعند جهد max تفوّق أيضًا على Sonnet الذي سيكلف نحو 17 ضعفًا لكتابة أوصاف المكتبة نفسها. خسر Luna معظم نقاطه في الفائدة واختيار الألبوم. كانت أوصافه أبسط وألبوماته أقل دقة.
مستويات الجهد
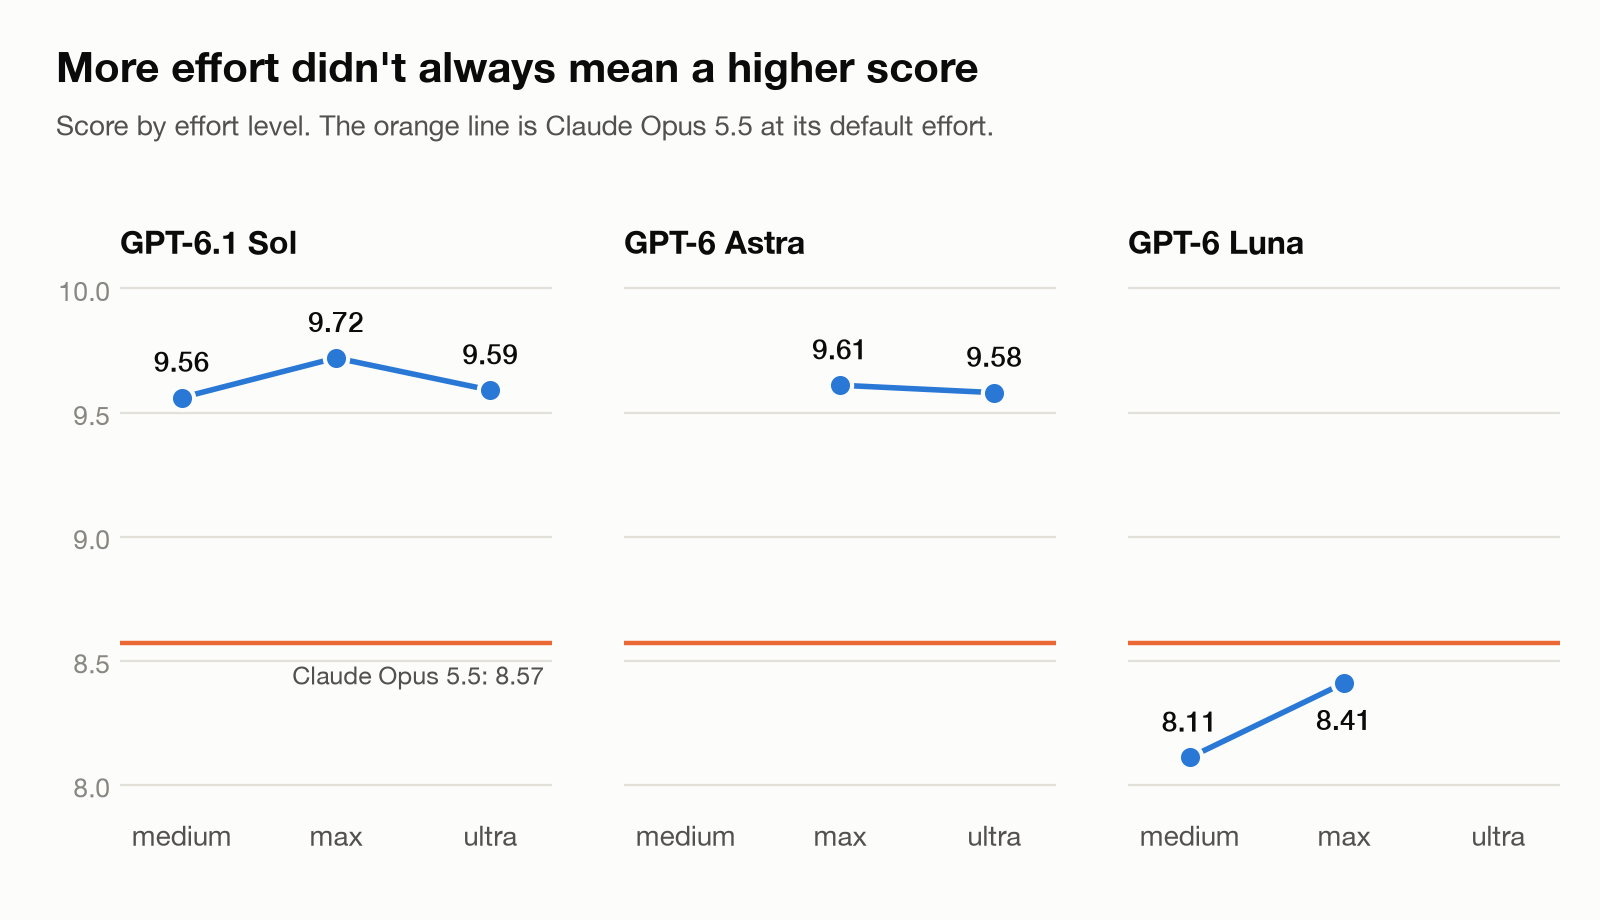 الشكل 7. الدرجة حسب مستوى الجهد. الخط البرتقالي هو Claude Opus 5.5 عند جهده الافتراضي.
لم يكن Ultra أفضل من max لأيٍّ من النموذجين. سجل Sol 9.59 عند ultra و9.72 عند max؛ وسجل Astra 9.58 و9.61. في هذا الاختبار، أنتج ultra رموز إخراج أقل من max. بالنسبة إلى Sol، اقترب medium من ذلك عند 9.56 بأقل من نصف تكلفة max. كما أن الجهد الأعلى لم يعنِ دائمًا تفاصيل أدق: Luna عند medium كتب 天虹 صحيحًا، وLuna عند max لم يكتبه.
خطأ في تقييمي
بعد التقييم، لاحظت أن المقيّمين لم يحصلا على تاريخ ووقت التقاط كل صورة، رغم أن نماذج كتابة الأوصاف حصلت عليهما. لذا عامل المقيّم GPT-6 Astra الأوصاف التي تذكر التاريخ أو الوقت الدقيقين باعتبارها تفاصيل ملفقة. كانت إعدادات GPT المتصدرة تذكر التاريخ أكثر من غيرها، فخرجت درجاتها في معيار «لا تفاصيل ملفقة» أقل مما يجب.
إذا أعدت فقط النقاط التي خُسرت بسبب التواريخ، ترتفع إعدادات GPT الأربعة الأولى إلى ما بين 9.84 و9.90، وهو تعادل فعليًا، ويبقى Opus عند 8.58. احتفظت بالدرجات الأصلية في هذا المنشور. في المرة القادمة سأعطي المقيّمين كل ما رأته النماذج.
السرعة
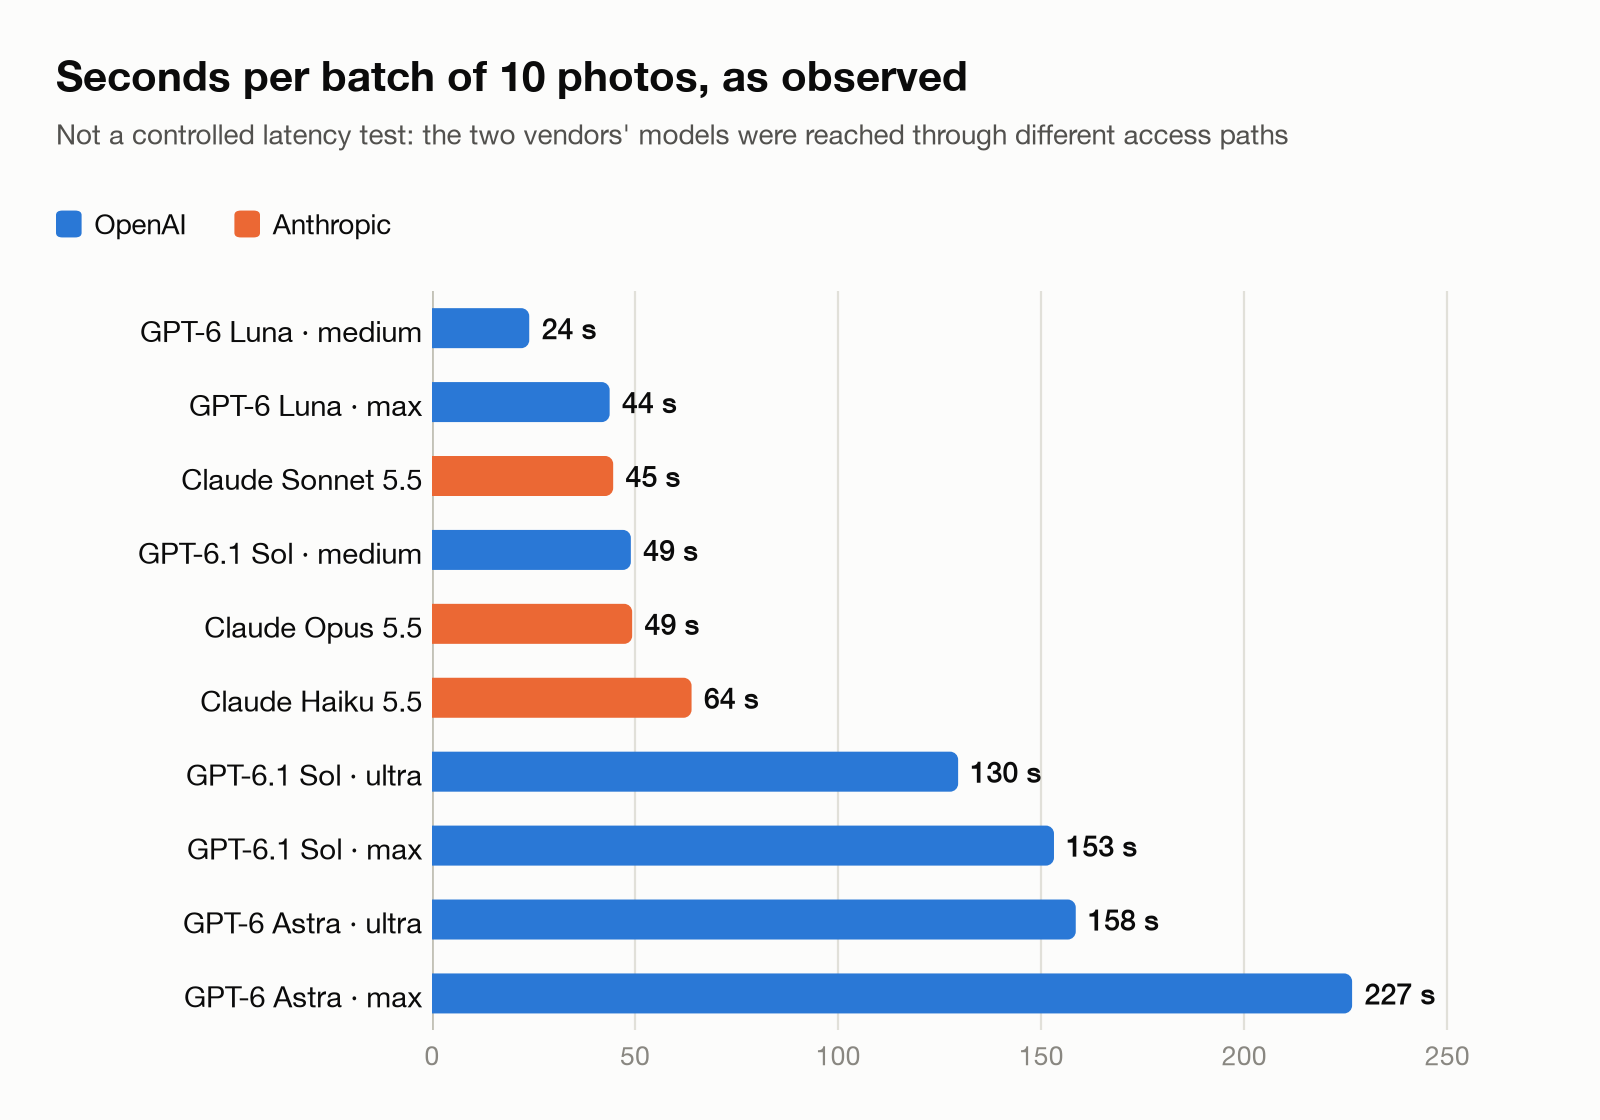 الشكل 8. الثواني لكل دفعة من 10 صور، كما رُصدت. ليس هذا اختبار زمن استجابة مضبوطًا، لأن نماذج الجهتين وُصل إليها عبر مسارات وصول مختلفة.
هذا يطابق إحساسي بـ Opus في عملي اليومي: إنه سريع، أسرع بنحو ثلاثة أضعاف من Sol عند max. لكن Sol عند medium كان بنفس سرعة Opus، وسجل نحو نقطة أعلى.
كم التكلفة
سعّرت كل إعداد بأسعار واجهة برمجة التطبيقات الرسمية للجهتين. إن اعتبار الاستخدام المضمّن في خطة الاشتراك مجانيًا سيجعل بعض النماذج تبدو أفضل مما هي عليه.
الأسعار الرسمية لكل مليون رمز، الفئة القياسية:
| النموذج | الإدخال | الإخراج |
|---|---|---|
| Claude Opus 5.5 | $4.00 | $20.00 |
| Claude Sonnet 5.5 | $2.00 | $10.00 |
| Claude Haiku 5.5 | $0.10 | $0.50 |
| GPT-6 Astra | $10.00 | $50.00 |
| GPT-6.1 Sol | $2.00 | $10.00 |
| GPT-6 Luna | $0.10 | $0.50 |
تكلف واجهات Batch API لدى الجهتين أقل بنسبة 50%، وهو ما يناسب مهمة كهذه لا تحتاج إجابات فورية. أخذت الأسعار من صفحة تسعير Anthropic (claude.com/pricing) وصفحة تسعير واجهة برمجة التطبيقات لدى OpenAI (developers.openai.com/api/docs/pricing) في 20 أكتوبر 2026.
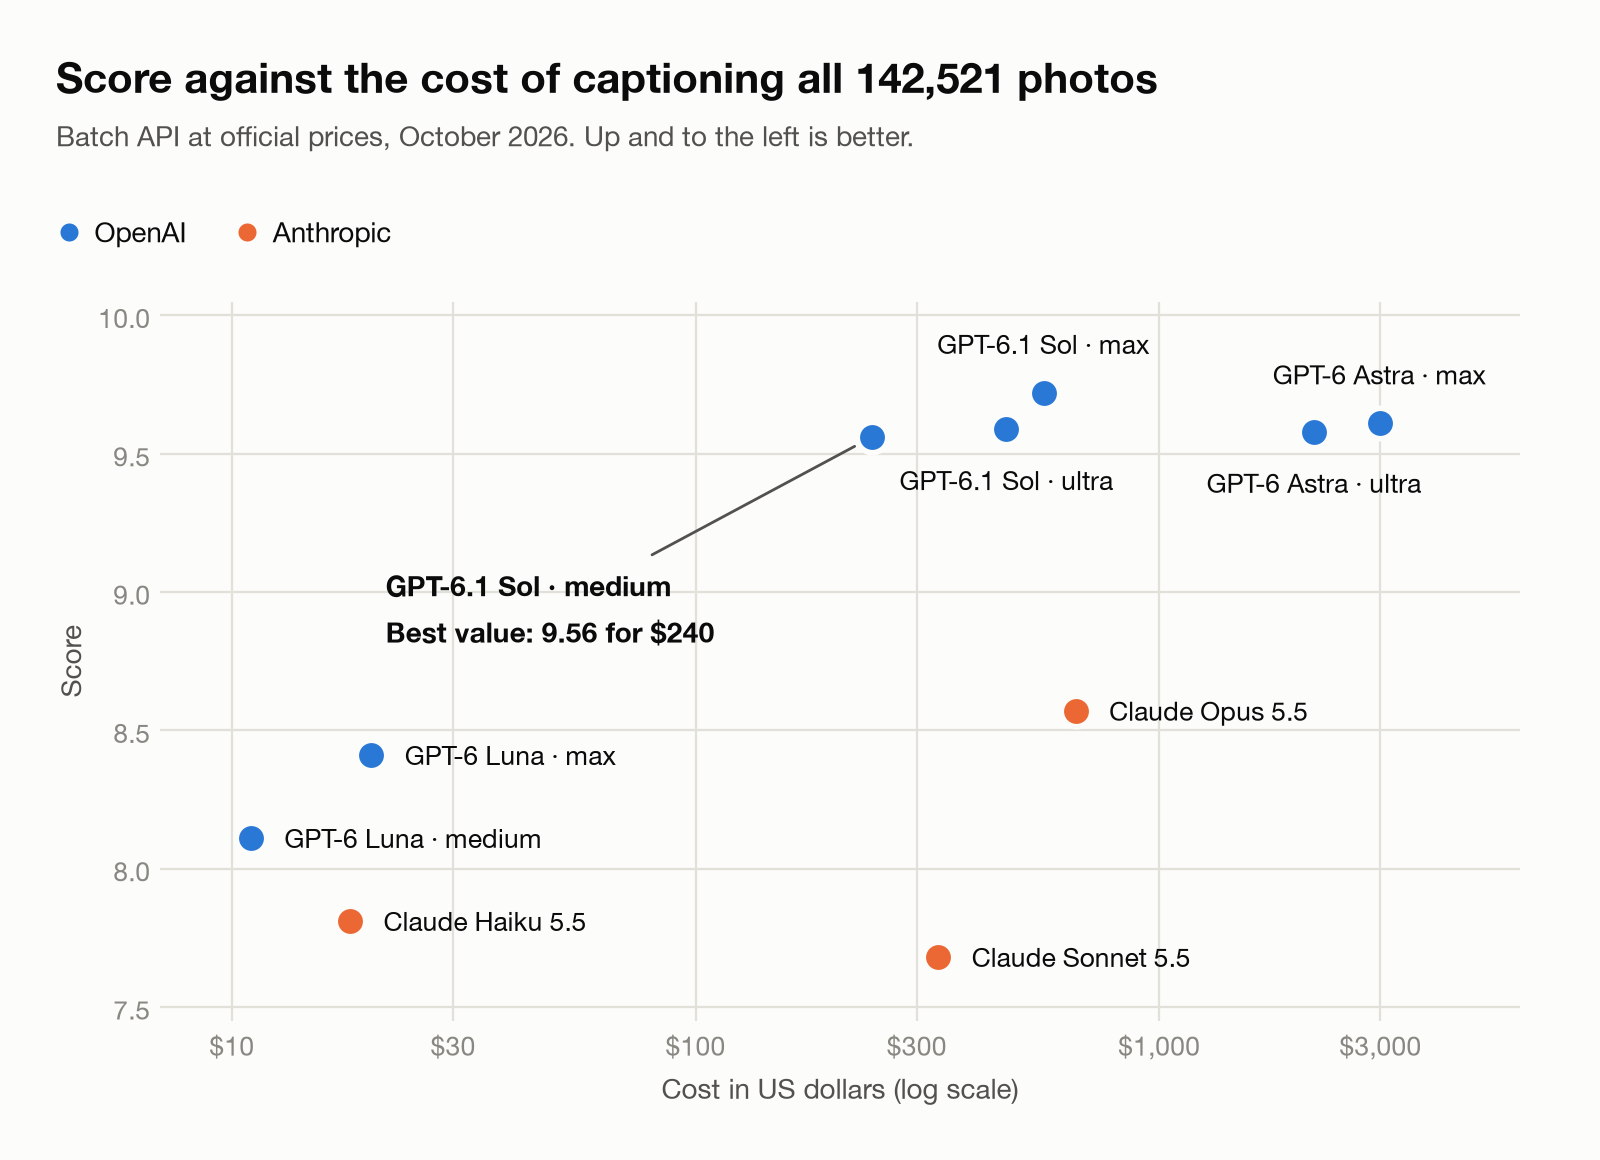 الشكل 9. الدرجة مقابل تكلفة كتابة أوصاف المكتبة كلها بأسعار Batch. محور التكلفة لوغاريتمي.
| النموذج والجهد | رموز الإخراج لكل صورة | القياسي | Batch | الدرجة |
|---|---|---|---|---|
| GPT-6.1 Sol، medium | 193 | $479 | $240 | 9.56 |
| GPT-6.1 Sol، ultra | 514 | $937 | $468 | 9.59 |
| GPT-6.1 Sol، max | 647 | $1,126 | $563 | 9.72 |
| Claude Opus 5.5 | ~292 | $1,323 | $661 | 8.57 |
| Claude Sonnet 5.5 | ~297 | $668 | $334 | 7.68 |
| GPT-6 Astra، ultra | 462 | $4,313 | $2,156 | 9.58 |
| GPT-6 Astra، max | 695 | $5,973 | $2,987 | 9.61 |
| GPT-6 Luna، medium | 163 | $22 | $11 | 8.11 |
| Claude Haiku 5.5 | ~330 | $36 | $18 | 7.81 |
| GPT-6 Luna، max | 419 | $40 | $20 | 8.41 |
حصل Sol عند medium على 98% من أعلى درجة مقابل 36% مما سيكلفه Opus و43% من Sol عند max. طابق Astra جودة Sol لكنه يكلف نحو خمسة أضعاف، لأن سعره لكل رمز أعلى بخمس مرات. كلّف Opus أكثر من Sol عند max وسجل درجة أقل. لقد عمل أصلًا عند جهد medium، لكن سعره لكل رمز ضعف سعر Sol. سيكتب Luna أوصاف المكتبة كلها مقابل 11 إلى 20 دولارًا وسيتفوق مع ذلك على Haiku وSonnet.
ملاحظة منهجية: قيست أعداد رموز GPT من عمليات التشغيل، وقُدّرت أعداد رموز Claude من سجلات التشغيل. لم تكن بعض رموز الاستدلال لدى Claude مرئية، لذا قد تكون تكاليف Claude أقل من الواقع قليلًا. لم تُطبَّق على أي نموذج خصومات غير Batch، مثل التخزين المؤقت للأوامر.
ما تعلمته
اخترت Opus قبل أن أحصل على أي درجات عمياء، غالبًا لأنه كان بالفعل خياري الافتراضي للبرمجة. ما زلت أفضل Claude Opus 5.5 للبرمجة وسير العمل، حيث يكون أسرع وأقوى في تجربتي. يتطلب وصف الصور الحقيقية مهارة مختلفة: قراءة ما هو موجود فعلًا في الإطار من دون ملء الوضعيات أو العلاقات. قام GPT-6.1 Sol بذلك أفضل. لو اتّبعت العادة وتجاوزت الاختبار الأعمى، لكنت دفعت أكثر مقابل أوصاف أسوأ.
في المرة القادمة سأبدأ بشكل أعمى وأعطي مقيّمين من جهات مختلفة كل المدخلات التي حصلت عليها نماذج كتابة الأوصاف. وسأواصل المقارنة بأسعار واجهة برمجة التطبيقات الرسمية، ولن أفترض أن الجهد الأكبر أفضل: فـ ultra لم يتفوق على max هنا.
حتى أفضل النماذج علّمت صورًا مفيدة للحذف، لذا سأتحقق من كل علامة حذف بنفسي قبل إزالة أي شيء.
القيود
كان هذا اختبارًا صغيرًا: 50 صورة حديثة من مدينة واحدة. لم أختبر الصور القديمة أو المستندات الممسوحة ضوئيًا أو اللغات الأخرى أو مقاطع الفيديو. عُملت نماذج Claude بإعداداتها الافتراضية فقط؛ قد يسجل Opus بجهد أعلى درجة أفضل بتكلفة أعلى. المقيّمان نموذجا ذكاء اصطناعي، وليسا بشرًا. اتفقا جيدًا لكن ليس بشكل مثالي، والتحقق البشري الجزئي سيجعل النتيجة أقوى. تتغير النماذج والأسعار بسرعة، وكل رقم هنا هو حتى أكتوبر 2026.
خياري
لمكتبتي: GPT-6.1 Sol عند جهد medium. وللبرمجة وسير العمل، سأبقى على Claude Opus 5.5.