
Я вслепую протестировал 10 ИИ-моделей на своей библиотеке из 142,000 фотографий: GPT-6.1 Sol обошел Claude Opus
Аннотация
Я каждый день пользуюсь Claude Opus 5.5 для кода и рабочих процессов, и в этих задачах он кажется мне быстрее и лучше, чем GPT-6. Я предполагал, что он окажется лучшим и в описании фотографий, поэтому и решил проверить. Я прогнал десять конфигураций: Claude Haiku, Sonnet и Opus 5.5, а также OpenAI GPT-6.1 Sol, GPT-6 Astra и GPT-6 Luna на нескольких уровнях усилий. Каждая озаглавливала, описывала, размечала ключевыми словами и раскладывала по альбомам 50 реальных фотографий из моей библиотеки в 142,521 снимок, а также помечала те, которые, по её мнению, стоит удалить. Два слепых оценщика от разных вендоров, Claude Fable 5.1 и GPT-6 Astra, оценили все 500 ответов по фактам, выдуманным деталям, решениям об удалении, соответствию альбому и полезности. GPT-6.1 Sol набрал больше всех — 9.72 из 10. Opus получил 8.57, а Sonnet и Haiku оказались в диапазоне от 7.7 до 7.8. Уровень ultra оказался не лучше, чем max. По официальным ценам Batch API описание всей библиотеки обойдётся примерно в $240 с Sol на уровне medium (9.56), в $661 с Opus и в $11–$20 с Luna, которая всё равно обошла Haiku.
Зачем я это проверял
Большая часть моего дня уходит на код, агентные рабочие процессы и автоматизацию, и мой выбор — Claude Opus 5.5. В таких задачах он ощущается быстрее и лучше, чем GPT-6. Поэтому, когда я решил поручить ИИ подписи и теги для моей фотобиблиотеки, я без раздумий выбрал Opus.
Библиотека — это 25 лет моей жизни: 142,521 фотография, от первых снимков цифровой камеры до прошлонедельных кадров с телефона, плюс более 16,000 скриншотов. Почти ни у одной нет подписи. Я хочу, чтобы у каждого снимка были заголовок, подпись, ключевые слова для поиска, подходящий альбом и честная пометка, если это дубликат или мусор. Прежде чем платить за обработку 142,000 фотографий, я хотел понять, какая модель справляется лучше всех и сколько стоит эта разница.
Я ожидал, что победит Opus. На этих 50 фотографиях GPT-6.1 Sol набрал больше чем на балл выше.
Результаты вкратце
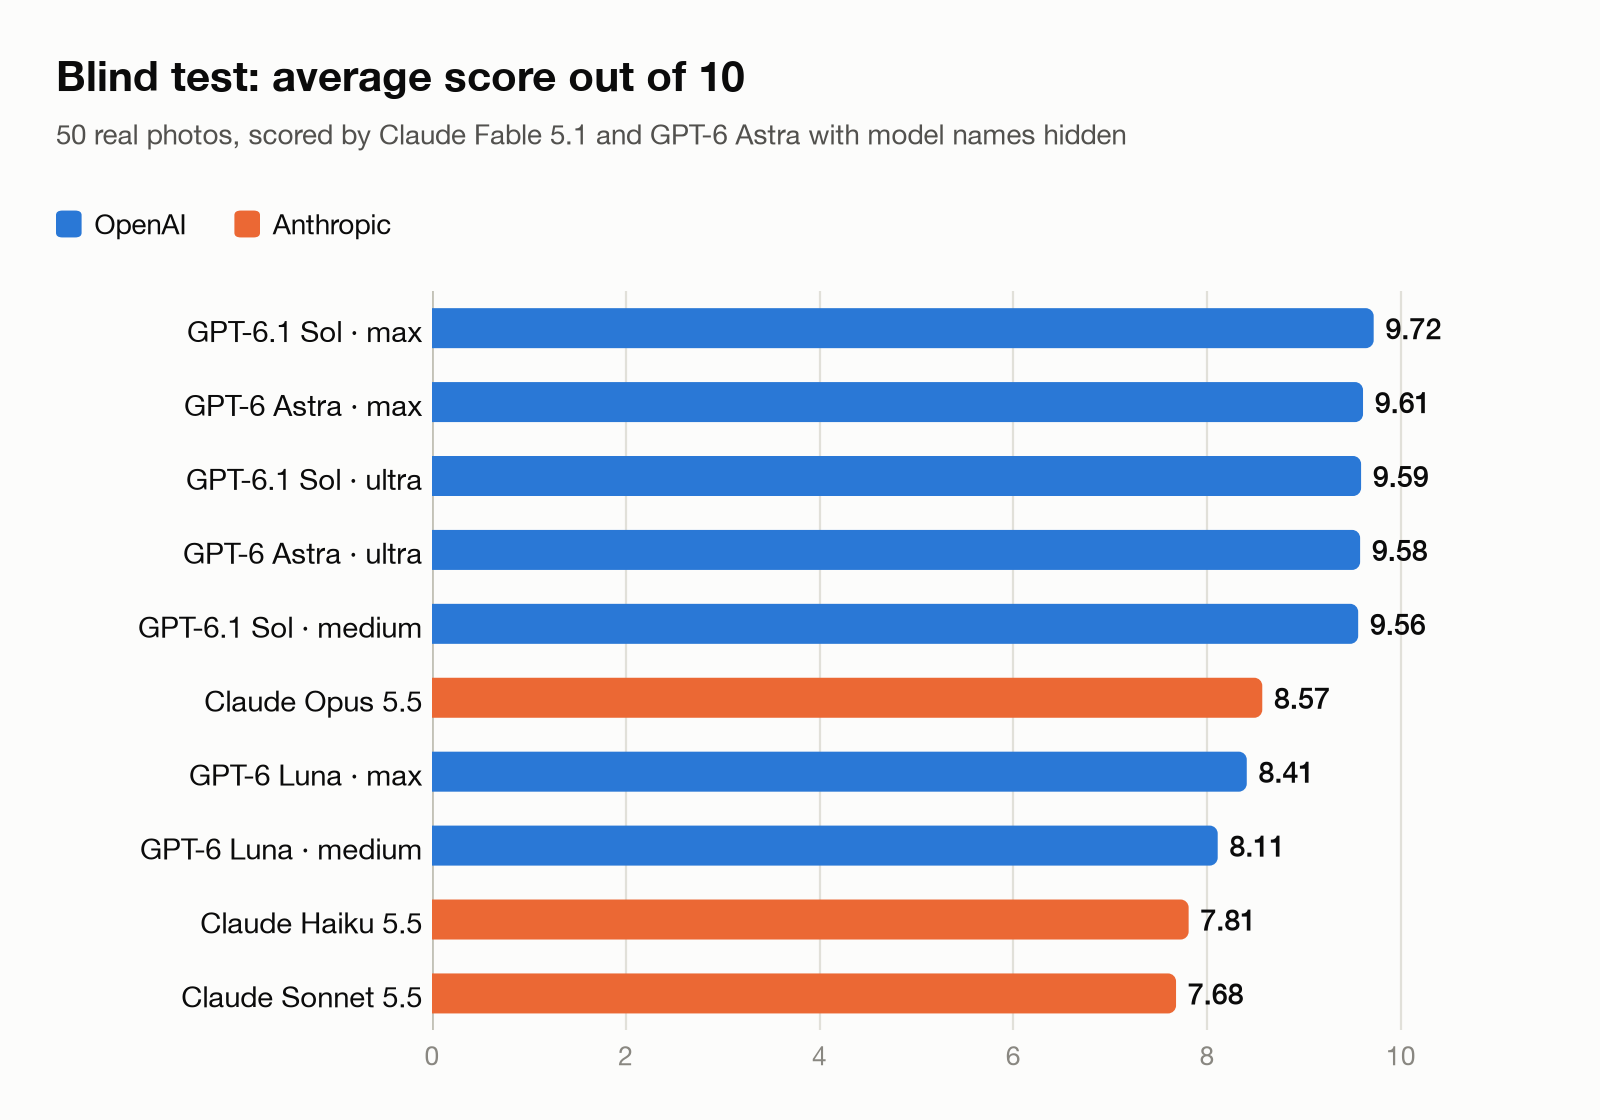 Рисунок 1. Средняя оценка двух слепых оценщиков, максимум 10.
| Место | Модель и уровень усилий | Оценка (из 10) | Вся библиотека, Batch API | Вся библиотека, стандартный API |
|---|---|---|---|---|
| 1 | GPT-6.1 Sol, max | 9.72 | $563 | $1,126 |
| 2 | GPT-6 Astra, max | 9.61 | $2,987 | $5,973 |
| 3 | GPT-6.1 Sol, ultra | 9.59 | $468 | $937 |
| 4 | GPT-6 Astra, ultra | 9.58 | $2,156 | $4,313 |
| 5 | GPT-6.1 Sol, medium | 9.56 | $240 | $479 |
| 6 | Claude Opus 5.5 | 8.57 | $661 | $1,323 |
| 7 | GPT-6 Luna, max | 8.41 | $20 | $40 |
| 8 | GPT-6 Luna, medium | 8.11 | $11 | $22 |
| 9 | Claude Haiku 5.5 | 7.81 | $18 | $36 |
| 10 | Claude Sonnet 5.5 | 7.68 | $334 | $668 |
Стоимость рассчитана для всех 142,521 фотографий по официальной цене API каждого вендора.
Что я выбрал бы по итогам этого теста:
- Если бы меня интересовала только оценка — GPT-6.1 Sol на уровне max.
- Для собственной библиотеки — GPT-6.1 Sol на уровне medium. Он набрал 98% от максимальной оценки за $240, то есть около трети того, во что обошёлся бы Opus.
- При ограниченном бюджете — GPT-6 Luna на уровне max. За $20 он обошёл Haiku, который стоит столько же за токен, и Sonnet, который обошёлся бы для этой библиотеки примерно в 17 раз дороже.
- Не Claude Sonnet 5.5. У него средняя цена и самая низкая оценка.
Модели
| Вендор | Модель | Проверенные уровни усилий | Позиционирование |
|---|---|---|---|
| Anthropic | Claude Opus 5.5 | по умолчанию (medium) | Флагман на каждый день |
| Anthropic | Claude Sonnet 5.5 | по умолчанию | Средний сегмент |
| Anthropic | Claude Haiku 5.5 | по умолчанию | Быстрая и дешёвая |
| OpenAI | GPT-6 Astra | max, ultra | Передовая модель |
| OpenAI | GPT-6.1 Sol | medium, max, ultra | Рабочая лошадка |
| OpenAI | GPT-6 Luna | medium, max | Быстрая и дешёвая |
Цены у двух вендоров совпадают по линейкам. GPT-6.1 Sol стоит столько же за токен, сколько Claude Sonnet 5.5, GPT-6 Astra — столько же, сколько Claude Fable 5.1, а GPT-6 Luna — столько же, сколько Claude Haiku 5.5. Claude Opus 5.5 находится между Sol и Astra. Поэтому, если ниже две модели оказываются с разной стоимостью, это в основном потому, что одна из них потратила больше токенов на ту же работу.
Модели Claude прогонялись по одному разу каждая с настройками по умолчанию, что для Opus означает уровень medium. Модели GPT я тестировал на нескольких уровнях усилий. Самое близкое сравнение «равное с равным» — это GPT-6.1 Sol на medium против Claude Opus 5.5 на medium: 9.56 против 8.57.
Тест
Я взял 50 самых свежих на тот момент фотографий из библиотеки, без видео. Это обычная неделя из моей плёнки: семейные моменты дома и в походе по магазинам, виды города с высокого этажа, карта памяти на столе, скриншоты карточек товаров с электронными компонентами, скриншоты отслеживания заказа, пост из соцсети, табличка с QR-кодом парковочной скидки и этикетка зарядной станции для электромобиля.
У каждой модели было по пять задач на каждую фотографию. Она писала короткий заголовок и подпись из одного–трёх предложений на китайском, давала от 5 до 12 ключевых слов на китайском и английском и выбирала лучший альбом из моих существующих альбомов или ни одного. Затем она ставила оценку качества и говорила, оставить или удалить фотографию, выискивая дубликаты, неудачные кадры, устаревшие скриншоты и снимки без долговременной ценности. Все модели получали одинаковые инструкции и одинаковый контекст для каждой фотографии, по десять фотографий за раз.
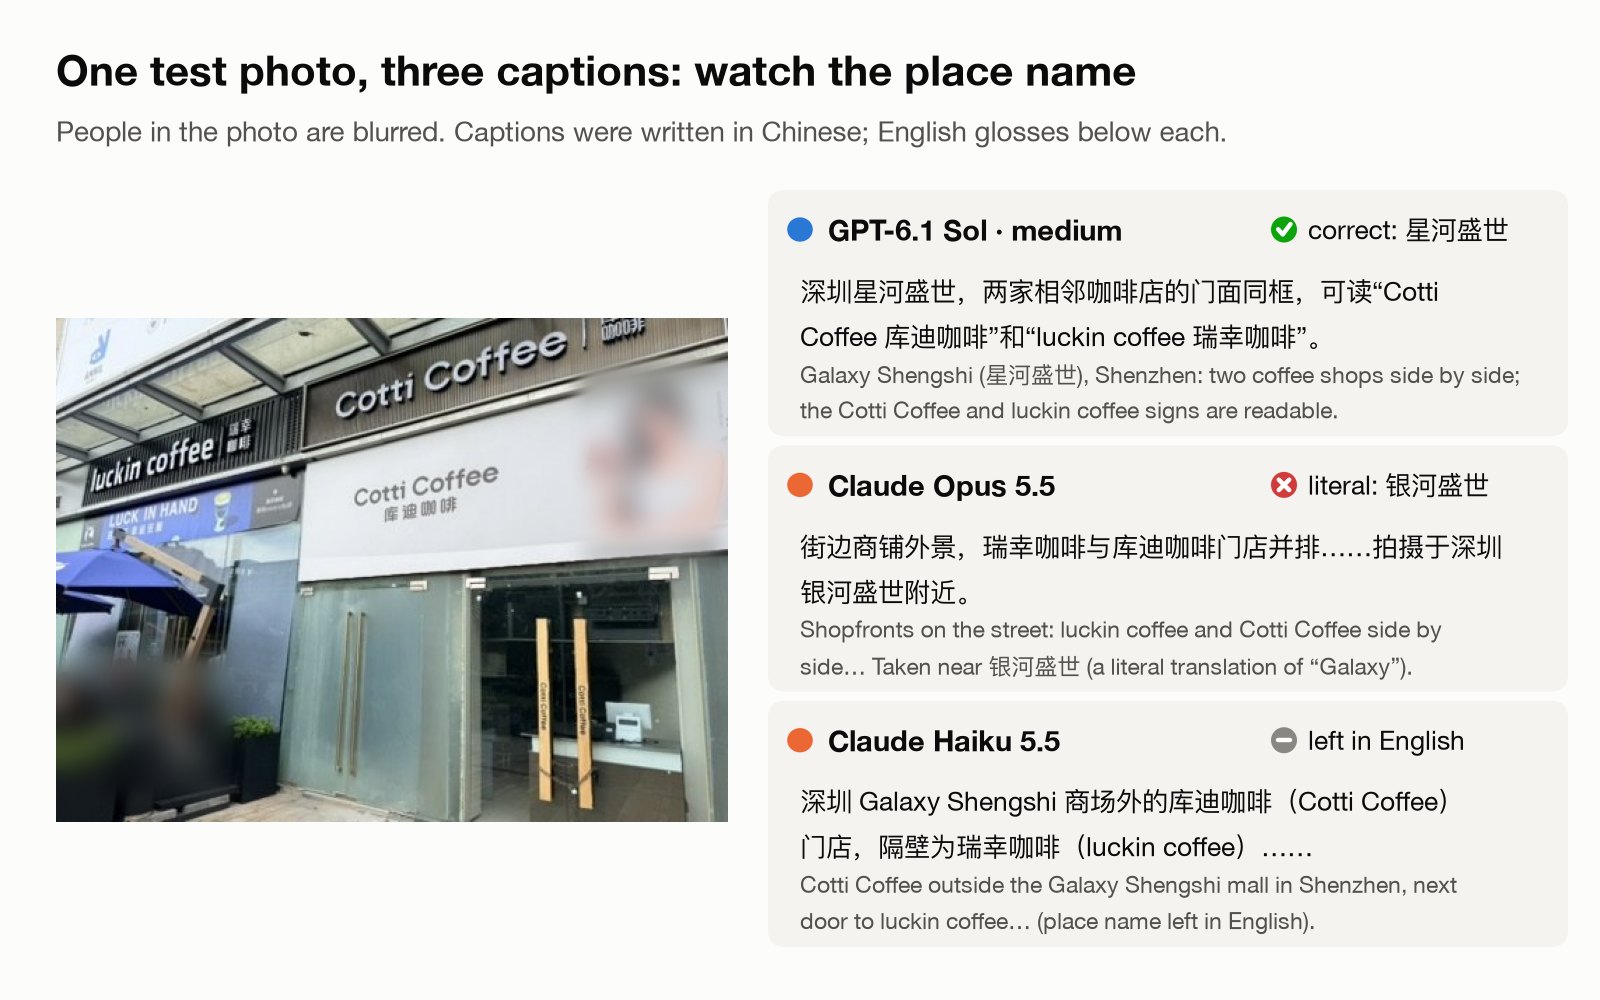 Рисунок 2. Одна из 50 тестовых фотографий с тремя подписями. Обратите внимание, как каждая модель обрабатывает название места; я вернусь к этому ниже. Люди на фото размыты.
Как я оценивал
Я не оценивал ответы сам. Я ещё до теста выбрал победителя и каждый день пользуюсь Claude, так что не был нейтрален.
Вместо этого я перемешал десять ответов для каждой фотографии и пометил их буквами от A до J, с новым случайным порядком для каждого снимка. Затем два оценщика независимо оценили все 500 ответов, глядя на фотографии. Одним был Claude Fable 5.1 — самая мощная модель Anthropic. Другим — GPT-6 Astra на уровне xhigh, передовая модель OpenAI.
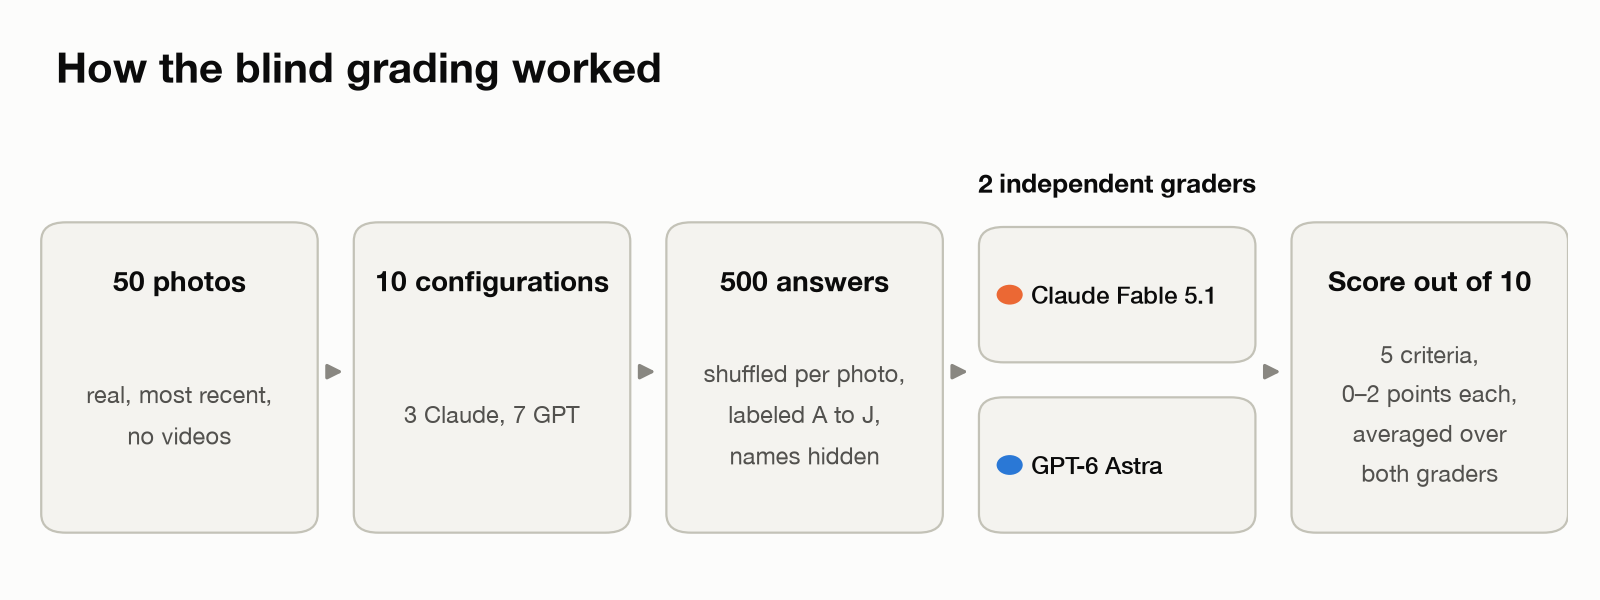 Рисунок 3. Как работало слепое оценивание.
Каждый ответ оценивался по пяти критериям, от 0 до 2 баллов каждый, итого 10:
| Критерий | Что проверял оценщик |
|---|---|
| Факты | Верны ли объект, место и любой читаемый текст, включая местные названия? |
| Отсутствие выдуманных деталей | Не утверждает ли ответ то, чего нет на фотографии? |
| Решение об удалении | Разумно ли решение оставить или удалить? Удаление хорошей фотографии даёт 0. |
| Соответствие альбому | Правильный ли альбом? Неверный старый альбом даёт 0; отсутствие альбома — приемлемая 1. |
| Полезность | Помогут ли заголовок, подпись и ключевые слова позже найти и вспомнить эту фотографию? |
Я взял по одному оценщику от каждого вендора, чтобы понять, не станет ли кто-то отдавать предпочтение собственным моделям. Они в основном согласились. Корреляция между 500 парными оценками составила 0.71, и оба поставили наверх одни и те же пять GPT-конфигураций. Оценщик Claude также поставил GPT-6.1 Sol и GPT-6 Astra выше Claude Opus. Оценщик GPT был в целом строже, и строже всего — к моделям Claude.
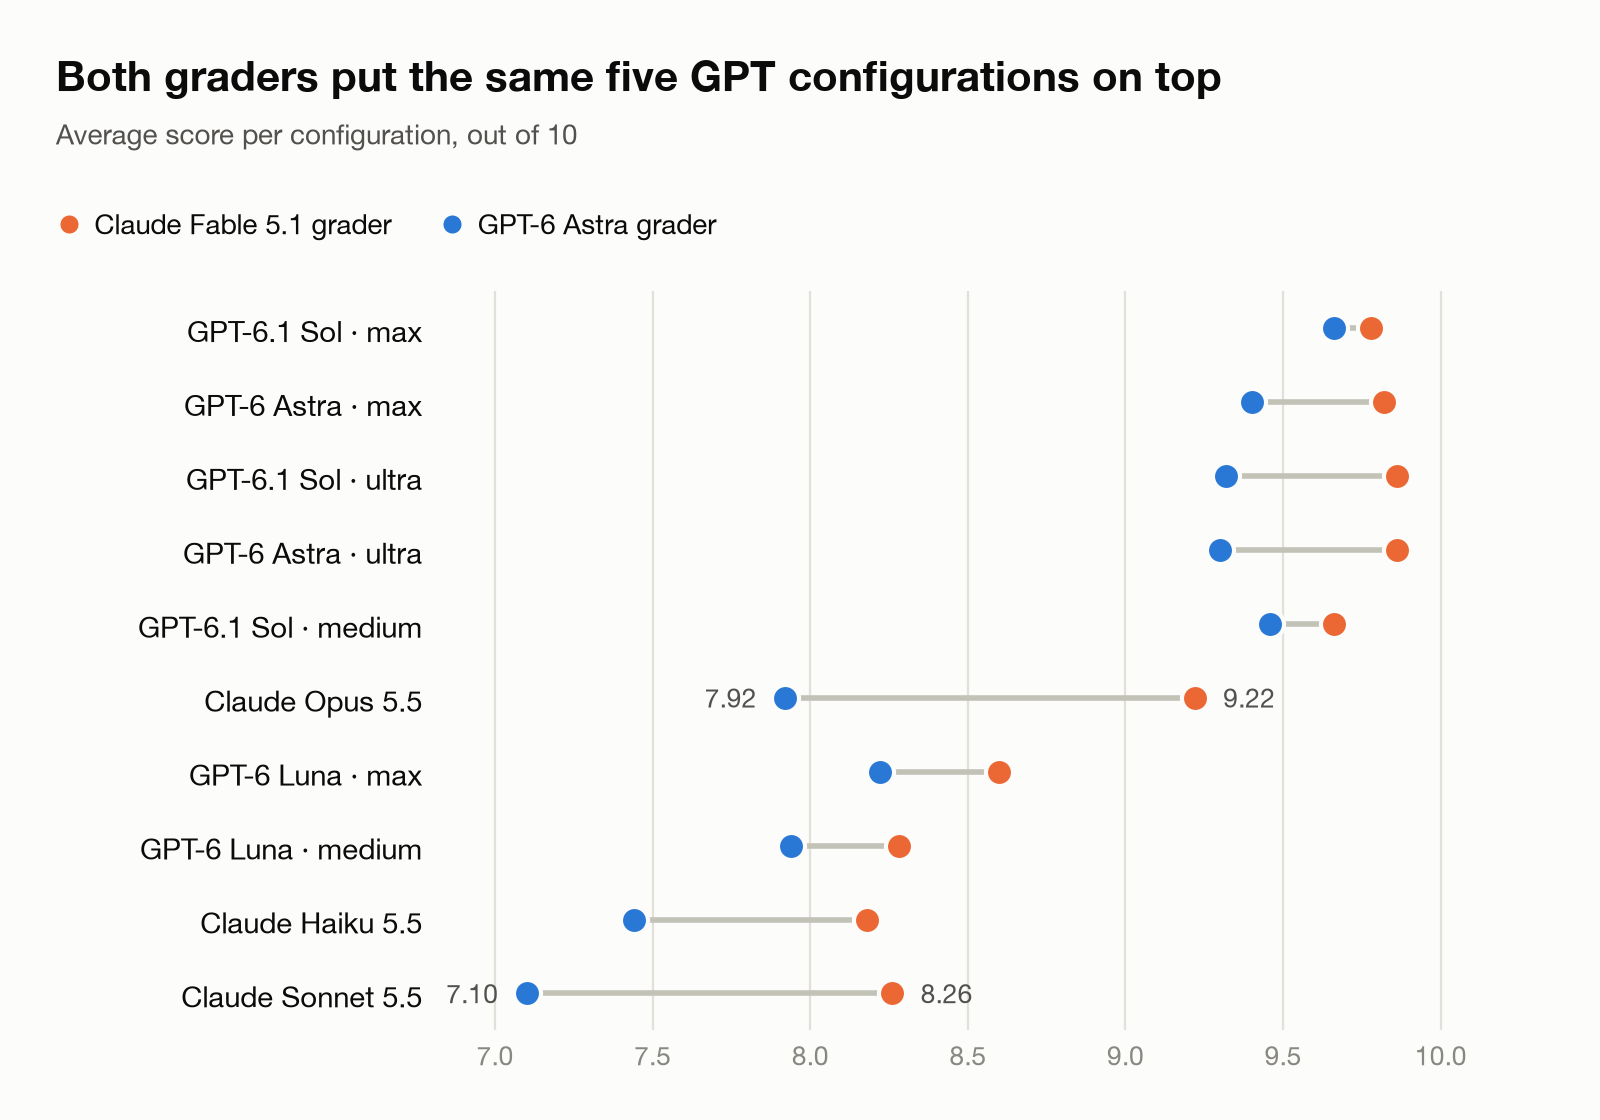 Рисунок 4. Средняя оценка каждого оценщика по конфигурациям.
Результаты
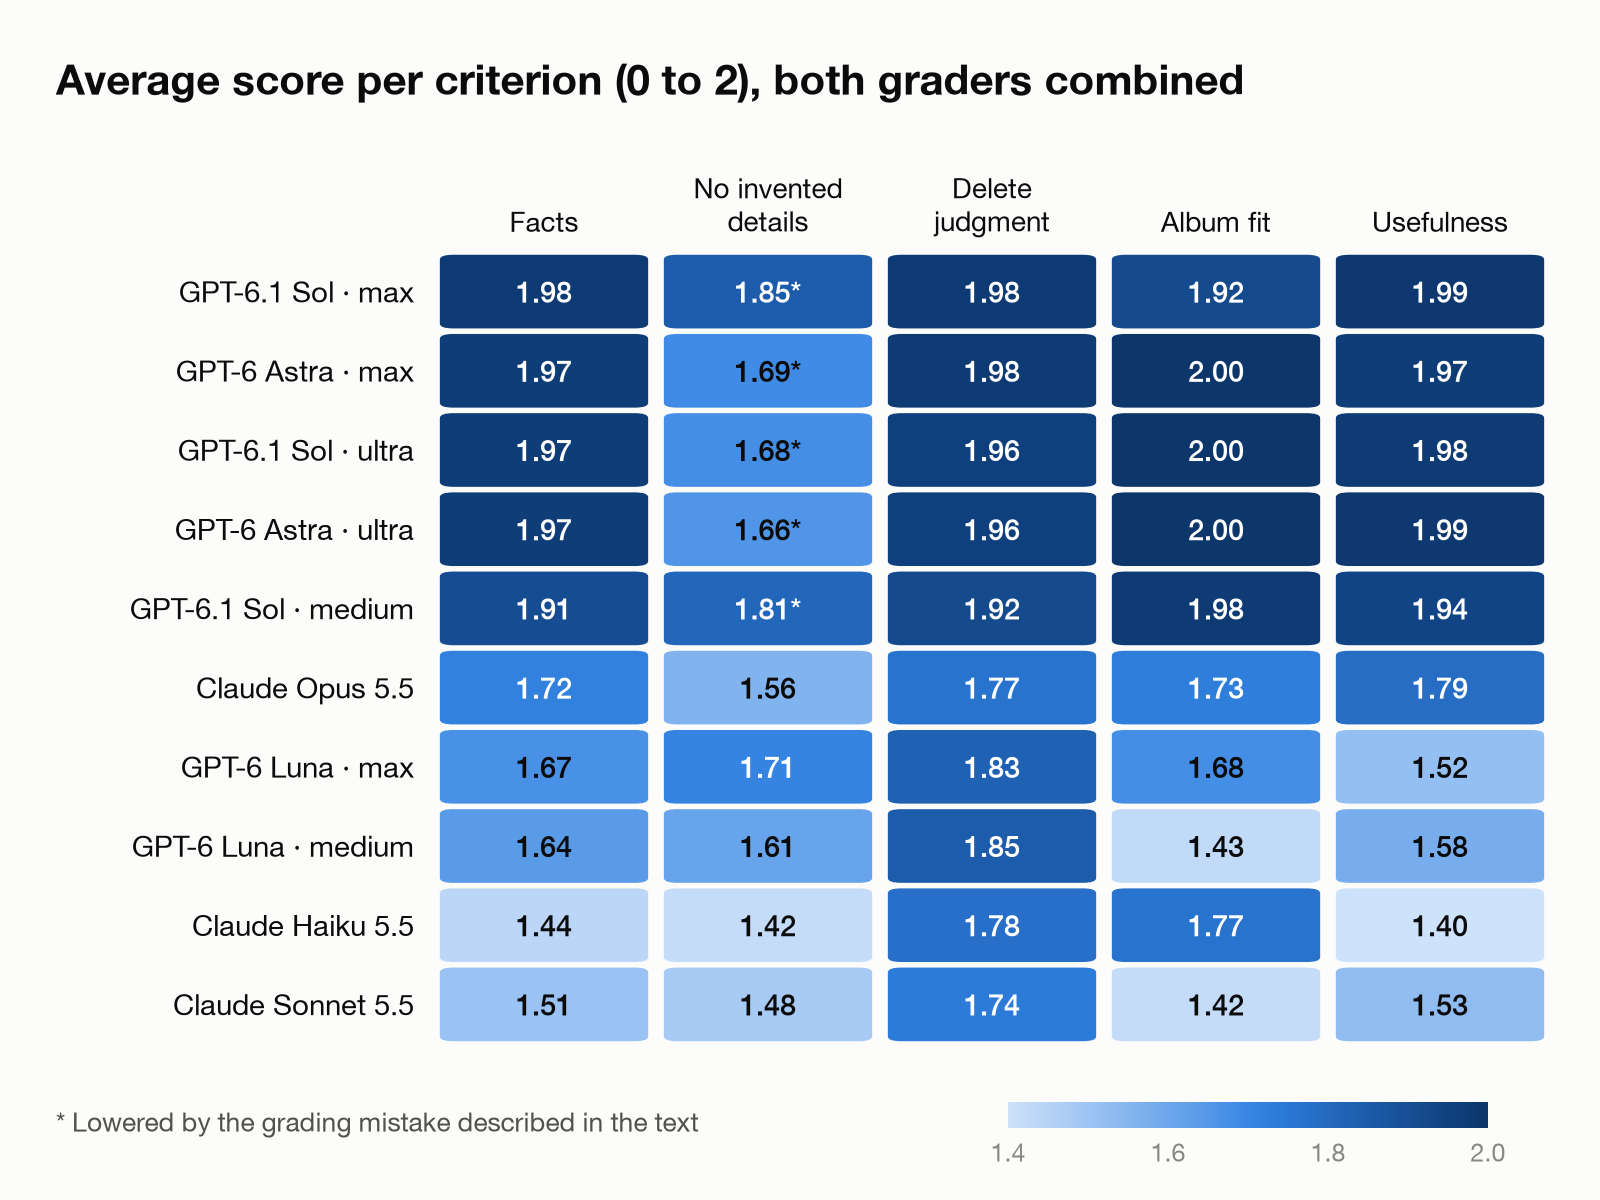 Рисунок 5. Средняя оценка по каждому критерию, оба оценщика вместе. Звёздочка отмечает оценки, заниженные из-за ошибки оценивания, которую я описываю ниже.
GPT-6.1 Sol и GPT-6 Astra
Sol и Astra точно читали текст и в основном ограничивали подписи тем, что видно на фотографиях. Они также лучше всех справлялись с местными названиями, что важно для снимков, сделанных в Китае.
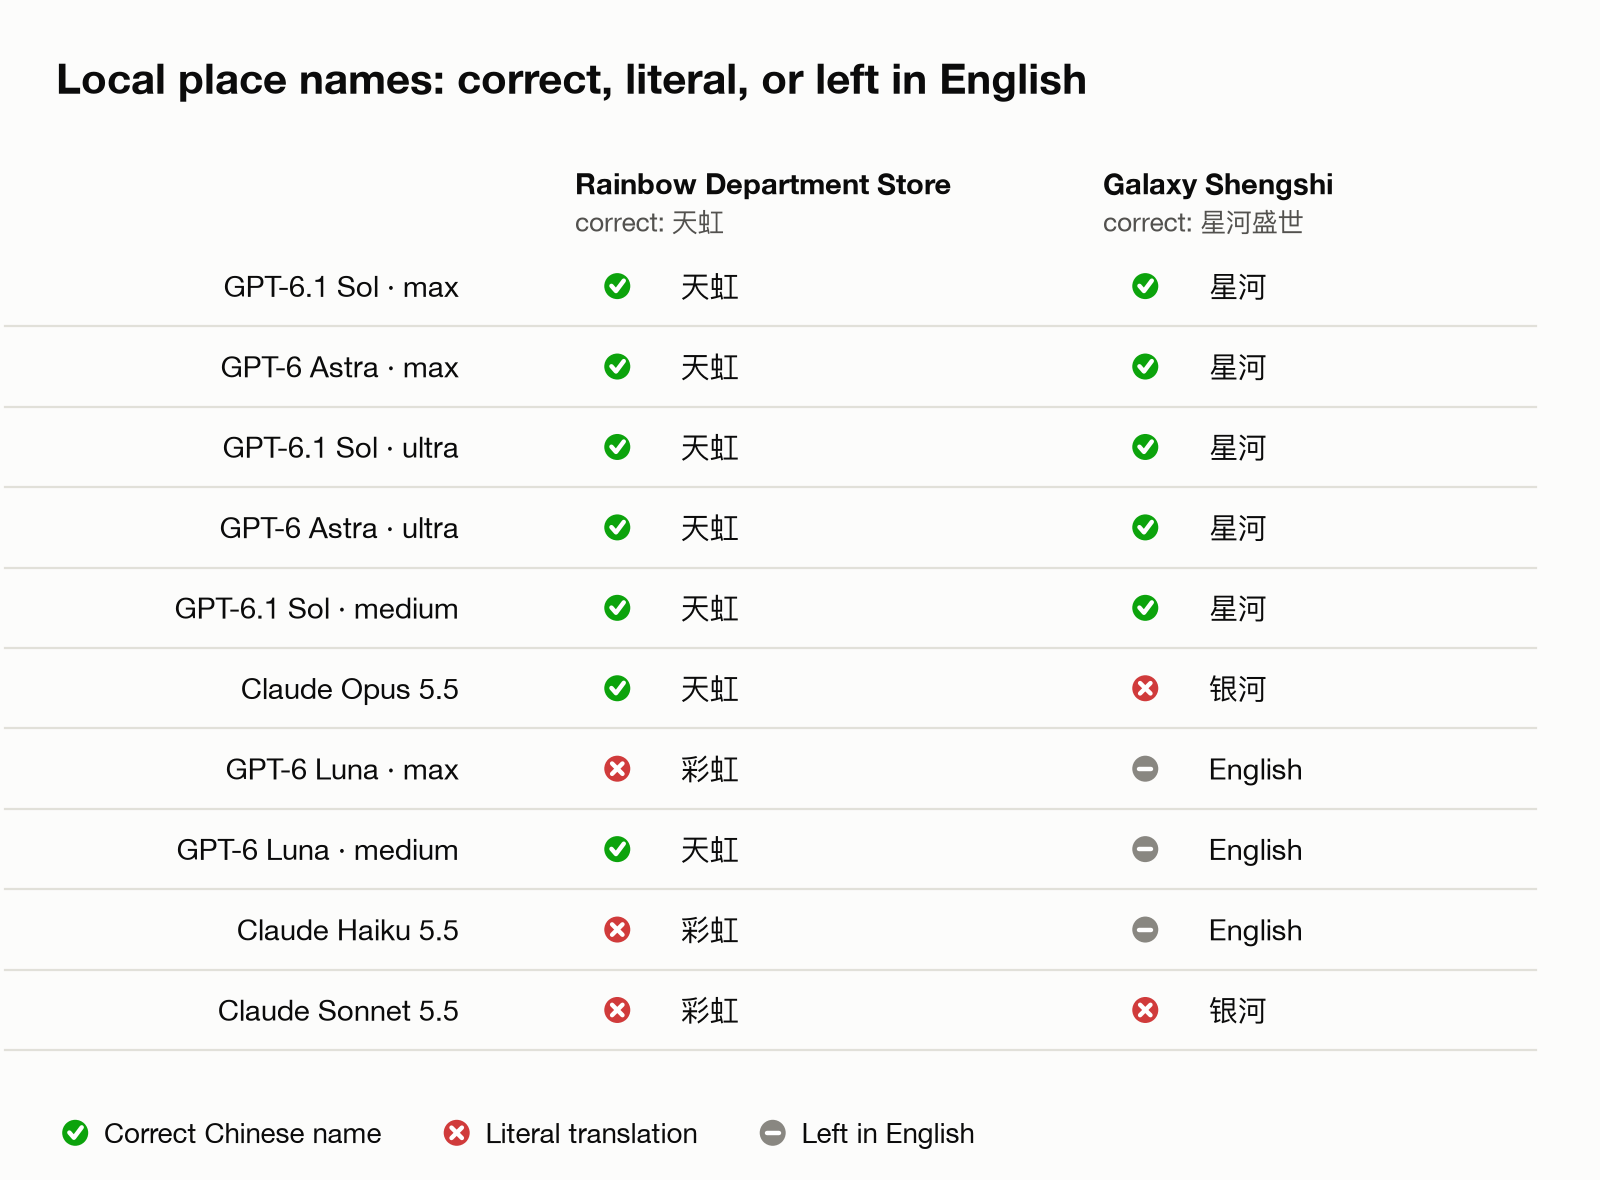 Рисунок 6. Два теста на местные названия. Галочка означает правильное китайское название, крестик — буквальный перевод, а EN — что название оставлено на английском.
Несколько фотографий получили тег с местом «Rainbow Department Store». Это английское название шэньчжэньской сети торговых центров 天虹. Дословный перевод даёт 彩虹百货, что неверно. Все конфигурации Sol и Astra справились, как и Opus и Luna на medium. Haiku, Sonnet и Luna на max использовали буквальный перевод. Фотография кофейни на рисунке 2 получила тег «Galaxy Shengshi», китайское название которого — 星河盛世. Все конфигурации Sol и Astra написали 星河. Opus и Sonnet перевели буквально как 银河, а Haiku и обе конфигурации Luna оставили его на английском.
Sol и Astra были также осторожны с удалением. Они предлагали удалить от 4 до 6 из 50 фотографий. В наборе было восемь скриншотов карточек товаров с электронными компонентами, и GPT-модели сохранили почти все; одна конфигурация Sol пометила единственный скриншот как почти-дубликат. Модели Claude пометили по две–четыре каждая. Оба оценщика согласились их сохранить, поскольку на страницах были распиновки, размеры и фото плат, которые я захотел бы найти позже.
Claude Opus 5.5
Opus иногда вписывал в подпись то, чего одна фотография показать не может. Он описывал отношения, которые по одному снимку нельзя доказать, например братьев и сестёр или родителя и ребёнка. Он также ошибался в позах. На одной фотографии ребёнок стоял за взрослым, а Opus написал, что ребёнок сидит у взрослого на спине. Оба оценщика сняли за это баллы.
Это меня удивило. До слепого теста я просматривал ответы и похвалил Opus за то, что он верно угадал, что двое детей — брат и сестра. Я знаю свою семью; оценщик — нет. Но с 142,000 фотографиями я не могу проверять каждую подпись сам, и подпись, утверждающая то, чего нет на фото, — это проблема.
Opus также предложил больше всего удалений — 13 из 50 фотографий. Три из них были скриншотами карточек товаров, которые он назвал устаревшими, хотя там была справочная информация, которую я бы сохранил. Это была единственная модель, которая хотела удалить табличку с QR-кодом парковочной скидки как не имеющую ценности. Он также сложил несколько фотографий одного человека в альбом «семейный портрет».
Claude Sonnet 5.5 и Haiku 5.5
Эти две совершили больше всего фактических ошибок, включая буквальный перевод 彩虹. Sonnet делал самые слабые выборы альбомов и раскладывал повседневные фотографии в старый альбом из несвязанного события. Haiku выдумал деталь, которая привела к плохому решению об удалении. В серии почти одинаковых кадров он описал лучший кадр как человека, смотрящего вниз, что противоположно тому, что на фото, и предложил удалить его.
GPT-6 Luna
Luna стоит столько же за токен, сколько Haiku, но набрала выше на обоих уровнях усилий: 8.41 и 8.11 против 7.81 у Haiku. На уровне max она также обошла Sonnet, который обошёлся бы примерно в 17 раз дороже за описание той же библиотеки. Больше всего баллов Luna потеряла на полезности и выборе альбома. Её подписи были проще, а альбомы — менее точными.
Уровни усилий
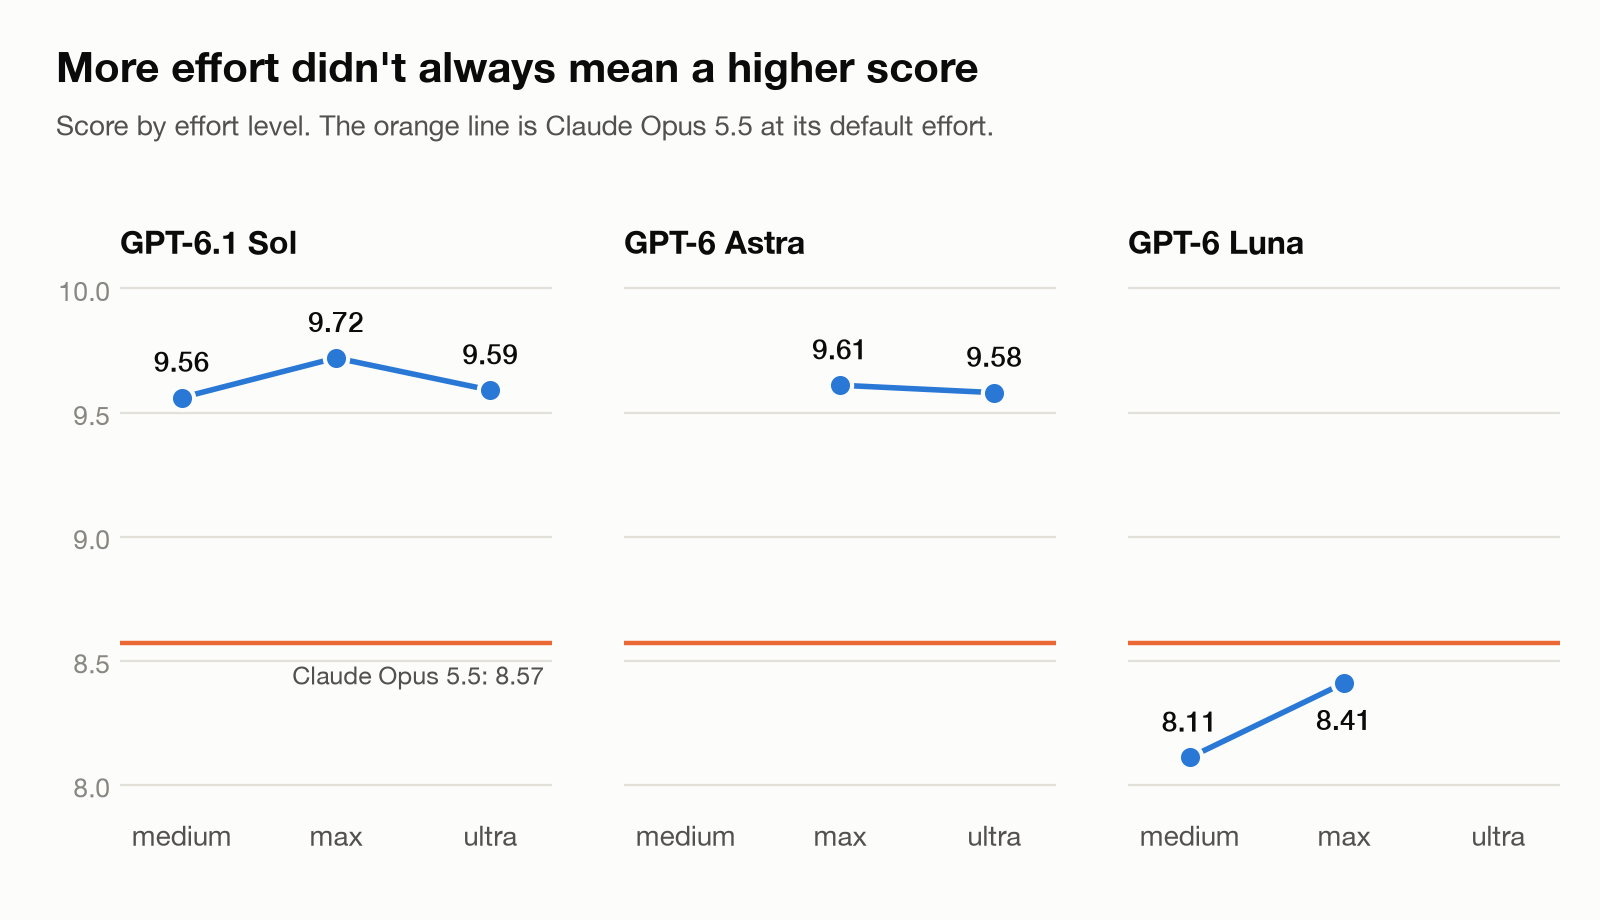 Рисунок 7. Оценка по уровням усилий. Оранжевая линия — Claude Opus 5.5 на уровне по умолчанию.
Ultra оказался не лучше, чем max, ни для одной модели. Sol набрал 9.59 на ultra и 9.72 на max; Astra — 9.58 и 9.61. В этом тесте ultra даже выдал меньше выходных токенов, чем max. Для Sol уровень medium подошёл близко — 9.56 — при менее чем половине стоимости max. Более высокий уровень усилий не всегда означал более точные детали: Luna на medium написала 天虹 правильно, а Luna на max — нет.
Ошибка в моём оценивании
После оценивания я заметил, что оценщикам не дали дату и время съёмки каждой фотографии, хотя модели, писавшие подписи, их получили. Поэтому оценщик GPT-6 Astra считал подписи с упоминанием точной даты или времени выдуманными деталями. Лучшие GPT-конфигурации упоминали дату чаще всего, поэтому их оценки по критерию «отсутствие выдуманных деталей» оказались ниже, чем следовало.
Если вернуть только баллы, потерянные из-за дат, четыре лучшие GPT-конфигурации поднимаются до 9.84–9.90, что фактически ничья, а Opus остаётся на 8.58. В этой статье я оставил исходные оценки. В следующий раз я дам оценщикам всё, что видели модели.
Скорость
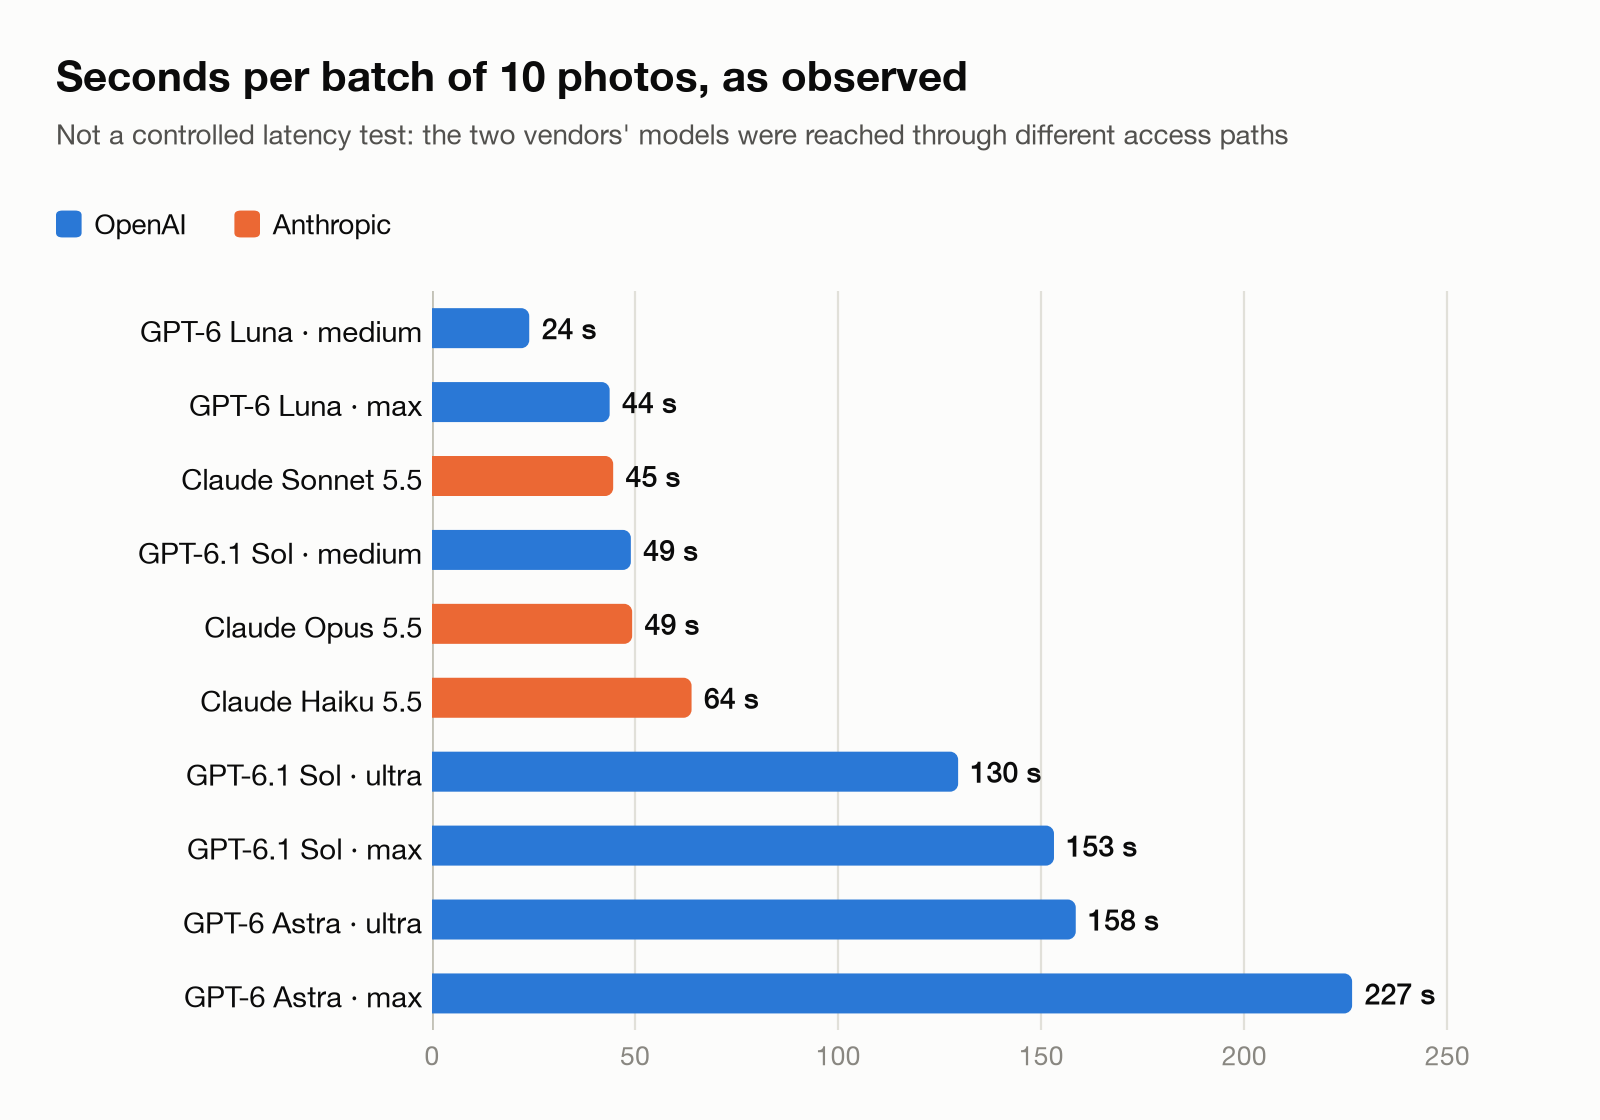 Рисунок 8. Секунды на партию из 10 фотографий, как наблюдалось. Это не контролируемый тест задержки, потому что модели двух вендоров вызывались через разные пути доступа.
Это совпадает с тем, как Opus ощущается в моей повседневной работе: он быстрый, примерно втрое быстрее Sol на max. Sol на medium, впрочем, был так же быстр, как Opus, и набрал примерно на балл выше.
Сколько это стоит
Я оценил каждую конфигурацию по официальным ценам API вендоров. Если считать включённое в подписку использование бесплатным, некоторые модели выглядели бы лучше, чем они есть.
Официальные цены за миллион токенов, стандартный тариф:
| Модель | Вход | Выход |
|---|---|---|
| Claude Opus 5.5 | $4.00 | $20.00 |
| Claude Sonnet 5.5 | $2.00 | $10.00 |
| Claude Haiku 5.5 | $0.10 | $0.50 |
| GPT-6 Astra | $10.00 | $50.00 |
| GPT-6.1 Sol | $2.00 | $10.00 |
| GPT-6 Luna | $0.10 | $0.50 |
Batch API обоих вендоров стоят на 50% дешевле, что подходит для задачи, которой не нужны мгновенные ответы. Цены я взял со страницы цен Anthropic (claude.com/pricing) и страницы цен API OpenAI (developers.openai.com/api/docs/pricing) 20 октября 2026 года.
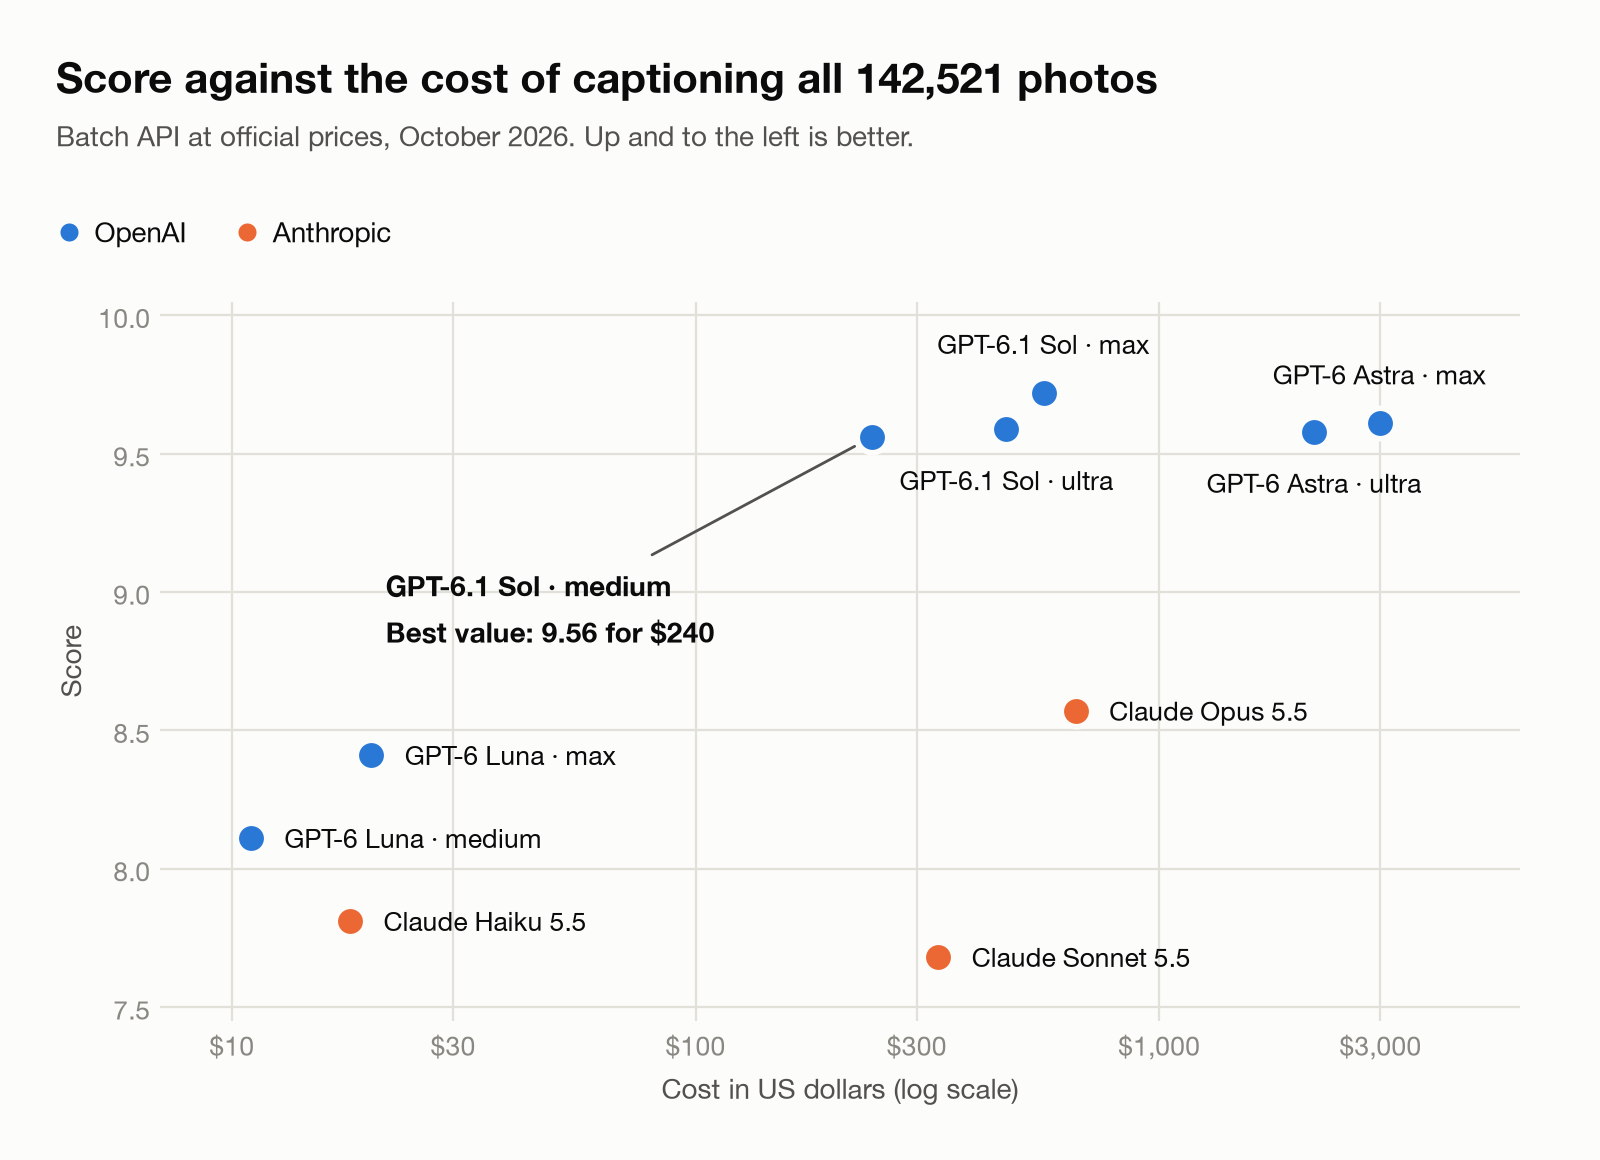 Рисунок 9. Оценка против стоимости описания всей библиотеки по ценам Batch. Ось стоимости логарифмическая.
| Модель и уровень усилий | Выходных токенов на фото | Стандартный | Batch | Оценка |
|---|---|---|---|---|
| GPT-6.1 Sol, medium | 193 | $479 | $240 | 9.56 |
| GPT-6.1 Sol, ultra | 514 | $937 | $468 | 9.59 |
| GPT-6.1 Sol, max | 647 | $1,126 | $563 | 9.72 |
| Claude Opus 5.5 | ~292 | $1,323 | $661 | 8.57 |
| Claude Sonnet 5.5 | ~297 | $668 | $334 | 7.68 |
| GPT-6 Astra, ultra | 462 | $4,313 | $2,156 | 9.58 |
| GPT-6 Astra, max | 695 | $5,973 | $2,987 | 9.61 |
| GPT-6 Luna, medium | 163 | $22 | $11 | 8.11 |
| Claude Haiku 5.5 | ~330 | $36 | $18 | 7.81 |
| GPT-6 Luna, max | 419 | $40 | $20 | 8.41 |
Sol на medium набрал 98% от максимальной оценки за 36% стоимости Opus и 43% стоимости Sol на max. Astra сравнялась с Sol по качеству, но стоит примерно впятеро дороже, потому что её цена за токен в пять раз выше. Opus стоил дороже Sol на max, а набрал ниже. Он уже работал на medium, но его цена за токен вдвое выше, чем у Sol. Luna описала бы всю библиотеку за $11–$20 и всё равно обошла бы Haiku и Sonnet.
Примечание о методике: число токенов GPT измерялось по прогонам, а число токенов Claude оценивалось по журналам прогонов. Часть reasoning-токенов Claude не была видна, поэтому стоимость Claude может быть немного занижена. Ни к одной модели не применялись скидки сверх Batch, например кэширование промптов.
Что я вынес
Я выбрал Opus ещё до слепых оценок, в основном потому, что он уже был моим выбором по умолчанию для кода. Я по-прежнему предпочитаю Claude Opus 5.5 для кода и рабочих процессов, где он, по моему опыту, быстрее и сильнее. Описание реальных фотографий требует другого навыка: читать, что действительно есть в кадре, не додумывая позы и отношения. GPT-6.1 Sol делал это лучше. Если бы я пошёл по привычке и пропустил слепой тест, я заплатил бы больше за худшие подписи.
В следующий раз я начну вслепую и дам оценщикам от разных вендоров все входные данные, которые получали модели описания. Я также продолжу сравнивать по официальным ценам API и не буду считать, что больше усилий — лучше: здесь ultra не превзошёл max.
Даже лучшие модели помечали полезные фотографии к удалению, так что я сам проверю каждую пометку об удалении, прежде чем что-либо удалять.
Ограничения
Это был маленький тест: 50 недавних фотографий из одного города. Я не тестировал старые фотографии, отсканированные документы, другие языки и видео. Модели Claude запускались только с настройками по умолчанию; Opus на более высоком уровне усилий, возможно, набрал бы больше — при большей стоимости. Оценщики — это ИИ-модели, а не люди. Они хорошо согласовались, но не идеально, и выборочная проверка человеком сделала бы результат надёжнее. Модели и цены меняются быстро, и все числа здесь — по состоянию на октябрь 2026 года.
Мой выбор
Для моей библиотеки: GPT-6.1 Sol на уровне medium. Для кода и рабочих процессов я остаюсь с Claude Opus 5.5.