
Tôi đã thử nghiệm mù 10 mô hình AI trên thư viện 142.000 ảnh của mình: GPT-6.1 Sol đánh bại Claude Opus
Tóm tắt
Tôi dùng Claude Opus 5.5 mỗi ngày cho việc lập trình và quy trình làm việc, và với công việc đó tôi thấy nó nhanh hơn và tốt hơn GPT-6. Tôi cho rằng nó cũng sẽ giỏi nhất trong việc mô tả ảnh, nên đã thử nghiệm. Tôi chạy mười cấu hình: Claude Haiku, Sonnet và Opus 5.5, cùng GPT-6.1 Sol, GPT-6 Astra và GPT-6 Luna của OpenAI ở nhiều mức nỗ lực khác nhau. Mỗi cấu hình đặt tiêu đề, viết chú thích, gắn từ khóa và sắp xếp 50 ảnh thật từ thư viện 142.521 ảnh của tôi, đồng thời đánh dấu những ảnh mà nó cho rằng tôi nên xóa. Hai người chấm điểm mù từ hai nhà cung cấp khác nhau, Claude Fable 5.1 và GPT-6 Astra, đã chấm tất cả 500 câu trả lời về tính chính xác, chi tiết bịa đặt, đánh giá xóa, độ phù hợp album và tính hữu ích. GPT-6.1 Sol đạt điểm cao nhất 9,72 trên 10. Opus đạt 8,57, còn Sonnet và Haiku ở mức 7,7 đến 7,8. Mức ultra không tốt hơn max. Theo giá Batch API chính thức, việc viết chú thích cho cả thư viện sẽ tốn khoảng $240 với Sol ở mức medium (9,56), $661 với Opus, và $11 đến $20 với Luna, vốn vẫn vượt điểm Haiku.
Vì sao tôi thử nghiệm điều này
Phần lớn thời gian trong ngày của tôi dành cho lập trình, quy trình làm việc của agent và tự động hóa, và Claude Opus 5.5 là mô hình tôi dùng. Với loại công việc đó, tôi cảm thấy nó nhanh hơn và tốt hơn GPT-6. Vì vậy khi quyết định để AI viết chú thích và gắn thẻ cho thư viện ảnh, tôi chọn Opus ngay lập tức.
Thư viện này là 25 năm cuộc đời tôi: 142.521 ảnh, từ những bức chụp bằng máy ảnh kỹ thuật số thời đầu đến ảnh điện thoại tuần trước, cộng thêm hơn 16.000 ảnh chụp màn hình. Hầu như không bức nào có chú thích. Tôi muốn mỗi bức ảnh có một tiêu đề, một chú thích, những từ khóa tôi có thể tìm kiếm, một album hợp lý, và một đánh dấu trung thực khi nó trùng lặp hoặc rác. Trước khi trả tiền để xử lý 142.000 ảnh, tôi muốn biết mô hình nào làm việc này tốt nhất và sự khác biệt đó tốn bao nhiêu tiền.
Tôi kỳ vọng Opus sẽ thắng. Trên 50 ảnh này, GPT-6.1 Sol đạt điểm cao hơn hơn một điểm.
Kết quả nhìn nhanh
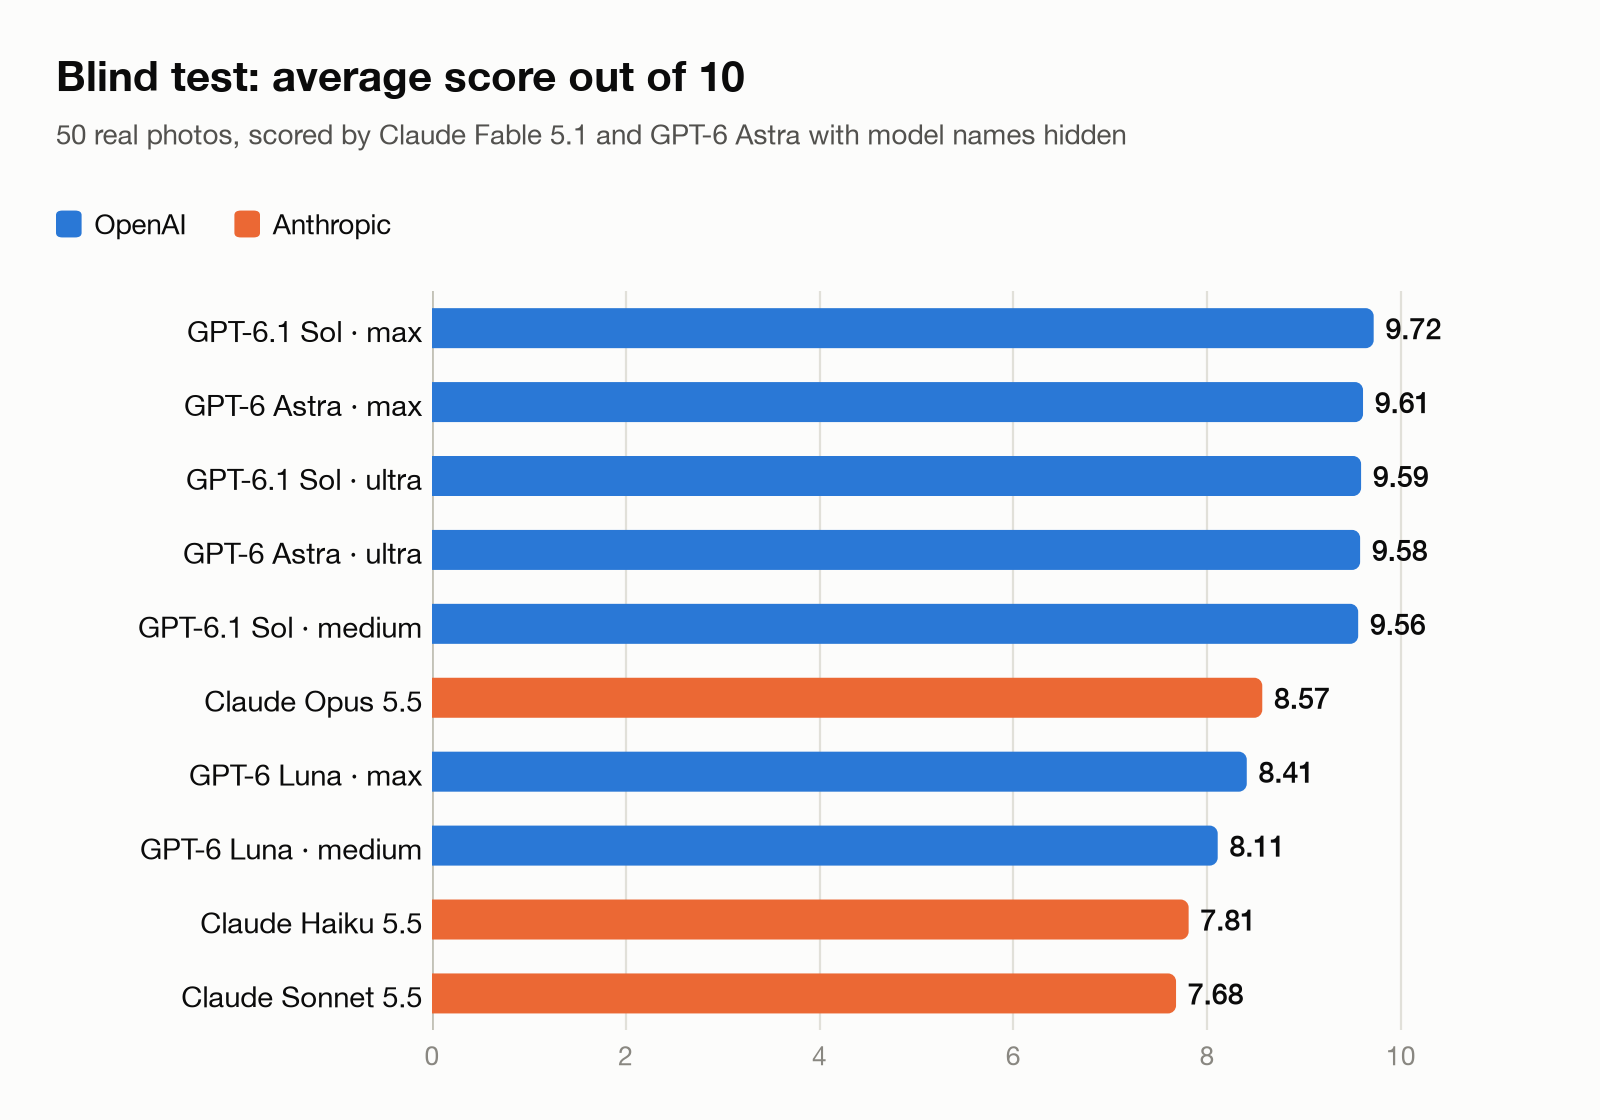 Hình 1. Điểm trung bình từ hai người chấm mù, trên thang 10.
| Hạng | Mô hình và mức nỗ lực | Điểm (trên 10) | Cả thư viện, Batch API | Cả thư viện, API tiêu chuẩn |
|---|---|---|---|---|
| 1 | GPT-6.1 Sol, max | 9,72 | $563 | $1.126 |
| 2 | GPT-6 Astra, max | 9,61 | $2.987 | $5.973 |
| 3 | GPT-6.1 Sol, ultra | 9,59 | $468 | $937 |
| 4 | GPT-6 Astra, ultra | 9,58 | $2.156 | $4.313 |
| 5 | GPT-6.1 Sol, medium | 9,56 | $240 | $479 |
| 6 | Claude Opus 5.5 | 8,57 | $661 | $1.323 |
| 7 | GPT-6 Luna, max | 8,41 | $20 | $40 |
| 8 | GPT-6 Luna, medium | 8,11 | $11 | $22 |
| 9 | Claude Haiku 5.5 | 7,81 | $18 | $36 |
| 10 | Claude Sonnet 5.5 | 7,68 | $334 | $668 |
Chi phí là cho tất cả 142.521 ảnh theo giá API chính thức của từng nhà cung cấp.
Điều tôi sẽ dùng, dựa trên bài thử nghiệm này:
- Nếu chỉ quan tâm đến điểm số, GPT-6.1 Sol ở mức max.
- Cho thư viện của riêng tôi, GPT-6.1 Sol ở mức medium. Nó đạt 98% điểm cao nhất với $240, khoảng một phần ba số tiền mà Opus sẽ tốn.
- Ngân sách eo hẹp, GPT-6 Luna ở mức max. Với $20 nó vượt Haiku, vốn cùng giá mỗi token, và Sonnet, vốn sẽ đắt hơn khoảng 17 lần cho thư viện này.
- Không phải Claude Sonnet 5.5. Giá trung bình mà điểm thấp nhất.
Các mô hình
| Nhà cung cấp | Mô hình | Mức nỗ lực đã thử | Định vị |
|---|---|---|---|
| Anthropic | Claude Opus 5.5 | mặc định (medium) | Đầu bảng, dùng hằng ngày |
| Anthropic | Claude Sonnet 5.5 | mặc định | Tầm trung |
| Anthropic | Claude Haiku 5.5 | mặc định | Nhanh, chi phí thấp |
| OpenAI | GPT-6 Astra | max, ultra | Mô hình tiên phong |
| OpenAI | GPT-6.1 Sol | medium, max, ultra | Cỗ máy chính |
| OpenAI | GPT-6 Luna | medium, max | Nhanh, chi phí thấp |
Giá cả khớp nhau giữa hai nhà cung cấp. GPT-6.1 Sol có giá mỗi token bằng Claude Sonnet 5.5, GPT-6 Astra bằng Claude Fable 5.1, và GPT-6 Luna bằng Claude Haiku 5.5. Claude Opus 5.5 nằm giữa Sol và Astra. Vì vậy khi hai mô hình có chi phí khác nhau dưới đây, phần lớn là do một bên dùng nhiều token hơn cho cùng một việc.
Các mô hình Claude mỗi cái chạy một lần ở cài đặt mặc định, nghĩa là mức medium đối với Opus. Tôi thử các mô hình GPT ở nhiều mức nỗ lực. So sánh tương đương nhất là GPT-6.1 Sol ở medium với Claude Opus 5.5 ở medium: 9,56 so với 8,57.
Cách thử nghiệm
Tôi dùng 50 ảnh gần đây nhất trong thư viện tại thời điểm đó, không tính video. Đó là một tuần bình thường trong cuộn phim của tôi: khoảnh khắc gia đình ở nhà và khi đi mua sắm, cảnh thành phố từ tầng cao, một thẻ nhớ trên bàn, ảnh chụp màn hình trang sản phẩm linh kiện điện tử, ảnh chụp màn hình theo dõi đơn hàng, một bài đăng mạng xã hội, một biển mã QR giảm giá đỗ xe và một nhãn bộ sạc EV.
Mỗi mô hình có năm nhiệm vụ cho mỗi ảnh. Nó viết một tiêu đề ngắn và một chú thích một đến ba câu bằng tiếng Trung, đưa ra 5 đến 12 từ khóa bằng tiếng Trung và tiếng Anh, rồi chọn album tốt nhất từ các album hiện có của tôi, hoặc không chọn. Sau đó nó cho một điểm chất lượng và nói nên giữ hay xóa ảnh, tìm kiếm ảnh trùng lặp, ảnh hỏng, ảnh chụp màn hình hết hạn và ảnh không có giá trị lâu dài. Mọi mô hình nhận cùng hướng dẫn và cùng ngữ cảnh cho mỗi ảnh, mười ảnh một lần.
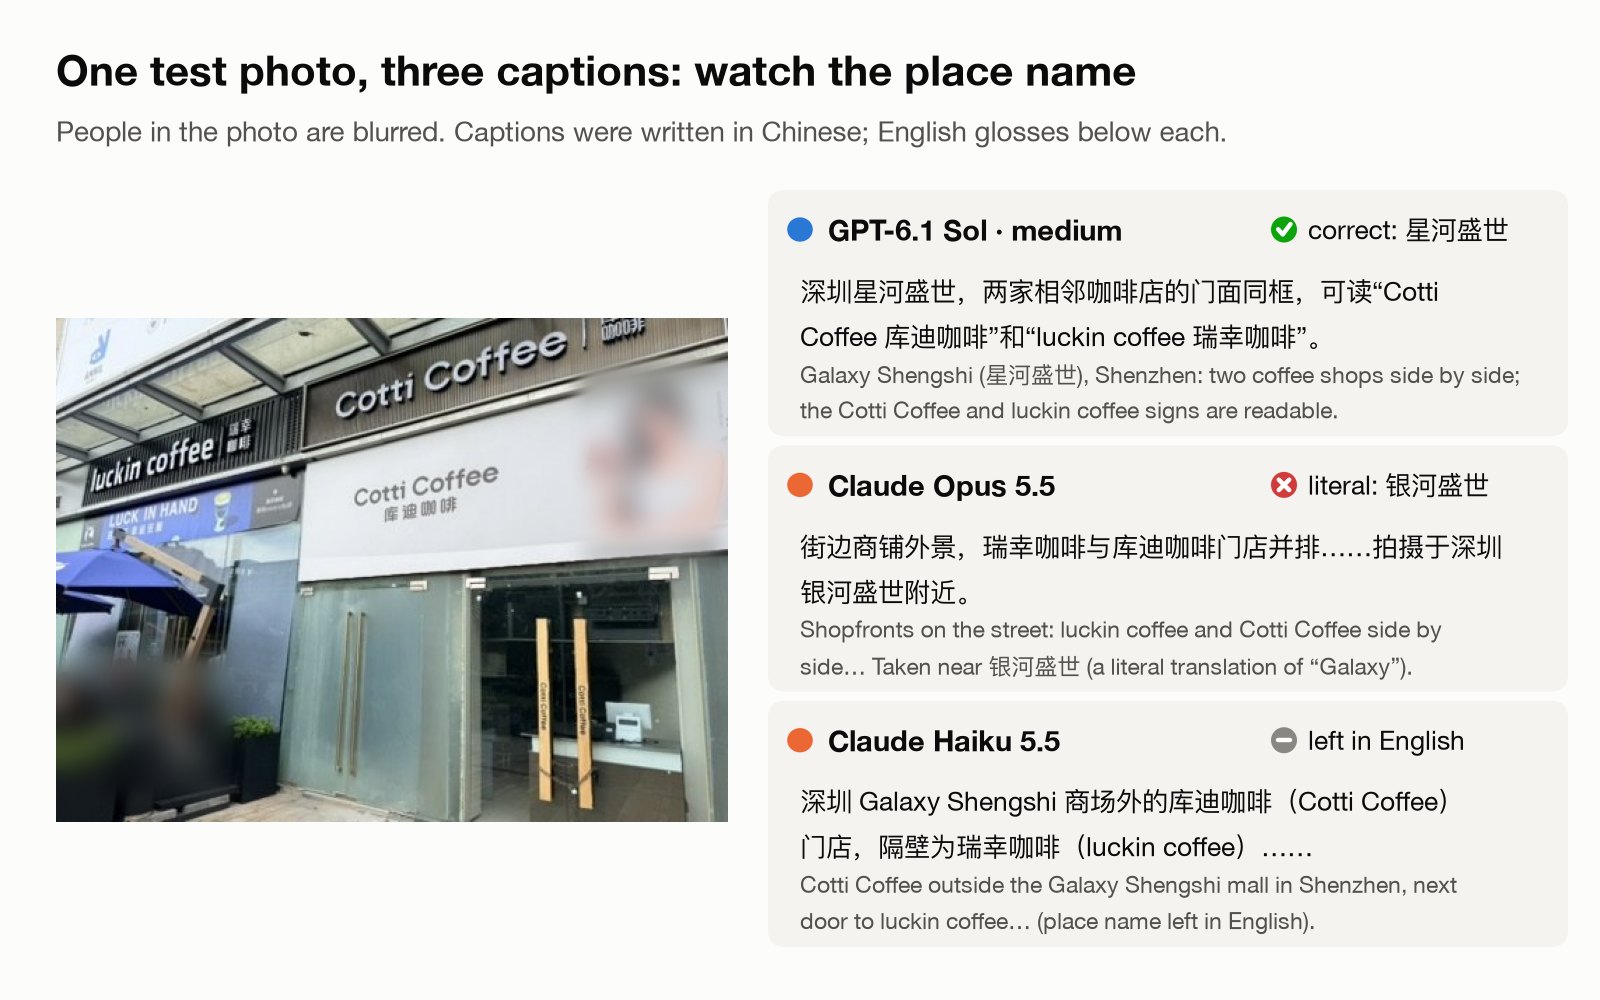 Hình 2. Một trong 50 ảnh thử nghiệm, với ba chú thích. Hãy xem mỗi mô hình xử lý tên địa điểm ra sao; tôi sẽ quay lại vấn đề này bên dưới. Người trong ảnh đã được làm mờ.
Cách tôi chấm điểm
Tôi không tự chấm các câu trả lời. Tôi đã chọn trước người thắng cuộc trước khi thử nghiệm, và tôi dùng Claude mỗi ngày, nên tôi không trung lập.
Thay vào đó, tôi xáo trộn mười câu trả lời của mỗi ảnh và gắn nhãn A đến J, với thứ tự ngẫu nhiên mới cho mỗi ảnh. Hai người chấm sau đó chấm độc lập tất cả 500 câu trả lời trong khi xem các bức ảnh. Một người là Claude Fable 5.1, mô hình mạnh nhất của Anthropic. Người kia là GPT-6 Astra ở mức nỗ lực xhigh, mô hình tiên phong của OpenAI.
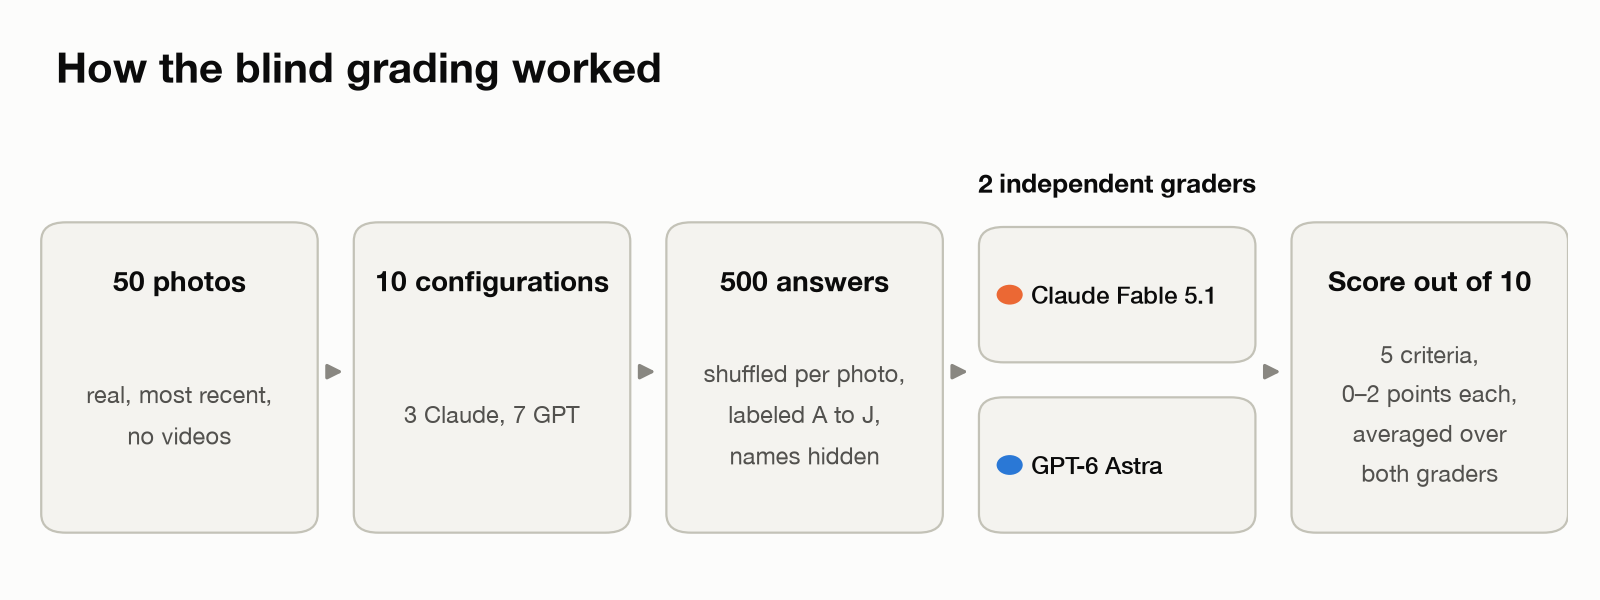 Hình 3. Cách chấm điểm mù hoạt động.
Mỗi câu trả lời được chấm theo năm tiêu chí, mỗi tiêu chí 0 đến 2 điểm, tổng cộng 10:
| Tiêu chí | Điều người chấm kiểm tra |
|---|---|
| Tính chính xác | Chủ thể, địa điểm và mọi chữ đọc được có đúng không, bao gồm tên địa điểm địa phương? |
| Không bịa đặt chi tiết | Câu trả lời có tránh khẳng định điều mà ảnh không thể hiện không? |
| Đánh giá xóa | Việc giữ hay xóa có hợp lý không? Xóa một ảnh tốt bị 0 điểm. |
| Độ phù hợp album | Album có đúng không? Album cũ sai bị 0 điểm; không có album được chấp nhận 1 điểm. |
| Tính hữu ích | Tiêu đề, chú thích và từ khóa có giúp tôi tìm và nhớ lại ảnh này về sau không? |
Tôi chọn một người chấm từ mỗi nhà cung cấp để xem bên nào có thiên vị mô hình của mình không. Họ phần lớn đồng thuận. Hệ số tương quan trên 500 cặp điểm là 0,71, và cả hai đều xếp năm cấu hình GPT giống nhau lên đầu. Người chấm Claude cũng xếp GPT-6.1 Sol và GPT-6 Astra trên Claude Opus. Người chấm GPT nhìn chung nghiêm khắc hơn, và nghiêm khắc nhất với các mô hình Claude.
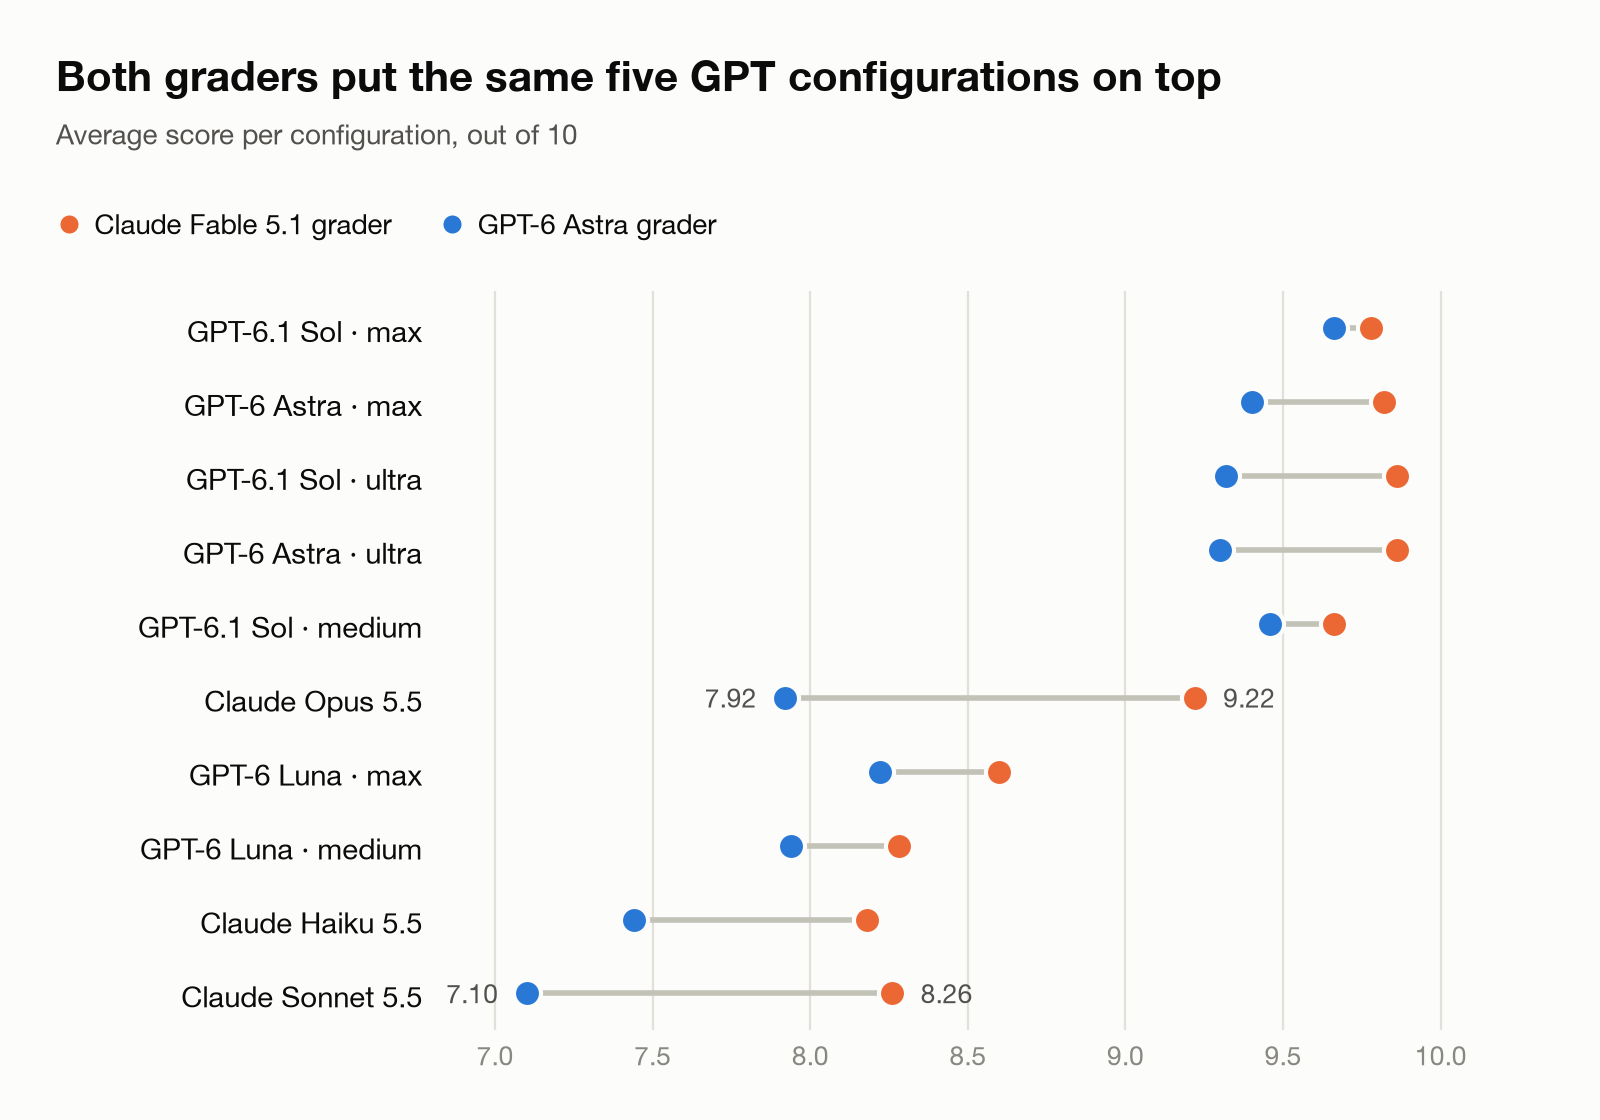 Hình 4. Điểm trung bình của từng người chấm cho mỗi cấu hình.
Kết quả
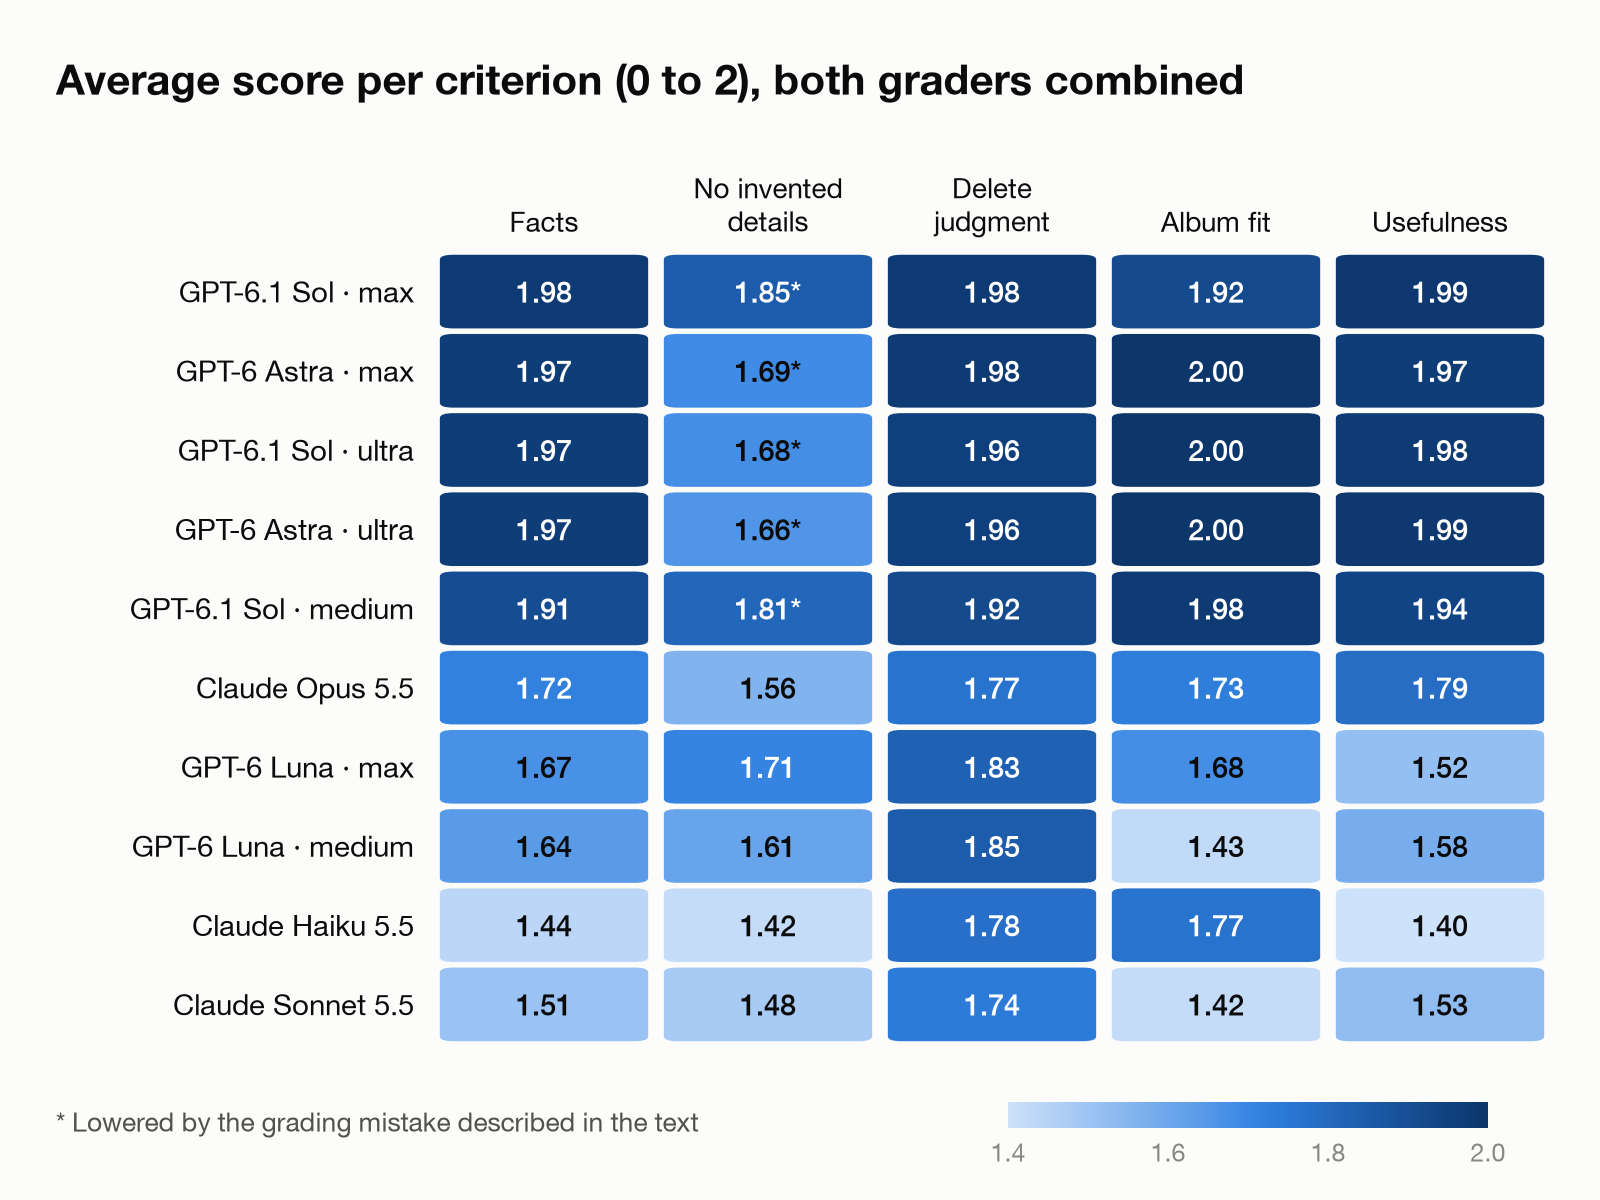 Hình 5. Điểm trung bình theo tiêu chí, gộp cả hai người chấm. Dấu hoa thị đánh dấu những điểm bị hạ do lỗi chấm mà tôi mô tả bên dưới.
GPT-6.1 Sol và GPT-6 Astra
Sol và Astra đọc chữ chính xác và hầu như giới hạn chú thích trong những gì ảnh thể hiện. Chúng cũng giỏi nhất với tên địa điểm địa phương, điều quan trọng với ảnh chụp ở Trung Quốc.
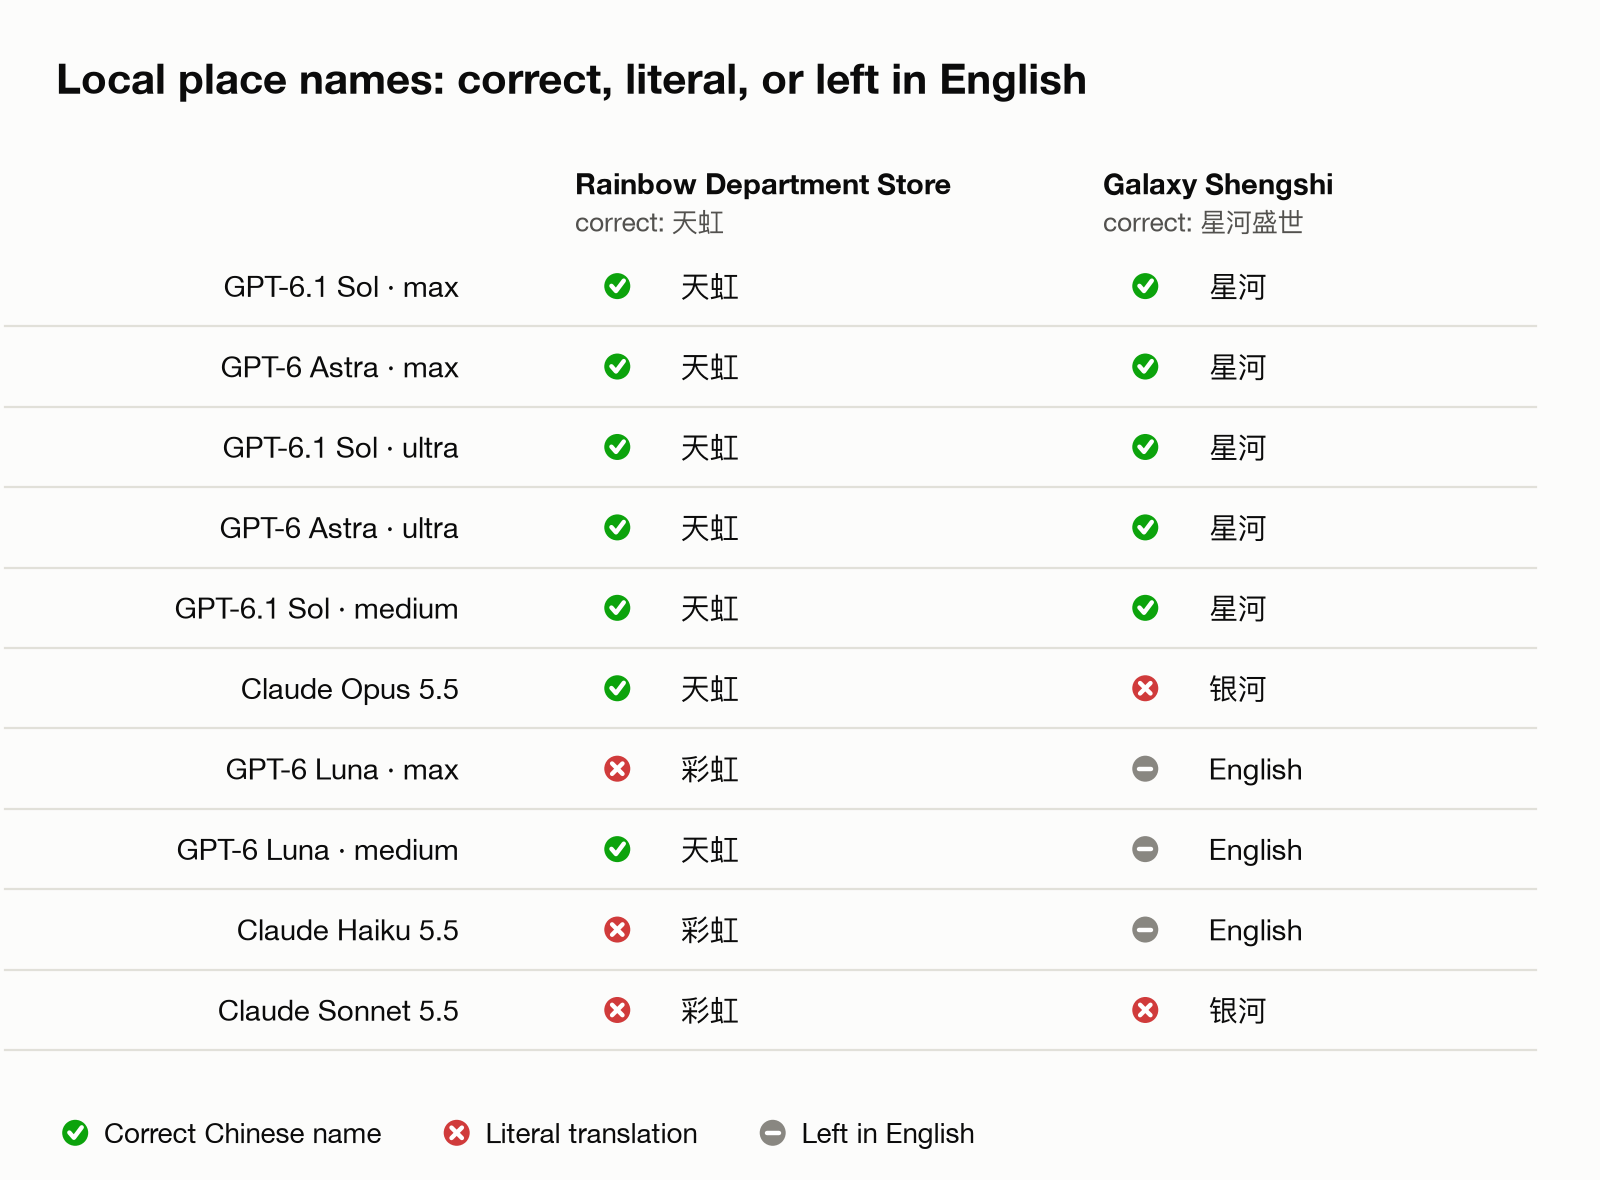 Hình 6. Hai bài kiểm tra tên địa phương. Dấu kiểm nghĩa là tên tiếng Trung đúng, dấu chéo là bản dịch sát nghĩa, và EN nghĩa là tên được giữ nguyên tiếng Anh.
Một số ảnh được gắn thẻ địa điểm "Rainbow Department Store". Đó là tên tiếng Anh của chuỗi trung tâm thương mại Thâm Quyến 天虹. Dịch từng chữ sẽ ra 彩虹百貨, là sai. Mọi cấu hình Sol và Astra đều đúng, và Opus với Luna ở medium cũng vậy. Haiku, Sonnet và Luna ở max dùng bản dịch sát nghĩa. Ảnh quán cà phê trong Hình 2 được gắn thẻ "Galaxy Shengshi", tên tiếng Trung là 星河盛世. Mọi cấu hình Sol và Astra đều viết 星河. Opus và Sonnet dịch sát nghĩa thành 銀河, còn Haiku và hai cấu hình Luna giữ nguyên tiếng Anh.
Sol và Astra cũng cẩn thận trong việc xóa. Chúng đề xuất xóa 4 đến 6 trong 50 ảnh. Bộ ảnh gồm tám ảnh chụp màn hình trang sản phẩm linh kiện điện tử, và các mô hình GPT giữ gần như tất cả; một cấu hình Sol đánh dấu một ảnh chụp màn hình duy nhất là gần trùng lặp. Các mô hình Claude đánh dấu hai đến bốn ảnh mỗi cái. Cả hai người chấm đều nghiêng về việc giữ chúng, vì các trang đó chứa sơ đồ chân, kích thước và ảnh bo mạch mà tôi sẽ tra cứu sau này.
Claude Opus 5.5
Opus đôi khi viết vào chú thích những điều mà chỉ riêng bức ảnh không thể hiện. Nó mô tả những mối quan hệ mà riêng hình ảnh không thể chứng minh, như anh chị em hay cha mẹ và con cái. Nó cũng đoán sai vài tư thế. Trong một ảnh, một đứa trẻ đứng sau người lớn, nhưng Opus viết rằng đứa trẻ cưỡi trên lưng người lớn. Cả hai người chấm đều trừ điểm vì điều này.
Điều này khiến tôi ngạc nhiên. Trước bài thử nghiệm mù, tôi đã xem qua các câu trả lời và khen Opus đoán đúng rằng hai đứa trẻ là anh em. Tôi biết gia đình mình; người chấm thì không. Nhưng với 142.000 ảnh, tôi không thể tự kiểm tra từng chú thích, và một chú thích nêu điều mà ảnh không thể hiện chính là vấn đề.
Opus cũng đề xuất xóa nhiều nhất, 13 trong 50 ảnh. Ba trong số đó là ảnh chụp màn hình trang sản phẩm mà nó gọi là hết hạn, dù chúng chứa thông tin tham khảo mà tôi muốn giữ. Nó là mô hình duy nhất muốn xóa biển mã QR giảm giá đỗ xe vì cho là ít giá trị. Nó cũng đưa vài ảnh chụp một người vào album "chân dung gia đình".
Claude Sonnet 5.5 và Haiku 5.5
Hai mô hình này mắc nhiều lỗi thực tế nhất, kể cả bản dịch sát nghĩa 彩虹. Sonnet chọn album kém nhất và đưa những ảnh đời thường vào một album cũ từ một sự kiện không liên quan. Haiku bịa ra một chi tiết dẫn đến quyết định xóa sai. Trong một loạt ảnh chụp liên tiếp gần như giống hệt, nó mô tả khung hình tốt nhất là có người đang nhìn xuống, ngược với những gì ảnh thể hiện, và đề xuất xóa nó.
GPT-6 Luna
Luna có giá mỗi token bằng Haiku nhưng đạt điểm cao hơn ở cả hai mức nỗ lực: 8,41 và 8,11, so với 7,81 của Haiku. Ở mức max nó cũng vượt Sonnet, vốn sẽ đắt hơn khoảng 17 lần để viết chú thích cho cùng thư viện. Luna mất điểm chủ yếu ở tính hữu ích và chọn album. Chú thích của nó mộc mạc hơn và album kém chính xác hơn.
Các mức nỗ lực
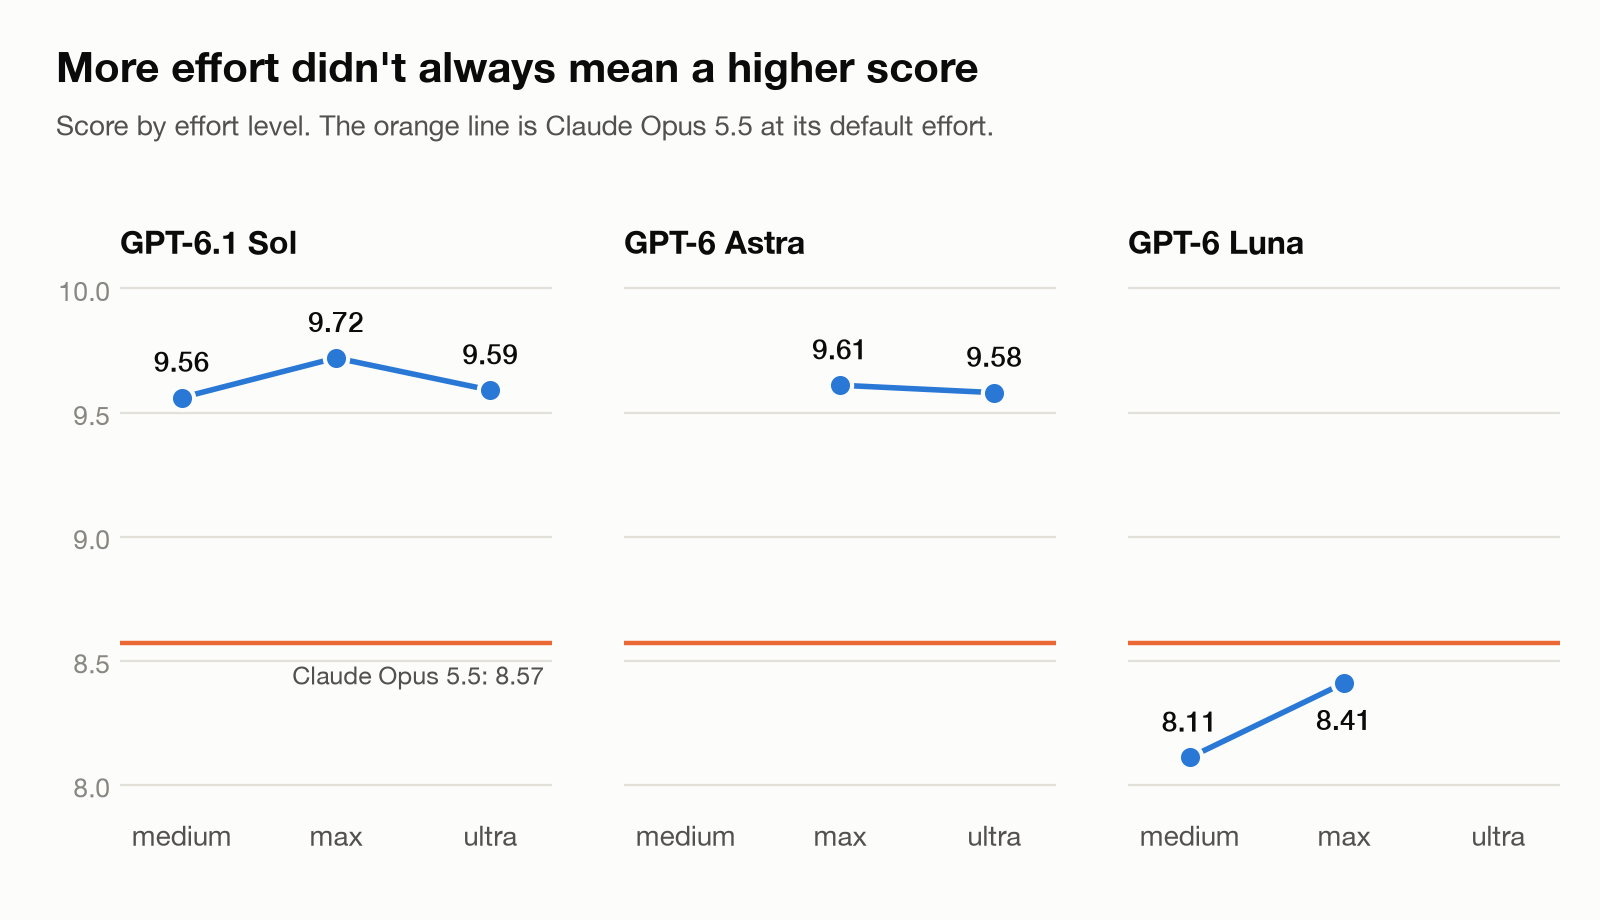 Hình 7. Điểm theo mức nỗ lực. Đường màu cam là Claude Opus 5.5 ở mức nỗ lực mặc định.
Ultra không tốt hơn max với cả hai mô hình. Sol đạt 9,59 ở ultra và 9,72 ở max; Astra đạt 9,58 và 9,61. Trong thử nghiệm này, ultra thậm chí tạo ra ít token đầu ra hơn max. Với Sol, medium đến gần ở mức 9,56, với chi phí chưa đến một nửa max. Nỗ lực cao hơn không phải lúc nào cũng đồng nghĩa chi tiết chính xác hơn: Luna ở medium ghi đúng 天虹, còn Luna ở max thì không.
Một lỗi trong cách chấm của tôi
Sau khi chấm xong, tôi nhận ra người chấm không được cung cấp ngày và giờ chụp của mỗi ảnh, dù các mô hình viết chú thích thì có. Vì vậy người chấm GPT-6 Astra coi những chú thích nhắc đến ngày giờ chính xác là chi tiết bịa đặt. Các cấu hình GPT hàng đầu nhắc đến ngày thường xuyên nhất, nên điểm "Không bịa đặt chi tiết" của chúng thấp hơn mức đáng lẽ phải có.
Nếu tôi chỉ trả lại số điểm bị mất vì ngày tháng, bốn cấu hình GPT hàng đầu sẽ tăng lên khoảng 9,84 đến 9,90, tức gần như hòa nhau, còn Opus vẫn ở mức 8,58. Tôi giữ nguyên điểm gốc trong bài này. Lần tới tôi sẽ cung cấp cho người chấm mọi thứ mà các mô hình đã thấy.
Tốc độ
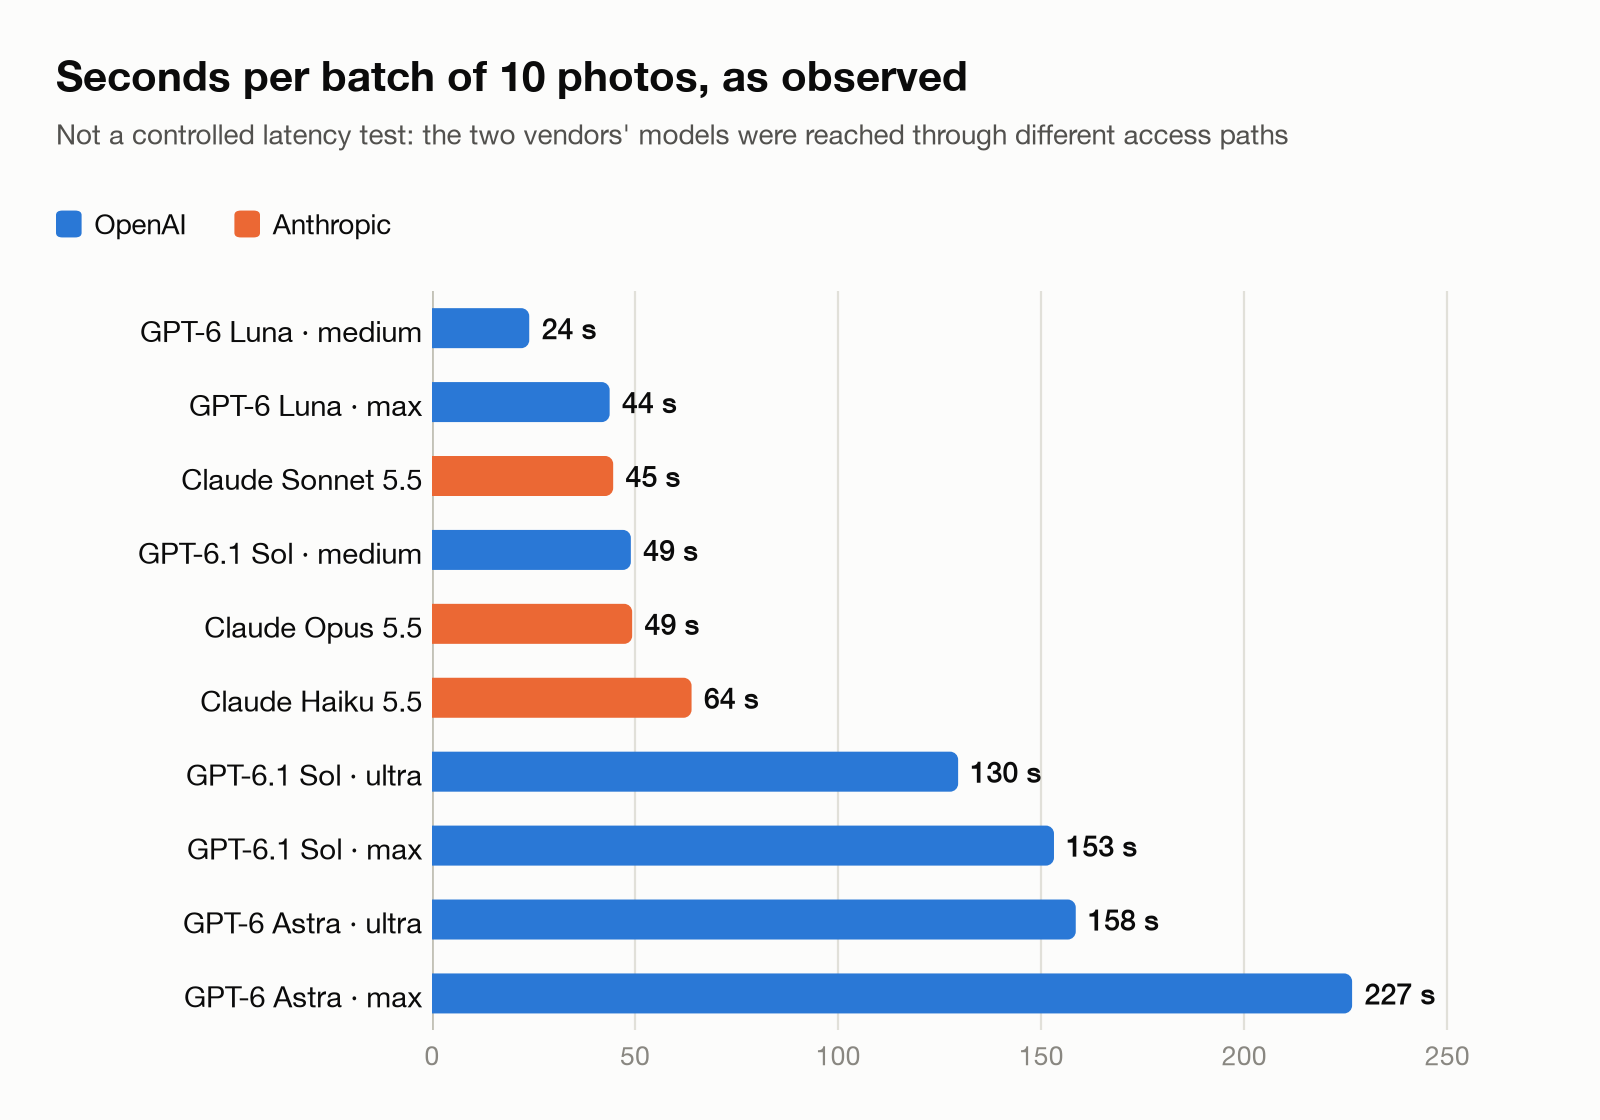 Hình 8. Số giây mỗi lô 10 ảnh, theo quan sát. Đây không phải bài kiểm tra độ trễ có kiểm soát, vì các mô hình của hai nhà cung cấp được gọi qua các đường truy cập khác nhau.
Điều này khớp với cảm nhận của tôi về Opus trong công việc hằng ngày: nó nhanh, nhanh gấp khoảng ba lần Sol ở max. Nhưng Sol ở medium nhanh ngang Opus và đạt điểm cao hơn khoảng một điểm.
Chi phí
Tôi định giá mọi cấu hình theo giá API chính thức của các nhà cung cấp. Coi mức sử dụng đi kèm gói đăng ký là miễn phí sẽ khiến một số mô hình trông tốt hơn thực tế.
Giá chính thức mỗi triệu token, bậc tiêu chuẩn:
| Mô hình | Đầu vào | Đầu ra |
|---|---|---|
| Claude Opus 5.5 | $4.00 | $20.00 |
| Claude Sonnet 5.5 | $2.00 | $10.00 |
| Claude Haiku 5.5 | $0.10 | $0.50 |
| GPT-6 Astra | $10.00 | $50.00 |
| GPT-6.1 Sol | $2.00 | $10.00 |
| GPT-6 Luna | $0.10 | $0.50 |
Batch API của cả hai nhà cung cấp rẻ hơn 50%, phù hợp với loại việc không cần câu trả lời tức thì. Tôi lấy giá từ trang định giá của Anthropic (claude.com/pricing) và trang định giá API của OpenAI (developers.openai.com/api/docs/pricing) vào ngày 20 tháng 10 năm 2026.
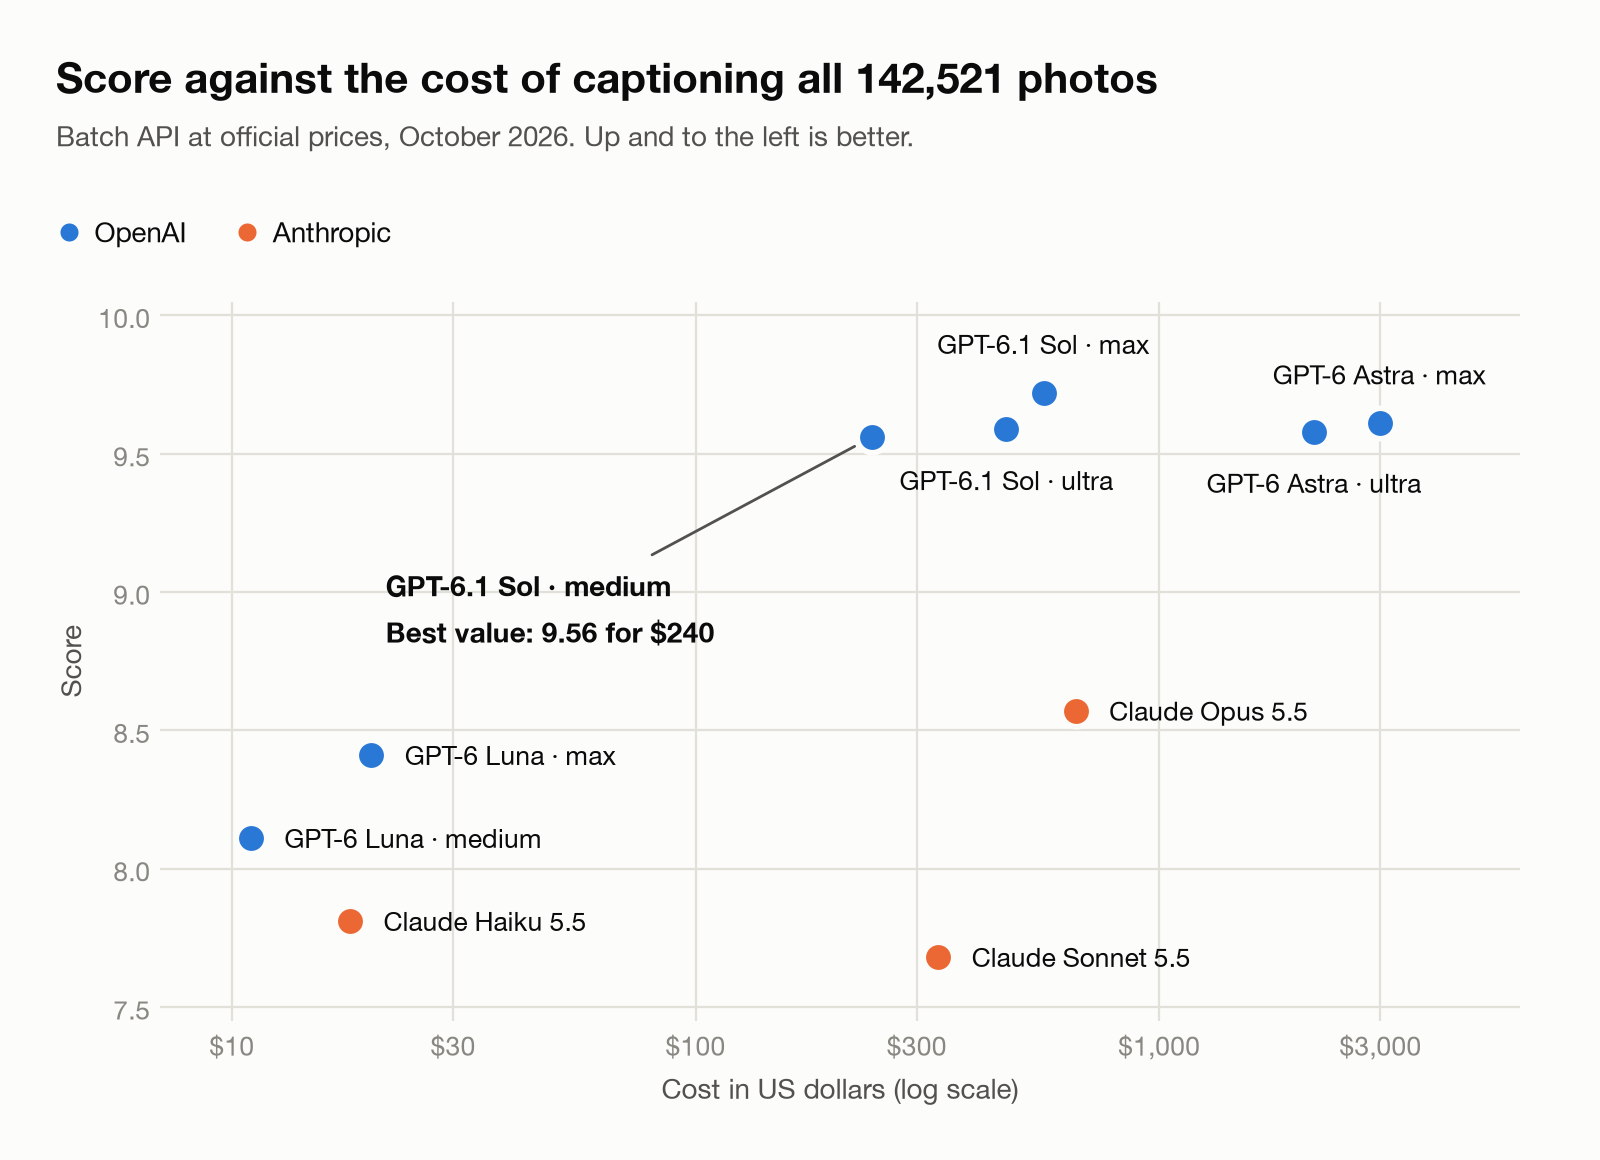 Hình 9. Điểm so với chi phí viết chú thích cả thư viện theo giá Batch. Trục chi phí là logarit.
| Mô hình và mức nỗ lực | Token đầu ra mỗi ảnh | Tiêu chuẩn | Batch | Điểm |
|---|---|---|---|---|
| GPT-6.1 Sol, medium | 193 | $479 | $240 | 9,56 |
| GPT-6.1 Sol, ultra | 514 | $937 | $468 | 9,59 |
| GPT-6.1 Sol, max | 647 | $1.126 | $563 | 9,72 |
| Claude Opus 5.5 | ~292 | $1.323 | $661 | 8,57 |
| Claude Sonnet 5.5 | ~297 | $668 | $334 | 7,68 |
| GPT-6 Astra, ultra | 462 | $4.313 | $2.156 | 9,58 |
| GPT-6 Astra, max | 695 | $5.973 | $2.987 | 9,61 |
| GPT-6 Luna, medium | 163 | $22 | $11 | 8,11 |
| Claude Haiku 5.5 | ~330 | $36 | $18 | 7,81 |
| GPT-6 Luna, max | 419 | $40 | $20 | 8,41 |
Sol ở medium đạt 98% điểm cao nhất với 36% chi phí của Opus và 43% của Sol ở max. Astra có chất lượng tương đương Sol nhưng đắt gấp khoảng năm lần, vì giá mỗi token của nó cao gấp năm lần. Opus đắt hơn Sol ở max và điểm thấp hơn. Nó đã chạy ở mức medium rồi, nhưng giá mỗi token gấp đôi Sol. Luna sẽ viết chú thích cả thư viện với $11 đến $20 mà vẫn vượt điểm Haiku và Sonnet.
Ghi chú phương pháp: số token của GPT được đo từ các lần chạy, còn số token của Claude được ước tính từ nhật ký chạy. Một số token suy luận của Claude không nhìn thấy được, nên chi phí Claude có thể bị đánh giá hơi thấp. Không áp dụng chiết khấu nào ngoài Batch, như lưu đệm prompt, cho bất kỳ mô hình nào.
Điều tôi học được
Tôi chọn Opus trước khi có bất kỳ điểm mù nào, phần lớn vì nó đã là mặc định cho việc lập trình của tôi. Tôi vẫn thích Claude Opus 5.5 cho việc lập trình và quy trình làm việc, nơi theo kinh nghiệm của tôi nó nhanh hơn và mạnh hơn. Mô tả ảnh thật đòi hỏi một kỹ năng khác: đọc những gì thực sự có trong khung hình mà không tự bịa thêm tư thế hay mối quan hệ. GPT-6.1 Sol làm điều đó tốt hơn. Nếu tôi theo thói quen mà bỏ qua bài thử nghiệm mù, tôi đã trả nhiều tiền hơn cho những chú thích tệ hơn.
Lần tới tôi sẽ bắt đầu một cách mù quáng và cung cấp cho người chấm từ các nhà cung cấp khác nhau mọi đầu vào mà các mô hình viết chú thích nhận được. Tôi cũng sẽ tiếp tục so sánh theo giá API chính thức, và không cho rằng nỗ lực cao hơn là tốt hơn: ultra không thắng max ở đây.
Ngay cả những mô hình tốt nhất cũng đánh dấu ảnh hữu ích là nên xóa, nên tôi sẽ tự kiểm tra từng lệnh xóa trước khi xóa bất cứ thứ gì.
Hạn chế
Đây là một thử nghiệm nhỏ: 50 ảnh gần đây từ một thành phố. Tôi không thử ảnh cũ, tài liệu đã quét, ngôn ngữ khác hay video. Các mô hình Claude chỉ chạy ở cài đặt mặc định; một Opus nỗ lực cao hơn có thể đạt điểm tốt hơn, với chi phí cao hơn. Người chấm là các mô hình AI, không phải con người. Chúng đồng thuận tốt nhưng không hoàn hảo, và một đợt kiểm tra chọn mẫu bằng con người sẽ làm kết quả mạnh hơn. Mô hình và giá cả thay đổi nhanh, và mọi con số ở đây tính đến tháng 10 năm 2026.
Lựa chọn của tôi
Cho thư viện của tôi: GPT-6.1 Sol ở mức medium. Cho lập trình và quy trình làm việc, tôi vẫn dùng Claude Opus 5.5.