我用 10 个 AI 模型盲测了自己 14 万张照片的图库:GPT-6.1 Sol 胜过 Claude Opus
摘要
我每天用 Claude Opus 5.5 写代码、跑工作流,这类活儿上我一直觉得它比 GPT-6 快,也更好用。我以为描述照片它也会最强,就专门测了一下。参加测试的有 10 种配置:Claude Haiku、Sonnet、Opus 5.5,以及 OpenAI 的 GPT-6.1 Sol、GPT-6 Astra、GPT-6 Luna 的几个推理强度档位。每个配置都要给我图库(共 142,521 张)里的 50 张真实照片写标题、写描述、打关键词、选相册,再挑出该删的照片。我从两家厂商各选了一个模型做盲评,Claude Fable 5.1 和 GPT-6 Astra,从事实、有无编造、删除判断、相册是否合适、是否实用五个方面,给全部 500 份答案打分。GPT-6.1 Sol 最高,9.72 分(满分 10 分);Opus 8.57 分;Sonnet 和 Haiku 在 7.7 到 7.8 分之间。ultra 档并不比 max 档好。按官方 Batch API 价格,给整个图库写描述,medium 档的 Sol 大约 $240(9.56 分),Opus 要 $661,Luna 只要 $11 到 $20,分数还比 Haiku 高。
为什么要测
我每天大部分时间在写代码、跑 agent 工作流、做自动化,用得最多的就是 Claude Opus 5.5。这类工作上,我的感受一直是它比 GPT-6 快,也更好。所以想让 AI 给照片写描述、打标签时,我想都没想就选了 Opus。
这个图库是我 25 年的生活:142,521 张照片,从早年的数码相机到上周的手机照片,光截图就有一万六千多张,几乎都没写过描述。我希望每张照片都有标题、描述和搜得到的关键词,放进合适的相册;如果是重复或没用的照片,也要老实标出来。真要为 14 万张照片花钱之前,我想先搞清楚哪个模型做得最好,差别又值多少钱。
我原本以为 Opus 会赢。结果在这 50 张照片上,GPT-6.1 Sol 高出了一分多。
结果一览
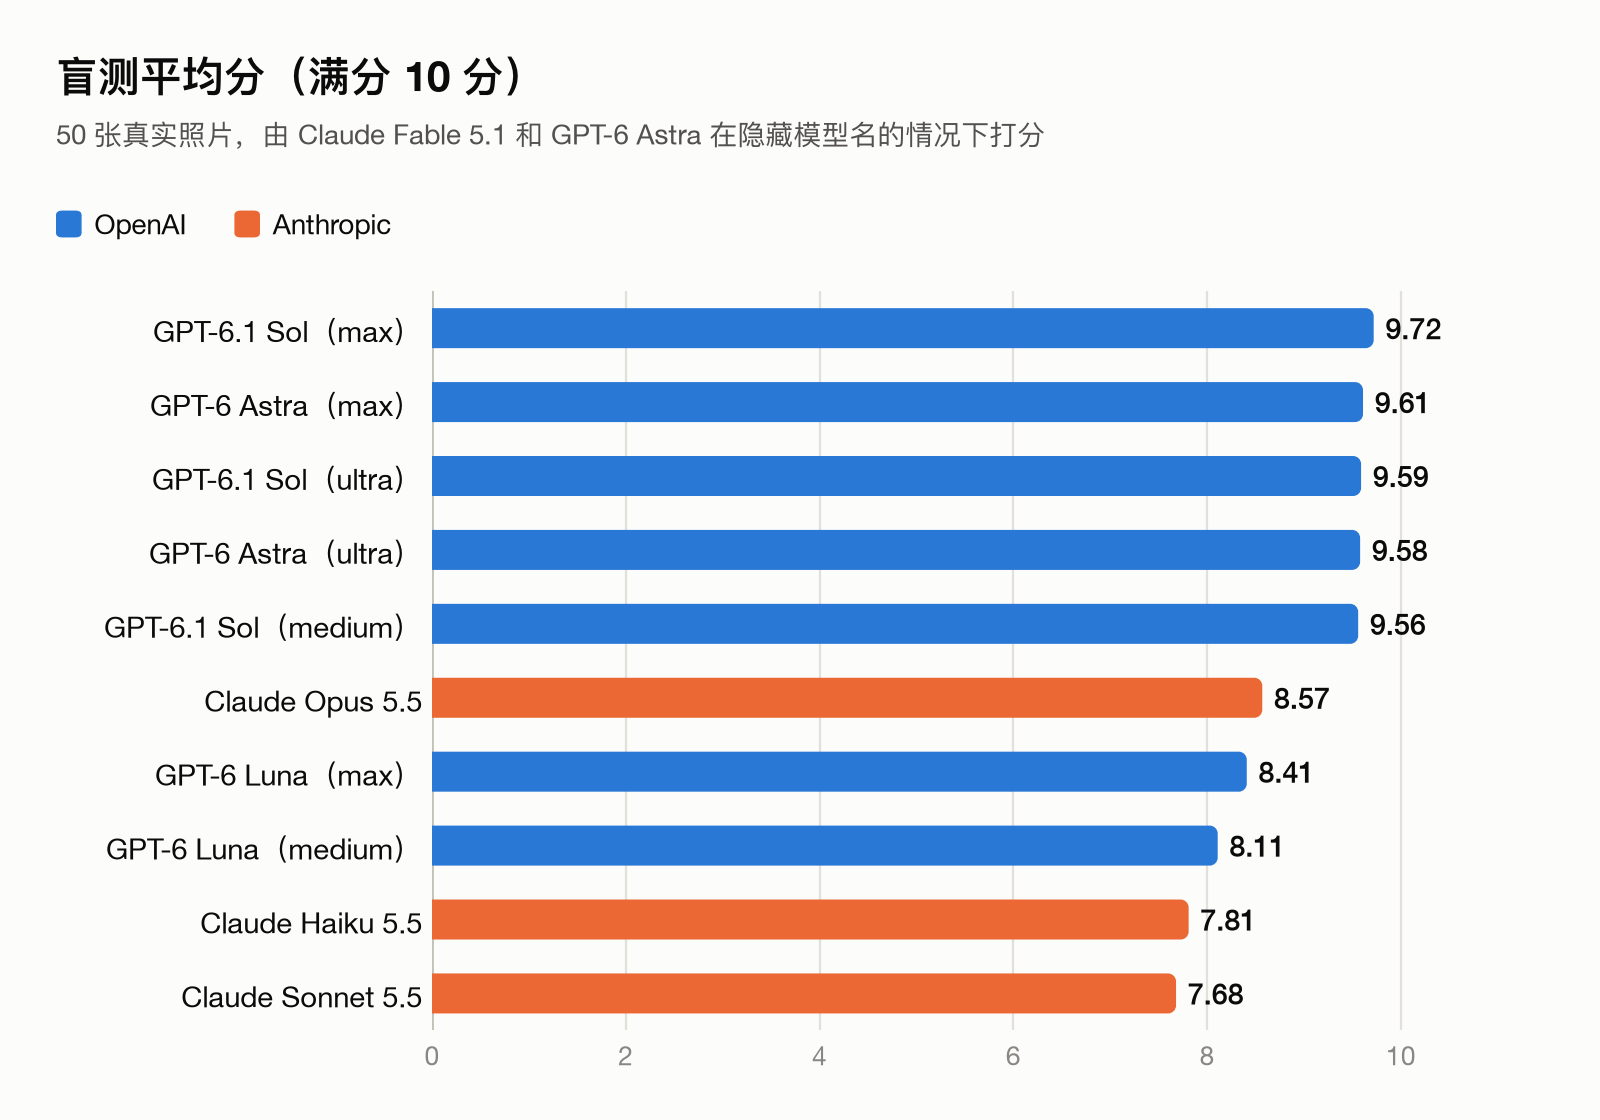 图 1:两位盲评的平均分,满分 10 分。
| 名次 | 模型与推理强度 | 得分(满分 10) | 全库成本(Batch API) | 全库成本(标准 API) |
|---|---|---|---|---|
| 1 | GPT-6.1 Sol,max | 9.72 | $563 | $1,126 |
| 2 | GPT-6 Astra,max | 9.61 | $2,987 | $5,973 |
| 3 | GPT-6.1 Sol,ultra | 9.59 | $468 | $937 |
| 4 | GPT-6 Astra,ultra | 9.58 | $2,156 | $4,313 |
| 5 | GPT-6.1 Sol,medium | 9.56 | $240 | $479 |
| 6 | Claude Opus 5.5 | 8.57 | $661 | $1,323 |
| 7 | GPT-6 Luna,max | 8.41 | $20 | $40 |
| 8 | GPT-6 Luna,medium | 8.11 | $11 | $22 |
| 9 | Claude Haiku 5.5 | 7.81 | $18 | $36 |
| 10 | Claude Sonnet 5.5 | 7.68 | $334 | $668 |
成本按各厂商官方 API 价格,给全部 142,521 张照片写描述计算。
按这次的结果,我会这样选:
- 只看分数,选 GPT-6.1 Sol 的 max 档。
- 我自己的图库,选 GPT-6.1 Sol 的 medium 档。拿到最高分的 98%,只要 $240,大约是 Opus 的三分之一。
- 预算很紧,选 GPT-6 Luna 的 max 档。只要 $20,分数比同价位的 Haiku 高,也比成本贵约 17 倍的 Sonnet 高。
- 不选 Claude Sonnet 5.5:价格中等,分数最低。
参加测试的模型
| 厂商 | 模型 | 测试的推理强度 | 定位 |
|---|---|---|---|
| Anthropic | Claude Opus 5.5 | 默认(medium) | 旗舰、日常主力 |
| Anthropic | Claude Sonnet 5.5 | 默认 | 中端 |
| Anthropic | Claude Haiku 5.5 | 默认 | 快速、低成本 |
| OpenAI | GPT-6 Astra | max、ultra | 前沿旗舰 |
| OpenAI | GPT-6.1 Sol | medium、max、ultra | 主力 |
| OpenAI | GPT-6 Luna | medium、max | 快速、低成本 |
两家的价格档位正好对得上:GPT-6.1 Sol 和 Claude Sonnet 5.5 单价相同,GPT-6 Astra 和 Claude Fable 5.1 相同,GPT-6 Luna 和 Claude Haiku 5.5 相同,Claude Opus 5.5 在 Sol 和 Astra 之间。所以单价相同的模型,处理同一批照片时,谁用的 token 多,谁就更贵。
Claude 模型各按默认设置跑了一次,Opus 默认是 medium 档;GPT 模型我测了好几个档位。两边都用 medium 档时,GPT-6.1 Sol 得 9.56 分,Claude Opus 5.5 得 8.57 分,这样比较最公平。
怎么测的
我用的是当时图库里最新的 50 张照片,不含视频,就是普通一周的手机相册:家里和出去逛街时的家庭照、高楼窗外的城市景色、桌上的一张存储卡、电子元件的商品详情页截图、订单物流截图、一条社交媒体帖子、一个停车优惠二维码立牌,还有一个充电桩标签。
每张照片,每个模型都要做五件事:写一个短标题;写一到三句中文描述;给 5 到 12 个中英双语关键词;从我已有的相册里选一个最合适的,或者不选;打一个质量分,并说明该留还是该删,重点看重复、拍废、过期截图和没有保存价值的照片。所有模型拿到的指令和每张照片的上下文都一样,每次处理 10 张。
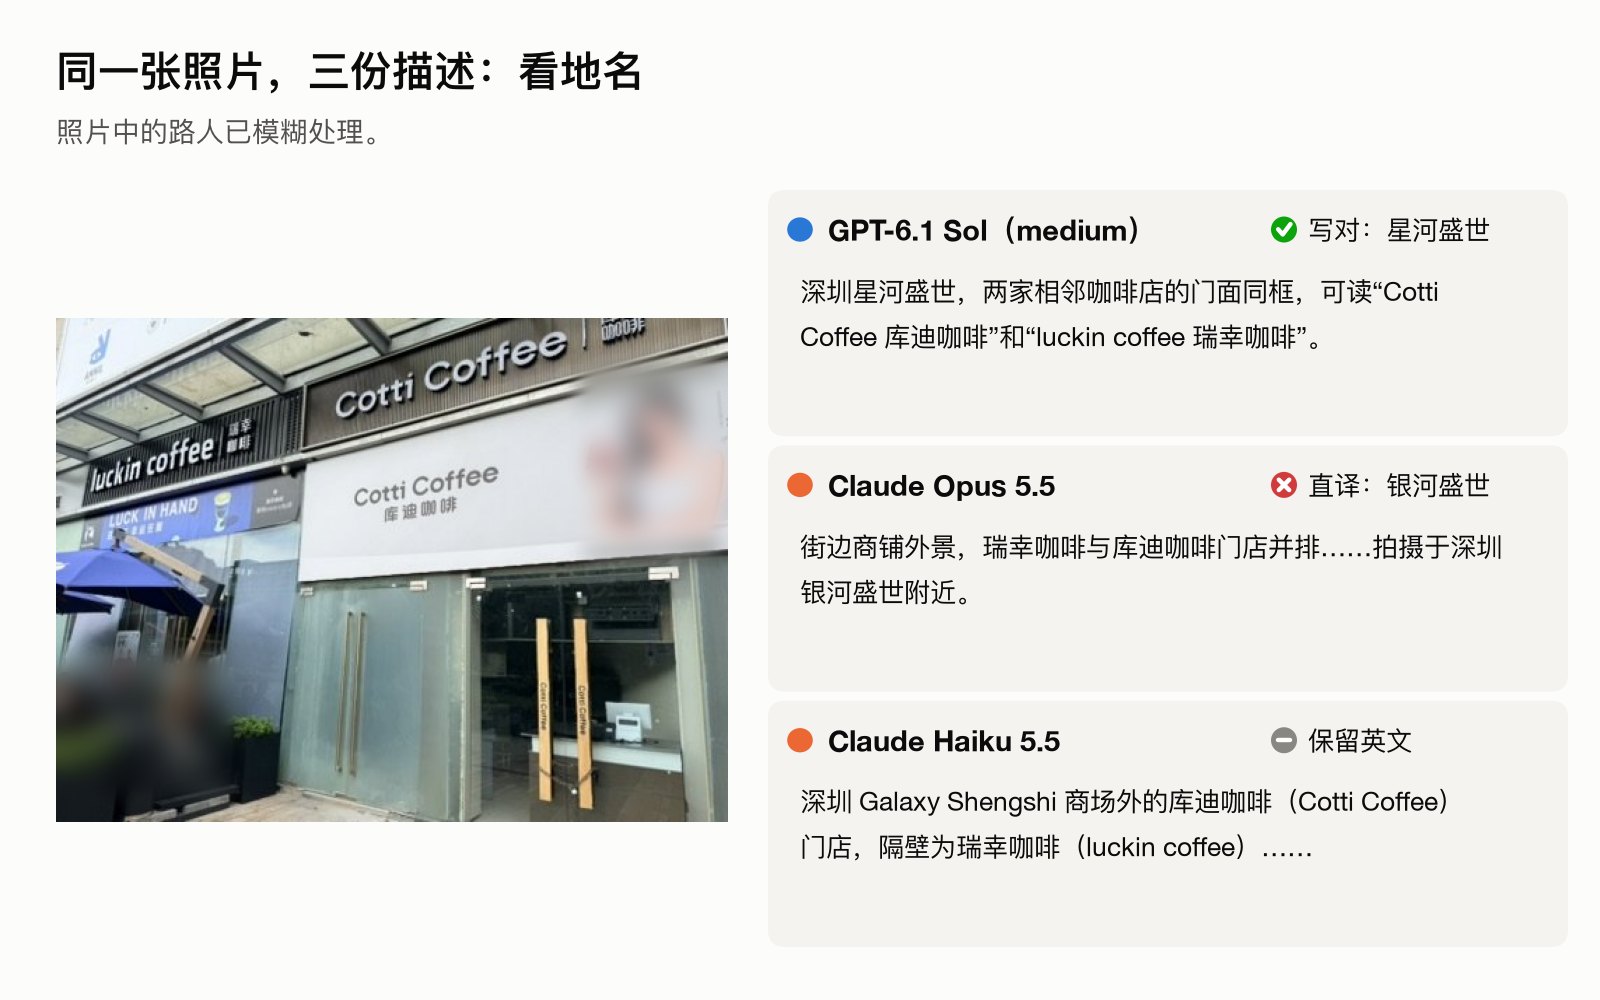 图 2:50 张测试照片中的一张,以及其中三个模型写的描述。注意它们怎么处理地名,后面会再讲到。照片中的路人已模糊处理。
怎么评分
我没有自己打分。我天天用 Claude,测试前就认定 Opus 会赢,自己打分难免偏心。
我把每张照片的 10 份答案打乱,标成 A 到 J,每张照片重新随机一次。两位评审对着照片,各自独立给 500 份答案打分:一位是 Anthropic 能力最强的 Claude Fable 5.1,另一位是 OpenAI 的前沿模型 GPT-6 Astra(xhigh 档)。
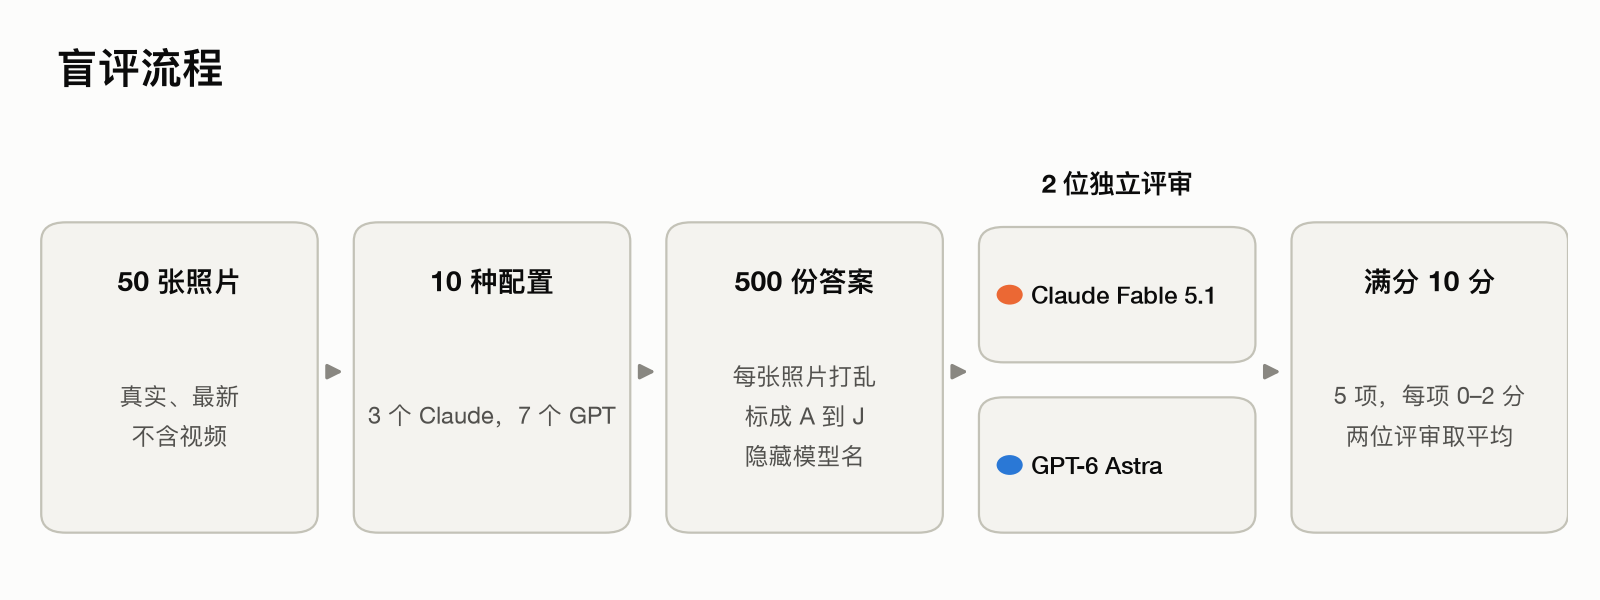 图 3:盲评流程。
每份答案按五项打分,每项 0 到 2 分,满分 10 分:
| 评分项 | 评审看什么 |
|---|---|
| 事实 | 主体、地点和画面里能读到的文字对不对,本地地名有没有写对? |
| 无编造 | 有没有写出照片里看不出来的东西? |
| 删除判断 | 该留还是该删,判断是否合理?误删好照片得 0 分。 |
| 相册 | 相册选得对不对?放进不相关的旧相册得 0 分,不选得 1 分。 |
| 实用 | 标题、描述和关键词,能不能帮我以后找到、想起这张照片? |
两家各请一位评审,是想看看有没有谁偏袒自家模型。两位评审的结论很接近:500 组配对分数的相关系数是 0.71,排在前五的都是同样五个 GPT 配置。Claude 评审也把 GPT-6.1 Sol 和 GPT-6 Astra 排在 Claude Opus 前面。GPT 评审整体打分更严,给 Claude 模型的分扣得最多。
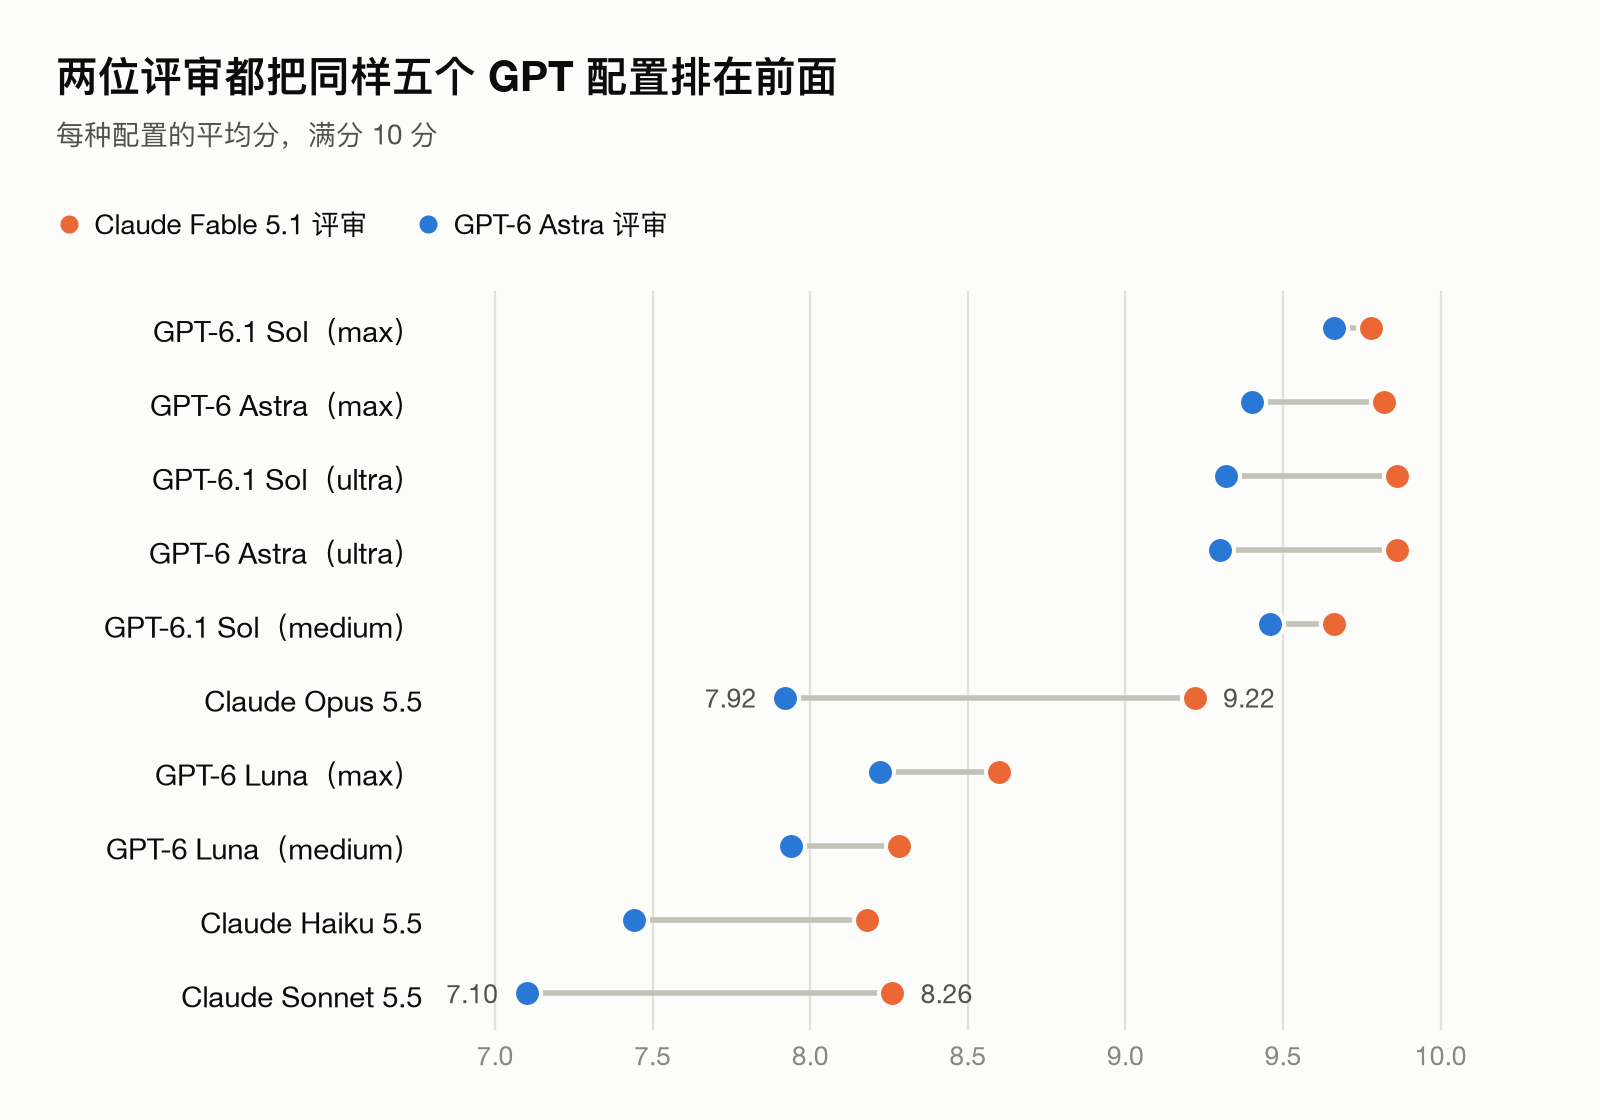 图 4:每位评审给各配置的平均分。
测试结果
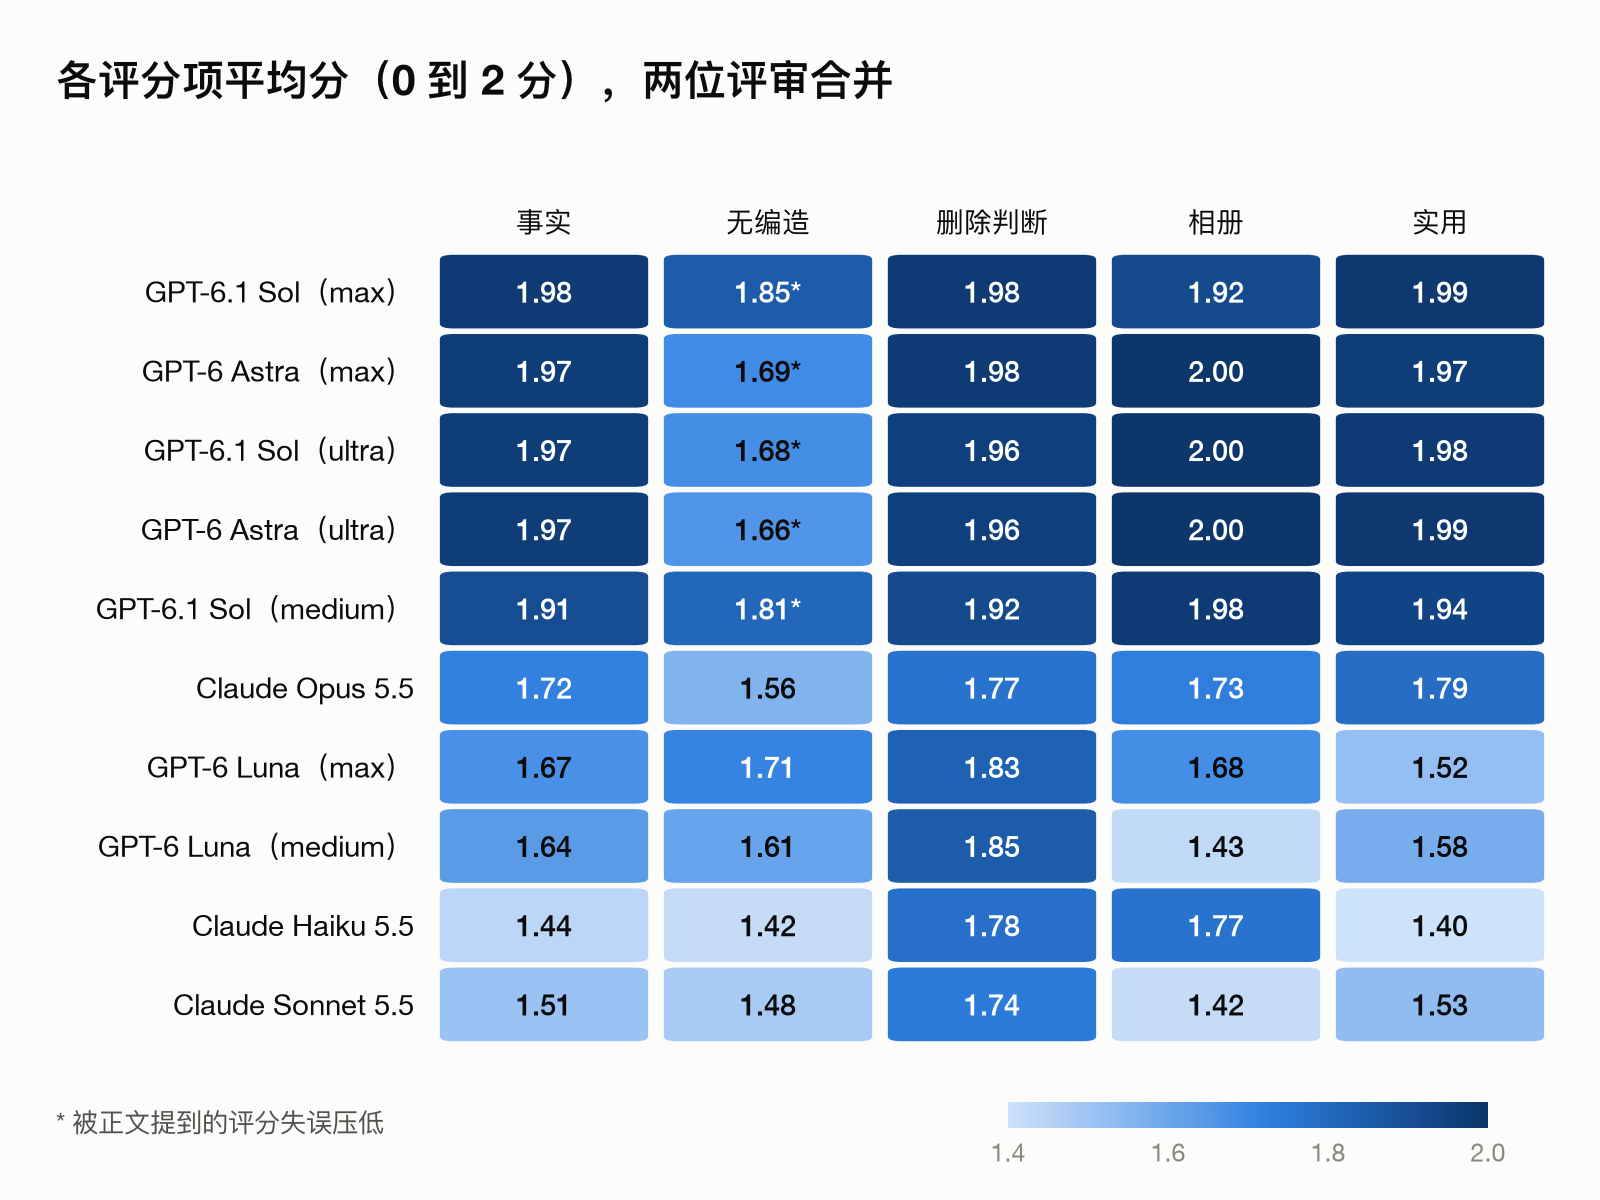 图 5:两位评审合并后的各项平均分。带星号的分数被下文提到的评分失误压低了。
GPT-6.1 Sol 和 GPT-6 Astra
Sol 和 Astra 基本只写画面里能确认的内容,文字读得准,很少写出照片里看不出来的东西。本地地名也是它们处理得最好,这对在国内拍的照片很重要。
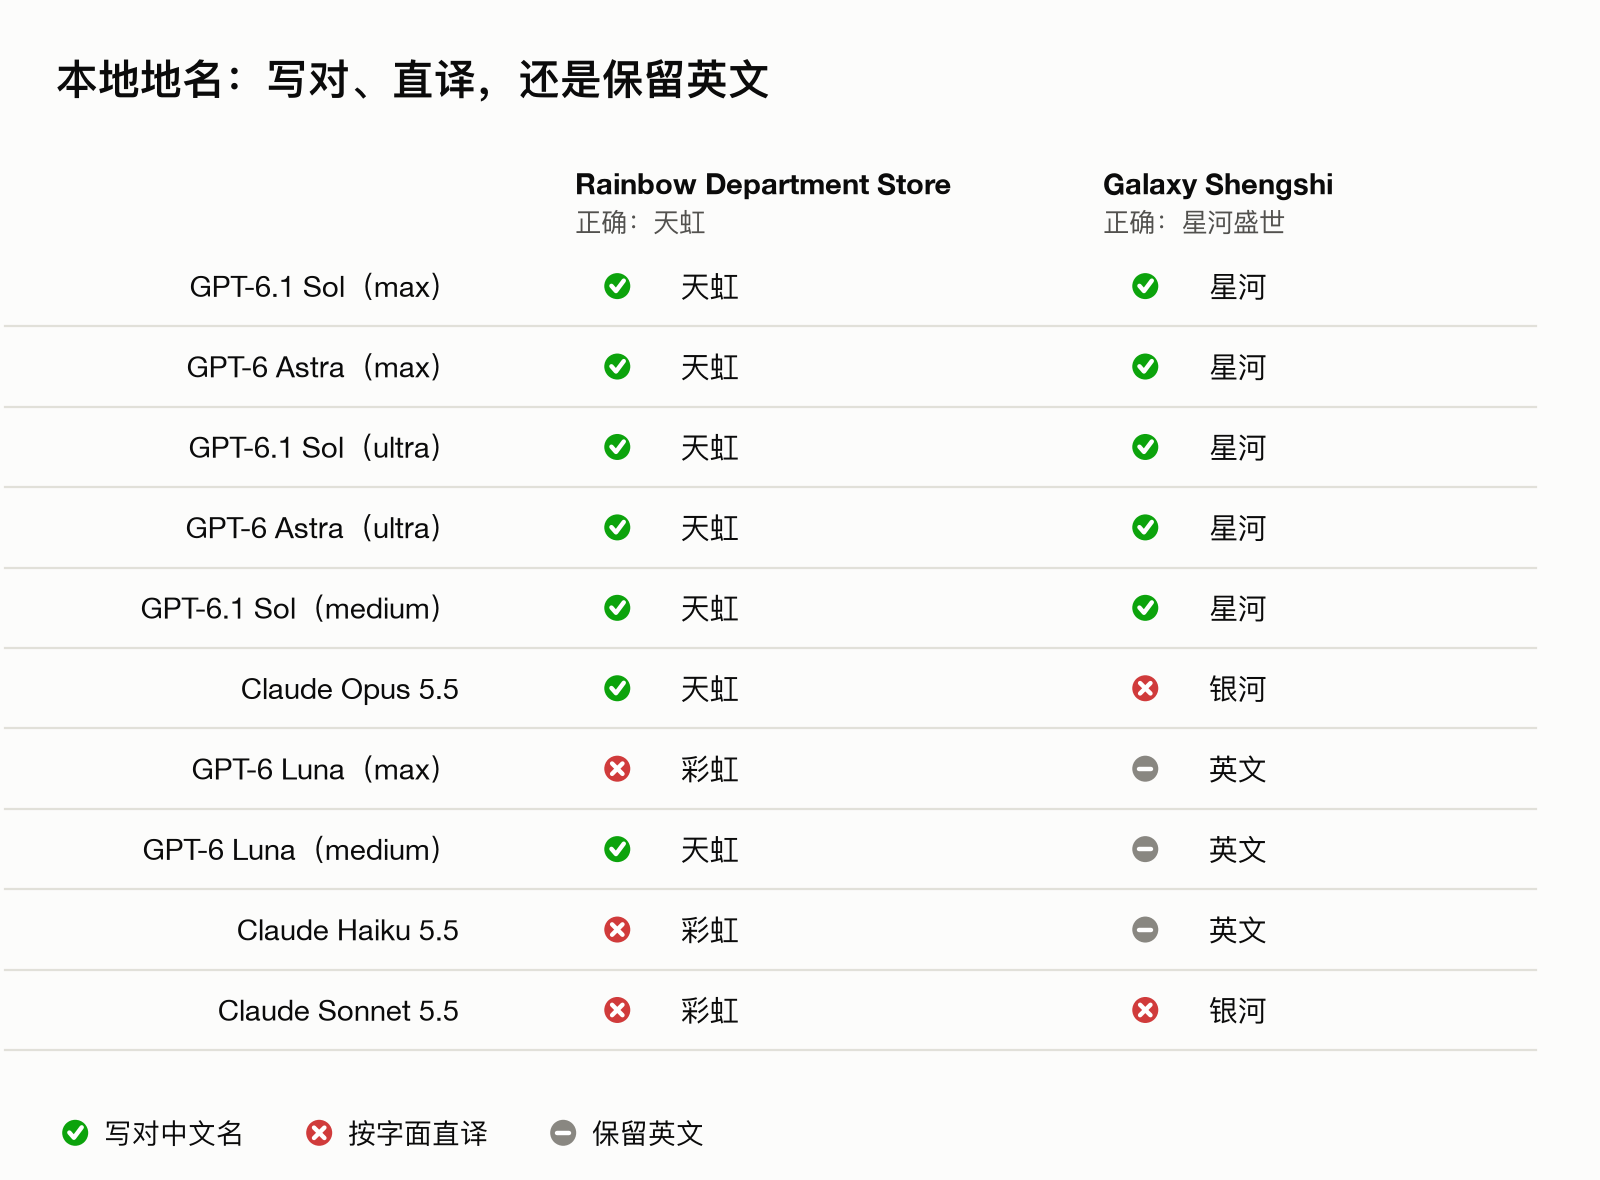 图 6:两道本地地名题。勾表示写对了中文名,叉表示按字面直译,EN 表示保留了英文。
有几张照片的定位是 Rainbow Department Store,这是深圳连锁商场天虹的英文名,直译成「彩虹百货」就错了。所有 Sol 和 Astra 配置都写对了,Opus 和 medium 档的 Luna 也对;Haiku、Sonnet 和 max 档的 Luna 用了直译。图 2 那张咖啡店照片的定位是 Galaxy Shengshi,中文名是星河盛世。所有 Sol 和 Astra 配置都写成星河;Opus 和 Sonnet 直译成了银河;Haiku 和两个 Luna 配置直接保留了英文。
删照片它们也很谨慎,50 张里只建议删 4 到 6 张。测试集里有 8 张电子元件的商品详情页截图,GPT 模型几乎都留下了,只有一个 Sol 配置把其中一张标成近似重复;Claude 模型各标了两到四张要删。两位评审都认为应该留,因为这些页面上有引脚定义、尺寸和板子实物照片,以后我还要查。
Claude Opus 5.5
Opus 有时会把画面里无法确认的内容也写进描述。它会写出单看照片无法确定的关系,比如兄弟姐妹、父母和孩子。姿势也有写错的时候:一张照片里孩子站在大人身后,它写成孩子趴在大人背上。两位评审都为此扣了分。
这一点让我很意外。盲测之前我先看过一遍结果,当时还夸 Opus 猜对了两个孩子是姐弟。我认识自己的家人,评审不认识。可是 14 万张照片,我不可能每条描述都自己核对,写出照片里没有的东西就是隐患。
Opus 也是建议删得最多的模型,50 张里提了 13 张。其中三张商品详情页截图被它说成过期,可上面的参考信息我是要留的。它也是唯一一个想把停车优惠二维码当成没价值删掉的模型。另外,它还把几张单人照放进了「全家福」相册。
Claude Sonnet 5.5 和 Haiku 5.5
这两个模型事实错误最多,把天虹直译成「彩虹」的也有它们。Sonnet 选相册最弱,把日常照片放进了一个不相关的旧活动相册。Haiku 编了一个细节,结果删错了照片:一组几乎一样的连拍里,它说最好的一张有人在低头,跟照片正好相反,还建议删掉。
GPT-6 Luna
Luna 单价和 Haiku 一样,两个档位的分数却都比 Haiku 高:8.41 和 8.11,Haiku 是 7.81。max 档得分也高于 Sonnet;同样给这个图库写描述,Sonnet 的成本贵约 17 倍。Luna 主要在实用性和相册上丢分,描述比较平淡,相册也选得不够准。
推理强度
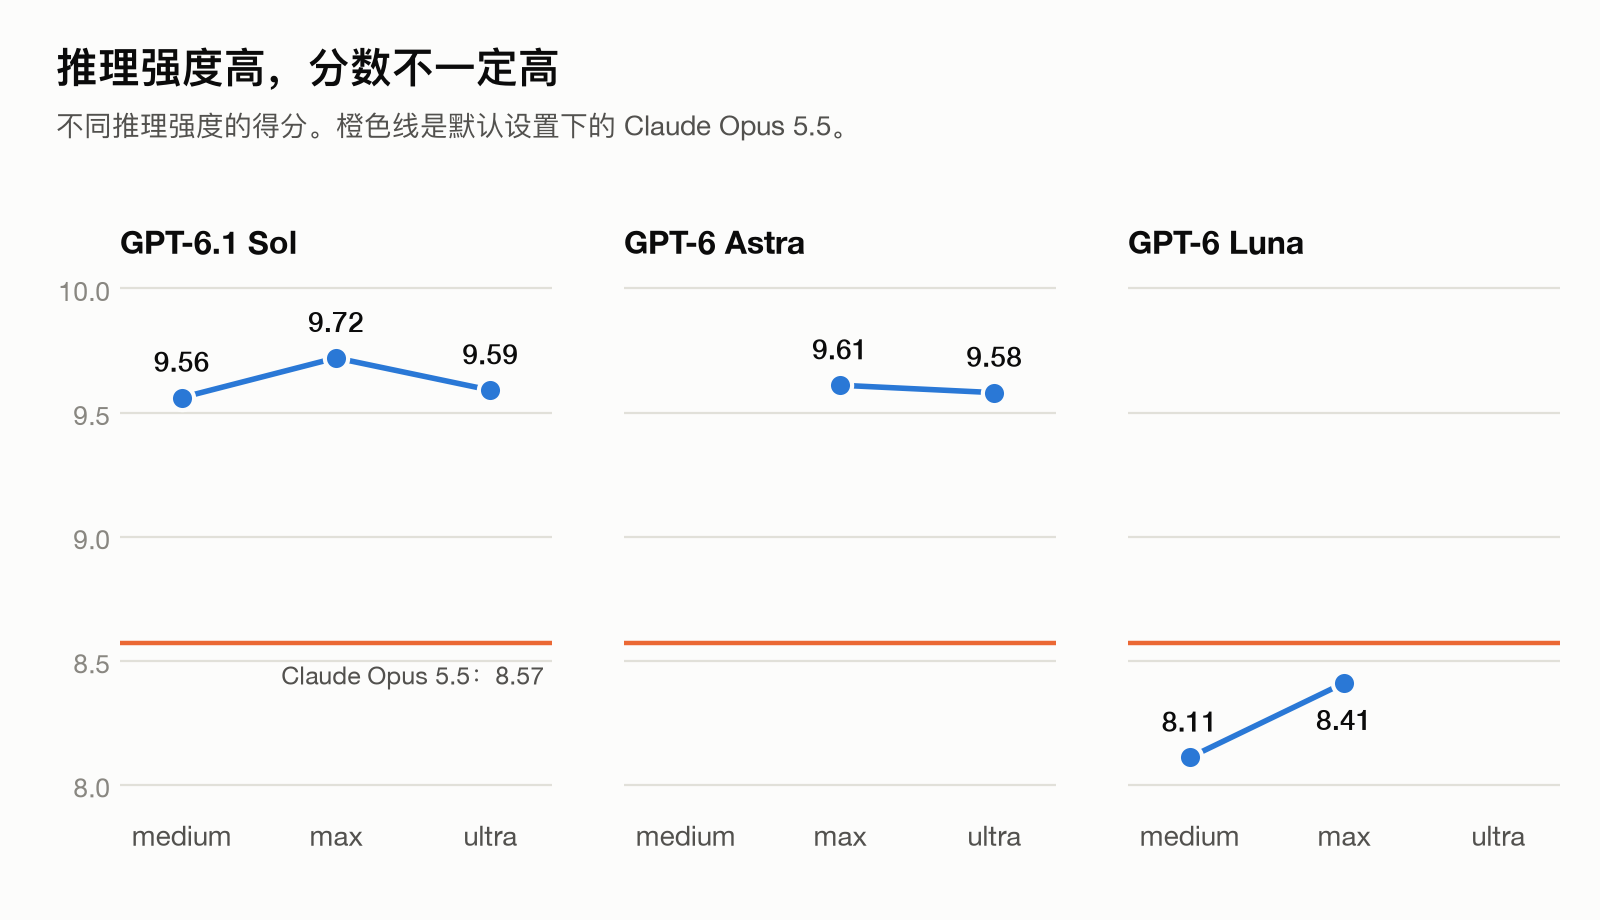 图 7:不同推理强度的得分。橙色线是默认设置下的 Claude Opus 5.5。
这次 Sol 和 Astra 都是 max 档比 ultra 档得分高:Sol 在 max 档 9.72 分、ultra 档 9.59 分,Astra 分别是 9.61 和 9.58 分。这次 ultra 档的输出 token 甚至比 max 档少。Sol 的 medium 档也很接近,9.56 分,成本不到 max 档的一半。推理强度高,细节也不一定更准:medium 档的 Luna 写对了天虹,max 档反而写错了。
我评分里的一个失误
评分做完之后我才发现,写描述的模型拿到了每张照片的拍摄日期和时间,评审却没有。所以 GPT-6 Astra 评审把描述里写了具体日期或时间的地方当成了编造。排在前面的 GPT 配置最常写日期,「无编造」这一项的分数因此被压低了。
只把因为日期扣掉的分加回去,前四名 GPT 配置会升到 9.84 到 9.90 分,基本打平;Opus 还是 8.58 分。文中我保留了原始分数,下次会把模型看到的信息全部给评审。
速度
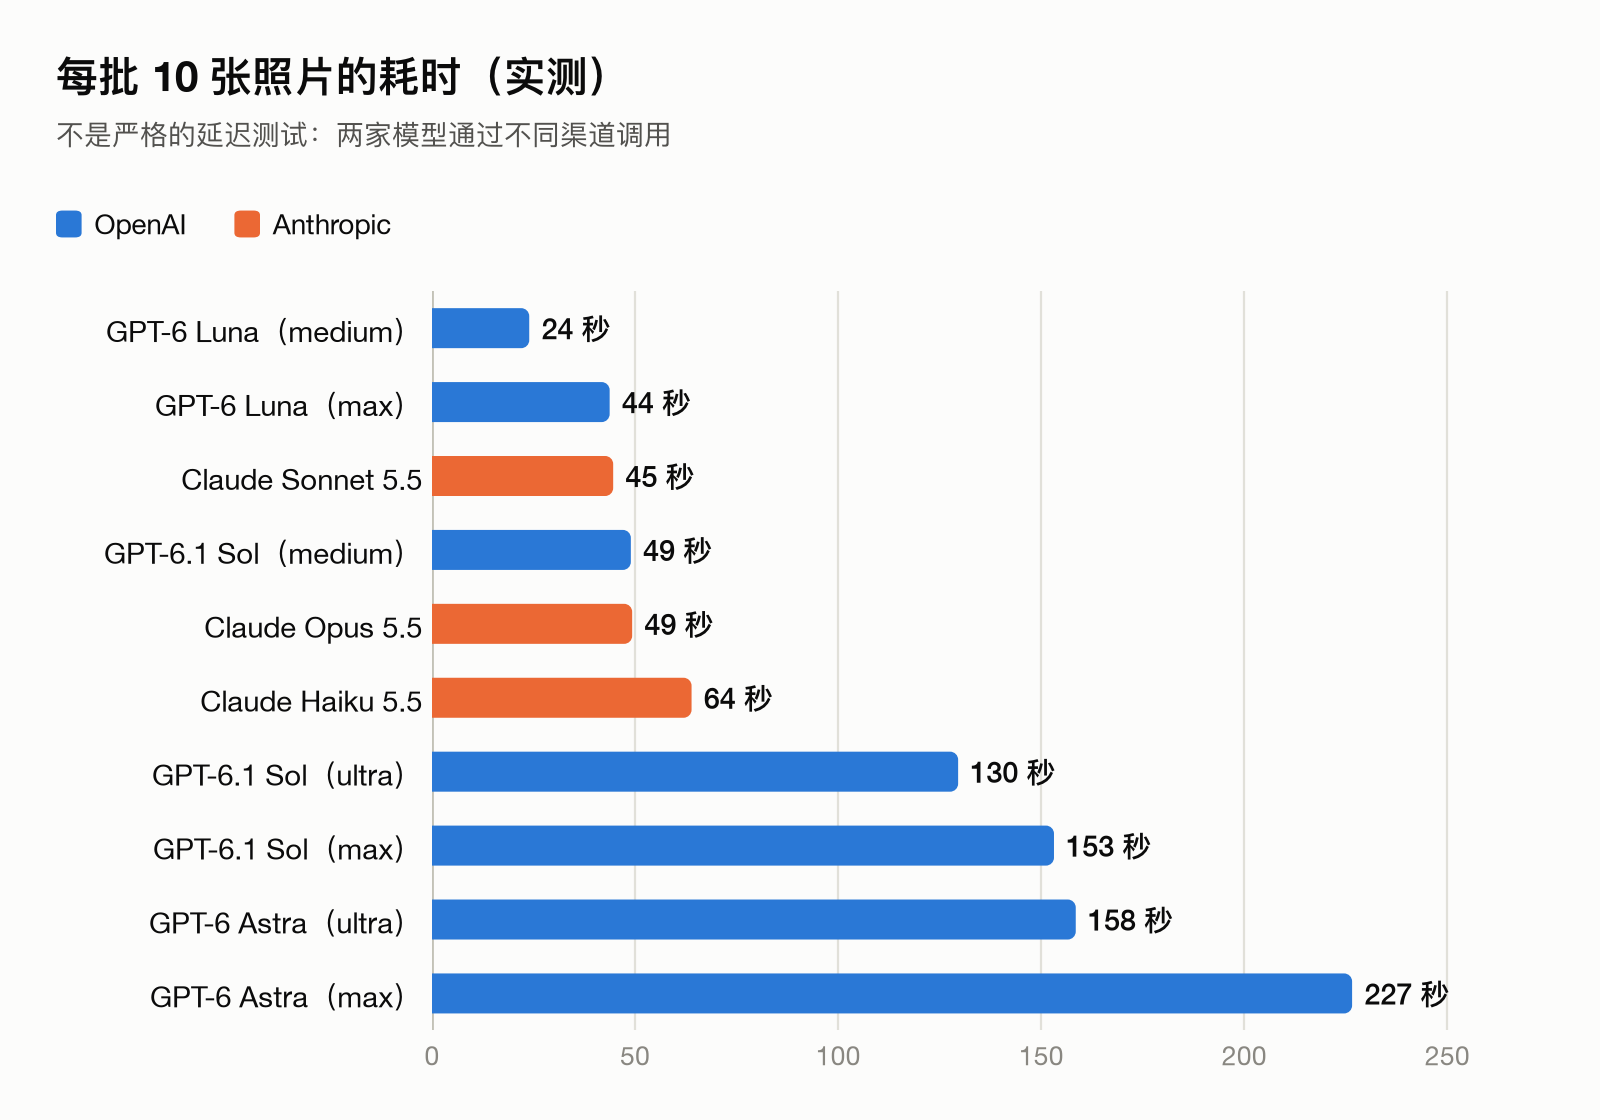 图 8:每批 10 张照片的实际耗时。这不是严格的延迟测试,两家模型是通过不同渠道调用的。
这和我平时的感觉一致:Opus 很快,大约是 max 档 Sol 的 3 倍。不过 medium 档的 Sol 和 Opus 一样快,分数还高出差不多 1 分。
要花多少钱
所有配置我都按厂商官方 API 价格来算。如果把订阅套餐里包含的用量当成免费,有些模型就会显得比实际更划算。
官方价格(每百万 token,标准档):
| 模型 | 输入 | 输出 |
|---|---|---|
| Claude Opus 5.5 | $4.00 | $20.00 |
| Claude Sonnet 5.5 | $2.00 | $10.00 |
| Claude Haiku 5.5 | $0.10 | $0.50 |
| GPT-6 Astra | $10.00 | $50.00 |
| GPT-6.1 Sol | $2.00 | $10.00 |
| GPT-6 Luna | $0.10 | $0.50 |
两家的 Batch API 都便宜一半,这种不需要马上出结果的任务正好合适。价格来自 Anthropic 定价页(claude.com/pricing)和 OpenAI API 定价页(developers.openai.com/api/docs/pricing),2026 年 10 月 20 日核对。
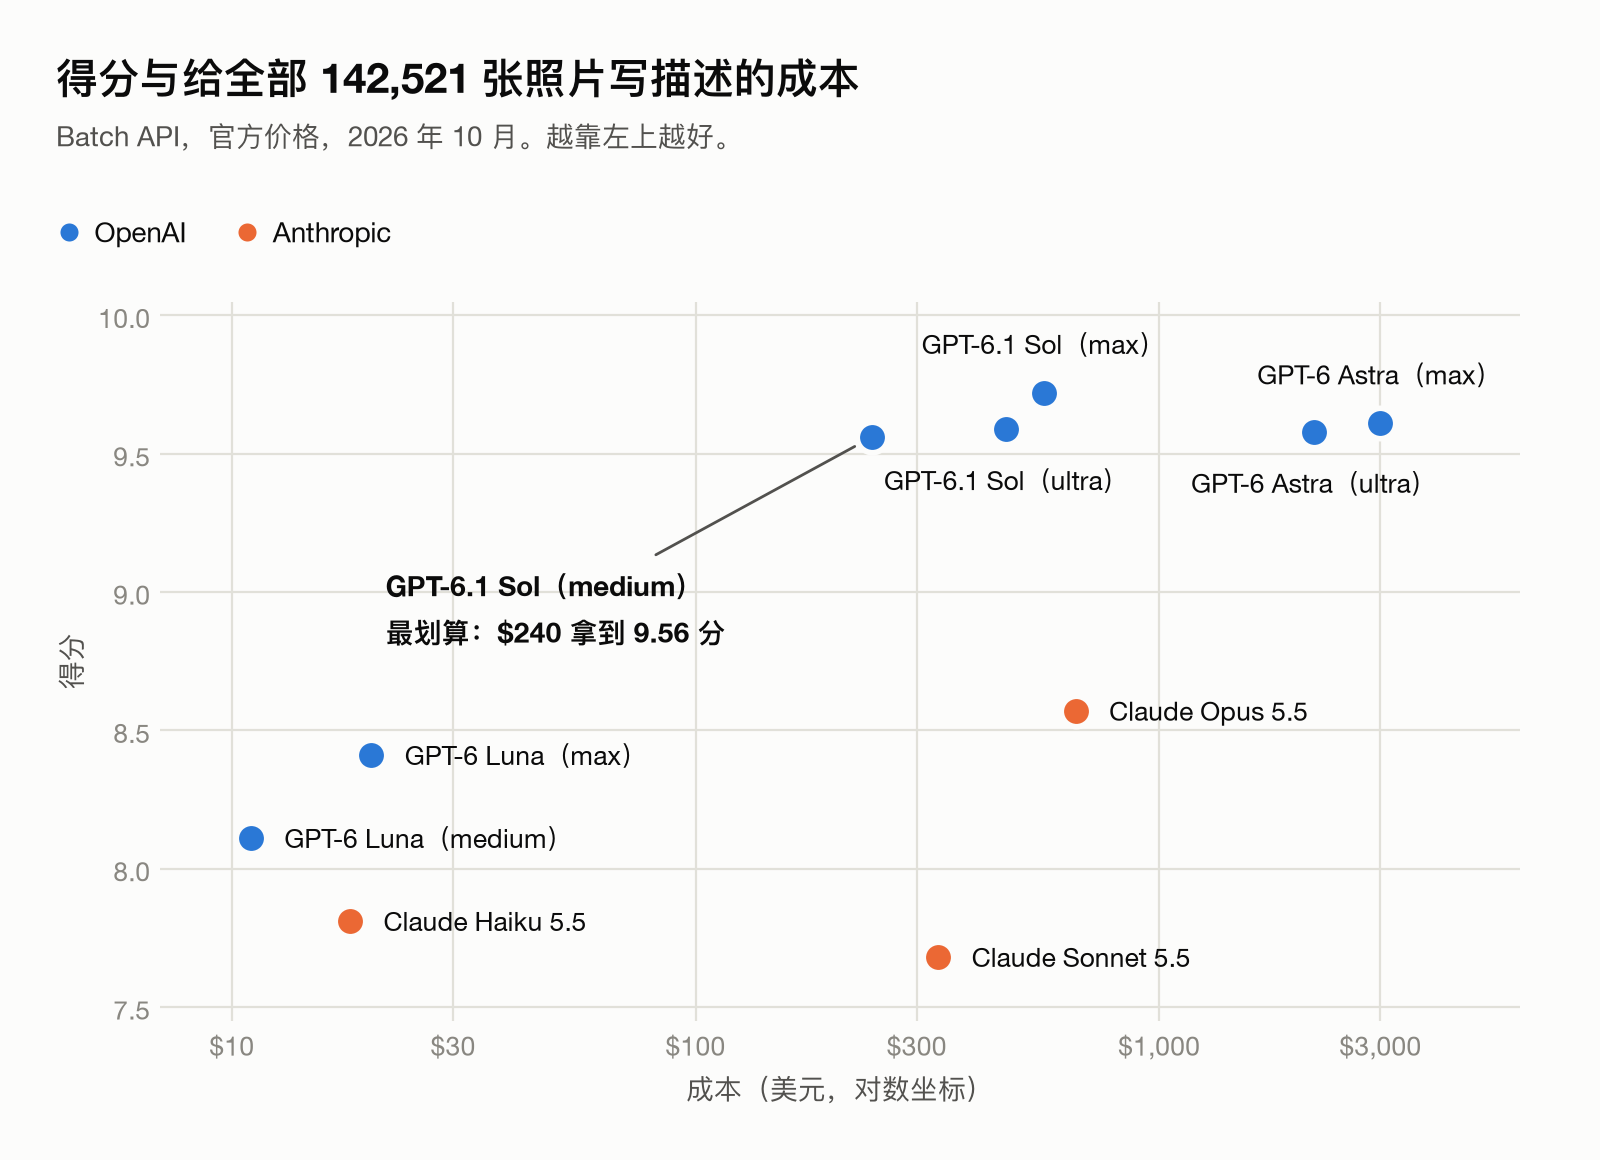 图 9:按 Batch 价格给整个图库写描述的成本与得分。成本轴为对数坐标。
| 模型与推理强度 | 每张输出 token | 标准 | Batch | 得分 |
|---|---|---|---|---|
| GPT-6.1 Sol,medium | 193 | $479 | $240 | 9.56 |
| GPT-6.1 Sol,ultra | 514 | $937 | $468 | 9.59 |
| GPT-6.1 Sol,max | 647 | $1,126 | $563 | 9.72 |
| Claude Opus 5.5 | ~292 | $1,323 | $661 | 8.57 |
| Claude Sonnet 5.5 | ~297 | $668 | $334 | 7.68 |
| GPT-6 Astra,ultra | 462 | $4,313 | $2,156 | 9.58 |
| GPT-6 Astra,max | 695 | $5,973 | $2,987 | 9.61 |
| GPT-6 Luna,medium | 163 | $22 | $11 | 8.11 |
| Claude Haiku 5.5 | ~330 | $36 | $18 | 7.81 |
| GPT-6 Luna,max | 419 | $40 | $20 | 8.41 |
medium 档的 Sol 拿到最高分的 98%,成本只有 Opus 的 36%、max 档 Sol 的 43%。Astra 质量和 Sol 差不多,价格却是大约 5 倍,因为它的单价就是 Sol 的 5 倍。Opus 比 max 档的 Sol 还贵,分数却更低;它跑的已经是 medium 档,但单价是 Sol 的两倍。Luna 给整个图库写描述只要 $11 到 $20,得分还高于 Claude 的 Haiku 和 Sonnet。
方法说明:GPT 的 token 数来自运行实测,Claude 的 token 数根据运行日志估算。Claude 有部分推理 token 看不到,所以 Claude 的成本可能略微偏低。除 Batch 外,所有模型都没有计入提示缓存等其他折扣。
我的收获
我先按写代码的习惯选了 Opus,等盲评结束才发现选错了。写代码、跑工作流,我还是更喜欢 Claude Opus 5.5,我自己用下来,它更快,效果也更好。描述真实照片是另一回事:要看清画面里到底有什么,不能自己补出姿势和关系。这一点 GPT-6.1 Sol 做得更好。如果我按习惯直接用 Opus、不做盲测,就会花更多的钱,拿到更差的描述。
下次我先盲测,让至少两家厂商的评审模型拿到写描述时的全部输入。比较成本也继续按官方 API 价格算。推理强度不是越高越好:这次 ultra 没赢 max。
最好的模型偶尔也会把有用的照片标成要删,所以每一条删除建议,我都会自己看过再删。
局限
这次测试规模不大:50 张同一个城市的近期照片。老照片、扫描文件、其他语言和视频都没测。Claude 模型只跑了默认设置,高推理强度的 Opus 也许分数更高,成本也会更高。评审是 AI 模型,不是人;两位评审结论接近,但不完全一致,如果有人工抽查会更扎实。模型和价格变化很快,文中所有数字截至 2026 年 10 月。
我的选择
我的图库:GPT-6.1 Sol,medium 档。写代码和跑工作流,我还是继续用 Claude Opus 5.5。