
如今有一条公链运行在与 AI 相同的矩阵乘法上,全网约 90 EH/s。我阅读了它的代码、链上数据以及周边的经济账,想回答三个问题:AI × Crypto 里哪些方向有付费客户,ASIC 什么时候值得做,哪种工艺节点适合哪类芯片。附完整报告与幻灯片。
摘要
2026 年 4 月上线的 Pearl,是第一条以 AI 式矩阵乘法规模化充当工作量证明的公链。2026 年 11 月 13 日,其全网算力约 90 EH/s,其中 1 H 即一次 INT7 乘加,相当于约 12.2 万张 H100 的整数算力。它在工程上可行,但还不“有用”:只有约 1% 的区块承载真实 AI 工作,因为边推理边挖矿的 GPU 只能保留专用矿卡 1% 到 27% 的算力。纵观 AI × Crypto,可验证的付费需求集中在三处——卖推理、卖数据、卖隐私——而补贴是外部收入的 4 到 360 倍。在芯片方面,ASIC 的利润上限是单位算力收益 ×(1 − 1/k),因此 k 超过 5 之后效率提升作用不大;决定成败的是盘子大小、规则的稳定性和第二市场。今天没有任何网络三者兼具。合适的工艺节点由芯片终生成本中最大的一项决定;而芯片本身应分阶段购买,这样规则一旦变化,损失的是一次原型,而不是一次流片。
我为什么研究这个
我做了多年芯片设计,包括加密货币矿机的全定制 ASIC 数据通路,如今从事 AI 研发。当一条公链的安全预算字面意义上以张量吞吐计价时,对我这样的人来说,问题显而易见:这些工作有用吗?专用芯片能赢吗?做一颗要花多少钱?
我阅读了 Pearl 的代码与协议提案、来自独立全节点的链上数据、公司公告,以及密码学、计算机体系结构与机器学习方面的论文、代工厂与厂商的价格数据,还有行业媒体的报道。下文所有数字均截至 2026 年 11 月 13 日,金额单位为美元。这篇笔记是我学习这个领域的过程;我把它分享出来,是希望别人能核对它、使用它、与它争论。附有全部来源的完整报告见文末。
结果一览
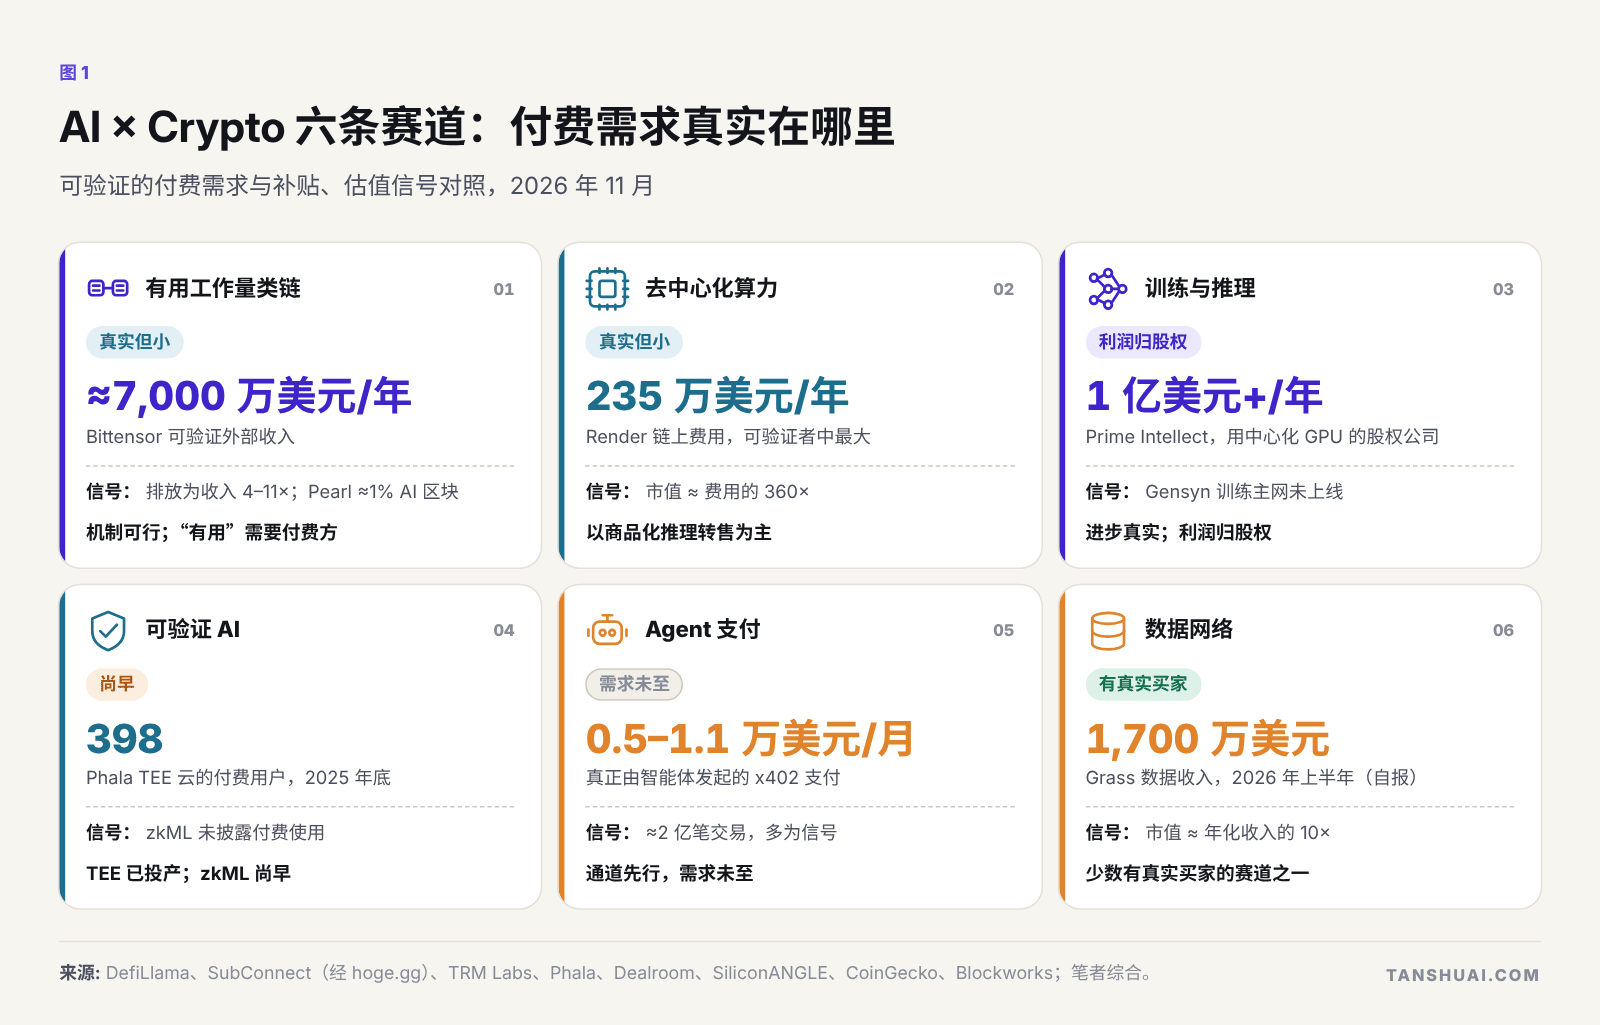 图 1. AI × Crypto 六条赛道:付费需求真实在哪里。
| 问题 | 简答 |
|---|---|
| Pearl 可行吗?它的工作有用吗? | 可行:约 90 EH/s 的矩阵乘法保护着这条链。尚未有用:只有约 1% 的区块承载 AI 工作 |
| 真实的付费需求在哪里? | 推理、数据与隐私。Agent 支付、zkML 与去中心化训练仍处于需求之前 |
| ASIC 值得做吗? | 只在盘子大、规则稳、有第二市场时才值得;今天没有任何网络三者兼具 |
| 小团队该做哪些芯片? | 推理优先、可挖矿的加速器,面向已签约客户的推理芯片,早期 FHE 工作;不做商户比特币矿机或训练芯片 |
| 第一颗芯片要花多少钱? | 分阶段购买:模型、FPGA 与 MPW 约 150 万美元即可拿到实测硅片,之后才是动辄数百万美元的掩模 |
Pearl:一次乘加就是一个哈希
Pearl 建立在 Ilan Komargodski 与 Omri Weinstein 2025 年的一项成果之上:为任意矩阵乘积构造有用工作量证明,成本为矩阵乘法本身的 1 + o(1) 倍。矿工计算带噪矩阵乘法,把每个输出分块的累加器哈希成一张彩票,并用 60 KB 以内的零知识证明证明中奖分块。在共识代码中,1 H 即一次被记账的 INT7 × INT7 → INT32 乘加,区块链的安全预算因此第一次以 AI 加速器的张量吞吐来计价。
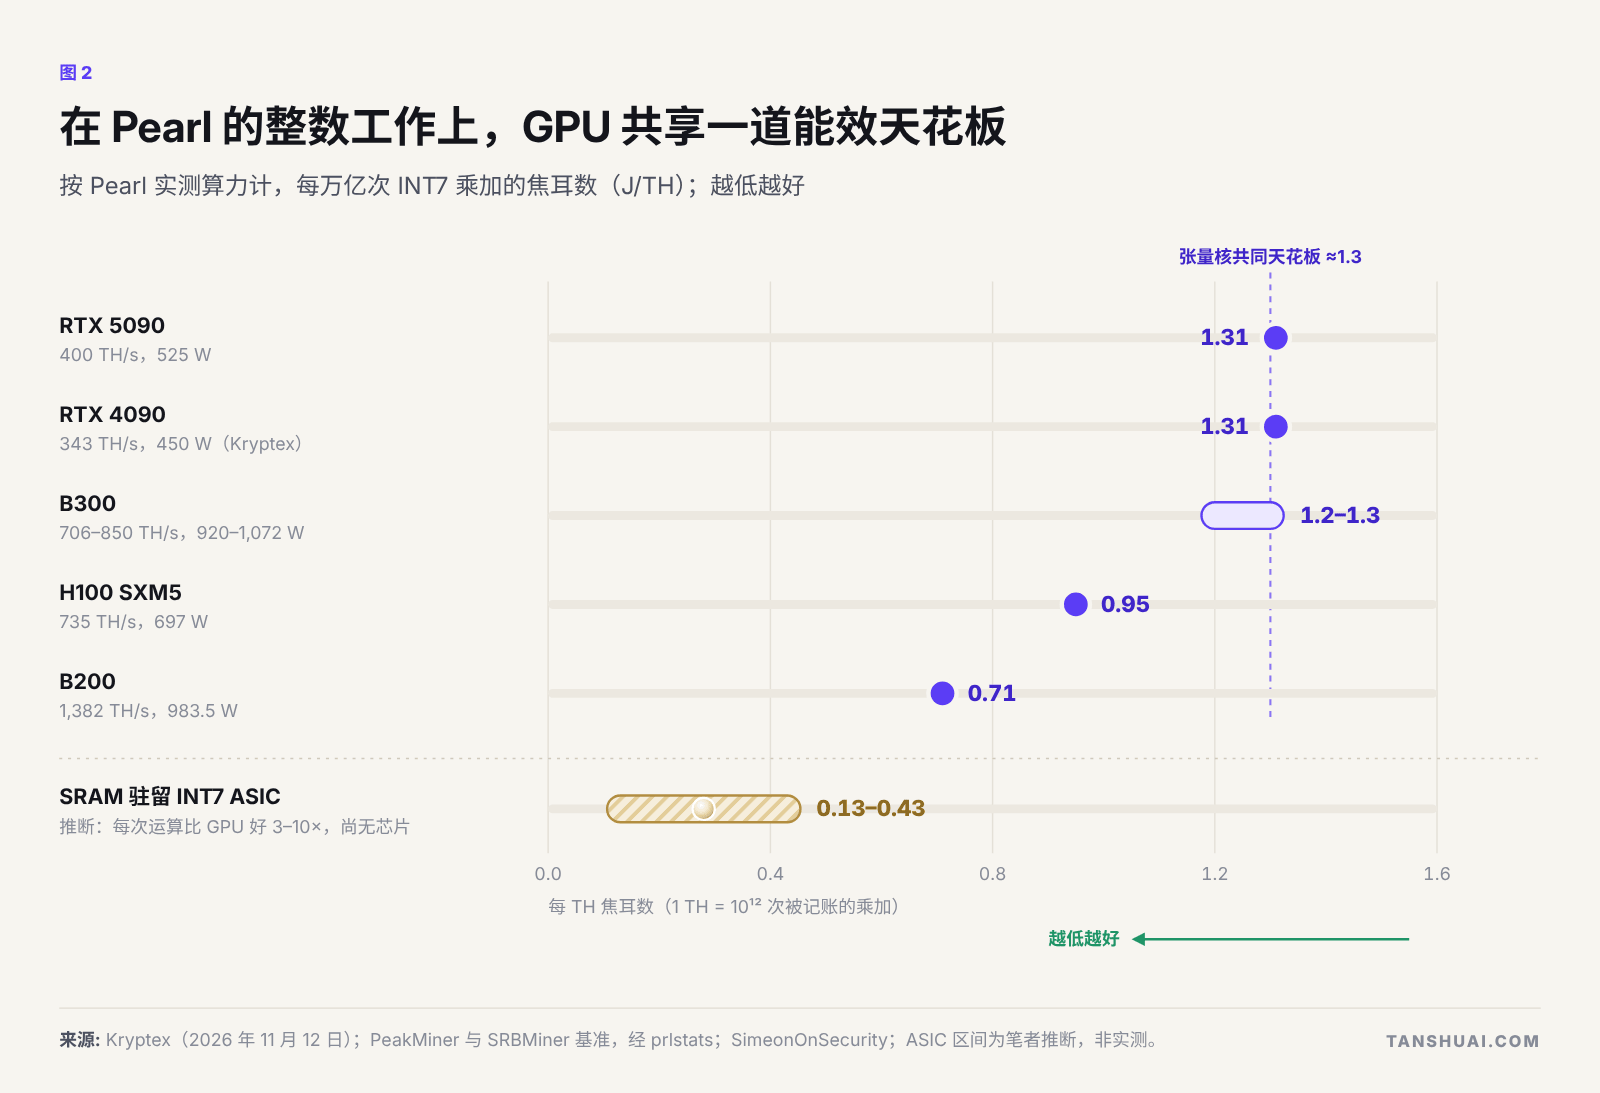 图 2. 在 Pearl 的整数工作上,GPU 共享一道能效天花板。
游戏卡与数据中心 B300 都在约 1.3 J/TH,即便 B200 也只有 0.71。这道共同的天花板正是专用芯片可以突破的地方:一颗只从片上 SRAM 读取 7 位整数做乘法、没有 HBM 和通用单元的芯片,每次运算在原理上或可好 3 到 10 倍。与此同时,英伟达正让其最新硅片离开 INT8、走向 FP8 和 FP4,这也是 Pearl 准备更改其算术的原因。
Pearl 的经济学:定理成立,激励未成立
Pearl 的算力追随币价。全网算力从上线第二天的 0.01 EH/s 升至 5 月底的 23–26 EH/s,在币价下跌约 86% 的夏天维持在 21–39 EH/s,秋季币价约十倍反弹后达到约 90 EH/s。前六天挖出了约 1.2 亿枚,约占今日供应的 32%,未来 12 个月供应还将增长约 78%。一张 RTX 5090 现在每天约赚 5–6 美元。
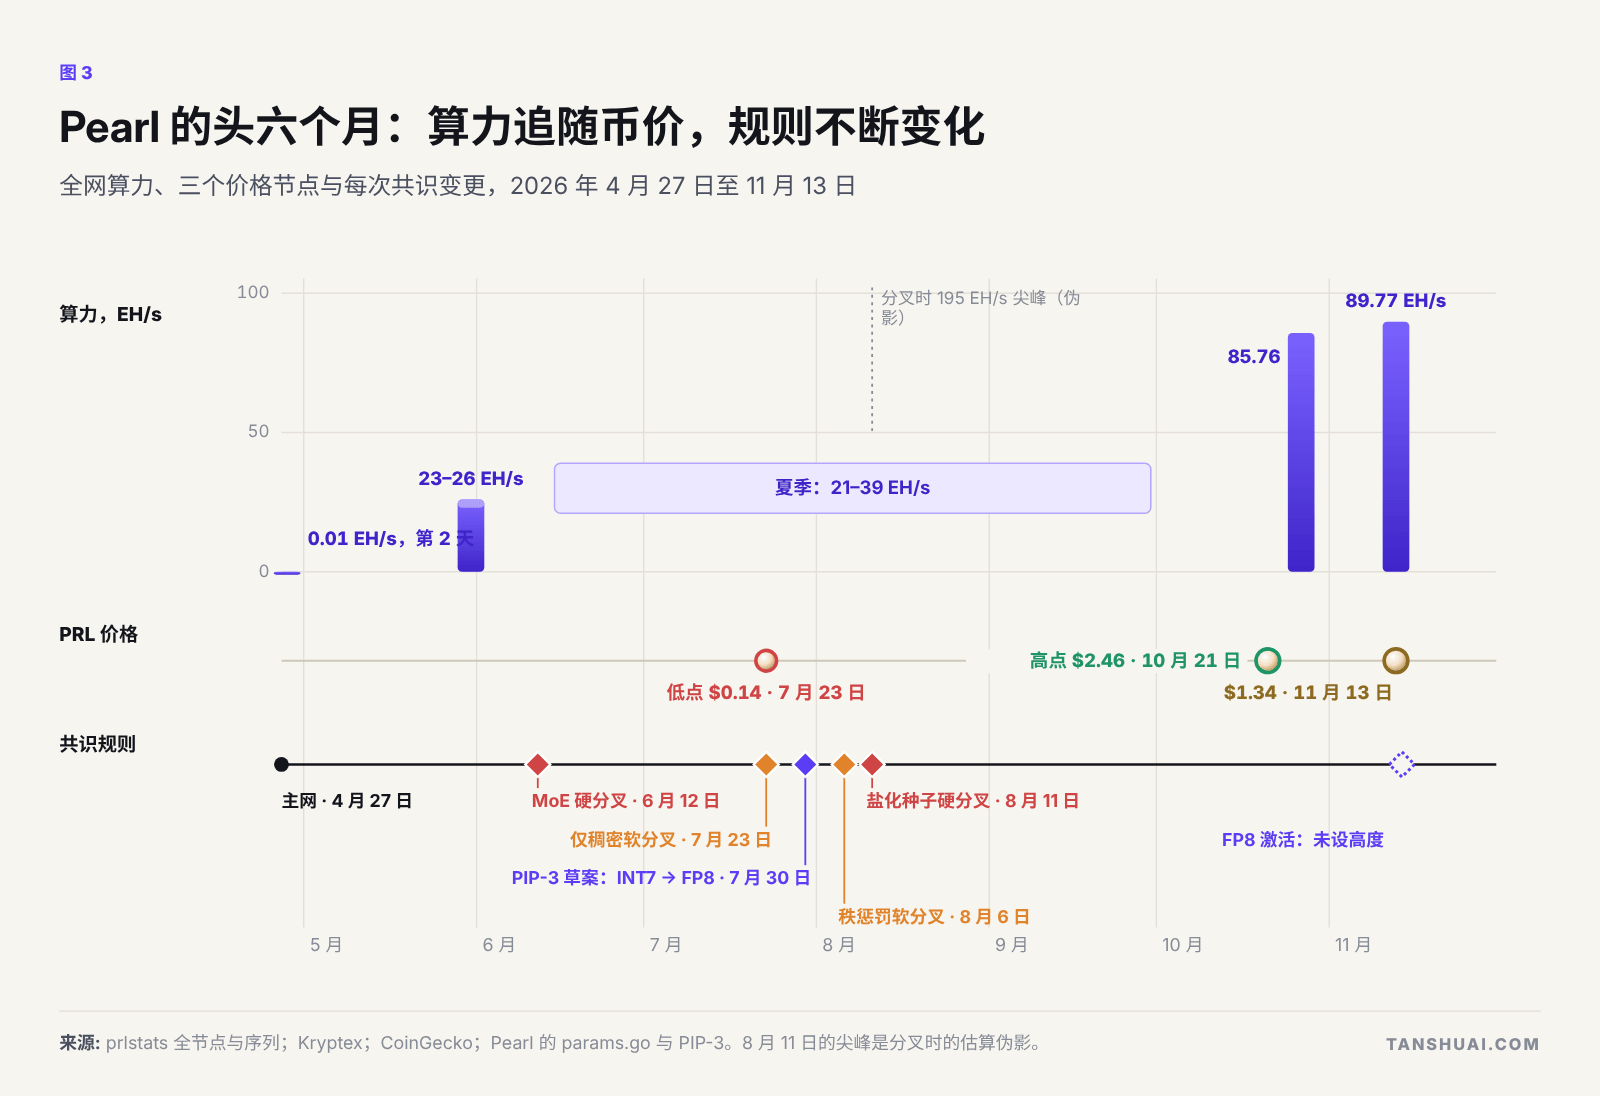 图 3. Pearl 的头六个月:算力追随币价,规则不断变化。
“有用”这一环正是模型失灵之处。在真实推理中挖矿,推理侧代价很小,约为吞吐的 5% 到 9%,但挖矿侧收益也很少:Pearl 的插件只在长预填充批次上挖矿,因此一张承担对话负载的卡只能保留专用矿卡约 5% 的算力。于是理性矿工去算随机矩阵,而协议无从分辨。唯一公开的推理合作也已不在其服务商的无服务器 API 上。Pearl 的“有用”是一个链下的商业问题:必须有人为推理付费。
规则是另一重风险。6 月至 8 月,实验室以硬编码高度激活了四次共识变更,其 PIP-3 草案把挖矿改为 FP8,并要求只覆盖英伟达两种架构的逐位精确设备配置文件。数值格式可以对 AI 有用、逐位可验证、硬件中立,但三者最多得其二。
纵观 AI × Crypto:补贴是燃料,不是商业模式
其他有用工作量类链讲的是同一个故事。Kaspa 把矩阵乘积放进哈希,16 个月内照样迎来了 ASIC;其最好的机器如今每天只赚 0.86 美元。Aleo 的合成证明谜题五个月就有了专用硬件,付给证明者的奖励是其手续费的 175–180 倍。Bittensor 是这一组里唯一拥有规模化外部收入的网络,年化约 7,000 万美元,而排放超过 3 亿美元。
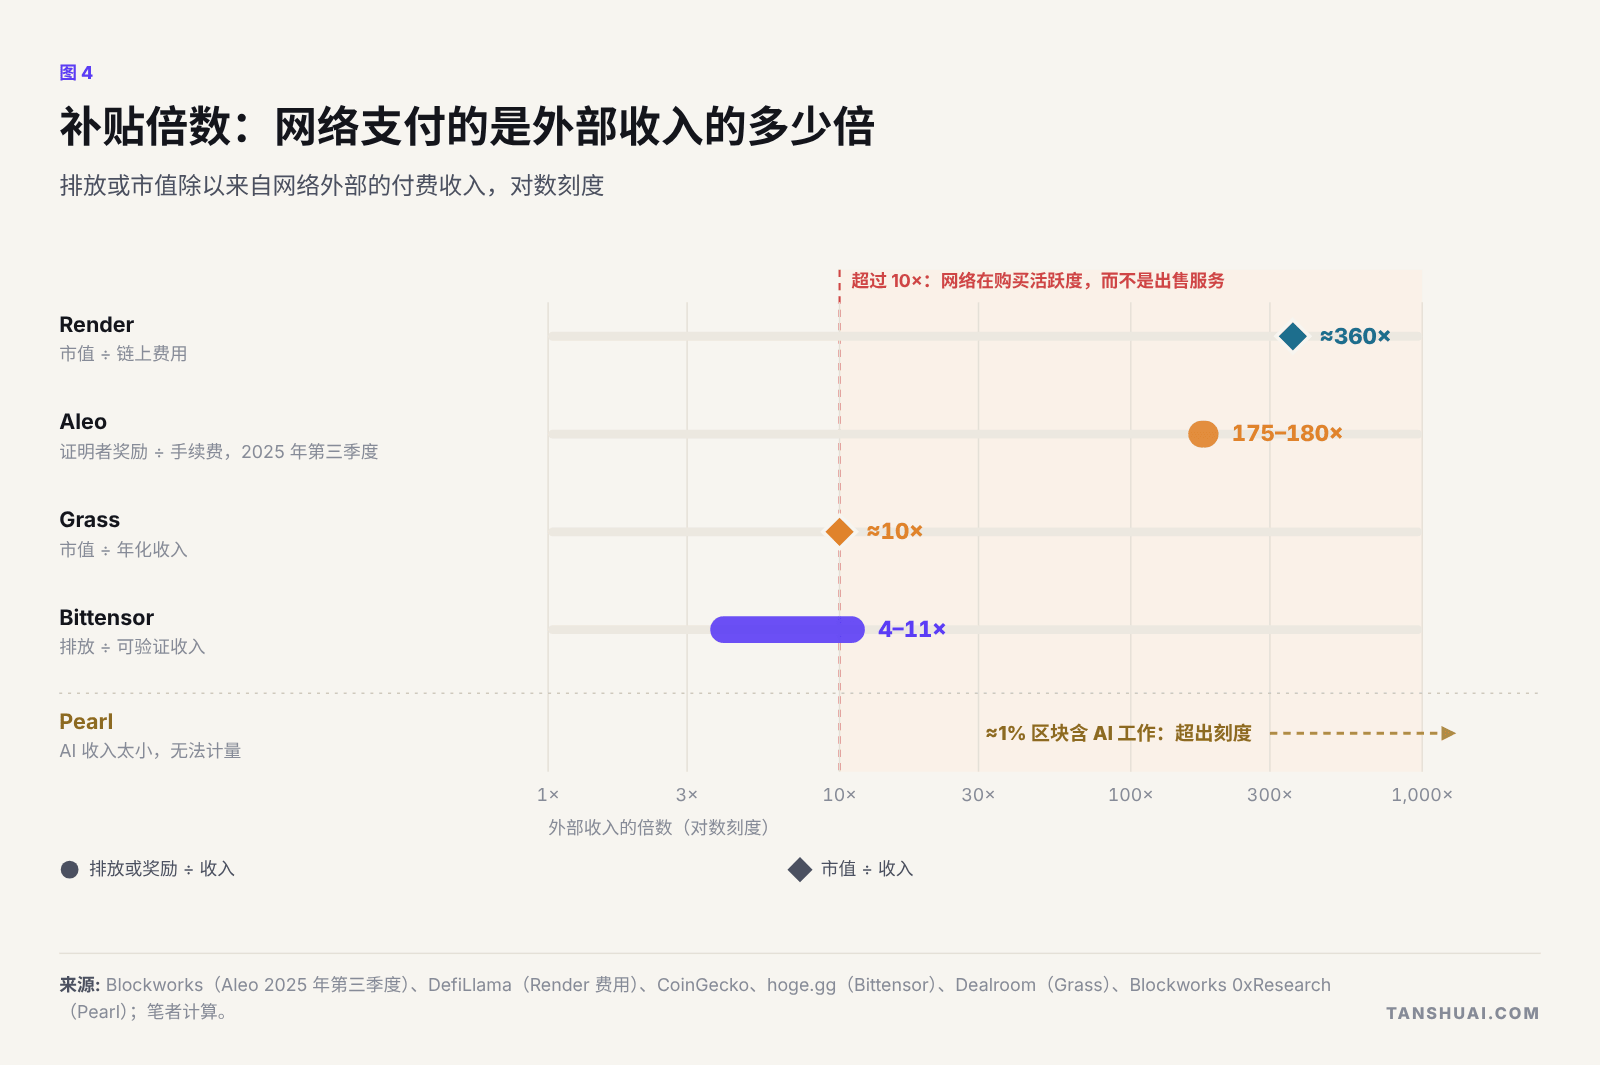 图 4. 补贴倍数:网络支付的是外部收入的多少倍。
在共识之外,图景是规模很小的真实需求。去中心化 GPU 市场卖的是商品化推理,价格低于云巨头,却不及最便宜的新兴云。互联网上的训练在 80 亿至 400 亿参数级可行,前沿规模的训练则回到了集中式集群。可信执行环境已在生产中运行机密推理;AI 的零知识证明仍在实验室。尽管 Visa、Mastercard、Stripe 与 Google 搭好了通道,由 AI 智能体发起的支付每月也只有约 5,000–11,000 美元。数据是少数有真实买家的赛道之一。与此同时,四家基于中心化基础设施的股权公司,价值约等于全部协议层与应用层 AI 代币之和:加密负责分发与结算,股权收走利润。
ASIC 何时值得做:一个公式,三把尺子
当 GPU 决定挖矿价格时,单位算力收益趋向其成本,一颗便宜 k 倍的 ASIC 最多留下收益的 (1 − 1/k)。这条曲线是凹的:k = 2 时 50%,k = 5 时 80%,k = 10 时 90%。k 超过 5 之后,效率再提升几乎不增加利润;而面对只付电费的闲置 GPU,有效 k 可能只有约 2.5。
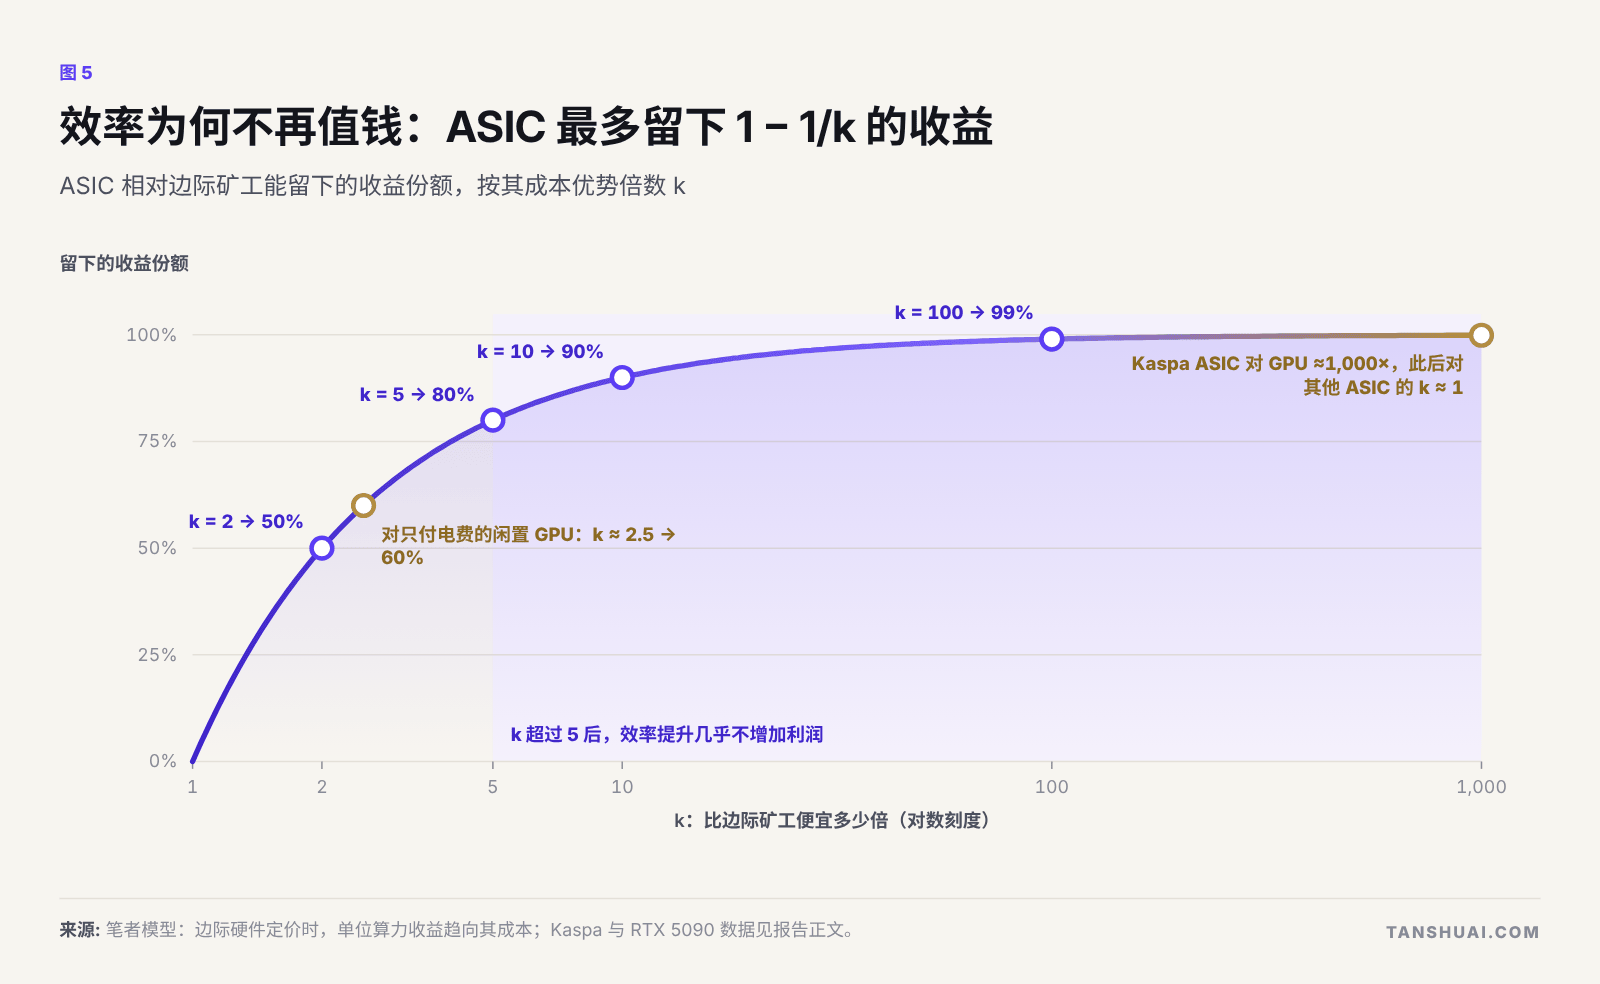 图 5. 效率为何不再值钱:ASIC 最多留下 1 − 1/k 的收益。
接下来由三把尺子决定:盘子、回本规模与规则。比特币矿工年收入约 115 亿美元,Pearl 约 4.6–4.9 亿美元,Aleo 约 3,100 万美元,Kaspa 约 1,800 万美元,还不到一次 5/4nm 芯片设计的下限。对 Pearl 而言,一颗 NRE 2,000 万美元、k = 5 的芯片,若规则不变,需要约 4.9 EH/s 运行一整年才能回本;若规则维持的概率只有五五开,则需要两倍。
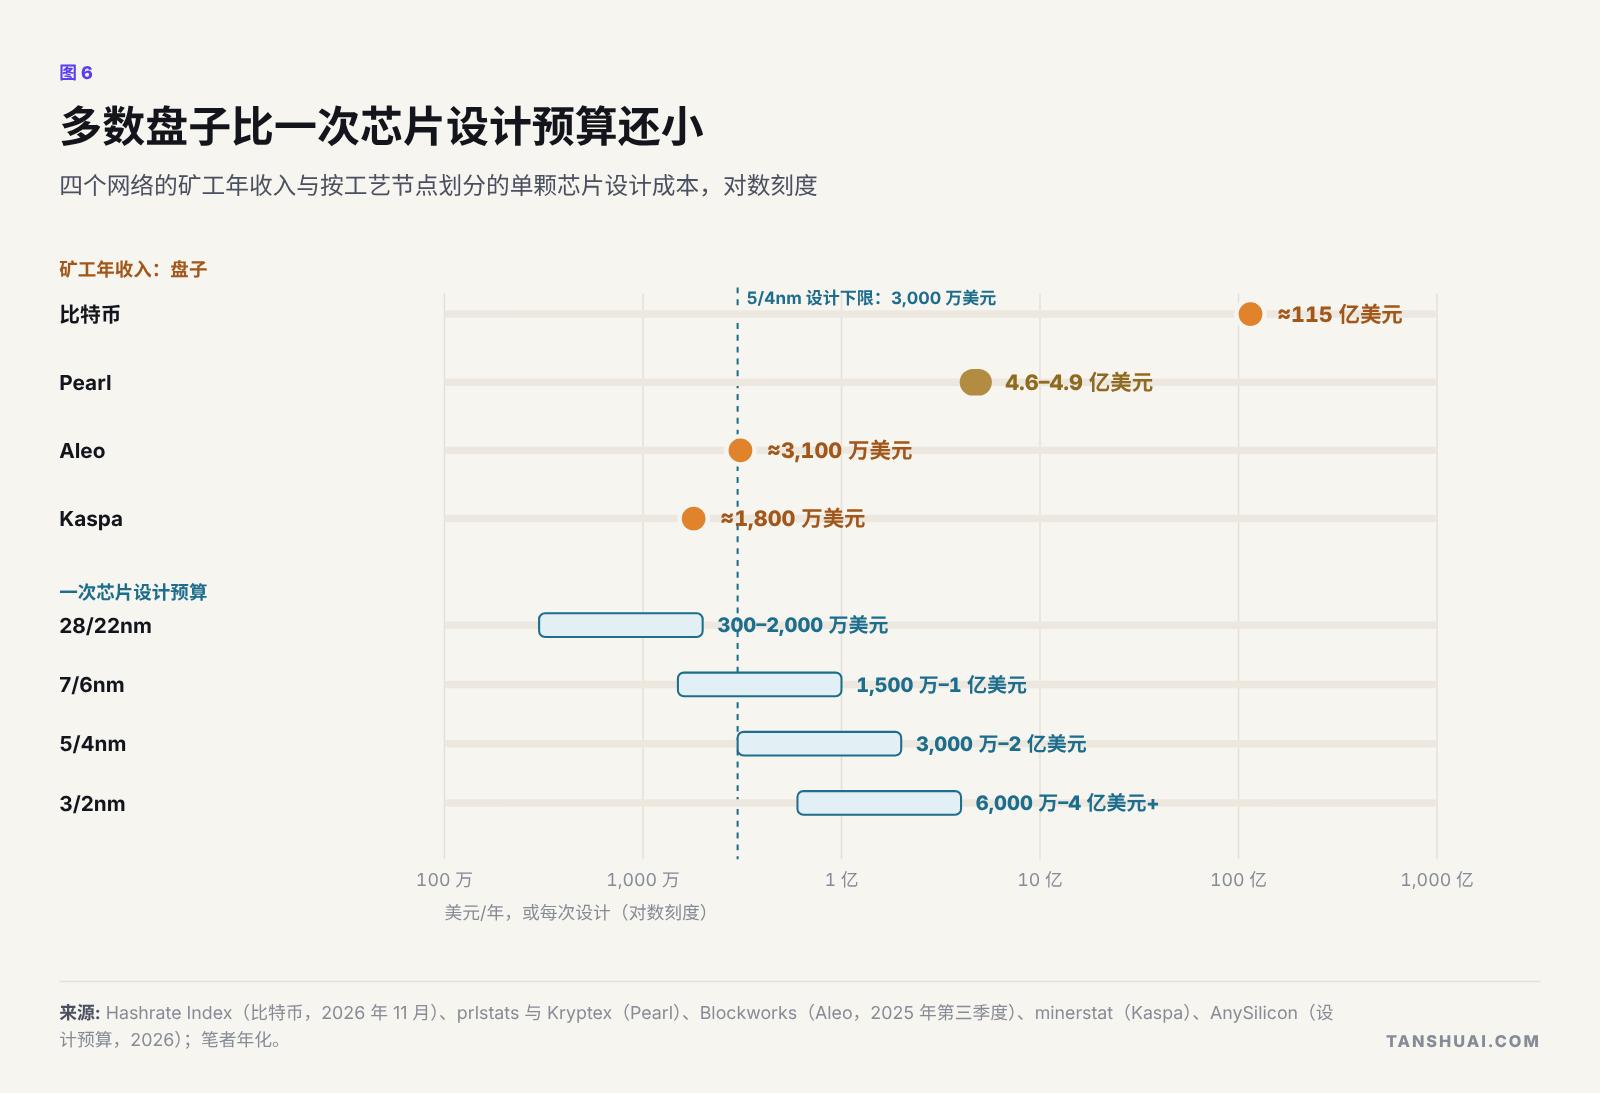 图 6. 多数盘子比一次芯片设计预算还小。
今天没有任何网络同时具备大盘子、稳规则和大于 1 的 k:比特币的 k 归在位者,Pearl 的规则最不稳,Kaspa 与 Aleo 的盘子太小。
五类芯片,五个答案
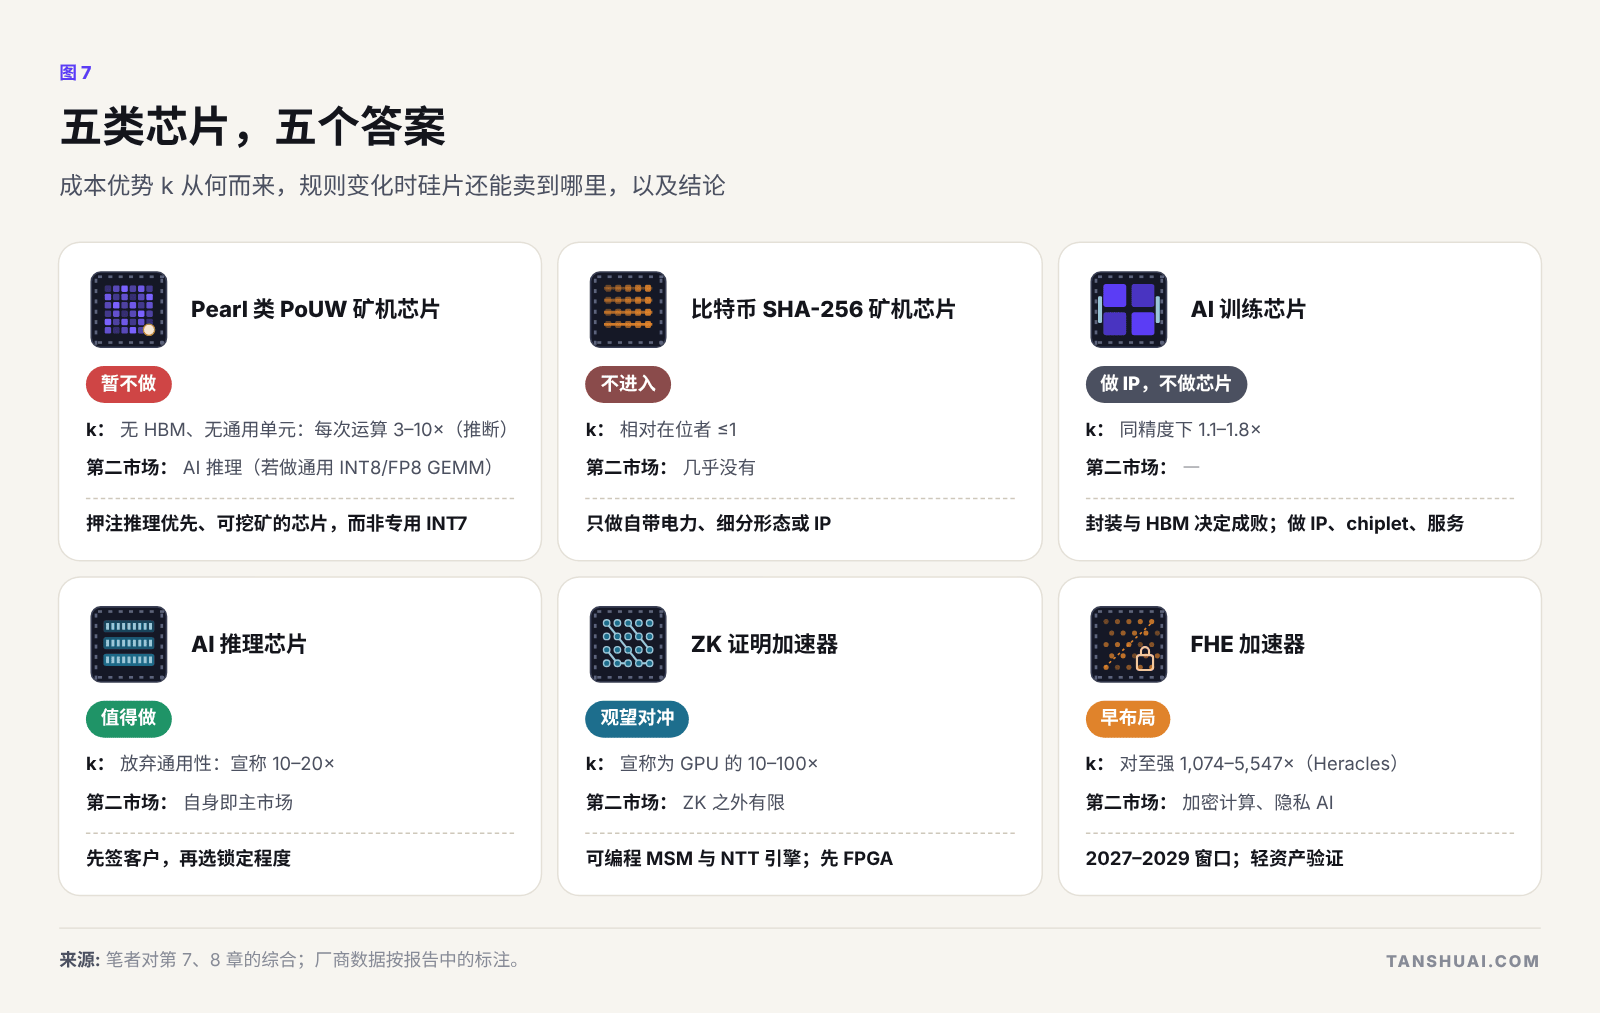 图 7. 五类芯片,五个答案。
对 Pearl,我现在不会流片专用的 INT7 芯片:新团队需要 18 到 24 个月,届时协议可能已改用 FP8。更好的押注是“推理优先”的加速器,以通用 INT8/FP8 GEMM 为核心、操作数驻留 SRAM,这样即使挖矿准入关闭,硅片也有第二市场。新团队不应进入比特币商户矿机市场:比特大陆已在出货 8.9 J/TH 的机器,挑战者纷纷退场;电力站点如今改作 AI 数据中心比用来挖矿更值钱。小团队不应做独立的训练芯片。推理芯片在签下客户后值得做,ZK 加速器是对冲,FHE 加速器是面向 2027–2029 年的早期布局。
工艺节点与分阶段预算
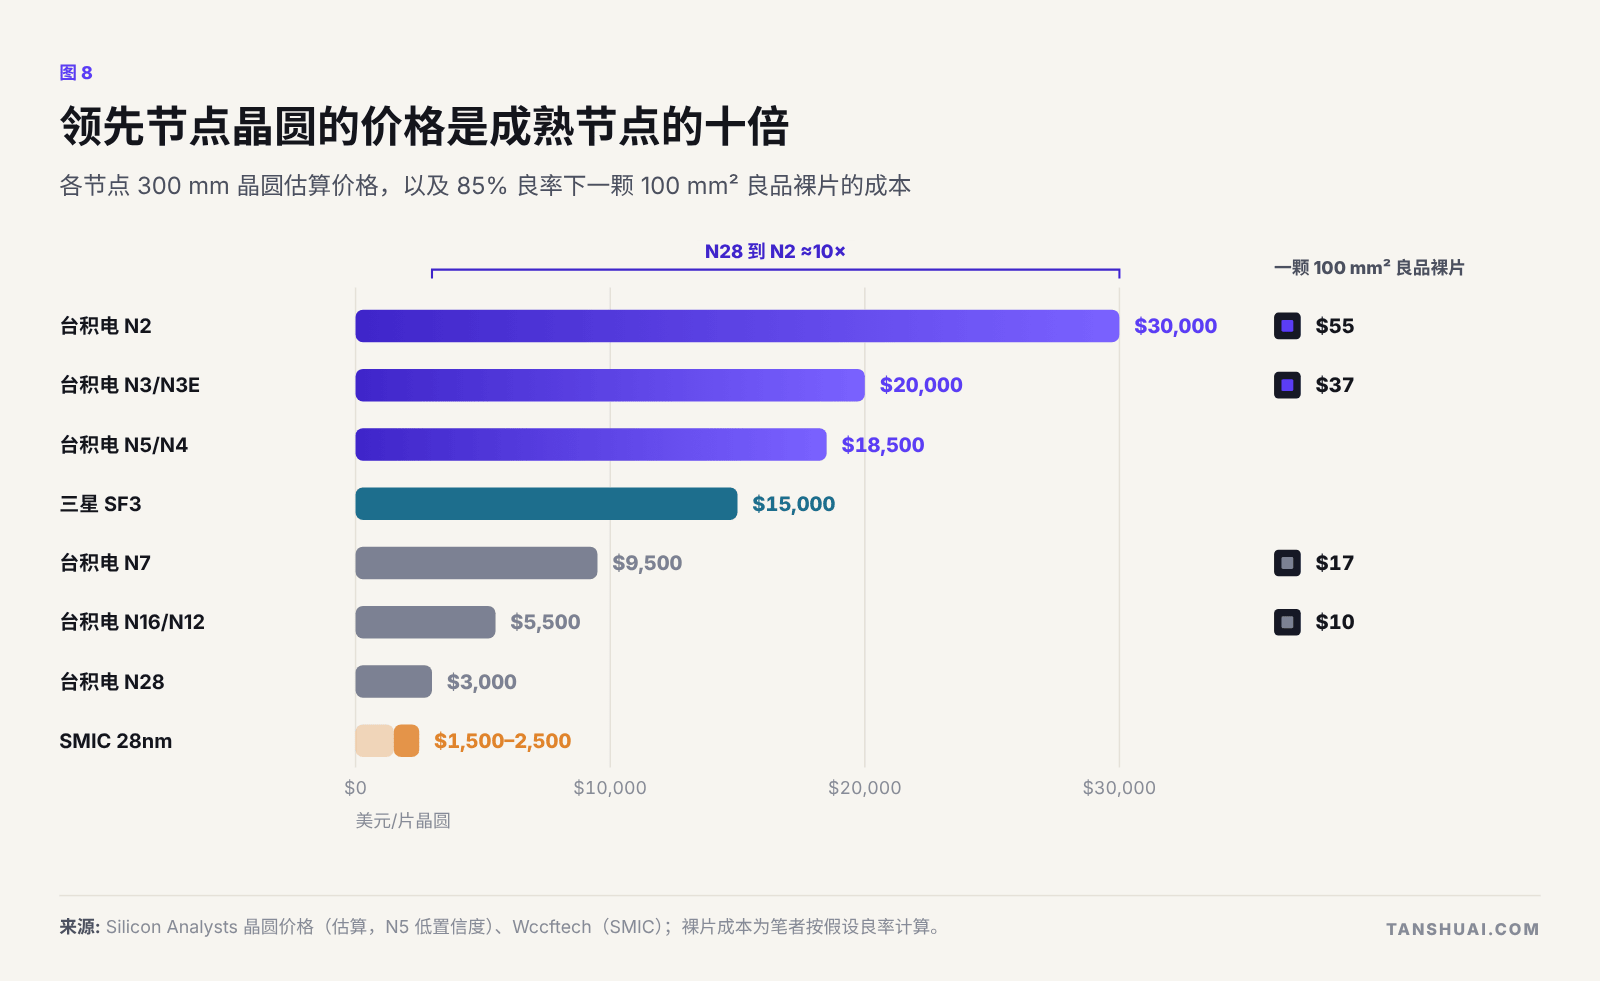 图 8. 领先节点晶圆的价格是成熟节点的十倍。
让芯片终生成本中最大的一项来选节点:全天候运行的算力芯片看能耗,训练芯片看封装与 HBM(约占 H100 成本的 63%),推理芯片看 SRAM 还是 HBM。PoUW 矿机芯片可以先在 28nm 或 16/12nm 多项目晶圆上做原型,只有在算法与收益稳定之后,才转向 N7/N6,再到 N5/N4。
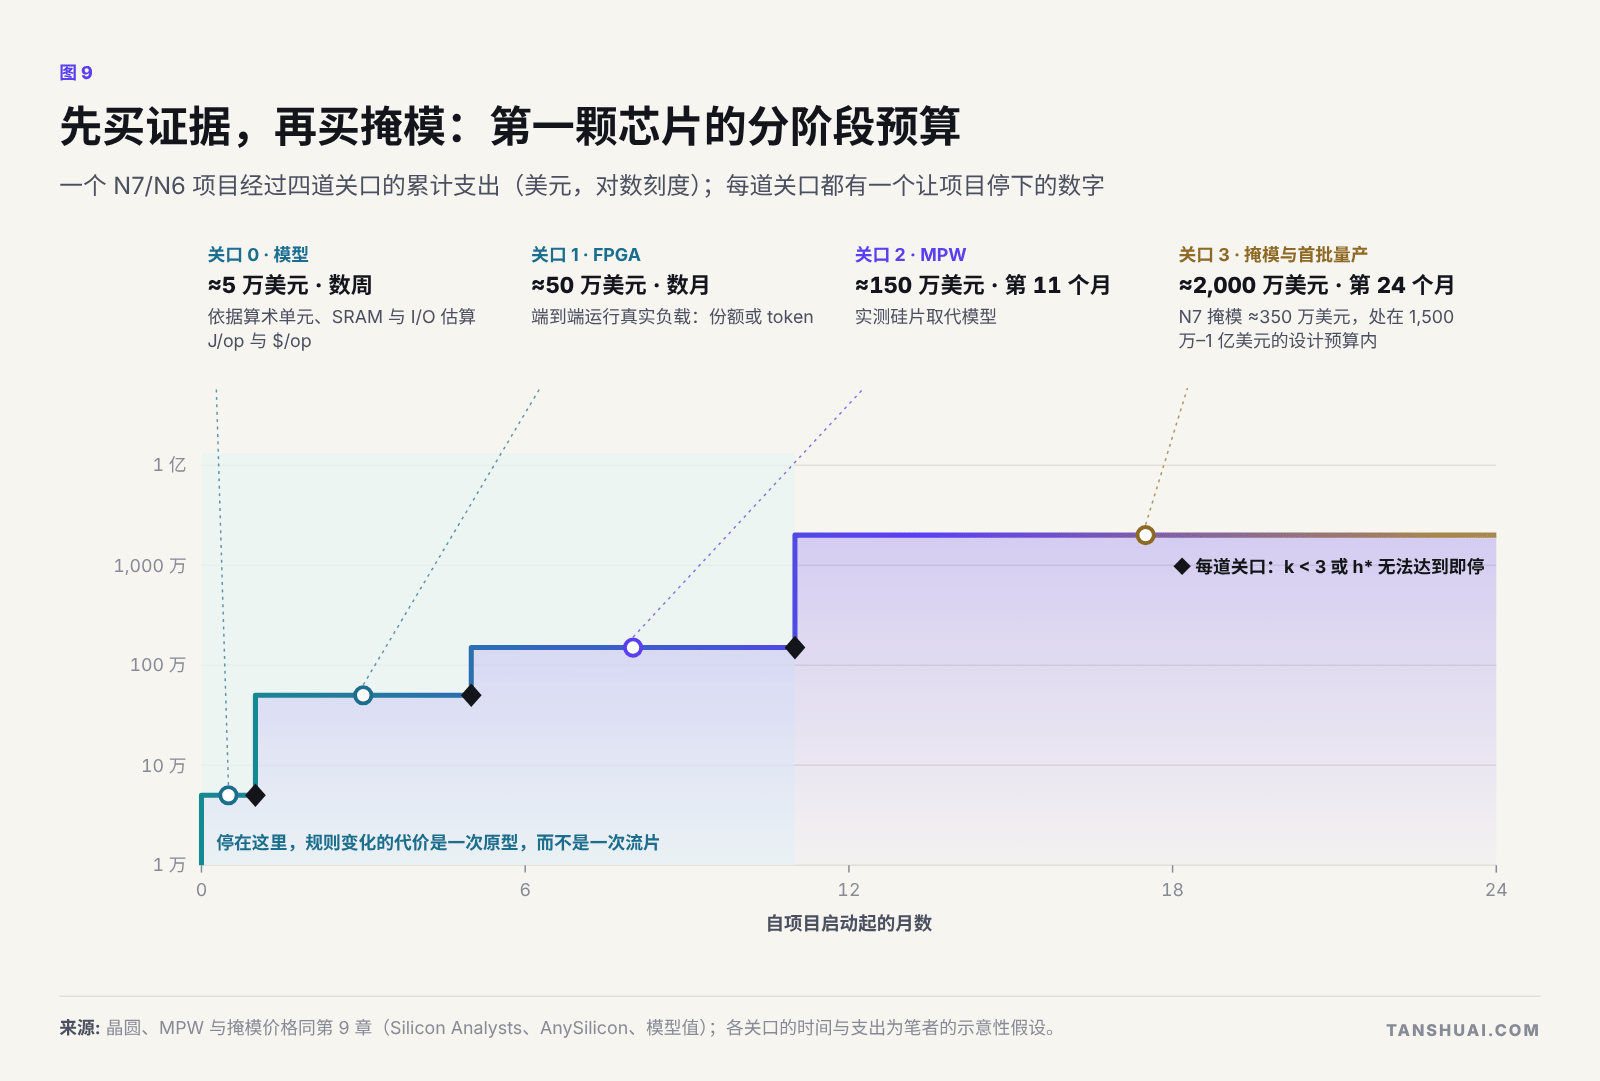 图 9. 先买证据,再买掩模:第一颗芯片的分阶段预算。
第一颗芯片应分四个阶段购买,每个阶段都有一个让项目停下的数字:J/op 与 $/op 的模型、运行真实负载的 FPGA、多项目晶圆,最后才是掩模组。在 N7/N6 上,前三个阶段约需 150 万美元、十一个月;掩模组与首批量产的花费是其十倍以上 [笔者测算]。如果协议改了算术,或者买家走了,停在晶圆阶段的团队损失的是一次原型的钱,而不是一次流片的钱。最便宜的能效来自架构:让操作数驻留 SRAM、去掉 HBM,在选择任何节点之前就已省掉 GPU 的大部分成本。
我会从哪里开始
机会在各领域的交叉处:以 Crypto 为第一个客户,以 AI 为第二市场。2026 年的定制芯片需求压倒性地来自 AI,而矿机芯片团队的技能——低压阵列、千瓦级供电与快速流片——可以直接迁移。我最多走三条路,每条都先用一个小的第一步检验:推理优先、可挖矿的加速器,从为期四周的 J/op 与 $/op 研究开始;以 Crypto 为第一个客户的定制芯片服务,从付费可行性研究开始;以及在设计代币之前先签下算力买家的 AI 原生网络。
下载完整报告与幻灯片
完整报告详细介绍了 Pearl 的机制、经济学与规则,其他有用工作量类链与更广的 AI × Crypto 版图,带回本测算的 ASIC 模型,逐类芯片的结论,节点成本与选择,第一颗芯片的分阶段预算,观察信号清单以及全部来源。
- 算力即共识:完整报告(PDF)
- 算力即共识:幻灯片(PDF)
- 英文版:完整报告 · 幻灯片
你没有问、但应该问的问题
在把资金或硅片投入任何 AI × Crypto 项目之前,我会问:谁控制工作函数;补贴倍数是多少;下一道关口要花多少钱、哪个数字会让你停下;回本算力是多少、p 取多少;芯片的第二市场是什么;价值落在代币里还是股权里;以及第一个付费客户是谁,叫什么名字。
这些是我们可以通过技术交流与技术合作共同探索的方向:面向挖矿、AI 训练与推理的定制芯片及各类加速器;AI 研发;以及从链到节点再到芯片的 AI × Crypto 系统。欢迎通过 i@tanshuai.com 与我联系。
关于作者
谭帅是一名技术专家与创业者,在芯片、硬件与系统软件领域工作二十余年,拥有 20 项已授权专利。他有多年无晶圆厂芯片研发与管理经验,包括加密货币矿机芯片与多媒体摄像头芯片的全定制 ASIC 数据通路设计。他的工作经历遍及硅谷、纽约、芝加哥、台湾地区、大湾区(深圳与香港)、越南和马来西亚。如今他是一名 AI 研发者。
技术交流:i@tanshuai.com。