
いまやブロックチェーンが、AIと同じ行列積の上で約90 EH/sで動いている。私はそのコード、チェーンデータ、それを取り巻く経済を読み、三つの問いに答えようとした。AI × 暗号資産のうち何に支払う顧客がいるのか、ASICはいつ作る価値があるのか、どのプロセスノードがどのチップに合うのか。レポート全文とスライド付き。
要旨
2026年4月にローンチしたPearlは、AI型の行列積を大規模にプルーフ・オブ・ワークとする初のブロックチェーンである。2026年11月13日、そのネットワークは約90 EH/sで稼働していた。1 Hは1回のINT7積和演算であり、これはH100約122,000基分の整数演算性能にあたる。工学としては機能している。だがまだ有用ではない。実際のAI作業を含むブロックは約1%にすぎない。推論を提供しながらマイニングするGPUは、専用マイナーのハッシュレートの1%から27%しか得られないからである。AI × 暗号資産全体で、検証可能な有償需要が現れているのは三つの場所、推論の販売、データの販売、プライバシーの販売であり、補助金は外部収益の4倍から360倍に及ぶ。チップについて言えば、ASICの利益上限は計算量あたり収益に (1 − 1/k) を掛けたものなので、k = 5を超える効率はほとんど上乗せにならない。決めるのはパイの大きさ、ルールの安定性、そして第二の市場である。今日、三つすべてを備えたネットワークはない。適切なプロセスノードはチップの生涯コストの最大項目が決め、チップそのものは段階を踏んで買うべきである。そうすればルールが変わっても、失うのはテープアウトではなく試作の費用で済む。
なぜこれを調べたのか
私は長年チップを設計してきた。暗号資産マイニング用のフルカスタムASICデータパスもその一つであり、今はAIに取り組んでいる。セキュリティ予算が文字どおりテンソル演算性能で値付けされるチェーンが現れたとき、私のような者にとっての問いは明らかだった。その作業は有用なのか、専用チップは勝てるのか、作るにはいくらかかるのか。
私はPearlのコードとプロトコル提案、独立したフルノードのチェーンデータ、企業の開示資料、暗号学・コンピュータアーキテクチャ・機械学習の論文、ファウンドリとベンダーの価格データ、そして業界紙を読んだ。以下の数値はすべて2026年11月13日時点のもので、金額は米ドルである。このノートは私がこの分野を学んだ記録であり、他の人が検証し、使い、反論できるように公開する。すべての出典を含むレポート全文は末尾にある。
結果の概要
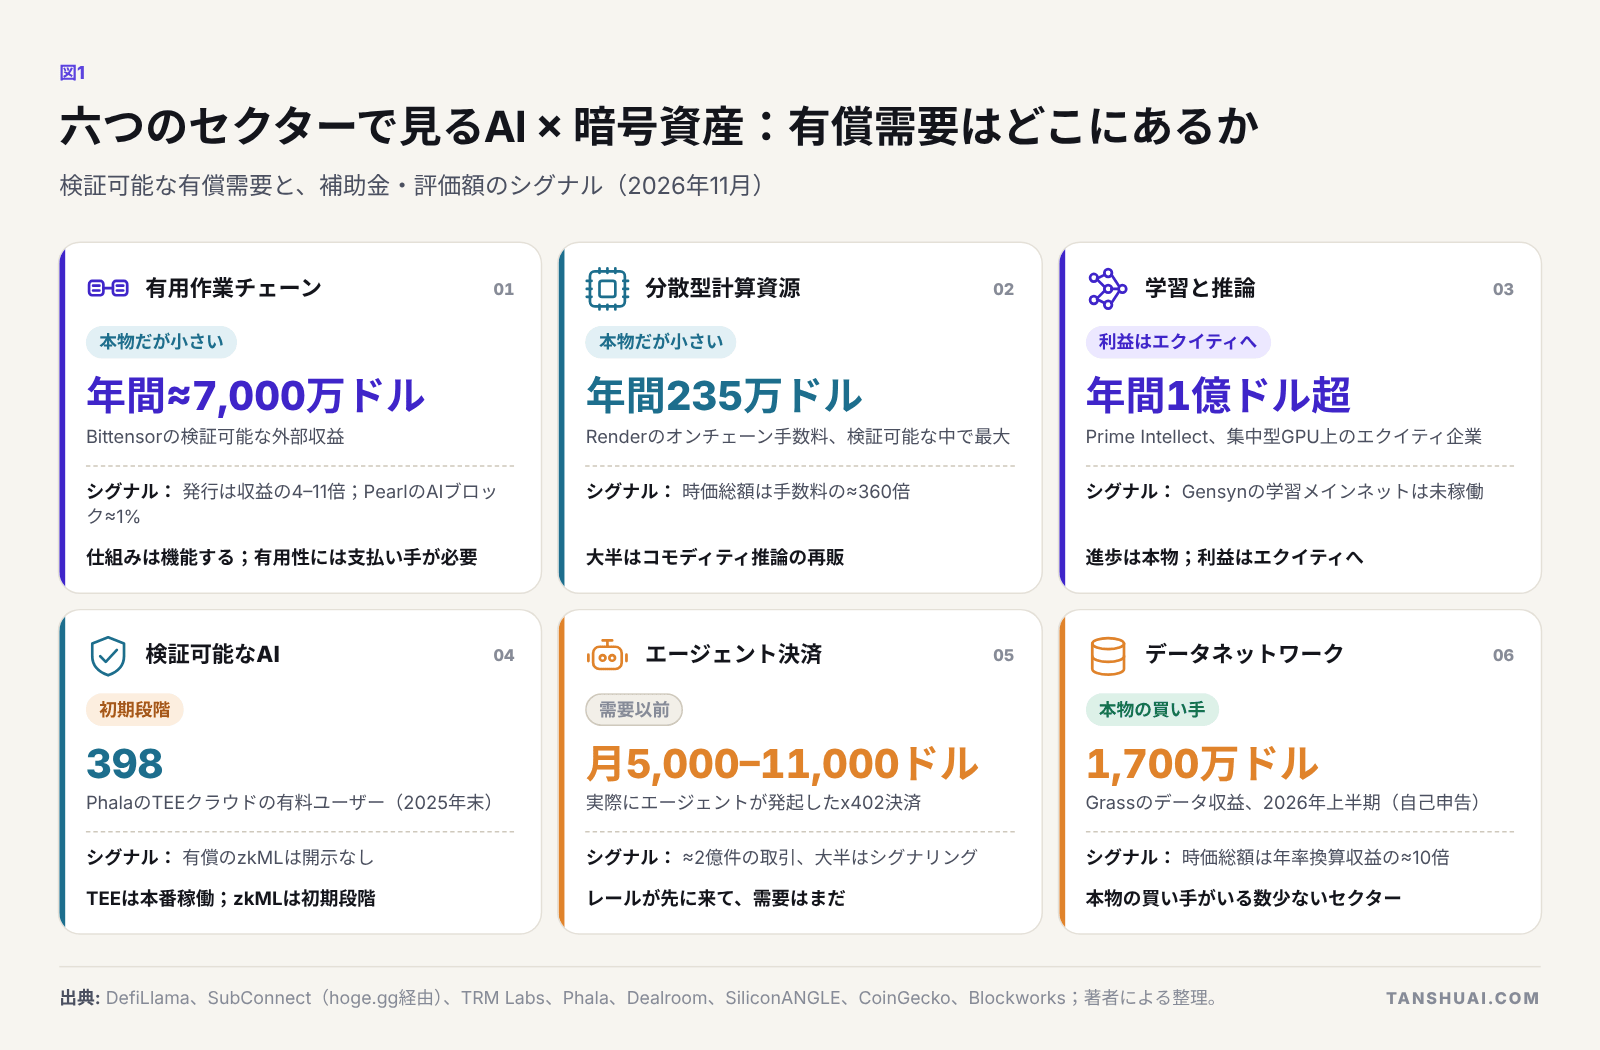 図1. 六つのセクターで見るAI × 暗号資産:有償需要はどこにあるか。
| 問い | 短い答え |
|---|---|
| Pearlは機能するか、その作業は有用か | 機能する:約90 EH/sの行列積がチェーンを守っている。まだ有用ではない:AI作業を含むブロックは約1% |
| 本当の有償需要はどこにあるか | 推論、データ、プライバシー。エージェント決済、zkML、分散型学習はまだ需要以前 |
| ASICは作る価値があるか | 大きなパイ、安定したルール、第二の市場がある場合に限る。今日、三つすべてを備えたネットワークはない |
| 小さなチームはどのチップを作るべきか | マイニングもできる推論優先のアクセラレータ、契約済み顧客向けの推論チップ、早期のFHE開発。マーチャント型ビットコインマイナーや学習チップではない |
| 最初のチップにはいくらかかるか | 段階を踏んで買う:モデル、FPGA、MPWで約150万ドルで実測のシリコンに至り、その後に数百万ドルのマスクが来る |
Pearl:1回の積和演算が1ハッシュ
Pearlは、Ilan KomargodskiとOmri Weinsteinによる2025年の成果に立脚している。任意の行列積に対して、乗算のコストの1 + o(1)倍で済む有用作業証明である。マイナーはノイズ付き行列を掛け合わせ、各出力タイルのアキュムレータをハッシュして宝くじの券にし、当選したタイルを60 KB未満のゼロ知識証明で証明する。コンセンサスコードでは、1 Hは1回のクレジットされたINT7 × INT7 → INT32積和演算である。こうして初めて、ブロックチェーンのセキュリティ予算がAIアクセラレータのテンソル演算性能で値付けされた。
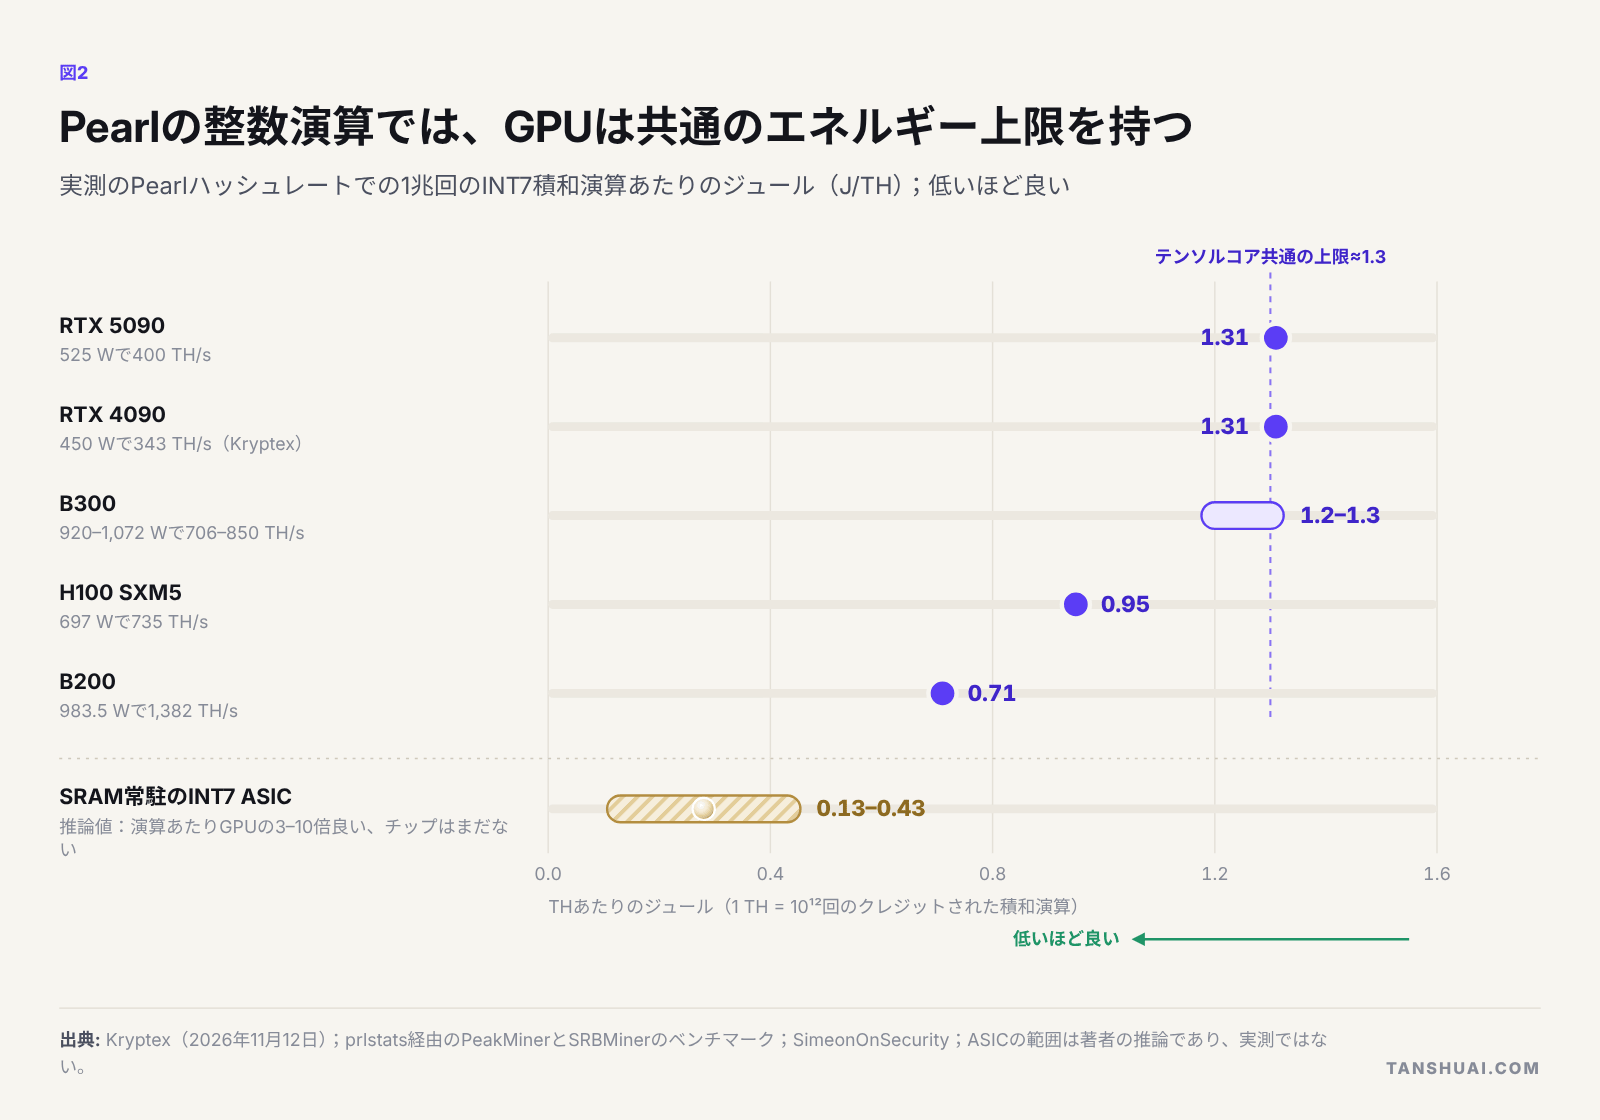 図2. Pearlの整数演算では、GPUは共通のエネルギー上限を持つ。
ゲーミングカードとデータセンター向けのB300は約1.3 J/THで並び、B200でさえ0.71にとどまる。この共通の上限こそ、専用チップが破りうるものである。オンチップSRAMから7ビット整数を掛けるだけで、HBMも汎用ユニットも持たない部品なら、演算あたり3倍から10倍良くなることも十分ありうる。その一方でNVIDIAは最新のシリコンをINT8からFP8とFP4へ移しつつあり、だからこそPearlは演算方式の変更を準備している。
Pearlの経済性:定理は成り立つが、インセンティブは成り立たない
Pearlのハッシュレートは価格に従う。ネットワークは2日目の0.01 EH/sから5月末には23–26 EH/sに達し、価格が約86%下落した夏の間は21–39 EH/sを保ち、秋に価格が約10倍に上昇すると約90 EH/sに達した。現在の供給量のおよそ32%にあたる約1億2,000万コインが最初の6日間で採掘され、供給は今後12か月で約78%増える。RTX 5090は現在1日約5〜6ドルを稼ぐ。
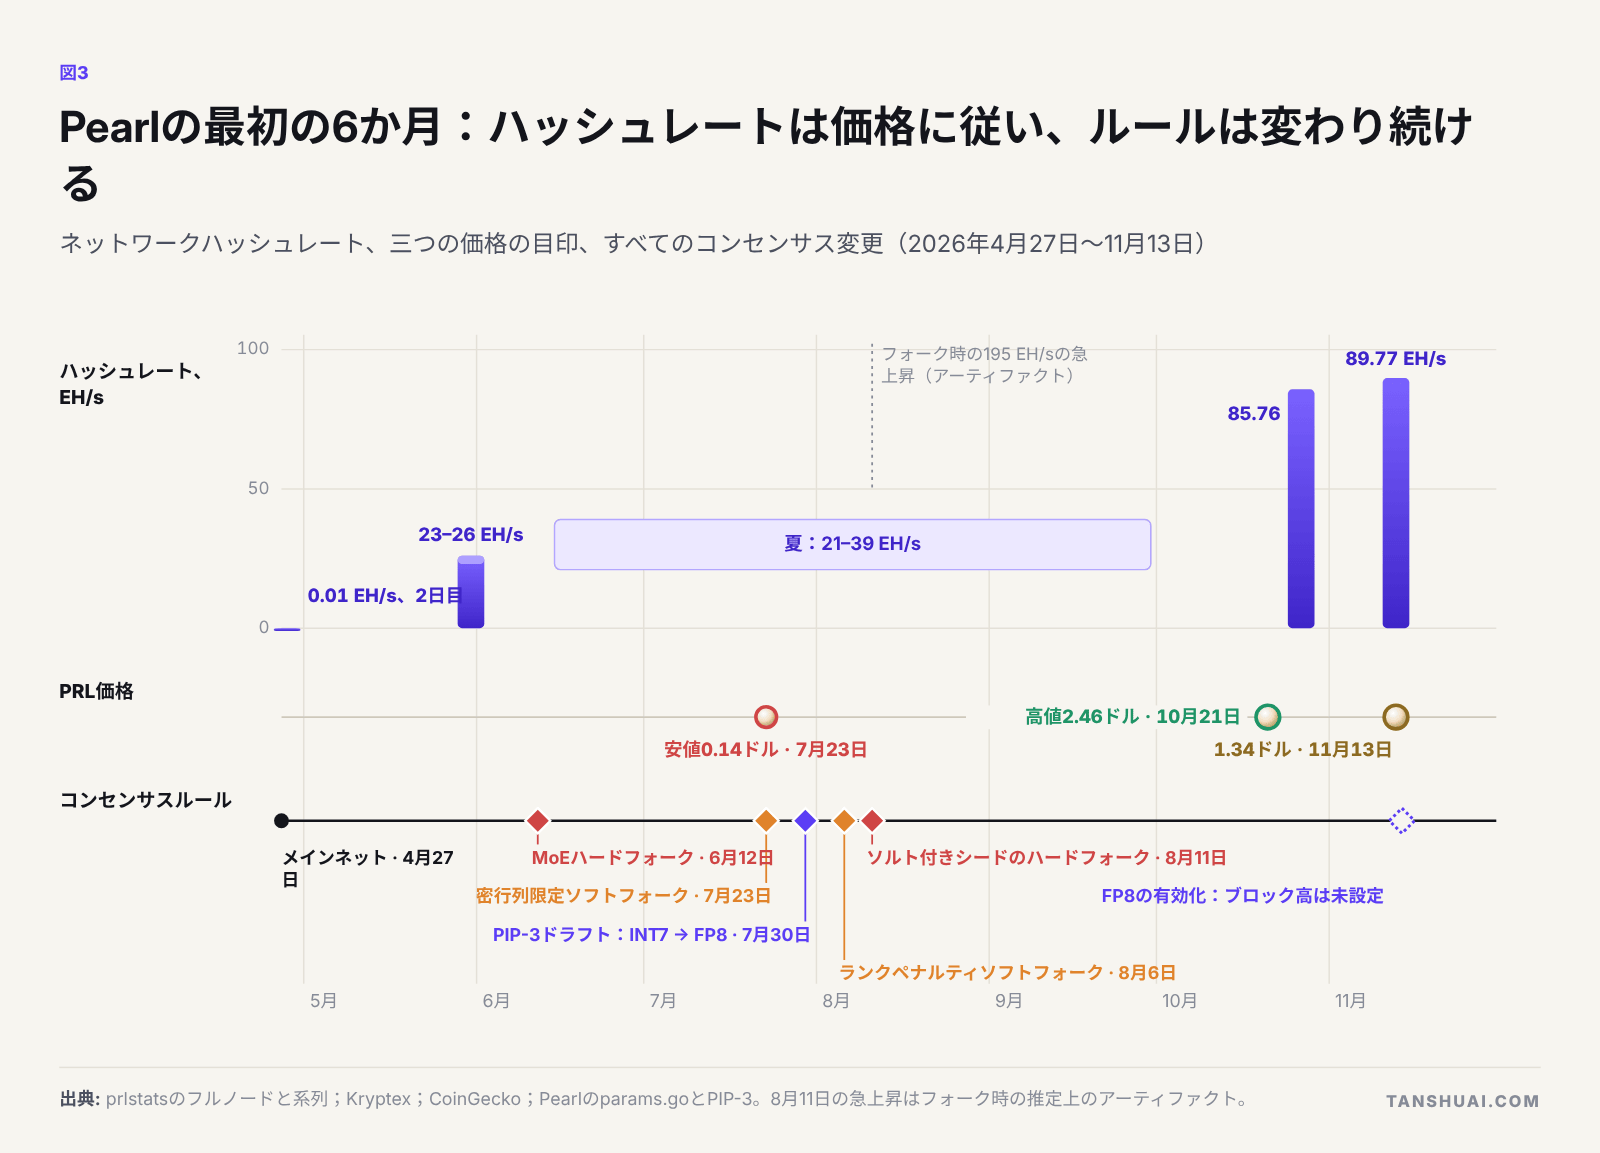 図3. Pearlの最初の6か月:ハッシュレートは価格に従い、ルールは変わり続ける。
モデルが崩れるのは有用な部分である。本物の推論の中でマイニングすることは、推論側ではスループットの約5%から9%とわずかなコストで済むが、マイニング側の稼ぎもわずかである。Pearlのプラグインは長いプリフィルバッチでしかマイニングしないので、チャットのワークロードを提供するカードは専用マイナーのハッシュレートの約5%しか得られない。だから合理的なマイナーはランダムな行列を掛け合わせ、プロトコルはそれを見分けられない。唯一公開されている推論パートナーシップは、提供元のサーバーレスAPIではもう提供されていない。Pearlの有用性はオフチェーンの商業的な問題であり、誰かが推論に支払わなければならない。
ルールはもう一つのリスクである。6月から8月にかけて、ラボはハードコードされたブロック高で四つのコンセンサス変更を有効化し、そのドラフトPIP-3は、NVIDIAの二つのアーキテクチャだけに向けたビット単位で一致するデバイスプロファイルで、マイニングをFP8へ移す。数値形式は、AIに有用であること、ビット単位で検証可能であること、ハードウェア中立であることのうち、多くても二つしか満たせない。
AI × 暗号資産全体:補助金は燃料であり、ビジネスモデルではない
他の有用作業チェーンも同じ話をしている。Kaspaはハッシュの中に行列積を入れたが、それでも16か月以内にASICが現れ、最良のマシンは今や1日0.86ドルを稼ぐにすぎない。Aleoの合成証明パズルには5か月で専用ハードウェアが現れ、プルーバーに手数料の175–180倍を支払った。Bittensorはこのグループで一定規模の外部収益を持つ唯一のネットワークで、年間約7,000万ドルの収益に対し、発行は3億ドルを超える。
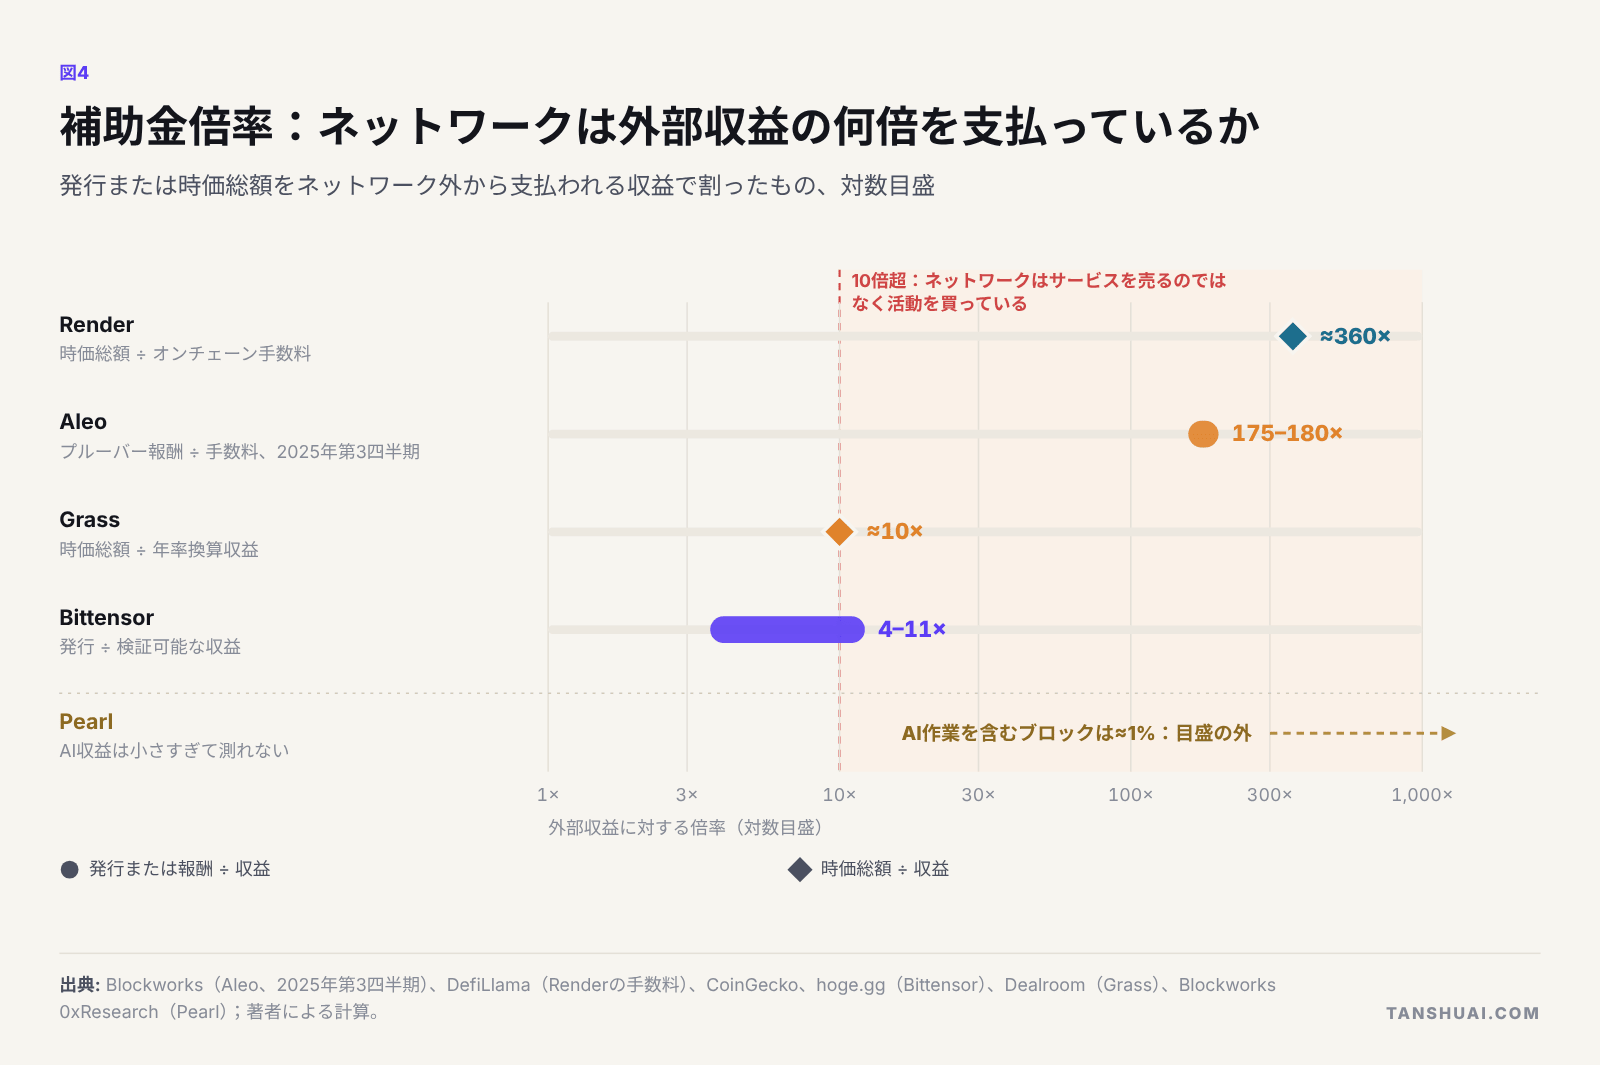 図4. 補助金倍率:ネットワークは外部収益の何倍を支払っているか。
コンセンサスの外では、小さな規模の本物の需要という姿になる。分散型GPU市場はコモディティ推論を売っており、ハイパースケーラーの価格には勝つが、最も安いネオクラウドには勝てない。インターネット越しの学習は80億から400億パラメータで機能しているが、フロンティアの実行は集中型クラスタに戻った。信頼実行環境は本番で秘密推論を動かしているが、AIのゼロ知識証明はまだ研究段階である。AIエージェントが発起した決済は、Visa、Mastercard、Stripe、Googleが作ったレールがあるにもかかわらず、月約5,000〜11,000ドルにとどまる。データは本物の買い手がいる数少ないセクターの一つである。その一方で、集中型インフラ上のエクイティ企業4社の価値は、プロトコル層とアプリケーション層のAIトークンをすべて合わせたものとほぼ同じである。暗号資産は流通と決済を担い、利益はエクイティが取る。
ASICが報われるとき:一つの公式、三つの物差し
GPUがマイニングの価格を決めるとき、計算量あたり収益はそのコストに近づき、k倍安いASICが手元に残せるのは収益の最大 (1 − 1/k) である。この曲線は凹である。k = 2で50%、k = 5で80%、k = 10で90%。k = 5を超えると効率を上げても利益はほとんど増えない。そして電気代だけを払う遊休GPUに対しては、実効kは約2.5にすぎないかもしれない。
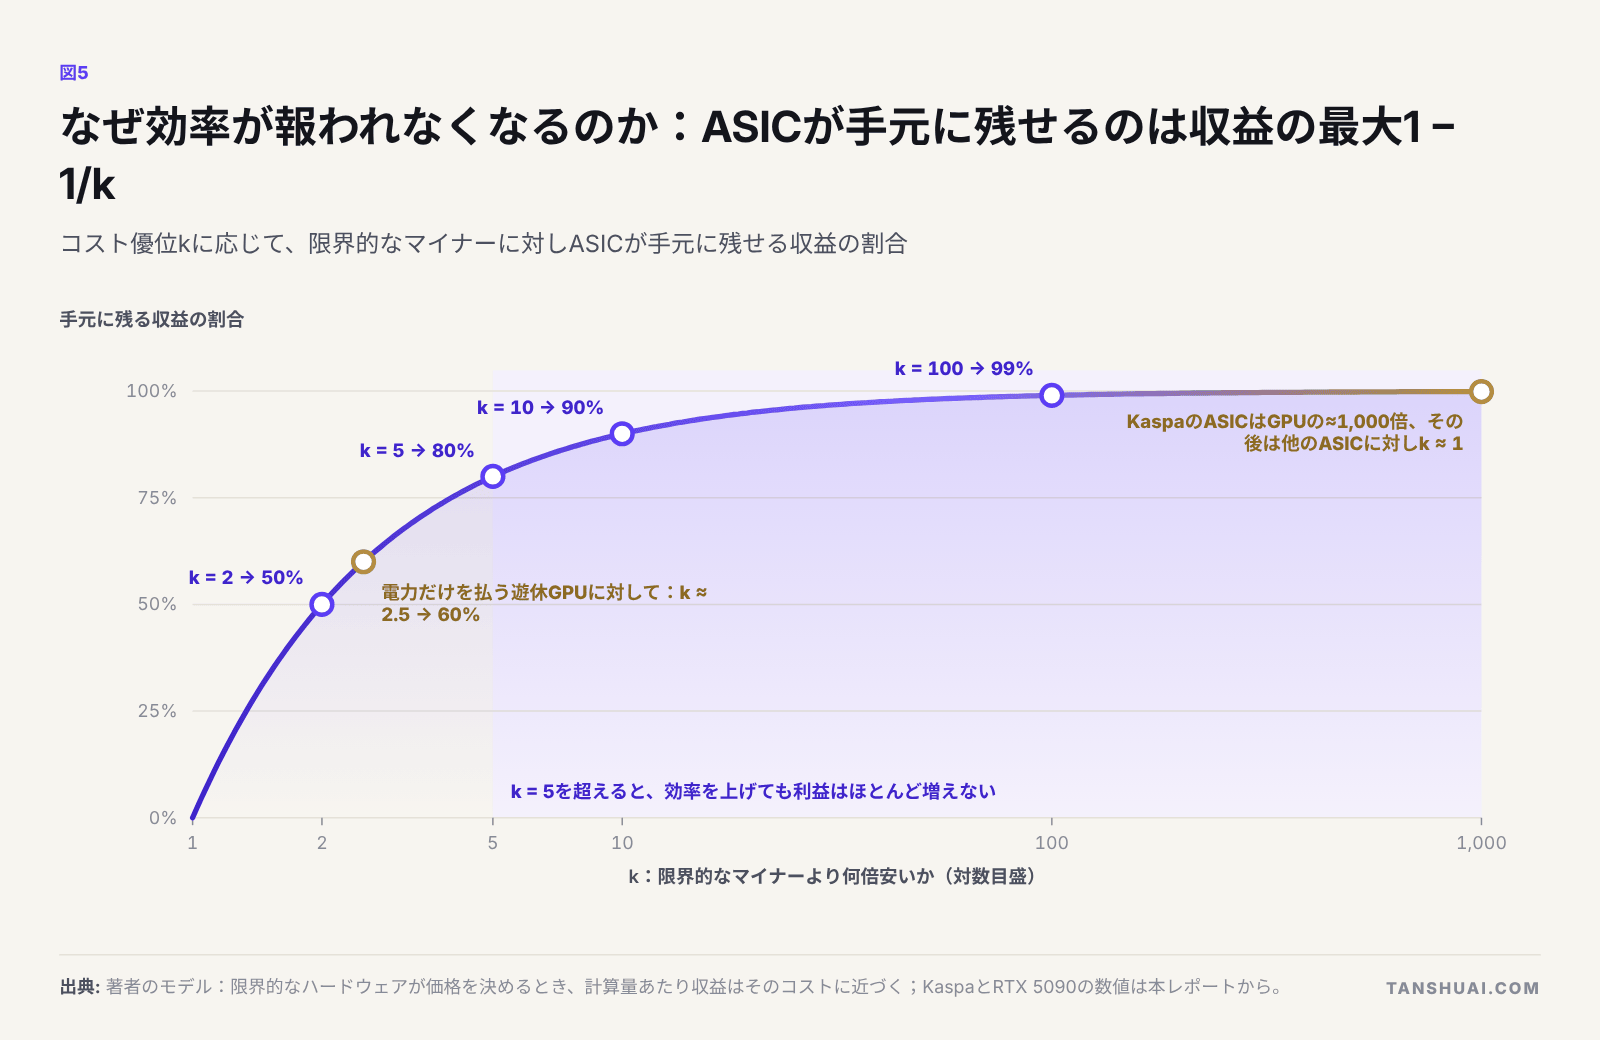 図5. なぜ効率が報われなくなるのか:ASICが手元に残せるのは収益の最大1 − 1/k。
そこから三つの物差しが決める。パイ、回収規模、ルールである。ビットコインマイナーは年間約115億ドル、Pearlは約4.6億〜4.9億ドル、Aleoは約3,100万ドル、Kaspaは約1,800万ドルを稼ぐ。最後のものは5/4 nmチップ1品種の設計予算の下限より少ない。Pearlでは、k = 5の2,000万ドルのチップを回収するには、ルールが維持されれば約4.9 EH/sを1年間稼働させる必要があり、維持の確率が五分五分ならその2倍が必要である。
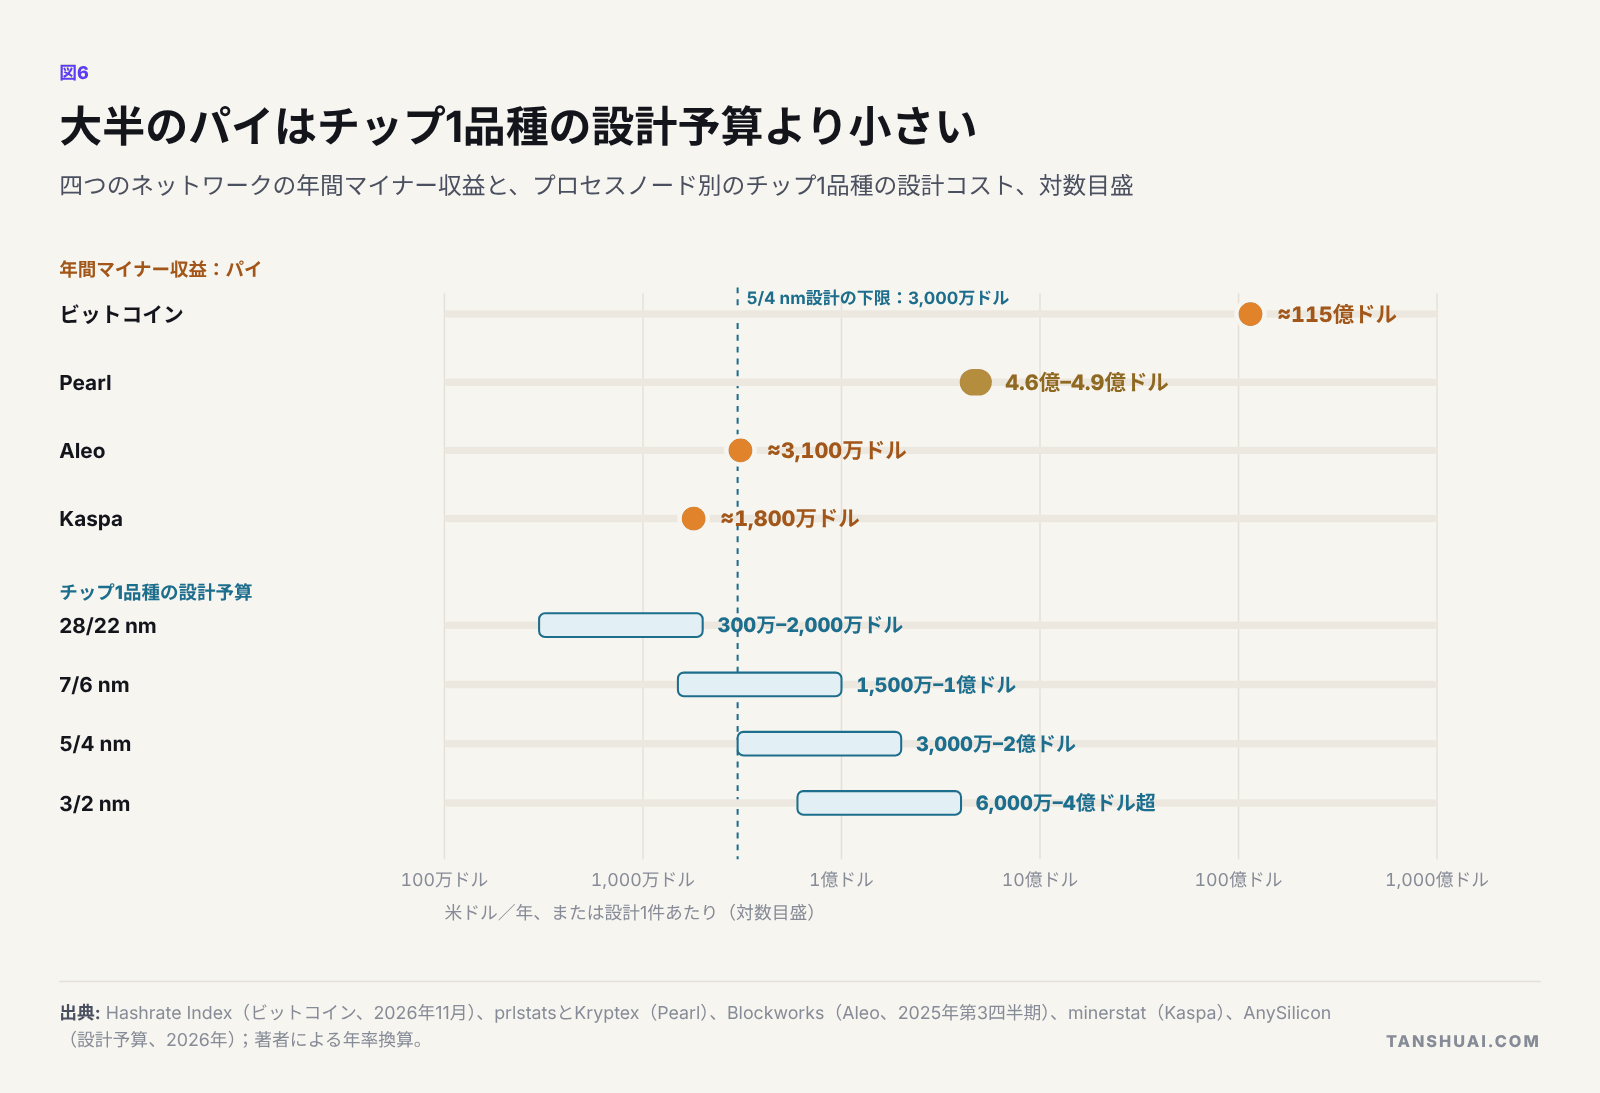 図6. 大半のパイはチップ1品種の設計予算より小さい。
今日、大きなパイ、安定したルール、1を超えるkを同時に備えたネットワークはない。ビットコインのkは既存勢力のもの、Pearlのルールは最も不安定、KaspaとAleoのパイは小さすぎる。
五つのチップの種類、五つの答え
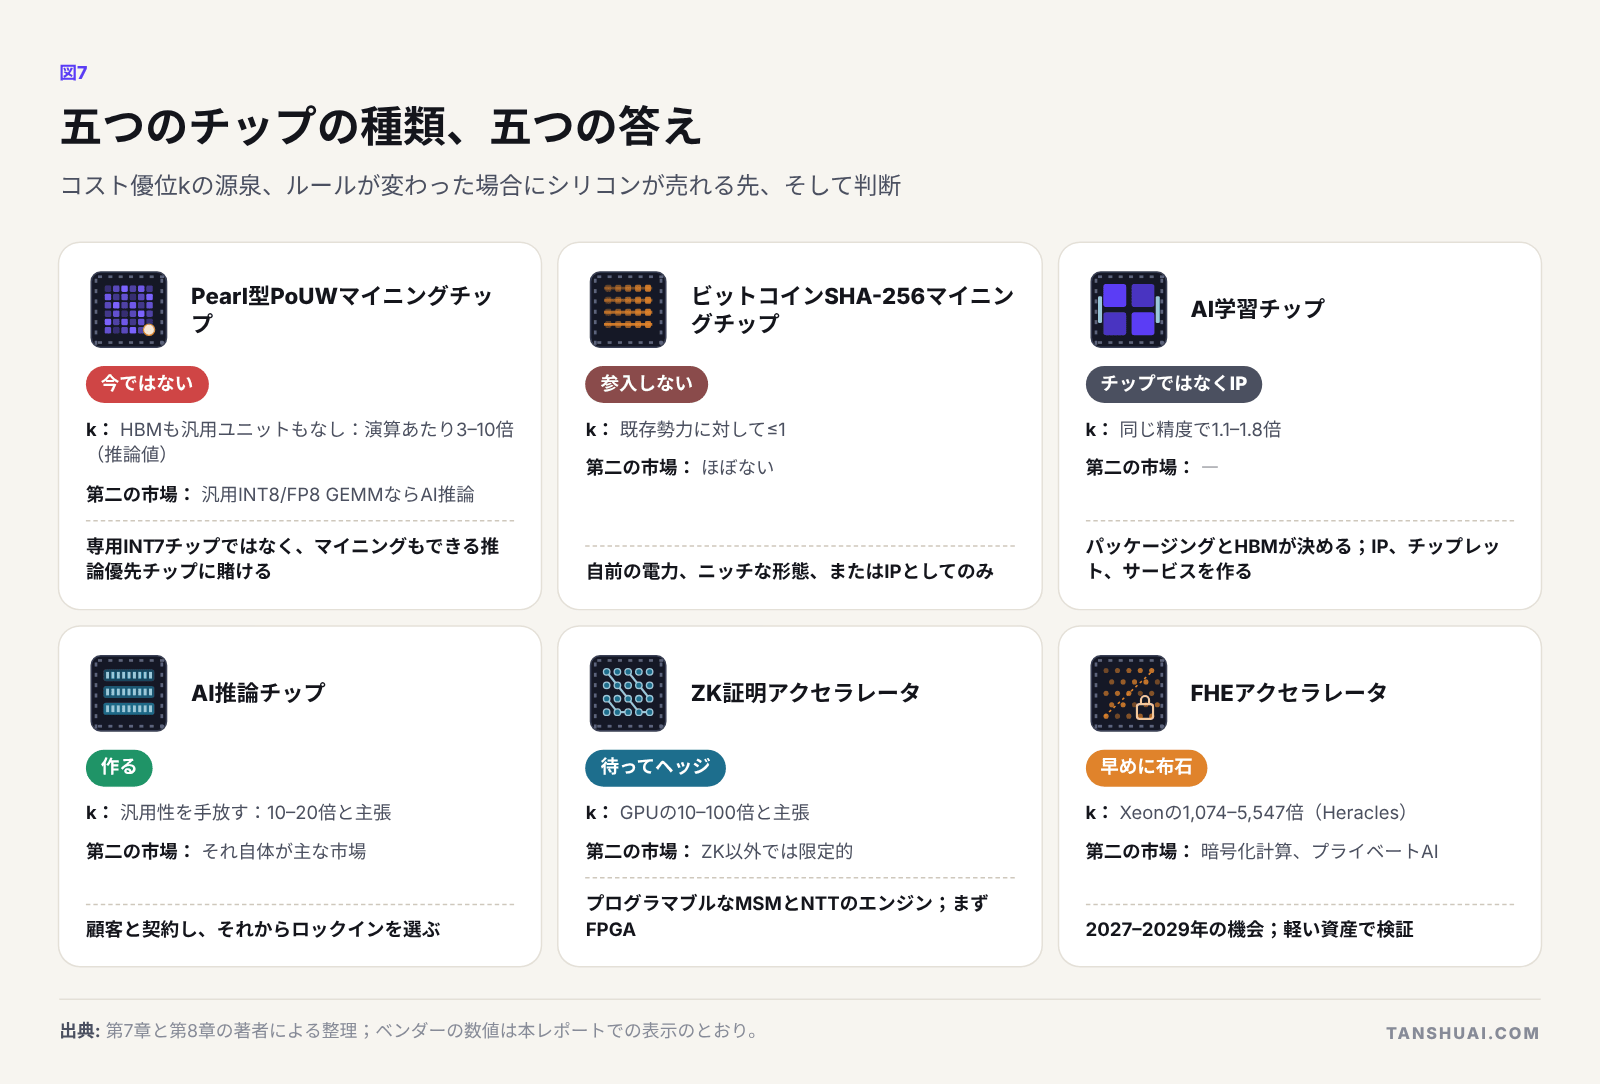 図7. 五つのチップの種類、五つの答え。
Pearlについては、今は専用INT7チップをテープアウトしない。新しいチームには18から24か月かかり、その頃にはプロトコルがFP8へ移っているかもしれない。より良い賭けは、オペランドをSRAMに置いた汎用INT8/FP8 GEMMの上に作る推論優先のアクセラレータである。そうすればマイニングへのアクセスが閉ざされても、シリコンには第二の市場がある。新しいチームはマーチャント型ビットコインマイナー市場には入らないほうがよい。そこではBitmainが8.9 J/THのマシンを出荷し、挑戦者は撤退しつつある。電力サイトは今や鉱山としてよりAIデータセンターとしてのほうが価値がある。小さなチームは単体の学習チップを作るべきではない。推論チップは契約済みの顧客のためなら作る価値があり、ZKアクセラレータはヘッジ、FHEアクセラレータは2027–2029年に向けた早めの布石である。
プロセスノードと段階的予算
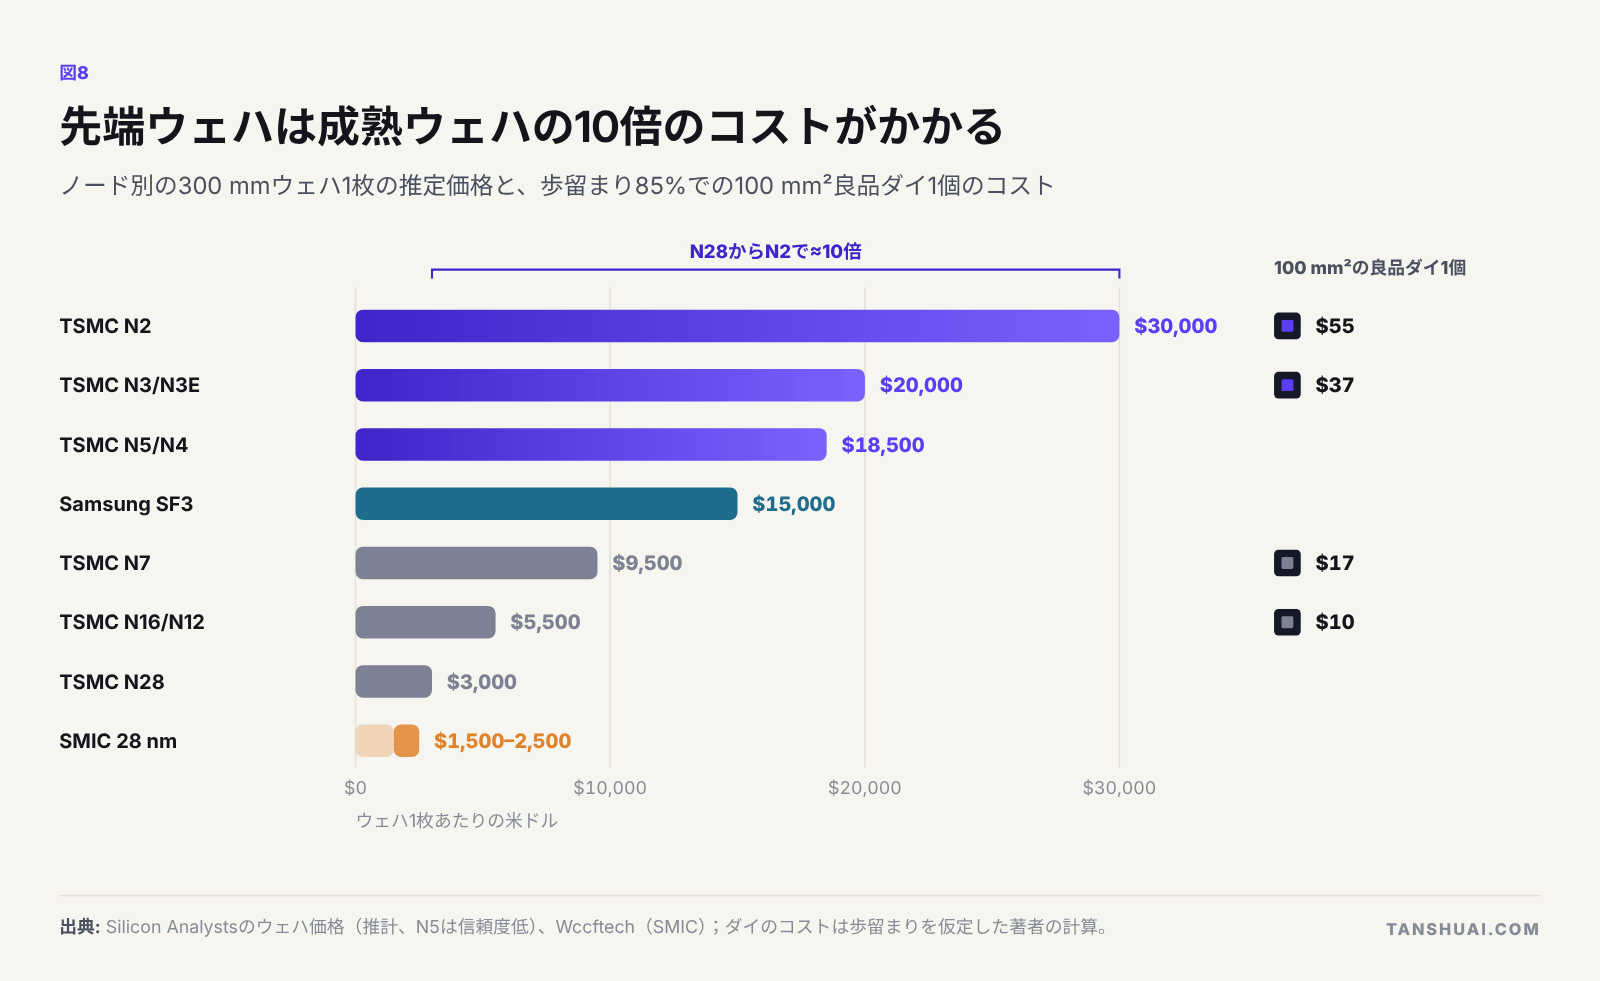 図8. 先端ウェハは成熟ウェハの10倍のコストがかかる。
ノードはチップの生涯コストの最大項目に選ばせる。常時稼働する計算チップならエネルギー、学習チップならパッケージングとHBM(H100のコストの約63%)、推論チップならSRAMかHBMかの選択である。PoUWマイニングチップは28または16/12 nmのマルチプロジェクトウェハで試作でき、N7/N6、さらにN5/N4へ移るのはアルゴリズムと収益が安定してからでよい。
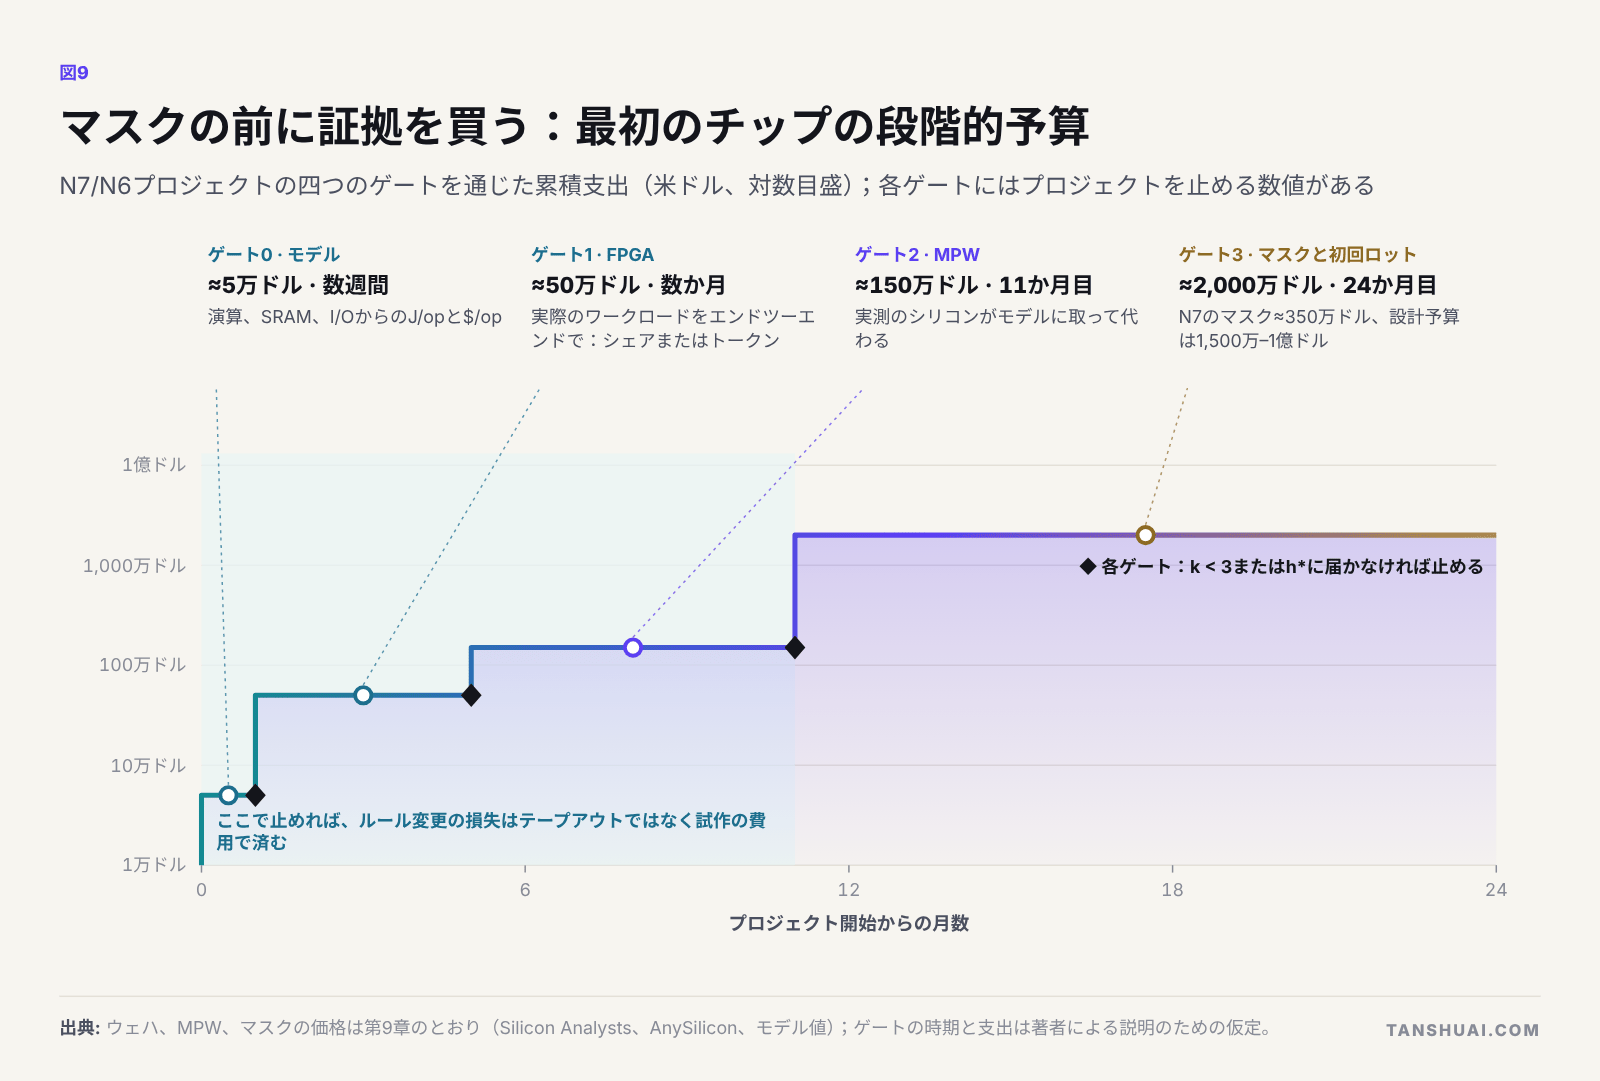 図9. マスクの前に証拠を買う:最初のチップの段階的予算。
最初のチップは四つの段階で買うべきであり、各段階にはプロジェクトを止める数値を置く。J/opと$/opのモデル、実際のワークロードを動かすFPGA、マルチプロジェクトウェハ、そしてその後で初めてマスクセットである。N7/N6では最初の三つで約150万ドルと11か月かかり、マスクセットと初回ロットはその10倍以上かかる[推計]。プロトコルが演算方式を変えたり、買い手が去ったりしても、ウェハの段階で止めたチームが失うのはテープアウトではなく試作の費用である。最も安い効率はアーキテクチャから得られる。オペランドをSRAMに置き、HBMを省けば、ノードを選ぶ前にGPUのコストの大半がなくなる。
私ならどこから始めるか
機会は分野が交差する場所にある。暗号資産を最初の顧客に、AIを第二の市場にすることである。2026年のカスタムチップの需要は圧倒的にAIであり、マイニングチップのチームの技術、すなわち低電圧アレイ、キロワット級の電力供給、速いテープアウトはそのまま移転できる。私なら道は多くても三つとし、それぞれ小さな最初の一歩で検証する。マイニングもできる推論優先のアクセラレータは4週間のJ/opと$/opの調査から始める。暗号資産を最初の顧客とするカスタムシリコンサービスは有償の実現可能性調査から始める。そしてAIネイティブなネットワークは、トークンを設計する前に計算資源の買い手と契約する。
レポート全文とスライドのダウンロード
レポート全文は、Pearlの仕組み、経済性、ルールの詳細、他の有用作業チェーンとより広いAI × 暗号資産の全体像、回収計算を含むASICのモデル、チップの種類ごとの判断、ノードのコストと選択、最初のチップの段階的予算、注目点の一覧、そしてすべての出典を扱っている。
本書は英語版の翻訳であり、両者に相違がある場合は英語版が優先する。
尋ねなかったが、尋ねるべきだった質問
AI × 暗号資産のどのプロジェクトであれ、資金やシリコンを投じる前に私はこう尋ねる。作業関数を支配しているのは誰か。補助金倍率はいくつか。次のゲートの費用はいくらで、何の数値で止めるか。pを含めた回収に必要なハッシュレートはいくつか。チップの第二の市場は何か。価値はトークンとエクイティのどちらに着地するのか。そして最初に支払う顧客は誰か、名前で言えるか。
これらは、技術交流と技術協力を通じてともに探求できる領域である。マイニング、AIの学習と推論のためのカスタムチップとアクセラレータ、AI開発、そしてチェーンからノード、チップまでのAI × 暗号資産システムである。連絡先はi@tanshuai.comである。
著者について
タン・シュアイは技術者・創業者であり、チップ、ハードウェア、システムソフトウェアにわたる20年以上の経験と、20件の登録特許を持つ。ファブレスのチップ研究開発とマネジメントに長年携わり、暗号資産マイニングチップとマルチメディアカメラチップのフルカスタムASICデータパス設計も手がけてきた。その仕事はシリコンバレー、ニューヨーク、シカゴ、台湾、粤港澳大湾区(深圳と香港)、ベトナム、マレーシアに及ぶ。現在はAI研究者・開発者として活動している。
技術的な議論:i@tanshuai.com。