
Una cadena de bloques funciona ya con la misma multiplicación de matrices que la IA, a unos 90 EH/s. He leído su código, los datos de su cadena y la economía que la rodea para responder a tres preguntas: qué parte de IA × cripto tiene clientes que pagan, cuándo merece la pena construir un ASIC y qué nodo de proceso encaja con cada chip. Con el informe completo y las diapositivas.
Resumen
Pearl, lanzada en abril de 2026, es la primera cadena de bloques cuya prueba de trabajo es multiplicación de matrices al estilo de la IA y a gran escala. El 13 de noviembre de 2026 su red funcionaba a unos 90 EH/s, donde un H es una multiplicación-acumulación INT7: el rendimiento entero de unas 122.000 H100. Funciona como ingeniería. Todavía no es útil: cerca del 1 % de los bloques lleva trabajo real de IA, porque una GPU que mina mientras sirve inferencia conserva solo entre el 1 % y el 27 % del hashrate de un minero dedicado. En todo IA × cripto, la demanda de pago verificable aparece en tres lugares —vender inferencia, vender datos y vender privacidad—, mientras que los subsidios van de 4 a 360 veces los ingresos externos. En chips, el techo de beneficio de un ASIC son los ingresos por unidad de cómputo multiplicados por (1 − 1/k), así que la eficiencia más allá de k = 5 añade poco; lo que decide es el tamaño del bote, la estabilidad de las reglas y un segundo mercado. Hoy ninguna red ofrece las tres cosas. El nodo de proceso adecuado lo fija la mayor partida del coste de un chip a lo largo de su vida útil, y el propio chip debe comprarse por etapas, para que un cambio de reglas cueste un prototipo y no un tape-out.
Por qué me fijé en esto
He pasado muchos años diseñando chips, incluidas rutas de datos ASIC full-custom para la minería de criptomonedas, y ahora trabajo en IA. Cuando apareció una cadena cuyo presupuesto de seguridad se valora literalmente en rendimiento tensorial, las preguntas para alguien como yo eran evidentes: ¿es útil el trabajo?, ¿ganaría un chip dedicado? y ¿cuánto costaría construirlo?
He leído el código y las propuestas de protocolo de Pearl, datos de la cadena obtenidos de un nodo completo independiente, documentación presentada por empresas, artículos de criptografía, arquitectura de computadores y aprendizaje automático, datos de precios de fundiciones y fabricantes, y la prensa especializada. Todas las cifras que siguen son a 13 de noviembre de 2026, y los importes están en dólares estadounidenses. Esta nota es la forma en que aprendí el campo; la comparto para que otros puedan comprobarla, usarla y discutirla. El informe completo, con todas las fuentes, está al final.
Resultados de un vistazo
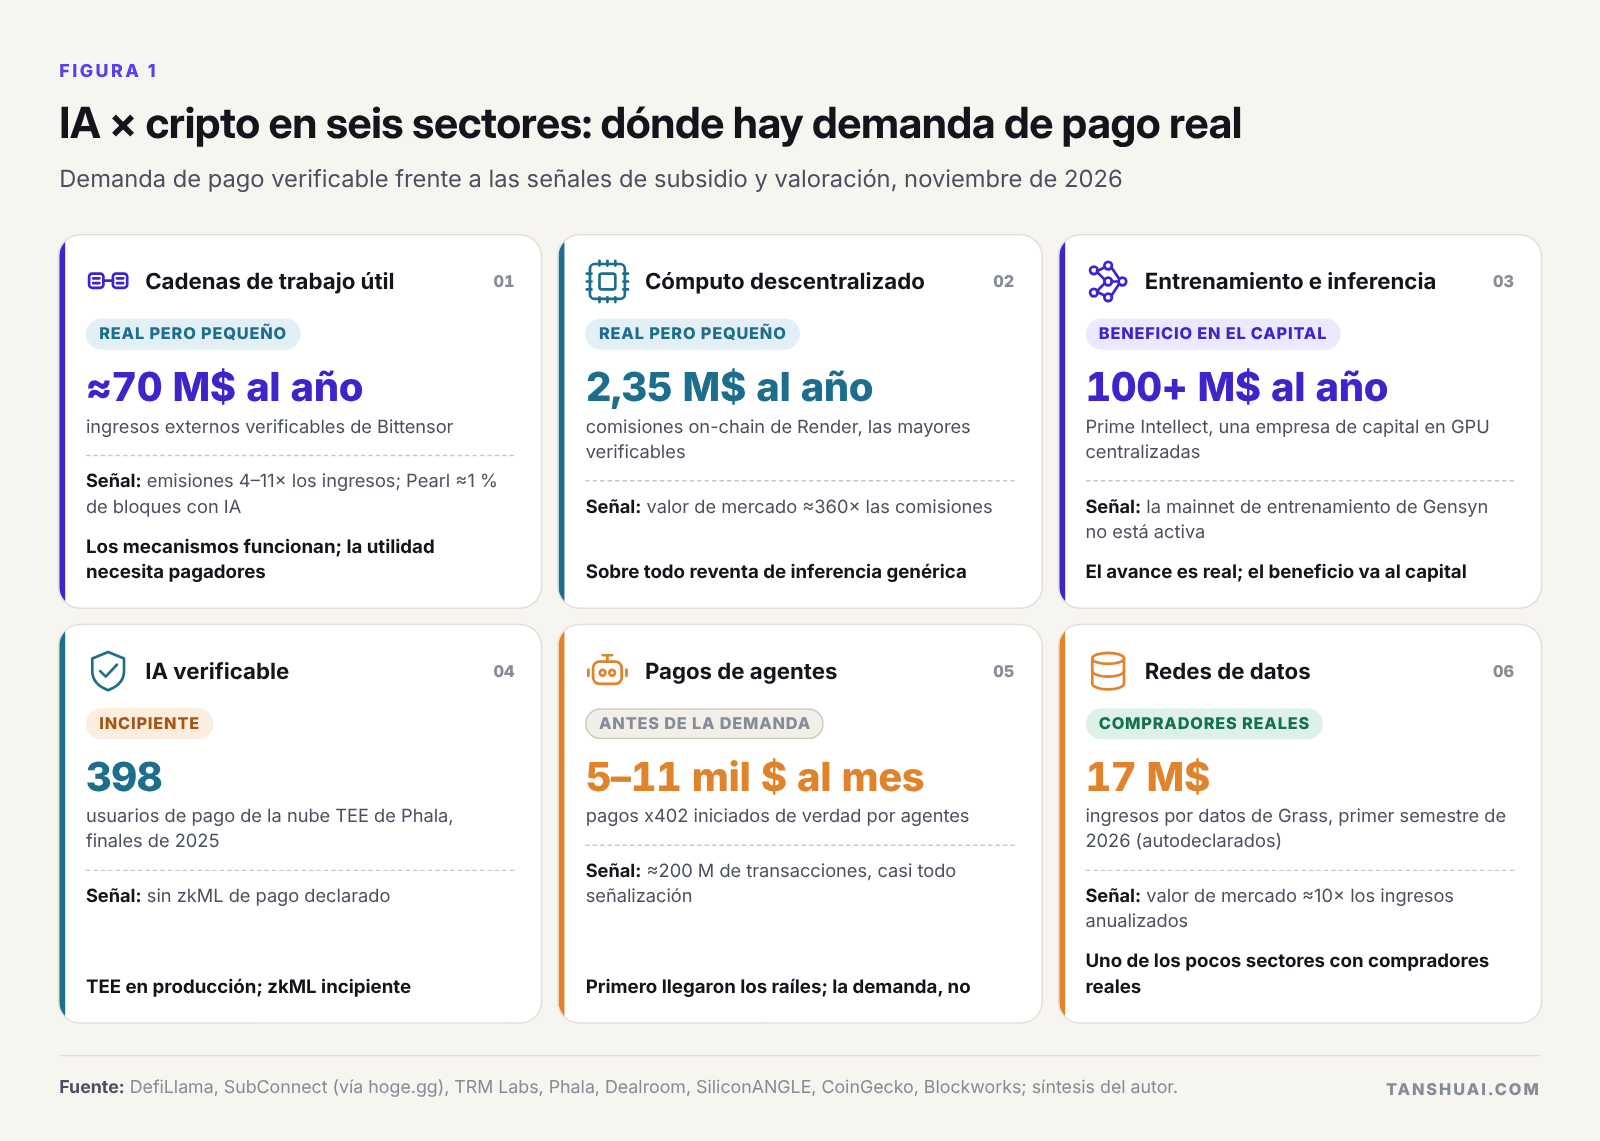 Figura 1. IA × cripto en seis sectores: dónde hay demanda de pago real.
| Pregunta | Respuesta breve |
|---|---|
| ¿Funciona Pearl, y es útil su trabajo? | Funciona: unos 90 EH/s de multiplicación de matrices protegen la cadena. Todavía no es útil: cerca del 1 % de los bloques lleva trabajo de IA |
| ¿Dónde está la demanda de pago real? | En la inferencia, los datos y la privacidad. Los pagos de agentes, el zkML y el entrenamiento descentralizado siguen antes de la demanda |
| ¿Merece la pena construir un ASIC? | Solo con un bote grande, reglas estables y un segundo mercado; hoy ninguna red ofrece las tres cosas |
| ¿Qué chips debería construir un equipo pequeño? | Aceleradores pensados para inferencia que también puedan minar, chips de inferencia para un cliente firmado, trabajo temprano en FHE; no mineros de bitcoin para el mercado abierto ni chips de entrenamiento |
| ¿Cuánto cuesta un primer chip? | Comprarlo por etapas: un modelo, una FPGA y una MPW llegan a silicio medido por unos 1,5 millones de dólares, antes de unas máscaras que cuestan millones |
Pearl: una multiplicación-acumulación es un hash
Pearl se apoya en un resultado de 2025 de Ilan Komargodski y Omri Weinstein: una prueba de trabajo útil para cualquier producto de matrices, a 1 + o(1) veces el coste de la multiplicación. Los mineros multiplican matrices con ruido, convierten el acumulador de cada tesela de salida en un boleto de lotería mediante un hash y prueban la tesela ganadora con una prueba de conocimiento cero de menos de 60 KB. En el código de consenso, un H es una multiplicación-acumulación INT7 × INT7 → INT32 acreditada, de modo que por primera vez el presupuesto de seguridad de una cadena de bloques se valora en el rendimiento tensorial de los aceleradores de IA.
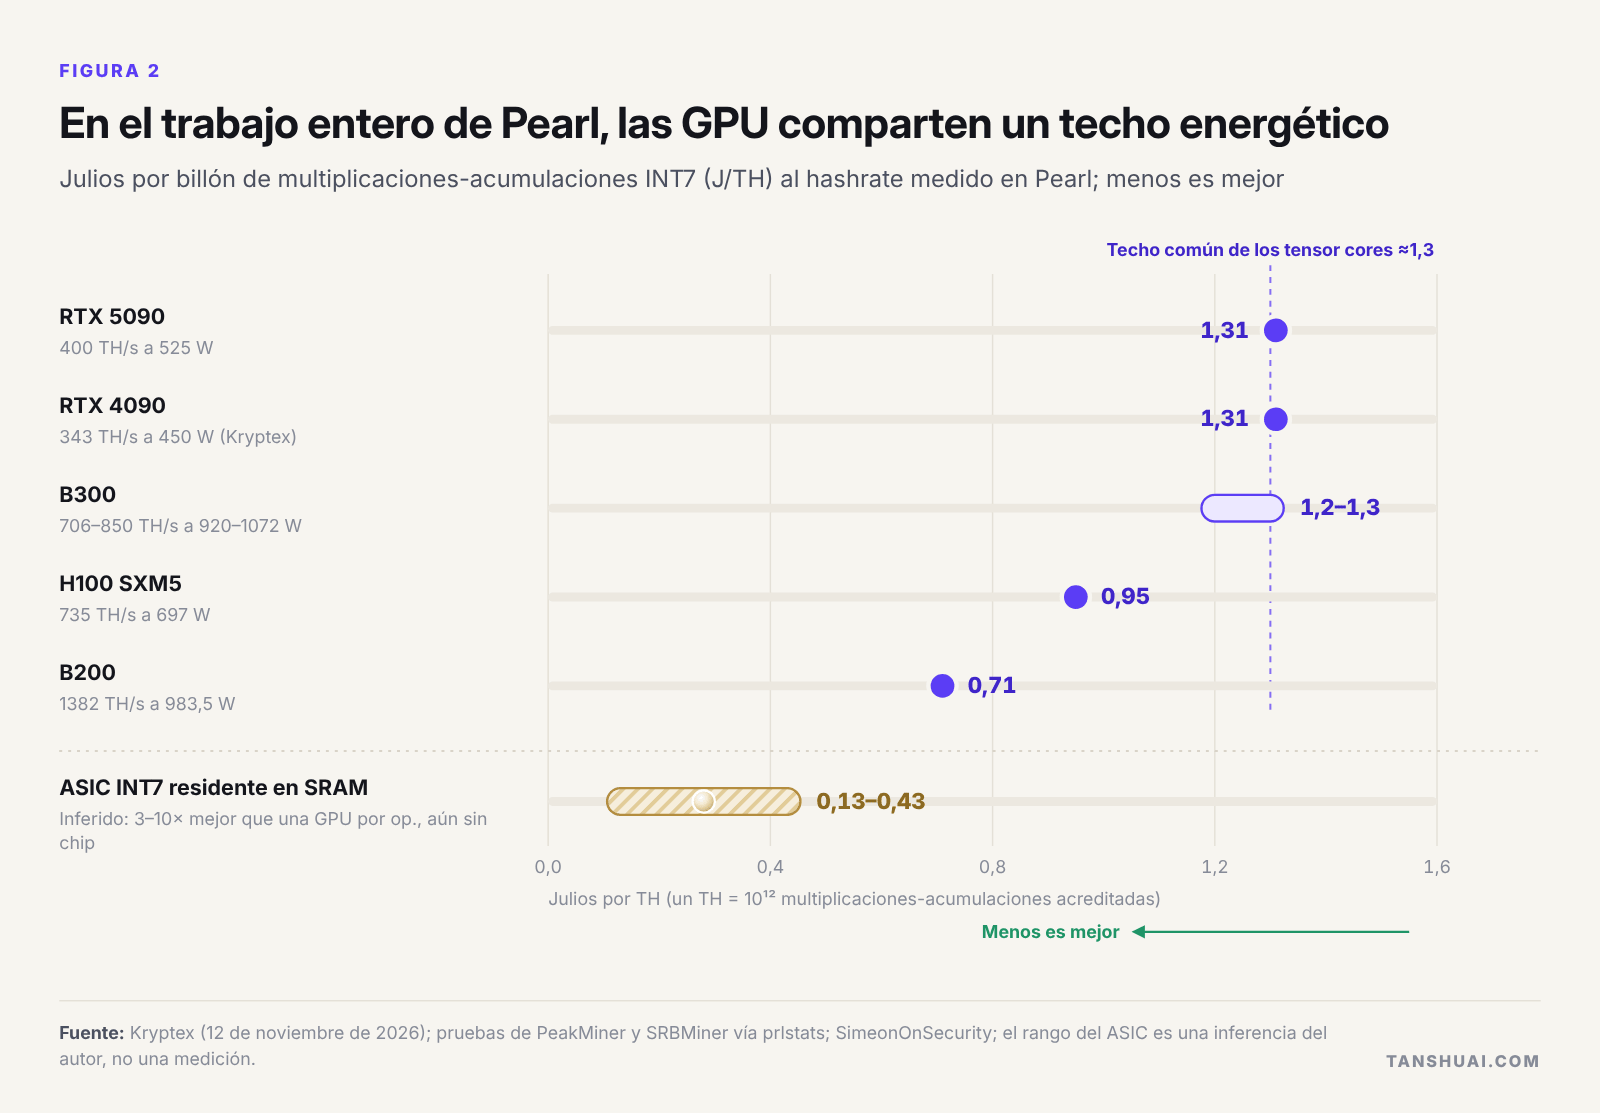 Figura 2. En el trabajo entero de Pearl, las GPU comparten un techo energético.
Las tarjetas gaming y la B300 de centro de datos coinciden en torno a 1,3 J/TH, e incluso la B200 solo llega a 0,71. Ese techo compartido es justo lo que un chip dedicado podría romper: una pieza que solo multiplique enteros de 7 bits desde SRAM en el propio chip, sin HBM ni unidades de propósito general, podría plausiblemente ser de 3 a 10 veces mejor por operación. Mientras tanto, NVIDIA está alejando su silicio más nuevo de INT8 hacia FP8 y FP4, y por eso Pearl se prepara para cambiar su aritmética.
La economía de Pearl: el teorema se sostiene, el incentivo no
El hashrate de Pearl sigue a su precio. La red pasó de 0,01 EH/s en su segundo día a 23–26 EH/s a finales de mayo, se mantuvo en 21–39 EH/s durante un verano en el que el precio cayó cerca de un 86 %, y alcanzó unos 90 EH/s después de que el precio se multiplicara por diez en otoño. Unos 120 millones de monedas, cerca del 32 % de la oferta actual, se minaron en los seis primeros días, y la oferta crecerá cerca de un 78 % en los próximos 12 meses. Una RTX 5090 gana ahora unos 5–6 dólares al día.
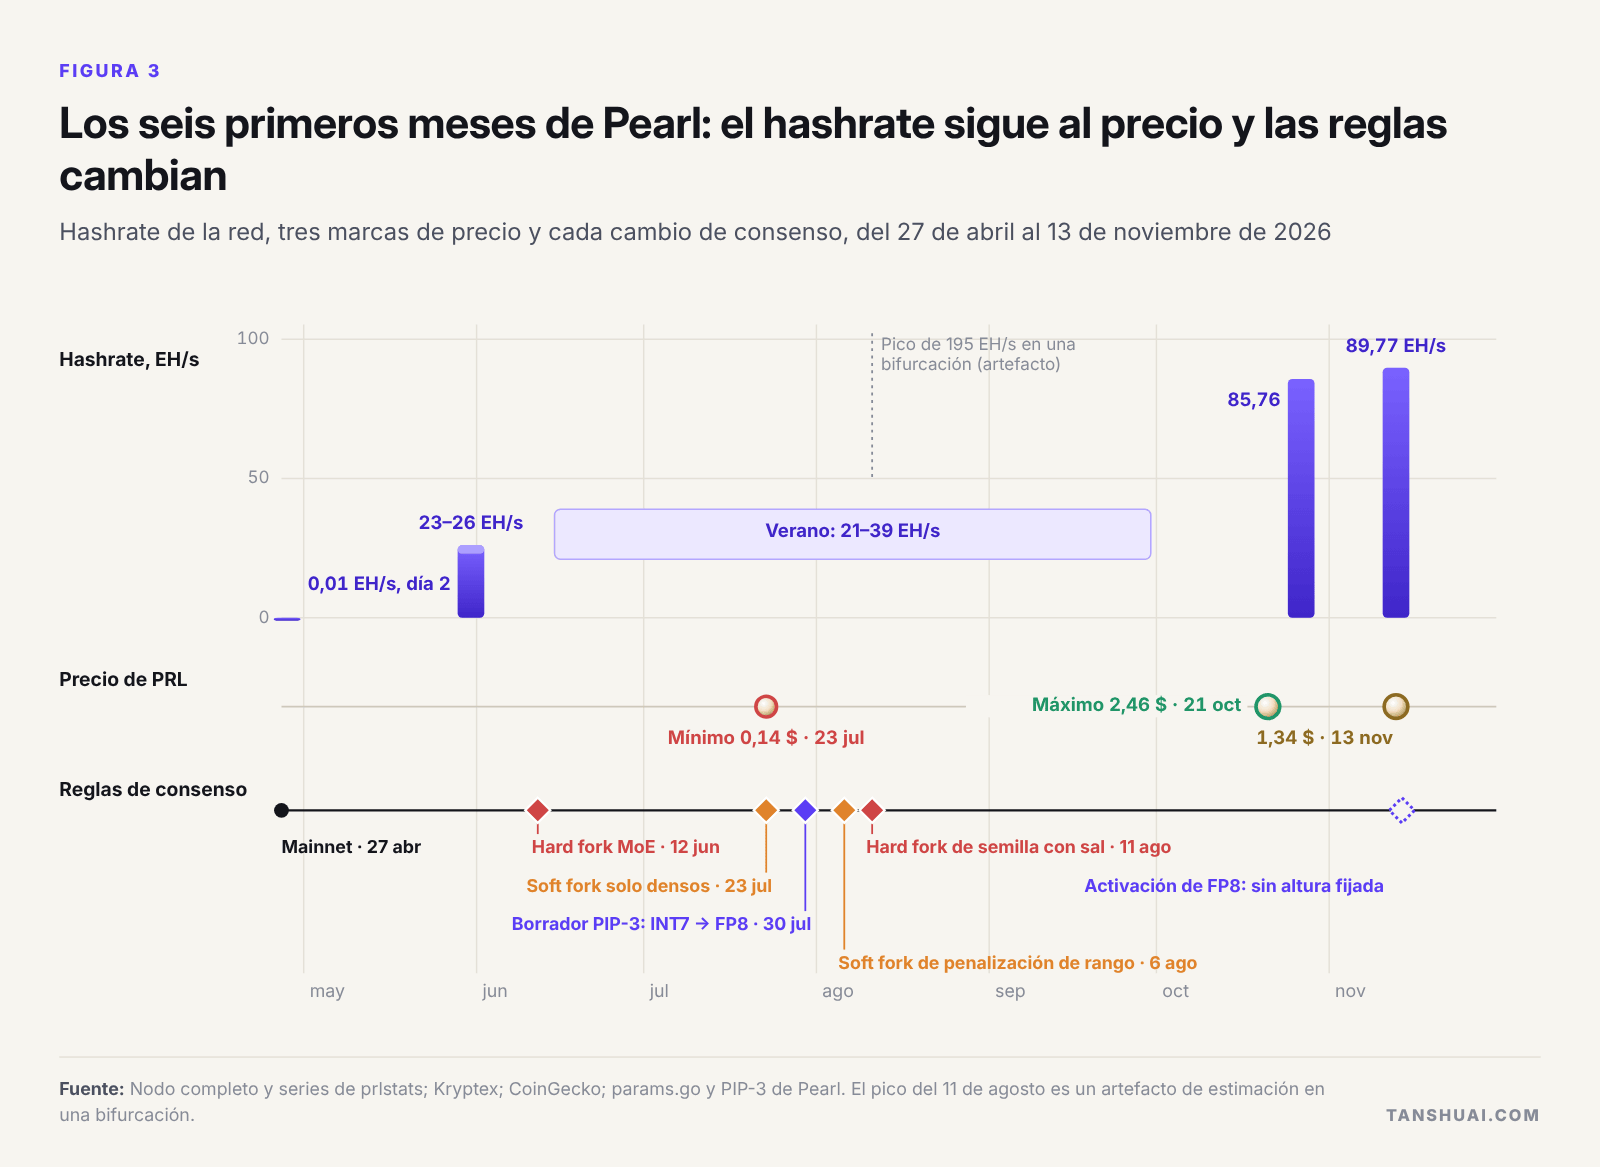 Figura 3. Los seis primeros meses de Pearl: el hashrate sigue al precio y las reglas cambian.
Es en la parte útil donde el modelo se rompe. Minar dentro de una inferencia real cuesta poco en el lado de la inferencia, entre un 5 % y un 9 % del rendimiento, pero gana poco en el lado de la minería: el plug-in de Pearl solo mina en lotes largos de prefill, así que una tarjeta que sirve una carga de chat conserva cerca del 5 % del hashrate de un minero dedicado. Por eso los mineros racionales multiplican matrices aleatorias, y el protocolo no puede distinguirlo. La única alianza pública de inferencia ya no figura en la API serverless de su proveedor. La utilidad de Pearl es un problema comercial fuera de la cadena: alguien tiene que pagar la inferencia.
Las reglas son el otro riesgo. Entre junio y agosto el laboratorio activó cuatro cambios de consenso en alturas fijadas en el código, y su borrador PIP-3 lleva la minería a FP8 con perfiles de dispositivo exactos bit a bit para solo dos arquitecturas de NVIDIA. Un formato numérico puede ser útil para la IA, verificable bit a bit y neutral respecto al hardware, pero como mucho dos de las tres cosas.
En todo IA × cripto: el subsidio es combustible, no un modelo de negocio
Las demás cadenas de trabajo útil cuentan la misma historia. Kaspa metió un producto de matrices dentro de su hash y aun así tuvo ASIC en 16 meses; su mejor máquina gana hoy 0,86 dólares al día. El rompecabezas de prueba sintético de Aleo tuvo hardware dedicado en cinco meses y pagó a los probadores 175–180 veces sus comisiones. Bittensor es la única red del grupo con ingresos externos a escala, unos 70 millones de dólares al año, frente a más de 300 millones de dólares de emisiones.
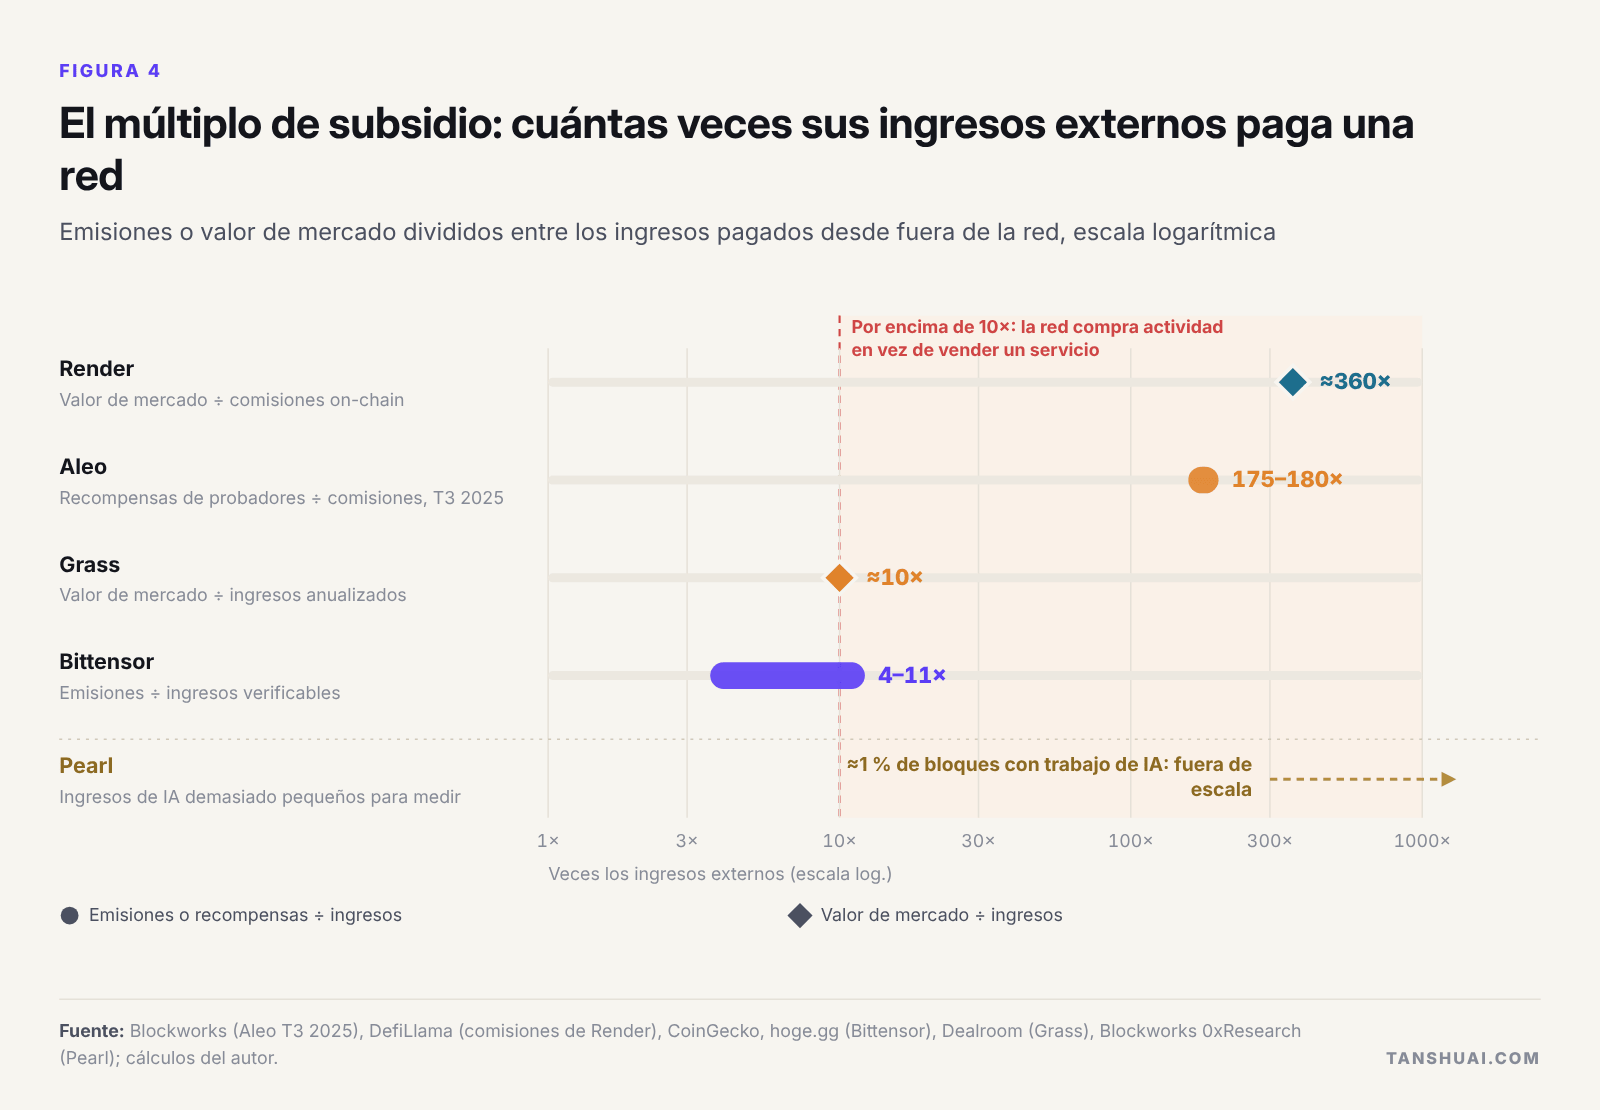 Figura 4. El múltiplo de subsidio: cuántas veces sus ingresos externos paga una red.
Más allá del consenso, el cuadro es de demanda real a pequeña escala. Los mercados descentralizados de GPU venden inferencia genérica y mejoran los precios de los hiperescaladores, pero no los de las neoclouds más baratas. El entrenamiento por internet funciona con 8000 a 40.000 millones de parámetros, mientras que las ejecuciones de frontera han vuelto a los clústeres centralizados. Los entornos de ejecución de confianza ejecutan inferencia confidencial en producción; las pruebas de conocimiento cero de IA siguen en el laboratorio. Los pagos iniciados por agentes de IA suman unos 5000–11.000 dólares al mes pese a los raíles construidos por Visa, Mastercard, Stripe y Google. Los datos son uno de los pocos sectores con compradores reales. Mientras tanto, cuatro empresas de capital sobre infraestructura centralizada valen más o menos lo mismo que todos los tokens de IA de capa de protocolo y de aplicación juntos: lo cripto aporta distribución y liquidación, y el capital se lleva los beneficios.
Cuándo compensa un ASIC: una fórmula, tres varas de medir
Cuando las GPU fijan el precio de la minería, los ingresos por unidad de cómputo tienden a su coste, y un ASIC que sea k veces más barato retiene como mucho (1 − 1/k) de los ingresos. La curva es cóncava: 50 % con k = 2, 80 % con k = 5, 90 % con k = 10. Más allá de k = 5, más eficiencia añade poco beneficio; y frente a GPU ociosas que solo pagan la electricidad, la k efectiva puede ser de apenas unos 2,5.
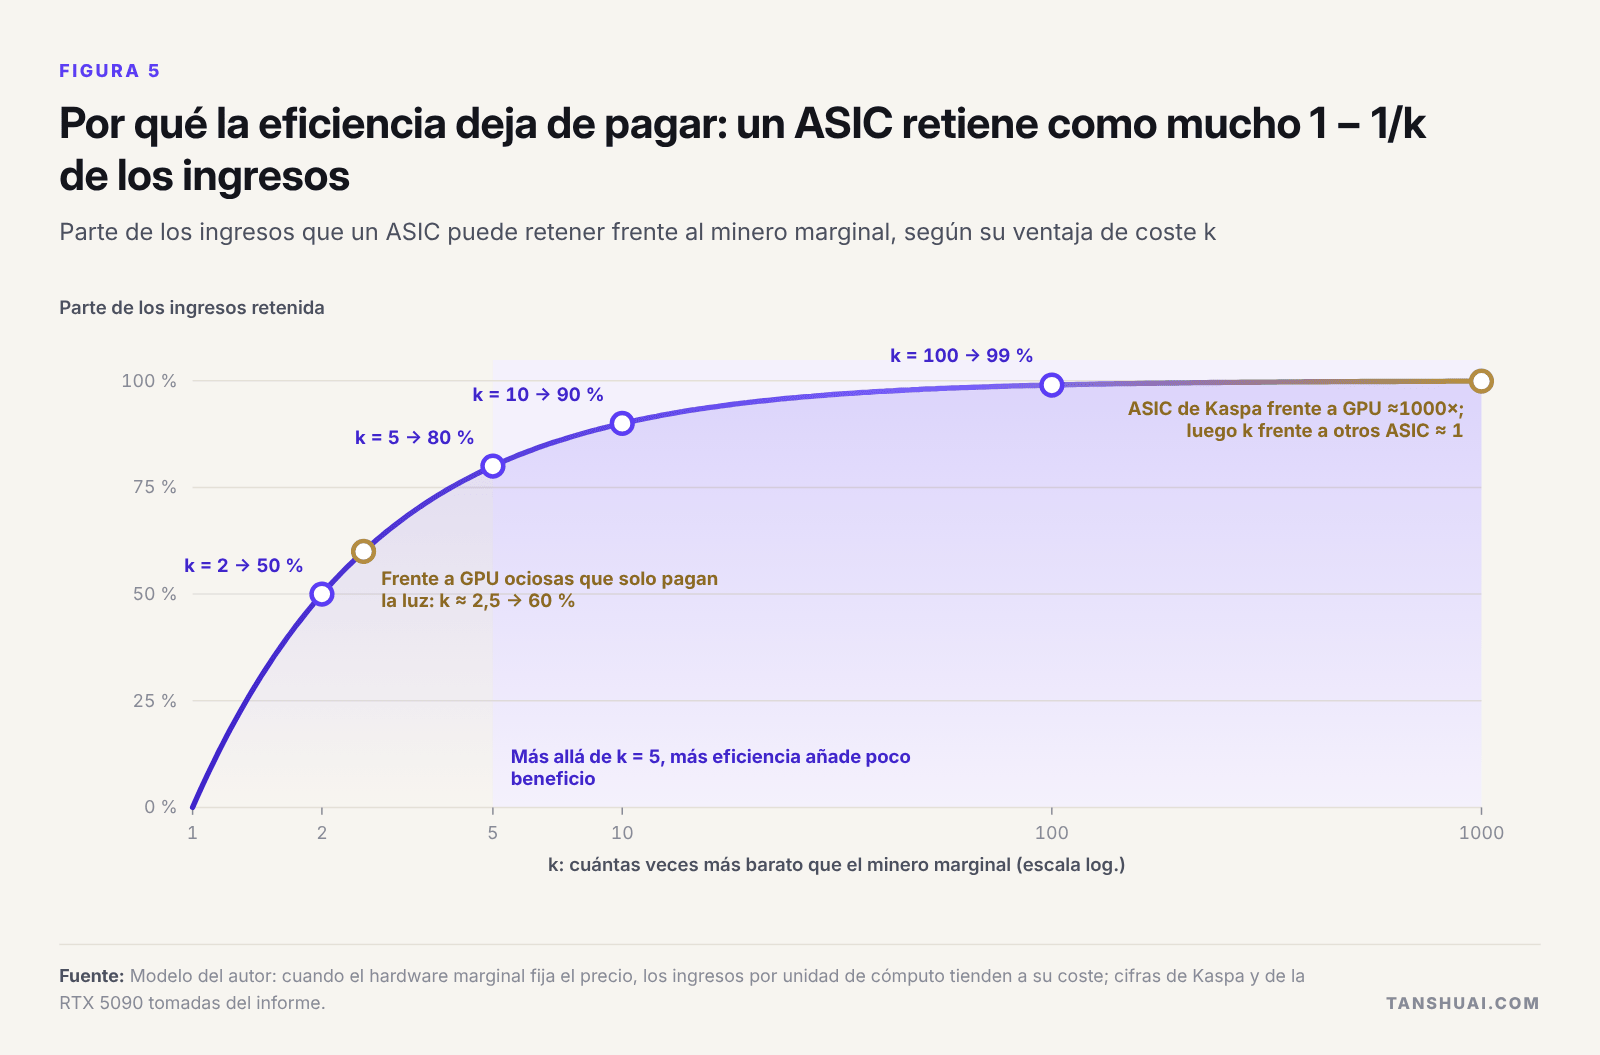 Figura 5. Por qué la eficiencia deja de pagar: un ASIC retiene como mucho 1 − 1/k de los ingresos.
Después deciden tres varas de medir: el bote, la escala de amortización y las reglas. Los mineros de bitcoin ingresan unos 11,5 mil millones de dólares al año, los de Pearl unos 0,46–0,49 mil millones, los de Aleo unos 31 millones y los de Kaspa unos 18 millones, menos que el extremo bajo del diseño de un chip de 5/4 nm. Para Pearl, un chip de 20 millones de dólares con k = 5 necesita unos 4,9 EH/s funcionando durante un año para amortizarse si las reglas se mantienen, y el doble si solo se mantienen con probabilidad del cincuenta por ciento.
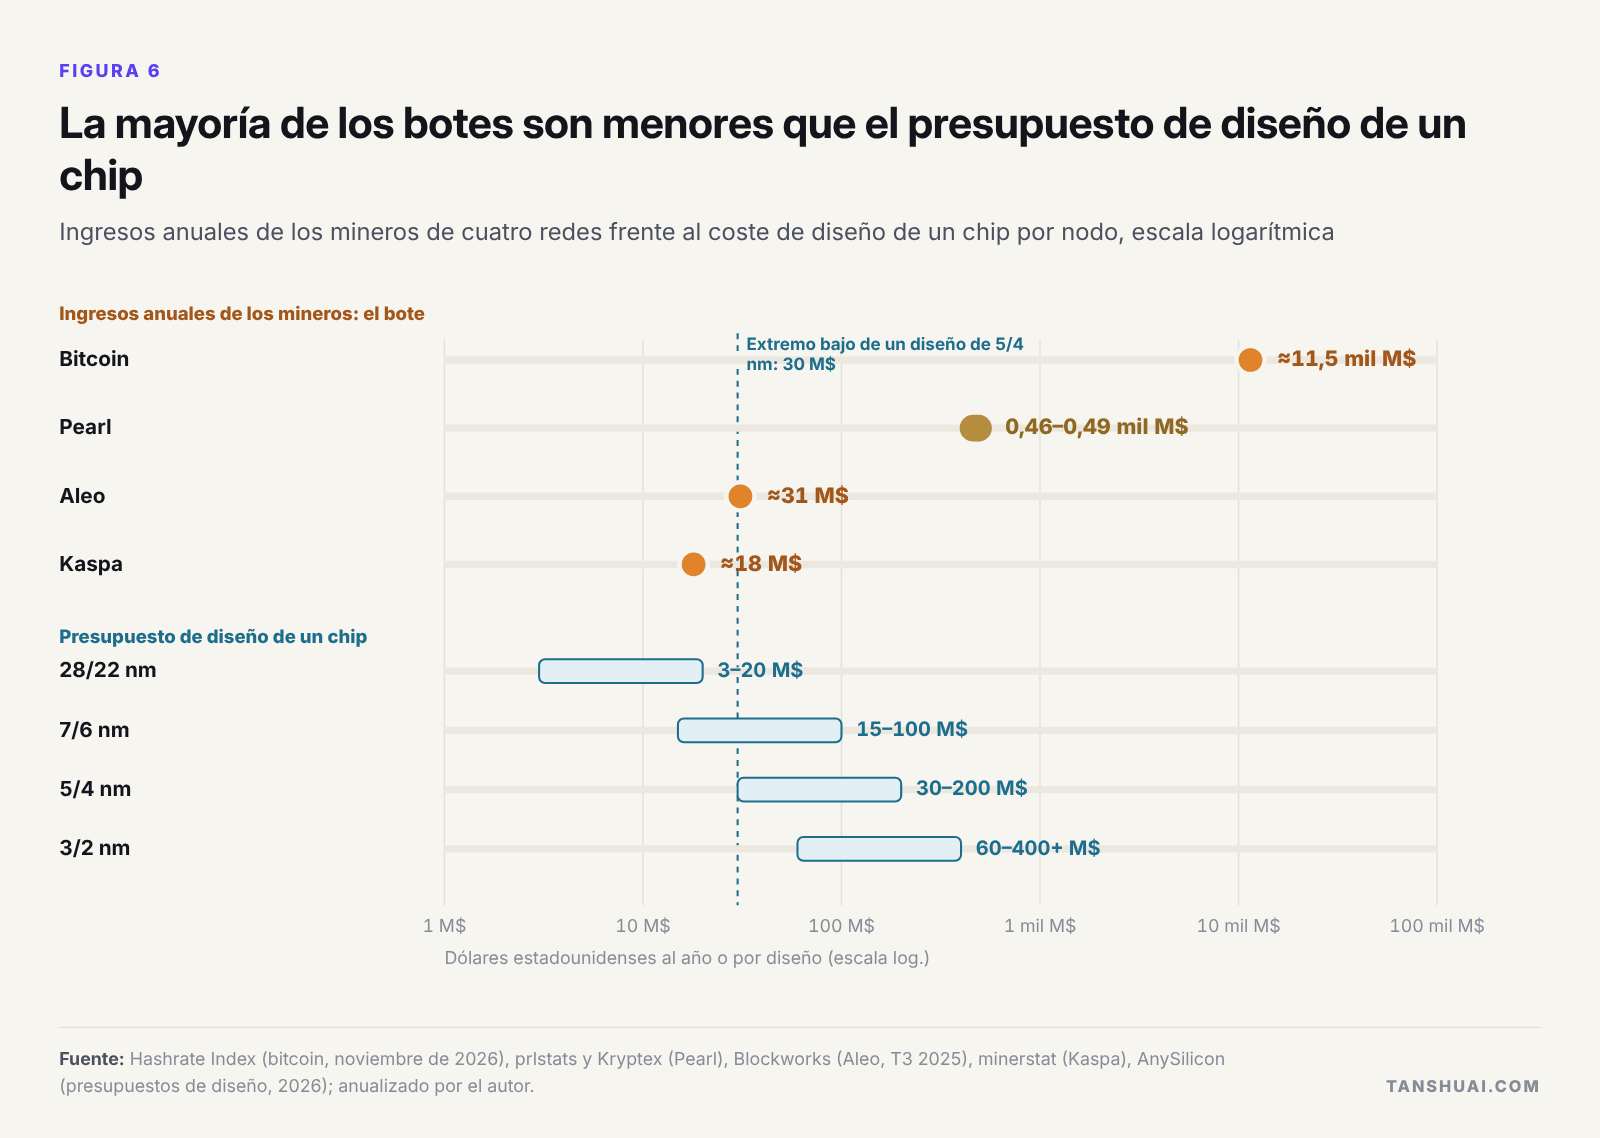 Figura 6. La mayoría de los botes son menores que el presupuesto de diseño de un chip.
Hoy ninguna red ofrece a la vez un bote grande, reglas estables y una k superior a 1: la k de bitcoin es de los líderes, las reglas de Pearl son las menos estables y los botes de Kaspa y Aleo son demasiado pequeños.
Cinco tipos de chip, cinco respuestas
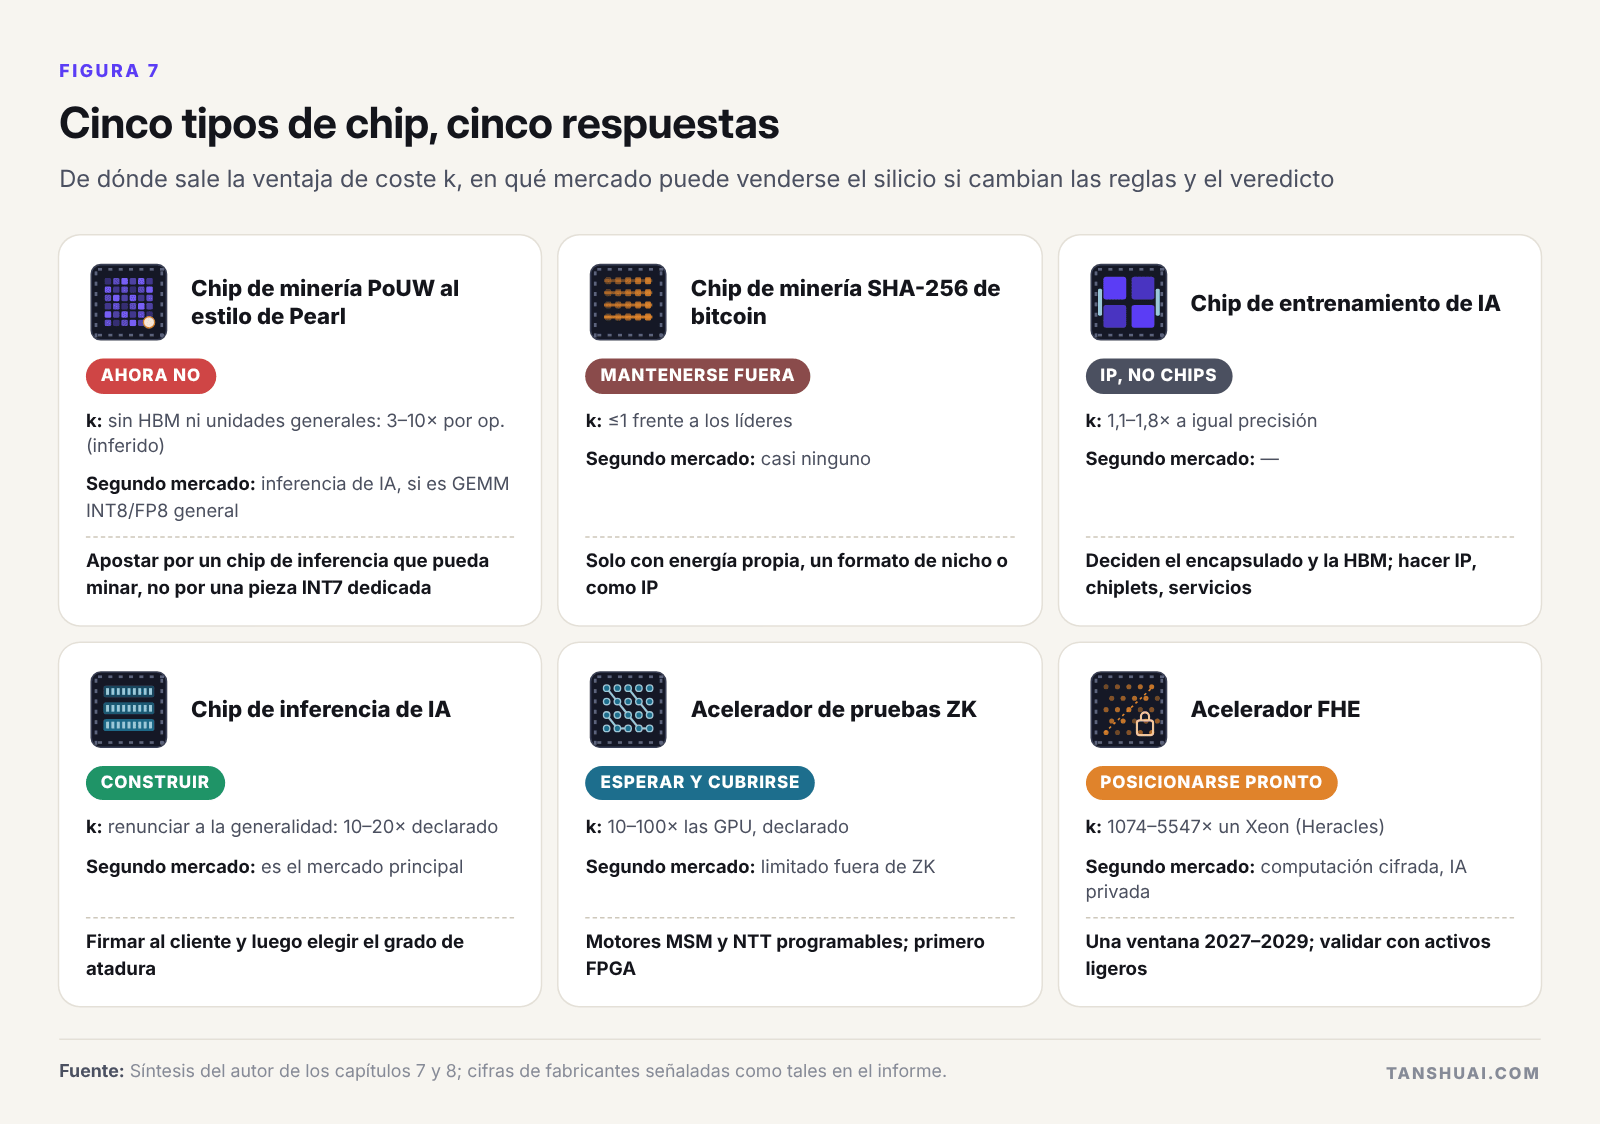 Figura 7. Cinco tipos de chip, cinco respuestas.
Para Pearl, yo no haría ahora el tape-out de un chip INT7 dedicado: un equipo nuevo necesita de 18 a 24 meses, y para entonces el protocolo puede haber pasado a FP8. La mejor apuesta es un acelerador pensado para inferencia y construido sobre GEMM INT8/FP8 general con los operandos en SRAM, para que el silicio tenga un segundo mercado si se cierra el acceso a la minería. Un equipo nuevo debería mantenerse fuera del mercado abierto de mineros de bitcoin, donde Bitmain vende máquinas de 8,9 J/TH y los aspirantes se retiran; los emplazamientos con energía valen hoy más como centros de datos de IA que como minas. Los equipos pequeños no deberían construir chips de entrenamiento independientes. Los chips de inferencia merecen la pena para un cliente firmado, los aceleradores ZK son una cobertura y los aceleradores FHE son una posición temprana para 2027–2029.
Nodos de proceso y un presupuesto por etapas
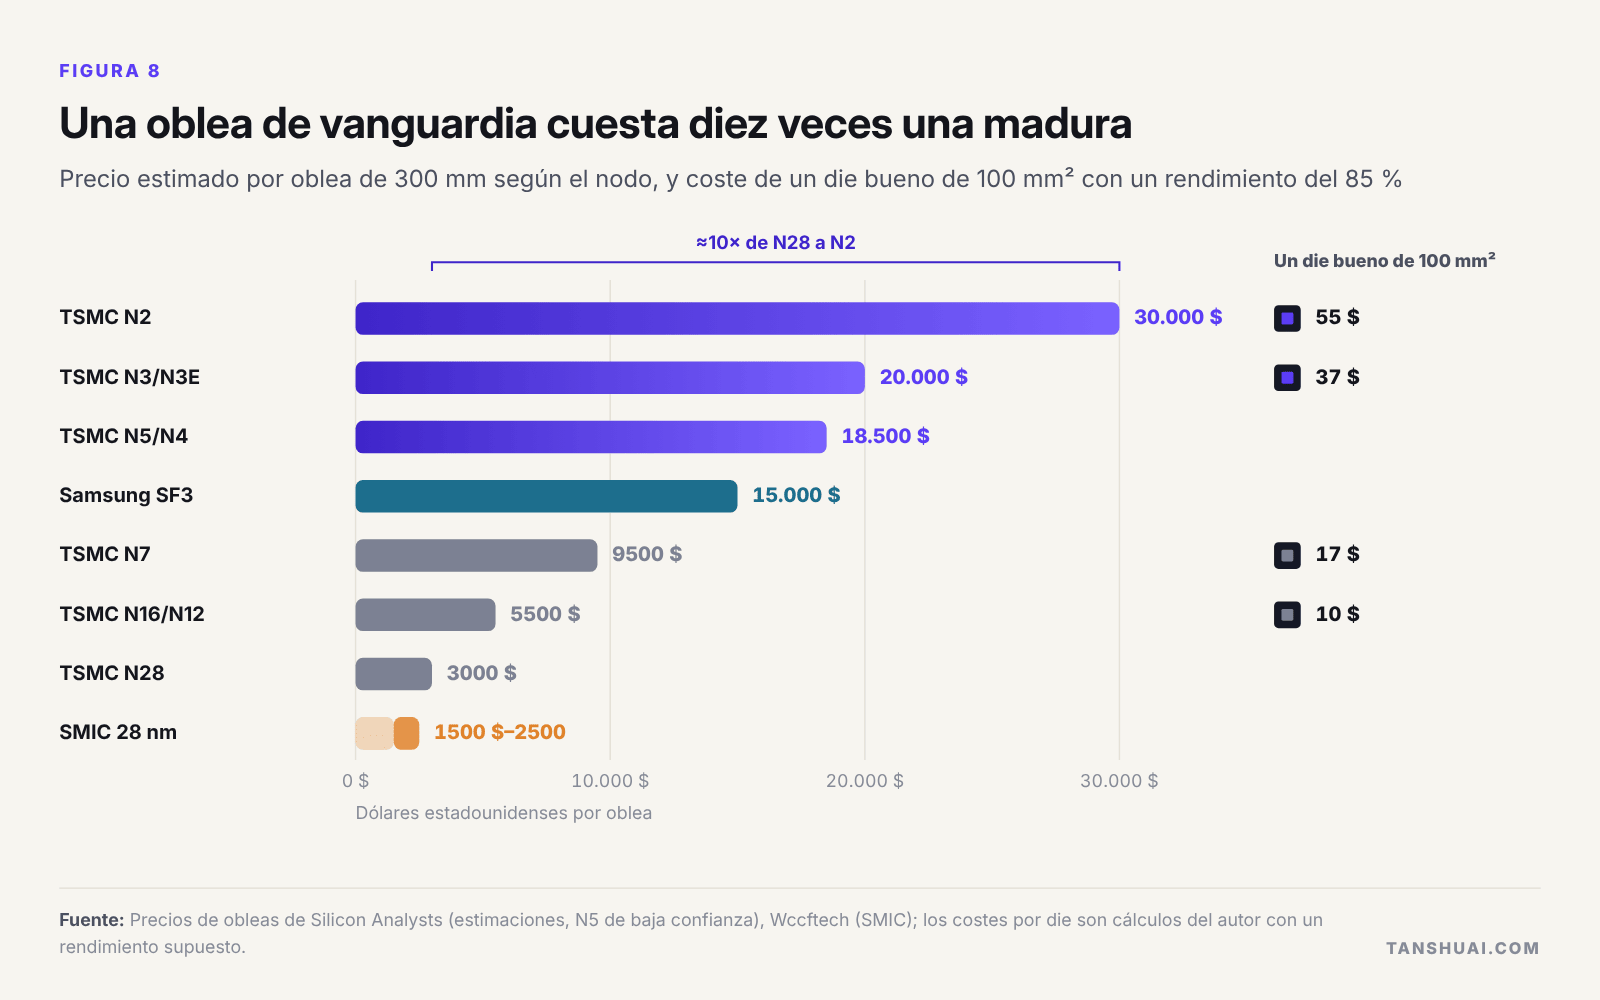 Figura 8. Una oblea de vanguardia cuesta diez veces una madura.
Que la mayor partida del coste del chip a lo largo de su vida útil elija el nodo: la energía en los chips de cómputo que funcionan día y noche, el encapsulado y la HBM en los de entrenamiento (cerca del 63 % del coste de una H100) y la elección entre SRAM y HBM en los de inferencia. Un chip de minería PoUW puede prototiparse en obleas multiproyecto de 28 o 16/12 nm y pasar a N7/N6 y después a N5/N4 solo cuando el algoritmo y los ingresos sean estables.
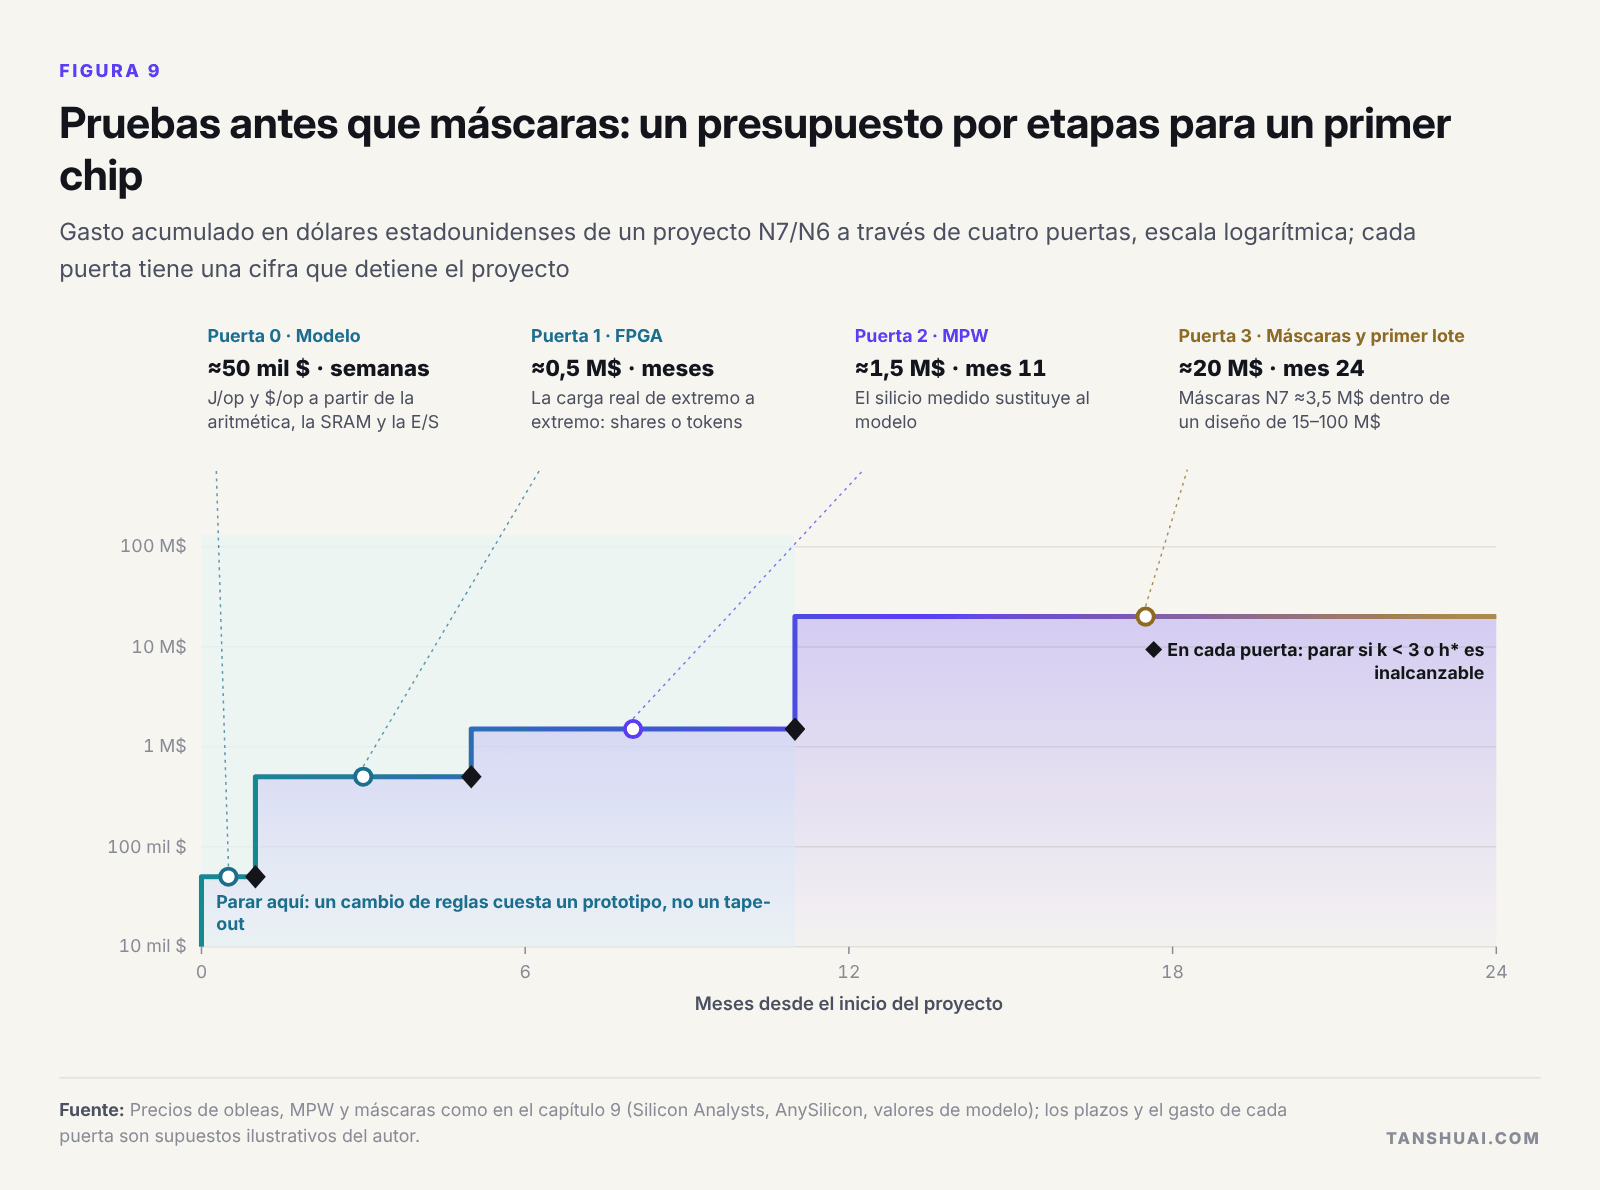 Figura 9. Pruebas antes que máscaras: un presupuesto por etapas para un primer chip.
Un primer chip debe comprarse en cuatro etapas, cada una con una cifra que detiene el proyecto: un modelo de J/op y $/op, una FPGA que ejecute la carga real, una oblea multiproyecto y solo después un juego de máscaras. En N7/N6 las tres primeras cuestan unos 1,5 millones de dólares y once meses; el juego de máscaras y el primer lote cuestan más de diez veces más [estimación]. Si el protocolo cambia su aritmética o el comprador se retira, un equipo que se detuvo en la oblea pierde el precio de un prototipo, no el de un tape-out. La eficiencia más barata es la arquitectónica: mantener los operandos en SRAM y prescindir de la HBM elimina la mayor parte del coste de una GPU antes de elegir ningún nodo.
Por dónde empezaría
Las oportunidades están donde se cruzan los campos: lo cripto como primer cliente, la IA como segundo mercado. La demanda de chips a medida en 2026 es abrumadoramente de IA, y las habilidades de un equipo de chips de minería —matrices de baja tensión, suministro de potencia de kilovatios y tape-outs rápidos— se transfieren directamente. Yo tomaría como mucho tres caminos, cada uno probado con un primer paso pequeño: un acelerador pensado para inferencia que también pueda minar, empezando por un estudio de cuatro semanas de J/op y $/op; servicios de silicio a medida con lo cripto como primer cliente, empezando por estudios de viabilidad de pago; y una red nativa de IA que firme a su comprador de cómputo antes de diseñar su token.
Descargue el informe completo y las diapositivas
El informe completo trata en detalle el mecanismo, la economía y las reglas de Pearl, las demás cadenas de trabajo útil y el panorama general de IA × cripto, el modelo del ASIC con sus cálculos de amortización, los veredictos chip a chip, los costes y la elección de nodos, un presupuesto por etapas para un primer chip, una lista de indicadores y todas las fuentes.
- El cómputo como consenso: informe completo (PDF)
- El cómputo como consenso: diapositivas (PDF)
- Edición en inglés: informe completo · diapositivas
Esta es una traducción de la edición en inglés; si difieren, prevalece la edición en inglés.
Preguntas que no hizo pero debería haber hecho
Antes de poner dinero o silicio en cualquier proyecto de IA × cripto, yo preguntaría: quién controla la función de trabajo; cuál es el múltiplo de subsidio; cuánto cuesta la siguiente puerta y qué cifra le hace parar; cuál es el hashrate de amortización, con p; cuál es el segundo mercado del chip; si el valor acaba en el token o en el capital; y quién es el primer cliente de pago, con nombre.
Son áreas que podemos explorar juntos, mediante intercambio y colaboración técnicos: chips a medida para minería, entrenamiento e inferencia de IA, y aceleradores; desarrollo de IA; y sistemas IA × cripto de la cadena al nodo y al chip. Puede escribirme a i@tanshuai.com.
Sobre el autor
Tan Shuai es tecnólogo y fundador, con más de veinte años de trabajo en chips, hardware y software de sistemas, y 20 patentes concedidas. Acumula muchos años de I+D y dirección de chips fabless, incluido el diseño full-custom de rutas de datos ASIC para chips de minería de criptomonedas y chips multimedia para cámaras. Su trabajo le ha llevado por Silicon Valley, Nueva York, Chicago, Taiwán, la Gran Área de la Bahía (Shenzhen y Hong Kong), Vietnam y Malasia. Hoy trabaja como investigador y desarrollador de IA.
Debate técnico: i@tanshuai.com.