
Uma blockchain funciona agora com a mesma multiplicação de matrizes que a IA, a cerca de 90 EH/s. Li o seu código, os dados da cadeia e a economia que a rodeia para responder a três perguntas: o que, em IA × cripto, tem clientes pagantes, quando vale a pena construir um ASIC e que nó de processo serve a que chip. Com o relatório completo e os diapositivos.
Resumo
A Pearl, lançada em abril de 2026, é a primeira blockchain cuja prova de trabalho é multiplicação de matrizes ao estilo da IA, em grande escala. A 13 de novembro de 2026, a sua rede funcionava a cerca de 90 EH/s, em que um H é uma multiplicação-acumulação INT7: o débito inteiro de cerca de 122 000 H100. Funciona como engenharia. Ainda não é útil: cerca de 1% dos blocos transporta trabalho real de IA, porque uma GPU que minera enquanto serve inferência conserva apenas 1% a 27% da taxa de hash de um minerador dedicado. Em todo o domínio IA × cripto, a procura paga verificável surge em três lugares, a venda de inferência, a venda de dados e a venda de privacidade, enquanto os subsídios vão de 4 a 360 vezes a receita externa. Quanto aos chips, o teto de lucro de um ASIC é a receita por unidade de computação vezes (1 − 1/k), pelo que a eficiência para lá de k = 5 pouco acrescenta; o que decide é o tamanho do bolo, a estabilidade das regras e um segundo mercado. Hoje nenhuma rede oferece as três coisas. O nó de processo certo é ditado pela maior parcela do custo do chip ao longo da sua vida, e o próprio chip deve ser comprado por etapas, para que uma mudança de regras custe um protótipo e não um tape-out.
Porque estudei isto
Passei muitos anos a conceber chips, incluindo datapaths ASIC full-custom para mineração de criptomoedas, e hoje trabalho em IA. Quando surgiu uma cadeia cujo orçamento de segurança tem literalmente um preço em débito tensorial, as perguntas para alguém como eu eram óbvias: o trabalho é útil, um chip dedicado ganharia, e quanto custaria construí-lo?
Li o código e as propostas de protocolo da Pearl, dados da cadeia de um nó completo independente, documentos oficiais de empresas, artigos de criptografia, arquitetura de computadores e aprendizagem automática, dados de preços de foundries e de fornecedores, e a imprensa especializada. Todos os números abaixo são de 13 de novembro de 2026, e os valores estão em dólares americanos. Esta nota é a forma como aprendi o domínio; partilho-a para que outros a possam verificar, usar e contestar. O relatório completo, com todas as fontes, está no fim.
Resultados em resumo
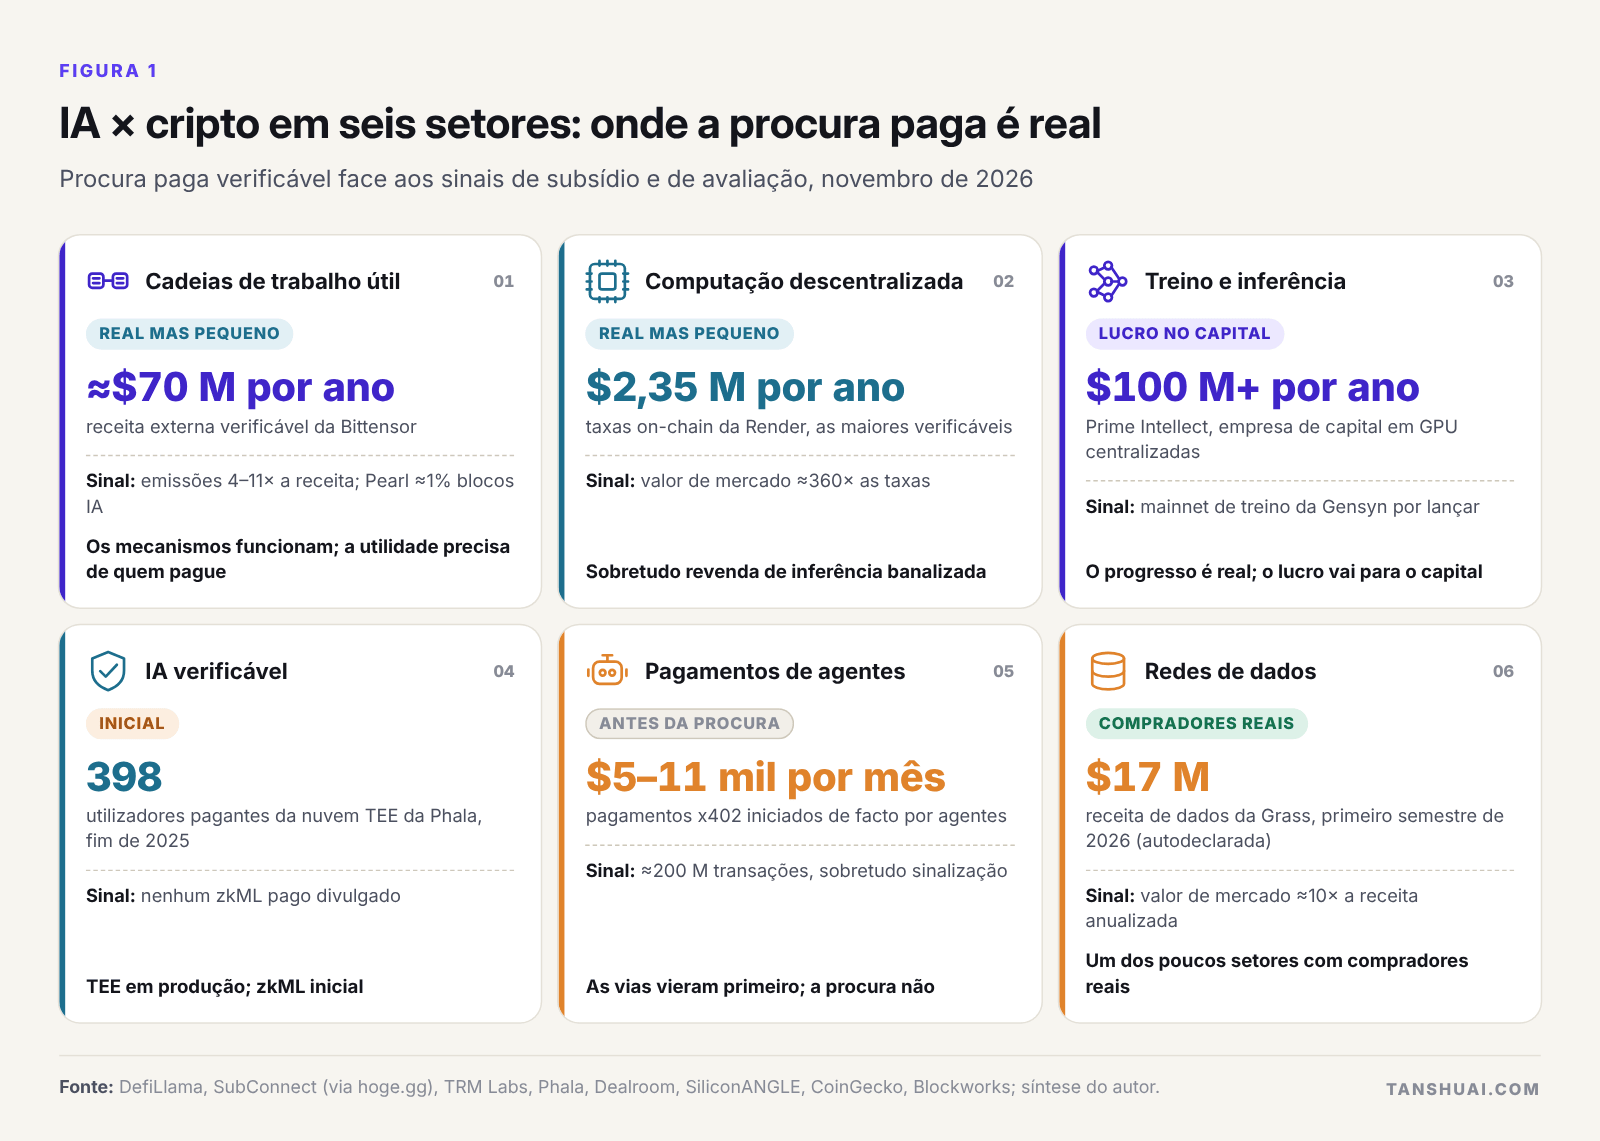 Figura 1. IA × cripto em seis setores: onde a procura paga é real.
| Pergunta | Resposta curta |
|---|---|
| A Pearl funciona, e o seu trabalho é útil? | Funciona: cerca de 90 EH/s de multiplicação de matrizes protegem a cadeia. Ainda não é útil: cerca de 1% dos blocos transporta trabalho de IA |
| Onde está a procura paga real? | Inferência, dados e privacidade. Os pagamentos de agentes, o zkML e o treino descentralizado ainda estão antes da procura |
| Vale a pena construir um ASIC? | Só com um bolo grande, regras estáveis e um segundo mercado; hoje nenhuma rede oferece as três coisas |
| Que chips deve construir uma equipa pequena? | Aceleradores de inferência que também possam minerar, chips de inferência para um cliente assinado, trabalho inicial em FHE; não mineradores de bitcoin para venda nem chips de treino |
| Quanto custa um primeiro chip? | Comprá-lo por etapas: um modelo, uma FPGA e uma MPW chegam ao silício medido por cerca de 1,5 milhões de dólares, antes de máscaras que custam milhões |
Pearl: uma multiplicação-acumulação é um hash
A Pearl assenta num resultado de 2025 de Ilan Komargodski e Omri Weinstein: uma prova de trabalho útil para qualquer produto de matrizes, a 1 + o(1) vezes o custo da multiplicação. Os mineradores multiplicam matrizes com ruído, fazem o hash do acumulador de cada tile de saída num bilhete de lotaria e provam o tile vencedor com uma prova de conhecimento zero de menos de 60 KB. No código de consenso, um H é uma multiplicação-acumulação INT7 × INT7 → INT32 creditada, pelo que, pela primeira vez, o orçamento de segurança de uma blockchain tem preço no débito tensorial dos aceleradores de IA.
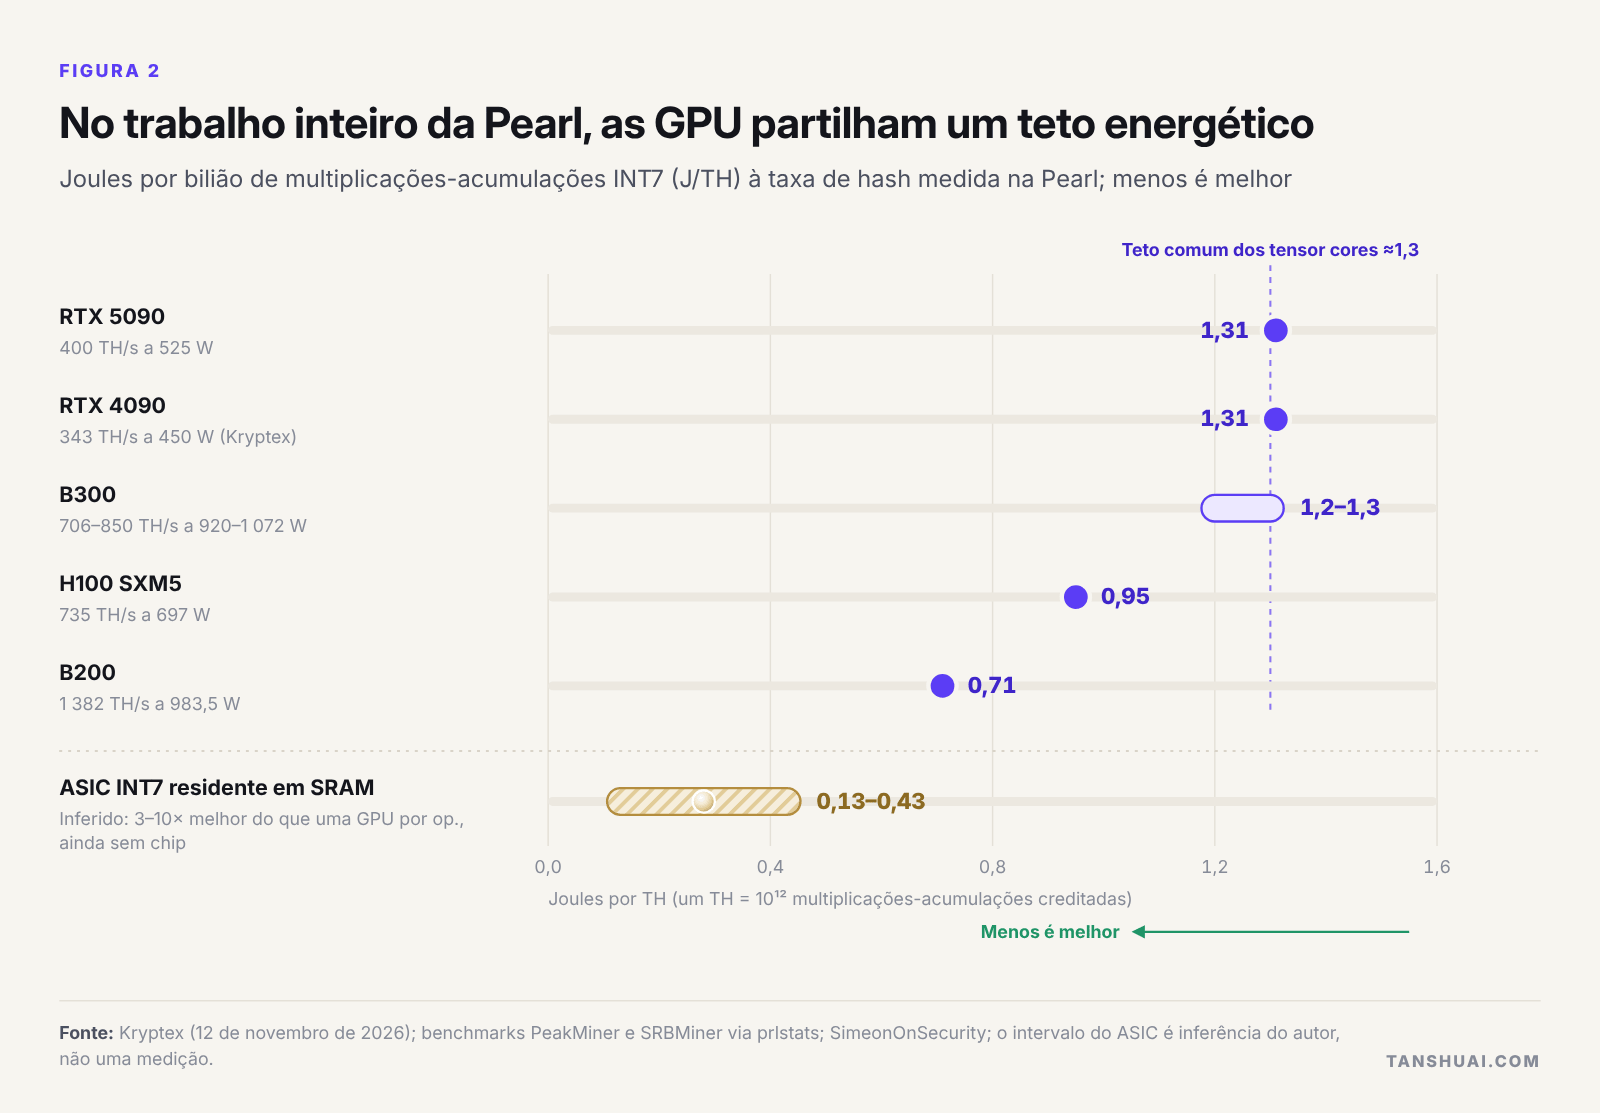 Figura 2. No trabalho inteiro da Pearl, as GPU partilham um teto energético.
As placas de jogos e a B300 de centro de dados encontram-se em cerca de 1,3 J/TH, e mesmo a B200 só chega a 0,71. Esse teto comum é exatamente o que um chip dedicado poderia quebrar: uma peça que apenas multiplique inteiros de 7 bits a partir de SRAM no chip, sem HBM nem unidades de uso geral, poderia plausivelmente ser 3 a 10 vezes melhor por operação. Entretanto, a NVIDIA está a afastar o seu silício mais recente do INT8 em direção ao FP8 e ao FP4, e é por isso que a Pearl se prepara para mudar a sua aritmética.
A economia da Pearl: o teorema mantém-se, o incentivo não
A taxa de hash da Pearl segue o seu preço. A rede passou de 0,01 EH/s no segundo dia para 23–26 EH/s no fim de maio, manteve-se em 21–39 EH/s durante um verão em que o preço caiu cerca de 86% e chegou a cerca de 90 EH/s depois de o preço ter subido cerca de dez vezes no outono. Cerca de 120 milhões de moedas, aproximadamente 32% da oferta atual, foram mineradas nos primeiros seis dias, e a oferta crescerá cerca de 78% nos próximos 12 meses. Uma RTX 5090 rende hoje cerca de 5–6 dólares por dia.
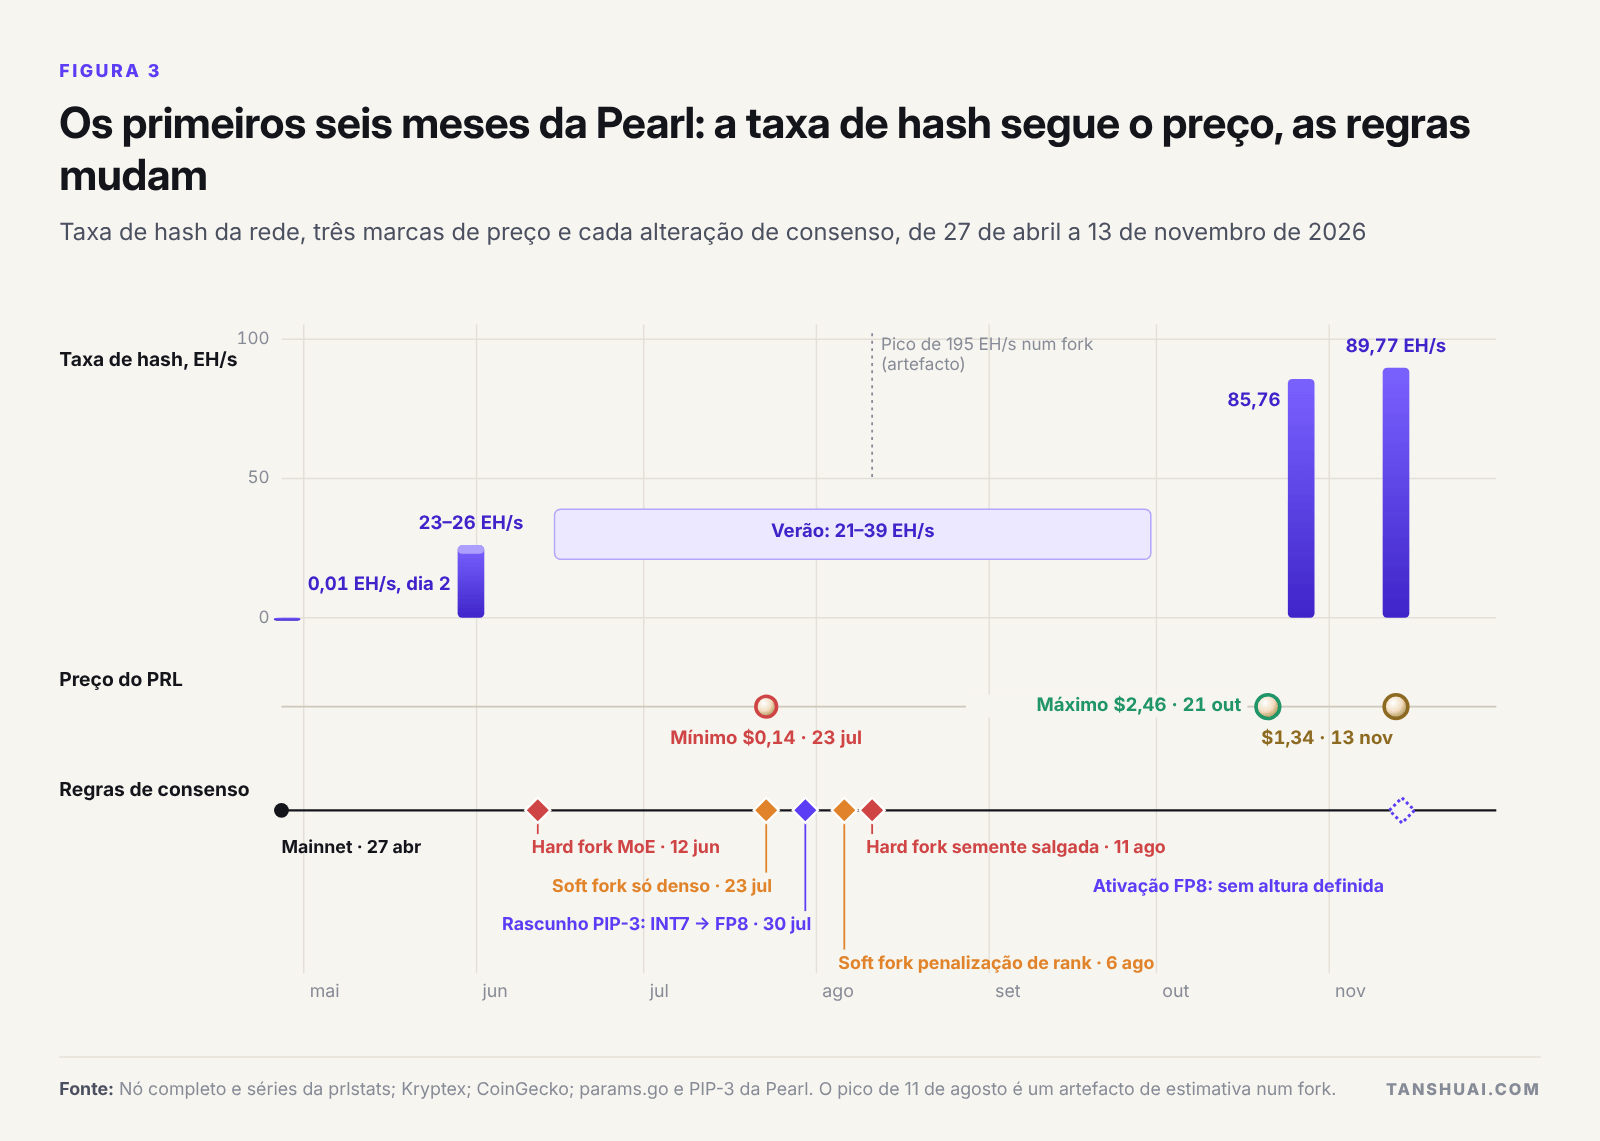 Figura 3. Os primeiros seis meses da Pearl: a taxa de hash segue o preço, as regras continuam a mudar.
É na parte útil que o modelo falha. Minerar dentro de inferência real custa pouco do lado da inferência, cerca de 5% a 9% do débito, mas rende pouco do lado da mineração: o plug-in da Pearl só minera em lotes longos de prefill, pelo que uma placa a servir uma carga de chat conserva cerca de 5% da taxa de hash de um minerador dedicado. Os mineradores racionais multiplicam, portanto, matrizes aleatórias, e o protocolo não consegue distinguir. A única parceria pública de inferência já não está na API serverless do seu fornecedor. A utilidade da Pearl é um problema comercial fora da cadeia: alguém tem de pagar a inferência.
As regras são o outro risco. Entre junho e agosto, o laboratório ativou quatro alterações de consenso em alturas fixadas no código, e o seu rascunho PIP-3 passa a mineração para FP8 com perfis de dispositivo exatos ao bit para apenas duas arquiteturas da NVIDIA. Um formato numérico pode ser útil para IA, verificável bit a bit e neutro quanto ao hardware, mas no máximo duas das três coisas.
Em todo o domínio IA × cripto: o subsídio é combustível, não um modelo de negócio
As outras cadeias de trabalho útil contam a mesma história. A Kaspa pôs um produto de matrizes dentro do seu hash e, ainda assim, teve ASIC em 16 meses; a sua melhor máquina rende hoje $0,86 por dia. O puzzle de prova sintético da Aleo teve hardware dedicado em cinco meses e pagou aos provadores 175–180 vezes as suas taxas. A Bittensor é a única rede do grupo com receita externa à escala, cerca de 70 milhões de dólares por ano, contra mais de 300 milhões de dólares de emissões.
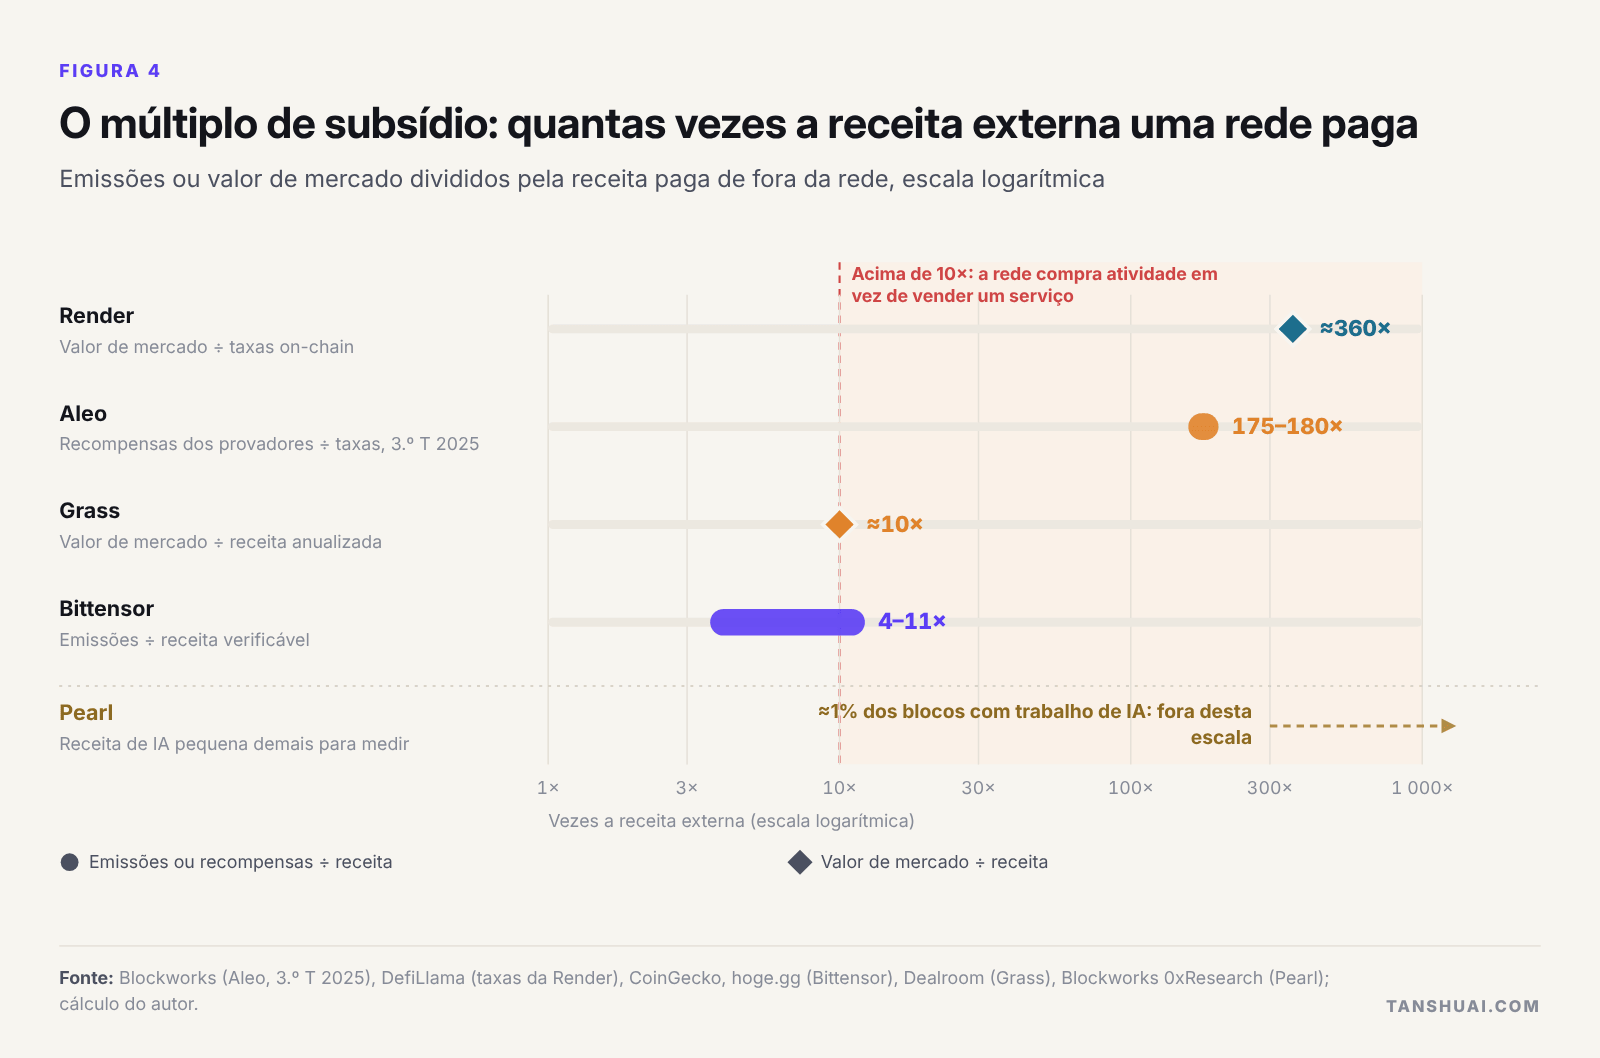 Figura 4. O múltiplo de subsídio: quantas vezes a receita externa uma rede paga.
Para lá do consenso, o quadro é de procura real em pequena escala. Os mercados descentralizados de GPU vendem inferência banalizada e batem os preços dos hiperescaladores, mas não os das neoclouds mais baratas. O treino pela internet funciona com 8 a 40 mil milhões de parâmetros, enquanto as execuções de fronteira voltaram aos clusters centralizados. Os ambientes de execução confiáveis executam inferência confidencial em produção; as provas de conhecimento zero de IA ainda estão no laboratório. Os pagamentos iniciados por agentes de IA rondam os 5 000–11 000 dólares por mês, apesar das vias construídas pela Visa, Mastercard, Stripe e Google. Os dados são um dos poucos setores com compradores reais. Entretanto, quatro empresas de capital em infraestrutura centralizada valem aproximadamente tanto como todos os tokens de IA das camadas de protocolo e de aplicação juntos: a cripto faz a distribuição e a liquidação, e o capital fica com os lucros.
Quando um ASIC compensa: uma fórmula, três medidas
Quando as GPU fixam o preço da mineração, a receita por unidade de computação tende para o seu custo, e um ASIC k vezes mais barato retém no máximo (1 − 1/k) da receita. A curva é côncava: 50% com k = 2, 80% com k = 5, 90% com k = 10. Para lá de k = 5, mais eficiência pouco lucro acrescenta; e face a GPU ociosas que só pagam a eletricidade, o k efetivo pode ser apenas cerca de 2,5.
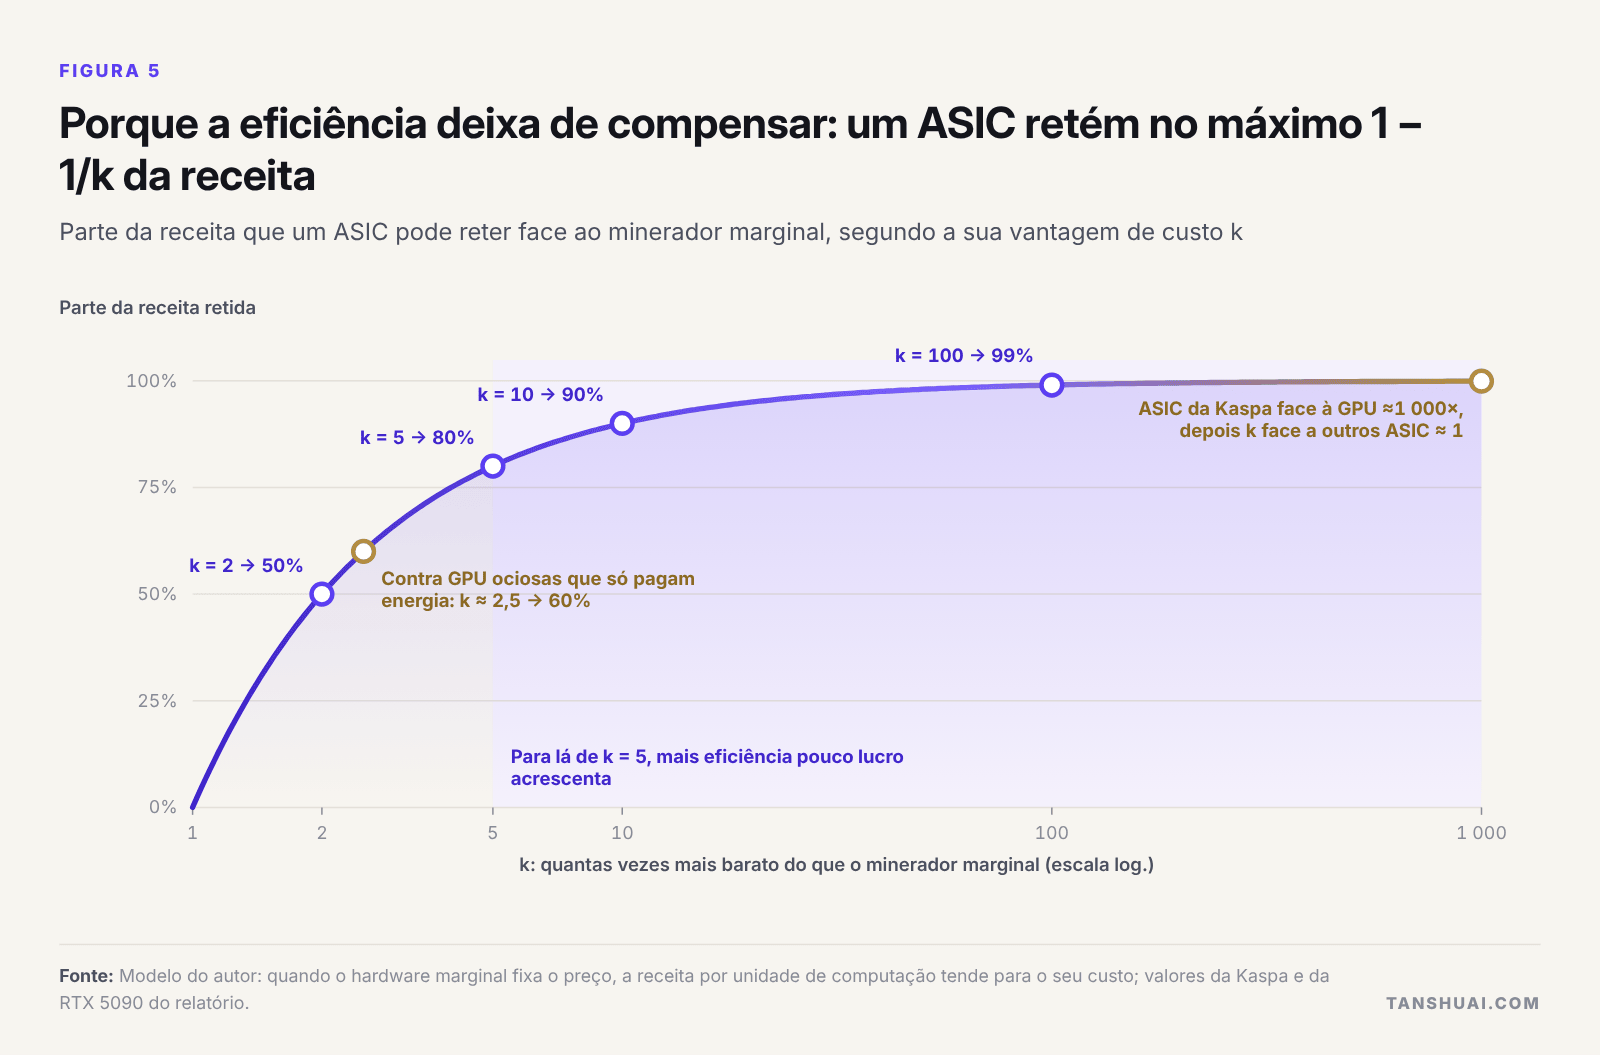 Figura 5. Porque a eficiência deixa de compensar: um ASIC retém no máximo 1 − 1/k da receita.
Decidem então três medidas: o bolo, a escala de retorno e as regras. Os mineradores de bitcoin ganham cerca de 11,5 mil milhões de dólares por ano, os da Pearl cerca de 0,46–0,49 mil milhões, os da Aleo cerca de 31 milhões e os da Kaspa cerca de 18 milhões, menos do que o limite inferior de uma única conceção de chip em 5/4 nm. Para a Pearl, um chip de 20 milhões de dólares com k = 5 precisa de cerca de 4,9 EH/s a funcionar durante um ano para se pagar se as regras se mantiverem, e do dobro se houver apenas metade das hipóteses de se manterem.
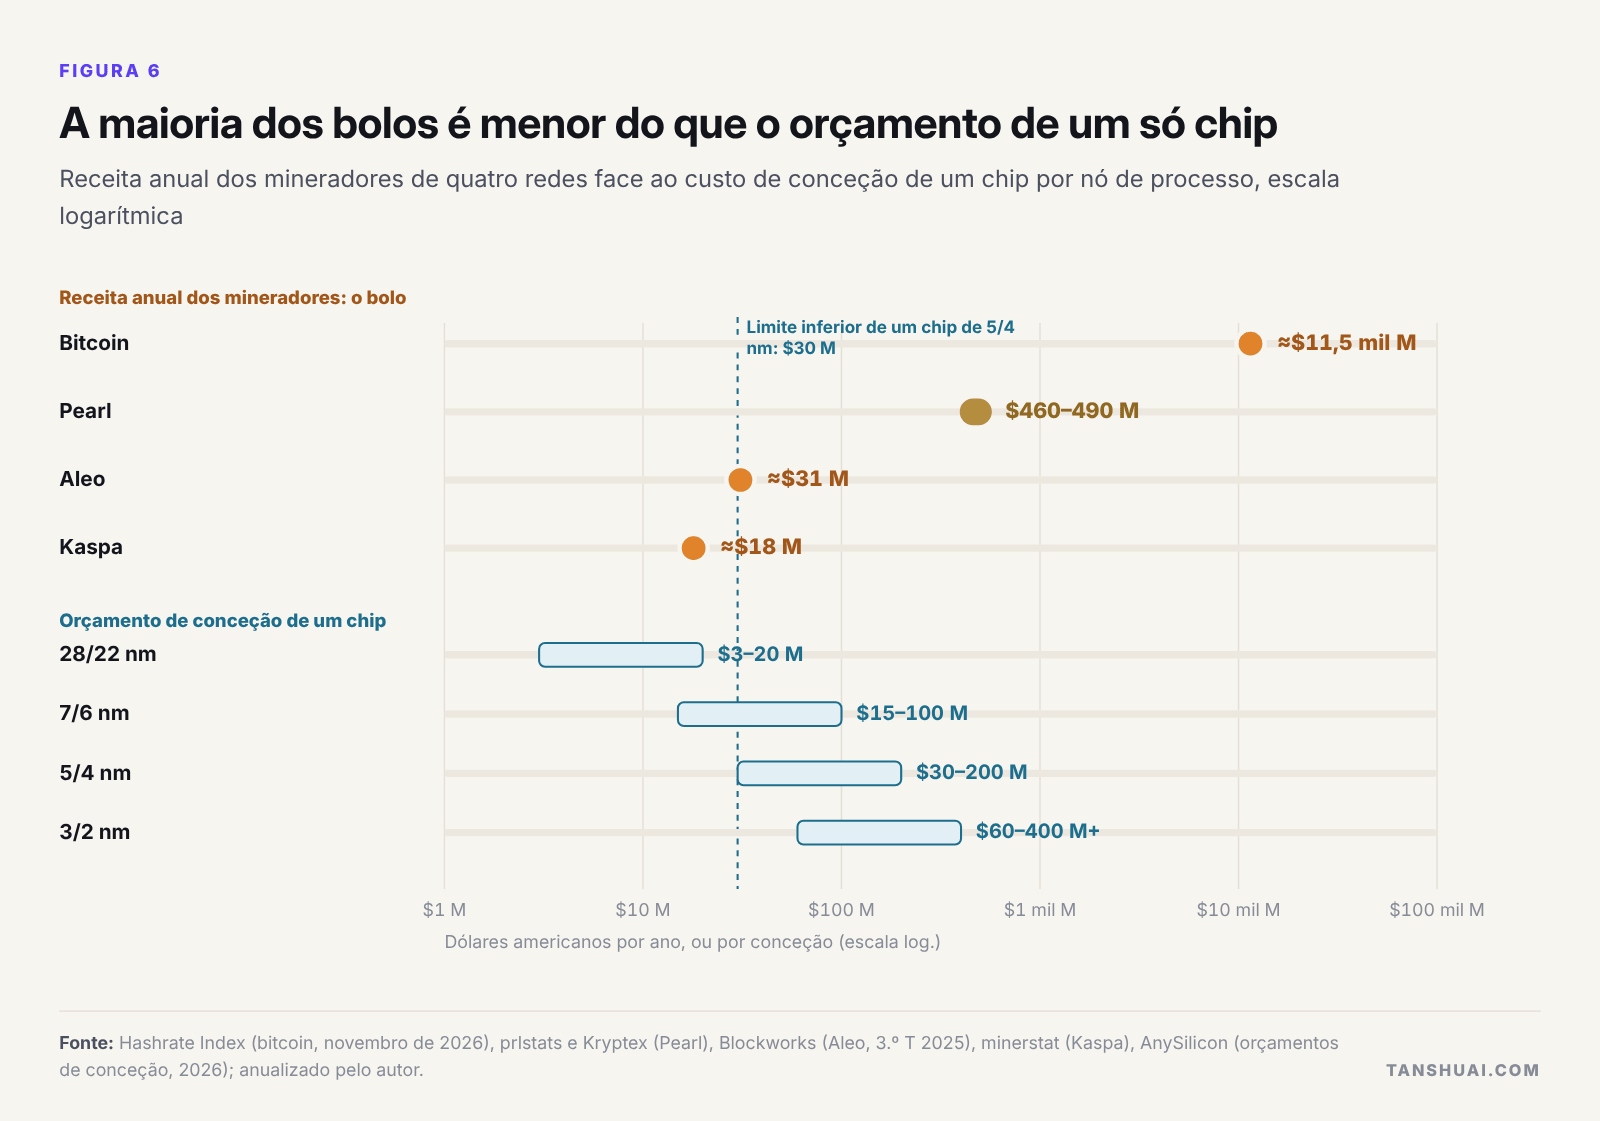 Figura 6. A maioria dos bolos é menor do que o orçamento de um só chip.
Hoje nenhuma rede oferece ao mesmo tempo um bolo grande, regras estáveis e k acima de 1: o k da bitcoin pertence aos incumbentes, as regras da Pearl são as menos estáveis, e os bolos da Kaspa e da Aleo são pequenos demais.
Cinco tipos de chip, cinco respostas
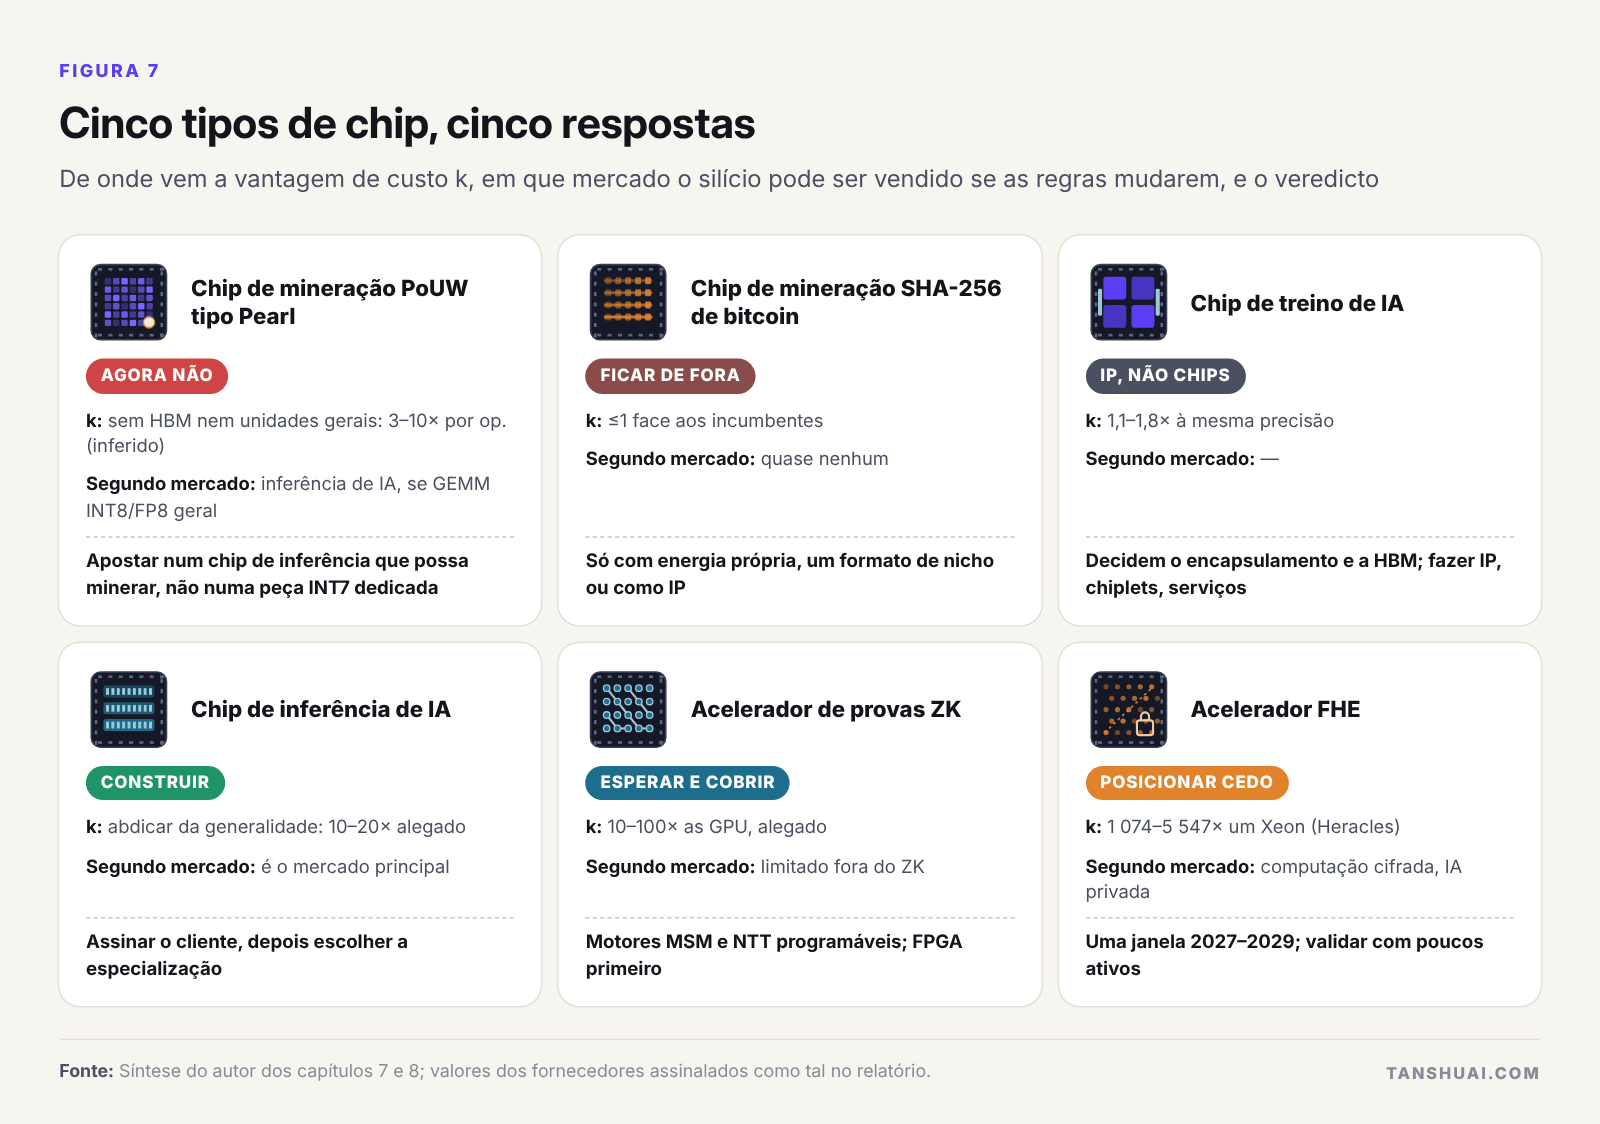 Figura 7. Cinco tipos de chip, cinco respostas.
Para a Pearl, eu não faria agora o tape-out de um chip INT7 dedicado: uma equipa nova precisa de 18 a 24 meses, e o protocolo pode ter passado para FP8 até lá. A melhor aposta é um acelerador de inferência construído sobre GEMM INT8/FP8 geral com operandos em SRAM, para que o silício tenha um segundo mercado se o acesso à mineração se fechar. Uma equipa nova deve ficar fora do mercado de mineradores de bitcoin para venda, onde a Bitmain fornece máquinas de 8,9 J/TH e os concorrentes estão a recuar; os locais com energia valem hoje mais como centros de dados de IA do que como minas. As equipas pequenas não devem construir chips de treino autónomos. Os chips de inferência valem a pena para um cliente assinado, os aceleradores ZK são uma cobertura e os aceleradores FHE são uma posição antecipada para 2027–2029.
Nós de processo e um orçamento por etapas
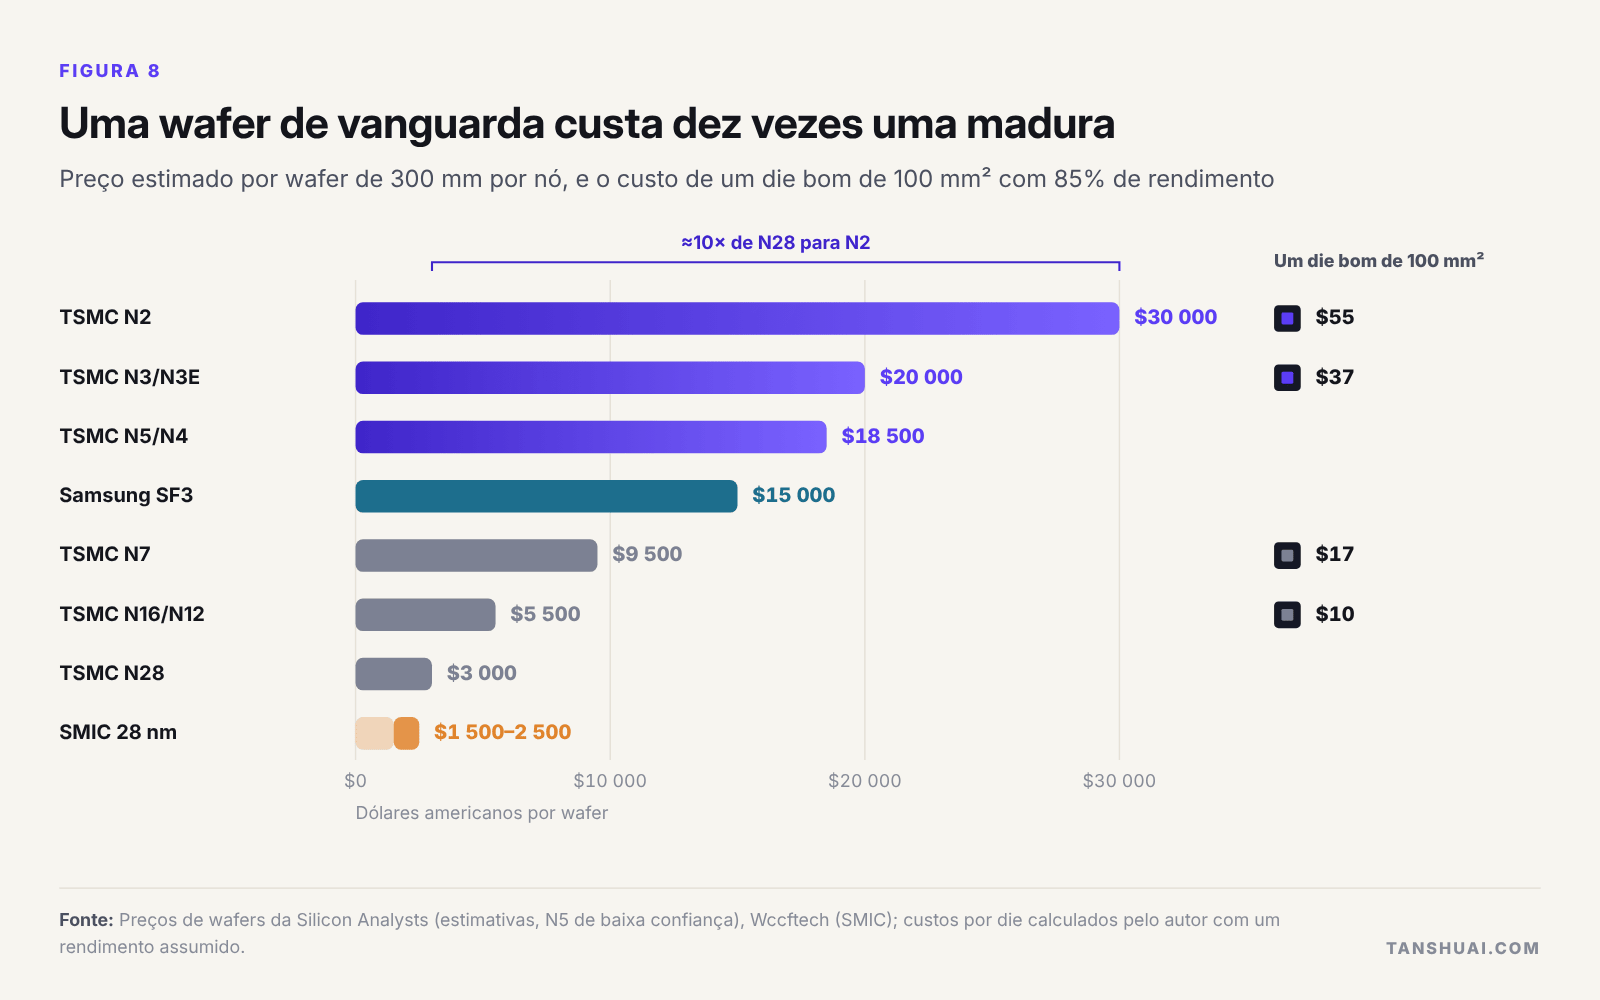 Figura 8. Uma wafer de vanguarda custa dez vezes uma madura.
Deixe que a maior parcela do custo do chip ao longo da sua vida escolha o nó: a energia para chips de computação que funcionam dia e noite, o encapsulamento e a HBM para chips de treino (cerca de 63% do custo de uma H100), e a escolha entre SRAM e HBM para chips de inferência. Um chip de mineração PoUW pode ser prototipado em wafers multiprojeto de 28 ou 16/12 nm e passar para N7/N6 e depois N5/N4 só quando o algoritmo e a receita estiverem estáveis.
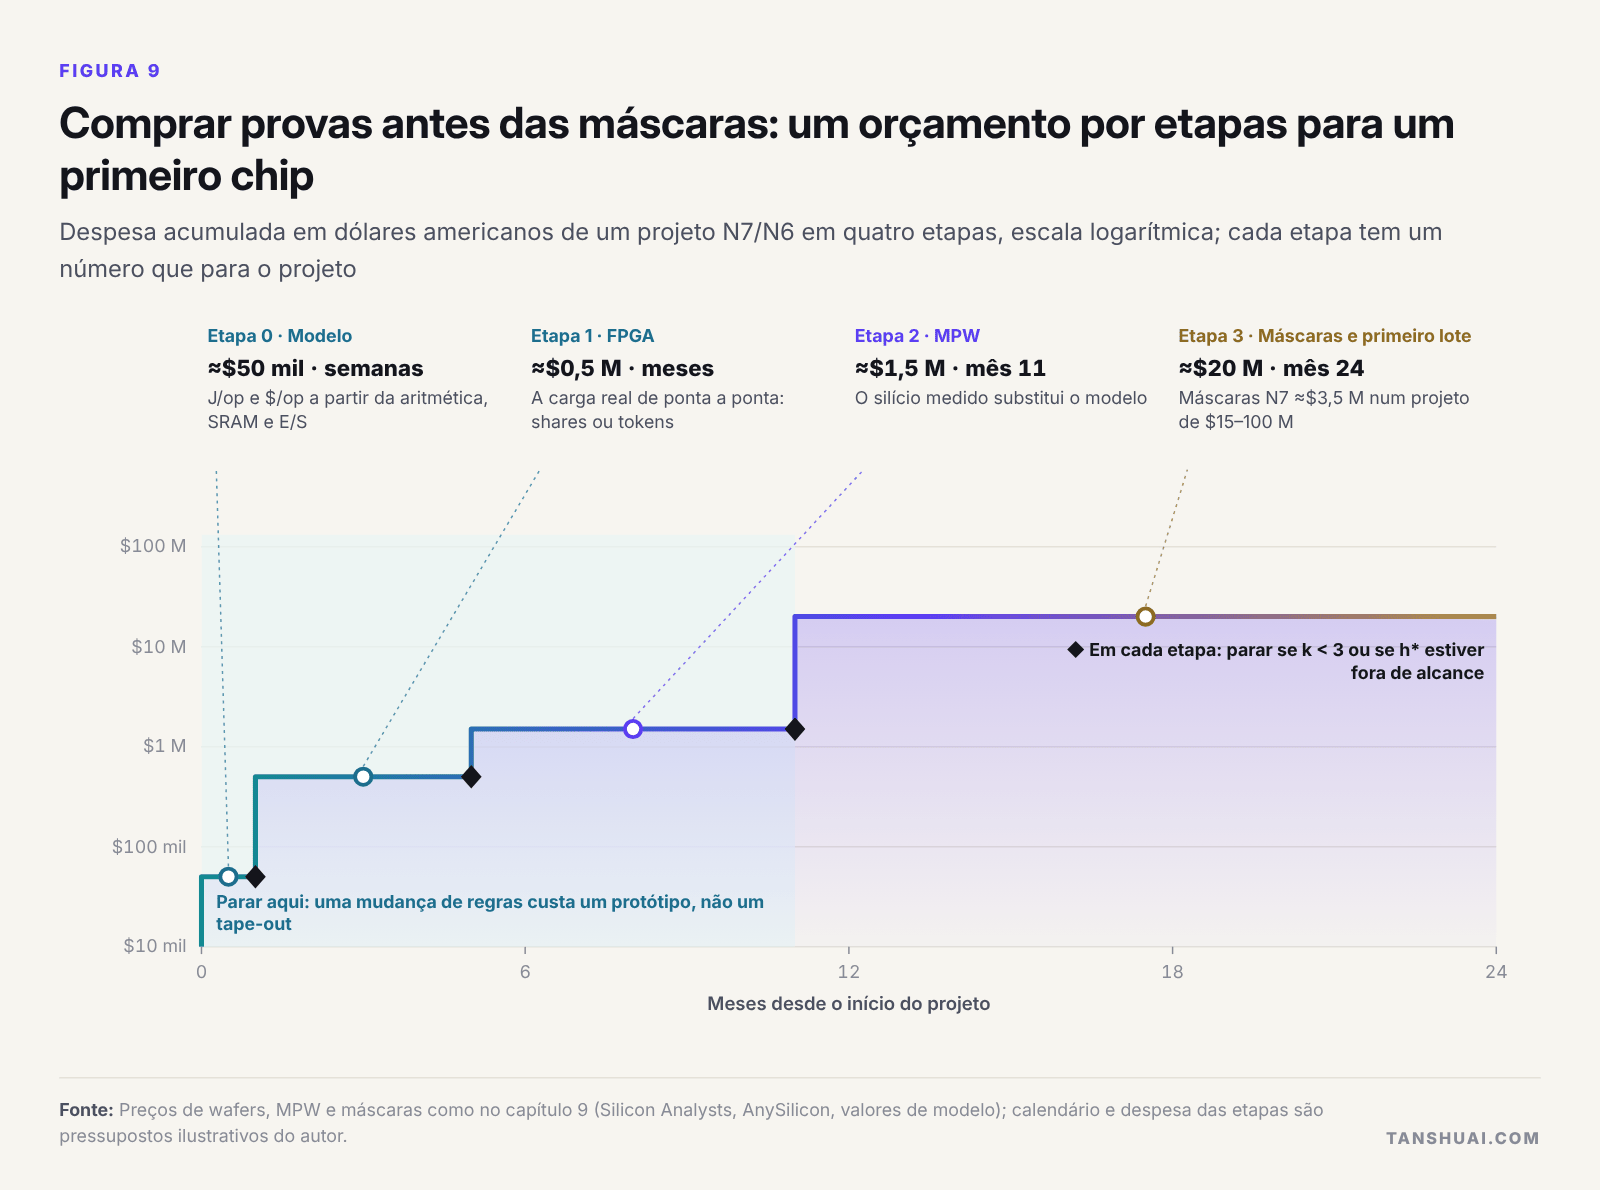 Figura 9. Comprar provas antes das máscaras: um orçamento por etapas para um primeiro chip.
Um primeiro chip deve ser comprado em quatro etapas, cada uma com um número que pare o projeto: um modelo de J/op e $/op, uma FPGA a executar a carga real, uma wafer multiprojeto e só depois um conjunto de máscaras. Em N7/N6, as três primeiras custam cerca de 1,5 milhões de dólares e onze meses; o conjunto de máscaras e o primeiro lote custam mais de dez vezes isso [estimativa]. Se o protocolo mudar a sua aritmética ou o comprador desistir, uma equipa que parou na wafer perde o preço de um protótipo, não o de um tape-out. A eficiência mais barata é arquitetural: manter os operandos em SRAM e deixar de fora a HBM elimina a maior parte do custo de uma GPU antes de se escolher qualquer nó.
Por onde eu começaria
As oportunidades estão onde os domínios se cruzam: a cripto como primeiro cliente, a IA como segundo mercado. A procura de chips à medida em 2026 é esmagadoramente de IA, e as competências de uma equipa de chips de mineração, matrizes de baixa tensão, alimentação de quilowatts e tape-outs rápidos, transferem-se diretamente. Eu seguiria no máximo três caminhos, cada um testado com um pequeno primeiro passo: um acelerador de inferência que também possa minerar, começando por um estudo de quatro semanas de J/op e $/op; serviços de silício à medida com a cripto como primeiro cliente, começando por estudos de viabilidade pagos; e uma rede nativa de IA que assine o seu comprador de computação antes de conceber o seu token.
Descarregar o relatório completo e os diapositivos
O relatório completo cobre em detalhe o mecanismo, a economia e as regras da Pearl, as outras cadeias de trabalho útil e o panorama alargado de IA × cripto, o modelo dos ASIC com o cálculo do retorno, veredictos chip a chip, custos e escolhas de nós, um orçamento por etapas para um primeiro chip, uma lista de sinais a seguir e todas as fontes.
- Computação como Consenso: relatório completo (PDF)
- Computação como Consenso: diapositivos (PDF)
- Edição inglesa: relatório completo · diapositivos
Esta é uma tradução da edição inglesa; em caso de divergência, prevalece a edição inglesa.
Perguntas que não fez mas devia ter feito
Antes de pôr dinheiro ou silício em qualquer projeto IA × cripto, eu perguntaria: quem controla a função de trabalho; qual é o múltiplo de subsídio; quanto custa a próxima etapa e que número o faz parar; qual é a taxa de hash de retorno, com p; qual é o segundo mercado do chip; se o valor fica no token ou no capital; e quem é o primeiro cliente pagante, com nome.
São áreas que podemos explorar em conjunto, através de intercâmbio e colaboração técnicos: chips à medida para mineração, treino e inferência de IA, e aceleradores; desenvolvimento de IA; e sistemas IA × cripto, da cadeia ao nó e ao chip. Pode contactar-me em i@tanshuai.com.
Sobre o autor
Tan Shuai é tecnólogo e fundador, com mais de vinte anos de trabalho em chips, hardware e software de sistema, e 20 patentes concedidas. Tem atrás de si muitos anos de I&D e gestão de chips fabless, incluindo a conceção de datapaths ASIC full-custom para chips de mineração de criptomoedas e chips multimédia para câmaras. O seu trabalho levou-o a Silicon Valley, Nova Iorque, Chicago, Taiwan, à Grande Área da Baía (Shenzhen e Hong Kong), ao Vietname e à Malásia. Hoje trabalha como investigador e programador de IA.
Discussão técnica: i@tanshuai.com.