
En blockkedja körs nu på samma matrismultiplikation som AI, med omkring 90 EH/s. Jag läste dess kod, dess kedjedata och ekonomin runt den för att besvara tre frågor: vad inom AI × krypto som har betalande kunder, när en ASIC är värd att bygga, och vilken processnod som passar vilket chip. Med hela rapporten och bildspelet.
Sammandrag
Pearl, som lanserades i april 2026, är den första blockkedjan vars arbetsbevis är matrismultiplikation av AI-typ i stor skala. Den 13 november 2026 körde nätverket med omkring 90 EH/s, där en H är en INT7-multiplikation med ackumulering: heltalskapaciteten hos omkring 122 000 H100. Det fungerar som teknik. Det är ännu inte nyttigt: omkring 1 % av blocken bär verkligt AI-arbete, eftersom en GPU som utvinner medan den kör inferens bara behåller 1 % till 27 % av en dedikerad miners hashkraft. Inom AI × krypto syns verifierbar betald efterfrågan på tre ställen, försäljning av inferens, försäljning av data och försäljning av integritet, medan subventionerna ligger på 4 till 360 gånger de externa intäkterna. För chip är vinsttaket för en ASIC intäkten per beräkningsenhet gånger (1 − 1/k), så effektivitet bortom k = 5 ger lite; det som avgör är pottens storlek, reglernas stabilitet och en andra marknad. Inget nätverk erbjuder alla tre i dag. Rätt processnod bestäms av den största posten i chipets livstidskostnad, och själva chipet bör köpas i steg, så att en regeländring kostar en prototyp snarare än en tape-out.
Varför jag tittade på detta
Jag har i många år konstruerat chip, bland annat helt kundanpassade ASIC-datavägar för mining av kryptovalutor, och i dag arbetar jag med AI. När en kedja dök upp vars säkerhetsbudget bokstavligen prissätts i tensorgenomströmning var frågorna för någon som jag självklara: är arbetet nyttigt, skulle ett dedikerat chip vinna, och vad skulle det kosta att bygga ett?
Jag läste Pearls kod och protokollförslag, kedjedata från en oberoende fullnod, företagsrapporter, artiklar inom kryptografi, datorarkitektur och maskininlärning, prisdata från foundries och leverantörer samt branschpressen. Varje siffra nedan avser 13 november 2026, och belopp anges i US-dollar. Det här notatet är hur jag lärde mig fältet; jag delar det så att andra kan granska det, använda det och argumentera emot det. Hela rapporten, med alla källor, finns i slutet.
Resultaten i korthet
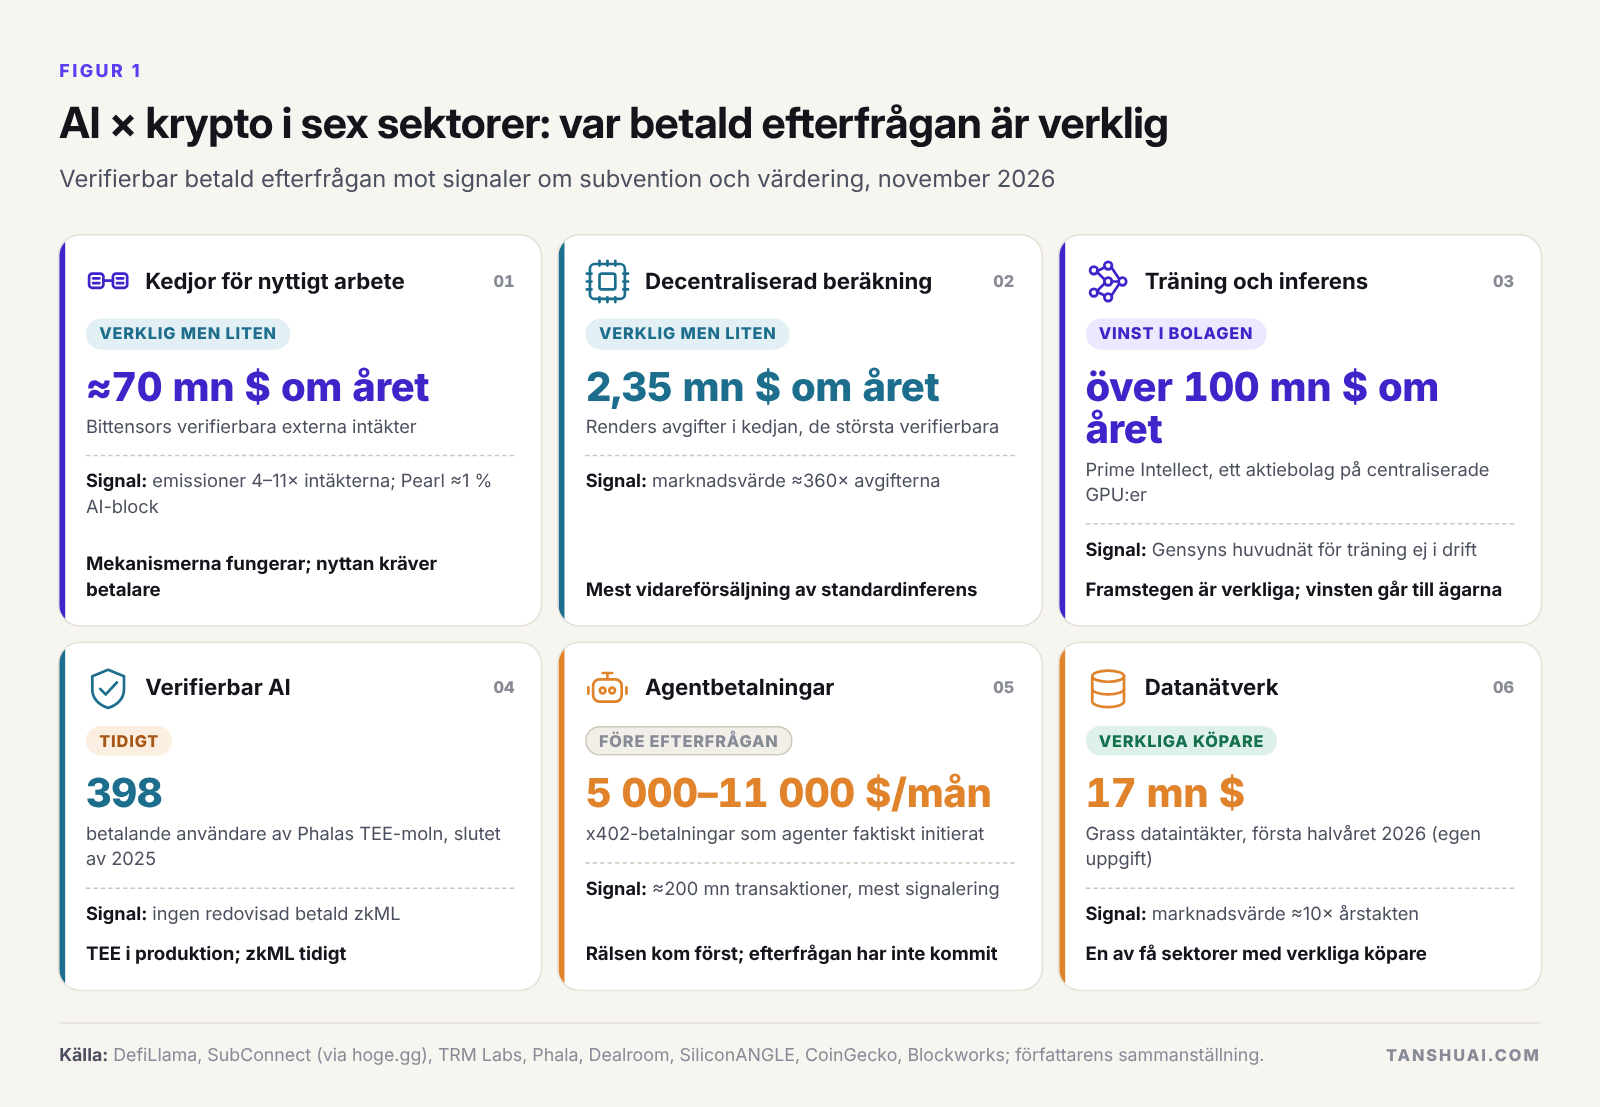 Figur 1. AI × krypto i sex sektorer: var betald efterfrågan är verklig.
| Fråga | Kort svar |
|---|---|
| Fungerar Pearl, och är arbetet nyttigt? | Det fungerar: omkring 90 EH/s matrismultiplikation säkrar kedjan. Det är ännu inte nyttigt: omkring 1 % av blocken bär AI-arbete |
| Var finns den verkliga betalda efterfrågan? | Inferens, data och integritet. Agentbetalningar, zkML och decentraliserad träning är fortfarande före efterfrågan |
| Är en ASIC värd att bygga? | Bara med stor pott, stabila regler och en andra marknad; inget nätverk erbjuder alla tre i dag |
| Vilka chip bör ett litet team bygga? | Inferensacceleratorer som också kan utvinna, inferenschip för en tecknad kund, tidigt FHE-arbete; inte bitcoin-miners till försäljning eller träningschip |
| Vad kostar ett första chip? | Köp det i steg: en modell, en FPGA och en MPW når uppmätt kisel för omkring 1,5 miljoner dollar, före masker som kostar miljoner |
Pearl: en MAC-operation är en hash
Pearl vilar på ett resultat från 2025 av Ilan Komargodski och Omri Weinstein: ett bevis på nyttigt arbete för varje matrisprodukt, till 1 + o(1) gånger kostnaden för multiplikationen. Miners multiplicerar brusiga matriser, hashar ackumulatorn i varje utdataruta till en lott och bevisar den vinnande rutan med ett nollkunskapsbevis under 60 KB. I konsensuskoden är en H en krediterad INT7 × INT7 → INT32-multiplikation med ackumulering, så för första gången prissätts en blockkedjas säkerhetsbudget i AI-acceleratorers tensorgenomströmning.
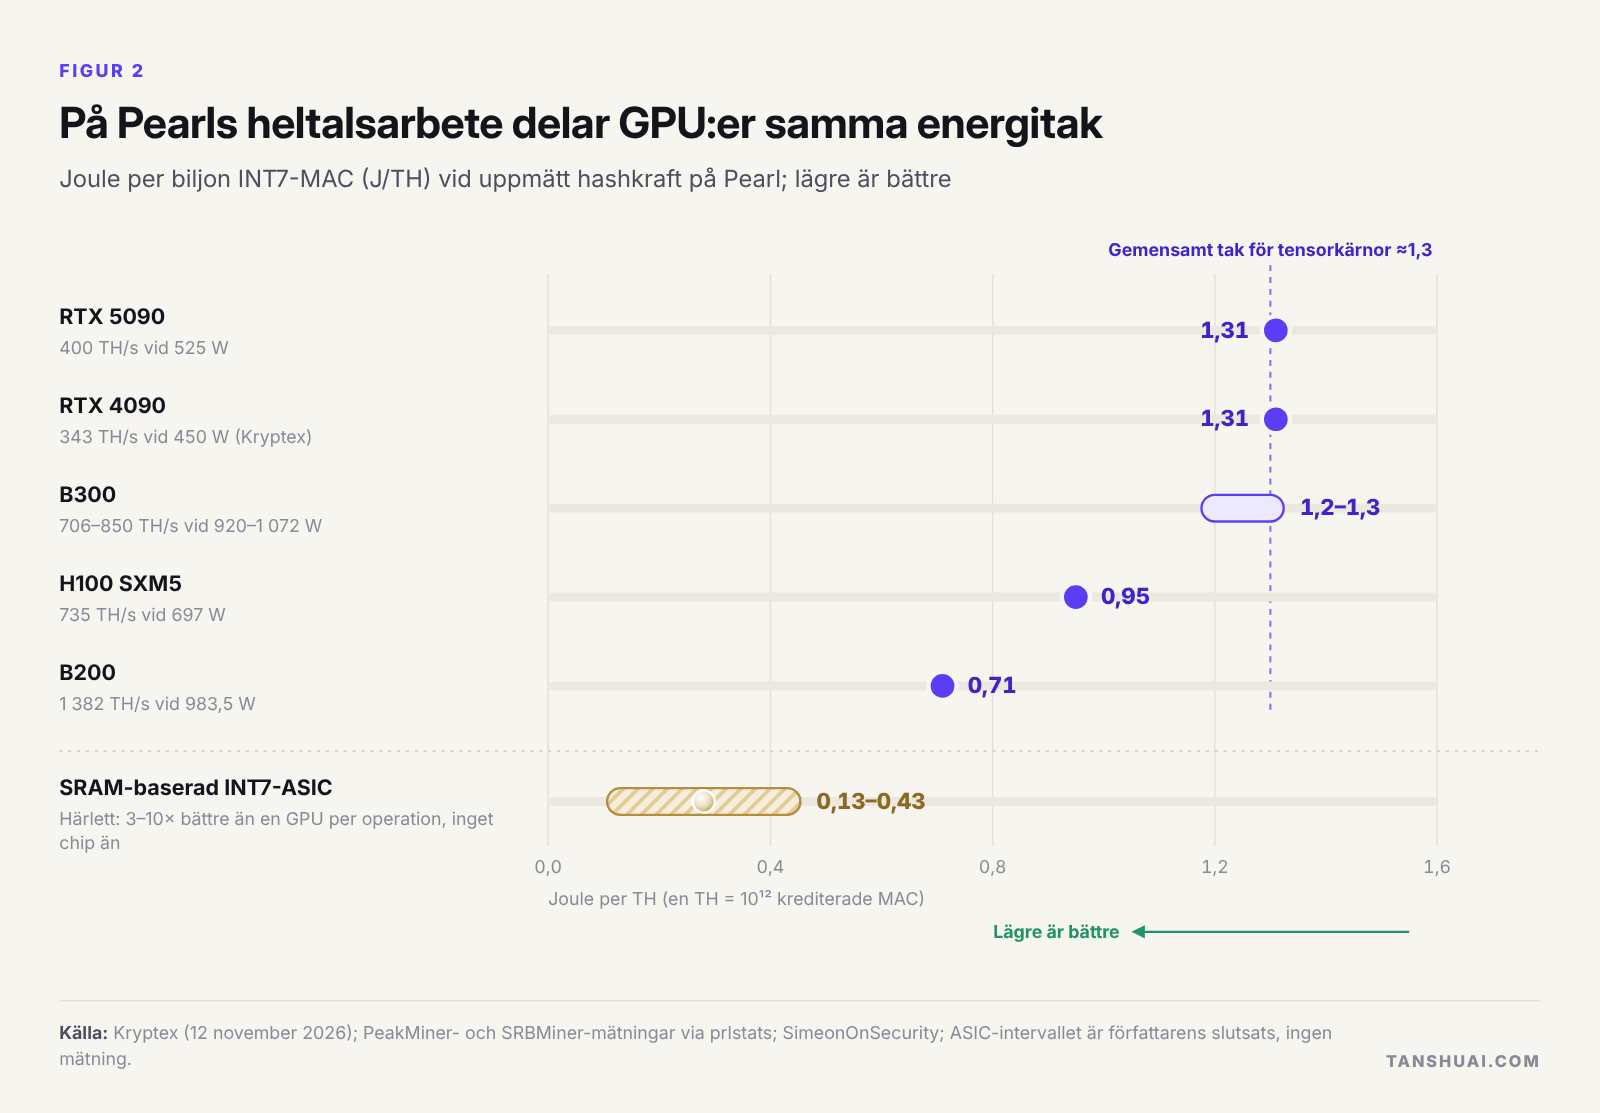 Figur 2. På Pearls heltalsarbete delar GPU:er samma energitak.
Spelkort och datacenterkortet B300 möts vid omkring 1,3 J/TH, och även B200 når bara 0,71. Just det gemensamma taket är vad ett dedikerat chip skulle kunna bryta: en krets som bara multiplicerar 7-bitars heltal ur SRAM på chipet, utan HBM eller generella enheter, skulle rimligen kunna bli 3 till 10 gånger bättre per operation. Samtidigt flyttar NVIDIA sitt nyaste kisel bort från INT8 mot FP8 och FP4, vilket är skälet till att Pearl förbereder en ändring av sin aritmetik.
Pearls ekonomi: teoremet håller, incitamentet gör det inte
Pearls hashkraft följer priset. Nätverket gick från 0,01 EH/s den andra dagen till 23–26 EH/s i slutet av maj, låg kvar på 21–39 EH/s under en sommar då priset föll omkring 86 %, och nådde omkring 90 EH/s sedan priset stigit ungefär tiofaldigt under hösten. Omkring 120 miljoner mynt, ungefär 32 % av dagens utbud, utvanns under de första sex dagarna, och utbudet växer med omkring 78 % under de kommande 12 månaderna. Ett RTX 5090 tjänar nu omkring 5–6 dollar om dagen.
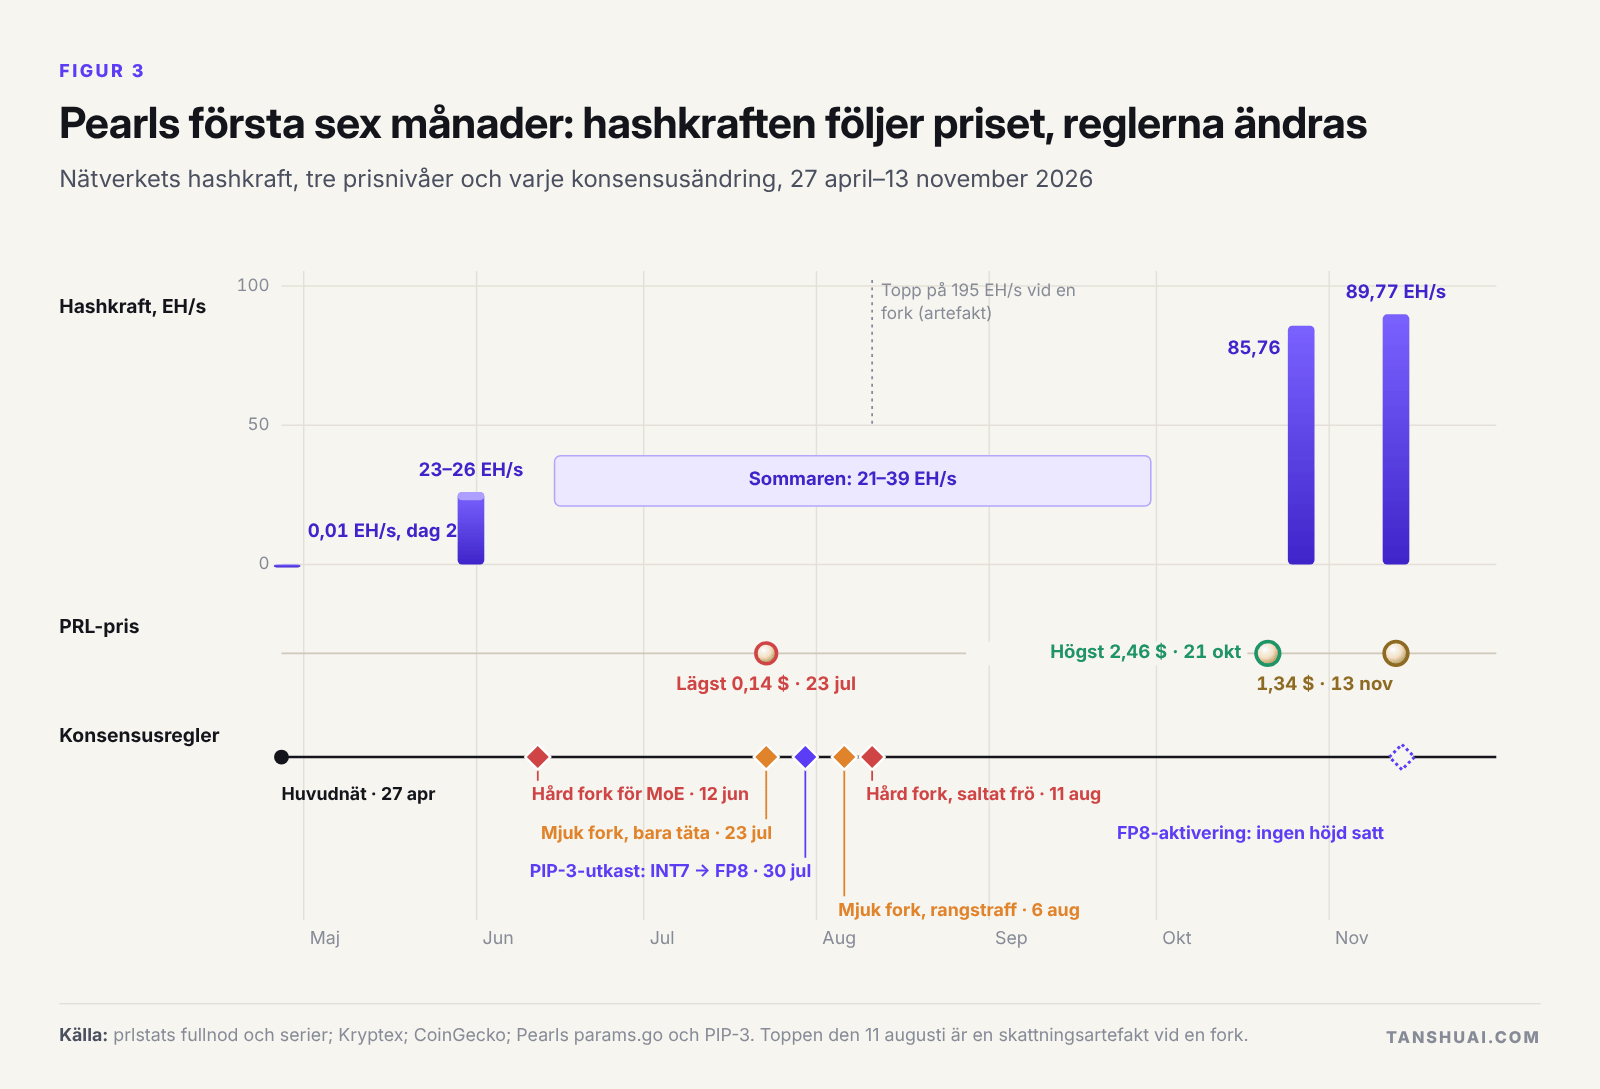 Figur 3. Pearls första sex månader: hashkraften följer priset, reglerna ändras.
Det nyttiga är där modellen brister. Mining inuti verklig inferens kostar lite på inferenssidan, omkring 5 % till 9 % av genomströmningen, men tjänar lite på miningsidan: Pearls insticksprogram utvinner bara på långa prefill-satser, så ett kort som kör en chattlast behåller omkring 5 % av en dedikerad miners hashkraft. Rationella miners multiplicerar därför slumpmatriser, och protokollet kan inte avgöra skillnaden. Det enda offentliga inferenspartnerskapet finns inte längre i leverantörens serverlösa API. Pearls nytta är ett kommersiellt problem utanför kedjan: någon måste betala för inferensen.
Reglerna är den andra risken. Från juni till augusti aktiverade labbet fyra konsensusändringar vid hårdkodade höjder, och dess utkast PIP-3 flyttar mining till FP8 med bitexakta enhetsprofiler för bara två NVIDIA-arkitekturer. Ett talformat kan vara nyttigt för AI, verifierbart bit för bit och hårdvaruneutralt, men högst två av de tre.
Inom AI × krypto: subventioner är bränsle, inte en affärsmodell
Andra kedjor för nyttigt arbete berättar samma historia. Kaspa lade en matrisprodukt i sin hash och fick ändå ASIC:er inom 16 månader; dess bästa maskin tjänar nu 0,86 dollar om dagen. Aleos syntetiska bevispussel fick dedikerad hårdvara på fem månader och betalade bevisare 175–180 gånger avgifterna. Bittensor är det enda nätverket i gruppen med externa intäkter i stor skala, omkring 70 miljoner dollar om året, mot mer än 300 miljoner dollar i emissioner.
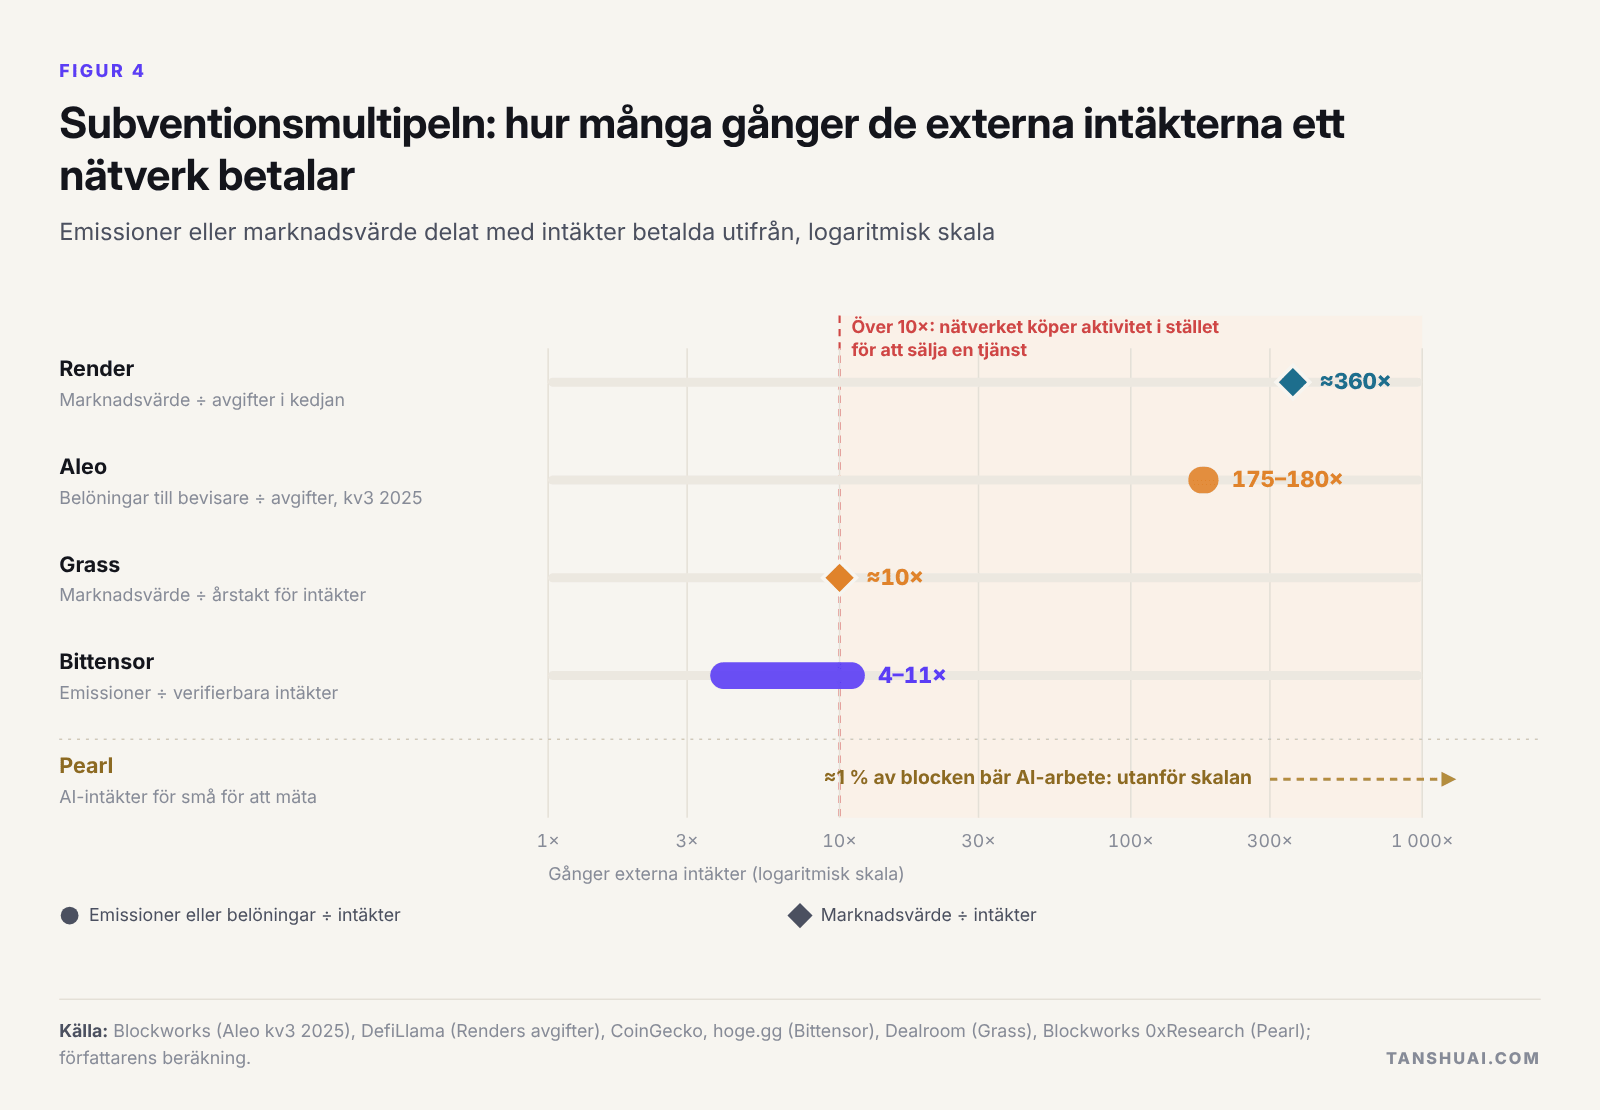 Figur 4. Subventionsmultipeln: hur många gånger de externa intäkterna ett nätverk betalar.
Bortom konsensus är bilden verklig efterfrågan i liten skala. Decentraliserade GPU-marknader säljer standardinferens och slår hyperskalarnas priser men inte de billigaste neocloudernas. Träning över internet fungerar med 8 till 40 miljarder parametrar, medan körningar i frontskala gick tillbaka till centraliserade kluster. Betrodda exekveringsmiljöer kör konfidentiell inferens i produktion; nollkunskapsbevis för AI är fortfarande i labbet. Betalningar som initieras av AI-agenter uppgår till omkring 5 000–11 000 dollar i månaden trots räls byggd av Visa, Mastercard, Stripe och Google. Data är en av få sektorer med verkliga köpare. Samtidigt är fyra aktiebolag på centraliserad infrastruktur värda ungefär lika mycket som alla AI-tokens på protokoll- och applikationsnivå tillsammans: kryptot sköter distribution och avräkning, och aktierna tar vinsterna.
När en ASIC lönar sig: en formel, tre måttstockar
När GPU:er sätter priset på mining går intäkten per beräkningsenhet mot deras kostnad, och en ASIC som är k gånger billigare behåller högst (1 − 1/k) av intäkterna. Kurvan är konkav: 50 % vid k = 2, 80 % vid k = 5, 90 % vid k = 10. Bortom k = 5 ger mer effektivitet lite vinst; och mot lediga GPU:er som bara betalar för el kan det effektiva k vara bara omkring 2,5.
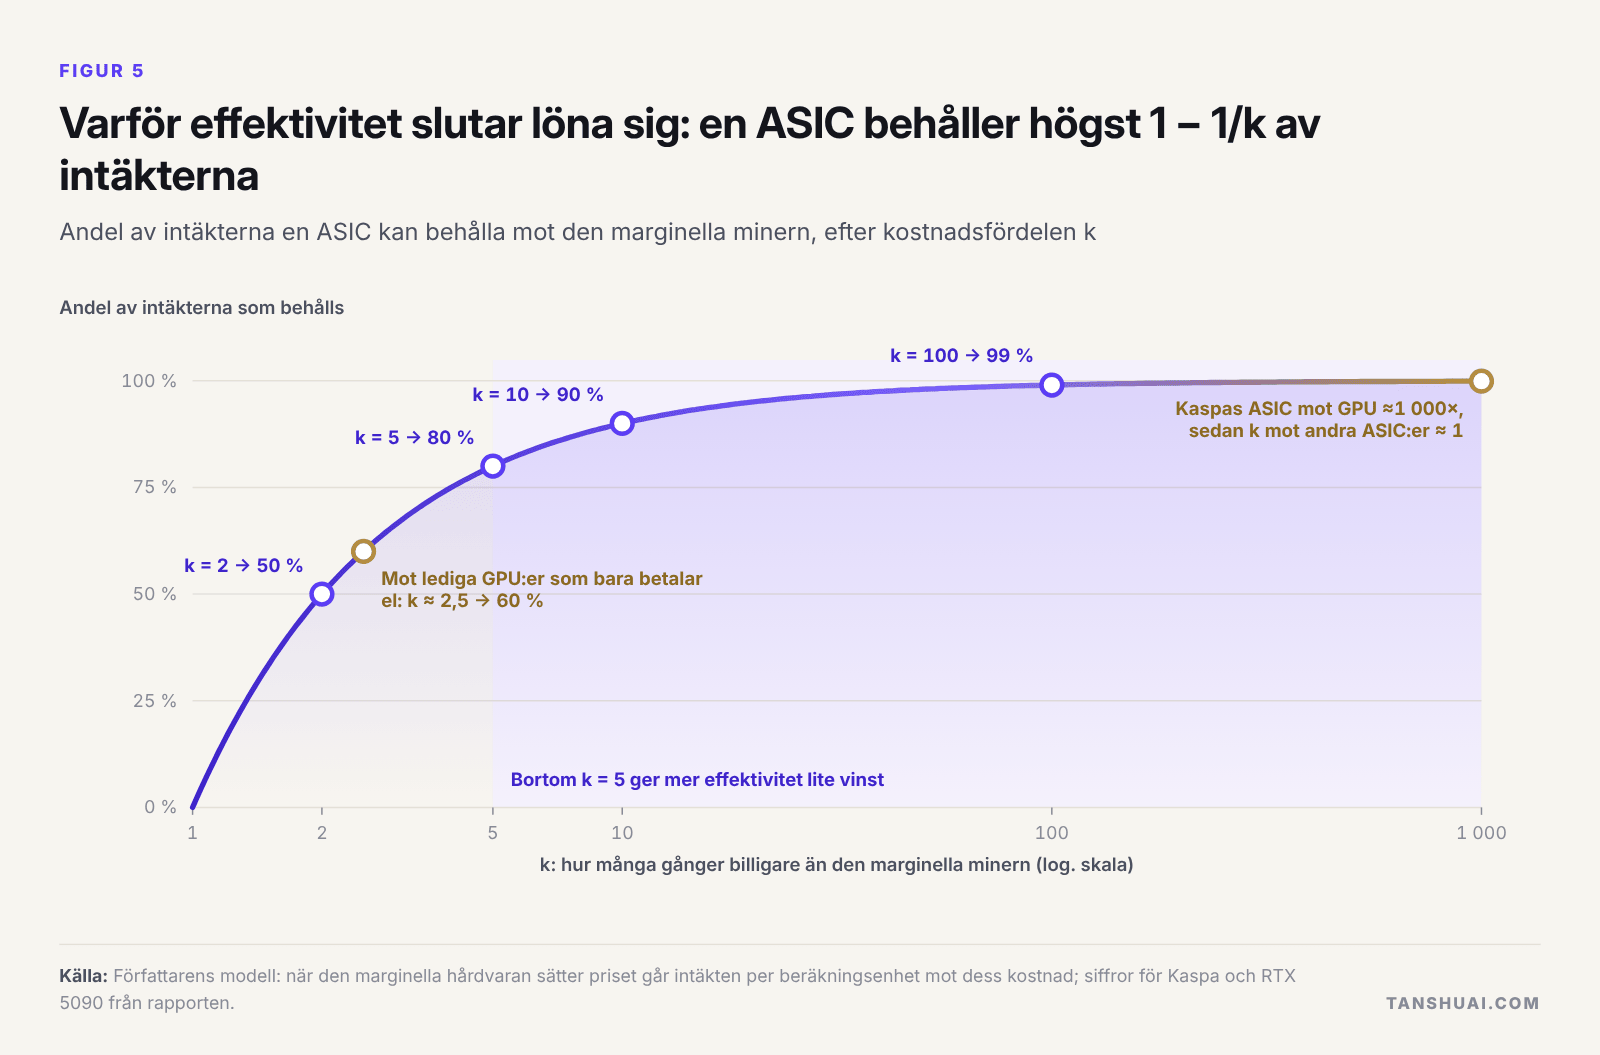 Figur 5. Varför effektivitet slutar löna sig: en ASIC behåller högst 1 − 1/k av intäkterna.
Tre måttstockar avgör sedan: potten, återbetalningsskalan och reglerna. Bitcoin-miners tjänar omkring 11,5 miljarder dollar om året, Pearls omkring 0,46–0,49 miljarder dollar, Aleos omkring 31 miljoner dollar och Kaspas omkring 18 miljoner dollar, mindre än den nedre gränsen för en enda chipdesign på 5/4 nm. För Pearl behöver ett chip för 20 miljoner dollar med k = 5 omkring 4,9 EH/s i drift under ett år för att betala sig om reglerna håller, och dubbelt så mycket om de bara håller med lika odds.
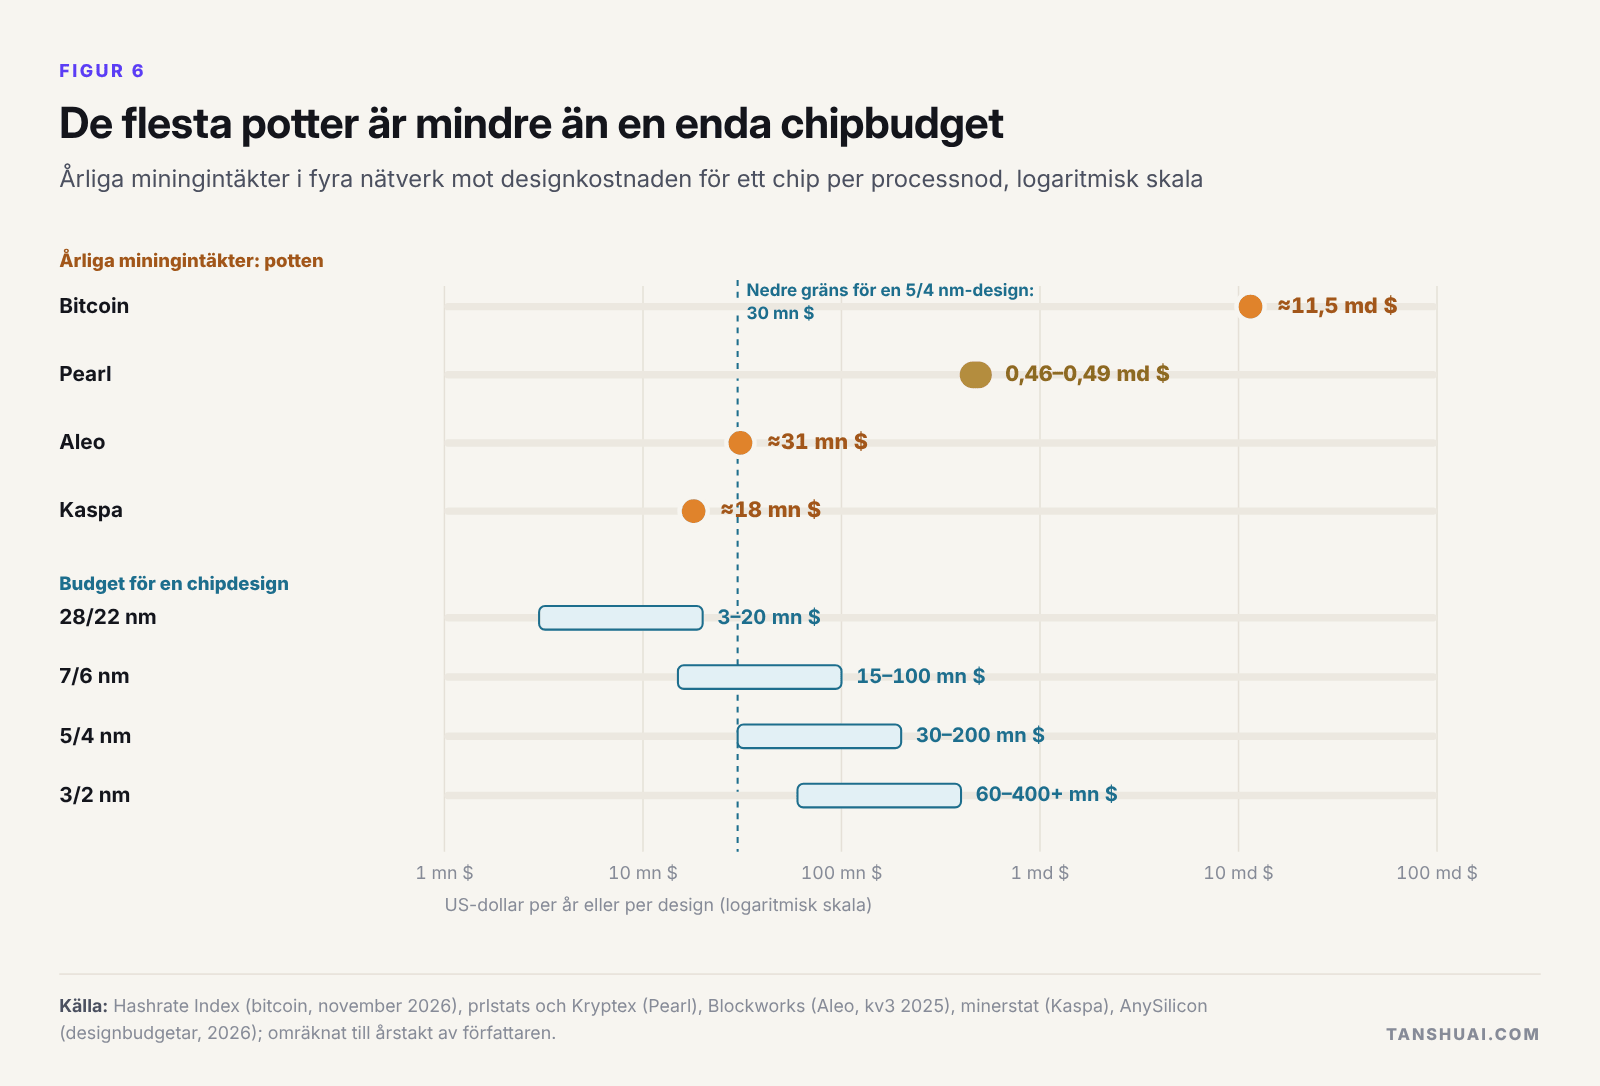 Figur 6. De flesta potter är mindre än en enda chipbudget.
I dag erbjuder inget nätverk stor pott, stabila regler och k över 1 på samma gång: bitcoins k tillhör de etablerade, Pearls regler är minst stabila, och Kaspas och Aleos potter är för små.
Fem chiptyper, fem svar
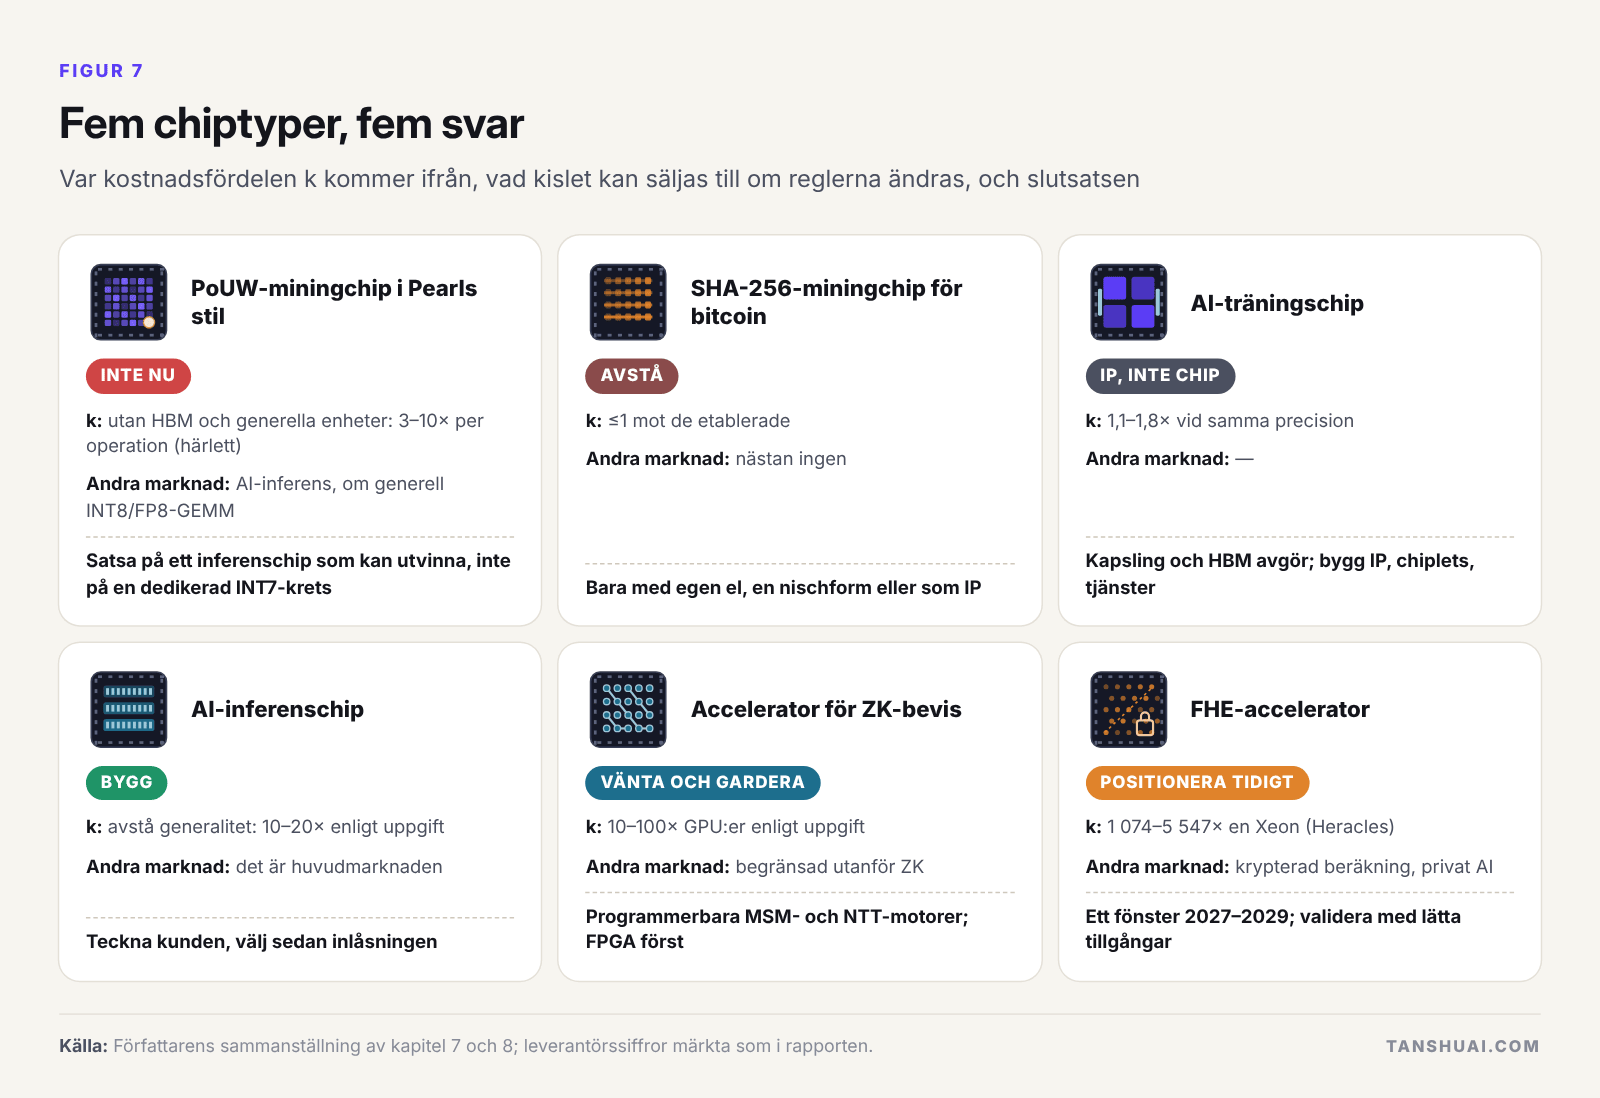 Figur 7. Fem chiptyper, fem svar.
För Pearl skulle jag inte göra en tape-out av ett dedikerat INT7-chip nu: ett nytt team behöver 18 till 24 månader, och protokollet kan ha gått över till FP8 till dess. Den bättre satsningen är en inferensaccelerator byggd på generell INT8/FP8-GEMM med operander i SRAM, så att kislet har en andra marknad om tillgången till mining stängs. Ett nytt team bör hålla sig borta från marknaden för bitcoin-miners till försäljning, där Bitmain levererar maskiner på 8,9 J/TH och utmanarna drar sig tillbaka; kraftanläggningar är nu mer värda som AI-datacenter än som gruvor. Små team bör inte bygga fristående träningschip. Inferenschip är värda att bygga för en tecknad kund, ZK-acceleratorer är en gardering, och FHE-acceleratorer är en tidig position för 2027–2029.
Processnoder och en budget i steg
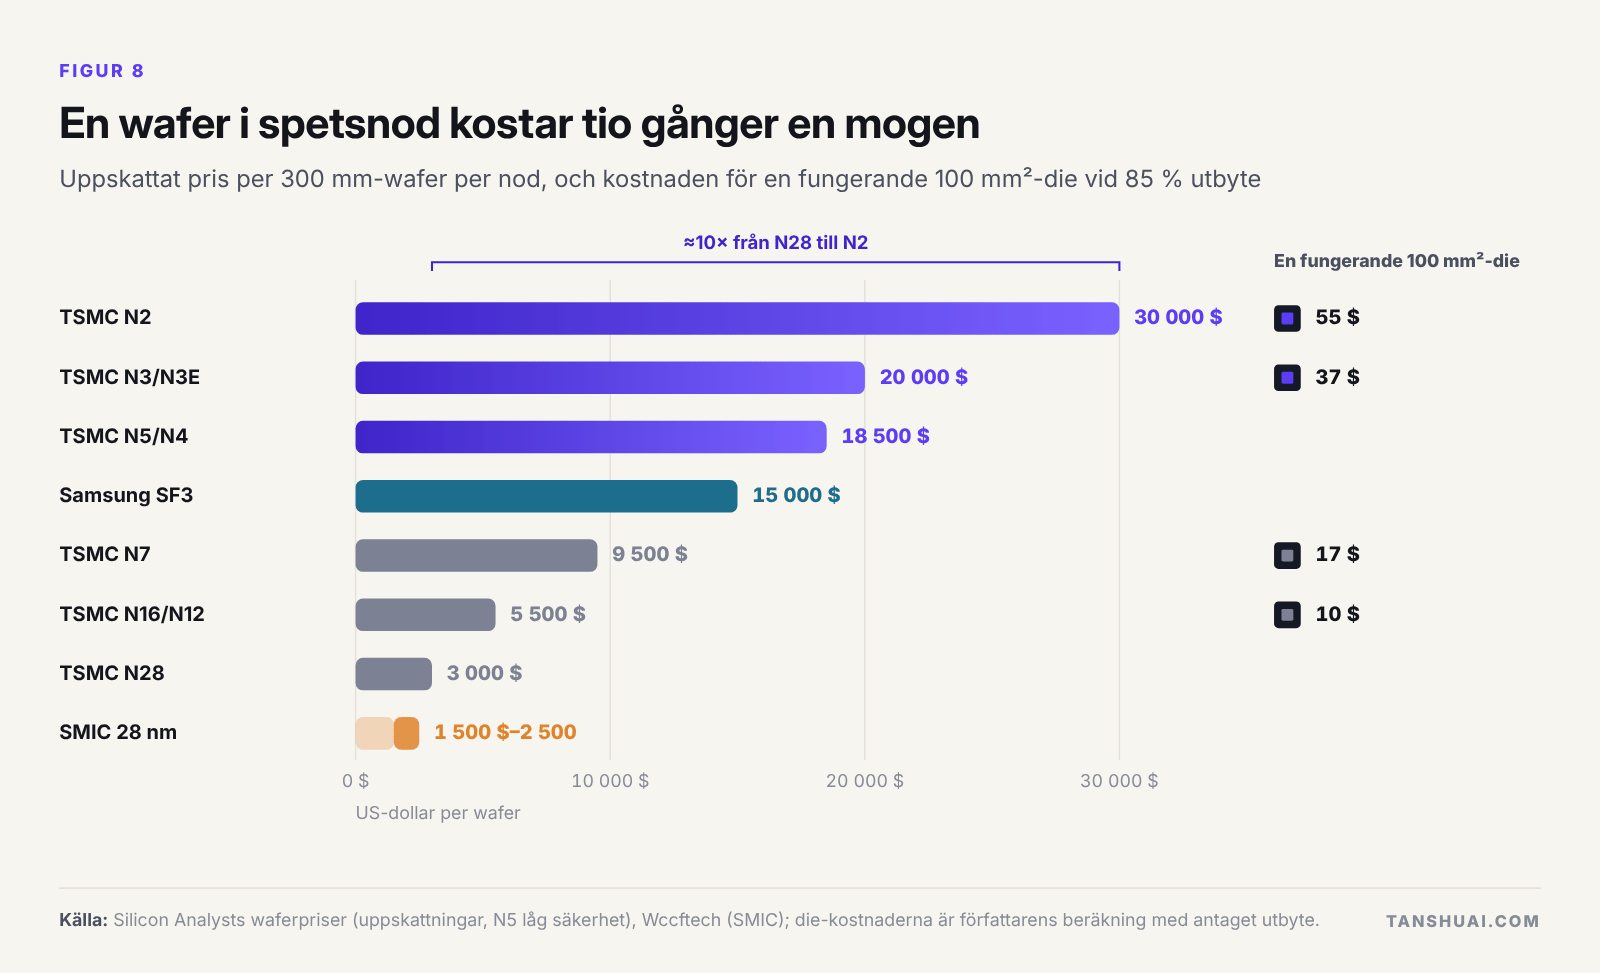 Figur 8. En wafer i spetsnod kostar tio gånger en mogen.
Låt den största posten i chipets livstidskostnad välja nod: energi för beräkningschip som går dygnet runt, kapsling och HBM för träningschip (omkring 63 % av kostnaden för en H100), och valet mellan SRAM och HBM för inferenschip. Ett PoUW-miningchip kan tas fram som prototyp på multiprojektwafers på 28 eller 16/12 nm och flytta till N7/N6 och sedan N5/N4 först när algoritmen och intäkterna är stabila.
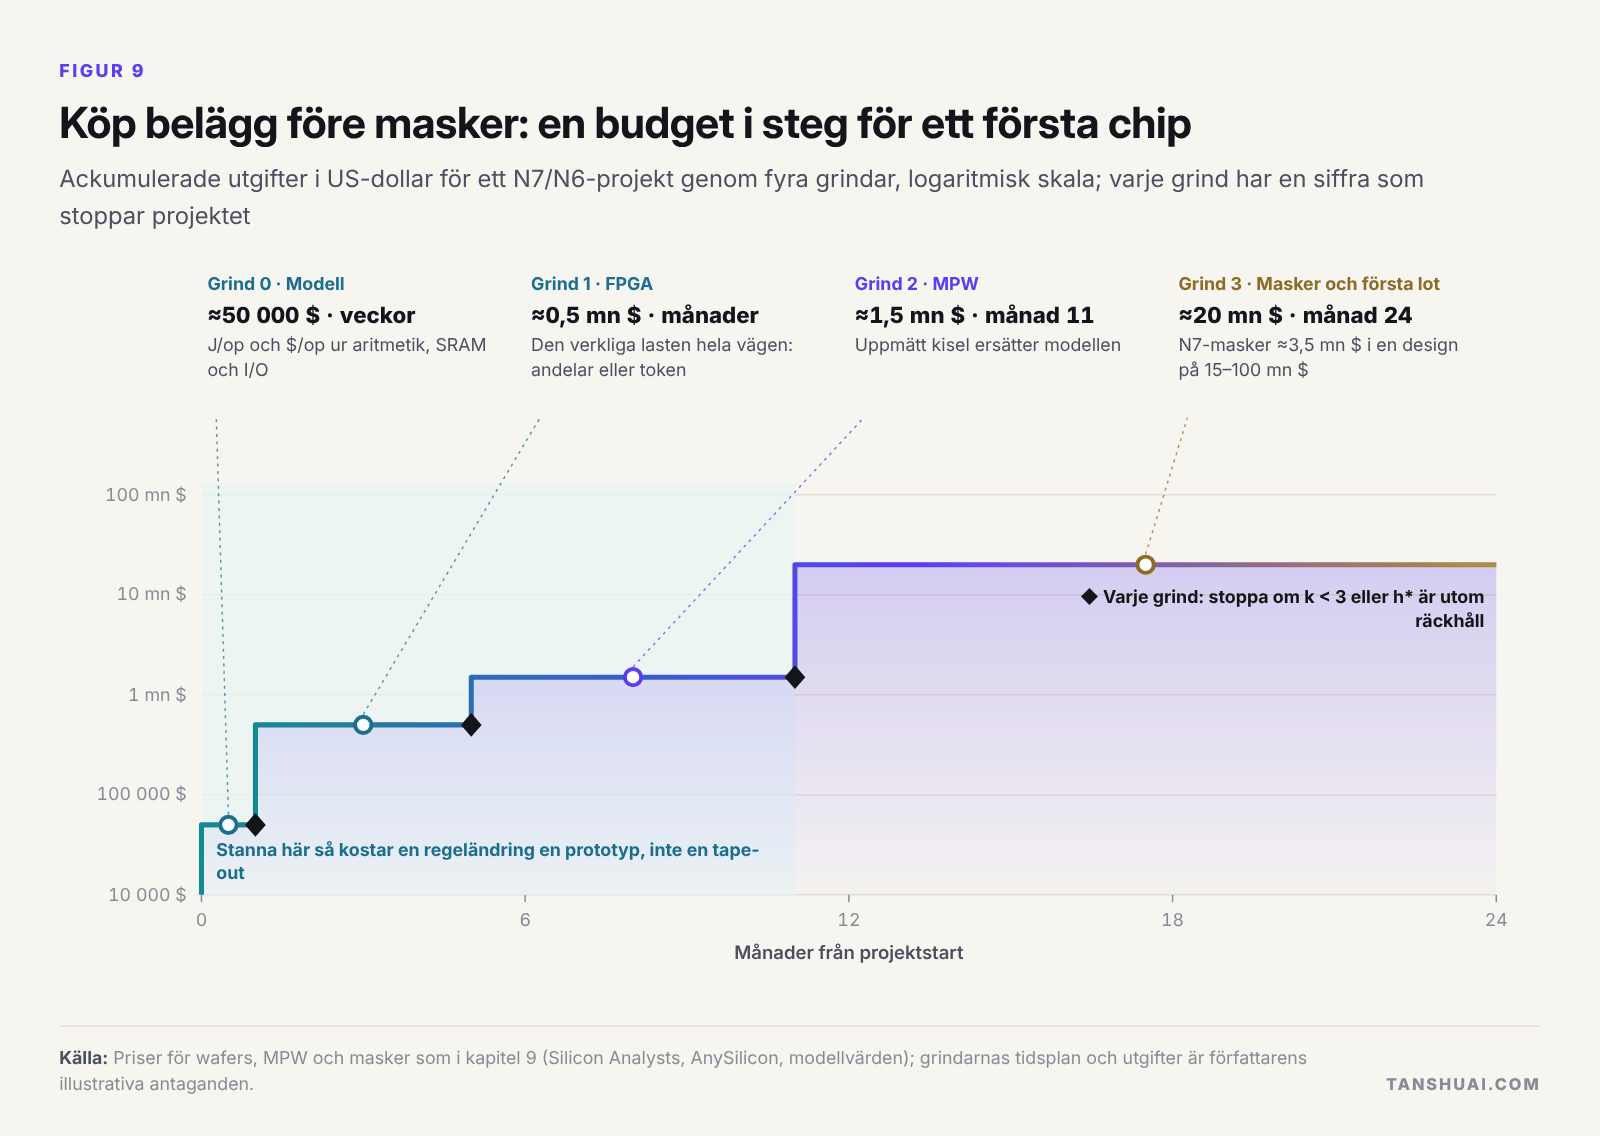 Figur 9. Köp belägg före masker: en budget i steg för ett första chip.
Ett första chip bör köpas i fyra steg, vart och ett med en siffra som stoppar projektet: en modell av J/op och $/op, en FPGA som kör den verkliga lasten, en multiprojektwafer och först därefter ett maskset. På N7/N6 kostar de tre första omkring 1,5 miljoner dollar och elva månader; masksetet och den första loten kostar mer än tio gånger så mycket [uppskattning]. Om protokollet ändrar sin aritmetik eller köparen går ifrån förlorar ett team som stannade vid wafern priset för en prototyp, inte för en tape-out. Den billigaste effektiviteten är arkitektonisk: att hålla operanderna i SRAM och utelämna HBM tar bort större delen av en GPU:s kostnad innan någon nod har valts.
Var jag skulle börja
Möjligheterna finns där fälten korsas: kryptot som första kund, AI som andra marknad. Efterfrågan på kundanpassade chip 2026 är överväldigande AI, och ett miningchipteams kunnande, lågspänningsmatriser, kraftmatning i kilowattklassen och snabba tape-outs, går att överföra direkt. Jag skulle ta högst tre vägar, var och en prövad med ett litet första steg: en inferensaccelerator som också kan utvinna, med början i en fyra veckor lång studie av J/op och $/op; tjänster för kundanpassat kisel med kryptot som första kund, med början i betalda förstudier; och ett AI-nativt nätverk som tecknar sin köpare av beräkningskraft innan det konstruerar sin token.
Ladda ned hela rapporten och bildspelet
Hela rapporten går i detalj igenom Pearls mekanism, ekonomi och regler, de andra kedjorna för nyttigt arbete och det bredare landskapet inom AI × krypto, ASIC-modellen med dess återbetalningskalkyl, bedömningar chip för chip, nodernas kostnader och val, en budget i steg för ett första chip, en lista över signaler att följa och alla källor.
- Beräkningskraft som konsensus: hela rapporten (PDF)
- Beräkningskraft som konsensus: bildspel (PDF)
- Engelsk utgåva: hela rapporten · bildspel
Detta är en översättning av den engelska utgåvan; där de skiljer sig åt gäller den engelska utgåvan.
Frågor du inte ställde men borde ha ställt
Innan jag satsade pengar eller kisel på något projekt inom AI × krypto skulle jag fråga: vem styr arbetsfunktionen; hur stor subventionsmultipeln är; vad nästa grind kostar och vilken siffra som stoppar dig; hur stor hashkraften för återbetalning är, med p; vilken chipets andra marknad är; om värdet hamnar i token eller i aktierna; och vem den första betalande kunden är, med namn.
Det här är områden vi kan utforska tillsammans, genom tekniskt utbyte och tekniskt samarbete: kundanpassade chip för mining, AI-träning och inferens samt acceleratorer; AI-utveckling; och system för AI × krypto från kedja till nod till chip. Du når mig på i@tanshuai.com.
Om författaren
Tan Shuai är teknolog och grundare med mer än tjugo års arbete inom chip, hårdvara och systemprogramvara, och 20 beviljade patent. Han har många års forskning, utveckling och ledning inom fabless-chip bakom sig, bland annat helt kundanpassad design av ASIC-datavägar för miningchip för kryptovalutor och multimediachip för kameror. Hans arbete har tagit honom genom Silicon Valley, New York, Chicago, Taiwan, Greater Bay Area (Shenzhen och Hongkong), Vietnam och Malaysia. I dag arbetar han som AI-forskare och AI-utvecklare.
Teknisk diskussion: i@tanshuai.com.