
Neurala nätverk formar redan nästan varje video du ser, men i båda ändar av en standardcodec, inte i stället för den. Här är var neural kodning används 2026, vad den kostar i kisel och vem som får betalt, med fullständig rapport och bildspel.
Sammandrag
Neural kodning är redan etablerad 2026, men den arbetar runt standardcodecar i stället för att ersätta dem. Nätverk formar bilden före kodningen, i telefonkameror och i Netflix kodningskedja, och reparerar den efter avkodningen, i YouTubes Super Resolution, hos Meta och i tv-processorer; bitströmmen däremellan är fortfarande AV1, HEVC, AVC eller VVC, avkodad av hårdvara med fast funktion. Helt neurala codecar används bara i slutna system där ett företag styr båda ändarna: Microsofts MLVC i Teams-samtal, tokeniserarna i varje röst- och videomodell, neurala texturer i ett spel. Uppspelning av neurala bitströmmar på massmarknaden väntar på H.267, planerad till slutet av 2029, och på en kiselcykel efter den. Skälet finns i chipet: den enda publicerade konstruktionen av en neural videoavkodare behöver omkring 12 gånger så mycket energi per pixel som en uppmätt HEVC-avkodare, och en snabb forskningscodec behöver omkring 22 TOPS för 1080p30. Pengarna följer standarderna och plattformarna; de mest kända startupbolagen inom neurala codecar köptes upp.
Varför jag tittade på det här
Med några månaders mellanrum får jag höra att AI-codecar snart ska ersätta H.264, HEVC och AV1. Det mesta jag läser om saken kommer antingen från forskningsartiklar, där komprimeringsrekorden finns, eller från leverantörer. Ingen av dem säger särskilt mycket om vad som faktiskt når ut, till vem och till vilken kostnad.
Jag har många år av FoU och ledning inom fabless-chipdesign bakom mig, bland annat full-custom-konstruktion av ASIC-datavägar och multimediaprojekt för kamerachip, till exempel acceleratorer för videocodecar, så jag granskade frågan som jag skulle granska ett chip: energi per pixel, minnestrafik, vad en standard låter dig låsa fast i kisel och vem som betalar. Jag läste standarddokument och mötesrapporter från JVET, MPEG, JPEG, AOMedia och IETF, företags teknikbloggar, chipartiklar, patentpoolers prislistor, texter om exportkontroll och pressen. Varje siffra nedan gäller per den 12 november 2026, och belopp anges i US-dollar. Den fullständiga rapporten, med alla källor, finns i slutet.
Resultaten i korthet
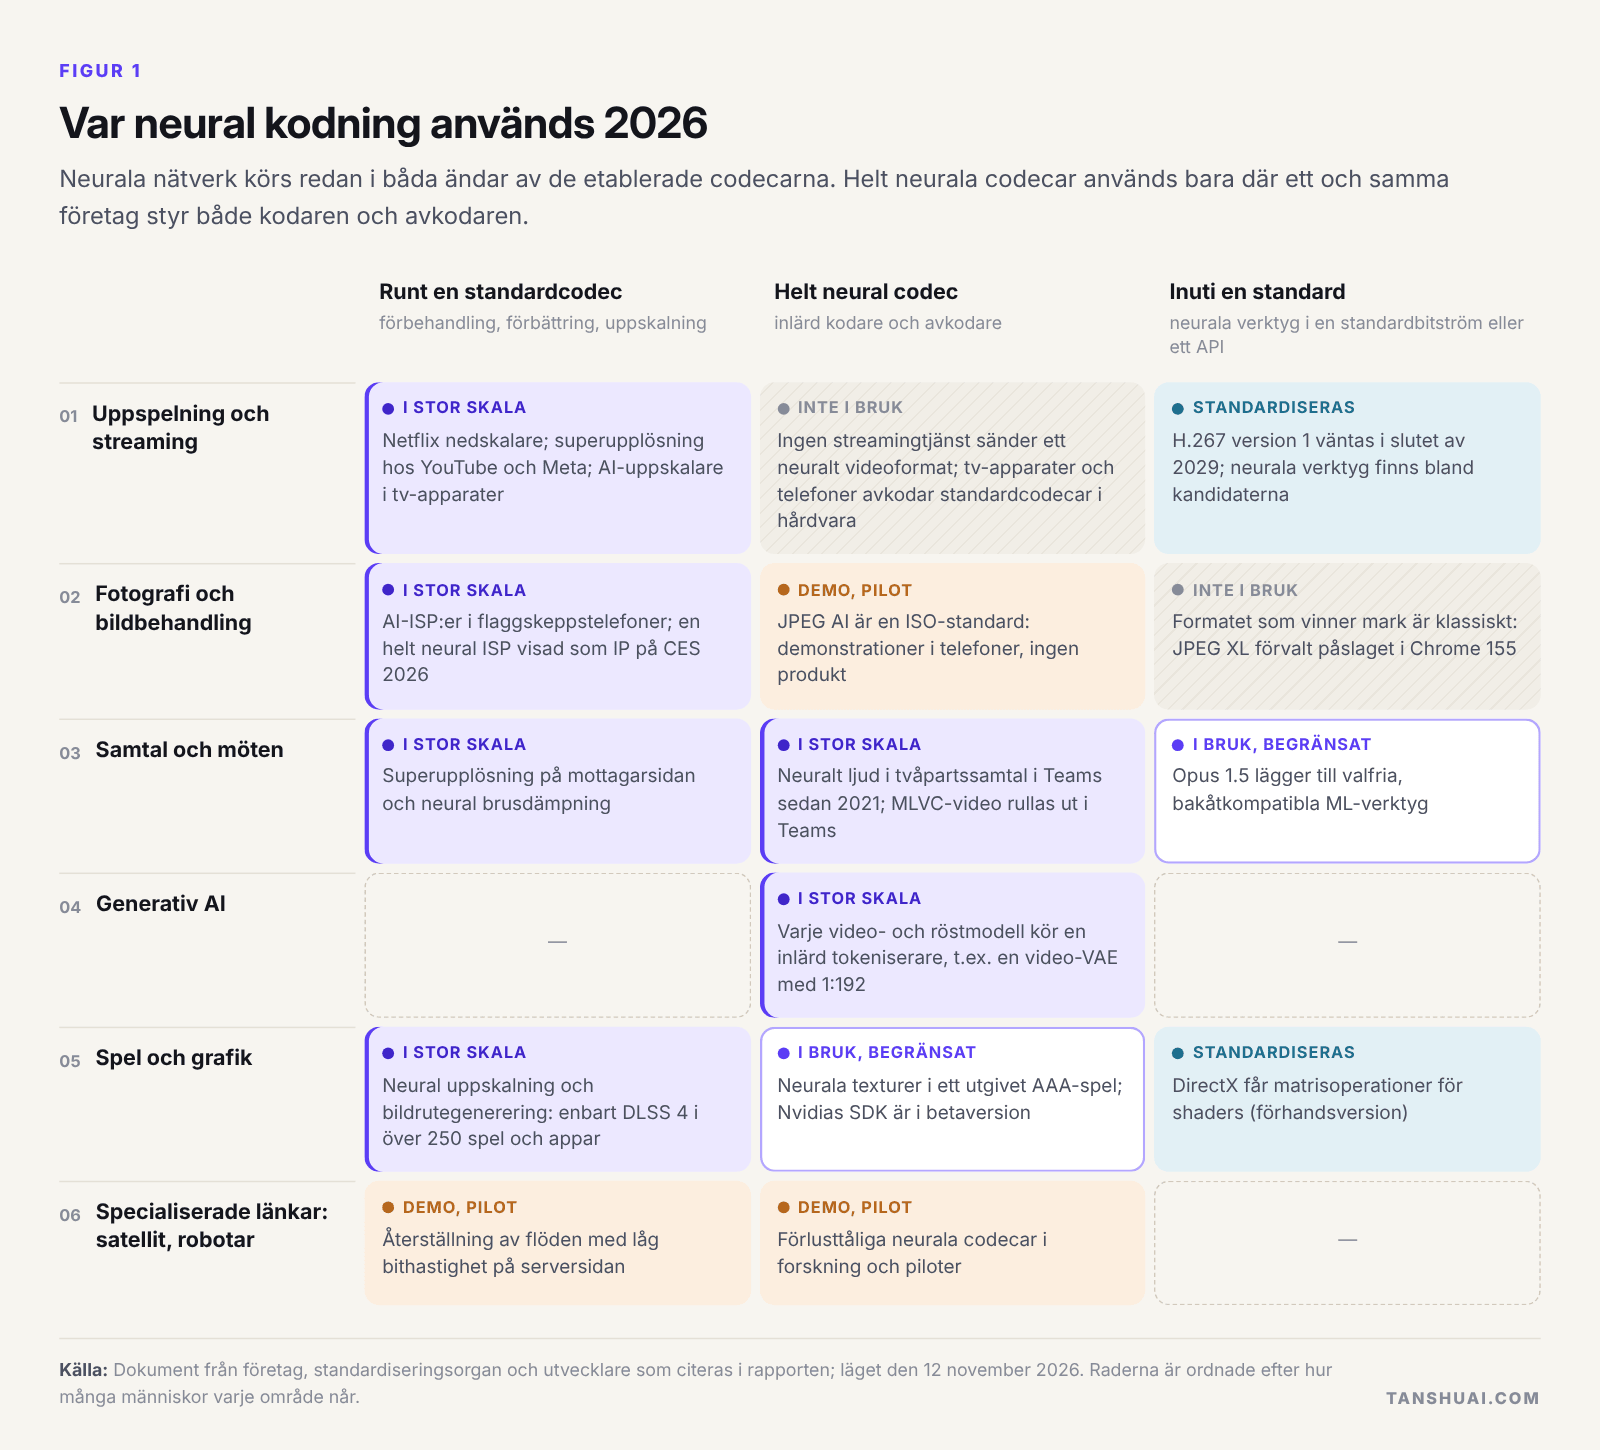 Figur 1. Var neural kodning används 2026. Raderna är ordnade efter hur många människor varje område når.
| Fråga | Kort svar |
|---|---|
| Var används neural kodning i stor skala? | Runt codecen: kamera-ISP:er, nedskalning på kodarsidan, superupplösning vid uppspelning. Helt neuralt bara i slutna system: samtal, speltillgångar, tokeniserare för generativ AI |
| Kommer neurala codecar att ersätta AV1, HEVC och VVC i uppspelning? | Inte före H.267 (version 1 i slutet av 2029) och en enhetscykel efter den; massmarknad i mitten av 2030-talet enligt min uppskattning |
| Vad kostar det i kisel? | Omkring 12 gånger så mycket energi per pixel som en HEVC-avkodare i hårdvara, plus minnestrafik och ett krav på bitexakt avkodning |
| Vem får betalt? | Plattformarna behåller besparingarna; IP-leverantörer och patentpooler får betalt per konstruktion och per enhet; startupbolagen inom neurala codecar köptes upp |
| Var kan ett företag satsa? | Neural för- och efterbearbetning, produkter för slutna system, kisel med codec plus NPU, och utvärderings- och standardiseringsarbetet däremellan |
Tre vägar in
”Neural kodning” täcker tre olika saker, och de flesta meningsskiljaktigheter om ämnet kommer av att de blandas ihop. Ett nätverk kan arbeta runt en standardcodec och bearbeta pixlar före kodningen eller efter avkodningen, medan bitströmmen förblir standard. Det kan sitta inuti en standard, som ett verktyg som varje avkodare måste köra, vilket betyder att det måste specificeras exakt. Eller så kan det ersätta codecen från ände till ände, med en inlärd kodare och avkodare som bara fungerar som ett par.
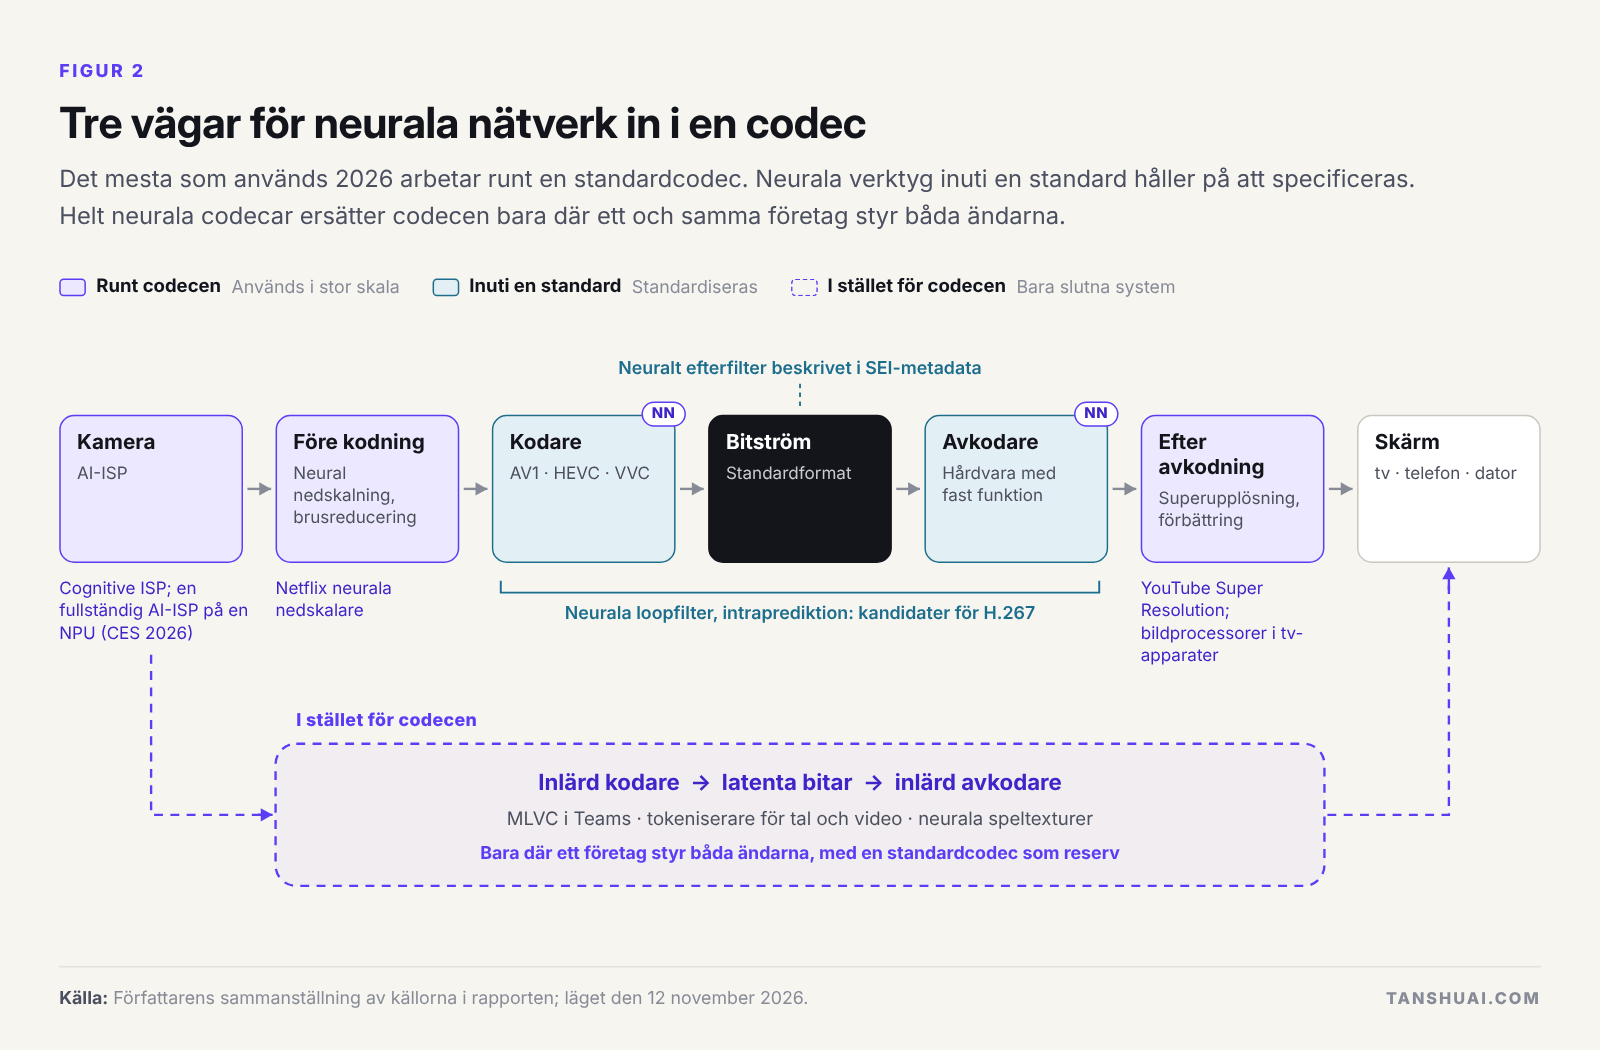 Figur 2. Tre vägar för neurala nätverk in i en codec. Det mesta som används 2026 hör till den första.
Den första vägen kräver ingens tillstånd. Den andra kräver en standard. Den tredje kräver kontroll över båda ändarna. Det är i den ordningen de når människor.
Uppspelning och streaming: neuralt i båda ändar, standard i mitten
De stora tjänsterna har avslutat ett codecskifte och påbörjar nästa, och inget av dem involverar en neural avkodare. Netflix rapporterade i december 2025 att AV1 stod för omkring 30 % av tittandet; YouTube uppger att mer än 90 % av katalogen, viktat efter visningstid, finns i AV1. AV2 blev klar den 28 maj 2026 med omkring 30 % bättre komprimering än AV1, och inom tre veckor hade Chips&Media, Allegro DVT och VeriSilicon presenterat kunder för AV2-avkodare. Brasiliens TV 3.0 inledde kommersiella VVC-sändningar i juni 2026.
Den neurala delen sitter i båda ändar. Sedan 2022 använder Netflix ett litet neuralt nätverk i stället för ett konventionellt filter för att skala ned sina masterfiler, en lösning som inte kräver någon ändring i någon enhet och som omkring 77 % av tittarna föredrog i Netflix tester. YouTube skalar upp videor som laddats upp under 1080p med maskininlärning på tv-apparater, Meta kör superupplösning på sina servrar och i telefoner, och Samsungs flaggskeppsprocessor för tv marknadsförs med 768 nätverk för uppskalning.
Det som inte finns är en neural bitström på massmarknadens skärmar, och skälet är tid. Ett uppspelningsformat måste kunna avkodas på varje enhet som någonsin ska spela upp det. AV1 behövde nästan åtta år från färdig specifikation till 30 % av tittandet på Netflix.
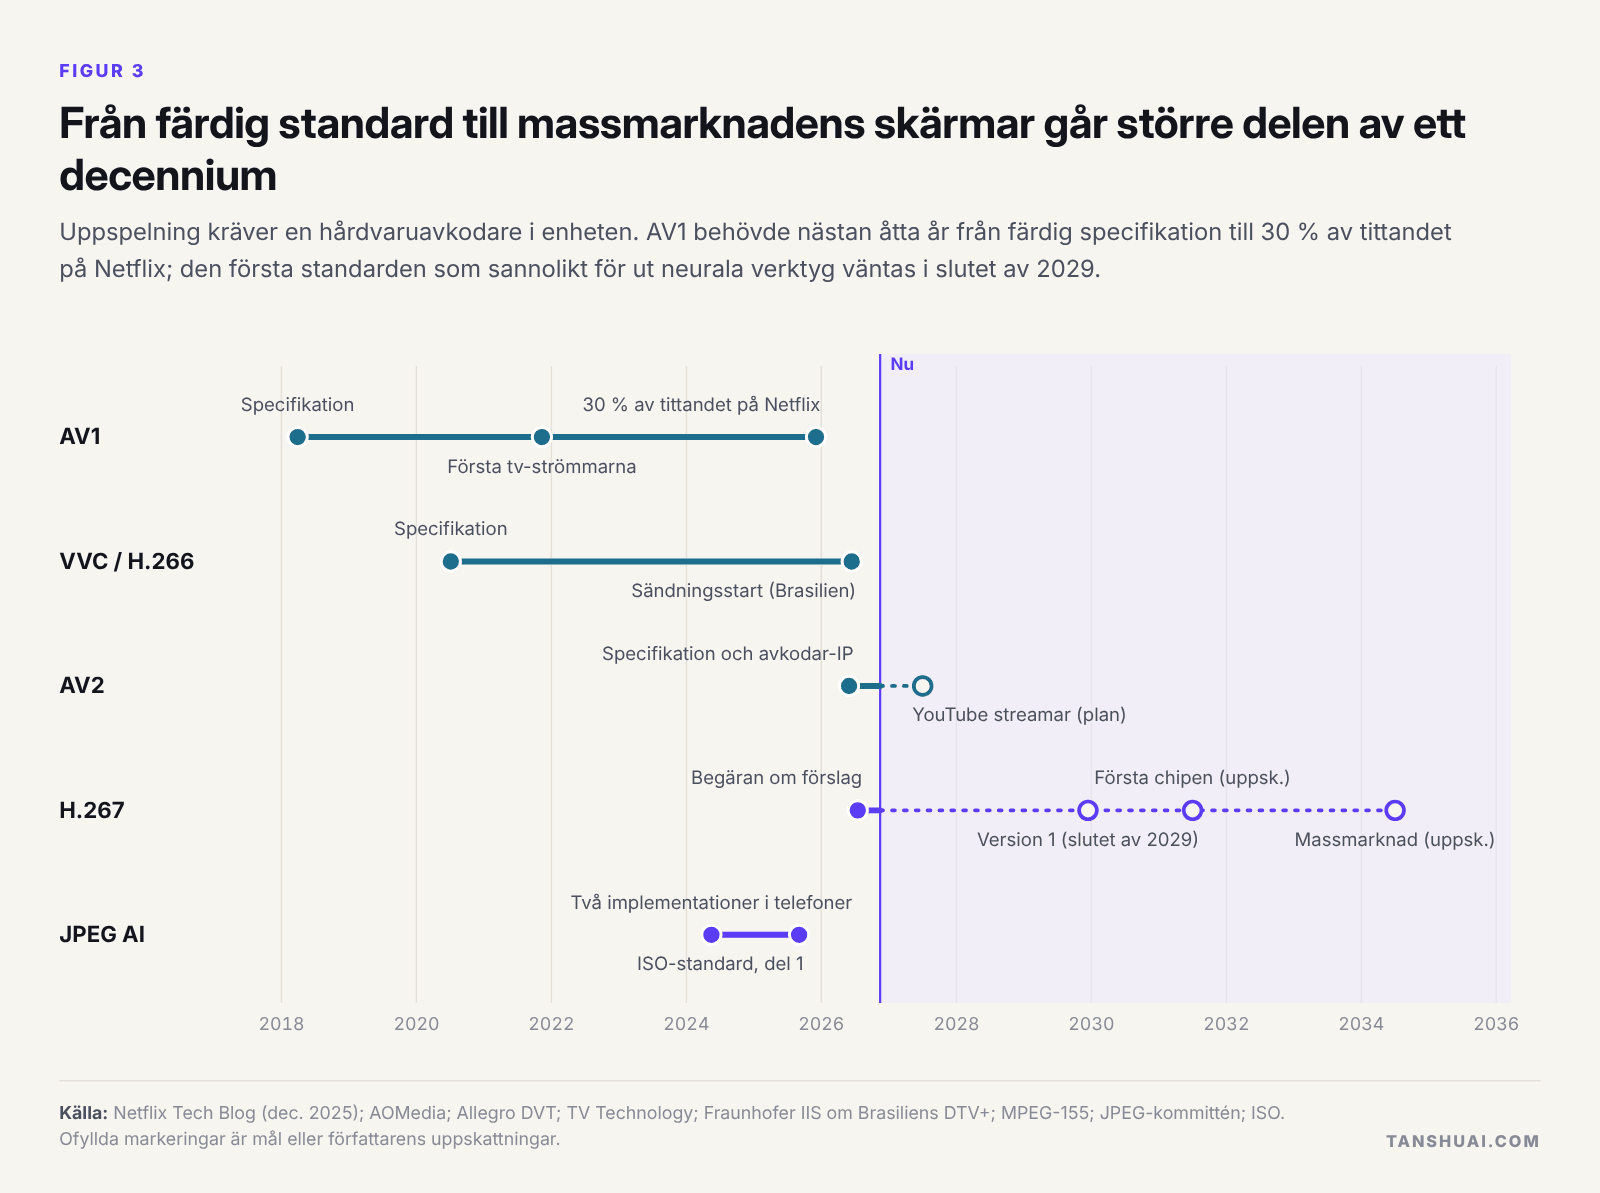 Figur 3. Från färdig standard till massmarknadens skärmar går större delen av ett decennium.
Standarden som skulle kunna föra ut neurala verktyg till varje skärm är H.267, arbetsnamnet på VVC:s efterföljare. JVET utfärdade sin begäran om förslag i juli 2026; svaren utvärderas i januari 2027 och den första versionen väntas i slutet av 2029. Det klassiska spåret sparar redan omkring 28 % jämfört med VVC, medan JVET:s neurala loopfilter sparar 6–14 % till en avkodarkostnad från 10 tusen MAC per pixel och uppåt. Jag räknar med en klassisk kärna med några neurala verktyg där de sparade bitarna motiverar kostnaden.
Fotografi: neuralt i kameran, klassiskt på webben
Varje foto från en nyare flaggskeppstelefon har passerat neurala nätverk innan det sparas. Qualcomms Cognitive ISP har kört semantisk segmentering i realtid sedan 2023, och på CES 2026 visade Chips&Media och Visionary.ai en fullständig ISP som körs helt på en NPU. Sedan sparas resultatet som JPEG eller HEIF.
JPEG AI, den första standarden för inlärd bildkodning, publicerades 2025, med vinster på 12,5–27,9 % jämfört med VVC:s intrakodning till avkodarkostnader på 7 till 216 tusen MAC per pixel. Jag hittade ingen kamera, galleriapp eller webbläsare som använder den som förval. Formatet som webben införde 2026 är klassiskt: Chrome 155 slog på JPEG XL den 6 oktober, med en snabb, minnessäker avkodare som körs på vilken CPU som helst. Neural kodning vinner inom ett enskilt företags kedja; format som måste gå att öppna överallt förblir klassiska.
Samtal: där helt neurala codecar används
Samtal är slutna system: båda ändarna kör samma app och kan falla tillbaka på en standardcodec mitt i samtalet. Det är därför de första helt neurala codecarna i stor skala finns där. Microsofts AI-baserade talcodec Satin har körts i alla tvåpartssamtal i Teams och Skype sedan 2021. I juli 2026 släppte Microsoft MLVC som öppen källkod, en neural videocodec som nu rullas ut i peer-to-peer-samtal i Teams.
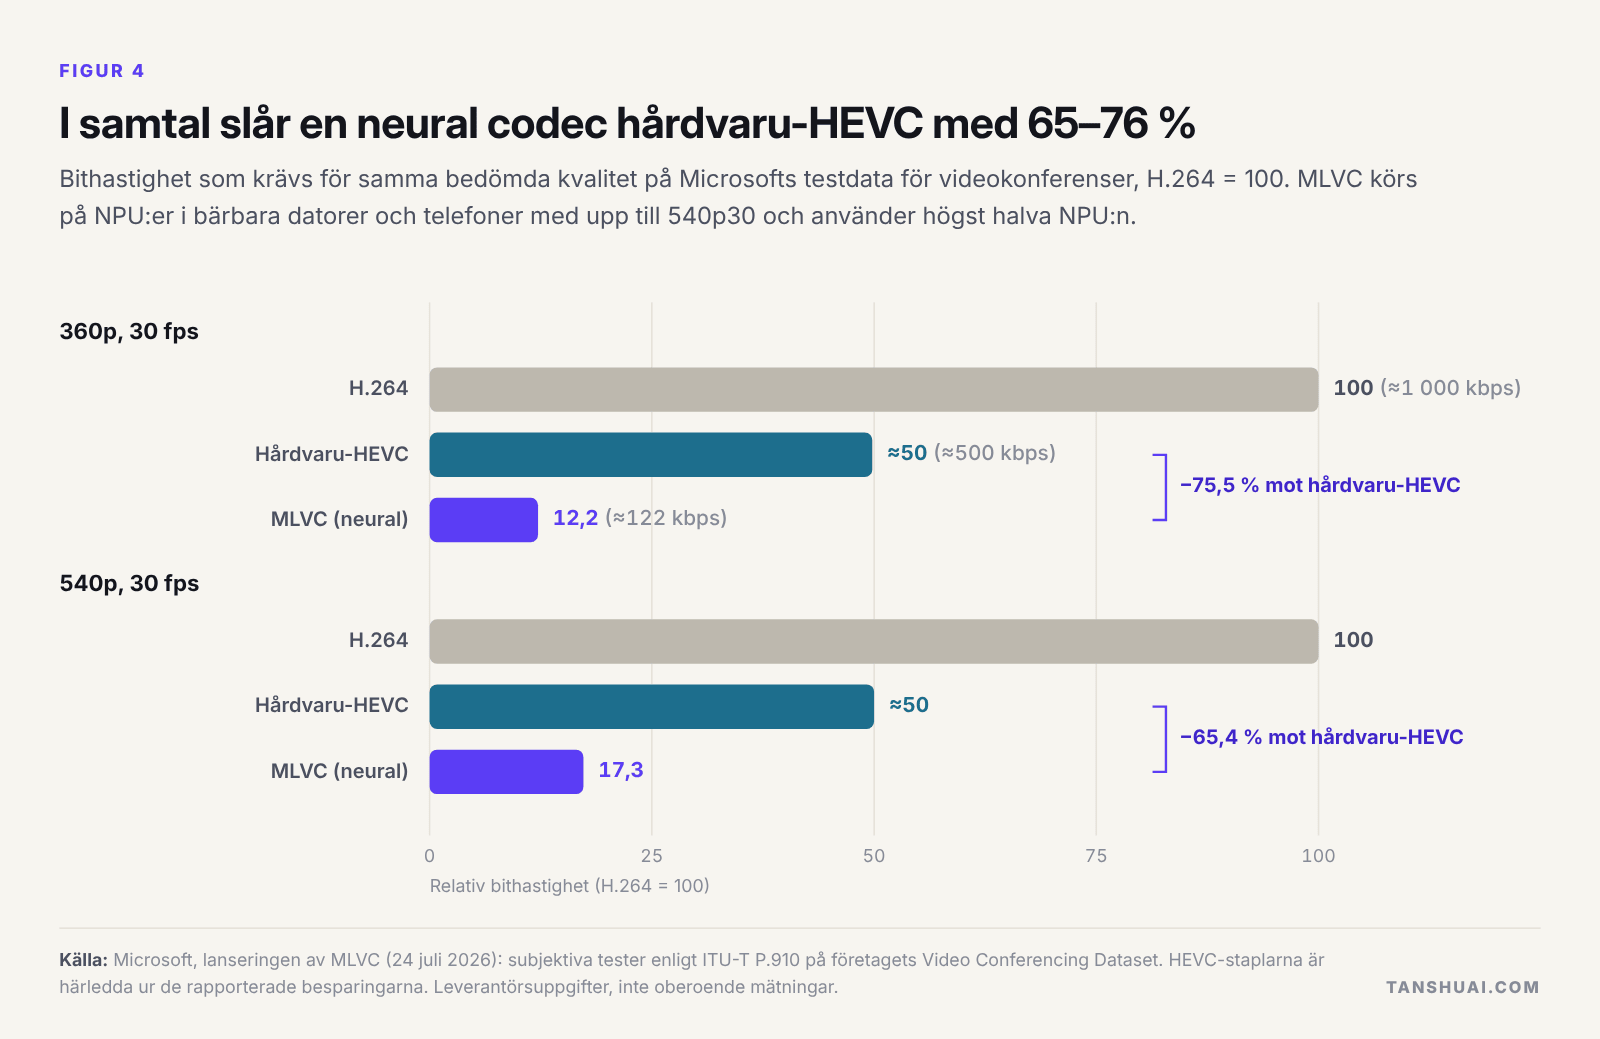 Figur 4. I samtal slår en neural codec hårdvaru-HEVC med 65–76 %, på Microsofts egna testdata.
Rubriksiffran 88 % gäller mot H.264; mot den hårdvaru-HEVC som redan finns i samma bärbara datorer är det 65–76 %, fortfarande mycket. MLVC körs i 540p och 360p med högst halva NPU:n, och den gav upp en del komprimering för att avkoda identiskt på hårdvara som Microsoft inte äger.
Alla valde inte den vägen. Opus lade till djupinlärning 2024 som valfria, bakåtkompatibla tillägg. Meta byggde MLow, en klassisk talcodec, eftersom mer än 20 % av företagets samtal sker på gamla ARMv7-telefoner och tiotals miljoner WhatsApp-samtal om dagen sker på telefoner som är över tio år gamla. Neurala codecar används först där enheterna är nya och en leverantör styr båda ändarna.
Generativ AI: den största utrullningen som ingen kallar en codec
Varje röst- och videomodell körs på en inlärd codec. Talmodeller läser och skriver tokens från neurala ljudcodecar som Kyutais Mimi, med 12,5 ramar per sekund och 1,1 kbps. Videogeneratorer arbetar i det latenta rummet hos videoautokodare som den i LTX-Video, som komprimerar 1:192. Inget av dessa är ett format som någon annan avkodar, men de visar att inlärd komprimering fungerar i stor skala när ett företag äger kodaren, avkodaren och hårdvaran. För den som erbjuder generativ video är tokeniserarens effektivitet en direkt kostnadspost.
Spel: neural rekonstruktion är etablerad, neurala tillgångar är på väg in
Nvidias DLSS renderar färre pixlar och bildrutor och låter ett nätverk bygga upp resten. Neural texturkomprimering har kommit med i Assassin's Creed Mirage, men bara för utvalda tillgångar på grund av kostnaden vid körning.
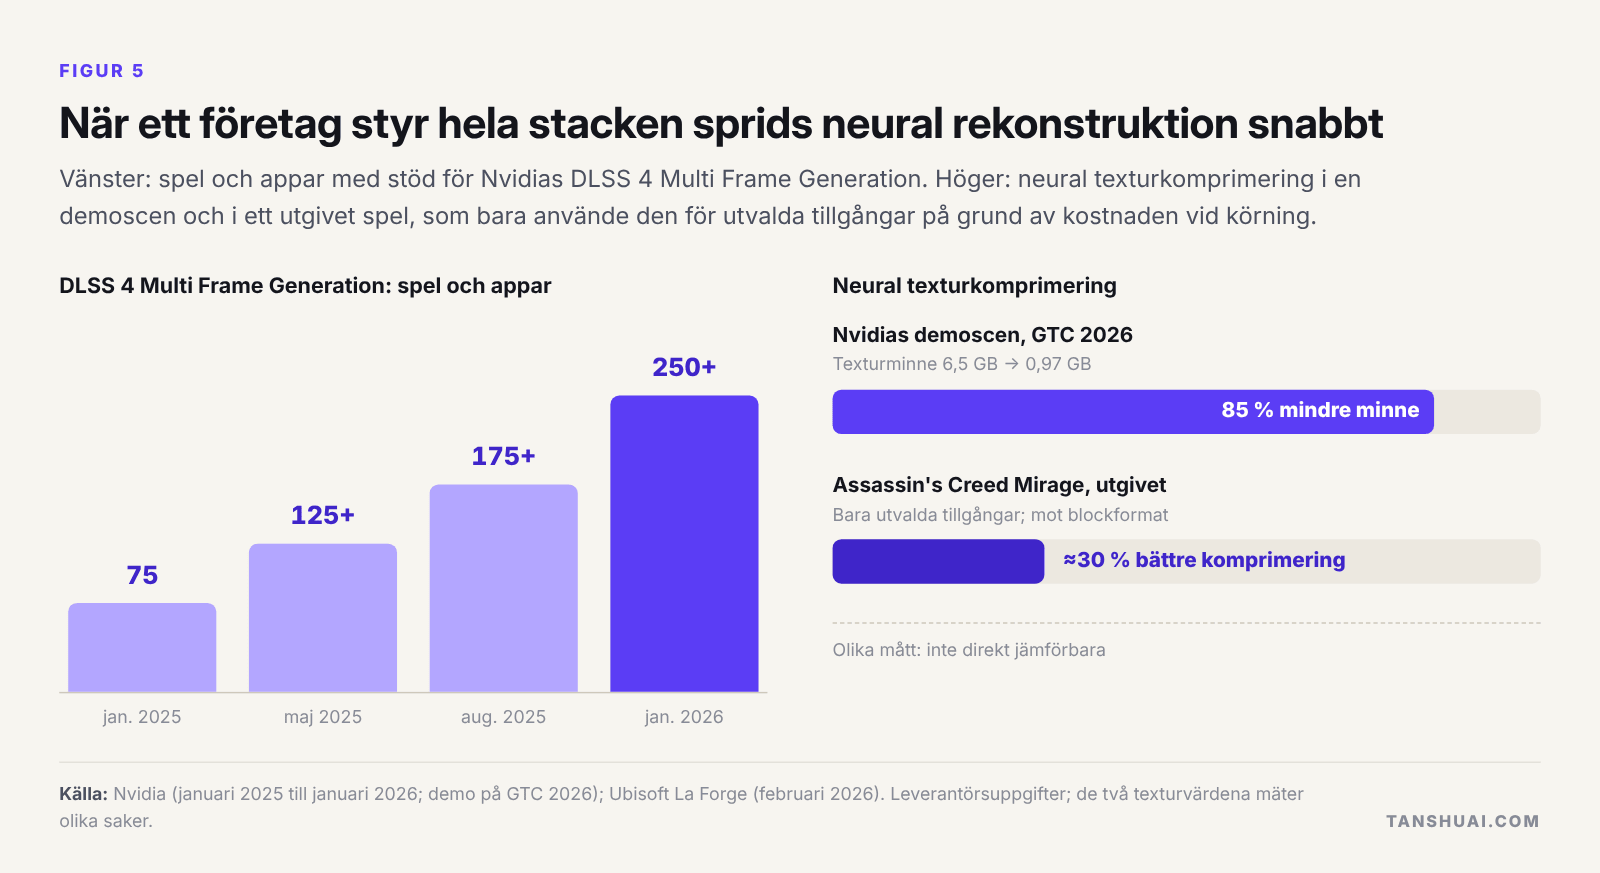 Figur 5. När ett företag styr hela stacken sprids neural rekonstruktion snabbt.
Länkar för satelliter, drönare och robotar är där helt neurala codecar passar bäst tekniskt, men de utgör en liten marknad som i allt högre grad omfattas av exportkontroll på båda sidor: Kinas exportregler för drönare från den 18 november 2026 anger till och med semantisk bildkomprimering som tröskelvärde.
Kiselperspektivet
Här spelar min egen bakgrund störst roll. Ett chipteam ställer fyra frågor om varje ny codec: joule per pixel, DRAM-trafik per pixel, grindar, och om varje avkodare i världen räknar fram exakt samma bitar. På alla fyra punkterna står en neural avkodare 2026 där hårdvaru-HEVC stod före sina första chip.
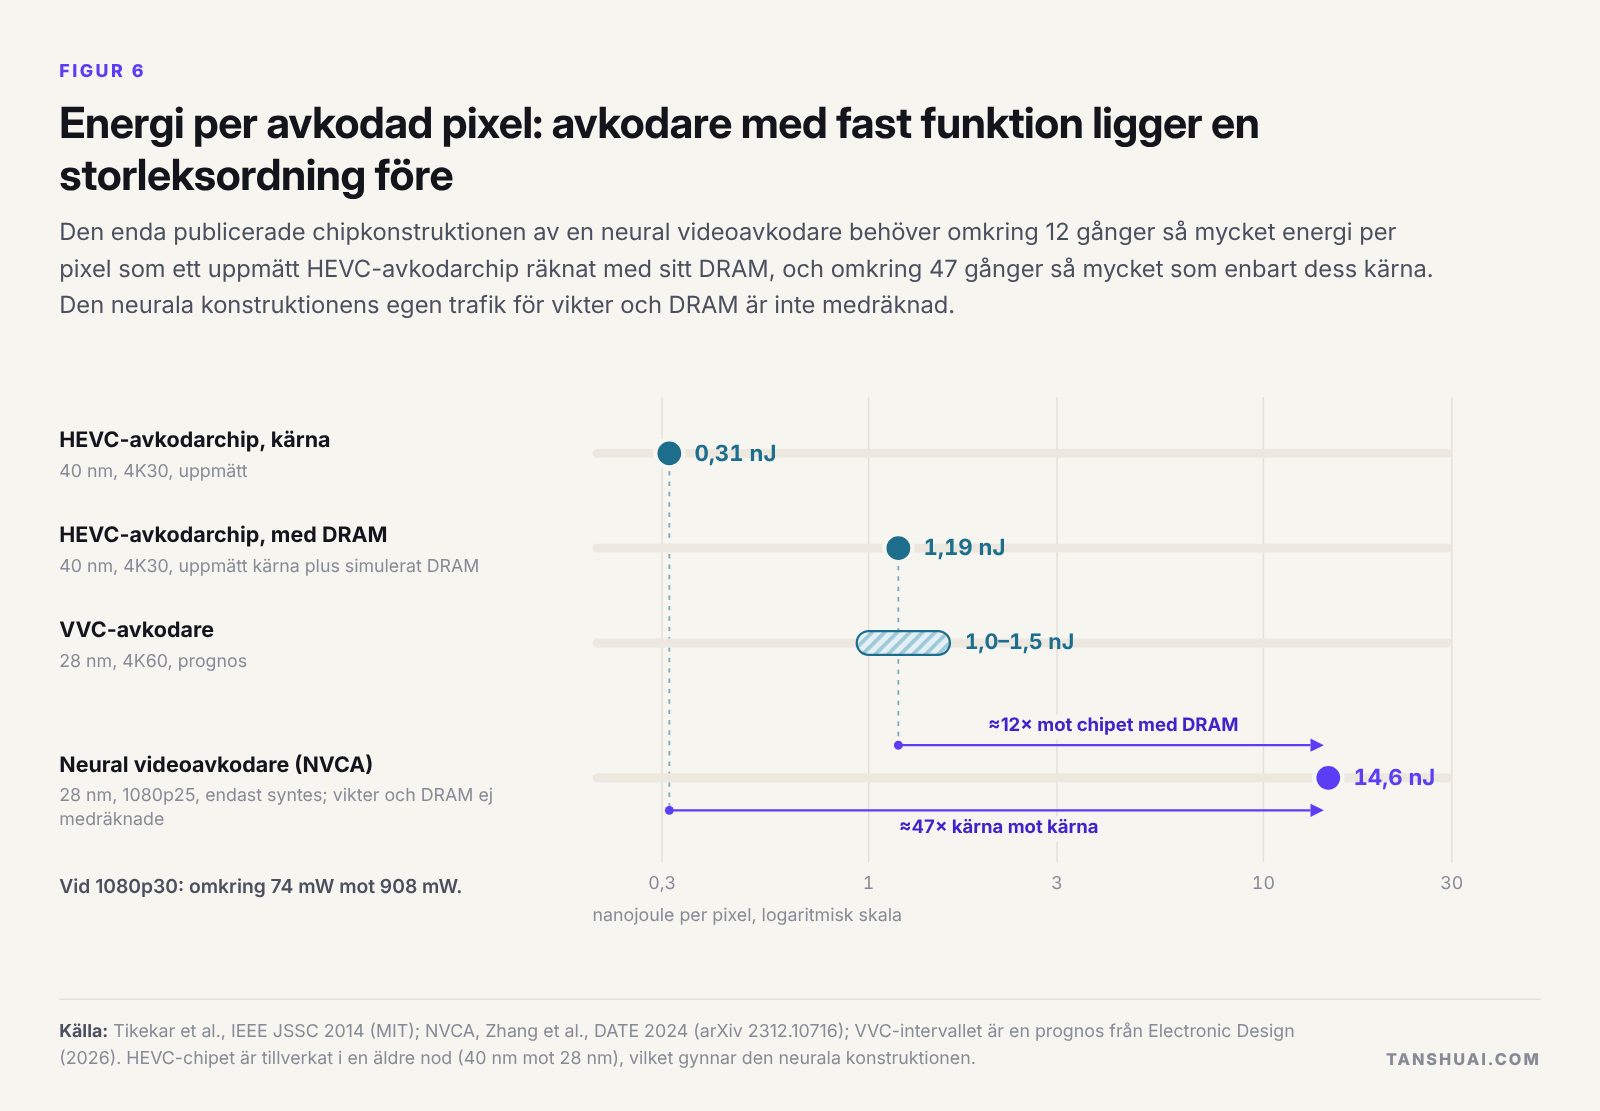 Figur 6. Energi per avkodad pixel: avkodare med fast funktion ligger en storleksordning före.
Den enda publicerade chipkonstruktionen av en neural videoavkodare, NVCA, behöver 14,6 nJ per pixel; MIT:s HEVC-avkodarchip behöver 1,19 med sitt DRAM och 0,31 för kärnan. Vid 1080p30 blir det ungefär 900 mW mot 74 mW. Microsofts snabba forskningscodec DCVC-RT behöver, enligt min summering av dess egen tabell per modul, omkring 175 tusen MAC per avkodad pixel, eller omkring 22 TOPS vid 1080p30: hälften av de 40 TOPS som definierar en AI-dator, för en enda ström.
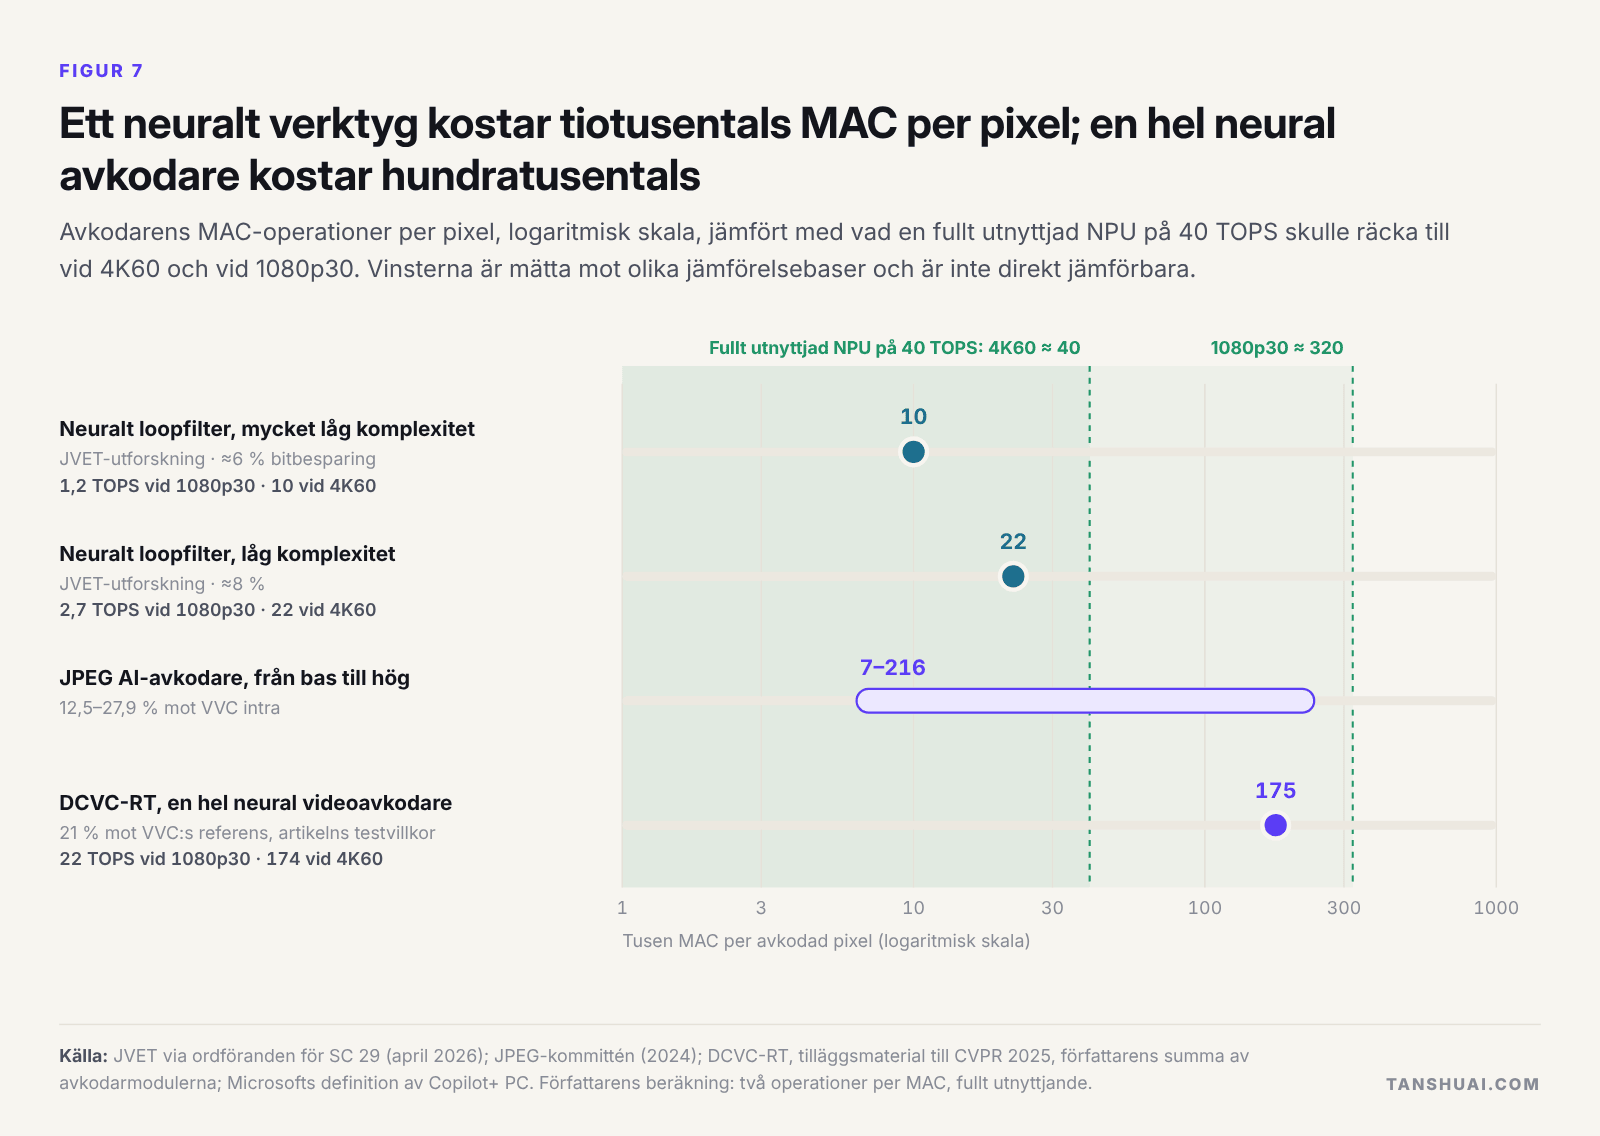 Figur 7. Ett neuralt verktyg kostar tiotusentals MAC per pixel; en hel neural avkodare kostar hundratusentals.
Två kostnader till spelar roll. Minne: i MIT-chipet går omkring tre fjärdedelar av systemets energi till DRAM, och neurala avkodare bär stora särdragskartor mellan bildrutor. Exakthet: entropiavkodningen misslyckas om två enheter beräknar en sannolikhet olika, vilket är skälet till att varje seriös neural codec i dag använder heltalsaritmetik och till att MLVC byter bort komprimering mot identisk avkodning.
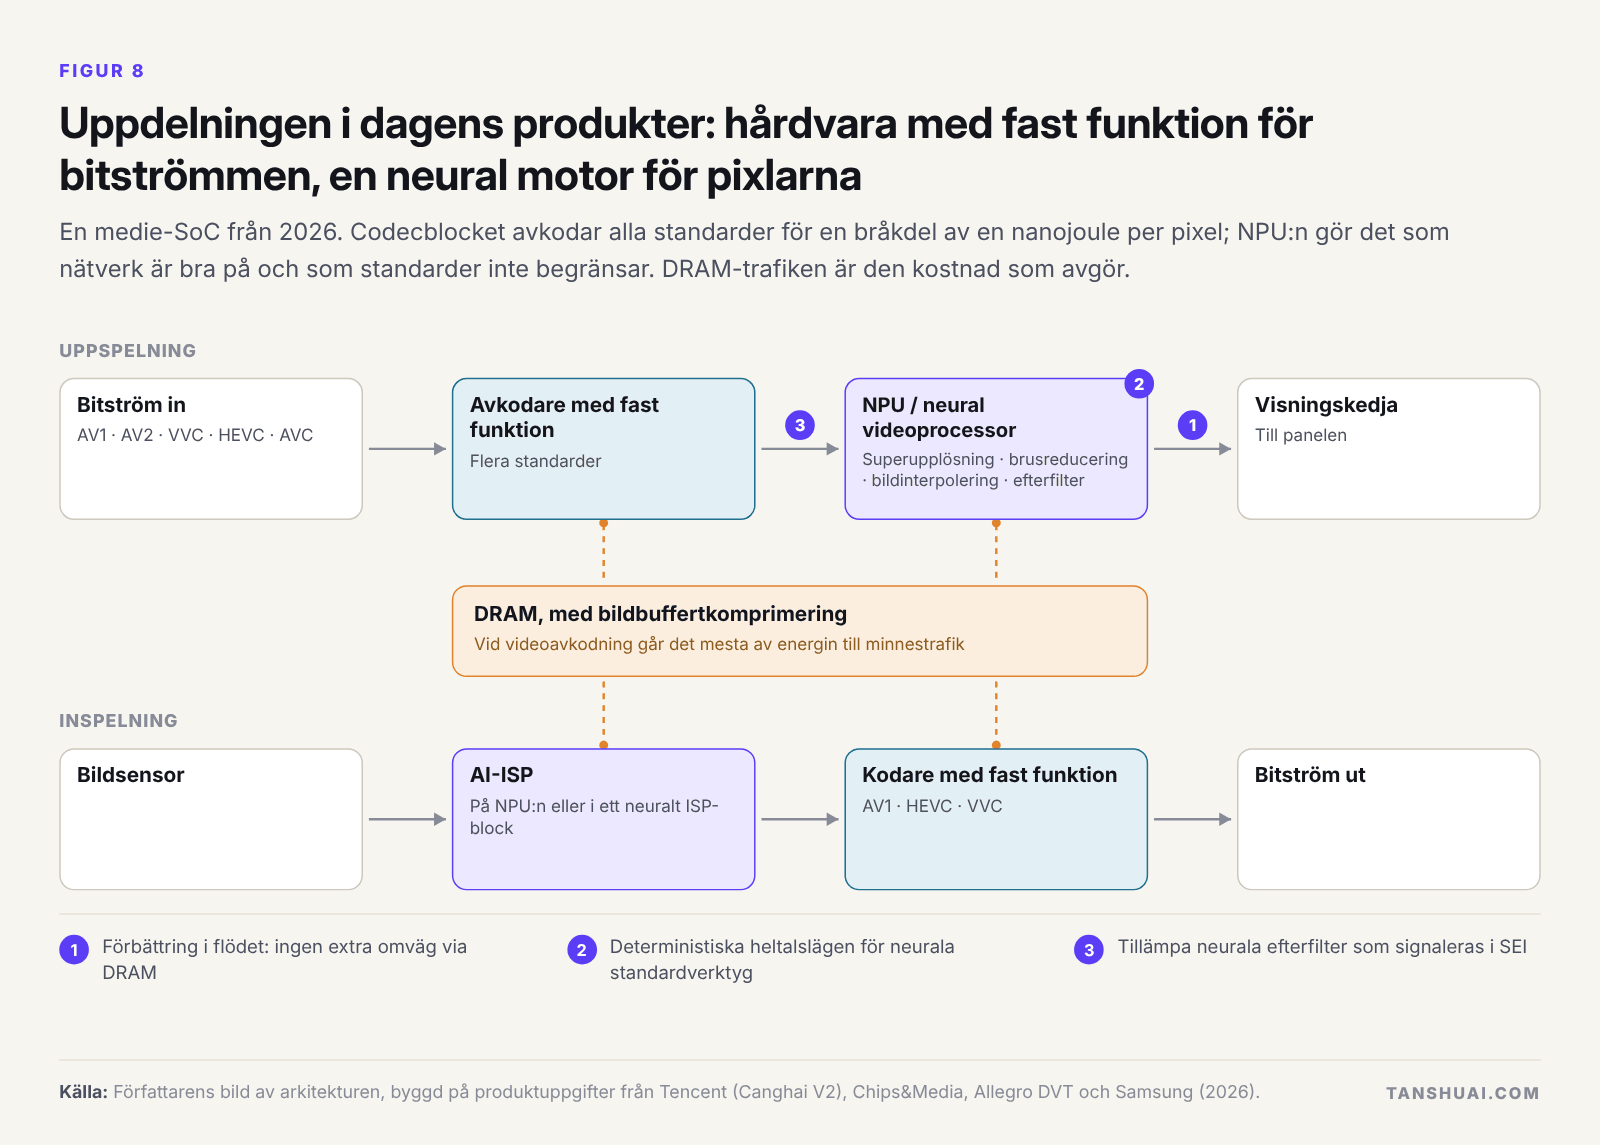 Figur 8. Uppdelningen i dagens produkter: hårdvara med fast funktion för bitströmmen, en neural motor för pixlarna.
Kislet som säljer kombinerar de två. Tencent har mer än 100 000 av sina egenutvecklade codec-chip Canghai i drift, och andra generationen lägger till H.266 och superupplösning på chipet; IP-leverantörer säljer codecblock och video-NPU:er sida vid sida. Om jag planerade en medie-SoC nu: avkodare med fast funktion för varje standard du måste spela upp, inklusive AV2; en NPU dimensionerad för förbättring i skärmupplösning, utan en extra omväg via DRAM; deterministiska heltalslägen; och H.267 som konstruktionsstart efter 2029.
Vem som får betalt, och var ett företag kan satsa
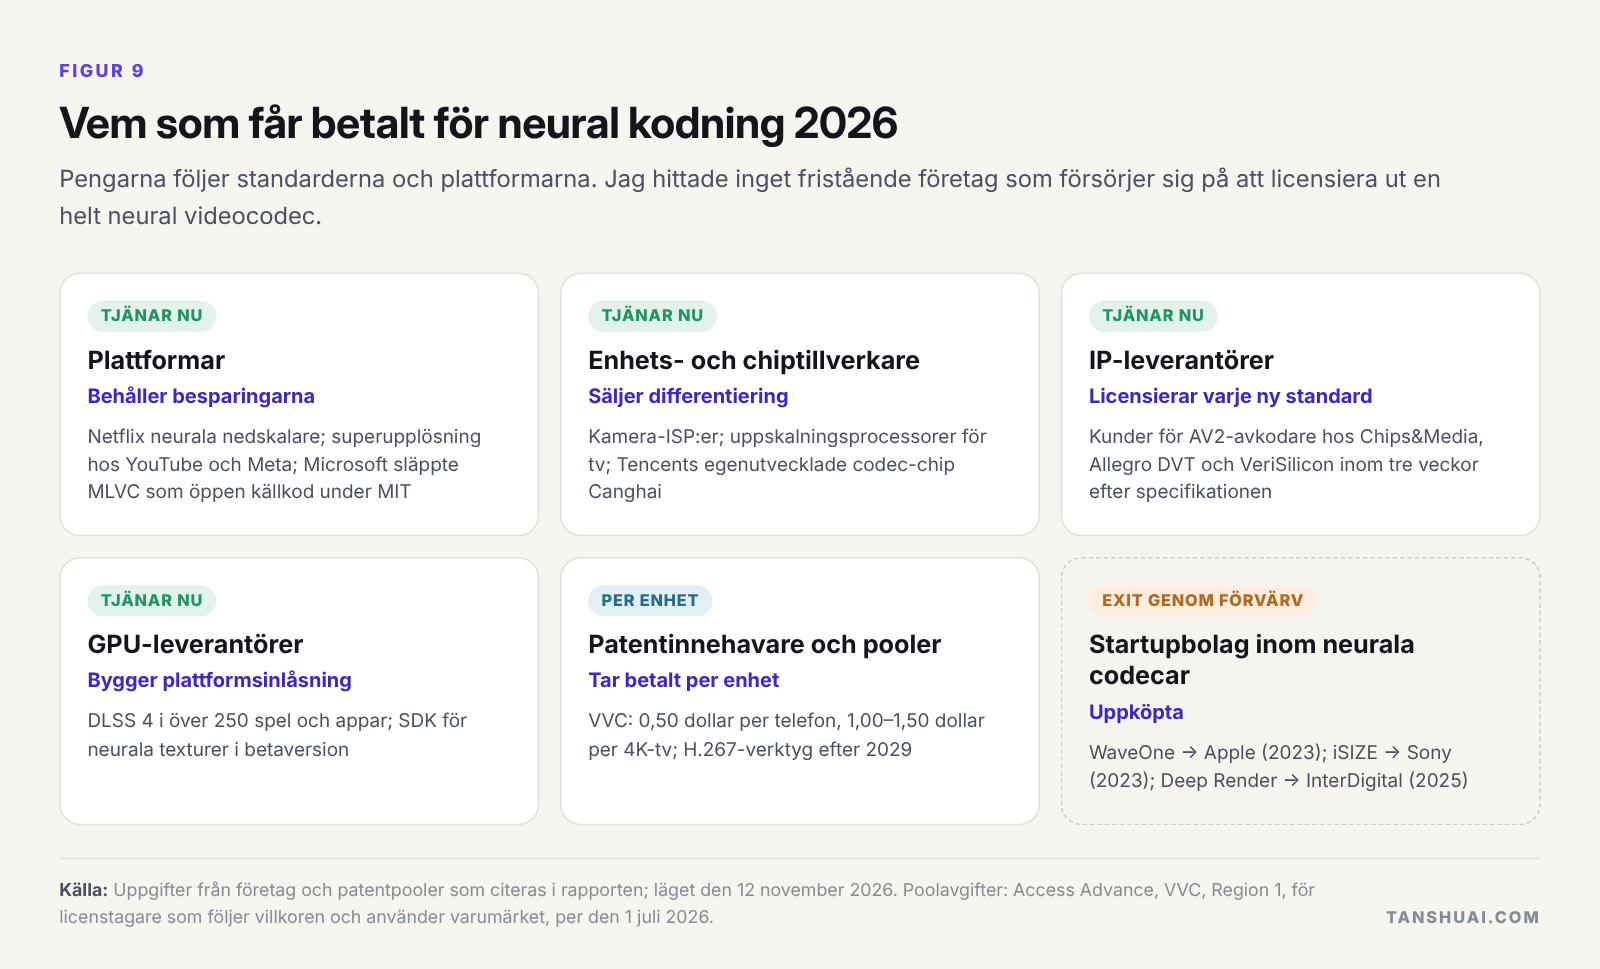 Figur 9. Pengarna följer standarderna och plattformarna.
Plattformarna behåller besparingarna och ger ibland bort koden, som Microsoft gjorde med MLVC. IP-leverantörer licensierar avkodare för varje ny standard. Patentpooler tar betalt per enhet: för VVC 0,50 dollar per telefon och 1,00–1,50 dollar per 4K-tv i USA och andra marknader i Region 1. WaveOne gick till Apple, iSIZE till Sony och Deep Render till InterDigital. Jag hittade inget fristående företag som försörjer sig på att licensiera ut en helt neural videocodec.
För ett företag är de öppna satsningarna neural förbehandling för videotjänster, förbättring på skärmsidan för chiptillverkare, neurala codecar i slutna system för konferenser och privata länkar, kisel med codec plus NPU, och de verktyg för utvärdering och konformitet som alla som levererar neurala verktyg kommer att behöva. Standardarbete kring H.267 kräver tålamod och en licensstrategi.
Påståenden att vara skeptisk till, och vad som bör bevakas
Kräv fyra saker av varje påstående om neurala codecar: jämförelsebasen, måttet, upplösningen och avkodningskostnaden. ”88 % besparing” gäller mot H.264 vid 360p; ”85–96 % mindre videominne” är en demoscen, mot 30 % i det utgivna spelet; bakom ”JPEG AI är en standard” finns ännu ingen produkt.
De datum som spelar roll: utvärderingen av H.267 i januari 2027, YouTubes första AV2-strömmar i början av 2027, H.267:s första testmodell under andra halvåret 2027, om MLVC sprids bortom Teams, den första produkten som använder JPEG AI som förval, och NPU-budgetarna i telefoner och datorer. Version 1 av H.267 i slutet av 2029 startar kiselcykeln för neurala verktyg i uppspelning på massmarknaden.
Ladda ned den fullständiga rapporten och bildspelet
Den fullständiga rapporten går igenom varje område mer i detalj, kiselberäkningarna, standarderna och patenten, en tabell över påståenden mot belägg, och alla källor.
- Neural kodning 2026: fullständig rapport (pdf)
- Neural kodning 2026: bildspel (pdf)
- Engelsk utgåva: fullständig rapport · bildspel
Detta är en översättning av den engelska utgåvan, som gäller där versionerna skiljer sig åt.
Öppna frågor
Några av frågorna här har ännu inget offentligt svar, och det är dem jag tycker är mest intressanta tekniskt: hur nära bitexakt heltalsaritmetik en neural avkodare kan komma på olika leverantörers NPU:er innan den förlorar sin komprimeringsfördel; vad neural efterbearbetning kostar i DRAM-trafik per pixel; vid vilken kostnad per pixel ett neuralt verktyg slutar löna sig i en H.267-avkodare; vilka slutna system bortom samtal som först kan införa helt neurala codecar; och hur man mäter återgivningstrohet när en avkodare genererar detaljer i stället för att rekonstruera dem.
Det här är områden vi kan utforska tillsammans under de kommande åren, genom tekniskt utbyte och tekniskt samarbete: i@tanshuai.com.
Om författaren
Tan Shuai är teknikexpert och grundare med mer än tjugo års arbete inom chip, hårdvara och systemmjukvara, och 20 beviljade patent. Han har många år av FoU och ledning inom fabless-chipdesign bakom sig, bland annat full-custom-konstruktion av ASIC-datavägar och multimediaprojekt för kamerachip, till exempel acceleratorer för videocodecar. Hans arbete har tagit honom genom Silicon Valley, New York, Chicago, Taiwan, Greater Bay Area (Shenzhen och Hongkong), Vietnam och Malaysia. I dag arbetar han som AI-forskare och -utvecklare.
Teknisk diskussion: i@tanshuai.com.