
Nevrale nettverk former allerede nesten all video du ser, men i begge ender av en standardkodek, ikke i stedet for den. Her er hvor nevral koding tas i bruk i 2026, hva den koster i silisium og hvem som får betalt, med full rapport og lysbilder.
Sammendrag
Nevral koding er allerede utbredt i 2026, men den virker rundt standardkodekene i stedet for å erstatte dem. Nettverk former bildet før koding, i mobilkameraer og i Netflix' kodingskjede, og reparerer det etter dekoding, i YouTubes Super Resolution, hos Meta og i TV-prosessorer; bitstrømmen i mellom er fortsatt AV1, HEVC, AVC eller VVC, dekodet av fastkoblet maskinvare. Nevrale ende-til-ende-kodeker tas bare i bruk i lukkede sløyfer der ett selskap kontrollerer begge ender: Microsofts MLVC i Teams-samtaler, tokenisererne inne i alle tale- og videomodeller, nevrale teksturer i ett spill. Masseavspilling av nevrale bitstrømmer venter på H.267, som ventes ved utgangen av 2029, og en brikkesyklus etter den. Grunnen ligger i brikken: det eneste publiserte designet for en nevral videodekoder trenger omtrent 12 ganger så mye energi per piksel som en målt HEVC-dekoder, og en rask forskningskodek trenger rundt 22 TOPS for 1080p30. Pengene følger standardene og plattformene; de mest kjente oppstartsselskapene innen nevrale kodeker ble kjøpt opp.
Hvorfor jeg så på dette
Med noen måneders mellomrom forteller noen meg at KI-kodeker snart vil erstatte H.264, HEVC og AV1. Det meste jeg leser om det, kommer enten fra forskningsartikler, der komprimeringsrekordene er, eller fra leverandører. Ingen av dem sier stort om hva som faktisk tas i bruk, for hvem og til hvilken kostnad.
Jeg har mange års erfaring med FoU og ledelse innen fabless-brikker, blant annet full-custom-design av ASIC-databaner og prosjekter med multimediebrikker for kameraer, som akseleratorer for videokodeker, så jeg så på det slik jeg ville gjennomgått en brikke: energi per piksel, minnetrafikk, hva en standard lar deg låse fast i silisium, og hvem som betaler. Jeg leste standarddokumenter og møterapporter fra JVET, MPEG, JPEG, AOMedia og IETF, selskapers ingeniørblogger, fagartikler om brikker, satsoversiktene til patentpoolene, tekster om eksportkontroll og pressen. Alle tall nedenfor gjelder per 12. november 2026, og beløp er i amerikanske dollar. Den fullstendige rapporten, med alle kildene, finner du til slutt.
Resultatene i korte trekk
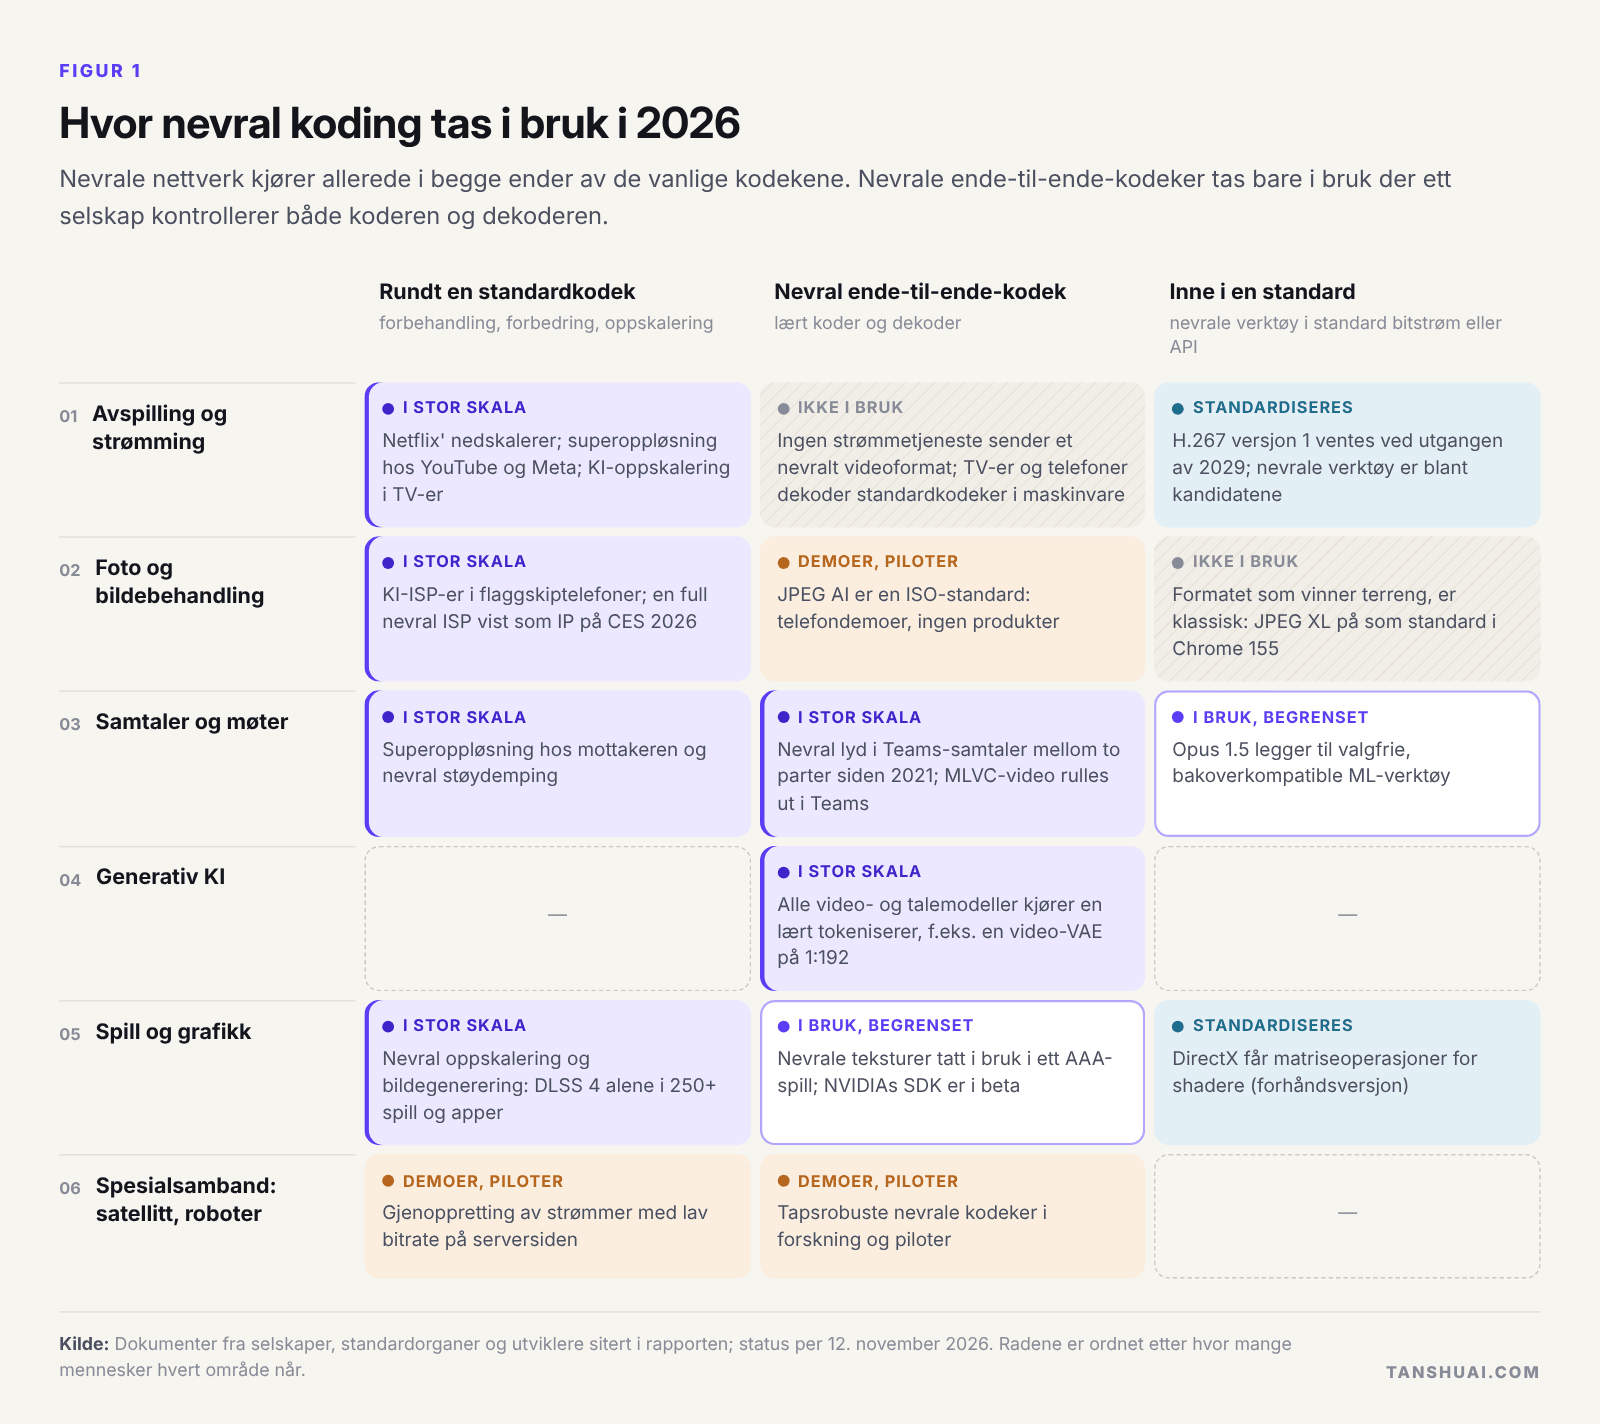 Figur 1. Hvor nevral koding tas i bruk i 2026. Radene er ordnet etter hvor mange mennesker hvert område når.
| Spørsmål | Kort svar |
|---|---|
| Hvor tas nevral koding i bruk i stor skala? | Rundt kodeken: kamera-ISP-er, nedskalering på kodingssiden, superoppløsning ved avspilling. Ende til ende bare i lukkede sløyfer: samtaler, spillressurser, tokeniserere for generativ KI |
| Vil nevrale kodeker erstatte AV1, HEVC og VVC i avspilling? | Ikke før H.267 (versjon 1 ved utgangen av 2029) og en enhetssyklus etter den; bred bruk midt på 2030-tallet etter mitt anslag |
| Hva koster det i silisium? | Omtrent 12 ganger så mye energi per piksel som en HEVC-dekoder i maskinvare, pluss minnetrafikk og et krav om bitnøyaktig dekoding |
| Hvem får betalt? | Plattformene beholder besparelsene; IP-leverandører og patentpooler får betalt per design og per enhet; oppstartsselskapene innen nevrale kodeker ble kjøpt opp |
| Hvor har et selskap muligheter? | Nevral for- og etterbehandling, produkter med lukkede sløyfer, silisium med kodek pluss NPU, og evaluerings- og standardiseringsarbeidet i mellom |
Tre veier inn
«Nevral koding» dekker tre ulike ting, og de fleste uenighetene om det kommer av at de blandes sammen. Et nettverk kan virke rundt en standardkodek og behandle piksler før koding eller etter dekoding mens bitstrømmen forblir standard. Det kan sitte inne i en standard, som et verktøy alle dekodere må kjøre, noe som betyr at det må spesifiseres nøyaktig. Eller det kan erstatte kodeken ende til ende, med en lært koder og dekoder som bare virker som et par.
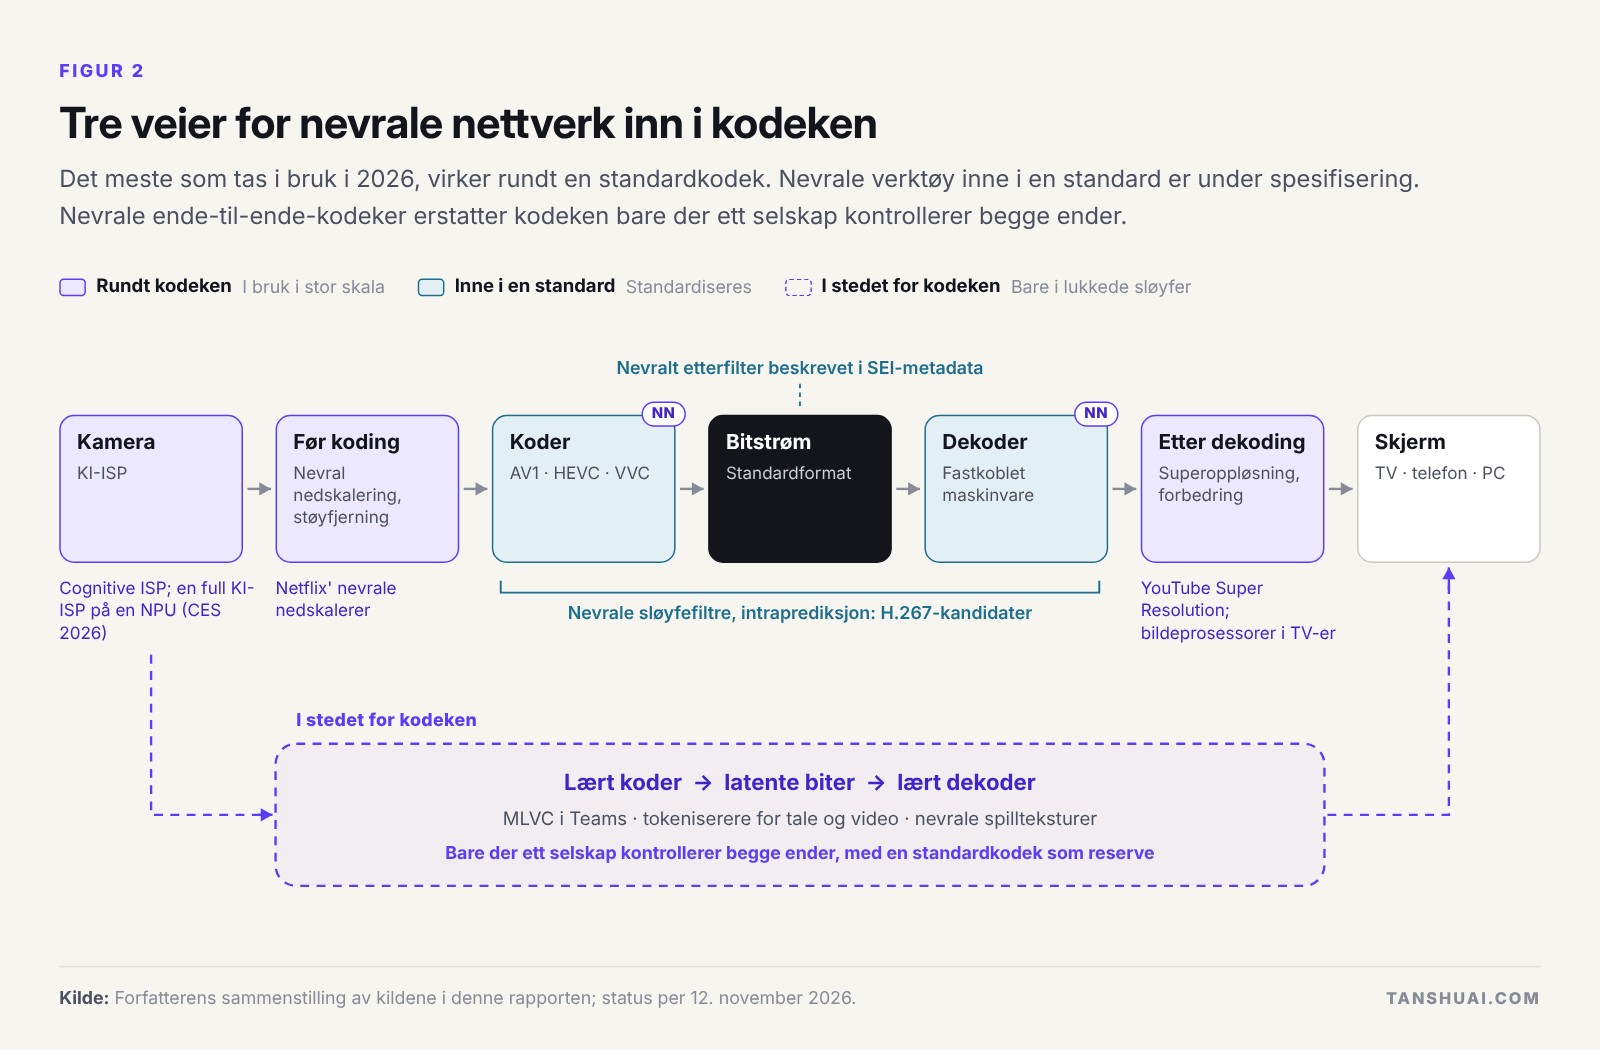 Figur 2. Tre veier for nevrale nettverk inn i kodeken. Det meste som tas i bruk i 2026, er den første.
Den første trenger ingens tillatelse. Den andre trenger en standard. Den tredje trenger kontroll over begge ender. Det er rekkefølgen de når folk i.
Avspilling og strømming: nevralt i begge ender, standard i midten
De store tjenestene har fullført én kodekovergang og begynner på den neste, og ingen av dem involverer en nevral dekoder. Netflix rapporterte i desember 2025 at AV1 sto for omtrent 30 % av seertiden; YouTube sier at mer enn 90 % av katalogen, vektet etter seertid, er tilgjengelig i AV1. AV2 ble ferdigstilt 28. mai 2026 med omtrent 30 % bedre komprimering enn AV1, og innen tre uker hadde Chips&Media, Allegro DVT og VeriSilicon annonsert kunder for AV2-dekodere. Brasils TV 3.0 startet kommersiell VVC-kringkasting i juni 2026.
Den nevrale delen sitter i begge ender. Siden 2022 har Netflix brukt et lite nevralt nettverk i stedet for et konvensjonelt filter til å nedskalere masterne sine, noe som ikke krever endringer på noen enhet, og som omtrent 77 % av seerne foretrakk i Netflix' tester. YouTube oppskalerer videoer lastet opp under 1080p med maskinlæring på TV-er, Meta kjører superoppløsning på serverne og på telefoner, og Samsungs flaggskipprosessor for TV markedsføres med 768 nettverk for oppskalering.
Det som ikke finnes, er en nevral bitstrøm på vanlige skjermer, og grunnen er tid. Et avspillingsformat må kunne dekodes på alle enheter som noen gang skal spille det av. AV1 brukte nesten åtte år fra ferdig spesifikasjon til 30 % av seertiden på Netflix.
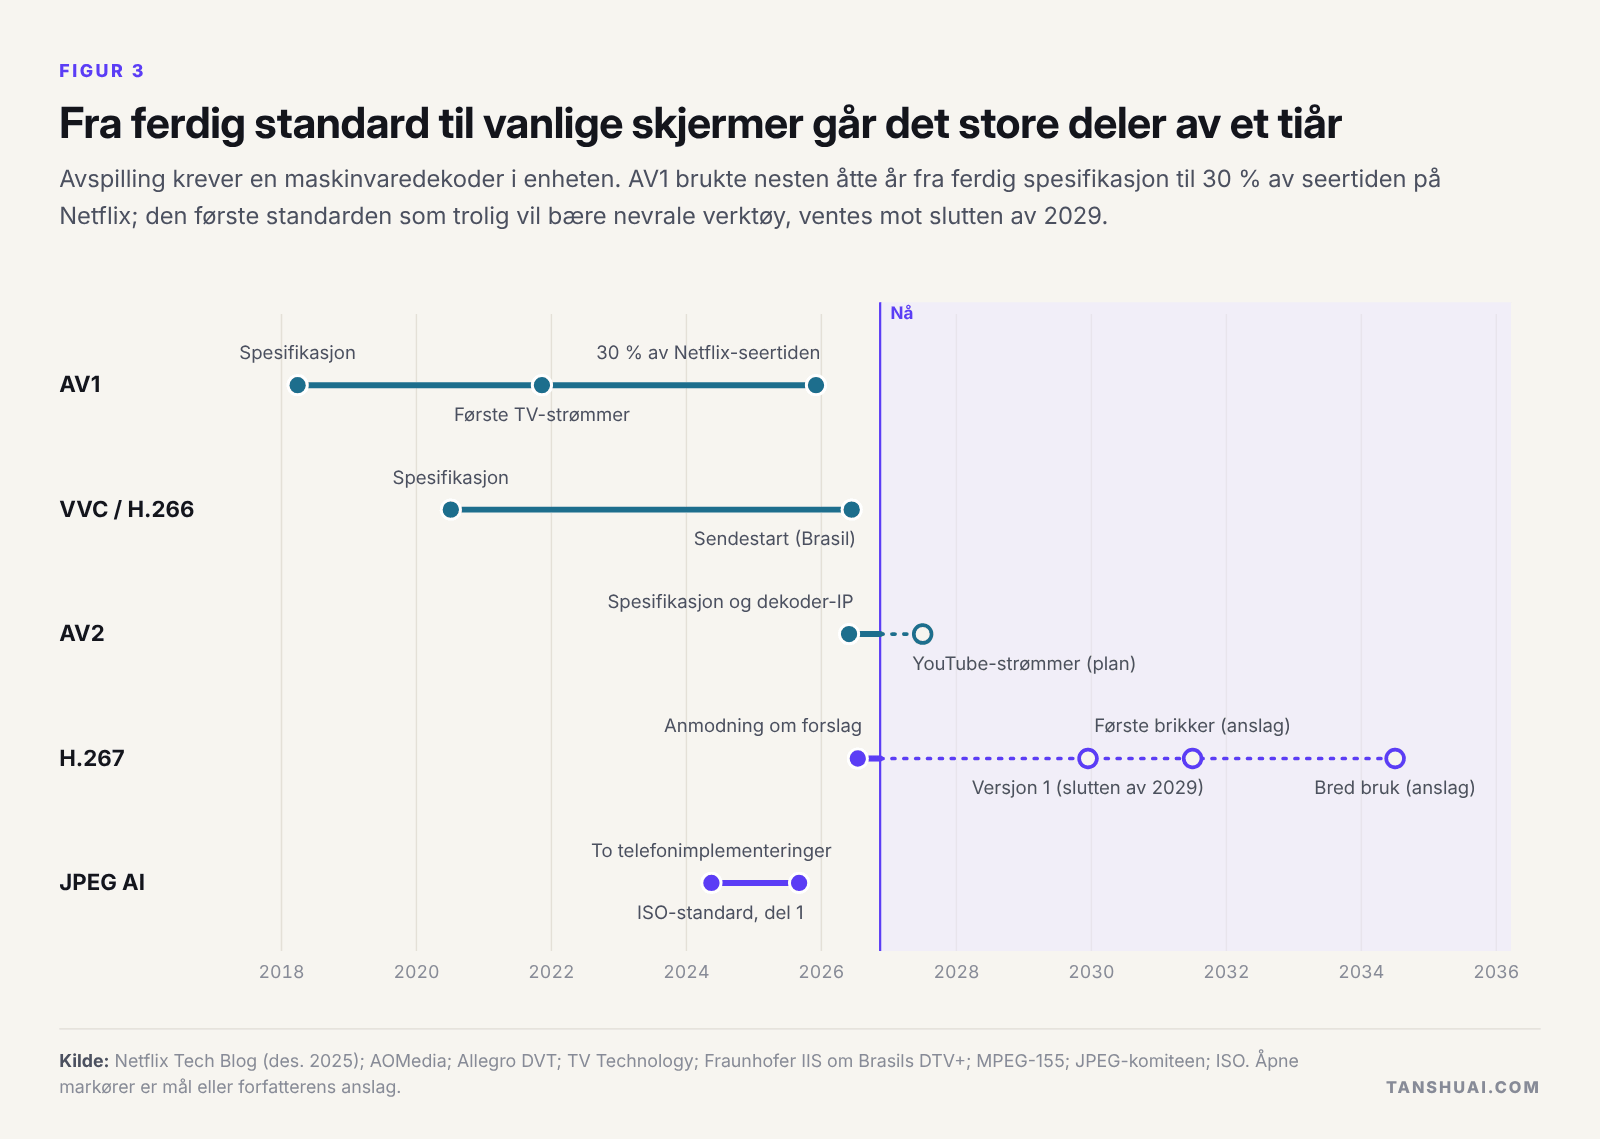 Figur 3. Fra ferdig standard til vanlige skjermer går det store deler av et tiår.
Standarden som kan bringe nevrale verktøy til alle skjermer, er H.267, arbeidsnavnet på etterfølgeren til VVC. JVET sendte ut sin anmodning om forslag i juli 2026; svarene vurderes i januar 2027, og den første versjonen ventes ved utgangen av 2029. Det klassiske sporet sparer allerede omtrent 28 % mot VVC, mens JVETs nevrale sløyfefiltre sparer 6–14 % ved en dekoderkostnad på 10 tusen MAC per piksel og oppover. Jeg venter en klassisk kjerne med noen få nevrale verktøy der bitene som spares, forsvarer kostnaden.
Foto: nevralt inne i kameraet, klassisk på nettet
Hvert bilde fra en nyere flaggskiptelefon har gått gjennom nevrale nettverk før det lagres. Qualcomms Cognitive ISP har kjørt semantisk segmentering i sanntid siden 2023, og på CES 2026 viste Chips&Media og Visionary.ai en fullstendig ISP som kjører helt på en NPU. Deretter lagres resultatet som JPEG eller HEIF.
JPEG AI, den første standarden for lært bildekoding, ble publisert i 2025, med gevinster på 12,5–27,9 % mot VVC-intrakoding ved dekoderkostnader på 7 til 216 tusen MAC per piksel. Jeg fant ingen kameraer, galleriapper eller nettlesere som bruker den som standard. Formatet nettet tok i bruk i 2026, er klassisk: Chrome 155 slo på JPEG XL 6. oktober, med en rask, minnesikker dekoder som kjører på enhver CPU. Nevral koding vinner inne i ett selskaps kjede; formater som må kunne åpnes overalt, forblir klassiske.
Samtaler: der nevrale ende-til-ende-kodeker tas i bruk
Samtaler er en lukket sløyfe: begge ender kjører samme app og kan falle tilbake på en standardkodek midt i samtalen. Derfor er det her de første nevrale ende-til-ende-kodekene i stor skala finnes. Microsofts KI-baserte talekodek Satin har kjørt i alle samtaler mellom to parter i Teams og Skype siden 2021. I juli 2026 gjorde Microsoft MLVC, en nevral videokodek som nå rulles ut i peer-to-peer-samtaler i Teams, til åpen kildekode.
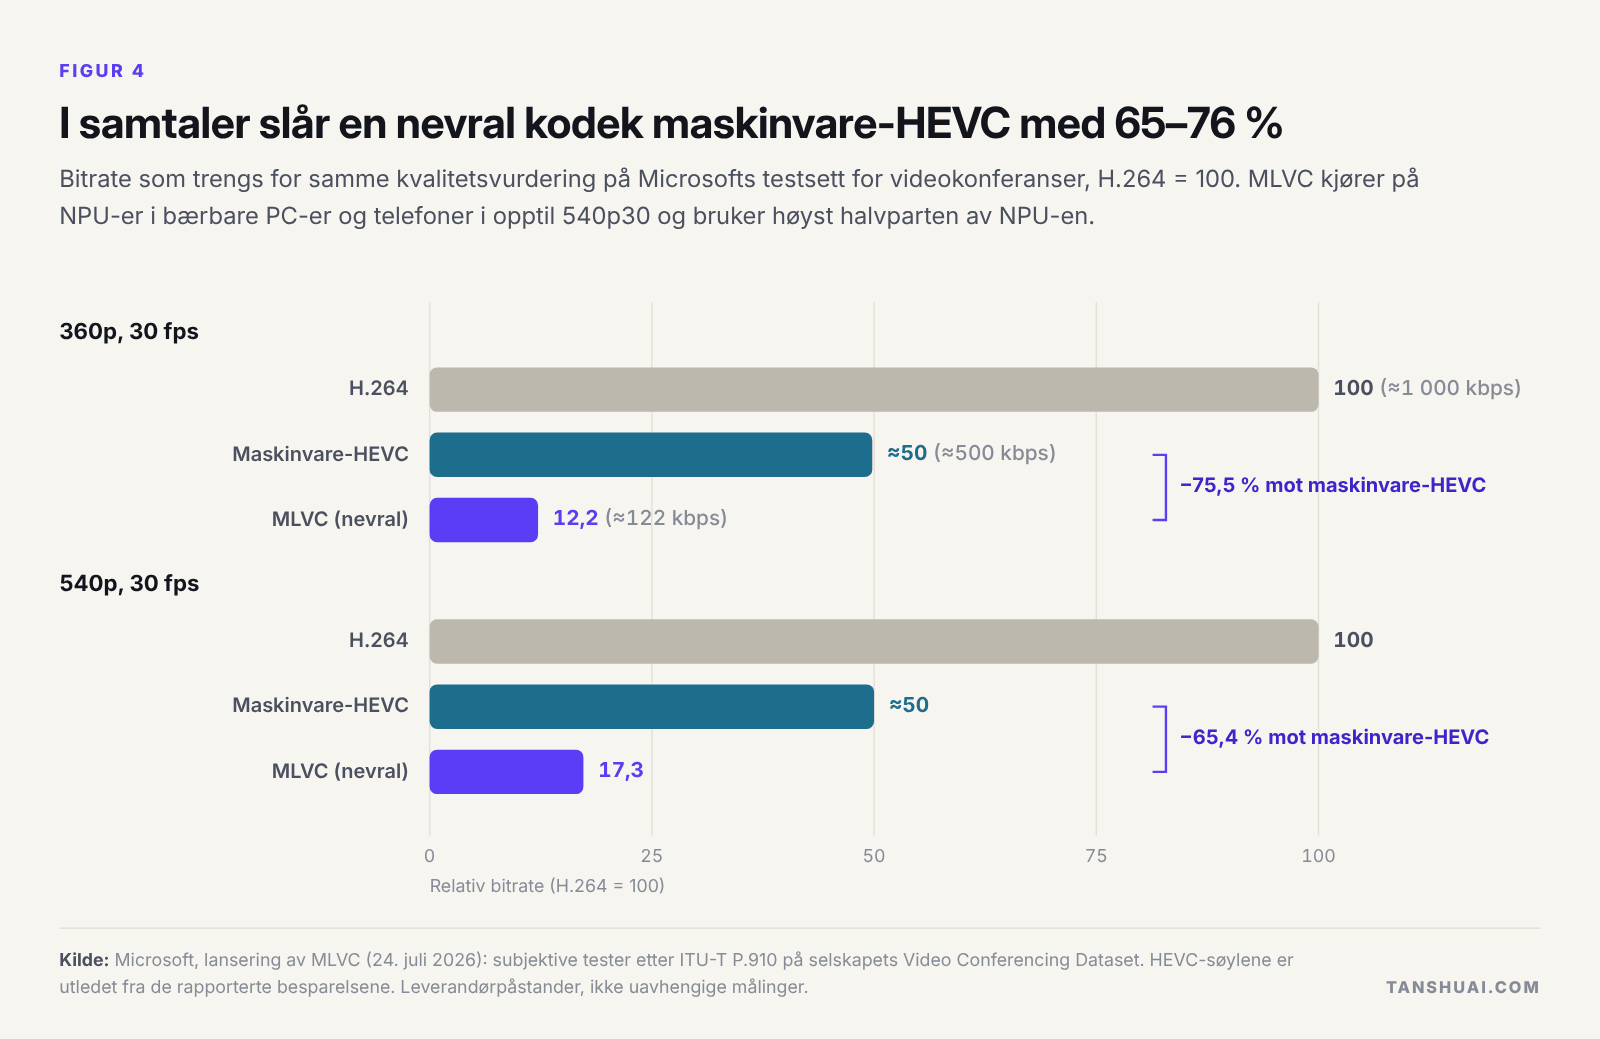 Figur 4. I samtaler slår en nevral kodek maskinvare-HEVC med 65–76 %, på Microsofts eget testsett.
Tallet på 88 % i overskriftene er mot H.264; mot HEVC-maskinvaren som allerede sitter i de samme bærbare PC-ene, er det 65–76 %, fortsatt mye. MLVC kjører i 540p og 360p med høyst halvparten av NPU-en, og den ga avkall på noe komprimering for å dekode identisk på maskinvare Microsoft ikke eier.
Ikke alle valgte denne veien. Opus la i 2024 til dyp læring som valgfrie, bakoverkompatible tillegg. Meta bygde MLow, en klassisk talekodek, fordi mer enn 20 % av samtalene går på gamle ARMv7-telefoner, og titalls millioner WhatsApp-samtaler per dag går på telefoner som er over ti år gamle. Nevrale kodeker tas først i bruk der enhetene er nye og én leverandør kontrollerer begge ender.
Generativ KI: den største utrullingen som ingen kaller en kodek
Alle tale- og videomodeller kjører på en lært kodek. Talemodeller leser og skriver tokenene til nevrale lydkodeker som Kyutais Mimi, med 12,5 rammer i sekundet og 1,1 kbps. Videogeneratorer arbeider i latentrommet til videoautoenkodere som den i LTX-Video, som komprimerer 1:192. Ingen av disse er et format noen andre dekoder, men de beviser at lært komprimering virker i stor skala når ett selskap eier koderen, dekoderen og maskinvaren. For alle som leverer generativ video, er tokeniserernes effektivitet en direkte kostnadspost.
Spill: nevral rekonstruksjon er utbredt, nevrale ressurser er på vei inn
NVIDIAs DLSS rendrer færre piksler og bilder og lar et nettverk gjenoppbygge resten. Nevral teksturkomprimering ble tatt i bruk i Assassin's Creed Mirage, men bare på utvalgte ressurser på grunn av kjøretidskostnaden.
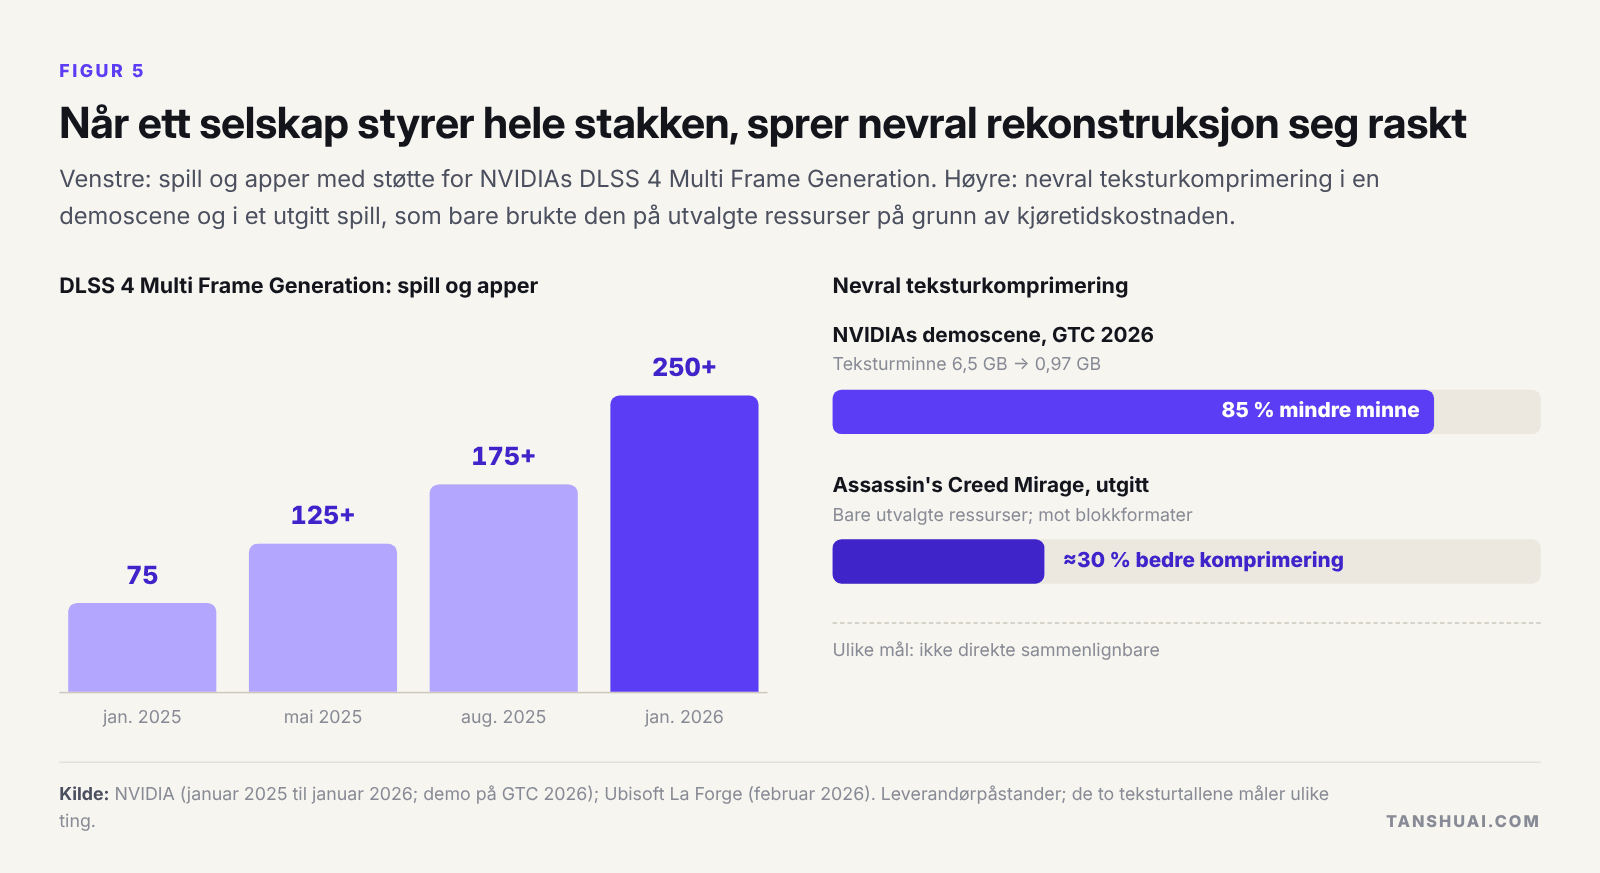 Figur 5. Når ett selskap styrer hele stakken, sprer nevral rekonstruksjon seg raskt.
Satellitt-, drone- og robotsamband passer teknisk best for nevrale ende-til-ende-kodeker, men de er et lite marked og i økende grad eksportkontrollert på begge sider: Kinas eksportregler for droner fra 18. november 2026 nevner til og med semantisk bildekomprimering som en terskel.
Silisiumperspektivet
Det er her min egen bakgrunn betyr mest. Et brikketeam stiller fire spørsmål om enhver ny kodek: joule per piksel, DRAM-trafikk per piksel, porter, og om alle dekodere i verden beregner nøyaktig de samme bitene. På alle fire er en nevral dekoder i 2026 der maskinvare-HEVC var før de første brikkene.
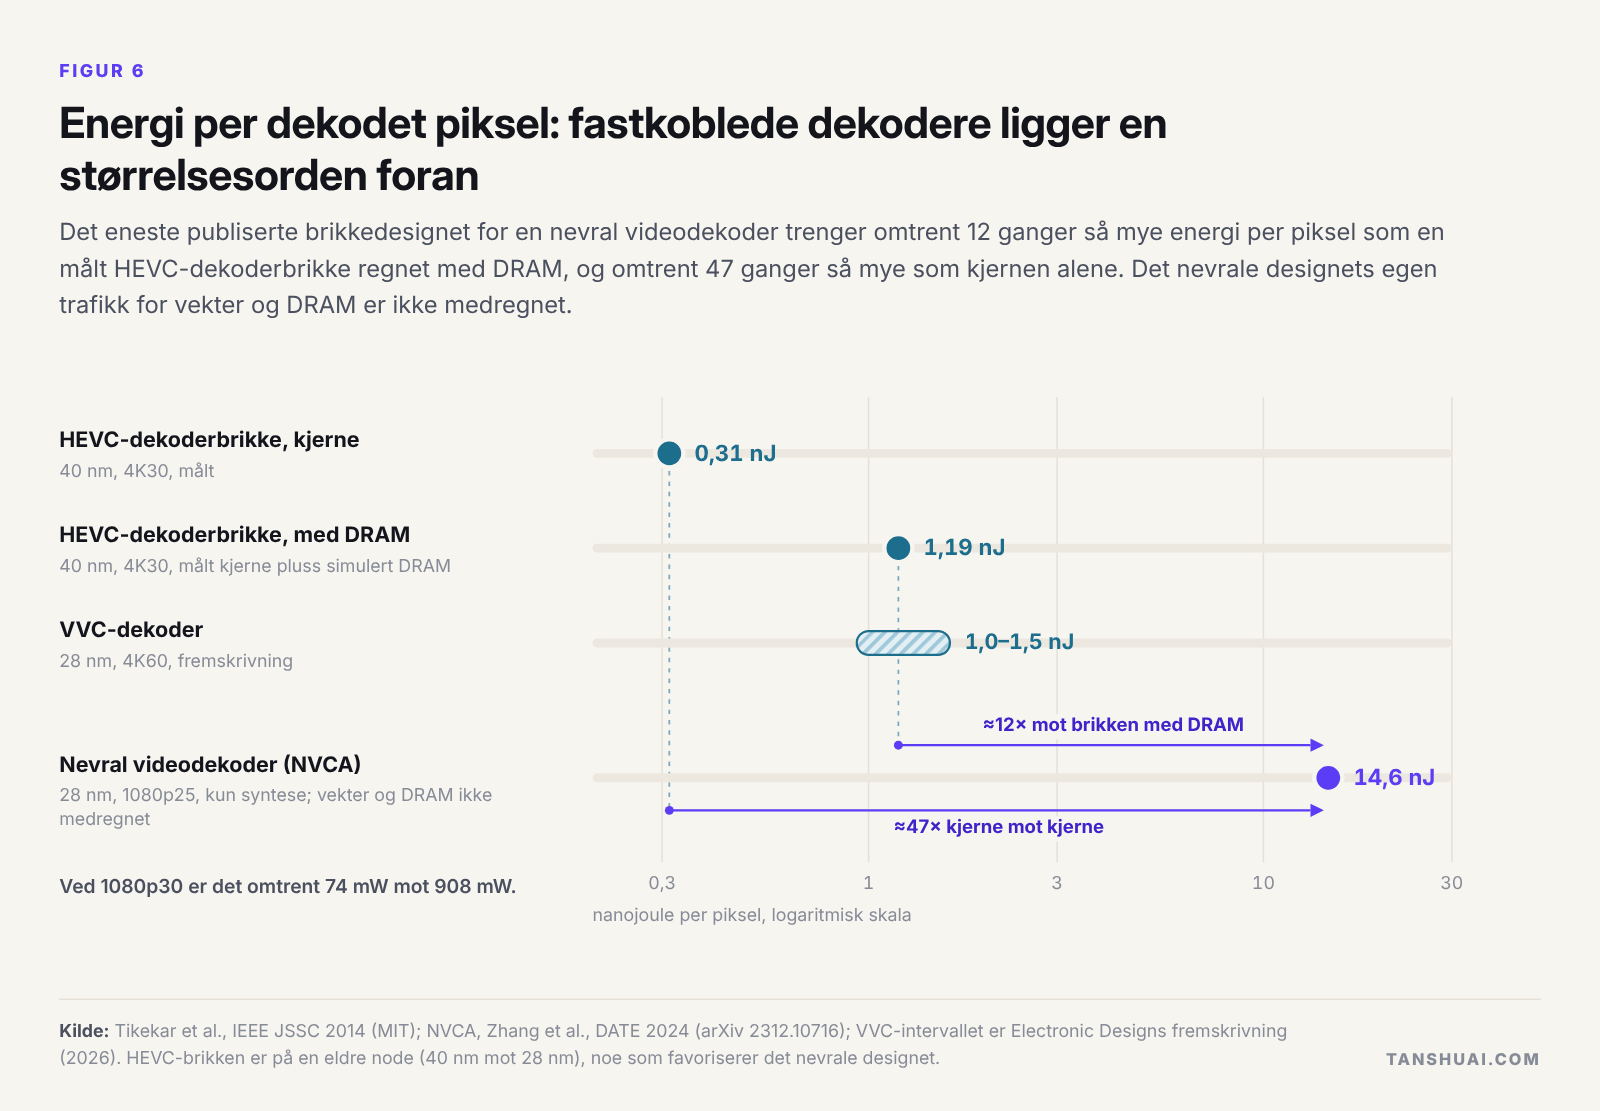 Figur 6. Energi per dekodet piksel: fastkoblede dekodere ligger en størrelsesorden foran.
Det eneste publiserte brikkedesignet for en nevral videodekoder, NVCA, trenger 14,6 nJ per piksel; MITs HEVC-dekoderbrikke trenger 1,19 med DRAM og 0,31 for kjernen. Ved 1080p30 er det rundt 900 mW mot 74 mW. Microsofts raske forskningskodek DCVC-RT trenger, etter min sum av dens egen tabell per modul, omtrent 175 tusen MAC per dekodet piksel, eller omtrent 22 TOPS ved 1080p30: halvparten av de 40 TOPS som definerer en KI-PC, for én strøm.
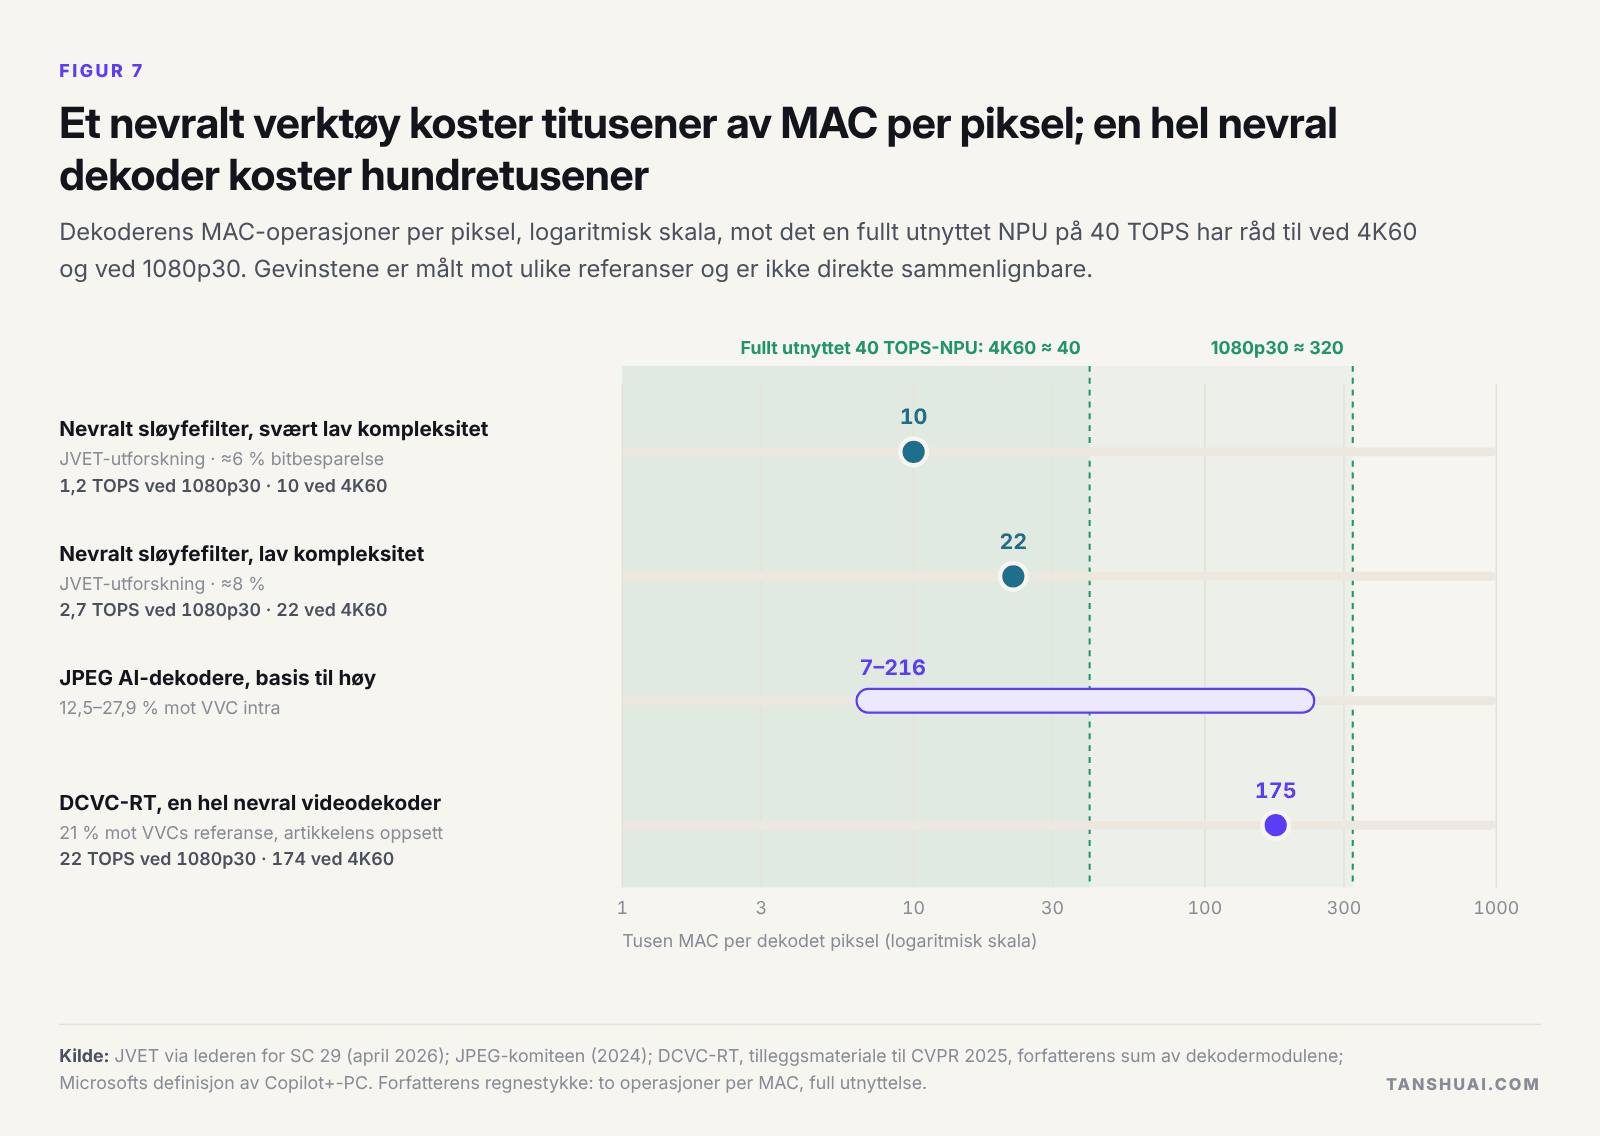 Figur 7. Et nevralt verktøy koster titusener av MAC per piksel; en hel nevral dekoder koster hundretusener.
To kostnader til betyr noe. Minne: i MIT-brikken går omtrent tre firedeler av systemets energi til DRAM, og nevrale dekodere bærer store egenskapskart mellom bildene. Eksakthet: entropidekodingen feiler hvis to enheter beregner en sannsynlighet ulikt, og det er derfor alle seriøse nevrale kodeker nå bruker heltallsaritmetikk, og derfor MLVC bytter komprimering mot identisk dekoding.
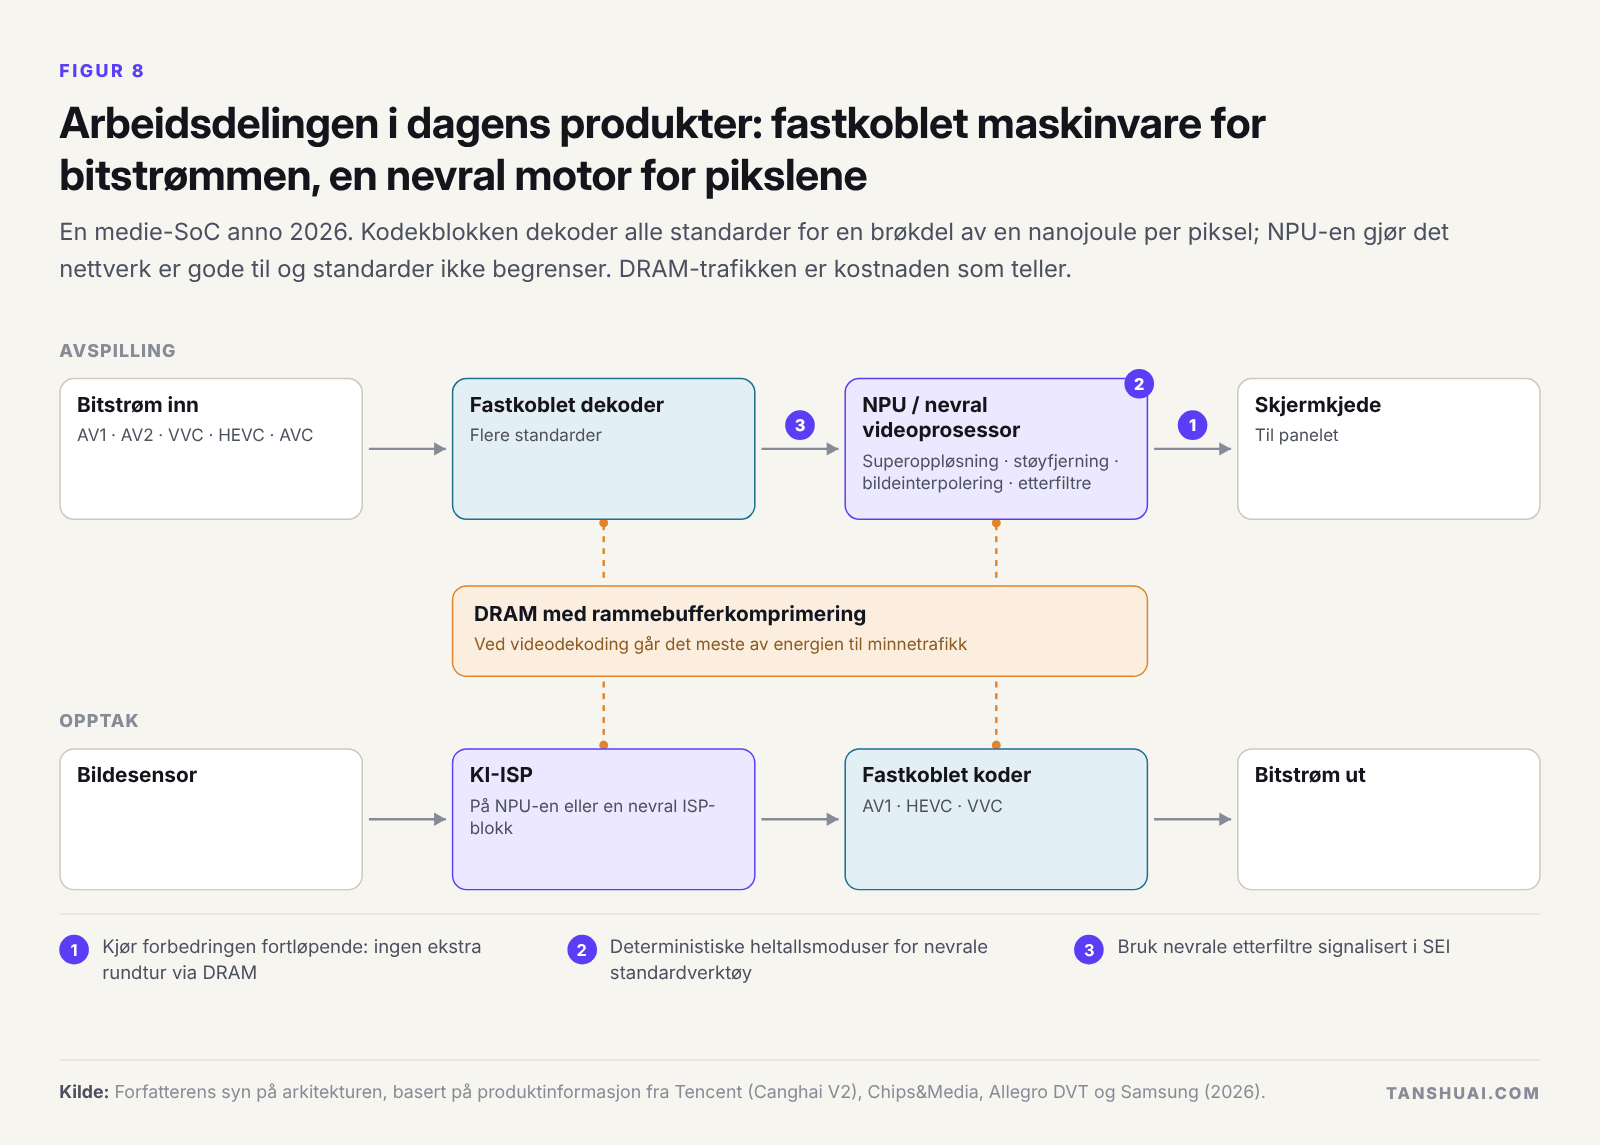 Figur 8. Arbeidsdelingen i dagens produkter: fastkoblet maskinvare for bitstrømmen, en nevral motor for pikslene.
Silisiumet som selger, kombinerer de to. Tencent har mer enn 100 000 av sine egenutviklede Canghai-kodekbrikker i drift, og andre generasjon legger til H.266 og superoppløsning på brikken; IP-leverandører selger kodekblokker og video-NPU-er side om side. Hvis jeg skulle planlagt en medie-SoC nå: fastkoblede dekodere for alle standarder du må spille av, inkludert AV2; en NPU dimensjonert for forbedring i skjermoppløsning, uten en ekstra tur gjennom DRAM; deterministiske heltallsmoduser; og H.267 som designstart etter 2029.
Hvem får betalt, og hvor et selskap har muligheter
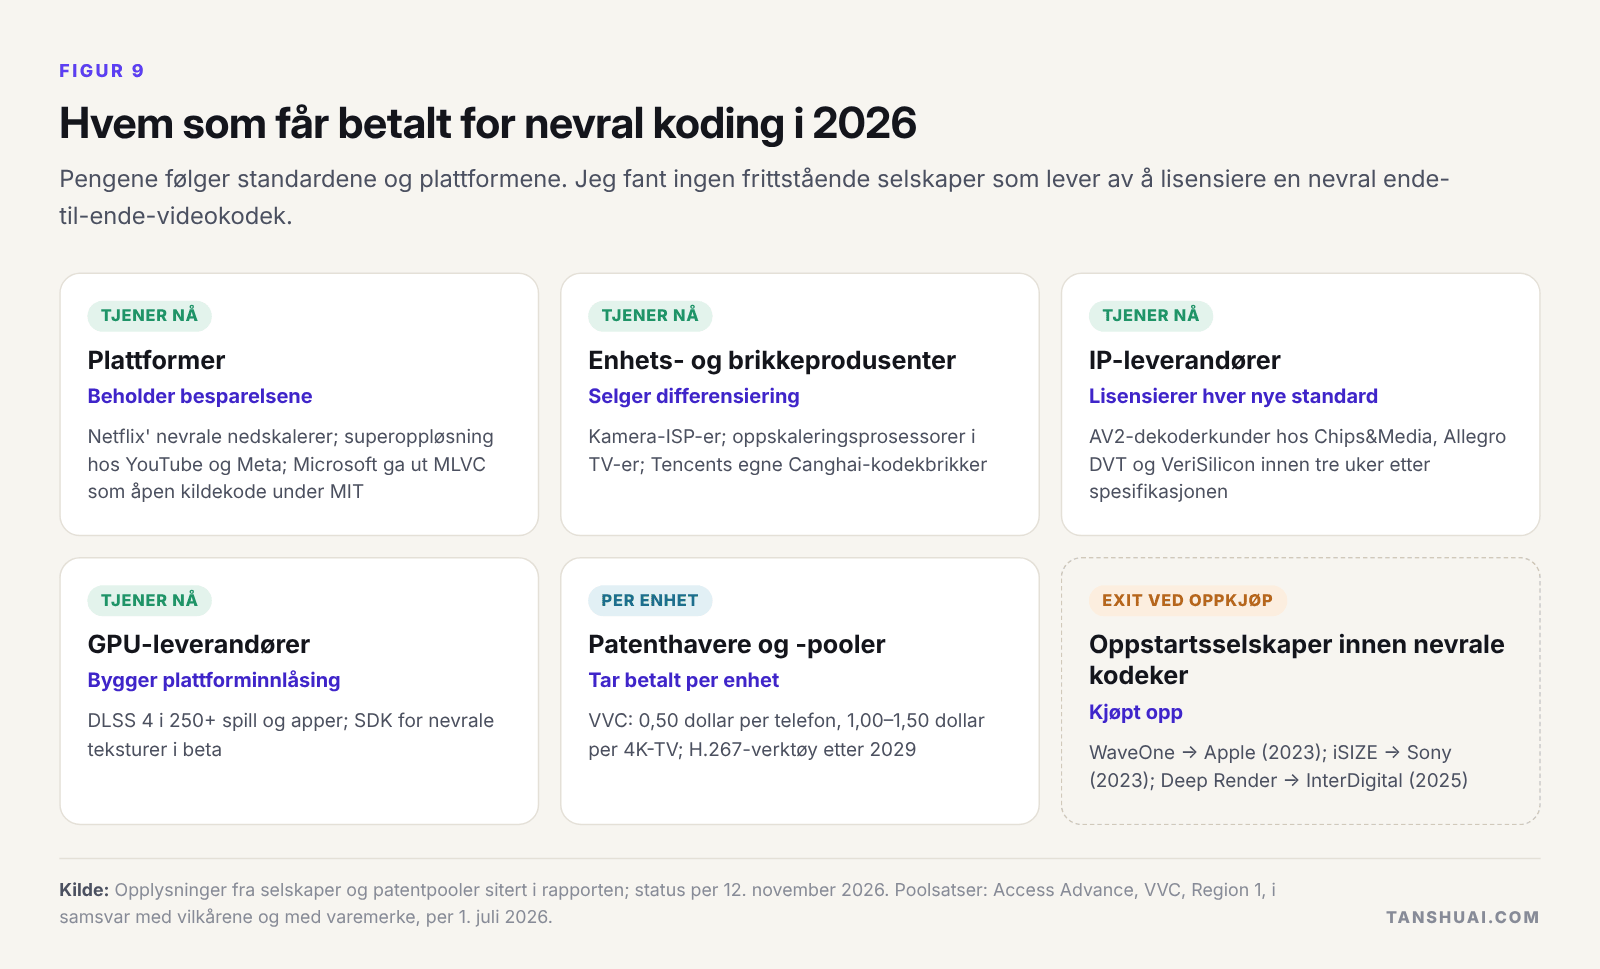 Figur 9. Pengene følger standardene og plattformene.
Plattformene beholder besparelsene og gir noen ganger bort koden, slik Microsoft gjorde med MLVC. IP-leverandører lisensierer dekodere for hver nye standard. Patentpooler tar betalt per enhet: for VVC 0,50 dollar per telefon og 1,00–1,50 dollar per 4K-TV i USA og andre Region 1-markeder. WaveOne gikk til Apple, iSIZE til Sony og Deep Render til InterDigital. Jeg fant ingen frittstående selskaper som lever av å lisensiere en nevral ende-til-ende-videokodek.
For et selskap er de åpne mulighetene nevral forbehandling for videotjenester, forbedring på skjermsiden for brikkeprodusenter, nevrale kodeker i lukkede sløyfer for konferanser og private samband, silisium med kodek pluss NPU, og verktøyene for evaluering og konformitet som alle som leverer nevrale verktøy, vil trenge. Standardarbeid på H.267 krever tålmodighet og en lisensieringsstrategi.
Påstander å ta med en klype salt, og hva du bør følge med på
Krev fire ting av enhver påstand om nevrale kodeker: referansen, kvalitetsmålet, oppløsningen og dekodingskostnaden. «88 % besparelse» er mot H.264 ved 360p; «85–96 % mindre videominne» gjelder en demoscene, mot 30 % i det utgitte spillet; «JPEG AI er en standard» har ennå ikke noe produkt bak seg.
Datoene som betyr noe: H.267-evalueringen i januar 2027, YouTubes første AV2-strømmer tidlig i 2027, H.267s første testmodell i andre halvår 2027, om MLVC sprer seg utover Teams, det første produktet som bruker JPEG AI som standard, og NPU-budsjettene i telefoner og PC-er. Versjon 1 av H.267 ved utgangen av 2029 starter brikkesyklusen for nevrale verktøy i vanlig avspilling.
Last ned full rapport og lysbilder
Den fullstendige rapporten dekker hvert område mer detaljert, regnestykkene for silisiumet, standardene og patentene, en tabell over påstander mot dokumentasjon og alle kildene.
- Nevral koding i 2026: full rapport (PDF)
- Nevral koding i 2026: lysbilder (PDF)
- Engelsk utgave: full rapport · lysbilder
Dette er en oversettelse av den engelske utgaven; ved avvik gjelder den engelske utgaven.
Åpne spørsmål
Noen spørsmål her har ennå ikke noe offentlig svar, og det er dem jeg finner mest interessante teknisk: hvor nær en nevral dekoder kan komme bitnøyaktig heltallsaritmetikk på tvers av ulike leverandørers NPU-er før den mister komprimeringsfordelen; hva nevral etterbehandling koster i DRAM-trafikk per piksel; ved hvilken kostnad per piksel et nevralt verktøy slutter å lønne seg i en H.267-dekoder; hvilke lukkede systemer utover samtaler som først kan ta i bruk nevrale ende-til-ende-kodeker; og hvordan man måler troskap mot originalen når en dekoder genererer detaljer i stedet for å rekonstruere dem.
Dette er områder vi kan utforske sammen i årene som kommer, gjennom teknisk utveksling og teknisk samarbeid: i@tanshuai.com.
Om forfatteren
Tan Shuai er teknolog og gründer med mer enn tjue års arbeid innen brikker, maskinvare og systemprogramvare, og 20 innvilgede patenter. Han har mange års erfaring med FoU og ledelse innen fabless-brikker, blant annet full-custom-design av ASIC-databaner og prosjekter med multimediebrikker for kameraer, som akseleratorer for videokodeker. Arbeidet har ført ham gjennom Silicon Valley, New York, Chicago, Taiwan, Greater Bay Area (Shenzhen og Hongkong), Vietnam og Malaysia. I dag arbeider han som KI-forsker og -utvikler.
Teknisk diskusjon: i@tanshuai.com.