
Neuronale Netze prägen schon heute fast jedes Video, das Sie sehen, allerdings an beiden Enden eines Standard-Codecs, nicht an seiner Stelle. Hier steht, wo neuronale Codierung 2026 im Einsatz ist, was sie in Silizium kostet und wer daran verdient, mit vollständigem Bericht und Folien.
Kurzfassung
Neuronale Codierung ist 2026 bereits im Mainstream angekommen, aber sie arbeitet rund um die Standard-Codecs, statt sie zu ersetzen. Netze formen das Bild vor der Codierung, in Smartphone-Kameras und in der Encoding-Pipeline von Netflix, und reparieren es nach der Decodierung, in YouTubes Super Resolution, bei Meta und in TV-Prozessoren; der Bitstrom dazwischen ist weiterhin AV1, HEVC, AVC oder VVC und wird von festverdrahteter Hardware decodiert. Neuronale End-to-End-Codecs gibt es nur in geschlossenen Systemen, in denen ein Unternehmen beide Enden kontrolliert: Microsofts MLVC in Teams-Anrufen, die Tokenizer in jedem Voice- und Videomodell, neuronale Texturen in einem Spiel. Die Wiedergabe neuronaler Bitströme im Massenmarkt wartet auf H.267, geplant für Ende 2029, und auf einen Chipzyklus danach. Der Grund liegt im Chip: Das einzige veröffentlichte Design eines neuronalen Videodecoders braucht pro Pixel etwa das 12-Fache der Energie eines gemessenen HEVC-Decoders, und ein schneller Forschungscodec braucht rund 22 TOPS für 1080p30. Das Geld folgt den Standards und den Plattformen; die bekanntesten Start-ups für neuronale Codecs wurden übernommen.
Warum ich mir das angesehen habe
Alle paar Monate erzählt mir jemand, dass KI-Codecs demnächst H.264, HEVC und AV1 ablösen werden. Das meiste, was ich darüber lese, stammt entweder aus Forschungsarbeiten, wo die Kompressionsrekorde stehen, oder von Anbietern. Beide sagen wenig darüber, was tatsächlich im Einsatz ist, bei wem und zu welchen Kosten.
Ich habe viele Jahre Chipentwicklung und Management im Fabless-Bereich hinter mir, darunter den Full-Custom-Entwurf von ASIC-Datenpfaden und Multimedia-Kamerachip-Projekte wie Beschleuniger für Videocodecs, und habe das Thema deshalb so betrachtet, wie ich einen Chip prüfen würde: Energie pro Pixel, Speicherverkehr, was ein Standard in Silizium festzuschreiben erlaubt, und wer bezahlt. Ich habe Standarddokumente und Sitzungsberichte von JVET, MPEG, JPEG, AOMedia und der IETF gelesen, Engineering-Blogs von Unternehmen, Chip-Paper, Gebührentabellen von Patentpools, Texte zu Exportkontrollen und die Presse. Alle Zahlen unten haben den Stand vom 12. November 2026, Beträge sind in US-Dollar angegeben. Der vollständige Bericht mit allen Quellen steht am Ende.
Ergebnisse auf einen Blick
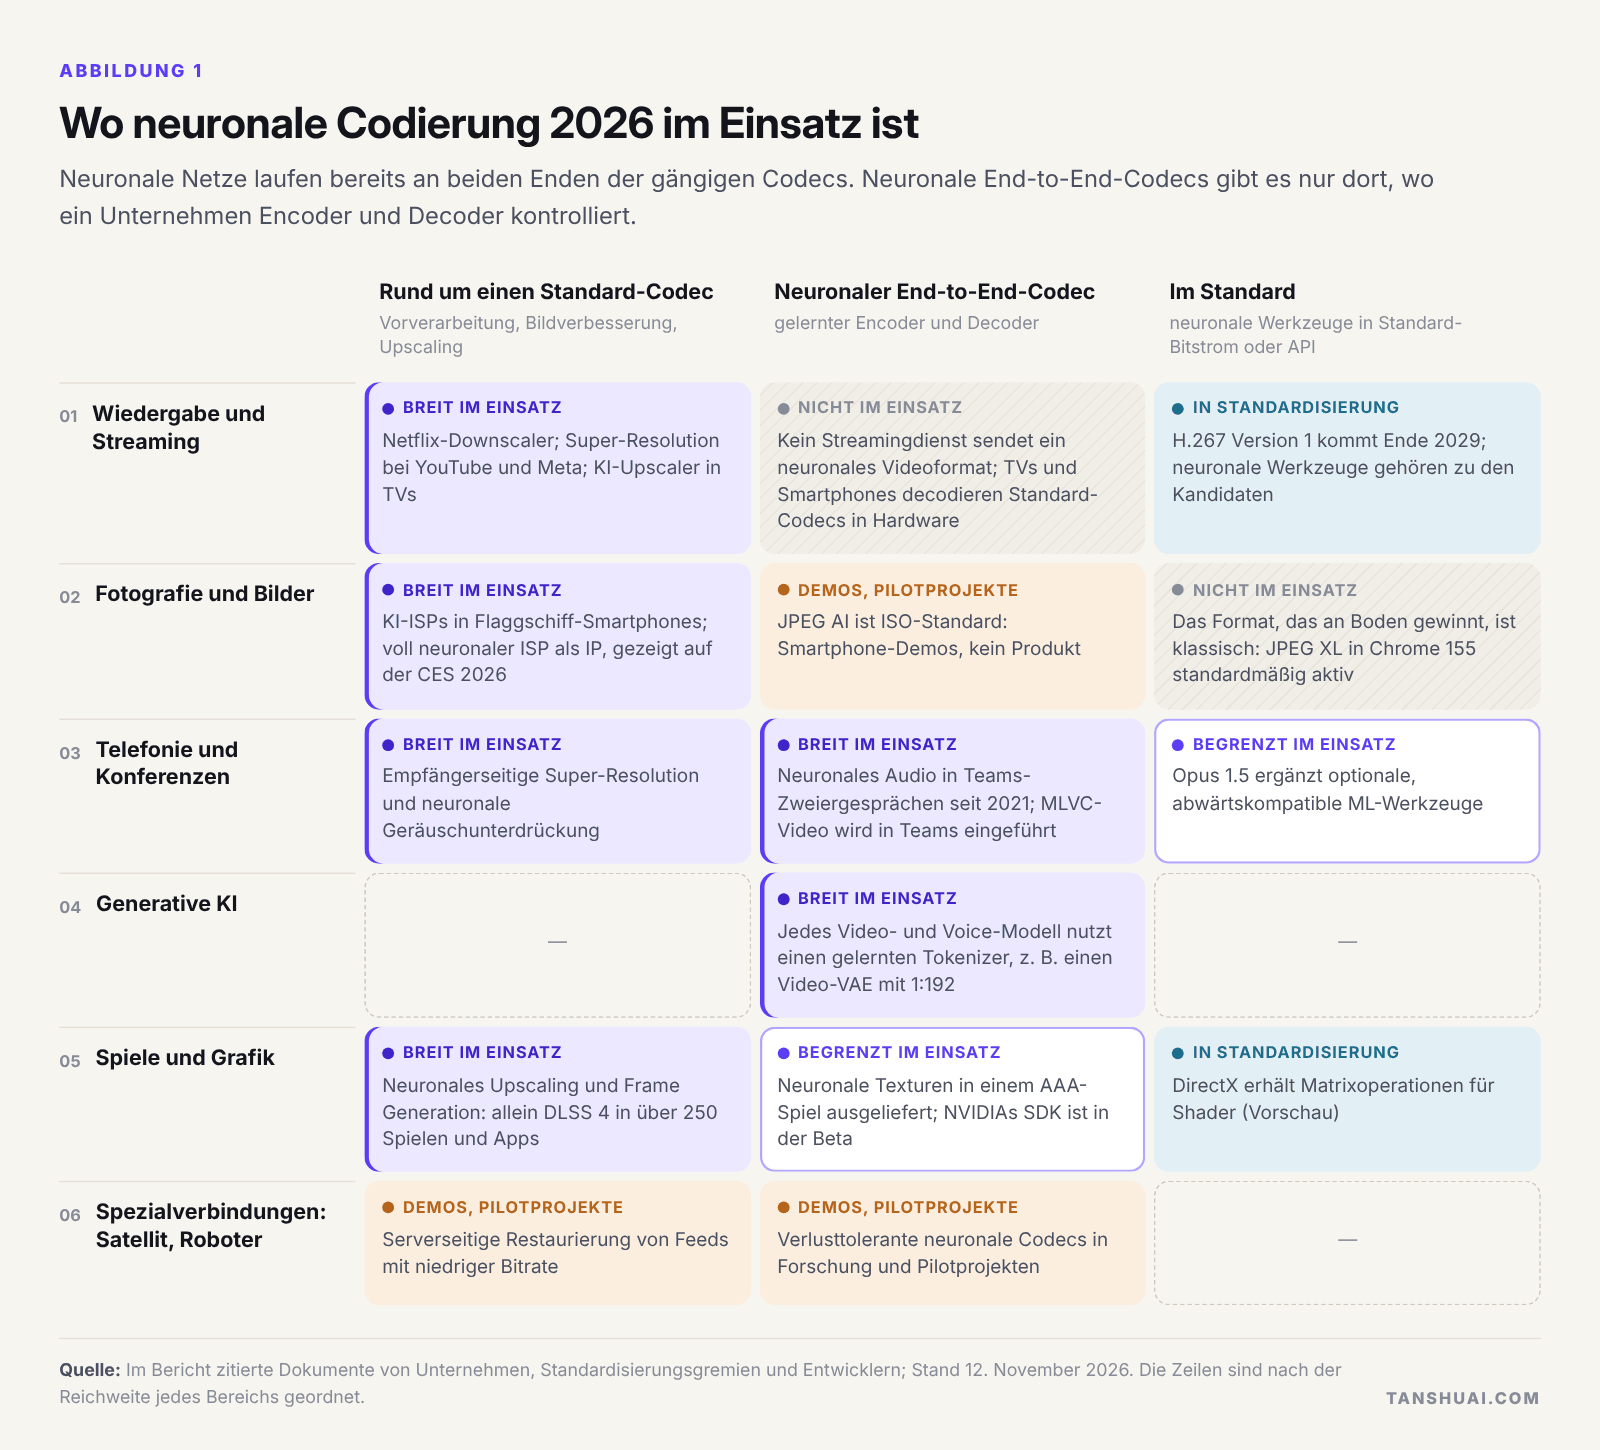 Abbildung 1. Wo neuronale Codierung 2026 im Einsatz ist. Die Zeilen sind danach geordnet, wie viele Menschen jeder Bereich erreicht.
| Frage | Kurze Antwort |
|---|---|
| Wo ist neuronale Codierung breit im Einsatz? | Rund um den Codec: Kamera-ISPs, Downscaling vor dem Encoder, Super-Resolution bei der Wiedergabe. End-to-End nur in geschlossenen Systemen: Telefonie, Spiel-Assets, Tokenizer generativer KI |
| Werden neuronale Codecs AV1, HEVC und VVC bei der Wiedergabe ersetzen? | Nicht vor H.267 (Version 1 Ende 2029) und einem Gerätezyklus danach; breiter Einsatz nach meiner Schätzung Mitte der 2030er-Jahre |
| Was kostet das in Silizium? | Etwa das 12-Fache der Energie pro Pixel eines Hardware-HEVC-Decoders, dazu Speicherverkehr und die Anforderung bitgenauer Decodierung |
| Wer verdient daran? | Plattformen behalten die Einsparungen; IP-Anbieter und Patentpools werden pro Design und pro Gerät bezahlt; Start-ups für neuronale Codecs wurden übernommen |
| Wo kann ein Unternehmen ansetzen? | Neuronale Vor- und Nachverarbeitung, Produkte für geschlossene Systeme, Silizium aus Codec plus NPU sowie die Evaluierungs- und Standardisierungsarbeit dazwischen |
Drei Wege in den Codec
„Neuronale Codierung“ umfasst drei verschiedene Dinge, und die meisten Debatten darüber entstehen, weil man sie vermischt. Ein Netz kann rund um einen Standard-Codec arbeiten und Pixel vor der Codierung oder nach der Decodierung verarbeiten, während der Bitstrom standardkonform bleibt. Es kann innerhalb eines Standards sitzen, als Werkzeug, das jeder Decoder ausführen muss, und muss deshalb exakt spezifiziert sein. Oder es ersetzt den Codec End-to-End, mit einem gelernten Encoder und Decoder, die nur als Paar funktionieren.
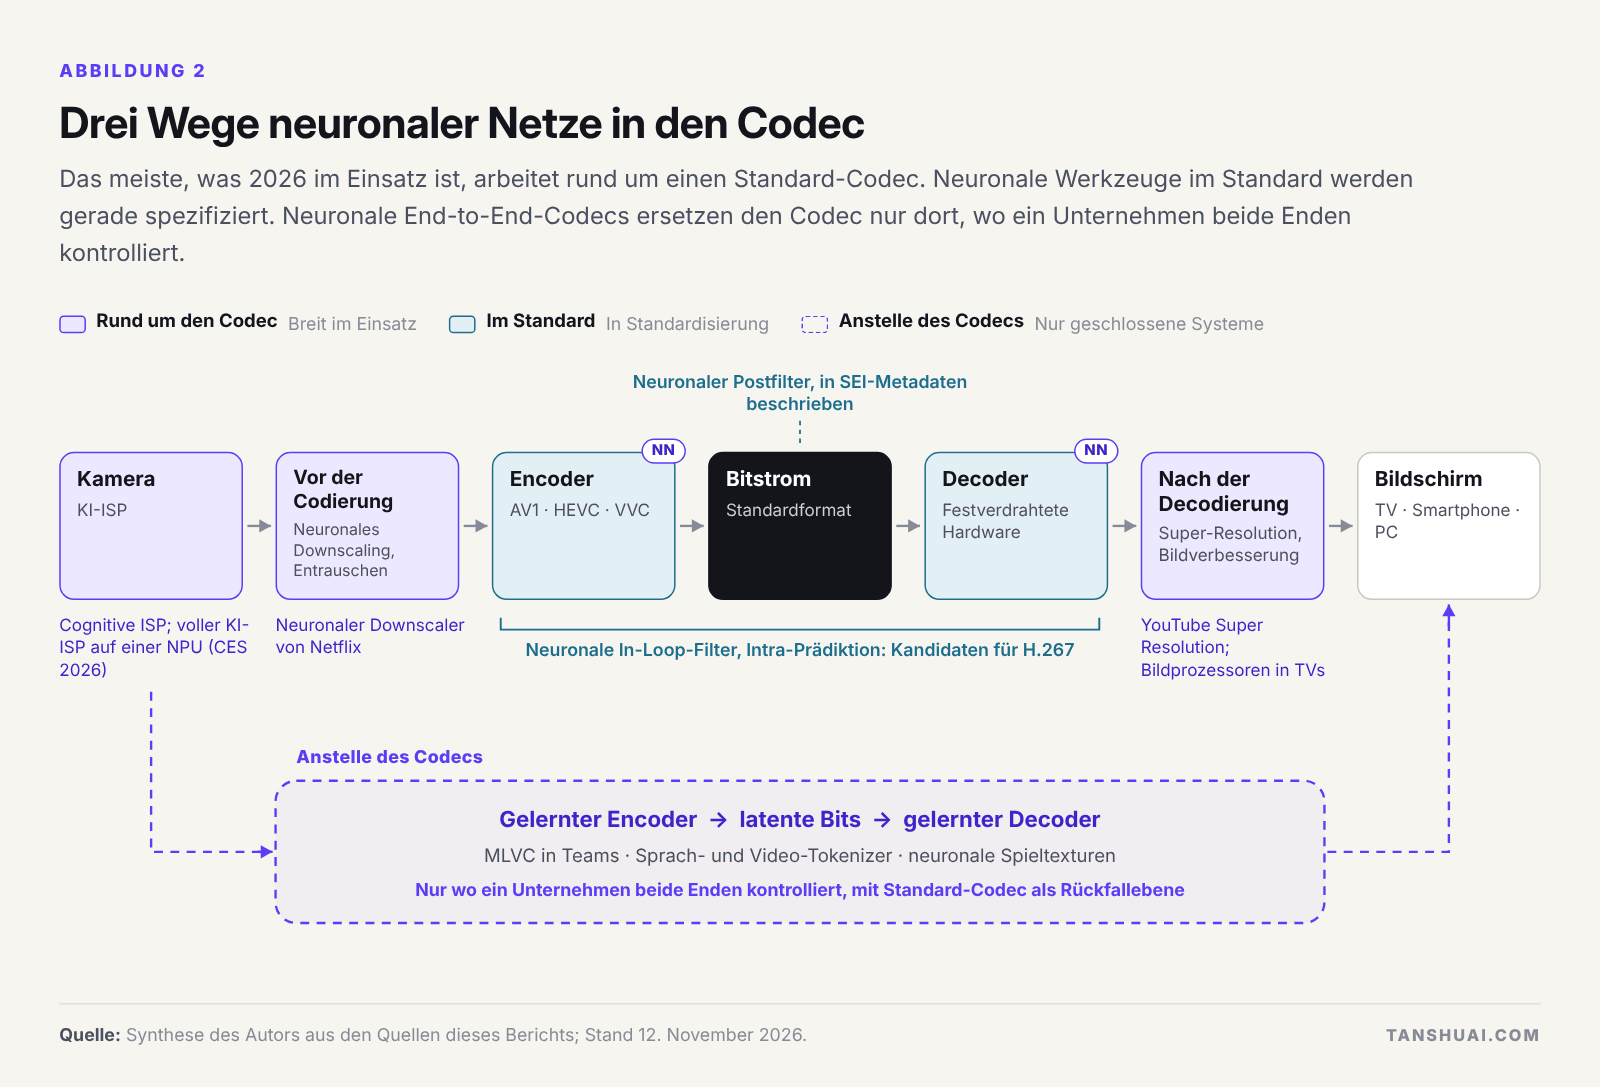 Abbildung 2. Drei Wege neuronaler Netze in den Codec. Das meiste, was 2026 im Einsatz ist, gehört zum ersten.
Der erste braucht niemandes Erlaubnis. Der zweite braucht einen Standard. Der dritte braucht die Kontrolle über beide Enden. In dieser Reihenfolge erreichen sie die Menschen.
Wiedergabe und Streaming: neuronal an beiden Enden, Standard in der Mitte
Die großen Dienste haben einen Codec-Wechsel abgeschlossen und beginnen den nächsten, und bei keinem von beiden spielt ein neuronaler Decoder eine Rolle. Netflix meldete im Dezember 2025, dass auf AV1 etwa 30 % seines Streamings entfielen; YouTube zufolge sind mehr als 90 % seines Katalogs, gewichtet nach Wiedergabezeit, in AV1 verfügbar. AV2 wurde am 28. Mai 2026 fertiggestellt, mit etwa 30 % besserer Kompression als AV1, und binnen drei Wochen hatten Chips&Media, Allegro DVT und VeriSilicon Kunden für AV2-Decoder bekanntgegeben. Brasiliens TV 3.0 hat im Juni 2026 den kommerziellen Sendebetrieb mit VVC aufgenommen.
Der neuronale Teil sitzt an beiden Enden. Seit 2022 skaliert Netflix seine Master mit einem kleinen neuronalen Netz statt mit einem konventionellen Filter herunter; das erfordert an keinem Gerät eine Änderung und wurde in den Tests von Netflix von etwa 77 % der Zuschauer bevorzugt. YouTube skaliert unter 1080p hochgeladene Videos auf Fernsehern per maschinellem Lernen hoch, Meta betreibt Super-Resolution auf seinen Servern und auf Smartphones, und Samsungs Flaggschiff-Prozessor für Fernseher wirbt mit 768 Upscaling-Netzen.
Was es nicht gibt, ist ein neuronaler Bitstrom auf den Bildschirmen des Massenmarkts, und der Grund ist die Zeit. Ein Wiedergabeformat muss auf jedem Gerät decodierbar sein, das es je abspielen wird. AV1 brauchte von der fertigen Spezifikation bis zu 30 % des Netflix-Streamings fast acht Jahre.
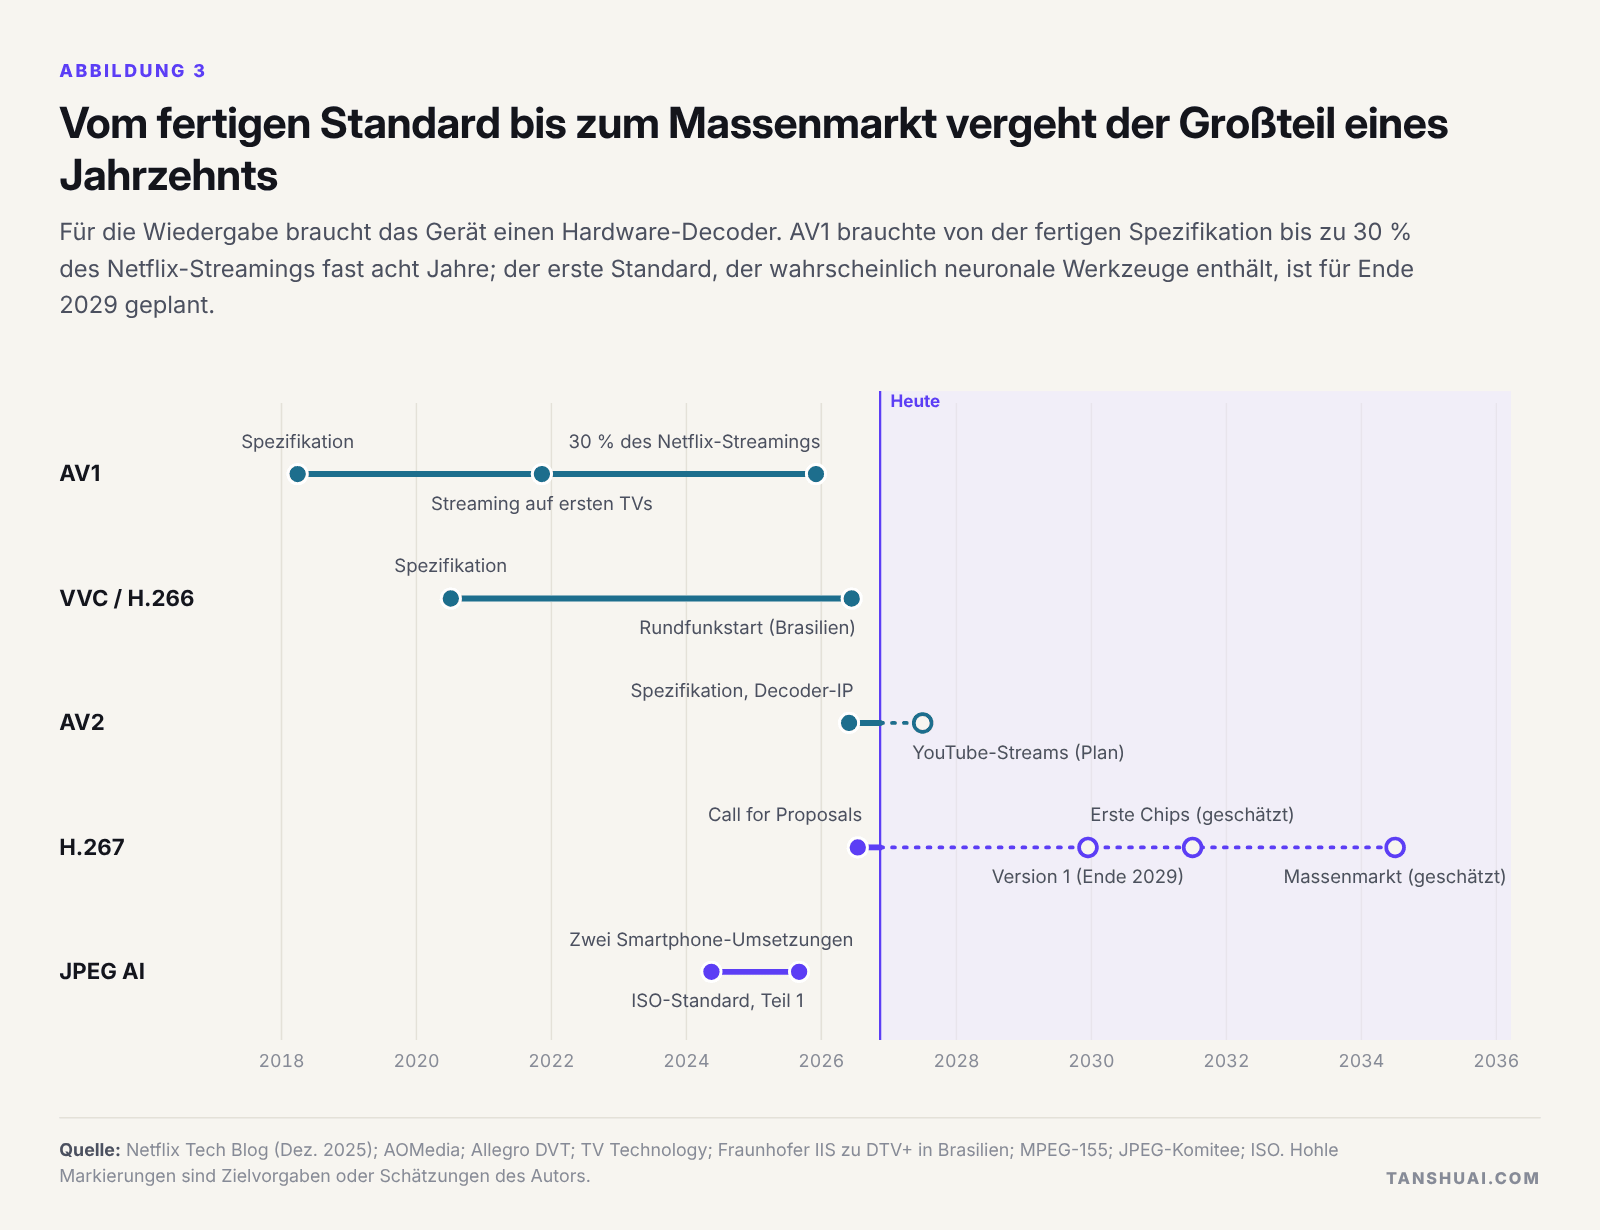 Abbildung 3. Vom fertigen Standard bis zum Massenmarkt vergeht der Großteil eines Jahrzehnts.
Der Standard, der neuronale Werkzeuge auf jeden Bildschirm bringen könnte, ist H.267, der Arbeitsname für den Nachfolger von VVC. JVET hat seinen Call for Proposals im Juli 2026 veröffentlicht; die Einreichungen werden im Januar 2027 ausgewertet, und die erste Version ist für Ende 2029 geplant. Der klassische Zweig spart bereits etwa 28 % gegenüber VVC, während die neuronalen In-Loop-Filter von JVET 6–14 % sparen, bei einem Decodieraufwand ab 10 Tausend MACs pro Pixel. Ich erwarte einen klassischen Kern mit einigen neuronalen Werkzeugen dort, wo die eingesparten Bits die Kosten rechtfertigen.
Fotografie: neuronal in der Kamera, klassisch im Web
Jedes Foto eines aktuellen Flaggschiff-Smartphones hat neuronale Netze durchlaufen, bevor es gespeichert wird. Qualcomms Cognitive ISP führt seit 2023 eine semantische Segmentierung in Echtzeit durch, und auf der CES 2026 zeigten Chips&Media und Visionary.ai einen vollständigen ISP, der komplett auf einer NPU läuft. Danach wird das Ergebnis als JPEG oder HEIF gespeichert.
JPEG AI, der erste Standard für gelernte Bildcodierung, erschien 2025, mit Gewinnen von 12,5–27,9 % gegenüber der Intra-Codierung von VVC bei einem Decodieraufwand von 7 bis 216 Tausend MACs pro Pixel. Ich habe keine Kamera, keine Galerie-App und keinen Browser gefunden, die JPEG AI standardmäßig nutzen. Das Format, das das Web 2026 übernommen hat, ist klassisch: Chrome 155 hat JPEG XL am 6. Oktober aktiviert, mit einem schnellen, speichersicheren Decoder, der auf jeder CPU läuft. Neuronale Codierung gewinnt innerhalb der Pipeline eines Unternehmens; Formate, die sich überall öffnen lassen müssen, bleiben klassisch.
Telefonie: wo neuronale End-to-End-Codecs im Einsatz sind
Anrufe sind ein geschlossenes System: Beide Enden nutzen dieselbe App und können mitten im Gespräch auf einen Standard-Codec ausweichen. Deshalb laufen dort die ersten neuronalen End-to-End-Codecs in großem Maßstab. Microsofts KI-Sprachcodec Satin läuft seit 2021 in allen Zweiergesprächen in Teams und Skype. Im Juli 2026 hat Microsoft MLVC als Open Source veröffentlicht, einen neuronalen Videocodec, der derzeit in Peer-to-Peer-Anrufen in Teams eingeführt wird.
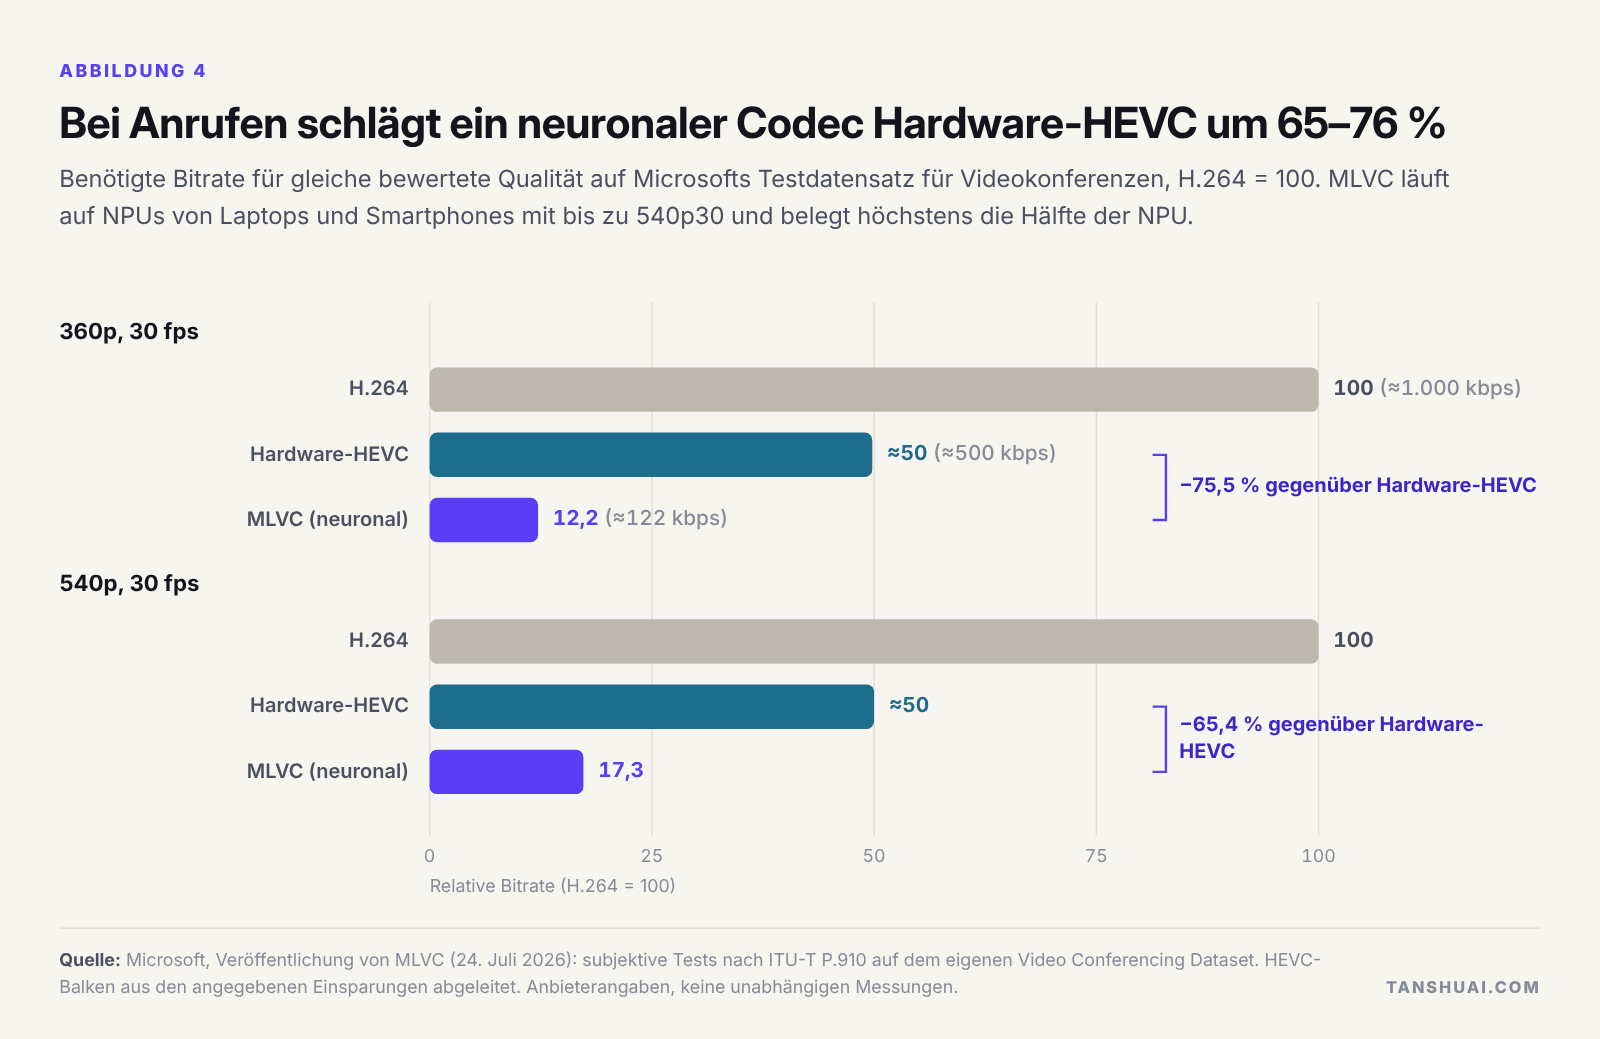 Abbildung 4. Bei Anrufen schlägt ein neuronaler Codec Hardware-HEVC um 65–76 %, auf Microsofts eigenem Testdatensatz.
Die Schlagzeilenzahl von 88 % bezieht sich auf H.264; gegenüber dem Hardware-HEVC, das in denselben Laptops bereits steckt, sind es 65–76 %, immer noch viel. MLVC läuft mit 540p und 360p und belegt dabei höchstens die Hälfte der NPU, und der Codec hat etwas Kompression geopfert, um auf fremder Hardware identisch zu decodieren.
Nicht alle haben diesen Weg gewählt. Opus hat 2024 Deep Learning als optionale, abwärtskompatible Ergänzungen aufgenommen. Meta hat mit MLow einen klassischen Sprachcodec gebaut, weil mehr als 20 % seiner Anrufe auf alten ARMv7-Smartphones laufen und täglich Dutzende Millionen WhatsApp-Anrufe auf Smartphones, die über zehn Jahre alt sind. Neuronale Codecs kommen zuerst dort zum Einsatz, wo die Geräte neu sind und ein Anbieter beide Enden kontrolliert.
Generative KI: der größte Einsatz, den niemand Codec nennt
Jedes Voice- und Videomodell läuft auf einem gelernten Codec. Voice-Modelle lesen und schreiben die Tokens neuronaler Audiocodecs wie Mimi von Kyutai, mit 12,5 Frames pro Sekunde und 1,1 kbps. Videogeneratoren arbeiten im Latentraum von Video-Autoencodern wie dem von LTX-Video, der im Verhältnis 1:192 komprimiert. Keiner davon ist ein Format, das jemand anderes decodiert, aber sie beweisen, dass gelernte Kompression in großem Maßstab funktioniert, wenn einem Unternehmen Encoder, Decoder und Hardware gehören. Für jeden, der generatives Video anbietet, ist die Effizienz des Tokenizers ein direkter Kostenposten.
Spiele: neuronale Rekonstruktion ist etabliert, neuronale Assets stehen am Anfang
NVIDIAs DLSS rendert weniger Pixel und Frames und lässt ein Netz den Rest rekonstruieren. Neuronale Texturkompression wurde mit Assassin's Creed Mirage ausgeliefert, wegen ihrer Laufzeitkosten aber nur für ausgewählte Assets.
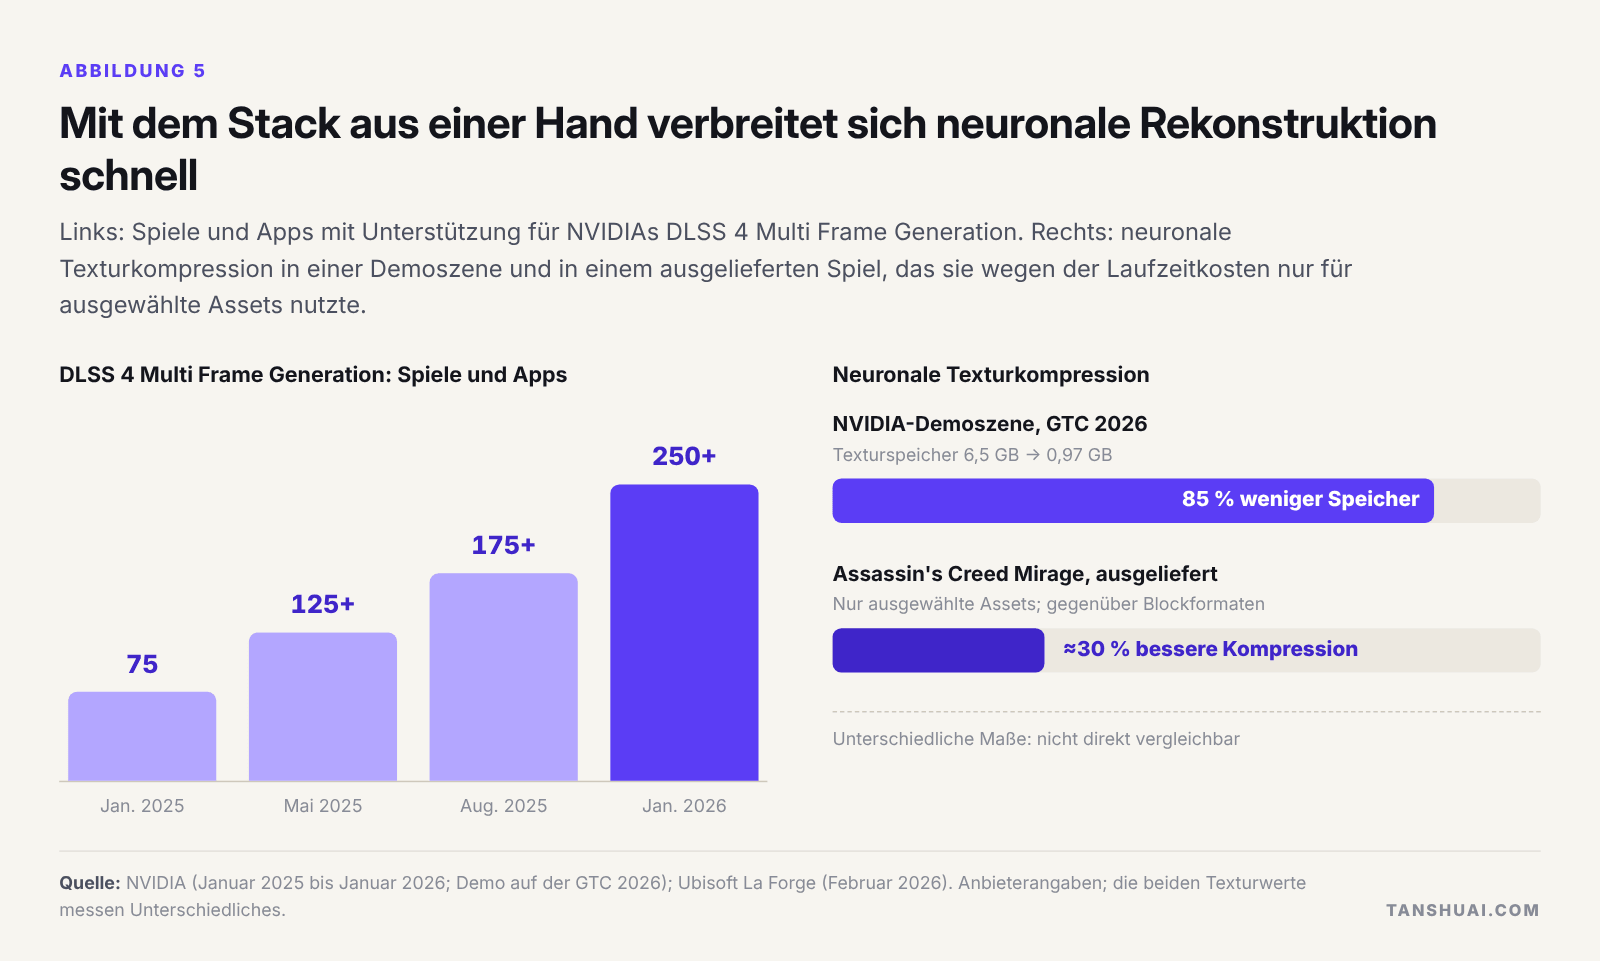 Abbildung 5. Mit dem Stack aus einer Hand verbreitet sich neuronale Rekonstruktion schnell.
Satelliten-, Drohnen- und Roboterverbindungen passen technisch am besten zu neuronalen End-to-End-Codecs, sind aber ein kleiner Markt und auf beiden Seiten zunehmend Exportkontrollen unterworfen: Chinas Exportregeln für Drohnen ab dem 18. November 2026 nennen sogar semantische Bildkompression als Schwellenwert.
Der Blick aufs Silizium
Hier zählt mein eigener Hintergrund am meisten. Ein Chipteam stellt jedem neuen Codec vier Fragen: Joule pro Pixel, DRAM-Verkehr pro Pixel, Gatter und ob jeder Decoder der Welt exakt dieselben Bits berechnet. Bei allen vier steht ein neuronaler Decoder 2026 dort, wo Hardware-HEVC vor seinen ersten Chips stand.
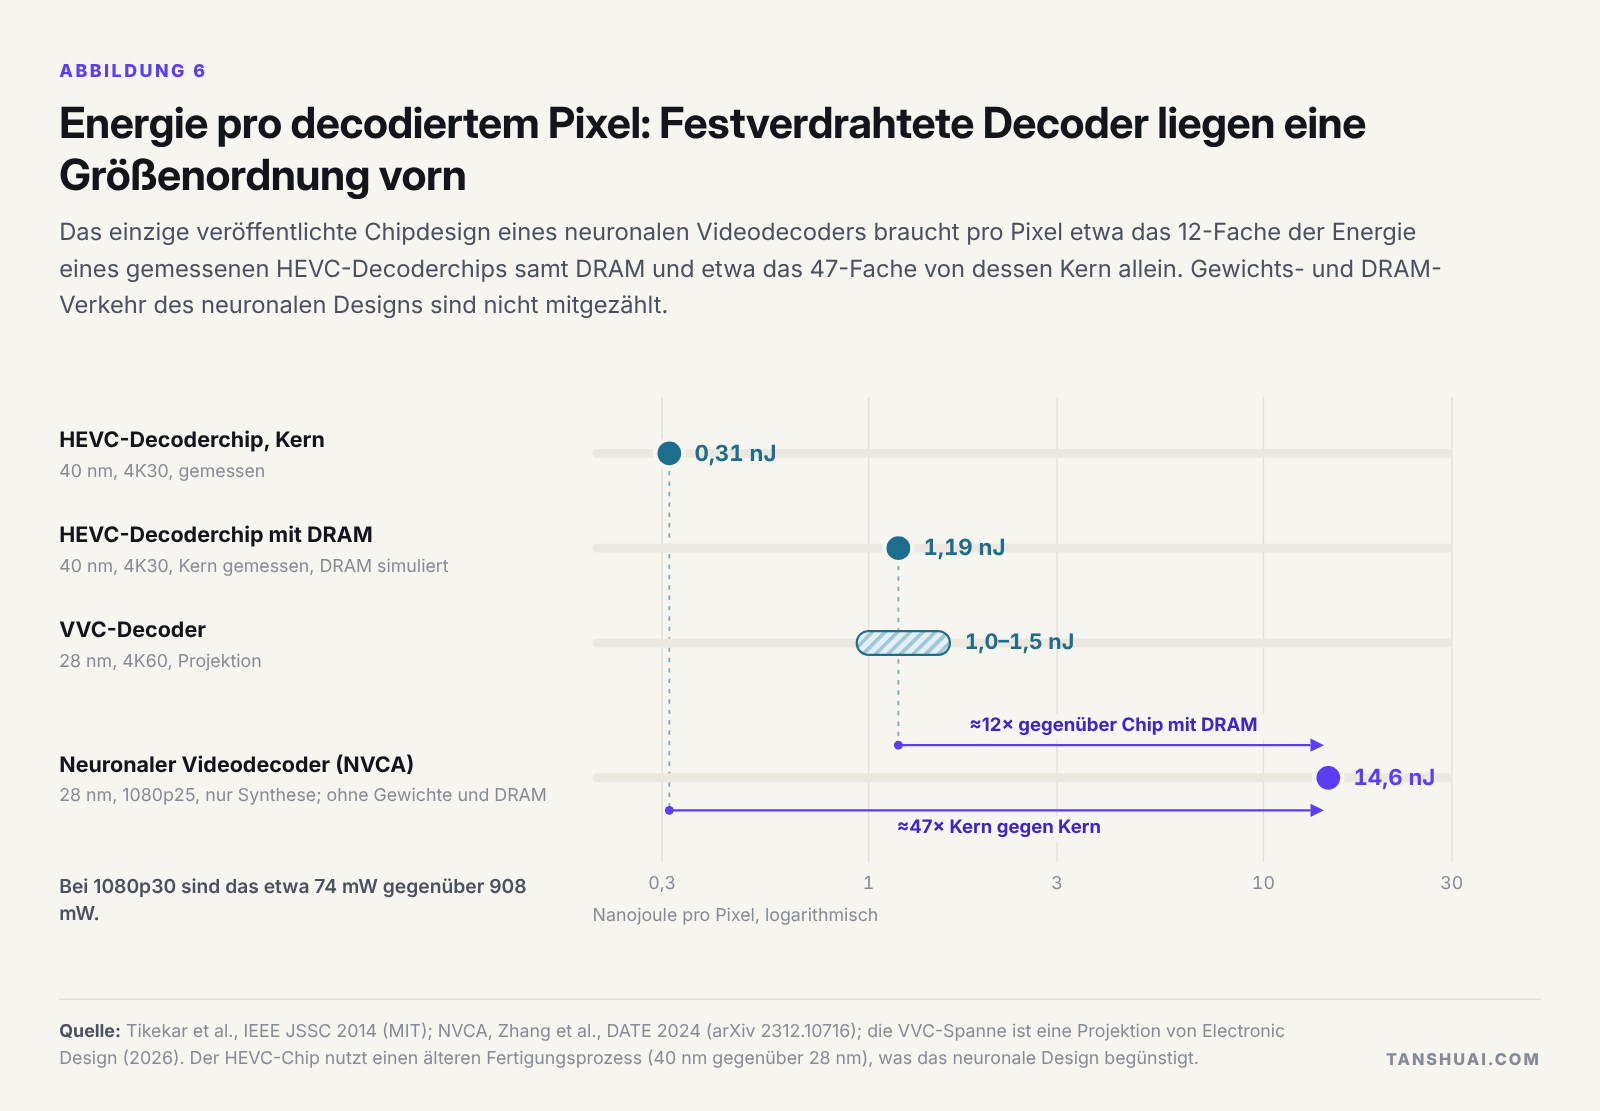 Abbildung 6. Energie pro decodiertem Pixel: Festverdrahtete Decoder liegen eine Größenordnung vorn.
Das einzige veröffentlichte Chipdesign eines neuronalen Videodecoders, NVCA, braucht 14,6 nJ pro Pixel; der HEVC-Decoderchip des MIT braucht 1,19 mit DRAM und 0,31 für den Kern. Bei 1080p30 sind das rund 900 mW gegenüber 74 mW. Microsofts schneller Forschungscodec DCVC-RT braucht nach meiner Summierung seiner eigenen Modultabelle etwa 175 Tausend MACs pro decodiertem Pixel, also etwa 22 TOPS bei 1080p30: die Hälfte der 40 TOPS, die einen KI-PC definieren, für einen einzigen Stream.
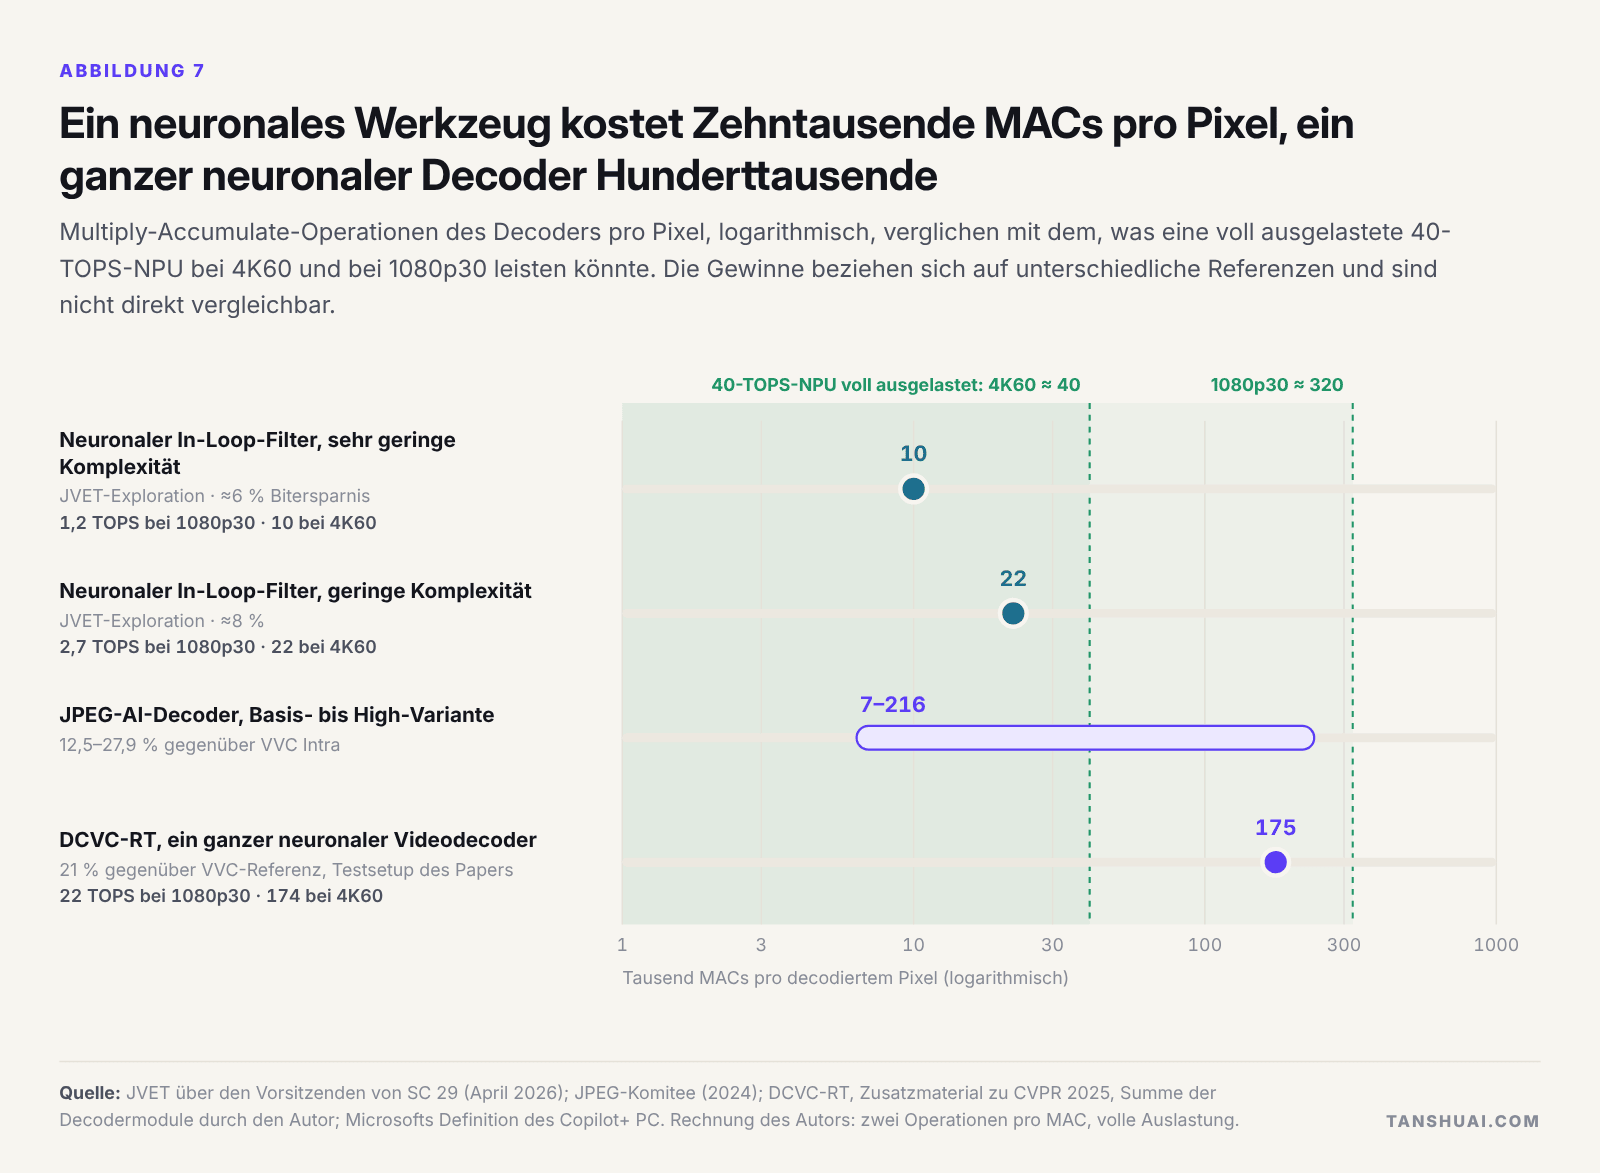 Abbildung 7. Ein neuronales Werkzeug kostet Zehntausende MACs pro Pixel, ein ganzer neuronaler Decoder Hunderttausende.
Zwei weitere Kostenfaktoren zählen. Speicher: Im MIT-Chip gehen etwa drei Viertel der Systemenergie an den DRAM, und neuronale Decoder tragen große Feature-Maps von Frame zu Frame mit. Exaktheit: Die Entropiedecodierung scheitert, wenn zwei Geräte eine Wahrscheinlichkeit unterschiedlich berechnen; deshalb nutzt heute jeder ernsthafte neuronale Codec Ganzzahlarithmetik, und deshalb tauscht MLVC Kompression gegen identische Decodierung.
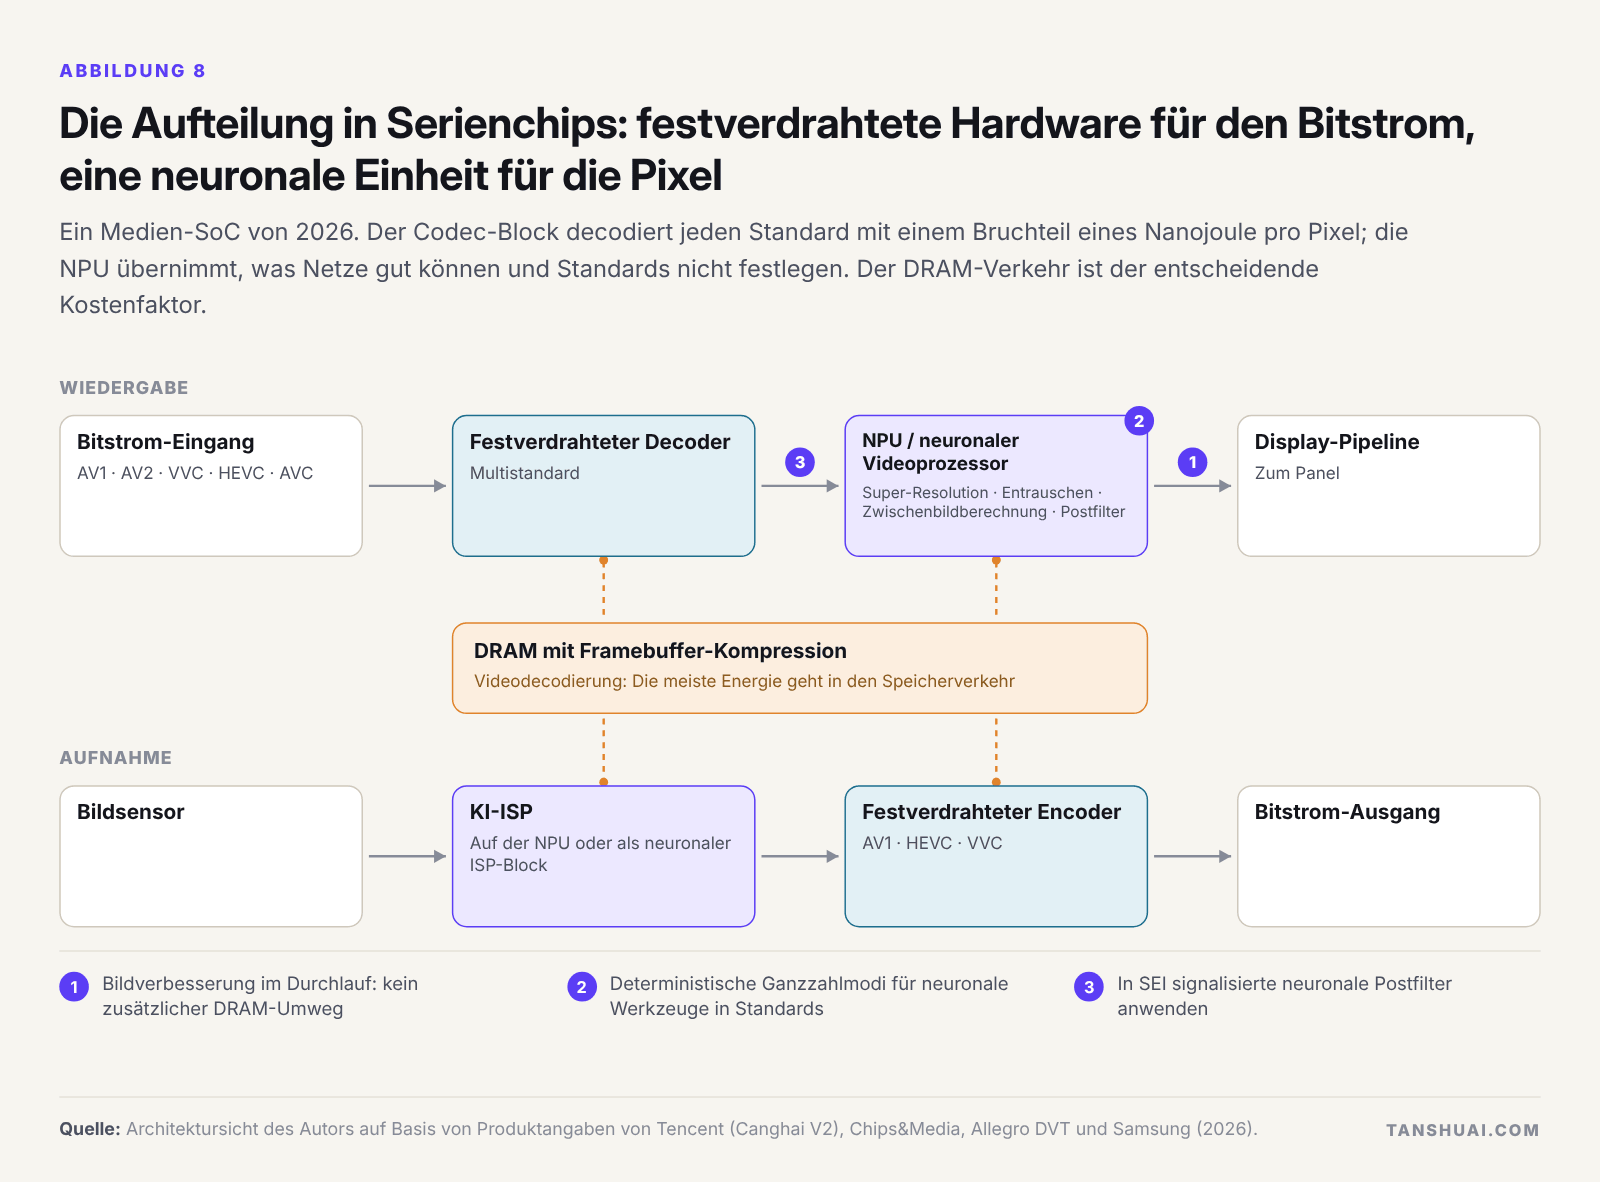 Abbildung 8. Die Aufteilung in Serienchips: festverdrahtete Hardware für den Bitstrom, eine neuronale Einheit für die Pixel.
Das Silizium, das sich verkauft, kombiniert beides. Tencent hat mehr als 100.000 seiner hauseigenen Canghai-Codec-Chips im Einsatz, und die zweite Generation bringt H.266 und Super-Resolution auf dem Chip; IP-Anbieter verkaufen Codec-Blöcke und Video-NPUs nebeneinander. Würde ich jetzt ein Medien-SoC planen: festverdrahtete Decoder für jeden Standard, den Sie abspielen müssen, einschließlich AV2; eine NPU, dimensioniert für Bildverbesserung in Displayauflösung, ohne zusätzlichen Umweg über den DRAM; deterministische Ganzzahlmodi; und H.267 als Designstart nach 2029.
Wer verdient, und wo ein Unternehmen ansetzen kann
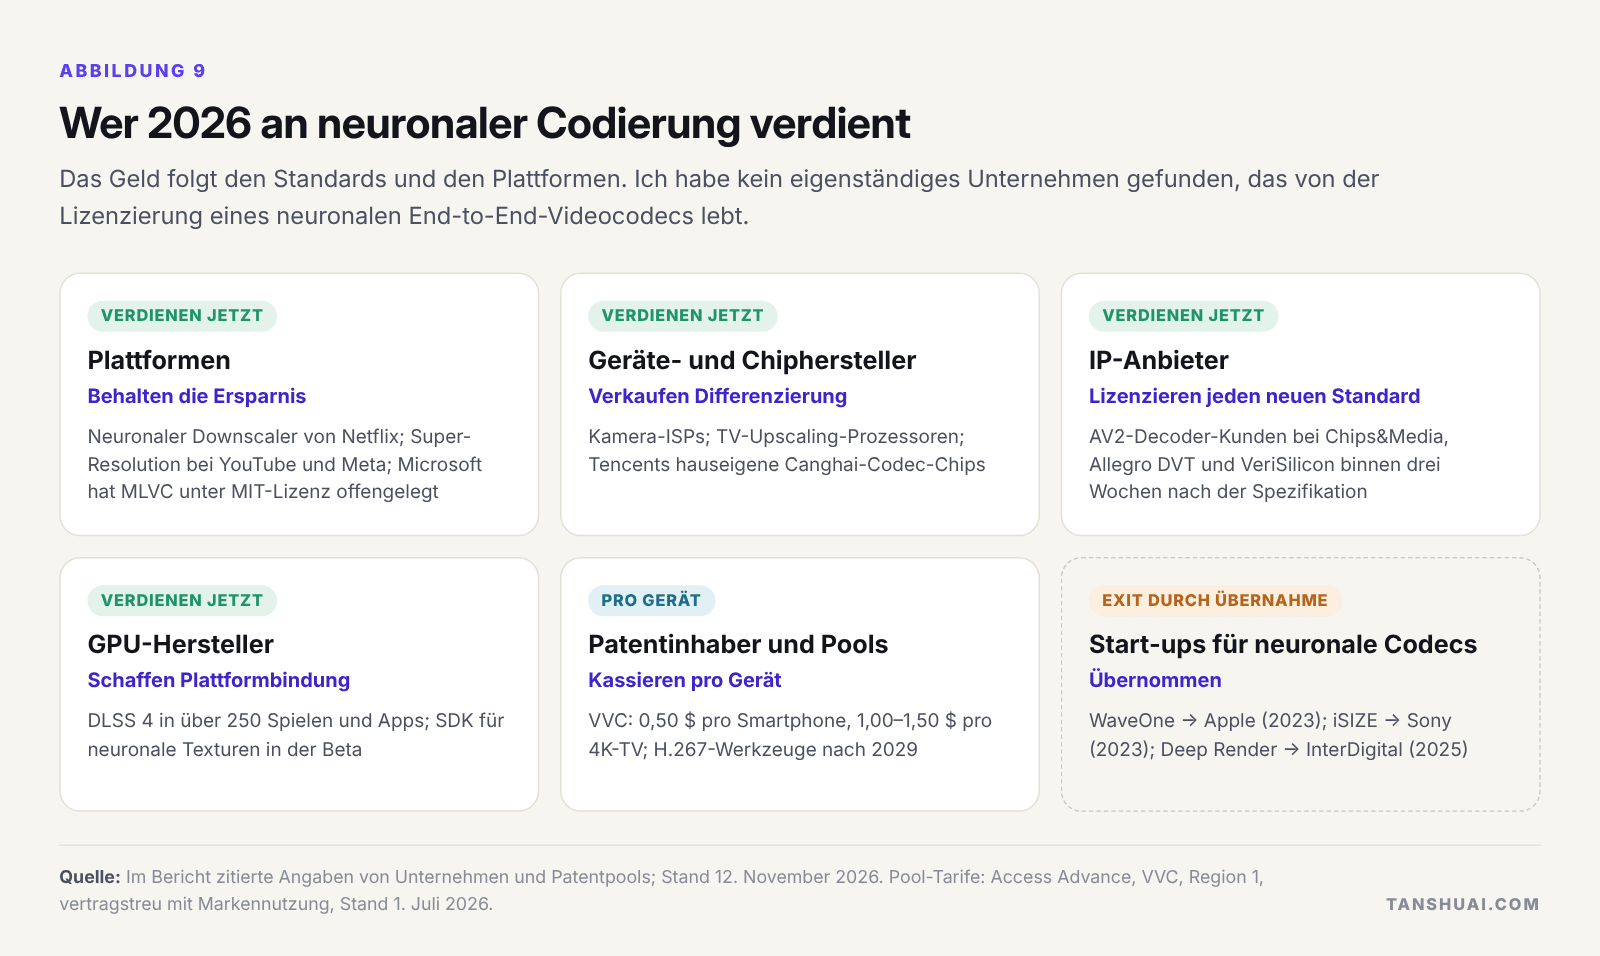 Abbildung 9. Das Geld folgt den Standards und den Plattformen.
Plattformen behalten die Einsparungen und verschenken manchmal den Code, wie Microsoft bei MLVC. IP-Anbieter lizenzieren Decoder für jeden neuen Standard. Patentpools kassieren pro Gerät: für VVC 0,50 US-Dollar pro Smartphone und 1,00–1,50 US-Dollar pro 4K-TV in den USA und anderen Märkten der Region 1. WaveOne ging an Apple, iSIZE an Sony und Deep Render an InterDigital. Ich habe kein eigenständiges Unternehmen gefunden, das von der Lizenzierung eines neuronalen End-to-End-Videocodecs lebt.
Für ein Unternehmen liegen die offenen Geschäftsfelder in neuronaler Vorverarbeitung für Videodienste, displayseitiger Bildverbesserung für Chiphersteller, neuronalen Codecs für geschlossene Systeme wie Konferenzen und private Verbindungen, Silizium aus Codec plus NPU sowie in den Werkzeugen für Evaluierung und Konformität, die jeder brauchen wird, der neuronale Werkzeuge ausliefert. Standardisierungsarbeit an H.267 braucht Geduld und eine Lizenzstrategie.
Behauptungen, die Skepsis verdienen, und worauf zu achten ist
Verlangen Sie von jeder Behauptung über neuronale Codecs vier Dinge: Referenz, Metrik, Auflösung und Decodieraufwand. „88 % Einsparung“ bezieht sich auf H.264 bei 360p; „85–96 % weniger Grafikspeicher“ ist eine Demoszene, gegenüber 30 % im ausgelieferten Spiel; hinter „JPEG AI ist ein Standard“ steht noch kein Produkt.
Die wichtigen Termine: die Auswertung von H.267 im Januar 2027, die ersten AV2-Streams von YouTube Anfang 2027, das erste Testmodell von H.267 in der zweiten Jahreshälfte 2027, ob sich MLVC über Teams hinaus verbreitet, das erste Produkt, das JPEG AI standardmäßig nutzt, und die NPU-Budgets in Smartphones und PCs. Version 1 von H.267 Ende 2029 startet den Chipzyklus für neuronale Werkzeuge in der Wiedergabe im Massenmarkt.
Vollständigen Bericht und Folien herunterladen
Der vollständige Bericht behandelt jeden Bereich ausführlicher, dazu die Silizium-Rechnung, die Standards und Patente, eine Tabelle mit Behauptungen und Belegen sowie alle Quellen.
- Neuronale Codierung 2026: vollständiger Bericht (PDF)
- Neuronale Codierung 2026: Folien (PDF)
- Englische Ausgabe: vollständiger Bericht · Folien
Dies ist eine Übersetzung der englischen Ausgabe; bei Abweichungen gilt die englische Fassung.
Offene Fragen
Einige der Fragen hier haben noch keine öffentliche Antwort, und gerade sie finde ich technisch am interessantesten: wie nah ein neuronaler Decoder an bitgenaue Ganzzahlarithmetik über die NPUs verschiedener Hersteller herankommen kann, bevor er seinen Kompressionsvorteil verliert; was neuronale Nachverarbeitung an DRAM-Verkehr pro Pixel kostet; ab welchen Kosten pro Pixel sich ein neuronales Werkzeug in einem H.267-Decoder nicht mehr lohnt; welche geschlossenen Systeme jenseits der Telefonie zuerst neuronale End-to-End-Codecs übernehmen können; und wie sich Wiedergabetreue messen lässt, wenn ein Decoder Details erzeugt, statt sie zu rekonstruieren.
Das sind Felder, die wir in den kommenden Jahren gemeinsam erkunden können, im technischen Austausch und in technischer Zusammenarbeit: i@tanshuai.com.
Über den Autor
Tan Shuai ist Technologe und Gründer mit mehr als zwanzig Jahren Arbeit an Chips, Hardware und Systemsoftware und 20 erteilten Patenten. Er hat viele Jahre Chipentwicklung und Management im Fabless-Bereich hinter sich, darunter den Full-Custom-Entwurf von ASIC-Datenpfaden und Multimedia-Kamerachip-Projekte wie Beschleuniger für Videocodecs. Seine Arbeit führte ihn ins Silicon Valley, nach New York, Chicago und Taiwan, in die Greater Bay Area (Shenzhen und Hongkong) sowie nach Vietnam und Malaysia. Heute arbeitet er als KI-Forscher und -Entwickler.
Technische Diskussion: i@tanshuai.com.