
신경망은 이미 우리가 보는 거의 모든 비디오를 다듬고 있지만, 표준 코덱을 대체하지 않고 그 양 끝에서 작동한다. 2026년 신경망 코딩이 어디에 상용화되어 있는지, 실리콘에서 비용이 얼마나 드는지, 누가 돈을 버는지 정리했다. 전체 보고서와 슬라이드도 함께 싣는다.
요약
2026년 신경망 코딩은 이미 주류가 되었지만, 표준 코덱을 대체하기보다 그 주변에서 작동한다. 신경망은 인코딩 전에는 휴대폰 카메라와 넷플릭스의 인코딩 파이프라인에서 영상을 다듬고, 디코딩 후에는 유튜브의 Super Resolution, 메타, TV 프로세서에서 영상을 복원한다. 그 사이의 비트스트림은 여전히 AV1, HEVC, AVC, VVC이며, 고정 기능 하드웨어가 디코딩한다. 엔드투엔드 신경망 코덱은 한 회사가 양 끝을 통제하는 폐쇄 루프에서만 상용화된다. Teams 통화의 마이크로소프트 MLVC, 모든 음성·비디오 모델 안의 토크나이저, 게임 한 편의 신경망 텍스처가 그렇다. 신경망 비트스트림의 대중적 재생은 2029년 말로 예정된 H.267과 그 뒤의 실리콘 사이클을 기다려야 한다. 이유는 칩에 있다. 유일하게 공개된 신경망 비디오 디코더 설계는 실측한 HEVC 디코더의 약 12배에 이르는 픽셀당 에너지가 필요하고, 빠른 연구용 코덱은 1080p30에 약 22 TOPS가 필요하다. 돈은 표준과 플랫폼을 따라가며, 가장 잘 알려진 신경망 코덱 스타트업들은 인수됐다.
왜 이 주제를 살펴봤나
몇 달에 한 번씩 누군가 필자에게 AI 코덱이 곧 H.264, HEVC, AV1을 대체할 것이라고 말한다. 이에 관해 읽게 되는 글은 대부분 압축 기록이 나오는 연구 논문이거나 업체 자료다. 어느 쪽도 실제로 무엇이, 누구에게, 얼마의 비용으로 상용화되는지는 거의 말해 주지 않는다.
필자는 풀 커스텀 ASIC 데이터패스 설계, 비디오 코덱 가속기 같은 멀티미디어 카메라 칩 프로젝트를 포함해 팹리스 칩 연구개발과 관리를 오랫동안 해 왔다. 그래서 칩을 검토하듯 이 문제를 살펴봤다. 픽셀당 에너지, 메모리 트래픽, 표준이 실리콘에 무엇을 고정할 수 있게 해 주는지, 그리고 누가 돈을 내는지다. JVET, MPEG, JPEG, AOMedia, IETF의 표준 문서와 회의 보고서, 기업의 엔지니어링 블로그, 칩 논문, 특허 풀 요율표, 수출 통제 문서, 언론 보도를 읽었다. 아래의 모든 수치는 2026년 11월 12일 기준이며, 금액은 미국 달러 기준이다. 모든 출처를 담은 전체 보고서는 글 끝에 있다.
한눈에 보는 결과
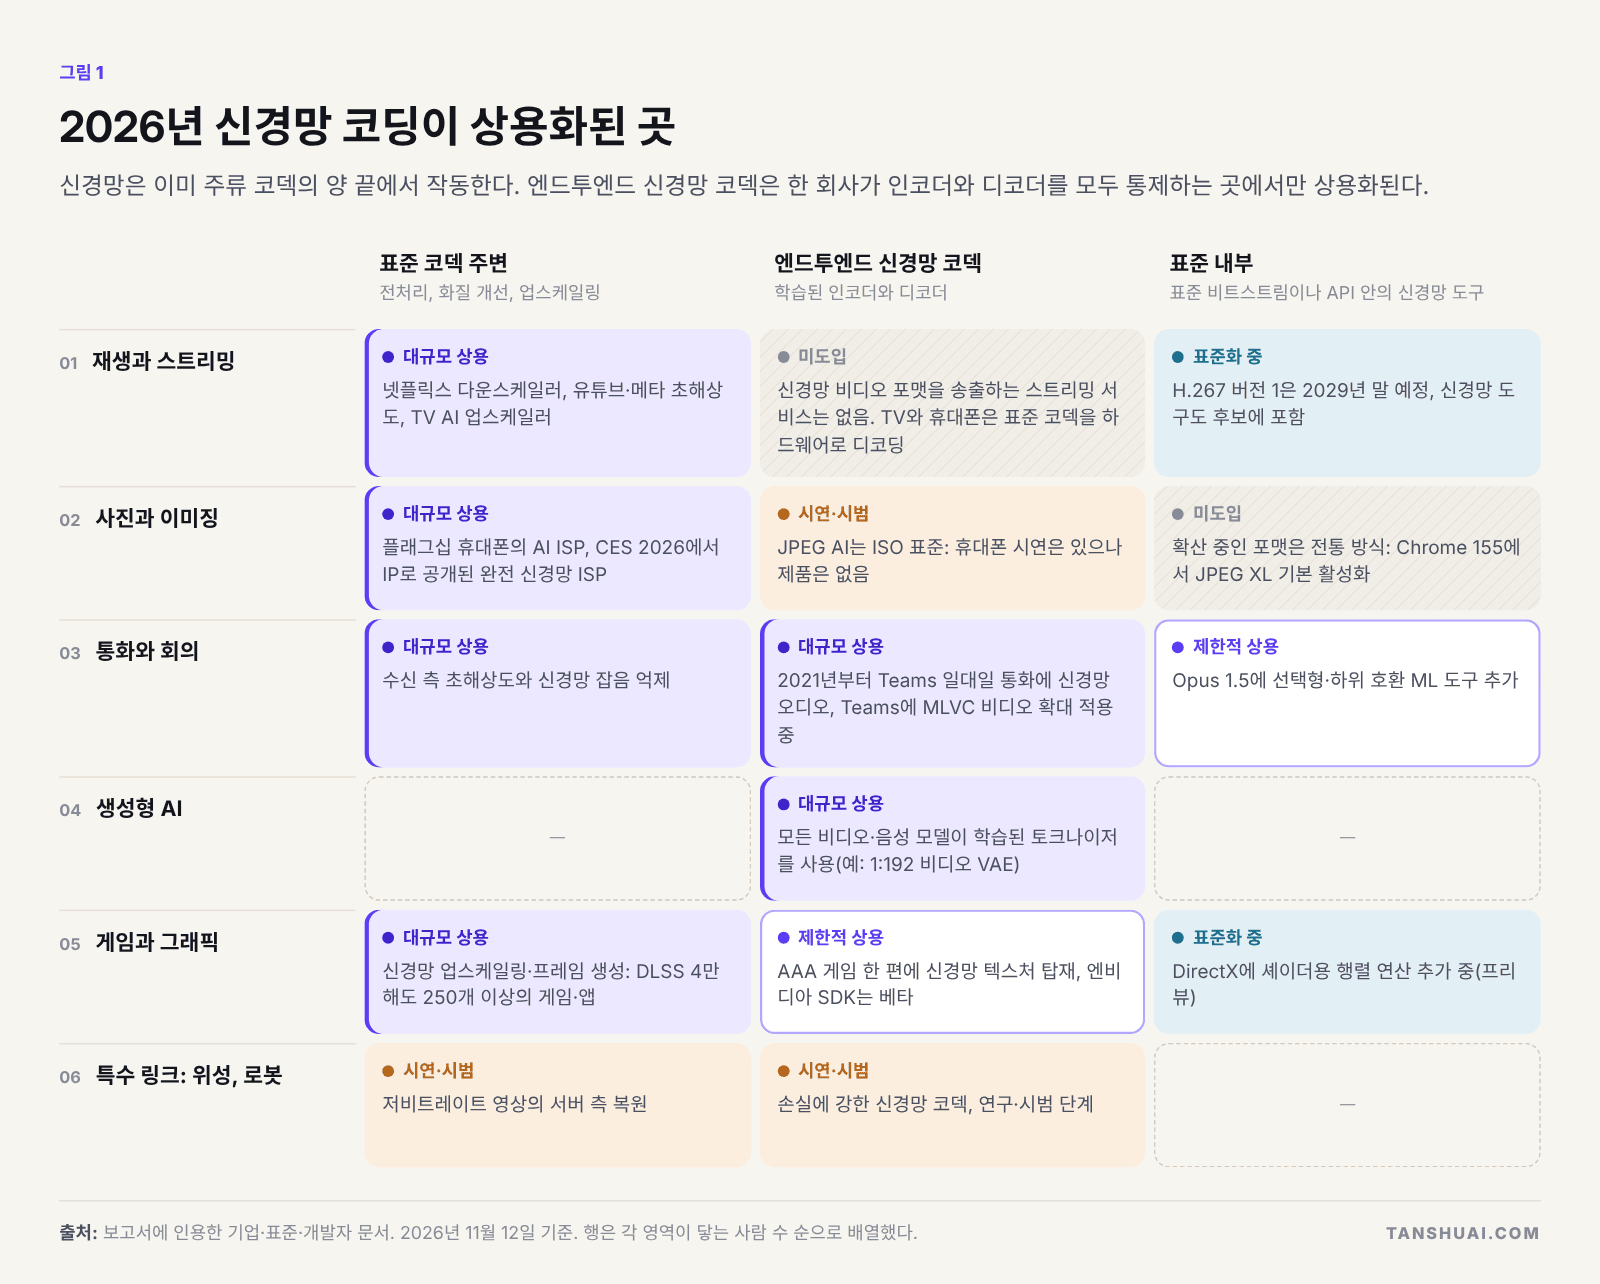 그림 1. 2026년 신경망 코딩이 상용화된 곳. 행은 각 영역이 닿는 사람 수 순으로 배열했다.
| 질문 | 짧은 답 |
|---|---|
| 신경망 코딩은 어디서 대규모로 상용화되었는가? | 코덱 주변: 카메라 ISP, 인코딩 측 다운스케일링, 재생 시 초해상도. 엔드투엔드는 폐쇄 루프에서만: 통화, 게임 에셋, 생성형 AI 토크나이저 |
| 재생에서 신경망 코덱이 AV1, HEVC, VVC를 대체할 것인가? | H.267(2029년 말 버전 1)과 그 뒤의 기기 교체 주기 이전에는 아니다. 필자 추정으로는 2030년대 중반에 대중화된다 |
| 실리콘 비용은 얼마인가? | 하드웨어 HEVC 디코더의 약 12배에 이르는 픽셀당 에너지, 여기에 메모리 트래픽과 비트 단위로 일치하는 디코딩이라는 요건이 더해진다 |
| 누가 돈을 버는가? | 플랫폼은 절감분을 가져가고, IP 업체와 특허 풀은 설계당·기기당 대가를 받으며, 신경망 코덱 스타트업은 인수됐다 |
| 기업은 어디서 기회를 찾을 수 있는가? | 신경망 전처리·후처리, 폐쇄 루프 제품, 코덱과 NPU를 결합한 실리콘, 그리고 그 사이의 평가·표준화 작업 |
세 가지 진입 방식
‘신경망 코딩’은 서로 다른 세 가지를 가리키며, 이를 둘러싼 논쟁 대부분은 이 셋을 뒤섞는 데서 생긴다. 신경망은 표준 코덱의 주변에서 작동할 수 있다. 비트스트림은 표준 그대로 두고 인코딩 전이나 디코딩 후에 픽셀을 처리하는 방식이다. 표준 내부에 들어갈 수도 있다. 모든 디코더가 실행해야 하는 도구가 되는 것이므로 정확하게 규정되어야 한다. 아니면 엔드투엔드로 코덱을 대체할 수도 있다. 학습된 인코더와 디코더가 한 쌍으로만 작동하는 방식이다.
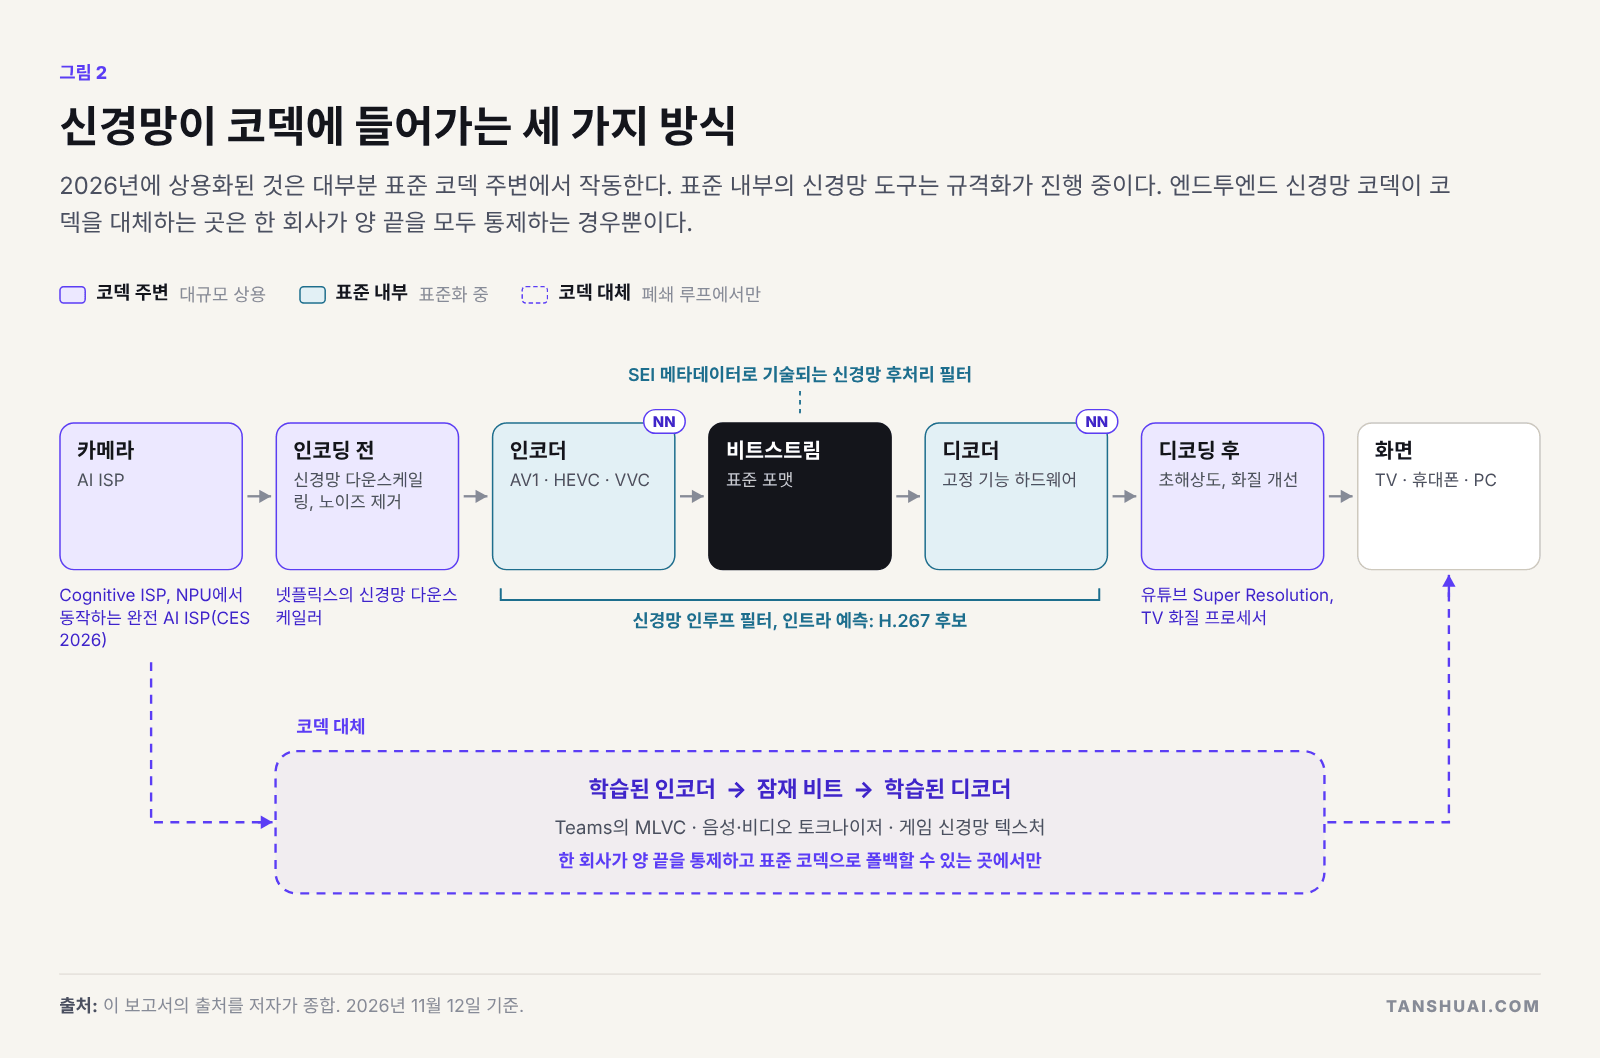 그림 2. 신경망이 코덱에 들어가는 세 가지 방식. 2026년에 상용화된 것은 대부분 첫 번째 방식이다.
첫 번째 방식은 누구의 허락도 필요 없다. 두 번째는 표준이 필요하다. 세 번째는 양 끝을 모두 통제해야 한다. 사람들에게 닿는 순서도 바로 이 순서다.
재생과 스트리밍: 양 끝은 신경망, 가운데는 표준
대형 서비스들은 코덱 전환을 한 차례 마치고 다음 전환을 시작하고 있으며, 어느 쪽에도 신경망 디코더는 없다. 넷플릭스는 2025년 12월 AV1이 자사 시청량의 약 30%를 차지한다고 발표했다. 유튜브는 시청 시간 가중 기준으로 카탈로그의 90% 이상을 AV1 형식으로 제공한다고 밝혔다. AV2는 2026년 5월 28일 AV1보다 압축 효율이 약 30% 높은 코덱으로 완성되었고, 3주 만에 칩스앤미디어, Allegro DVT, 베리실리콘이 AV2 디코더 고객을 발표했다. 브라질의 TV 3.0은 2026년 6월 VVC 상업 방송을 시작했다.
신경망은 양 끝에 있다. 넷플릭스는 2022년부터 마스터 영상을 다운스케일링할 때 기존 필터 대신 작은 신경망을 써 왔다. 이 방식은 어떤 기기도 바꿀 필요가 없고, 넷플릭스 시험에서 시청자의 약 77%가 선호했다. 유튜브는 1080p 미만으로 업로드된 동영상을 TV에서 머신러닝으로 업스케일링하고, 메타는 서버와 휴대폰에서 초해상도를 돌리며, 삼성전자의 플래그십 TV 프로세서는 업스케일링 신경망 768개를 내세운다.
없는 것은 대중 기기에서 재생되는 신경망 비트스트림이며, 이유는 시간이다. 재생 포맷은 그것을 재생할 모든 기기에서 디코딩되어야 한다. AV1은 규격 완성에서 넷플릭스 시청의 30%에 이르기까지 8년 가까이 걸렸다.
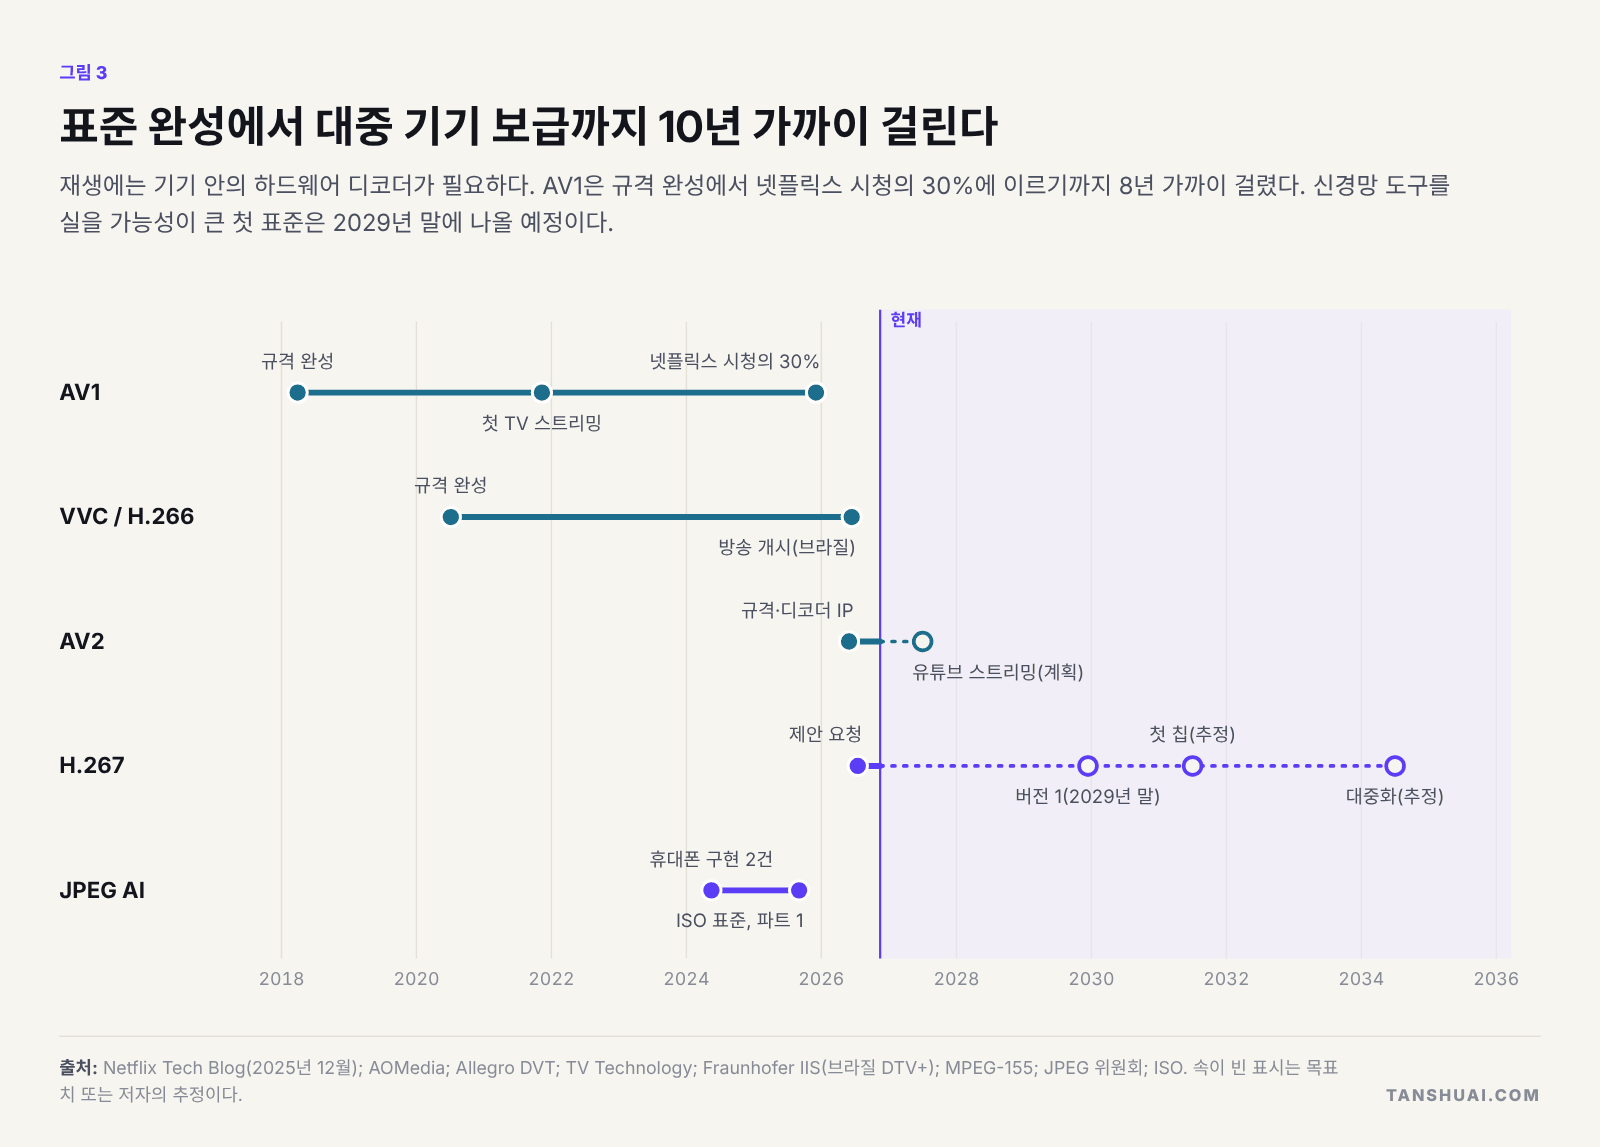 그림 3. 표준 완성에서 대중 기기 보급까지 10년 가까이 걸린다.
신경망 도구를 모든 화면에 실어 나를 수 있는 표준은 VVC 후속 표준의 가칭인 H.267이다. JVET은 2026년 7월 제안 요청을 발표했고, 2027년 1월 응답을 평가하며, 첫 버전은 2029년 말에 나올 예정이다. 전통 방식 트랙은 이미 VVC 대비 약 28%를 절감하는 반면, JVET의 신경망 인루프 필터는 픽셀당 1만 MAC 이상의 디코더 비용으로 6–14%를 절감한다. 필자는 H.267이 절감되는 비트가 비용을 정당화하는 곳에만 신경망 도구 몇 개를 넣은 전통 방식 코어가 될 것으로 본다.
사진: 카메라 안은 신경망, 웹은 전통 방식
최근 플래그십 휴대폰으로 찍은 사진은 모두 저장되기 전에 신경망을 거친다. 퀄컴의 Cognitive ISP는 2023년부터 실시간 시맨틱 세그멘테이션을 수행해 왔고, CES 2026에서 칩스앤미디어와 Visionary.ai는 전체가 NPU에서만 동작하는 완전한 ISP를 선보였다. 그런 다음 결과물은 JPEG이나 HEIF로 저장된다.
최초의 학습 기반 이미지 표준인 JPEG AI는 2025년에 발행되었고, 픽셀당 7천에서 21만 6천 MAC의 디코더 비용으로 VVC 인트라 코딩 대비 12.5–27.9%의 이득을 낸다. 이를 기본으로 사용하는 카메라, 갤러리 앱, 브라우저는 찾지 못했다. 2026년 웹이 채택한 포맷은 전통 방식이다. Chrome 155는 10월 6일, 어떤 CPU에서도 돌아가는 빠르고 메모리 안전한 디코더와 함께 JPEG XL을 활성화했다. 신경망 코딩은 한 회사의 파이프라인 안에서 이기고, 어디서나 열려야 하는 포맷은 전통 방식으로 남는다.
통화: 엔드투엔드 신경망 코덱이 상용화된 곳
통화는 폐쇄 루프다. 양 끝이 같은 앱을 실행하고, 통화 도중에 표준 코덱으로 폴백할 수 있다. 대규모로 상용화된 첫 엔드투엔드 신경망 코덱이 통화에 있는 이유다. 마이크로소프트의 AI 음성 코덱 Satin은 2021년부터 Teams와 Skype의 모든 일대일 통화에 쓰여 왔다. 2026년 7월 마이크로소프트는 현재 Teams P2P 통화에 확대 적용 중인 신경망 비디오 코덱 MLVC를 오픈소스로 공개했다.
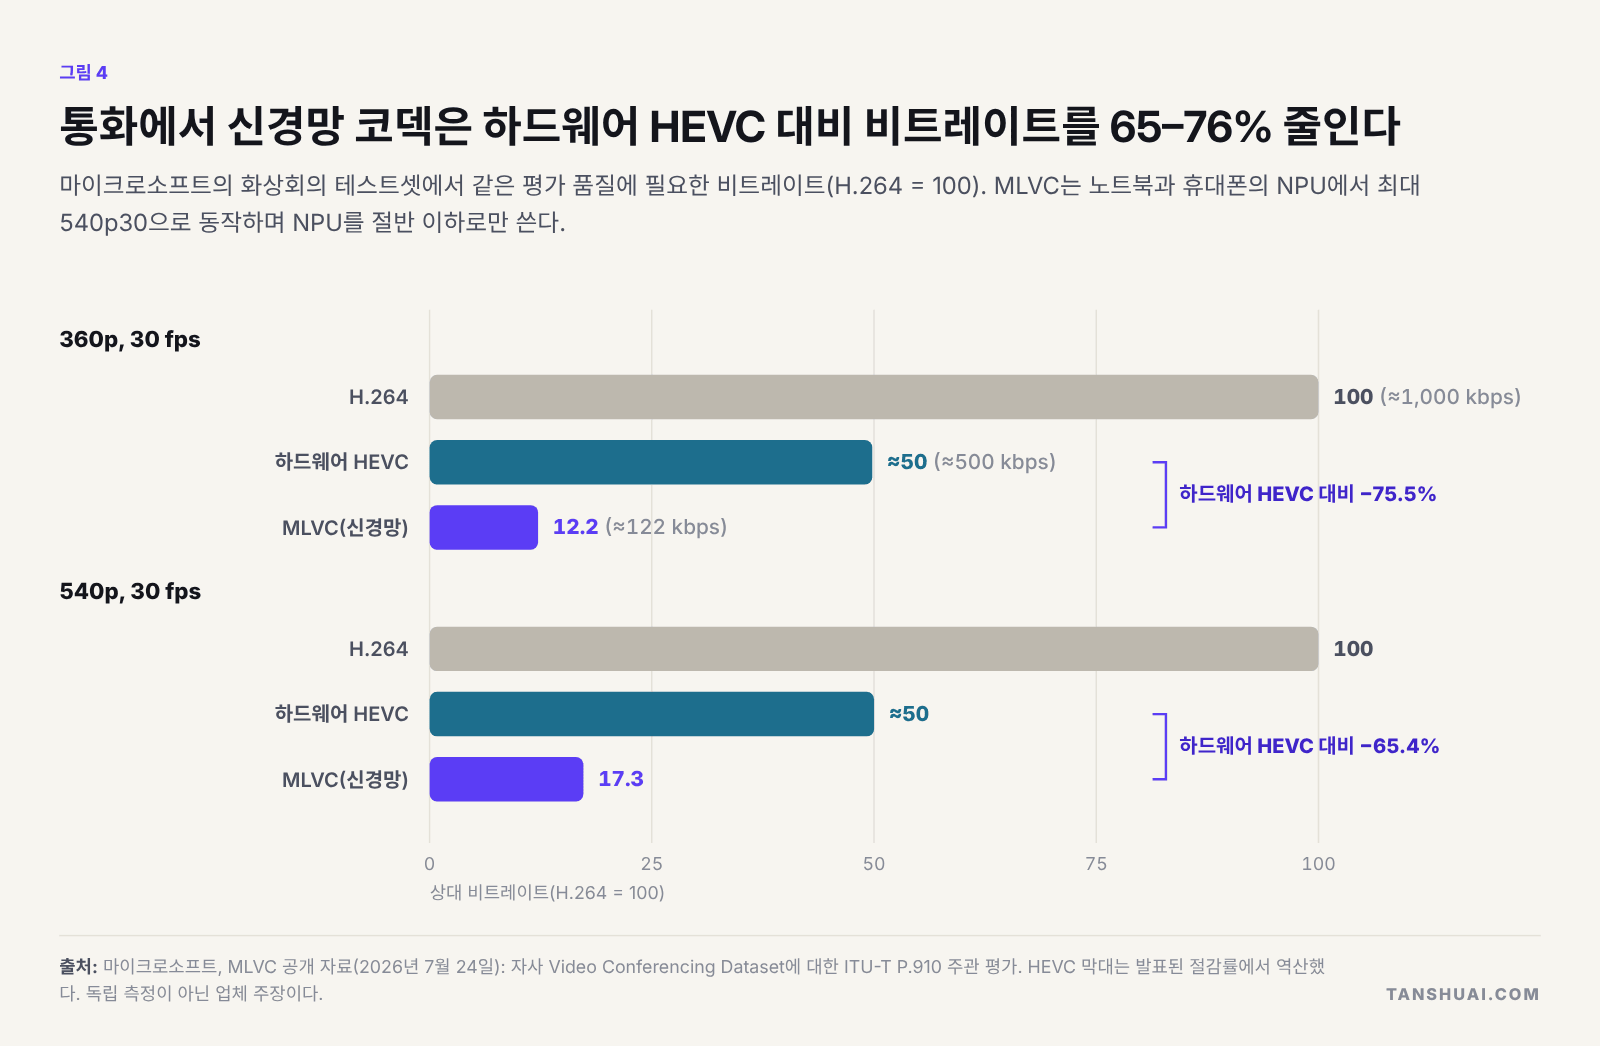 그림 4. 통화에서 신경망 코덱은 하드웨어 HEVC 대비 비트레이트를 65–76% 줄인다(마이크로소프트 자체 테스트셋 기준).
헤드라인의 88%는 H.264 대비 수치다. 같은 노트북에 이미 들어 있는 하드웨어 HEVC 대비로는 65–76%로, 여전히 크다. MLVC는 NPU를 절반 이하로만 쓰면서 540p와 360p로 동작하며, 마이크로소프트가 소유하지 않은 하드웨어에서도 똑같이 디코딩되도록 압축 효율을 일부 포기했다.
모두가 이 길을 택한 것은 아니다. Opus는 2024년 딥러닝을 선택적이고 하위 호환되는 부가 기능으로 추가했다. 메타는 전통 방식 음성 코덱인 MLow를 만들었는데, 자사 통화의 20% 이상이 오래된 ARMv7 휴대폰에서 이뤄지고 하루 수천만 건의 WhatsApp 통화가 10년 넘은 휴대폰에서 이뤄지기 때문이다. 신경망 코덱은 기기가 새것이고 한 업체가 양 끝을 통제하는 곳에서 먼저 상용화된다.
생성형 AI: 아무도 코덱이라 부르지 않는 최대 규모의 배포
모든 음성·비디오 모델은 학습된 코덱 위에서 돌아간다. 음성 모델은 Kyutai의 Mimi 같은 신경망 오디오 코덱의 토큰을 초당 12.5프레임, 1.1 kbps로 읽고 쓴다. 비디오 생성기는 LTX-Video의 오토인코더처럼 비디오를 1:192로 압축하는 비디오 오토인코더의 잠재 공간에서 작동한다. 이 중 어느 것도 다른 누군가가 디코딩하는 포맷은 아니지만, 한 회사가 인코더와 디코더, 하드웨어를 모두 소유하면 학습 기반 압축이 대규모로 작동한다는 것을 증명한다. 생성형 비디오를 서비스하는 쪽에게 토크나이저 효율은 곧바로 비용 항목이다.
게임: 신경망 복원은 주류, 신경망 에셋은 시작 단계
엔비디아의 DLSS는 픽셀과 프레임을 덜 렌더링하고 나머지는 신경망이 재구성하게 한다. 신경망 텍스처 압축은 Assassin's Creed Mirage에 탑재되었는데, 런타임 비용 때문에 일부 에셋에만 쓰였다.
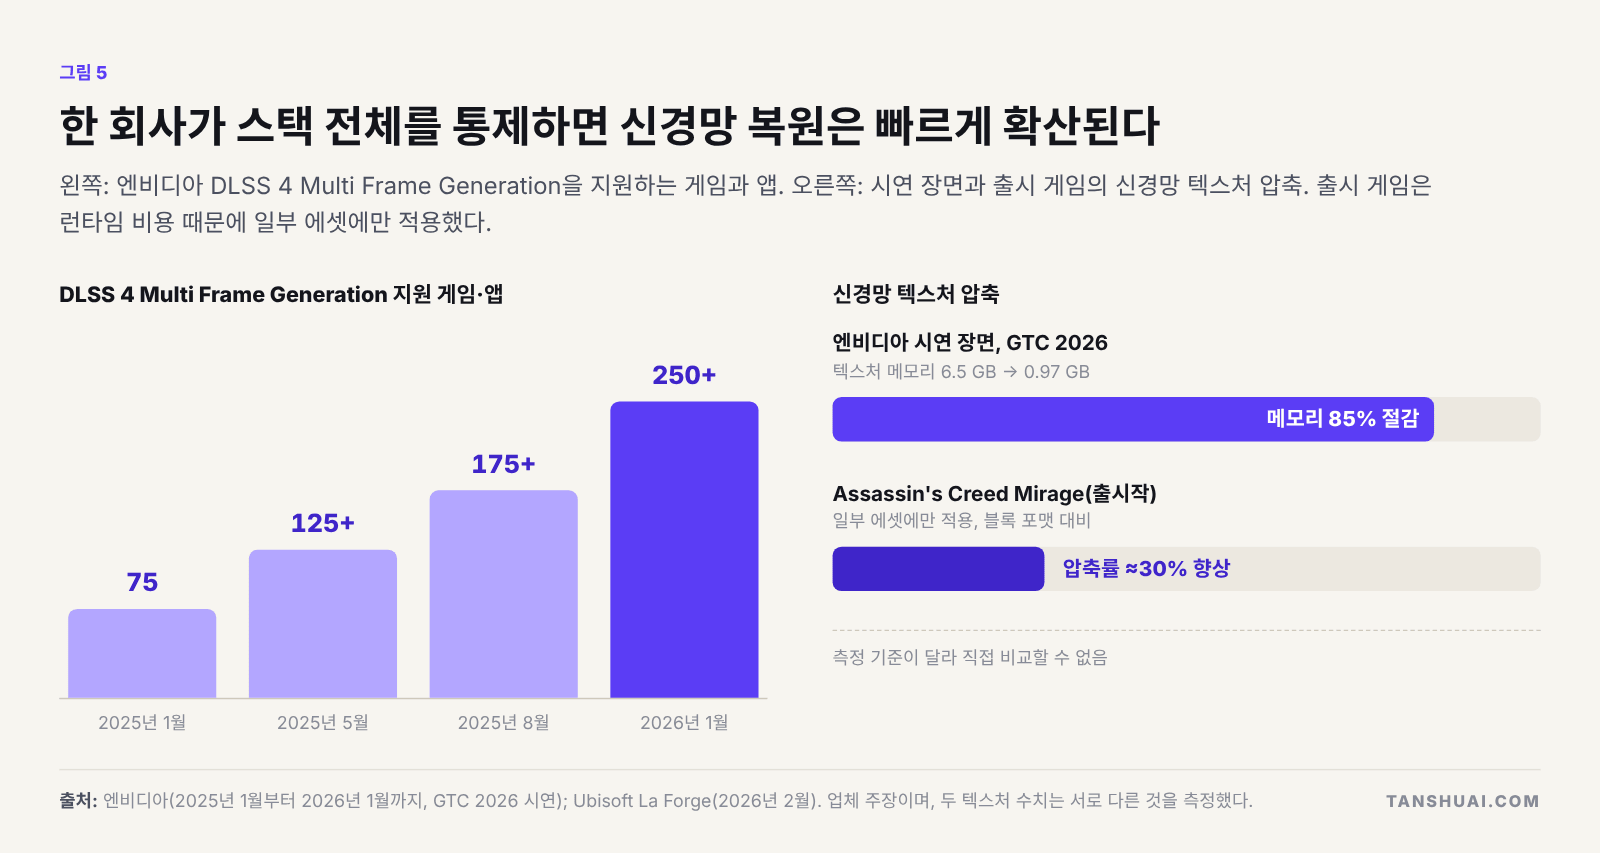 그림 5. 한 회사가 스택 전체를 통제하면 신경망 복원은 빠르게 확산된다.
위성, 드론, 로봇 링크는 기술적으로 엔드투엔드 신경망 코덱에 가장 잘 맞지만, 시장이 작고 양쪽 모두에서 수출 통제가 강화되고 있다. 2026년 11월 18일부터 시행되는 중국의 드론 수출 규정은 시맨틱 이미지 압축까지 기준치로 명시한다.
실리콘 관점
필자의 이력이 가장 중요해지는 대목이다. 칩 팀은 새 코덱에 대해 네 가지를 묻는다. 픽셀당 줄(J), 픽셀당 DRAM 트래픽, 게이트 수, 그리고 세상의 모든 디코더가 정확히 같은 비트를 계산하는지 여부다. 네 가지 모두에서 2026년의 신경망 디코더는 첫 칩이 나오기 전의 하드웨어 HEVC와 같은 위치에 있다.
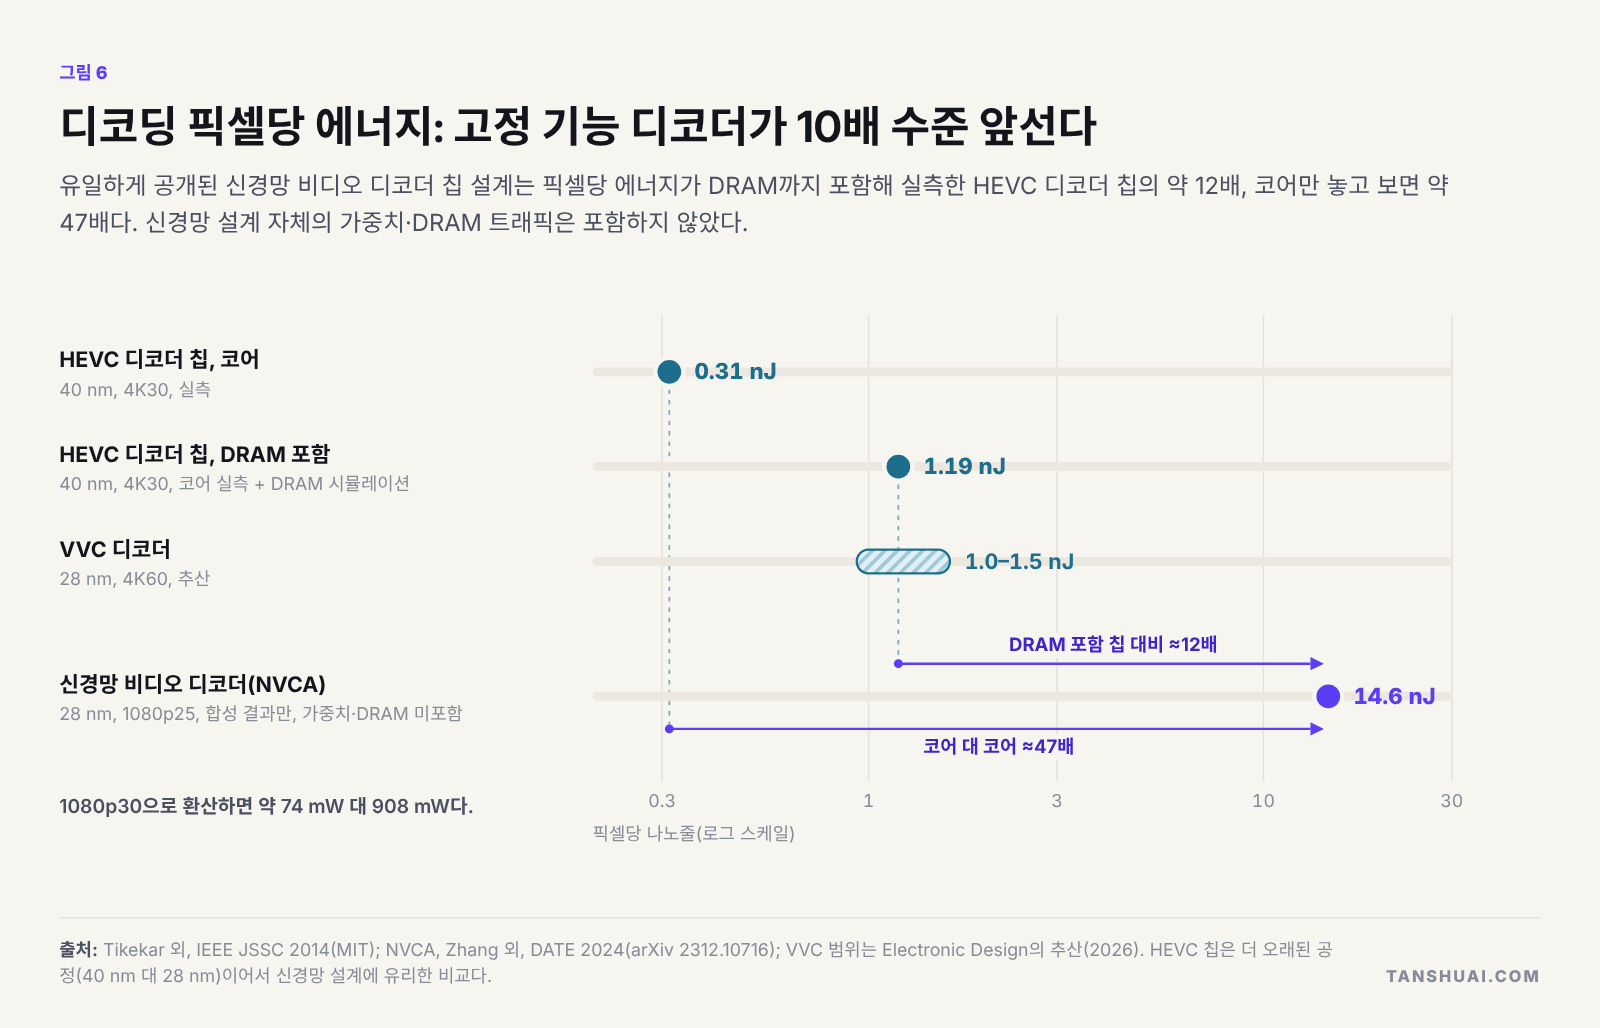 그림 6. 디코딩 픽셀당 에너지: 고정 기능 디코더가 10배 수준 앞선다.
유일하게 공개된 신경망 비디오 디코더 칩 설계인 NVCA는 픽셀당 14.6 nJ의 에너지가 필요하다. MIT의 HEVC 디코더 칩은 DRAM을 포함해 1.19 nJ, 코어만은 0.31 nJ다. 1080p30으로 환산하면 약 900 mW 대 74 mW다. 마이크로소프트의 빠른 연구용 코덱 DCVC-RT는 논문의 모듈별 표를 필자가 합산한 결과 디코딩 픽셀당 약 17만 5천 MAC, 1080p30 기준으로 약 22 TOPS가 필요하다. AI PC를 정의하는 40 TOPS의 절반을 스트림 하나에 쓰는 셈이다.
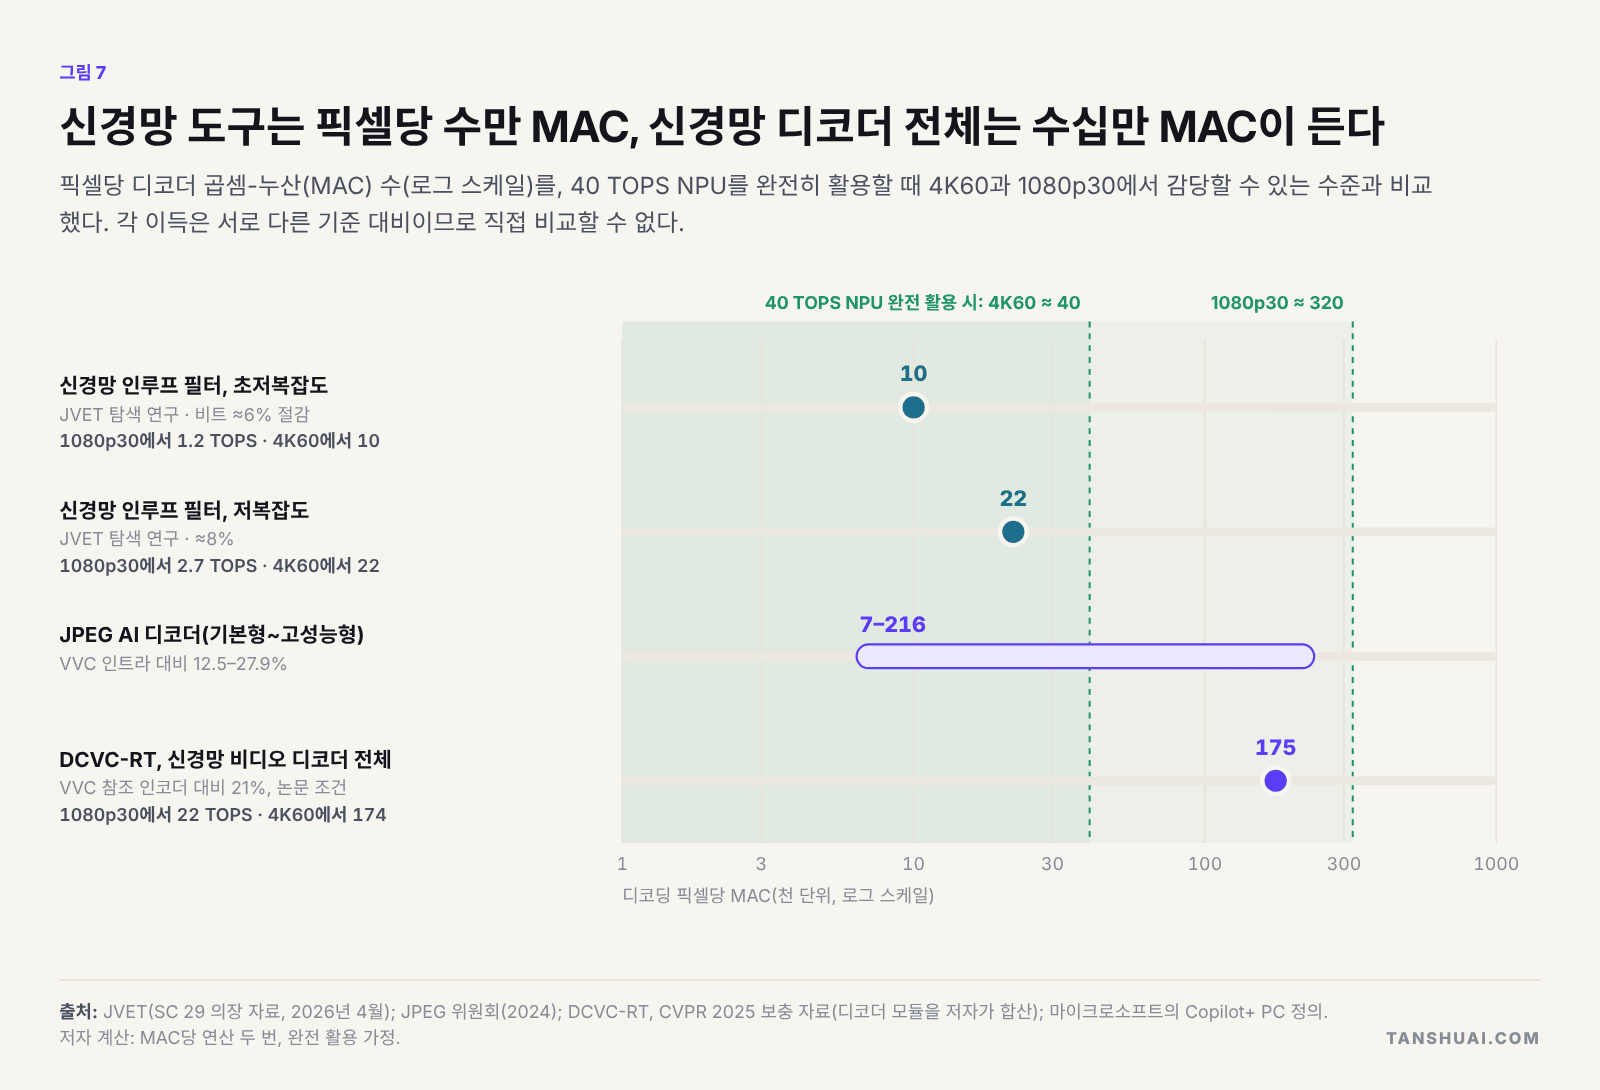 그림 7. 신경망 도구는 픽셀당 수만 MAC, 신경망 디코더 전체는 수십만 MAC이 든다.
중요한 비용이 두 가지 더 있다. 하나는 메모리다. MIT 칩에서는 시스템 에너지의 약 4분의 3이 DRAM에 쓰이며, 신경망 디코더는 프레임 사이에 큰 특징 맵을 들고 다닌다. 다른 하나는 정확성이다. 두 기기가 확률을 다르게 계산하면 엔트로피 디코딩이 실패한다. 진지한 신경망 코덱이 이제 모두 정수 연산을 쓰고, MLVC가 동일한 디코딩을 위해 압축 효율을 내주는 이유가 여기에 있다.
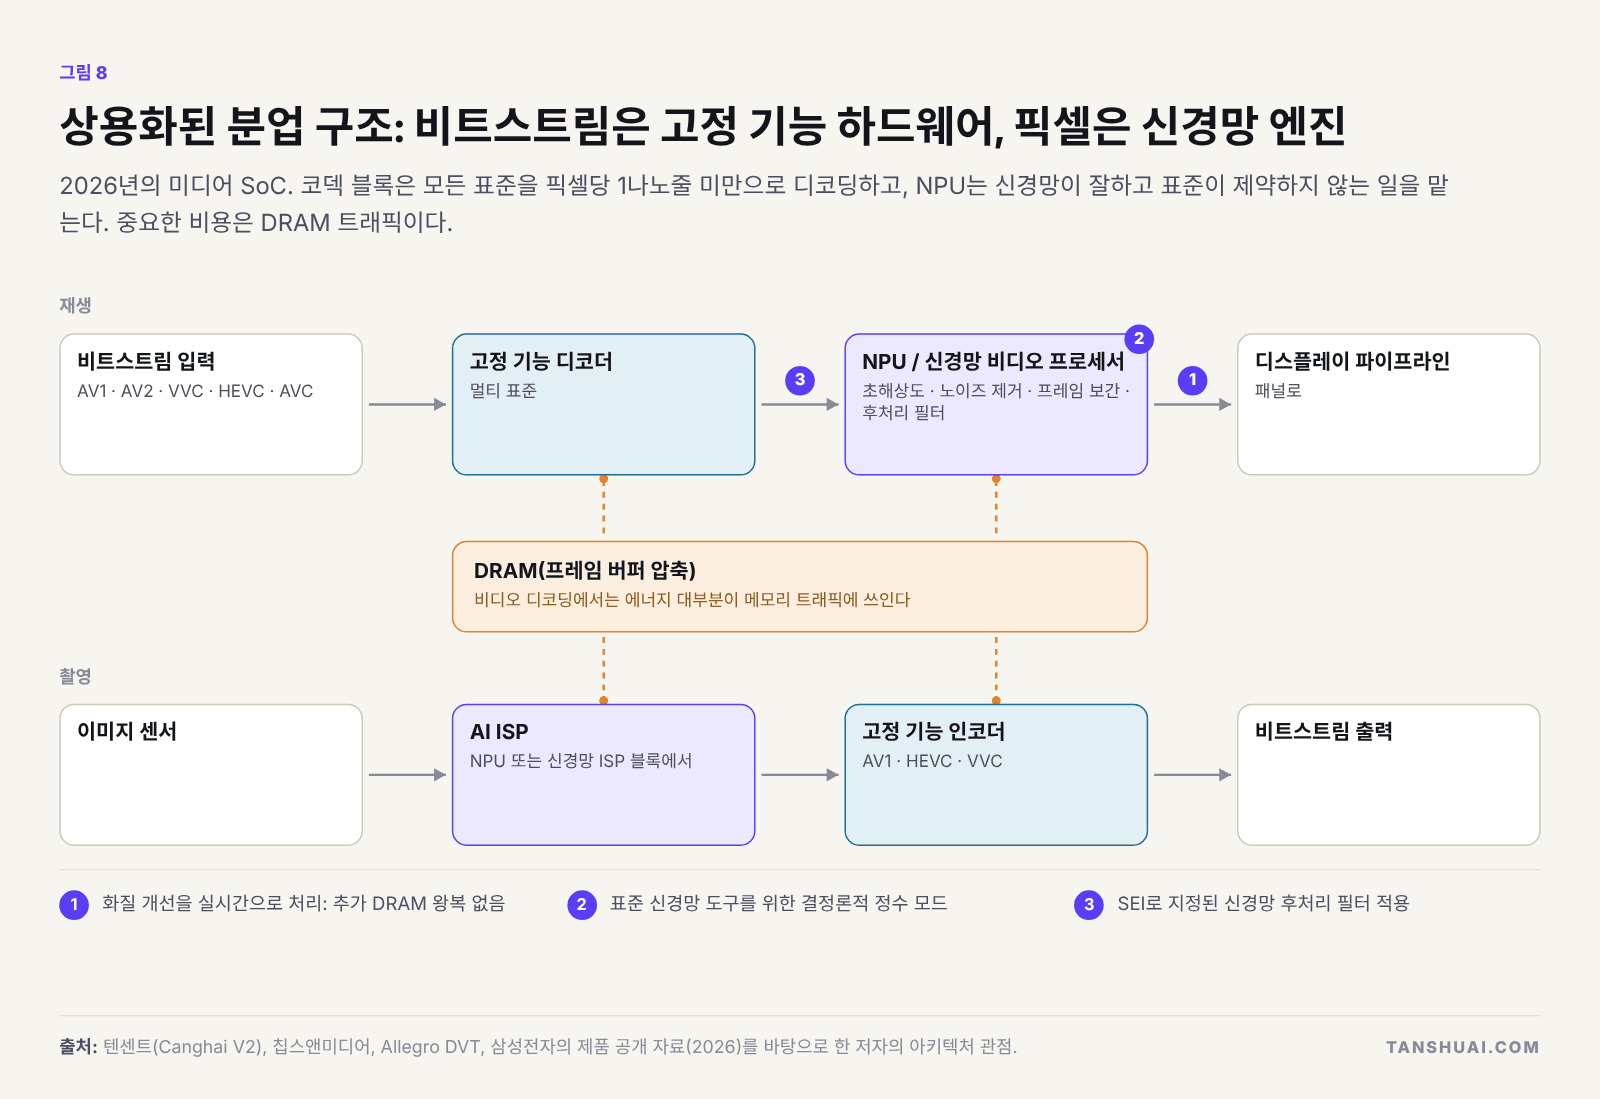 그림 8. 상용화된 분업 구조: 비트스트림은 고정 기능 하드웨어, 픽셀은 신경망 엔진.
팔리는 실리콘은 이 둘을 짝짓는다. 텐센트는 자체 개발한 Canghai 코덱 칩을 10만 개 넘게 배치했고, 2세대는 H.266과 온칩 초해상도를 추가했다. IP 업체들은 코덱 블록과 비디오 NPU를 나란히 판다. 필자가 지금 미디어 SoC를 기획한다면 이렇게 하겠다. 재생해야 하는 모든 표준(AV2 포함)의 고정 기능 디코더, DRAM을 한 번 더 거치지 않고 디스플레이 해상도의 화질 개선을 처리할 수 있는 크기의 NPU, 결정론적 정수 모드를 갖추고, H.267은 2029년 이후에 설계를 시작할 대상으로 둔다.
누가 돈을 버는가, 기업은 어디서 기회를 찾을 수 있는가
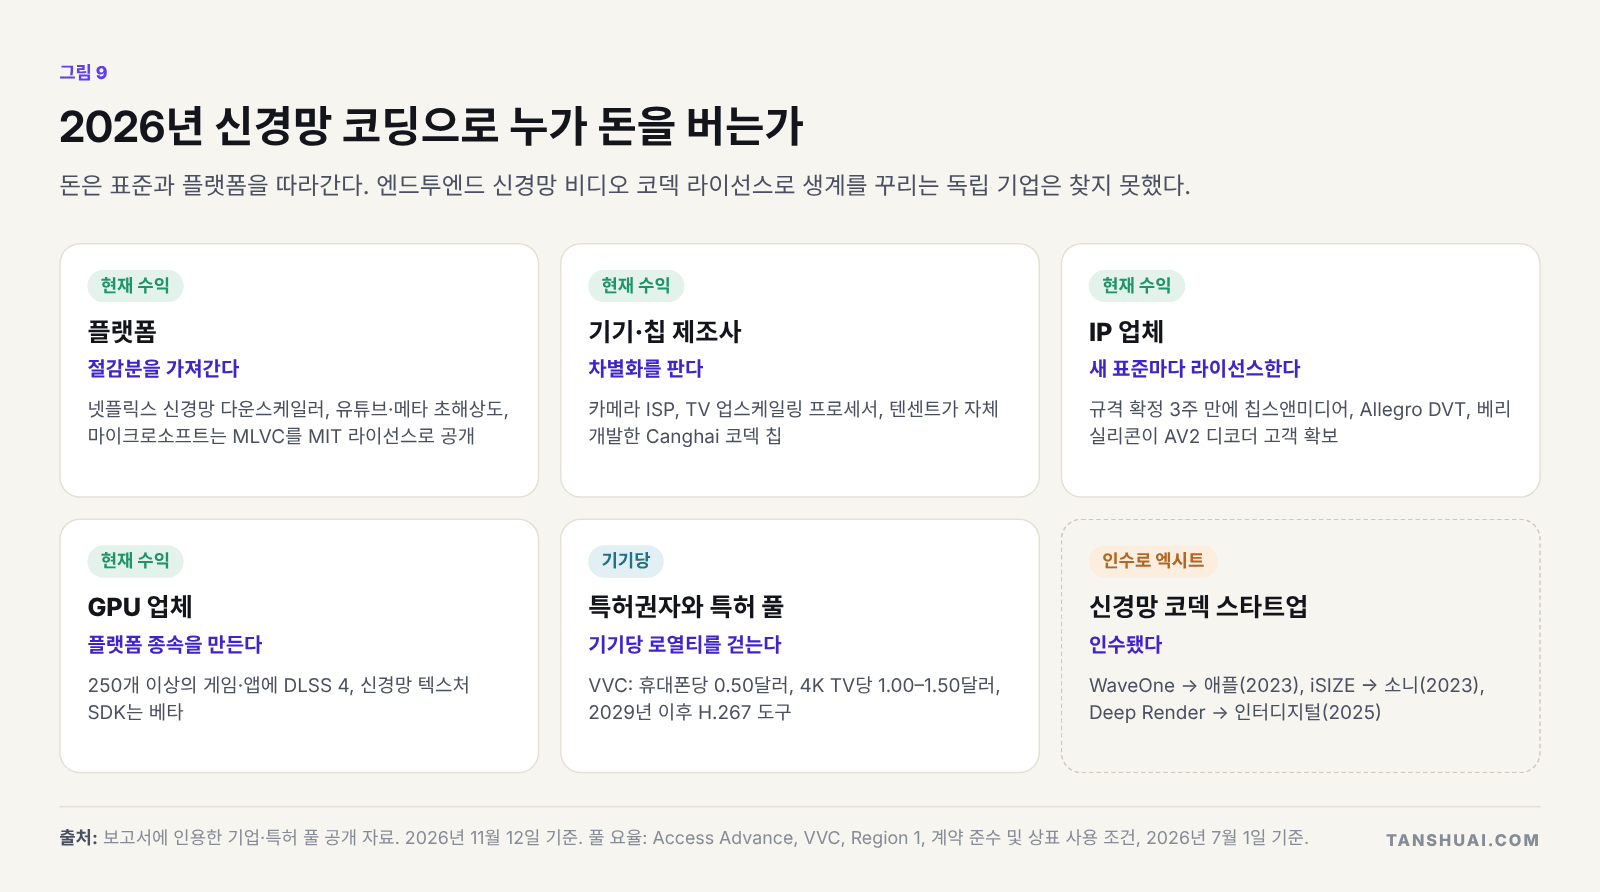 그림 9. 돈은 표준과 플랫폼을 따라간다.
플랫폼은 절감분을 가져가고, 마이크로소프트가 MLVC로 그랬듯 때로는 코드를 공개한다. IP 업체는 새 표준이 나올 때마다 디코더를 라이선스한다. 특허 풀은 기기당 로열티를 걷는다. VVC의 경우 미국 등 Region 1 시장에서 휴대폰당 0.50달러, 4K TV당 1.00–1.50달러다. WaveOne은 애플에, iSIZE는 소니에, Deep Render는 인터디지털에 넘어갔다. 엔드투엔드 신경망 비디오 코덱 라이선스로 생계를 꾸리는 독립 기업은 찾지 못했다.
기업에 열려 있는 기회는 비디오 서비스를 위한 신경망 전처리, 칩 제조사를 위한 디스플레이 측 화질 개선, 화상회의와 전용 링크를 위한 폐쇄 루프 신경망 코덱, 코덱과 NPU를 결합한 실리콘, 그리고 신경망 도구를 출시하는 모든 기업이 필요로 할 평가·적합성 도구다. H.267 표준화 작업에는 인내와 라이선스 전략이 필요하다.
에누리해 들을 주장과 주목할 점
신경망 코덱에 관한 주장에는 네 가지를 요구하라. 기준, 지표, 해상도, 디코딩 비용이다. “88% 절감”은 360p에서 H.264 대비 수치다. “비디오 메모리 85–96% 절감”은 시연 장면의 결과로, 출시된 게임에서는 30%였다. “JPEG AI는 표준이다”라는 말 뒤에는 아직 제품이 없다.
주목할 시점은 다음과 같다. 2027년 1월의 H.267 평가, 2027년 초 유튜브의 첫 AV2 스트리밍, 2027년 하반기 H.267의 첫 테스트 모델, MLVC가 Teams 밖으로 확산되는지 여부, JPEG AI를 기본으로 쓰는 첫 제품, 그리고 휴대폰과 PC의 NPU 예산이다. 2029년 말 H.267 버전 1이 나오면 대중적 재생에 쓰일 신경망 도구의 실리콘 사이클이 시작된다.
전체 보고서와 슬라이드 내려받기
전체 보고서에는 각 영역의 더 자세한 내용, 실리콘 관련 계산, 표준과 특허, 주장과 근거를 대조한 표, 그리고 모든 출처가 담겨 있다.
이 문서는 영어판을 번역한 것이며, 두 판의 내용이 다를 경우 영어판이 우선한다.
열린 질문
여기에는 아직 공개된 답이 없는 질문이 몇 가지 있고, 필자가 기술적으로 가장 흥미롭게 여기는 것도 바로 이 질문들이다. 신경망 디코더는 압축 우위를 잃기 전까지 서로 다른 업체의 NPU에서 비트 단위로 일치하는 정수 연산에 얼마나 다가갈 수 있는가. 신경망 후처리는 픽셀당 DRAM 트래픽이 얼마나 드는가. H.267 디코더에서 신경망 도구는 픽셀당 비용이 얼마일 때 제값을 못 하게 되는가. 통화 외에 어떤 폐쇄형 시스템이 엔드투엔드 신경망 코덱을 먼저 채택할 수 있는가. 디코더가 디테일을 복원하는 대신 생성할 때 충실도를 어떻게 측정할 것인가.
앞으로 몇 년간 기술 교류와 기술 협력을 통해 함께 탐구할 수 있는 분야들이다. 연락처: i@tanshuai.com
저자 소개
탄 슈아이는 칩, 하드웨어, 시스템 소프트웨어 분야에서 20년 넘게 일해 온 기술 전문가이자 창업가이며, 등록 특허 20건을 보유하고 있다. 풀 커스텀 ASIC 데이터패스 설계, 비디오 코덱 가속기 같은 멀티미디어 카메라 칩 프로젝트를 포함해 팹리스 칩 연구개발과 관리 경험을 오랫동안 쌓았다. 실리콘밸리, 뉴욕, 시카고, 대만, 그레이터 베이 에어리어(선전과 홍콩), 베트남, 말레이시아를 거치며 일했다. 현재는 AI 연구자이자 개발자로 일하고 있다.
기술 논의: i@tanshuai.com