
Neurale netværk former allerede næsten alle de videoer, du ser, men i begge ender af en standardcodec, ikke i stedet for den. Her gennemgår jeg, hvor neural kodning bruges i 2026, hvad den koster i silicium, og hvem der tjener pengene, med den fulde rapport og slides.
Resumé
Neural kodning er allerede udbredt i 2026, men den arbejder omkring standardcodecs i stedet for at erstatte dem. Netværk former billedet før kodningen, i telefonkameraer og i Netflix' kodningspipeline, og reparerer det efter dekodningen, i YouTubes Super Resolution, hos Meta og i tv-processorer; bitstrømmen imellem er stadig AV1, HEVC, AVC eller VVC, dekodet af dedikeret hardware. Ende-til-ende-neurale codecs bruges kun i lukkede kredsløb, hvor én virksomhed styrer begge ender: Microsofts MLVC i Teams-opkald, tokenizerne inde i alle stemme- og videomodeller, neurale teksturer i ét spil. Afspilning af neurale bitstrømme på massemarkedet venter på H.267, som er planlagt til udgangen af 2029, og en chipcyklus derefter. Årsagen ligger i chippen: det eneste publicerede design til en neural videodekoder kræver omkring 12 gange så meget energi pr. pixel som en målt HEVC-dekoder, og en hurtig forskningscodec kræver omkring 22 TOPS til 1080p30. Pengene følger standarderne og platformene; de bedst kendte startups med neurale codecs blev opkøbt.
Hvorfor jeg undersøgte det
Med få måneders mellemrum fortæller nogen mig, at AI-codecs er ved at erstatte H.264, HEVC og AV1. Det meste af det, jeg læser om emnet, kommer enten fra forskningsartikler, hvor komprimeringsrekorderne er, eller fra leverandører. Ingen af delene siger ret meget om, hvad der faktisk leveres, til hvem og til hvilken pris.
Jeg har mange år med F&U og ledelse inden for fabless-chips bag mig, herunder full-custom-design af ASIC-datapaths og multimedieprojekter med kamerachips, såsom acceleratorer til videocodecs, så jeg så på det, som jeg ville gennemgå en chip: energi pr. pixel, hukommelsestrafik, hvad en standard lader dig fastlægge i silicium, og hvem der betaler. Jeg læste standarddokumenter og mødereferater fra JVET, MPEG, JPEG, AOMedia og IETF, virksomheders ingeniørblogs, chipartikler, patentpuljers prislister, tekster om eksportkontrol og pressen. Alle tal nedenfor er pr. 12. november 2026, og beløb er i amerikanske dollar. Den fulde rapport med alle kilderne findes til sidst.
Resultaterne i overblik
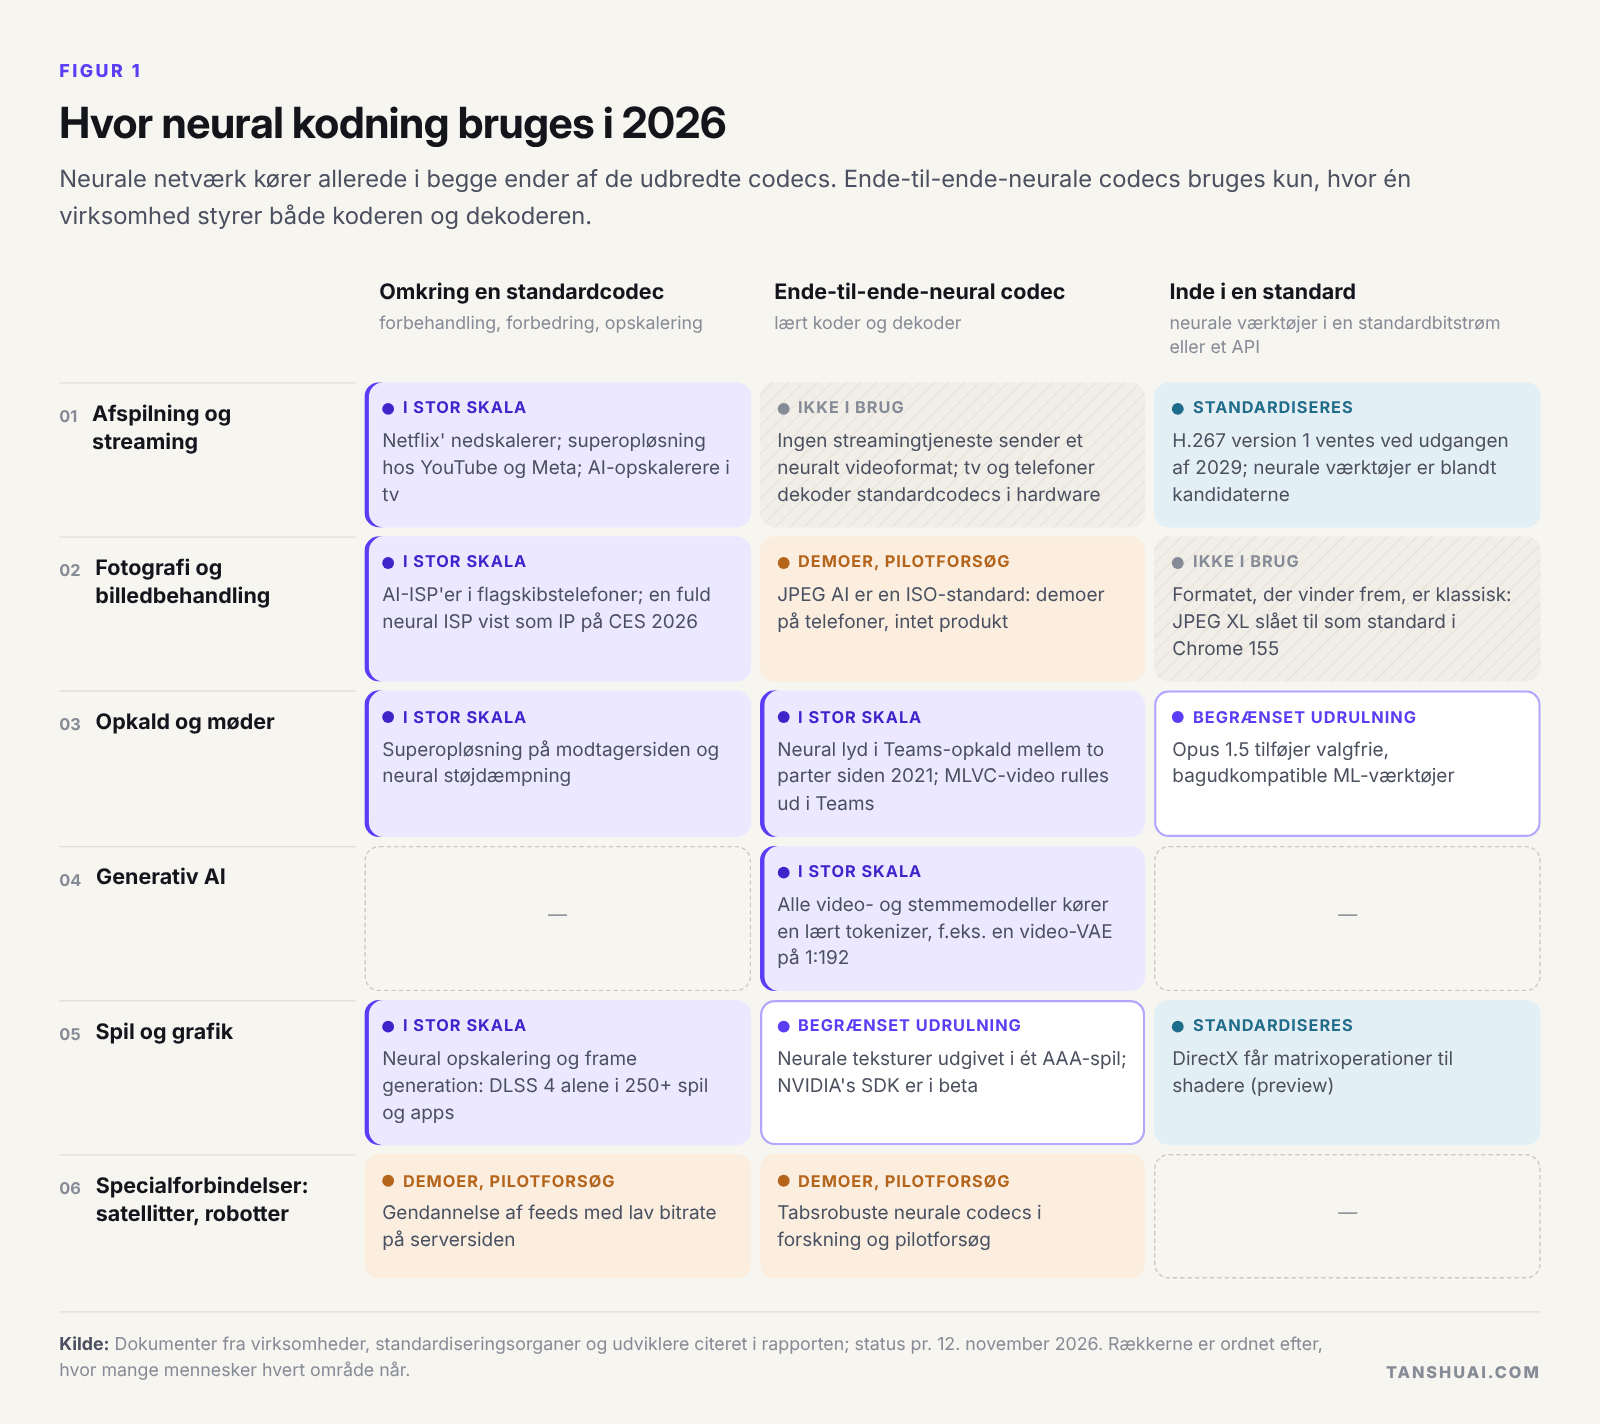 Figur 1. Hvor neural kodning bruges i 2026. Rækkerne er ordnet efter, hvor mange mennesker hvert område når.
| Spørgsmål | Kort svar |
|---|---|
| Hvor bruges neural kodning i stor skala? | Omkring codec'en: kamera-ISP'er, nedskalering på kodersiden, superopløsning ved afspilning. Ende-til-ende kun i lukkede kredsløb: opkald, spil-assets, tokenizere i generativ AI |
| Vil neurale codecs erstatte AV1, HEVC og VVC i afspilning? | Ikke før H.267 (version 1 ved udgangen af 2029) og en enhedscyklus derefter; bred udbredelse i midten af 2030'erne efter mit estimat |
| Hvad koster det i silicium? | Omkring 12 gange så meget energi pr. pixel som en HEVC-hardwaredekoder plus hukommelsestrafik og et krav om bitnøjagtig dekodning |
| Hvem tjener pengene? | Platformene beholder besparelserne; IP-leverandører og patentpuljer får betaling pr. design og pr. enhed; startups med neurale codecs blev opkøbt |
| Hvor kan en virksomhed byde ind? | Neural for- og efterbehandling, produkter med lukkede kredsløb, chips med codec plus NPU og evaluerings- og standardiseringsarbejdet midt imellem |
Tre veje ind
»Neural kodning« dækker over tre forskellige ting, og de fleste uenigheder om emnet skyldes, at de blandes sammen. Et netværk kan arbejde omkring en standardcodec og behandle pixels før kodning eller efter dekodning, mens bitstrømmen forbliver standard. Det kan sidde inde i en standard som et værktøj, alle dekodere skal køre, hvilket betyder, at det skal specificeres nøjagtigt. Eller det kan erstatte codec'en fra ende til anden med en lært koder og dekoder, der kun virker som et par.
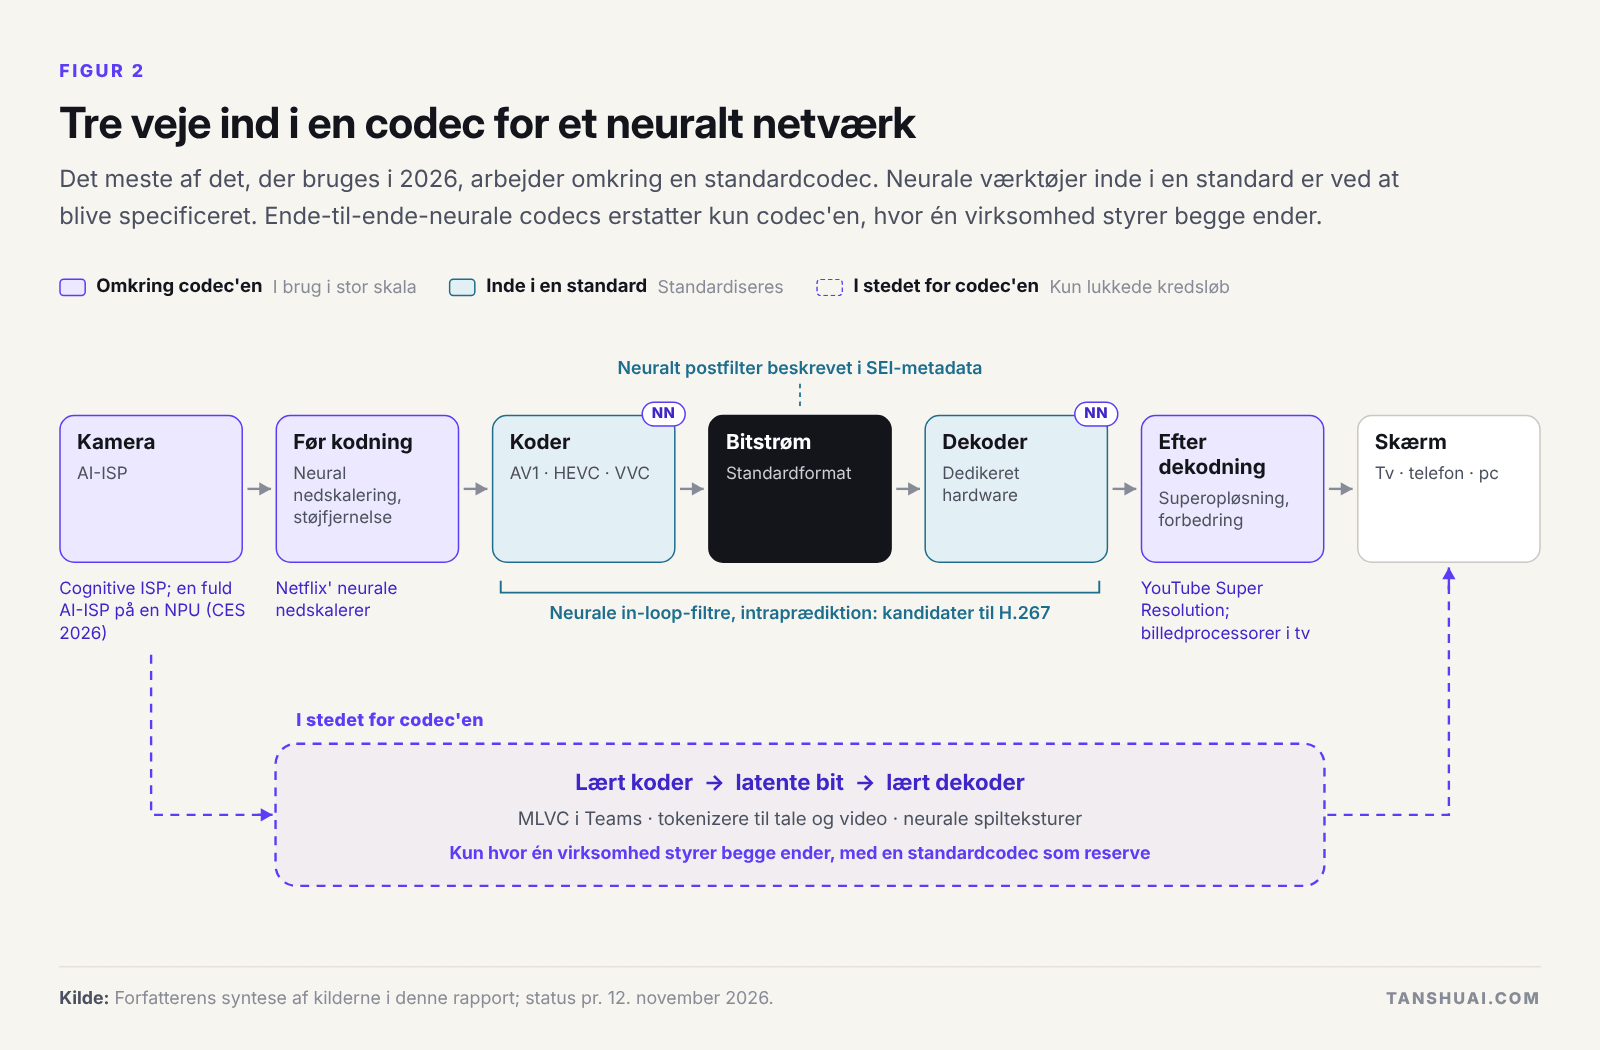 Figur 2. Tre veje ind i en codec for et neuralt netværk. Det meste af det, der bruges i 2026, er den første.
Den første kræver ingens tilladelse. Den anden kræver en standard. Den tredje kræver kontrol over begge ender. Det er den rækkefølge, de når ud til folk i.
Afspilning og streaming: neural i begge ender, standard i midten
De store tjenester har afsluttet én codecovergang og er ved at begynde den næste, og ingen af dem involverer en neural dekoder. Netflix oplyste i december 2025, at AV1 stod for omkring 30 % af tjenestens seertid; YouTube oplyser, at over 90 % af kataloget, vægtet efter seertid, er tilgængeligt i AV1. AV2 blev færdig den 28. maj 2026 med omkring 30 % bedre komprimering end AV1, og inden for tre uger havde Chips&Media, Allegro DVT og VeriSilicon annonceret kunder til AV2-dekodere. Brasiliens TV 3.0 begyndte kommercielle VVC-udsendelser i juni 2026.
Den neurale del sidder i begge ender. Siden 2022 har Netflix brugt et lille neuralt netværk i stedet for et konventionelt filter til at nedskalere sine mastere, en løsning, der ikke kræver ændringer på nogen enhed, og som omkring 77 % af seerne foretrak i Netflix' test. YouTube opskalerer videoer, der er uploadet under 1080p, med maskinlæring på tv, Meta kører superopløsning på sine servere og på telefoner, og Samsungs flagskibsprocessor til tv reklamerer med 768 opskaleringsnetværk.
Det, der ikke findes, er en neural bitstrøm på massemarkedets skærme, og årsagen er tid. Et afspilningsformat skal kunne dekodes på alle enheder, der nogensinde skal afspille det. AV1 tog næsten otte år fra færdig specifikation til 30 % af Netflix' seertid.
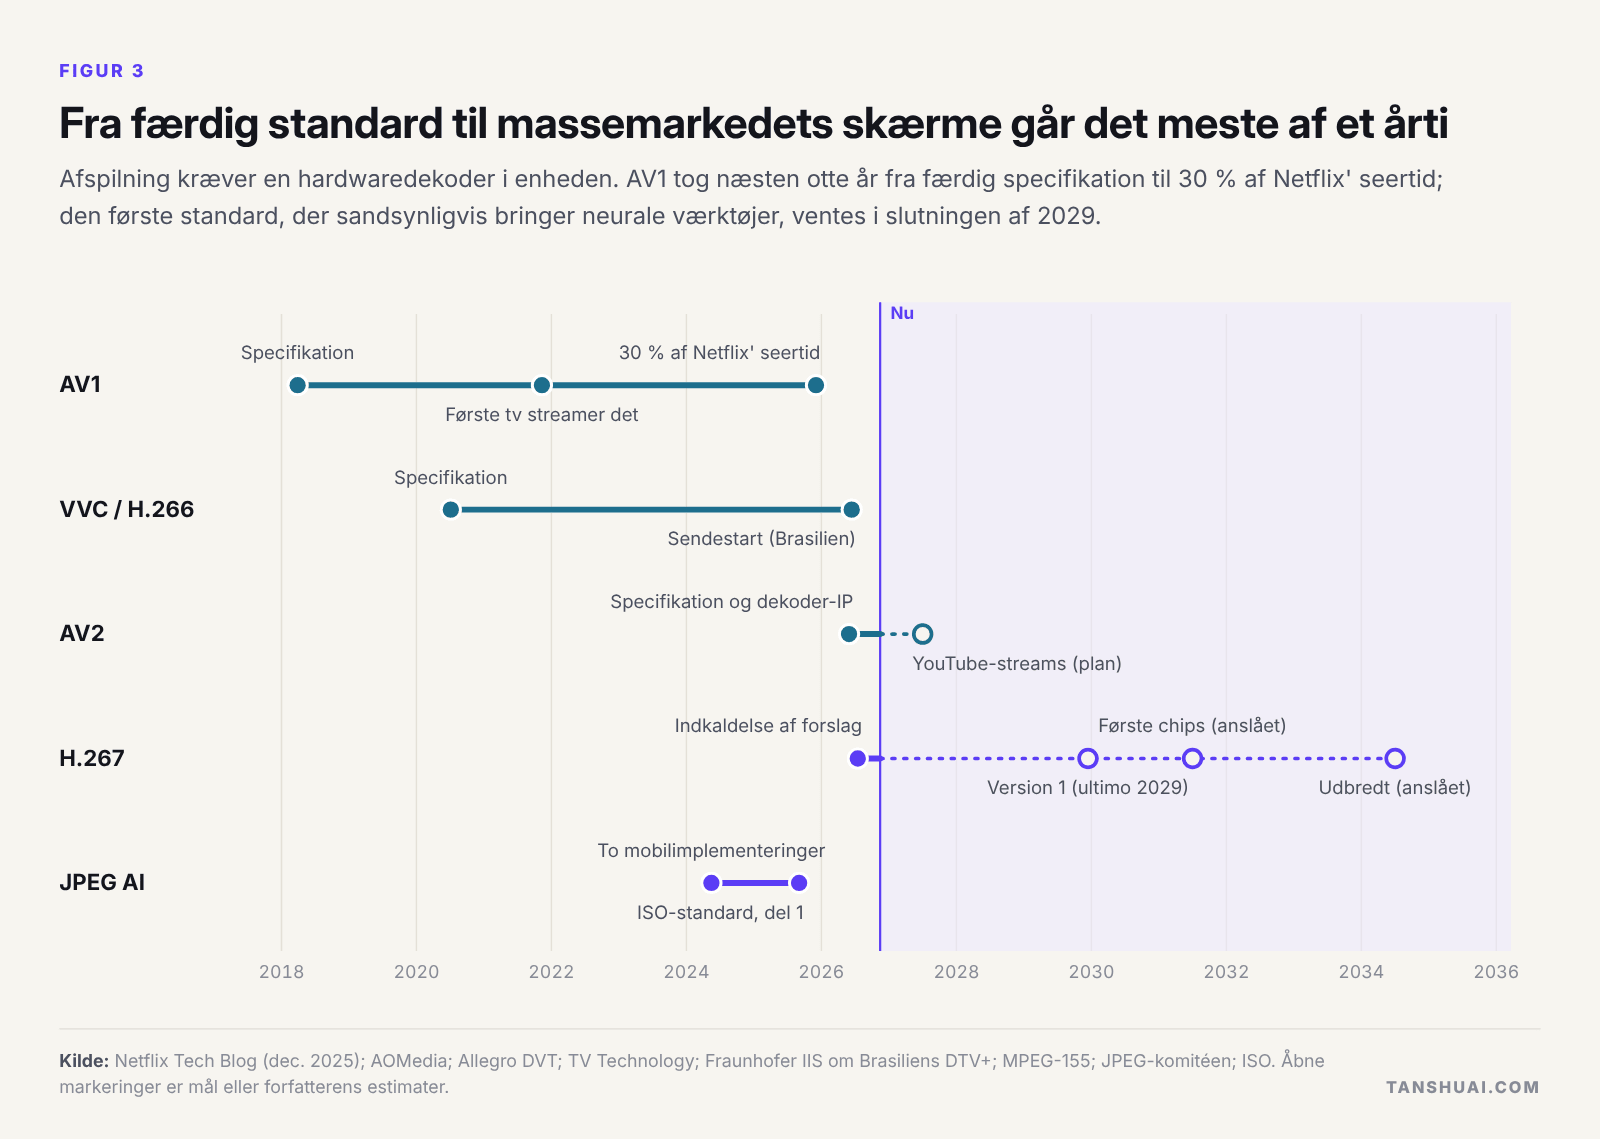 Figur 3. Fra færdig standard til massemarkedets skærme går det meste af et årti.
Den standard, der kunne bringe neurale værktøjer ud på alle skærme, er H.267, arbejdsnavnet for VVC's efterfølger. JVET udsendte sin indkaldelse af forslag i juli 2026; svarene evalueres i januar 2027, og den første version ventes ved udgangen af 2029. Det klassiske spor sparer allerede omkring 28 % i forhold til VVC, mens JVET's neurale in-loop-filtre sparer 6–14 % til en dekoderomkostning på 10 tusind MAC'er pr. pixel og opefter. Jeg forventer en klassisk kerne med nogle få neurale værktøjer, hvor de sparede bit retfærdiggør omkostningen.
Fotografi: neural inde i kameraet, klassisk på nettet
Hvert foto fra en nyere flagskibstelefon har passeret neurale netværk, før det gemmes. Qualcomms Cognitive ISP har kørt semantisk segmentering i realtid siden 2023, og på CES 2026 viste Chips&Media og Visionary.ai en fuld ISP, der kører helt på en NPU. Derefter gemmes resultatet som JPEG eller HEIF.
JPEG AI, den første standard for lært billedkodning, blev udgivet i 2025 med gevinster på 12,5–27,9 % i forhold til VVC-intrakodning til dekoderomkostninger på 7 til 216 tusind MAC'er pr. pixel. Jeg fandt intet kamera, ingen galleriapp og ingen browser, der bruger det som standardformat. Det format, nettet tog i brug i 2026, er klassisk: Chrome 155 slog JPEG XL til den 6. oktober med en hurtig, hukommelsessikker dekoder, der kører på enhver CPU. Neural kodning vinder inden for én virksomheds pipeline; formater, der skal kunne åbnes overalt, forbliver klassiske.
Opkald: hvor ende-til-ende-neurale codecs bruges
Opkald er et lukket kredsløb: begge ender kører samme app og kan falde tilbage på en standardcodec midt i opkaldet. Derfor er det dér, de første ende-til-ende-neurale codecs i stor skala findes. Microsofts AI-talecodec Satin har kørt i alle Teams- og Skype-opkald mellem to parter siden 2021. I juli 2026 frigav Microsoft som open source MLVC, en neural videocodec, der nu rulles ud i peer-to-peer-opkald i Teams.
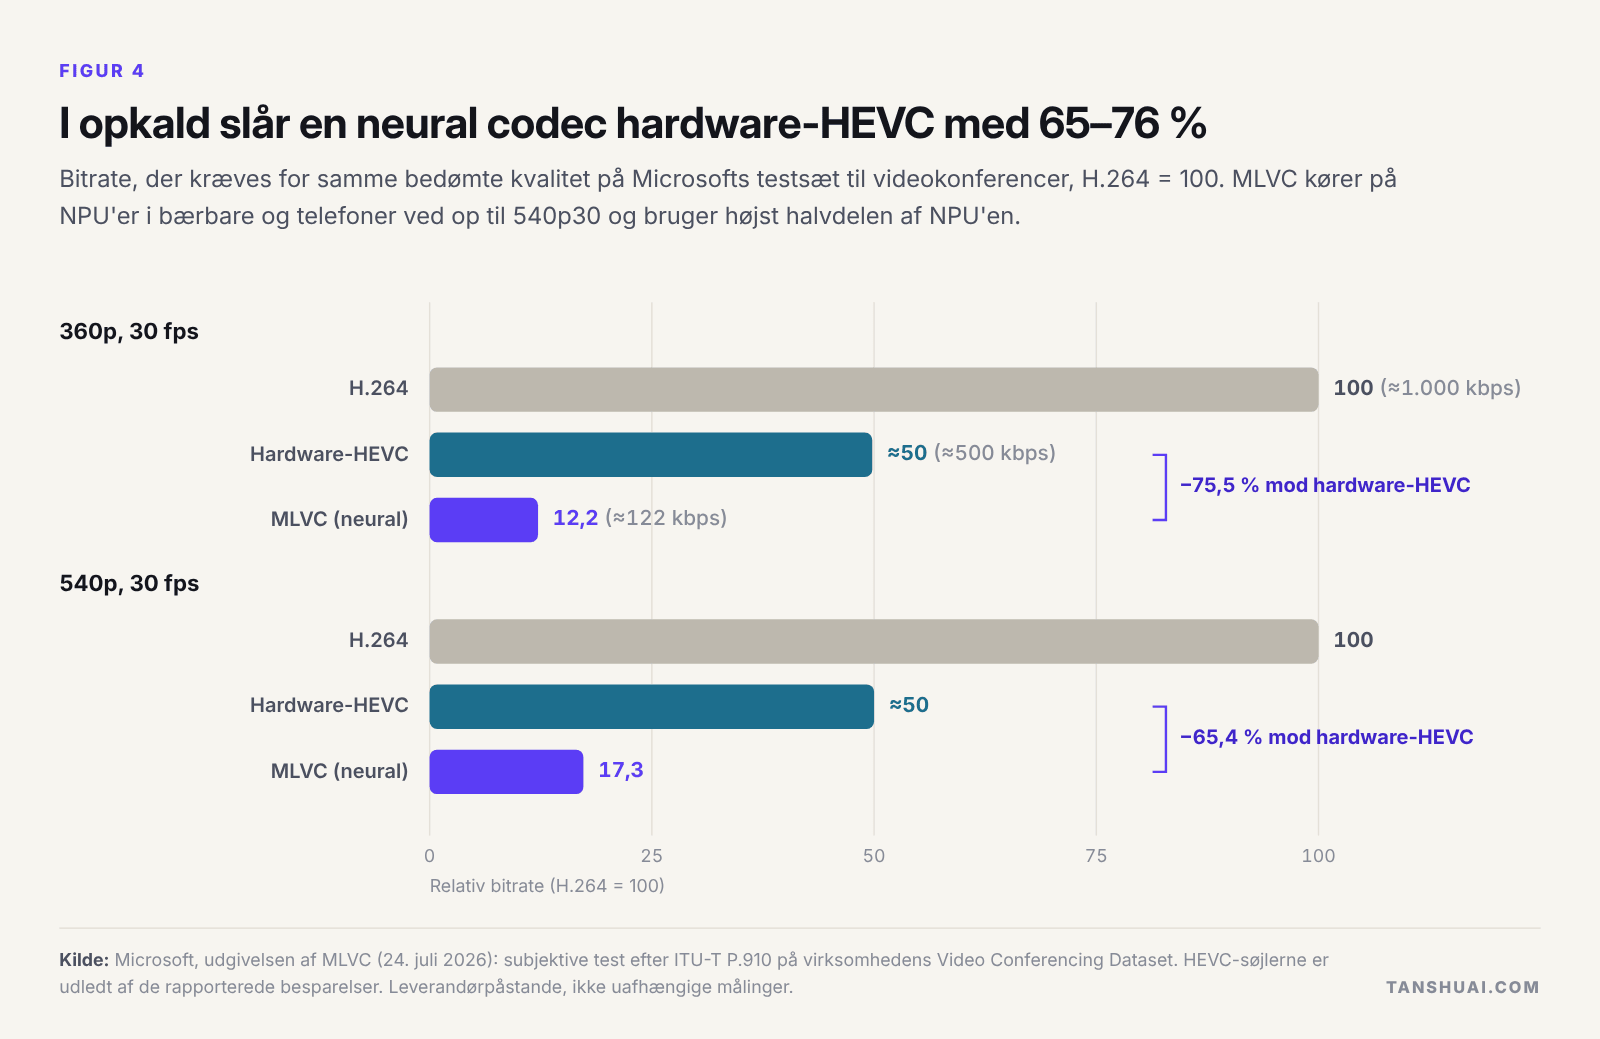 Figur 4. I opkald slår en neural codec hardware-HEVC med 65–76 % på Microsofts eget testsæt.
Overskriftens 88 % er i forhold til H.264; i forhold til den hardware-HEVC, der allerede sidder i de samme bærbare, er det 65–76 %, stadig meget. MLVC kører ved 540p og 360p med højst halvdelen af NPU'en og opgav noget komprimering for at dekode identisk på hardware, som Microsoft ikke ejer.
Ikke alle valgte den vej. Opus fik deep learning i 2024 som valgfrie, bagudkompatible tilføjelser. Meta byggede MLow, en klassisk talecodec, fordi over 20 % af virksomhedens opkald kører på gamle ARMv7-telefoner, og titals millioner WhatsApp-opkald om dagen kører på telefoner, der er over ti år gamle. Neurale codecs kommer først i brug, hvor enhederne er nye, og én leverandør styrer begge ender.
Generativ AI: den største udrulning, som ingen kalder en codec
Alle stemme- og videomodeller kører på en lært codec. Talemodeller læser og skriver tokens fra neurale lydcodecs som Kyutais Mimi med 12,5 frames i sekundet og 1,1 kbps. Videogeneratorer arbejder i det latente rum i video-autoencodere som LTX-Videos, der komprimerer 1:192. Ingen af dem er et format, som andre dekoder, men de beviser, at lært komprimering virker i stor skala, når én virksomhed ejer koderen, dekoderen og hardwaren. For alle, der leverer generativ video, er tokenizerens effektivitet en direkte omkostningspost.
Spil: neural rekonstruktion er udbredt, neurale assets er på vej
NVIDIA's DLSS renderer færre pixels og billeder og lader et netværk genopbygge resten. Neural teksturkomprimering kom med i Assassin's Creed Mirage, men blev kun brugt på udvalgte assets på grund af omkostningen under kørsel.
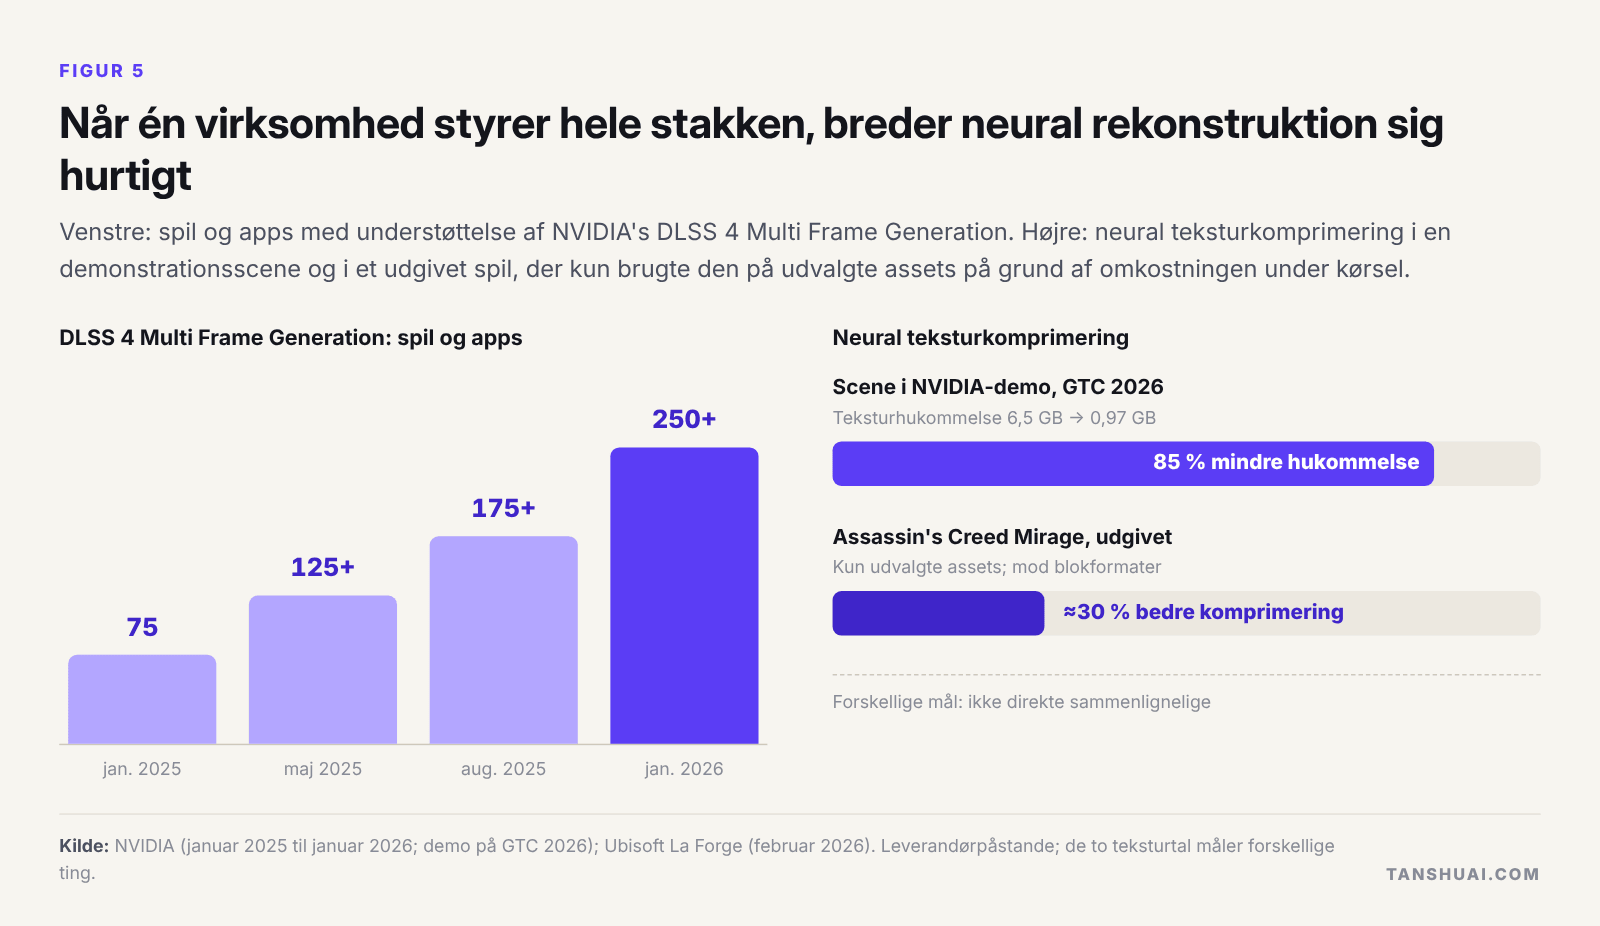 Figur 5. Når én virksomhed styrer hele stakken, breder neural rekonstruktion sig hurtigt.
Satellit-, drone- og robotforbindelser er det bedste tekniske match for ende-til-ende-neurale codecs, men de er et lille marked og i stigende grad underlagt eksportkontrol på begge sider: Kinas eksportregler for droner fra 18. november 2026 nævner endda semantisk billedkomprimering som en tærskel.
Set fra chippen
Det er her, min egen baggrund betyder mest. Et chipteam stiller fire spørgsmål til enhver ny codec: joule pr. pixel, DRAM-trafik pr. pixel, gates, og om alle dekodere i verden beregner præcis de samme bit. På alle fire punkter står en neural dekoder i 2026, hvor hardware-HEVC stod før sine første chips.
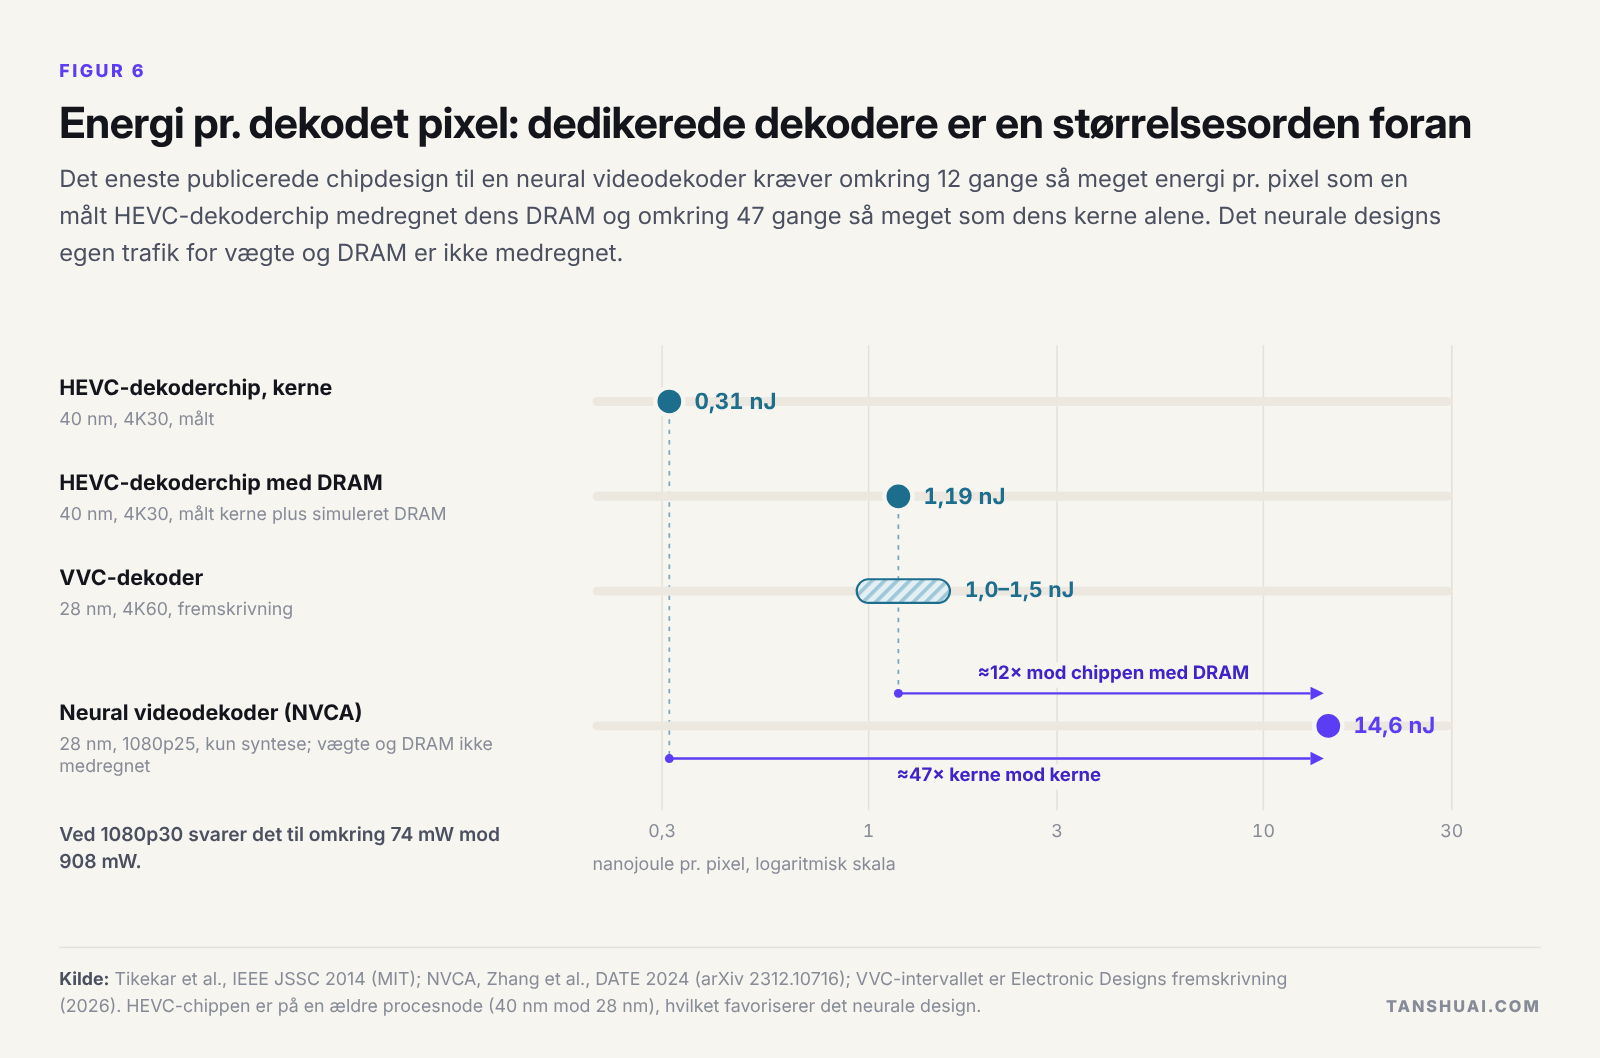 Figur 6. Energi pr. dekodet pixel: dedikerede dekodere er en størrelsesorden foran.
Det eneste publicerede chipdesign til en neural videodekoder, NVCA, kræver 14,6 nJ pr. pixel; MIT's HEVC-dekoderchip kræver 1,19 med sin DRAM og 0,31 for kernen. Ved 1080p30 svarer det til cirka 900 mW mod 74 mW. Microsofts hurtige forskningscodec DCVC-RT kræver efter min sum af dens egen tabel pr. modul omkring 175 tusind MAC'er pr. dekodet pixel, eller omkring 22 TOPS ved 1080p30: halvdelen af de 40 TOPS, der definerer en AI-pc, til én strøm.
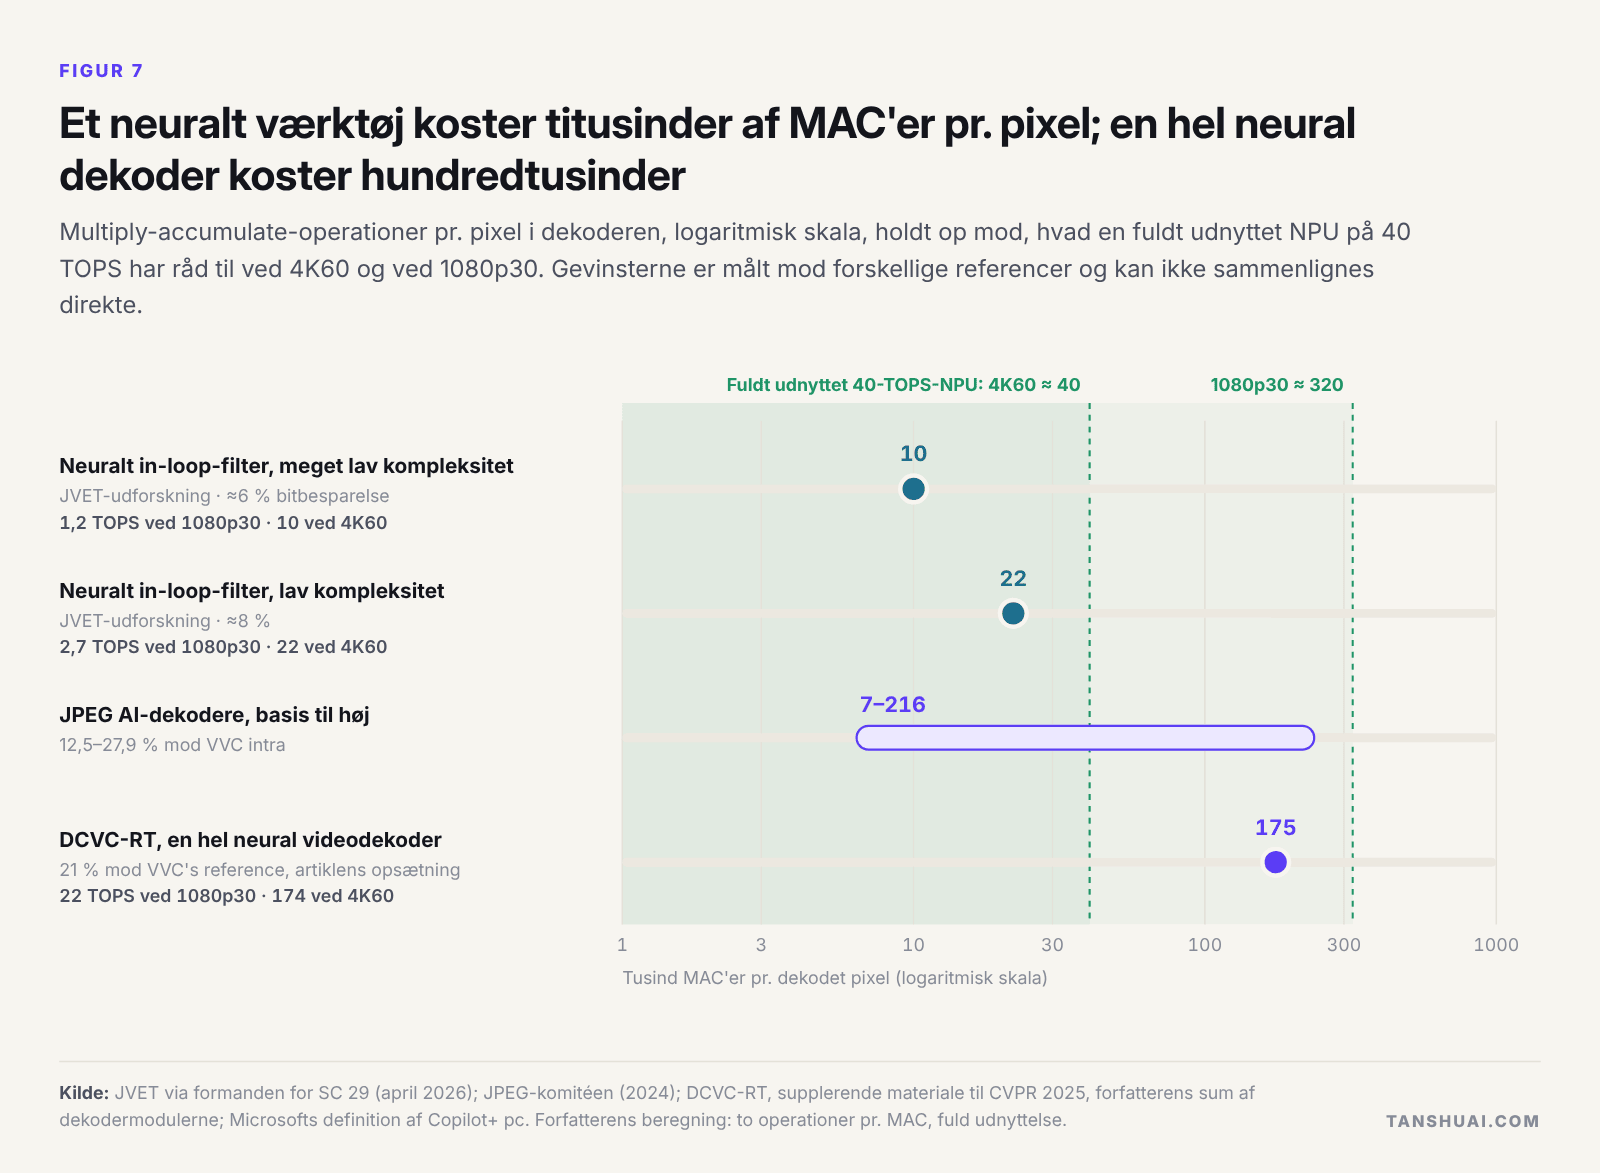 Figur 7. Et neuralt værktøj koster titusinder af MAC'er pr. pixel; en hel neural dekoder koster hundredtusinder.
To omkostninger mere betyder noget. Hukommelse: i MIT-chippen går omkring tre fjerdedele af systemets energi til DRAM, og neurale dekodere bærer store featurekort mellem billederne. Nøjagtighed: entropidekodning fejler, hvis to enheder beregner en sandsynlighed forskelligt, og det er grunden til, at alle seriøse neurale codecs nu bruger heltalsaritmetik, og at MLVC bytter komprimering for identisk dekodning.
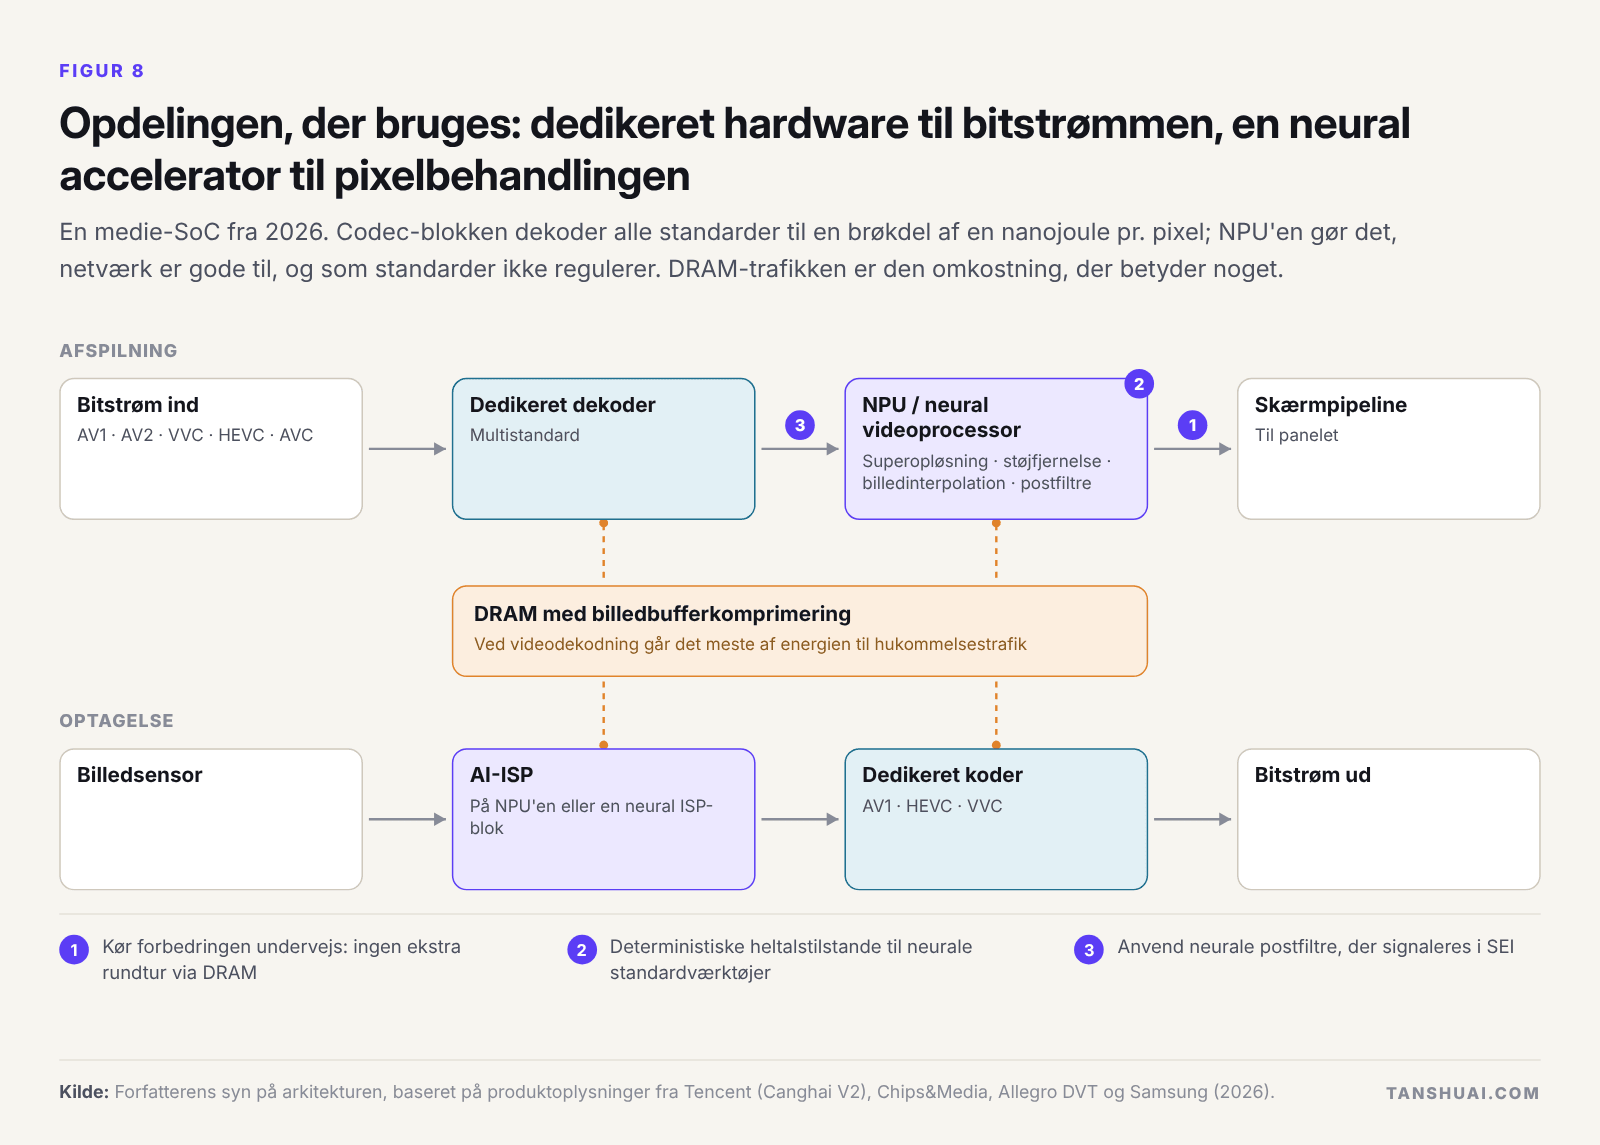 Figur 8. Opdelingen, der bruges: dedikeret hardware til bitstrømmen, en neural accelerator til pixelbehandlingen.
De chips, der sælger, parrer de to. Tencent har over 100.000 af sine egenudviklede Canghai-codecchips i drift, og anden generation tilføjer H.266 og superopløsning på chippen; IP-leverandører sælger codec-blokke og video-NPU'er side om side. Hvis jeg planlagde en medie-SoC nu: dedikerede dekodere til alle de standarder, du skal afspille, herunder AV2; en NPU dimensioneret til forbedring ved skærmopløsning uden en ekstra tur gennem DRAM; deterministiske heltalstilstande; og H.267 som designstart efter 2029.
Hvem tjener pengene, og hvor kan en virksomhed byde ind
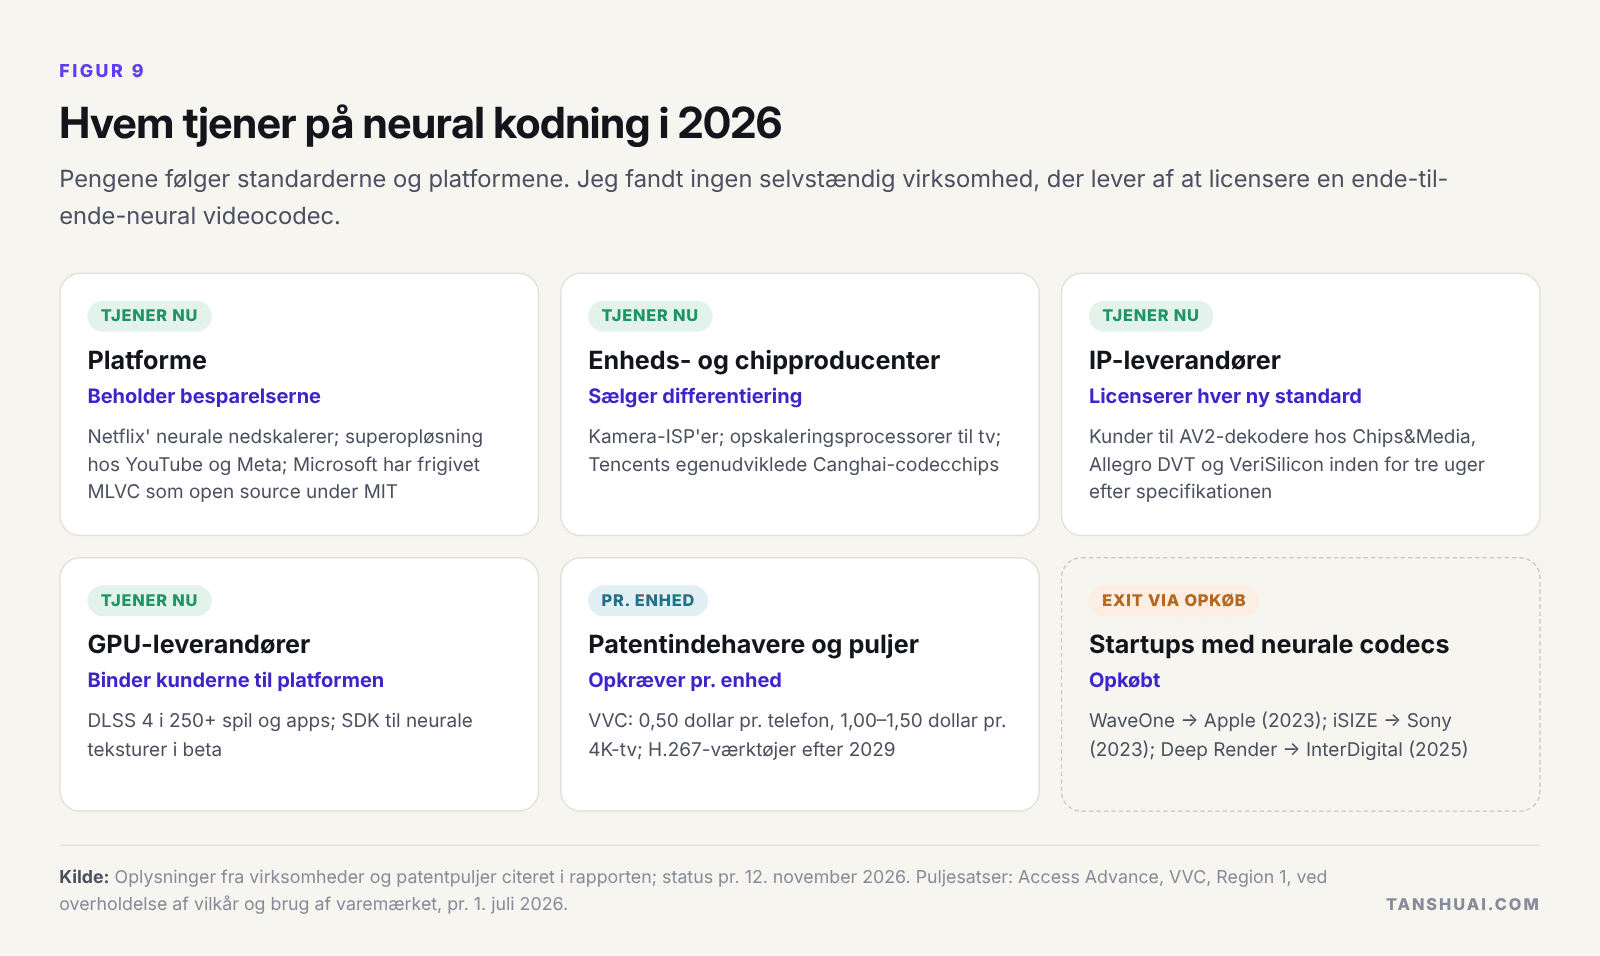 Figur 9. Pengene følger standarderne og platformene.
Platformene beholder besparelserne og giver nogle gange koden væk, som Microsoft gjorde med MLVC. IP-leverandører licenserer dekodere til hver ny standard. Patentpuljer opkræver pr. enhed: for VVC 0,50 dollar pr. telefon og 1,00–1,50 dollar pr. 4K-tv i USA og andre Region 1-markeder. WaveOne gik til Apple, iSIZE til Sony og Deep Render til InterDigital. Jeg fandt ingen selvstændig virksomhed, der lever af at licensere en ende-til-ende-neural videocodec.
For en virksomhed er de åbne muligheder neural forbehandling til videotjenester, forbedring på skærmsiden til chipproducenter, neurale codecs i lukkede kredsløb til konferencer og private forbindelser, chips med codec plus NPU og de værktøjer til evaluering og konformitet, som alle, der leverer neurale værktøjer, får brug for. Standardiseringsarbejde på H.267 kræver tålmodighed og en licensstrategi.
Påstande, der skal tages med forbehold, og hvad der er værd at følge
Kræv fire ting af enhver påstand om neurale codecs: referencen, kvalitetsmålet, opløsningen og dekodningsomkostningen. »88 % besparelse« er i forhold til H.264 ved 360p; »85–96 % mindre videohukommelse« gælder en demonstrationsscene, mod 30 % i det udgivne spil; »JPEG AI er en standard« har endnu intet produkt bag sig.
De datoer, der betyder noget: H.267-evalueringen i januar 2027, YouTubes første AV2-streams i begyndelsen af 2027, H.267's første testmodel i andet halvår 2027, om MLVC breder sig ud over Teams, det første produkt, der bruger JPEG AI som standardformat, og NPU-budgetterne i telefoner og pc'er. Version 1 af H.267 ved udgangen af 2029 starter chipcyklussen for neurale værktøjer i afspilning på massemarkedet.
Download den fulde rapport og slides
Den fulde rapport dækker hvert område mere detaljeret, regnestykkerne for silicium, standarderne og patenterne, en tabel over påstande holdt op mod dokumentationen og alle kilderne.
- Neural kodning i 2026: fuld rapport (PDF)
- Neural kodning i 2026: slides (PDF)
- Engelsk udgave: fuld rapport · slides
Dette er en oversættelse af den engelske udgave; ved uoverensstemmelser er den engelske udgave gældende.
Åbne spørgsmål
Nogle få spørgsmål her har endnu intet offentligt svar, og det er dem, jeg finder mest interessante teknisk: hvor tæt en neural dekoder kan komme på bitnøjagtig heltalsaritmetik på tværs af forskellige leverandørers NPU'er, før den mister sin komprimeringsfordel; hvad neural efterbehandling koster i DRAM-trafik pr. pixel; ved hvilken omkostning pr. pixel et neuralt værktøj holder op med at betale sig i en H.267-dekoder; hvilke lukkede systemer ud over opkald der først kan tage ende-til-ende-neurale codecs i brug; og hvordan man måler gengivelsestroskab, når en dekoder genererer detaljer i stedet for at rekonstruere dem.
Det er områder, vi kan udforske sammen i de kommende år, gennem teknisk udveksling og teknisk samarbejde: i@tanshuai.com.
Om forfatteren
Tan Shuai er teknolog og stifter med mere end tyve års arbejde inden for chips, hardware og systemsoftware og 20 udstedte patenter. Han har mange år med F&U og ledelse inden for fabless-chips bag sig, herunder full-custom-design af ASIC-datapaths og multimedieprojekter med kamerachips, såsom acceleratorer til videocodecs. Hans arbejde har ført ham gennem Silicon Valley, New York, Chicago, Taiwan, Greater Bay Area (Shenzhen og Hongkong), Vietnam og Malaysia. I dag arbejder han som AI-forsker og -udvikler.
Teknisk dialog: i@tanshuai.com.