
Jeg blindtestede 10 AI-modeller på mit billedbibliotek med 142,000 billeder: GPT-6.1 Sol slog Claude Opus
Resumé
Jeg bruger Claude Opus 5.5 hver dag til kode og arbejdsgange, og til det arbejde synes jeg, den er hurtigere og bedre end GPT-6. Jeg antog, at den også ville være bedst til at beskrive billeder, så jeg testede det. Jeg kørte ti konfigurationer: Claude Haiku, Sonnet og Opus 5.5, plus OpenAIs GPT-6.1 Sol, GPT-6 Astra og GPT-6 Luna på flere indsatsniveauer. Hver af dem gav 50 rigtige billeder fra mit bibliotek på 142,521 billeder en titel, billedtekst, nøgleord og et album, og flagrede de billeder, den mente jeg burde slette. To blinde bedømmere fra forskellige leverandører, Claude Fable 5.1 og GPT-6 Astra, scorede alle 500 svar på fakta, opdigtede detaljer, slettevurdering, albumpasning og nytteværdi. GPT-6.1 Sol scorede højest med 9.72 ud af 10. Opus scorede 8.57, og Sonnet og Haiku landede på 7.7 til 7.8. Ultra-indsats var ikke bedre end max. Til officielle Batch API-priser ville det koste omkring $240 at beskrive hele biblioteket med Sol på medium indsats (9.56), $661 med Opus og $11 til $20 med Luna, som stadig slog Haiku.
Hvorfor jeg testede dette
Det meste af min dag går til kode, agentarbejdsgange og automatisering, og Claude Opus 5.5 er den model, jeg griber efter. Til den slags arbejde har den føltes hurtigere og bedre for mig end GPT-6. Så da jeg besluttede at lade AI beskrive og tagge mit billedbibliotek, valgte jeg Opus uden at tøve.
Biblioteket er 25 år af mit liv: 142,521 billeder, fra tidlige digitalkamerabilleder til sidste uges mobilbilleder, plus mere end 16,000 skærmbilleder. Næsten ingen af dem har en billedtekst. Jeg vil have, at hvert billede har en titel, en billedtekst, søgbare nøgleord, et fornuftigt album og et ærligt flag, når det er en dublet eller skrald. Før jeg betaler for at behandle 142,000 billeder, ville jeg vide, hvilken model der gør dette bedst, og hvad forskellen koster.
Jeg forventede, at Opus ville vinde. På disse 50 billeder scorede GPT-6.1 Sol mere end ét point højere.
Resultater i et overblik
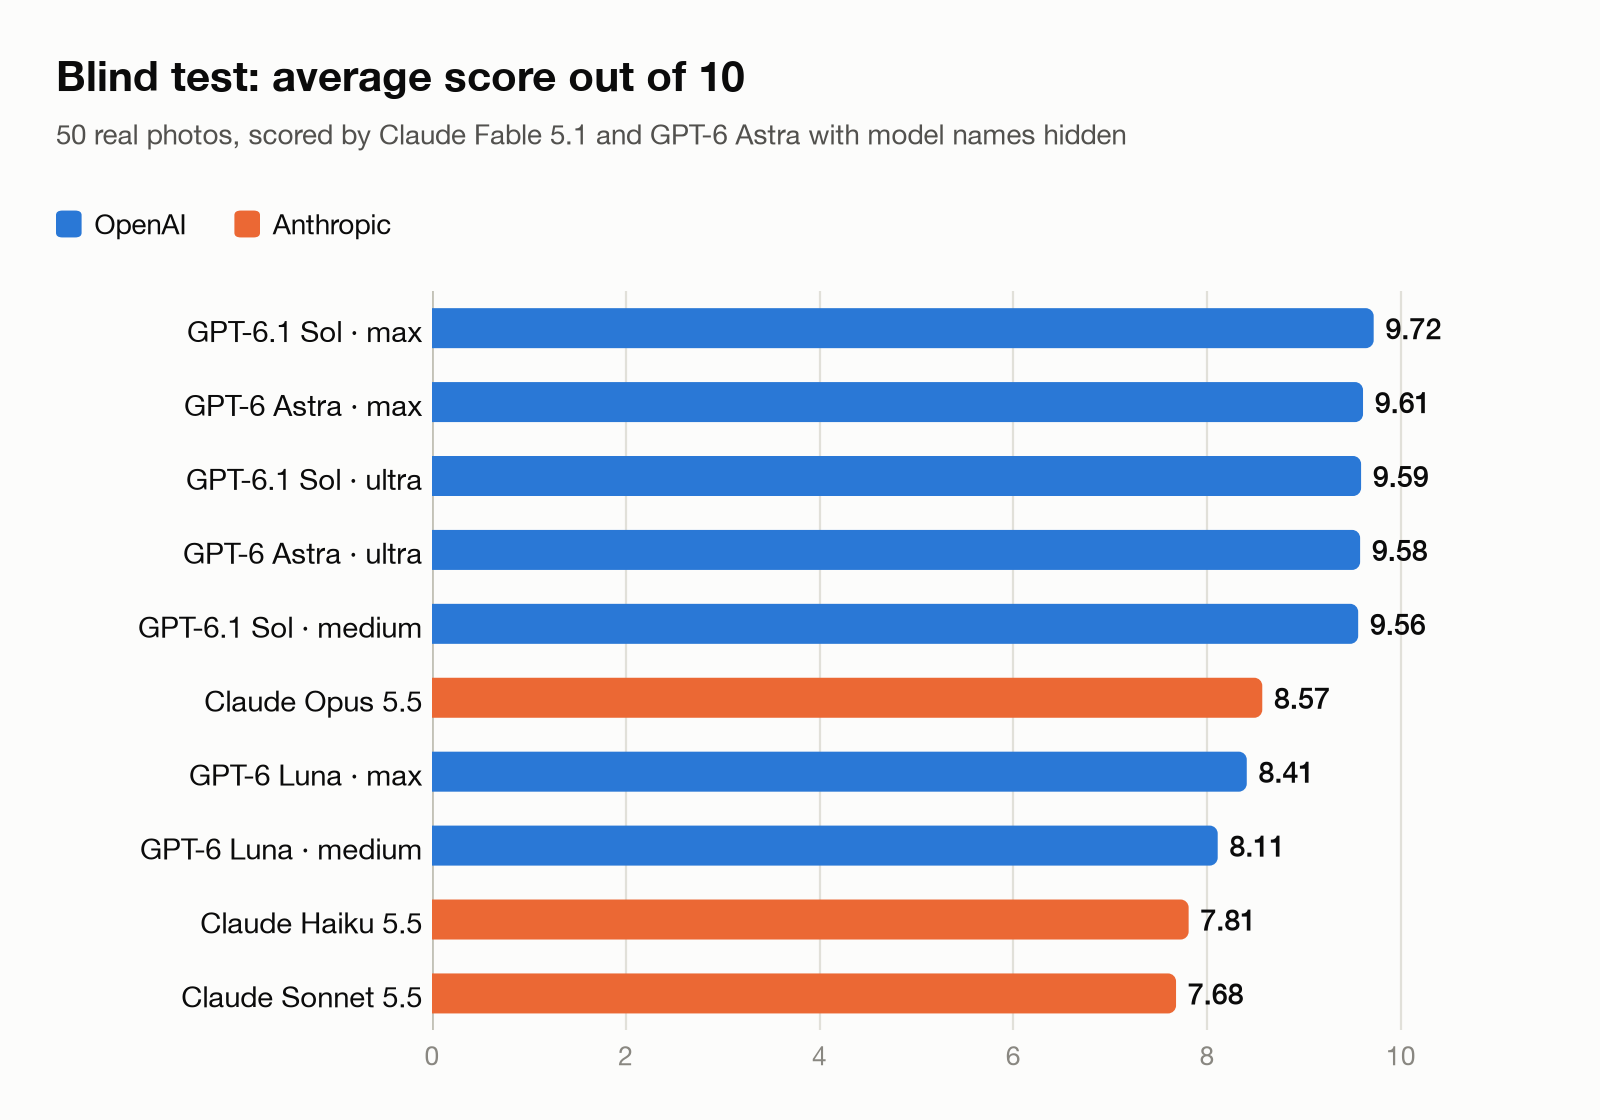 Figur 1. Gennemsnitsscore fra to blinde bedømmere, ud af 10.
| Rang | Model og indsats | Score (ud af 10) | Hele biblioteket, Batch API | Hele biblioteket, standard API |
|---|---|---|---|---|
| 1 | GPT-6.1 Sol, max | 9.72 | $563 | $1,126 |
| 2 | GPT-6 Astra, max | 9.61 | $2,987 | $5,973 |
| 3 | GPT-6.1 Sol, ultra | 9.59 | $468 | $937 |
| 4 | GPT-6 Astra, ultra | 9.58 | $2,156 | $4,313 |
| 5 | GPT-6.1 Sol, medium | 9.56 | $240 | $479 |
| 6 | Claude Opus 5.5 | 8.57 | $661 | $1,323 |
| 7 | GPT-6 Luna, max | 8.41 | $20 | $40 |
| 8 | GPT-6 Luna, medium | 8.11 | $11 | $22 |
| 9 | Claude Haiku 5.5 | 7.81 | $18 | $36 |
| 10 | Claude Sonnet 5.5 | 7.68 | $334 | $668 |
Omkostningen gælder alle 142,521 billeder til hver leverandørs officielle API-pris.
Hvad jeg ville bruge, baseret på denne test:
- Hvis jeg kun gik op i scoren, GPT-6.1 Sol på max-indsats.
- Til mit eget bibliotek, GPT-6.1 Sol på medium. Den fik 98% af topscoren for $240, omkring en tredjedel af, hvad Opus ville koste.
- På et stramt budget, GPT-6 Luna på max. For $20 slog den Haiku, som koster det samme pr. token, og Sonnet, som ville koste omkring 17 gange så meget for dette bibliotek.
- Ikke Claude Sonnet 5.5. Den er mellempris og havde den laveste score.
Modellerne
| Leverandør | Model | Testet indsats | Positionering |
|---|---|---|---|
| Anthropic | Claude Opus 5.5 | standard (medium) | Flagship til daglig brug |
| Anthropic | Claude Sonnet 5.5 | standard | Mellemlag |
| Anthropic | Claude Haiku 5.5 | standard | Hurtig, lav pris |
| OpenAI | GPT-6 Astra | max, ultra | Frontmodel |
| OpenAI | GPT-6.1 Sol | medium, max, ultra | Arbejdshest |
| OpenAI | GPT-6 Luna | medium, max | Hurtig, lav pris |
Priserne ligger på linje mellem de to leverandører. GPT-6.1 Sol koster det samme pr. token som Claude Sonnet 5.5, GPT-6 Astra det samme som Claude Fable 5.1, og GPT-6 Luna det samme som Claude Haiku 5.5. Claude Opus 5.5 ligger mellem Sol og Astra. Så når to modeller nedenfor ender med forskellige omkostninger, er det mest fordi en af dem brugte flere tokens på det samme job.
Claude-modellerne kørte én gang hver med deres standardindstillinger, hvilket for Opus betyder medium indsats. GPT-modellerne testede jeg på flere indsatsniveauer. Den nærmeste retfærdige sammenligning er GPT-6.1 Sol på medium mod Claude Opus 5.5 på medium: 9.56 mod 8.57.
Testen
Jeg brugte de 50 nyeste billeder i mit bibliotek på det tidspunkt, uden videoer. Det er en almindelig uge fra min kamerarulle: familiestunder hjemme og på indkøbstur, byudsigt fra en høj etage, et hukommelseskort på mit skrivebord, produktbilleder af elektroniske komponenter, skærmbilleder af ordresporing, et opslag på sociale medier, et QR-skilt for parkeringsrabat og en etiket på en elbiloplader.
Hver model havde fem opgaver for hvert billede. Den skrev en kort titel og en billedtekst på én til tre sætninger på kinesisk, gav 5 til 12 nøgleord på kinesisk og engelsk og valgte det bedste album blandt mine eksisterende albummer, eller intet. Derefter gav den en kvalitetsscore og sagde, om billedet skulle beholdes eller slettes, på udkig efter dubletter, mislykkede billeder, udløbne skærmbilleder og billeder uden varig værdi. Hver model fik de samme instruktioner og den samme kontekst for hvert billede, ti billeder ad gangen.
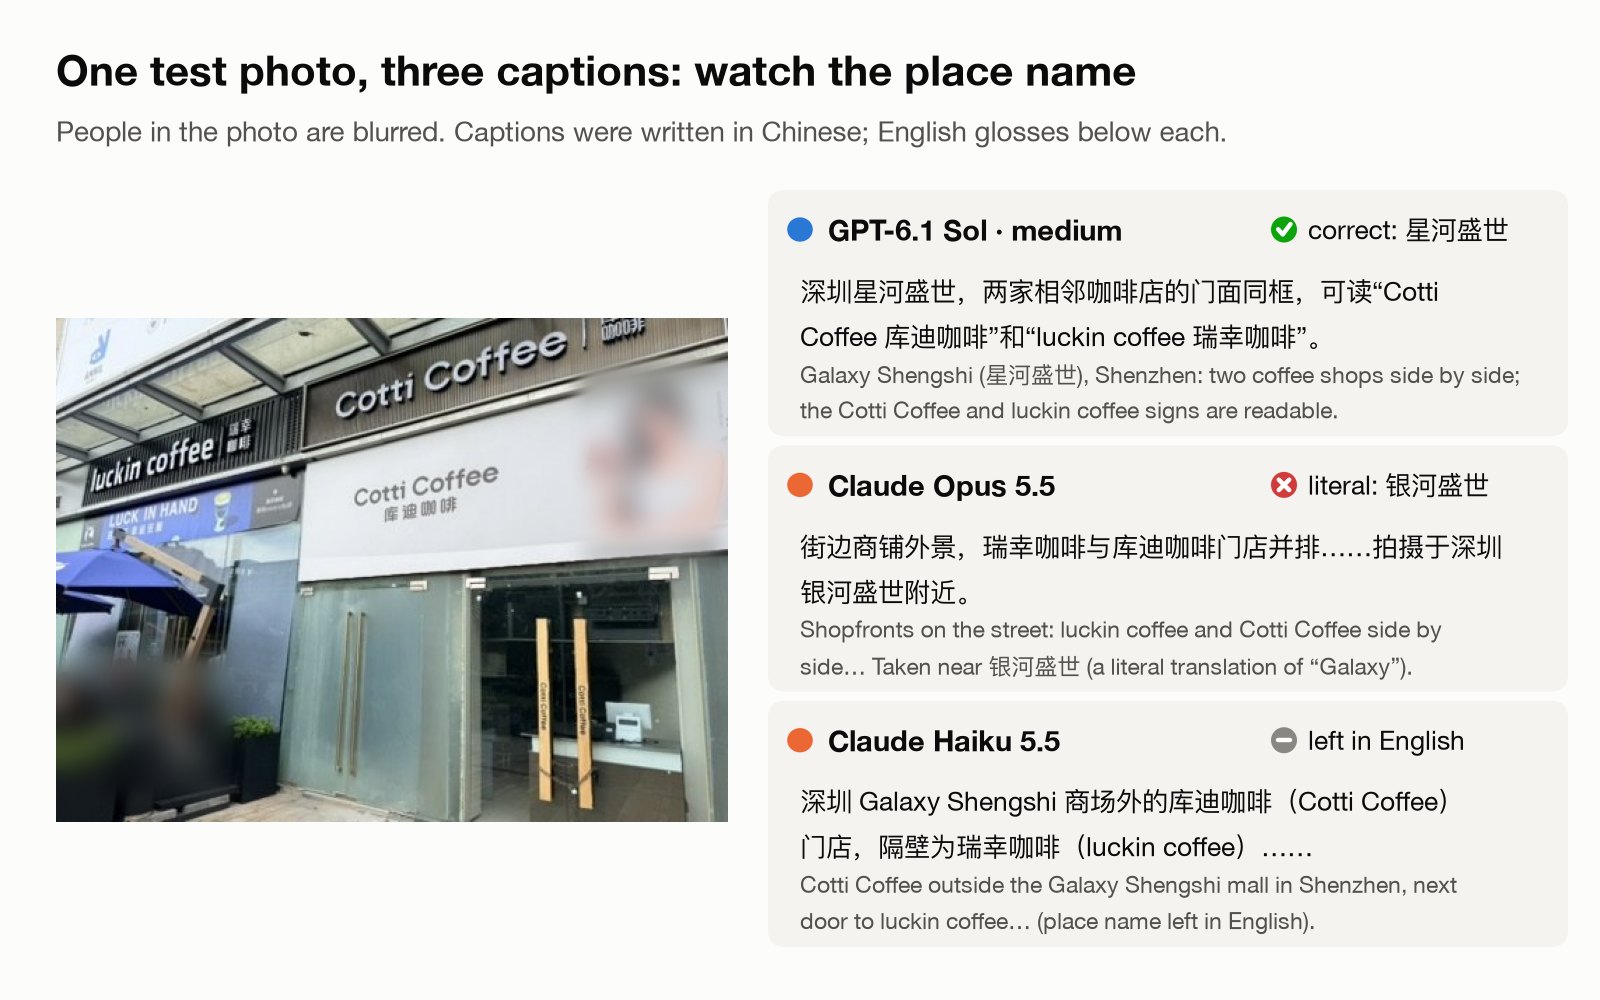 Figur 2. Et af de 50 testbilleder, med tre af billedteksterne. Læg mærke til, hvordan hver model håndterer stednavnet; jeg vender tilbage til det nedenfor. Personer på billedet er slørede.
Hvordan jeg bedømte
Jeg bedømte ikke svarene selv. Jeg havde allerede valgt en vinder før testen, og jeg bruger Claude hver dag, så jeg var ikke neutral.
I stedet blandede jeg hvert billedes ti svar og mærkede dem A til J med en ny tilfældig rækkefølge for hvert billede. To bedømmere scorede derefter alle 500 svar uafhængigt, mens de så på billederne. Den ene var Claude Fable 5.1, Anthropics mest kapable model. Den anden var GPT-6 Astra på xhigh-indsats, OpenAIs frontmodel.
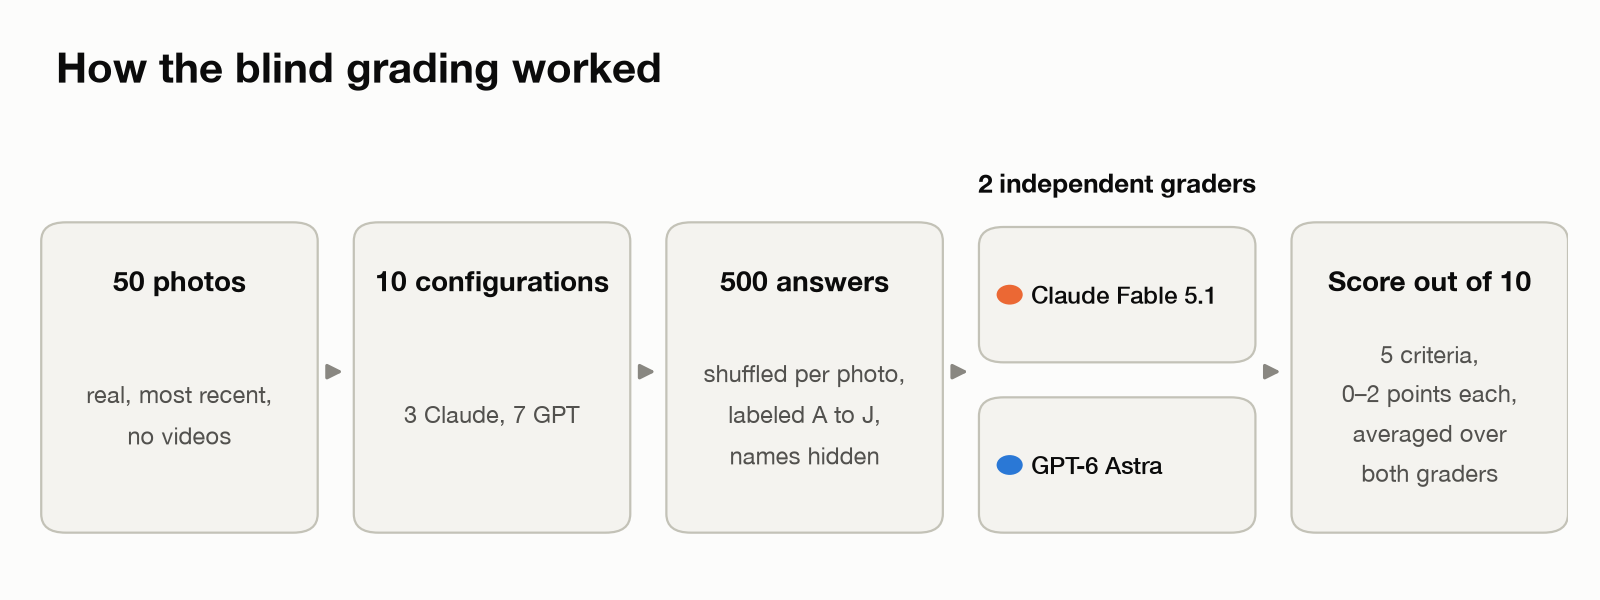 Figur 3. Hvordan den blinde bedømmelse fungerede.
Hvert svar blev scoret på fem kriterier, 0 til 2 point hver, i alt 10:
| Kriterium | Hvad bedømmeren kontrollerede |
|---|---|
| Fakta | Er motiv, sted og al læsbar tekst korrekt, inklusive lokale stednavne? |
| Ingen opdigtede detaljer | Undgår svaret at påstå noget, billedet ikke viser? |
| Slettevurdering | Er behold eller slet rimeligt? At slette et godt billede giver 0. |
| Albumpasning | Er albummet rigtigt? Et forkert gammelt album giver 0; intet album er en acceptabel 1. |
| Nytteværdi | Ville titel, billedtekst og nøgleord hjælpe mig med at finde og huske dette billede senere? |
Jeg valgte én bedømmer fra hver leverandør for at se, om nogen af dem ville favorisere sine egne modeller. De var for det meste enige. Korrelationen over de 500 parrede scorer var 0.71, og begge satte de samme fem GPT-konfigurationer øverst. Claude-bedømmeren rangerede også GPT-6.1 Sol og GPT-6 Astra over Claude Opus. GPT-bedømmeren var generelt strengere, og strengest over for Claude-modellerne.
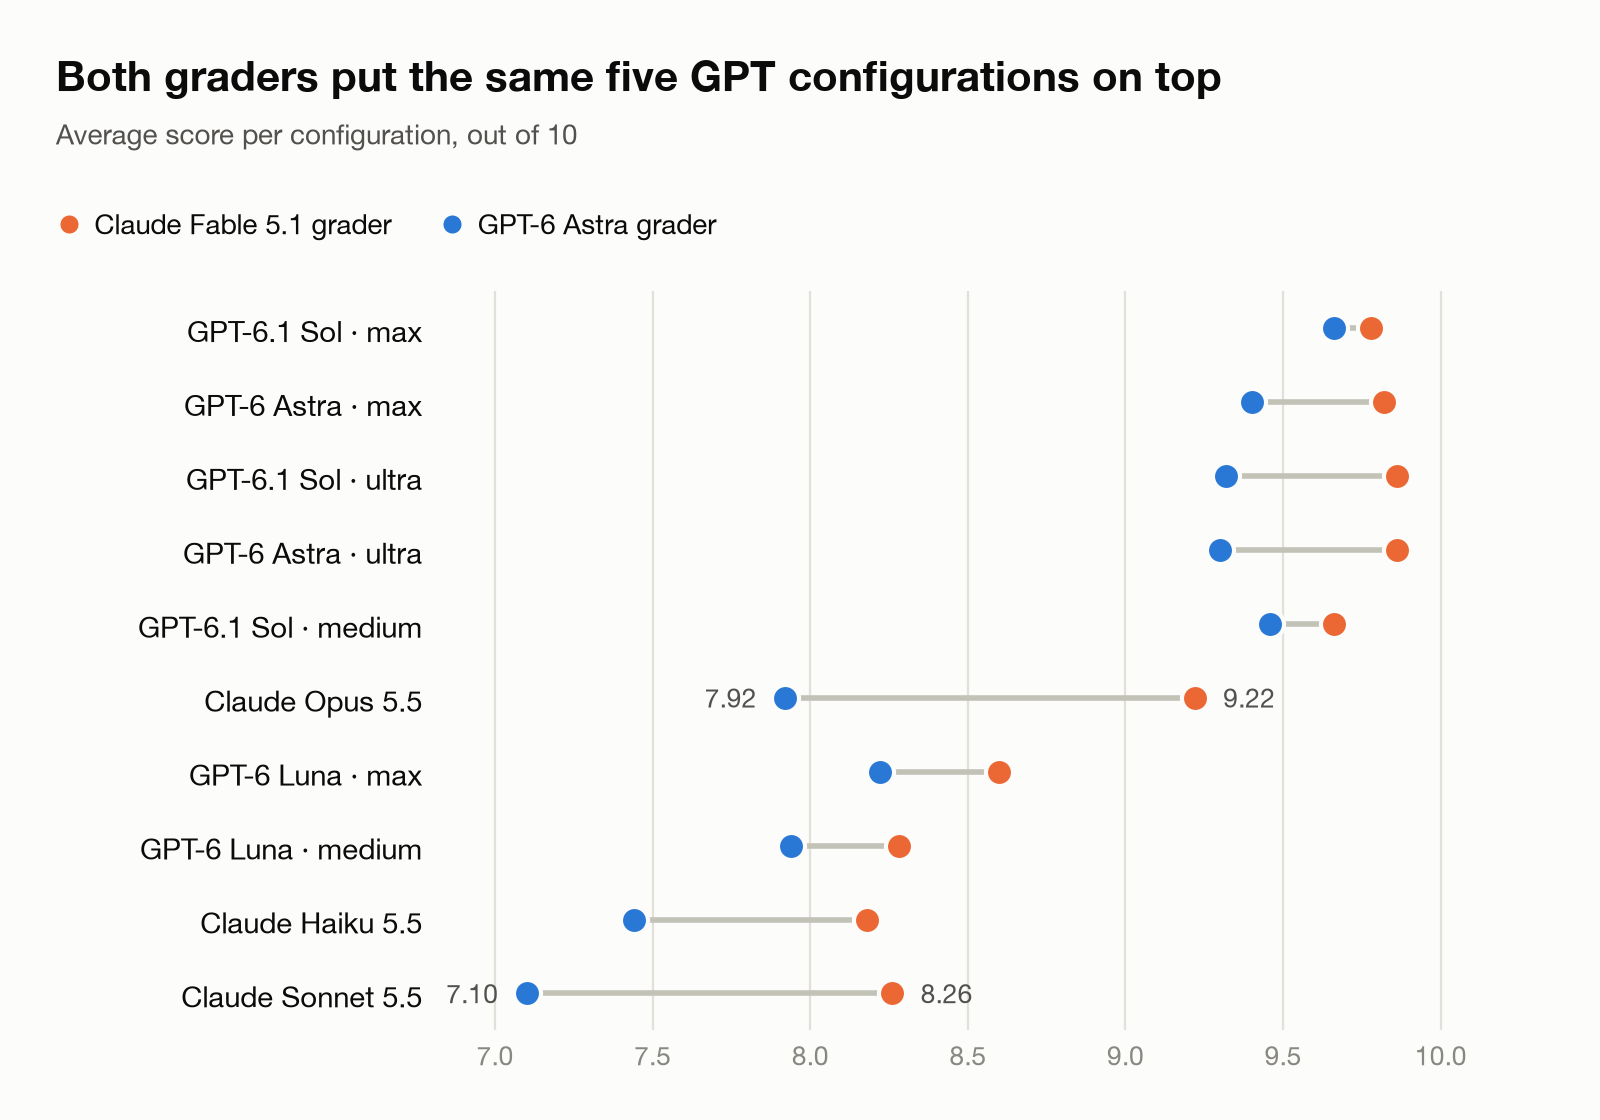 Figur 4. Hver bedømmers gennemsnitsscore pr. konfiguration.
Resultater
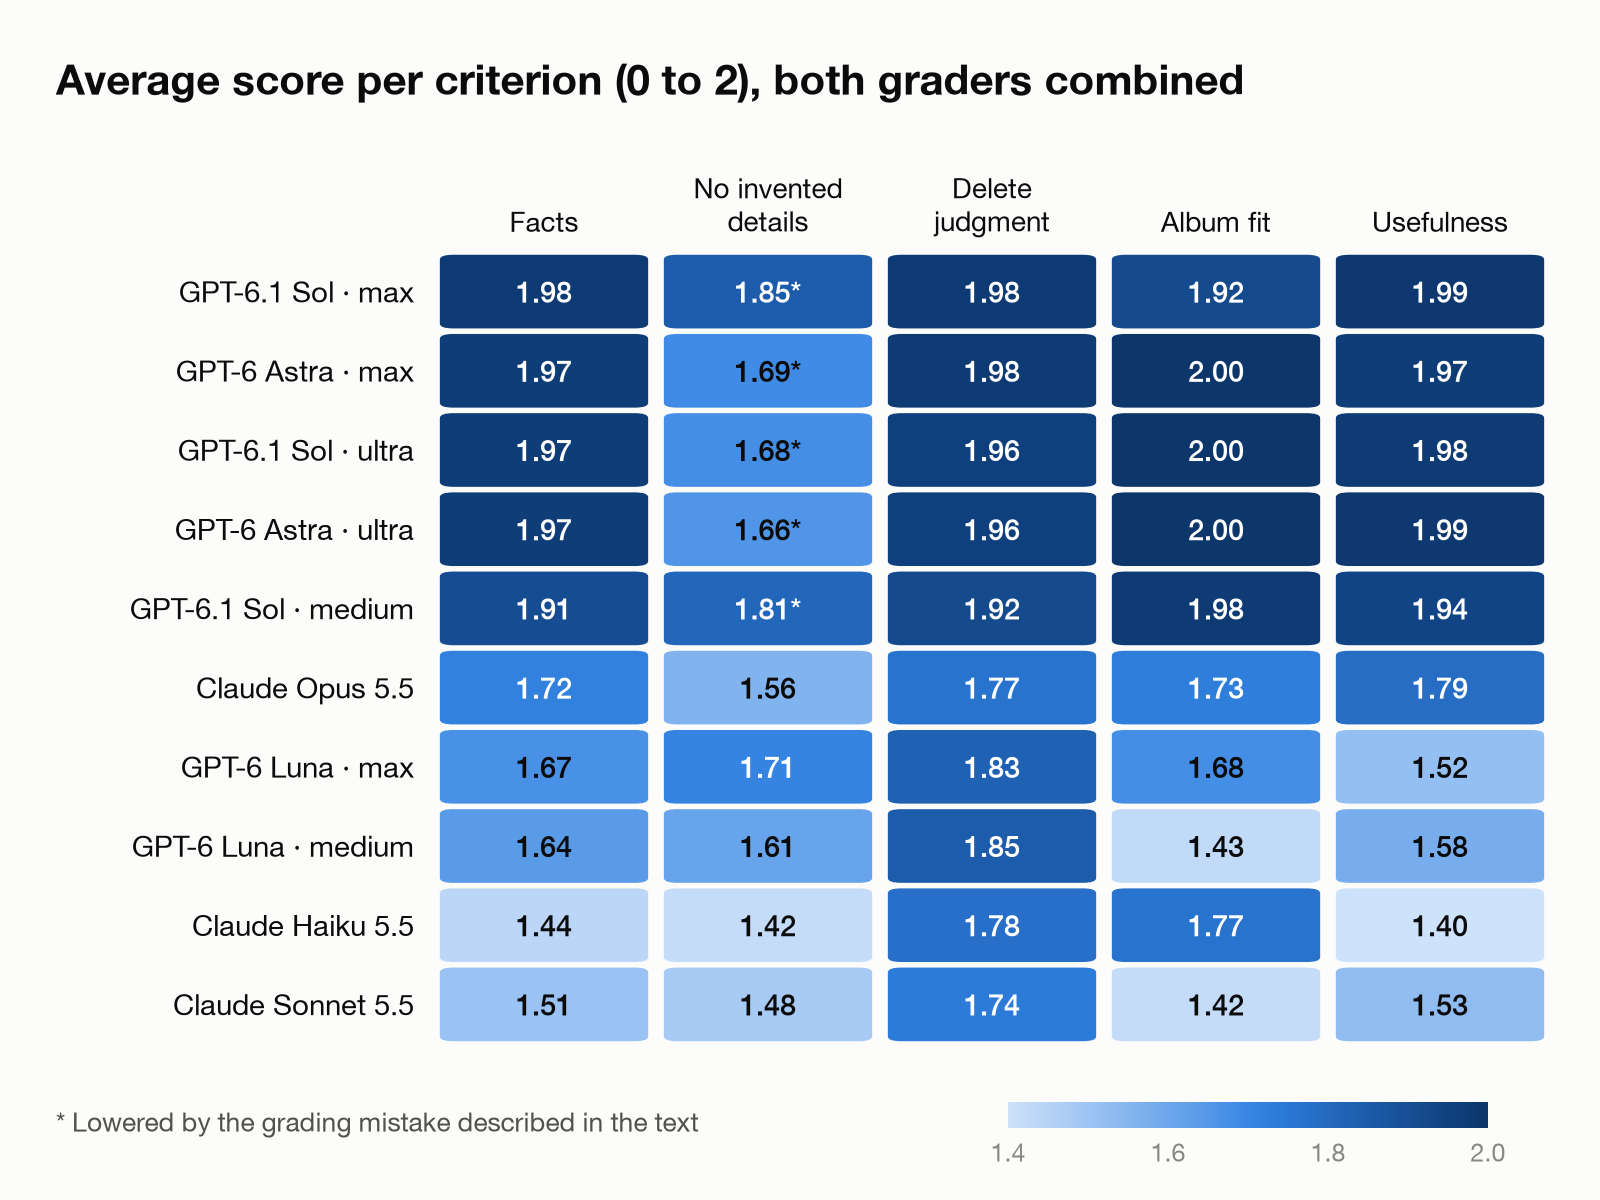 Figur 5. Gennemsnitsscore pr. kriterium, begge bedømmere lagt sammen. En stjerne markerer scorer, der er sænket af den bedømmelsesfejl, jeg beskriver nedenfor.
GPT-6.1 Sol og GPT-6 Astra
Sol og Astra læste teksten præcist og begrænsede for det meste deres billedtekster til det, billederne viste. De var også bedst til lokale stednavne, hvilket betyder noget for billeder taget i Kina.
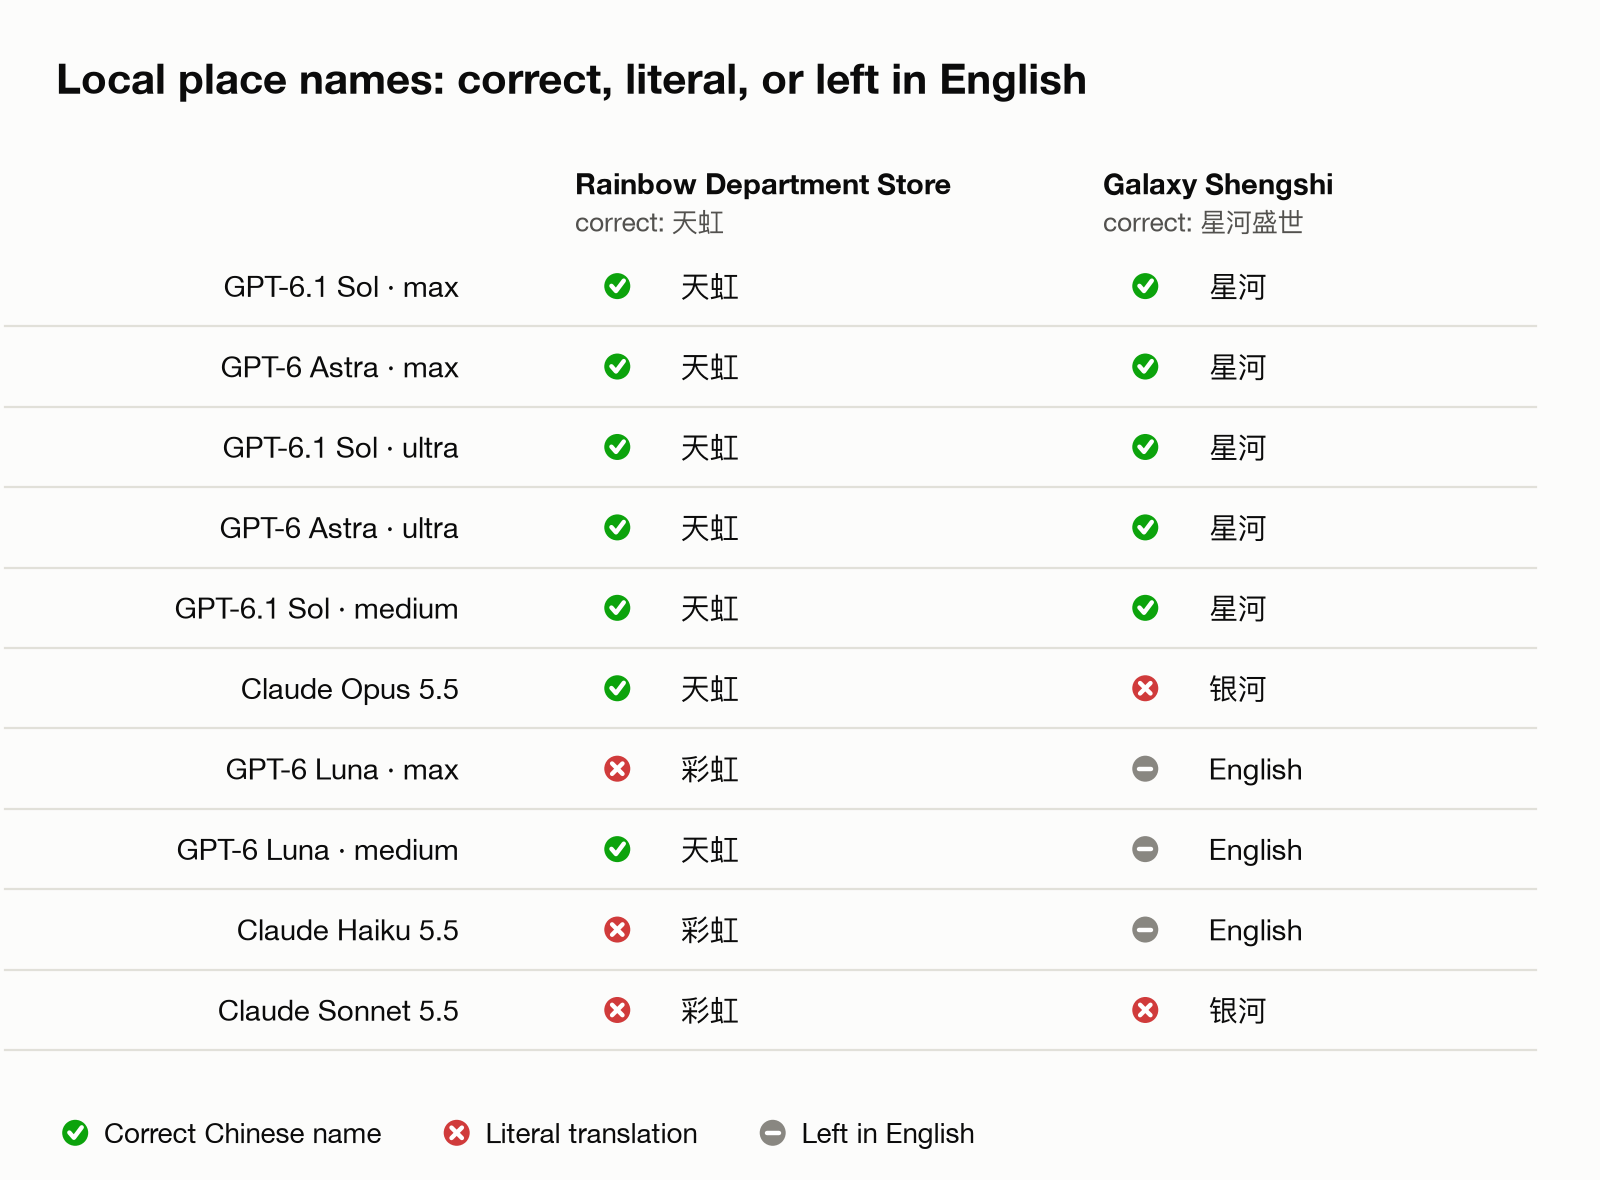 Figur 6. To tests med lokale navne. Et flueben betyder det korrekte kinesiske navn, et kryds en bogstavelig oversættelse, og EN betyder, at navnet blev efterladt på engelsk.
Flere billeder blev tagget med stedet «Rainbow Department Store». Det er det engelske navn på varehuskæden i Shenzhen 天虹. En ord-for-ord-oversættelse giver 彩虹百货, hvilket er forkert. Hver Sol- og Astra-konfiguration fik dette rigtigt, og det samme gjorde Opus og Luna på medium. Haiku, Sonnet og Luna på max brugte den bogstavelige oversættelse. Kaffebarbilledet i figur 2 blev tagget som «Galaxy Shengshi», hvis kinesiske navn er 星河盛世. Hver Sol- og Astra-konfiguration skrev 星河. Opus og Sonnet oversatte det bogstaveligt som 银河, og Haiku og begge Luna-konfigurationer efterlod det på engelsk.
Sol og Astra var også forsigtige med at slette. De foreslog at slette 4 til 6 af de 50 billeder. Sættet indeholdt otte produktbilleder af elektroniske komponenter, og GPT-modellerne beholdt næsten alle; én Sol-konfiguration flagrede et enkelt skærmbillede som næsten-dublet. Claude-modellerne flagrede to til fire hver. Begge bedømmere holdt med om at beholde dem, da siderne indeholdt pinouts, mål og kortbilleder, jeg gerne ville slå op senere.
Claude Opus 5.5
Opus skrev nogle gange ting ind i en billedtekst, som billedet alene ikke kan vise. Den beskrev relationer, som billedet alene ikke kan bevise, som søskende eller forælder og barn. Den tog også fejl af nogle stillinger. På ét billede stod et barn bag en voksen, og Opus skrev, at barnet sad på den voksnes ryg. Begge bedømmere trak point for dette.
Det overraskede mig. Før blindtesten havde jeg kigget svarene igennem og rost Opus for korrekt at gætte, at to børn var søskende. Jeg kender min familie; det gør bedømmeren ikke. Men med 142,000 billeder kan jeg ikke tjekke hver billedtekst selv, og en billedtekst, der påstår noget, billedet ikke viser, er et problem.
Opus foreslog også flest sletninger, 13 af de 50 billeder. Tre af dem var produktbilleder, som den kaldte udløbne, selvom de indeholdt referenceinformation, jeg ville beholde. Den var den eneste model, der ville slette QR-skiltet for parkeringsrabat som værdiløst. Den lagde også flere billeder af en enkelt person i et album for «familieportræt».
Claude Sonnet 5.5 og Haiku 5.5
Disse to lavede flest faktuelle fejl, herunder den bogstavelige oversættelse 彩虹. Sonnet lavede de svageste albumvalg og arkiverede hverdagsbilleder i et gammelt album fra en urelateret begivenhed. Haiku opdigtede en detalje, der førte til en dårlig slettevurdering. I en serie næsten identiske billeder beskrev den det bedste billede som én, der kigger ned, hvilket er det modsatte af, hvad billedet viser, og foreslog at slette det.
GPT-6 Luna
Luna koster det samme pr. token som Haiku, men scorede højere på begge indsatsniveauer: 8.41 og 8.11 mod Haikus 7.81. På max-indsats slog den også Sonnet, som ville koste omkring 17 gange så meget at beskrive det samme bibliotek. Luna tabte flest point på nytteværdi og albumvalg. Dens billedtekster var mere flade og dens albummer mindre præcise.
Indsatsniveauer
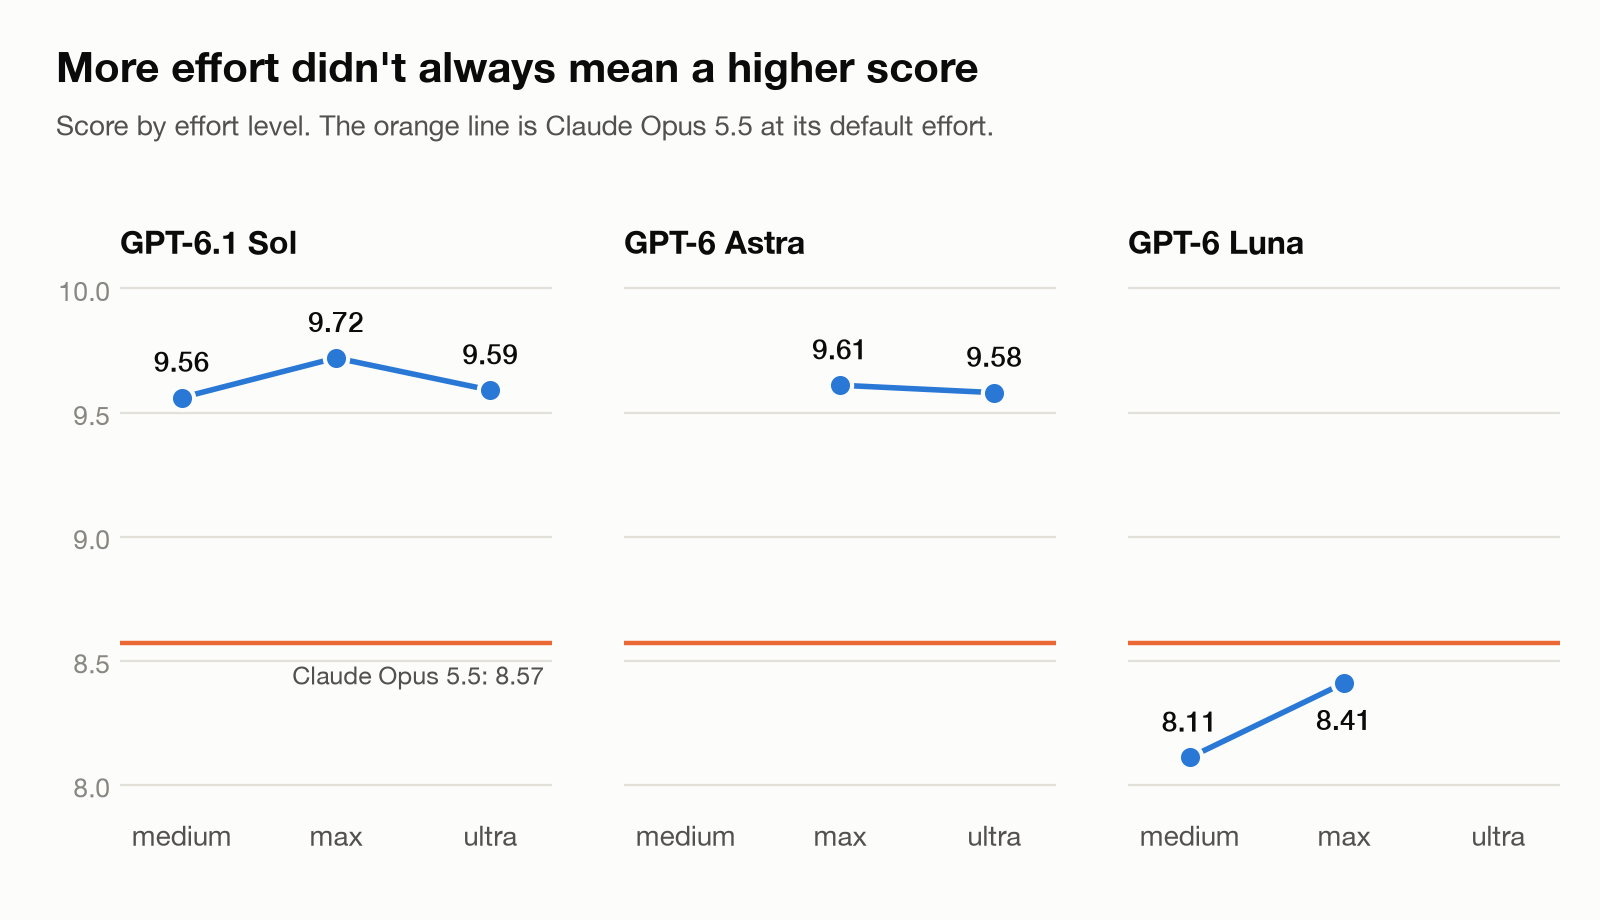 Figur 7. Score pr. indsatsniveau. Den orange linje er Claude Opus 5.5 på dens standardindsats.
Ultra var ikke bedre end max for nogen af modellerne. Sol scorede 9.59 på ultra og 9.72 på max; Astra scorede 9.58 og 9.61. I denne test producerede ultra endda færre output-tokens end max. For Sol kom medium tæt på med 9.56, for under halvdelen af omkostningen ved max. Højere indsats betød heller ikke altid mere præcise detaljer: Luna på medium fik 天虹 rigtigt, og Luna på max gjorde det ikke.
En fejl i min bedømmelse
Efter bedømmelsen lagde jeg mærke til, at bedømmerne ikke havde fået hvert billedes optagelsesdato og -tidspunkt, selvom beskrivelsesmodellerne havde fået det. Så GPT-6 Astra-bedømmeren behandlede billedtekster, der nævnte den nøjagtige dato eller tid, som opdigtede detaljer. De bedste GPT-konfigurationer nævnte datoen oftest, så deres scorer på «ingen opdigtede detaljer» kom lavere ud, end de burde.
Hvis jeg kun giver de point tilbage, der gik tabt over datoer, stiger de fire bedste GPT-konfigurationer til mellem 9.84 og 9.90, hvilket i praksis er uafgjort, og Opus bliver stående på 8.58. Jeg har beholdt de oprindelige scorer i dette indlæg. Næste gang giver jeg bedømmerne alt, hvad modellerne så.
Hastighed
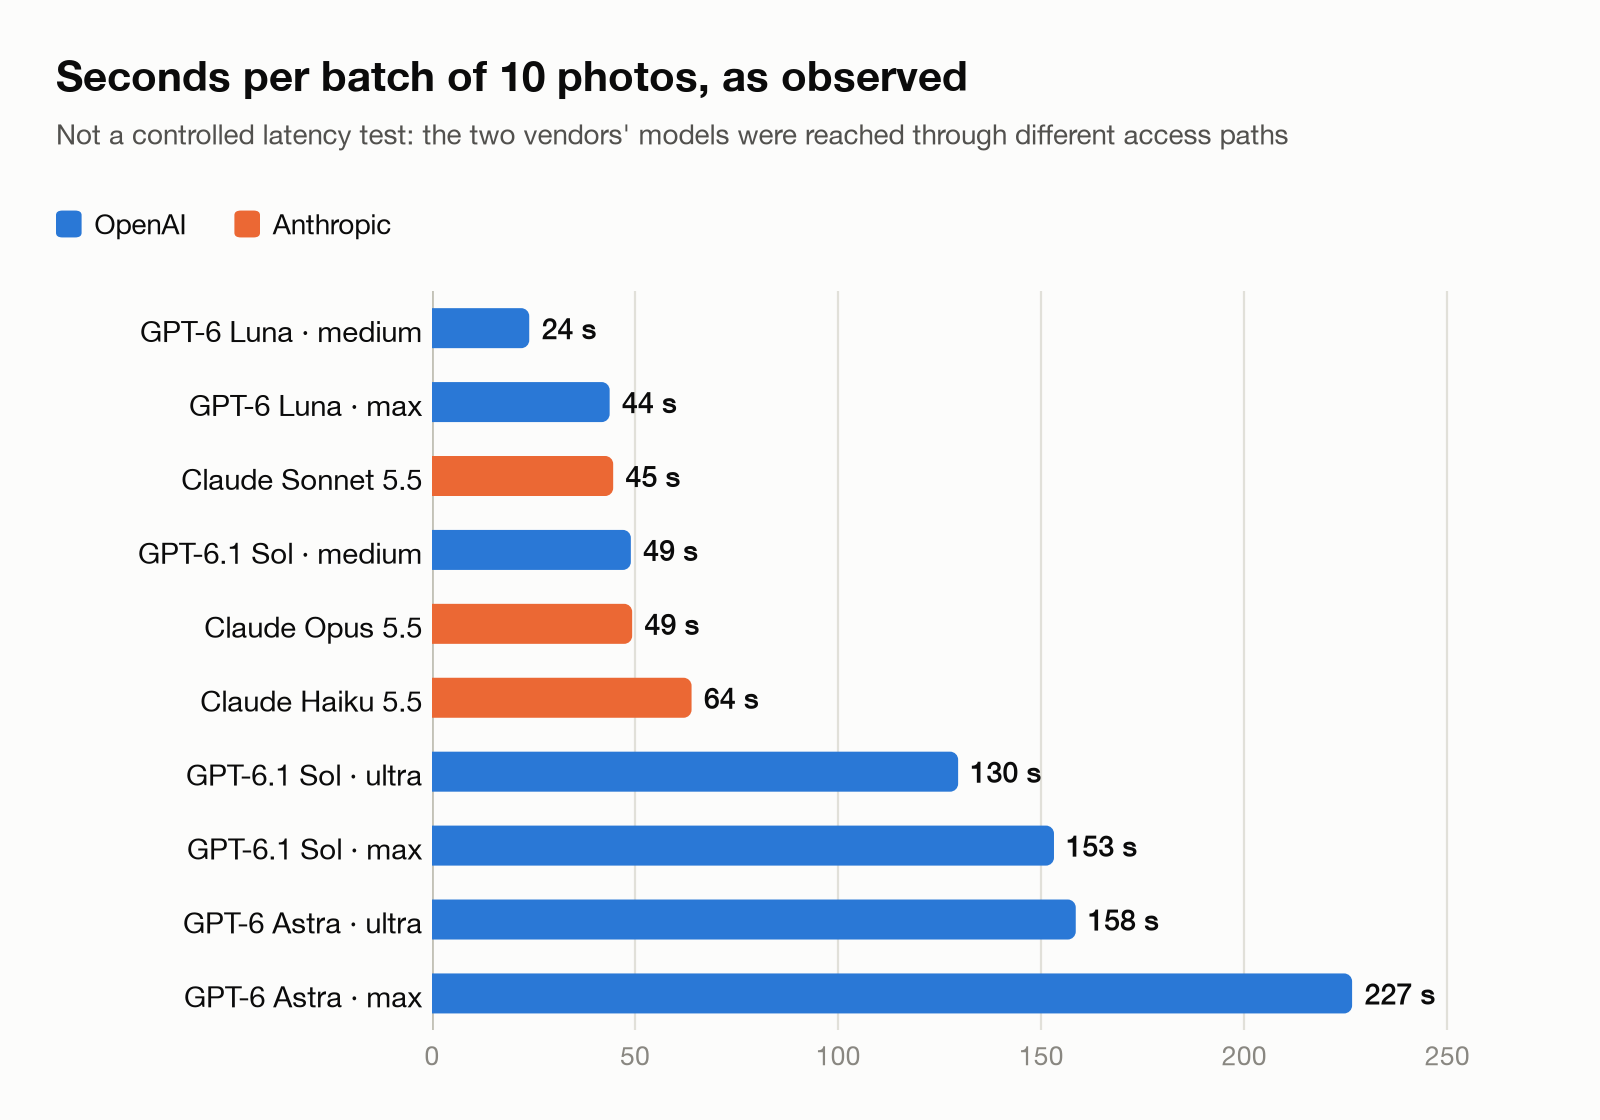 Figur 8. Sekunder pr. batch på 10 billeder, som observeret. Dette er ikke en kontrolleret latenstest, fordi de to leverandørers modeller blev nået gennem forskellige adgangsveje.
Det stemmer med, hvordan Opus føles i mit daglige arbejde: den er hurtig, omkring tre gange hurtigere end Sol på max. Sol på medium var dog lige så hurtig som Opus og scorede omkring ét point højere.
Hvad det koster
Jeg prissatte hver konfiguration til leverandørernes officielle API-priser. At behandle et abonnements inkluderede forbrug som gratis ville få nogle modeller til at se bedre ud, end de er.
Officielle priser pr. million tokens, standardniveau:
| Model | Input | Output |
|---|---|---|
| Claude Opus 5.5 | $4.00 | $20.00 |
| Claude Sonnet 5.5 | $2.00 | $10.00 |
| Claude Haiku 5.5 | $0.10 | $0.50 |
| GPT-6 Astra | $10.00 | $50.00 |
| GPT-6.1 Sol | $2.00 | $10.00 |
| GPT-6 Luna | $0.10 | $0.50 |
Begge leverandørers Batch API'er koster 50% mindre, hvilket passer til et job som dette, der ikke kræver øjeblikkelige svar. Jeg tog priserne fra Anthropics prisside (claude.com/pricing) og OpenAIs API-prisside (developers.openai.com/api/docs/pricing) den 20. oktober 2026.
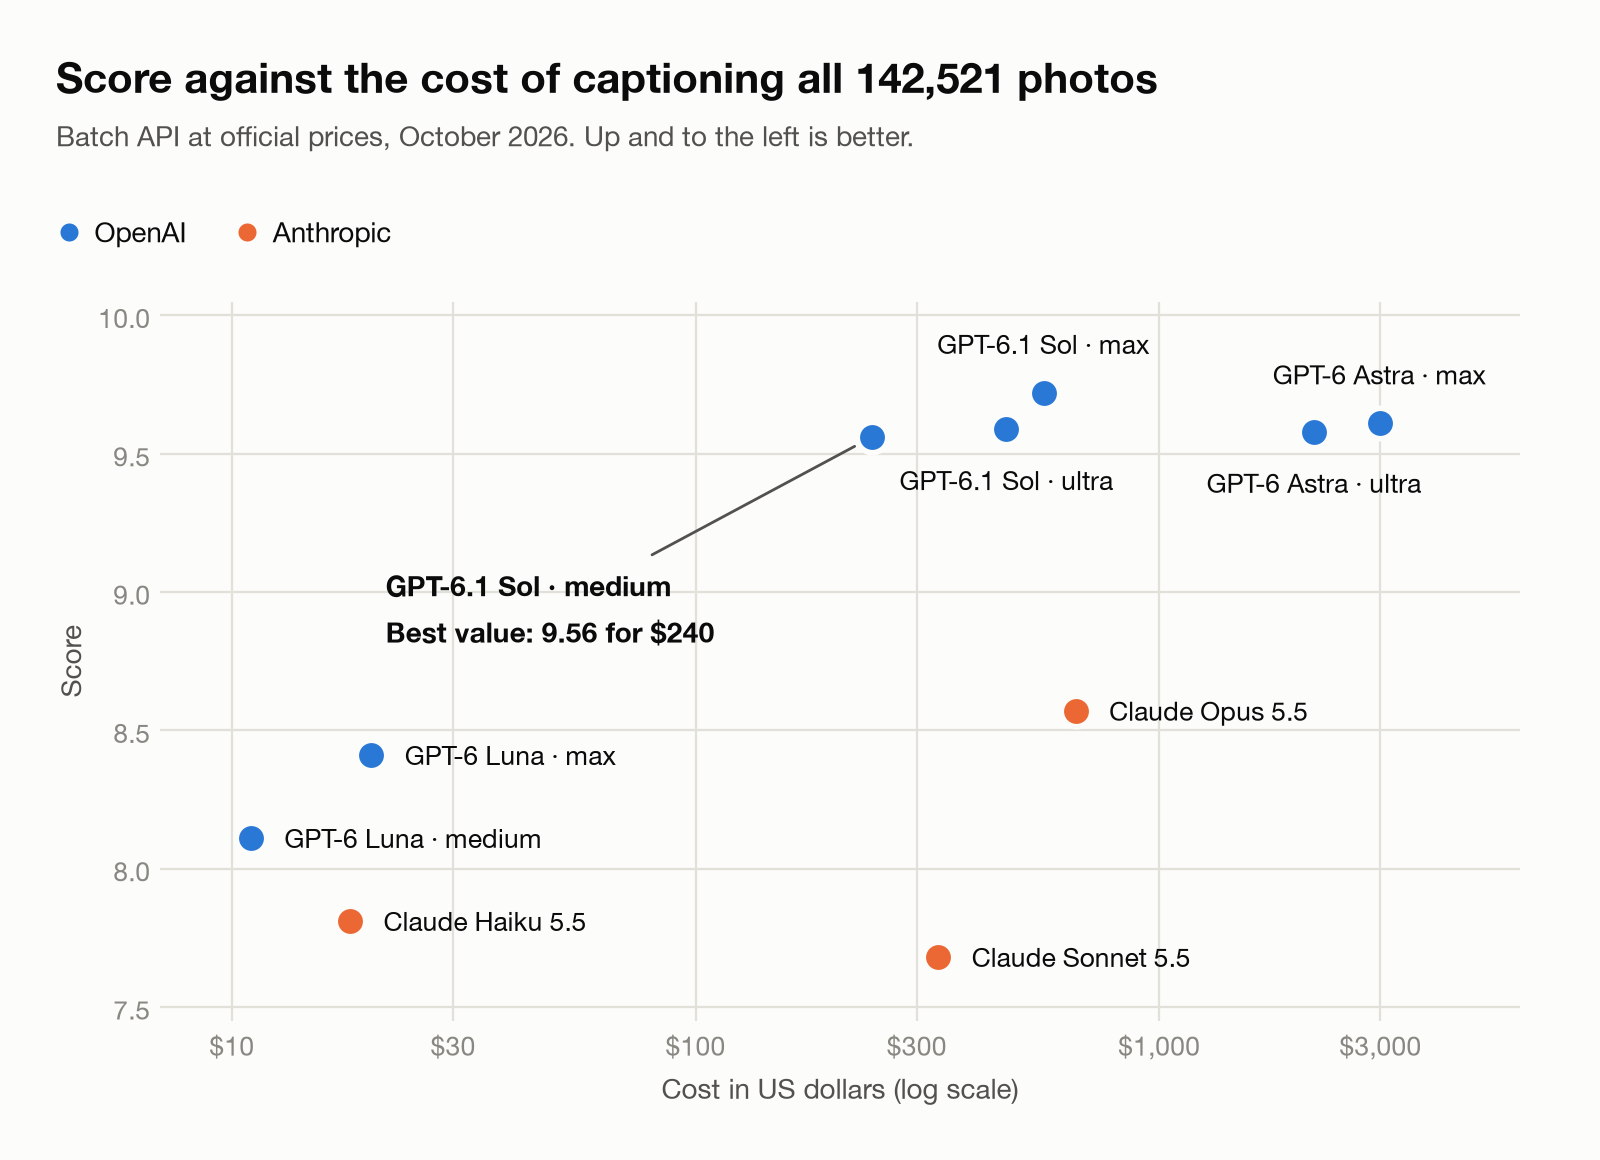 Figur 9. Score mod omkostningen ved at beskrive hele biblioteket til Batch-priser. Omkostningsaksen er logaritmisk.
| Model og indsats | Output-tokens pr. billede | Standard | Batch | Score |
|---|---|---|---|---|
| GPT-6.1 Sol, medium | 193 | $479 | $240 | 9.56 |
| GPT-6.1 Sol, ultra | 514 | $937 | $468 | 9.59 |
| GPT-6.1 Sol, max | 647 | $1,126 | $563 | 9.72 |
| Claude Opus 5.5 | ~292 | $1,323 | $661 | 8.57 |
| Claude Sonnet 5.5 | ~297 | $668 | $334 | 7.68 |
| GPT-6 Astra, ultra | 462 | $4,313 | $2,156 | 9.58 |
| GPT-6 Astra, max | 695 | $5,973 | $2,987 | 9.61 |
| GPT-6 Luna, medium | 163 | $22 | $11 | 8.11 |
| Claude Haiku 5.5 | ~330 | $36 | $18 | 7.81 |
| GPT-6 Luna, max | 419 | $40 | $20 | 8.41 |
Sol på medium fik 98% af topscoren for 36% af, hvad Opus ville koste, og 43% af Sol på max. Astra matchede Sols kvalitet, men koster omkring fem gange så meget, fordi dens pris pr. token er fem gange højere. Opus kostede mere end Sol på max og scorede lavere. Den kørte allerede på medium indsats, men dens pris pr. token er det dobbelte af Sols. Luna ville beskrive hele biblioteket for $11 til $20 og stadig slå Haiku og Sonnet.
Metodenote: GPT-tokenantal blev målt fra kørslerne, og Claude-tokenantal blev estimeret fra kørselsloggene. Nogle Claude-ræsonnementstokens var ikke synlige, så Claude-omkostningerne kan være en smule undervurderede. Ingen rabatter ud over Batch, såsom prompt-cache, blev anvendt på nogen model.
Hvad jeg lærte
Jeg valgte Opus, før jeg havde nogen blinde scorer, mest fordi den allerede var mit standardvalg til kode. Jeg foretrækker stadig Claude Opus 5.5 til kode og arbejdsgange, hvor den er hurtigere og stærkere efter min erfaring. At beskrive rigtige billeder kræver en anden færdighed: at læse, hvad der faktisk er i billedet, uden at udfylde stillinger eller relationer. GPT-6.1 Sol gjorde det bedre. Hvis jeg var gået på vane og havde sprunget blindtesten over, ville jeg have betalt mere for dårligere billedtekster.
Næste gang starter jeg blindt og giver bedømmere fra forskellige leverandører alle de input, beskrivelsesmodellerne fik. Jeg fortsætter også med at sammenligne til officielle API-priser, og jeg antager ikke, at mere indsats er bedre: ultra slog ikke max her.
Selv de bedste modeller flagrede nyttige billeder til sletning, så jeg tjekker hvert sletteflag selv, før jeg fjerner noget.
Begrænsninger
Dette var en lille test: 50 ferske billeder fra én by. Jeg testede ikke ældre billeder, scannede dokumenter, andre sprog eller videoer. Claude-modellerne kørte kun med deres standardindstillinger; en Opus med højere indsats kunne score bedre, til en højere omkostning. Bedømmerne er AI-modeller, ikke mennesker. De var godt enige, men ikke perfekt, og en menneskelig stikprøve ville gøre resultatet stærkere. Modeller og priser ændrer sig hurtigt, og hvert tal her er pr. oktober 2026.
Mit valg
Til mit bibliotek: GPT-6.1 Sol på medium indsats. Til kode og arbejdsgange holder jeg fast ved Claude Opus 5.5.