
Testei às cegas 10 modelos de IA na minha biblioteca de 142 mil fotos: o GPT-6.1 Sol superou o Claude Opus
Resumo
Uso o Claude Opus 5.5 todos os dias para programar e para fluxos de trabalho, e nesse trabalho o acho mais rápido e melhor que o GPT-6. Presumi que ele também seria o melhor para descrever fotos, então o testei. Executei dez configurações: Claude Haiku, Sonnet e Opus 5.5, além do GPT-6.1 Sol, GPT-6 Astra e GPT-6 Luna da OpenAI em vários níveis de esforço. Cada uma titulou, legendou, marcou e arquivou 50 fotos reais da minha biblioteca de 142.521 fotos, e sinalizou as que achava que eu deveria excluir. Dois avaliadores cegos de fornecedores diferentes, Claude Fable 5.1 e GPT-6 Astra, pontuaram as 500 respostas em fatos, detalhes inventados, julgamento de exclusão, adequação ao álbum e utilidade. O GPT-6.1 Sol obteve a maior pontuação, 9,72 de 10. O Opus obteve 8,57, e o Sonnet e o Haiku ficaram entre 7,7 e 7,8. O esforço ultra não foi melhor que o max. Aos preços oficiais da Batch API, legendar toda a biblioteca custaria cerca de US$ 240 com o Sol em esforço medium (9,56), US$ 661 com o Opus, e de US$ 11 a US$ 20 com o Luna, que ainda assim superou o Haiku.
Por que testei isso
A maior parte do meu dia é dedicada a programar, a fluxos de trabalho com agentes e à automação, e o Claude Opus 5.5 é o modelo ao qual recorro. Para esse tipo de trabalho, ele me pareceu mais rápido e melhor que o GPT-6. Então, quando decidi fazer uma IA legendar e marcar minha biblioteca de fotos, escolhi o Opus sem pensar duas vezes.
A biblioteca são 25 anos da minha vida: 142.521 fotos, das primeiras fotos de câmera digital às fotos de celular da semana passada, além de mais de 16.000 capturas de tela. Quase nenhuma delas tem legenda. Quero que cada foto tenha um título, uma legenda, palavras-chave que eu possa pesquisar, um álbum sensato e uma marcação honesta quando for duplicata ou lixo. Antes de pagar para processar 142.000 fotos, eu queria saber qual modelo faz isso melhor e quanto custa a diferença.
Eu esperava que o Opus vencesse. Nessas 50 fotos, o GPT-6.1 Sol marcou mais de um ponto a mais.
Resultados de relance
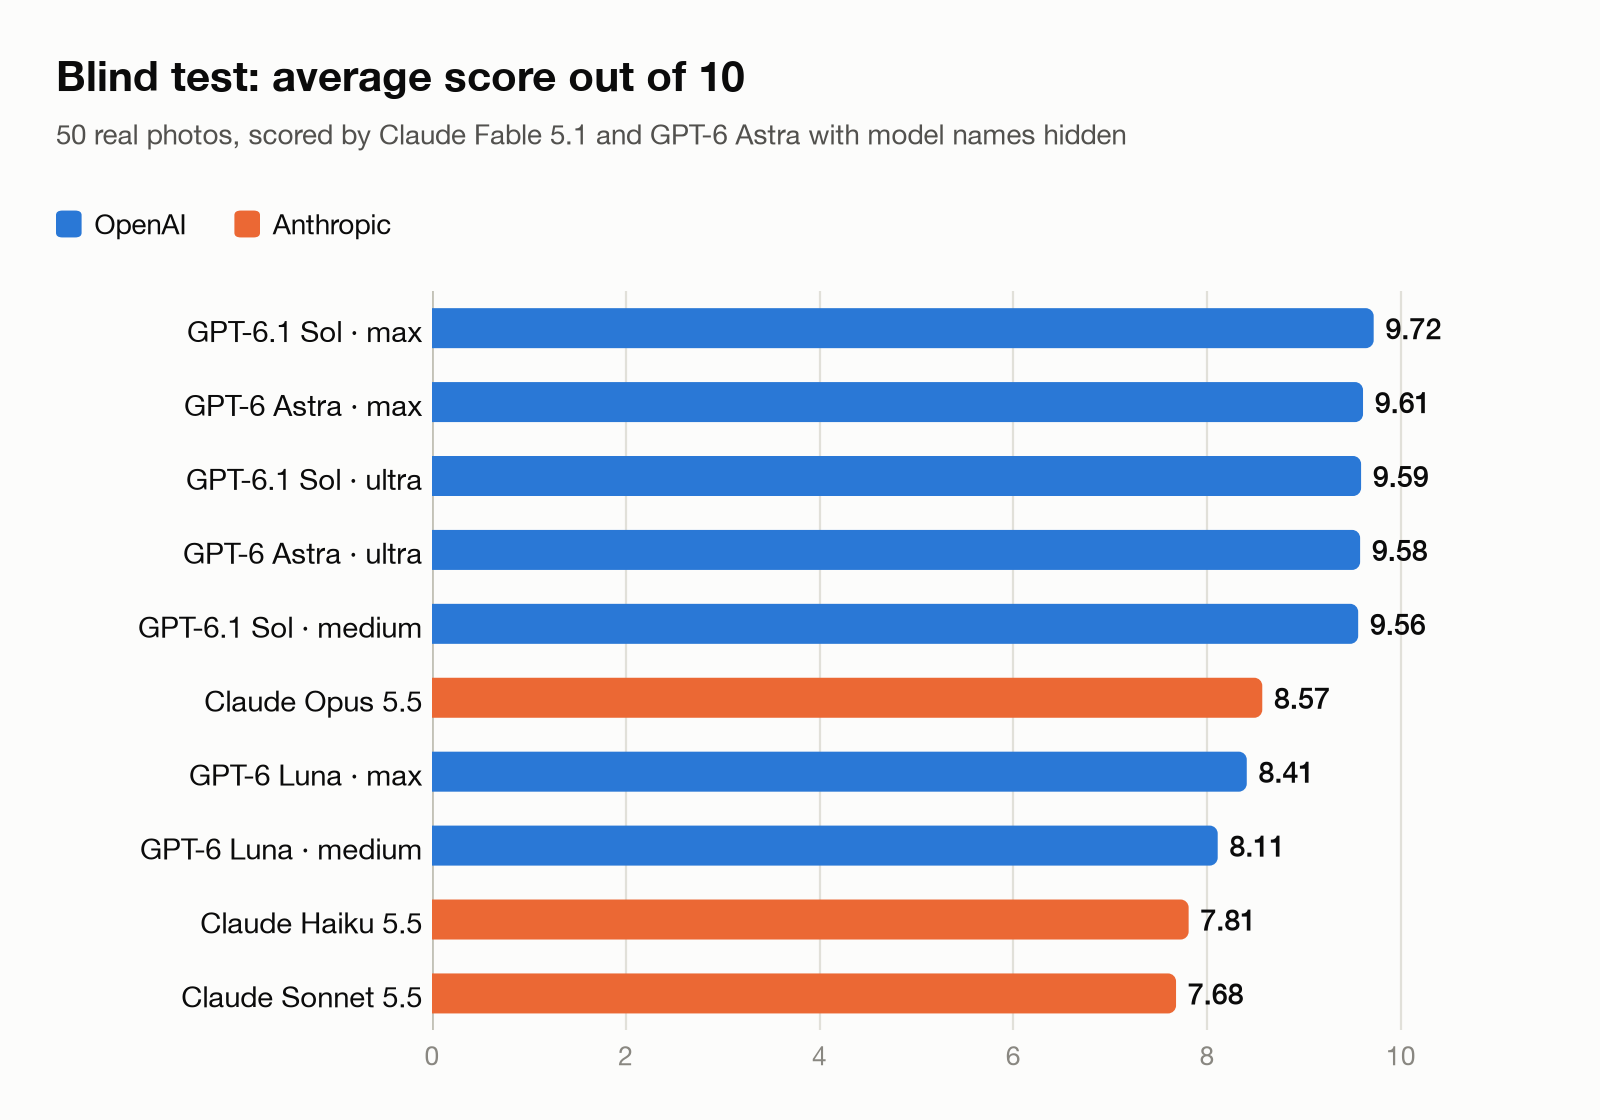 Figura 1. Pontuação média de dois avaliadores cegos, de 10.
| Posição | Modelo e esforço | Pontuação (de 10) | Biblioteca inteira, Batch API | Biblioteca inteira, API padrão |
|---|---|---|---|---|
| 1 | GPT-6.1 Sol, max | 9.72 | $563 | $1,126 |
| 2 | GPT-6 Astra, max | 9.61 | $2,987 | $5,973 |
| 3 | GPT-6.1 Sol, ultra | 9.59 | $468 | $937 |
| 4 | GPT-6 Astra, ultra | 9.58 | $2,156 | $4,313 |
| 5 | GPT-6.1 Sol, medium | 9.56 | $240 | $479 |
| 6 | Claude Opus 5.5 | 8.57 | $661 | $1,323 |
| 7 | GPT-6 Luna, max | 8.41 | $20 | $40 |
| 8 | GPT-6 Luna, medium | 8.11 | $11 | $22 |
| 9 | Claude Haiku 5.5 | 7.81 | $18 | $36 |
| 10 | Claude Sonnet 5.5 | 7.68 | $334 | $668 |
O custo é para as 142.521 fotos ao preço oficial da API de cada fornecedor.
O que eu usaria, com base neste teste:
- Se eu só me importasse com a pontuação, GPT-6.1 Sol em esforço max.
- Para minha própria biblioteca, GPT-6.1 Sol em medium. Ele obteve 98 % da melhor pontuação por US$ 240, cerca de um terço do que o Opus custaria.
- Com orçamento apertado, GPT-6 Luna em max. Por US$ 20 ele superou o Haiku, que custa o mesmo por token, e o Sonnet, que custaria cerca de 17 vezes mais para esta biblioteca.
- Não o Claude Sonnet 5.5: tem preço intermediário e a pontuação mais baixa.
Os modelos
| Fornecedor | Modelo | Esforço testado | Posicionamento |
|---|---|---|---|
| Anthropic | Claude Opus 5.5 | padrão (medium) | Carro-chefe, uso diário |
| Anthropic | Claude Sonnet 5.5 | padrão | Faixa intermediária |
| Anthropic | Claude Haiku 5.5 | padrão | Rápido, de baixo custo |
| OpenAI | GPT-6 Astra | max, ultra | Modelo de fronteira |
| OpenAI | GPT-6.1 Sol | medium, max, ultra | Cavalo de batalha |
| OpenAI | GPT-6 Luna | medium, max | Rápido, de baixo custo |
Os preços se alinham entre os dois fornecedores. O GPT-6.1 Sol custa o mesmo por token que o Claude Sonnet 5.5, o GPT-6 Astra o mesmo que o Claude Fable 5.1, e o GPT-6 Luna o mesmo que o Claude Haiku 5.5. O Claude Opus 5.5 fica entre o Sol e o Astra. Assim, quando dois modelos terminam com custos diferentes abaixo, é principalmente porque um deles usou mais tokens para o mesmo trabalho.
Os modelos Claude rodaram uma vez cada em suas configurações padrão, o que significa esforço medium para o Opus. Testei os modelos GPT em vários níveis de esforço. A comparação mais justa é GPT-6.1 Sol em medium contra Claude Opus 5.5 em medium: 9,56 contra 8,57.
O teste
Usei as 50 fotos mais recentes da minha biblioteca naquele momento, sem vídeos. São uma semana comum do meu rolo de câmera: momentos em família em casa e em uma ida às compras, vistas da cidade de um andar alto, um cartão de memória na minha mesa, capturas de páginas de produto de componentes eletrônicos, capturas de rastreamento de pedidos, uma postagem em rede social, uma placa de QR de desconto de estacionamento e uma etiqueta de carregador de veículo elétrico.
Cada modelo tinha cinco tarefas por foto. Escrevia um título curto e uma legenda de uma a três frases em chinês, dava de 5 a 12 palavras-chave em chinês e inglês, e escolhia o melhor álbum entre meus álbuns existentes, ou nenhum. Depois dava uma nota de qualidade e dizia se deveria manter ou excluir a foto, procurando duplicatas, fotos falhas, capturas de tela vencidas e fotos sem valor duradouro. Cada modelo recebia as mesmas instruções e o mesmo contexto para cada foto, dez fotos por vez.
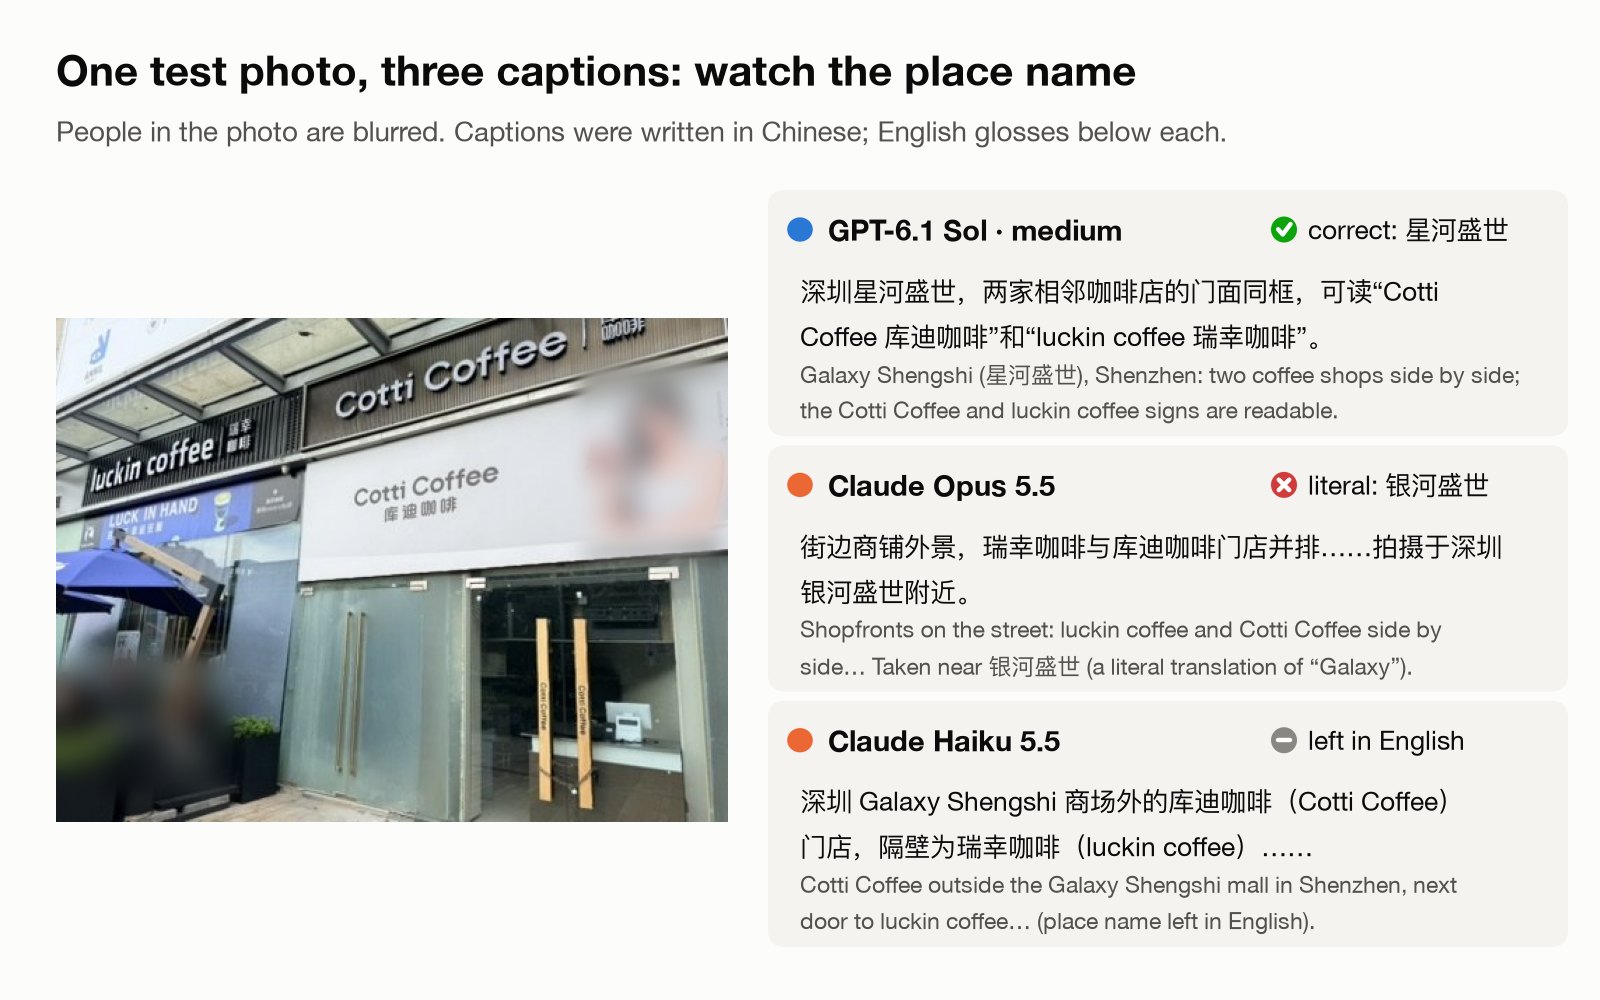 Figura 2. Uma das 50 fotos de teste, com três das legendas. Veja como cada modelo trata o nome do lugar; volto a isso abaixo. As pessoas na foto estão desfocadas.
Como pontuei
Não pontuei as respostas eu mesmo. Eu já tinha escolhido um vencedor antes do teste, e uso o Claude todos os dias, então não era neutro.
Em vez disso, embaralhei as dez respostas de cada foto e as rotulei de A a J, com uma nova ordem aleatória para cada foto. Dois avaliadores pontuaram então as 500 respostas de forma independente enquanto olhavam as fotos. Um era o Claude Fable 5.1, o modelo mais capaz da Anthropic. O outro era o GPT-6 Astra em esforço xhigh, o modelo de fronteira da OpenAI.
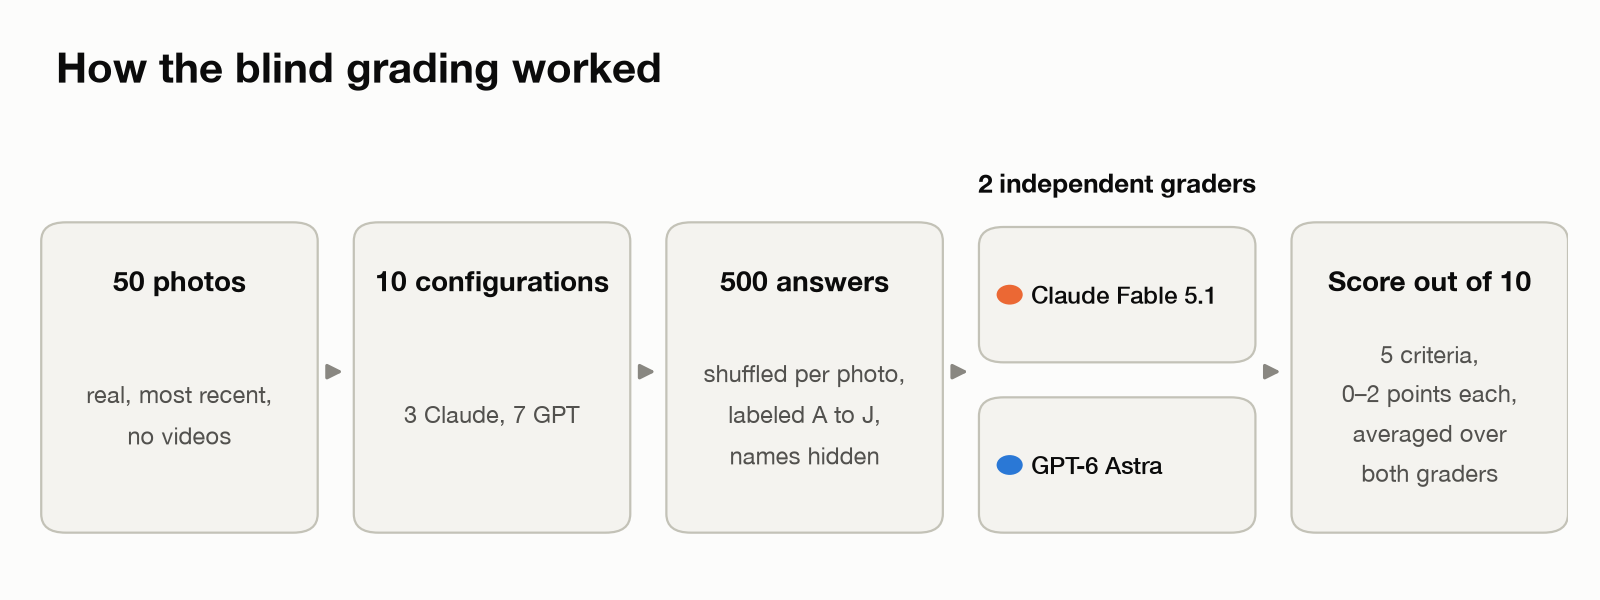 Figura 3. Como funcionou a pontuação cega.
Cada resposta foi pontuada em cinco critérios, de 0 a 2 pontos cada, totalizando 10:
| Critério | O que o avaliador verificava |
|---|---|
| Fatos | O sujeito, o lugar e qualquer texto legível estão corretos, incluindo nomes de lugares locais? |
| Sem detalhes inventados | A resposta evita afirmar algo que a foto não mostra? |
| Julgamento de exclusão | Manter ou excluir é razoável? Excluir uma boa foto vale 0. |
| Adequação ao álbum | O álbum está certo? Um álbum antigo errado vale 0; nenhum álbum é um 1 aceitável. |
| Utilidade | O título, a legenda e as palavras-chave me ajudariam a encontrar e lembrar desta foto depois? |
Escolhi um avaliador de cada fornecedor para ver se algum favoreceria seus próprios modelos. Eles concordaram em grande parte. A correlação entre as 500 pontuações pareadas foi de 0,71, e ambos colocaram as mesmas cinco configurações GPT no topo. O avaliador Claude também classificou o GPT-6.1 Sol e o GPT-6 Astra acima do Claude Opus. O avaliador GPT foi mais rigoroso no geral, e mais rigoroso com os modelos Claude.
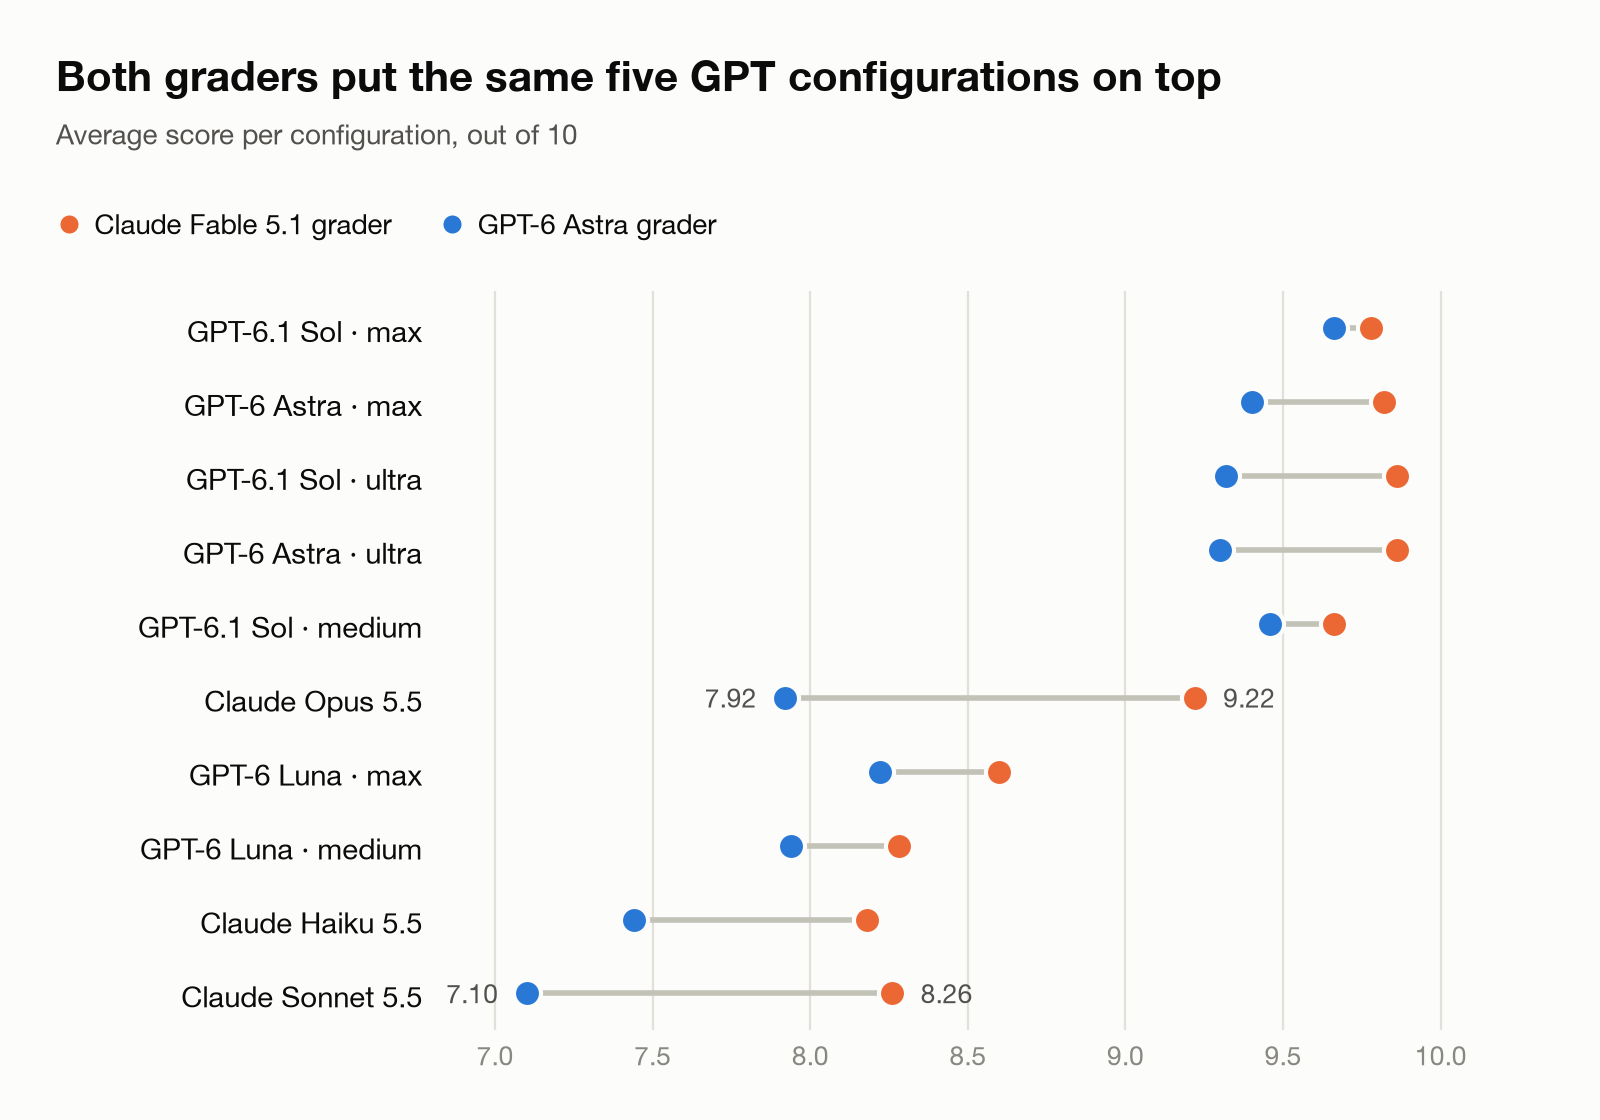 Figura 4. Pontuação média de cada avaliador por configuração.
Resultados
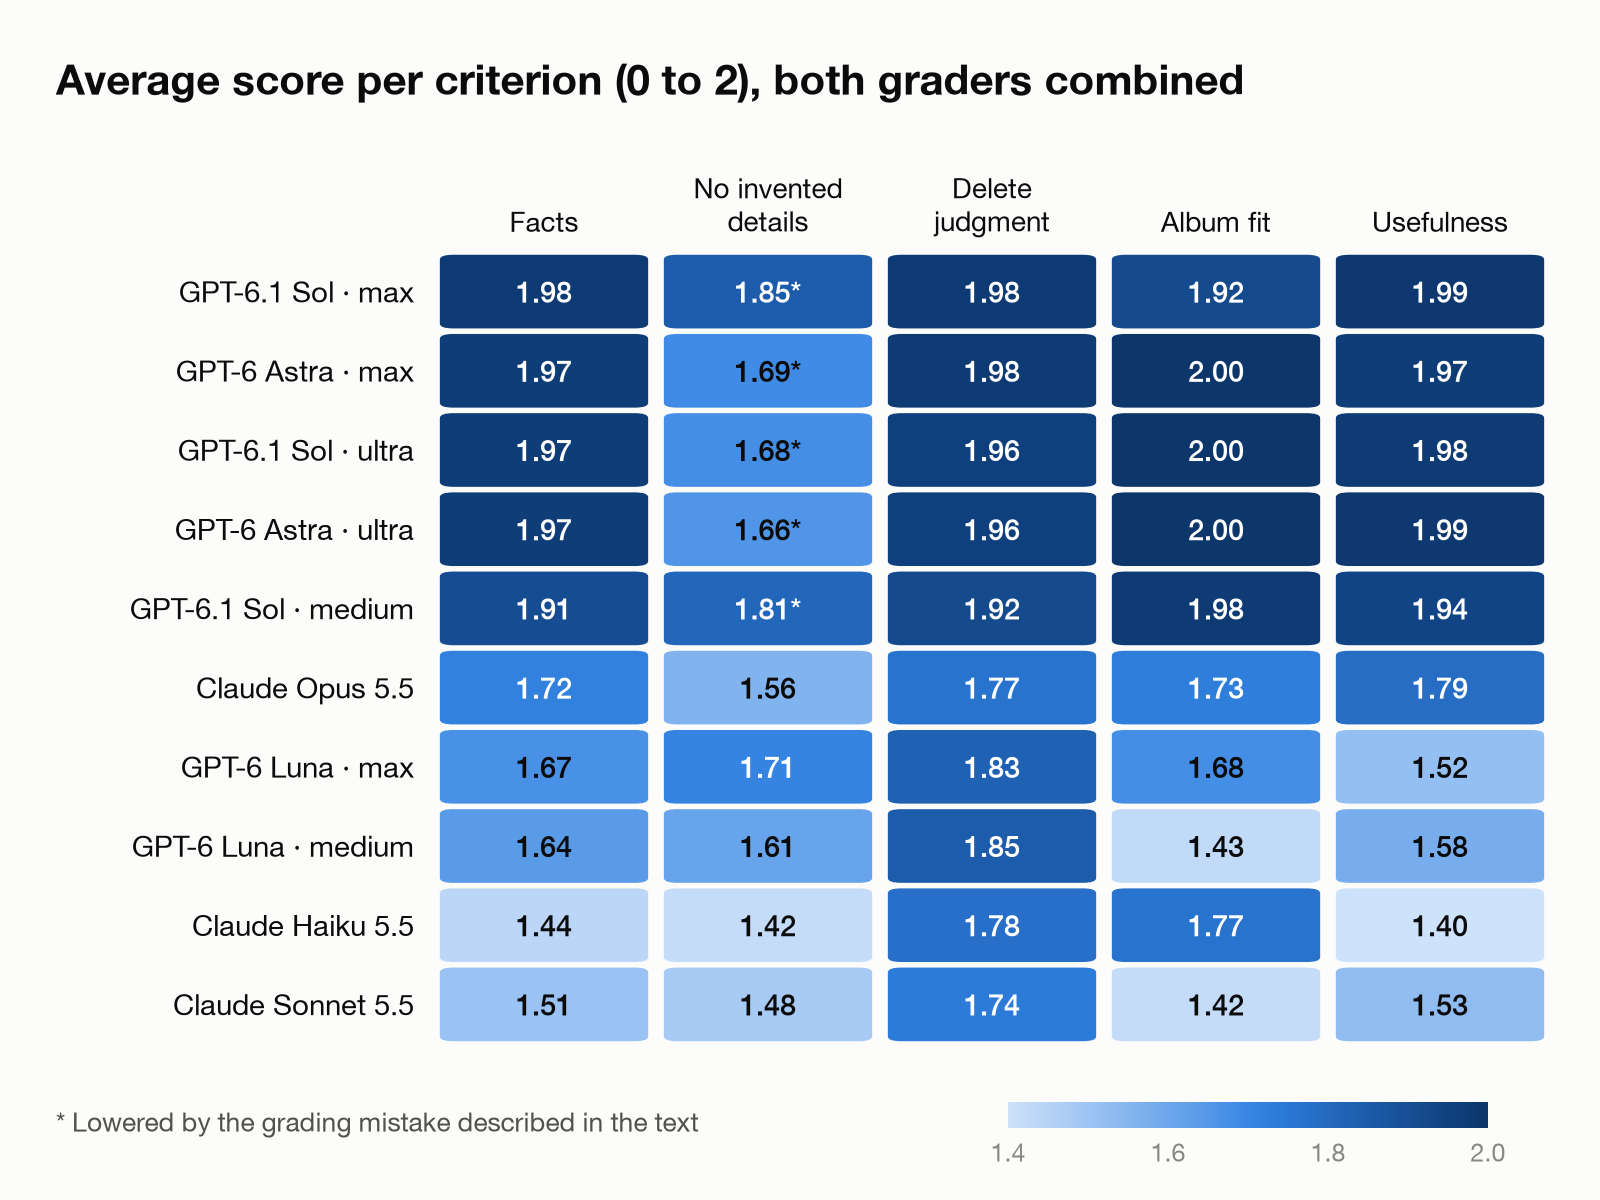 Figura 5. Pontuação média por critério, os dois avaliadores combinados. Um asterisco marca as pontuações reduzidas pelo erro de pontuação que descrevo abaixo.
GPT-6.1 Sol e GPT-6 Astra
O Sol e o Astra leram o texto com precisão e, na maioria das vezes, limitaram suas legendas ao que as fotos mostravam. Também foram os melhores com nomes de lugares locais, o que importa para fotos tiradas na China.
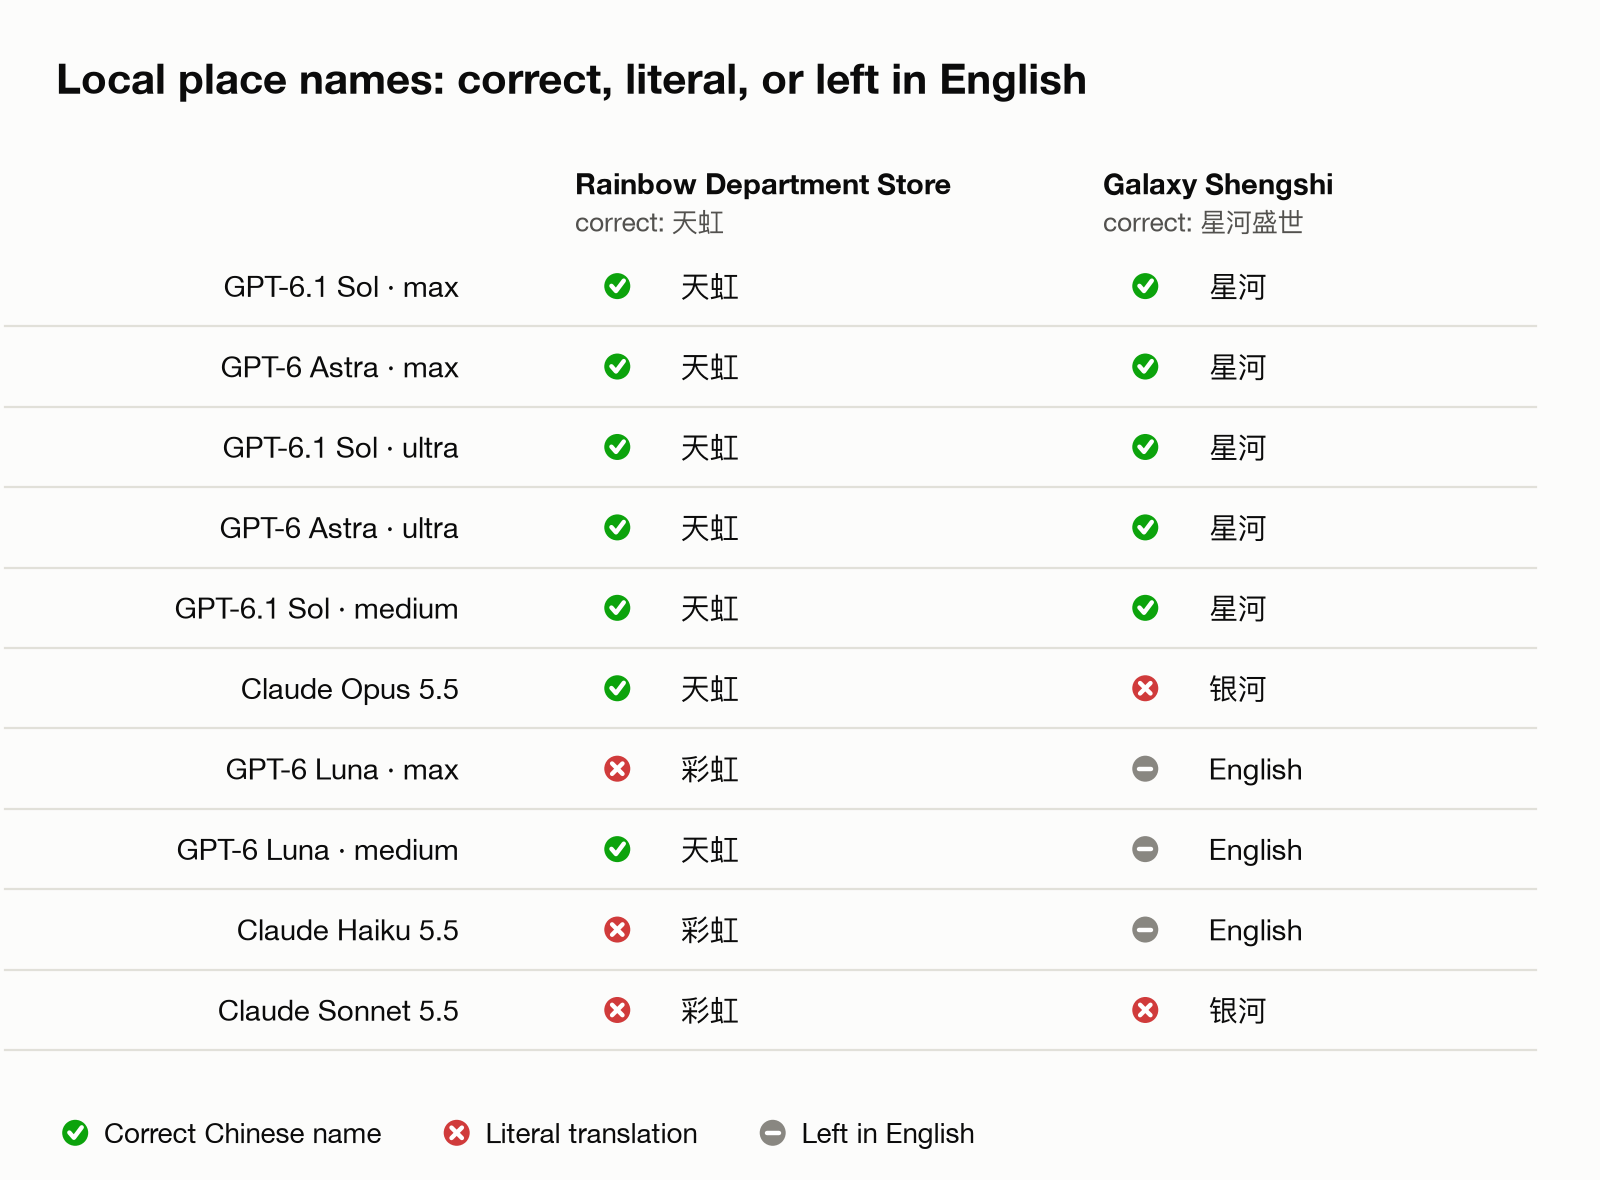 Figura 6. Dois testes de nomes locais. Uma marca significa o nome chinês correto, uma cruz uma tradução literal, e EN significa que o nome ficou em inglês.
Várias fotos foram marcadas com o local «Rainbow Department Store». Esse é o nome em inglês da rede de shoppings de Shenzhen 天虹. Uma tradução palavra por palavra dá 彩虹百货, que está errado. Todas as configurações de Sol e Astra acertaram, assim como o Opus e o Luna em medium. O Haiku, o Sonnet e o Luna em max usaram a tradução literal. A foto da cafeteria na Figura 2 foi marcada como «Galaxy Shengshi», cujo nome chinês é 星河盛世. Todas as configurações de Sol e Astra escreveram 星河. O Opus e o Sonnet traduziram literalmente como 银河, e o Haiku e as duas configurações de Luna deixaram em inglês.
O Sol e o Astra também foram cuidadosos com a exclusão. Sugeriram excluir de 4 a 6 das 50 fotos. O conjunto incluía oito capturas de páginas de produto de componentes eletrônicos, e os modelos GPT mantiveram quase todas; uma configuração de Sol marcou uma única captura como quase duplicata. Os modelos Claude marcaram de duas a quatro cada. Ambos os avaliadores concordaram em mantê-las, pois as páginas continham pinagens, dimensões e fotos de placas que eu iria querer consultar depois.
Claude Opus 5.5
O Opus às vezes escrevia em uma legenda coisas que a foto sozinha não pode mostrar. Descrevia relações que a imagem sozinha não pode provar, como irmãos ou pai e filho. Também errava algumas poses. Em uma foto, uma criança estava de pé atrás de um adulto, e o Opus escreveu que a criança estava nas costas do adulto. Ambos os avaliadores tiraram pontos por isso.
Isso me surpreendeu. Antes do teste cego, eu tinha revisado as respostas e elogiado o Opus por adivinhar corretamente que duas crianças eram irmãs. Eu conheço minha família; o avaliador não. Mas com 142.000 fotos, não posso conferir cada legenda eu mesmo, e uma legenda que afirma algo que a foto não mostra é um problema.
O Opus também sugeriu o maior número de exclusões, 13 das 50 fotos. Três delas eram capturas de páginas de produto que ele chamou de vencidas, embora contivessem informações de referência que eu manteria. Foi o único modelo que quis excluir a placa de QR de desconto de estacionamento como de baixo valor. Também colocou várias fotos de uma única pessoa em um álbum de «retrato de família».
Claude Sonnet 5.5 e Haiku 5.5
Esses dois cometeram a maioria dos erros factuais, incluindo a tradução literal 彩虹. O Sonnet fez as escolhas de álbum mais fracas e arquivou fotos cotidianas em um álbum antigo de um evento sem relação. O Haiku inventou um detalhe que levou a uma má decisão de exclusão. Em uma sequência de fotos quase idênticas, descreveu o melhor quadro como alguém olhando para baixo, o oposto do que a foto mostra, e sugeriu excluí-lo.
GPT-6 Luna
O Luna custa o mesmo por token que o Haiku, mas pontuou mais alto em ambos os níveis de esforço: 8,41 e 8,11, contra 7,81 do Haiku. Em esforço max também superou o Sonnet, que custaria cerca de 17 vezes mais para legendar a mesma biblioteca. O Luna perdeu a maioria dos pontos em utilidade e escolha de álbum. Suas legendas eram mais simples e seus álbuns menos precisos.
Níveis de esforço
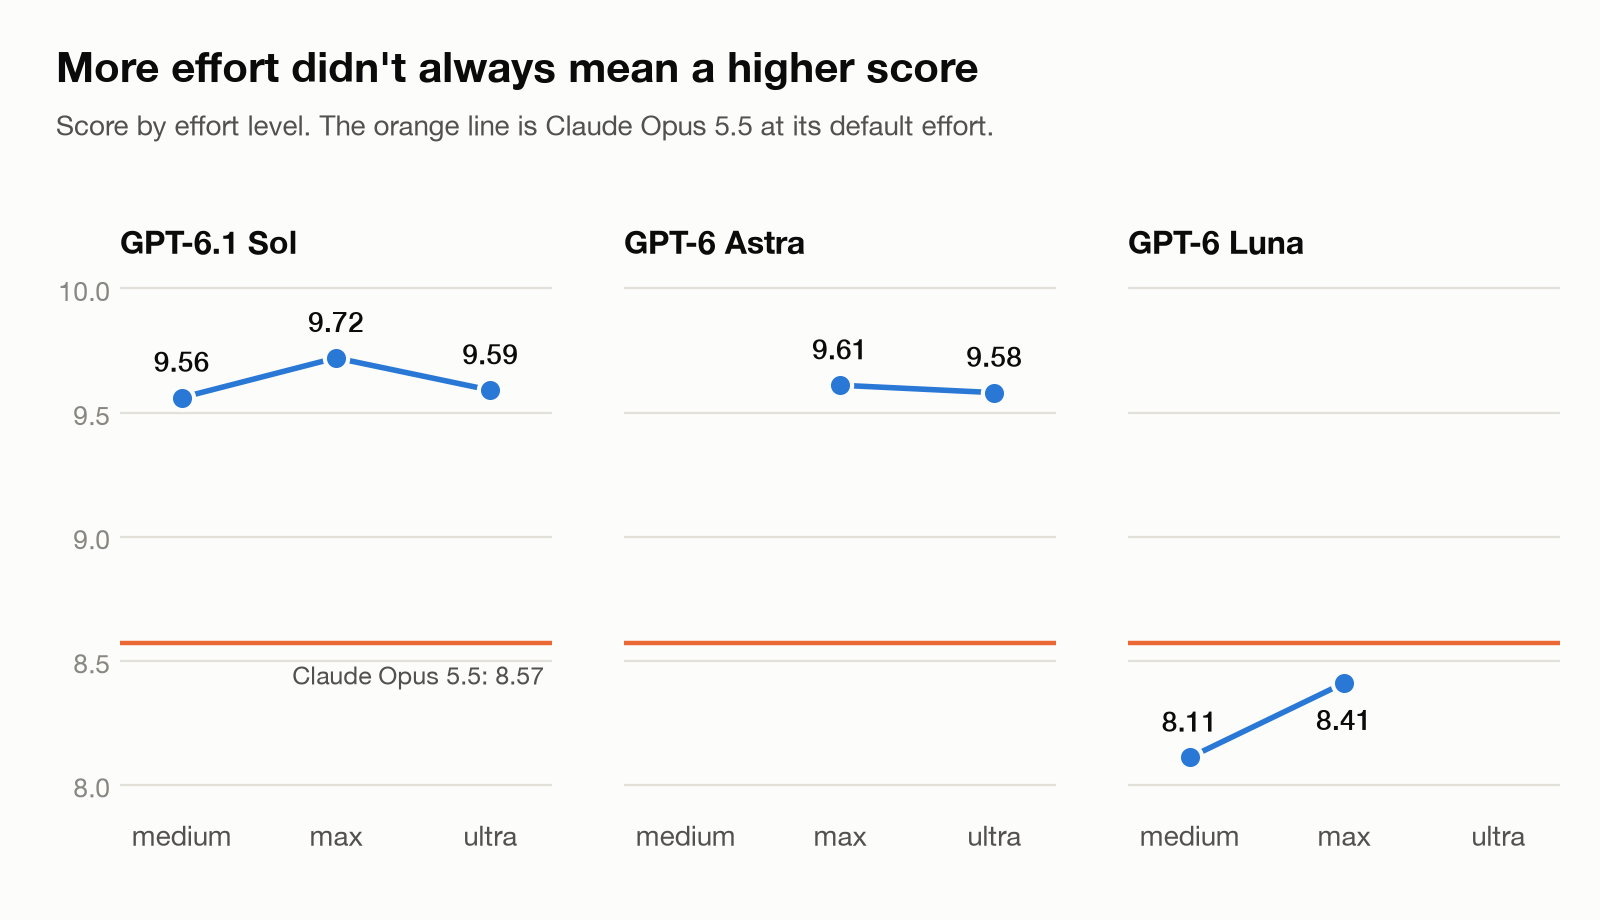 Figura 7. Pontuação por nível de esforço. A linha laranja é o Claude Opus 5.5 em seu esforço padrão.
Ultra não foi melhor que max para nenhum dos dois modelos. O Sol pontuou 9,59 em ultra e 9,72 em max; o Astra pontuou 9,58 e 9,61. Neste teste, o ultra até produziu menos tokens de saída que o max. Para o Sol, o medium chegou perto com 9,56, por menos da metade do custo do max. Mais esforço também nem sempre significou detalhes mais precisos: o Luna em medium acertou 天虹, e o Luna em max não.
Um erro na minha pontuação
Depois de pontuar, notei que os avaliadores não tinham recebido a data e a hora de captura de cada foto, embora os modelos de legenda tivessem. Assim, o avaliador GPT-6 Astra tratou as legendas que mencionavam a data ou hora exata como detalhes inventados. As principais configurações GPT mencionavam a data com mais frequência, então suas pontuações em «Sem detalhes inventados» saíram mais baixas do que deveriam.
Se eu devolver apenas os pontos perdidos por causa das datas, as quatro principais configurações GPT sobem para entre 9,84 e 9,90, o que é na prática um empate, e o Opus fica em 8,58. Mantive as pontuações originais neste artigo. Da próxima vez, darei aos avaliadores tudo o que os modelos viram.
Velocidade
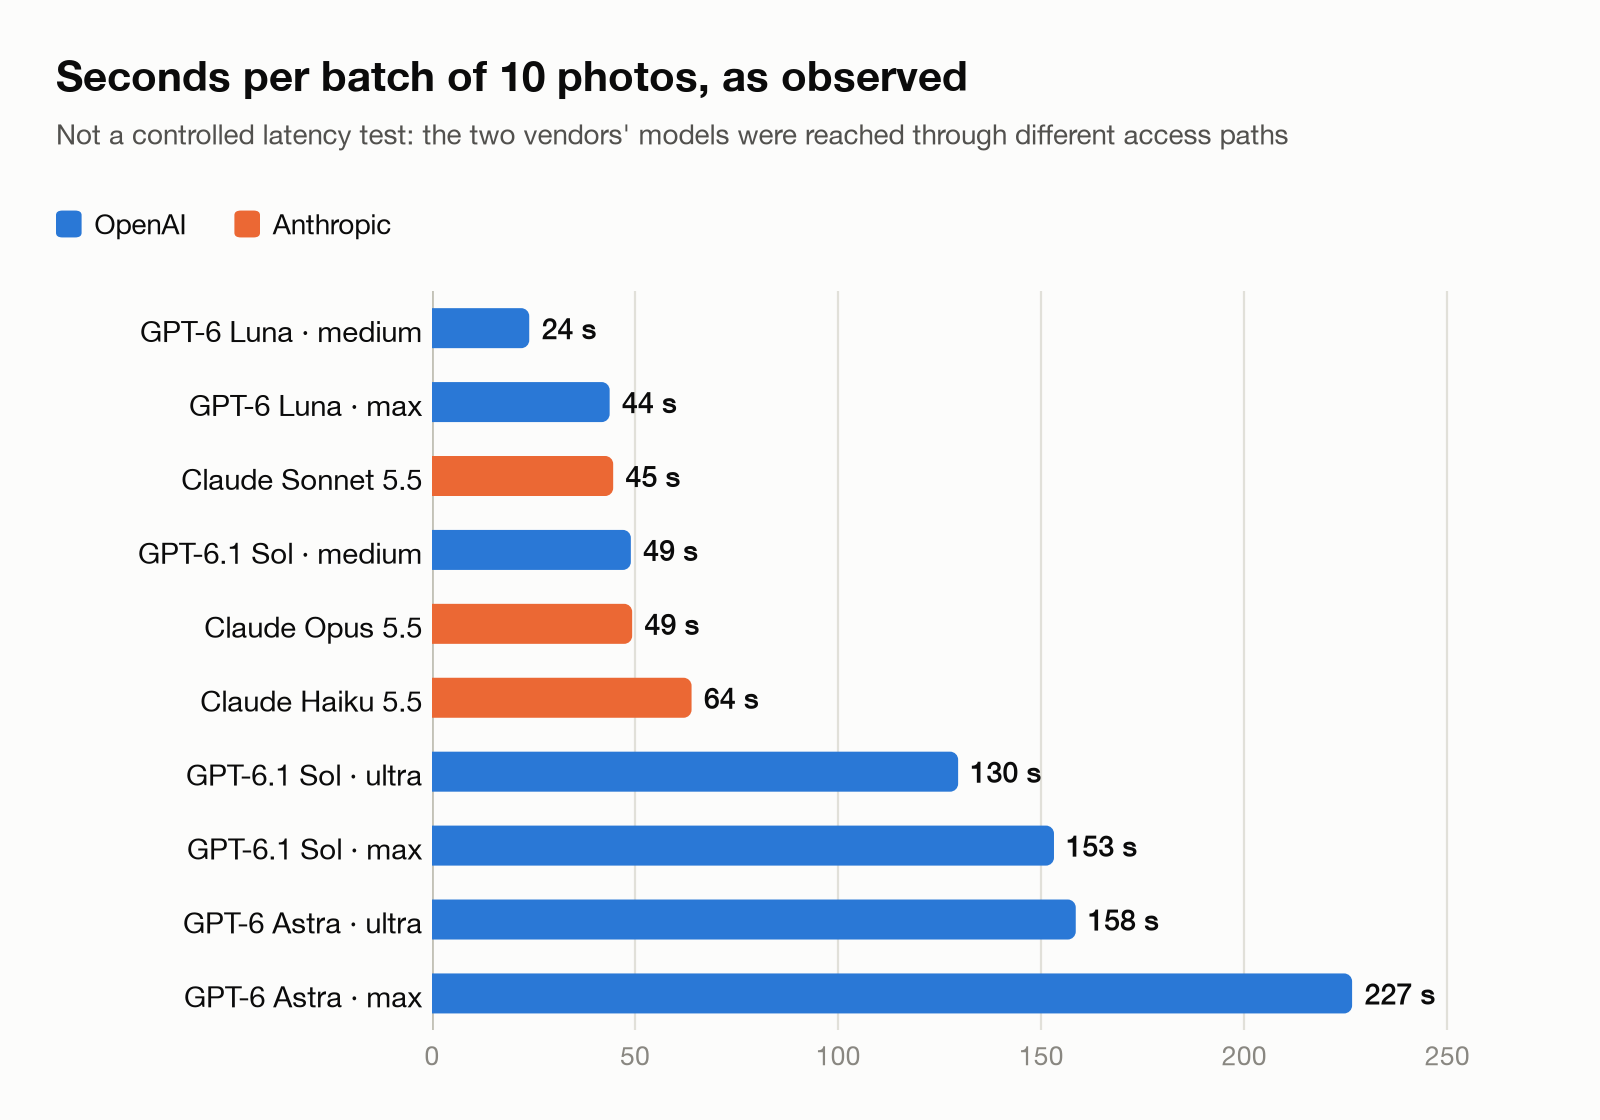 Figura 8. Segundos por lote de 10 fotos, como observado. Este não é um teste de latência controlado, porque os modelos dos dois fornecedores foram acessados por vias diferentes.
Isso corresponde à sensação que o Opus me dá no trabalho diário: é rápido, cerca de três vezes mais rápido que o Sol em max. O Sol em medium, porém, era tão rápido quanto o Opus e pontuou cerca de um ponto a mais.
Quanto custa
Precifiquei cada configuração pelos preços oficiais da API dos fornecedores. Tratar o uso incluído em um plano de assinatura como gratuito faria alguns modelos parecerem melhores do que são.
Preços oficiais por milhão de tokens, nível padrão:
| Modelo | Entrada | Saída |
|---|---|---|
| Claude Opus 5.5 | $4.00 | $20.00 |
| Claude Sonnet 5.5 | $2.00 | $10.00 |
| Claude Haiku 5.5 | $0.10 | $0.50 |
| GPT-6 Astra | $10.00 | $50.00 |
| GPT-6.1 Sol | $2.00 | $10.00 |
| GPT-6 Luna | $0.10 | $0.50 |
As Batch APIs de ambos os fornecedores custam 50 % menos, o que convém a uma tarefa como esta que não precisa de respostas instantâneas. Peguei os preços na página de preços da Anthropic (claude.com/pricing) e na página de preços da API da OpenAI (developers.openai.com/api/docs/pricing) em 20 de outubro de 2026.
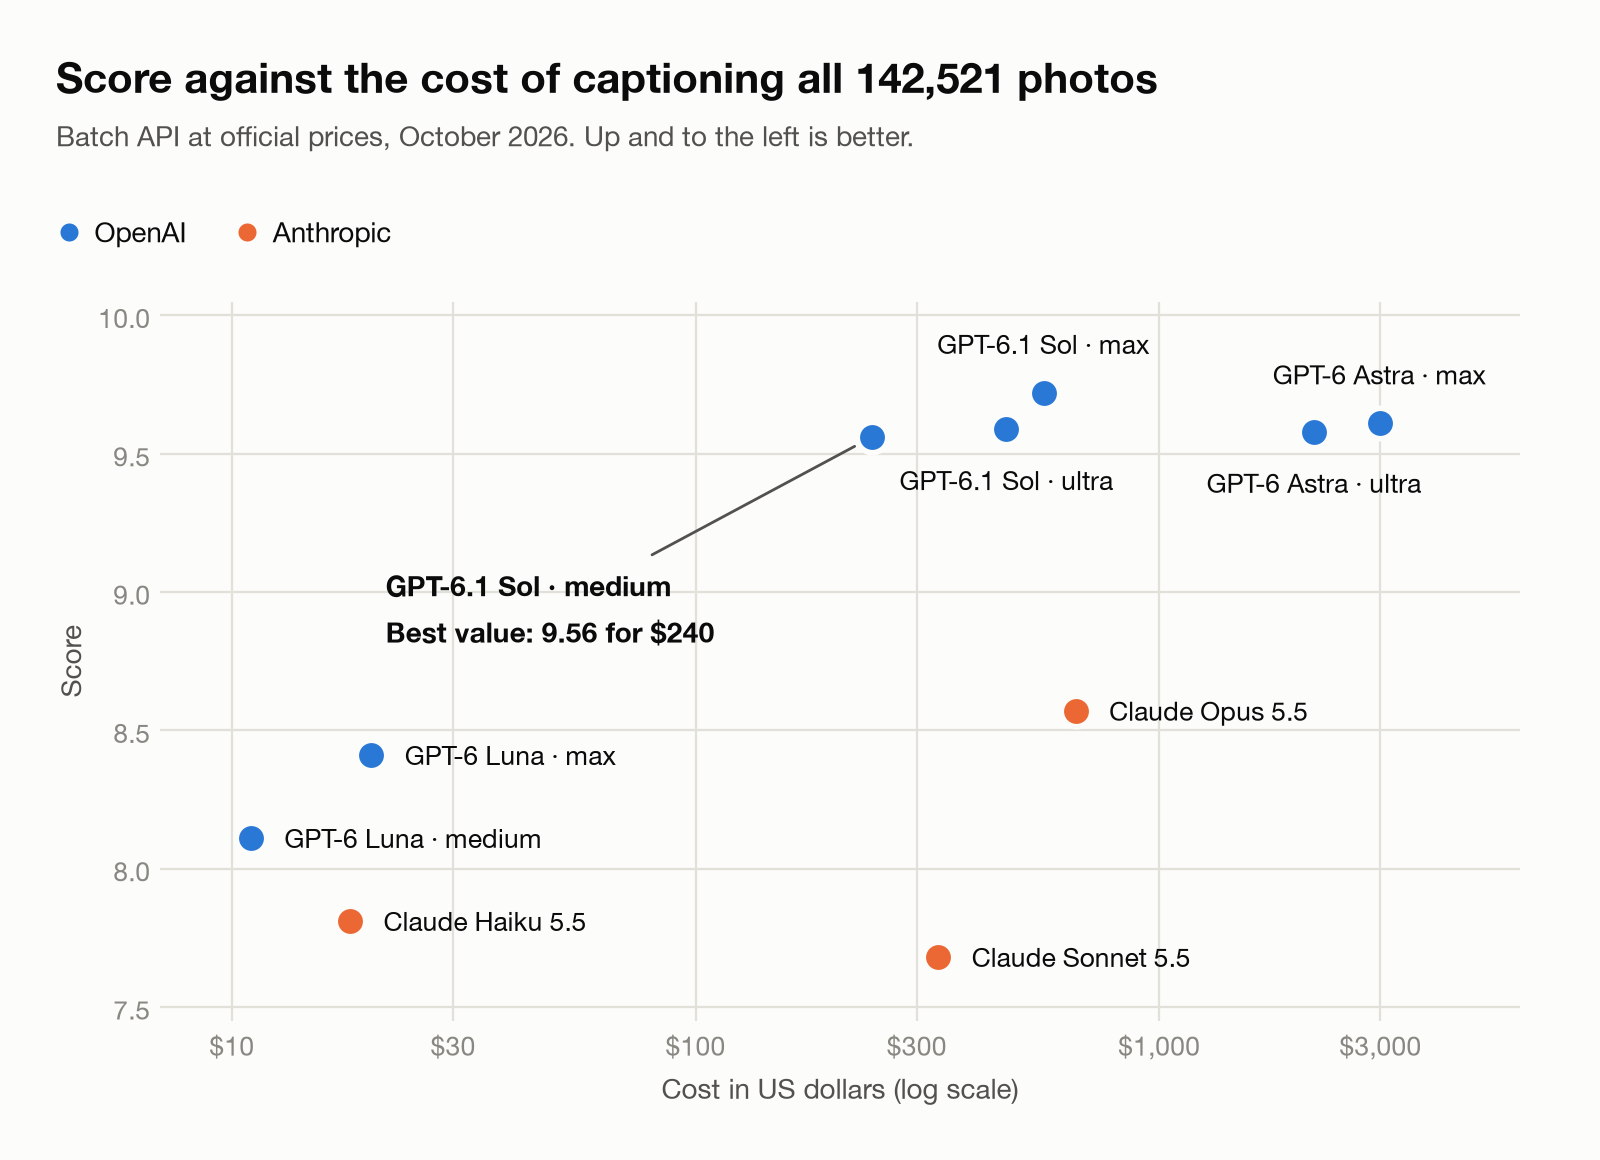 Figura 9. Pontuação contra o custo de legendar toda a biblioteca a preços Batch. O eixo de custo é logarítmico.
| Modelo e esforço | Tokens de saída por foto | Padrão | Batch | Pontuação |
|---|---|---|---|---|
| GPT-6.1 Sol, medium | 193 | $479 | $240 | 9.56 |
| GPT-6.1 Sol, ultra | 514 | $937 | $468 | 9.59 |
| GPT-6.1 Sol, max | 647 | $1,126 | $563 | 9.72 |
| Claude Opus 5.5 | ~292 | $1,323 | $661 | 8.57 |
| Claude Sonnet 5.5 | ~297 | $668 | $334 | 7.68 |
| GPT-6 Astra, ultra | 462 | $4,313 | $2,156 | 9.58 |
| GPT-6 Astra, max | 695 | $5,973 | $2,987 | 9.61 |
| GPT-6 Luna, medium | 163 | $22 | $11 | 8.11 |
| Claude Haiku 5.5 | ~330 | $36 | $18 | 7.81 |
| GPT-6 Luna, max | 419 | $40 | $20 | 8.41 |
O Sol em medium obteve 98 % da melhor pontuação por 36 % do que o Opus custaria e 43 % do Sol em max. O Astra igualou a qualidade do Sol, mas custa cerca de cinco vezes mais, porque seu preço por token é cinco vezes maior. O Opus custou mais que o Sol em max e pontuou menos. Ele já rodava em esforço medium, mas seu preço por token é o dobro do Sol. O Luna legendará toda a biblioteca por US$ 11 a US$ 20 e ainda superará o Haiku e o Sonnet.
Nota de método: as contagens de tokens do GPT foram medidas a partir das execuções, e as contagens de tokens do Claude foram estimadas a partir dos registros de execução. Alguns tokens de raciocínio do Claude não eram visíveis, então os custos do Claude podem estar ligeiramente subestimados. Nenhum desconto além do Batch, como cache de prompts, foi aplicado a qualquer modelo.
O que aprendi
Escolhi o Opus antes de ter qualquer pontuação cega, principalmente porque ele já era meu padrão para programar. Ainda prefiro o Claude Opus 5.5 para programar e para fluxos de trabalho, onde, na minha experiência, ele é mais rápido e mais forte. Descrever fotos reais exige uma habilidade diferente: ler o que realmente está no quadro sem preencher poses ou relações. O GPT-6.1 Sol fez isso melhor. Se eu tivesse seguido o hábito e pulado o teste cego, teria pago mais por legendas piores.
Da próxima vez, começarei às cegas e darei aos avaliadores de fornecedores diferentes todas as entradas que os modelos de legenda receberam. Também continuarei comparando aos preços oficiais da API, e não assumirei que mais esforço é melhor: ultra não superou max aqui.
Até os melhores modelos marcaram fotos úteis para exclusão, então conferirei cada marcação de exclusão eu mesmo antes de remover qualquer coisa.
Limitações
Este foi um teste pequeno: 50 fotos recentes de uma cidade. Não testei fotos mais antigas, documentos digitalizados, outros idiomas nem vídeos. Os modelos Claude rodaram apenas em suas configurações padrão; um Opus com esforço maior poderia pontuar melhor, a um custo maior. Os avaliadores são modelos de IA, não pessoas. Eles concordaram bem, mas não perfeitamente, e uma verificação pontual humana tornaria o resultado mais forte. Modelos e preços mudam rápido, e cada número aqui é de outubro de 2026.
Minha escolha
Para minha biblioteca: GPT-6.1 Sol em esforço medium. Para programar e para fluxos de trabalho, continuo com o Claude Opus 5.5.