
142.000 Fotoğraflık Kütüphanemde 10 Yapay Zekâ Modelini Kör Test Ettim: GPT-6.1 Sol, Claude Opus'u Geçti
Özet
Claude Opus 5.5'i her gün kodlama ve iş akışları için kullanıyorum; o işlerde bana GPT-6'dan daha hızlı ve daha iyi geliyor. Fotoğrafları betimlemede de en iyisi olacağını varsaydım ve test ettim. On yapılandırma çalıştırdım: Claude Haiku, Sonnet ve Opus 5.5, ayrıca OpenAI'ın GPT-6.1 Sol, GPT-6 Astra ve GPT-6 Luna modelleri birkaç çaba seviyesinde. Her biri, 142.521 fotoğraflık kütüphanemden 50 gerçek fotoğrafa başlık yazdı, açıklama yazdı, anahtar kelime ekledi, albüme yerleştirdi ve silmem gerektiğini düşündüğü fotoğrafları işaretledi. Farklı sağlayıcılardan iki kör değerlendirici — Claude Fable 5.1 ve GPT-6 Astra — 500 yanıtın tümünü doğruluk, uydurulmuş ayrıntı, silme kararı, albüm uyumu ve kullanışlılık açısından puanladı. GPT-6.1 Sol 10 üzerinden 9,72 ile en yüksek puanı aldı. Opus 8,57 aldı; Sonnet ve Haiku ise 7,7 ile 7,8 arasında kaldı. Ultra çaba, max'tan daha iyi değildi. Resmî Batch API fiyatlarıyla tüm kütüphaneye açıklama yazmak, medium çabada Sol ile yaklaşık $240 (9,56), Opus ile $661, Luna ile $11 ila $20 tutar; Luna yine de Haiku'yu geçti.
Bunu neden test ettim
Günümün çoğu kodlamaya, ajan iş akışlarına ve otomasyona gidiyor; ulaştığım model Claude Opus 5.5. O tür işlerde bana GPT-6'dan daha hızlı ve daha iyi geliyordu. Fotoğraf kütüphaneme yapay zekâya başlık ve etiket yazdırmaya karar verince de hiç düşünmeden Opus'u seçtim.
Kütüphane, hayatımın 25 yılı: erken dijital fotoğraf makinesi karelerinden geçen haftaki telefon fotoğraflarına kadar 142.521 fotoğraf, ayrıca 16.000'den fazla ekran görüntüsü. Neredeyse hiçbirinin açıklaması yok. Her fotoğrafın bir başlığı, bir açıklaması, arayabileceğim anahtar kelimeleri, mantıklı bir albümü ve yinelenen ya da çöp olduğunda dürüst bir işareti olsun istiyorum. 142.000 fotoğrafı işlemek için para ödemeden önce, hangi modelin bunu en iyi yaptığını ve farkın maliyetini bilmek istedim.
Opus'un kazanmasını bekliyordum. Bu 50 fotoğrafta GPT-6.1 Sol bir puandan fazla önde bitirdi.
Sonuçlara genel bakış
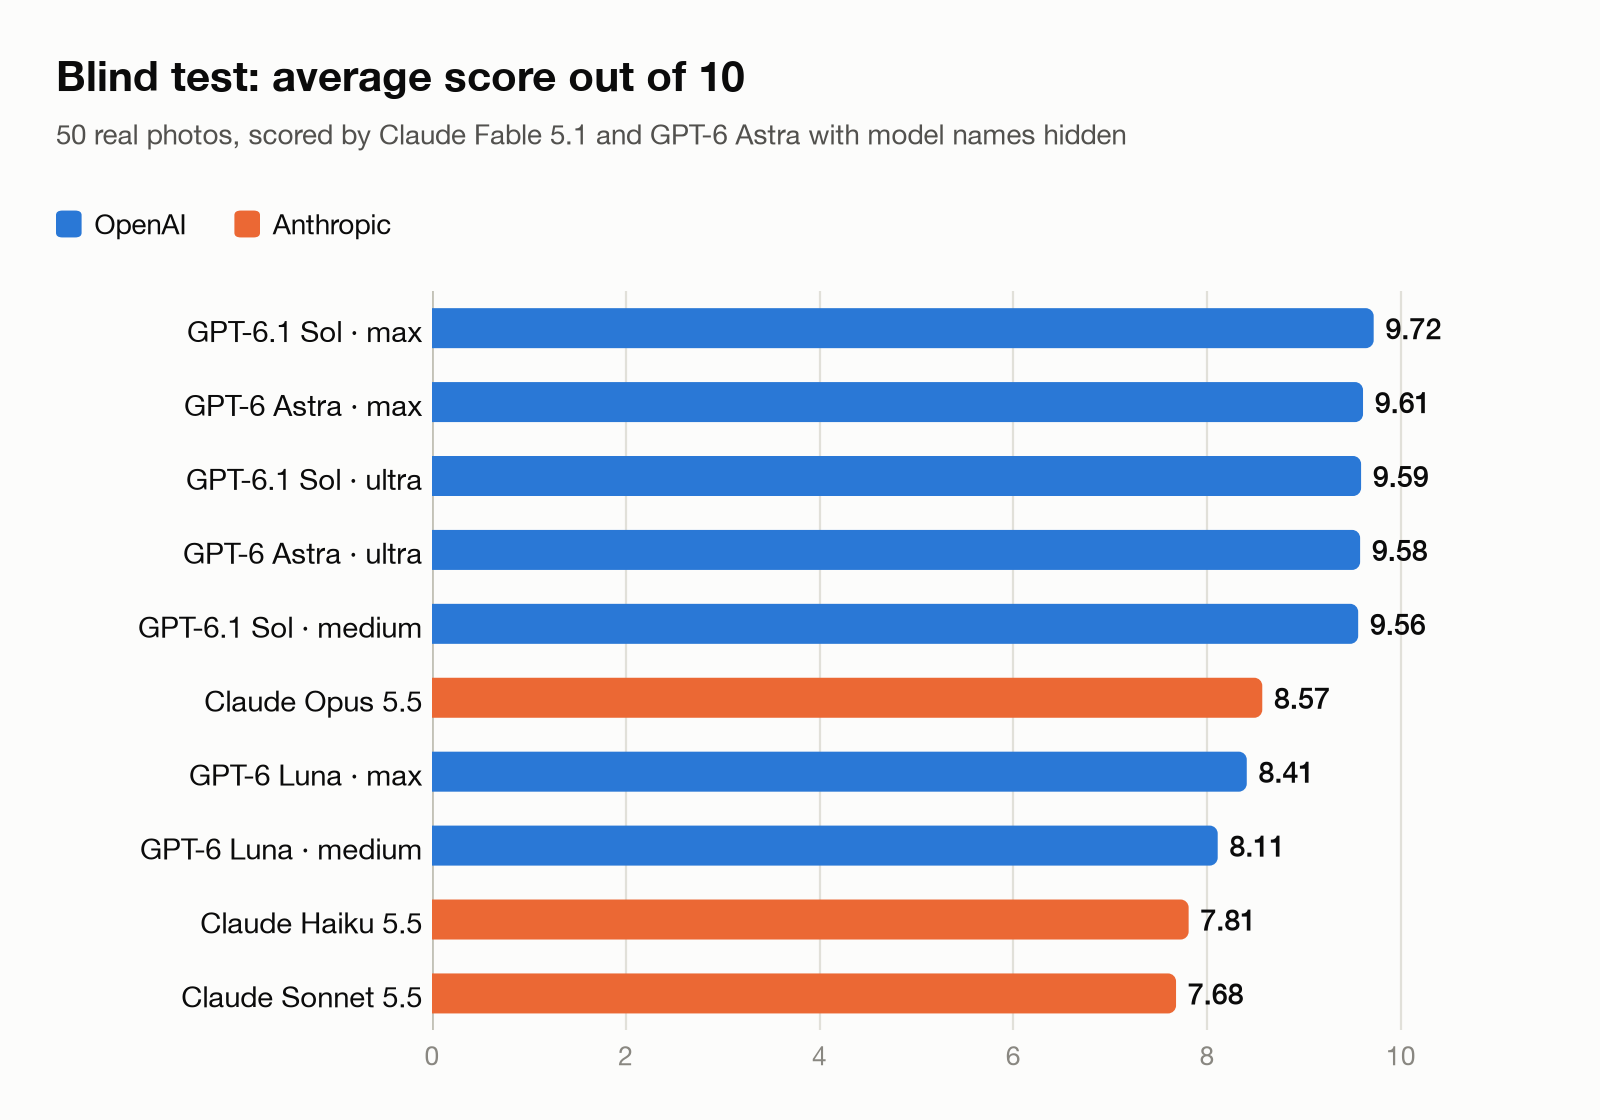 Şekil 1. İki kör değerlendiricinin ortalama puanı, 10 üzerinden.
| Sıra | Model ve çaba | Puan (10 üzerinden) | Tüm kütüphane, Batch API | Tüm kütüphane, standart API |
|---|---|---|---|---|
| 1 | GPT-6.1 Sol, max | 9.72 | $563 | $1,126 |
| 2 | GPT-6 Astra, max | 9.61 | $2,987 | $5,973 |
| 3 | GPT-6.1 Sol, ultra | 9.59 | $468 | $937 |
| 4 | GPT-6 Astra, ultra | 9.58 | $2,156 | $4,313 |
| 5 | GPT-6.1 Sol, medium | 9.56 | $240 | $479 |
| 6 | Claude Opus 5.5 | 8.57 | $661 | $1,323 |
| 7 | GPT-6 Luna, max | 8.41 | $20 | $40 |
| 8 | GPT-6 Luna, medium | 8.11 | $11 | $22 |
| 9 | Claude Haiku 5.5 | 7.81 | $18 | $36 |
| 10 | Claude Sonnet 5.5 | 7.68 | $334 | $668 |
Maliyet, 142.521 fotoğrafın tümü için her sağlayıcının resmî API fiyatıyla hesaplanmıştır.
Bu teste göre benim seçimim:
- Yalnızca puana baksaydım, max çabada GPT-6.1 Sol.
- Kendi kütüphanem için, medium çabada GPT-6.1 Sol. En yüksek puanın %98'ini $240'a aldı; bu, Opus'un maliyetinin yaklaşık üçte biri.
- Sıkı bir bütçeyle, max çabada GPT-6 Luna. $20'ye, token başına aynı fiyatı olan Haiku'yu ve bu kütüphane için yaklaşık 17 kat pahalıya gelecek Sonnet'i geçti.
- Claude Sonnet 5.5 değil. Orta fiyatlı ama en düşük puanı aldı.
Modeller
| Sağlayıcı | Model | Test edilen çaba | Konumlandırma |
|---|---|---|---|
| Anthropic | Claude Opus 5.5 | varsayılan (medium) | Amiral gemisi, günlük iş modeli |
| Anthropic | Claude Sonnet 5.5 | varsayılan | Orta seviye |
| Anthropic | Claude Haiku 5.5 | varsayılan | Hızlı, düşük maliyetli |
| OpenAI | GPT-6 Astra | max, ultra | Öncü (frontier) model |
| OpenAI | GPT-6.1 Sol | medium, max, ultra | İş gücü |
| OpenAI | GPT-6 Luna | medium, max | Hızlı, düşük maliyetli |
Fiyatlar iki sağlayıcı arasında örtüşüyor. GPT-6.1 Sol, token başına Claude Sonnet 5.5 ile aynı fiyatta; GPT-6 Astra, Claude Fable 5.1 ile; GPT-6 Luna da Claude Haiku 5.5 ile aynı. Claude Opus 5.5, Sol ile Astra arasında yer alıyor. Yani aşağıda iki model farklı maliyetlerle çıkıyorsa, bunun nedeni çoğunlukla aynı iş için birinin daha fazla token kullanmış olması.
Claude modelleri varsayılan ayarlarında birer kez çalıştı; bu, Opus için medium çaba demek. GPT modellerini birkaç çaba seviyesinde test ettim. En yakın bire bir karşılaştırma, medium çabada GPT-6.1 Sol ile medium çabada Claude Opus 5.5: 9,56'ya karşı 8,57.
Test
O sırada kütüphanemdeki en yeni 50 fotoğrafı kullandım, video yok. Sıradan bir haftanın kamera rulosu: evde ve alışverişte aile anları, yüksek kattan şehir manzarası, masamdaki bir hafıza kartı, elektronik parçaların ürün sayfası ekran görüntüleri, kargo takip ekran görüntüleri, bir sosyal medya paylaşımı, bir otopark indirimi karekod tabelası ve bir elektrikli araç şarj etiketi.
Her modelin her fotoğraf için beş görevi vardı. Çince kısa bir başlık ve bir-üç cümlelik bir açıklama yazdı; Çince ve İngilizce 5 ila 12 anahtar kelime verdi; mevcut albümlerimden en iyisini seçti ya da hiçbirini seçmedi. Ardından bir kalite puanı verdi ve fotoğrafın saklanıp saklanmayacağını söyledi; yinelenenler, başarısız kareler, süresi geçmiş ekran görüntüleri ve kalıcı değeri olmayan fotoğrafları aradı. Her model, her fotoğraf için aynı talimatları ve aynı bağlamı aldı; her seferinde on fotoğraf.
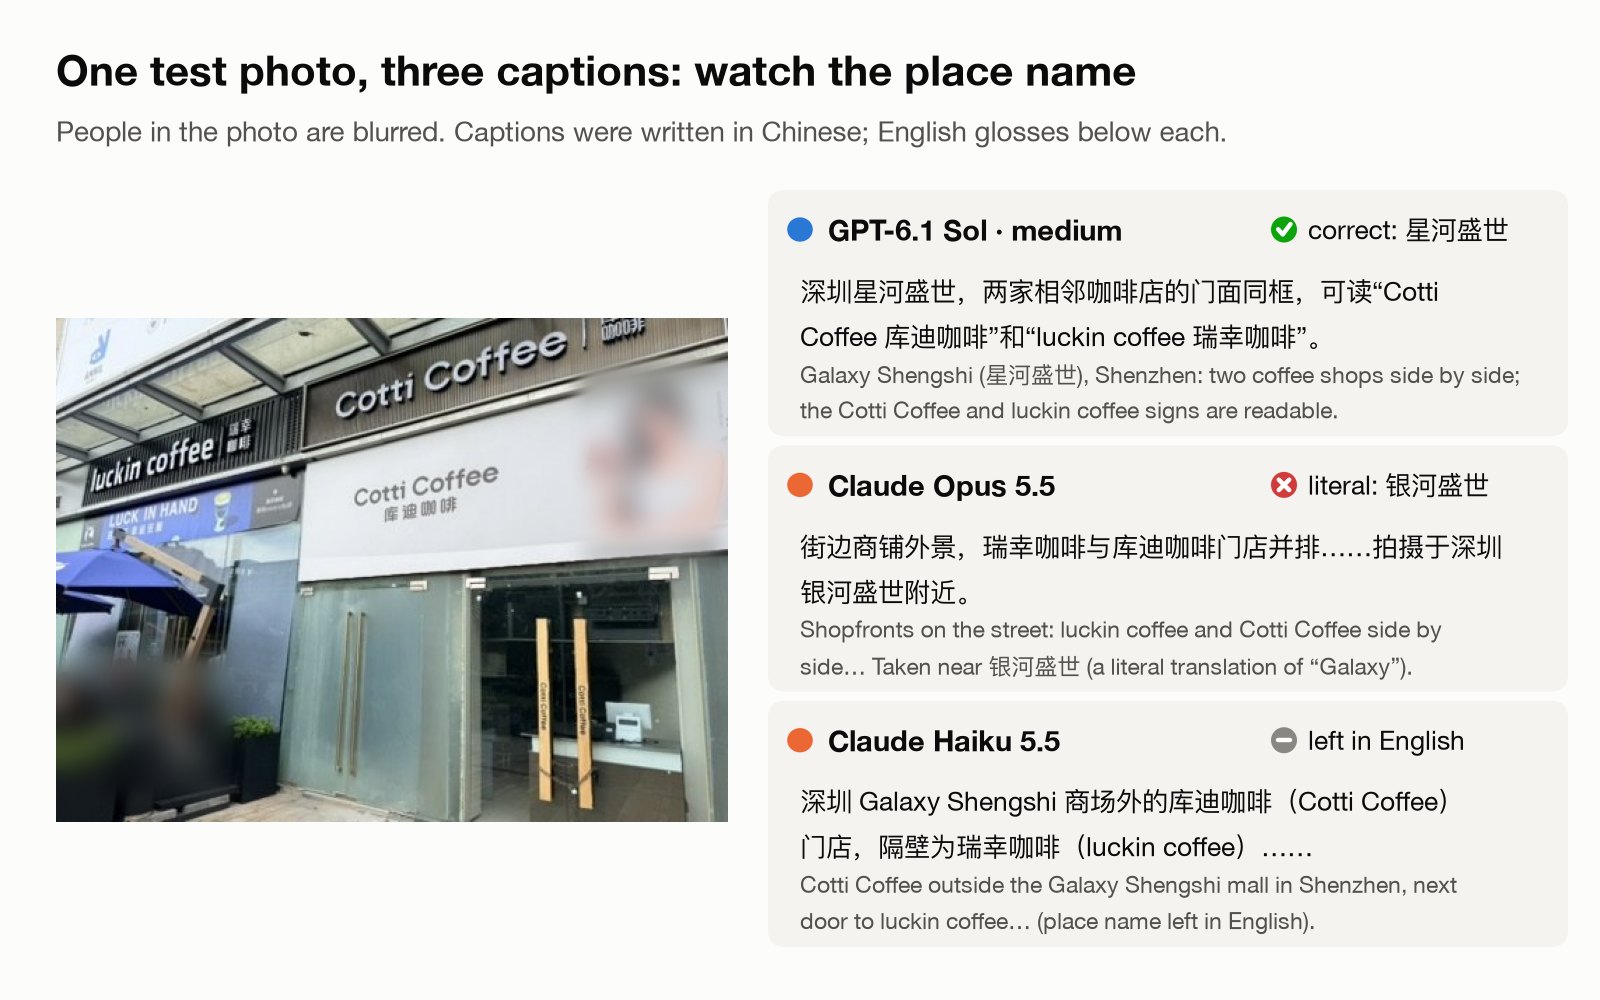 Şekil 2. 50 test fotoğrafından biri, üç açıklamayla birlikte. Her modelin yer adını nasıl ele aldığına bakın; aşağıda buna dönüyorum. Fotoğraftaki insanlar bulanıklaştırıldı.
Nasıl puanladım
Yanıtları kendim puanlamadım. Testten önce zaten bir kazanan seçmiştim ve her gün Claude kullanıyorum, yani tarafsız değildim.
Bunun yerine, her fotoğrafın on yanıtını karıştırıp A'dan J'ye etiketledim; her fotoğraf için yeni bir rastgele sıra. İki değerlendirici daha sonra fotoğraflara bakarak 500 yanıtın tümünü bağımsız puanladı. Biri Anthropic'in en yetenekli modeli Claude Fable 5.1'di. Diğeri OpenAI'ın öncü modeli GPT-6 Astra, xhigh çabada.
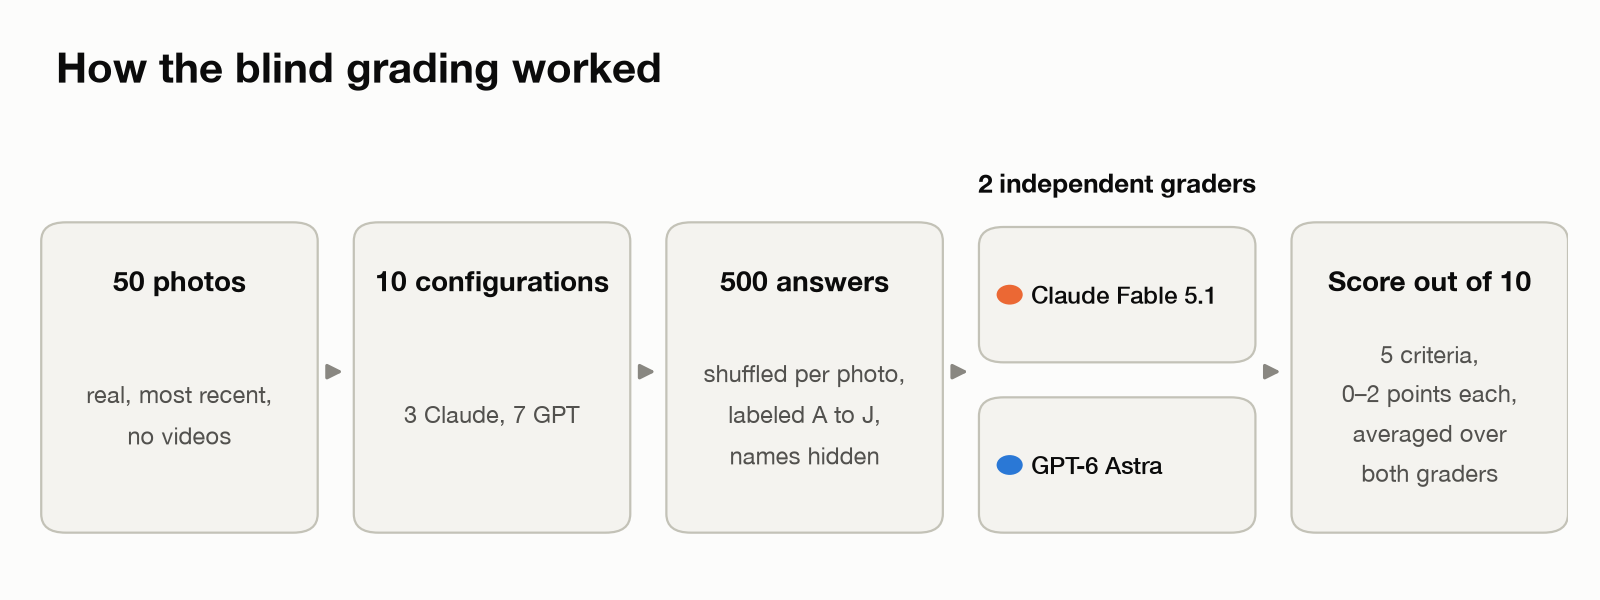 Şekil 3. Kör puanlamanın işleyişi.
Her yanıt beş ölçüt üzerinden puanlandı; her biri 0 ila 2 puan, toplam 10:
| Ölçüt | Değerlendiricinin kontrol ettiği şey |
|---|---|
| Doğruluk | Konu, yer ve okunabilen metinler — yerel yer adları dahil — doğru mu? |
| Uydurulmuş ayrıntı yok | Yanıt, fotoğrafın göstermediği hiçbir şeyi iddia etmekten kaçınıyor mu? |
| Silme kararı | Sakla ya da sil kararı makul mü? İyi bir fotoğrafı silmek 0 puan. |
| Albüm uyumu | Albüm doğru mu? Yanlış bir eski albüm 0 puan; albüm seçmemek kabul edilebilir 1 puan. |
| Kullanışlılık | Başlık, açıklama ve anahtar kelimeler bu fotoğrafı daha sonra bulmama ve hatırlamama yardımcı olur mu? |
Her sağlayıcıdan birer değerlendirici seçtim; böylece ikisinden birinin kendi modellerini kayırıp kayırmadığını görecektim. Çoğunlukla anlaştılar. 500 eşli puan arasındaki korelasyon 0,71'di ve ikisi de aynı beş GPT yapılandırmasını zirveye koydu. Claude değerlendirici ayrıca GPT-6.1 Sol ve GPT-6 Astra'yı Claude Opus'un üzerinde sıraladı. GPT değerlendirici genel olarak daha katıydı; en katısı da Claude modellerine.
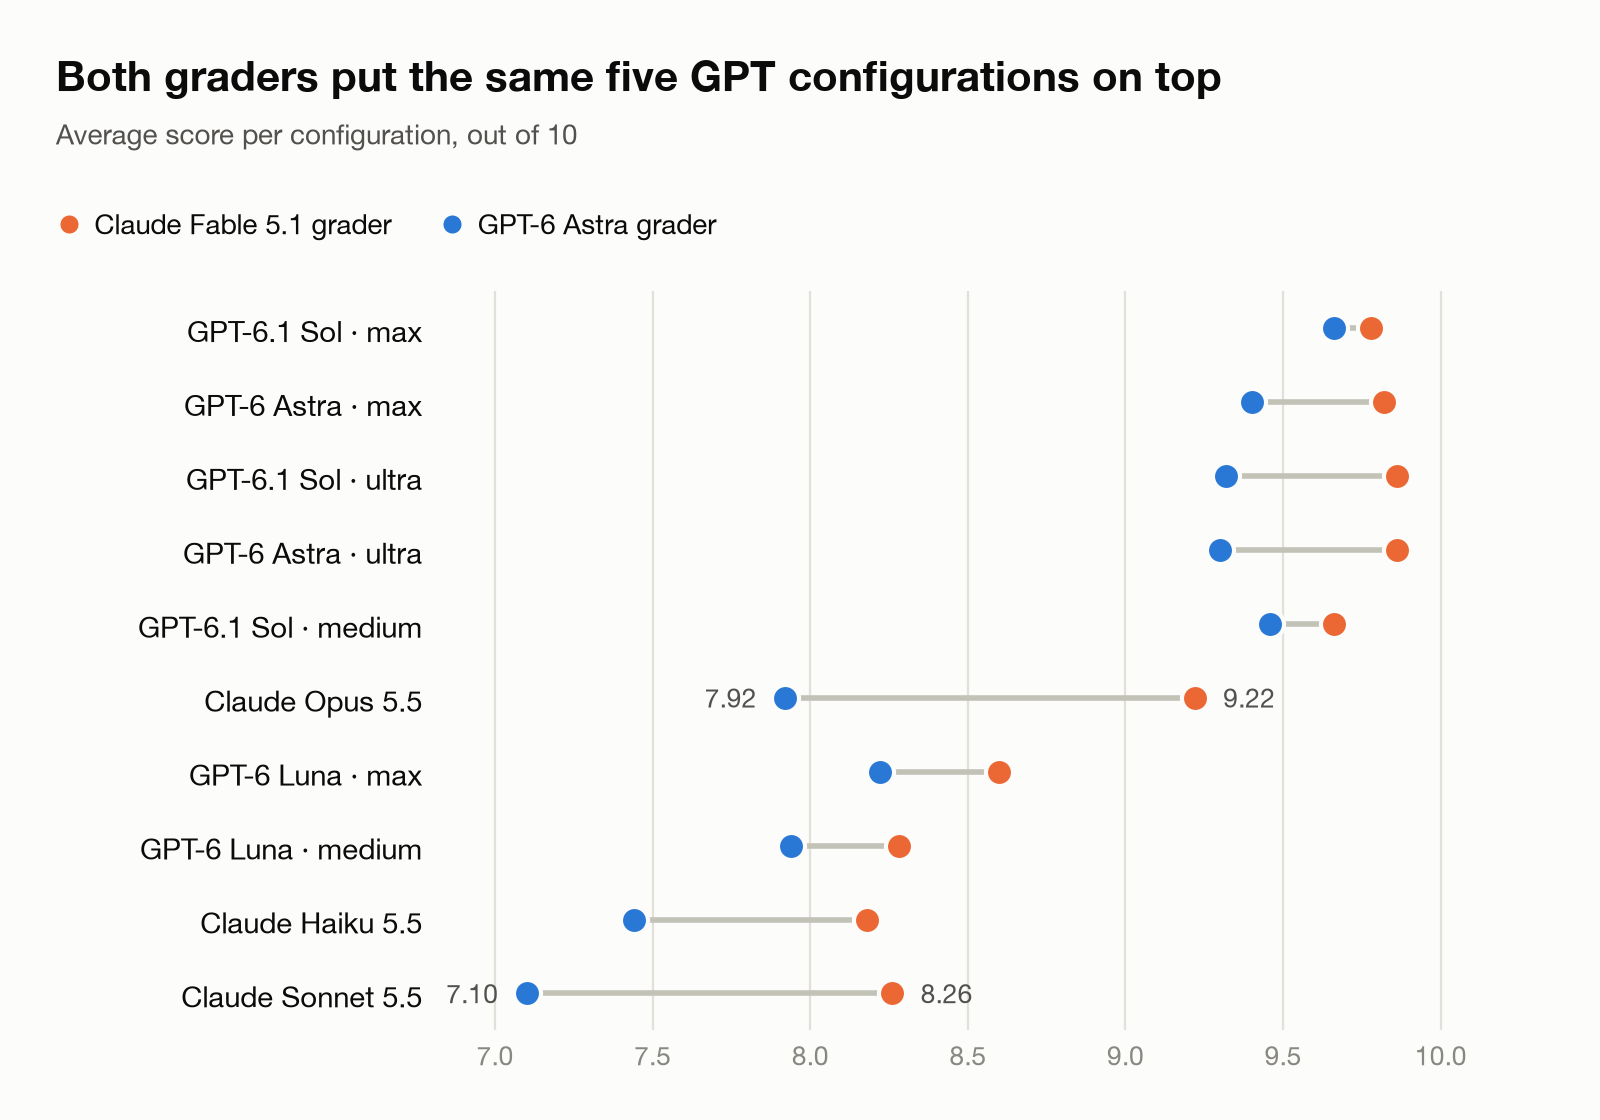 Şekil 4. Her değerlendiricinin yapılandırma başına ortalama puanı.
Sonuçlar
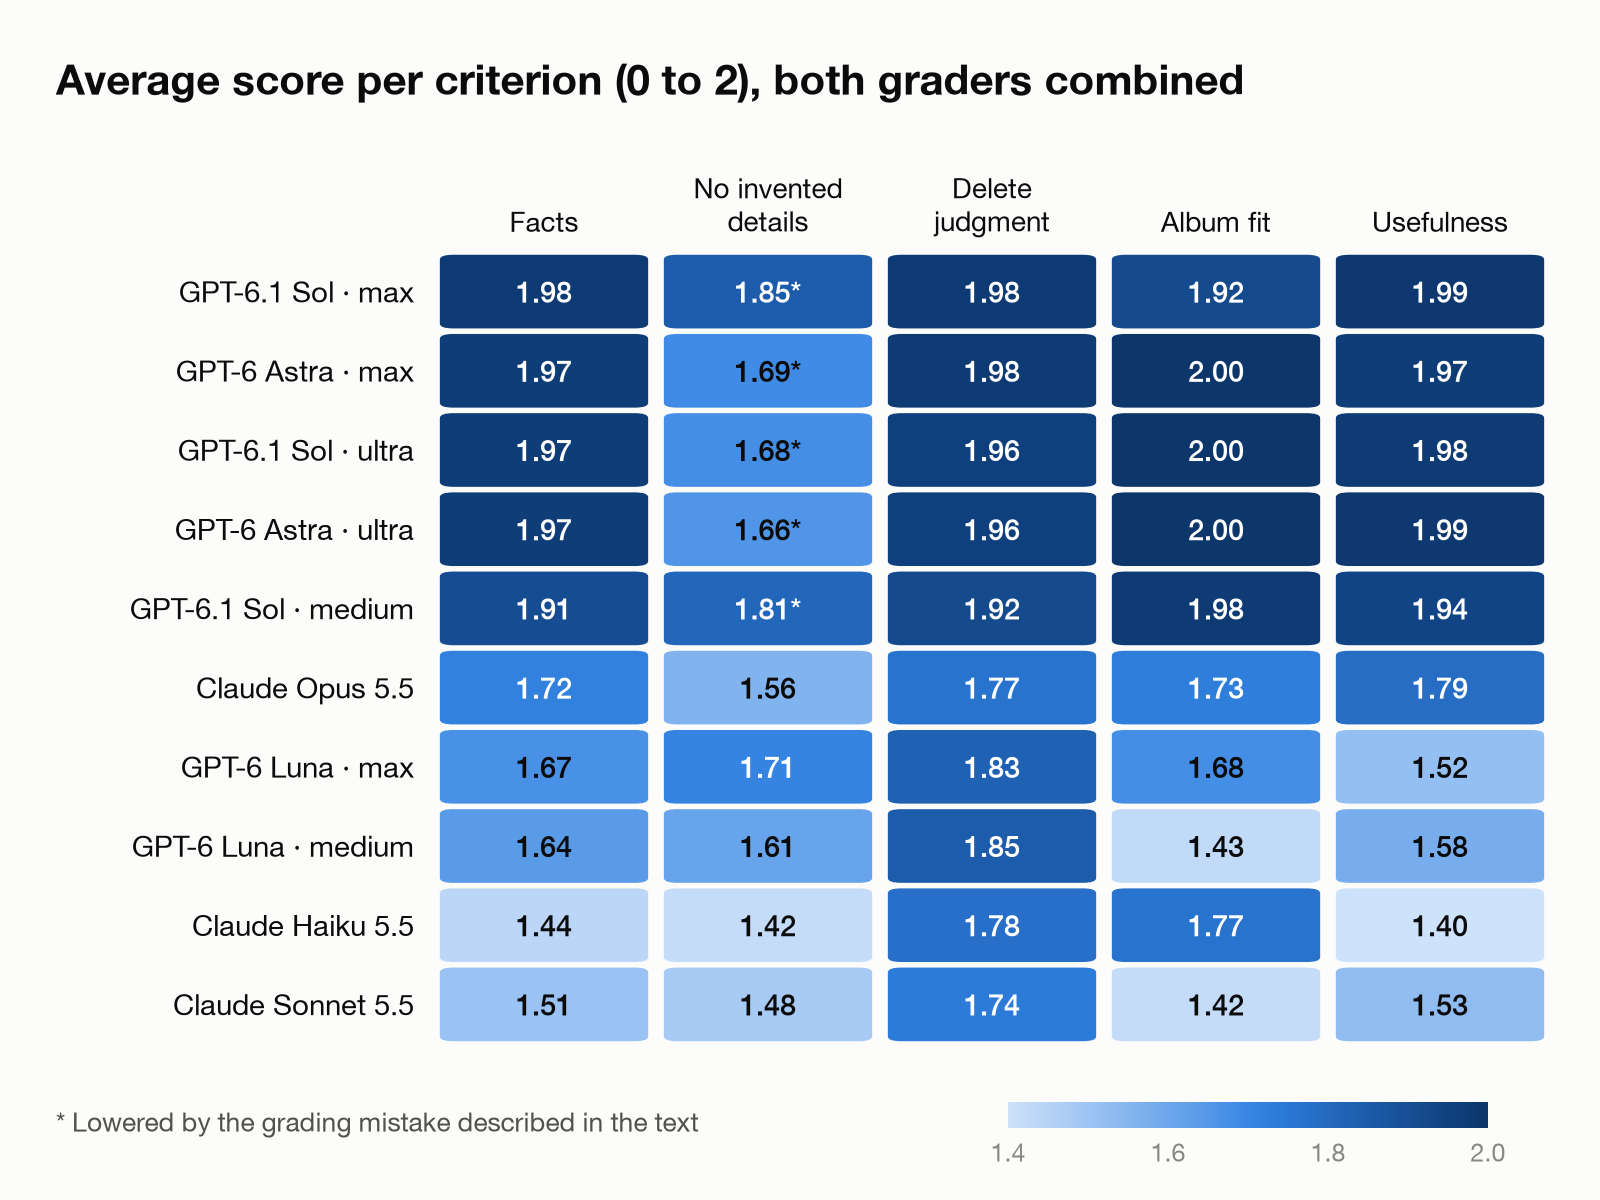 Şekil 5. Ölçüt başına ortalama puan, iki değerlendirici birleşik. Yıldız, aşağıda anlattığım puanlama hatasıyla düşürülmüş puanları işaret eder.
GPT-6.1 Sol ve GPT-6 Astra
Sol ve Astra metinleri doğru okudu ve açıklamalarını çoğunlukla fotoğrafların gösterdiği şeylerle sınırladı. Çin'de çekilen fotoğraflar için önemli olan yerel yer adlarında da en iyisiydiler.
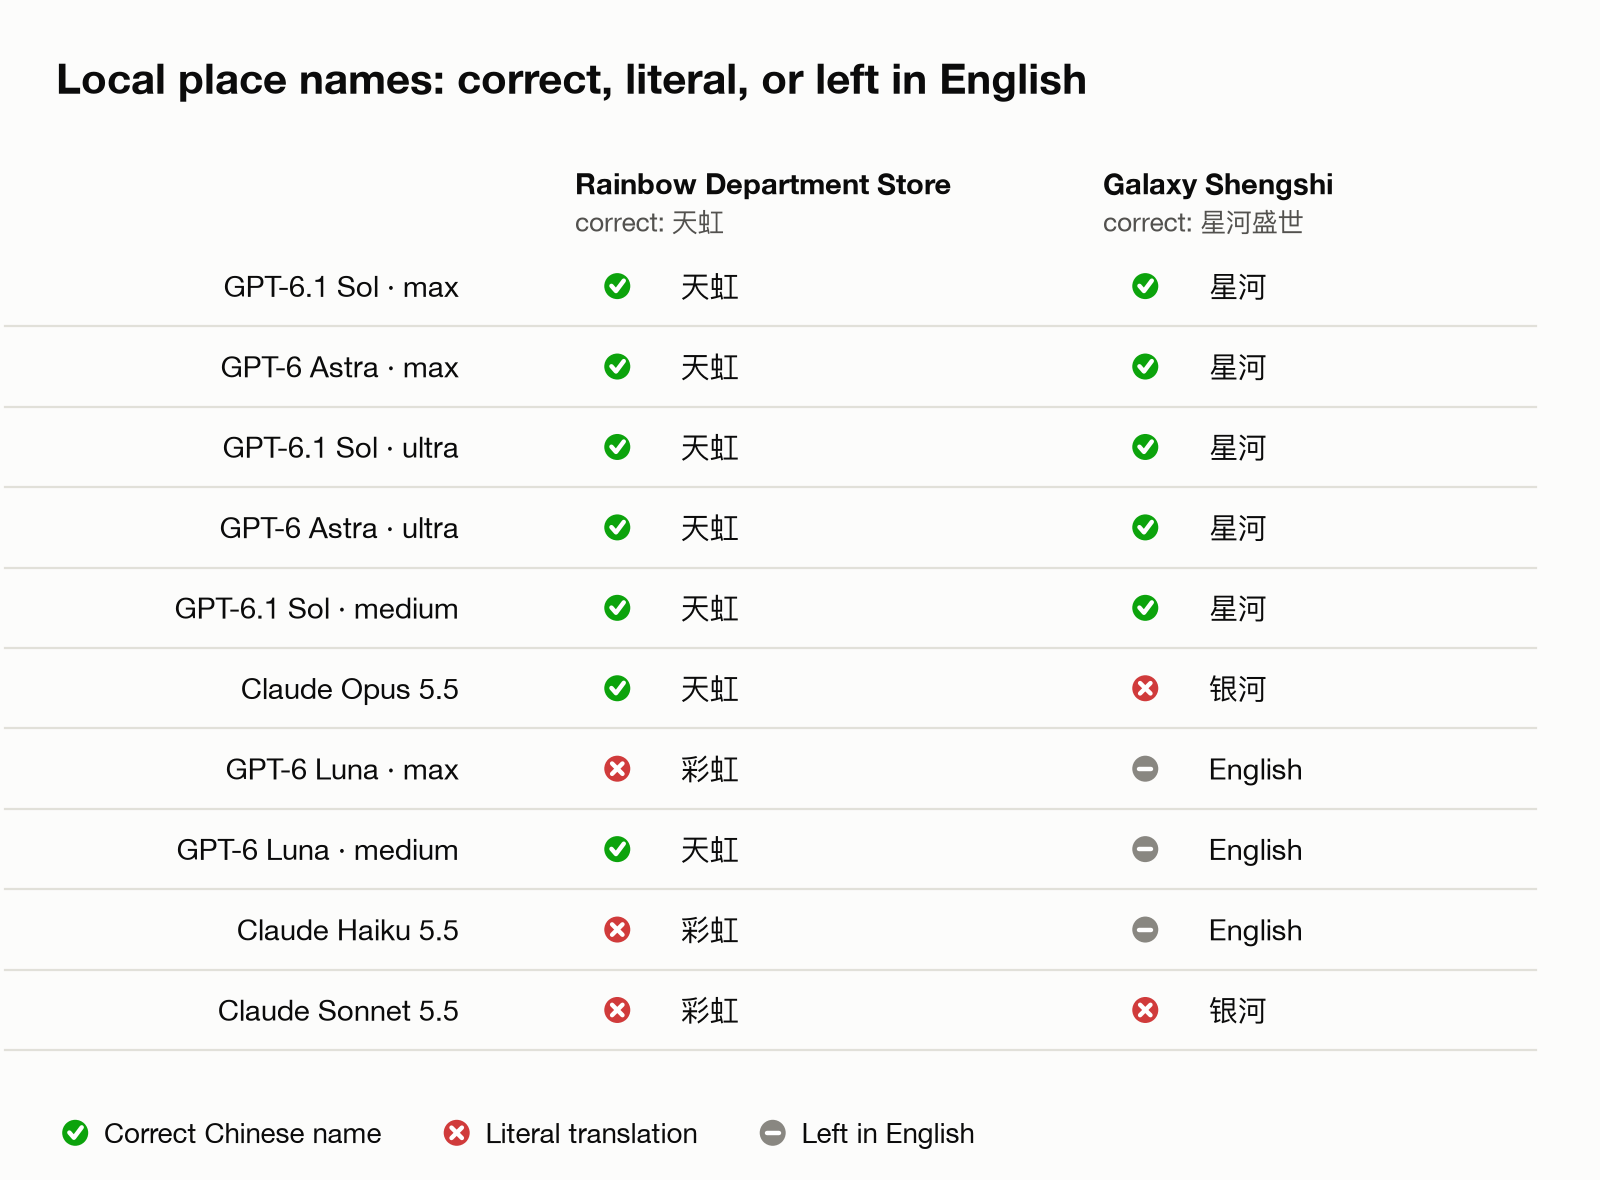 Şekil 6. İki yerel ad testi. Onay işareti doğru Çince adı, çarpı birebir çeviriyi, EN ise adın İngilizce bırakıldığını gösterir.
Birkaç fotoğraf "Rainbow Department Store" konumuyla etiketlendi. Bu, Shenzhen'deki 天虹 mağaza zincirinin İngilizce adı. Sözcük sözcük çevirisi 彩虹百货 verir ve bu yanlış. Her Sol ve Astra yapılandırması bunu doğru yazdı; Opus ve medium çabada Luna da öyle. Haiku, Sonnet ve max çabada Luna birebir çeviriyi kullandı. Şekil 2'deki kahve dükkanı fotoğrafı "Galaxy Shengshi" olarak etiketlendi; Çince adı 星河盛世. Her Sol ve Astra yapılandırması 星河 yazdı. Opus ve Sonnet birebir çevirip 银河 yazdı; Haiku ve her iki Luna yapılandırması adı İngilizce bıraktı.
Sol ve Astra silme konusunda da dikkatliydi. 50 fotoğraftan 4 ila 6'sını silmeyi önerdiler. Set, elektronik parçaların sekiz ürün sayfası ekran görüntüsünü içeriyordu ve GPT modelleri bunların neredeyse tamamını tuttu; bir Sol yapılandırması tek bir ekran görüntüsünü neredeyse yinelenen olarak işaretledi. Claude modelleri her biri iki ila dört işaretledi. İki değerlendirici de bunları tutmaktan yanaydı; sayfalarda daha sonra bakmak isteyeceğim pin şemaları, ölçüler ve kart fotoğrafları vardı.
Claude Opus 5.5
Opus bazen fotoğrafın tek başına gösteremeyeceği şeyleri açıklamaya yazdı. Görüntünün tek başına kanıtlayamayacağı ilişkileri — örneğin kardeşlik ya da ebeveyn-çocuk — betimledi. Bazı pozları da yanlış anladı. Bir fotoğrafta bir çocuk bir yetişkinin arkasında duruyordu; Opus çocuğun yetişkinin sırtında olduğunu yazdı. İki değerlendirici de bunun için puan kırdı.
Bu beni şaşırttı. Kör testten önce yanıtlara bakmış ve Opus'u iki çocuğun kardeş olduğunu doğru tahmin ettiği için övmüştüm. Ailemi ben tanırım; değerlendirici tanımaz. Ama 142.000 fotoğrafta her açıklamayı kendim kontrol edemem ve fotoğrafın göstermediği bir şeyi öne süren bir açıklama sorundur.
Opus ayrıca en çok silme öneren modeldi: 50 fotoğraftan 13'ü. Bunlardan üçü, saklayacağım referans bilgileri içerdiği halde "süresi geçmiş" dediği ürün sayfası ekran görüntüsüydü. Otopark indirimi karekodunu düşük değer diye silmek isteyen tek modeldi. Ayrıca tek bir kişinin birkaç fotoğrafını "aile portresi" albümüne koydu.
Claude Sonnet 5.5 ve Haiku 5.5
Bu ikisi en çok olgusal hata yaptı; birebir 彩虹 çevirisi dahil. Sonnet en zayıf albüm seçimlerini yaptı ve gündelik fotoğrafları ilgisiz bir etkinlikten kalma eski bir albüme koydu. Haiku, kötü bir silme kararına yol açan bir ayrıntı uydurdu. Neredeyse aynı karelerden oluşan bir seride, en iyi kareyi birinin aşağı baktığı an olarak betimledi — ki bu fotoğrafın gösterdiğinin tam tersi — ve silmeyi önerdi.
GPT-6 Luna
Luna, token başına Haiku ile aynı fiyata ama her iki çaba seviyesinde daha yüksek puan aldı: Haiku'nun 7,81'ine karşı 8,41 ve 8,11. Max çabada aynı kütüphaneye açıklama yazması yaklaşık 17 kat pahalıya gelecek Sonnet'i de geçti. Luna puanlarının çoğunu kullanışlılık ve albüm seçiminde kaybetti. Açıklamaları daha sade, albümleri daha az isabetliydi.
Çaba seviyeleri
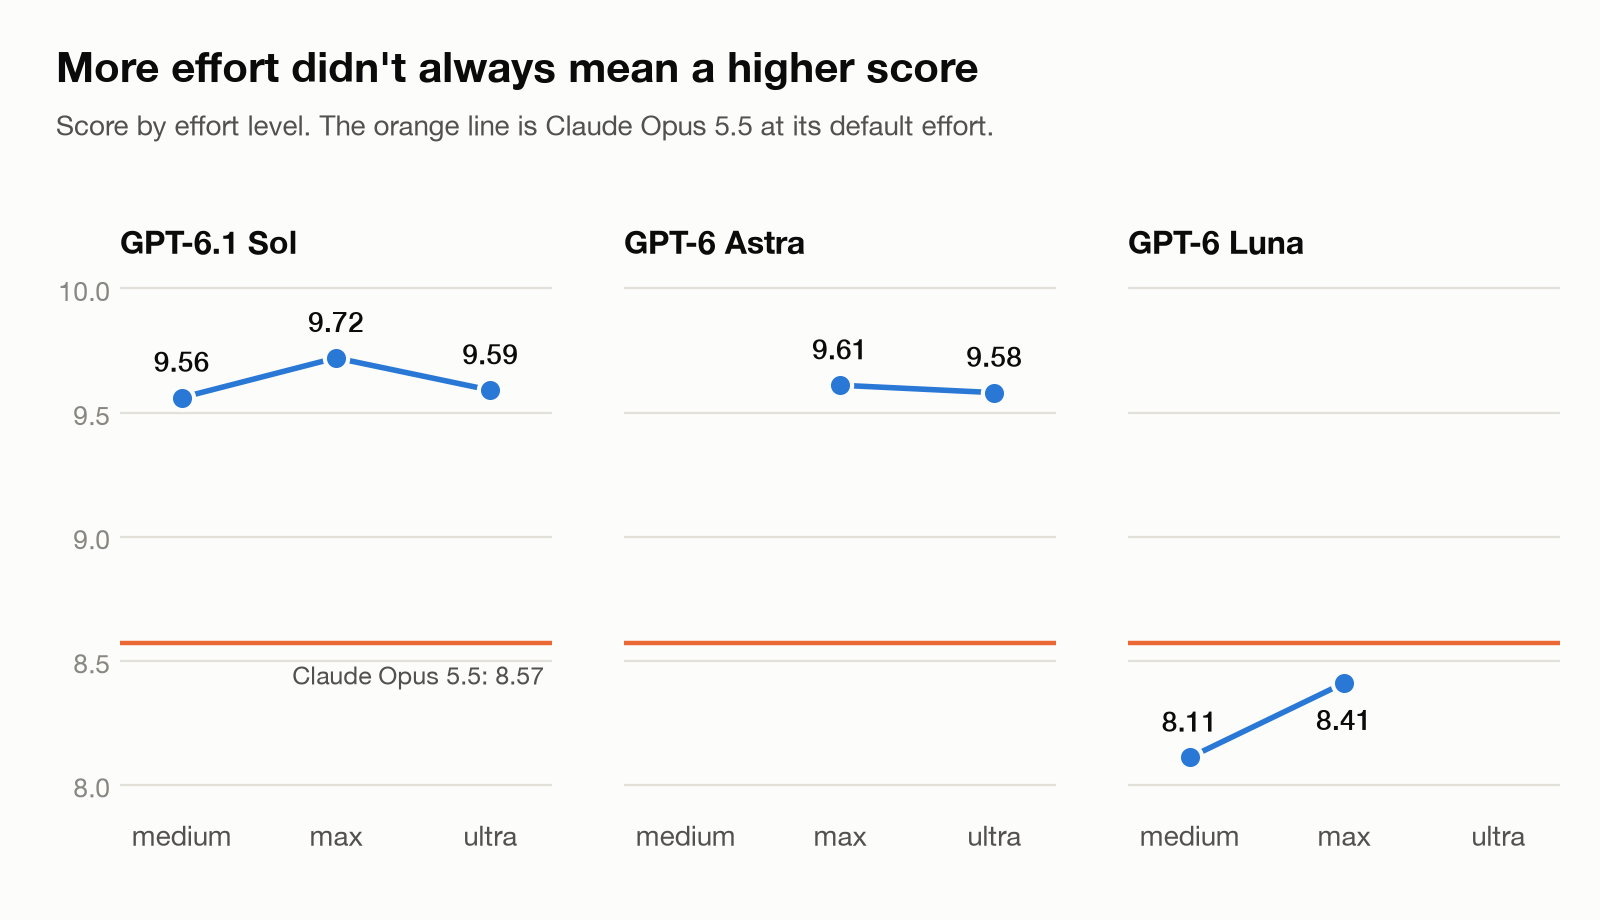 Şekil 7. Çaba seviyesine göre puan. Turuncu çizgi, varsayılan çabada Claude Opus 5.5.
Ultra, iki model için de max'tan daha iyi değildi. Sol ultra'da 9,59, max'ta 9,72 aldı; Astra 9,58 ve 9,61 aldı. Bu testte ultra, max'tan daha az çıktı token'ı bile üretti. Sol için medium 9,56 ile yaklaştı ve max'ın maliyetinin yarısından az. Daha yüksek çaba her zaman daha doğru ayrıntı demek değildi: medium çabadaki Luna 天虹'yı doğru yazdı, max çabadaki Luna yazamadı.
Puanlamamda bir hata
Puanlamadan sonra, açıklama yazan modellere her fotoğrafın çekim tarihi ve saati verildiği halde değerlendiricilere verilmediğini fark ettim. Bu yüzden GPT-6 Astra değerlendirici, kesin tarih ya da saat belirten açıklamaları uydurulmuş ayrıntı saydı. Üst sıradaki GPT yapılandırmaları en sık tarih belirttiği için "uydurulmuş ayrıntı yok" puanları olması gerekenden düşük çıktı.
Yalnızca tarihler yüzünden kaybedilen puanları geri verirsem, ilk dört GPT yapılandırması 9,84 ile 9,90 arasına çıkar — bu fiilen beraberlik — ve Opus 8,58'de kalır. Bu yazıda asıl puanları korudum. Bir dahaki sefere değerlendiricilere modellerin gördüğü her şeyi vereceğim.
Hız
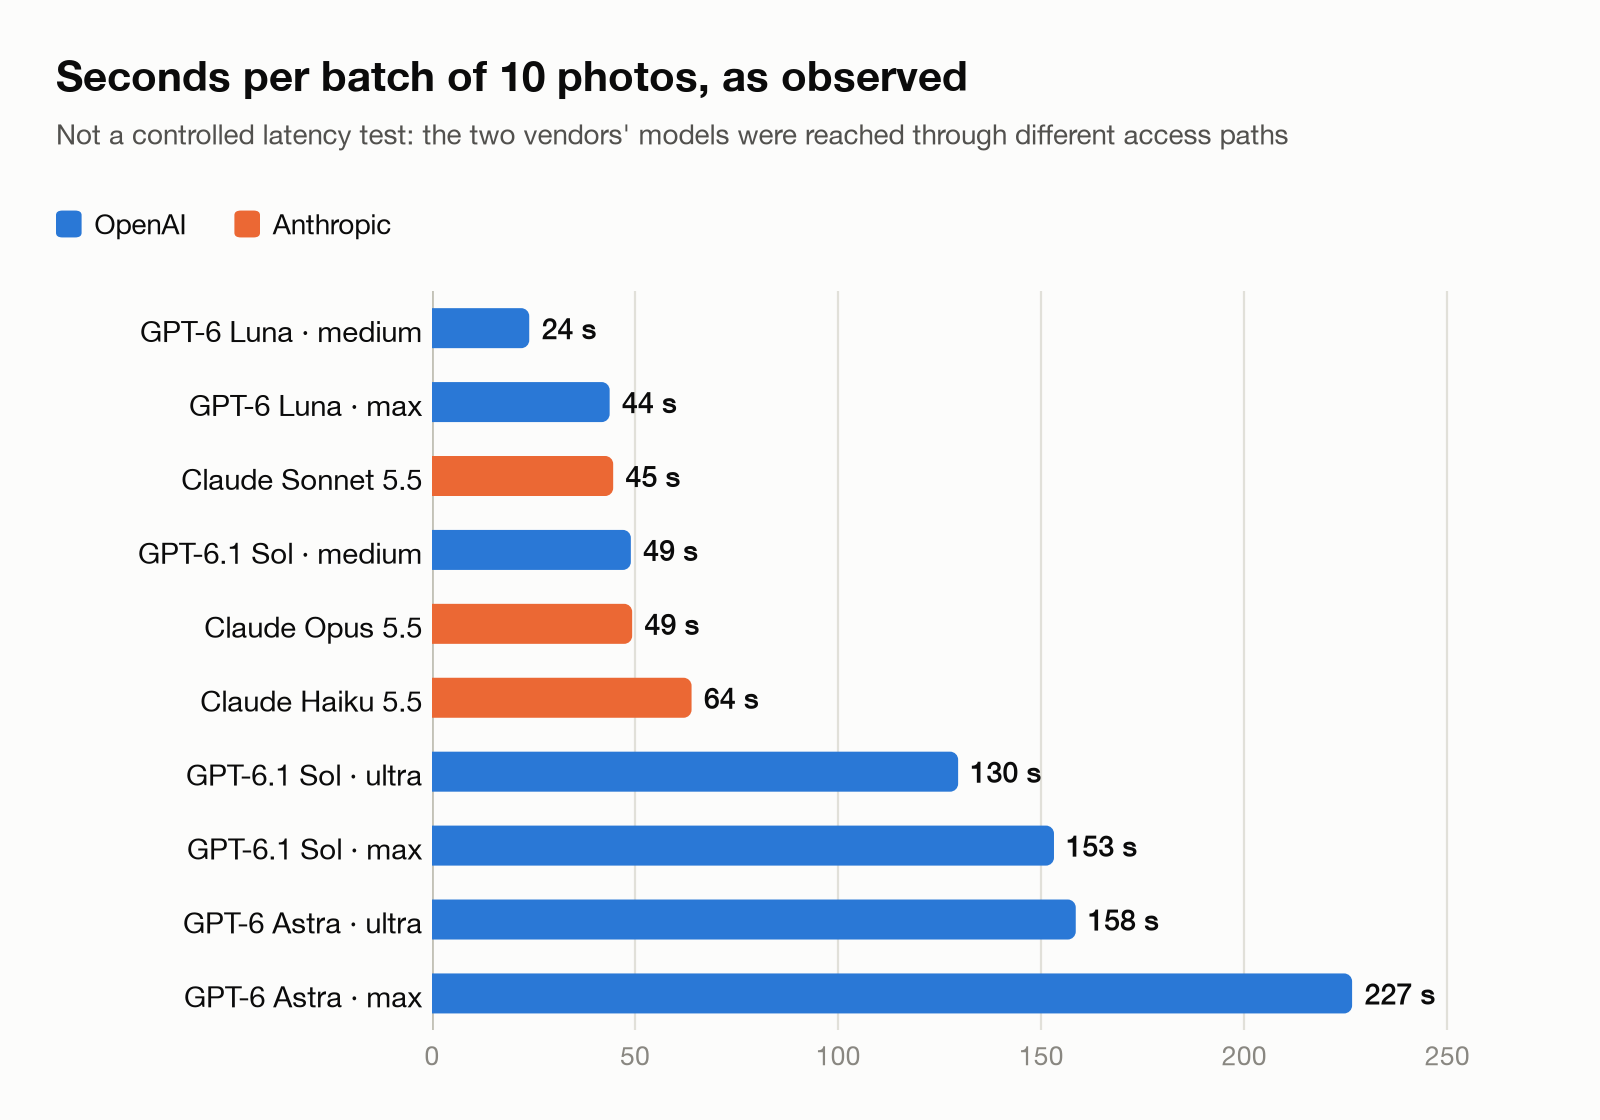 Şekil 8. 10 fotoğraflık parti başına saniye, gözlemlendiği haliyle. Bu kontrollü bir gecikme testi değil; iki sağlayıcının modellerine farklı erişim yollarından ulaşıldı.
Bu, Opus'un günlük işimdeki hissine uyuyor: hızlı, max çabadaki Sol'dan yaklaşık üç kat daha hızlı. Yine de medium çabadaki Sol, Opus kadar hızlıydı ve yaklaşık bir puan daha yüksek aldı.
Maliyeti ne kadar
Her yapılandırmayı sağlayıcıların resmî API fiyatlarıyla fiyatlandırdım. Abonelik planının dahil kullanımını ücretsiz saymak, bazı modelleri olduğundan daha iyi gösterebilir.
Resmî fiyatlar, milyon token başına, standart katman:
| Model | Girdi | Çıktı |
|---|---|---|
| Claude Opus 5.5 | $4.00 | $20.00 |
| Claude Sonnet 5.5 | $2.00 | $10.00 |
| Claude Haiku 5.5 | $0.10 | $0.50 |
| GPT-6 Astra | $10.00 | $50.00 |
| GPT-6.1 Sol | $2.00 | $10.00 |
| GPT-6 Luna | $0.10 | $0.50 |
Her iki sağlayıcının Batch API'si %50 daha ucuz; bu da anında yanıt gerektirmeyen böyle bir işe uyar. Fiyatları 20 Ekim 2026'da Anthropic'in fiyatlandırma sayfasından (claude.com/pricing) ve OpenAI'ın API fiyatlandırma sayfasından (developers.openai.com/api/docs/pricing) aldım.
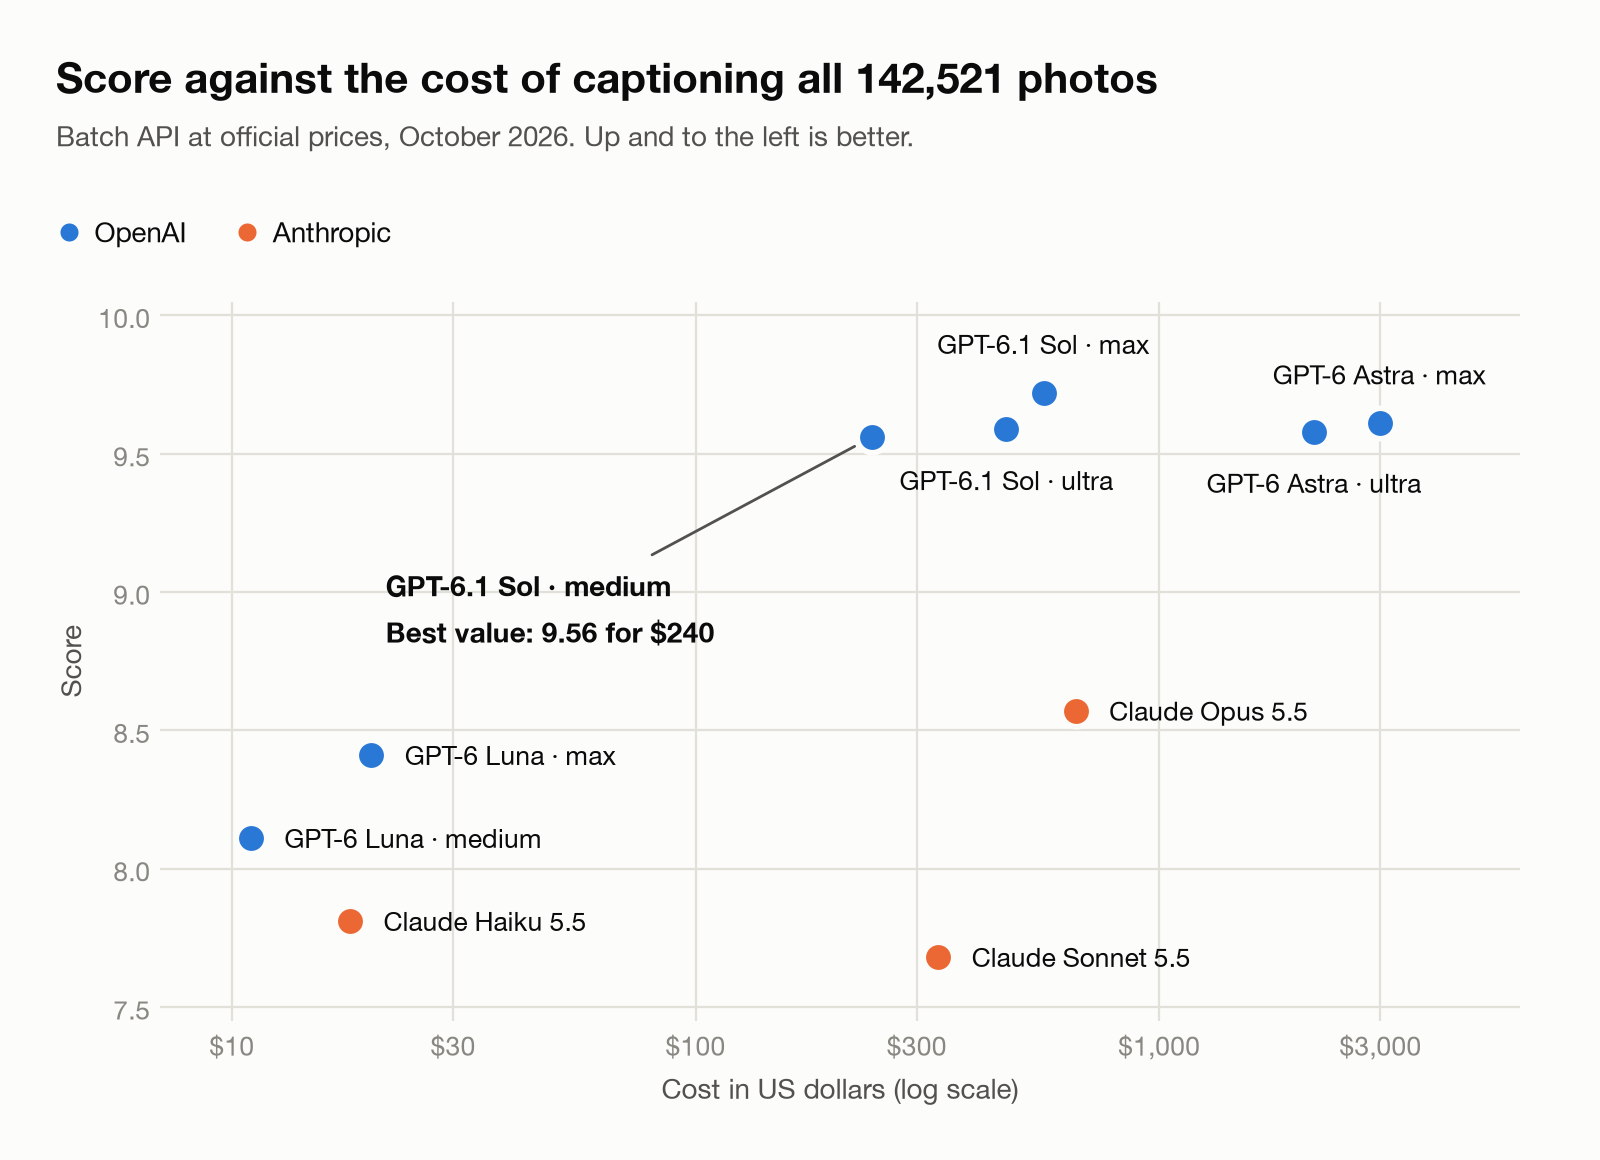 Şekil 9. Tüm kütüphaneye Batch fiyatlarıyla açıklama yazmanın maliyetine karşı puan. Maliyet ekseni logaritmik.
| Model ve çaba | Fotoğraf başına çıktı token'ı | Standart | Batch | Puan |
|---|---|---|---|---|
| GPT-6.1 Sol, medium | 193 | $479 | $240 | 9.56 |
| GPT-6.1 Sol, ultra | 514 | $937 | $468 | 9.59 |
| GPT-6.1 Sol, max | 647 | $1,126 | $563 | 9.72 |
| Claude Opus 5.5 | ~292 | $1,323 | $661 | 8.57 |
| Claude Sonnet 5.5 | ~297 | $668 | $334 | 7.68 |
| GPT-6 Astra, ultra | 462 | $4,313 | $2,156 | 9.58 |
| GPT-6 Astra, max | 695 | $5,973 | $2,987 | 9.61 |
| GPT-6 Luna, medium | 163 | $22 | $11 | 8.11 |
| Claude Haiku 5.5 | ~330 | $36 | $18 | 7.81 |
| GPT-6 Luna, max | 419 | $40 | $20 | 8.41 |
Medium çabadaki Sol, en yüksek puanın %98'ini, Opus'un maliyetinin %36'sına ve max çabadaki Sol'un %43'üne aldı. Astra, Sol'un kalitesini yakaladı ama yaklaşık beş kat pahalı; çünkü token başına fiyatı beş kat daha yüksek. Opus, max çabadaki Sol'dan daha pahalıya geldi ve daha düşük puan aldı. Zaten medium çabada çalışıyordu ama token başına fiyatı Sol'un iki katı. Luna tüm kütüphaneye $11 ila $20'ya açıklama yazar ve yine de Haiku ile Sonnet'i geçer.
Yöntem notu: GPT token sayıları çalıştırmalardan ölçüldü, Claude token sayıları çalıştırma günlüklerinden tahmin edildi. Bazı Claude akıl yürütme token'ları görünmüyordu, bu yüzden Claude maliyetleri biraz eksik hesaplanmış olabilir. Hiçbir modele Batch dışında, istem önbelleğe alma gibi bir indirim uygulanmadı.
Öğrendiklerim
Kör puanlarım olmadan önce Opus'u seçmiştim; çoğunlukla zaten kodlama varsayılanım olduğu için. Kodlama ve iş akışları için hâlâ Claude Opus 5.5'i tercih ediyorum; deneyimime göre daha hızlı ve daha güçlü. Gerçek fotoğrafları betimlemek farklı bir beceri gerektiriyor: pozları ve ilişkileri doldurmadan karede gerçekte ne olduğunu okumak. GPT-6.1 Sol bunu daha iyi yaptı. Alışkanlığa uyup kör testi atlasaydım, daha kötü açıklamalar için daha fazla öderdim.
Bir dahaki sefere kör başlayacağım ve farklı sağlayıcılardan değerlendiricilere, açıklama yazan modellerin aldığı tüm girdileri vereceğim. Resmî API fiyatlarıyla karşılaştırmaya da devam edeceğim ve daha fazla çabanın daha iyi olduğunu varsaymayacağım: burada ultra, max'ı geçmedi.
En iyi modeller bile faydalı fotoğrafları silinmek üzere işaretledi; bu yüzden bir şey silmeden önce her silme işaretini kendim kontrol edeceğim.
Sınırlamalar
Bu küçük bir testti: tek bir şehirden 50 güncel fotoğraf. Eski fotoğrafları, taranmış belgeleri, diğer dilleri ya da videoları test etmedim. Claude modelleri yalnızca varsayılan ayarlarında çalıştı; daha yüksek çabadaki bir Opus daha yüksek maliyetle daha iyi puan alabilir. Değerlendiriciler insan değil, yapay zekâ modeli. İyi ama mükemmel değil anlaştılar; bir insan örneklemesi sonucu güçlendirirdi. Modeller ve fiyatlar hızlı değişiyor; buradaki her sayı Ekim 2026 itibarıyladır.
Benim seçimim
Kütüphanem için: medium çabada GPT-6.1 Sol. Kodlama ve iş akışları için Claude Opus 5.5'te kalıyorum.