
我用 10 個 AI 模型盲測了自己 14 萬張照片的圖庫:GPT-6.1 Sol 勝過 Claude Opus
摘要
我每天用 Claude Opus 5.5 寫程式、跑工作流程,這類工作上我一直覺得它比 GPT-6 快,也更好用。我以為描述照片它也會最強,就專門測了一下。參加測試的有 10 種配置:Claude Haiku、Sonnet、Opus 5.5,以及 OpenAI 的 GPT-6.1 Sol、GPT-6 Astra、GPT-6 Luna 的幾個推理強度檔位。每個配置都要給我圖庫(共 142,521 張)裡的 50 張真實照片寫標題、寫描述、打關鍵字、選相簿,再挑出該刪的照片。我從兩家廠商各選了一個模型做盲評,Claude Fable 5.1 和 GPT-6 Astra,從事實、有無編造、刪除判斷、相簿是否合適、是否實用五個方面,給全部 500 份答案打分。GPT-6.1 Sol 最高,9.72 分(滿分 10 分);Opus 8.57 分;Sonnet 和 Haiku 在 7.7 到 7.8 分之間。ultra 檔並不比 max 檔好。按官方 Batch API 價格,給整個圖庫寫描述,medium 檔的 Sol 大約 $240(9.56 分),Opus 要 $661,Luna 只要 $11 到 $20,分數還比 Haiku 高。
為什麼要測
我每天大部分時間在寫程式、跑 agent 工作流程、做自動化,用得最多的就是 Claude Opus 5.5。這類工作上,我的感受一直是它比 GPT-6 快,也更好。所以想讓 AI 給照片寫描述、打標籤時,我想都沒想就選了 Opus。
這個圖庫是我 25 年的生活:142,521 張照片,從早年的數位相機到上週的手機照片,光截圖就有一萬六千多張,幾乎都沒寫過描述。我希望每張照片都有標題、描述和搜得到的關鍵字,放進合適的相簿;如果是重複或沒用的照片,也要老實標出來。真要為 14 萬張照片花錢之前,我想先搞清楚哪個模型做得最好,差別又值多少錢。
我原本以為 Opus 會贏。結果在這 50 張照片上,GPT-6.1 Sol 高出了一分多。
結果一覽
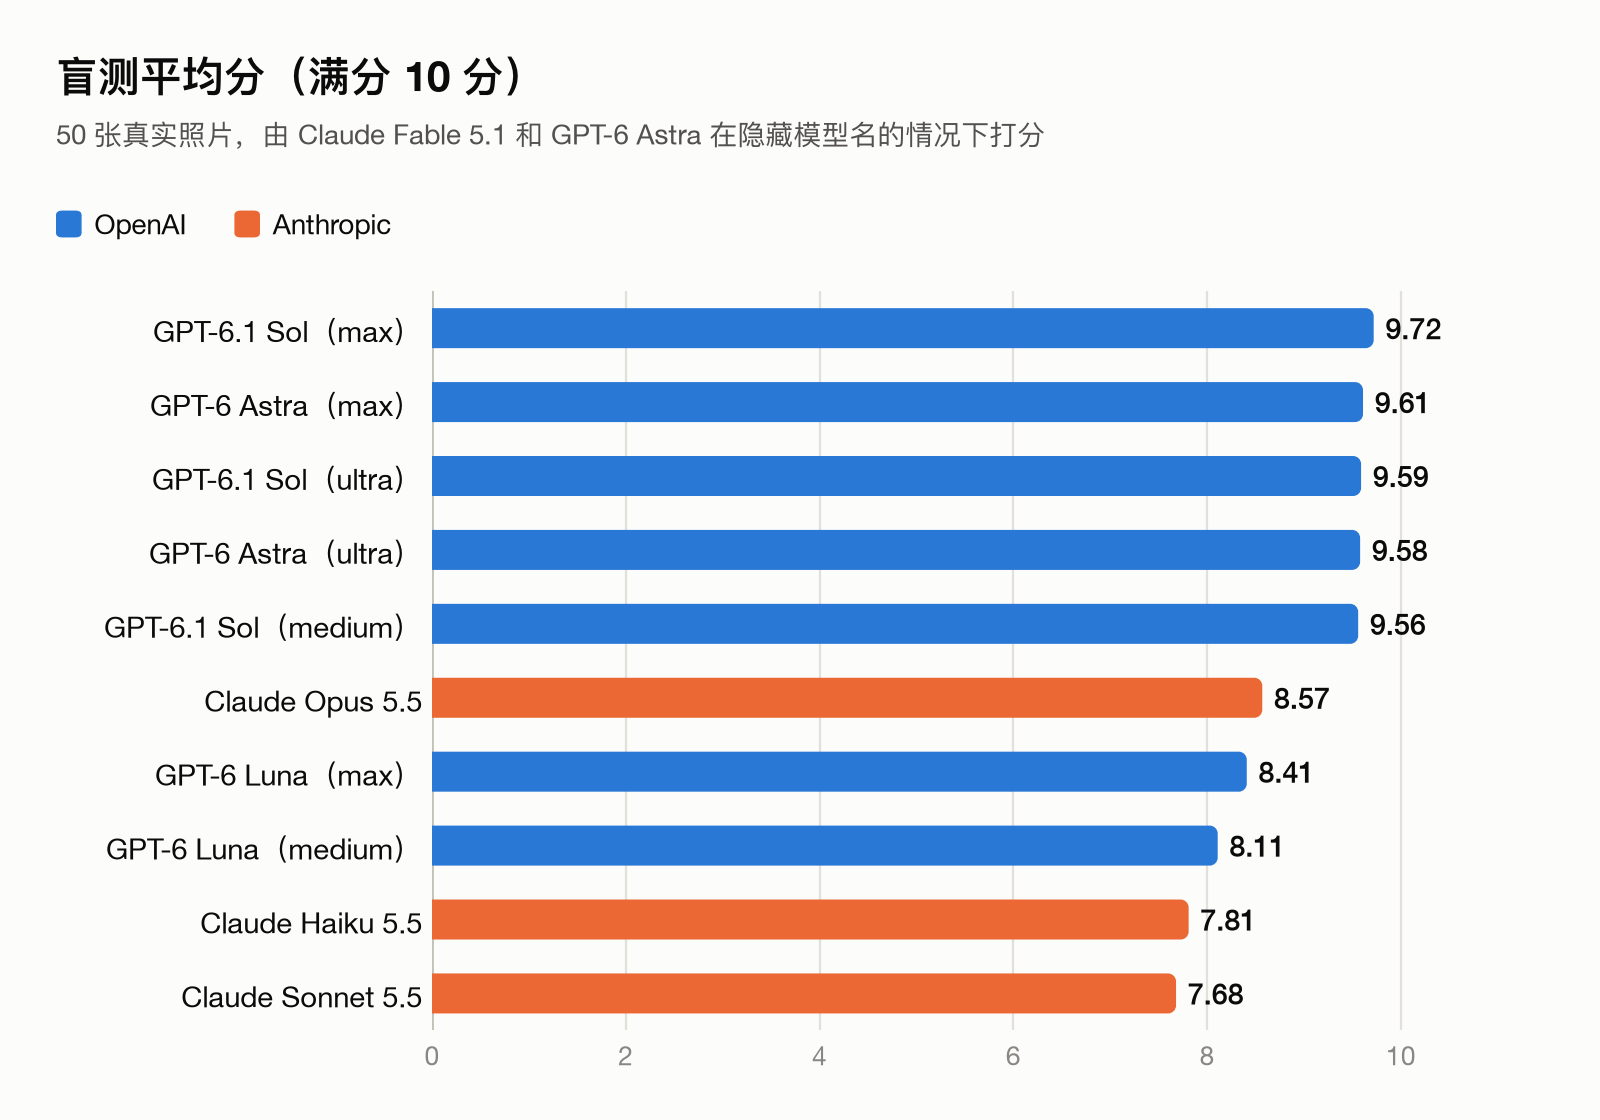 圖 1:兩位盲評的平均分,滿分 10 分。
| 名次 | 模型與推理強度 | 得分(滿分 10) | 全庫成本(Batch API) | 全庫成本(標準 API) |
|---|---|---|---|---|
| 1 | GPT-6.1 Sol,max | 9.72 | $563 | $1,126 |
| 2 | GPT-6 Astra,max | 9.61 | $2,987 | $5,973 |
| 3 | GPT-6.1 Sol,ultra | 9.59 | $468 | $937 |
| 4 | GPT-6 Astra,ultra | 9.58 | $2,156 | $4,313 |
| 5 | GPT-6.1 Sol,medium | 9.56 | $240 | $479 |
| 6 | Claude Opus 5.5 | 8.57 | $661 | $1,323 |
| 7 | GPT-6 Luna,max | 8.41 | $20 | $40 |
| 8 | GPT-6 Luna,medium | 8.11 | $11 | $22 |
| 9 | Claude Haiku 5.5 | 7.81 | $18 | $36 |
| 10 | Claude Sonnet 5.5 | 7.68 | $334 | $668 |
成本按各廠商官方 API 價格,給全部 142,521 張照片寫描述計算。
按這次的結果,我會這樣選:
- 只看分數,選 GPT-6.1 Sol 的 max 檔。
- 我自己的圖庫,選 GPT-6.1 Sol 的 medium 檔。拿到最高分的 98%,只要 $240,大約是 Opus 的三分之一。
- 預算很緊,選 GPT-6 Luna 的 max 檔。只要 $20,分數比同價位的 Haiku 高,也比成本貴約 17 倍的 Sonnet 高。
- 不選 Claude Sonnet 5.5:價格中等,分數最低。
參加測試的模型
| 廠商 | 模型 | 測試的推理強度 | 定位 |
|---|---|---|---|
| Anthropic | Claude Opus 5.5 | 預設(medium) | 旗艦、日常主力 |
| Anthropic | Claude Sonnet 5.5 | 預設 | 中階 |
| Anthropic | Claude Haiku 5.5 | 預設 | 快速、低成本 |
| OpenAI | GPT-6 Astra | max、ultra | 前沿旗艦 |
| OpenAI | GPT-6.1 Sol | medium、max、ultra | 主力 |
| OpenAI | GPT-6 Luna | medium、max | 快速、低成本 |
兩家的價格檔位正好對得上:GPT-6.1 Sol 和 Claude Sonnet 5.5 單價相同,GPT-6 Astra 和 Claude Fable 5.1 相同,GPT-6 Luna 和 Claude Haiku 5.5 相同,Claude Opus 5.5 在 Sol 和 Astra 之間。所以單價相同的模型,處理同一批照片時,誰用的 token 多,誰就更貴。
Claude 模型各按預設設定跑了一次,Opus 預設是 medium 檔;GPT 模型我測了好幾個檔位。兩邊都用 medium 檔時,GPT-6.1 Sol 得 9.56 分,Claude Opus 5.5 得 8.57 分,這樣比較最公平。
怎麼測的
我用的是當時圖庫裡最新的 50 張照片,不含影片,就是普通一週的手機相簿:家裡和出去逛街時的家庭照、高樓窗外的城市景色、桌上的一張記憶卡、電子元件的商品詳情頁截圖、訂單物流截圖、一則社群貼文、一個停車優惠 QR code 立牌,還有一個充電樁標籤。
每張照片,每個模型都要做五件事:寫一個短標題;寫一到三句中文描述;給 5 到 12 個中英雙語關鍵字;從我已有的相簿裡選一個最合適的,或者不選;打一個品質分,並說明該留還是該刪,重點看重複、拍壞、過期截圖和沒有保存價值的照片。所有模型拿到的指令和每張照片的上下文都一樣,每次處理 10 張。
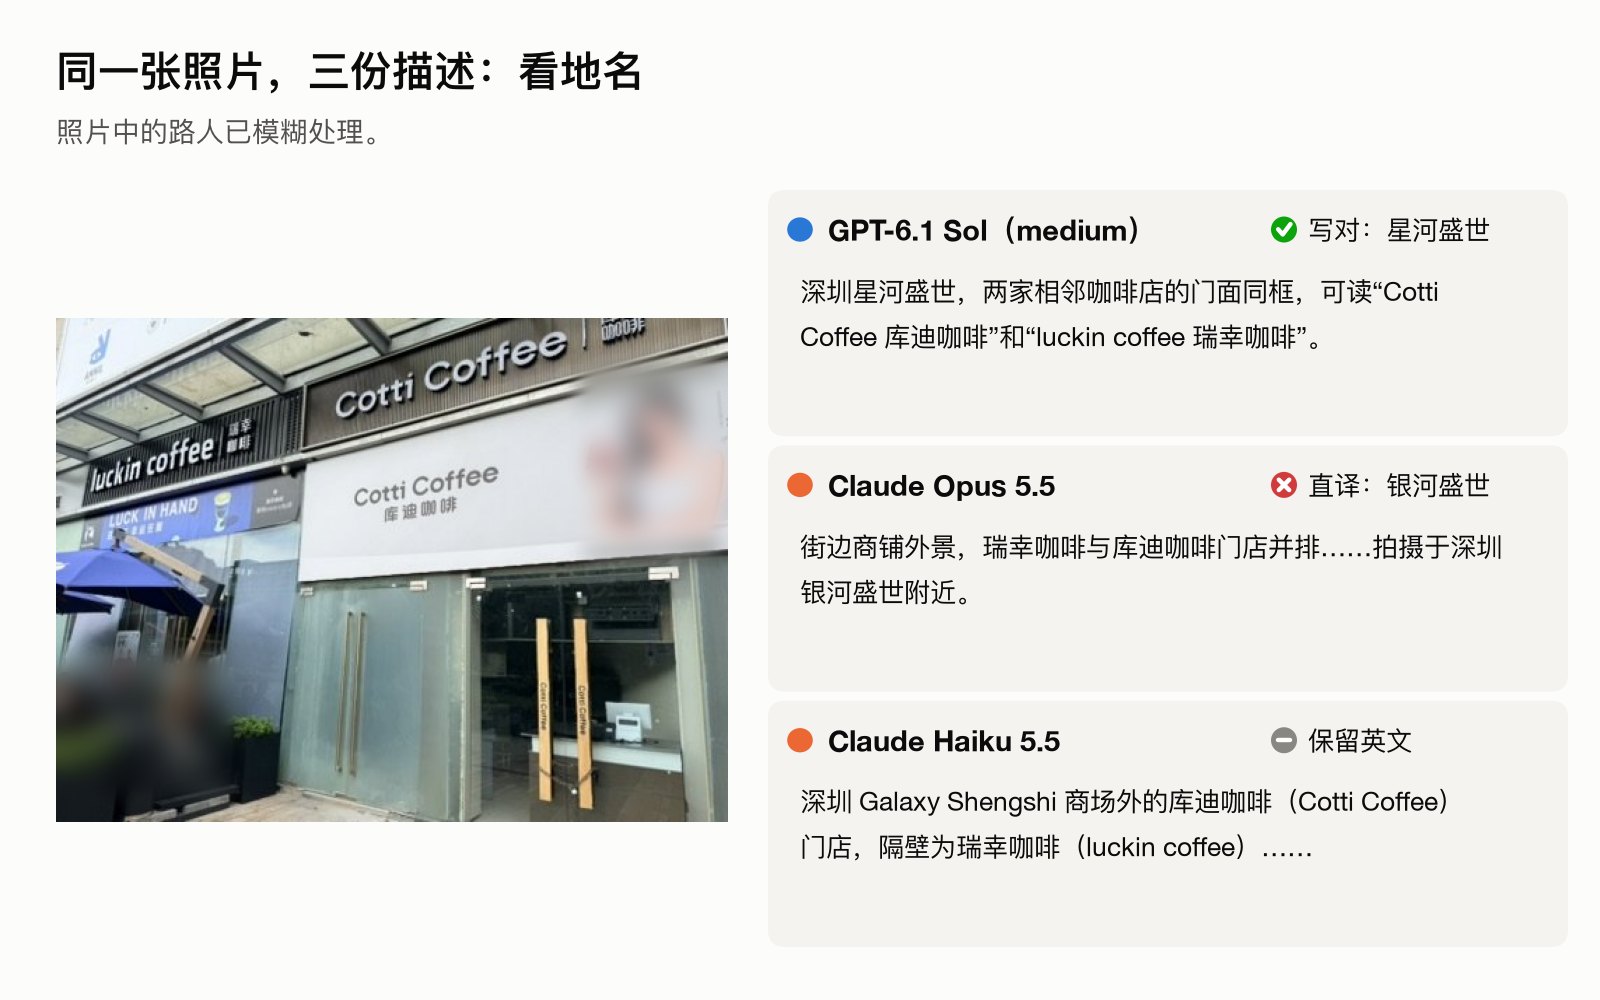 圖 2:50 張測試照片中的一張,以及其中三個模型寫的描述。注意它們怎麼處理地名,後面會再講到。照片中的路人已模糊處理。
怎麼評分
我沒有自己打分。我天天用 Claude,測試前就認定 Opus 會贏,自己打分難免偏心。
我把每張照片的 10 份答案打亂,標成 A 到 J,每張照片重新隨機一次。兩位評審對著照片,各自獨立給 500 份答案打分:一位是 Anthropic 能力最強的 Claude Fable 5.1,另一位是 OpenAI 的前沿模型 GPT-6 Astra(xhigh 檔)。
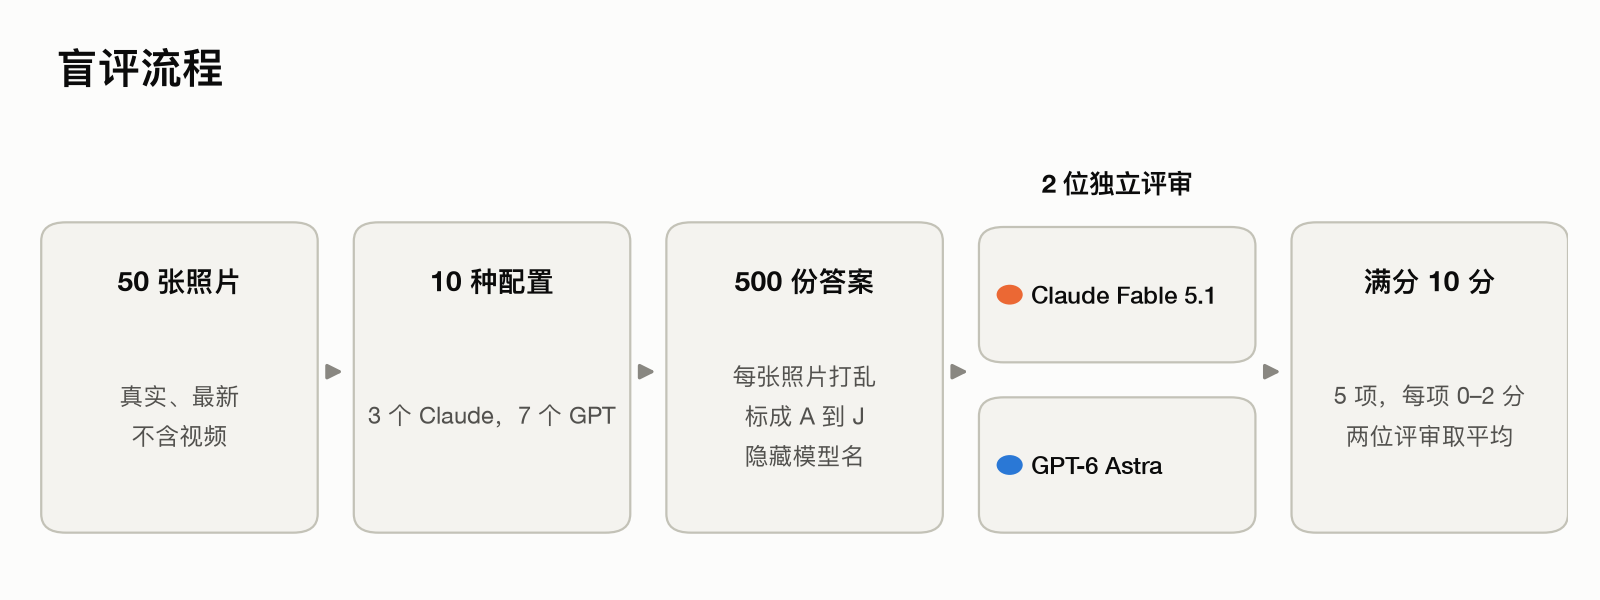 圖 3:盲評流程。
每份答案按五項打分,每項 0 到 2 分,滿分 10 分:
| 評分項 | 評審看什麼 |
|---|---|
| 事實 | 主體、地點和畫面裡能讀到的文字對不對,本地地名有沒有寫對? |
| 無編造 | 有沒有寫出照片裡看不出來的東西? |
| 刪除判斷 | 該留還是該刪,判斷是否合理?誤刪好照片得 0 分。 |
| 相簿 | 相簿選得對不對?放進不相關的舊相簿得 0 分,不選得 1 分。 |
| 實用 | 標題、描述和關鍵字,能不能幫我以後找到、想起這張照片? |
兩家各請一位評審,是想看看有沒有誰偏袒自家模型。兩位評審的結論很接近:500 組配對分數的相關係數是 0.71,排在前五的都是同樣五個 GPT 配置。Claude 評審也把 GPT-6.1 Sol 和 GPT-6 Astra 排在 Claude Opus 前面。GPT 評審整體打分更嚴,給 Claude 模型的分扣得最多。
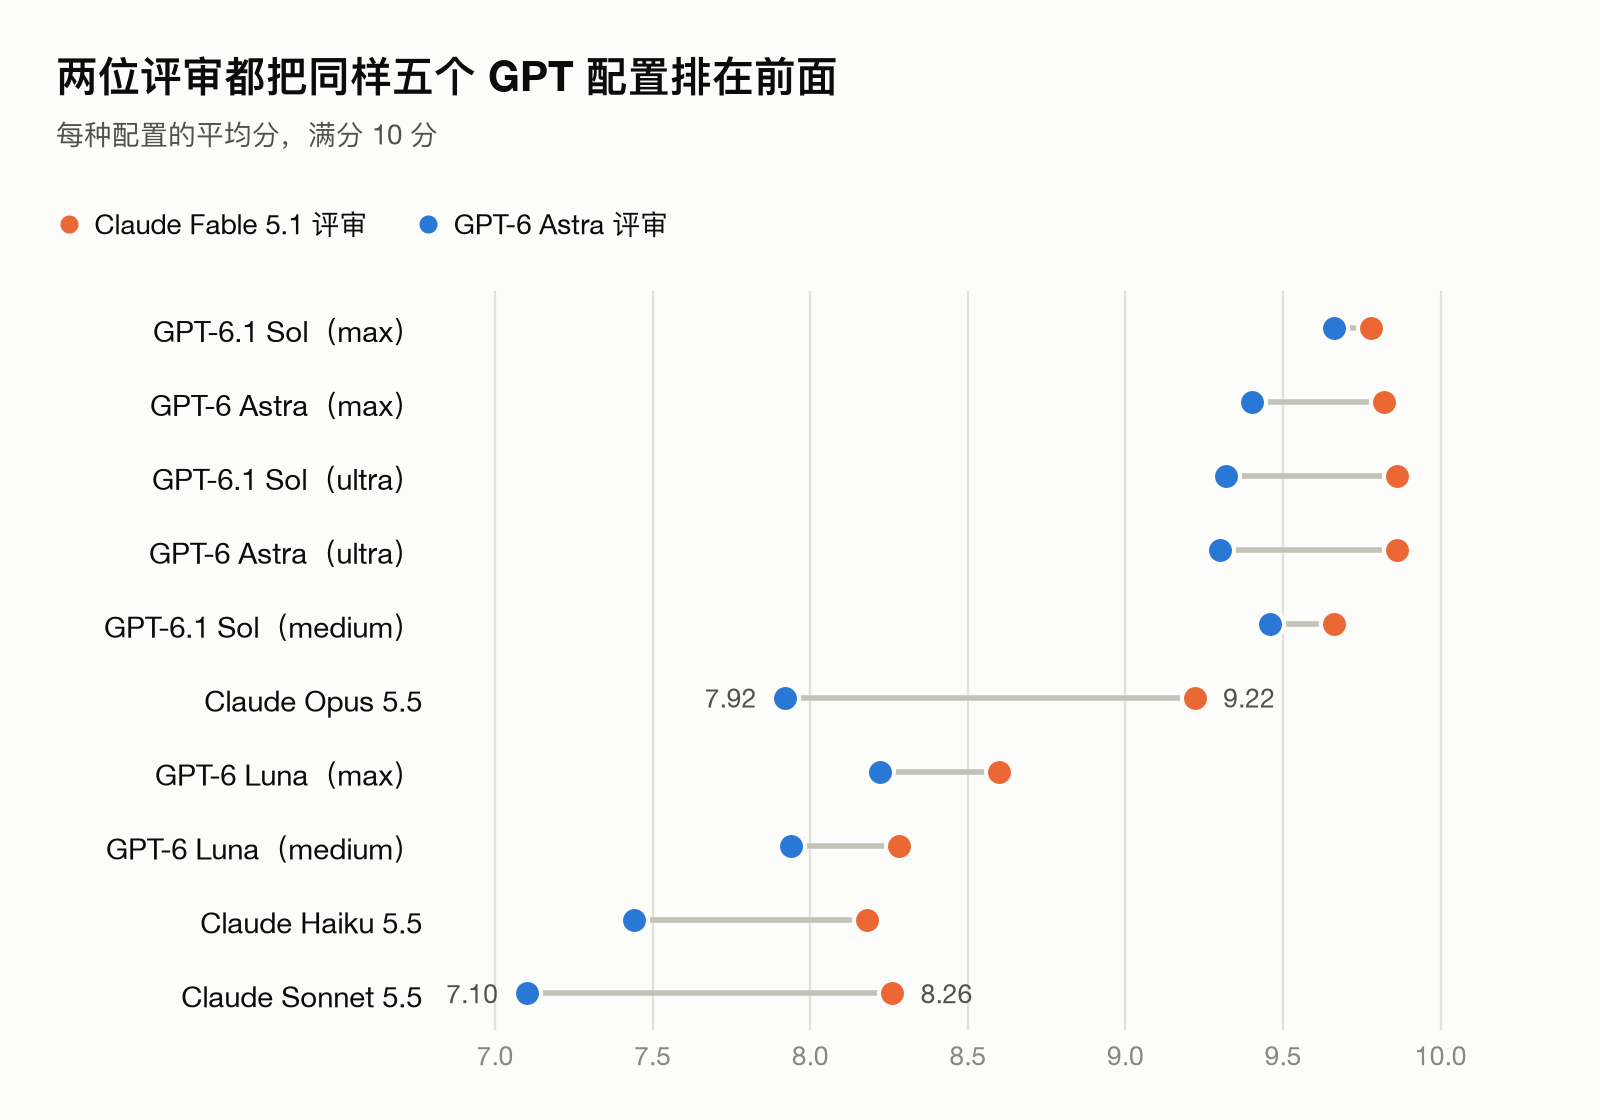 圖 4:每位評審給各配置的平均分。
測試結果
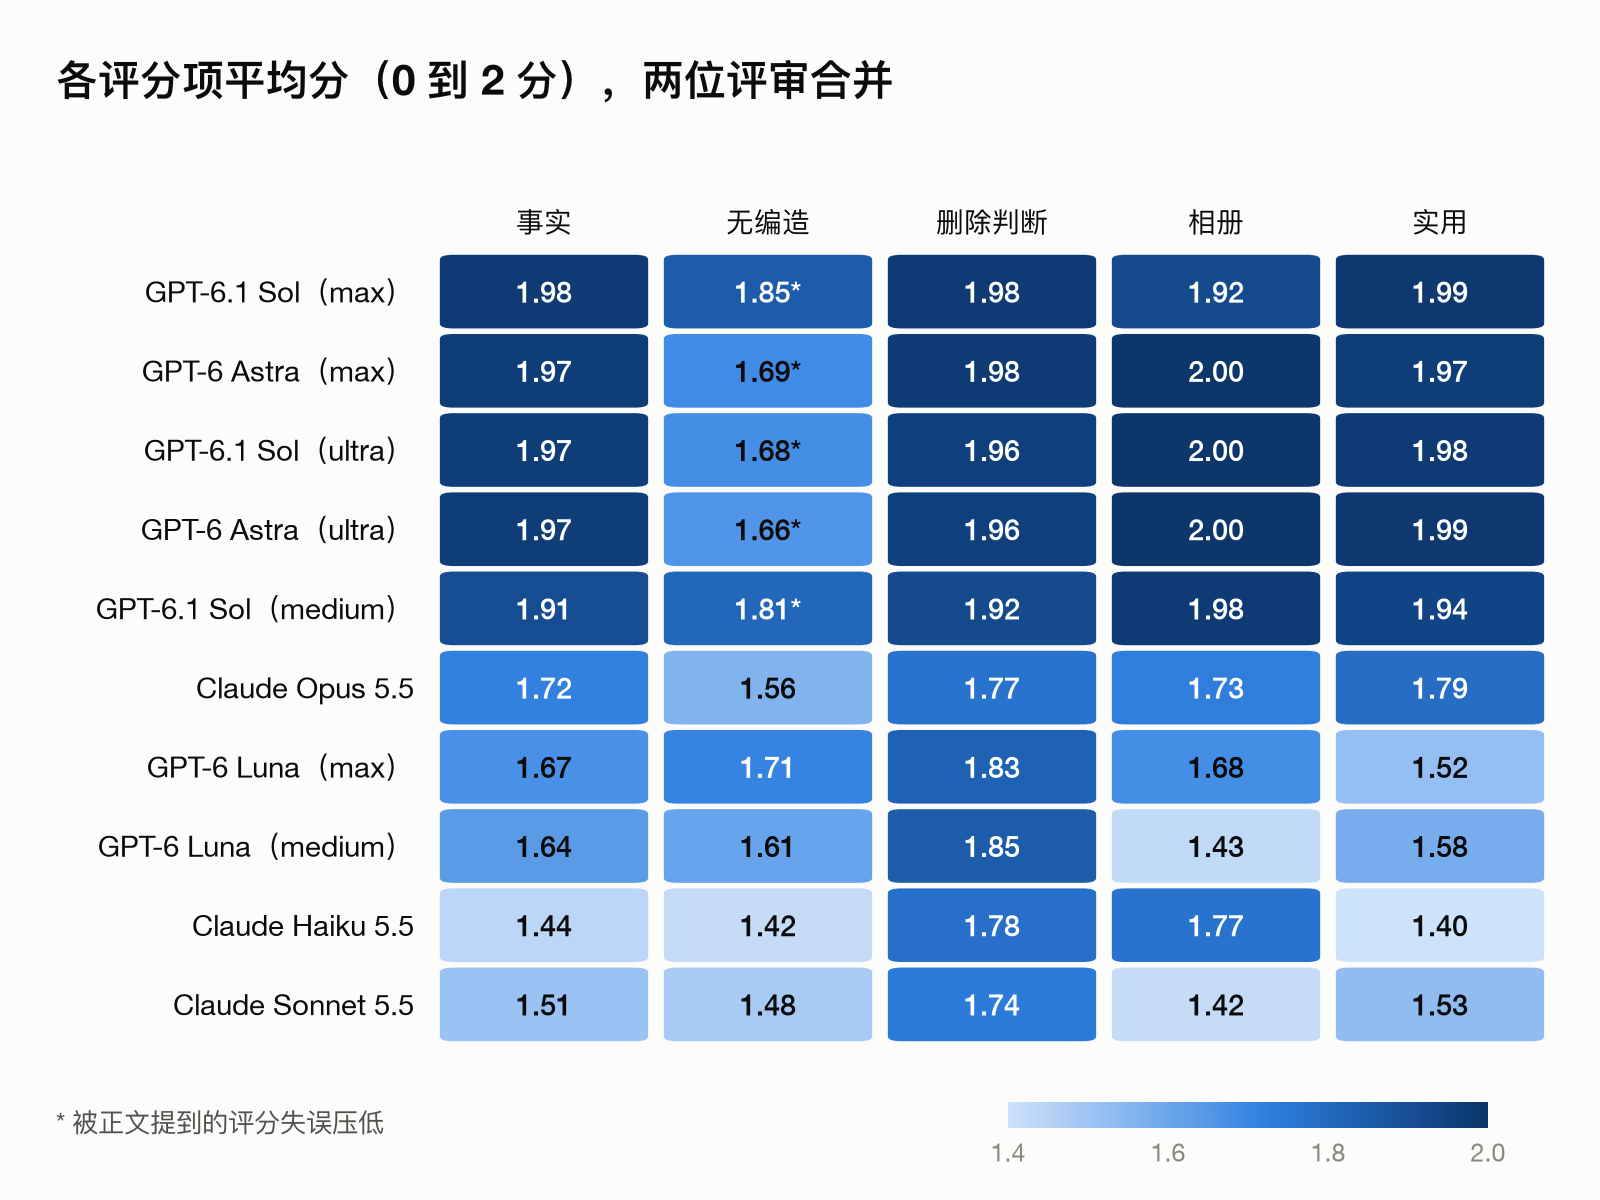 圖 5:兩位評審合併後的各項平均分。帶星號的分數被下文提到的評分失誤壓低了。
GPT-6.1 Sol 和 GPT-6 Astra
Sol 和 Astra 基本只寫畫面裡能確認的內容,文字讀得準,很少寫出照片裡看不出來的東西。本地地名也是它們處理得最好,這對在中國拍的照片很重要。
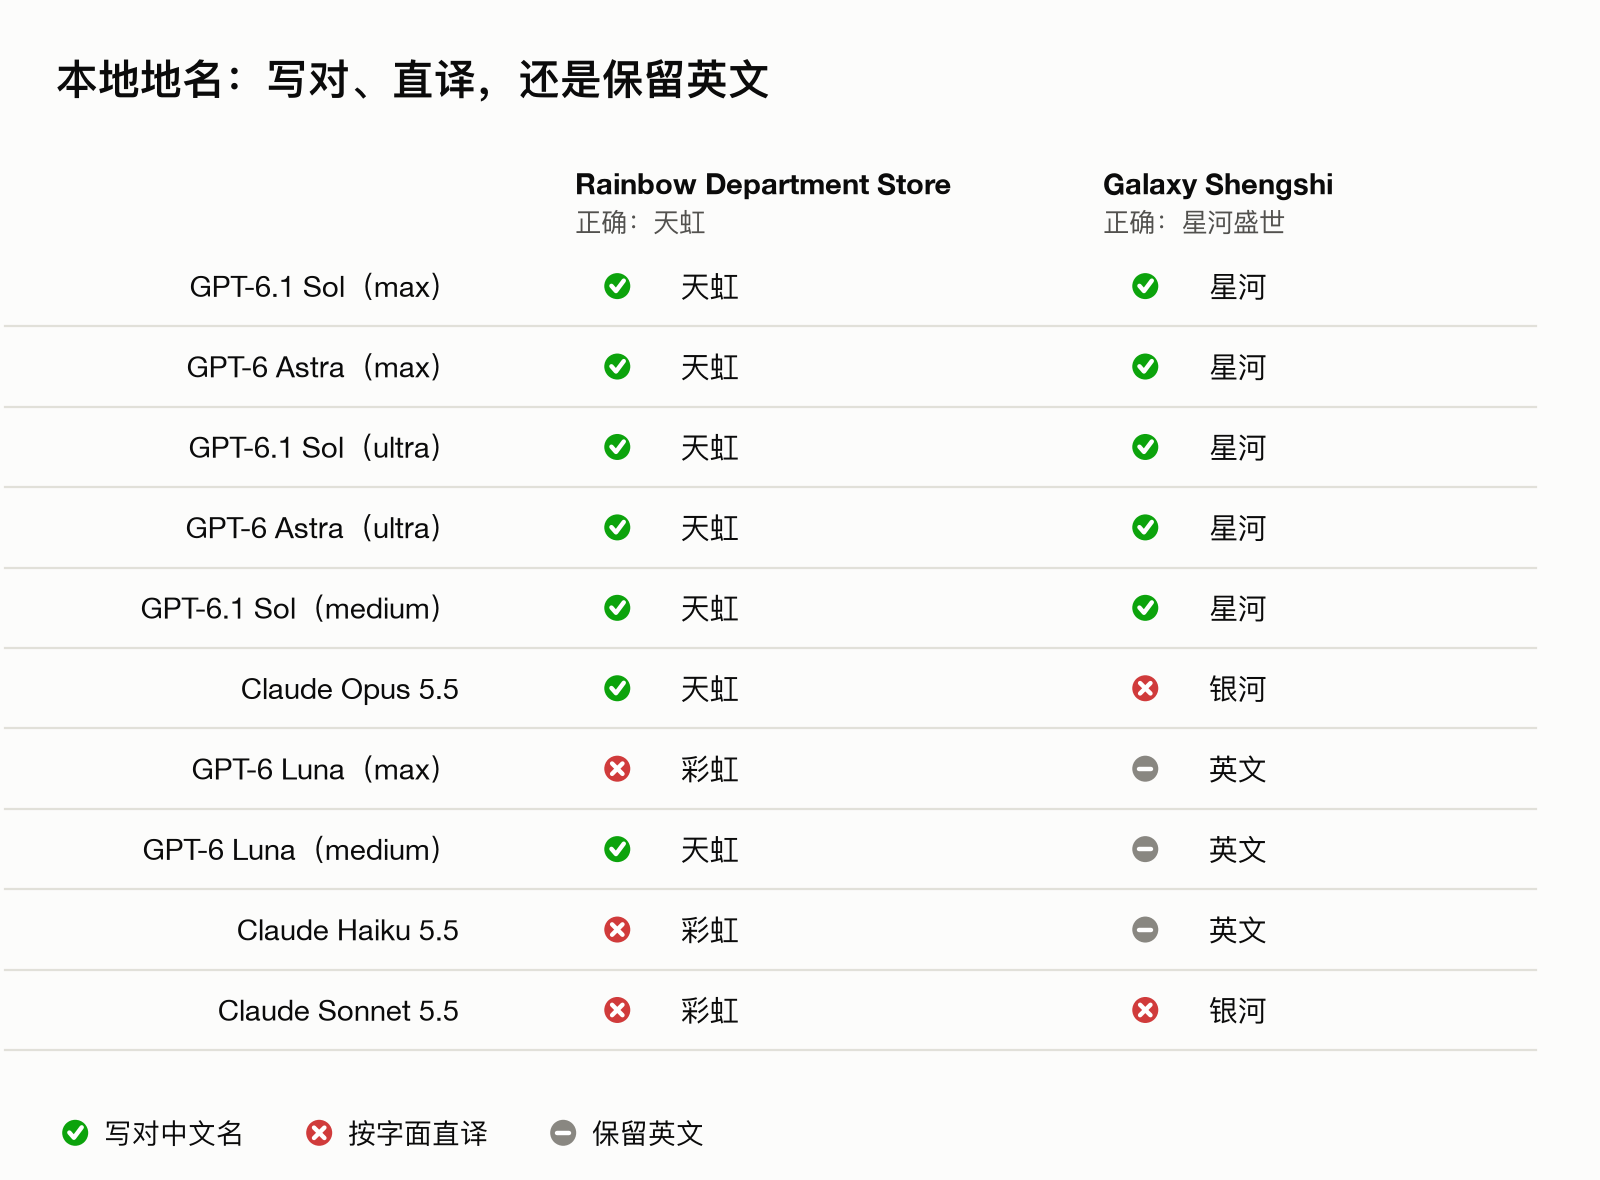 圖 6:兩道本地地名題。勾表示寫對了中文名,叉表示按字面直譯,EN 表示保留了英文。
有幾張照片的定位是 Rainbow Department Store,這是深圳連鎖商場天虹的英文名,直譯成「彩虹百貨」就錯了。所有 Sol 和 Astra 配置都寫對了,Opus 和 medium 檔的 Luna 也對;Haiku、Sonnet 和 max 檔的 Luna 用了直譯。圖 2 那張咖啡店照片的定位是 Galaxy Shengshi,中文名是星河盛世。所有 Sol 和 Astra 配置都寫成星河;Opus 和 Sonnet 直譯成了銀河;Haiku 和兩個 Luna 配置直接保留了英文。
刪照片它們也很謹慎,50 張裡只建議刪 4 到 6 張。測試集裡有 8 張電子元件的商品詳情頁截圖,GPT 模型幾乎都留下了,只有一個 Sol 配置把其中一張標成近似重複;Claude 模型各標了兩到四張要刪。兩位評審都認為應該留,因為這些頁面上有腳位定義、尺寸和板子實物照片,以後我還要查。
Claude Opus 5.5
Opus 有時會把畫面裡無法確認的內容也寫進描述。它會寫出單看照片無法確定的關係,比如兄弟姊妹、父母和孩子。姿勢也有寫錯的時候:一張照片裡孩子站在大人身後,它寫成孩子趴在大人背上。兩位評審都為此扣了分。
這一點讓我很意外。盲測之前我先看過一遍結果,當時還誇 Opus 猜對了兩個孩子是姊弟。我認識自己的家人,評審不認識。可是 14 萬張照片,我不可能每條描述都自己核對,寫出照片裡沒有的東西就是隱憂。
Opus 也是建議刪得最多的模型,50 張裡提了 13 張。其中三張商品詳情頁截圖被它說成過期,可上面的參考資訊我是要留的。它也是唯一一個想把停車優惠 QR code 當成沒價值刪掉的模型。另外,它還把幾張單人照放進了「全家福」相簿。
Claude Sonnet 5.5 和 Haiku 5.5
這兩個模型事實錯誤最多,把天虹直譯成「彩虹」的也有它們。Sonnet 選相簿最弱,把日常照片放進了一個不相關的舊活動相簿。Haiku 編了一個細節,結果刪錯了照片:一組幾乎一樣的連拍裡,它說最好的一張有人在低頭,跟照片正好相反,還建議刪掉。
GPT-6 Luna
Luna 單價和 Haiku 一樣,兩個檔位的分數卻都比 Haiku 高:8.41 和 8.11,Haiku 是 7.81。max 檔得分也高於 Sonnet;同樣給這個圖庫寫描述,Sonnet 的成本貴約 17 倍。Luna 主要在實用性和相簿上丟分,描述比較平淡,相簿也選得不夠準。
推理強度
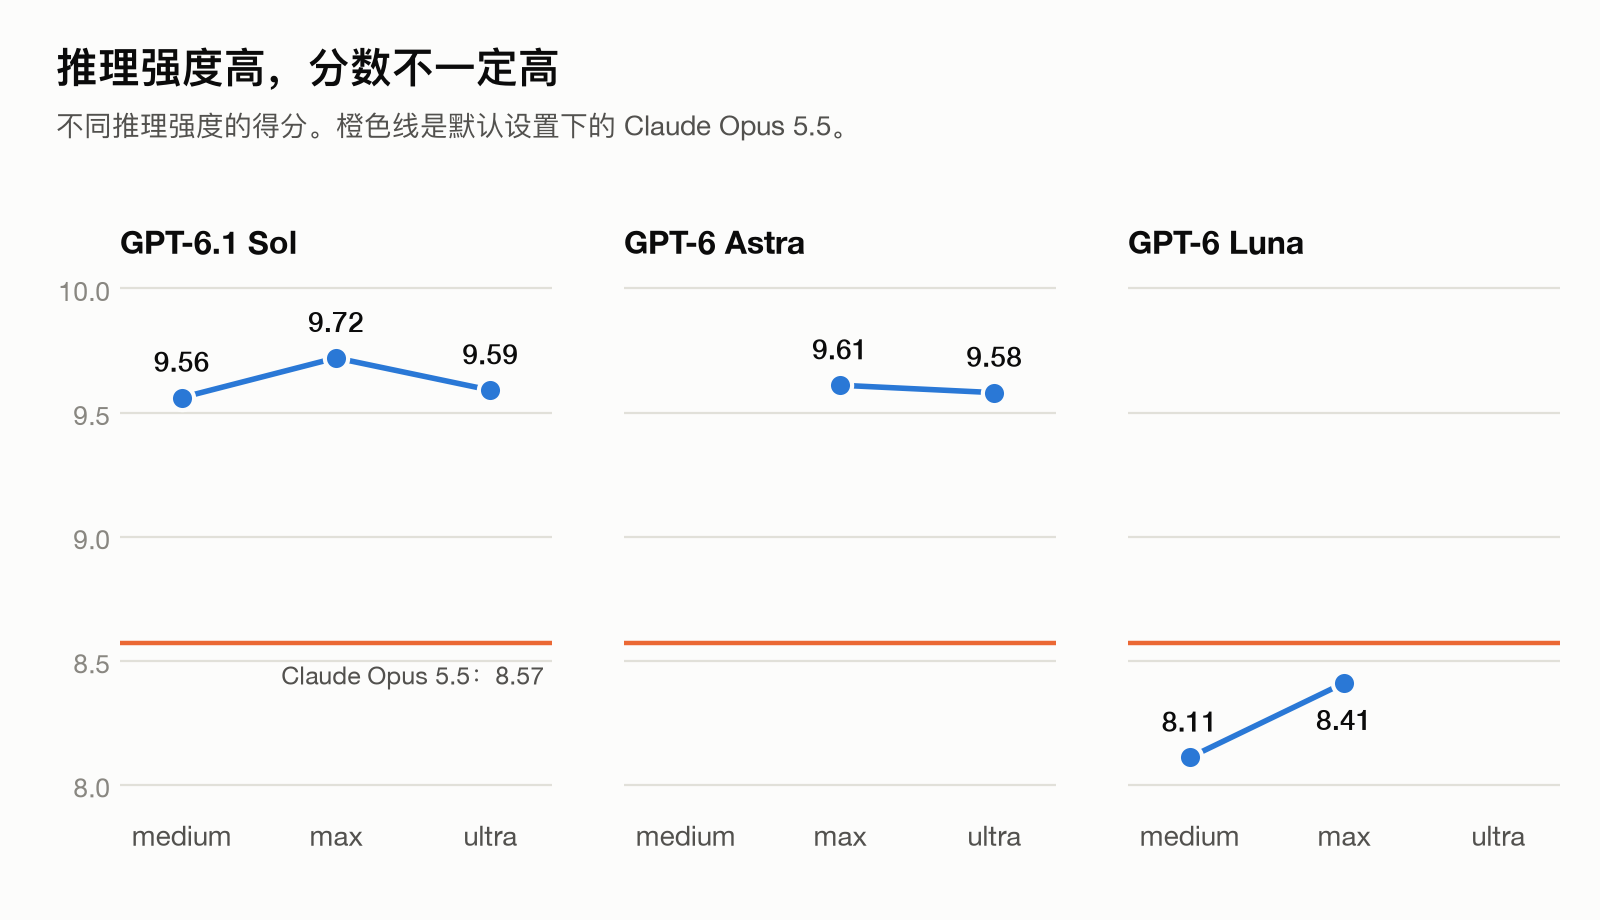 圖 7:不同推理強度的得分。橙色線是預設設定下的 Claude Opus 5.5。
這次 Sol 和 Astra 都是 max 檔比 ultra 檔得分高:Sol 在 max 檔 9.72 分、ultra 檔 9.59 分,Astra 分別是 9.61 和 9.58 分。這次 ultra 檔的輸出 token 甚至比 max 檔少。Sol 的 medium 檔也很接近,9.56 分,成本不到 max 檔的一半。推理強度高,細節也不一定更準:medium 檔的 Luna 寫對了天虹,max 檔反而寫錯了。
我評分裡的一個失誤
評分做完之後我才發現,寫描述的模型拿到了每張照片的拍攝日期和時間,評審卻沒有。所以 GPT-6 Astra 評審把描述裡寫了具體日期或時間的地方當成了編造。排在前面的 GPT 配置最常寫日期,「無編造」這一項的分數因此被壓低了。
只把因為日期扣掉的分加回去,前四名 GPT 配置會升到 9.84 到 9.90 分,基本打平;Opus 還是 8.58 分。文中我保留了原始分數,下次會把模型看到的所有資訊都給評審。
速度
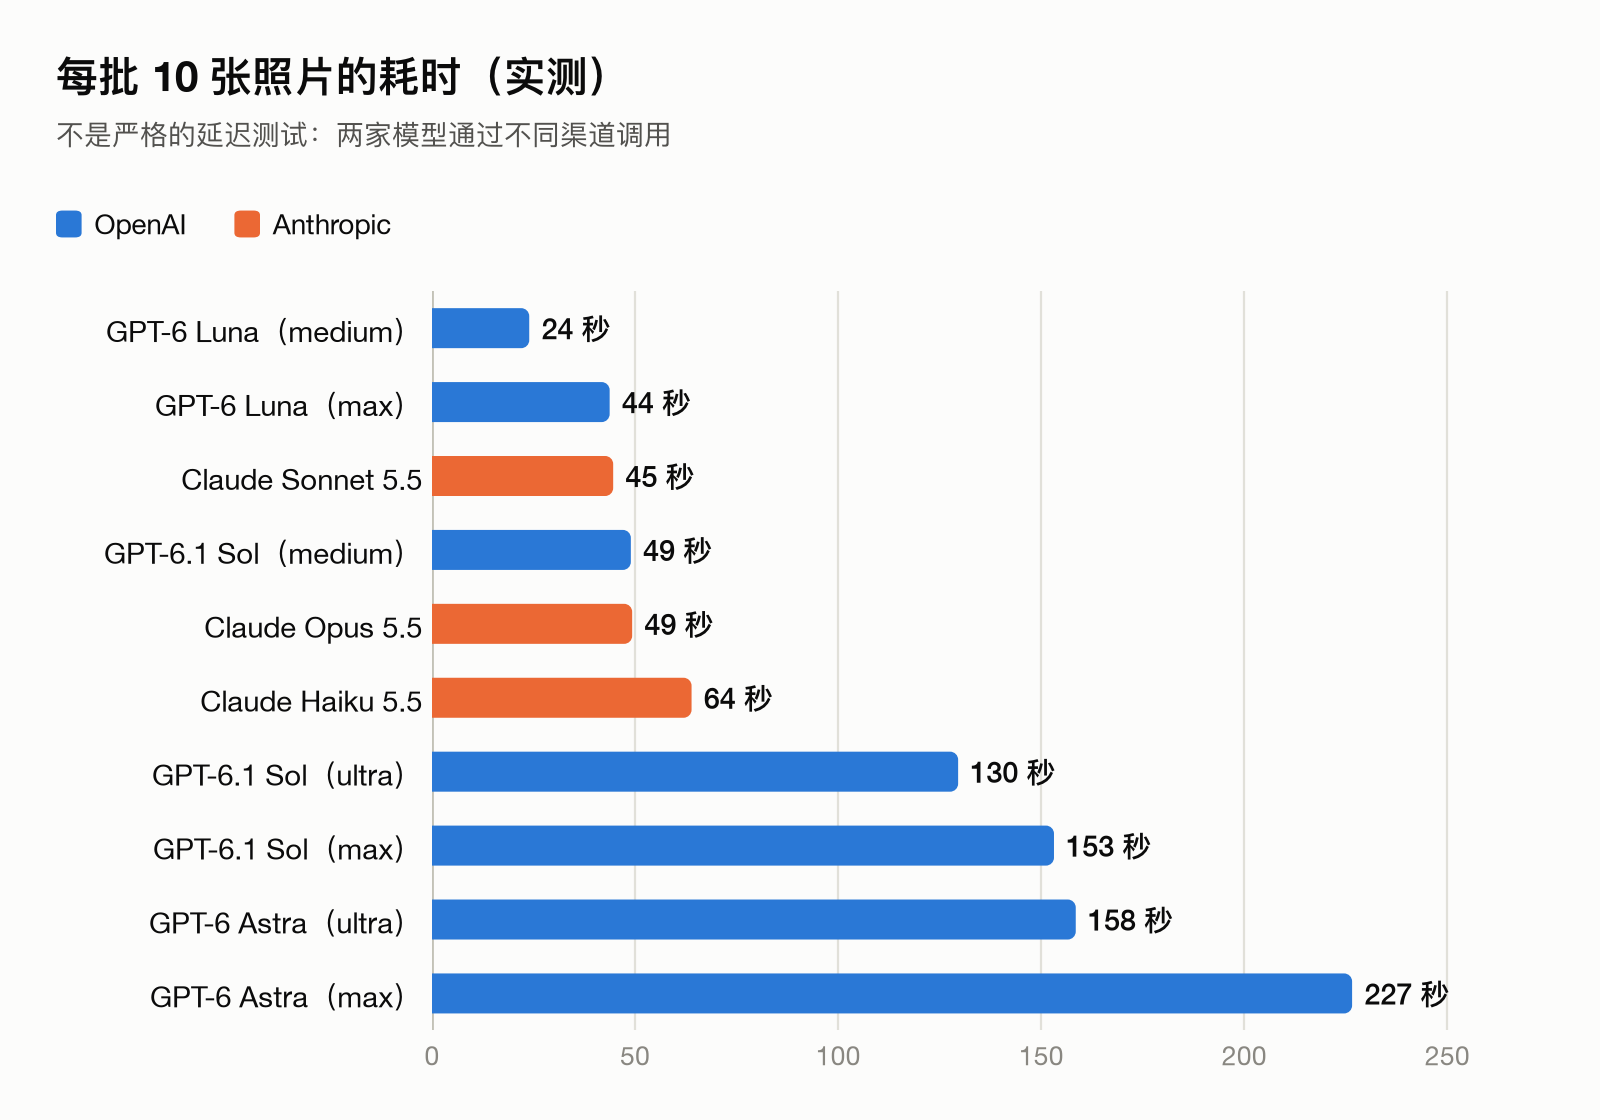 圖 8:每批 10 張照片的實際耗時。這不是嚴格的延遲測試,兩家模型是透過不同管道呼叫的。
這和我平時的感覺一致:Opus 很快,大約是 max 檔 Sol 的 3 倍。不過 medium 檔的 Sol 和 Opus 一樣快,分數還高出差不多 1 分。
要花多少錢
所有配置我都按廠商官方 API 價格來算。如果把訂閱方案裡包含的用量當成免費,有些模型就會顯得比實際更划算。
官方價格(每百萬 token,標準檔):
| 模型 | 輸入 | 輸出 |
|---|---|---|
| Claude Opus 5.5 | $4.00 | $20.00 |
| Claude Sonnet 5.5 | $2.00 | $10.00 |
| Claude Haiku 5.5 | $0.10 | $0.50 |
| GPT-6 Astra | $10.00 | $50.00 |
| GPT-6.1 Sol | $2.00 | $10.00 |
| GPT-6 Luna | $0.10 | $0.50 |
兩家的 Batch API 都便宜一半,這種不需要馬上出結果的任務正好合適。價格來自 Anthropic 定價頁(claude.com/pricing)和 OpenAI API 定價頁(developers.openai.com/api/docs/pricing),2026 年 10 月 20 日核對。
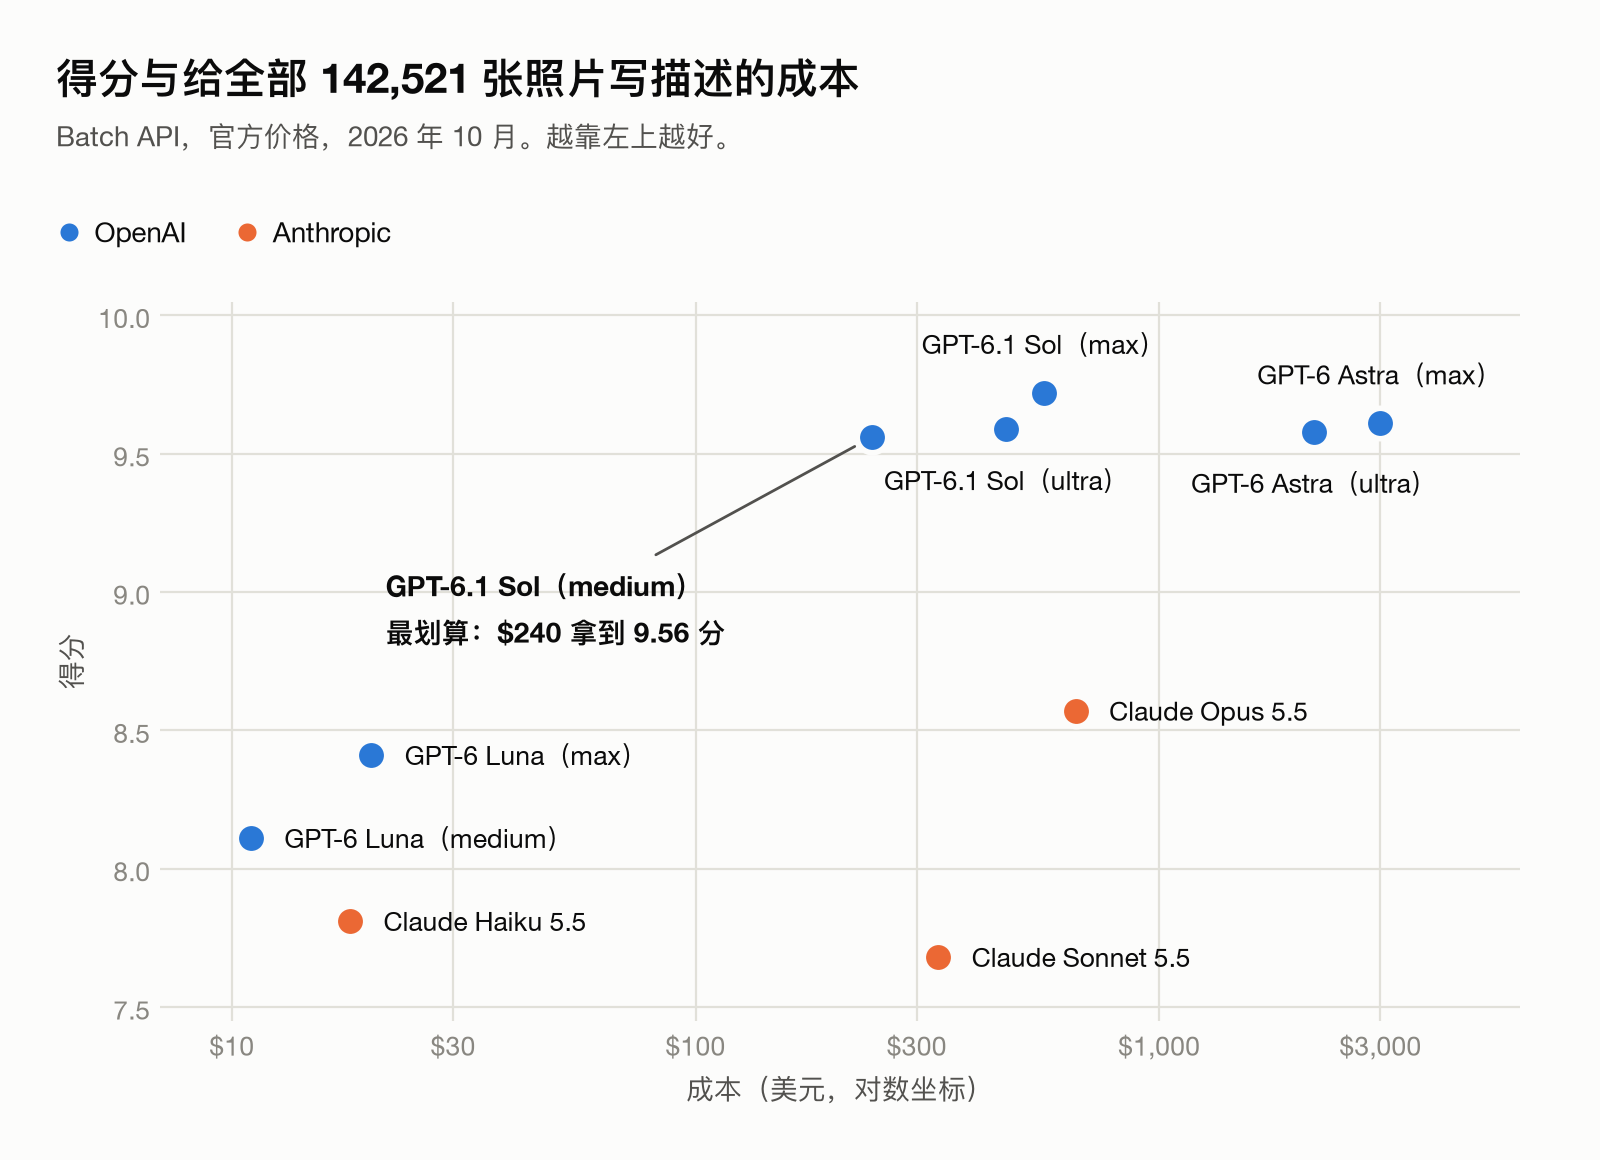 圖 9:按 Batch 價格給整個圖庫寫描述的成本與得分。成本軸為對數座標。
| 模型與推理強度 | 每張輸出 token | 標準 | Batch | 得分 |
|---|---|---|---|---|
| GPT-6.1 Sol,medium | 193 | $479 | $240 | 9.56 |
| GPT-6.1 Sol,ultra | 514 | $937 | $468 | 9.59 |
| GPT-6.1 Sol,max | 647 | $1,126 | $563 | 9.72 |
| Claude Opus 5.5 | ~292 | $1,323 | $661 | 8.57 |
| Claude Sonnet 5.5 | ~297 | $668 | $334 | 7.68 |
| GPT-6 Astra,ultra | 462 | $4,313 | $2,156 | 9.58 |
| GPT-6 Astra,max | 695 | $5,973 | $2,987 | 9.61 |
| GPT-6 Luna,medium | 163 | $22 | $11 | 8.11 |
| Claude Haiku 5.5 | ~330 | $36 | $18 | 7.81 |
| GPT-6 Luna,max | 419 | $40 | $20 | 8.41 |
medium 檔的 Sol 拿到最高分的 98%,成本只有 Opus 的 36%、max 檔 Sol 的 43%。Astra 品質和 Sol 差不多,價格卻是大約 5 倍,因為它的單價就是 Sol 的 5 倍。Opus 比 max 檔的 Sol 還貴,分數卻更低;它跑的已經是 medium 檔,但單價是 Sol 的兩倍。Luna 給整個圖庫寫描述只要 $11 到 $20,得分還高於 Claude 的 Haiku 和 Sonnet。
方法說明:GPT 的 token 數來自執行實測,Claude 的 token 數根據執行日誌估算。Claude 有部分推理 token 看不到,所以 Claude 的成本可能略微偏低。除 Batch 外,所有模型都沒有計入提示快取等其他折扣。
我的收穫
我先按寫程式的習慣選了 Opus,等盲評結束才發現選錯了。寫程式、跑工作流程,我還是更喜歡 Claude Opus 5.5,我自己用下來,它更快,效果也更好。描述真實照片是另一回事:要看清畫面裡到底有什麼,不能自己補出姿勢和關係。這一點 GPT-6.1 Sol 做得更好。如果我按習慣直接用 Opus、不做盲測,就會花更多的錢,拿到更差的描述。
下次我先盲測,讓至少兩家廠商的評審模型拿到寫描述時的全部輸入。比較成本也繼續按官方 API 價格算。推理強度不是越高越好:這次 ultra 沒贏 max。
最好的模型偶爾也會把有用的照片標成要刪,所以每一條刪除建議,我都會自己看過再刪。
侷限
這次測試規模不大:50 張同一個城市的近期照片。老照片、掃描文件、其他語言和影片都沒測。Claude 模型只跑了預設設定,高推理強度的 Opus 也許分數更高,成本也會更高。評審是 AI 模型,不是人;兩位評審結論接近,但不完全一致,如果有人工抽檢會更紮實。模型和價格變化很快,文中所有數字截至 2026 年 10 月。
我的選擇
我的圖庫:GPT-6.1 Sol,medium 檔。寫程式和跑工作流程,我還是繼續用 Claude Opus 5.5。