
J'ai testé à l'aveugle 10 modèles d'IA sur ma bibliothèque de 142 000 photos : GPT-6.1 Sol a battu Claude Opus
Résumé
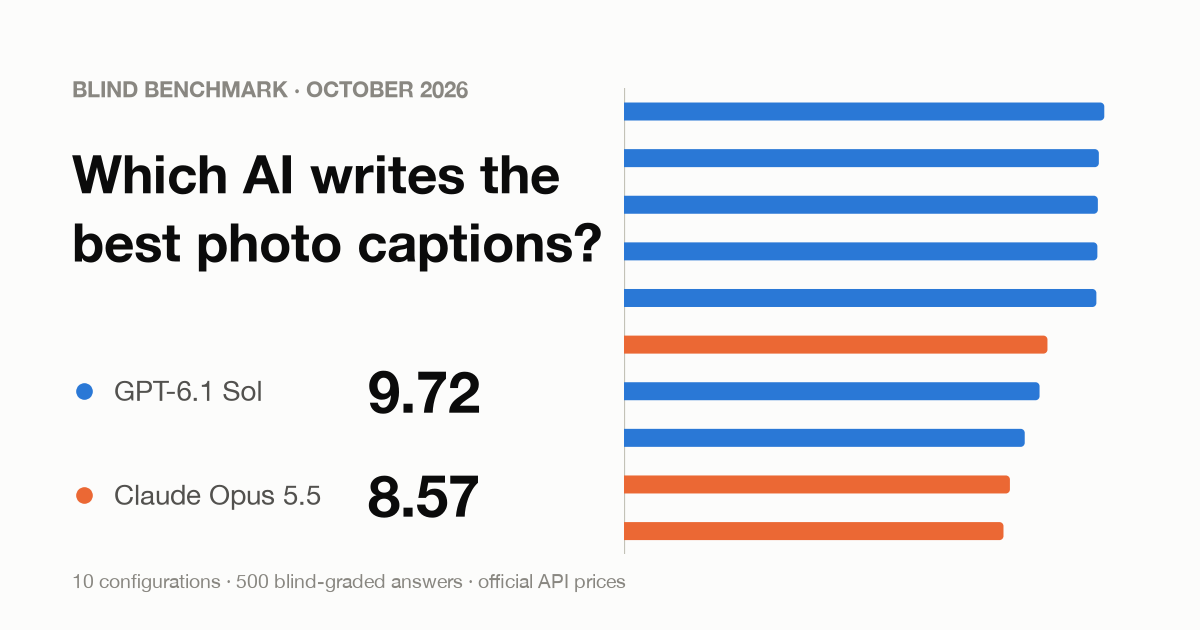
J'utilise Claude Opus 5.5 tous les jours pour coder et pour mes workflows, et pour ce travail je le trouve plus rapide et meilleur que GPT-6. Je pensais qu'il serait aussi le meilleur pour décrire des photos, alors je l'ai testé. J'ai fait tourner dix configurations : Claude Haiku, Sonnet et Opus 5.5, ainsi que GPT-6.1 Sol, GPT-6 Astra et GPT-6 Luna d'OpenAI à plusieurs niveaux d'effort. Chacune a titré, légendé, étiqueté et classé 50 vraies photos de ma bibliothèque de 142 521 photos, et a signalé celles que je devrais supprimer selon elle. Deux évaluateurs à l'aveugle de fournisseurs différents, Claude Fable 5.1 et GPT-6 Astra, ont noté les 500 réponses sur les faits, les détails inventés, le jugement de suppression, l'adéquation à l'album et l'utilité. GPT-6.1 Sol a obtenu le meilleur score, 9,72 sur 10. Opus a obtenu 8,57, et Sonnet et Haiku se situent entre 7,7 et 7,8. L'effort ultra n'a pas fait mieux que max. Aux prix officiels de la Batch API, légender toute la bibliothèque coûterait environ 240 $ avec Sol en effort moyen (9,56), 661 $ avec Opus, et 11 à 20 $ avec Luna, qui a tout de même surpassé Haiku.
Pourquoi j'ai testé cela
La plus grande partie de ma journée est consacrée au code, aux workflows d'agents et à l'automatisation, et Claude Opus 5.5 est le modèle vers lequel je me tourne. Pour ce type de travail, il m'a paru plus rapide et meilleur que GPT-6. Alors, quand j'ai décidé de faire légender et étiqueter ma photothèque par une IA, j'ai choisi Opus sans hésiter.
Cette bibliothèque, c'est 25 ans de ma vie : 142 521 photos, des premiers clichés d'appareil photo numérique aux photos de téléphone de la semaine dernière, plus de 16 000 captures d'écran. Presque aucune n'a de légende. Je veux que chaque photo ait un titre, une légende, des mots-clés que je puisse rechercher, un album sensé et un signalement honnête quand c'est un doublon ou une photo sans valeur. Avant de payer pour traiter 142 000 photos, je voulais savoir quel modèle fait cela le mieux et combien coûte la différence.
Je m'attendais à ce qu'Opus gagne. Sur ces 50 photos, GPT-6.1 Sol a obtenu plus d'un point de plus.
Résultats en un coup d'œil
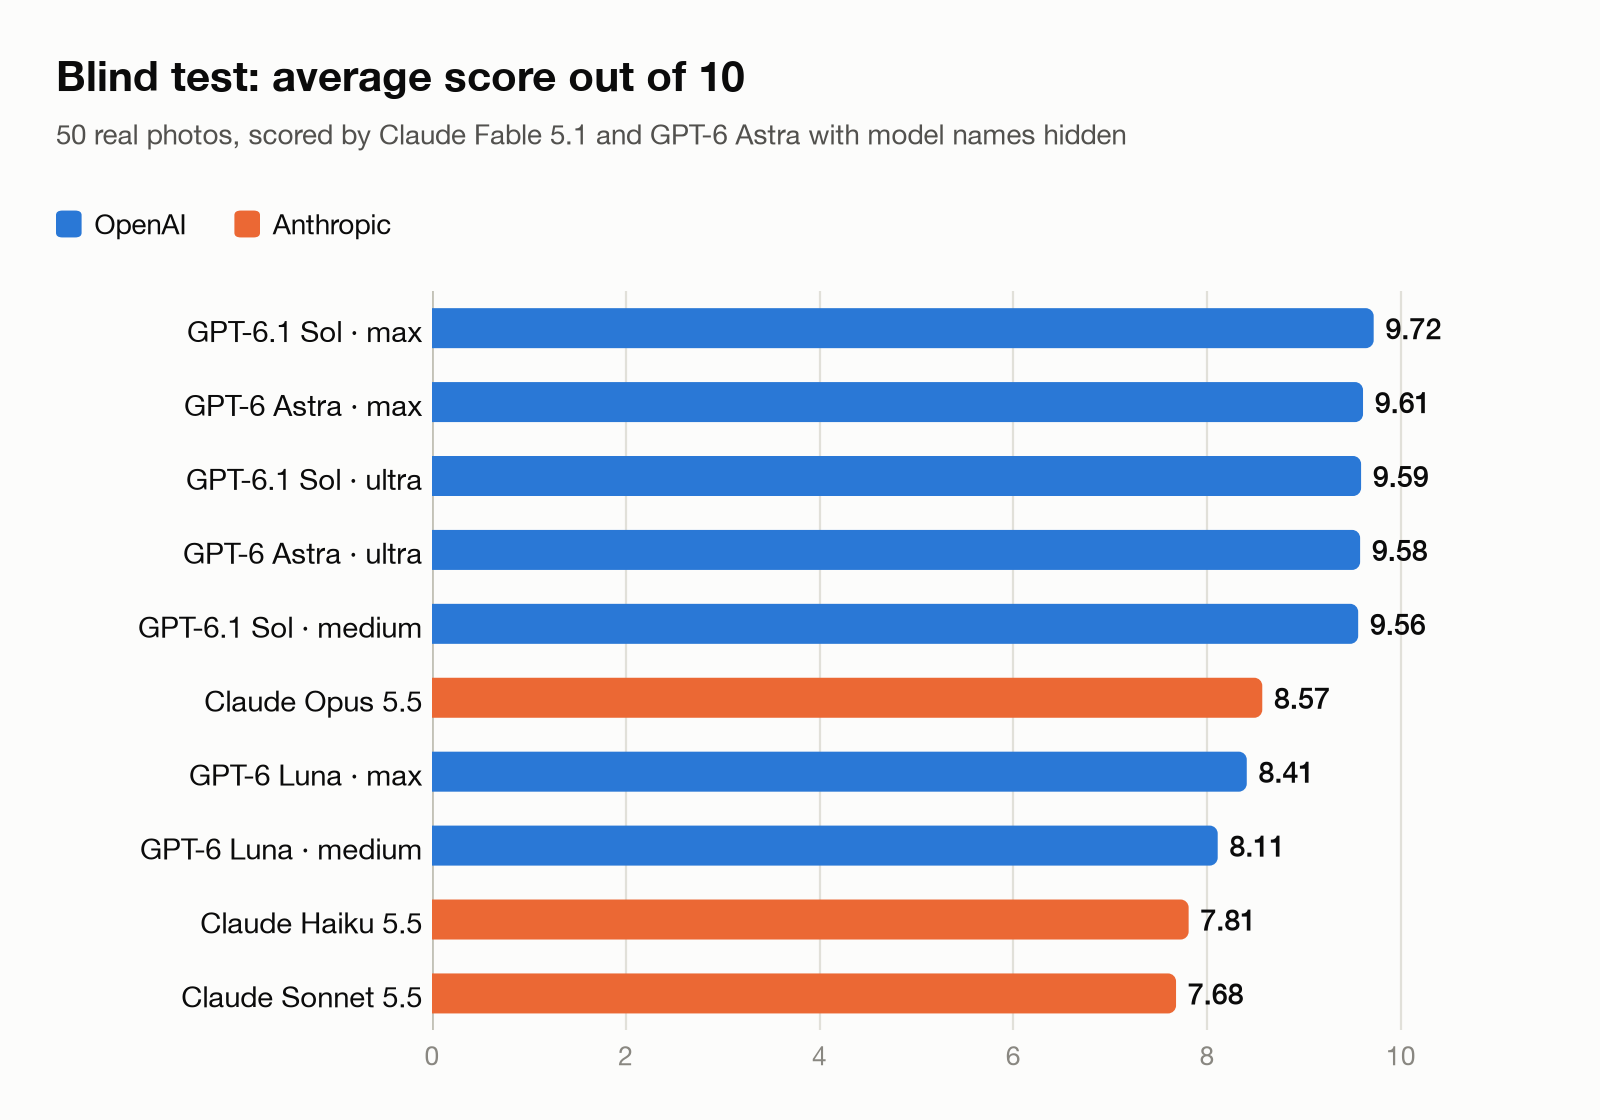 Figure 1. Score moyen de deux évaluateurs à l'aveugle, sur 10.
| Rang | Modèle et effort | Score (sur 10) | Toute la bibliothèque, Batch API | Toute la bibliothèque, API standard |
|---|---|---|---|---|
| 1 | GPT-6.1 Sol, max | 9.72 | $563 | $1,126 |
| 2 | GPT-6 Astra, max | 9.61 | $2,987 | $5,973 |
| 3 | GPT-6.1 Sol, ultra | 9.59 | $468 | $937 |
| 4 | GPT-6 Astra, ultra | 9.58 | $2,156 | $4,313 |
| 5 | GPT-6.1 Sol, medium | 9.56 | $240 | $479 |
| 6 | Claude Opus 5.5 | 8.57 | $661 | $1,323 |
| 7 | GPT-6 Luna, max | 8.41 | $20 | $40 |
| 8 | GPT-6 Luna, medium | 8.11 | $11 | $22 |
| 9 | Claude Haiku 5.5 | 7.81 | $18 | $36 |
| 10 | Claude Sonnet 5.5 | 7.68 | $334 | $668 |
Le coût vaut pour les 142 521 photos, au prix officiel de l'API de chaque fournisseur.
Ce que j'utiliserais, d'après ce test :
- Si seul le score comptait, GPT-6.1 Sol en effort max.
- Pour ma propre bibliothèque, GPT-6.1 Sol en effort medium. Il a obtenu 98 % du meilleur score pour 240 $, soit environ un tiers de ce que coûterait Opus.
- Avec un budget serré, GPT-6 Luna en effort max. Pour 20 $, il a battu Haiku, qui coûte le même prix par jeton, et Sonnet, qui coûterait environ 17 fois plus pour cette bibliothèque.
- Pas Claude Sonnet 5.5 : il est de prix intermédiaire et a eu le score le plus bas.
Les modèles
| Fournisseur | Modèle | Effort testé | Positionnement |
|---|---|---|---|
| Anthropic | Claude Opus 5.5 | par défaut (medium) | Modèle phare, usage quotidien |
| Anthropic | Claude Sonnet 5.5 | par défaut | Milieu de gamme |
| Anthropic | Claude Haiku 5.5 | par défaut | Rapide, à bas coût |
| OpenAI | GPT-6 Astra | max, ultra | Modèle de pointe |
| OpenAI | GPT-6.1 Sol | medium, max, ultra | Bête de somme |
| OpenAI | GPT-6 Luna | medium, max | Rapide, à bas coût |
Les prix s'alignent entre les deux fournisseurs. GPT-6.1 Sol coûte le même prix par jeton que Claude Sonnet 5.5, GPT-6 Astra le même que Claude Fable 5.1, et GPT-6 Luna le même que Claude Haiku 5.5. Claude Opus 5.5 se situe entre Sol et Astra. Ainsi, quand deux modèles aboutissent à des coûts différents ci-dessous, c'est surtout parce que l'un d'eux a utilisé plus de jetons pour la même tâche.
Les modèles Claude ont tourné une fois chacun avec leurs réglages par défaut, ce qui signifie un effort medium pour Opus. J'ai testé les modèles GPT à plusieurs niveaux d'effort. La comparaison la plus équitable est GPT-6.1 Sol en medium contre Claude Opus 5.5 en medium : 9,56 contre 8,57.
Le test
J'ai utilisé les 50 photos les plus récentes de ma bibliothèque à ce moment-là, sans vidéos. C'est une semaine ordinaire de ma pellicule : des moments en famille à la maison et lors d'une sortie shopping, des vues de la ville depuis un étage élevé, une carte mémoire sur mon bureau, des captures d'écran de pages produit de composants électroniques, des captures de suivi de commande, une publication sur les réseaux sociaux, un panneau QR de remise de parking et une étiquette de borne de recharge.
Chaque modèle avait cinq tâches pour chaque photo. Il écrivait un titre court et une légende d'une à trois phrases en chinois, donnait 5 à 12 mots-clés en chinois et en anglais, et choisissait le meilleur album parmi mes albums existants, ou aucun. Puis il donnait une note de qualité et disait s'il fallait conserver ou supprimer la photo, en cherchant les doublons, les photos ratées, les captures d'écran périmées et les photos sans valeur durable. Chaque modèle recevait les mêmes instructions et le même contexte pour chaque photo, dix photos à la fois.
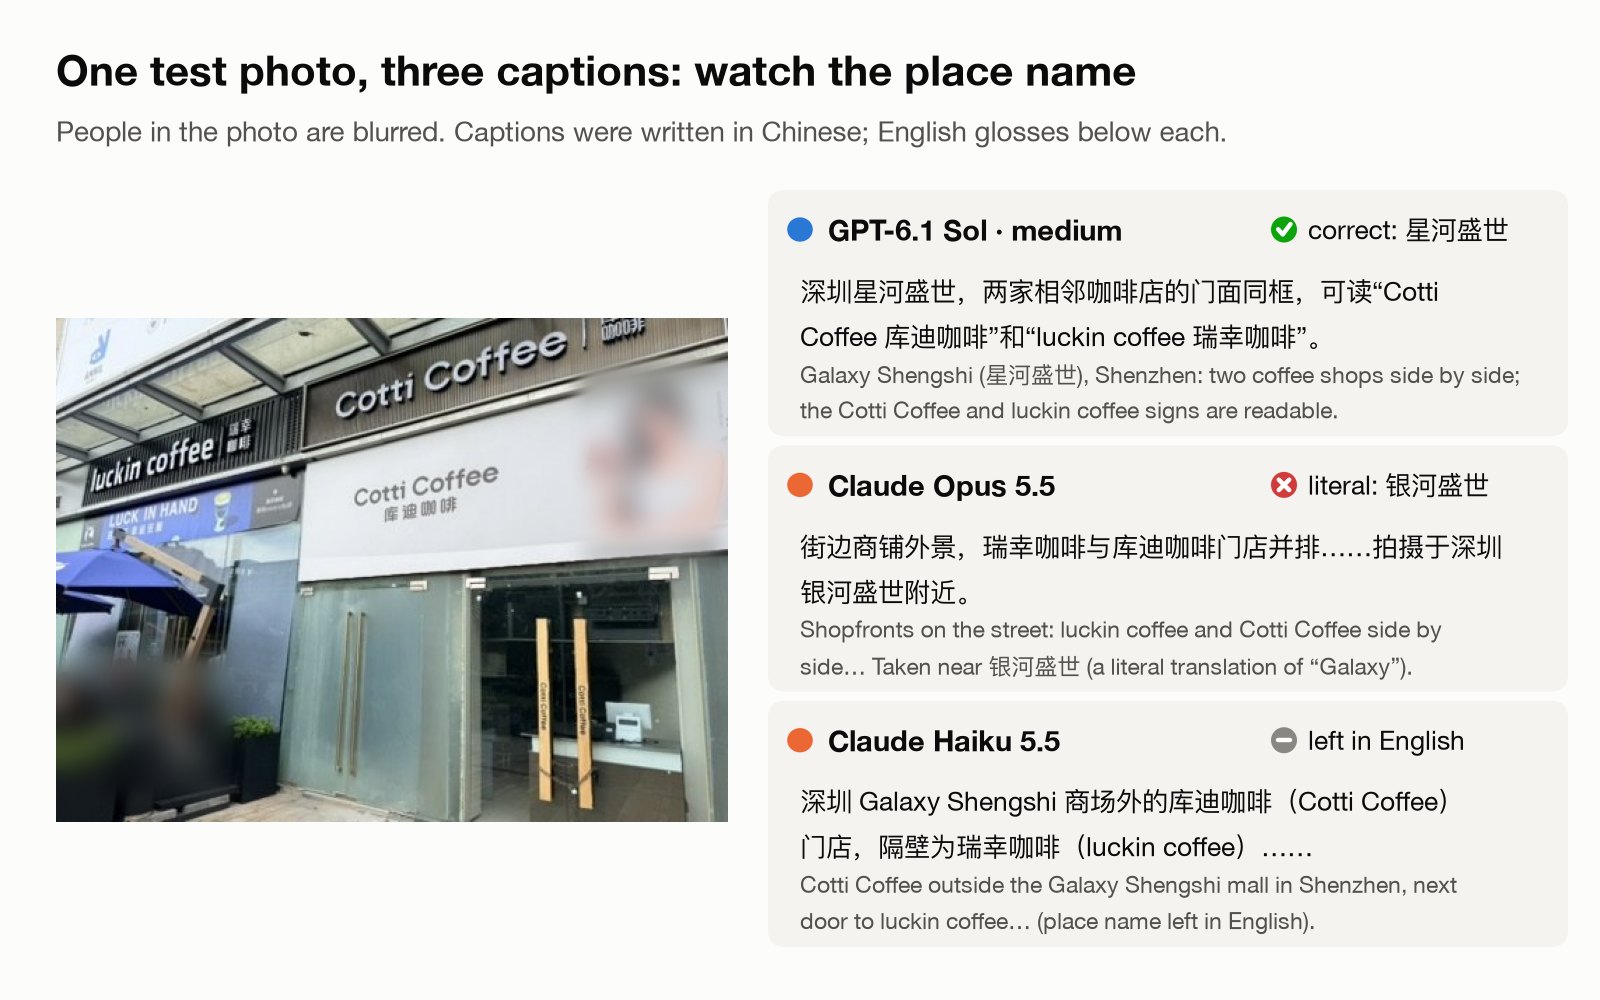 Figure 2. L'une des 50 photos de test, avec trois des légendes. Regardez comment chaque modèle traite le nom du lieu ; j'y reviens plus bas. Les personnes sur la photo sont floutées.
Comment j'ai noté
Je n'ai pas noté les réponses moi-même. J'avais déjà choisi un gagnant avant le test, et j'utilise Claude tous les jours, donc je n'étais pas neutre.
Au lieu de cela, j'ai mélangé les dix réponses de chaque photo et les ai étiquetées de A à J, avec un nouvel ordre aléatoire pour chaque photo. Deux évaluateurs ont ensuite noté les 500 réponses de façon indépendante, en regardant les photos. L'un était Claude Fable 5.1, le modèle le plus performant d'Anthropic. L'autre était GPT-6 Astra en effort xhigh, le modèle de pointe d'OpenAI.
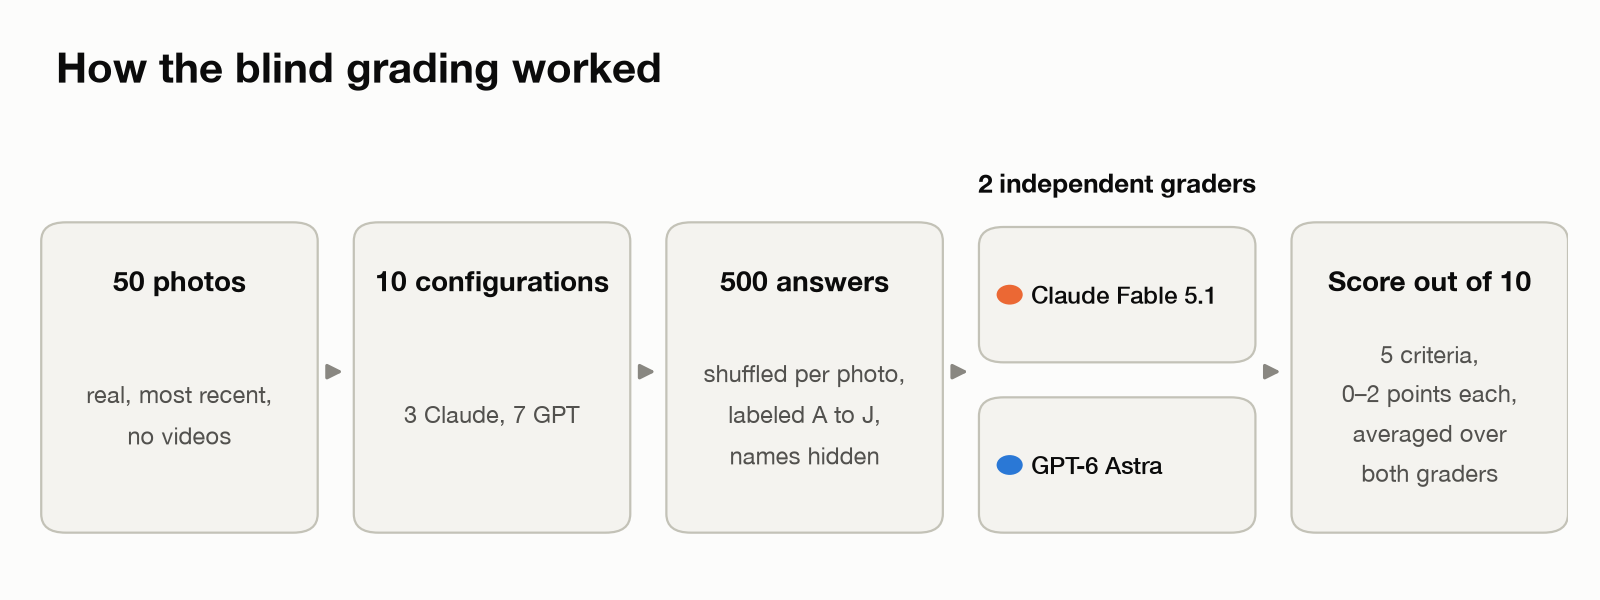 Figure 3. Comment fonctionnait la notation à l'aveugle.
Chaque réponse était notée sur cinq critères, de 0 à 2 points chacun, pour un total de 10 :
| Critère | Ce que l'évaluateur vérifiait |
|---|---|
| Faits | Le sujet, le lieu et tout texte lisible sont-ils corrects, y compris les noms de lieux locaux ? |
| Aucun détail inventé | La réponse évite-t-elle d'affirmer ce que la photo ne montre pas ? |
| Jugement de suppression | Conserver ou supprimer est-il raisonnable ? Supprimer une bonne photo vaut 0. |
| Adéquation à l'album | L'album est-il correct ? Un mauvais vieil album vaut 0 ; pas d'album est un 1 acceptable. |
| Utilité | Le titre, la légende et les mots-clés m'aideraient-ils à retrouver et à me souvenir de cette photo plus tard ? |
J'ai choisi un évaluateur chez chaque fournisseur pour voir si l'un favoriserait ses propres modèles. Ils étaient largement d'accord. La corrélation sur les 500 scores appariés était de 0,71, et les deux plaçaient les cinq mêmes configurations GPT en tête. L'évaluateur Claude classait aussi GPT-6.1 Sol et GPT-6 Astra au-dessus de Claude Opus. L'évaluateur GPT était globalement plus strict, et le plus strict avec les modèles Claude.
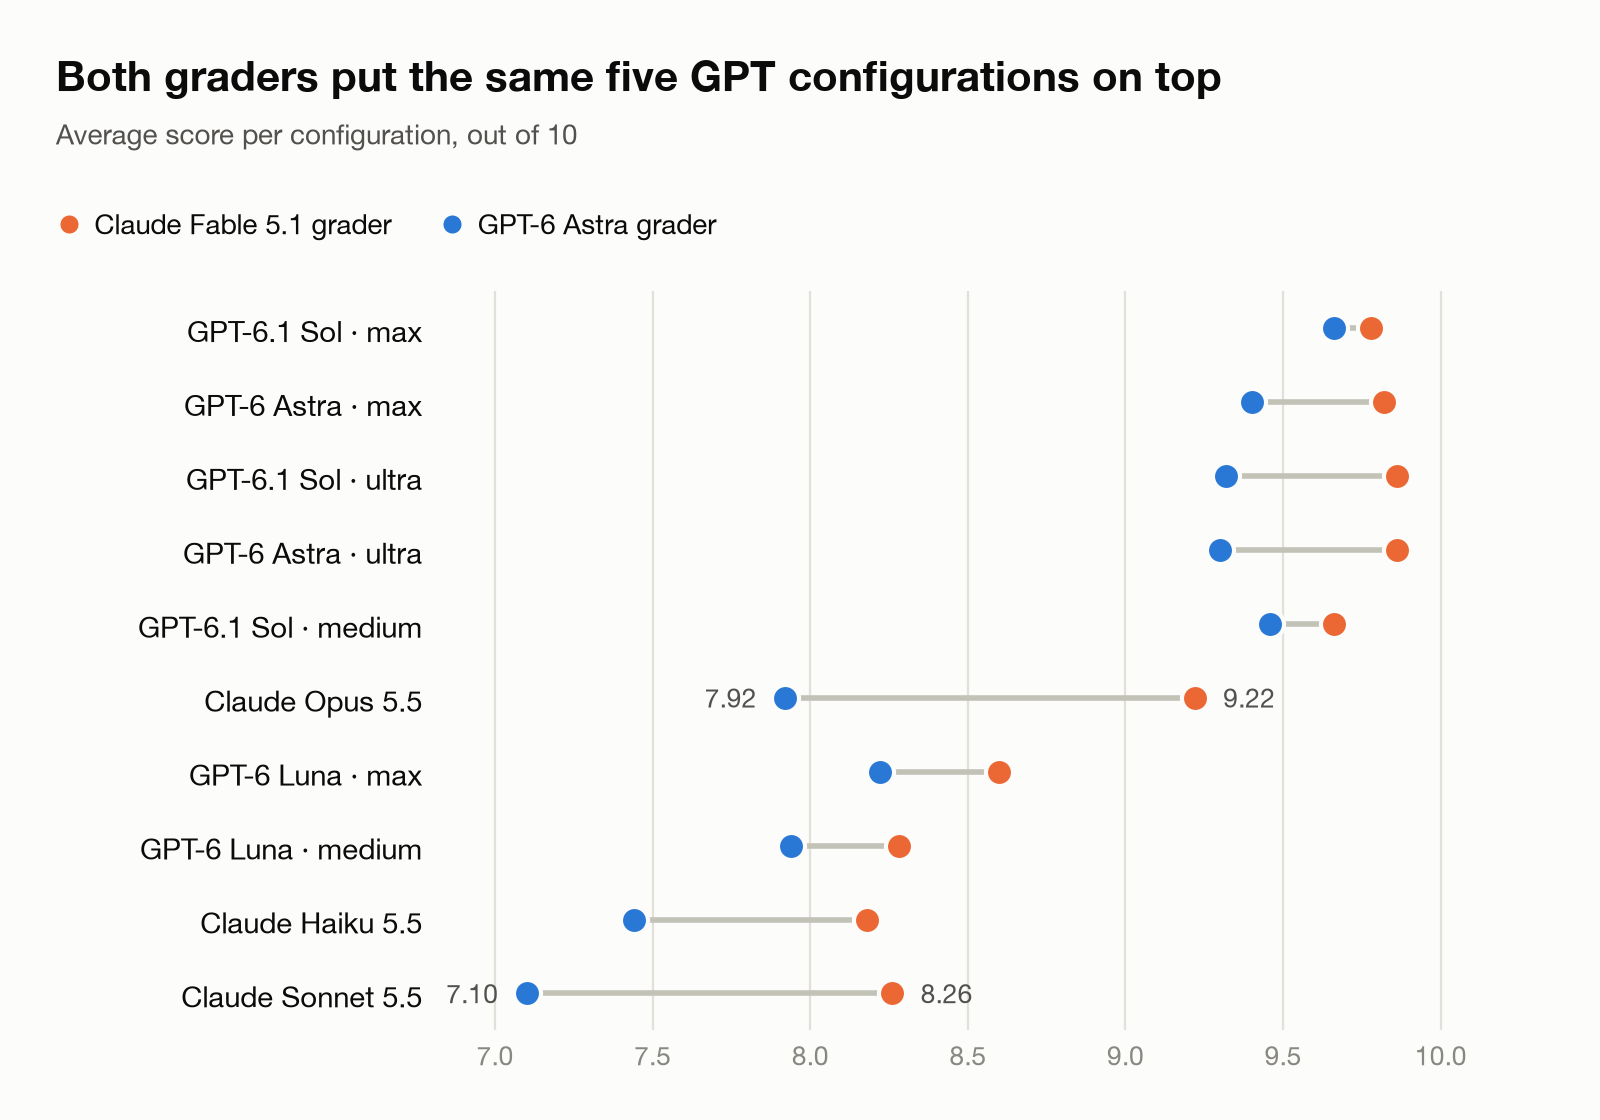 Figure 4. Score moyen de chaque évaluateur par configuration.
Résultats
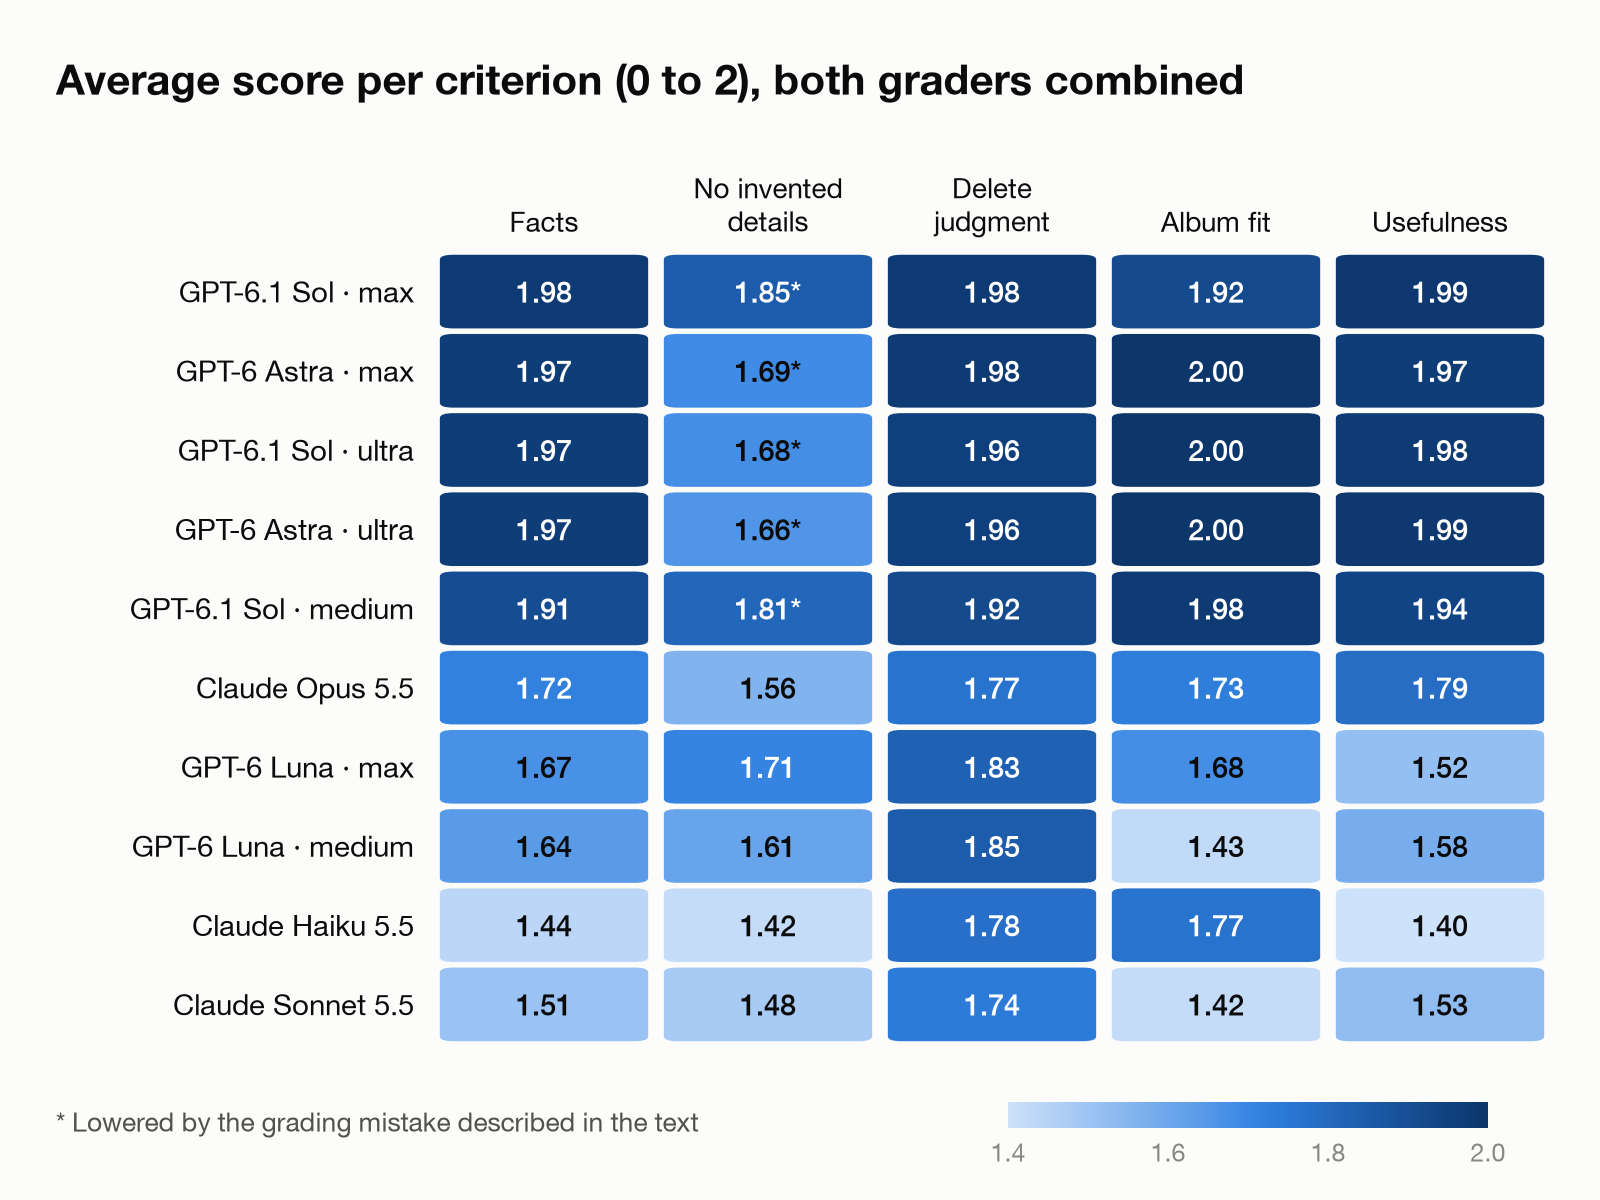 Figure 5. Score moyen par critère, les deux évaluateurs combinés. Un astérisque marque les scores abaissés par l'erreur de notation que je décris plus bas.
GPT-6.1 Sol et GPT-6 Astra
Sol et Astra lisaient le texte avec précision et limitaient surtout leurs légendes à ce que montraient les photos. Ils étaient aussi les meilleurs sur les noms de lieux locaux, ce qui compte pour des photos prises en Chine.
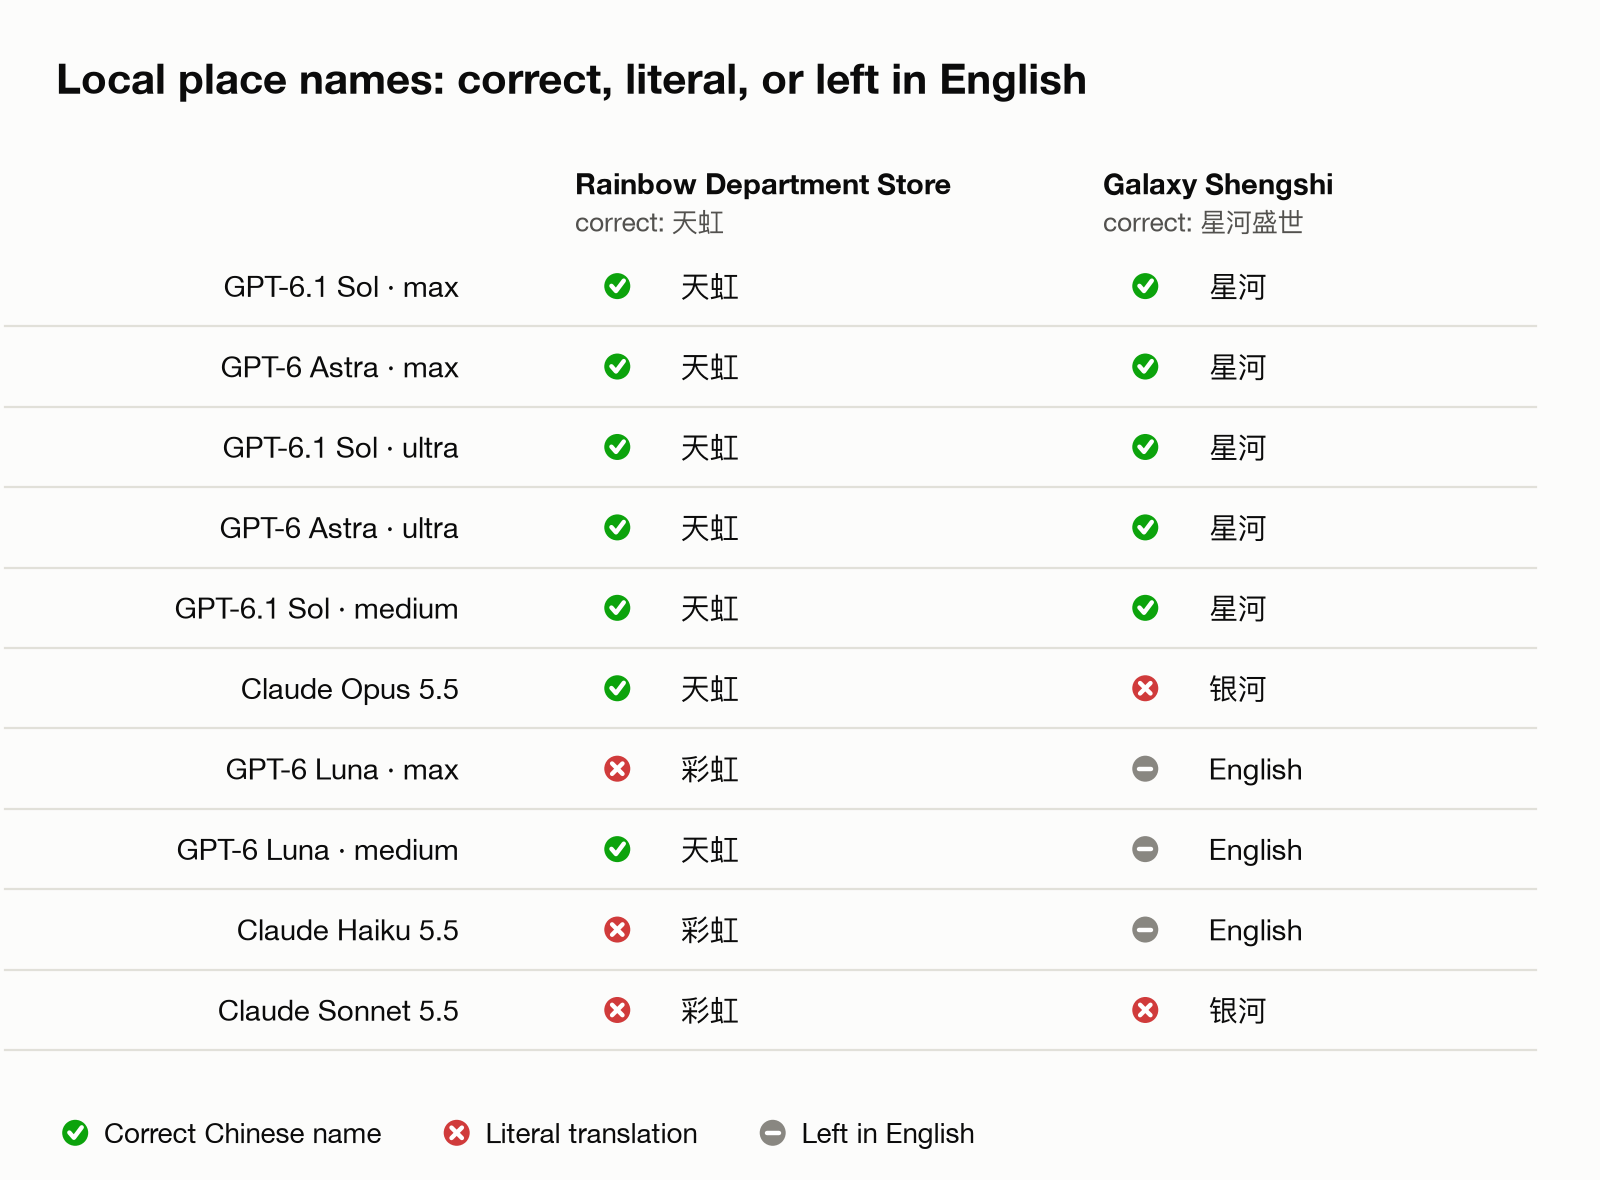 Figure 6. Deux tests de noms locaux. Une coche signifie le bon nom chinois, une croix une traduction littérale, et EN signifie que le nom est resté en anglais.
Plusieurs photos étaient étiquetées avec le lieu « Rainbow Department Store ». C'est le nom anglais de la chaîne de centres commerciaux de Shenzhen 天虹. Une traduction mot à mot donne 彩虹百货, ce qui est faux. Toutes les configurations Sol et Astra ont réussi, tout comme Opus et Luna en medium. Haiku, Sonnet et Luna en max ont utilisé la traduction littérale. La photo du café de la Figure 2 était étiquetée « Galaxy Shengshi », dont le nom chinois est 星河盛世. Toutes les configurations Sol et Astra ont écrit 星河. Opus et Sonnet l'ont traduit littéralement en 银河, et Haiku ainsi que les deux configurations Luna l'ont laissé en anglais.
Sol et Astra étaient aussi prudents sur la suppression. Ils suggéraient de supprimer 4 à 6 des 50 photos. L'ensemble comprenait huit captures de pages produit de composants électroniques, et les modèles GPT en ont conservé presque toutes ; une configuration Sol a signalé une seule capture comme quasi-doublon. Les modèles Claude en ont signalé deux à quatre chacun. Les deux évaluateurs étaient d'accord pour les conserver, car ces pages contenaient des brochages, des dimensions et des photos de cartes que je voudrais consulter plus tard.
Claude Opus 5.5
Opus écrivait parfois dans une légende des choses que la photo seule ne peut pas montrer. Il décrivait des relations que l'image seule ne peut pas prouver, comme des frères et sœurs ou un parent et un enfant. Il se trompait aussi sur certaines poses. Sur une photo, un enfant se tenait derrière un adulte, et Opus écrivait que l'enfant était sur le dos de l'adulte. Les deux évaluateurs ont retiré des points pour cela.
Cela m'a surpris. Avant le test à l'aveugle, j'avais parcouru les réponses et félicité Opus d'avoir correctement deviné que deux enfants étaient frère et sœur. Je connais ma famille ; l'évaluateur non. Mais avec 142 000 photos, je ne peux pas vérifier chaque légende moi-même, et une légende qui affirme ce que la photo ne montre pas est un problème.
Opus suggérait aussi le plus de suppressions, 13 des 50 photos. Trois d'entre elles étaient des captures de pages produit qu'il qualifiait de périmées, alors qu'elles contenaient des informations de référence que je conserverais. C'était le seul modèle à vouloir supprimer le panneau QR de remise de parking comme étant de faible valeur. Il a aussi placé plusieurs photos d'une seule personne dans un album « portrait de famille ».
Claude Sonnet 5.5 et Haiku 5.5
Ces deux-là ont fait le plus d'erreurs factuelles, y compris la traduction littérale 彩虹. Sonnet a fait les pires choix d'albums et a classé des photos du quotidien dans un vieil album d'un événement sans rapport. Haiku a inventé un détail qui a conduit à une mauvaise décision de suppression. Dans une rafale de photos quasi identiques, il décrivait le meilleur cadre comme quelqu'un qui regarde vers le bas, ce qui est le contraire de ce que montre la photo, et suggérait de le supprimer.
GPT-6 Luna
Luna coûte le même prix par jeton que Haiku mais a obtenu un meilleur score aux deux niveaux d'effort : 8,41 et 8,11, contre 7,81 pour Haiku. En effort max, il a aussi battu Sonnet, qui coûterait environ 17 fois plus pour légender la même bibliothèque. Luna a perdu la plupart de ses points sur l'utilité et le choix d'album. Ses légendes étaient plus simples et ses albums moins précis.
Niveaux d'effort
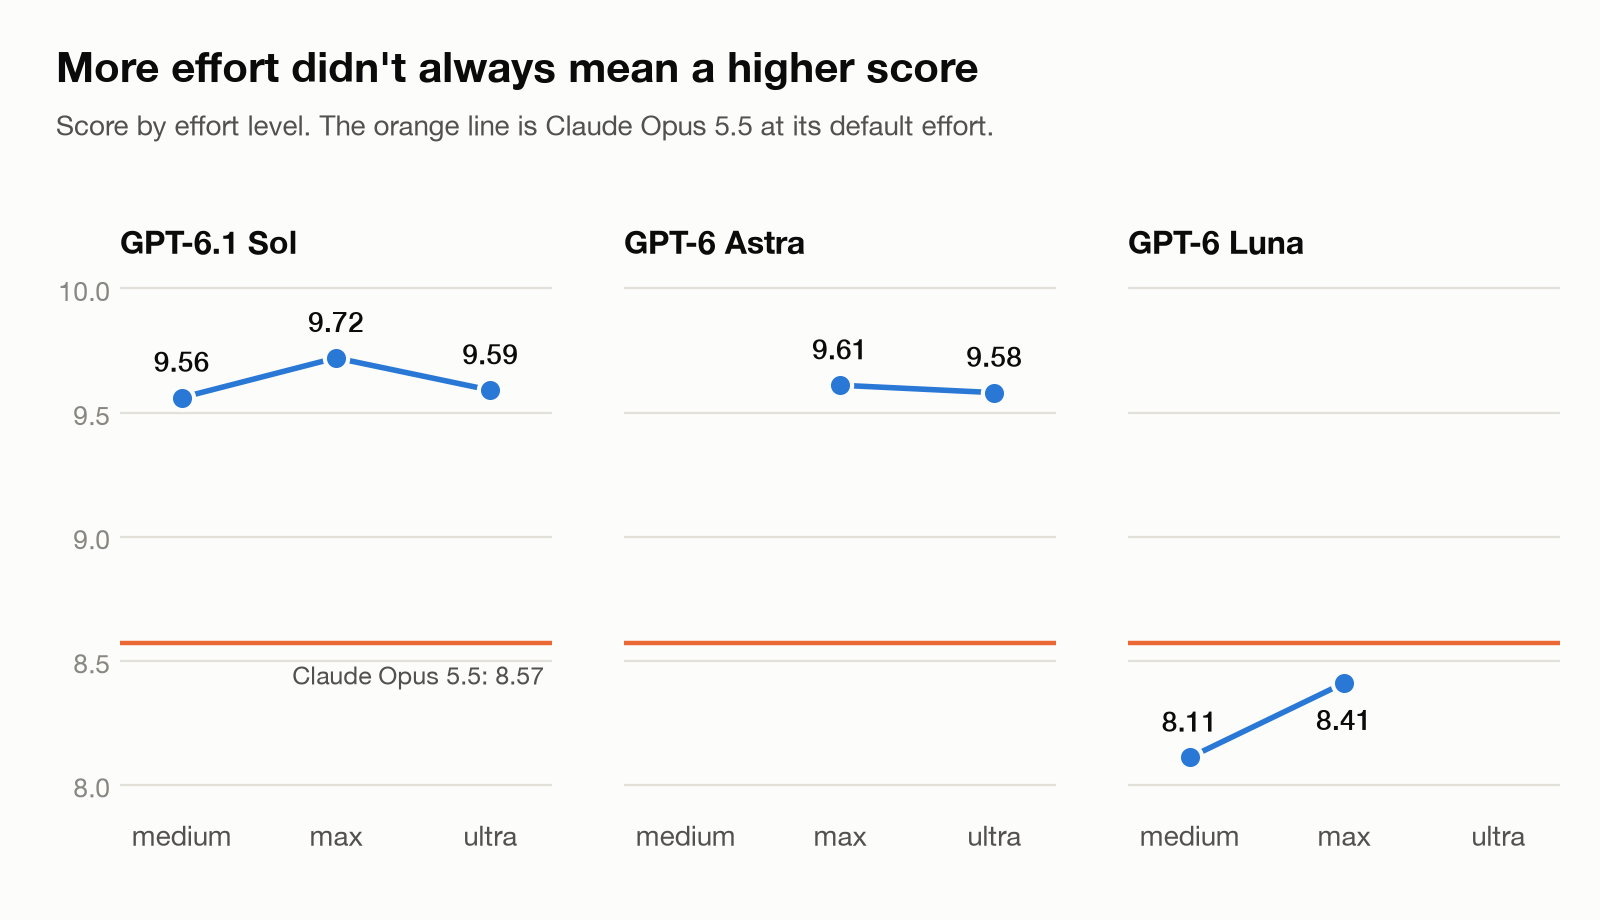 Figure 7. Score par niveau d'effort. La ligne orange est Claude Opus 5.5 à son effort par défaut.
Ultra n'a pas fait mieux que max pour aucun des deux modèles. Sol a obtenu 9,59 en ultra et 9,72 en max ; Astra a obtenu 9,58 et 9,61. Dans ce test, ultra a même produit moins de jetons de sortie que max. Pour Sol, medium s'approchait avec 9,56, pour moins de la moitié du coût de max. Un effort plus élevé ne signifiait pas non plus toujours des détails plus précis : Luna en medium a correctement écrit 天虹, et Luna en max non.
Une erreur dans ma notation
Après la notation, j'ai remarqué que les évaluateurs n'avaient pas reçu la date et l'heure de prise de vue de chaque photo, alors que les modèles de légende les avaient. L'évaluateur GPT-6 Astra a donc traité les légendes mentionnant la date ou l'heure exacte comme des détails inventés. Les meilleures configurations GPT mentionnaient la date le plus souvent, donc leurs scores « Aucun détail inventé » sont ressortis plus bas qu'ils n'auraient dû.
Si je ne rends que les points perdus sur les dates, les quatre premières configurations GPT montent à entre 9,84 et 9,90, ce qui est en pratique une égalité, et Opus reste à 8,58. J'ai conservé les scores d'origine dans ce billet. La prochaine fois, je donnerai aux évaluateurs tout ce que les modèles ont vu.
Vitesse
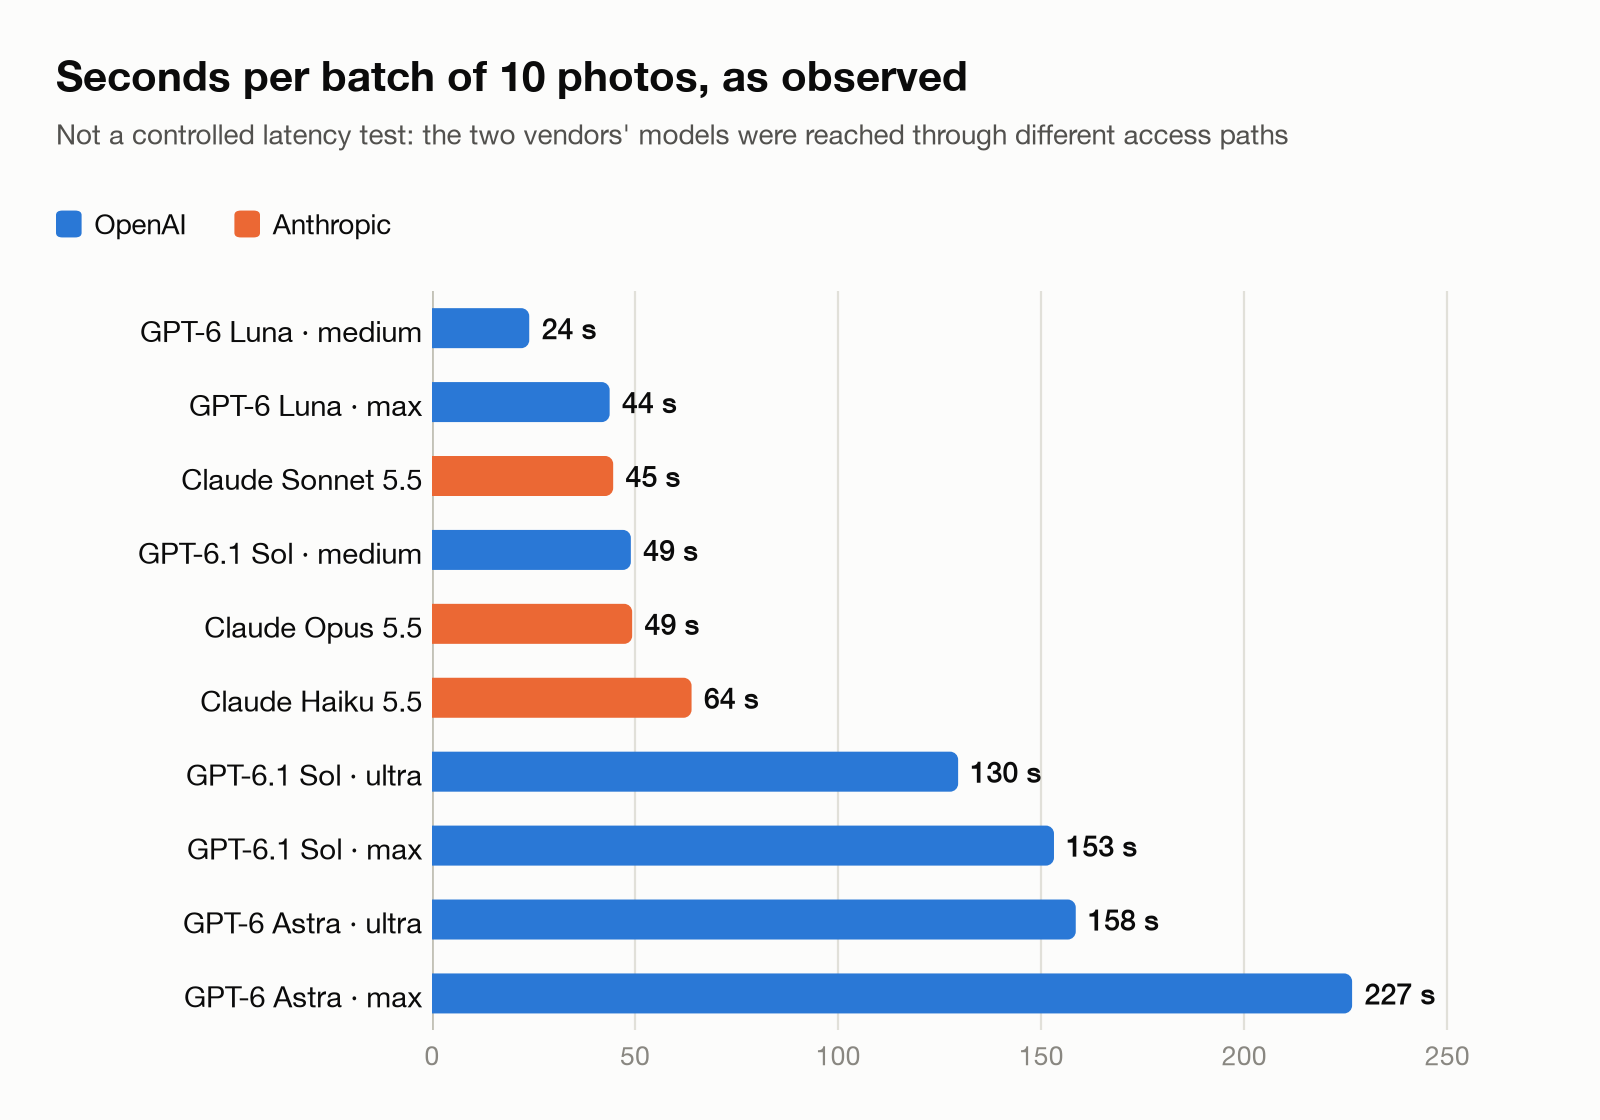 Figure 8. Secondes par lot de 10 photos, telles qu'observées. Ce n'est pas un test de latence contrôlé, car les modèles des deux fournisseurs ont été atteints par des voies d'accès différentes.
Cela correspond à la sensation qu'Opus me donne dans mon travail quotidien : il est rapide, environ trois fois plus rapide que Sol en max. Sol en medium était toutefois aussi rapide qu'Opus, et obtenait environ un point de plus.
Ce que ça coûte
J'ai chiffré chaque configuration aux prix officiels de l'API des fournisseurs. Traiter l'usage inclus dans un abonnement comme gratuit ferait paraître certains modèles meilleurs qu'ils ne le sont.
Prix officiels par million de jetons, niveau standard :
| Modèle | Entrée | Sortie |
|---|---|---|
| Claude Opus 5.5 | $4.00 | $20.00 |
| Claude Sonnet 5.5 | $2.00 | $10.00 |
| Claude Haiku 5.5 | $0.10 | $0.50 |
| GPT-6 Astra | $10.00 | $50.00 |
| GPT-6.1 Sol | $2.00 | $10.00 |
| GPT-6 Luna | $0.10 | $0.50 |
Les Batch API des deux fournisseurs coûtent 50 % de moins, ce qui convient à une tâche comme celle-ci qui n'a pas besoin de réponses instantanées. J'ai pris les prix sur la page de tarification d'Anthropic (claude.com/pricing) et sur celle de l'API d'OpenAI (developers.openai.com/api/docs/pricing) le 20 octobre 2026.
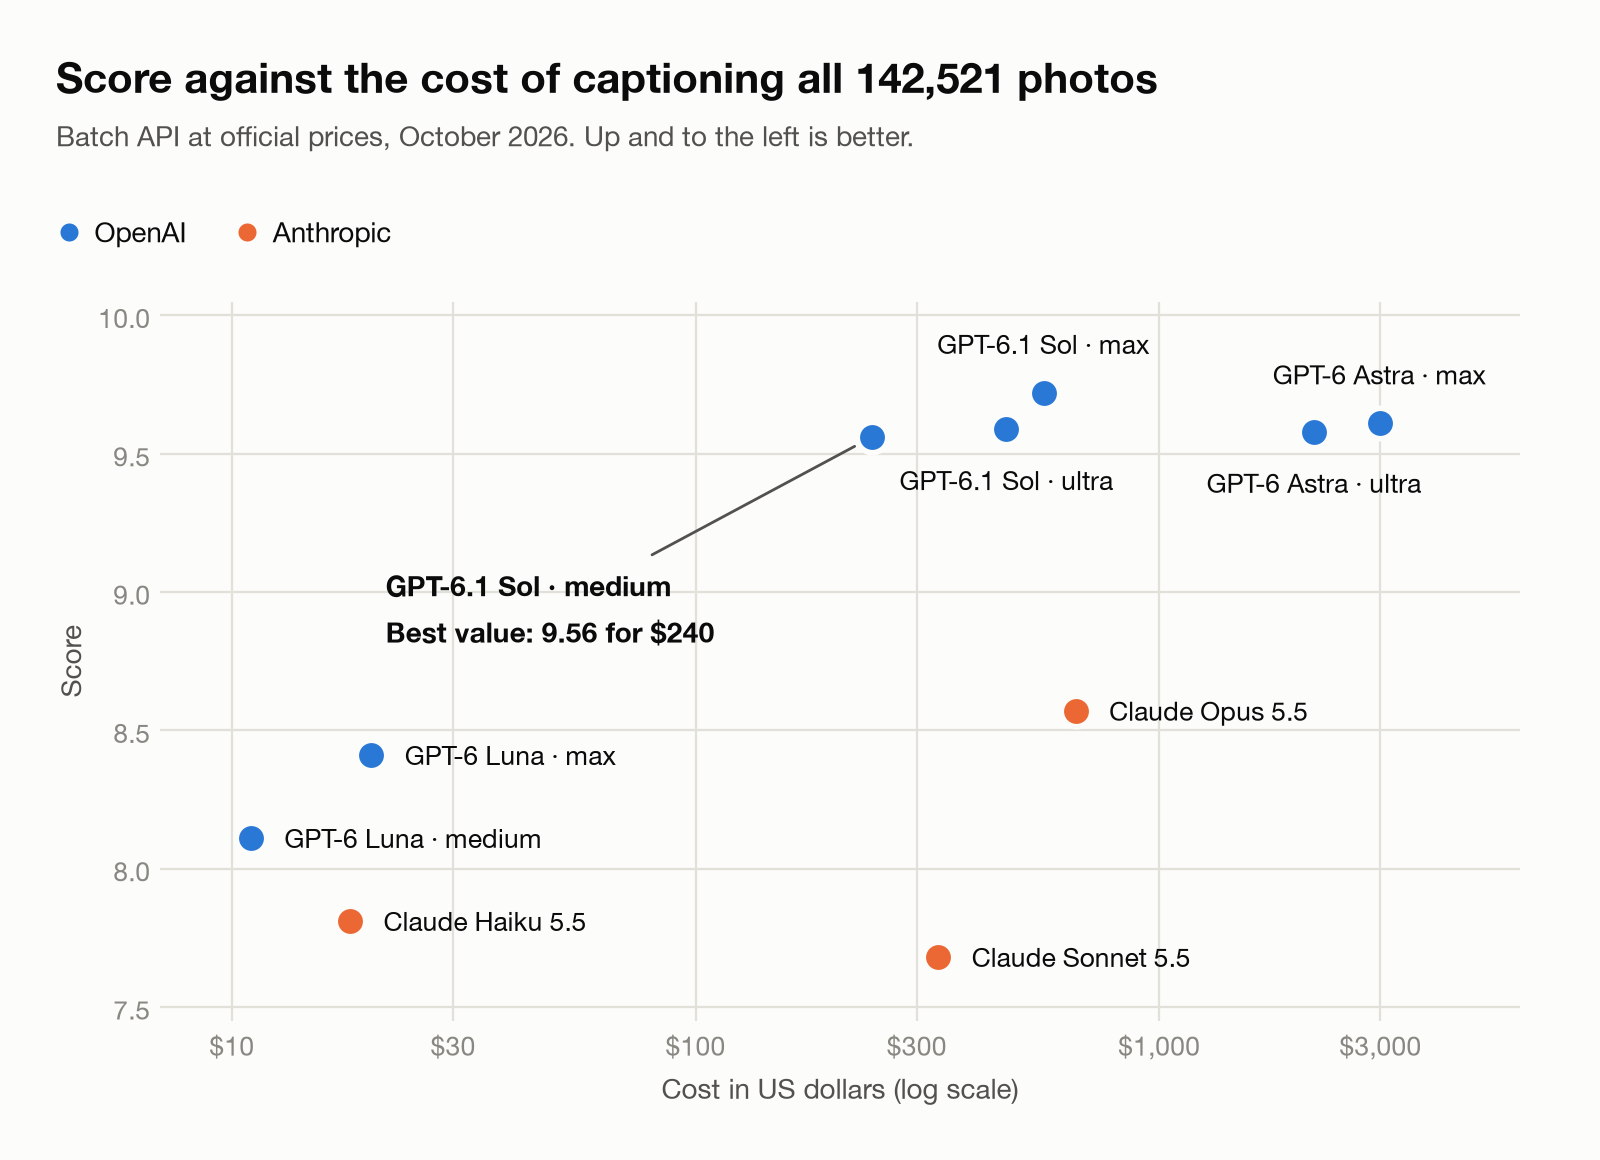 Figure 9. Score en fonction du coût de légender toute la bibliothèque aux prix Batch. L'axe de coût est logarithmique.
| Modèle et effort | Jetons de sortie par photo | Standard | Batch | Score |
|---|---|---|---|---|
| GPT-6.1 Sol, medium | 193 | $479 | $240 | 9.56 |
| GPT-6.1 Sol, ultra | 514 | $937 | $468 | 9.59 |
| GPT-6.1 Sol, max | 647 | $1,126 | $563 | 9.72 |
| Claude Opus 5.5 | ~292 | $1,323 | $661 | 8.57 |
| Claude Sonnet 5.5 | ~297 | $668 | $334 | 7.68 |
| GPT-6 Astra, ultra | 462 | $4,313 | $2,156 | 9.58 |
| GPT-6 Astra, max | 695 | $5,973 | $2,987 | 9.61 |
| GPT-6 Luna, medium | 163 | $22 | $11 | 8.11 |
| Claude Haiku 5.5 | ~330 | $36 | $18 | 7.81 |
| GPT-6 Luna, max | 419 | $40 | $20 | 8.41 |
Sol en medium a obtenu 98 % du meilleur score pour 36 % de ce que coûterait Opus et 43 % de Sol en max. Astra a égalé la qualité de Sol mais coûte environ cinq fois plus, car son prix par jeton est cinq fois plus élevé. Opus a coûté plus que Sol en max et a obtenu un score plus bas. Il tournait déjà en effort medium, mais son prix par jeton est le double de celui de Sol. Luna légenderait toute la bibliothèque pour 11 à 20 $ et surpasserait quand même Haiku et Sonnet.
Note de méthode : les comptes de jetons GPT ont été mesurés à partir des exécutions, et les comptes de jetons Claude ont été estimés à partir des journaux d'exécution. Certains jetons de raisonnement Claude n'étaient pas visibles, donc les coûts Claude peuvent être légèrement sous-estimés. Aucune remise au-delà de Batch, comme la mise en cache de prompts, n'a été appliquée à aucun modèle.
Ce que j'ai appris
J'ai choisi Opus avant d'avoir le moindre score à l'aveugle, surtout parce qu'il était déjà mon choix par défaut pour coder. Je préfère toujours Claude Opus 5.5 pour coder et pour les workflows, où il est plus rapide et plus fort d'après mon expérience. Décrire de vraies photos demande une compétence différente : lire ce qui est réellement dans le cadre sans combler les poses ou les relations. GPT-6.1 Sol faisait cela mieux. Si j'avais suivi mon habitude et sauté le test à l'aveugle, j'aurais payé plus pour de moins bonnes légendes.
La prochaine fois, je commencerai à l'aveugle et je donnerai aux évaluateurs de différents fournisseurs toutes les entrées que les modèles de légende ont reçues. Je continuerai aussi à comparer aux prix officiels de l'API, et je ne supposerai pas que plus d'effort est meilleur : ultra n'a pas battu max ici.
Même les meilleurs modèles ont signalé des photos utiles pour suppression, donc je vérifierai chaque signalement de suppression moi-même avant de retirer quoi que ce soit.
Limites
C'était un petit test : 50 photos récentes d'une seule ville. Je n'ai pas testé de photos plus anciennes, de documents numérisés, d'autres langues ni de vidéos. Les modèles Claude n'ont tourné qu'avec leurs réglages par défaut ; un Opus à effort plus élevé pourrait mieux scorer, à un coût plus élevé. Les évaluateurs sont des modèles d'IA, pas des personnes. Ils étaient bien d'accord mais pas parfaitement, et un contrôle ponctuel humain rendrait le résultat plus solide. Les modèles et les prix changent vite, et chaque chiffre ici date d'octobre 2026.
Mon choix
Pour ma bibliothèque : GPT-6.1 Sol en effort medium. Pour coder et pour les workflows, je m'en tiens à Claude Opus 5.5.