
私は自分の142,000枚の写真ライブラリで10個のAIモデルをブラインドテストした:GPT-6.1 SolがClaude Opusに勝った
要旨
私はコーディングやワークフローに毎日Claude Opus 5.5を使っており、その仕事ではGPT-6より速く、優れていると感じている。写真の説明でも最も優れているだろうと思い、テストしてみた。テストしたのは10構成だ。Claude Haiku、Sonnet、Opus 5.5、そしてOpenAIのGPT-6.1 Sol、GPT-6 Astra、GPT-6 Lunaを複数の推論強度で。それぞれが、私の142,521枚の写真ライブラリから50枚の実写真にタイトルを付け、キャプションを書き、キーワードを付け、アルバムに分類し、削除すべきだと思う写真にフラグを立てた。異なるベンダーの2人のブラインド採点者、Claude Fable 5.1とGPT-6 Astraが、事実、捏造の有無、削除判定、アルバムの適合性、有用性の5項目で500件の回答すべてを採点した。GPT-6.1 Solが10点満点中9.72点で最高。Opusは8.57点、SonnetとHaikuは7.7~7.8点だった。ultraはmaxより良くはなかった。公式Batch API価格では、ライブラリ全体のキャプション付けは、medium(9.56点)のSolで約240ドル、Opusで661ドル、Lunaで11~20ドルかかり、LunaはHaikuを上回った。
なぜテストしたのか
私の1日の大半はコーディング、エージェントのワークフロー、自動化に費やされ、頼りにしているのはClaude Opus 5.5だ。その種の仕事では、GPT-6より速く、優れていると感じてきた。だから、AIに写真ライブラリのキャプションとタグ付けをさせようと決めたとき、迷わずOpusを選んだ。
このライブラリは私の25年の人生そのものだ。142,521枚の写真。初期のデジタルカメラから先週のスマホ写真まで、スクリーンショットだけでも16,000枚以上ある。ほとんどにキャプションがない。私は各写真に、タイトル、キャプション、検索できるキーワード、妥当なアルバム、そして重複や不要な写真には正直なフラグを付けたい。142,000枚を処理するためにお金を払う前に、どのモデルがこれを最も得意とし、その差にいくらの価値があるのかを知りたかった。
私はOpusが勝つと思っていた。この50枚の写真では、GPT-6.1 Solが1点以上上回った。
結果の概要
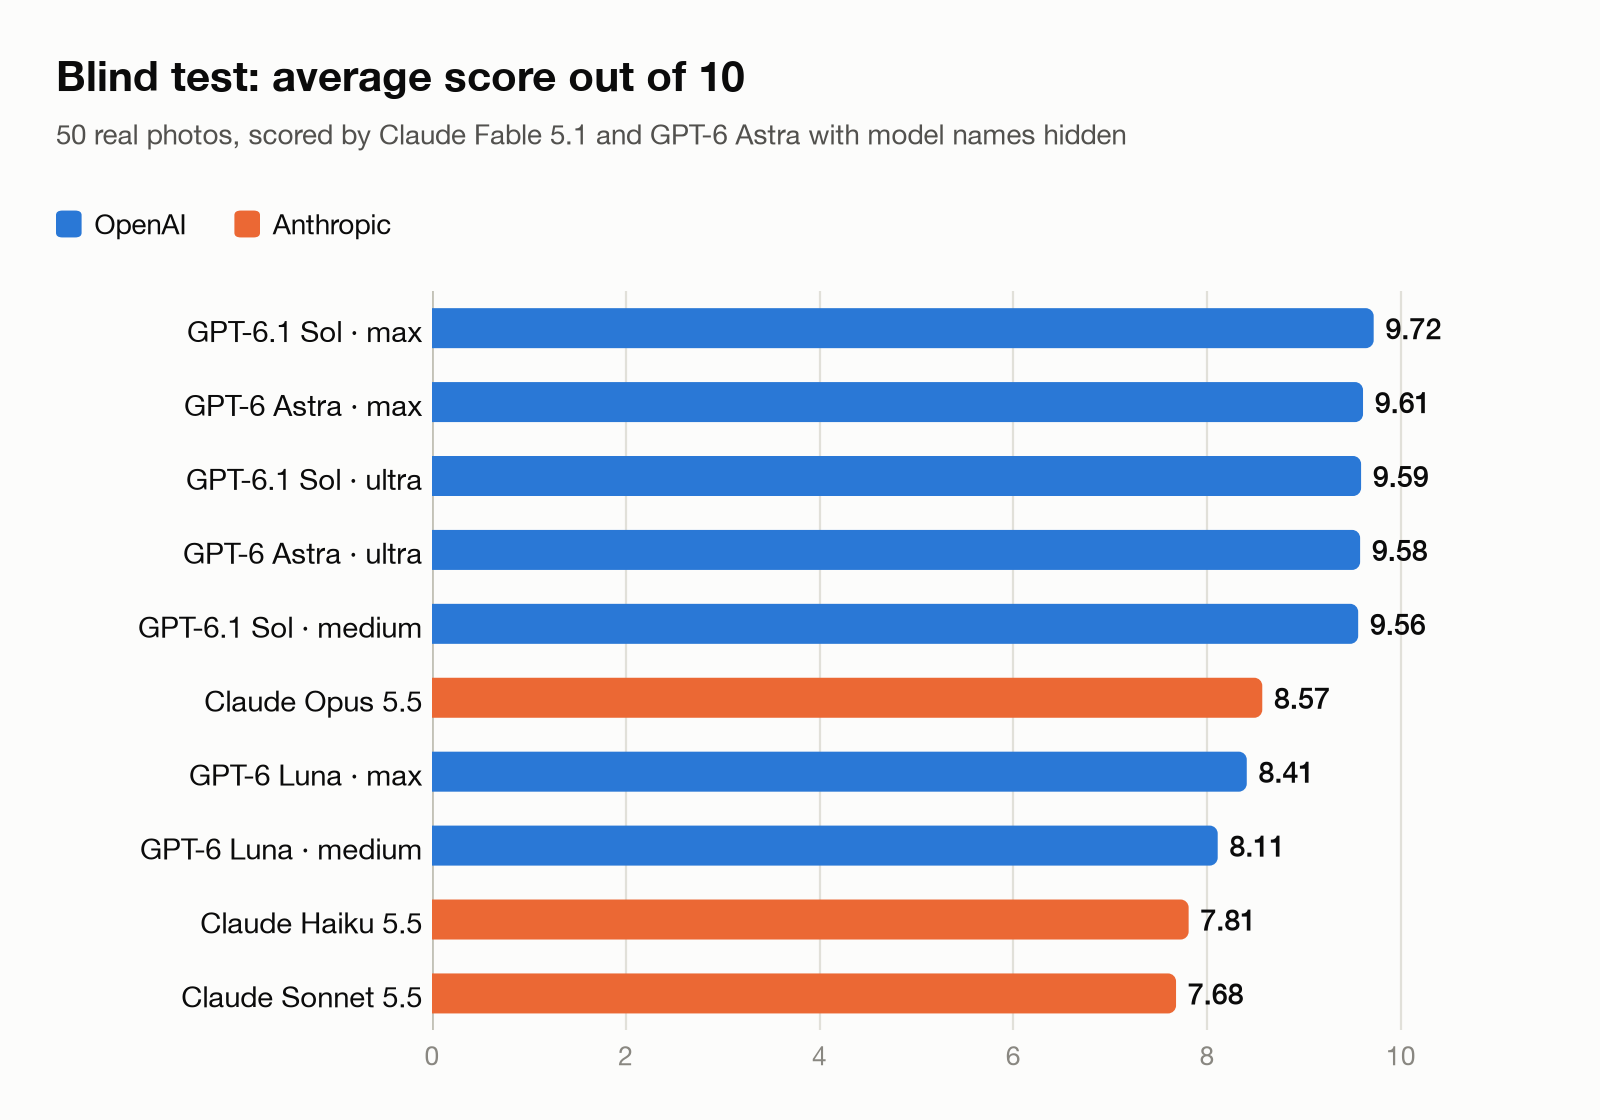 図1:2人のブラインド採点者による平均スコア、10点満点。
| 順位 | モデルと推論強度 | スコア(10点満点) | ライブラリ全体、Batch API | ライブラリ全体、標準API |
|---|---|---|---|---|
| 1 | GPT-6.1 Sol、max | 9.72 | $563 | $1,126 |
| 2 | GPT-6 Astra、max | 9.61 | $2,987 | $5,973 |
| 3 | GPT-6.1 Sol、ultra | 9.59 | $468 | $937 |
| 4 | GPT-6 Astra、ultra | 9.58 | $2,156 | $4,313 |
| 5 | GPT-6.1 Sol、medium | 9.56 | $240 | $479 |
| 6 | Claude Opus 5.5 | 8.57 | $661 | $1,323 |
| 7 | GPT-6 Luna、max | 8.41 | $20 | $40 |
| 8 | GPT-6 Luna、medium | 8.11 | $11 | $22 |
| 9 | Claude Haiku 5.5 | 7.81 | $18 | $36 |
| 10 | Claude Sonnet 5.5 | 7.68 | $334 | $668 |
コストは142,521枚すべての写真を、各ベンダーの公式API価格で処理した場合。
このテストに基づく私の選択:
- スコアだけを重視するなら、GPT-6.1 Solのmax。
- 自分のライブラリには、GPT-6.1 Solのmedium。240ドルで最高スコアの98%を達成し、Opusの約3分の1のコストで済む。
- 予算が厳しければ、GPT-6 Lunaのmax。20ドルで、トークン単価が同じHaikuを上回り、このライブラリでは約17倍のコストがかかるSonnetをも上回る。
- Claude Sonnet 5.5は選ばない。中価格帯なのにスコアが最低だった。
テストしたモデル
| ベンダー | モデル | テストした推論強度 | 位置づけ |
|---|---|---|---|
| Anthropic | Claude Opus 5.5 | デフォルト(medium) | 旗艦・日常の主力 |
| Anthropic | Claude Sonnet 5.5 | デフォルト | ミッドレンジ |
| Anthropic | Claude Haiku 5.5 | デフォルト | 高速・低コスト |
| OpenAI | GPT-6 Astra | max、ultra | フロンティアモデル |
| OpenAI | GPT-6.1 Sol | medium、max、ultra | 主力 |
| OpenAI | GPT-6 Luna | medium、max | 高速・低コスト |
価格は2社で対応している。GPT-6.1 SolはClaude Sonnet 5.5と、GPT-6 AstraはClaude Fable 5.1と、GPT-6 LunaはClaude Haiku 5.5とトークン単価が同じで、Claude Opus 5.5はSolとAstraの間にある。したがって、以下で2つのモデルのコストが異なる場合、そのほとんどは同じ仕事に対して片方がより多くのトークンを使ったためだ。
Claudeモデルはそれぞれデフォルト設定で1回ずつ実行した。Opusにとってデフォルトはmediumを意味する。GPTモデルは複数の推論強度でテストした。最も公平な比較は、mediumのGPT-6.1 SolとmediumのClaude Opus 5.5だ。9.56対8.57である。
テスト方法
当時のライブラリで最新の50枚の写真を使った。動画は除いた。これは私のカメラロールのありふれた1週間だ。自宅や買い物先での家族のひととき、高層階からの街の眺め、机の上のメモリーカード、電子部品の商品ページのスクリーンショット、注文追跡のスクリーンショット、SNSの投稿、駐車割引のQRコードの看板、EV充電器のラベル。
各モデルは写真ごとに5つの仕事をした。短いタイトルと、1~3文の中国語のキャプションを書き、中国語と英語で5~12個のキーワードを付け、既存のアルバムから最適なものを選ぶか、選ばない。その後、品質スコアを付け、重複、失敗したショット、期限切れのスクリーンショット、永続的な価値のない写真を探して、写真を残すか削除するかを判断する。すべてのモデルが同じ指示と同じコンテキストを受け取り、一度に10枚ずつ処理した。
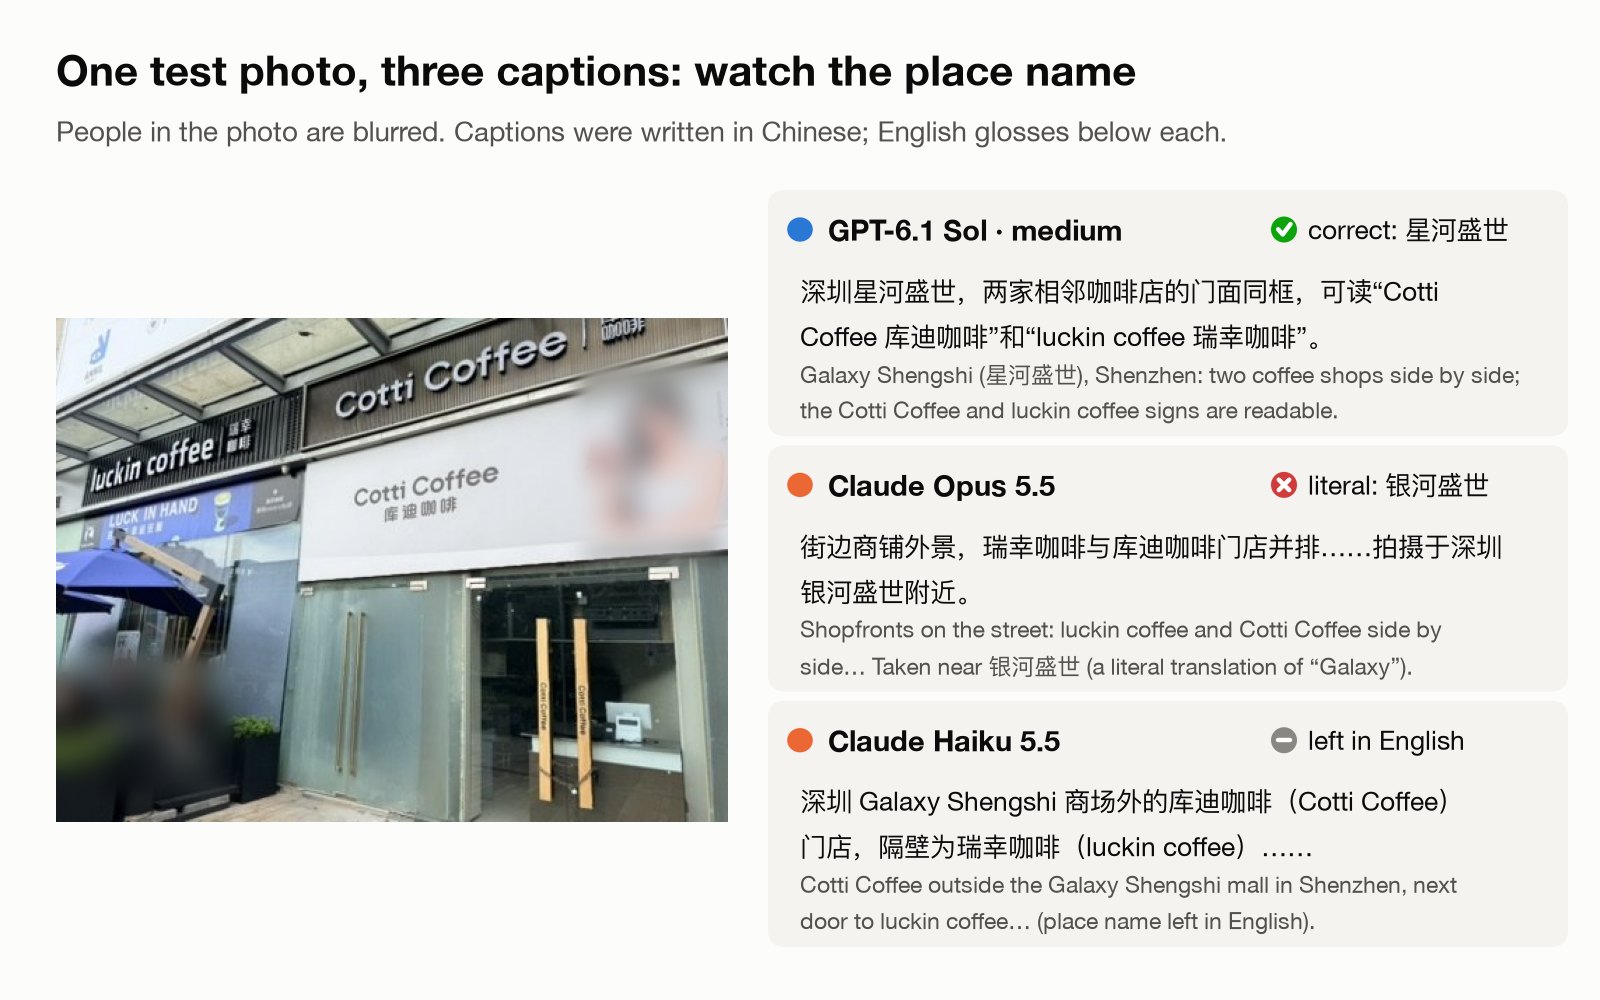 図2:50枚のテスト写真のうちの1枚と、3つのキャプション。各モデルが地名をどう扱うかに注目。後で触れる。写真の人物はぼかしてある。
採点方法
回答の採点は自分ではしなかった。テスト前に勝者をすでに決めていたし、毎日Claudeを使っているので中立ではないからだ。
代わりに、各写真の10件の回答をシャッフルしてAからJのラベルを付け、写真ごとに新しいランダムな順序にした。その後、2人の採点者が写真を見ながら、500件すべての回答を独立に採点した。1人はClaude Fable 5.1、Anthropicの最も高性能なモデル。もう1人はxhighのGPT-6 Astra、OpenAIのフロンティアモデル。
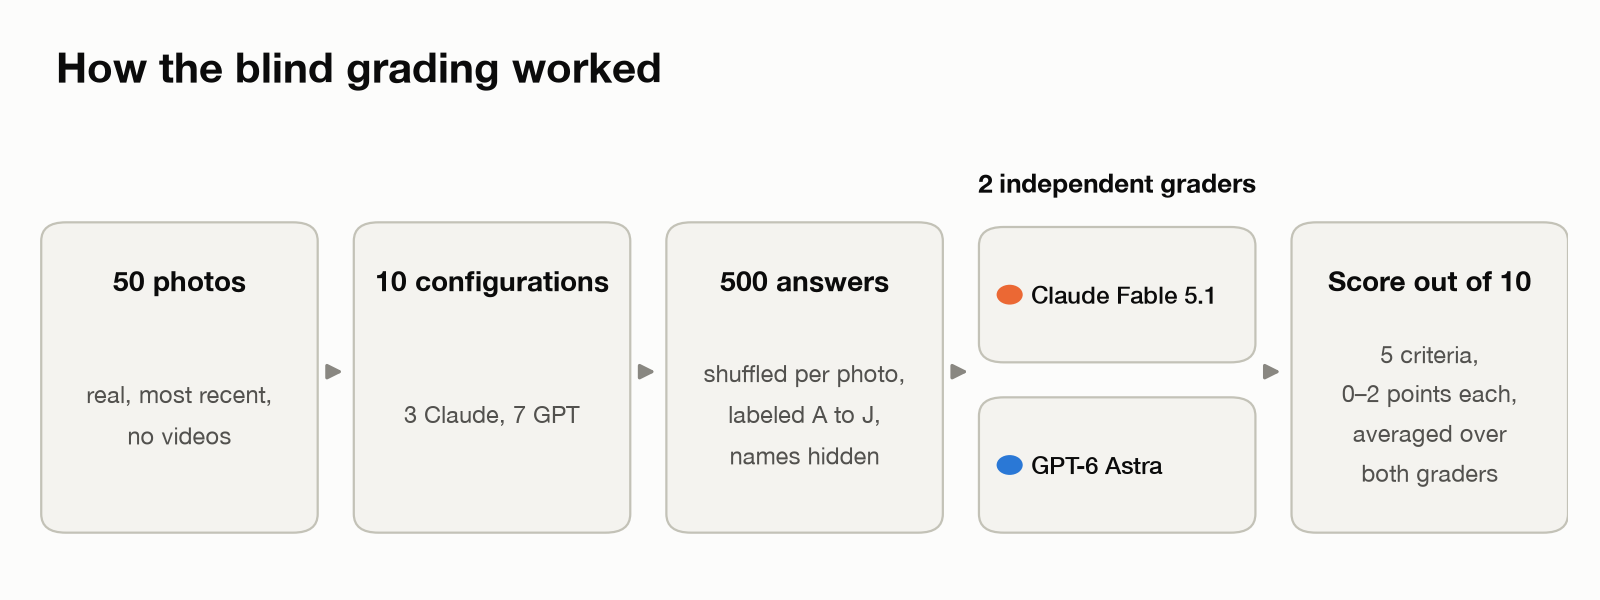 図3:ブラインド採点の仕組み。
各回答は5つの基準で採点され、各0~2点、合計10点満点:
| 基準 | 採点者が確認した点 |
|---|---|
| 事実 | 被写体、場所、読み取れる文字は正しいか。現地の地名も含む。 |
| 捏造なし | 写真に写っていないことを主張していないか。 |
| 削除判定 | 残すか削除するかは妥当か。良い写真を削除した場合は0点。 |
| アルバムの適合性 | アルバムは正しいか。間違った古いアルバムは0点、アルバムなしは許容できる1点。 |
| 有用性 | タイトル、キャプション、キーワードは、後でこの写真を見つけて思い出すのに役立つか。 |
各ベンダーから1人ずつ採点者を選んだのは、どちらかが自社モデルをひいきするかを見るためだ。2人はおおむね一致した。500件のペアのスコアの相関は0.71で、どちらも同じ5つのGPT構成を上位に置いた。Claudeの採点者も、GPT-6.1 SolとGPT-6 AstraをClaude Opusより上位にランク付けした。GPTの採点者は全体により厳しく、Claudeモデルに対して最も厳しかった。
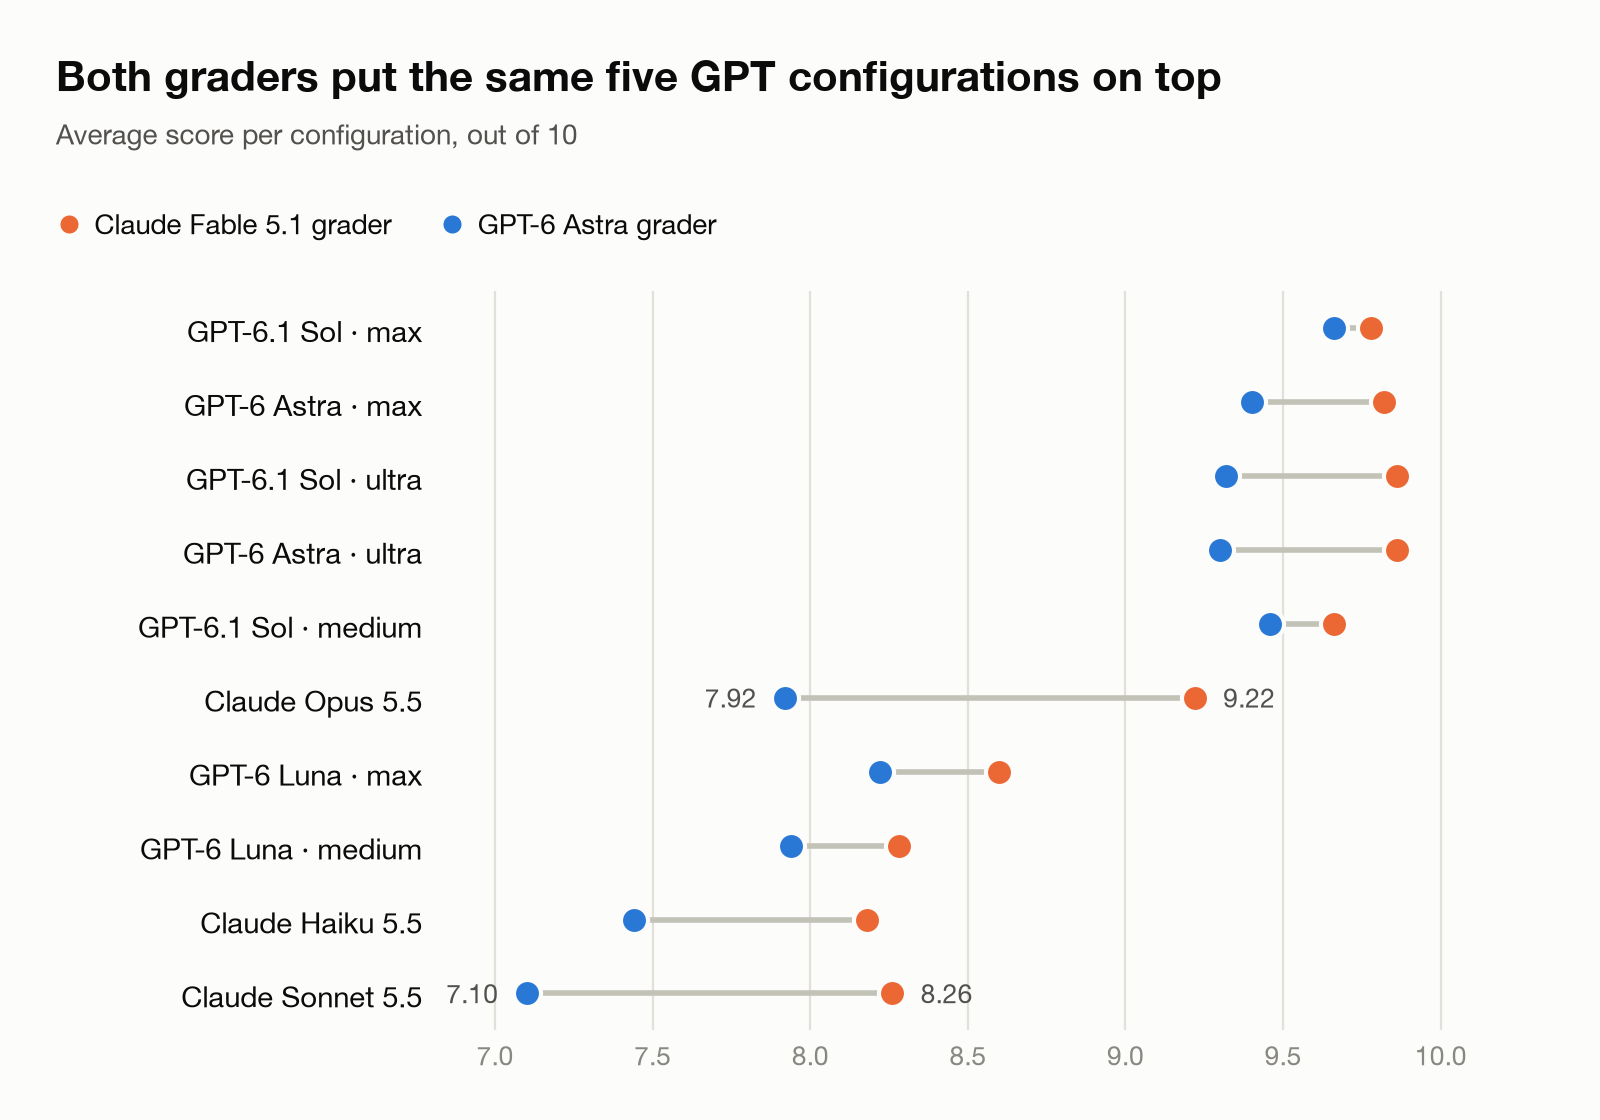 図4:各構成に対する各採点者の平均スコア。
結果
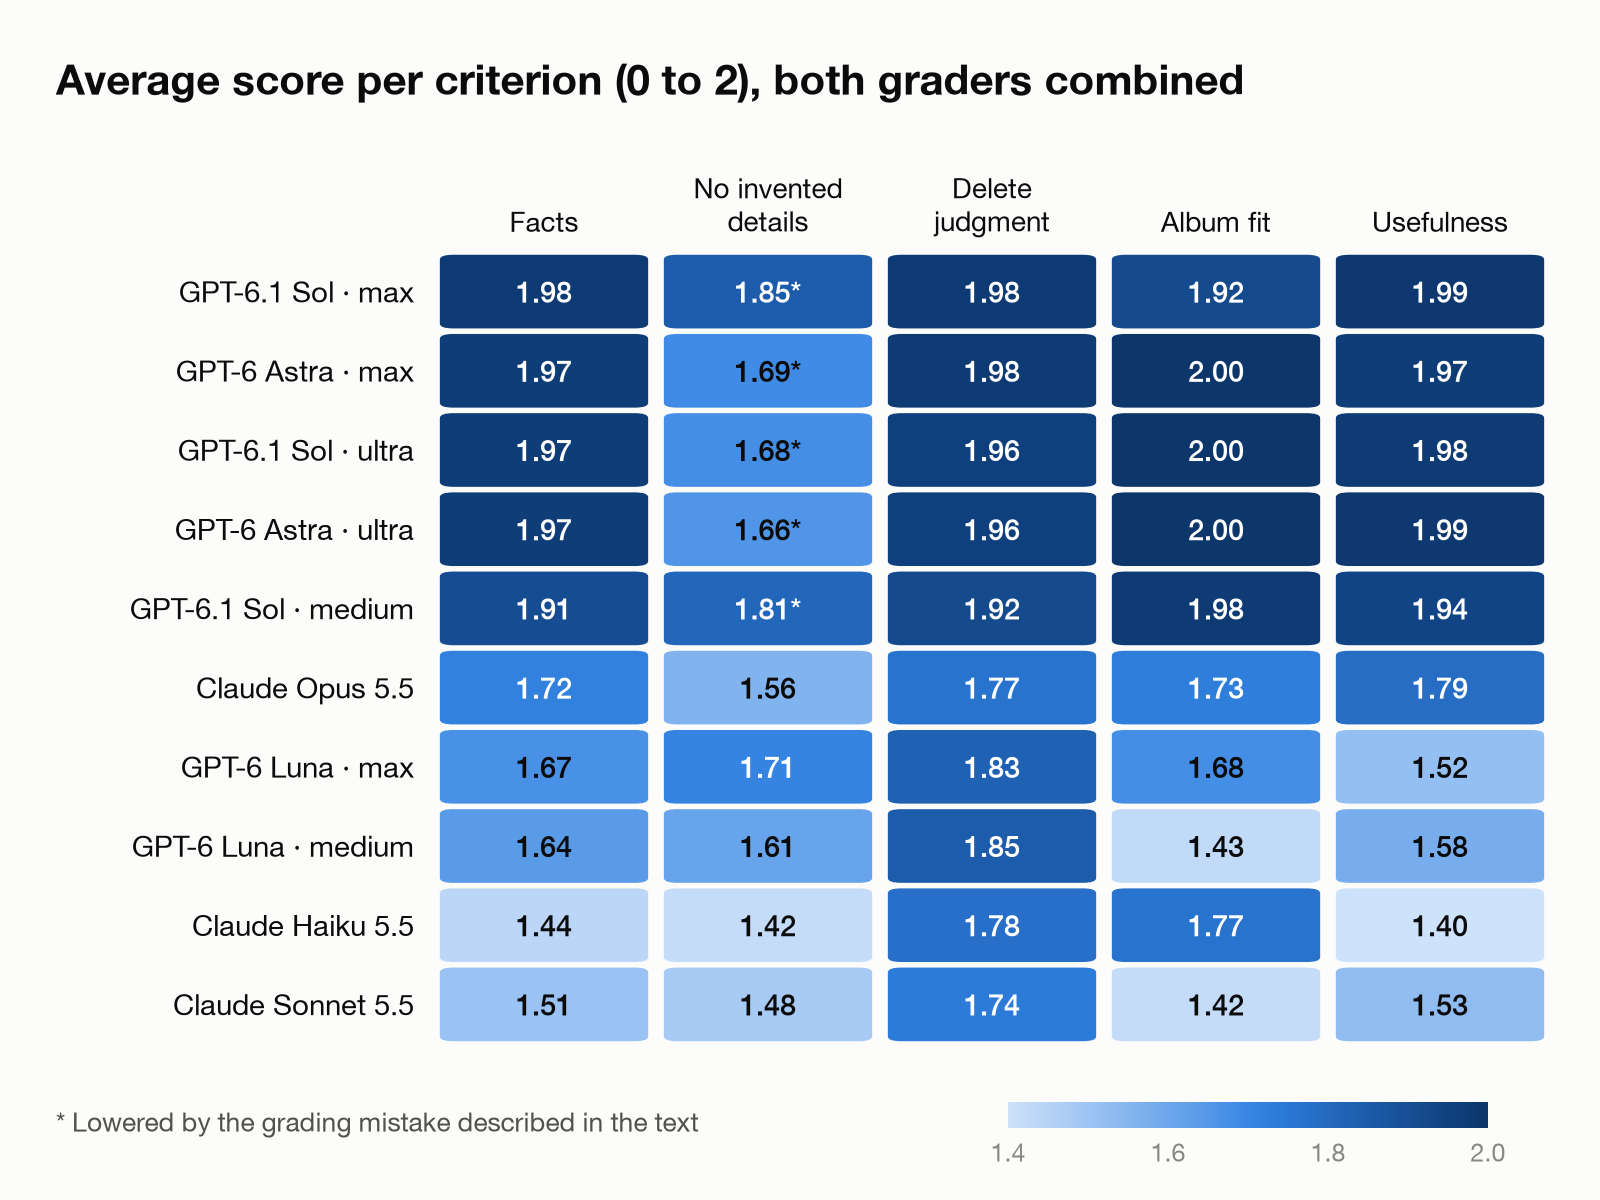 図5:基準ごとの平均スコア、2人の採点者の合算。アスタリスクは、後述する採点のミスで下がったスコアを示す。
GPT-6.1 SolとGPT-6 Astra
SolとAstraは文字を正確に読み取り、キャプションを写真に写っている内容にほぼ限定した。現地の地名の扱いも最も優れており、これは中国で撮影した写真にとって重要だ。
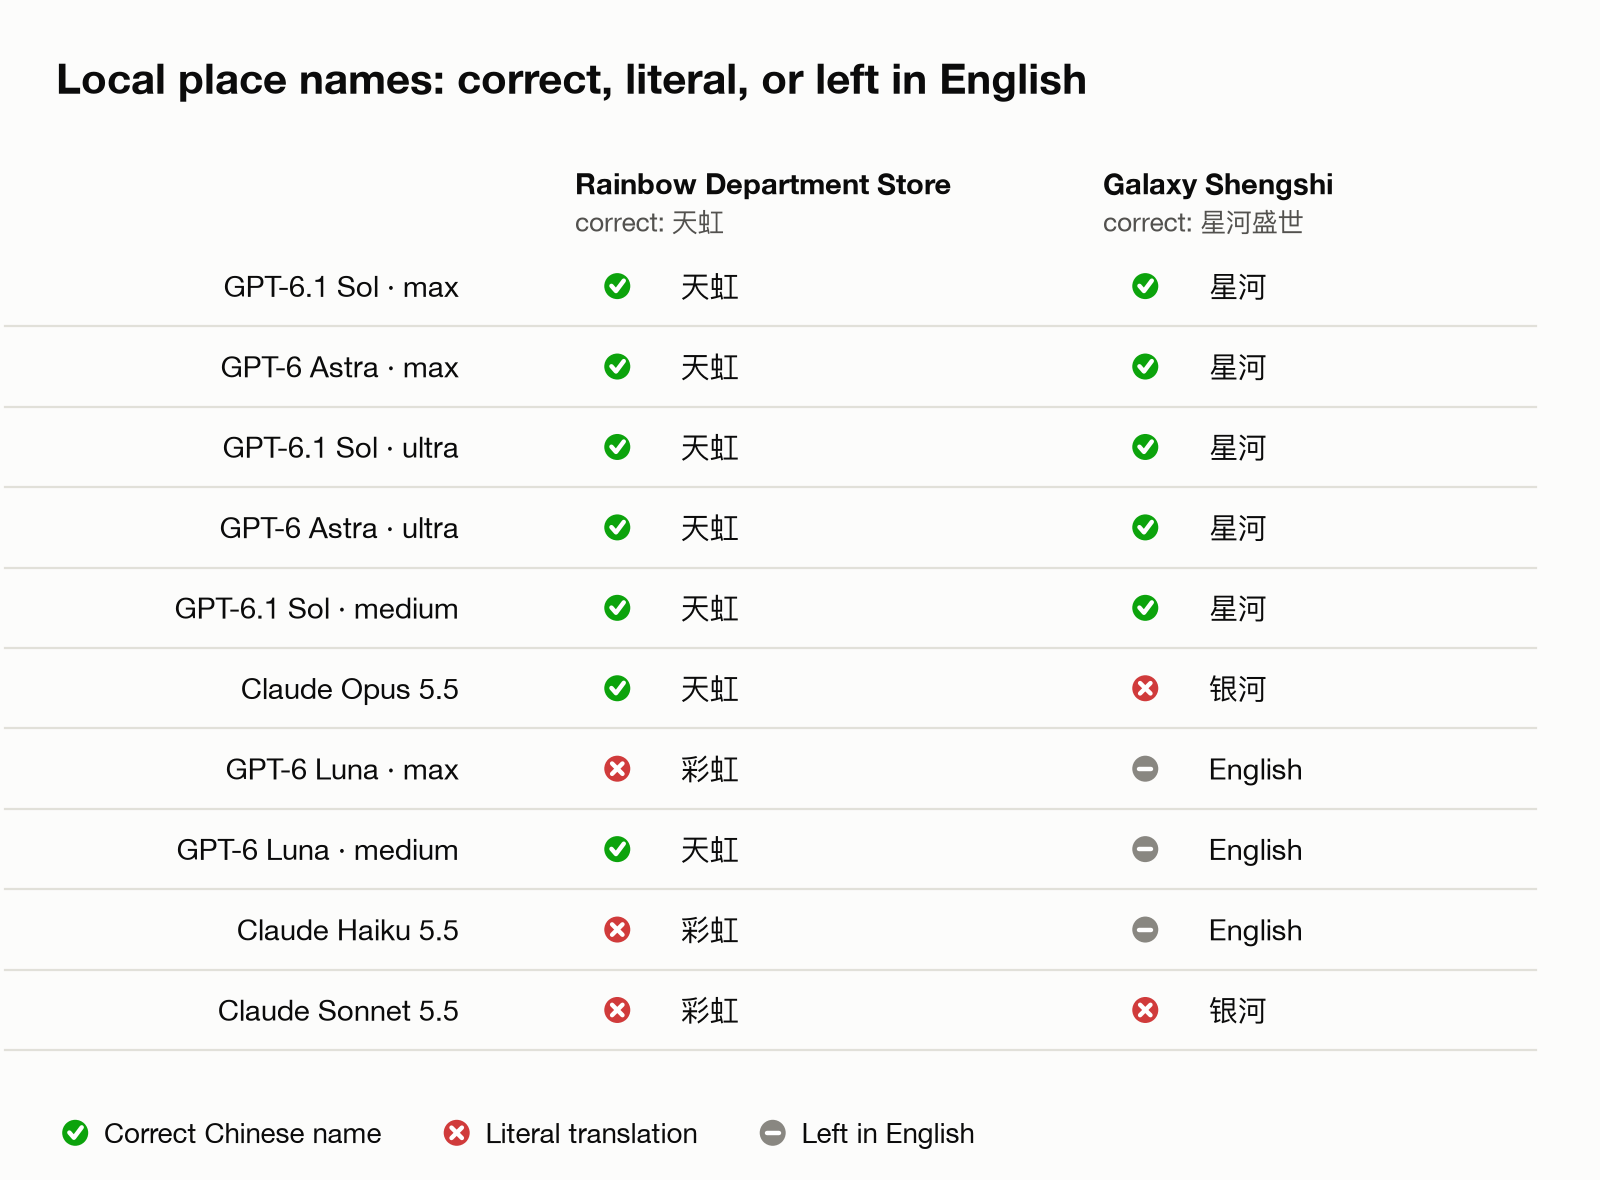 図6:2つの地名テスト。チェックは正しい中国語名、バツは直訳、ENは英語のまま残されたことを意味する。
いくつかの写真には「Rainbow Department Store」という場所がタグ付けされていた。これは深圳のショッピングモールチェーン、天虹の英語名だ。逐語訳すると彩虹百貨になり、これは誤り。すべてのSolとAstraの構成はこれを正しく書き、OpusとmediumのLunaも正しかった。Haiku、Sonnet、maxのLunaは直訳を使った。図2のコーヒーショップの写真には「Galaxy Shengshi」とタグ付けされ、その中国語名は星河盛世。すべてのSolとAstraの構成は星河と書いた。OpusとSonnetは銀河と直訳し、Haikuと両方のLuna構成は英語のまま残した。
SolとAstraは削除についても慎重だった。50枚のうち4~6枚の削除を提案した。セットには電子部品の商品ページのスクリーンショットが8枚含まれ、GPTモデルはほぼすべてを残した。1つのSol構成だけが、1枚のスクリーンショットをほぼ重複としてフラグした。Claudeモデルはそれぞれ2~4枚をフラグした。両採点者とも残す方に賛成した。それらのページには、後で調べたいピン配置、寸法、基板の写真が載っていたからだ。
Claude Opus 5.5
Opusは、写真だけでは示せないことをキャプションに書いてしまうことがあった。画像だけでは証明できない関係、たとえばきょうだいや親子を描写した。ポーズもいくつか間違えた。ある写真では子どもが大人の後ろに立っていたが、Opusは子どもが大人の背中に乗っていると書いた。両採点者ともこれで減点した。
これは意外だった。ブラインドテストの前に、私は回答に目を通し、2人の子どもがきょうだいだと正しく推測したOpusを褒めていた。私は自分の家族を知っているが、採点者は知らない。しかし142,000枚の写真では、すべてのキャプションを自分で確認することはできず、写真に写っていないことを述べるキャプションは問題だ。
Opusは削除の提案も最も多く、50枚中13枚だった。そのうち3枚は商品ページのスクリーンショットで、保持したい参照情報が載っていたのに「期限切れ」と判断した。駐車割引のQRコードの看板を価値が低いとして削除したがった唯一のモデルでもあった。また、1人の人物が写った写真をいくつか「家族写真」アルバムに入れた。
Claude Sonnet 5.5とHaiku 5.5
この2つは事実の誤りが最も多く、天虹の直訳「彩虹」も含まれる。Sonnetはアルバム選びが最も弱く、日常の写真を無関係な過去のイベントの古いアルバムに入れた。Haikuは、誤った削除判断につながる細部を捏造した。ほぼ同じ連写のうち、最も良いフレームを「誰かが下を向いている」と説明したが、これは写真とは逆で、削除を提案した。
GPT-6 Luna
LunaはHaikuとトークン単価が同じだが、両方の推論強度でHaikuより高いスコアを出した。8.41と8.11で、Haikuは7.81。maxでは、同じライブラリのキャプション付けに約17倍のコストがかかるSonnetも上回った。Lunaは有用性とアルバム選びで最も失点した。キャプションはより素朴で、アルバムもあまり正確ではなかった。
推論強度
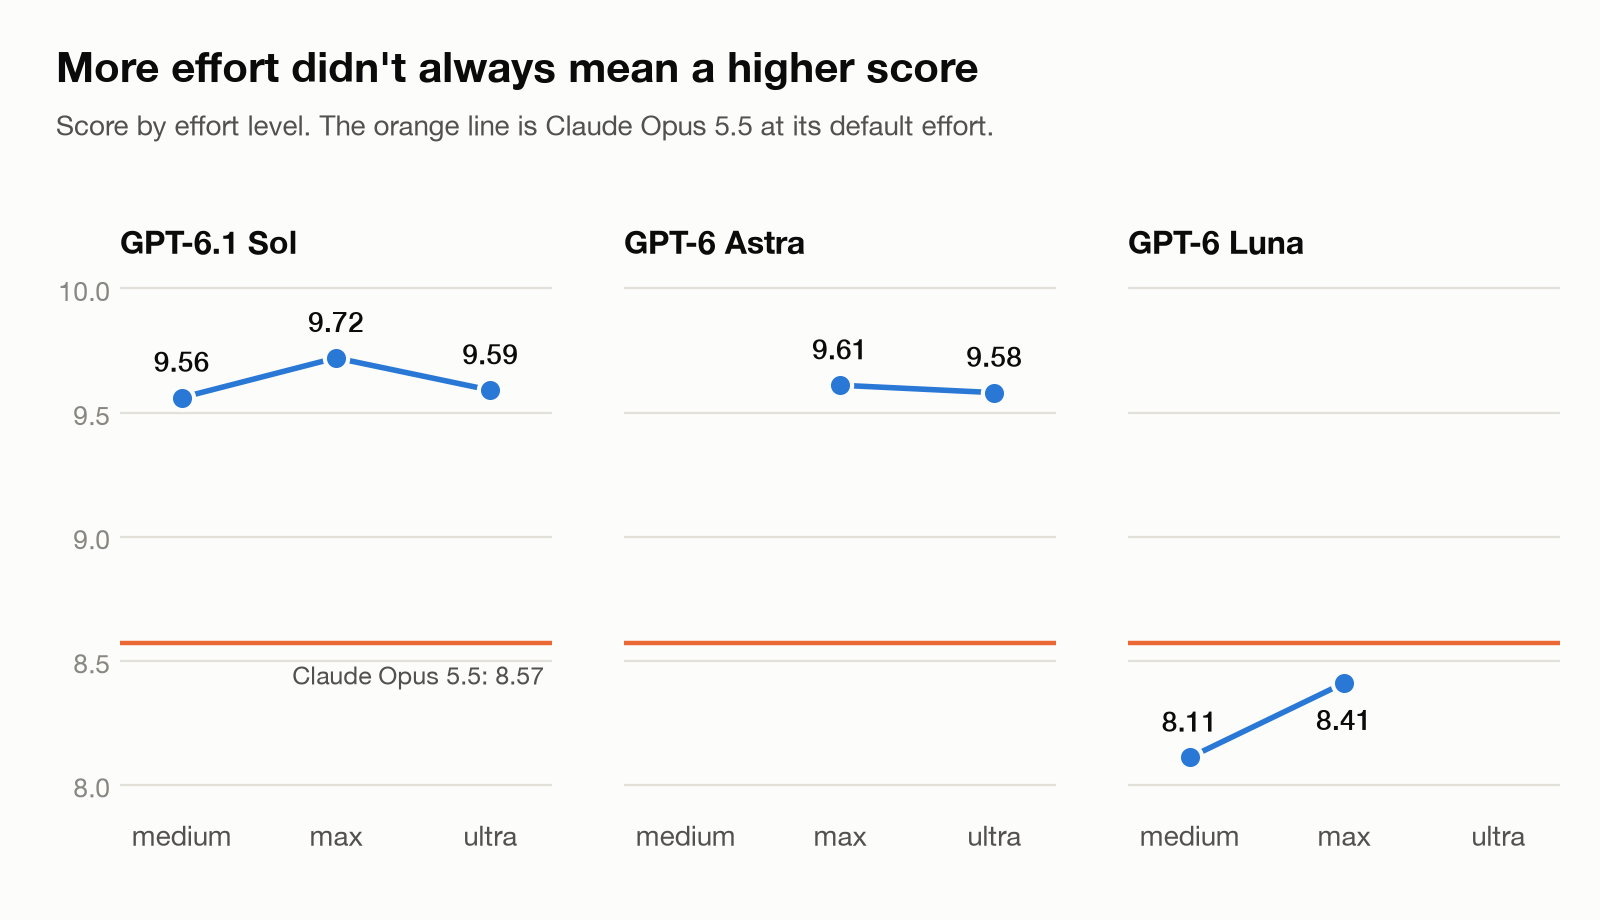 図7:推論強度別のスコア。オレンジの線はデフォルト推論強度のClaude Opus 5.5。
ultraはどちらのモデルでもmaxより良くはなかった。Solはultraで9.59、maxで9.72。Astraは9.58と9.61。このテストでは、ultraはmaxより出力トークンが少ないことさえあった。Solの場合、mediumは9.56と迫り、コストはmaxの半分未満だった。推論強度が高ければ細部が正確になるとは限らない。mediumのLunaは天虹を正しく書き、maxのLunaは正しく書けなかった。
採点における私のミス
採点後、キャプションのモデルには各写真の撮影日時が与えられていたのに、採点者には与えられていなかったことに気づいた。そのため、GPT-6 Astraの採点者は、正確な日付や時刻に言及したキャプションを捏造として扱った。上位のGPT構成が最も頻繁に日付に言及したため、その「捏造なし」スコアは本来よりも低く出た。
日付で失った分だけを戻すと、上位4つのGPT構成は9.84~9.90に上昇し、実質的に同点となる。Opusは8.58のまま。この記事では元のスコアを保持した。次回は、モデルが見たすべてのものを採点者にも与えるつもりだ。
速度
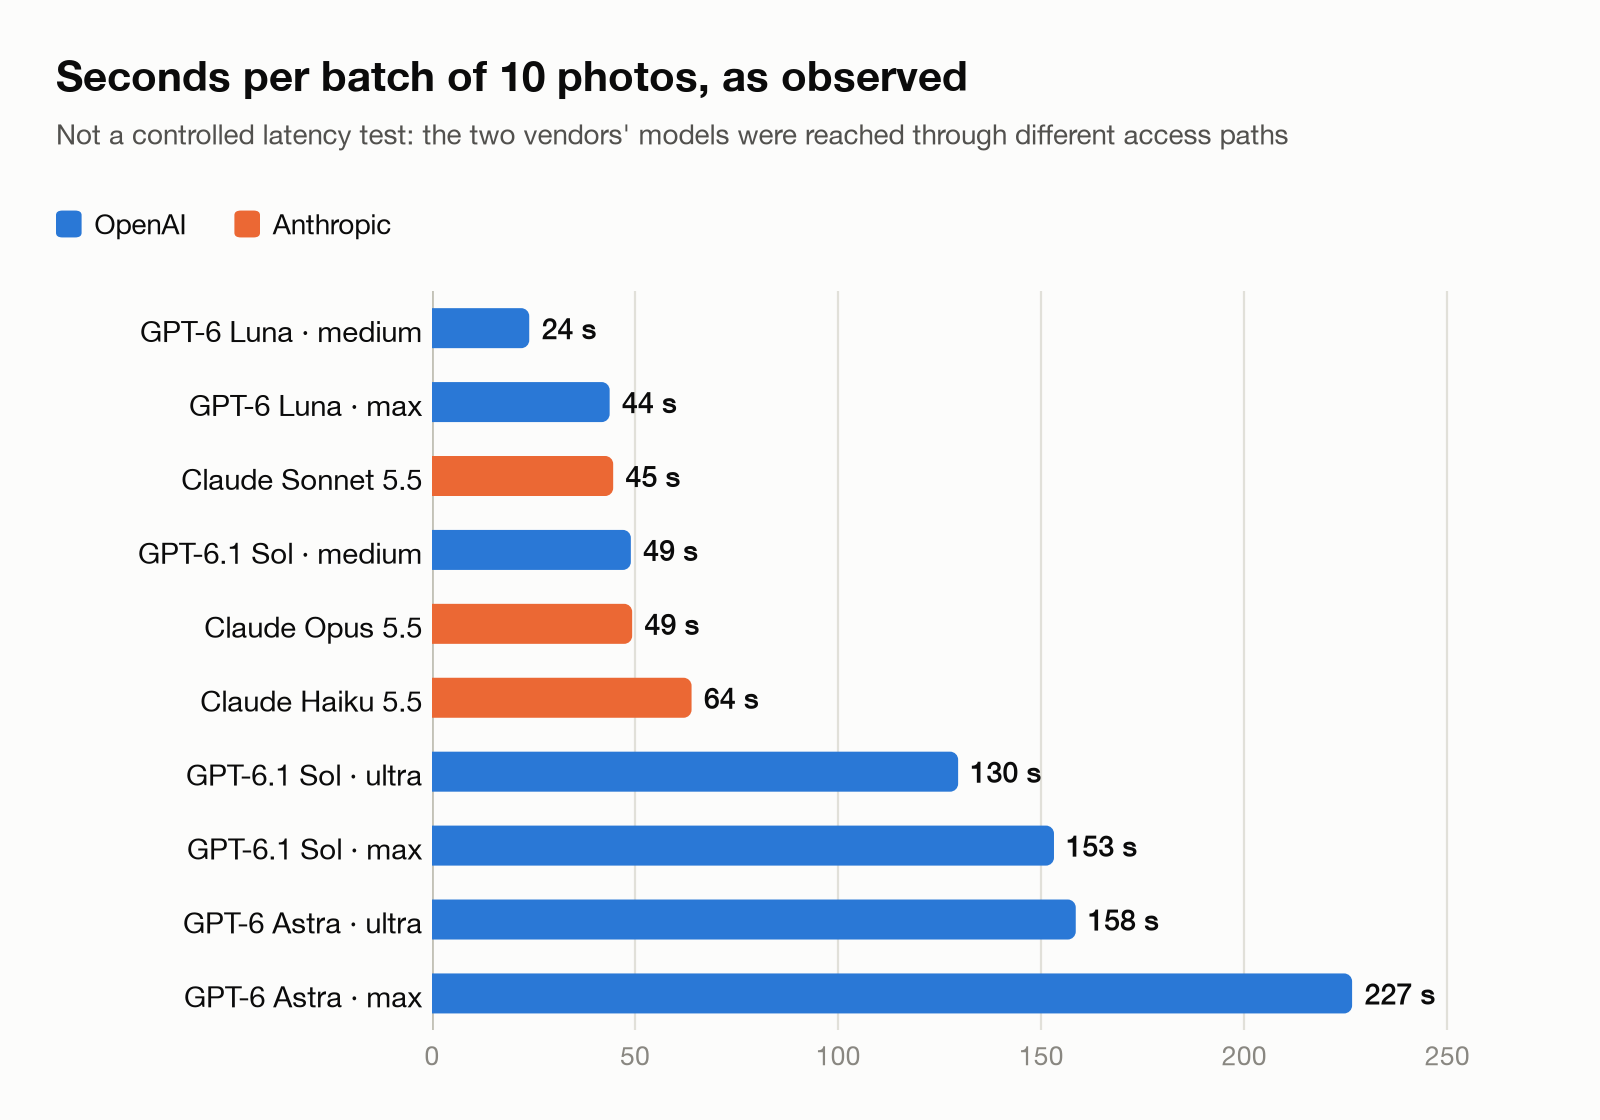 図8:観測された10枚1バッチあたりの秒数。これは統制された遅延テストではない。2社のモデルは異なるアクセス経路で呼び出したためだ。
これはOpusに対する日々の実感と一致する。Opusは速く、maxのSolより約3倍速い。ただし、mediumのSolはOpusと同じ速さで、スコアは約1点高かった。
コスト
すべての構成を各ベンダーの公式API価格で計算した。サブスクリプションプランに含まれる使用量を無料として扱うと、一部のモデルが実際よりも良く見えてしまう。
100万トークンあたりの公式価格、標準ティア:
| モデル | 入力 | 出力 |
|---|---|---|
| Claude Opus 5.5 | $4.00 | $20.00 |
| Claude Sonnet 5.5 | $2.00 | $10.00 |
| Claude Haiku 5.5 | $0.10 | $0.50 |
| GPT-6 Astra | $10.00 | $50.00 |
| GPT-6.1 Sol | $2.00 | $10.00 |
| GPT-6 Luna | $0.10 | $0.50 |
両社のBatch APIは50%安く、即時の回答を必要としないこの種の仕事に向いている。価格は2026年10月20日に、Anthropicの価格ページ(claude.com/pricing)とOpenAIのAPI価格ページ(developers.openai.com/api/docs/pricing)から取得した。
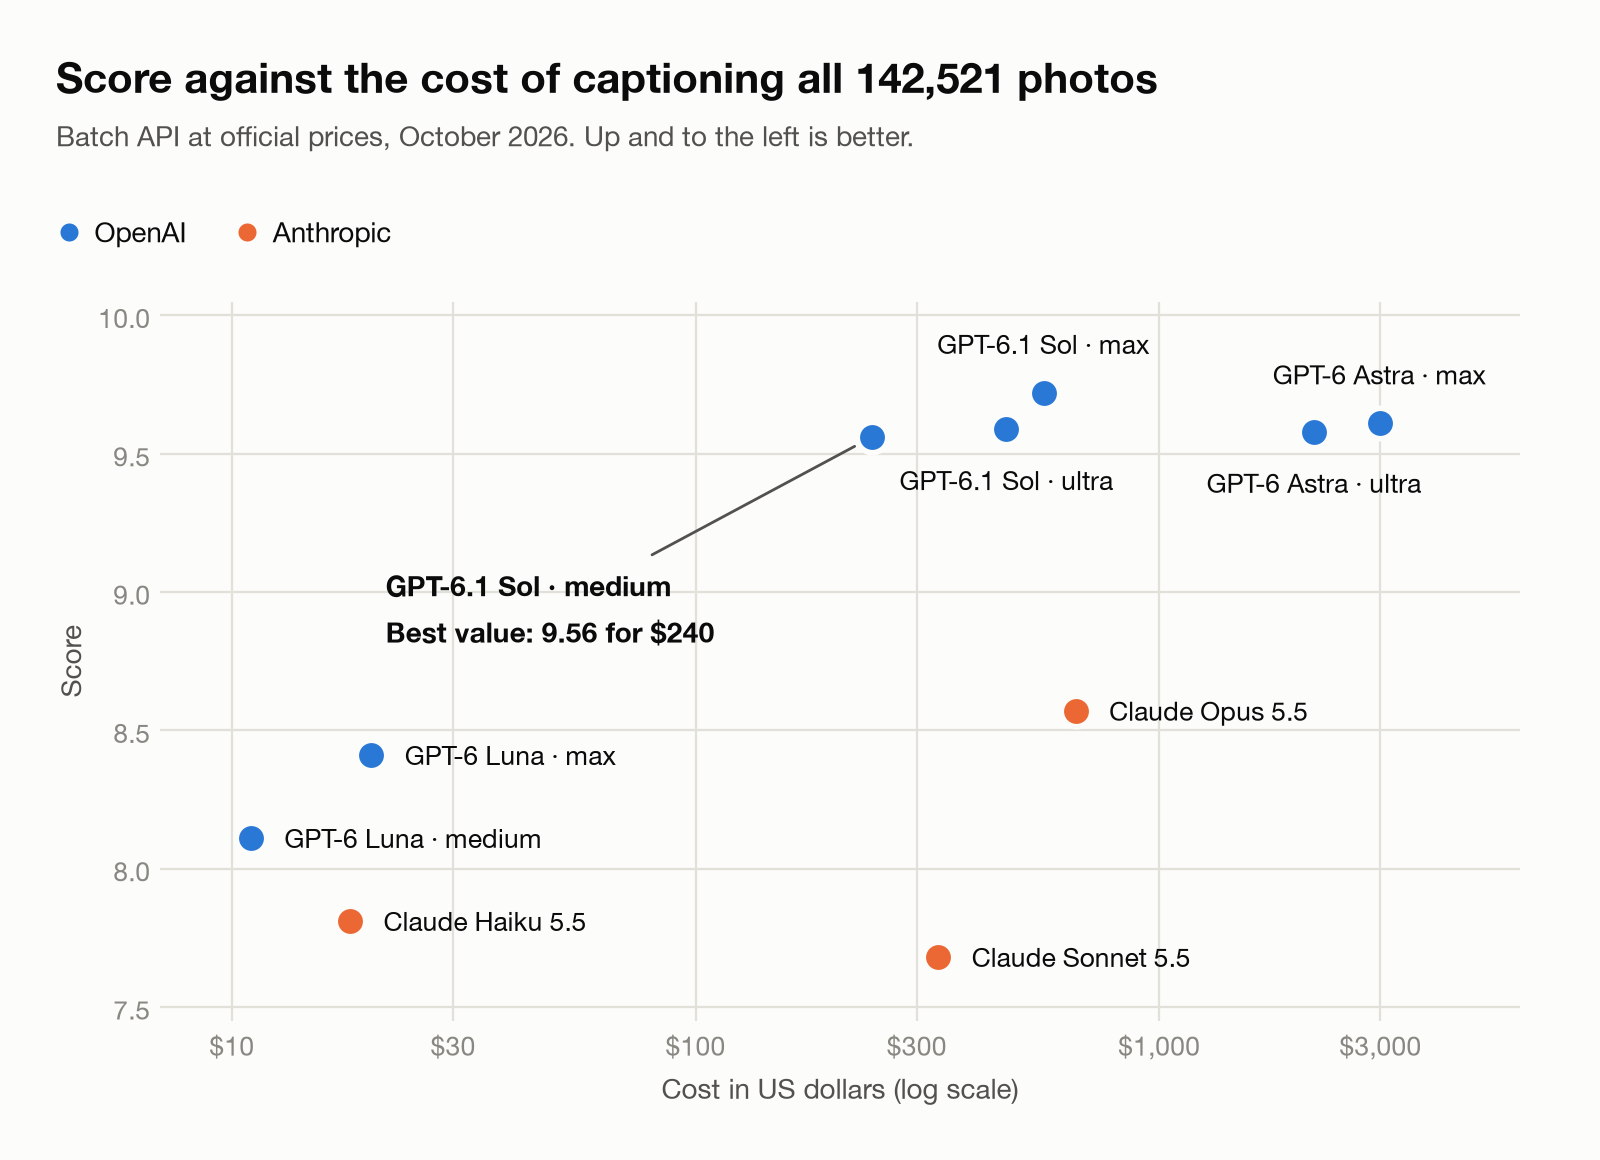 図9:Batch価格でライブラリ全体のキャプション付けにかかるコストに対するスコア。コスト軸は対数。
| モデルと推論強度 | 写真あたりの出力トークン | 標準 | Batch | スコア |
|---|---|---|---|---|
| GPT-6.1 Sol、medium | 193 | $479 | $240 | 9.56 |
| GPT-6.1 Sol、ultra | 514 | $937 | $468 | 9.59 |
| GPT-6.1 Sol、max | 647 | $1,126 | $563 | 9.72 |
| Claude Opus 5.5 | ~292 | $1,323 | $661 | 8.57 |
| Claude Sonnet 5.5 | ~297 | $668 | $334 | 7.68 |
| GPT-6 Astra、ultra | 462 | $4,313 | $2,156 | 9.58 |
| GPT-6 Astra、max | 695 | $5,973 | $2,987 | 9.61 |
| GPT-6 Luna、medium | 163 | $22 | $11 | 8.11 |
| Claude Haiku 5.5 | ~330 | $36 | $18 | 7.81 |
| GPT-6 Luna、max | 419 | $40 | $20 | 8.41 |
mediumのSolは最高スコアの98%を、Opusのコストの36%、maxのSolの43%で達成した。AstraはSolと同等の品質だが、トークン単価が5倍なのでコストは約5倍。OpusはmaxのSolよりコストがかかり、スコアは低かった。すでにmediumで実行していたが、トークン単価はSolの2倍だ。Lunaはライブラリ全体を11~20ドルでキャプション付けし、それでもHaikuとSonnetを上回る。
方法の注記:GPTのトークン数は実行から測定し、Claudeのトークン数は実行ログから推定した。Claudeの一部の推論トークンは見えなかったため、Claudeのコストはやや過小評価されている可能性がある。プロンプトキャッシュなど、Batch以外の割引はどのモデルにも適用していない。
学んだこと
ブラインドスコアを得る前にOpusを選んだが、それは主に、すでにコーディングのデフォルトだったからだ。コーディングとワークフローでは今もClaude Opus 5.5を好む。私の経験では、そちらが速く、強い。実写真の説明は別の技能を要する。ポーズや関係を補わずに、フレームに実際に写っているものを読み取ることだ。GPT-6.1 Solはそれをよりうまくやった。習慣に従ってブラインドテストを省いていたら、より多くのお金を払って、より悪いキャプションを得ていただろう。
次回はブラインドで始め、異なるベンダーの採点者に、キャプションのモデルが得た入力のすべてを与える。コスト比較も公式API価格で続ける。推論強度が高いほど良いとも仮定しない。今回はultraがmaxに勝てなかった。
最高のモデルでさえ、有用な写真を削除対象としてフラグすることがあった。だから、何かを削除する前に、すべての削除フラグを自分で確認する。
限界
これは小さなテストだ。1つの都市の最近の50枚の写真。古い写真、スキャンした文書、他の言語、動画はテストしていない。Claudeモデルはデフォルト設定でのみ実行した。より高い推論強度のOpusは、より高いコストでより良いスコアを出したかもしれない。採点者は人間ではなくAIモデルだ。良く一致したが完全ではなく、人間による抜き打ちチェックがあれば結果はより強固になる。モデルと価格は急速に変わり、ここにある数字はすべて2026年10月時点のものだ。
私の選択
自分のライブラリには:GPT-6.1 Solのmedium。コーディングとワークフローには、Claude Opus 5.5を使い続ける。