
ผมทดสอบโมเดล AI 10 ตัวแบบปกปิดกับคลังรูปภาพ 142,000 ภาพของตัวเอง: GPT-6.1 Sol ชนะ Claude Opus
บทคัดย่อ
ผมใช้ Claude Opus 5.5 ทุกวันสำหรับการเขียนโค้ดและเวิร์กโฟลว์ และสำหรับงานนั้นผมรู้สึกว่ามันเร็วกว่าและดีกว่า GPT-6 ผมคิดว่ามันคงจะอธิบายรูปภาพได้ดีที่สุดด้วย จึงทดสอบดู ผมรันการตั้งค่าสิบแบบ ได้แก่ Claude Haiku, Sonnet และ Opus 5.5 รวมถึง GPT-6.1 Sol, GPT-6 Astra และ GPT-6 Luna ของ OpenAI ที่ระดับความพยายามหลายระดับ แต่ละตัวตั้งชื่อ เขียนคำบรรยาย ใส่คีย์เวิร์ด และจัดเก็บรูปภาพจริง 50 ภาพจากคลัง 142,521 ภาพของผม และทำเครื่องหมายภาพที่คิดว่าผมควรลบ ผู้ให้คะแนนแบบปกปิดสองคนจากผู้ให้บริการต่างกัน คือ Claude Fable 5.1 และ GPT-6 Astra ให้คะแนนคำตอบทั้ง 500 ข้อในด้านข้อเท็จจริง รายละเอียดที่แต่งขึ้น การตัดสินใจลบ ความเหมาะสมของอัลบั้ม และความมีประโยชน์ GPT-6.1 Sol ได้คะแนนสูงสุดที่ 9.72 จาก 10 Opus ได้ 8.57 และ Sonnet กับ Haiku อยู่ที่ 7.7 ถึง 7.8 ระดับ ultra ไม่ดีกว่าระดับ max ในราคา Batch API อย่างเป็นทางการ การเขียนคำบรรยายทั้งคลังจะใช้เงินประมาณ $240 กับ Sol ที่ระดับ medium (9.56), $661 กับ Opus และ $11 ถึง $20 กับ Luna ซึ่งยังทำคะแนนได้สูงกว่า Haiku
ทำไมผมถึงทดสอบเรื่องนี้
เวลาส่วนใหญ่ในแต่ละวันของผมหมดไปกับการเขียนโค้ด เวิร์กโฟลว์ของเอเจนต์ และระบบอัตโนมัติ และ Claude Opus 5.5 คือโมเดลที่ผมใช้ สำหรับงานแบบนั้นผมรู้สึกว่ามันเร็วกว่าและดีกว่า GPT-6 ดังนั้นเมื่อตัดสินใจให้ AI เขียนคำบรรยายและติดแท็กคลังรูปภาพ ผมจึงเลือก Opus โดยไม่ลังเล
คลังนี้คือชีวิต 25 ปีของผม: รูปภาพ 142,521 ภาพ ตั้งแต่ภาพจากกล้องดิจิทัลยุคแรกจนถึงภาพมือถือเมื่อสัปดาห์ที่แล้ว รวมถึงภาพหน้าจอมากกว่า 16,000 ภาพ แทบไม่มีภาพไหนมีคำบรรยายเลย ผมอยากให้แต่ละภาพมีชื่อเรื่อง คำบรรยาย คีย์เวิร์ดที่ค้นหาได้ อัลบั้มที่สมเหตุสมผล และการทำเครื่องหมายอย่างตรงไปตรงมาเมื่อมันซ้ำหรือเป็นขยะ ก่อนจะจ่ายเงินประมวลผลภาพ 142,000 ภาพ ผมอยากรู้ว่าโมเดลไหนทำได้ดีที่สุด และความต่างนั้นมีต้นทุนเท่าไร
ผมคาดว่า Opus จะชนะ แต่กับภาพ 50 ภาพนี้ GPT-6.1 Sol ทำคะแนนสูงกว่ามากกว่าหนึ่งคะแนน
ผลลัพธ์โดยสรุป
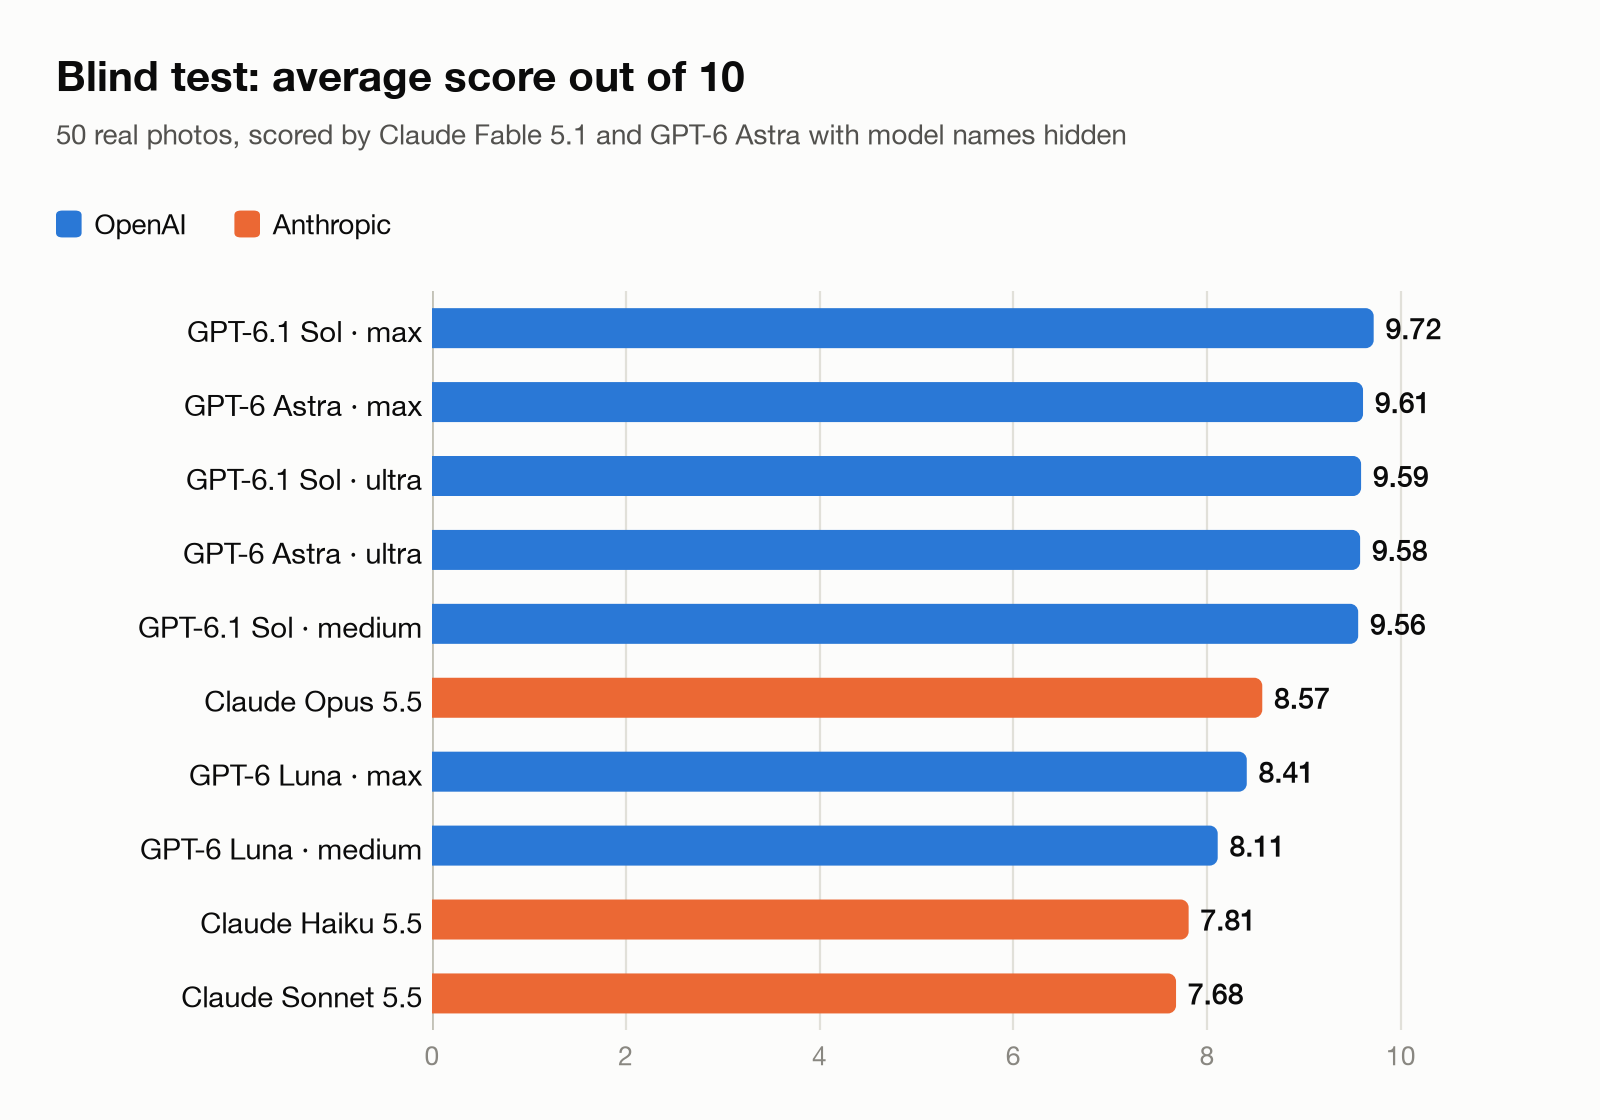 รูปที่ 1. คะแนนเฉลี่ยจากผู้ให้คะแนนแบบปกปิดสองคน เต็ม 10
| อันดับ | โมเดลและระดับความพยายาม | คะแนน (เต็ม 10) | ทั้งคลัง Batch API | ทั้งคลัง API มาตรฐาน |
|---|---|---|---|---|
| 1 | GPT-6.1 Sol, max | 9.72 | $563 | $1,126 |
| 2 | GPT-6 Astra, max | 9.61 | $2,987 | $5,973 |
| 3 | GPT-6.1 Sol, ultra | 9.59 | $468 | $937 |
| 4 | GPT-6 Astra, ultra | 9.58 | $2,156 | $4,313 |
| 5 | GPT-6.1 Sol, medium | 9.56 | $240 | $479 |
| 6 | Claude Opus 5.5 | 8.57 | $661 | $1,323 |
| 7 | GPT-6 Luna, max | 8.41 | $20 | $40 |
| 8 | GPT-6 Luna, medium | 8.11 | $11 | $22 |
| 9 | Claude Haiku 5.5 | 7.81 | $18 | $36 |
| 10 | Claude Sonnet 5.5 | 7.68 | $334 | $668 |
ต้นทุนคือการประมวลผลทั้ง 142,521 ภาพตามราคา API อย่างเป็นทางการของผู้ให้บริการแต่ละราย
สิ่งที่ผมจะใช้ จากผลทดสอบนี้:
- ถ้าสนใจแค่คะแนน ก็ GPT-6.1 Sol ที่ระดับ max
- สำหรับคลังของผมเอง GPT-6.1 Sol ที่ระดับ medium ได้ 98% ของคะแนนสูงสุดด้วยเงิน $240 ประมาณหนึ่งในสามของที่ Opus จะต้องจ่าย
- งบจำกัด ก็ GPT-6 Luna ที่ระดับ max ด้วยเงิน $20 มันชนะ Haiku ซึ่งมีราคาต่อโทเคนเท่ากัน และชนะ Sonnet ซึ่งการทำคลังนี้จะแพงกว่าประมาณ 17 เท่า
- ไม่ใช่ Claude Sonnet 5.5 ราคากลาง ๆ แต่ได้คะแนนต่ำสุด
โมเดลที่ทดสอบ
| ผู้ให้บริการ | โมเดล | ระดับความพยายามที่ทดสอบ | การวางตำแหน่ง |
|---|---|---|---|
| Anthropic | Claude Opus 5.5 | ค่าเริ่มต้น (medium) | ตัวหลักระดับเรือธงประจำวัน |
| Anthropic | Claude Sonnet 5.5 | ค่าเริ่มต้น | ระดับกลาง |
| Anthropic | Claude Haiku 5.5 | ค่าเริ่มต้น | เร็ว ต้นทุนต่ำ |
| OpenAI | GPT-6 Astra | max, ultra | โมเดลแนวหน้า |
| OpenAI | GPT-6.1 Sol | medium, max, ultra | ม้าใช้งาน |
| OpenAI | GPT-6 Luna | medium, max | เร็ว ต้นทุนต่ำ |
ราคาสอดคล้องกันระหว่างสองผู้ให้บริการ GPT-6.1 Sol มีราคาต่อโทเคนเท่ากับ Claude Sonnet 5.5, GPT-6 Astra เท่ากับ Claude Fable 5.1 และ GPT-6 Luna เท่ากับ Claude Haiku 5.5 ส่วน Claude Opus 5.5 อยู่ระหว่าง Sol กับ Astra ดังนั้นเมื่อสองโมเดลมีต้นทุนต่างกันด้านล่าง ส่วนใหญ่เป็นเพราะโมเดลหนึ่งใช้โทเคนมากกว่าสำหรับงานเดียวกัน
โมเดล Claude แต่ละตัวรันครั้งเดียวที่การตั้งค่าเริ่มต้น ซึ่งสำหรับ Opus หมายถึงระดับ medium ผมทดสอบโมเดล GPT หลายระดับความพยายาม การเปรียบเทียบแบบเท่าเทียมที่สุดคือ GPT-6.1 Sol ระดับ medium กับ Claude Opus 5.5 ระดับ medium: 9.56 ต่อ 8.57
วิธีการทดสอบ
ผมใช้ภาพล่าสุด 50 ภาพในคลังตอนนั้น โดยไม่รวมวิดีโอ มันคือหนึ่งสัปดาห์ธรรมดา ๆ ในม้วนฟิล์มกล้องของผม: ช่วงเวลาครอบครัวที่บ้านและตอนไปช้อปปิ้ง วิวเมืองจากชั้นสูง การ์ดหน่วยความจำบนโต๊ะ ภาพหน้าจอหน้าสินค้าของชิ้นส่วนอิเล็กทรอนิกส์ ภาพหน้าจอติดตามคำสั่งซื้อ โพสต์โซเชียลมีเดีย ป้าย QR ส่วนลดที่จอดรถ และป้ายเครื่องชาร์จ EV
แต่ละโมเดลมีงานห้าอย่างต่อภาพหนึ่งภาพ มันเขียนชื่อเรื่องสั้นและคำบรรยายภาษาจีนหนึ่งถึงสามประโยค ให้คีย์เวิร์ด 5 ถึง 12 คำทั้งภาษาจีนและอังกฤษ และเลือกอัลบั้มที่ดีที่สุดจากอัลบั้มเดิมของผม หรือไม่เลือกเลย จากนั้นให้คะแนนคุณภาพและบอกว่าจะเก็บหรือลบภาพ โดยมองหาภาพซ้ำ ภาพที่ถ่ายพลาด ภาพหน้าจอหมดอายุ และภาพที่ไม่มีคุณค่าถาวร ทุกโมเดลได้รับคำสั่งและบริบทเดียวกันสำหรับแต่ละภาพ ครั้งละสิบภาพ
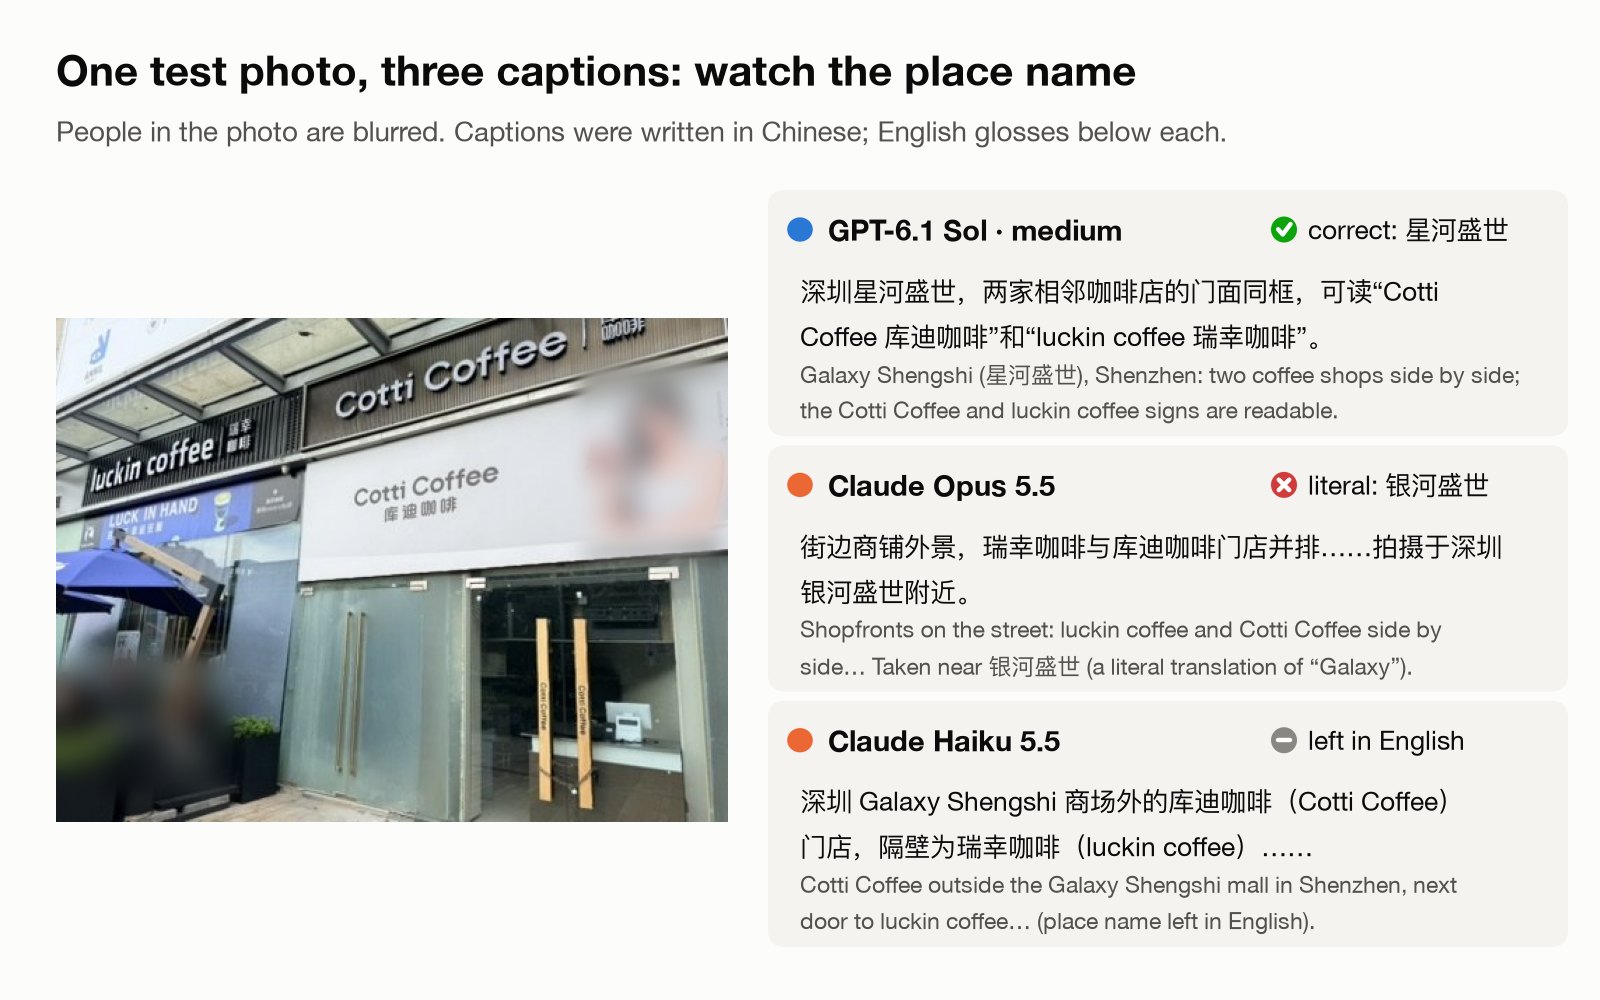 รูปที่ 2. หนึ่งในภาพทดสอบ 50 ภาพ พร้อมคำบรรยายสามชิ้น ดูว่าแต่ละโมเดลจัดการชื่อสถานที่อย่างไร ผมจะกลับมาที่จุดนี้ด้านล่าง คนในภาพถูกเบลอ
วิธีให้คะแนน
ผมไม่ได้ให้คะแนนคำตอบด้วยตัวเอง เพราะผมเลือกผู้ชนะไว้ก่อนการทดสอบแล้ว และใช้ Claude ทุกวัน จึงไม่เป็นกลาง
แต่ผมสลับคำตอบสิบข้อของแต่ละภาพแล้วติดป้าย A ถึง J ด้วยลำดับสุ่มใหม่ทุกภาพ จากนั้นผู้ให้คะแนนสองคนให้คะแนนคำตอบทั้ง 500 ข้ออย่างอิสระพร้อมกับดูรูปภาพ คนหนึ่งคือ Claude Fable 5.1 โมเดลที่เก่งที่สุดของ Anthropic อีกคนคือ GPT-6 Astra ที่ระดับความพยายาม xhigh โมเดลแนวหน้าของ OpenAI
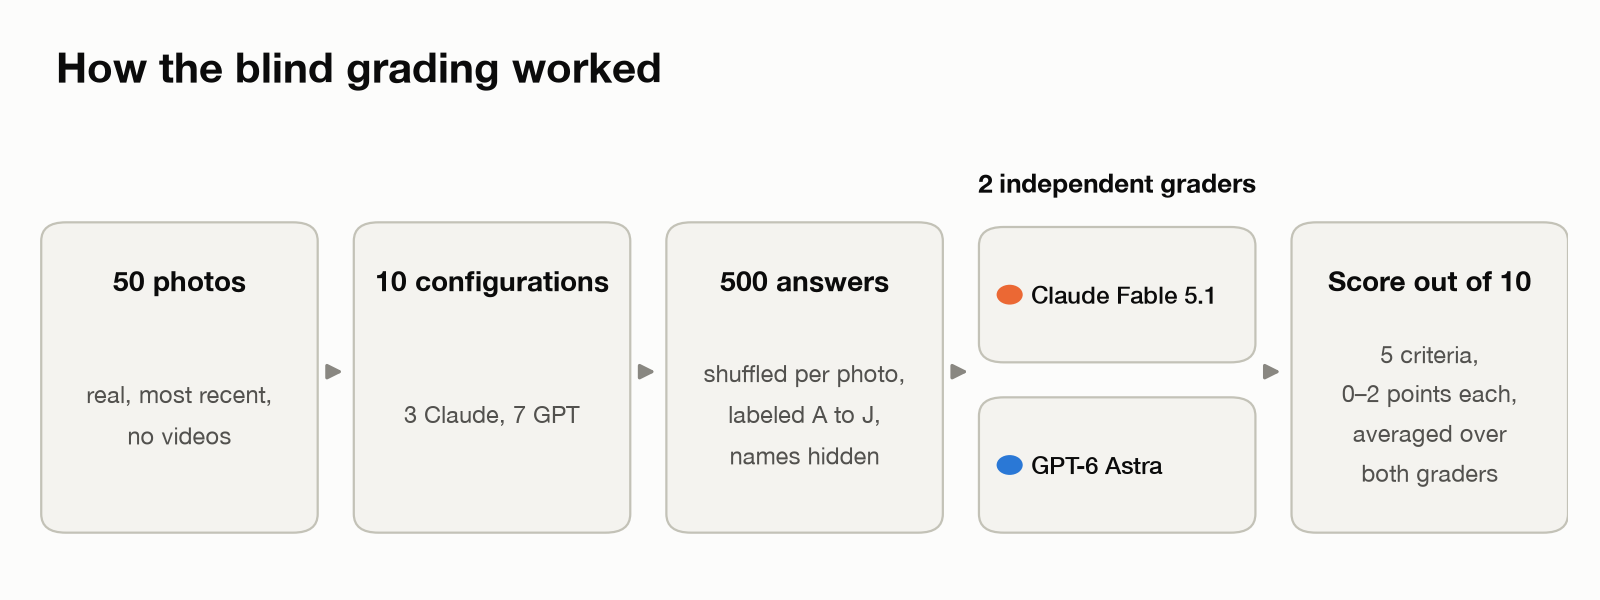 รูปที่ 3. การให้คะแนนแบบปกปิดทำงานอย่างไร
คำตอบแต่ละข้อถูกให้คะแนนตามเกณฑ์ห้าข้อ ข้อละ 0 ถึง 2 คะแนน รวม 10 คะแนน:
| เกณฑ์ | สิ่งที่ผู้ให้คะแนนตรวจสอบ |
|---|---|
| ข้อเท็จจริง | วัตถุ สถานที่ และข้อความที่อ่านได้ถูกต้องหรือไม่ รวมถึงชื่อสถานที่ท้องถิ่น |
| ไม่มีรายละเอียดที่แต่งขึ้น | คำตอบหลีกเลี่ยงการอ้างสิ่งที่ภาพไม่ได้แสดงหรือไม่ |
| การตัดสินใจลบ | การเก็บหรือลบสมเหตุสมผลหรือไม่ การลบภาพดีได้ 0 คะแนน |
| ความเหมาะสมของอัลบั้ม | อัลบั้มถูกต้องหรือไม่ อัลบั้มเก่าที่ผิดได้ 0 คะแนน ไม่มีอัลบั้มได้ 1 คะแนนที่ยอมรับได้ |
| ความมีประโยชน์ | ชื่อเรื่อง คำบรรยาย และคีย์เวิร์ดช่วยให้ผมหาภาพนี้เจอและจำมันได้ในภายหลังหรือไม่ |
ผมเลือกผู้ให้คะแนนจากแต่ละผู้ให้บริการคนละหนึ่งเพื่อดูว่าฝ่ายใดจะลำเอียงเข้าข้างโมเดลของตัวเองหรือไม่ ทั้งสองเห็นตรงกันเป็นส่วนใหญ่ ค่าสหสัมพันธ์ของคะแนนคู่ 500 คู่คือ 0.71 และทั้งคู่จัดอันดับการตั้งค่า GPT ห้าแบบเดียวกันไว้บนสุด ผู้ให้คะแนนฝั่ง Claude ยังจัด GPT-6.1 Sol และ GPT-6 Astra ไว้เหนือ Claude Opus ด้วย ผู้ให้คะแนนฝั่ง GPT เข้มงวดกว่าโดยรวม และเข้มงวดที่สุดกับโมเดล Claude
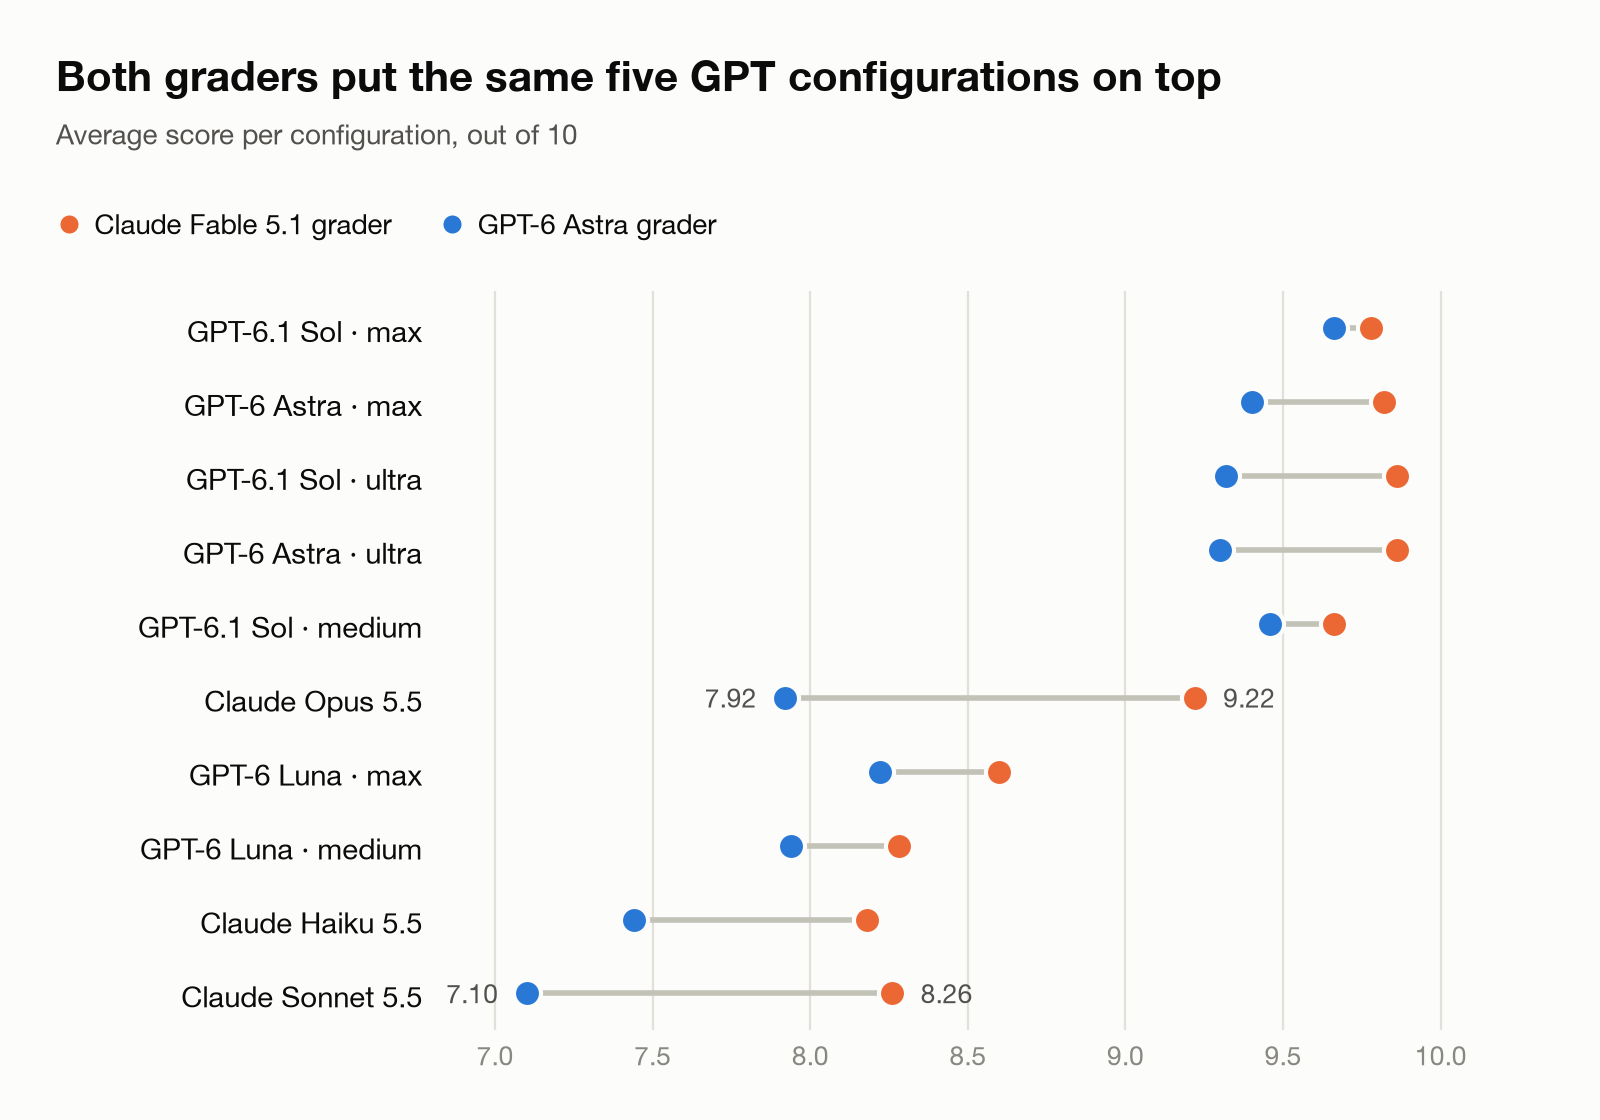 รูปที่ 4. คะแนนเฉลี่ยของผู้ให้คะแนนแต่ละคนต่อการตั้งค่าแต่ละแบบ
ผลลัพธ์
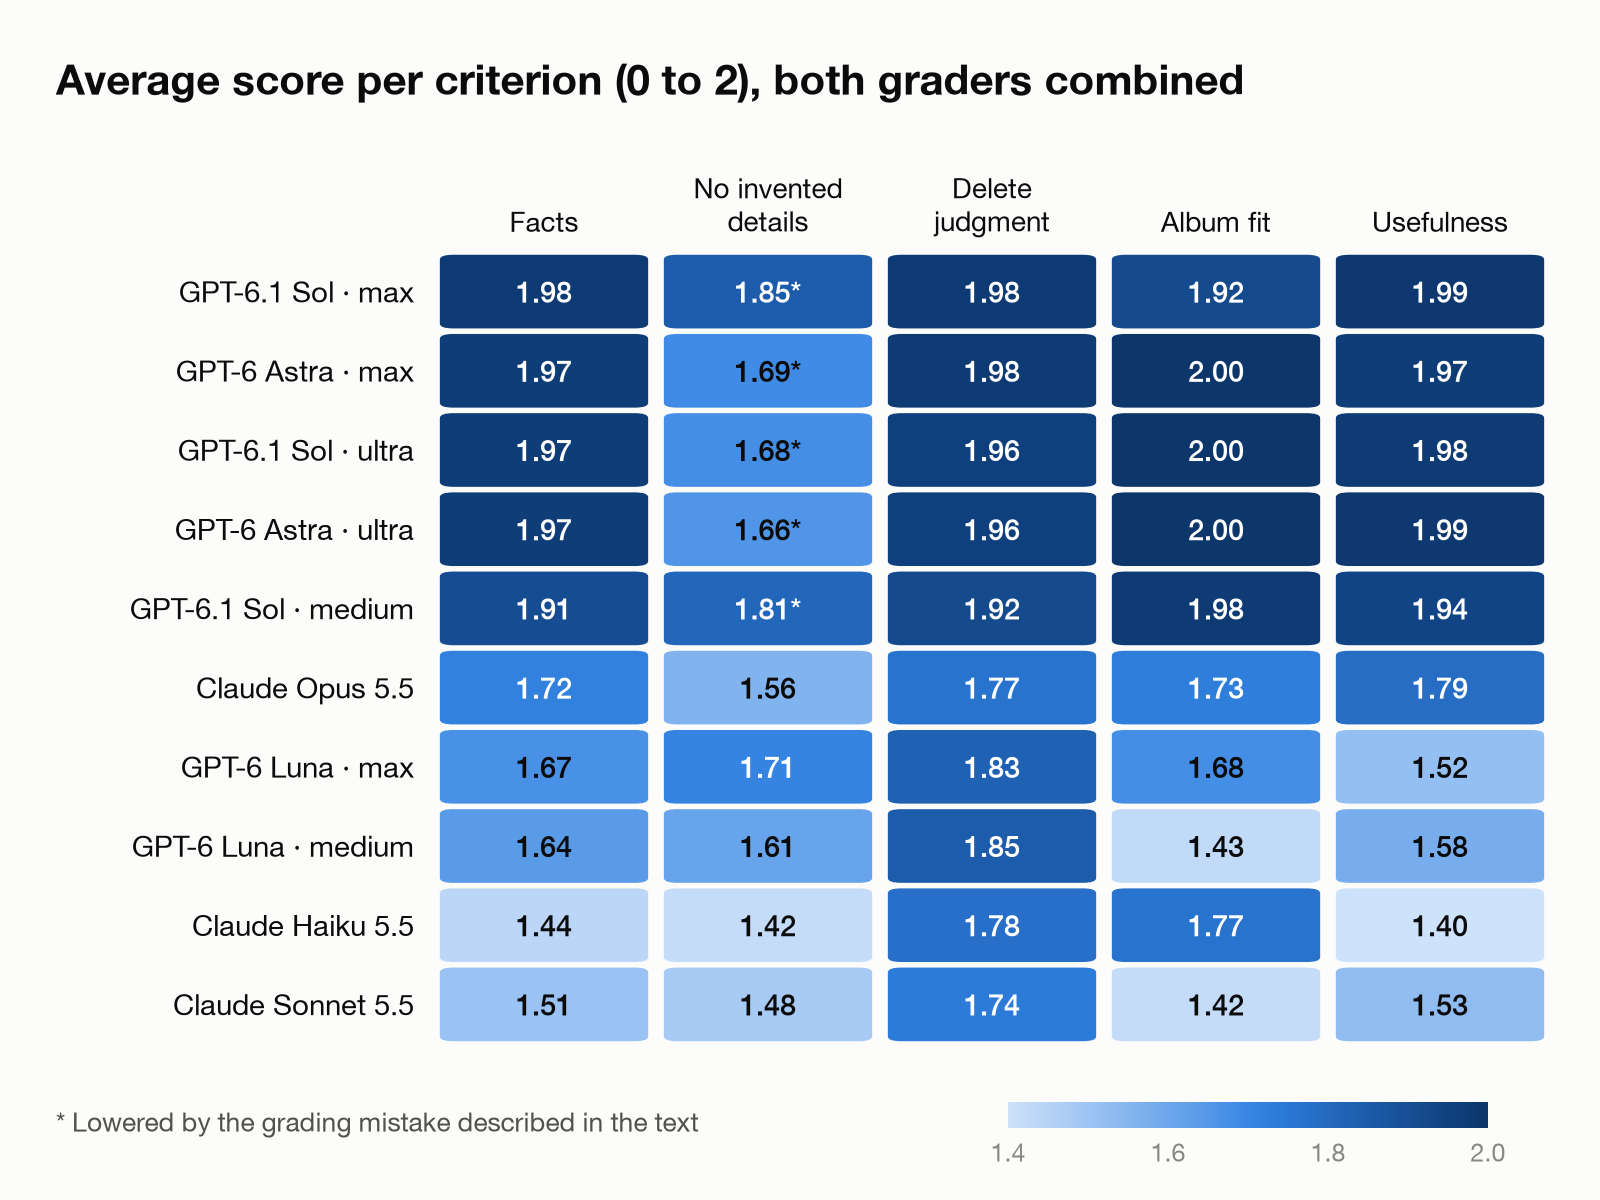 รูปที่ 5. คะแนนเฉลี่ยต่อเกณฑ์ รวมผู้ให้คะแนนสองคน เครื่องหมายดอกจันหมายถึงคะแนนที่ลดลงจากความผิดพลาดในการให้คะแนนที่ผมอธิบายด้านล่าง
GPT-6.1 Sol และ GPT-6 Astra
Sol และ Astra อ่านข้อความได้แม่นยำและจำกัดคำบรรยายให้อยู่ในสิ่งที่ภาพแสดงเป็นส่วนใหญ่ พวกมันยังเก่งที่สุดเรื่องชื่อสถานที่ท้องถิ่น ซึ่งสำคัญสำหรับภาพที่ถ่ายในจีน
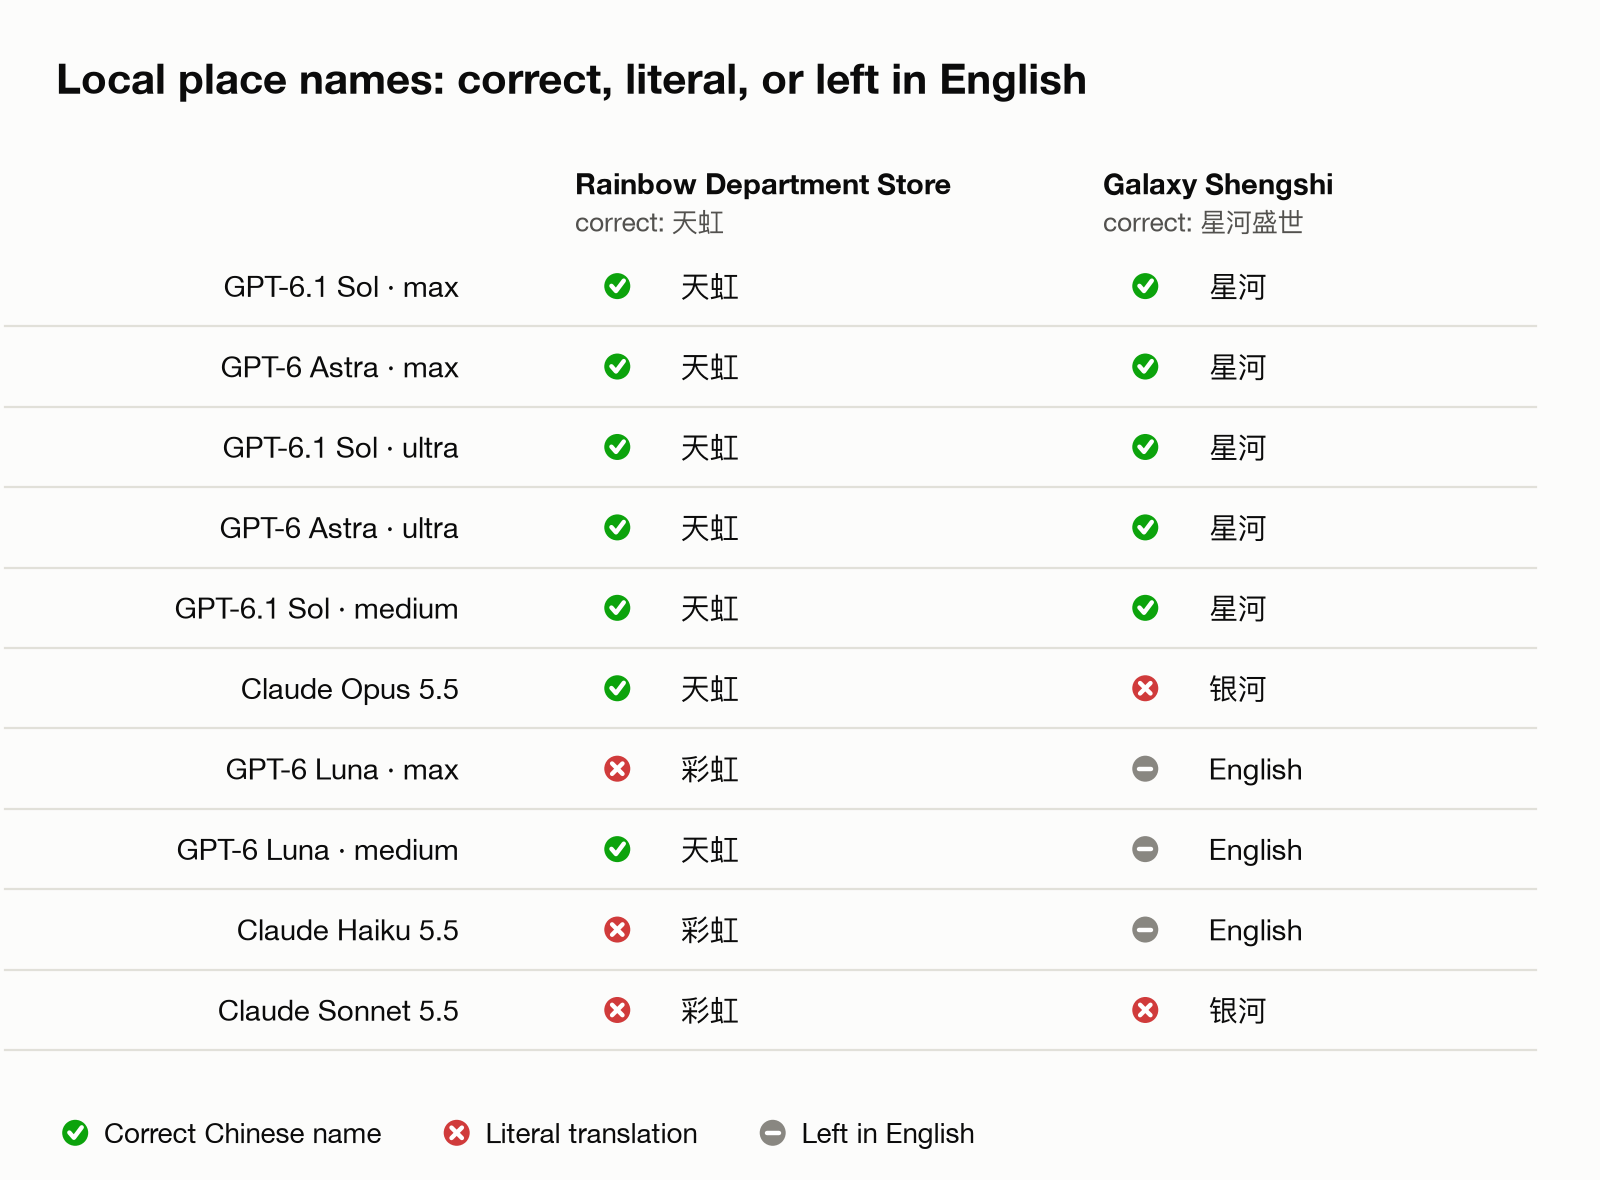 รูปที่ 6. การทดสอบชื่อท้องถิ่นสองข้อ เครื่องหมายถูกคือชื่อจีนที่ถูกต้อง กากบาทคือการแปลตรงตัว และ EN หมายถึงชื่อถูกเก็บเป็นภาษาอังกฤษ
หลายภาพถูกติดแท็กสถานที่ว่า "Rainbow Department Store" ซึ่งเป็นชื่อภาษาอังกฤษของห้างสรรพสินค้าเครือในเซินเจิ้น 天虹 การแปลคำต่อคำจะได้ 彩虹百貨 ซึ่งผิด การตั้งค่า Sol และ Astra ทุกแบบตอบถูก และ Opus กับ Luna ระดับ medium ก็ถูกเช่นกัน Haiku, Sonnet และ Luna ระดับ max ใช้การแปลตรงตัว ภาพร้านกาแฟในรูปที่ 2 ถูกติดแท็กว่า "Galaxy Shengshi" ซึ่งชื่อจีนคือ 星河盛世 การตั้งค่า Sol และ Astra ทุกแบบเขียน 星河 Opus และ Sonnet แปลตรงตัวเป็น 銀河 ส่วน Haiku และการตั้งค่า Luna ทั้งสองแบบเก็บเป็นภาษาอังกฤษ
Sol และ Astra ยังระมัดระวังเรื่องการลบด้วย พวกมันแนะนำให้ลบ 4 ถึง 6 ภาพจาก 50 ภาพ ชุดนี้มีภาพหน้าจอหน้าสินค้าของชิ้นส่วนอิเล็กทรอนิกส์แปดภาพ และโมเดล GPT เก็บไว้เกือบทั้งหมด มีการตั้งค่า Sol แบบเดียวที่ทำเครื่องหมายภาพหน้าจอหนึ่งภาพว่าเกือบซ้ำ โมเดล Claude ทำเครื่องหมายภาพละสองถึงสี่ภาพ ผู้ให้คะแนนทั้งสองเห็นด้วยกับการเก็บ เพราะหน้านั้นมีข้อมูลขา ตัวเลขขนาด และภาพบอร์ดที่ผมจะค้นดูภายหลัง
Claude Opus 5.5
บางครั้ง Opus เขียนสิ่งที่ไม่เห็นจากภาพเพียงอย่างเดียวลงในคำบรรยาย มันบรรยายความสัมพันธ์ที่ภาพเพียงอย่างเดียวพิสูจน์ไม่ได้ เช่น พี่น้องหรือพ่อแม่ลูก และยังเดาท่าทางผิดบ้าง ในภาพหนึ่งเด็กยืนอยู่หลังผู้ใหญ่ แต่ Opus เขียนว่าเด็กขี่หลังผู้ใหญ่ ผู้ให้คะแนนทั้งสองหักคะแนนในจุดนี้
นี่ทำให้ผมประหลาดใจ ก่อนการทดสอบแบบปกปิด ผมอ่านคำตอบและชม Opus ว่าทายถูกว่าเด็กสองคนเป็นพี่น้องกัน ผมรู้จักครอบครัวตัวเอง ผู้ให้คะแนนไม่รู้ แต่กับภาพ 142,000 ภาพ ผมตรวจคำบรรยายทุกอันเองไม่ได้ และคำบรรยายที่ระบุสิ่งที่ภาพไม่แสดงก็คือปัญหา
Opus ยังแนะนำให้ลบมากที่สุดคือ 13 ภาพจาก 50 ภาพ สามภาพในนั้นเป็นภาพหน้าจอหน้าสินค้าที่มันเรียกว่าหมดอายุ แม้จะมีข้อมูลอ้างอิงที่ผมอยากเก็บไว้ มันเป็นโมเดลเดียวที่อยากลบป้าย QR ส่วนลดที่จอดรถเพราะเห็นว่ามีค่าน้อย และยังนำภาพคนเดียวหลายภาพไปใส่ในอัลบั้ม "ภาพครอบครัว"
Claude Sonnet 5.5 และ Haiku 5.5
สองตัวนี้ทำข้อเท็จจริงผิดมากที่สุด รวมถึงการแปลตรงตัว 彩虹 Sonnet เลือกอัลบั้มอ่อนแอที่สุดและนำภาพชีวิตประจำวันไปใส่ในอัลบั้มเก่าจากเหตุการณ์ที่ไม่เกี่ยวข้อง Haiku แต่งรายละเอียดที่นำไปสู่การตัดสินลบที่ผิด ในชุดภาพถ่ายต่อเนื่องที่เกือบเหมือนกัน มันบรรยายเฟรมที่ดีที่สุดว่ามีคนก้มหน้า ซึ่งตรงข้ามกับที่ภาพแสดง และแนะนำให้ลบ
GPT-6 Luna
Luna มีราคาต่อโทเคนเท่ากับ Haiku แต่ทำคะแนนสูงกว่าในทั้งสองระดับความพยายาม: 8.41 และ 8.11 เทียบกับ 7.81 ของ Haiku ที่ระดับ max มันยังชนะ Sonnet ซึ่งการเขียนคำบรรยายคลังเดียวกันจะแพงกว่าประมาณ 17 เท่า Luna เสียคะแนนส่วนใหญ่ในด้านความมีประโยชน์และการเลือกอัลบั้ม คำบรรยายของมันเรียบกว่าและอัลบั้มแม่นยำน้อยกว่า
ระดับความพยายาม
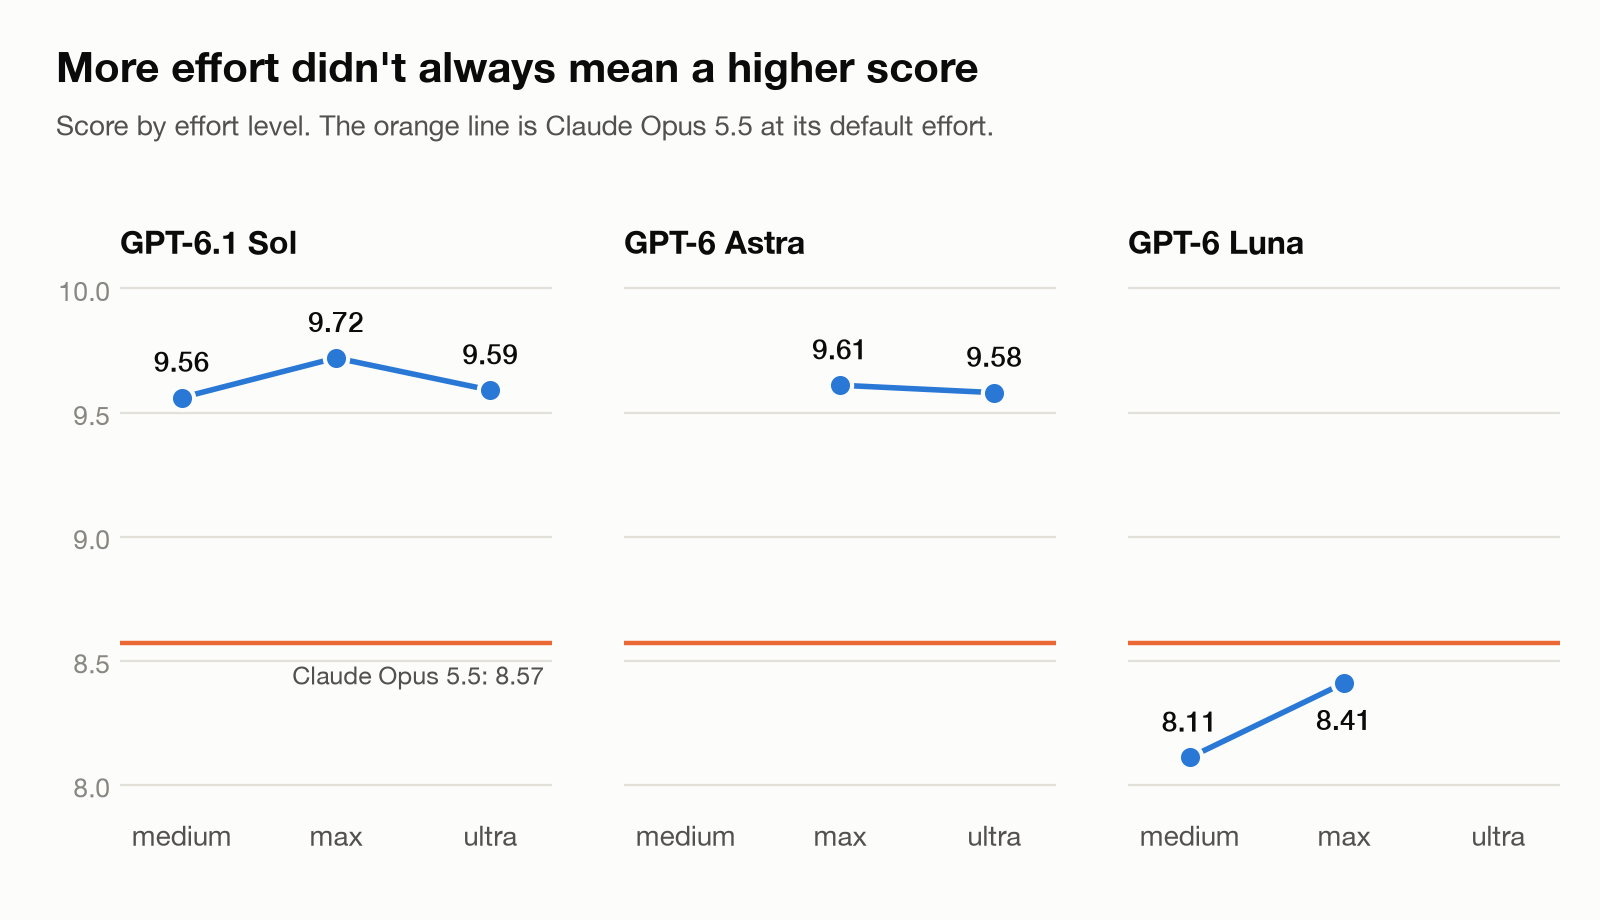 รูปที่ 7. คะแนนตามระดับความพยายาม เส้นสีส้มคือ Claude Opus 5.5 ที่ระดับความพยายามเริ่มต้น
ultra ไม่ดีกว่า max ในทั้งสองโมเดล Sol ได้ 9.59 ที่ ultra และ 9.72 ที่ max Astra ได้ 9.58 และ 9.61 ในการทดสอบนี้ ultra ยังสร้างโทเคนเอาต์พุตน้อยกว่า max ด้วยซ้ำ สำหรับ Sol ระดับ medium ใกล้เคียงที่ 9.56 ด้วยต้นทุนน้อยกว่าครึ่งของ max ความพยายามสูงขึ้นไม่ได้หมายความว่ารายละเอียดแม่นยำกว่าเสมอไป: Luna ระดับ medium เขียน 天虹 ถูก แต่ Luna ระดับ max ผิด
ความผิดพลาดในการให้คะแนนของผม
หลังให้คะแนน ผมสังเกตว่าผู้ให้คะแนนไม่ได้รับวันและเวลาที่ถ่ายภาพแต่ละภาพ แม้ว่าโมเดลที่เขียนคำบรรยายจะได้รับ ดังนั้นผู้ให้คะแนน GPT-6 Astra จึงถือว่าคำบรรยายที่กล่าวถึงวันหรือเวลาที่แน่นอนเป็นรายละเอียดที่แต่งขึ้น การตั้งค่า GPT อันดับต้น ๆ กล่าวถึงวันบ่อยที่สุด คะแนน "ไม่มีรายละเอียดที่แต่งขึ้น" ของมันจึงออกมาต่ำกว่าที่ควร
ถ้าผมคืนเฉพาะคะแนนที่เสียไปจากวันที่ การตั้งค่า GPT สี่อันดับแรกจะขึ้นไปอยู่ที่ 9.84 ถึง 9.90 ซึ่งเท่ากันโดยพฤตินัย และ Opus ยังอยู่ที่ 8.58 ผมเก็บคะแนนเดิมไว้ในโพสต์นี้ ครั้งหน้าผมจะให้ผู้ให้คะแนนเห็นทุกอย่างที่โมเดลเห็น
ความเร็ว
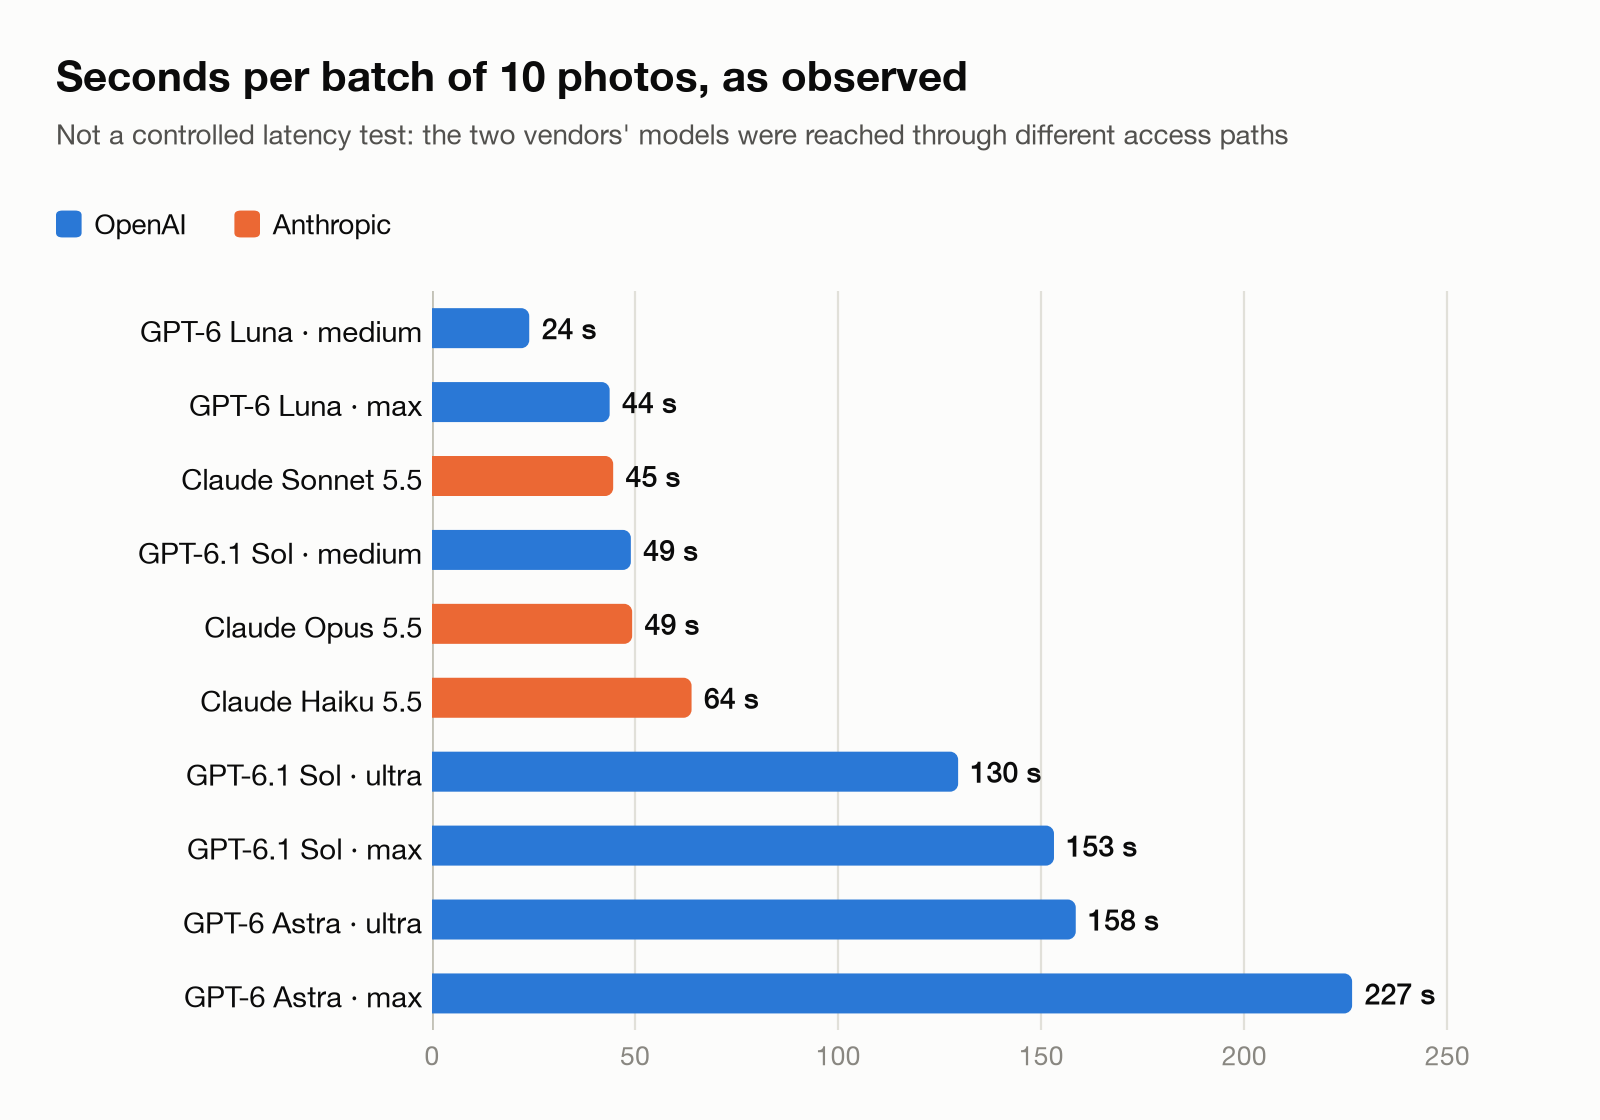 รูปที่ 8. วินาทีต่อชุดภาพ 10 ภาพตามที่สังเกต นี่ไม่ใช่การทดสอบความหน่วงแบบควบคุม เพราะโมเดลของผู้ให้บริการสองรายถูกเรียกผ่านเส้นทางการเข้าถึงที่ต่างกัน
นี่ตรงกับความรู้สึกต่อ Opus ในงานประจำวันของผม: มันเร็ว เร็วกว่า Sol ระดับ max ประมาณสามเท่า แต่ Sol ระดับ medium เร็วพอ ๆ กับ Opus และทำคะแนนสูงกว่าประมาณหนึ่งคะแนน
ต้นทุน
ผมคิดราคาการตั้งค่าทุกแบบตามราคา API อย่างเป็นทางการของผู้ให้บริการ การถือว่าการใช้งานที่รวมอยู่ในแพ็กเกจสมัครสมาชิกเป็นของฟรีจะทำให้บางโมเดลดูดีกว่าความเป็นจริง
ราคาอย่างเป็นทางการต่อล้านโทเคน ระดับมาตรฐาน:
| โมเดล | อินพุต | เอาต์พุต |
|---|---|---|
| Claude Opus 5.5 | $4.00 | $20.00 |
| Claude Sonnet 5.5 | $2.00 | $10.00 |
| Claude Haiku 5.5 | $0.10 | $0.50 |
| GPT-6 Astra | $10.00 | $50.00 |
| GPT-6.1 Sol | $2.00 | $10.00 |
| GPT-6 Luna | $0.10 | $0.50 |
Batch API ของทั้งสองผู้ให้บริการถูกลง 50% ซึ่งเหมาะกับงานแบบนี้ที่ไม่ต้องได้คำตอบทันที ผมนำราคามาจากหน้าราคาของ Anthropic (claude.com/pricing) และหน้าราคา API ของ OpenAI (developers.openai.com/api/docs/pricing) เมื่อวันที่ 20 ตุลาคม 2026
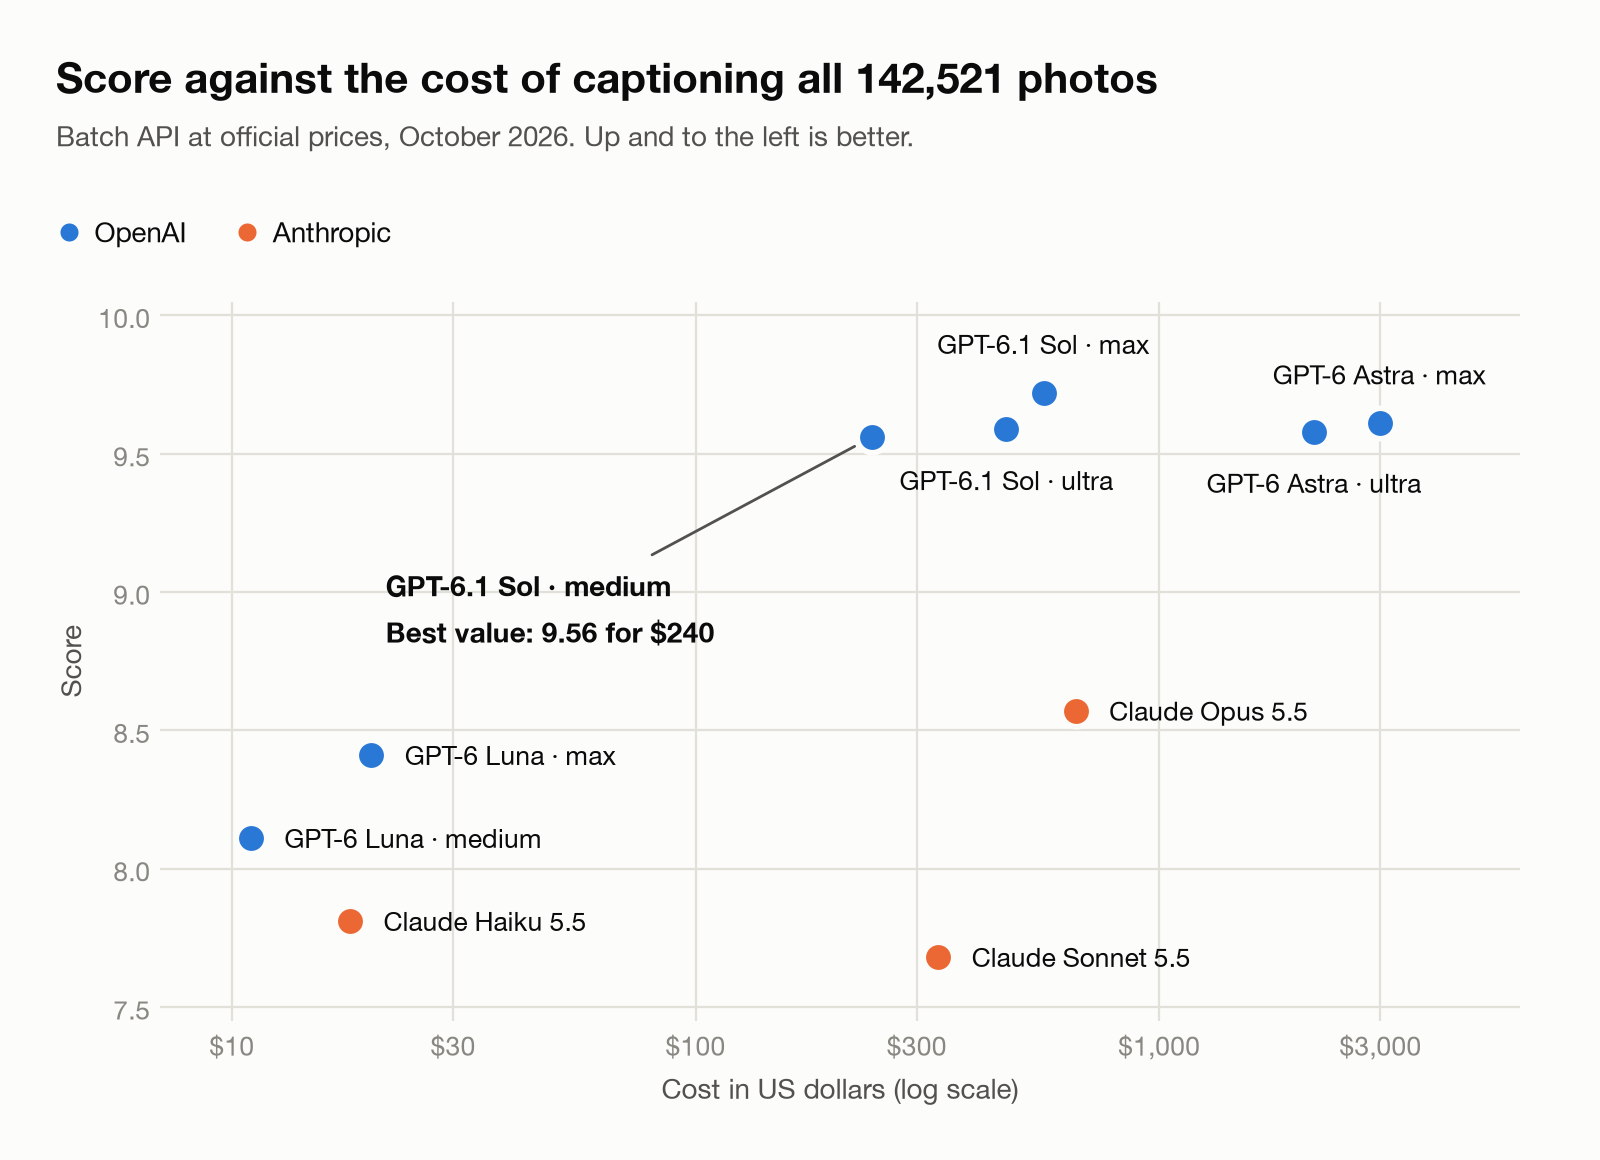 รูปที่ 9. คะแนนเทียบกับต้นทุนการเขียนคำบรรยายทั้งคลังในราคา Batch แกนต้นทุนเป็นลอการิทึม
| โมเดลและระดับความพยายาม | โทเคนเอาต์พุตต่อภาพ | มาตรฐาน | Batch | คะแนน |
|---|---|---|---|---|
| GPT-6.1 Sol, medium | 193 | $479 | $240 | 9.56 |
| GPT-6.1 Sol, ultra | 514 | $937 | $468 | 9.59 |
| GPT-6.1 Sol, max | 647 | $1,126 | $563 | 9.72 |
| Claude Opus 5.5 | ~292 | $1,323 | $661 | 8.57 |
| Claude Sonnet 5.5 | ~297 | $668 | $334 | 7.68 |
| GPT-6 Astra, ultra | 462 | $4,313 | $2,156 | 9.58 |
| GPT-6 Astra, max | 695 | $5,973 | $2,987 | 9.61 |
| GPT-6 Luna, medium | 163 | $22 | $11 | 8.11 |
| Claude Haiku 5.5 | ~330 | $36 | $18 | 7.81 |
| GPT-6 Luna, max | 419 | $40 | $20 | 8.41 |
Sol ระดับ medium ได้ 98% ของคะแนนสูงสุดด้วยเงิน 36% ของที่ Opus จะต้องจ่าย และ 43% ของ Sol ระดับ max Astra มีคุณภาพเท่า Sol แต่แพงกว่าประมาณห้าเท่า เพราะราคาต่อโทเคนของมันสูงกว่าห้าเท่า Opus แพงกว่า Sol ระดับ max และได้คะแนนต่ำกว่า มันรันที่ระดับ medium อยู่แล้ว แต่ราคาต่อโทเคนเป็นสองเท่าของ Sol Luna จะเขียนคำบรรยายทั้งคลังด้วยเงิน $11 ถึง $20 และยังทำคะแนนสูงกว่า Haiku และ Sonnet
หมายเหตุวิธี: จำนวนโทเคนของ GPT วัดจากการรันจริง และจำนวนโทเคนของ Claude ประมาณจากบันทึกการรัน โทเคนการให้เหตุผลบางส่วนของ Claude มองไม่เห็น ต้นทุนของ Claude จึงอาจถูกประเมินต่ำไปเล็กน้อย ไม่มีการใช้ส่วนลดอื่นนอกเหนือจาก Batch เช่น การแคชพรอมต์ กับโมเดลใด
สิ่งที่ผมได้เรียนรู้
ผมเลือก Opus ก่อนจะได้คะแนนแบบปกปิด ส่วนใหญ่เพราะมันเป็นค่าเริ่มต้นสำหรับการเขียนโค้ดของผมอยู่แล้ว ผมยังชอบ Claude Opus 5.5 สำหรับการเขียนโค้ดและเวิร์กโฟลว์ ซึ่งในประสบการณ์ผมมันเร็วกว่าและแข็งแกร่งกว่า แต่การอธิบายภาพจริงต้องใช้ทักษะอีกแบบ: การอ่านสิ่งที่อยู่ในเฟรมจริง ๆ โดยไม่เติมท่าทางหรือความสัมพันธ์ GPT-6.1 Sol ทำได้ดีกว่า ถ้าผมทำตามความเคยชินและข้ามการทดสอบแบบปกปิด ผมคงจ่ายแพงกว่าเพื่อคำบรรยายที่แย่กว่า
ครั้งหน้าผมจะเริ่มแบบปกปิด และให้ผู้ให้คะแนนจากผู้ให้บริการต่างกันเห็นอินพุตทั้งหมดที่โมเดลเขียนคำบรรยายได้รับ ผมจะเปรียบเทียบที่ราคา API อย่างเป็นทางการต่อไป และจะไม่ทึกทักว่าความพยายามสูงขึ้นดีกว่า: ครั้งนี้ ultra ไม่ชนะ max
แม้แต่โมเดลที่ดีที่สุดยังทำเครื่องหมายภาพที่มีประโยชน์ว่าควรลบ ดังนั้นผมจะตรวจทุกคำสั่งลบด้วยตัวเองก่อนลบอะไร
ข้อจำกัด
นี่เป็นการทดสอบเล็ก ๆ: ภาพล่าสุด 50 ภาพจากเมืองเดียว ผมไม่ได้ทดสอบภาพเก่า เอกสารสแกน ภาษาอื่น หรือวิดีโอ โมเดล Claude รันที่การตั้งค่าเริ่มต้นเท่านั้น Opus ที่ความพยายามสูงขึ้นอาจได้คะแนนดีขึ้น ด้วยต้นทุนที่สูงขึ้น ผู้ให้คะแนนคือโมเดล AI ไม่ใช่คน พวกมันเห็นตรงกันดีแต่ไม่สมบูรณ์ และการสุ่มตรวจโดยมนุษย์จะทำให้ผลแข็งแรงขึ้น โมเดลและราคาเปลี่ยนเร็ว และทุกตัวเลขที่นี่เป็นของเดือนตุลาคม 2026
ตัวเลือกของผม
สำหรับคลังของผม: GPT-6.1 Sol ที่ระดับ medium สำหรับการเขียนโค้ดและเวิร์กโฟลว์ ผมจะใช้ Claude Opus 5.5 ต่อไป