
בדקתי בעיוורון 10 מודלי בינה מלאכותית על ספריית 142,000 התמונות שלי: GPT-6.1 Sol ניצח את Claude Opus
תקציר
אני משתמש ב-Claude Opus 5.5 מדי יום לקידוד ולתהליכי עבודה, ובעבודה הזו אני מוצא אותו מהיר וטוב יותר מ-GPT-6. הנחתי שהוא יהיה גם הטוב ביותר בתיאור תמונות, אז בדקתי אותו. הרצתי עשר תצורות: Claude Haiku, Sonnet ו-Opus 5.5, ועוד GPT-6.1 Sol, GPT-6 Astra ו-GPT-6 Luna של OpenAI ברמות מאמץ שונות. כל אחת כתבה כותרת, תיאור, מילות מפתח ותייקה 50 תמונות אמיתיות מהספרייה שלי בת 142,521 התמונות, וסימנה את התמונות שלדעתה עליי למחוק. שני מעריכים עיוורים מספקים שונים, Claude Fable 5.1 ו-GPT-6 Astra, נתנו ציון לכל 500 התשובות על עובדות, פרטים מומצאים, שיקול מחיקה, התאמת אלבום ותועלת. GPT-6.1 Sol קיבל את הציון הגבוה ביותר: 9.72 מתוך 10. Opus קיבל 8.57, ו-Sonnet ו-Haiku הגיעו ל-7.7 עד 7.8. מאמץ ultra לא היה טוב מ-max. במחירי Batch API הרשמיים, כתיבת תיאורים לכל הספרייה תעלה כ-240 דולר עם Sol במאמץ medium (9.56), 661 דולר עם Opus, ו-11 עד 20 דולר עם Luna, שעדיין עקף את Haiku.
למה בדקתי את זה
רוב היום שלי הולך לקידוד, תהליכי עבודה של סוכנים ואוטומציה, ו-Claude Opus 5.5 הוא המודל שאליו אני פונה. בעבודה מהסוג הזה הוא הרגיש לי מהיר וטוב יותר מ-GPT-6. לכן כשהחלטתי לתת לבינה מלאכותית לכתוב תיאורים ותגיות לספריית התמונות שלי, בחרתי ב-Opus בלי לחשוב פעמיים.
הספרייה היא 25 שנה מחיי: 142,521 תמונות, מצילומי מצלמה דיגיטלית מוקדמים ועד תמונות הטלפון מהשבוע שעבר, ועוד יותר מ-16,000 צילומי מסך. כמעט לאף אחת מהן אין תיאור. אני רוצה שלכל תמונה יהיו כותרת, תיאור, מילות מפתח שאני יכול לחפש, אלבום הגיוני, וסימון כן כשהיא כפולה או זבל. לפני שאשלם על עיבוד 142,000 תמונות, רציתי לדעת איזה מודל עושה את זה הכי טוב וכמה עולה ההבדל.
ציפיתי ש-Opus ינצח. ב-50 התמונות האלה, GPT-6.1 Sol קיבל יותר מנקודה מעל.
התוצאות במבט אחד
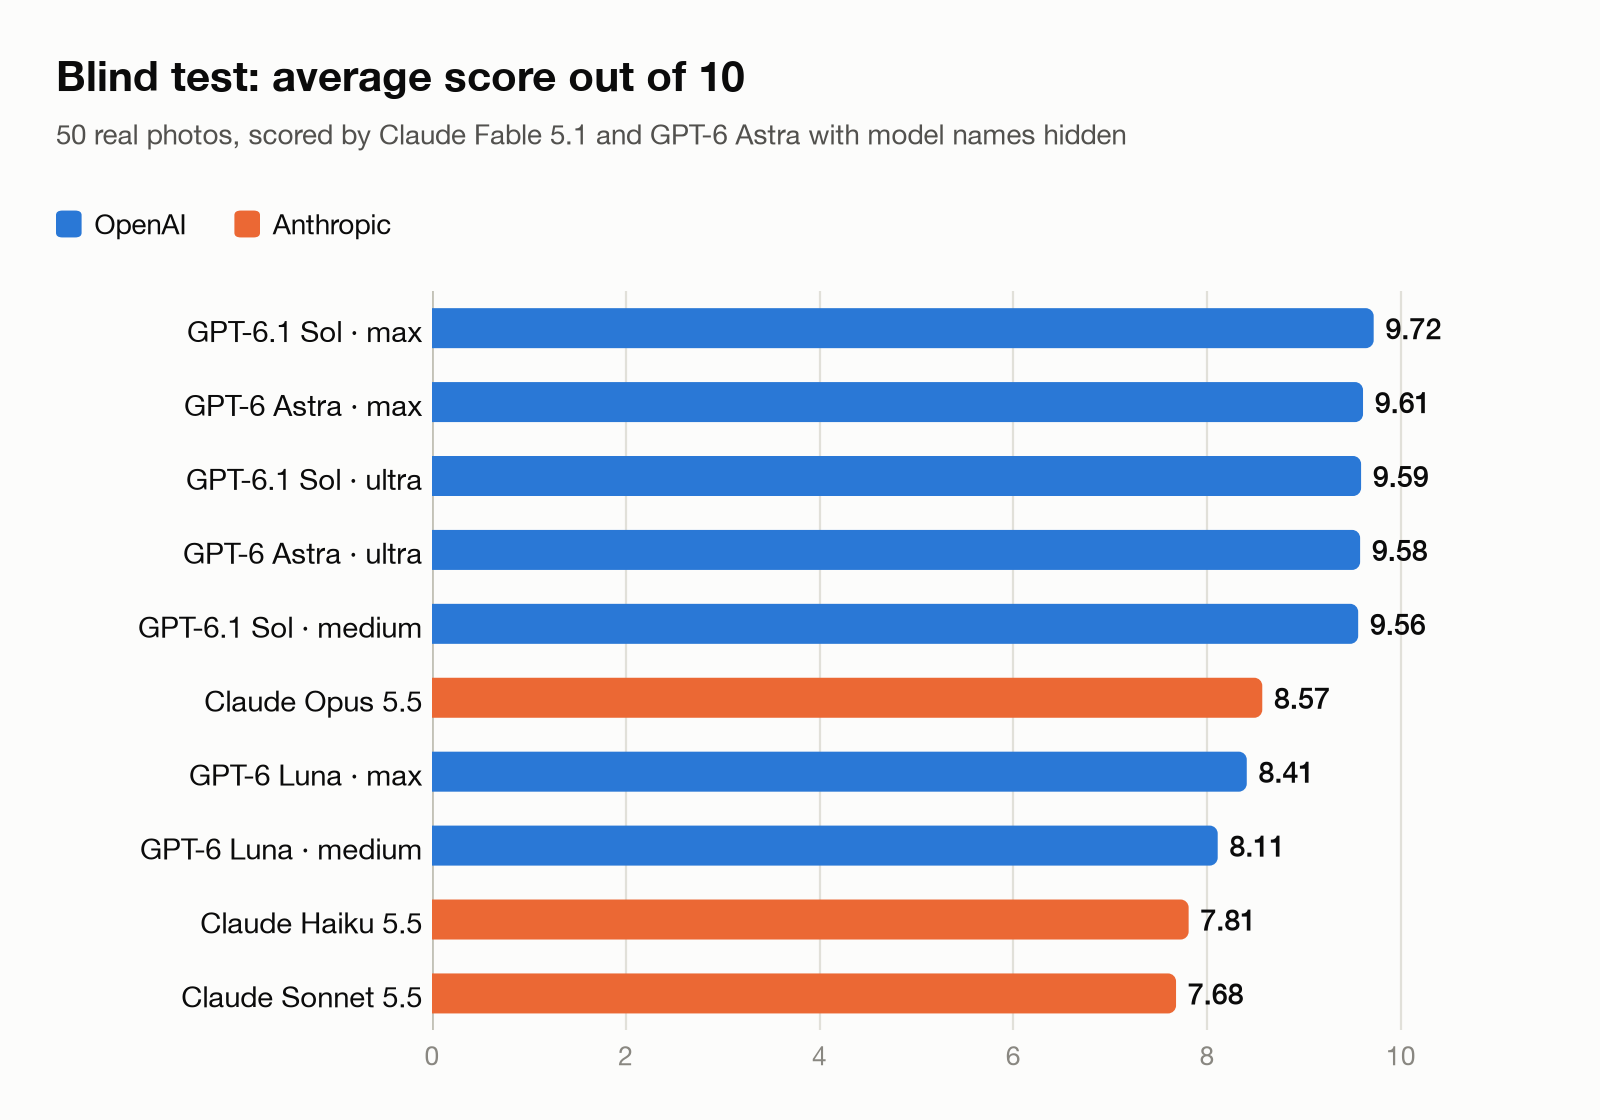 איור 1. ציון ממוצע משני מעריכים עיוורים, מתוך 10.
| דירוג | מודל ומאמץ | ציון (מתוך 10) | ספרייה מלאה, Batch API | ספרייה מלאה, API רגיל |
|---|---|---|---|---|
| 1 | GPT-6.1 Sol, max | 9.72 | $563 | $1,126 |
| 2 | GPT-6 Astra, max | 9.61 | $2,987 | $5,973 |
| 3 | GPT-6.1 Sol, ultra | 9.59 | $468 | $937 |
| 4 | GPT-6 Astra, ultra | 9.58 | $2,156 | $4,313 |
| 5 | GPT-6.1 Sol, medium | 9.56 | $240 | $479 |
| 6 | Claude Opus 5.5 | 8.57 | $661 | $1,323 |
| 7 | GPT-6 Luna, max | 8.41 | $20 | $40 |
| 8 | GPT-6 Luna, medium | 8.11 | $11 | $22 |
| 9 | Claude Haiku 5.5 | 7.81 | $18 | $36 |
| 10 | Claude Sonnet 5.5 | 7.68 | $334 | $668 |
העלות היא לכל 142,521 התמונות במחיר ה-API הרשמי של כל ספק.
מה הייתי משתמש בו, על סמך הבדיקה הזו:
- אם רק הציון היה חשוב לי, GPT-6.1 Sol במאמץ max.
- לספרייה שלי, GPT-6.1 Sol במאמץ medium. הוא השיג 98% מהציון הגבוה ביותר תמורת 240 דולר, בערך שליש ממה ש-Opus היה עולה.
- בתקציב מצומצם, GPT-6 Luna במאמץ max. תמורת 20 דולר הוא עקף את Haiku, שעולה אותו מחיר לכל טוקן, ואת Sonnet, שיעלה בערך פי 17 עבור הספרייה הזו.
- לא Claude Sonnet 5.5. הוא במחיר בינוני וקיבל את הציון הנמוך ביותר.
המודלים
| ספק | מודל | מאמץ שנבדק | מיקום |
|---|---|---|---|
| Anthropic | Claude Opus 5.5 | ברירת מחדל (medium) | מודל דגל לשימוש יומי |
| Anthropic | Claude Sonnet 5.5 | ברירת מחדל | דרג ביניים |
| Anthropic | Claude Haiku 5.5 | ברירת מחדל | מהיר וזול |
| OpenAI | GPT-6 Astra | max, ultra | מודל חזית (frontier) |
| OpenAI | GPT-6.1 Sol | medium, max, ultra | סוס עבודה |
| OpenAI | GPT-6 Luna | medium, max | מהיר וזול |
המחירים מסתדרים בין שני הספקים. GPT-6.1 Sol עולה אותו מחיר לכל טוקן כמו Claude Sonnet 5.5, GPT-6 Astra כמו Claude Fable 5.1, ו-GPT-6 Luna כמו Claude Haiku 5.5. Claude Opus 5.5 יושב בין Sol ל-Astra. לכן כששני מודלים מסיימים בעלויות שונות להלן, זה בעיקר כי אחד מהם השתמש ביותר טוקנים לאותה עבודה.
מודלי Claude רצו פעם אחת כל אחד בהגדרות ברירת המחדל שלהם, כלומר מאמץ medium ל-Opus. בדקתי את מודלי GPT בכמה רמות מאמץ. ההשוואה הקרובה ביותר היא GPT-6.1 Sol ב-medium מול Claude Opus 5.5 ב-medium: 9.56 מול 8.57.
הבדיקה
השתמשתי ב-50 התמונות האחרונות בספרייה שלי באותו זמן, ללא סרטונים. הן שבוע רגיל של גלגלת המצלמה שלי: רגעים משפחתיים בבית ובקניות, נופי עיר מקומה גבוהה, כרטיס זיכרון על שולחני, צילומי מסך של דפי מוצר של חלקים אלקטרוניים, צילומי מסך של מעקב הזמנות, פוסט ברשת חברתית, שלט QR להנחת חניה ותווית עמדת טעינה לרכב חשמלי.
לכל מודל היו חמש משימות לכל תמונה. הוא כתב כותרת קצרה ותיאור של משפט עד שלושה בסינית, נתן 5 עד 12 מילות מפתח בסינית ובאנגלית, ובחר את האלבום הטוב ביותר מהאלבומים הקיימים שלי, או אף אחד. אחר כך נתן ציון איכות ואמר אם לשמור או למחוק את התמונה, כשהוא מחפש כפילויות, צילומים כושלים, צילומי מסך שפג תוקפם ותמונות ללא ערך מתמשך. כל מודל קיבל את אותן הוראות ואותו הקשר לכל תמונה, עשר תמונות בכל פעם.
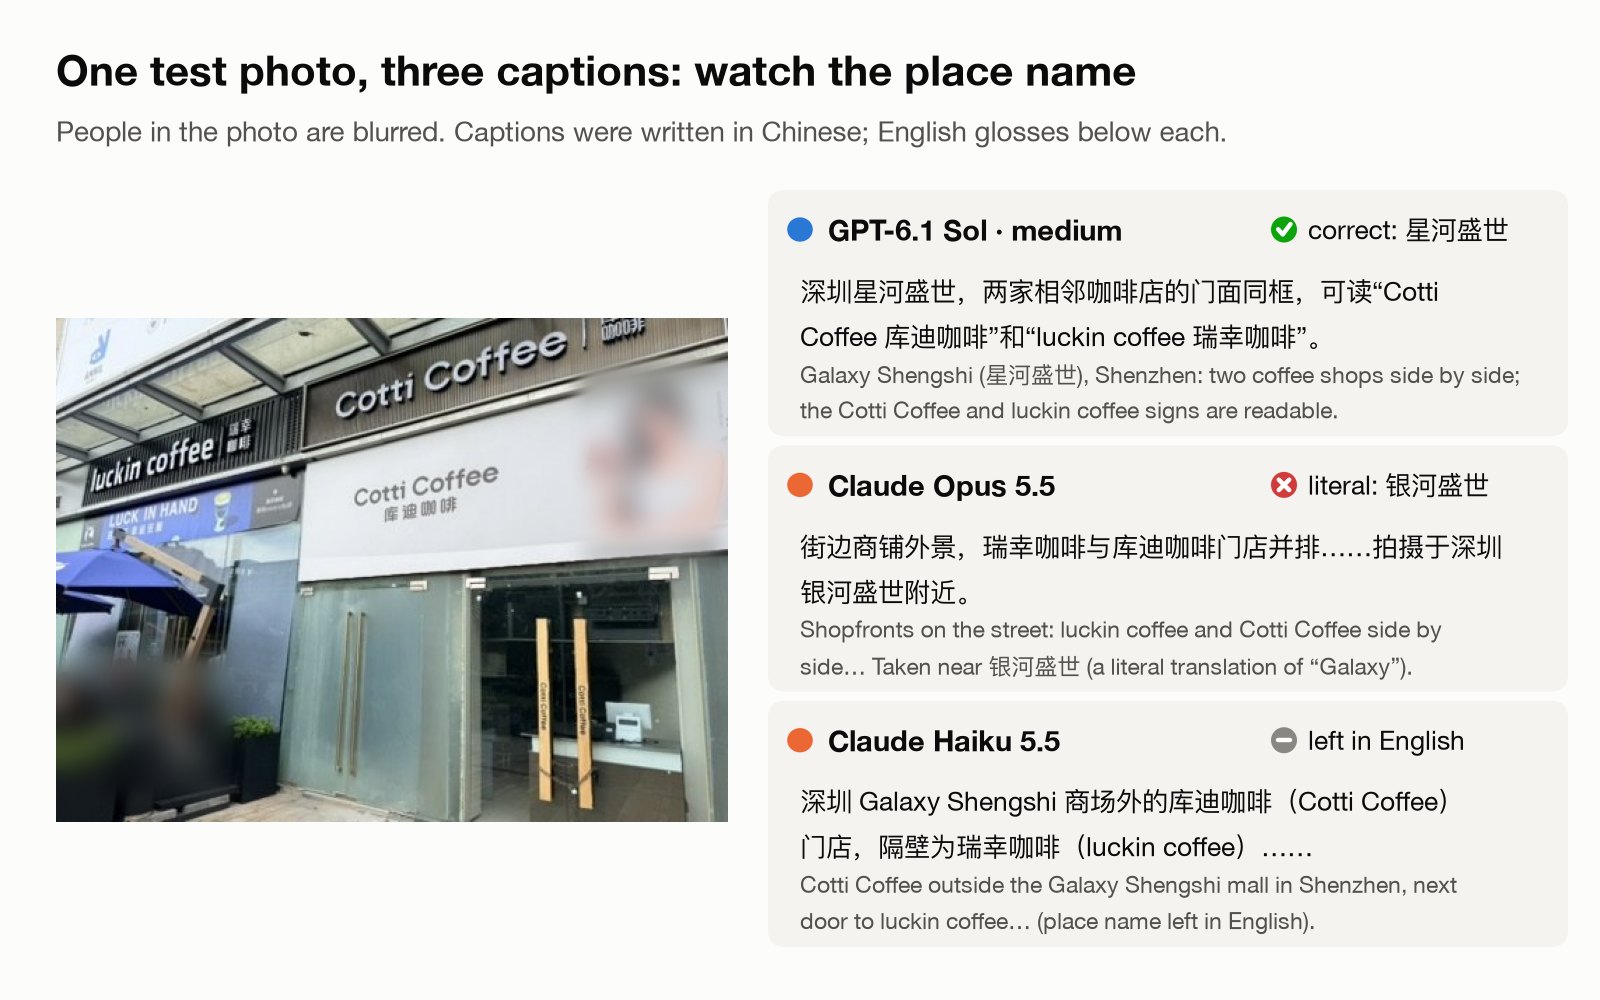 איור 2. אחת מ-50 תמונות הבדיקה, עם שלושה מהתיאורים. ראו איך כל מודל מטפל בשם המקום; אחזור לזה להלן. האנשים בתמונה מטושטשים.
איך נתתי ציון
לא נתתי ציון לתשובות בעצמי. כבר בחרתי מנצח לפני הבדיקה, ואני משתמש ב-Claude כל יום, כך שלא הייתי נייטרלי.
במקום זאת, ערבבתי את עשר התשובות של כל תמונה ותייגתי אותן מ-A עד J, בסדר אקראי חדש לכל תמונה. שני מעריכים נתנו ציון לכל 500 התשובות באופן עצמאי תוך הסתכלות בתמונות. אחד היה Claude Fable 5.1, המודל החזק ביותר של Anthropic. השני היה GPT-6 Astra במאמץ xhigh, מודל החזית של OpenAI.
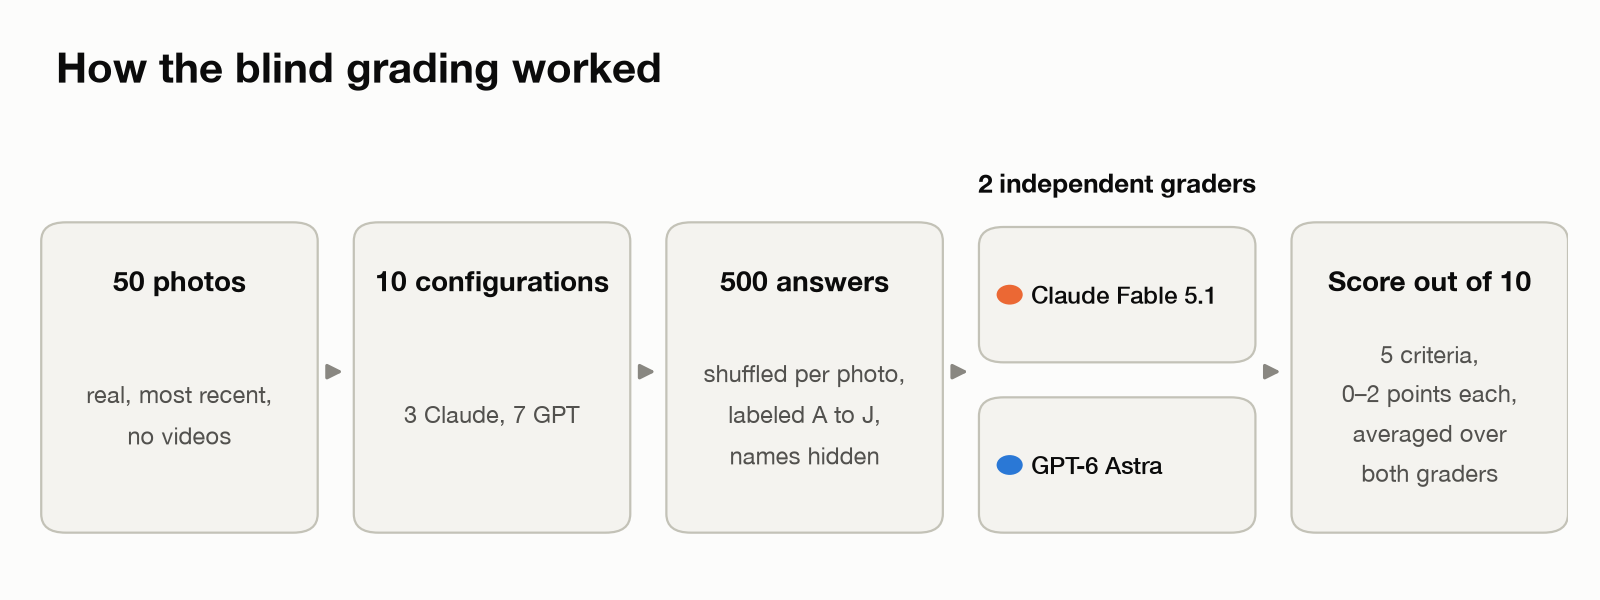 איור 3. איך עבד הניקוד העיוור.
כל תשובה קיבלה ציון על חמישה קריטריונים, 0 עד 2 נקודות כל אחד, בסך הכול 10:
| קריטריון | מה שהמעריך בדק |
|---|---|
| עובדות | האם הנושא, המקום וכל טקסט קריא נכונים, כולל שמות מקומות מקומיים? |
| ללא פרטים מומצאים | האם התשובה נמנעת מלטעון דבר שהתמונה לא מראה? |
| שיקול מחיקה | האם ההחלטה לשמור או למחוק סבירה? מחיקת תמונה טובה = 0. |
| התאמת אלבום | האם האלבום נכון? אלבום ישן שגוי = 0; ללא אלבום הוא 1 סביר. |
| תועלת | האם הכותרת, התיאור ומילות המפתח יעזרו לי למצוא ולזכור את התמונה הזו בהמשך? |
בחרתי מעריך אחד מכל ספק כדי לראות אם אחד מהם יעדיף את המודלים שלו. הם הסכימו ברוב המקרים. המתאם על פני 500 הציונים המזווגים היה 0.71, ושניהם שמו את חמש תצורות ה-GPT באותו מקום בראש. המעריך של Claude דירג גם את GPT-6.1 Sol ו-GPT-6 Astra מעל Claude Opus. המעריך של GPT היה מחמיר יותר בסך הכול, והכי מחמיר עם מודלי Claude.
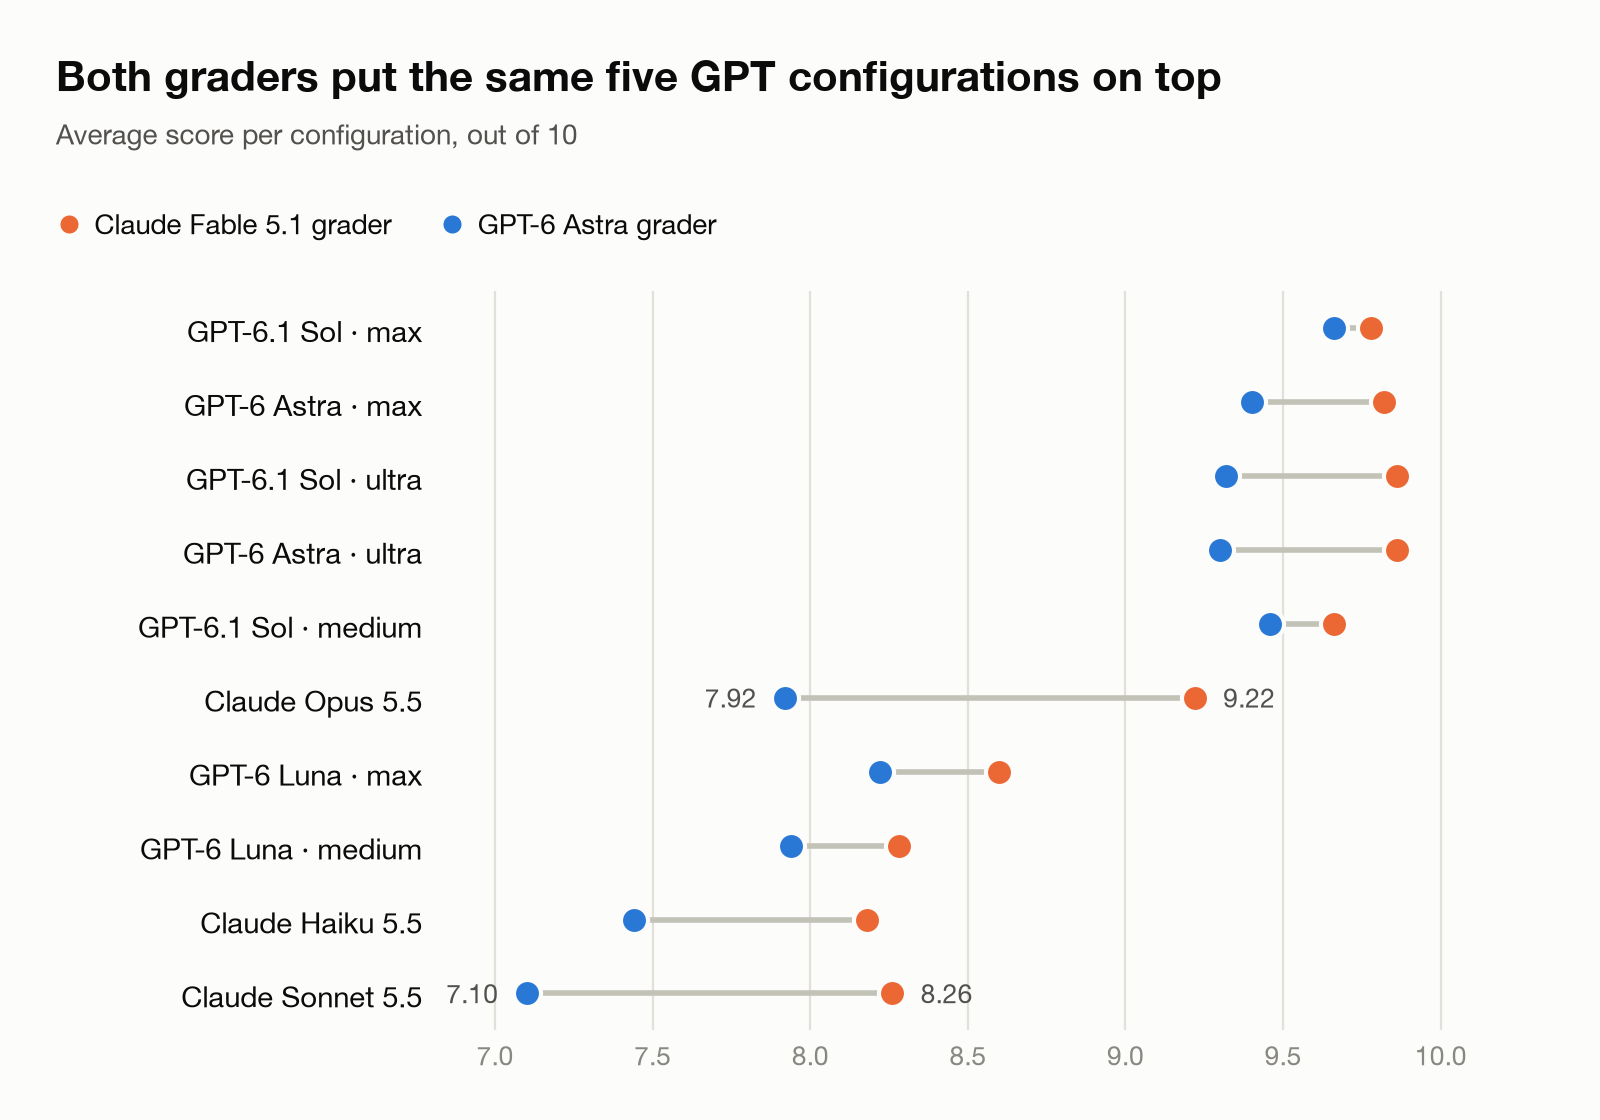 איור 4. הציון הממוצע של כל מעריך לכל תצורה.
תוצאות
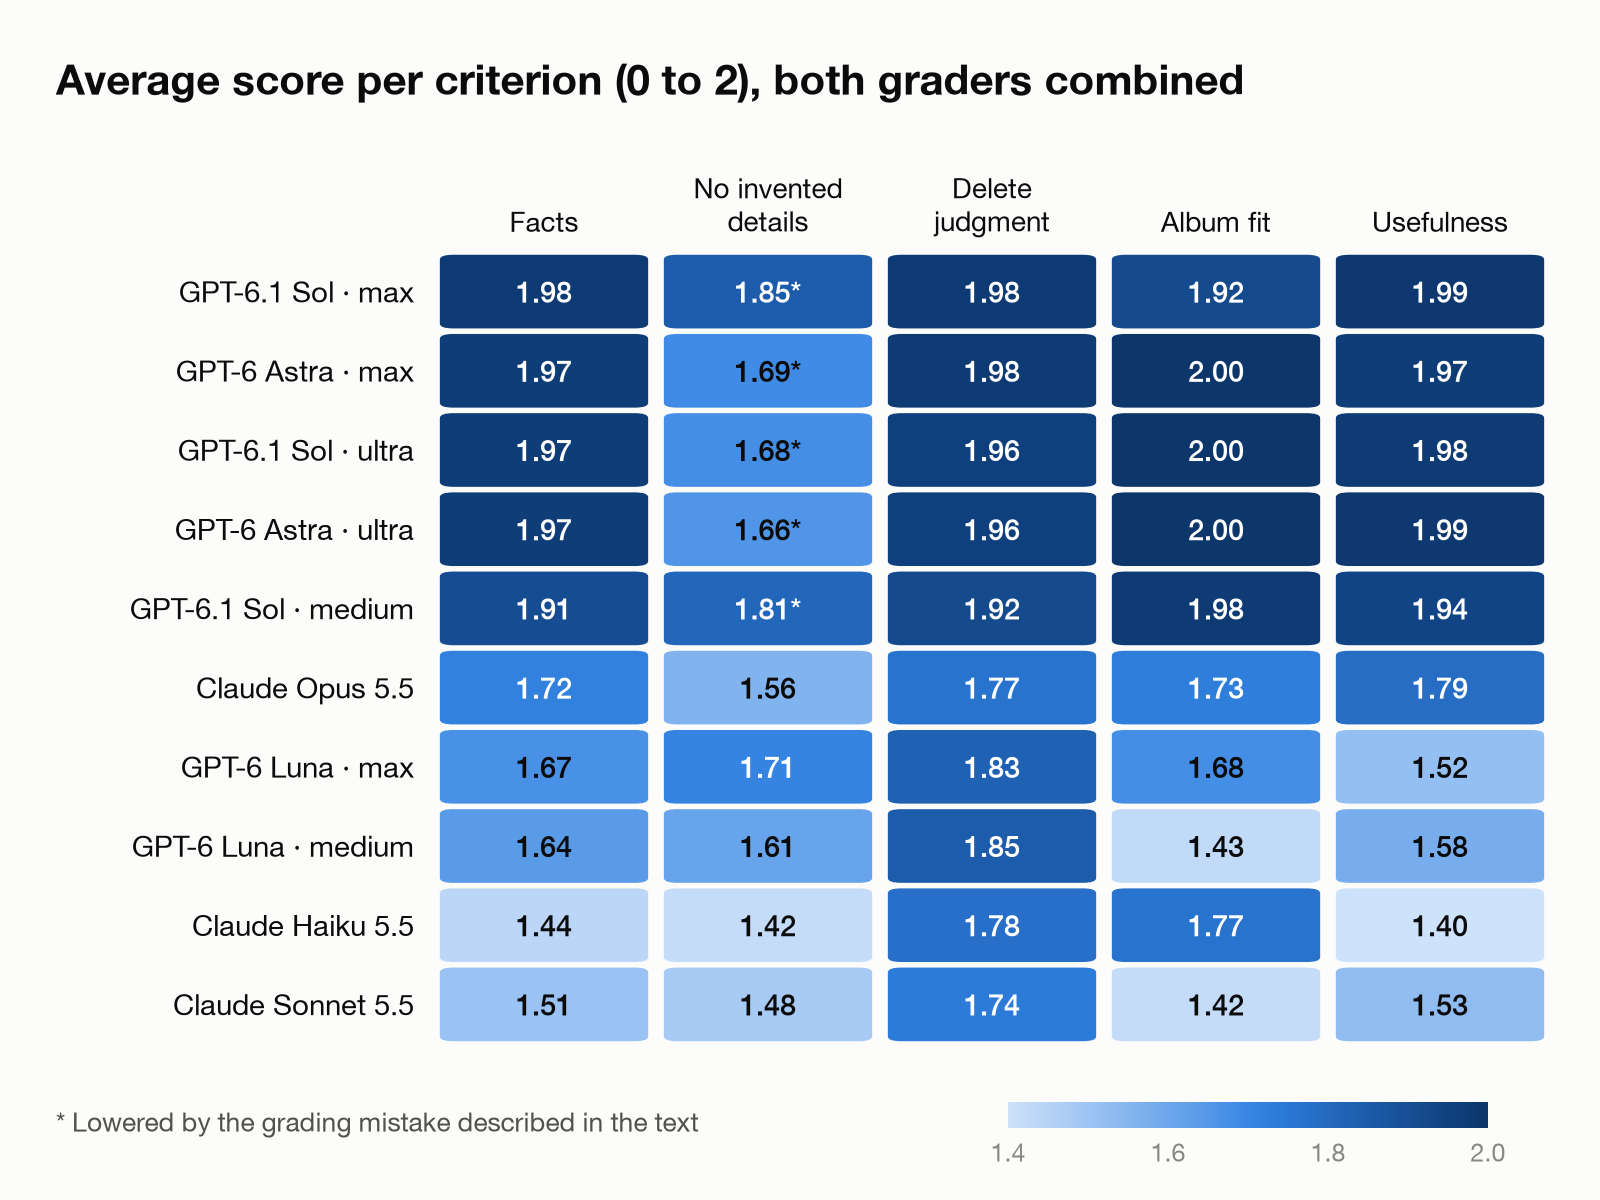 איור 5. ציון ממוצע לכל קריטריון, שני המעריכים יחד. כוכבית מסמנת ציונים שהונמכו בשל טעות הניקוד שאתאר להלן.
GPT-6.1 Sol ו-GPT-6 Astra
Sol ו-Astra קראו את הטקסט במדויק והגבילו לרוב את התיאורים שלהם למה שהתמונות הראו. הם גם היו הטובים ביותר בשמות מקומות מקומיים, מה שחשוב לתמונות שצולמו בסין.
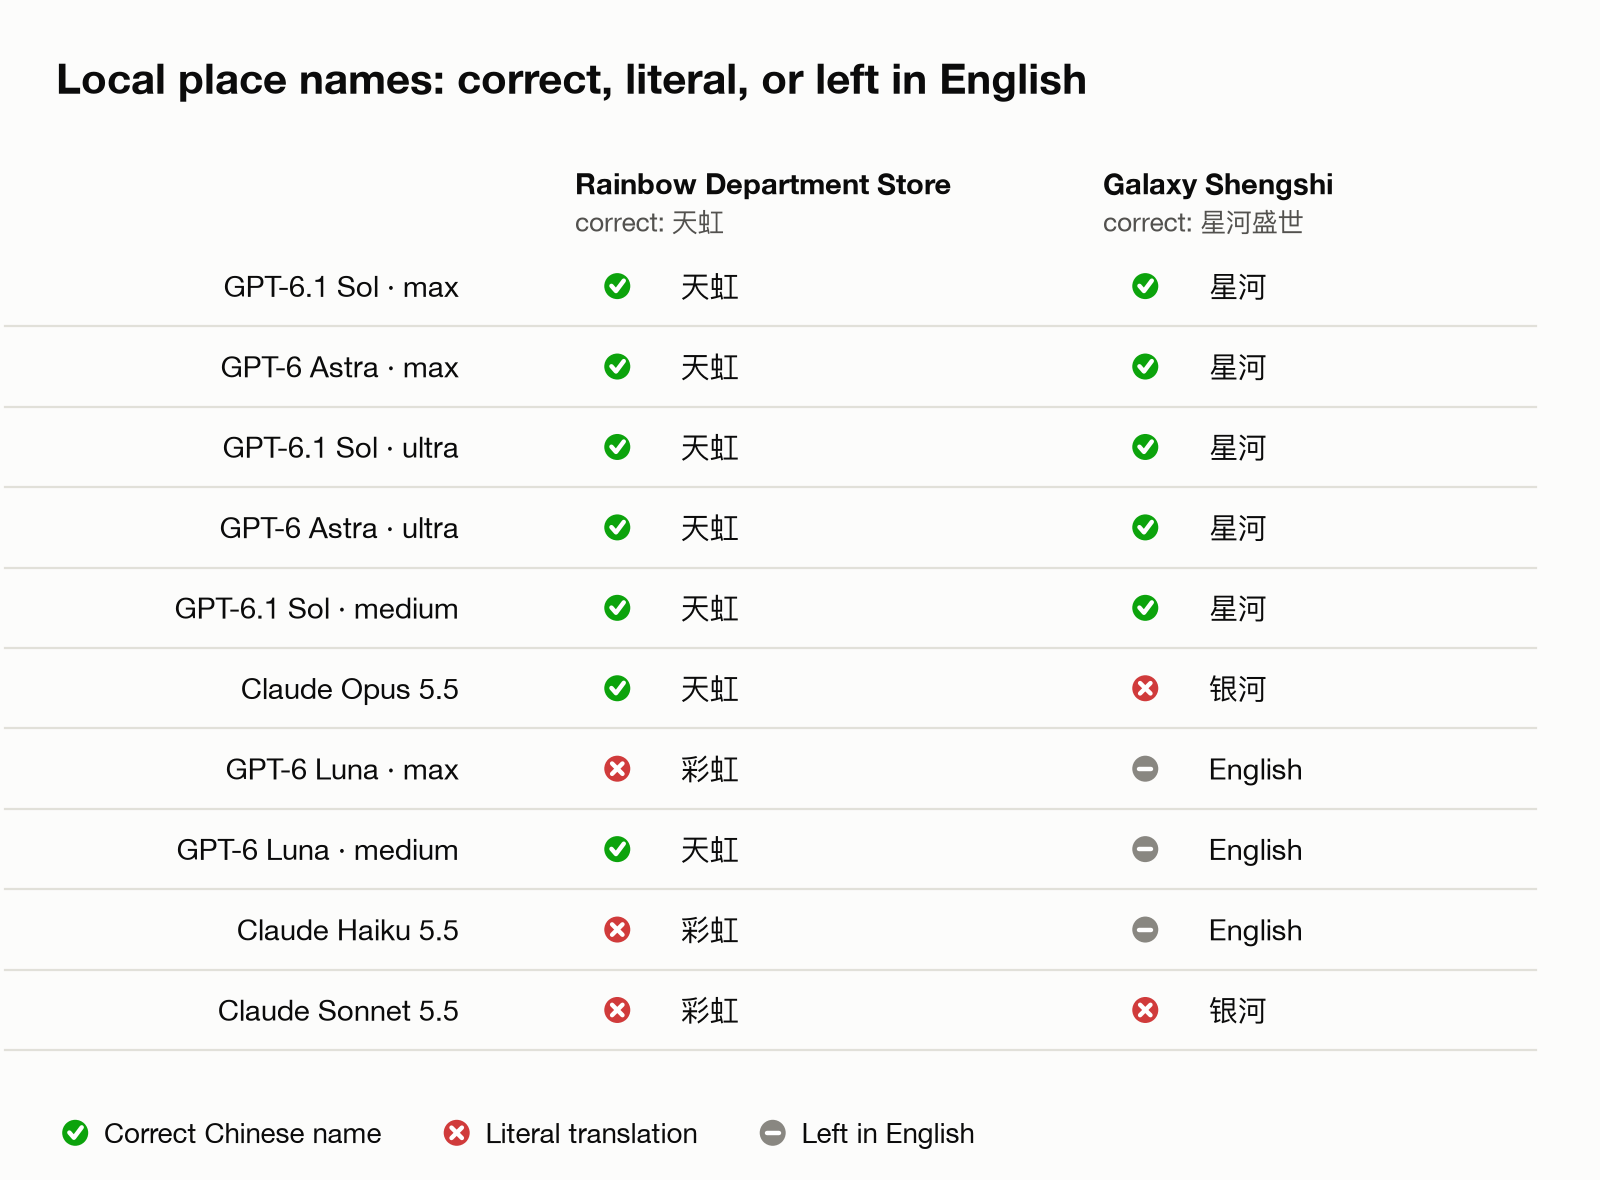 איור 6. שני מבחני שם מקומי. סימון V פירושו השם הסיני הנכון, X פירושו תרגום מילולי, ו-EN פירושו שהשם הושאר באנגלית.
כמה תמונות תויגו במיקום «Rainbow Department Store». זהו השם האנגלי של רשת הקניונים 天虹 בשנזן. תרגום מילה במילה נותן 彩虹百货, וזה שגוי. כל תצורת Sol ו-Astra כתבה את זה נכון, וכך גם Opus ו-Luna במאמץ medium. Haiku, Sonnet ו-Luna ב-max השתמשו בתרגום המילולי. תמונת בית הקפה באיור 2 תויגה כ-«Galaxy Shengshi», ששמה הסיני הוא 星河盛世. כל תצורת Sol ו-Astra כתבה 星河. Opus ו-Sonnet תרגמו מילולית ל-银河, ו-Haiku ושתי תצורות ה-Luna השאירו את השם באנגלית.
Sol ו-Astra גם נזהרו במחיקות. הם הציעו למחוק 4 עד 6 מתוך 50 התמונות. הסט כלל שמונה צילומי מסך של דפי מוצר של חלקים אלקטרוניים, ומודלי ה-GPT שמרו כמעט את כולם; תצורת Sol אחת סימנה צילום מסך יחיד ככמעט-כפול. מודלי Claude סימנו שניים עד ארבעה כל אחד. שני המעריכים תמכו בשמירתם, מכיוון שהדפים הכילו פין-אאוטים, מידות ותמונות לוח שארצה לחפש בהמשך.
Claude Opus 5.5
Opus כתב לפעמים דברים לתוך תיאור שהתמונה לבדה לא יכולה להראות. הוא תיאר קשרים שהתמונה לבדה לא יכולה להוכיח, כמו אחים או הורה וילד. הוא גם טעה בכמה תנוחות. בתמונה אחת ילד עמד מאחורי מבוגר, ו-Opus כתב שהילד על גב המבוגר. שני המעריכים הורידו נקודות על כך.
זה הפתיע אותי. לפני הבדיקה העיוורת עברתי על התשובות ושיבחתי את Opus על כך שניחש נכון ששני ילדים הם אחים. אני מכיר את המשפחה שלי; המעריך לא. אבל עם 142,000 תמונות, אני לא יכול לבדוק כל תיאור בעצמי, ותיאור שקובע משהו שהתמונה לא מראה הוא בעיה.
Opus גם הציע את מספר המחיקות הגדול ביותר, 13 מתוך 50 התמונות. שלוש מהן היו צילומי מסך של דפי מוצר שהוא כינה שפג תוקפם, אף שהכילו מידע עזר שאני רוצה לשמור. הוא היה המודל היחיד שרצה למחוק את שלט ה-QR של הנחת החניה כבעל ערך נמוך. הוא גם שם כמה תמונות של אדם יחיד באלבום «דיוקן משפחתי».
Claude Sonnet 5.5 ו-Haiku 5.5
שני אלה עשו הכי הרבה טעויות עובדתיות, כולל התרגום המילולי 彩虹. Sonnet עשה את בחירות האלבום החלשות ביותר ותייק תמונות יומיומיות באלבום ישן מאירוע לא קשור. Haiku המציא פרט שהוביל להחלטת מחיקה גרועה. בסדרת צילומים כמעט זהים, הוא תיאר את הפריים הטוב ביותר כמישהו שמביט למטה, שזה ההפך ממה שהתמונה מראה, והציע למחוק אותו.
GPT-6 Luna
Luna עולה אותו מחיר לכל טוקן כמו Haiku אבל קיבל ציונים גבוהים יותר בשתי רמות המאמץ: 8.41 ו-8.11, מול 7.81 של Haiku. במאמץ max הוא גם עקף את Sonnet, שיעלה בערך פי 17 לכתיבת תיאורים לאותה ספרייה. Luna איבד את רוב נקודותיו בתועלת ובבחירת אלבום. התיאורים שלו היו פשוטים יותר והאלבומים פחות מדויקים.
רמות מאמץ
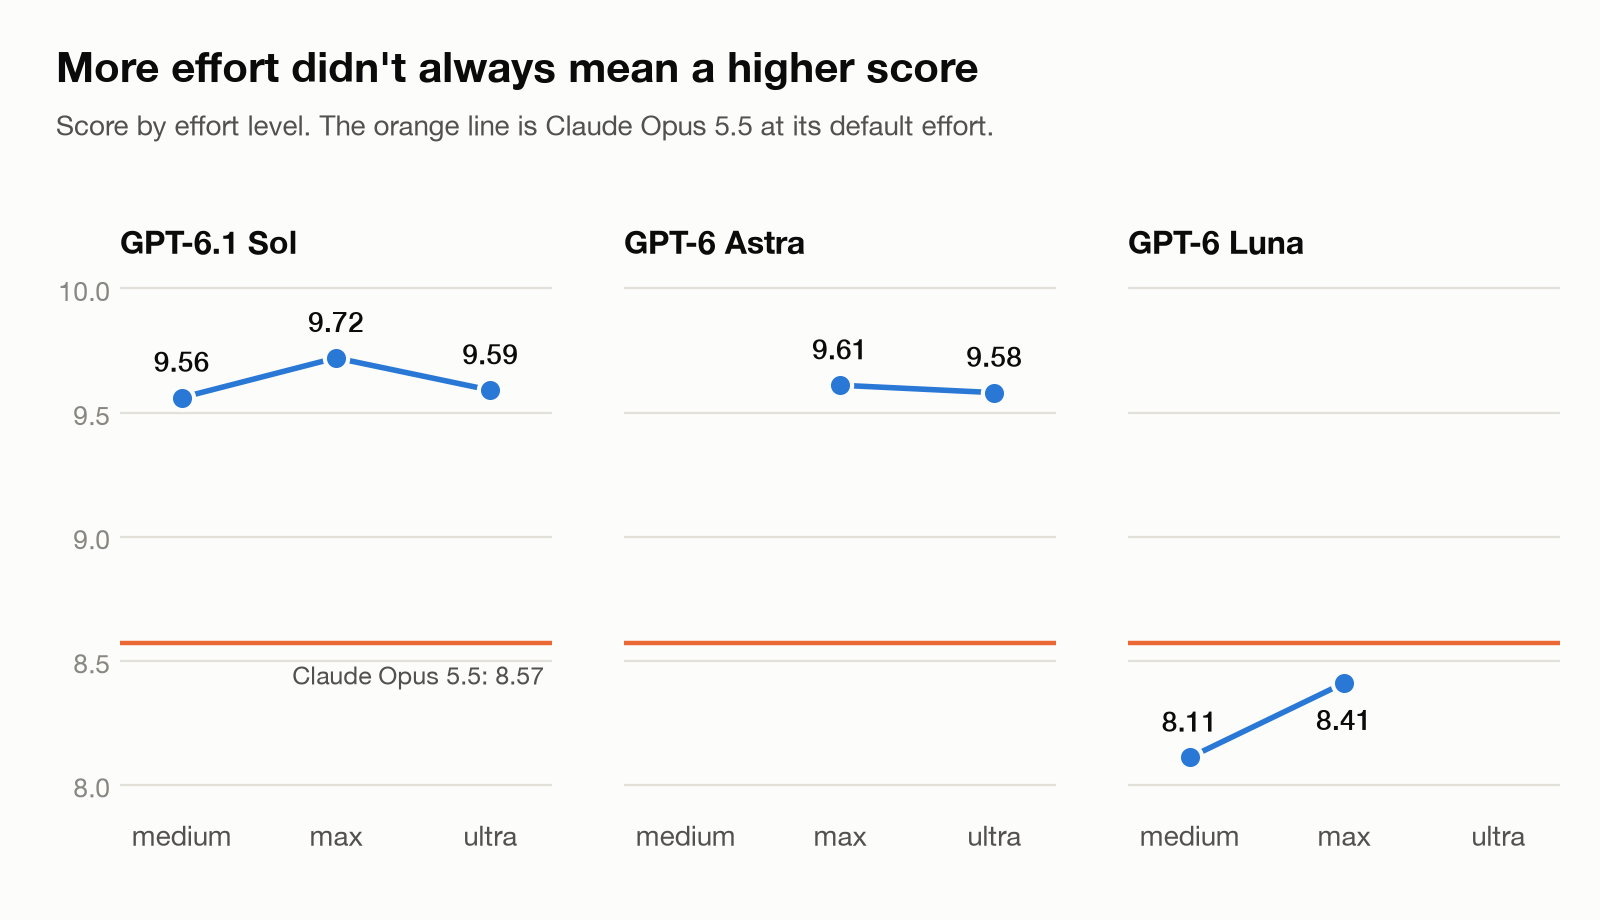 איור 7. ציון לפי רמת מאמץ. הקו הכתום הוא Claude Opus 5.5 במאמץ ברירת המחדל שלו.
Ultra לא היה טוב מ-max לאף אחד מהמודלים. Sol קיבל 9.59 ב-ultra ו-9.72 ב-max; Astra קיבל 9.58 ו-9.61. בבדיקה הזו, ultra אפילו ייצר פחות טוקני פלט מ-max. ל-Sol, medium היה קרוב ב-9.56, בפחות מחצי מהעלות של max. מאמץ גבוה יותר גם לא תמיד היה שווה פרטים מדויקים יותר: Luna ב-medium כתב נכון את 天虹, ו-Luna ב-max לא.
טעות בניקוד שלי
אחרי הניקוד שמתי לב שהמעריכים לא קיבלו את תאריך ושעת הצילום של כל תמונה, אף שמודלי כתיבת התיאורים קיבלו אותם. לכן המעריך GPT-6 Astra התייחס לתיאורים שציינו תאריך או שעה מדויקים כפרטים מומצאים. תצורות ה-GPT המובילות ציינו את התאריך לרוב, ולכן ציוני «ללא פרטים מומצאים» שלהן יצאו נמוכים ממה שהיו צריכים להיות.
אם אחזיר רק את הנקודות שאבדו בגלל תאריכים, ארבע תצורות ה-GPT המובילות עולות ל-9.84 עד 9.90, שזה למעשה תיקו, ו-Opus נשאר על 8.58. שמרתי על הציונים המקוריים בפוסט הזה. בפעם הבאה אתן למעריכים את כל מה שהמודלים ראו.
מהירות
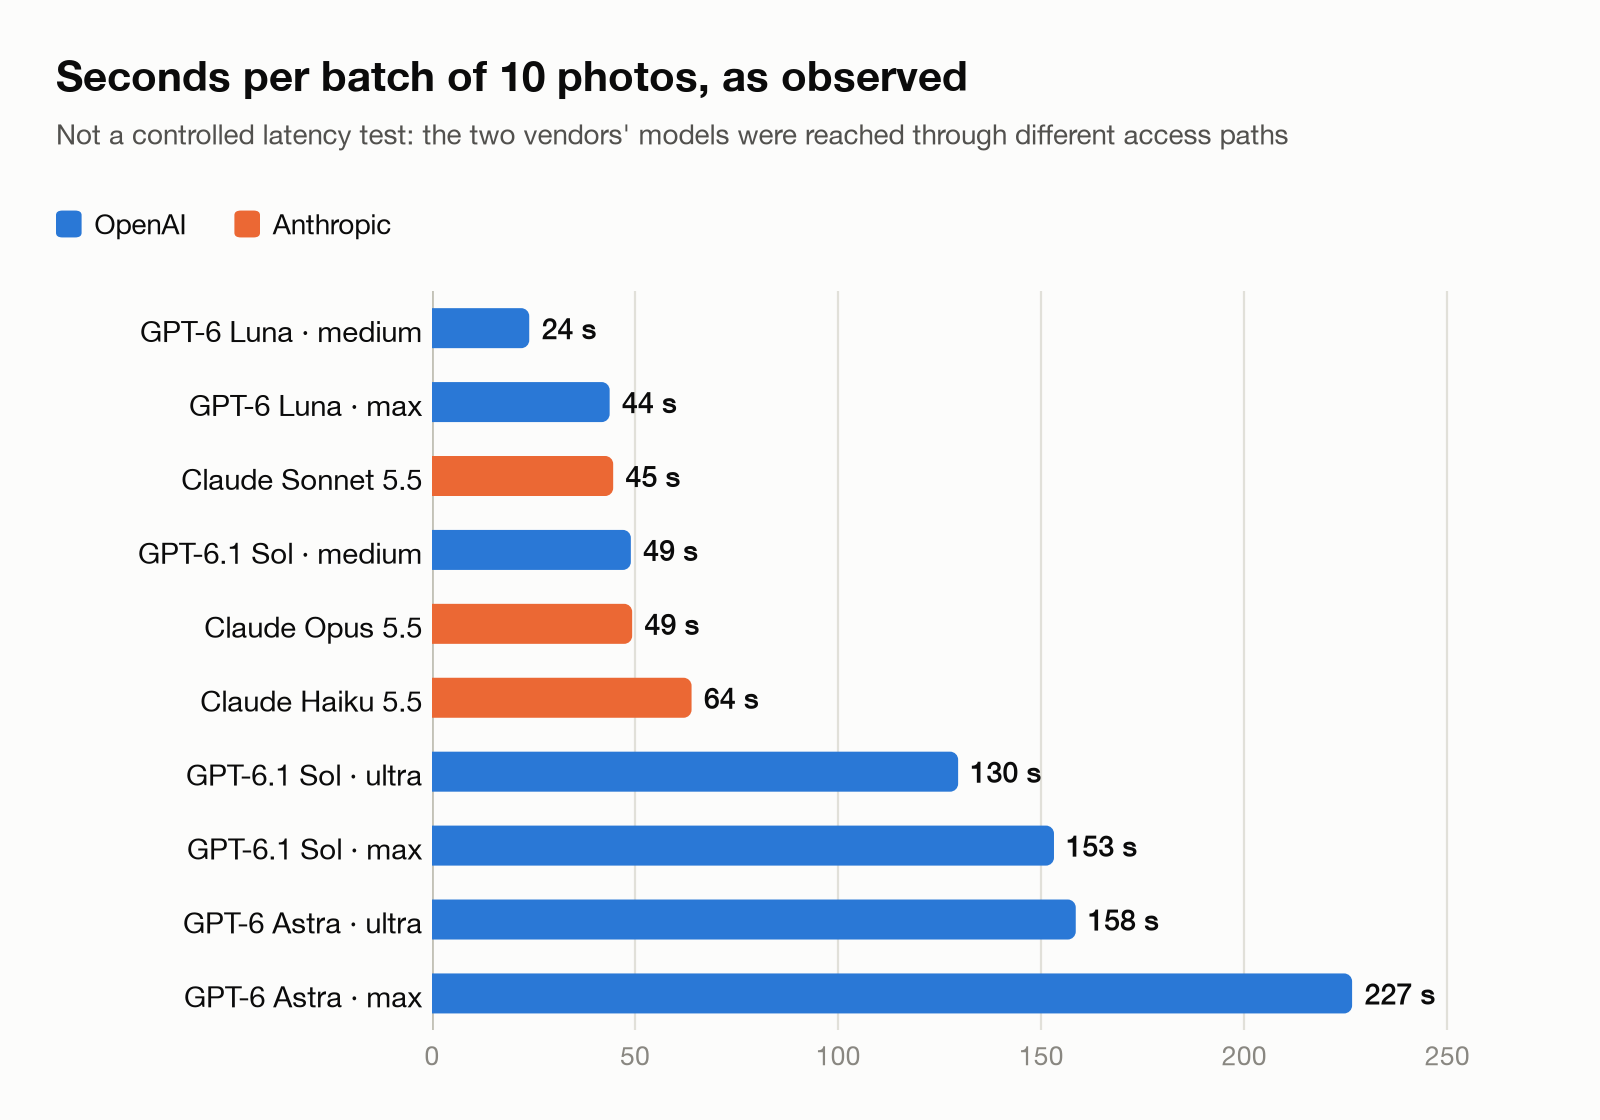 איור 8. שניות לכל אצווה של 10 תמונות, כפי שנצפה. זהו לא מבחן השהיה מבוקר, כי מודלי שני הספקים הושגו דרך נתיבי גישה שונים.
זה תואם את התחושה של Opus בעבודה היומיומית שלי: הוא מהיר, בערך פי שלושה מהר יותר מ-Sol ב-max. אבל Sol ב-medium היה מהיר בדיוק כמו Opus, וקיבל בערך נקודה יותר.
כמה זה עולה
תמחרתי כל תצורה במחירי ה-API הרשמיים של הספקים. להתייחס לשימוש הכלול בתוכנית מנוי כחינמי היה גורם לכמה מודלים להיראות טובים יותר ממה שהם.
מחירים רשמיים למיליון טוקנים, דרגה רגילה:
| מודל | קלט | פלט |
|---|---|---|
| Claude Opus 5.5 | $4.00 | $20.00 |
| Claude Sonnet 5.5 | $2.00 | $10.00 |
| Claude Haiku 5.5 | $0.10 | $0.50 |
| GPT-6 Astra | $10.00 | $50.00 |
| GPT-6.1 Sol | $2.00 | $10.00 |
| GPT-6 Luna | $0.10 | $0.50 |
ממשקי ה-Batch API של שני הספקים זולים ב-50%, מה שמתאים לעבודה כזו שלא זקוקה לתשובות מיידיות. לקחתי את המחירים מעמוד התמחור של Anthropic (claude.com/pricing) ומעמוד תמחור ה-API של OpenAI (developers.openai.com/api/docs/pricing) ב-20 באוקטובר 2026.
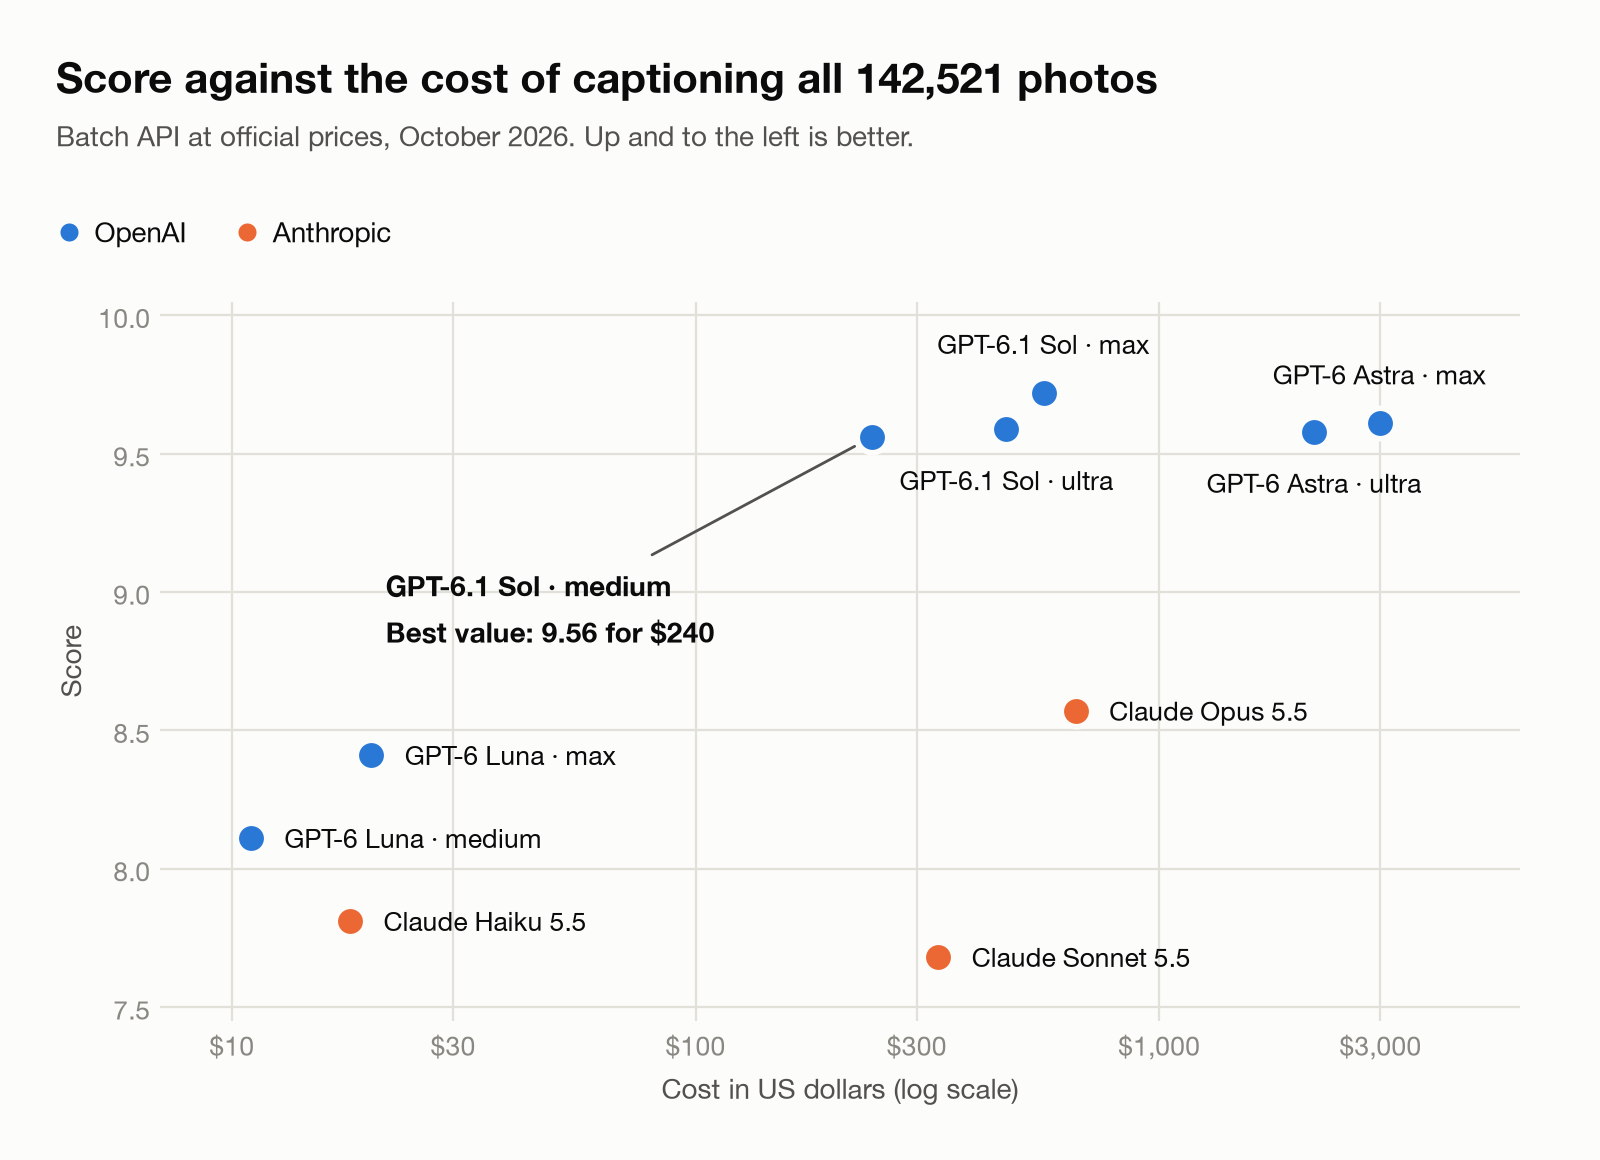 איור 9. ציון מול עלות כתיבת תיאורים לכל הספרייה במחירי Batch. ציר העלות לוגריתמי.
| מודל ומאמץ | טוקני פלט לתמונה | רגיל | Batch | ציון |
|---|---|---|---|---|
| GPT-6.1 Sol, medium | 193 | $479 | $240 | 9.56 |
| GPT-6.1 Sol, ultra | 514 | $937 | $468 | 9.59 |
| GPT-6.1 Sol, max | 647 | $1,126 | $563 | 9.72 |
| Claude Opus 5.5 | ~292 | $1,323 | $661 | 8.57 |
| Claude Sonnet 5.5 | ~297 | $668 | $334 | 7.68 |
| GPT-6 Astra, ultra | 462 | $4,313 | $2,156 | 9.58 |
| GPT-6 Astra, max | 695 | $5,973 | $2,987 | 9.61 |
| GPT-6 Luna, medium | 163 | $22 | $11 | 8.11 |
| Claude Haiku 5.5 | ~330 | $36 | $18 | 7.81 |
| GPT-6 Luna, max | 419 | $40 | $20 | 8.41 |
Sol ב-medium השיג 98% מהציון הגבוה ביותר תמורת 36% ממה ש-Opus היה עולה ו-43% מ-Sol ב-max. Astra התאים לאיכות של Sol אבל עולה בערך פי חמישה, כי המחיר שלו לטוקן גבוה פי חמישה. Opus עלה יותר מ-Sol ב-max וקיבל ציון נמוך יותר. הוא כבר רץ במאמץ medium, אבל המחיר שלו לטוקן כפול משל Sol. Luna יכתוב תיאורים לכל הספרייה תמורת 11 עד 20 דולר ועדיין יעקוף את Haiku ואת Sonnet.
הערה מתודולוגית: ספירות טוקני ה-GPT נמדדו מההרצות, וספירות טוקני ה-Claude הוערכו מיומני ההרצה. חלק מטוקני החשיבה של Claude לא היו גלויים, כך שעלויות Claude עשויות להיות מוצגות נמוך במעט. לא הוחלו על אף מודל הנחות מעבר ל-Batch, כמו שמירת פרומפטים במטמון.
מה שלמדתי
בחרתי ב-Opus לפני שהיו לי ציונים עיוורים, בעיקר כי הוא כבר היה ברירת המחדל שלי לקידוד. אני עדיין מעדיף את Claude Opus 5.5 לקידוד ולתהליכי עבודה, שם הוא מהיר וחזק יותר מניסיוני. תיאור תמונות אמיתיות דורש מיומנות אחרת: לקרוא מה באמת נמצא בפריים בלי למלא תנוחות או קשרים. GPT-6.1 Sol עשה את זה טוב יותר. אילו הלכתי לפי ההרגל ודילגתי על הבדיקה העיוורת, הייתי משלם יותר על תיאורים גרועים יותר.
בפעם הבאה אתחיל בעיוורון ואתן למעריכים מספקים שונים את כל הקלטים שמודלי כתיבת התיאורים קיבלו. אמשיך להשוות גם במחירי ה-API הרשמיים, ולא אניח שמאמץ רב יותר עדיף: ultra לא ניצח כאן את max.
אפילו המודלים הטובים ביותר סימנו תמונות שימושיות למחיקה, אז אבדוק כל סימון מחיקה בעצמי לפני שאסיר משהו.
מגבלות
זו הייתה בדיקה קטנה: 50 תמונות עדכניות מעיר אחת. לא בדקתי תמונות ישנות, מסמכים סרוקים, שפות אחרות או סרטונים. מודלי Claude רצו רק בהגדרות ברירת המחדל שלהם; Opus במאמץ גבוה יותר עשוי לקבל ציון טוב יותר, בעלות גבוהה יותר. המעריכים הם מודלי בינה מלאכותית, לא אנשים. הם הסכימו היטב אבל לא בצורה מושלמת, ובדיקה אנושית מדגמית הייתה מחזקת את התוצאה. מודלים ומחירים משתנים מהר, וכל מספר כאן הוא נכון לאוקטובר 2026.
הבחירה שלי
לספרייה שלי: GPT-6.1 Sol במאמץ medium. לקידוד ותהליכי עבודה, אני נשאר עם Claude Opus 5.5.