
Une blockchain tourne désormais sur la même multiplication matricielle que l’IA, à environ 90 EH/s. J’ai lu son code, les données de sa chaîne et l’économie qui l’entoure pour répondre à trois questions : qu’est-ce qui, dans l’IA × crypto, a des clients payants, quand un ASIC vaut-il la peine d’être conçu, et quel nœud de gravure convient à quelle puce. Avec le rapport complet et les diapositives.
Résumé
Pearl, lancé en avril 2026, est la première blockchain dont la preuve de travail est une multiplication matricielle de type IA à grande échelle. Le 13 novembre 2026, son réseau tournait à environ 90 EH/s, où un H correspond à une multiplication-accumulation INT7 : le débit entier d’environ 122 000 H100. Sur le plan technique, cela fonctionne. Ce n’est pas encore utile : environ 1 % des blocs portent un vrai travail d’IA, car un GPU qui mine tout en servant de l’inférence ne conserve que 1 % à 27 % du hashrate d’un mineur dédié. Dans l’ensemble IA × crypto, la demande payante vérifiable apparaît à trois endroits, vendre de l’inférence, vendre des données et vendre de la confidentialité, tandis que les subventions atteignent de 4 à 360 fois les revenus externes. Pour les puces, le plafond de profit d’un ASIC est le revenu par unité de calcul multiplié par (1 − 1/k), si bien que l’efficacité au-delà de k = 5 ajoute peu ; ce qui décide, c’est la taille de la cagnotte, la stabilité des règles et un second débouché. Aucun réseau n’offre les trois aujourd’hui. Le bon nœud de gravure est fixé par le poste le plus lourd du coût de la puce sur sa durée de vie, et la puce elle-même doit s’acheter par étapes, afin qu’un changement de règles coûte un prototype et non un tape-out.
Pourquoi je me suis penché sur la question
J’ai passé de nombreuses années à concevoir des puces, notamment des chemins de données ASIC full-custom pour le minage de cryptomonnaies, et je travaille aujourd’hui sur l’IA. Quand est apparue une chaîne dont le budget de sécurité est littéralement exprimé en débit tensoriel, les questions étaient évidentes pour quelqu’un comme moi : le travail est-il utile, une puce dédiée l’emporterait-elle, et combien coûterait-il d’en concevoir une ?
J’ai lu le code de Pearl et ses propositions de protocole, les données de la chaîne issues d’un nœud complet indépendant, les documents déposés par les entreprises, des articles de cryptographie, d’architecture des ordinateurs et d’apprentissage automatique, les données de prix des fondeurs et des fournisseurs, ainsi que la presse spécialisée. Tous les chiffres ci-dessous datent du 13 novembre 2026, et les montants sont en dollars américains. Cette note retrace la façon dont j’ai appris le domaine ; je la partage pour que d’autres puissent la vérifier, s’en servir et la discuter. Le rapport complet, avec toutes les sources, se trouve à la fin.
Les résultats en un coup d’œil
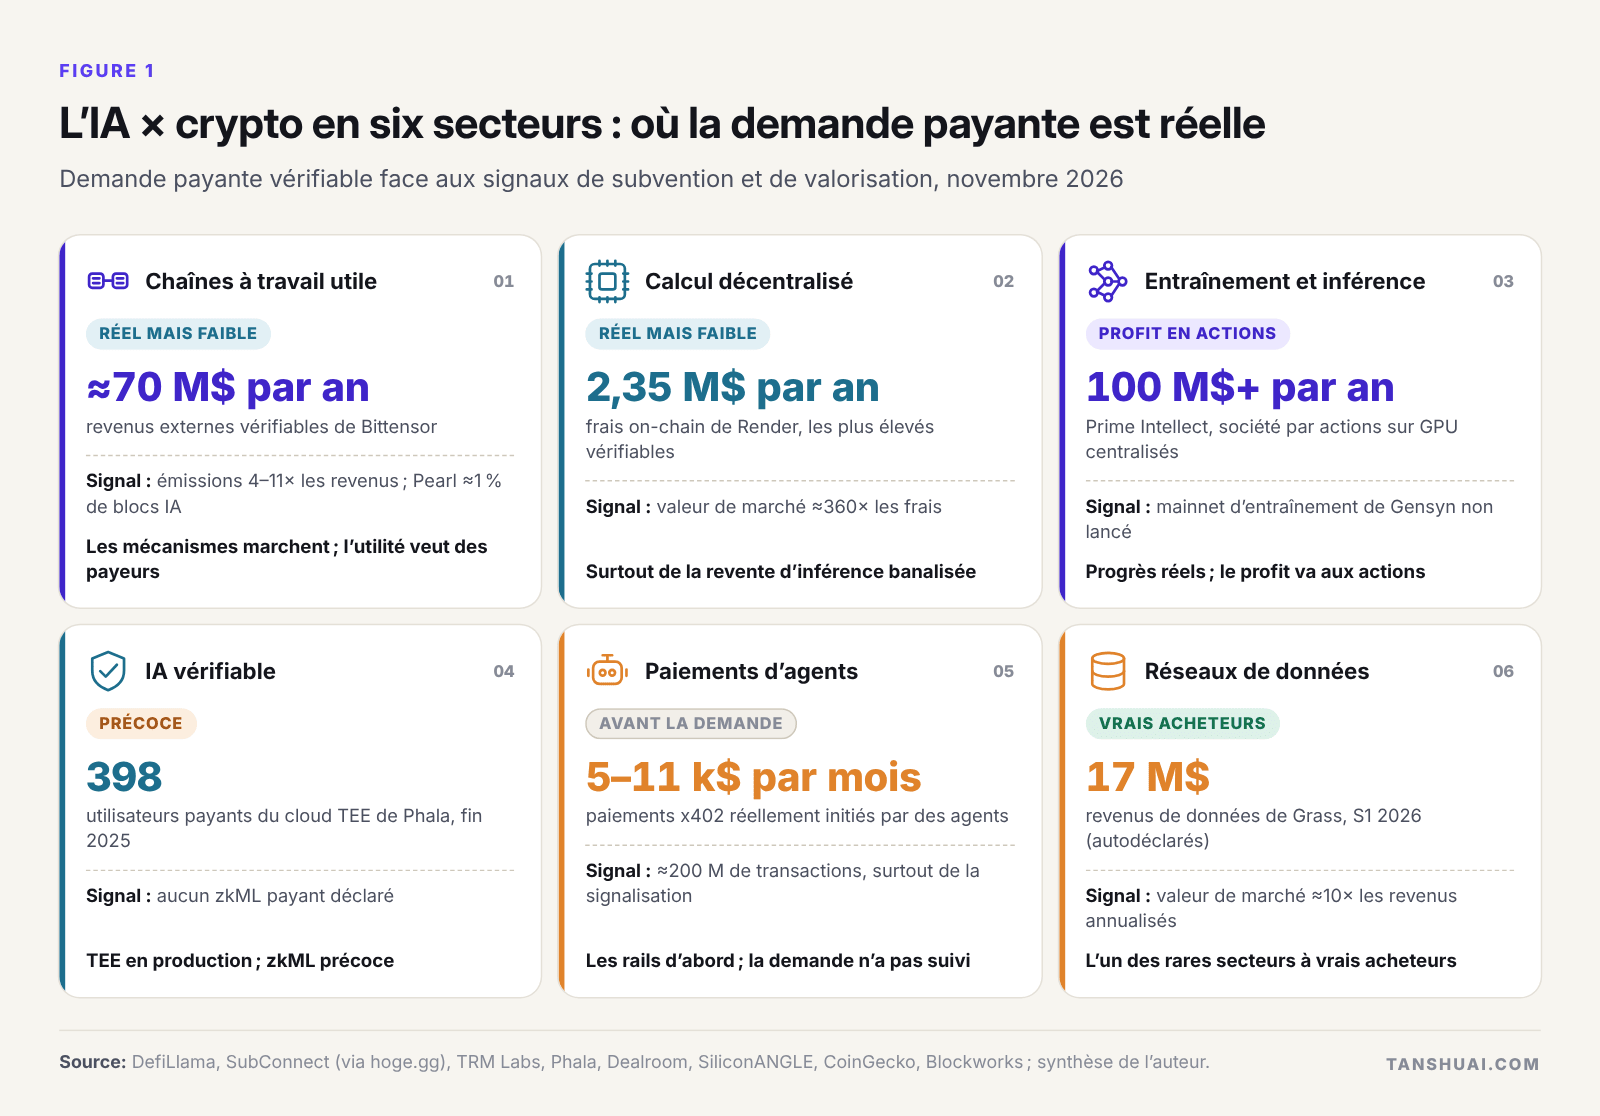 Figure 1. L’IA × crypto en six secteurs : où la demande payante est réelle.
| Question | Réponse courte |
|---|---|
| Pearl fonctionne-t-il, et son travail est-il utile ? | Il fonctionne : environ 90 EH/s de multiplication matricielle sécurisent la chaîne. Il n’est pas encore utile : environ 1 % des blocs portent du travail d’IA |
| Où est la vraie demande payante ? | Inférence, données et confidentialité. Paiements d’agents, zkML et entraînement décentralisé en sont encore à l’avant-demande |
| Un ASIC vaut-il la peine d’être conçu ? | Seulement avec une grande cagnotte, des règles stables et un second débouché ; aucun réseau n’offre les trois aujourd’hui |
| Quelles puces une petite équipe doit-elle concevoir ? | Des accélérateurs conçus d’abord pour l’inférence et capables de miner, des puces d’inférence pour un client signé, des travaux précoces sur le FHE ; pas de machines de minage bitcoin pour le marché ouvert ni de puces d’entraînement |
| Que coûte une première puce ? | L’acheter par étapes : un modèle, un FPGA et un MPW permettent d’obtenir du silicium mesuré pour environ 1,5 million de dollars, avant des masques qui coûtent des millions |
Pearl : une multiplication-accumulation vaut un hash
Pearl repose sur un résultat de 2025 d’Ilan Komargodski et Omri Weinstein : une preuve de travail utile pour tout produit matriciel, à 1 + o(1) fois le coût de la multiplication. Les mineurs multiplient des matrices bruitées, hachent l’accumulateur de chaque tuile de sortie en un ticket de loterie et prouvent la tuile gagnante par une preuve à divulgation nulle de connaissance de moins de 60 Ko. Dans le code de consensus, un H est une multiplication-accumulation INT7 × INT7 → INT32 créditée : pour la première fois, le budget de sécurité d’une blockchain est exprimé dans le débit tensoriel des accélérateurs d’IA.
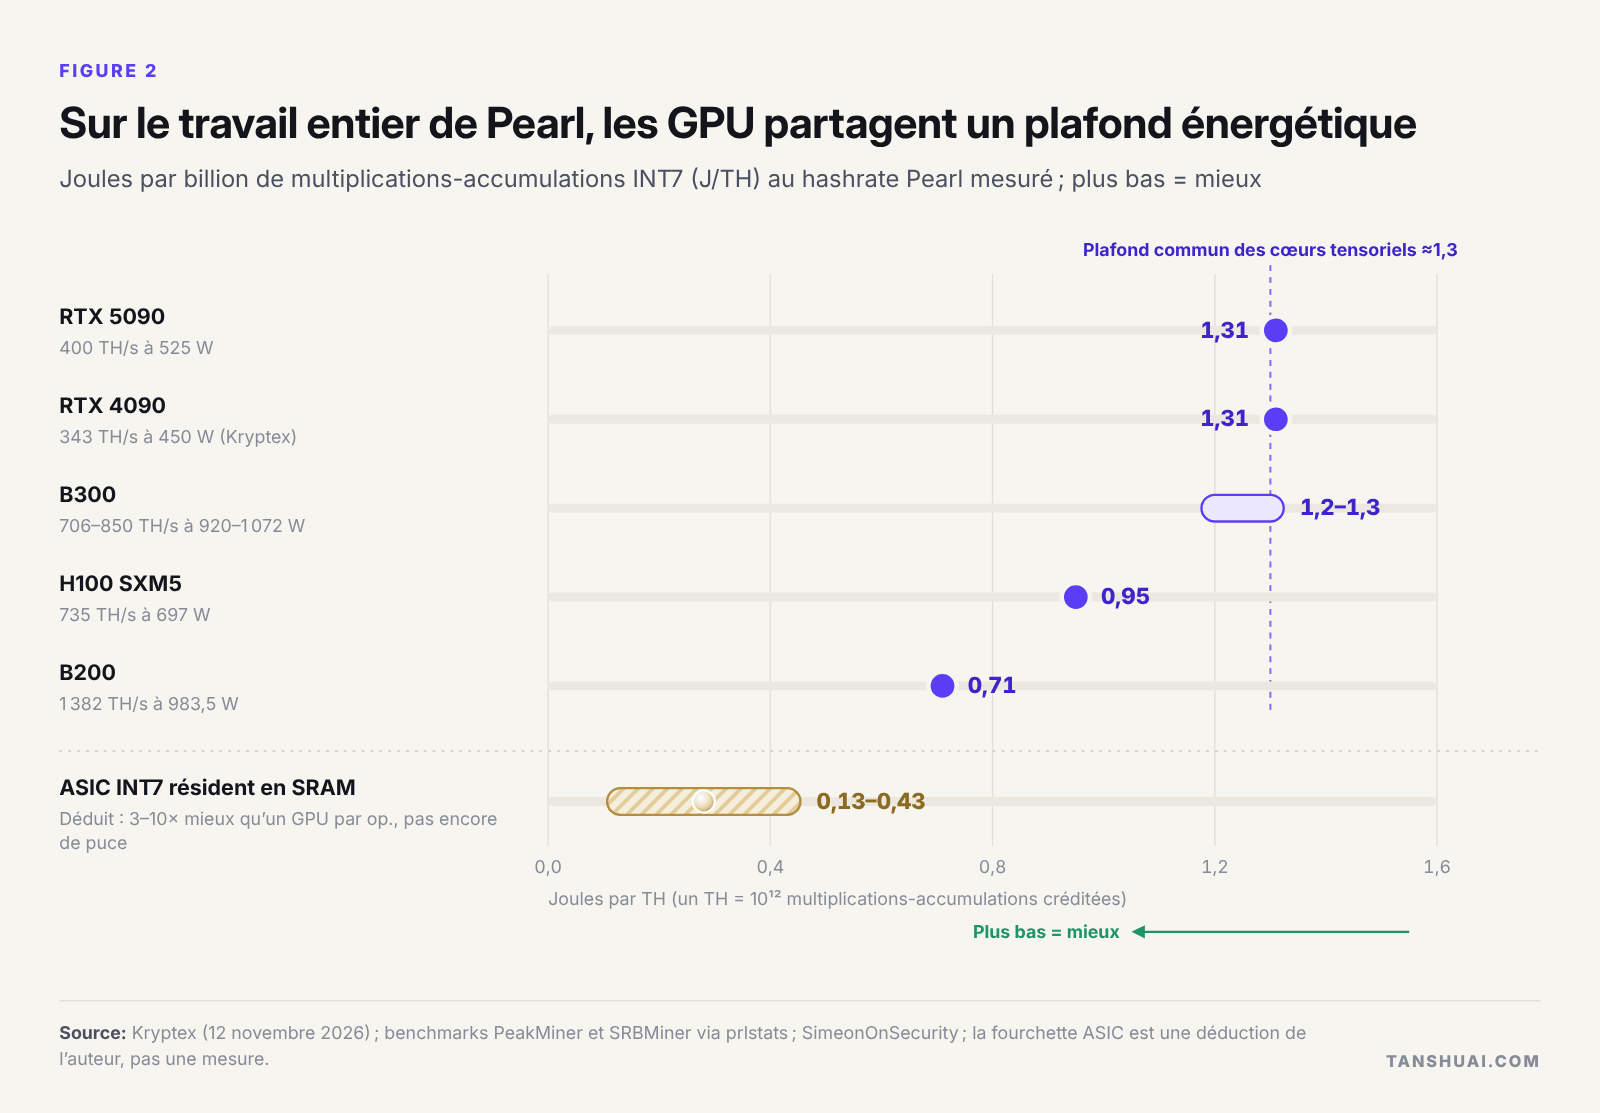 Figure 2. Sur le travail entier de Pearl, les GPU partagent un plafond énergétique.
Les cartes de jeu et le B300 pour centres de données se rejoignent vers 1,3 J/TH, et même le B200 n’atteint que 0,71. Ce plafond commun est précisément ce qu’une puce dédiée pourrait percer : un composant qui ne ferait que multiplier des entiers de 7 bits depuis la SRAM embarquée, sans HBM ni unités généralistes, pourrait plausiblement faire 3 à 10 fois mieux par opération. Pendant ce temps, NVIDIA éloigne son silicium le plus récent de l’INT8 au profit du FP8 et du FP4, ce qui explique que Pearl se prépare à changer son arithmétique.
L’économie de Pearl : le théorème tient, l’incitation non
Le hashrate de Pearl suit son prix. Le réseau est passé de 0,01 EH/s à son deuxième jour à 23–26 EH/s fin mai, s’est maintenu à 21–39 EH/s durant un été où le prix a chuté d’environ 86 %, et a atteint environ 90 EH/s après une hausse du prix d’environ dix fois à l’automne. Environ 120 millions de pièces, soit environ 32 % de l’offre actuelle, ont été minées au cours des six premiers jours, et l’offre augmentera d’environ 78 % au cours des 12 prochains mois. Une RTX 5090 rapporte aujourd’hui environ 5–6 dollars par jour.
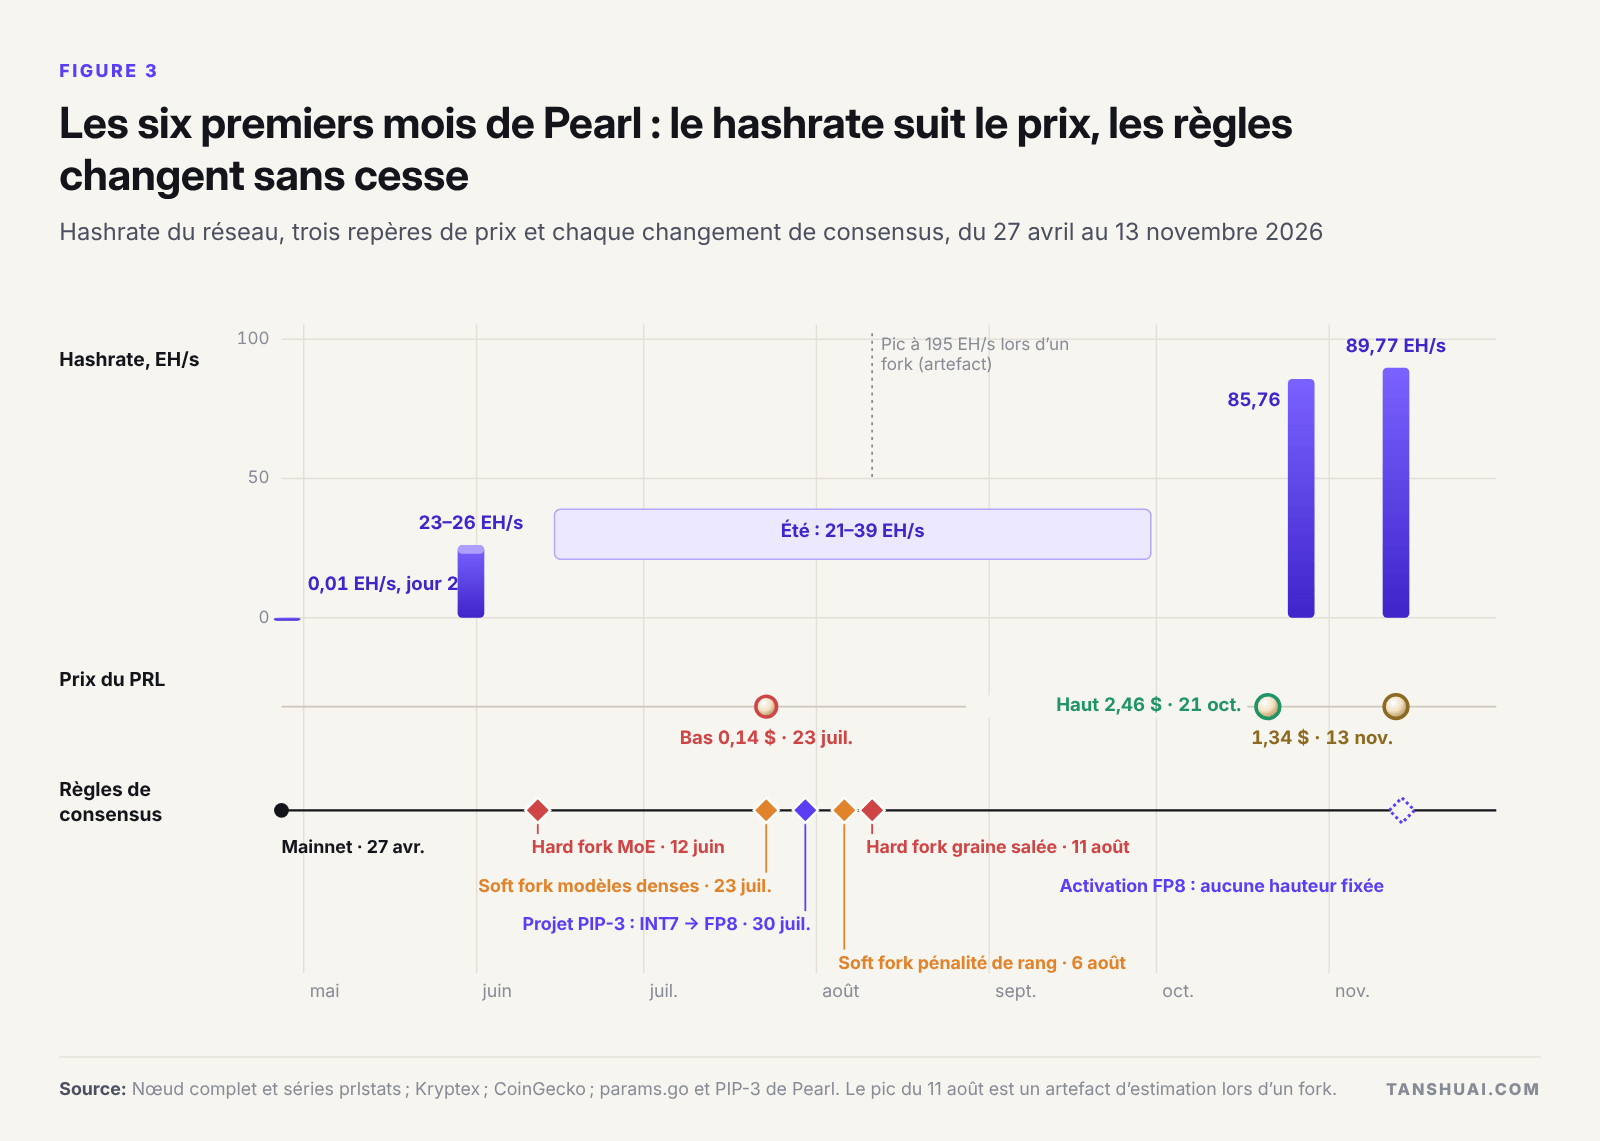 Figure 3. Les six premiers mois de Pearl : le hashrate suit le prix, les règles ne cessent de changer.
C’est sur la partie utile que le modèle se brise. Miner à l’intérieur d’une vraie inférence coûte peu côté inférence, environ 5 % à 9 % du débit, mais rapporte peu côté minage : le plug-in de Pearl ne mine que sur de longs lots de préremplissage, si bien qu’une carte qui sert une charge conversationnelle conserve environ 5 % du hashrate d’un mineur dédié. Les mineurs rationnels multiplient donc des matrices aléatoires, et le protocole ne peut pas faire la différence. L’unique partenariat d’inférence public n’est plus proposé sur l’API serverless de son fournisseur. L’utilité de Pearl est un problème commercial hors chaîne : quelqu’un doit payer pour l’inférence.
Les règles sont l’autre risque. De juin à août, le laboratoire a activé quatre changements de consensus à des hauteurs codées en dur, et son projet PIP-3 fait passer le minage au FP8 avec des profils de dispositif exacts au bit près pour seulement deux architectures NVIDIA. Un format numérique peut être utile pour l’IA, vérifiable au bit près et neutre vis-à-vis du matériel, mais au plus deux des trois.
Dans l’IA × crypto : la subvention est un carburant, pas un modèle économique
Les autres chaînes à travail utile racontent la même histoire. Kaspa a placé un produit matriciel dans son hachage et a quand même vu arriver des ASIC en 16 mois ; sa meilleure machine rapporte aujourd’hui 0,86 dollar par jour. Le puzzle de preuve synthétique d’Aleo a eu son matériel dédié en cinq mois et a versé aux prouveurs 175–180 fois ses frais. Bittensor est le seul réseau du groupe à disposer de revenus externes à grande échelle, environ 70 millions de dollars par an, face à plus de 300 millions de dollars d’émissions.
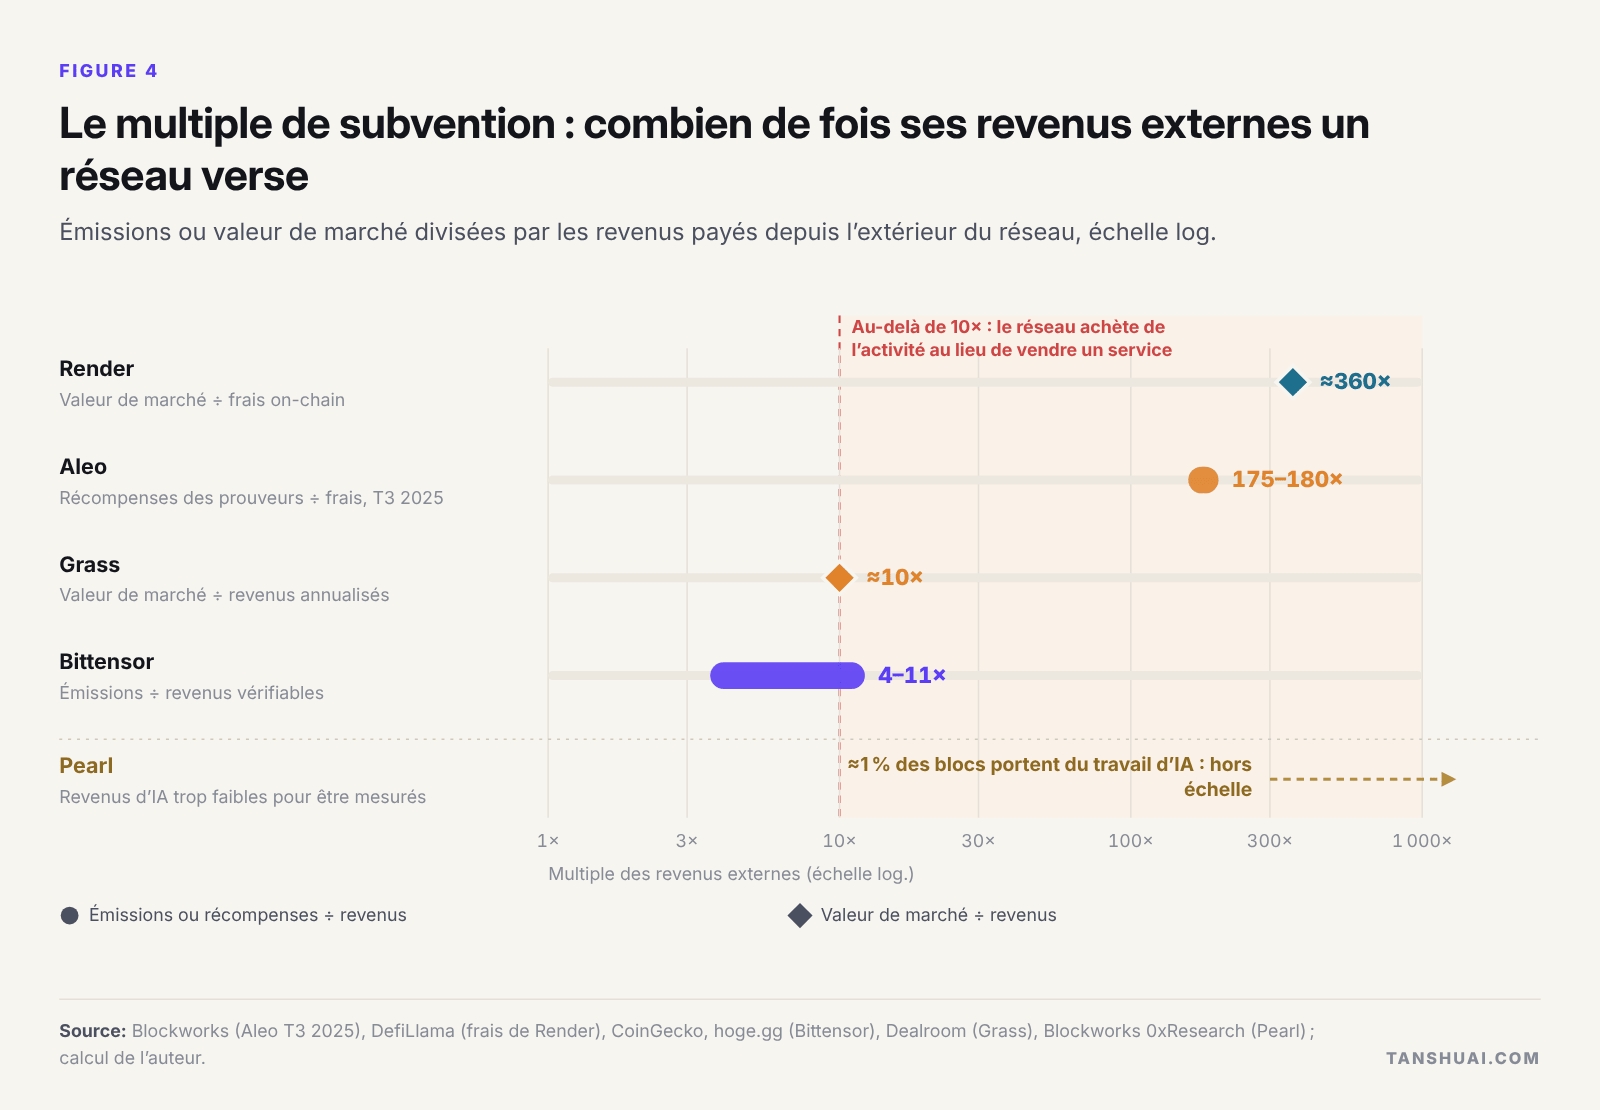 Figure 4. Le multiple de subvention : combien de fois ses revenus externes un réseau verse.
Au-delà du consensus, le tableau est celui d’une demande réelle à petite échelle. Les marchés de GPU décentralisés vendent de l’inférence banalisée et battent les prix des hyperscalers, mais pas ceux des néoclouds les moins chers. L’entraînement via Internet fonctionne entre 8 et 40 milliards de paramètres, alors que les entraînements de frontière sont revenus aux clusters centralisés. Les environnements d’exécution de confiance font tourner de l’inférence confidentielle en production ; les preuves d’IA à divulgation nulle de connaissance sont encore au laboratoire. Les paiements initiés par des agents d’IA représentent environ 5 000–11 000 dollars par mois, malgré des rails construits par Visa, Mastercard, Stripe et Google. Les données sont l’un des rares secteurs à avoir de vrais acheteurs. Pendant ce temps, quatre sociétés par actions sur infrastructure centralisée valent à peu près autant que l’ensemble des tokens d’IA des couches protocole et application : la crypto assure la distribution et le règlement, les actions captent les profits.
Quand un ASIC est rentable : une formule, trois critères
Quand les GPU fixent le prix du minage, le revenu par unité de calcul tend vers leur coût, et un ASIC k fois moins coûteux conserve au plus (1 − 1/k) des revenus. La courbe est concave : 50 % à k = 2, 80 % à k = 5, 90 % à k = 10. Au-delà de k = 5, davantage d’efficacité ajoute peu de profit ; et face à des GPU inutilisés qui ne paient que l’électricité, le k effectif n’est peut-être que d’environ 2,5.
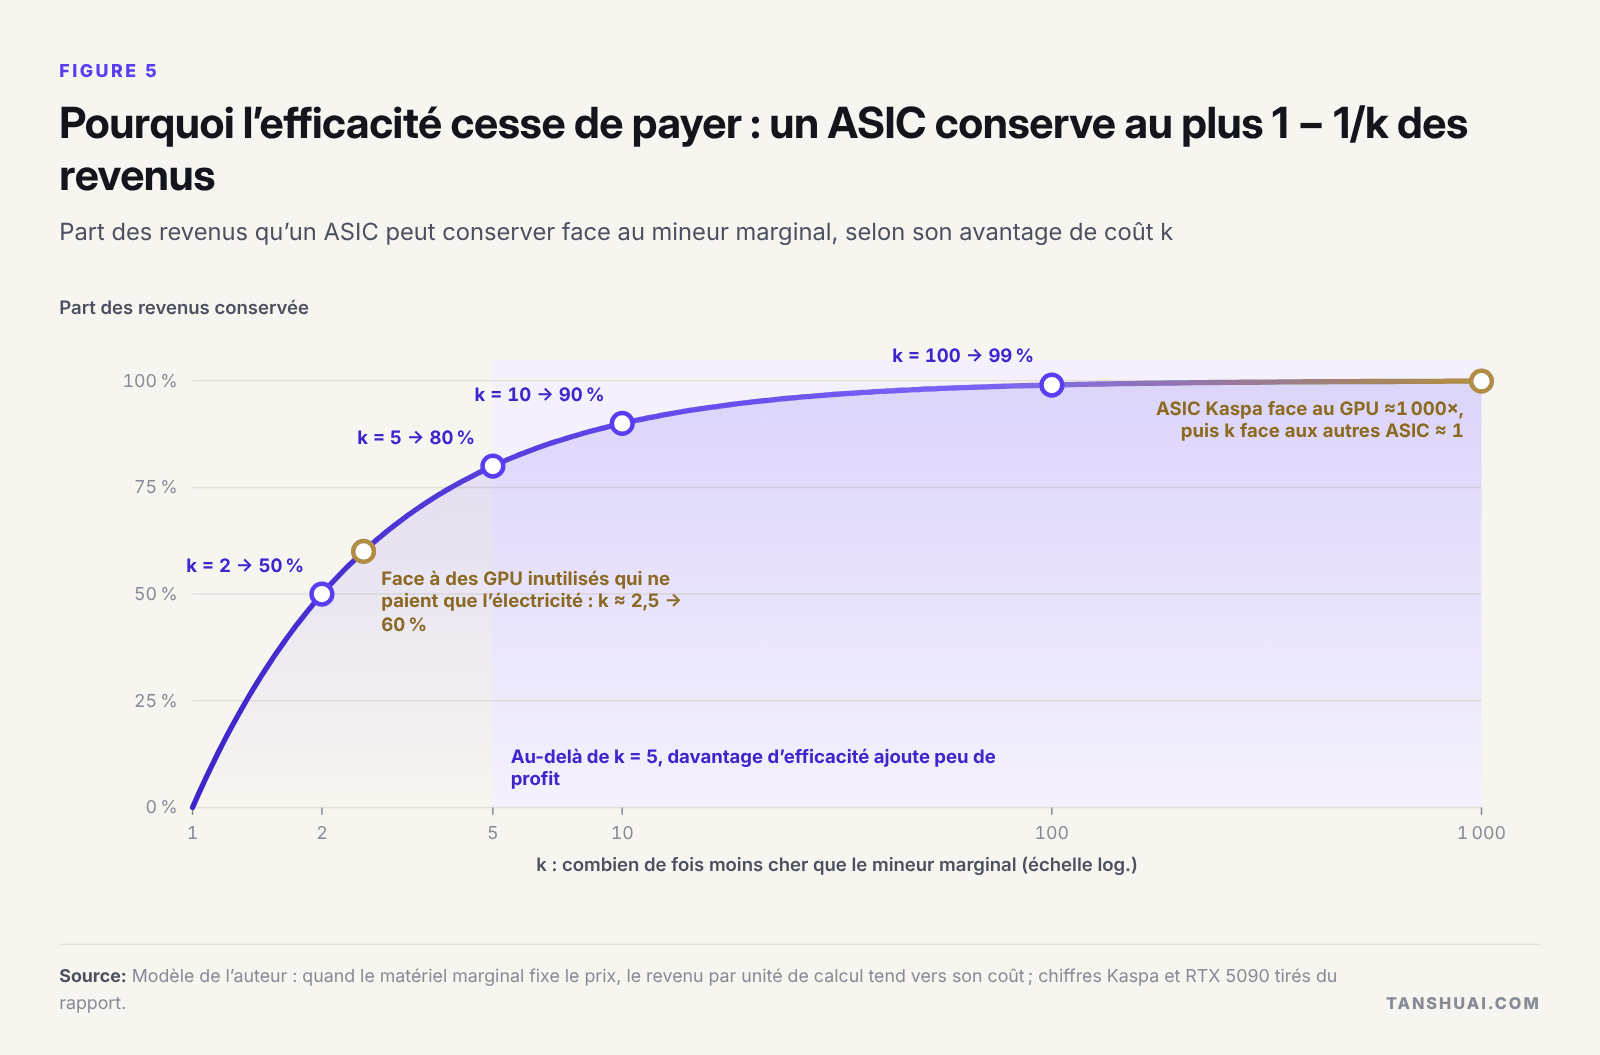 Figure 5. Pourquoi l’efficacité cesse de payer : un ASIC conserve au plus 1 − 1/k des revenus.
Trois critères décident alors : la cagnotte, l’échelle d’amortissement et les règles. Les mineurs de bitcoin gagnent environ 11,5 milliards de dollars par an, ceux de Pearl environ 0,46–0,49 milliard, ceux d’Aleo environ 31 millions et ceux de Kaspa environ 18 millions, moins que le bas de la fourchette de la conception d’une seule puce en 5/4 nm. Pour Pearl, une puce à 20 millions de dollars avec k = 5 a besoin d’environ 4,9 EH/s en fonctionnement pendant un an pour être amortie si les règles tiennent, et du double si elles n’ont qu’une chance sur deux de tenir.
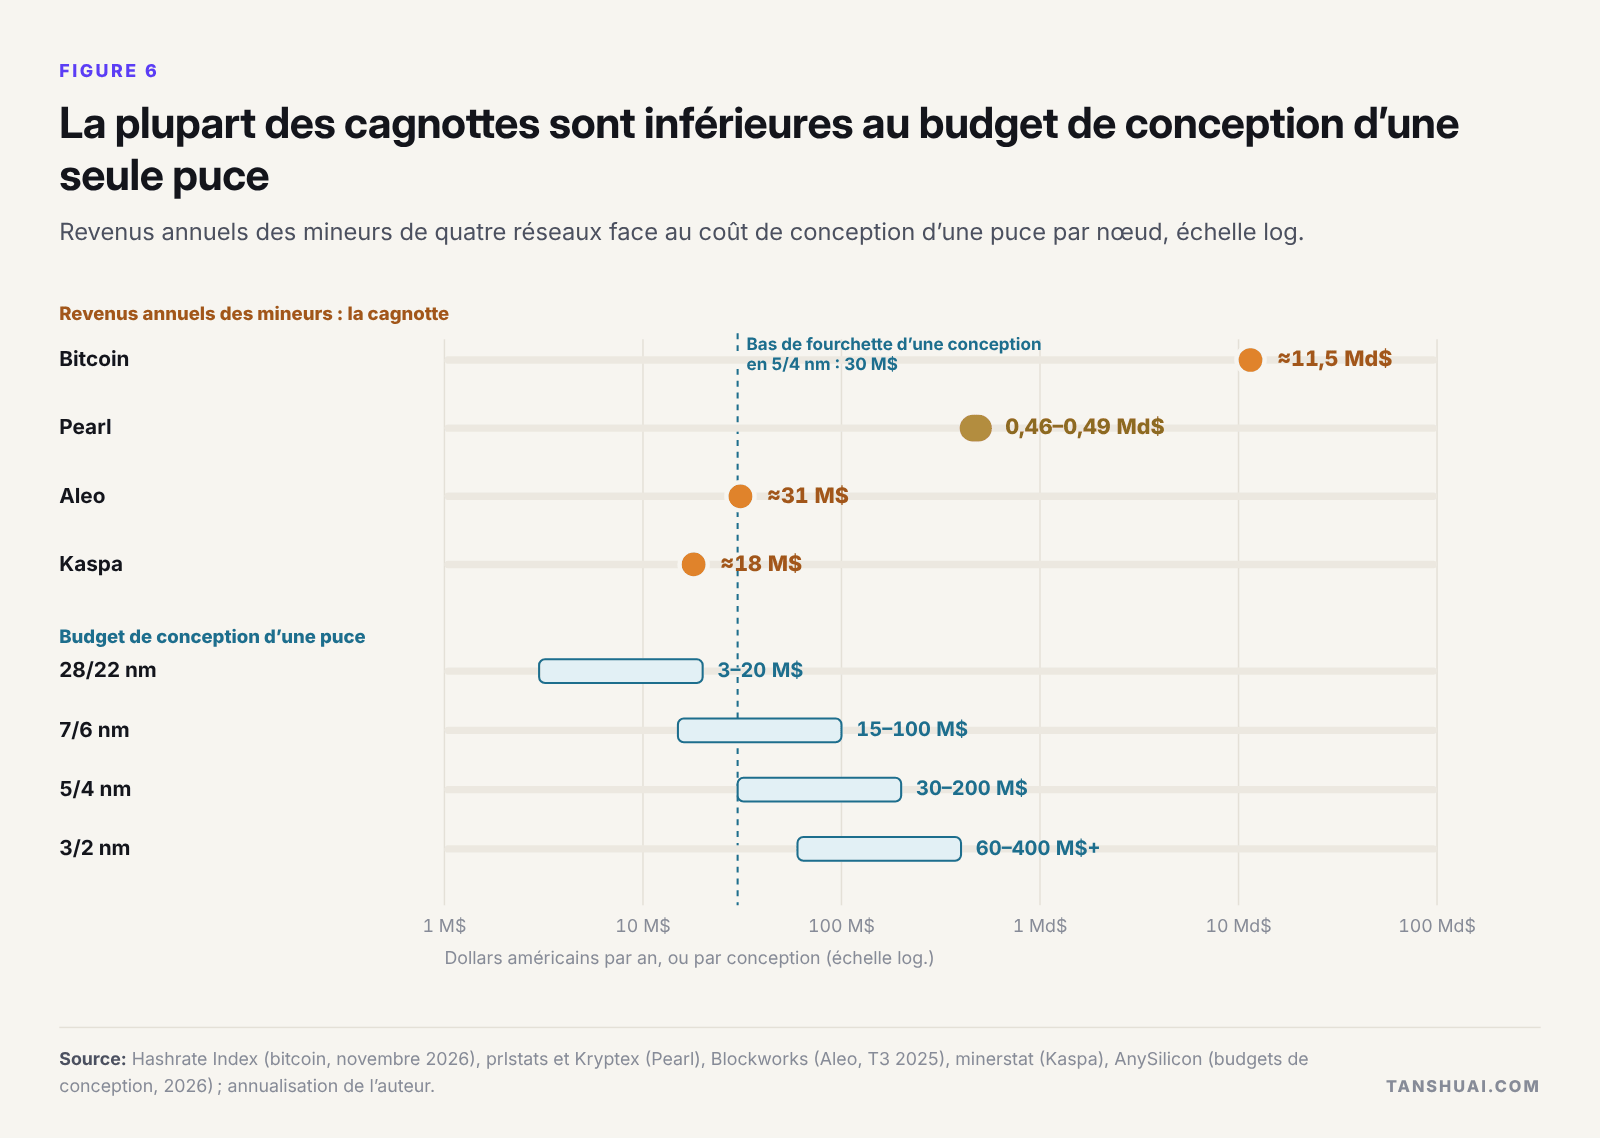 Figure 6. La plupart des cagnottes sont inférieures au budget de conception d’une seule puce.
Aujourd’hui, aucun réseau n’offre à la fois une grande cagnotte, des règles stables et un k supérieur à 1 : le k du bitcoin appartient aux acteurs établis, les règles de Pearl sont les moins stables, et les cagnottes de Kaspa et d’Aleo sont trop petites.
Cinq types de puces, cinq réponses
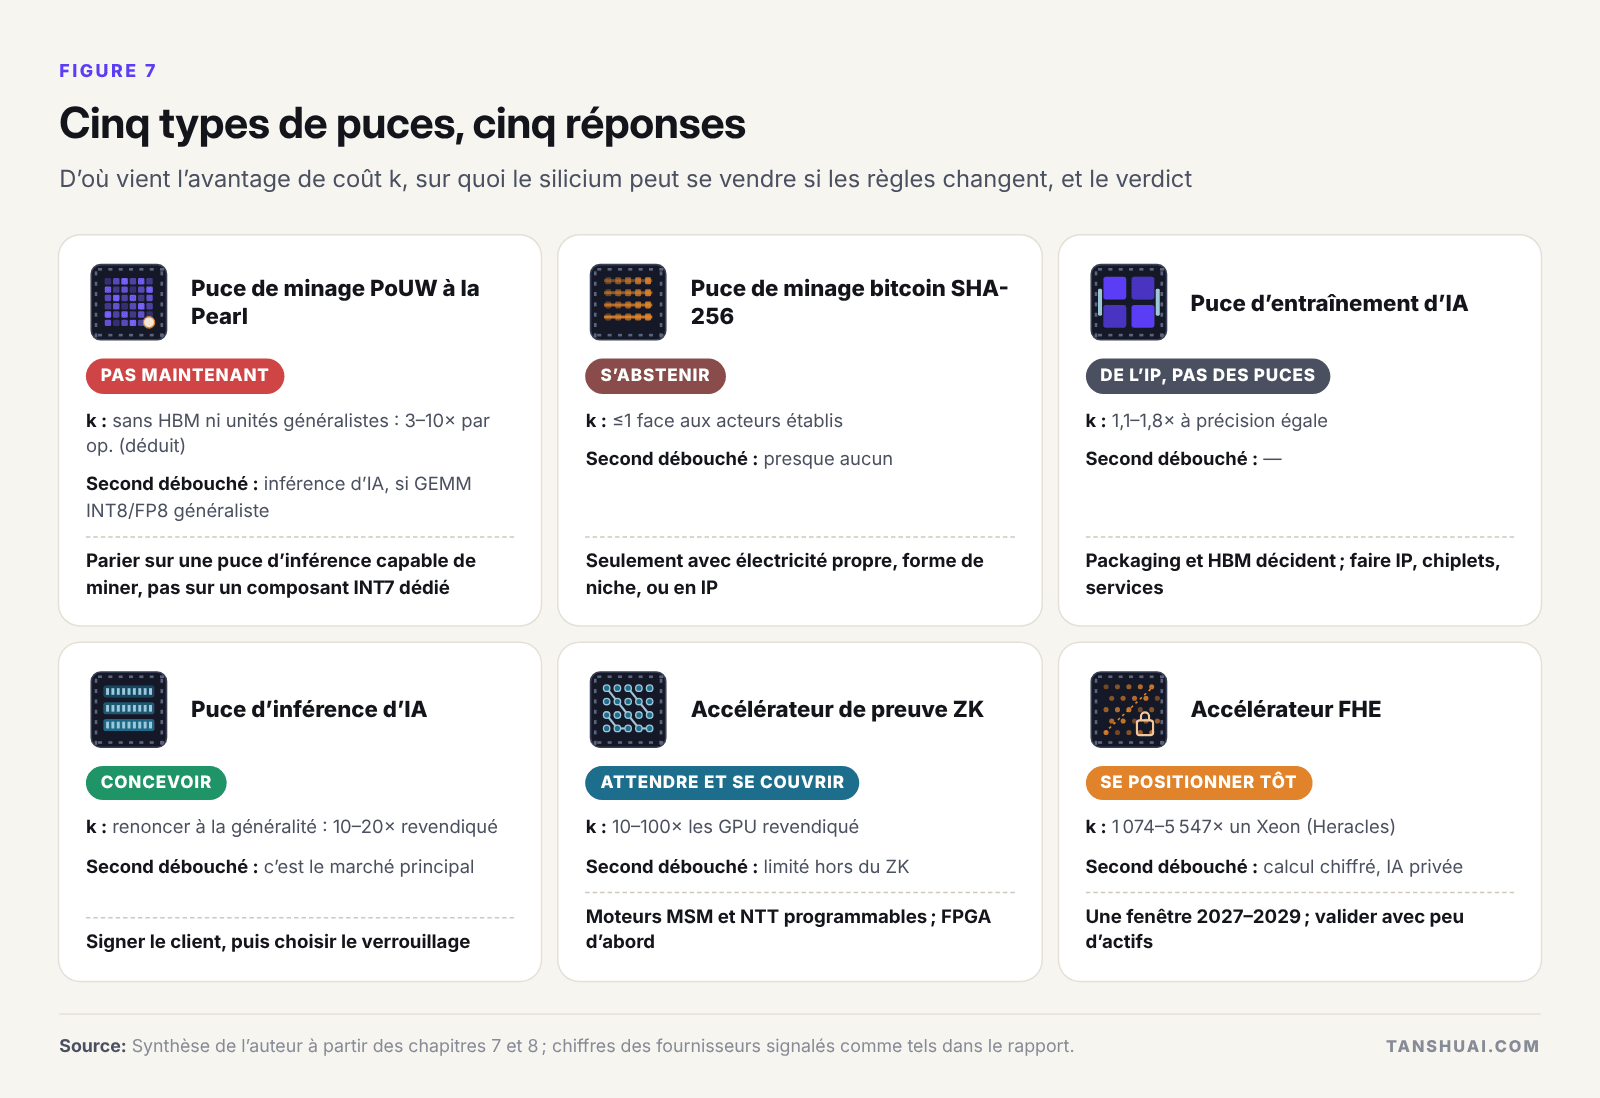 Figure 7. Cinq types de puces, cinq réponses.
Pour Pearl, je ne lancerais pas maintenant le tape-out d’une puce INT7 dédiée : une nouvelle équipe a besoin de 18 à 24 mois, et le protocole sera peut-être passé au FP8 d’ici là. Le meilleur pari est un accélérateur conçu d’abord pour l’inférence, bâti sur un GEMM INT8/FP8 généraliste avec des opérandes en SRAM, afin que le silicium dispose d’un second débouché si l’accès au minage est fermé. Une nouvelle équipe doit rester à l’écart du marché ouvert des machines de minage bitcoin, où Bitmain livre des machines à 8,9 J/TH et où les challengers battent en retraite ; les sites électriques valent désormais davantage comme centres de données d’IA que comme mines. Les petites équipes ne doivent pas concevoir de puces d’entraînement autonomes. Les puces d’inférence valent la peine d’être conçues pour un client signé, les accélérateurs ZK sont une couverture, et les accélérateurs FHE un positionnement précoce pour 2027–2029.
Nœuds de gravure et budget par étapes
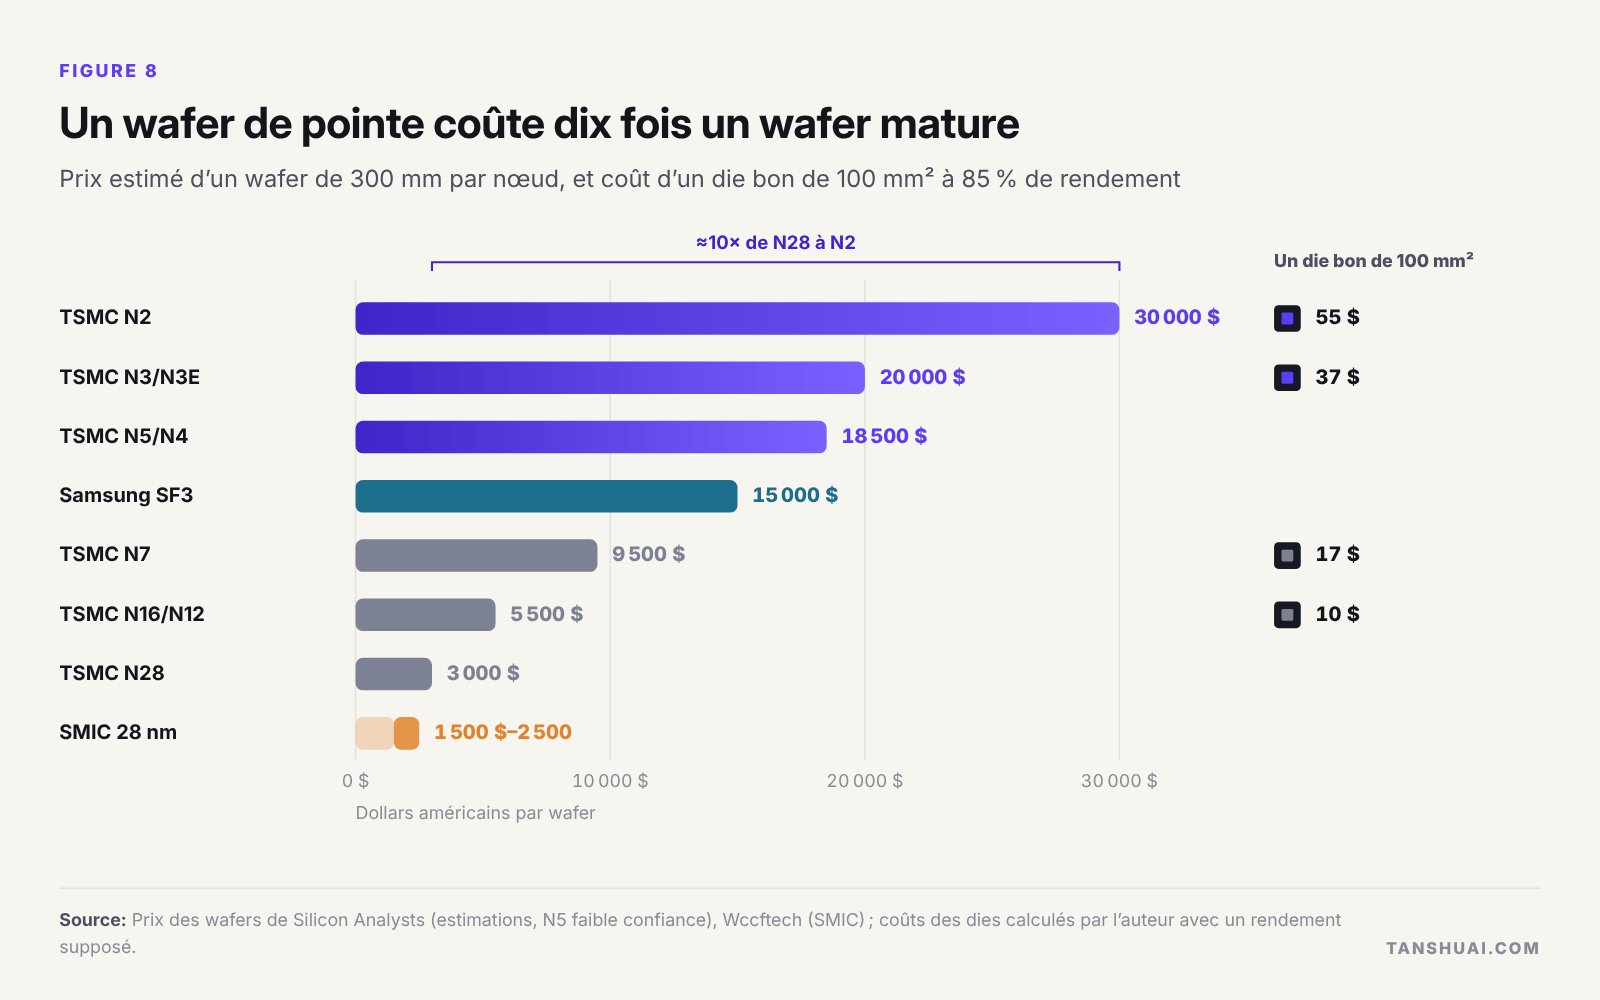 Figure 8. Un wafer de pointe coûte dix fois un wafer mature.
Laissez le poste le plus lourd du coût de la puce sur sa durée de vie choisir le nœud : l’énergie pour les puces de calcul qui tournent en continu, le packaging et la HBM pour les puces d’entraînement (environ 63 % du coût d’un H100), et le choix entre SRAM et HBM pour les puces d’inférence. Une puce de minage PoUW peut être prototypée sur des wafers multiprojets en 28 ou 16/12 nm, puis passer en N7/N6 et enfin en N5/N4 seulement une fois l’algorithme et les revenus stabilisés.
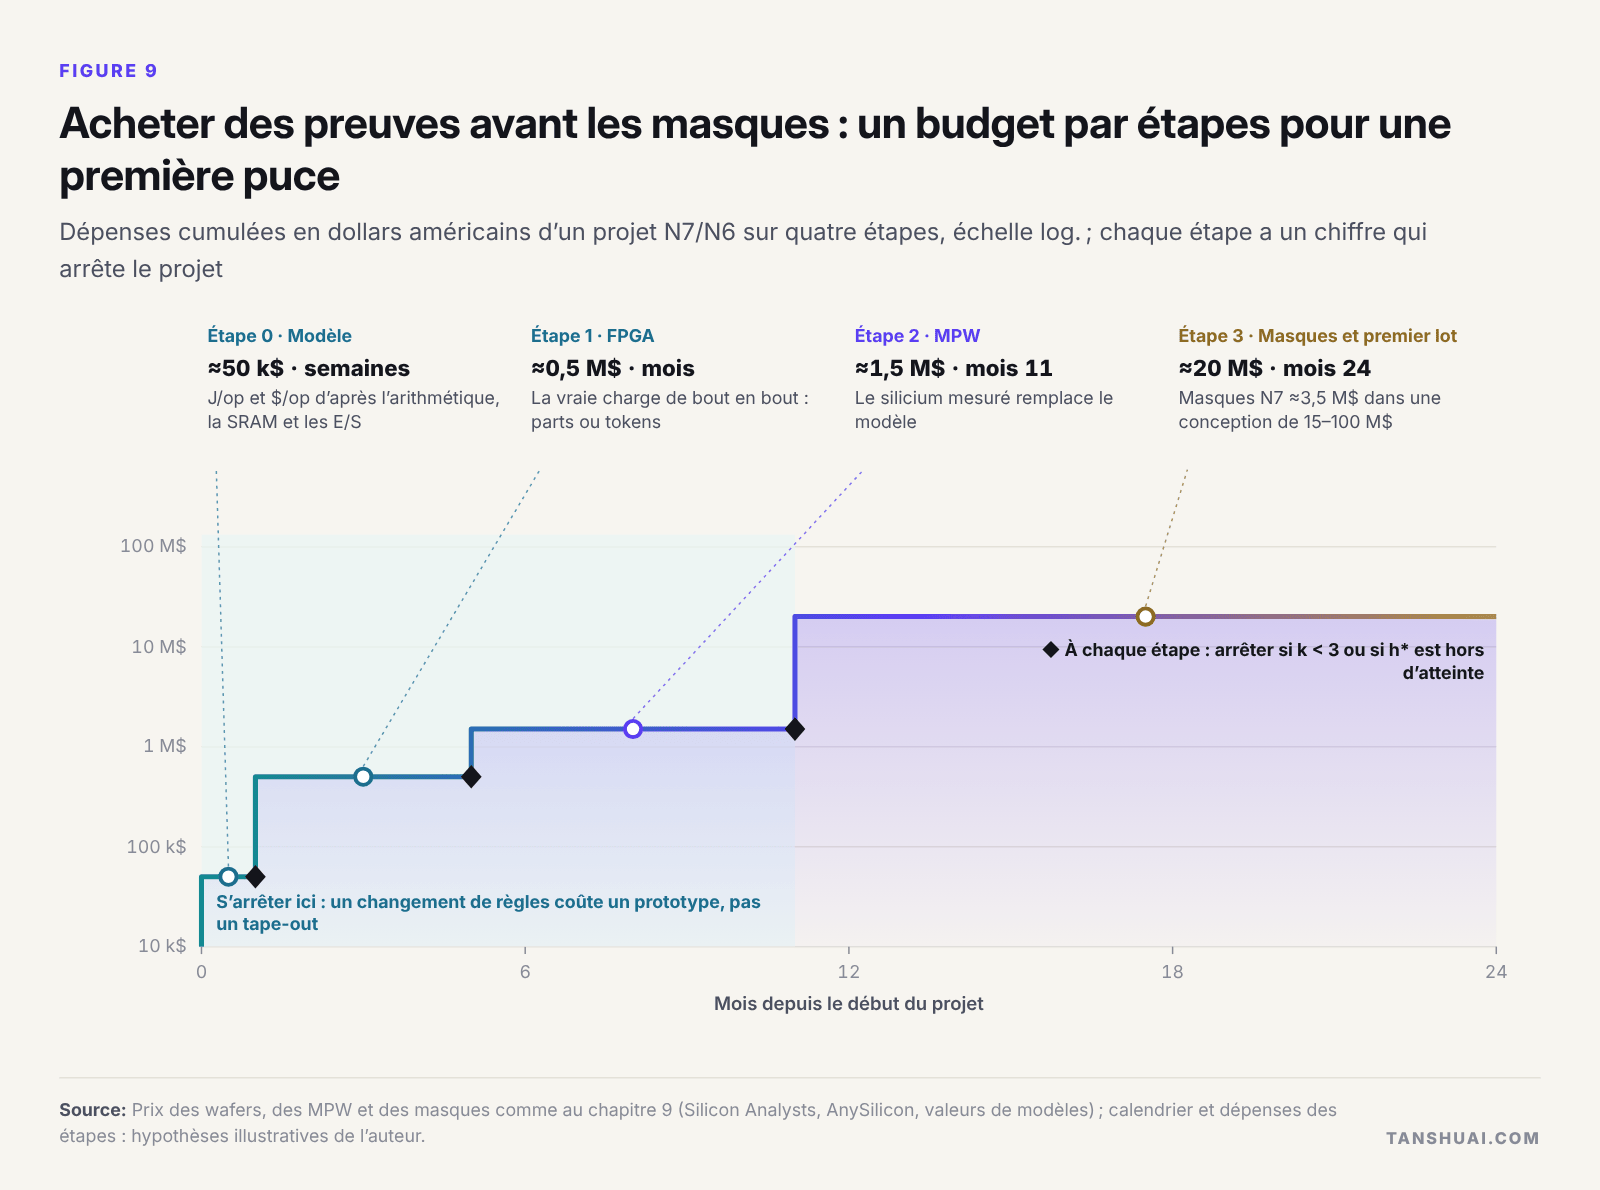 Figure 9. Acheter des preuves avant les masques : un budget par étapes pour une première puce.
Une première puce doit s’acheter en quatre étapes, chacune assortie d’un chiffre qui arrête le projet : un modèle de J/op et de $/op, un FPGA exécutant la vraie charge, un wafer multiprojet, et seulement ensuite un jeu de masques. En N7/N6, les trois premières coûtent environ 1,5 million de dollars et onze mois ; le jeu de masques et le premier lot coûtent plus de dix fois plus [estimation]. Si le protocole change son arithmétique ou si l’acheteur se retire, une équipe qui s’est arrêtée au wafer perd le prix d’un prototype, et non celui d’un tape-out. L’efficacité la moins chère est architecturale : garder les opérandes en SRAM et se passer de HBM supprime l’essentiel du coût d’un GPU avant même le choix d’un nœud.
Par où je commencerais
Les opportunités se trouvent au croisement des domaines : la crypto comme premier client, l’IA comme second débouché. En 2026, la demande de puces sur mesure vient massivement de l’IA, et les compétences d’une équipe de puces de minage, réseaux basse tension, alimentation de classe kilowatt et tape-outs rapides, se transfèrent directement. Je suivrais au plus trois voies, chacune testée par un petit premier pas : un accélérateur conçu d’abord pour l’inférence et capable de miner, en commençant par une étude J/op et $/op de quatre semaines ; des services de silicium sur mesure avec la crypto comme premier client, en commençant par des études de faisabilité payantes ; et un réseau natif IA qui signe son acheteur de calcul avant de concevoir son token.
Télécharger le rapport complet et les diapositives
Le rapport complet couvre en détail le mécanisme, l’économie et les règles de Pearl, les autres chaînes à travail utile et le paysage plus large de l’IA × crypto, le modèle des ASIC avec son calcul d’amortissement, les verdicts puce par puce, les coûts et les choix de nœuds, un budget par étapes pour une première puce, une liste de jalons et toutes les sources.
- Le calcul comme consensus : rapport complet (PDF)
- Le calcul comme consensus : diapositives (PDF)
- Édition anglaise : rapport complet · diapositives
Ceci est une traduction de l’édition anglaise ; en cas de divergence, l’édition anglaise fait foi.
Les questions que vous n’avez pas posées, mais auriez dû poser
Avant de mettre de l’argent ou du silicium dans un projet IA × crypto, je demanderais : qui contrôle la fonction de travail ; quel est le multiple de subvention ; ce que coûte la prochaine étape et quel chiffre vous arrête ; quel est le hashrate d’amortissement, avec p ; quel est le second débouché de la puce ; si la valeur va au token ou aux actions ; et qui est le premier client payant, nommément.
Ce sont des domaines que nous pouvons explorer ensemble, par l’échange technique et la collaboration technique : puces sur mesure pour le minage, l’entraînement et l’inférence d’IA, et accélérateurs ; développement d’IA ; et systèmes IA × crypto, de la chaîne au nœud et à la puce. Vous pouvez me joindre à i@tanshuai.com.
À propos de l’auteur
Tan Shuai est technologue et fondateur, avec plus de vingt ans de travail couvrant les puces, le matériel et le logiciel système, et 20 brevets délivrés. Il a derrière lui de nombreuses années de R&D et de direction dans la conception de puces fabless, notamment la conception full-custom de chemins de données ASIC pour des puces de minage de cryptomonnaies et des puces de caméra multimédia. Son parcours l’a mené dans la Silicon Valley, à New York, à Chicago, à Taïwan, dans la région de la Grande Baie (Shenzhen et Hong Kong), au Vietnam et en Malaisie. Il travaille aujourd’hui comme chercheur et développeur en IA.
Échanges techniques : i@tanshuai.com.