
Una blockchain oggi gira sulla stessa moltiplicazione di matrici dell’AI, a circa 90 EH/s. Ne ho letto il codice, i dati on-chain e l’economia che le sta intorno per rispondere a tre domande: che cosa, nel campo AI × crypto, ha clienti paganti, quando vale la pena costruire un ASIC e quale nodo di processo si adatta a quale chip. Con il rapporto completo e le slide.
Sintesi
Pearl, lanciata nell’aprile 2026, è la prima blockchain la cui proof of work è una moltiplicazione di matrici in stile AI su larga scala. Il 13 novembre 2026 la sua rete girava a circa 90 EH/s, dove un H è una moltiplicazione-accumulo INT7: il throughput intero di circa 122.000 H100. Come ingegneria funziona. Utile non lo è ancora: circa l’1% dei blocchi contiene lavoro di AI reale, perché una GPU che mina mentre serve inferenza conserva solo dall’1% al 27% dell’hashrate di un miner dedicato. In tutto il campo AI × crypto la domanda pagata verificabile compare in tre punti, vendere inferenza, vendere dati e vendere privacy, mentre i sussidi vanno da 4 a 360 volte i ricavi esterni. Quanto ai chip, il tetto di profitto di un ASIC è il ricavo per unità di calcolo per (1 − 1/k), quindi l’efficienza oltre k = 5 aggiunge poco; a decidere sono la dimensione del piatto, la stabilità delle regole e un secondo mercato. Oggi nessuna rete offre tutte e tre le cose. Il nodo di processo giusto lo fissa la voce più grande nel costo di un chip sull’intera vita, e il chip stesso va comprato a tappe, in modo che un cambio di regole costi un prototipo e non un tape-out.
Perché me ne sono occupato
Ho passato molti anni a progettare chip, compresi datapath ASIC full-custom per il mining di criptovalute, e oggi lavoro sull’AI. Quando è comparsa una catena il cui budget di sicurezza è letteralmente prezzato in throughput tensoriale, per uno come me le domande erano ovvie: il lavoro è utile, un chip dedicato vincerebbe, e quanto costerebbe costruirne uno?
Ho letto il codice e le proposte di protocollo di Pearl, i dati della catena da un nodo completo indipendente, documenti societari, articoli di crittografia, architettura dei calcolatori e machine learning, dati sui prezzi di fonderie e fornitori, e la stampa di settore. Ogni numero che segue è aggiornato al 13 novembre 2026, e gli importi sono in dollari USA. Questa nota è il modo in cui ho imparato il campo; la condivido perché altri possano verificarla, usarla e discuterla. Il rapporto completo, con tutte le fonti, è in fondo.
I risultati in breve
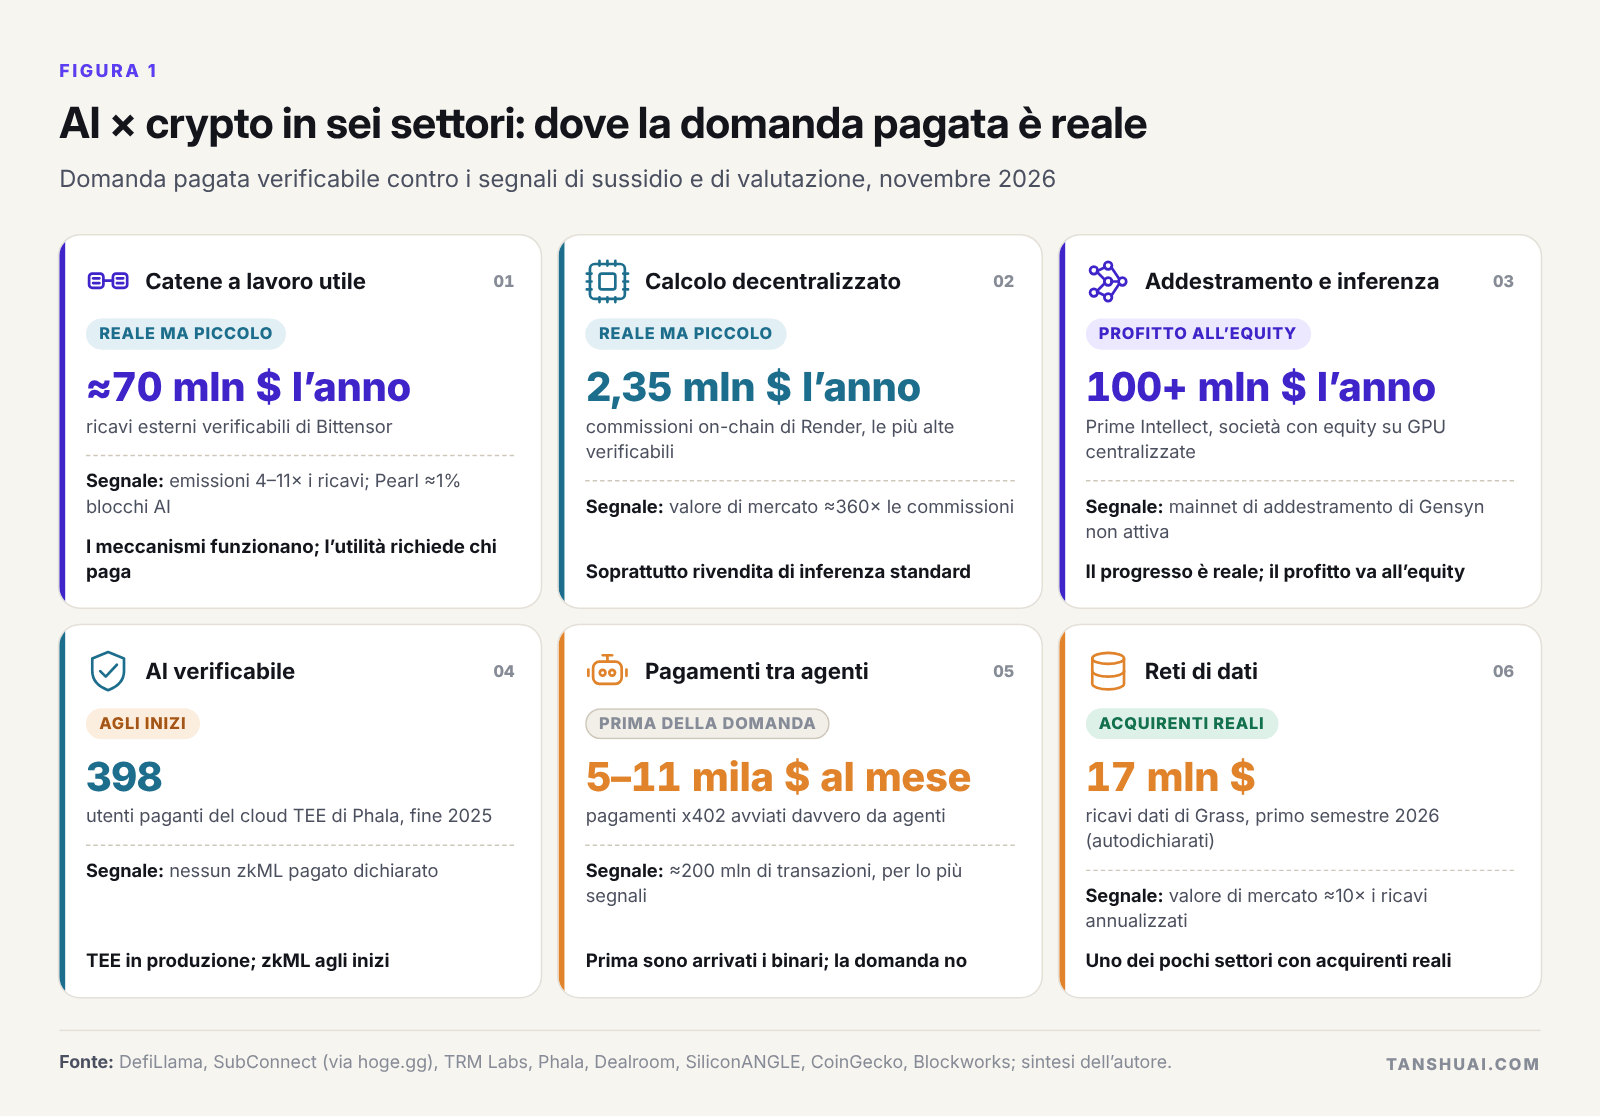 Figura 1. AI × crypto in sei settori: dove la domanda pagata è reale.
| Domanda | Risposta breve |
|---|---|
| Pearl funziona, e il suo lavoro è utile? | Funziona: circa 90 EH/s di moltiplicazione di matrici proteggono la catena. Utile non lo è ancora: circa l’1% dei blocchi contiene lavoro di AI |
| Dov’è la vera domanda pagata? | Inferenza, dati e privacy. Pagamenti tra agenti, zkML e addestramento decentralizzato sono ancora prima della domanda |
| Vale la pena costruire un ASIC? | Solo con un piatto grande, regole stabili e un secondo mercato; oggi nessuna rete offre tutte e tre le cose |
| Quali chip dovrebbe costruire un team piccolo? | Acceleratori pensati per l’inferenza che sanno anche minare, chip di inferenza per un cliente già firmato, lavoro precoce sull’FHE; non miner bitcoin da vendere sul mercato né chip di addestramento |
| Quanto costa un primo chip? | Comprarlo a tappe: un modello, un FPGA e un MPW arrivano al silicio misurato con circa 1,5 milioni di dollari, prima di maschere che costano milioni |
Pearl: una moltiplicazione-accumulo è un hash
Pearl poggia su un risultato del 2025 di Ilan Komargodski e Omri Weinstein: una proof of useful work per qualsiasi prodotto di matrici, a 1 + o(1) volte il costo della moltiplicazione. I miner moltiplicano matrici rumorose, trasformano con un hash l’accumulatore di ogni tile di output in un biglietto della lotteria e provano il tile vincente con una prova a conoscenza zero di meno di 60 KB. Nel codice del consenso un H è una moltiplicazione-accumulo INT7 × INT7 → INT32 accreditata, quindi per la prima volta il budget di sicurezza di una blockchain è prezzato nel throughput tensoriale degli acceleratori AI.
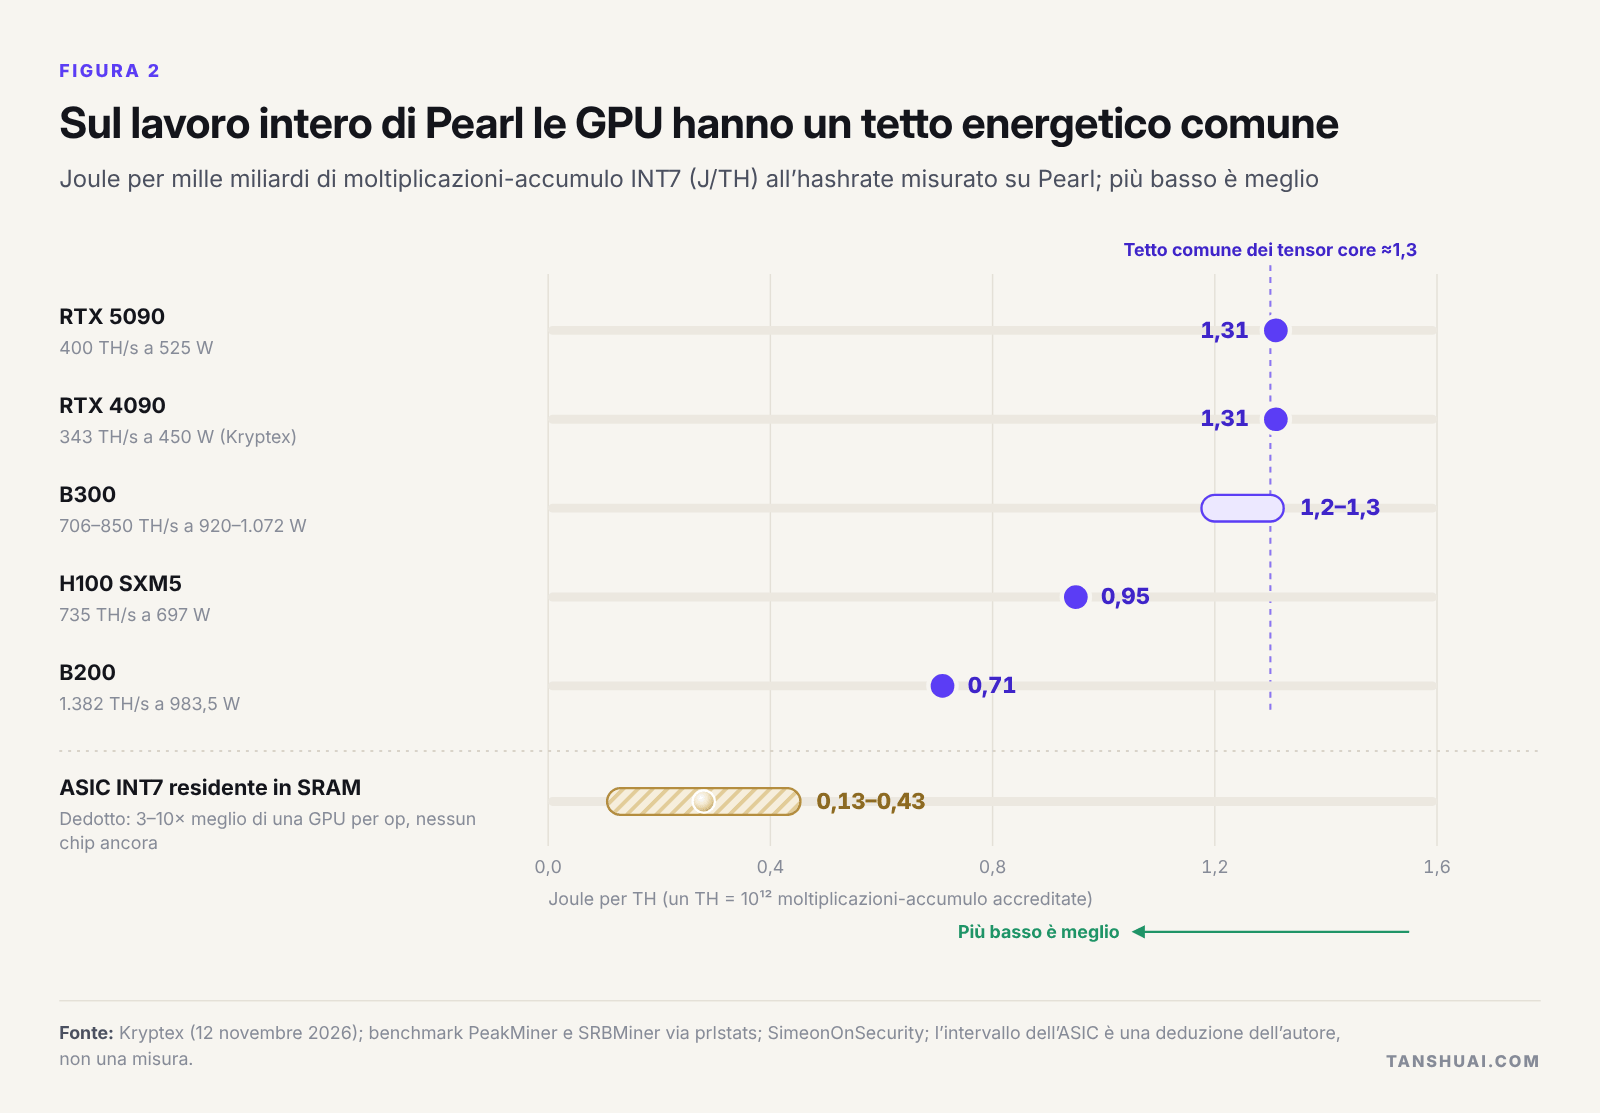 Figura 2. Sul lavoro intero di Pearl le GPU hanno un tetto energetico comune.
Le schede da gaming e la B300 da data center si incontrano a circa 1,3 J/TH, e anche la B200 arriva solo a 0,71. Quel tetto comune è proprio ciò che un chip dedicato potrebbe infrangere: un componente che moltiplica soltanto interi a 7 bit dalla SRAM on-chip, senza HBM né unità generiche, potrebbe plausibilmente fare da 3 a 10 volte meglio per operazione. Nel frattempo NVIDIA sta spostando il suo silicio più recente da INT8 verso FP8 e FP4, ed è per questo che Pearl si prepara a cambiare la propria aritmetica.
L’economia di Pearl: il teorema regge, l’incentivo no
L’hashrate di Pearl segue il suo prezzo. La rete è passata da 0,01 EH/s al secondo giorno a 23–26 EH/s a fine maggio, si è tenuta a 21–39 EH/s durante un’estate in cui il prezzo è sceso di circa l’86%, e ha raggiunto circa 90 EH/s dopo che in autunno il prezzo si è moltiplicato per circa dieci. Circa 120 milioni di monete, all’incirca il 32% dell’offerta attuale, sono state minate nei primi sei giorni, e l’offerta crescerà di circa il 78% nei prossimi 12 mesi. Una RTX 5090 oggi rende circa 5–6 dollari al giorno.
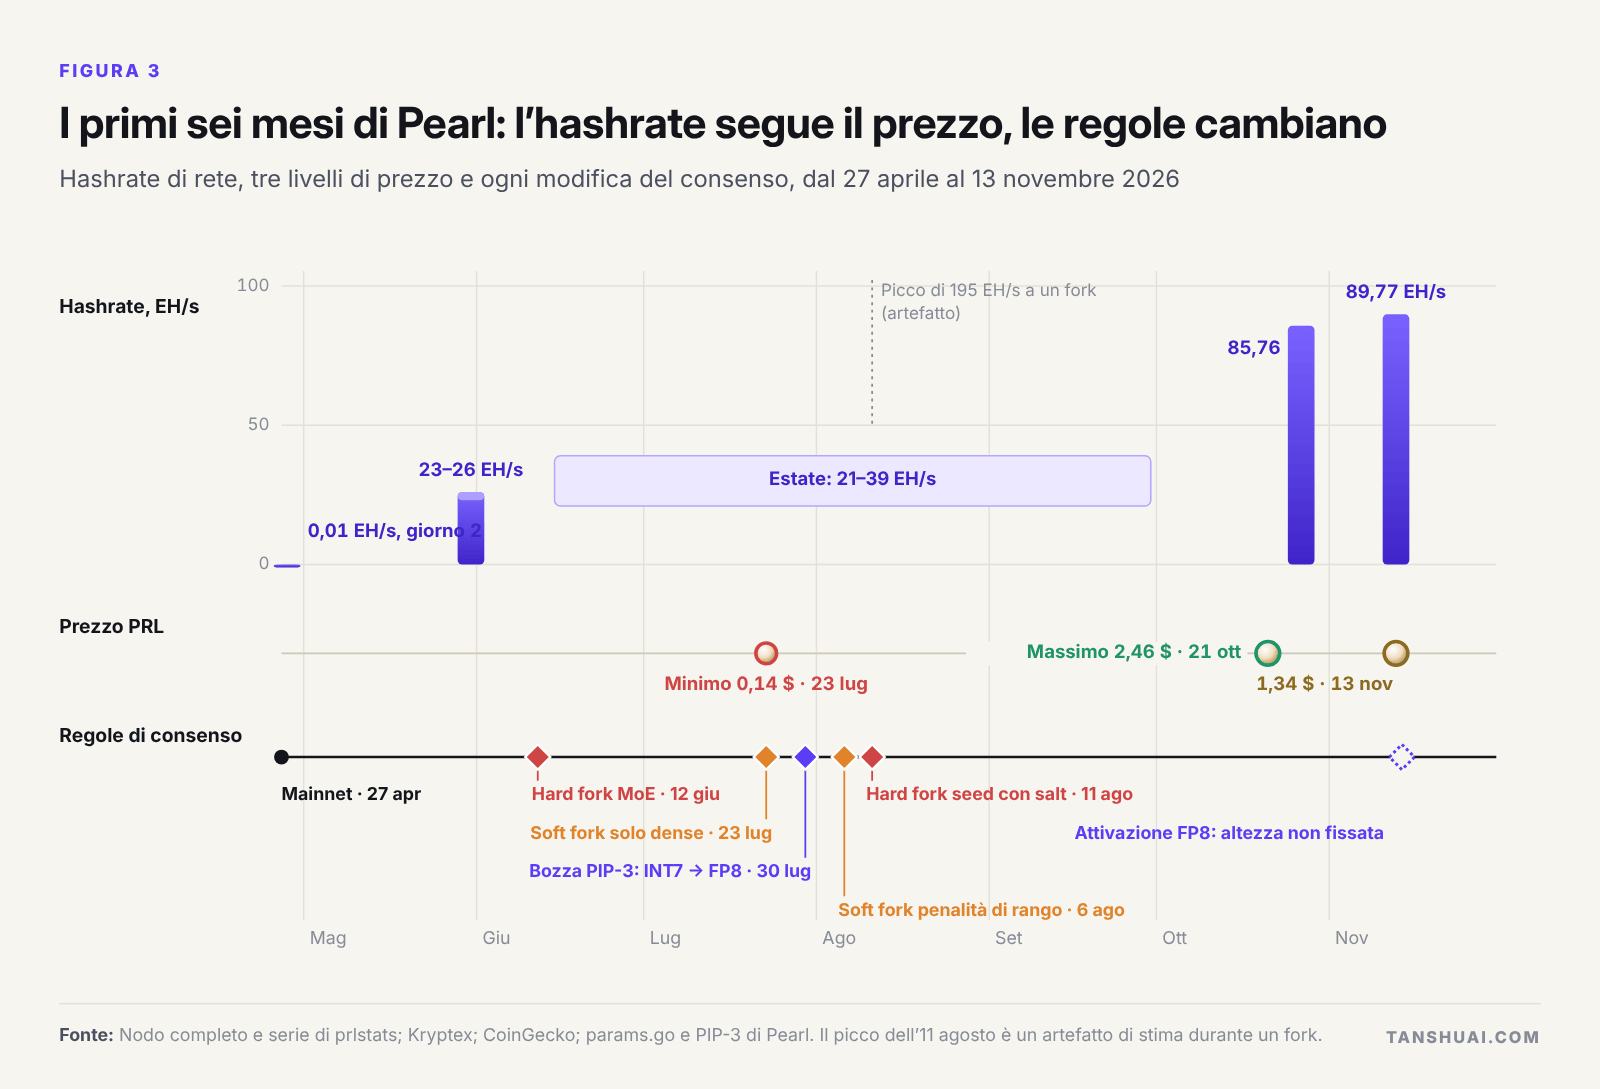 Figura 3. I primi sei mesi di Pearl: l’hashrate segue il prezzo, le regole cambiano.
È sulla parte utile che il modello si rompe. Minare dentro un’inferenza reale costa poco sul lato inferenza, circa dal 5% al 9% del throughput, ma rende poco sul lato mining: il plug-in di Pearl mina solo sui batch lunghi di prefill, quindi una scheda che serve un carico di chat conserva circa il 5% dell’hashrate di un miner dedicato. I miner razionali moltiplicano perciò matrici casuali, e il protocollo non può accorgersene. L’unica partnership pubblica di inferenza non è più sull’API serverless del suo fornitore. L’utilità di Pearl è un problema commerciale fuori catena: qualcuno deve pagare l’inferenza.
Le regole sono l’altro rischio. Tra giugno e agosto il laboratorio ha attivato quattro modifiche del consenso ad altezze fissate nel codice, e la sua bozza PIP-3 sposta il mining su FP8 con profili di dispositivo esatti al bit per due sole architetture NVIDIA. Un formato numerico può essere utile per l’AI, verificabile bit per bit e neutrale rispetto all’hardware, ma al massimo due di queste tre cose.
In tutto il campo AI × crypto: il sussidio è carburante, non un modello di business
Le altre catene a lavoro utile raccontano la stessa storia. Kaspa ha messo un prodotto di matrici dentro il suo hash e ha avuto comunque gli ASIC entro 16 mesi; la sua macchina migliore oggi rende 0,86 dollari al giorno. Il puzzle di prova sintetico di Aleo ha avuto hardware dedicato in cinque mesi e ha pagato ai prover 175–180 volte le sue commissioni. Bittensor è l’unica rete del gruppo con ricavi esterni su scala, circa 70 milioni di dollari l’anno, contro più di 300 milioni di emissioni.
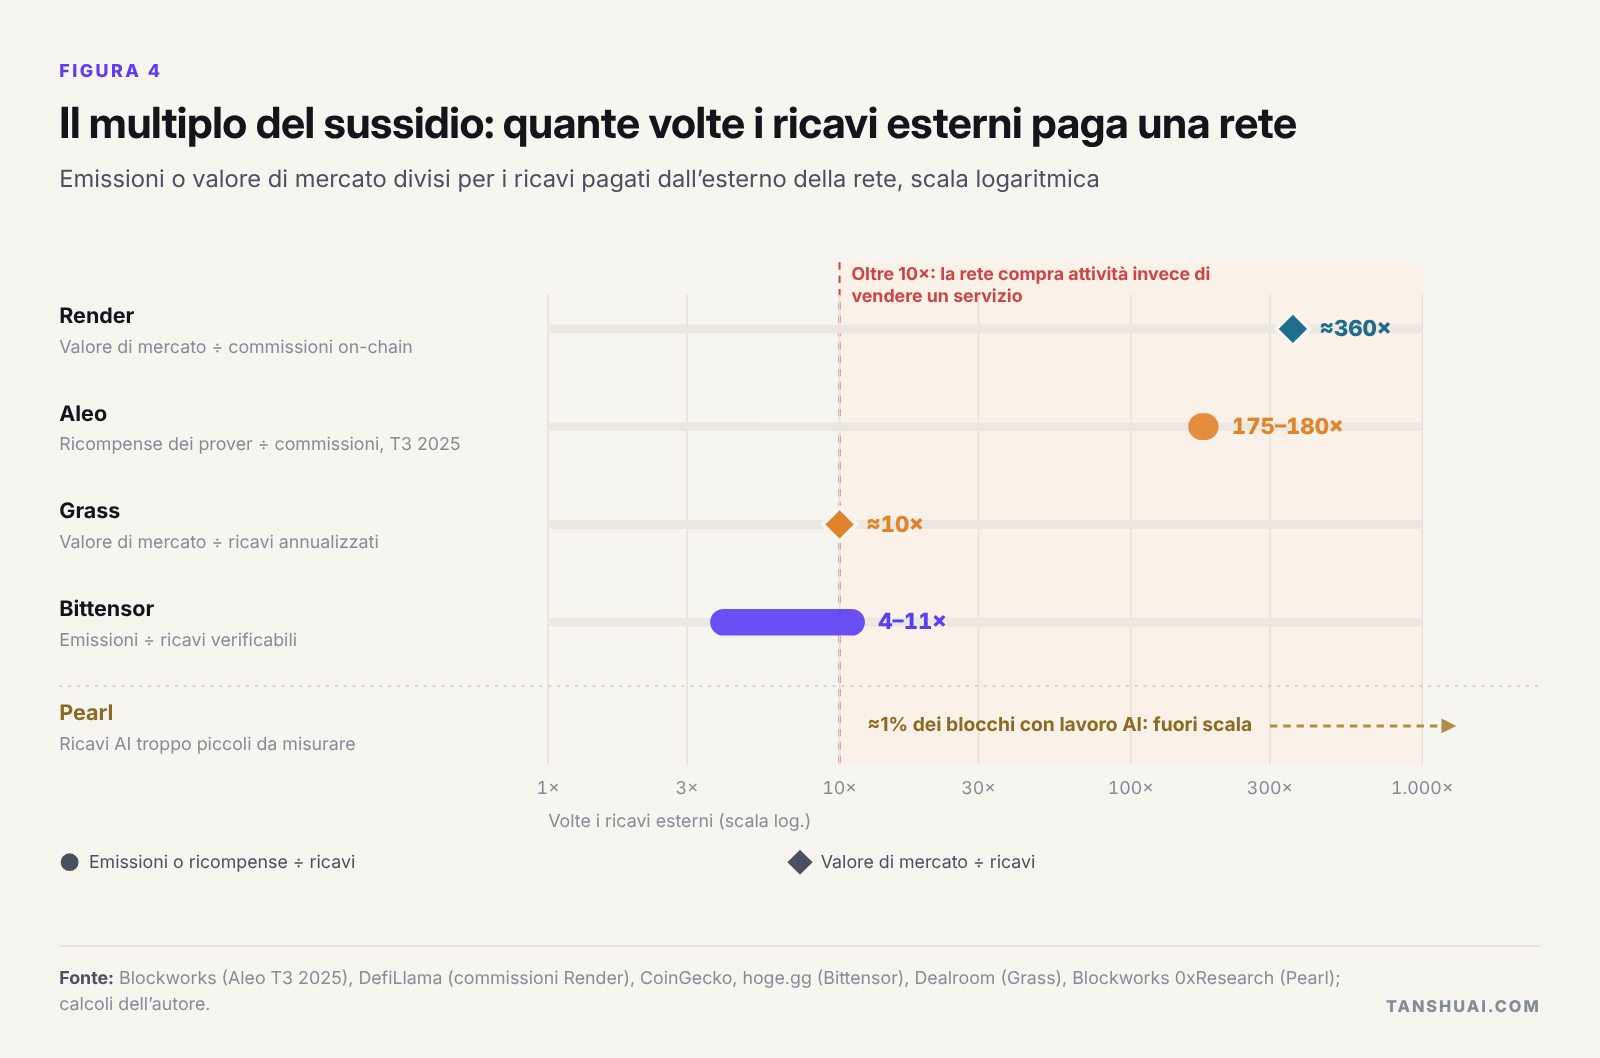 Figura 4. Il multiplo del sussidio: quante volte i ricavi esterni paga una rete.
Oltre il consenso, il quadro è di domanda reale su piccola scala. I mercati decentralizzati di GPU vendono inferenza standard e battono i prezzi degli hyperscaler ma non quelli dei neocloud più economici. L’addestramento via internet funziona tra 8 e 40 miliardi di parametri, mentre le esecuzioni di frontiera sono tornate ai cluster centralizzati. Gli ambienti di esecuzione affidabili (TEE) fanno girare inferenza riservata in produzione; le prove a conoscenza zero dell’AI sono ancora in laboratorio. I pagamenti avviati da agenti AI arrivano a circa 5.000–11.000 dollari al mese nonostante i binari costruiti da Visa, Mastercard, Stripe e Google. I dati sono uno dei pochi settori con acquirenti reali. Nel frattempo quattro società con equity su infrastruttura centralizzata valgono più o meno quanto tutti i token AI dei livelli protocollo e applicazione messi insieme: la crypto fa distribuzione e regolamento, e i profitti vanno all’equity.
Quando un ASIC ripaga: una formula, tre metri di misura
Quando sono le GPU a fare il prezzo del mining, il ricavo per unità di calcolo tende al loro costo, e un ASIC k volte più economico trattiene al massimo (1 − 1/k) dei ricavi. La curva è concava: 50% a k = 2, 80% a k = 5, 90% a k = 10. Oltre k = 5, più efficienza aggiunge poco profitto; e contro GPU inattive che pagano solo l’elettricità, il k effettivo può essere di appena 2,5 circa.
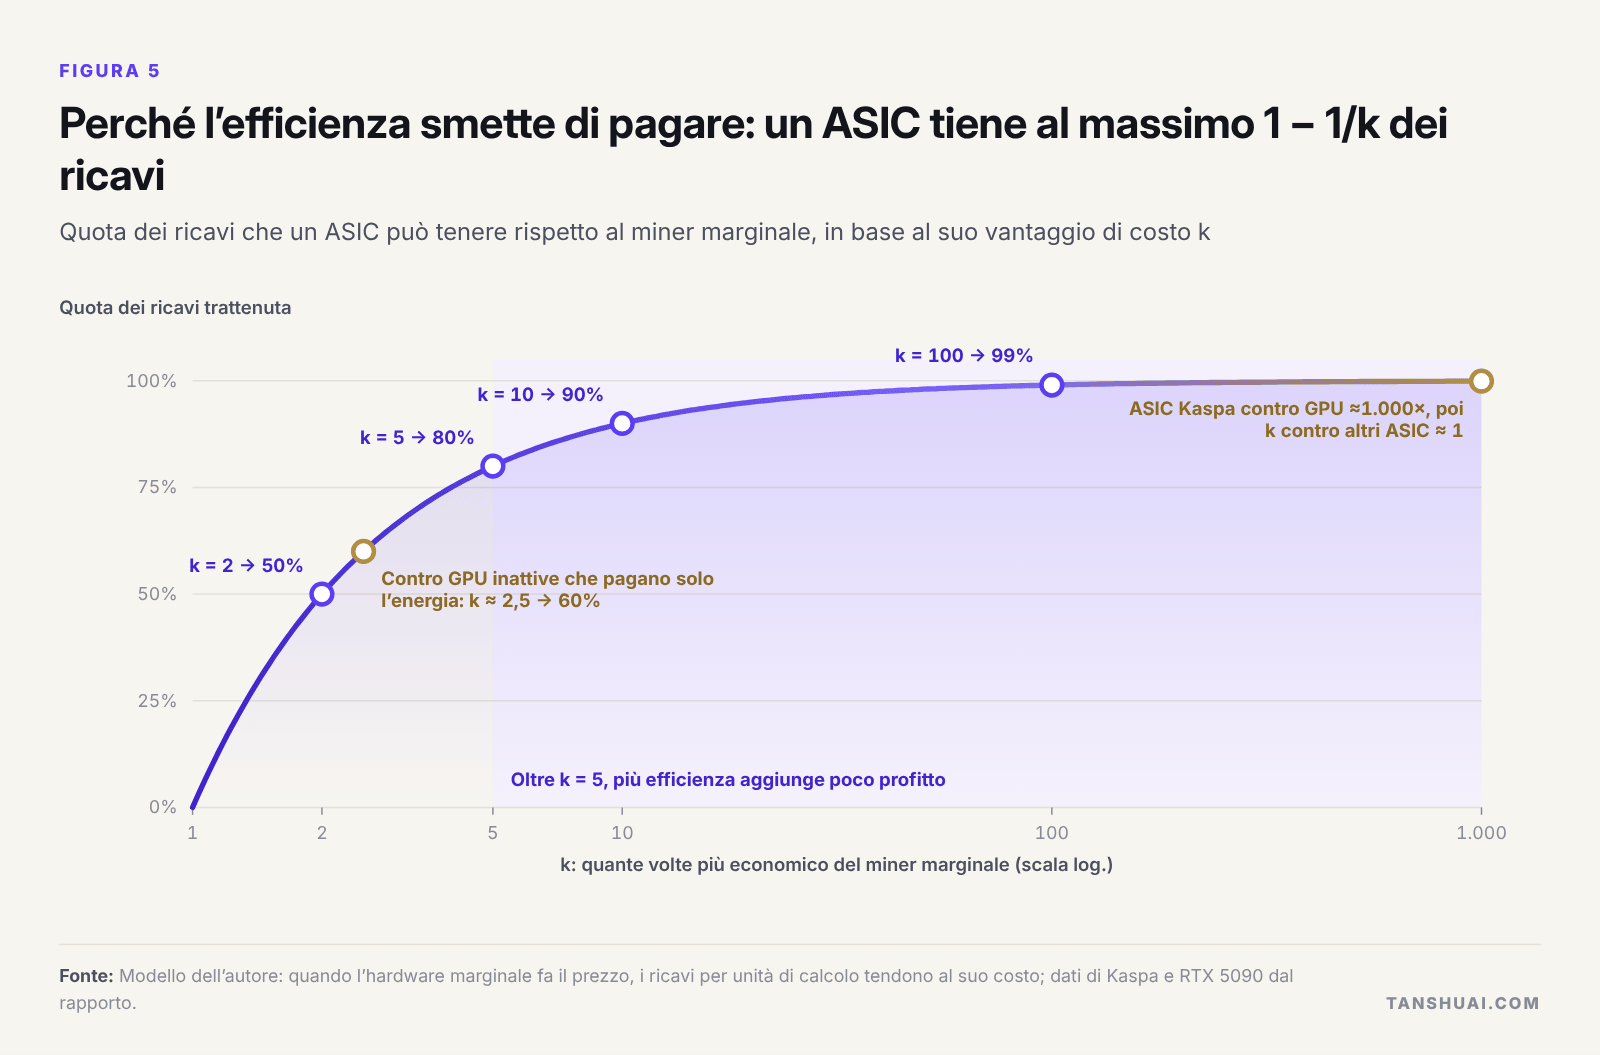 Figura 5. Perché l’efficienza smette di pagare: un ASIC tiene al massimo 1 − 1/k dei ricavi.
A quel punto decidono tre metri di misura: il piatto, la scala di rientro e le regole. I miner di Bitcoin guadagnano circa 11,5 miliardi di dollari l’anno, quelli di Pearl circa 0,46–0,49 miliardi, quelli di Aleo circa 31 milioni e quelli di Kaspa circa 18 milioni, meno della fascia bassa di un singolo progetto di chip a 5/4 nm. Per Pearl, un chip da 20 milioni di dollari con k = 5 ha bisogno di circa 4,9 EH/s in funzione per un anno per rientrare se le regole reggono, e del doppio se reggono solo con probabilità pari.
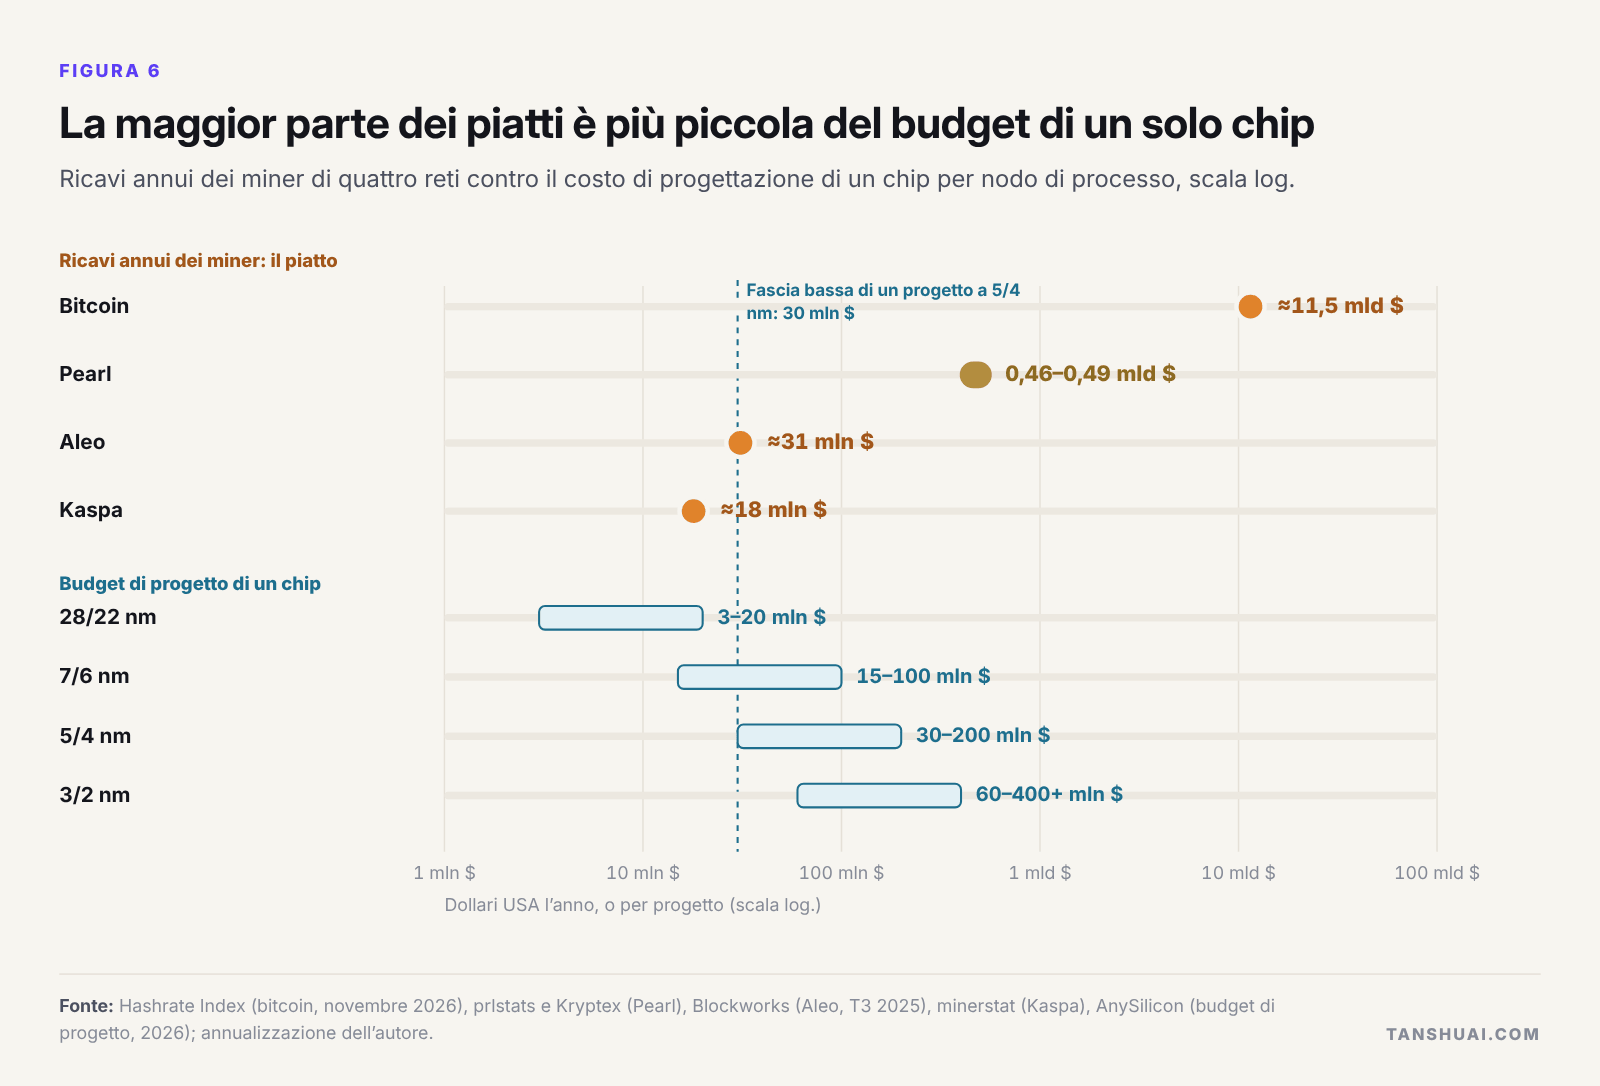 Figura 6. La maggior parte dei piatti è più piccola del budget di un solo chip.
Oggi nessuna rete offre allo stesso tempo un piatto grande, regole stabili e k sopra 1: il k di bitcoin appartiene agli operatori affermati, le regole di Pearl sono le meno stabili, e i piatti di Kaspa e Aleo sono troppo piccoli.
Cinque tipi di chip, cinque risposte
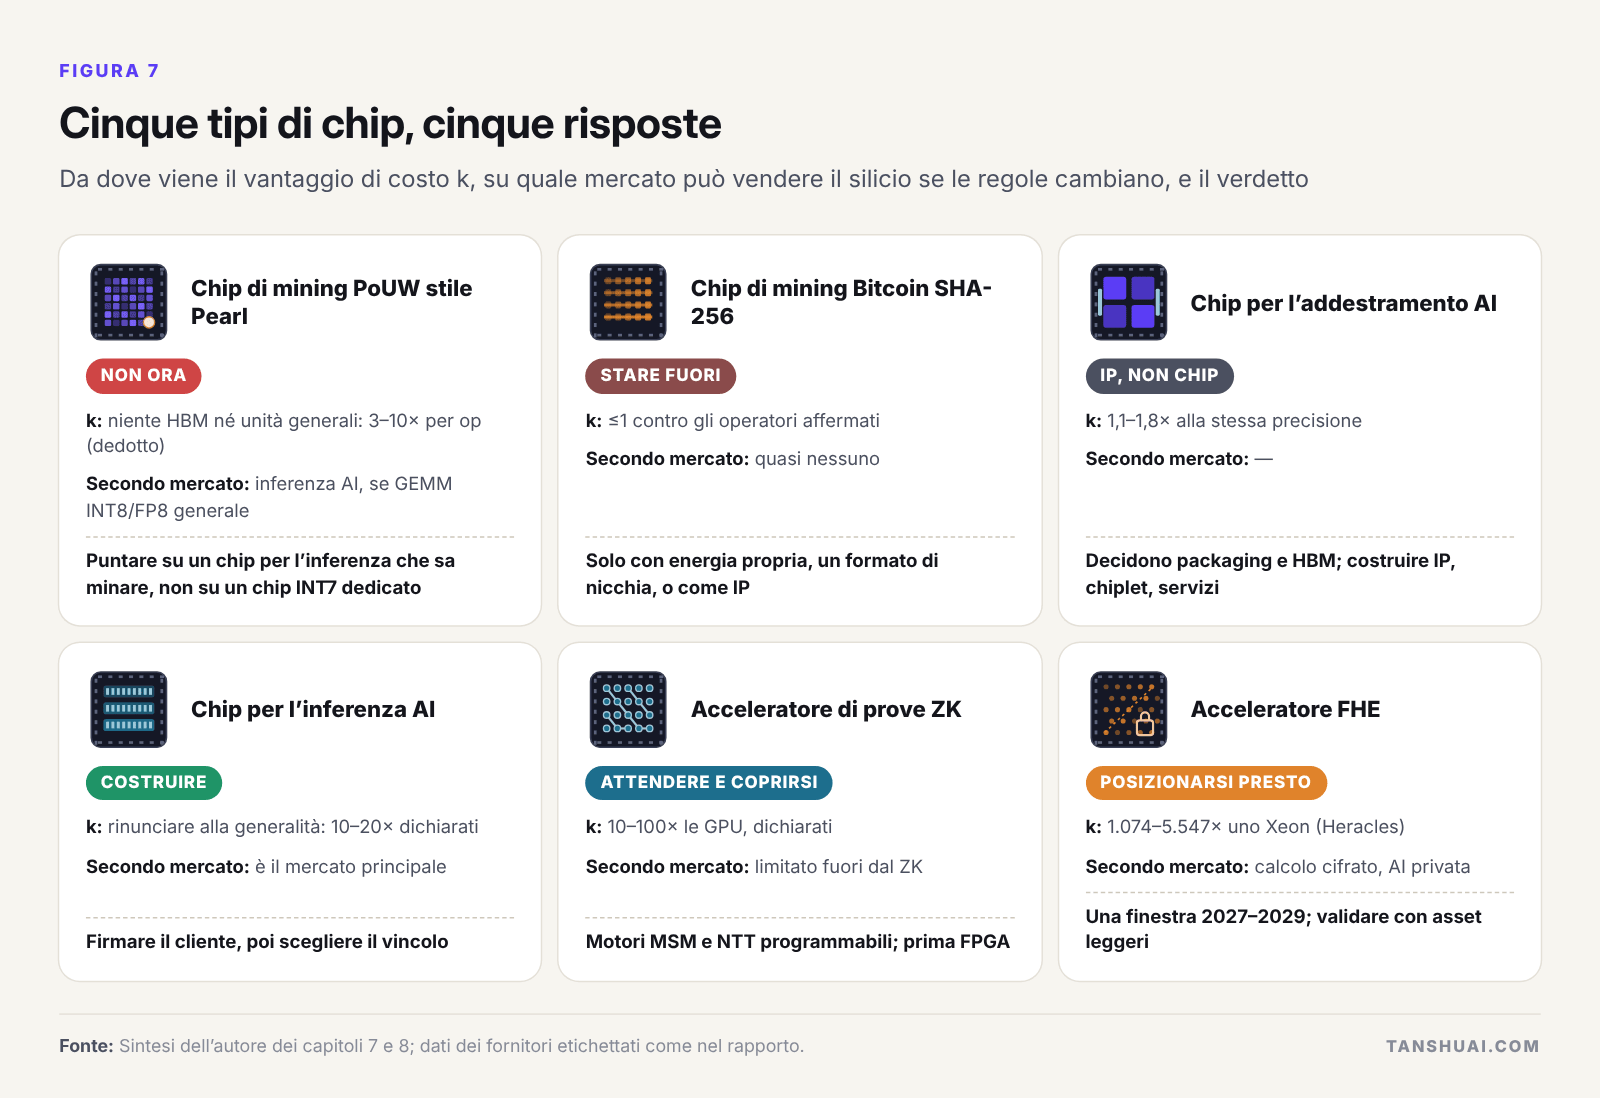 Figura 7. Cinque tipi di chip, cinque risposte.
Per Pearl, oggi non farei il tape-out di un chip INT7 dedicato: un team nuovo ha bisogno di 18–24 mesi, e per allora il protocollo potrebbe essere passato a FP8. La scommessa migliore è un acceleratore pensato per l’inferenza, costruito su GEMM INT8/FP8 generale con gli operandi in SRAM, in modo che il silicio abbia un secondo mercato se l’accesso al mining si chiude. Un team nuovo dovrebbe stare fuori dal mercato dei miner bitcoin venduti a terzi, dove Bitmain consegna macchine da 8,9 J/TH e gli sfidanti si stanno ritirando; i siti con energia oggi valgono di più come data center AI che come miniere. I team piccoli non dovrebbero costruire chip di addestramento autonomi. I chip di inferenza vale la pena costruirli per un cliente già firmato, gli acceleratori ZK sono una copertura, e gli acceleratori FHE sono una posizione precoce per il 2027–2029.
Nodi di processo e un budget a tappe
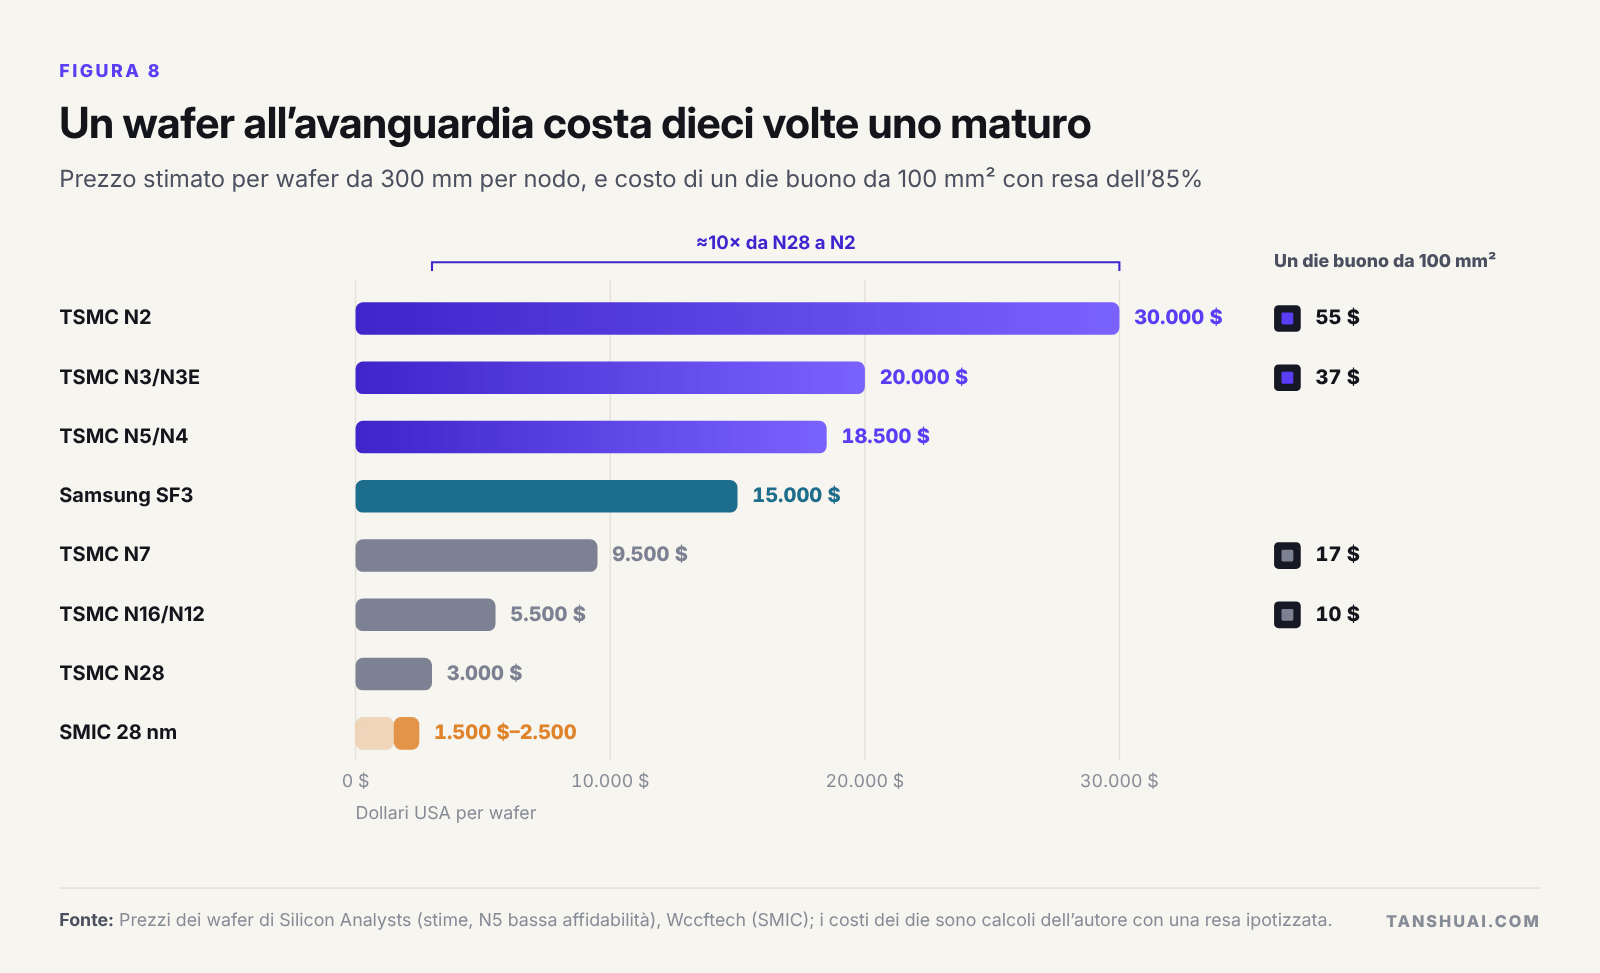 Figura 8. Un wafer all’avanguardia costa dieci volte uno maturo.
Lasciate che sia la voce più grande nel costo del chip sull’intera vita a scegliere il nodo: l’energia per i chip di calcolo che girano giorno e notte, packaging e HBM per i chip di addestramento (circa il 63% del costo di una H100), e la scelta tra SRAM e HBM per i chip di inferenza. Un chip di mining PoUW può essere prototipato su wafer multiprogetto a 28 o 16/12 nm e passare a N7/N6 e poi a N5/N4 solo quando algoritmo e ricavi sono stabili.
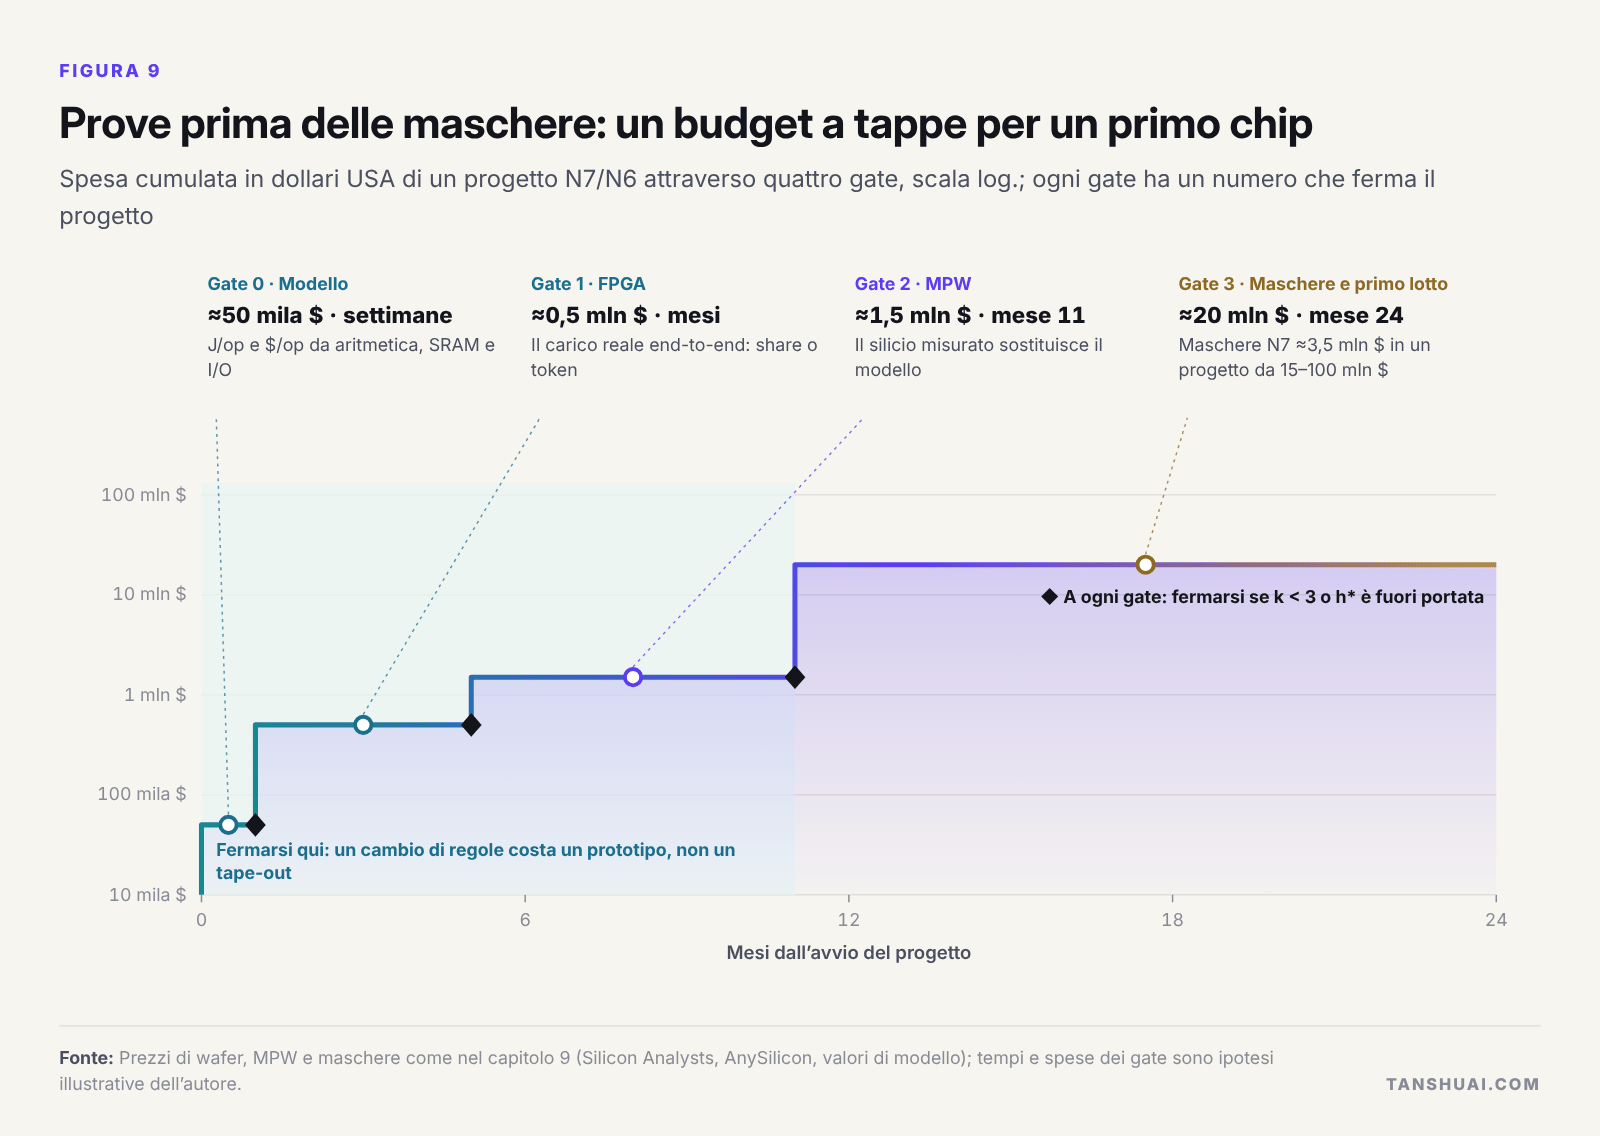 Figura 9. Prove prima delle maschere: un budget a tappe per un primo chip.
Un primo chip va comprato in quattro tappe, ognuna con un numero che ferma il progetto: un modello di J/op e $/op, un FPGA che esegue il carico reale, un wafer multiprogetto, e solo dopo un set di maschere. Su N7/N6 le prime tre costano circa 1,5 milioni di dollari e undici mesi; il set di maschere e il primo lotto costano più di dieci volte tanto [stima]. Se il protocollo cambia la sua aritmetica o l’acquirente si tira indietro, un team che si è fermato al wafer perde il prezzo di un prototipo, non quello di un tape-out. L’efficienza più economica è architetturale: tenere gli operandi in SRAM e fare a meno dell’HBM elimina la maggior parte del costo di una GPU prima ancora di scegliere un nodo.
Da dove comincerei
Le opportunità stanno dove i campi si incrociano: la crypto come primo cliente, l’AI come secondo mercato. La domanda di chip custom nel 2026 è in larghissima parte AI, e le competenze di un team di chip di mining, array a bassa tensione, alimentazione da kilowatt e tape-out rapidi, si trasferiscono direttamente. Prenderei al massimo tre percorsi, ognuno messo alla prova con un primo passo piccolo: un acceleratore pensato per l’inferenza che sa anche minare, a partire da uno studio di quattro settimane su J/op e $/op; servizi di silicio custom con la crypto come primo cliente, a partire da studi di fattibilità a pagamento; e una rete nativa AI che firma il suo acquirente di calcolo prima di progettare il suo token.
Scarica il rapporto completo e le slide
Il rapporto completo tratta in dettaglio il meccanismo, l’economia e le regole di Pearl, le altre catene a lavoro utile e il panorama più ampio di AI × crypto, il modello degli ASIC con i calcoli di rientro, i verdetti chip per chip, costi e scelte dei nodi, un budget a tappe per un primo chip, un elenco di segnali da seguire e tutte le fonti.
- Il calcolo come consenso: rapporto completo (PDF)
- Il calcolo come consenso: slide (PDF)
- Edizione inglese: rapporto completo · slide
Questa è una traduzione dell’edizione inglese; in caso di differenze prevale l’edizione inglese.
Le domande che non avete fatto ma avreste dovuto fare
Prima di mettere denaro o silicio in qualsiasi progetto AI × crypto, chiederei: chi controlla la funzione di lavoro; qual è il multiplo del sussidio; quanto costa il prossimo gate e quale numero vi ferma; qual è l’hashrate di rientro, con p; qual è il secondo mercato del chip; se il valore finisce nel token o nell’equity; e chi è il primo cliente pagante, con nome e cognome.
Sono ambiti che possiamo esplorare insieme, con scambi e collaborazioni tecniche: chip custom per il mining, per l’addestramento e l’inferenza AI e acceleratori; sviluppo AI; e sistemi AI × crypto dalla catena al nodo fino al chip. Potete scrivermi a i@tanshuai.com.
L’autore
Tan Shuai è un tecnologo e fondatore con più di vent’anni di lavoro tra chip, hardware e software di sistema, e 20 brevetti concessi. Ha alle spalle molti anni di ricerca e sviluppo e di gestione di chip fabless, compresa la progettazione full-custom di datapath ASIC per chip di mining di criptovalute e per chip multimediali per fotocamere. Il suo lavoro lo ha portato nella Silicon Valley, a New York, a Chicago, a Taiwan, nella Greater Bay Area (Shenzhen e Hong Kong), in Vietnam e in Malesia. Oggi lavora come ricercatore e sviluppatore di AI.
Discussione tecnica: i@tanshuai.com.