
Eine Blockchain läuft inzwischen auf derselben Matrixmultiplikation wie KI, mit rund 90 EH/s. Ich habe ihren Code, ihre Chain-Daten und die Ökonomie um sie herum gelesen, um drei Fragen zu beantworten: was im Feld KI × Krypto zahlende Kunden hat, wann sich der Bau eines ASIC lohnt und welcher Prozessknoten zu welchem Chip passt. Mit vollständigem Bericht und Folien.
Kurzfassung
Pearl, gestartet im April 2026, ist die erste Blockchain, deren Proof of Work eine Matrixmultiplikation nach KI-Art im großen Maßstab ist. Am 13. November 2026 lief ihr Netz mit rund 90 EH/s, wobei ein H eine INT7-Multiply-Accumulate-Operation ist: der Ganzzahldurchsatz von etwa 122.000 H100. Als Technik funktioniert das. Nützlich ist es noch nicht: Nur etwa 1 % der Blöcke enthält echte KI-Arbeit, weil eine GPU, die beim Bedienen von Inferenz mint, nur 1 % bis 27 % der Hashrate eines reinen Miners behält. Im gesamten Feld KI × Krypto zeigt sich verifizierbare bezahlte Nachfrage an drei Stellen, beim Verkauf von Inferenz, von Daten und von Privatsphäre, während Subventionen das 4- bis 360-Fache der externen Einnahmen erreichen. Für Chips gilt: Die Gewinnobergrenze eines ASIC ist der Erlös je Recheneinheit mal (1 − 1/k), sodass Effizienz jenseits von k = 5 wenig bringt; entscheidend sind die Größe des Topfs, die Stabilität der Regeln und ein Zweitmarkt. Kein Netz bietet heute alle drei. Der richtige Prozessknoten ergibt sich aus dem größten Posten der Lebenszeitkosten eines Chips, und der Chip selbst sollte in Stufen eingekauft werden, damit eine Regeländerung einen Prototyp kostet und nicht ein Tape-out.
Warum ich mir das angesehen habe
Ich habe viele Jahre lang Chips entworfen, darunter Full-Custom-ASIC-Datenpfade für das Mining von Kryptowährungen, und arbeite heute an KI. Als eine Kette auftauchte, deren Sicherheitsbudget buchstäblich in Tensordurchsatz bepreist ist, lagen die Fragen für jemanden wie mich auf der Hand: Ist die Arbeit nützlich, würde ein dedizierter Chip gewinnen, und was würde es kosten, einen zu bauen?
Ich habe Pearls Code und Protokollvorschläge gelesen, Chain-Daten eines unabhängigen Full Node, Unternehmensberichte, Fachartikel aus Kryptografie, Rechnerarchitektur und maschinellem Lernen, Preisdaten von Foundrys und Anbietern sowie die Fachpresse. Jede Zahl unten hat den Stand 13. November 2026, Beträge sind in US-Dollar. Mit dieser Notiz habe ich mir das Feld erarbeitet; ich teile sie, damit andere sie prüfen, nutzen und ihr widersprechen können. Der vollständige Bericht mit allen Quellen steht am Ende.
Ergebnisse im Überblick
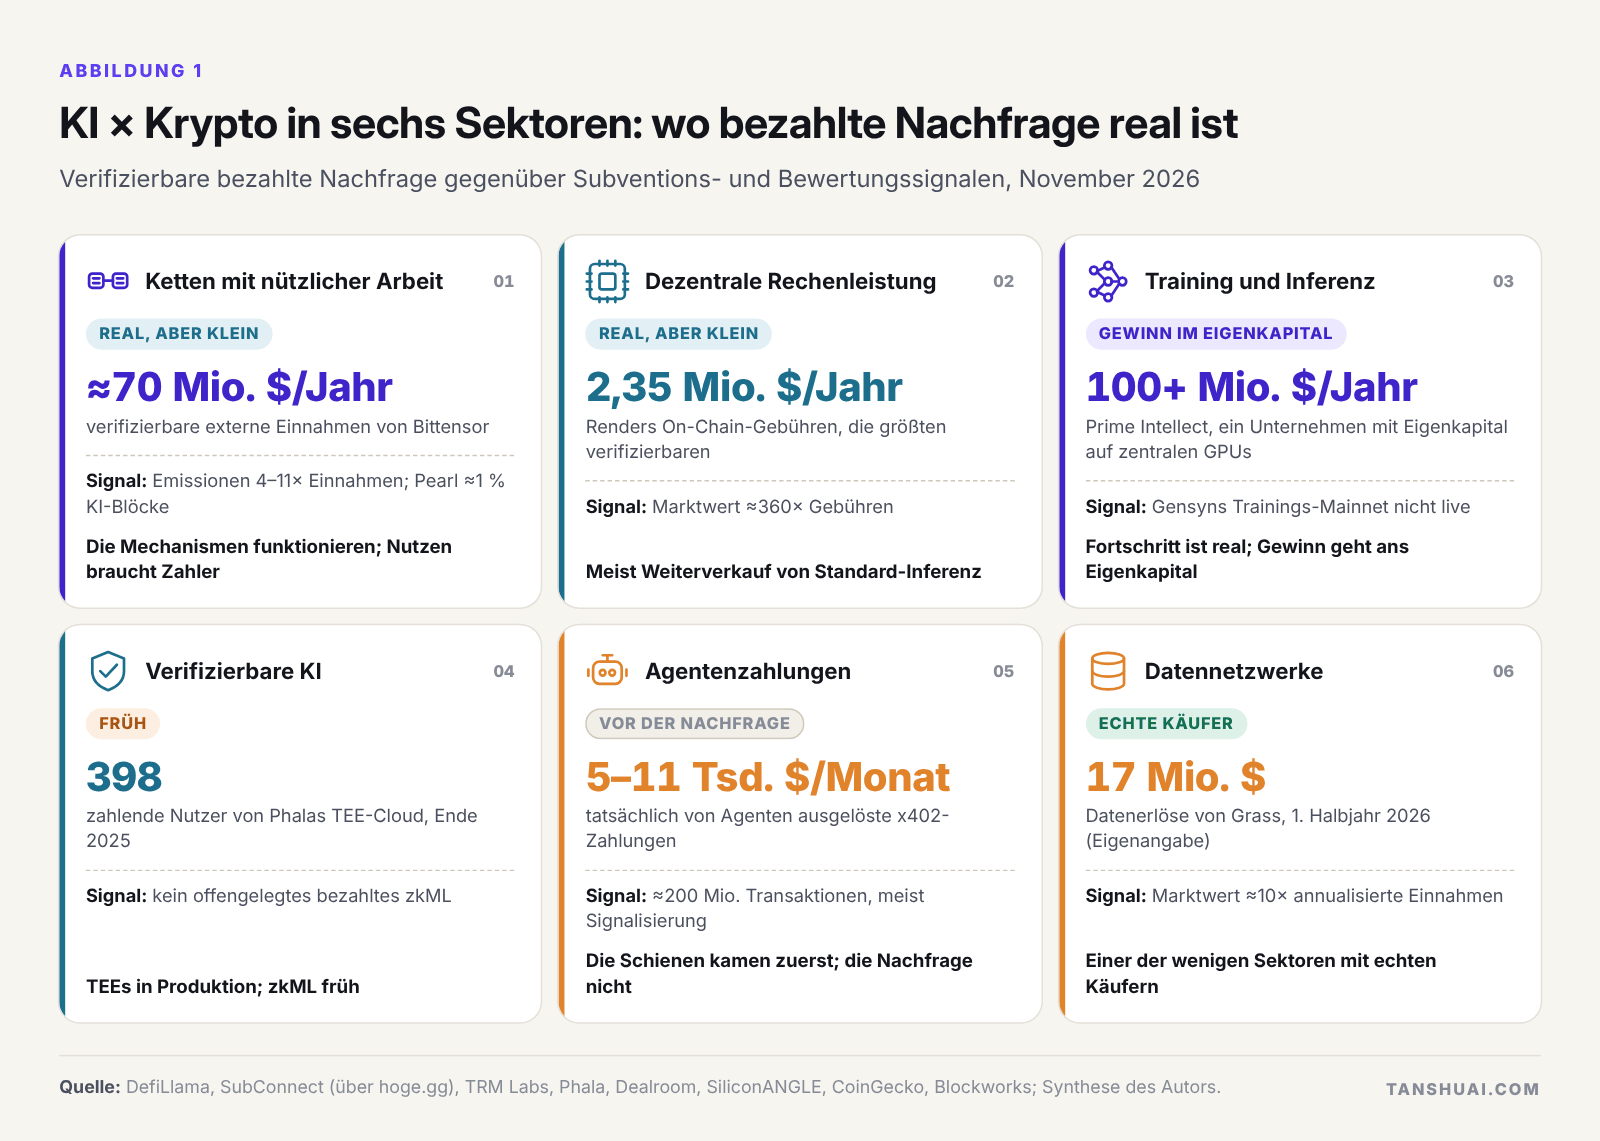 Abbildung 1. KI × Krypto in sechs Sektoren: wo bezahlte Nachfrage real ist.
| Frage | Kurze Antwort |
|---|---|
| Funktioniert Pearl, und ist seine Arbeit nützlich? | Es funktioniert: Rund 90 EH/s Matrixmultiplikation sichern die Kette. Nützlich ist es noch nicht: Nur etwa 1 % der Blöcke enthält KI-Arbeit |
| Wo ist die echte bezahlte Nachfrage? | Inferenz, Daten und Privatsphäre. Agentenzahlungen, zkML und dezentrales Training liegen noch vor der Nachfrage |
| Lohnt sich der Bau eines ASIC? | Nur mit großem Topf, stabilen Regeln und einem Zweitmarkt; kein Netz bietet heute alle drei |
| Welche Chips sollte ein kleines Team bauen? | Inferenzorientierte Beschleuniger, die auch minen können, Inferenzchips für einen unterschriebenen Kunden, frühe FHE-Arbeit; keine Bitcoin-Miner für den freien Markt und keine Trainingschips |
| Was kostet ein erster Chip? | In Stufen einkaufen: Ein Modell, ein FPGA und ein MPW führen für etwa 1,5 Millionen US-Dollar zu gemessenem Silizium, vor Masken, die Millionen kosten |
Pearl: ein Multiply-Accumulate ist ein Hash
Pearl beruht auf einem Ergebnis von Ilan Komargodski und Omri Weinstein aus dem Jahr 2025: einem Proof of Useful Work für jedes Matrixprodukt, zum 1 + o(1)-Fachen der Kosten der Multiplikation. Miner multiplizieren verrauschte Matrizen, hashen den Akkumulator jeder Ausgabekachel zu einem Los und beweisen die Gewinnerkachel mit einem Zero-Knowledge-Beweis von unter 60 KB. Im Konsenscode ist ein H ein angerechnetes INT7 × INT7 → INT32-Multiply-Accumulate; damit ist das Sicherheitsbudget einer Blockchain erstmals im Tensordurchsatz von KI-Beschleunigern bepreist.
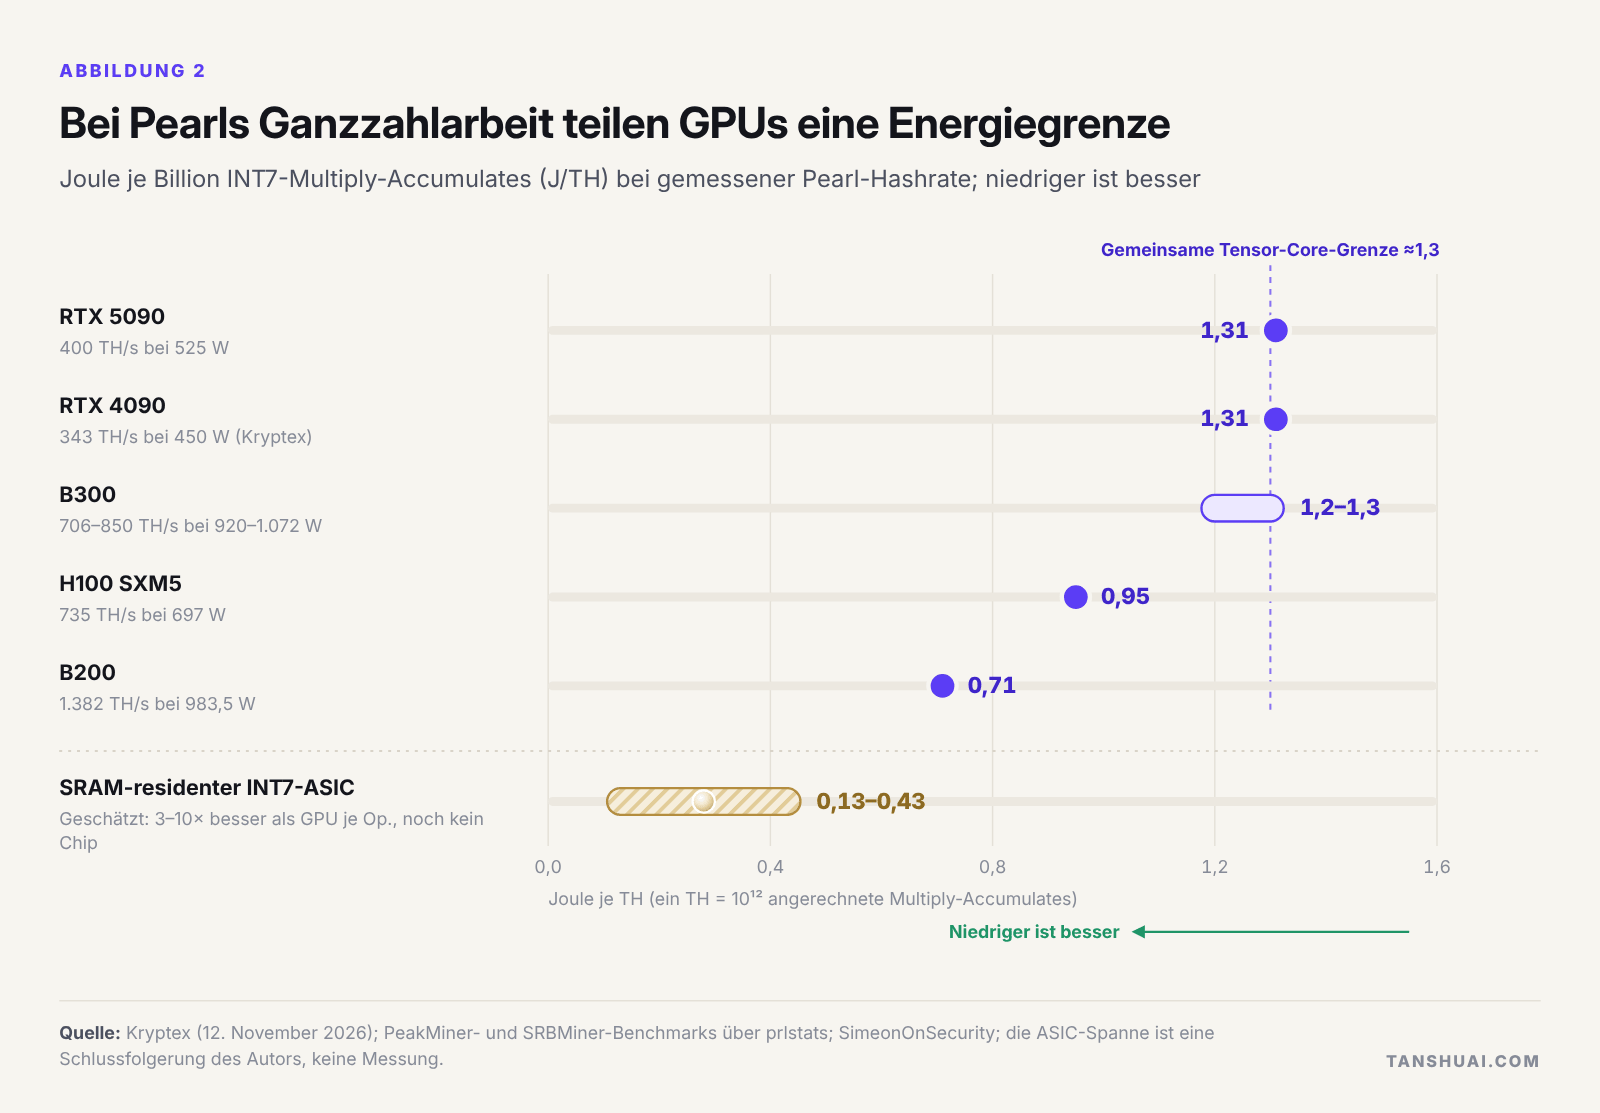 Abbildung 2. Bei Pearls Ganzzahlarbeit teilen GPUs eine Energiegrenze.
Gaming-Karten und die Rechenzentrums-GPU B300 treffen sich bei etwa 1,3 J/TH, und selbst die B200 erreicht nur 0,71. Genau diese gemeinsame Grenze könnte ein dedizierter Chip durchbrechen: Ein Baustein, der nur 7-Bit-Ganzzahlen aus On-Chip-SRAM multipliziert, ohne HBM und ohne Allzweckeinheiten, könnte plausibel 3- bis 10-mal besser je Operation sein. Zugleich verlagert NVIDIA sein neuestes Silizium von INT8 hin zu FP8 und FP4, weshalb Pearl sich darauf vorbereitet, seine Arithmetik zu ändern.
Pearls Ökonomie: Das Theorem hält, der Anreiz nicht
Pearls Hashrate folgt dem Preis. Das Netz stieg von 0,01 EH/s am zweiten Tag auf 23–26 EH/s Ende Mai, hielt sich bei 21–39 EH/s durch einen Sommer, in dem der Preis um etwa 86 % fiel, und erreichte rund 90 EH/s, nachdem sich der Preis im Herbst etwa verzehnfacht hatte. Rund 120 Millionen Coins, etwa 32 % des heutigen Angebots, wurden in den ersten sechs Tagen gemint, und das Angebot wird in den nächsten 12 Monaten um etwa 78 % wachsen. Eine RTX 5090 verdient jetzt etwa 5–6 US-Dollar am Tag.
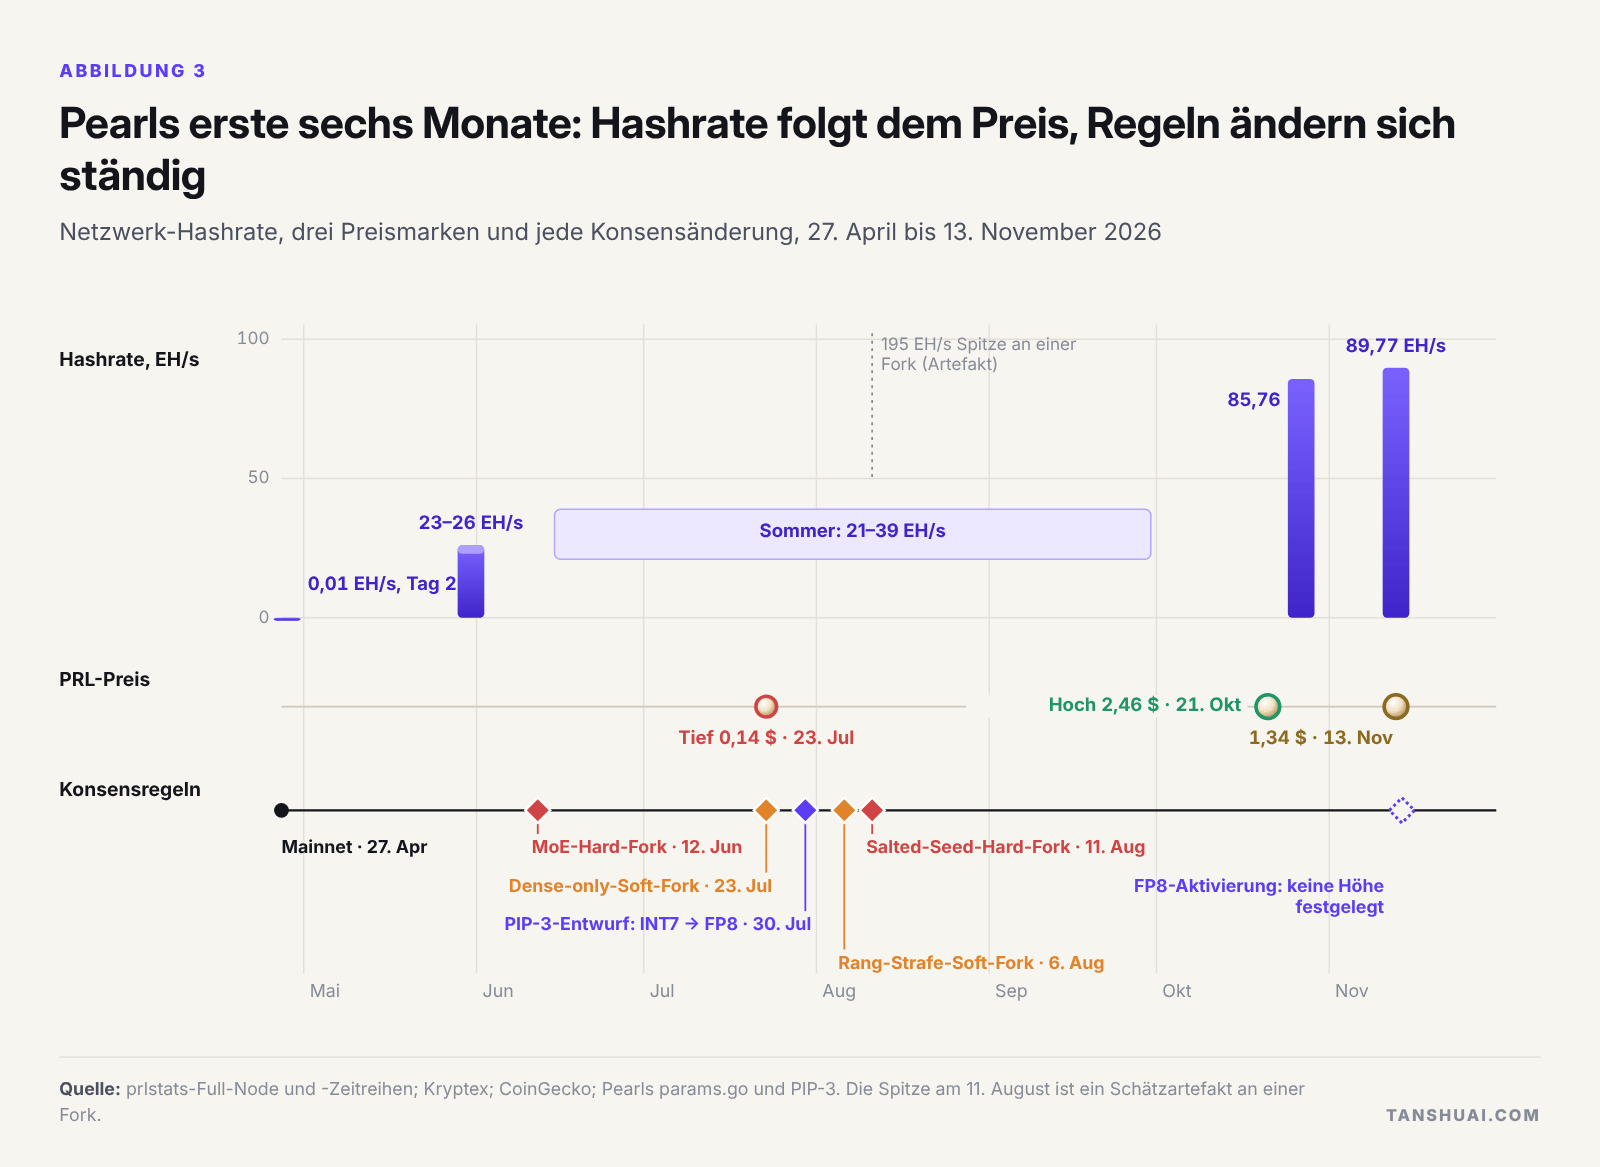 Abbildung 3. Pearls erste sechs Monate: Hashrate folgt dem Preis, Regeln ändern sich ständig.
Am nützlichen Teil bricht das Modell. Mining innerhalb echter Inferenz kostet auf der Inferenzseite wenig, etwa 5 % bis 9 % des Durchsatzes, bringt aber auf der Mining-Seite wenig ein: Pearls Plug-in mint nur bei langen Prefill-Batches, sodass eine Karte, die eine Chat-Last bedient, etwa 5 % der Hashrate eines reinen Miners behält. Rationale Miner multiplizieren deshalb Zufallsmatrizen, und das Protokoll kann es nicht unterscheiden. Die einzige öffentliche Inferenzpartnerschaft ist nicht mehr in der Serverless-API ihres Anbieters zu finden. Pearls Nützlichkeit ist ein kommerzielles Problem außerhalb der Kette: Jemand muss für die Inferenz bezahlen.
Die Regeln sind das andere Risiko. Von Juni bis August aktivierte das Labor vier Konsensänderungen bei fest einprogrammierten Höhen, und sein Entwurf PIP-3 verlegt das Mining auf FP8 mit bitgenauen Geräteprofilen für nur zwei NVIDIA-Architekturen. Ein Zahlenformat kann nützlich für KI, bitgenau prüfbar und hardwareneutral sein, aber höchstens zwei der drei Eigenschaften zugleich haben.
Im Feld KI × Krypto: Subvention ist Treibstoff, kein Geschäftsmodell
Andere Ketten mit nützlicher Arbeit erzählen dieselbe Geschichte. Kaspa baute ein Matrixprodukt in seinen Hash ein und bekam trotzdem binnen 16 Monaten ASICs; seine beste Maschine verdient jetzt 0,86 US-Dollar am Tag. Aleos synthetisches Proving-Rätsel bekam nach fünf Monaten dedizierte Hardware und zahlte Provern das 175- bis 180-Fache seiner Gebühren. Bittensor ist das einzige Netz der Gruppe mit externen Einnahmen in nennenswerter Größenordnung, etwa 70 Millionen US-Dollar pro Jahr, gegenüber mehr als 300 Millionen US-Dollar an Emissionen.
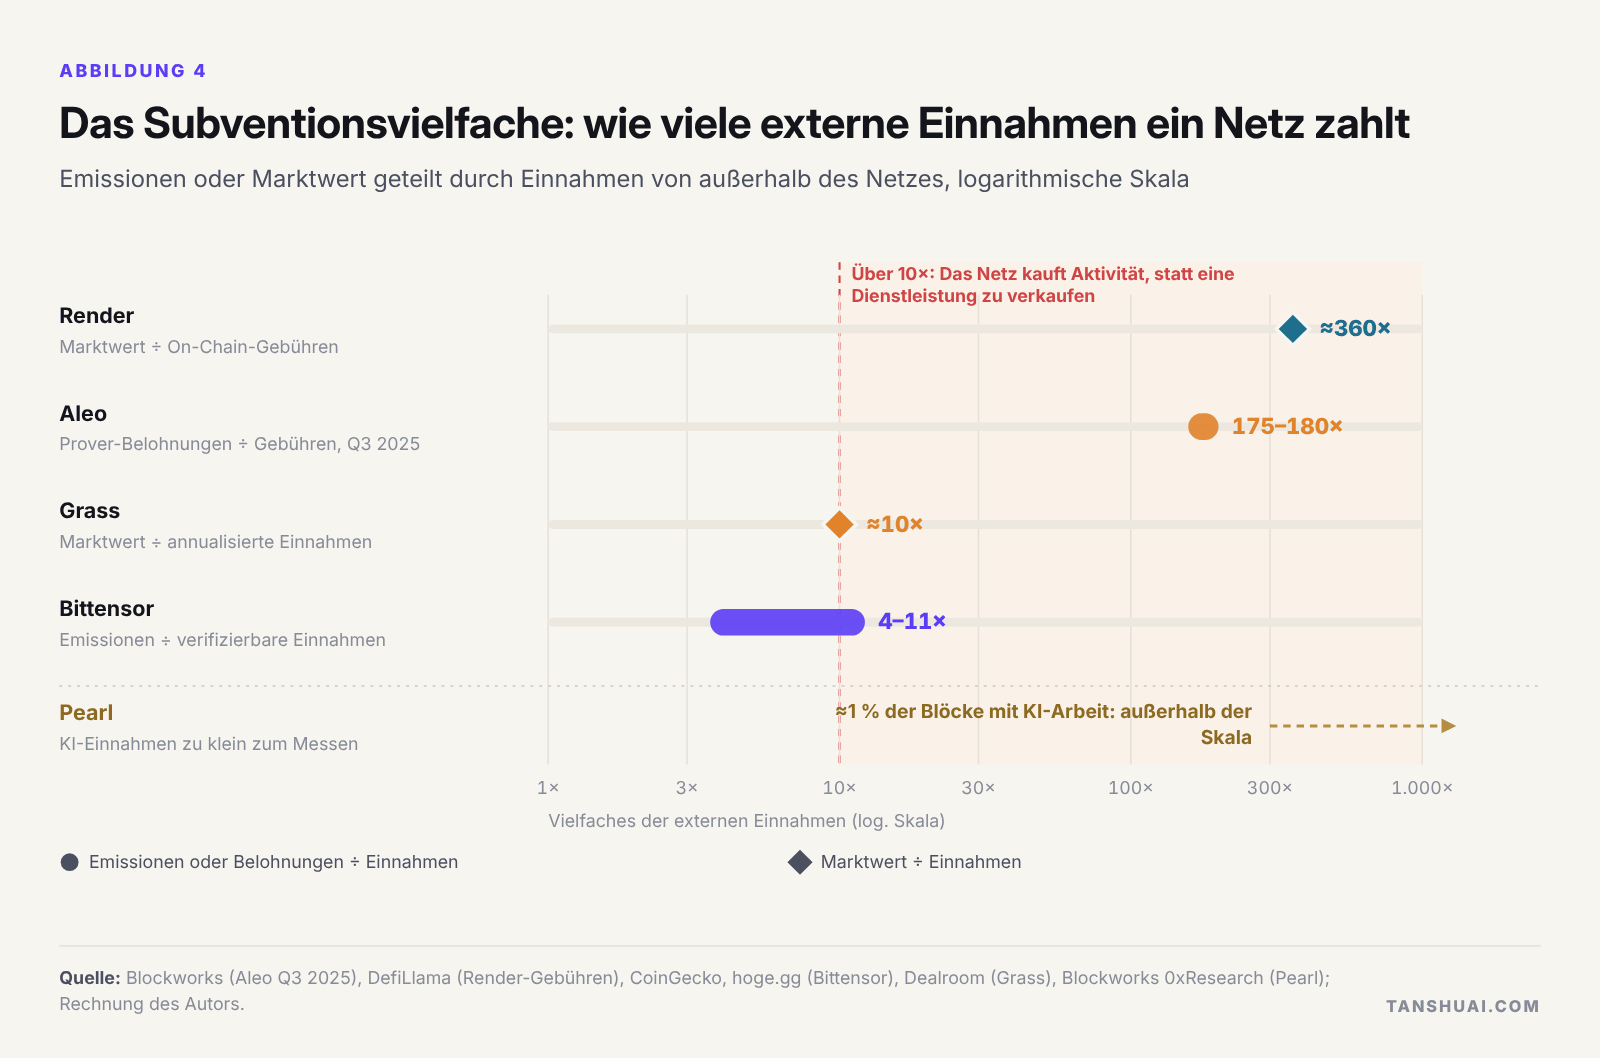 Abbildung 4. Das Subventionsvielfache: wie viele externe Einnahmen ein Netz zahlt.
Jenseits des Konsenses zeigt sich reale Nachfrage in kleinem Maßstab. Dezentrale GPU-Märkte verkaufen Standard-Inferenz und unterbieten die Preise der Hyperscaler, nicht aber die der günstigsten Neoclouds. Training über das Internet funktioniert bei 8 bis 40 Milliarden Parametern, während Frontier-Läufe zu zentralen Clustern zurückgekehrt sind. Trusted Execution Environments betreiben vertrauliche Inferenz in Produktion; Zero-Knowledge-Beweise für KI sind noch im Labor. Von KI-Agenten ausgelöste Zahlungen kommen auf etwa 5.000–11.000 US-Dollar im Monat, obwohl Visa, Mastercard, Stripe und Google die Schienen dafür gebaut haben. Daten sind einer der wenigen Sektoren mit echten Käufern. Zugleich sind vier Unternehmen mit Eigenkapital auf zentraler Infrastruktur etwa so viel wert wie alle KI-Token der Protokoll- und Anwendungsebene zusammen: Krypto leistet Vertrieb und Abwicklung, die Gewinne gehen ans Eigenkapital.
Wann sich ein ASIC rechnet: eine Formel, drei Maßstäbe
Wenn GPUs den Preis des Minings setzen, strebt der Erlös je Recheneinheit gegen ihre Kosten, und ein ASIC, der k-mal günstiger ist, behält höchstens (1 − 1/k) der Einnahmen. Die Kurve ist konkav: 50 % bei k = 2, 80 % bei k = 5, 90 % bei k = 10. Jenseits von k = 5 bringt mehr Effizienz wenig zusätzlichen Gewinn; und gegenüber ungenutzten GPUs, die nur für Strom bezahlen, liegt das effektive k womöglich nur bei etwa 2,5.
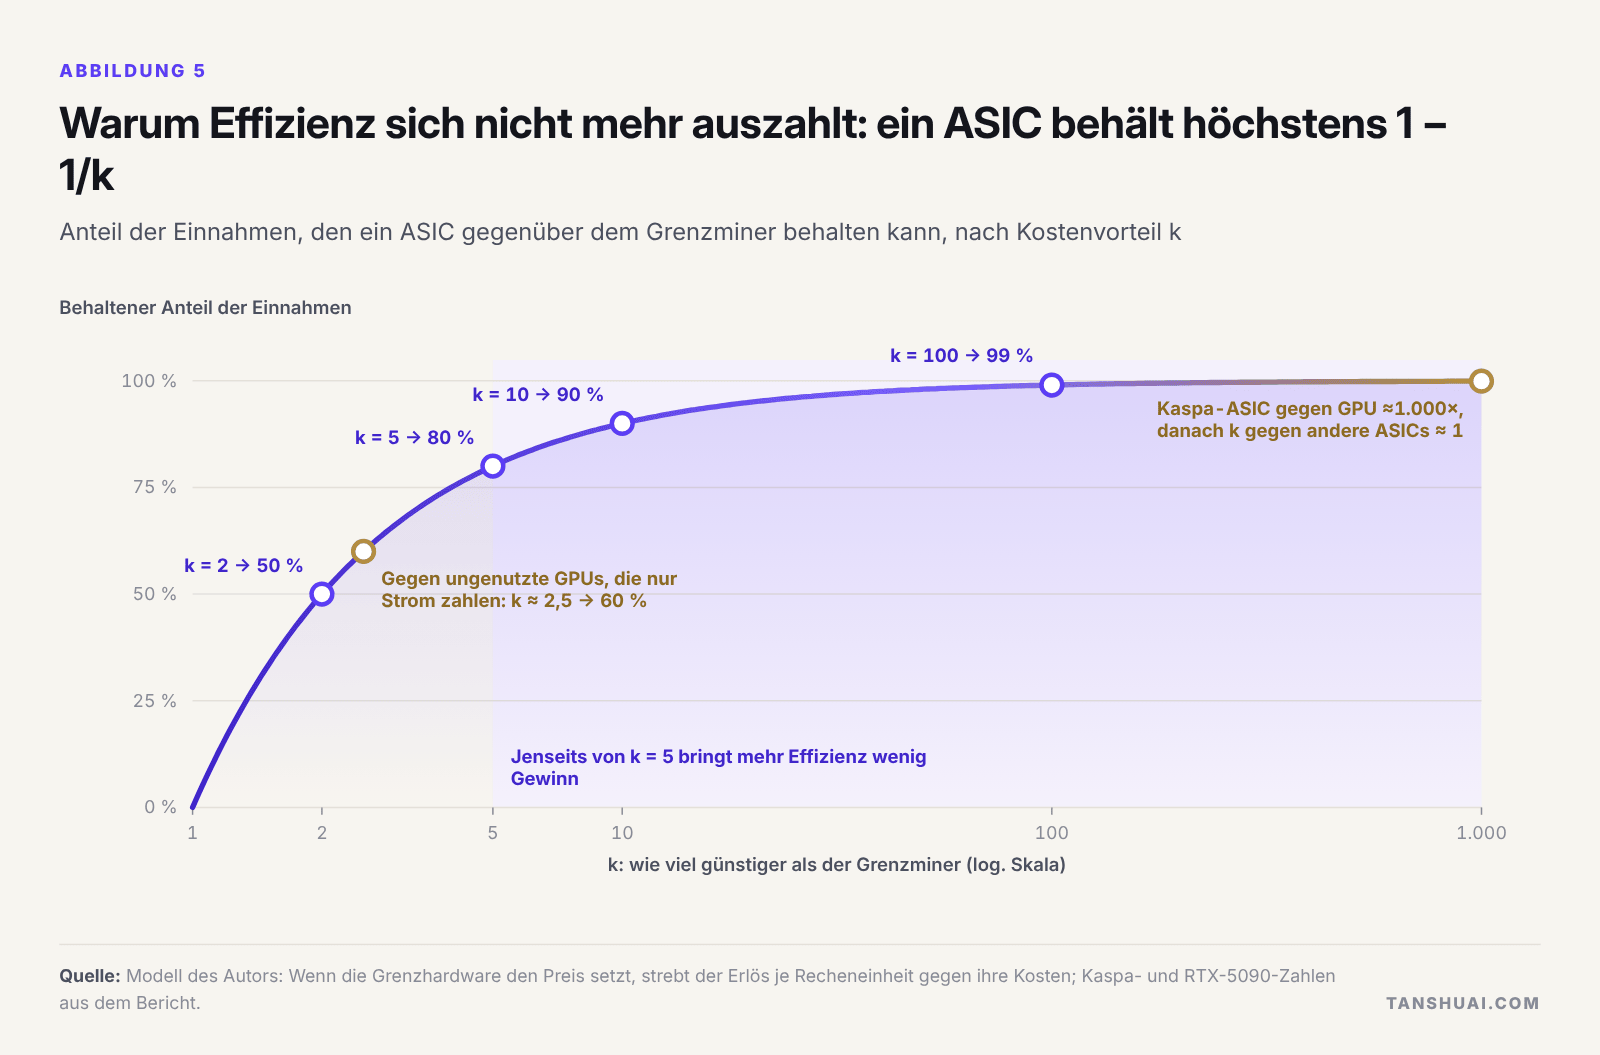 Abbildung 5. Warum Effizienz sich nicht mehr auszahlt: ein ASIC behält höchstens 1 − 1/k der Einnahmen.
Drei Maßstäbe entscheiden dann: der Topf, die Amortisationsgröße und die Regeln. Bitcoin-Miner verdienen etwa 11,5 Milliarden US-Dollar pro Jahr, die von Pearl etwa 0,46–0,49 Milliarden, die von Aleo etwa 31 Millionen und die von Kaspa etwa 18 Millionen, weniger als die Untergrenze eines einzigen 5/4-nm-Chipdesigns. Für Pearl braucht ein Chip für 20 Millionen US-Dollar mit k = 5 etwa 4,9 EH/s, die ein Jahr lang laufen, um sich zu amortisieren, wenn die Regeln halten, und das Doppelte, wenn sie nur mit gleicher Wahrscheinlichkeit halten.
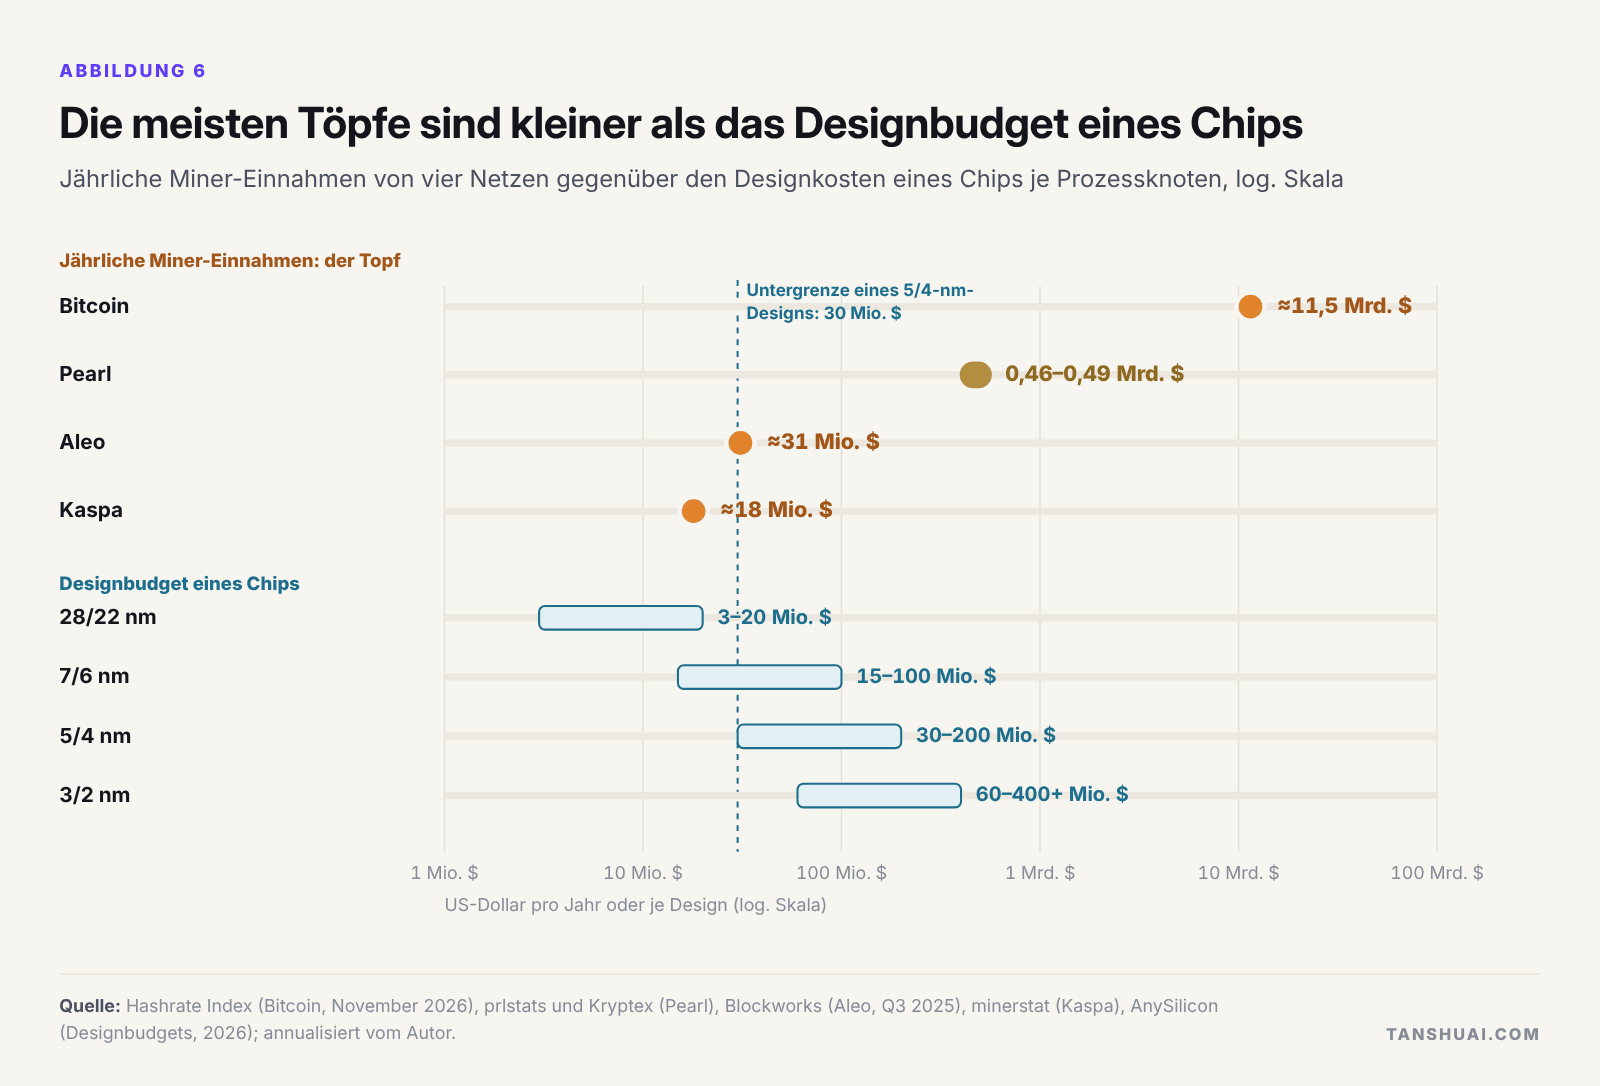 Abbildung 6. Die meisten Töpfe sind kleiner als das Designbudget eines Chips.
Heute bietet kein Netz einen großen Topf, stabile Regeln und k über 1 zugleich: Bitcoins k gehört den Etablierten, Pearls Regeln sind am wenigsten stabil, und die Töpfe von Kaspa und Aleo sind zu klein.
Fünf Chiptypen, fünf Antworten
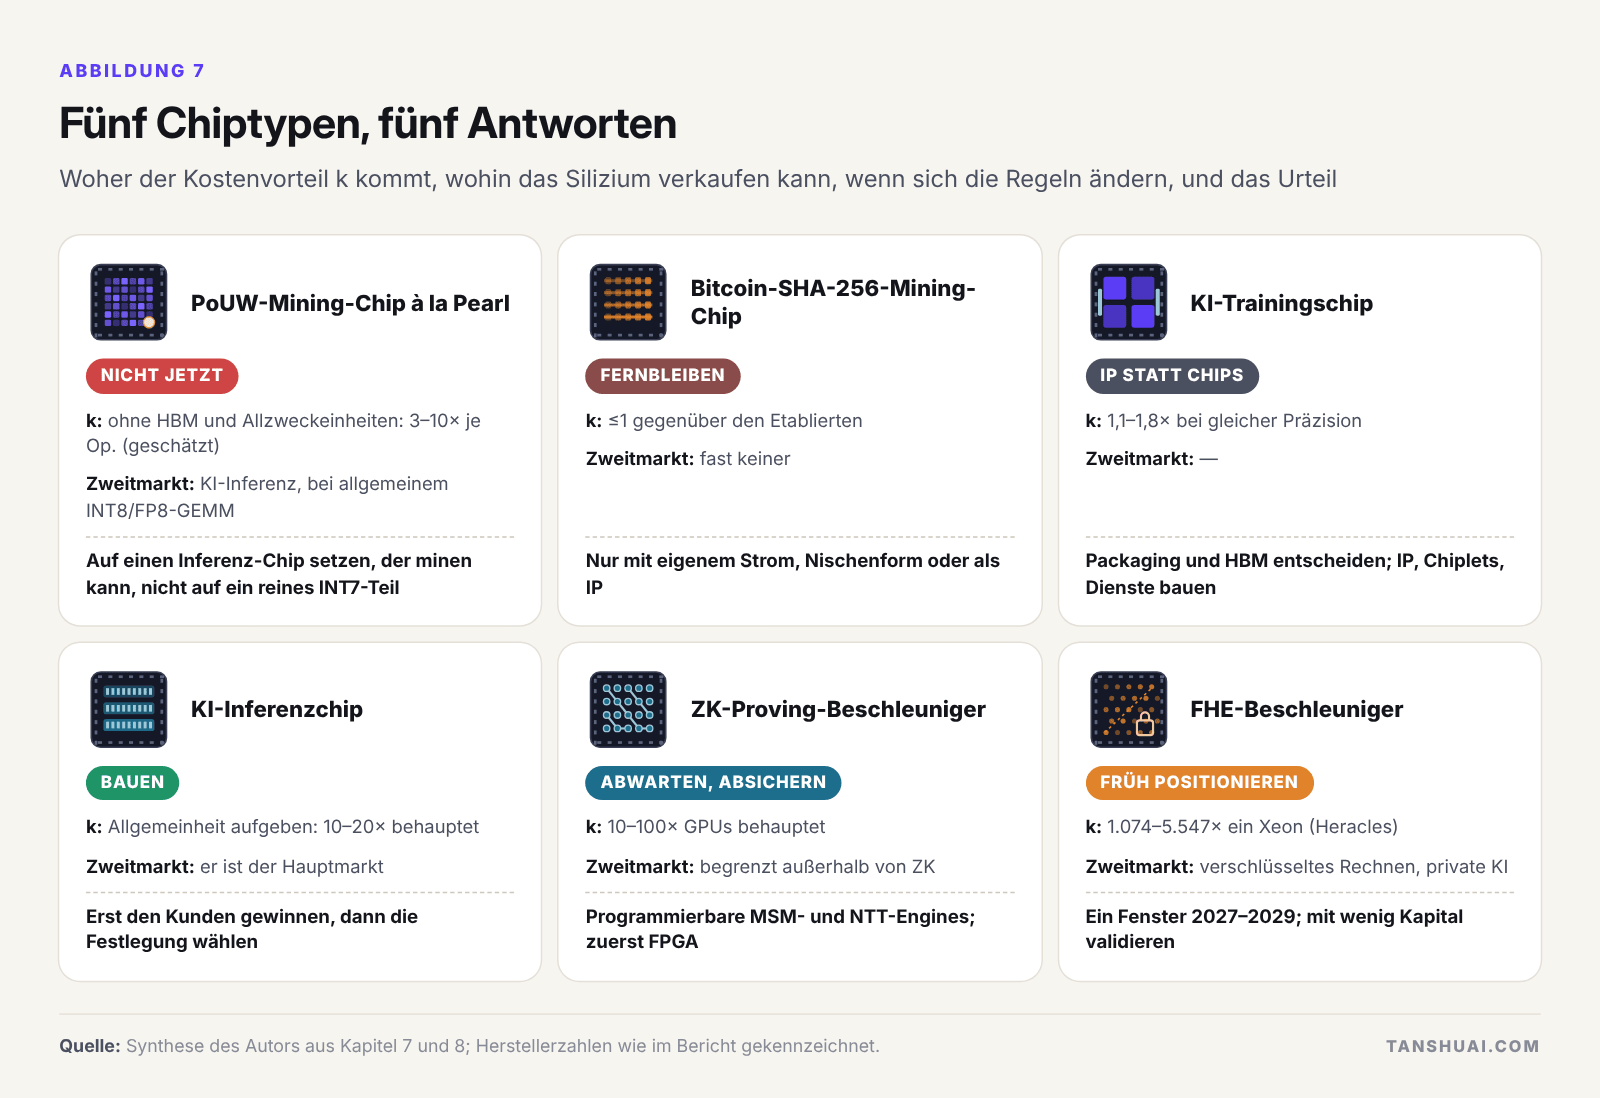 Abbildung 7. Fünf Chiptypen, fünf Antworten.
Für Pearl würde ich jetzt keinen dedizierten INT7-Chip zum Tape-out bringen: Ein neues Team braucht 18 bis 24 Monate, und das Protokoll ist bis dahin womöglich auf FP8 umgestiegen. Die bessere Wette ist ein inferenzorientierter Beschleuniger auf Basis allgemeiner INT8/FP8-GEMM mit Operanden im SRAM, damit das Silizium einen Zweitmarkt hat, falls der Zugang zum Mining geschlossen wird. Ein neues Team sollte dem freien Markt für Bitcoin-Miner fernbleiben, wo Bitmain Maschinen mit 8,9 J/TH ausliefert und Herausforderer sich zurückziehen; Standorte mit Stromanschluss sind als KI-Rechenzentren inzwischen mehr wert denn als Minen. Kleine Teams sollten keine eigenständigen Trainingschips bauen. Inferenzchips lohnen sich für einen unterschriebenen Kunden, ZK-Beschleuniger sind eine Absicherung, und FHE-Beschleuniger sind eine frühe Position für 2027–2029.
Prozessknoten und ein gestuftes Budget
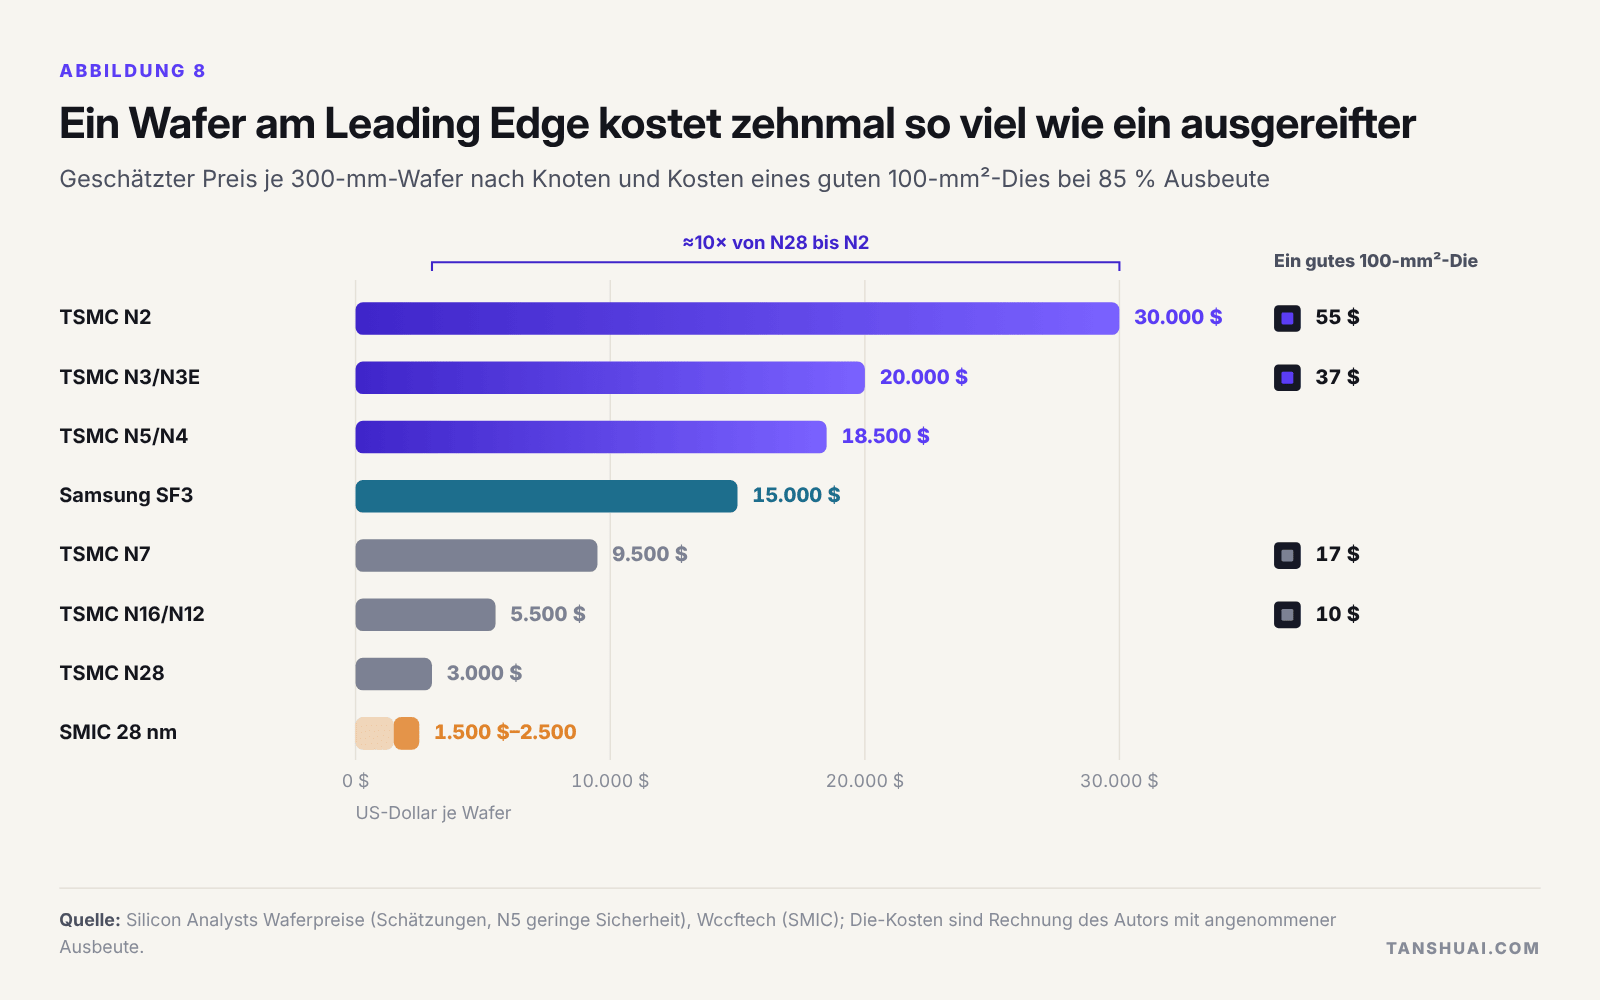 Abbildung 8. Ein Wafer am Leading Edge kostet zehnmal so viel wie ein ausgereifter.
Der größte Posten der Lebenszeitkosten des Chips soll den Knoten bestimmen: Energie bei Rechenchips, die rund um die Uhr laufen, Packaging und HBM bei Trainingschips (etwa 63 % der Kosten einer H100) und die Wahl zwischen SRAM und HBM bei Inferenzchips. Ein PoUW-Mining-Chip lässt sich als Prototyp auf 28- oder 16/12-nm-Multi-Project-Wafern bauen und erst dann auf N7/N6 und später N5/N4 bringen, wenn Algorithmus und Einnahmen stabil sind.
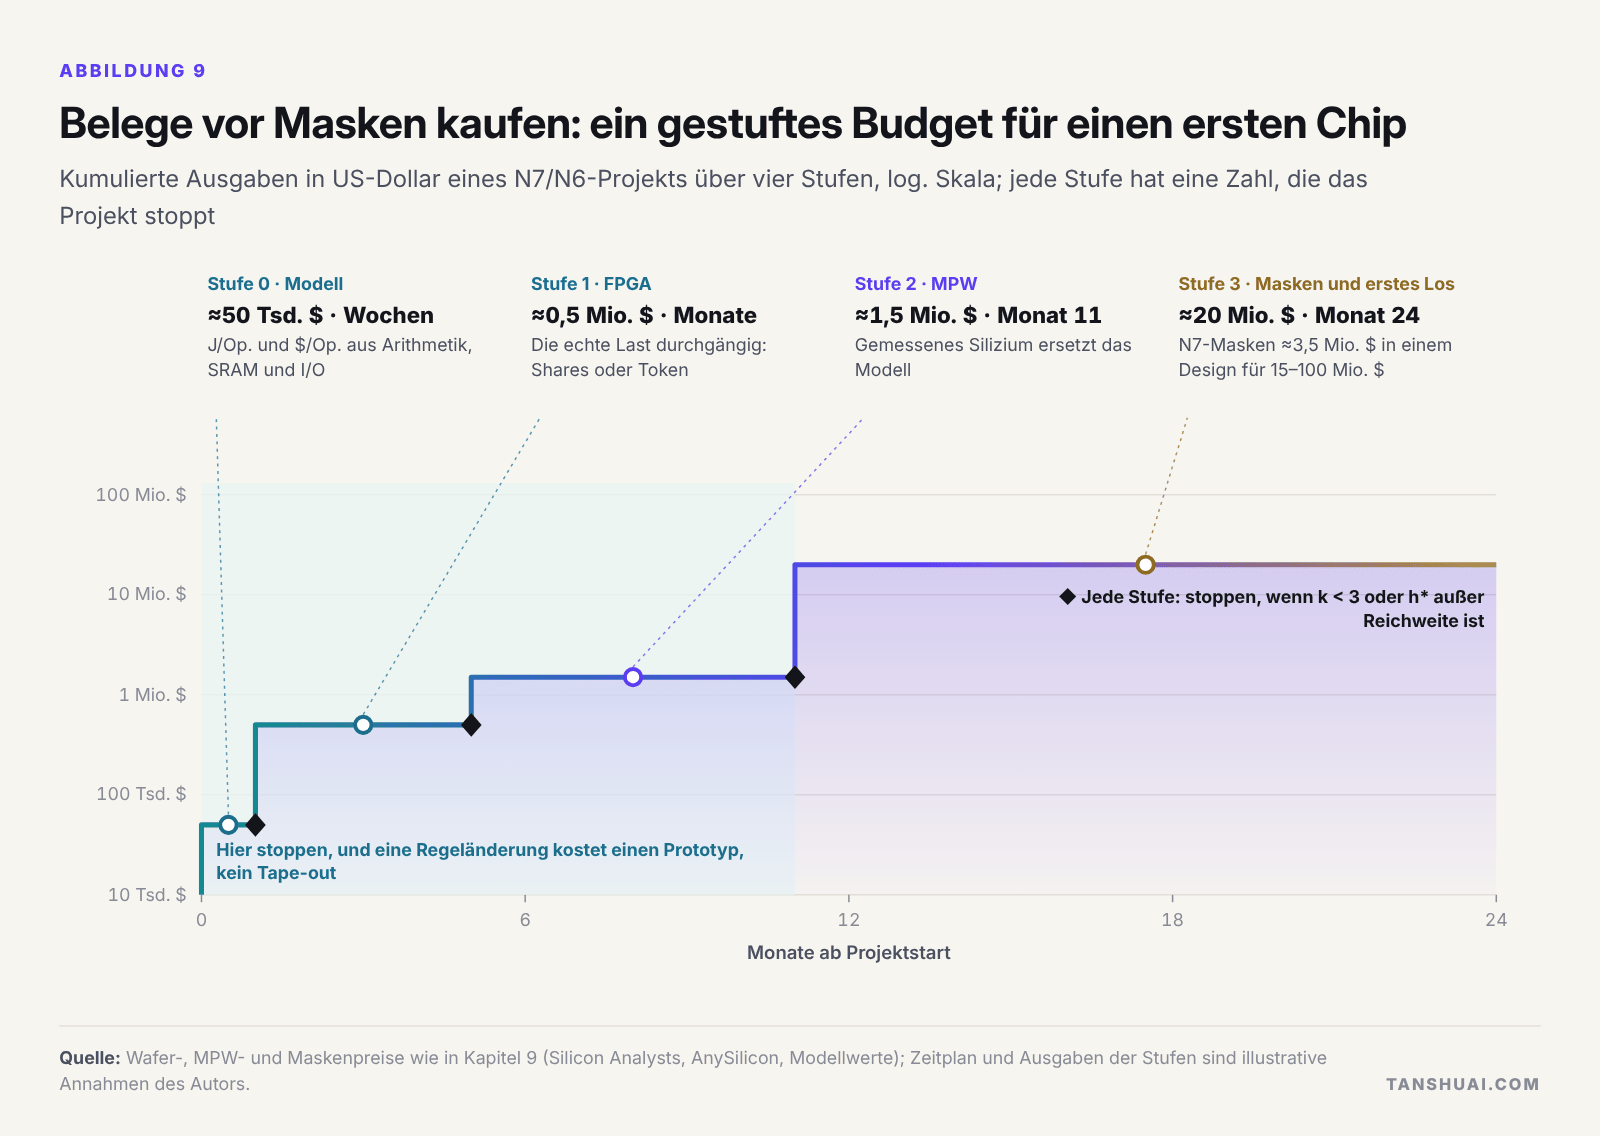 Abbildung 9. Belege vor Masken kaufen: ein gestuftes Budget für einen ersten Chip.
Ein erster Chip sollte in vier Stufen eingekauft werden, jede mit einer Zahl, die das Projekt stoppt: ein Modell von J/Op. und $/Op., ein FPGA, das die echte Last ausführt, ein Multi-Project-Wafer und erst dann ein Maskensatz. Auf N7/N6 kosten die ersten drei etwa 1,5 Millionen US-Dollar und elf Monate; Maskensatz und erstes Los kosten mehr als zehnmal so viel [Schätzung]. Ändert das Protokoll seine Arithmetik oder springt der Käufer ab, verliert ein Team, das beim Wafer aufgehört hat, den Preis eines Prototyps, nicht den eines Tape-outs. Die billigste Effizienz ist architektonisch: Operanden im SRAM zu halten und auf HBM zu verzichten, beseitigt den Großteil der Kosten einer GPU, bevor überhaupt ein Knoten gewählt ist.
Wo ich anfangen würde
Die Chancen liegen dort, wo sich die Felder kreuzen: Krypto als erster Kunde, KI als Zweitmarkt. Die Nachfrage nach kundenspezifischen Chips ist 2026 überwiegend KI, und das Können eines Mining-Chip-Teams, Niederspannungs-Arrays, Stromversorgung im Kilowattbereich und schnelle Tape-outs, lässt sich direkt übertragen. Ich würde höchstens drei Wege gehen, jeden mit einem kleinen ersten Schritt erprobt: einen inferenzorientierten Beschleuniger, der auch minen kann, beginnend mit einer vierwöchigen Studie zu J/Op. und $/Op.; Custom-Silicon-Dienste mit Krypto als erstem Kunden, beginnend mit bezahlten Machbarkeitsstudien; und ein KI-natives Netz, das seinen Compute-Käufer gewinnt, bevor es seinen Token entwirft.
Vollständigen Bericht und Folien herunterladen
Der vollständige Bericht behandelt Pearls Mechanismus, Ökonomie und Regeln im Detail, die anderen Ketten mit nützlicher Arbeit und das weitere Feld KI × Krypto, das ASIC-Modell mit seiner Amortisationsrechnung, Urteile Chip für Chip, Kosten und Wahl der Knoten, ein gestuftes Budget für einen ersten Chip, eine Liste von Wegmarken und alle Quellen.
- Rechenleistung als Konsens: vollständiger Bericht (PDF)
- Rechenleistung als Konsens: Folien (PDF)
- Englische Ausgabe: vollständiger Bericht · Folien
Dies ist eine Übersetzung der englischen Ausgabe; bei Abweichungen ist die englische Ausgabe maßgeblich.
Fragen, die Sie nicht gestellt haben, aber hätten stellen sollen
Bevor ich Geld oder Silizium in ein Projekt aus dem Feld KI × Krypto stecke, würde ich fragen: Wer kontrolliert die Arbeitsfunktion; wie hoch ist das Subventionsvielfache; was kostet die nächste Stufe, und welche Zahl stoppt Sie; wie hoch ist die Amortisations-Hashrate, samt p; was ist der Zweitmarkt des Chips; landet der Wert im Token oder im Eigenkapital; und wer ist der erste zahlende Kunde, namentlich?
Das sind Felder, die wir gemeinsam erkunden können, im fachlichen Austausch und in technischer Zusammenarbeit: kundenspezifische Chips für Mining, KI-Training und -Inferenz sowie Beschleuniger; KI-Entwicklung; und KI × Krypto-Systeme von der Kette über den Knoten bis zum Chip. Sie erreichen mich unter i@tanshuai.com.
Über den Autor
Tan Shuai ist Technologe und Gründer mit mehr als zwanzig Jahren Arbeit in Chips, Hardware und Systemsoftware sowie 20 erteilten Patenten. Er hat viele Jahre Fabless-Chip-Entwicklung und -Management hinter sich, darunter Full-Custom-ASIC-Datenpfaddesign für Mining-Chips für Kryptowährungen und Multimedia-Kamerachips. Seine Arbeit führte ihn durch das Silicon Valley, New York, Chicago, Taiwan, die Greater Bay Area (Shenzhen und Hongkong), Vietnam und Malaysia. Heute arbeitet er als KI-Forscher und -Entwickler.
Fachlicher Austausch: i@tanshuai.com.