
Een blockchain draait nu op dezelfde matrixvermenigvuldiging als AI, met ongeveer 90 EH/s. Ik las de code, de chaindata en de economie eromheen om drie vragen te beantwoorden: wat in AI × crypto betalende klanten heeft, wanneer een ASIC de moeite waard is, en welke procesnode bij welke chip past. Met het volledige rapport en de slides.
Samenvatting
Pearl, gelanceerd in april 2026, is de eerste blockchain waarvan de proof of work bestaat uit matrixvermenigvuldiging zoals AI die gebruikt, op schaal. Op 13 november 2026 draaide het netwerk op ongeveer 90 EH/s, waarbij één H één INT7-multiply-accumulate is: de integerdoorvoer van ongeveer 122.000 H100’s. Technisch werkt het. Nuttig is het nog niet: ongeveer 1% van de blokken bevat echt AI-werk, omdat een GPU die mint terwijl hij inferentie levert slechts 1% tot 27% van de hashrate van een toegewijde miner behoudt. In heel AI × crypto duikt verifieerbare betaalde vraag op drie plaatsen op, de verkoop van inferentie, de verkoop van data en de verkoop van privacy, terwijl subsidies oplopen van 4 tot 360 keer de externe omzet. Voor chips is het winstplafond van een ASIC de omzet per eenheid rekenkracht maal (1 − 1/k), dus efficiëntie voorbij k = 5 voegt weinig toe; wat beslist, zijn de omvang van de pot, de stabiliteit van de regels en een tweede markt. Geen enkel netwerk biedt vandaag alle drie. De juiste procesnode wordt bepaald door de grootste post in de levensduurkosten van een chip, en de chip zelf moet in fasen worden ingekocht, zodat een regelwijziging een prototype kost in plaats van een tape-out.
Waarom ik hiernaar keek
Ik heb vele jaren chips ontworpen, waaronder full-custom ASIC-datapaden voor het minen van cryptovaluta, en ik werk nu aan AI. Toen er een chain verscheen waarvan het beveiligingsbudget letterlijk in tensordoorvoer wordt uitgedrukt, lagen de vragen voor iemand zoals ik voor de hand: is het werk nuttig, zou een speciale chip winnen, en wat zou het kosten om er een te bouwen?
Ik las de code en de protocolvoorstellen van Pearl, chaindata van een onafhankelijke full node, jaarverslagen van bedrijven, papers over cryptografie, computerarchitectuur en machine learning, prijsgegevens van foundry’s en leveranciers, en de vakpers. Elk getal hieronder geldt per 13 november 2026, en bedragen zijn in Amerikaanse dollars. Deze notitie is hoe ik het vakgebied heb leren kennen; ik deel haar zodat anderen haar kunnen controleren, gebruiken en ertegen in kunnen gaan. Het volledige rapport, met alle bronnen, staat aan het eind.
Resultaten in één oogopslag
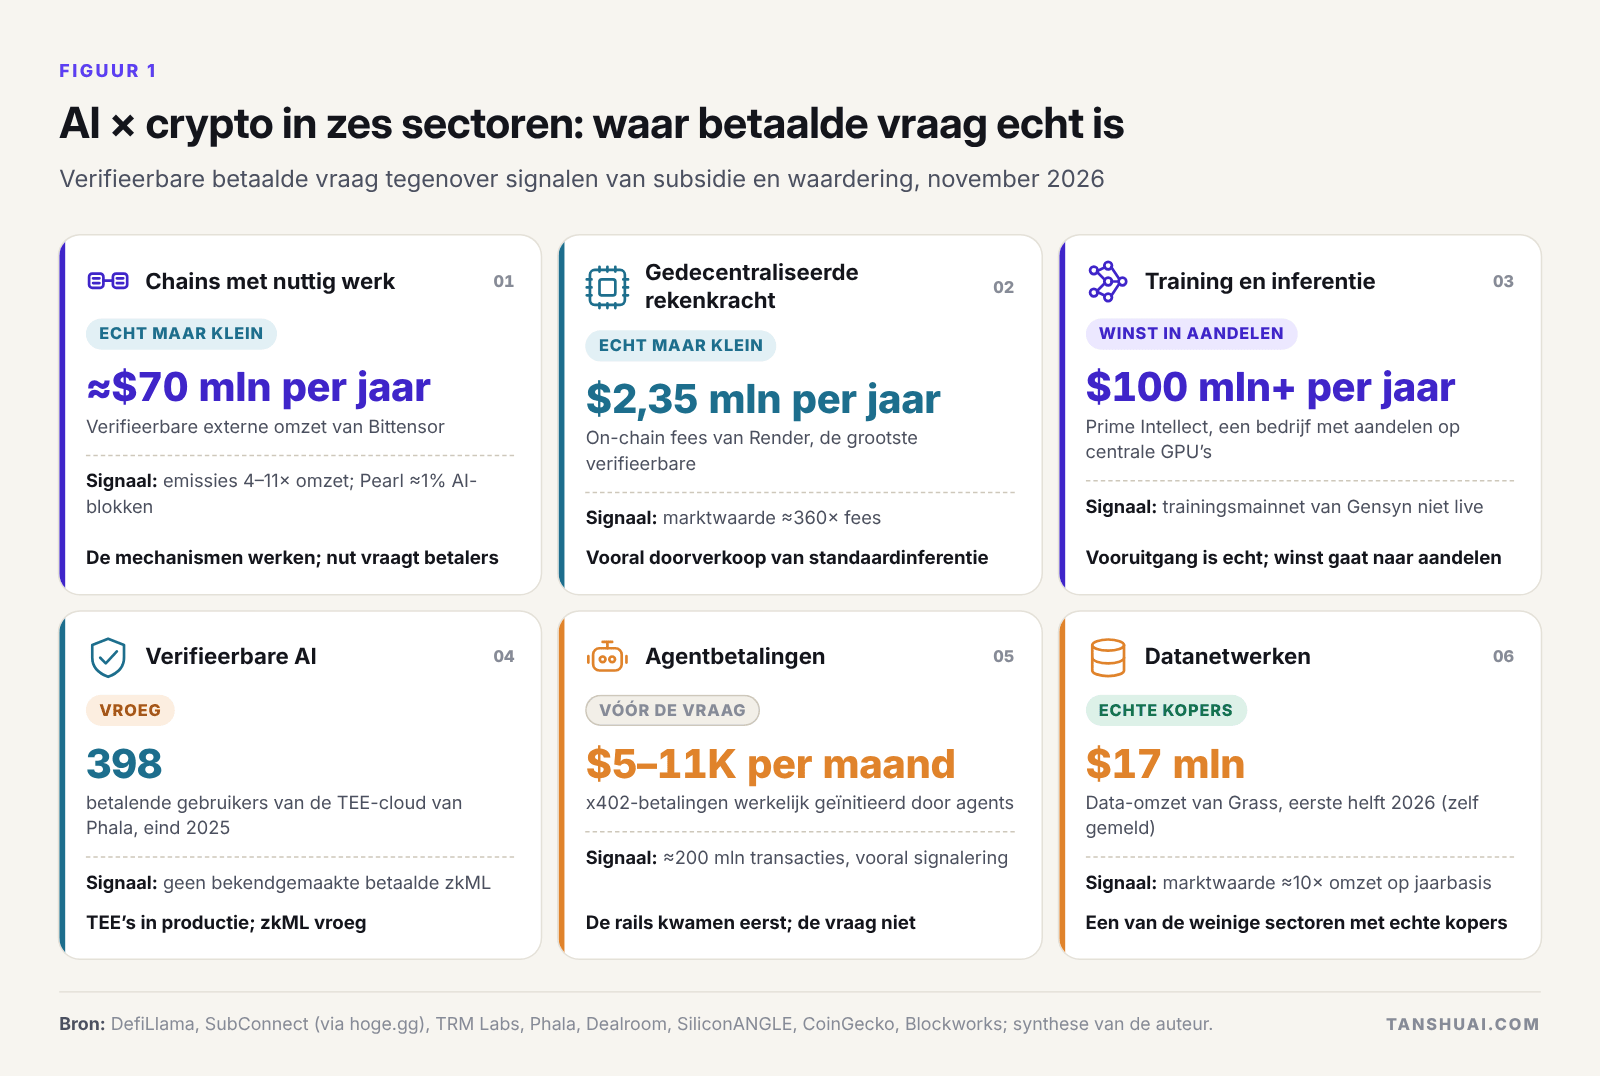 Figuur 1. AI × crypto in zes sectoren: waar betaalde vraag echt is.
| Vraag | Kort antwoord |
|---|---|
| Werkt Pearl, en is het werk nuttig? | Het werkt: ongeveer 90 EH/s aan matrixvermenigvuldiging beveiligt de chain. Nuttig is het nog niet: ongeveer 1% van de blokken bevat AI-werk |
| Waar zit de echte betaalde vraag? | Inferentie, data en privacy. Agentbetalingen, zkML en gedecentraliseerde training zitten nog vóór de vraag |
| Is een ASIC de moeite waard? | Alleen met een grote pot, stabiele regels en een tweede markt; geen enkel netwerk biedt vandaag alle drie |
| Welke chips moet een klein team bouwen? | Inferentie-eerst-accelerators die ook kunnen minen, inferentiechips voor een getekende klant, vroeg FHE-werk; geen commerciële bitcoinminers of trainingschips |
| Wat kost een eerste chip? | Koop hem in fasen: een model, een FPGA en een MPW leveren gemeten silicium op voor ongeveer $1,5 miljoen, vóór maskers die miljoenen kosten |
Pearl: één multiply-accumulate is één hash
Pearl berust op een resultaat uit 2025 van Ilan Komargodski en Omri Weinstein: een proof of useful work voor elk matrixproduct, tegen 1 + o(1) keer de kosten van de vermenigvuldiging. Miners vermenigvuldigen ruisige matrices, hashen de accumulator van elke uitvoertegel tot een loterijlot en bewijzen de winnende tegel met een zero-knowledge-bewijs van minder dan 60 KB. In de consensuscode is één H één gecrediteerde INT7 × INT7 → INT32-multiply-accumulate, dus voor het eerst wordt het beveiligingsbudget van een blockchain uitgedrukt in de tensordoorvoer van AI-accelerators.
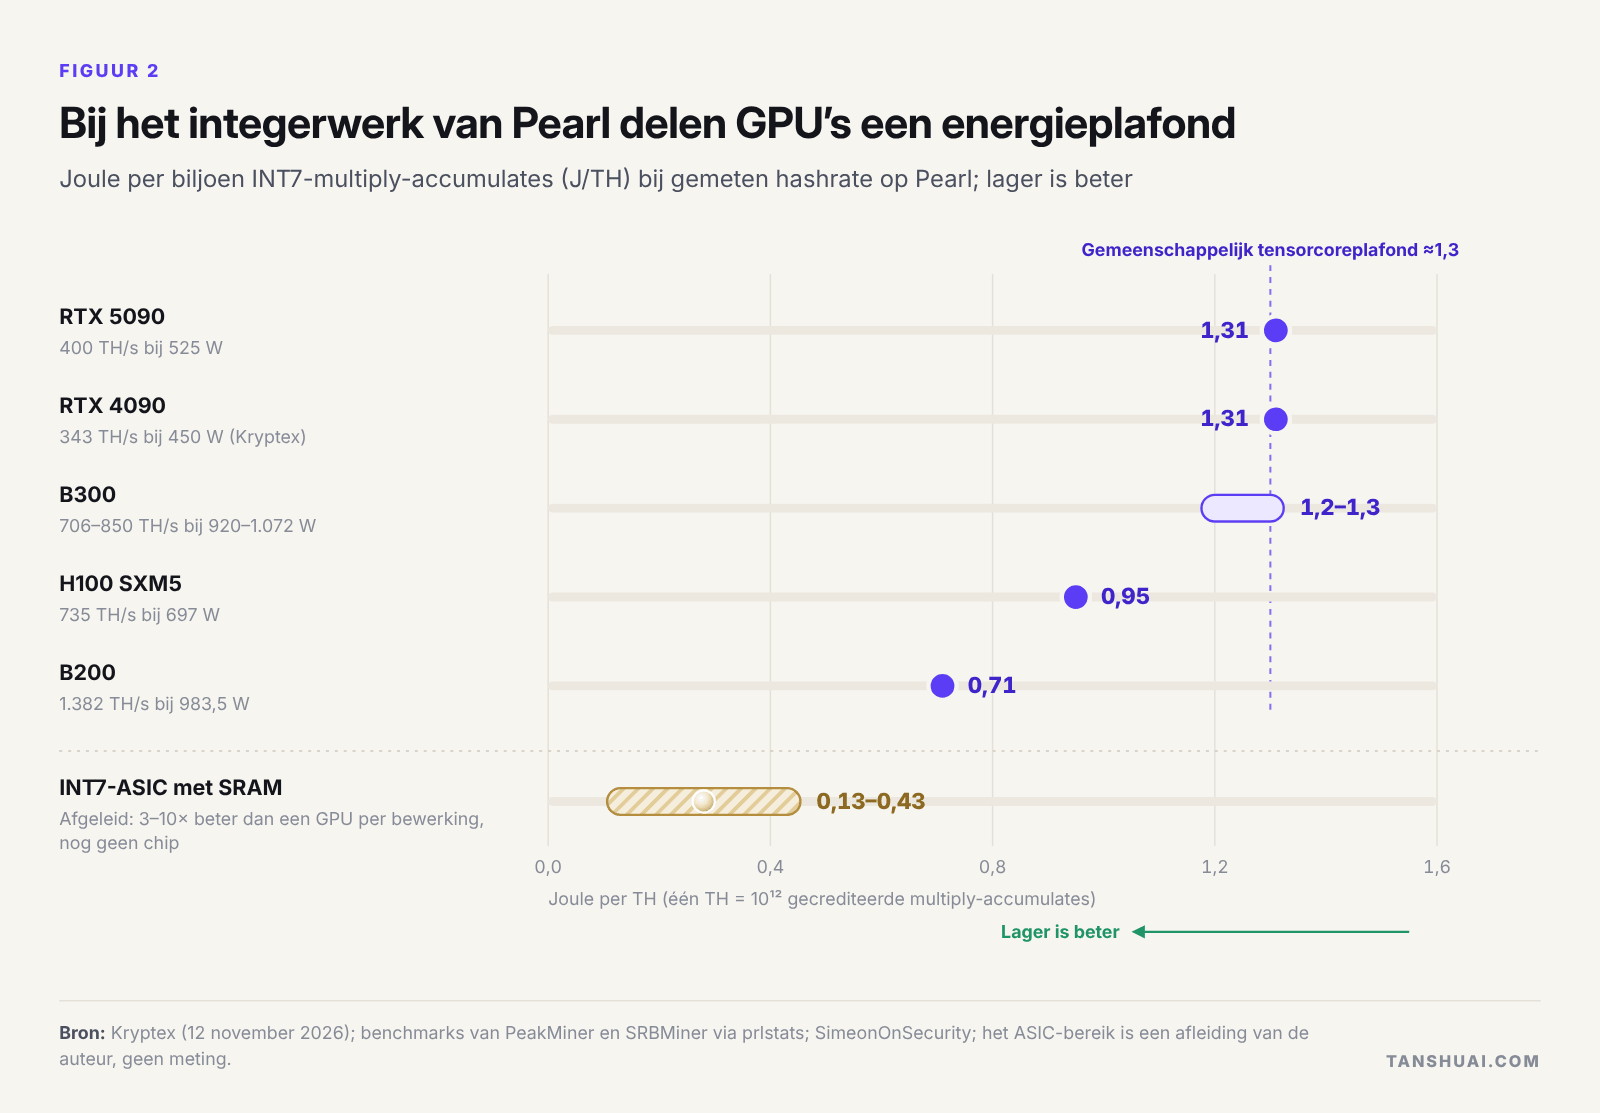 Figuur 2. Bij het integerwerk van Pearl delen GPU’s een energieplafond.
Gamingkaarten en de datacenterkaart B300 komen samen uit op ongeveer 1,3 J/TH, en zelfs de B200 haalt slechts 0,71. Dat gedeelde plafond is precies wat een speciale chip zou kunnen doorbreken: een onderdeel dat alleen 7-bits integers uit on-chip SRAM vermenigvuldigt, zonder HBM of eenheden voor algemeen gebruik, zou aannemelijk 3 tot 10 keer beter per bewerking kunnen presteren. Intussen beweegt NVIDIA zijn nieuwste silicium weg van INT8 richting FP8 en FP4, en daarom bereidt Pearl een wijziging van zijn rekenkunde voor.
De economie van Pearl: de stelling klopt, de prikkel niet
De hashrate van Pearl volgt de prijs. Het netwerk ging van 0,01 EH/s op de tweede dag naar 23–26 EH/s eind mei, bleef op 21–39 EH/s gedurende een zomer waarin de prijs ongeveer 86% daalde, en bereikte ongeveer 90 EH/s nadat de prijs in de herfst ongeveer vertienvoudigde. Ongeveer 120 miljoen munten, ruwweg 32% van het huidige aanbod, werden in de eerste zes dagen gedolven, en het aanbod groeit in de komende 12 maanden met ongeveer 78%. Een RTX 5090 verdient nu ongeveer $5–6 per dag.
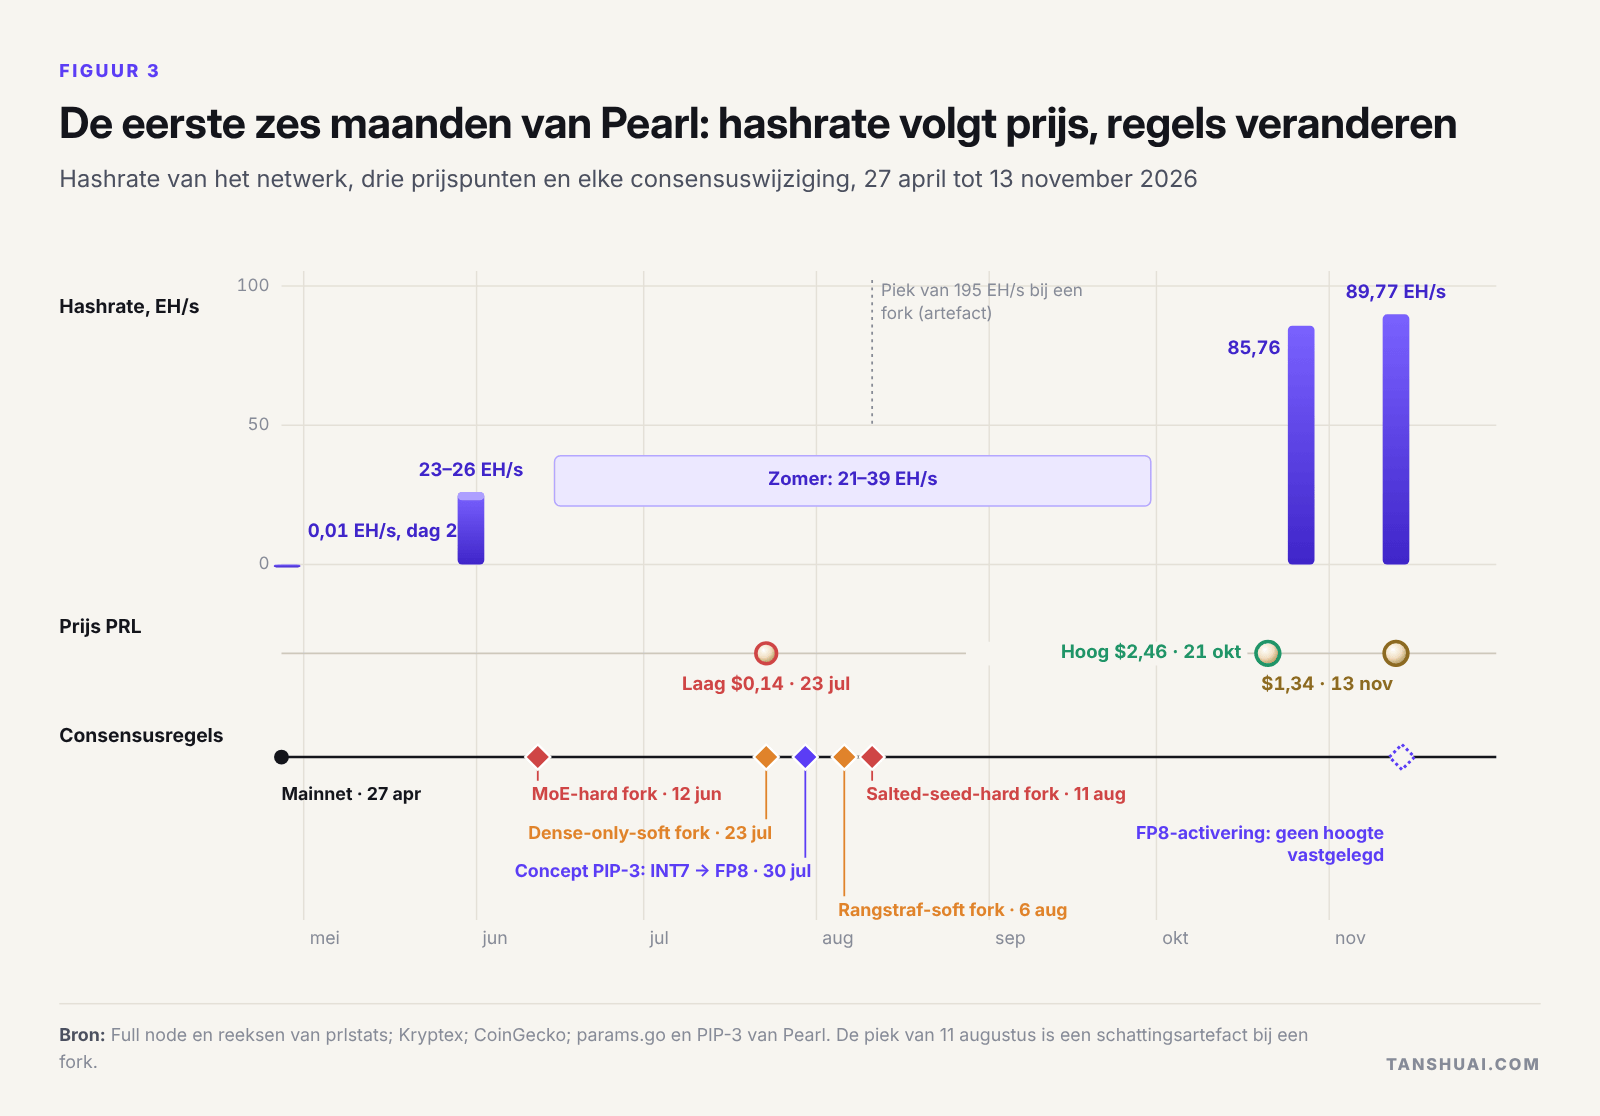 Figuur 3. De eerste zes maanden van Pearl: de hashrate volgt de prijs, de regels blijven veranderen.
Het nuttige deel is waar het model breekt. Minen binnen echte inferentie kost aan de inferentiekant weinig, ongeveer 5% tot 9% van de doorvoer, maar levert aan de miningkant weinig op: de plug-in van Pearl mint alleen op lange prefill-batches, dus een kaart die een chatworkload bedient, behoudt ongeveer 5% van de hashrate van een toegewijde miner. Rationele miners vermenigvuldigen daarom willekeurige matrices, en het protocol kan het verschil niet zien. Het ene openbare inferentiepartnerschap staat niet meer op de serverless API van de aanbieder. Het nut van Pearl is een commercieel probleem buiten de chain: iemand moet voor de inferentie betalen.
De regels zijn het andere risico. Van juni tot augustus activeerde het lab vier consensuswijzigingen op hardgecodeerde hoogtes, en zijn concept PIP-3 verplaatst minen naar FP8 met bit-exacte apparaatprofielen voor slechts twee NVIDIA-architecturen. Een getalformaat kan nuttig zijn voor AI, bit voor bit verifieerbaar en hardwareneutraal, maar hooguit twee van de drie.
In heel AI × crypto: subsidie is brandstof, geen verdienmodel
Andere chains met nuttig werk vertellen hetzelfde verhaal. Kaspa stopte een matrixproduct in zijn hash en kreeg toch binnen 16 maanden ASIC’s; zijn beste machine verdient nu $0,86 per dag. De synthetische bewijspuzzel van Aleo kreeg binnen vijf maanden speciale hardware en betaalde provers 175–180 keer de fees. Bittensor is het enige netwerk in de groep met externe omzet op schaal, ongeveer $70 miljoen per jaar, tegenover meer dan $300 miljoen aan emissies.
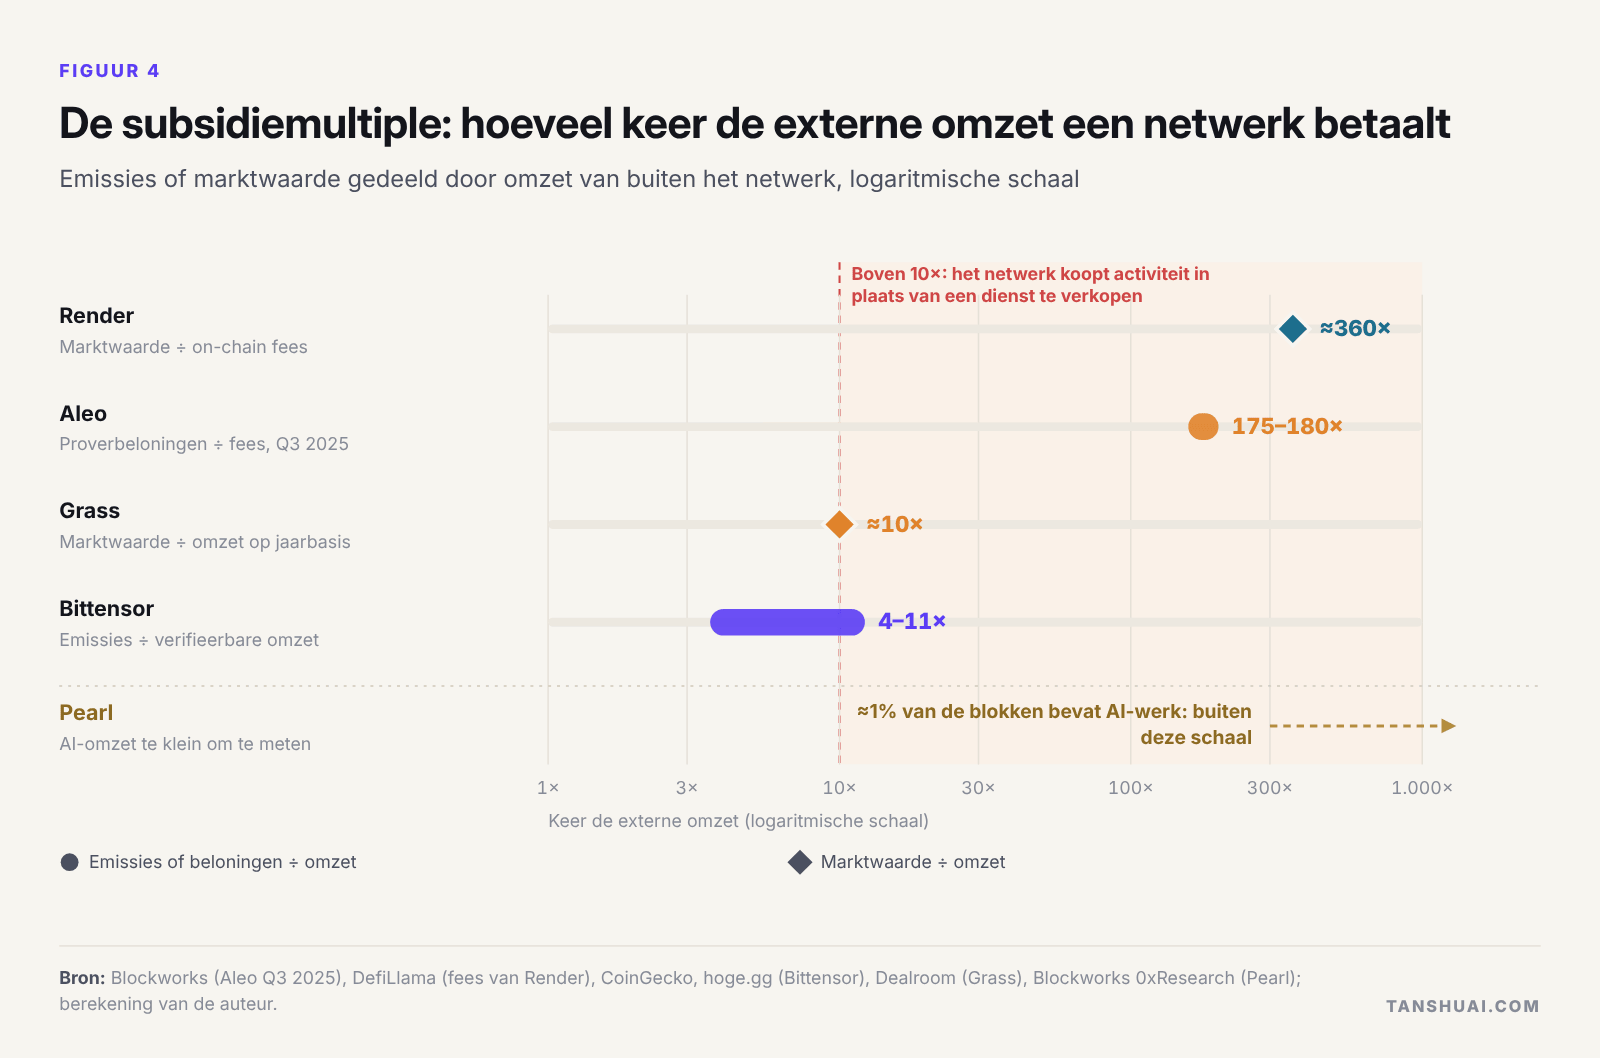 Figuur 4. De subsidiemultiple: hoeveel keer de externe omzet een netwerk betaalt.
Buiten de consensus is het beeld: echte vraag op kleine schaal. Gedecentraliseerde GPU-markten verkopen standaardinferentie en verslaan de prijzen van de hyperscalers, maar niet die van de goedkoopste neoclouds. Training via het internet werkt op 8 tot 40 miljard parameters, terwijl frontierruns teruggingen naar centrale clusters. Trusted execution environments draaien vertrouwelijke inferentie in productie; zero-knowledge-bewijzen van AI zitten nog in het lab. Betalingen die door AI-agents worden geïnitieerd, komen uit op ongeveer $5.000–11.000 per maand, ondanks rails die zijn gebouwd door Visa, Mastercard, Stripe en Google. Data is een van de weinige sectoren met echte kopers. Intussen zijn vier bedrijven met aandelenkapitaal op centrale infrastructuur ongeveer evenveel waard als alle AI-tokens op protocol- en applicatielaag samen: crypto doet distributie en afwikkeling, en aandelen nemen de winst.
Wanneer een ASIC loont: één formule, drie maatstaven
Wanneer GPU’s de prijs van minen bepalen, neigt de omzet per eenheid rekenkracht naar hun kosten, en een ASIC die k keer goedkoper is, houdt hooguit (1 − 1/k) van de omzet over. De curve is concaaf: 50% bij k = 2, 80% bij k = 5, 90% bij k = 10. Voorbij k = 5 voegt meer efficiëntie weinig winst toe; en tegenover stilstaande GPU’s die alleen voor stroom betalen, is de effectieve k misschien slechts ongeveer 2,5.
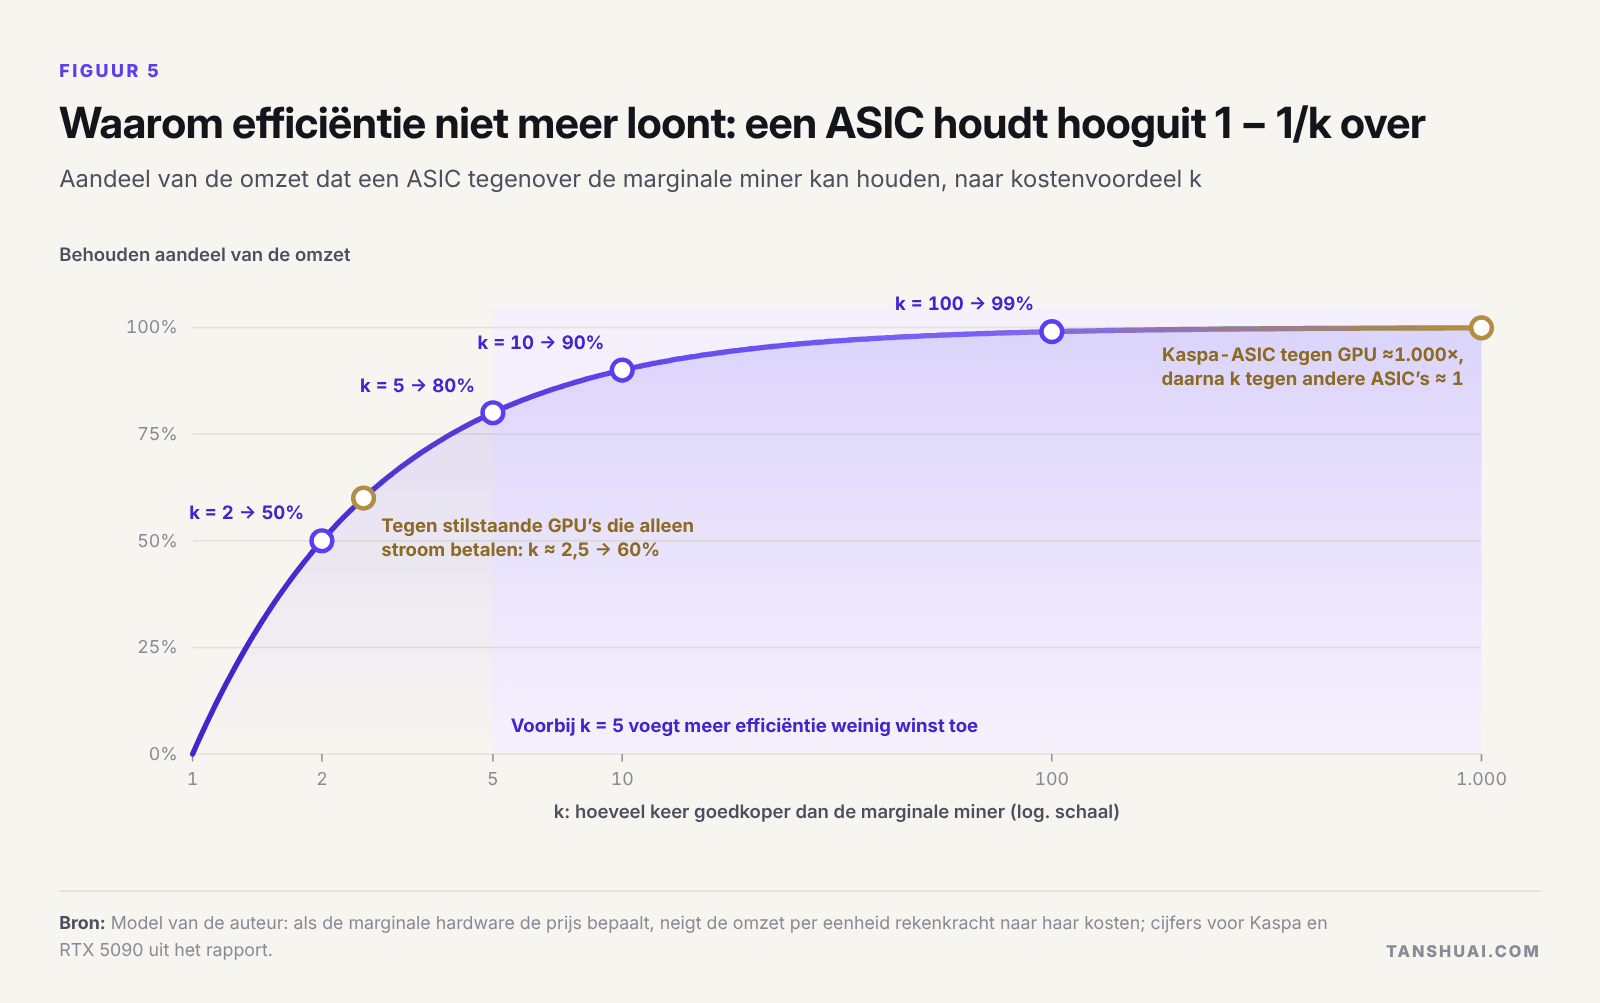 Figuur 5. Waarom efficiëntie niet meer loont: een ASIC houdt hooguit 1 − 1/k van de omzet over.
Daarna beslissen drie maatstaven: de pot, de terugverdienschaal en de regels. Bitcoinminers verdienen ongeveer $11,5 miljard per jaar, die van Pearl ongeveer $0,46–0,49 miljard, die van Aleo ongeveer $31 miljoen en die van Kaspa ongeveer $18 miljoen, minder dan de onderkant van één chipontwerp op 5/4 nm. Voor Pearl heeft een chip van $20 miljoen met k = 5 ongeveer 4,9 EH/s nodig die een jaar draait om zich terug te verdienen als de regels standhouden, en twee keer zoveel als ze slechts met een kans van fifty-fifty standhouden.
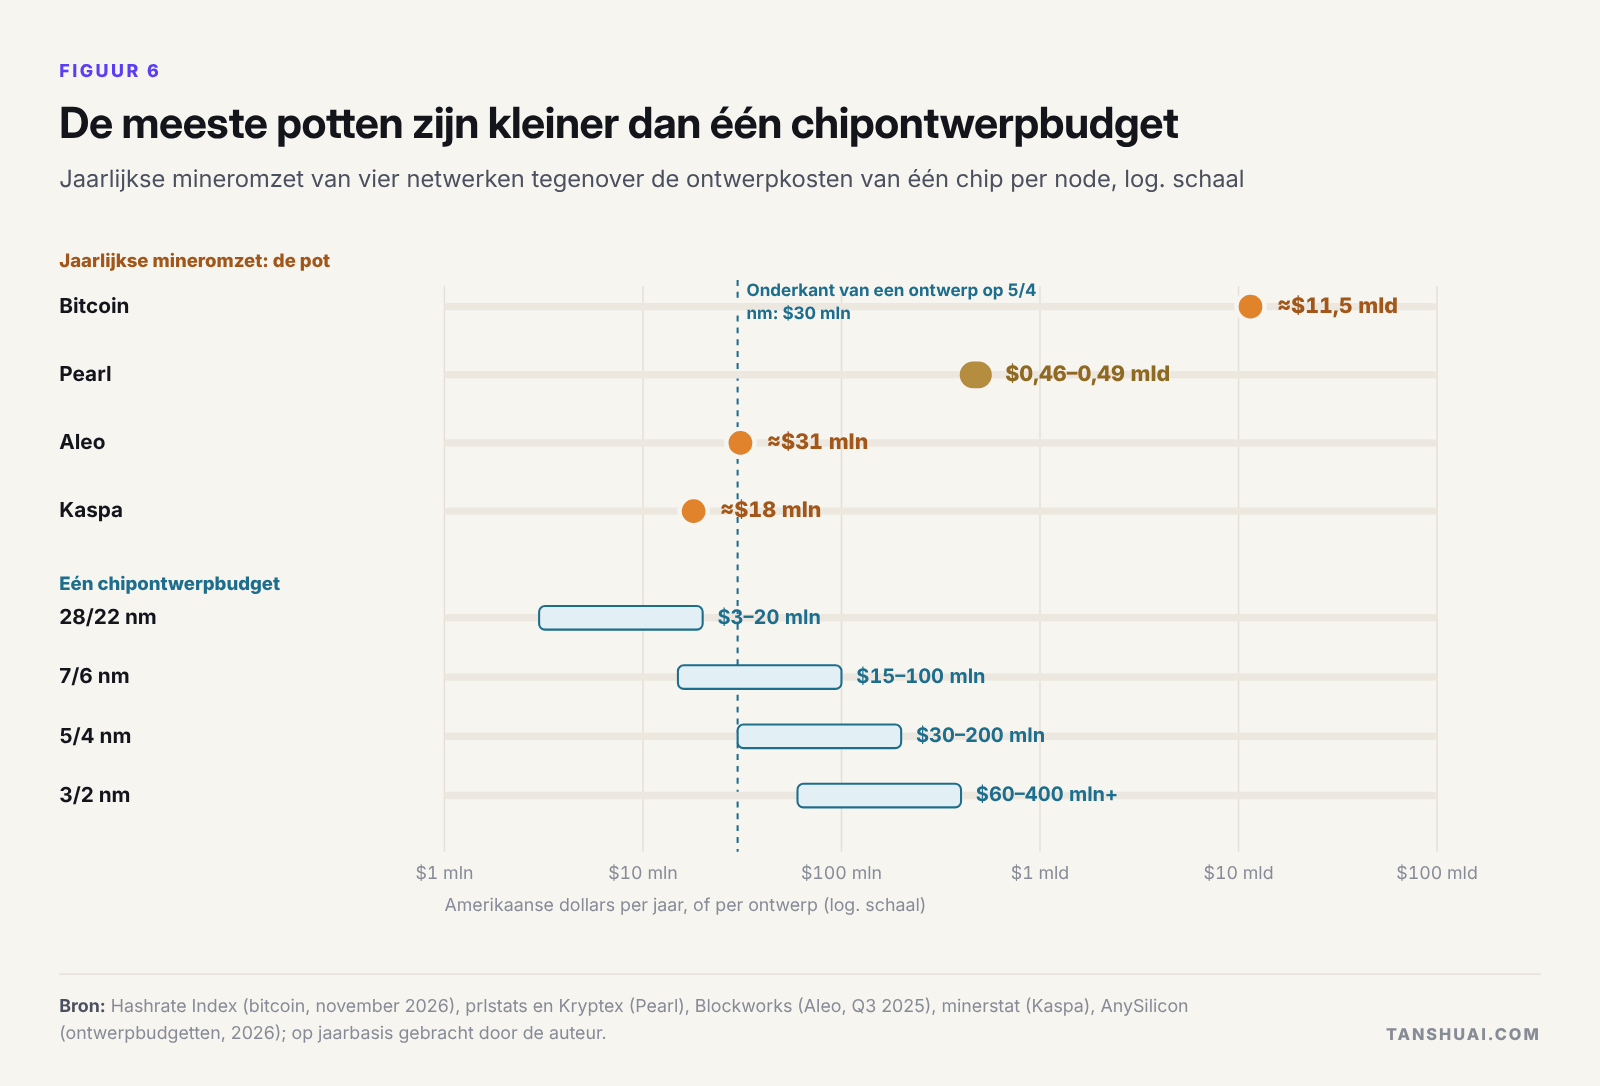 Figuur 6. De meeste potten zijn kleiner dan één chipontwerpbudget.
Vandaag biedt geen enkel netwerk tegelijk een grote pot, stabiele regels en een k boven 1: de k van bitcoin is van de gevestigde spelers, de regels van Pearl zijn het minst stabiel, en de potten van Kaspa en Aleo zijn te klein.
Vijf chiptypen, vijf antwoorden
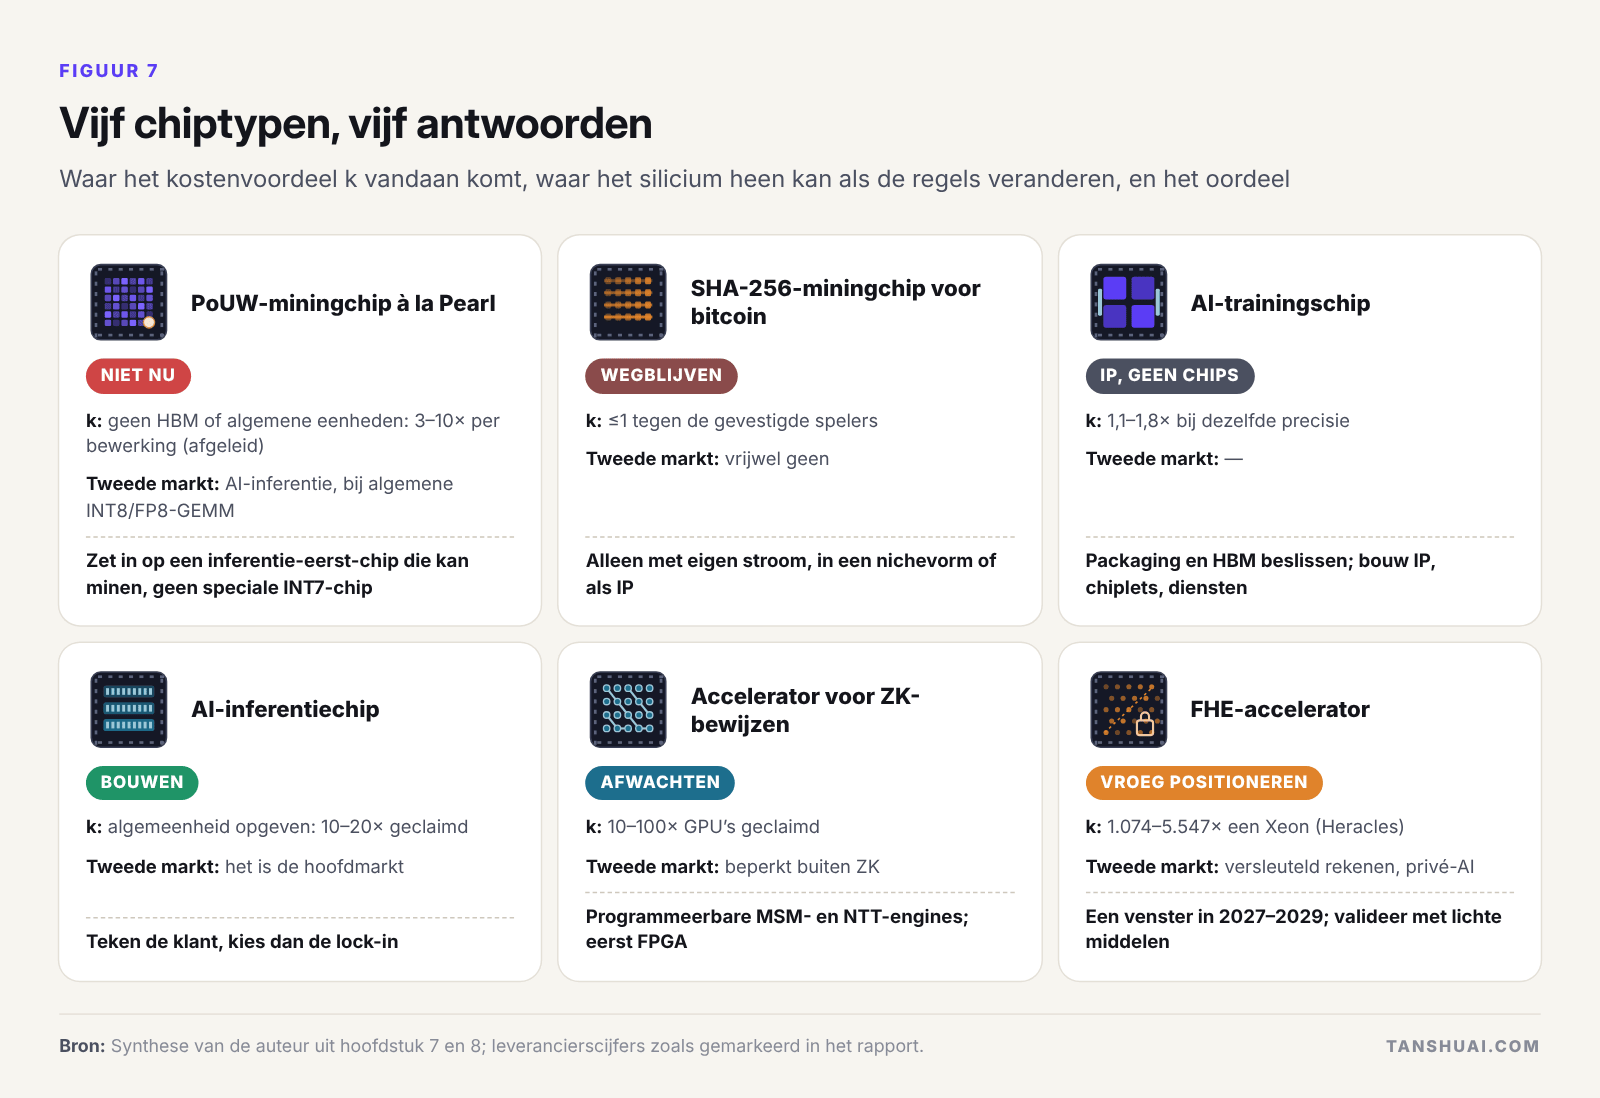 Figuur 7. Vijf chiptypen, vijf antwoorden.
Voor Pearl zou ik nu geen speciale INT7-chip uittapen: een nieuw team heeft 18 tot 24 maanden nodig, en het protocol kan tegen die tijd naar FP8 zijn overgestapt. De betere weddenschap is een inferentie-eerst-accelerator gebouwd op algemene INT8/FP8-GEMM met operanden in SRAM, zodat het silicium een tweede markt heeft als de toegang tot minen wordt afgesloten. Een nieuw team moet wegblijven uit de markt voor commerciële bitcoinminers, waar Bitmain machines van 8,9 J/TH levert en uitdagers zich terugtrekken; stroomlocaties zijn nu meer waard als AI-datacenter dan als mijn. Kleine teams moeten geen losse trainingschips bouwen. Inferentiechips zijn de moeite waard voor een getekende klant, ZK-accelerators zijn een indekking, en FHE-accelerators zijn een vroege positie voor 2027–2029.
Procesnodes en een gefaseerd budget
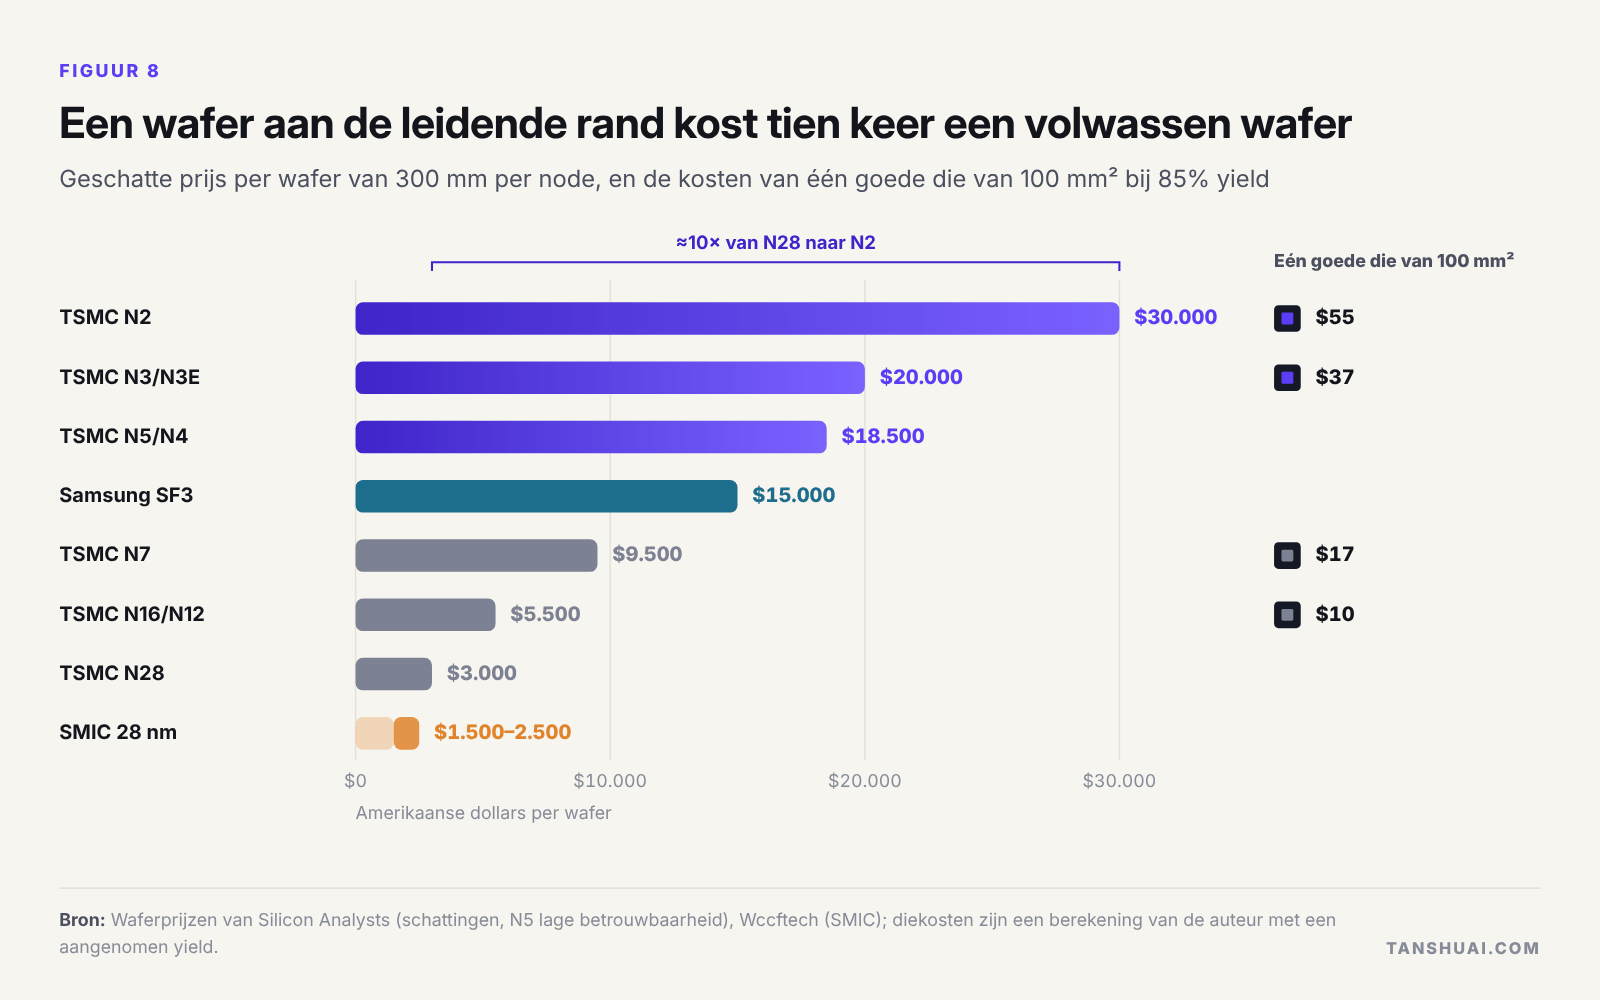 Figuur 8. Een wafer aan de leidende rand kost tien keer zoveel als een volwassen wafer.
Laat de grootste post in de levensduurkosten van de chip de node kiezen: energie voor rekenchips die dag en nacht draaien, packaging en HBM voor trainingschips (ongeveer 63% van de kosten van een H100), en de keuze tussen SRAM en HBM voor inferentiechips. Een PoUW-miningchip kan als prototype worden gemaakt op multi-project wafers op 28 of 16/12 nm en pas naar N7/N6 en daarna N5/N4 gaan zodra het algoritme en de omzet stabiel zijn.
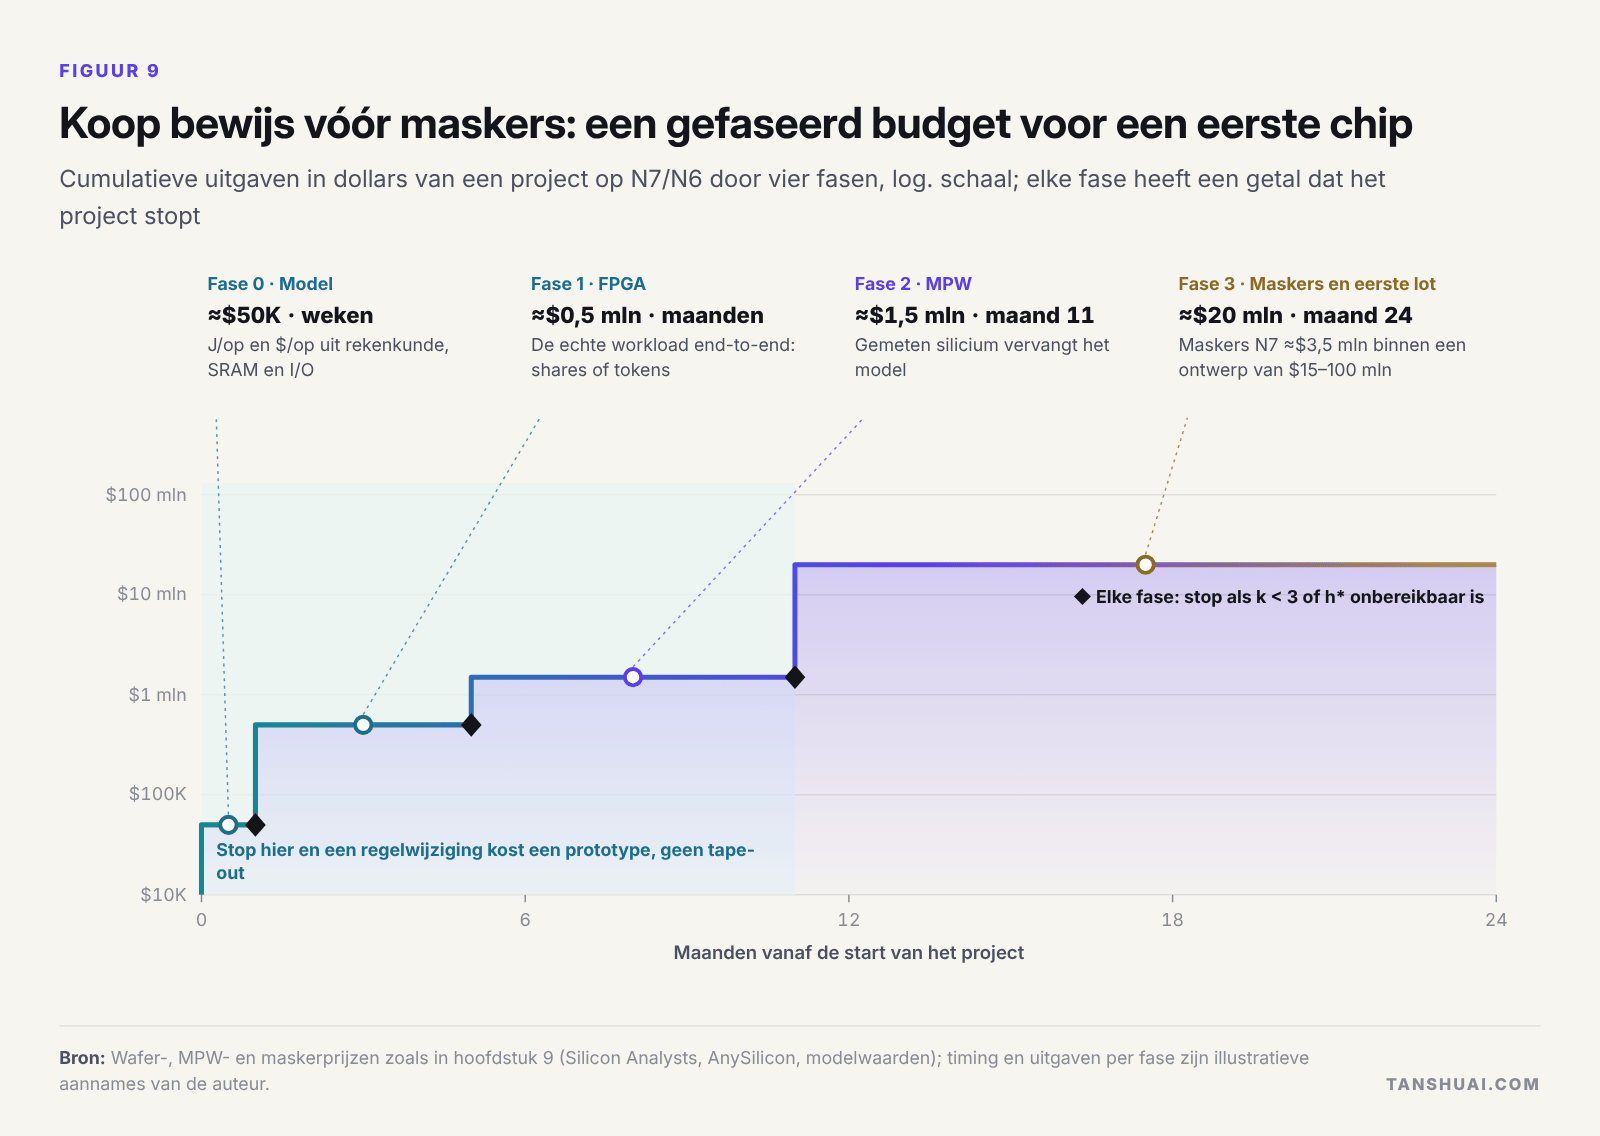 Figuur 9. Koop bewijs vóór maskers: een gefaseerd budget voor een eerste chip.
Een eerste chip moet in vier fasen worden ingekocht, elk met een getal dat het project stopt: een model van J/op en $/op, een FPGA die de echte workload draait, een multi-project wafer, en pas daarna een maskerset. Op N7/N6 kosten de eerste drie ongeveer $1,5 miljoen en elf maanden; de maskerset en de eerste lot kosten meer dan tien keer zoveel [schatting]. Als het protocol zijn rekenkunde verandert of de koper afhaakt, verliest een team dat bij de wafer is gestopt de prijs van een prototype, niet die van een tape-out. De goedkoopste efficiëntie is architecturaal: operanden in SRAM houden en HBM weglaten, haalt het grootste deel van de kosten van een GPU weg voordat er een node is gekozen.
Waar ik zou beginnen
De kansen liggen waar de vakgebieden elkaar kruisen: crypto als eerste klant, AI als tweede markt. De vraag naar maatwerkchips komt in 2026 overweldigend uit AI, en de vaardigheden van een miningchipteam, arrays op lage spanning, stroomvoorziening in de kilowattklasse en snelle tape-outs, zijn direct overdraagbaar. Ik zou hooguit drie paden nemen, elk getoetst met een kleine eerste stap: een inferentie-eerst-accelerator die ook kan minen, te beginnen met een studie van vier weken naar J/op en $/op; maatwerksiliciumdiensten met crypto als eerste klant, te beginnen met betaalde haalbaarheidsstudies; en een AI-native netwerk dat zijn koper van rekenkracht tekent voordat het zijn token ontwerpt.
Download het volledige rapport en de slides
Het volledige rapport behandelt in detail het mechanisme, de economie en de regels van Pearl, de andere chains met nuttig werk en het bredere landschap van AI × crypto, het ASIC-model met zijn terugverdienrekensom, oordelen per chiptype, kosten en keuzes van nodes, een gefaseerd budget voor een eerste chip, een lijst van wegwijzers en alle bronnen.
- Rekenkracht als consensus: volledig rapport (PDF)
- Rekenkracht als consensus: slides (PDF)
- Engelse editie: volledig rapport · slides
Dit is een vertaling van de Engelse editie; waar de twee verschillen, is de Engelse editie leidend.
Vragen die je niet stelde maar wel had moeten stellen
Voordat ik geld of silicium in een AI × crypto-project steek, zou ik vragen: wie de werkfunctie beheerst; wat de subsidiemultiple is; wat de volgende fase kost en welk getal je laat stoppen; wat de terugverdienhashrate is, met p; wat de tweede markt van de chip is; of de waarde in de token of in de aandelen terechtkomt; en wie de eerste betalende klant is, bij naam.
Dit zijn gebieden die we samen kunnen verkennen, via technische uitwisseling en technische samenwerking: maatwerkchips voor mining, AI-training en -inferentie, en accelerators; AI-ontwikkeling; en AI × crypto-systemen van chain tot node tot chip. Je kunt me bereiken via i@tanshuai.com.
Over de auteur
Tan Shuai is technoloog en oprichter, met meer dan twintig jaar werk in chips, hardware en systeemsoftware, en 20 verleende octrooien. Hij heeft vele jaren R&D en management van fabless chips achter de rug, waaronder full-custom ASIC-datapadontwerp voor miningchips voor cryptovaluta en multimediacamerachips. Zijn werk bracht hem naar Silicon Valley, New York, Chicago, Taiwan, de Greater Bay Area (Shenzhen en Hongkong), Vietnam en Maleisië. Vandaag werkt hij als AI-onderzoeker en -ontwikkelaar.
Technische discussie: i@tanshuai.com.