
As redes neuronais já moldam quase todos os vídeos que vê, mas nas duas pontas de um codec normalizado, não em vez dele. Eis onde a codificação neural chega ao mercado em 2026, quanto custa em silício e quem ganha dinheiro com ela, com o relatório completo e os diapositivos.
Resumo
Em 2026, a codificação neural já está generalizada, mas funciona em torno dos codecs normalizados em vez de os substituir. As redes moldam a imagem antes da codificação, nas câmaras dos telemóveis e na cadeia de codificação da Netflix, e reparam-na depois da descodificação, com o Super Resolution do YouTube, na Meta e nos processadores dos televisores; pelo meio, o fluxo de bits continua a ser AV1, HEVC, AVC ou VVC, descodificado por hardware de função fixa. Os codecs neurais de ponta a ponta só chegam ao mercado em circuitos fechados, onde uma empresa controla as duas pontas: o MLVC da Microsoft nas chamadas do Teams, os tokenizadores dentro de cada modelo de voz e de vídeo, as texturas neurais num jogo. A reprodução em massa de fluxos de bits neurais espera pelo H.267, previsto para o final de 2029, e por um ciclo de silício posterior. A razão está no chip: o único projeto publicado de descodificador de vídeo neural precisa de cerca de 12 vezes a energia por píxel de um descodificador HEVC medido, e um codec de investigação rápido precisa de cerca de 22 TOPS para 1080p30. O dinheiro segue as normas e as plataformas; as startups de codecs neurais mais conhecidas foram adquiridas.
Porque analisei este tema
De poucos em poucos meses, alguém me diz que os codecs de IA estão prestes a substituir o H.264, o HEVC e o AV1. A maior parte do que leio sobre o assunto vem de artigos de investigação, onde estão os recordes de compressão, ou de fornecedores. Nenhum deles diz grande coisa sobre o que chega realmente ao mercado, a quem e a que custo.
Tenho muitos anos de I&D e de gestão de chips fabless, incluindo conceção full-custom de caminhos de dados de ASIC e projetos de chips multimédia para câmaras, como aceleradores de codecs de vídeo, por isso analisei o tema como avaliaria um chip: energia por píxel, tráfego de memória, o que uma norma permite fixar em silício e quem paga. Li documentos de normalização e relatórios de reuniões da JVET, do MPEG, do JPEG, da AOMedia e da IETF, blogues de engenharia de empresas, artigos sobre chips, tabelas de tarifas de agrupamentos de patentes, textos de controlo de exportações e a imprensa. Todos os números abaixo se referem a 12 de novembro de 2026, e os valores monetários estão em dólares dos EUA. O relatório completo, com todas as fontes, está no fim.
Resultados em resumo
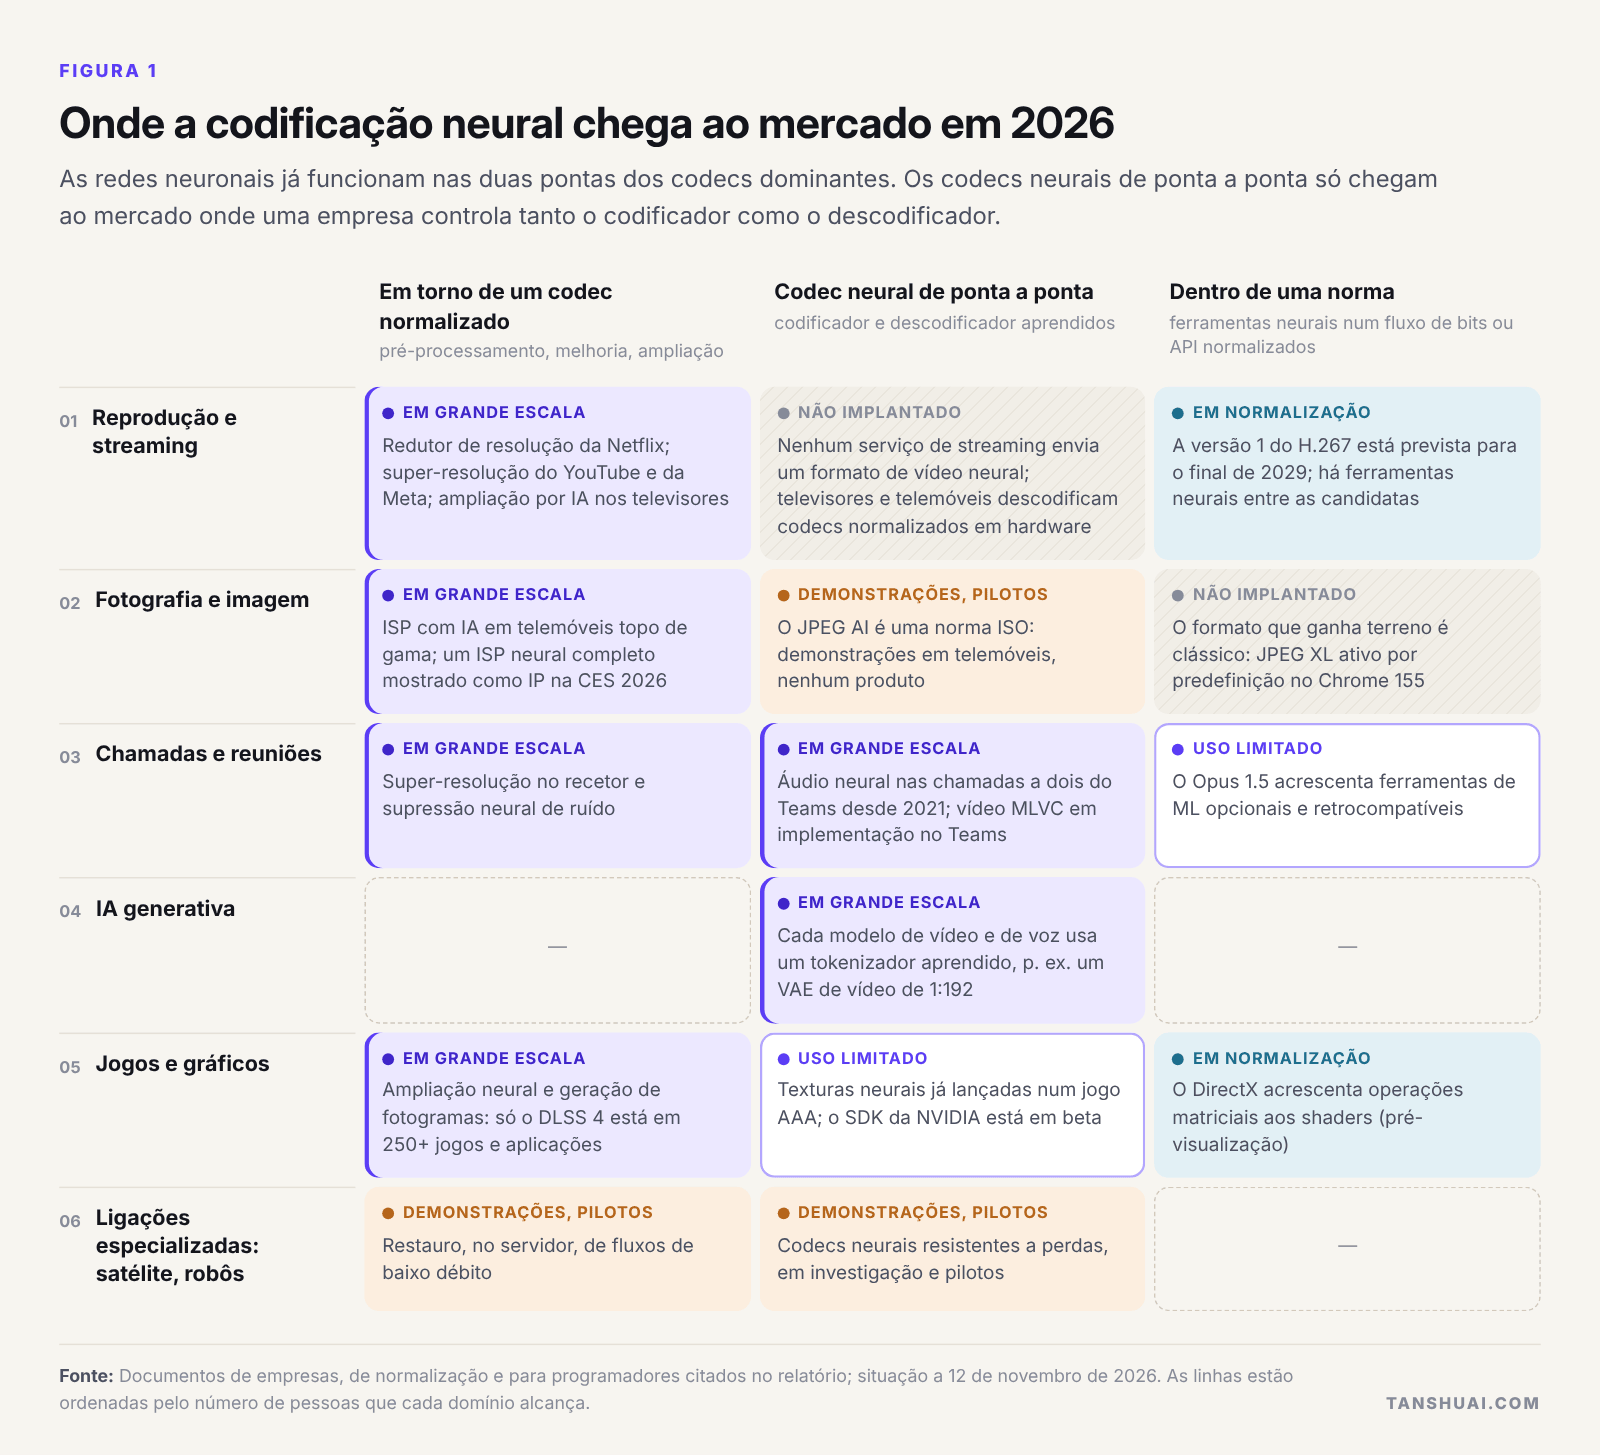 Figura 1. Onde a codificação neural chega ao mercado em 2026. As linhas estão ordenadas pelo número de pessoas que cada domínio alcança.
| Pergunta | Resposta curta |
|---|---|
| Onde chega a codificação neural ao mercado em grande escala? | Em torno do codec: ISP das câmaras, redução de resolução na codificação, super-resolução na reprodução. De ponta a ponta, só em circuitos fechados: chamadas, recursos de jogos, tokenizadores de IA generativa |
| Os codecs neurais vão substituir o AV1, o HEVC e o VVC na reprodução? | Não antes do H.267 (versão 1 no final de 2029) e de um ciclo de dispositivos posterior; generalização em meados da década de 2030, pela minha estimativa |
| Quanto custa em silício? | Cerca de 12 vezes a energia por píxel de um descodificador HEVC em hardware, mais tráfego de memória e a exigência de descodificação exata ao bit |
| Quem ganha dinheiro? | As plataformas ficam com as poupanças; os fornecedores de IP e os agrupamentos de patentes recebem por projeto e por dispositivo; as startups de codecs neurais foram adquiridas |
| Onde pode uma empresa apostar? | Pré e pós-processamento neural, produtos em circuito fechado, silício que junta codec e NPU, e o trabalho de avaliação e de normalização entre uns e outros |
Três formas de entrar
«Codificação neural» abrange três coisas diferentes, e a maior parte das discussões sobre o tema nasce de as confundir. Uma rede pode trabalhar em torno de um codec normalizado, processando píxeis antes da codificação ou depois da descodificação, enquanto o fluxo de bits se mantém normalizado. Pode estar dentro de uma norma, como ferramenta que todos os descodificadores têm de executar, o que obriga a especificá-la com exatidão. Ou pode substituir o codec de ponta a ponta, com um codificador e um descodificador aprendidos que só funcionam em par.
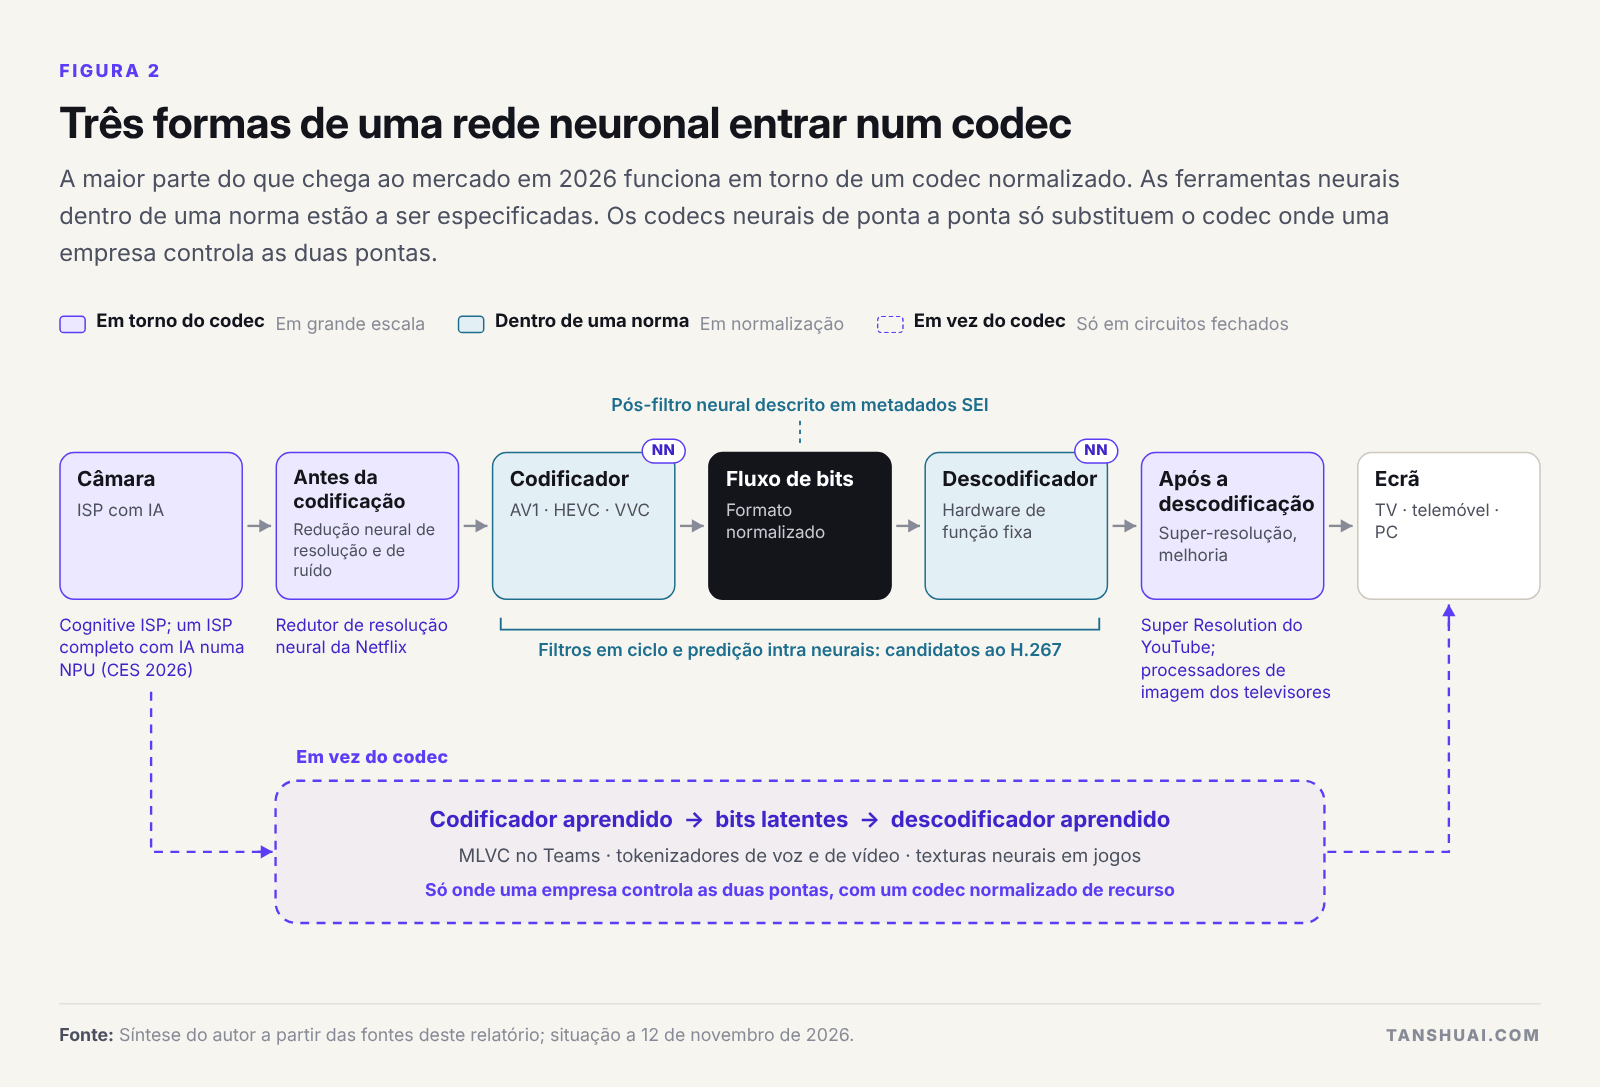 Figura 2. Três formas de uma rede neuronal entrar num codec. A maior parte do que chega ao mercado em 2026 é da primeira.
A primeira não precisa da autorização de ninguém. A segunda precisa de uma norma. A terceira precisa do controlo das duas pontas. É por essa ordem que chegam às pessoas.
Reprodução e streaming: neural nas duas pontas, normalizado no meio
Os grandes serviços concluíram uma transição de codec e estão a começar a seguinte, e nenhuma das duas envolve um descodificador neural. A Netflix informou em dezembro de 2025 que o AV1 transportava cerca de 30% das suas visualizações; o YouTube diz que mais de 90% do seu catálogo, ponderado pelo tempo de visualização, está disponível em AV1. O AV2 ficou concluído a 28 de maio de 2026, com uma compressão cerca de 30% melhor do que a do AV1, e em três semanas a Chips&Media, a Allegro DVT e a VeriSilicon já tinham anunciado clientes para descodificadores AV2. A TV 3.0 do Brasil começou as emissões comerciais em VVC em junho de 2026.
A parte neural está nas duas pontas. Desde 2022, a Netflix usa uma pequena rede neuronal em vez de um filtro convencional para reduzir a resolução dos seus masters, o que não exige qualquer alteração nos dispositivos e foi preferido por cerca de 77% dos espetadores nos testes da Netflix. O YouTube usa aprendizagem automática para ampliar nos televisores os vídeos carregados abaixo de 1080p, a Meta usa super-resolução nos seus servidores e nos telemóveis, e o processador de televisor topo de gama da Samsung anuncia 768 redes de ampliação.
O que não existe é um fluxo de bits neural nos ecrãs do grande público, e a razão é o tempo. Um formato de reprodução tem de ser descodificável em todos os dispositivos que alguma vez o vão reproduzir. O AV1 levou quase oito anos da especificação concluída até 30% das visualizações da Netflix.
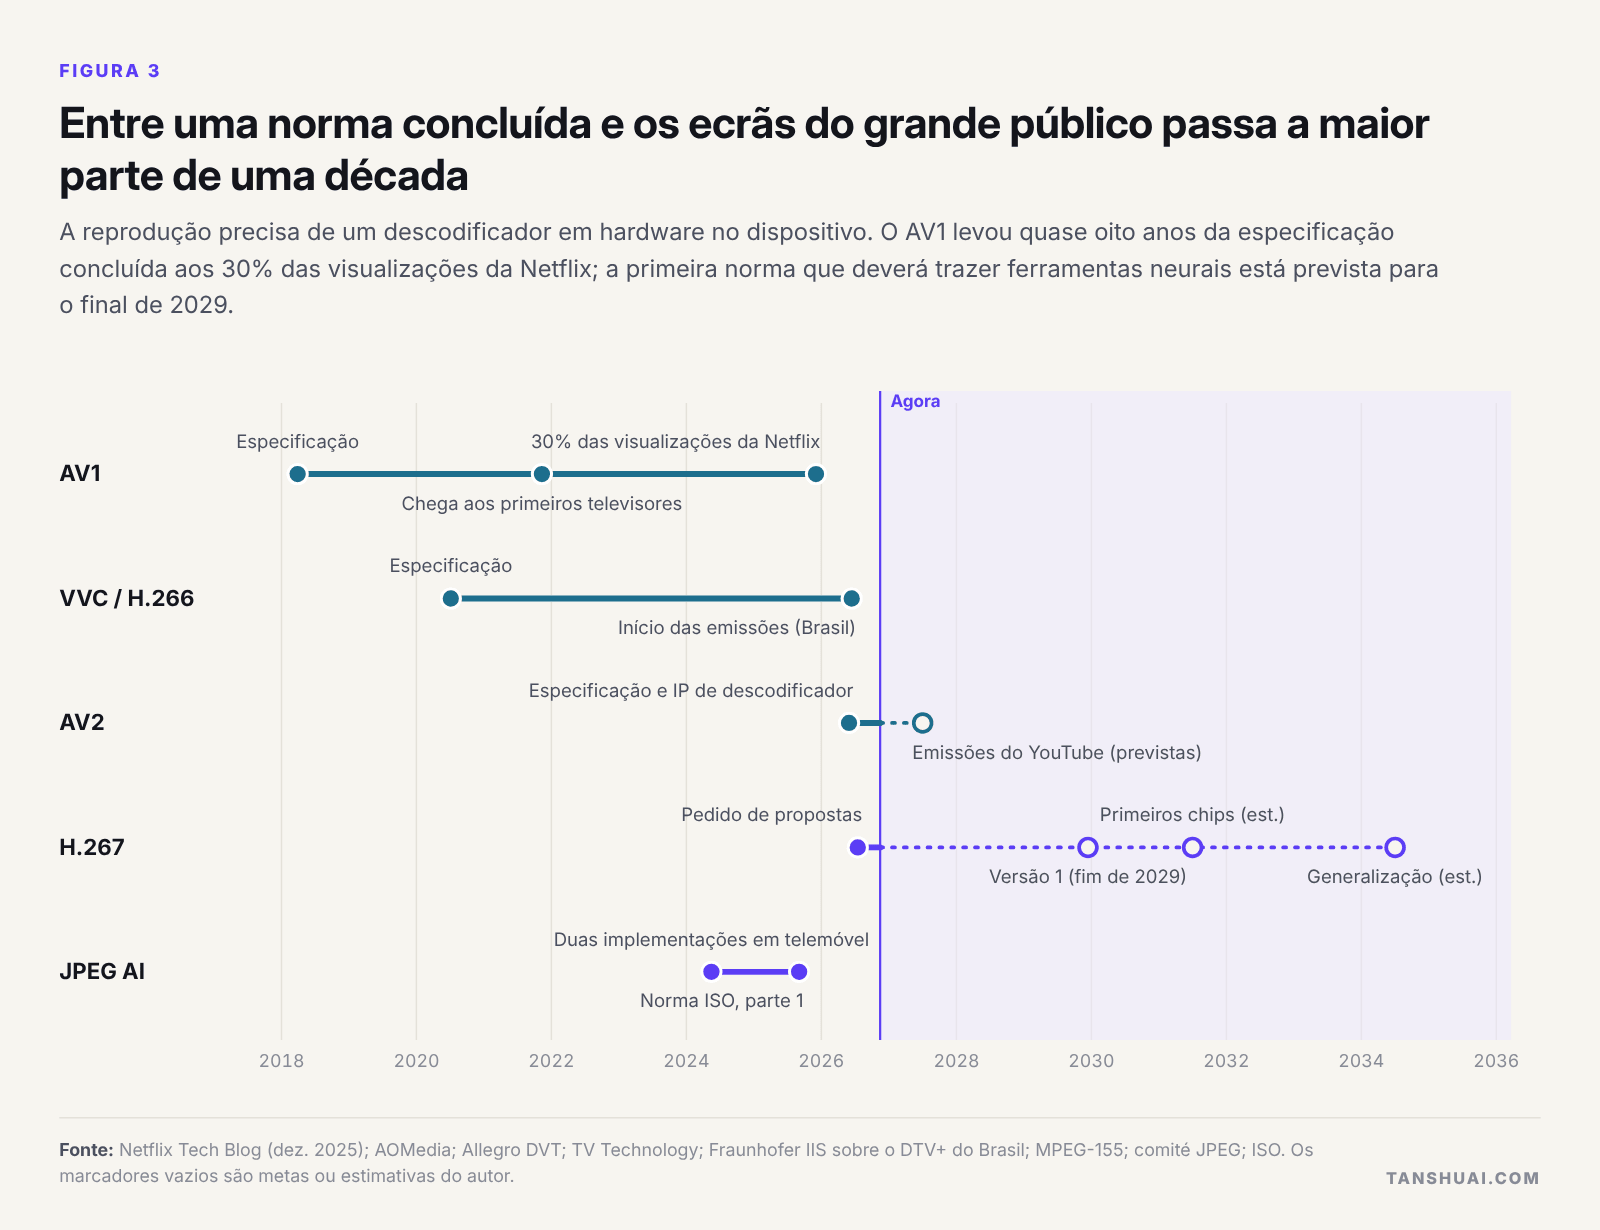 Figura 3. Entre uma norma concluída e os ecrãs do grande público passa a maior parte de uma década.
A norma que poderá levar ferramentas neurais a todos os ecrãs é o H.267, o nome provisório do sucessor do VVC. A JVET lançou o pedido de propostas em julho de 2026; as respostas são avaliadas em janeiro de 2027 e a primeira versão está prevista para o final de 2029. A via clássica já poupa cerca de 28% face ao VVC, enquanto os filtros em ciclo neurais da JVET poupam 6–14% com um custo de descodificação a partir de 10 mil MAC por píxel. Espero um núcleo clássico com algumas ferramentas neurais onde os bits poupados justifiquem o custo.
Fotografia: neural dentro da câmara, clássico na Web
Todas as fotografias de um telemóvel topo de gama recente passaram por redes neuronais antes de serem guardadas. O Cognitive ISP da Qualcomm faz segmentação semântica em tempo real desde 2023 e, na CES 2026, a Chips&Media e a Visionary.ai mostraram um ISP completo que corre inteiramente numa NPU. Depois, o resultado é guardado em JPEG ou HEIF.
O JPEG AI, a primeira norma de codificação de imagem aprendida, foi publicado em 2025, com ganhos de 12,5–27,9% face à codificação intra do VVC e custos de descodificação de 7 a 216 mil MAC por píxel. Não encontrei nenhuma câmara, aplicação de galeria ou navegador que o use por predefinição. O formato que a Web adotou em 2026 é clássico: o Chrome 155 ativou o JPEG XL a 6 de outubro, com um descodificador rápido e com segurança de memória que corre em qualquer CPU. A codificação neural ganha dentro da cadeia de uma empresa; os formatos que têm de abrir em todo o lado continuam clássicos.
Chamadas: onde os codecs neurais de ponta a ponta chegam ao mercado
As chamadas são um circuito fechado: as duas pontas correm a mesma aplicação e podem recorrer a um codec normalizado a meio da chamada. É por isso que os primeiros codecs neurais de ponta a ponta em grande escala estão aí. O Satin, o codec de voz com IA da Microsoft, funciona em todas as chamadas a dois do Teams e do Skype desde 2021. Em julho de 2026, a Microsoft abriu o código do MLVC, um codec de vídeo neural que está agora a ser implementado nas chamadas ponto a ponto do Teams.
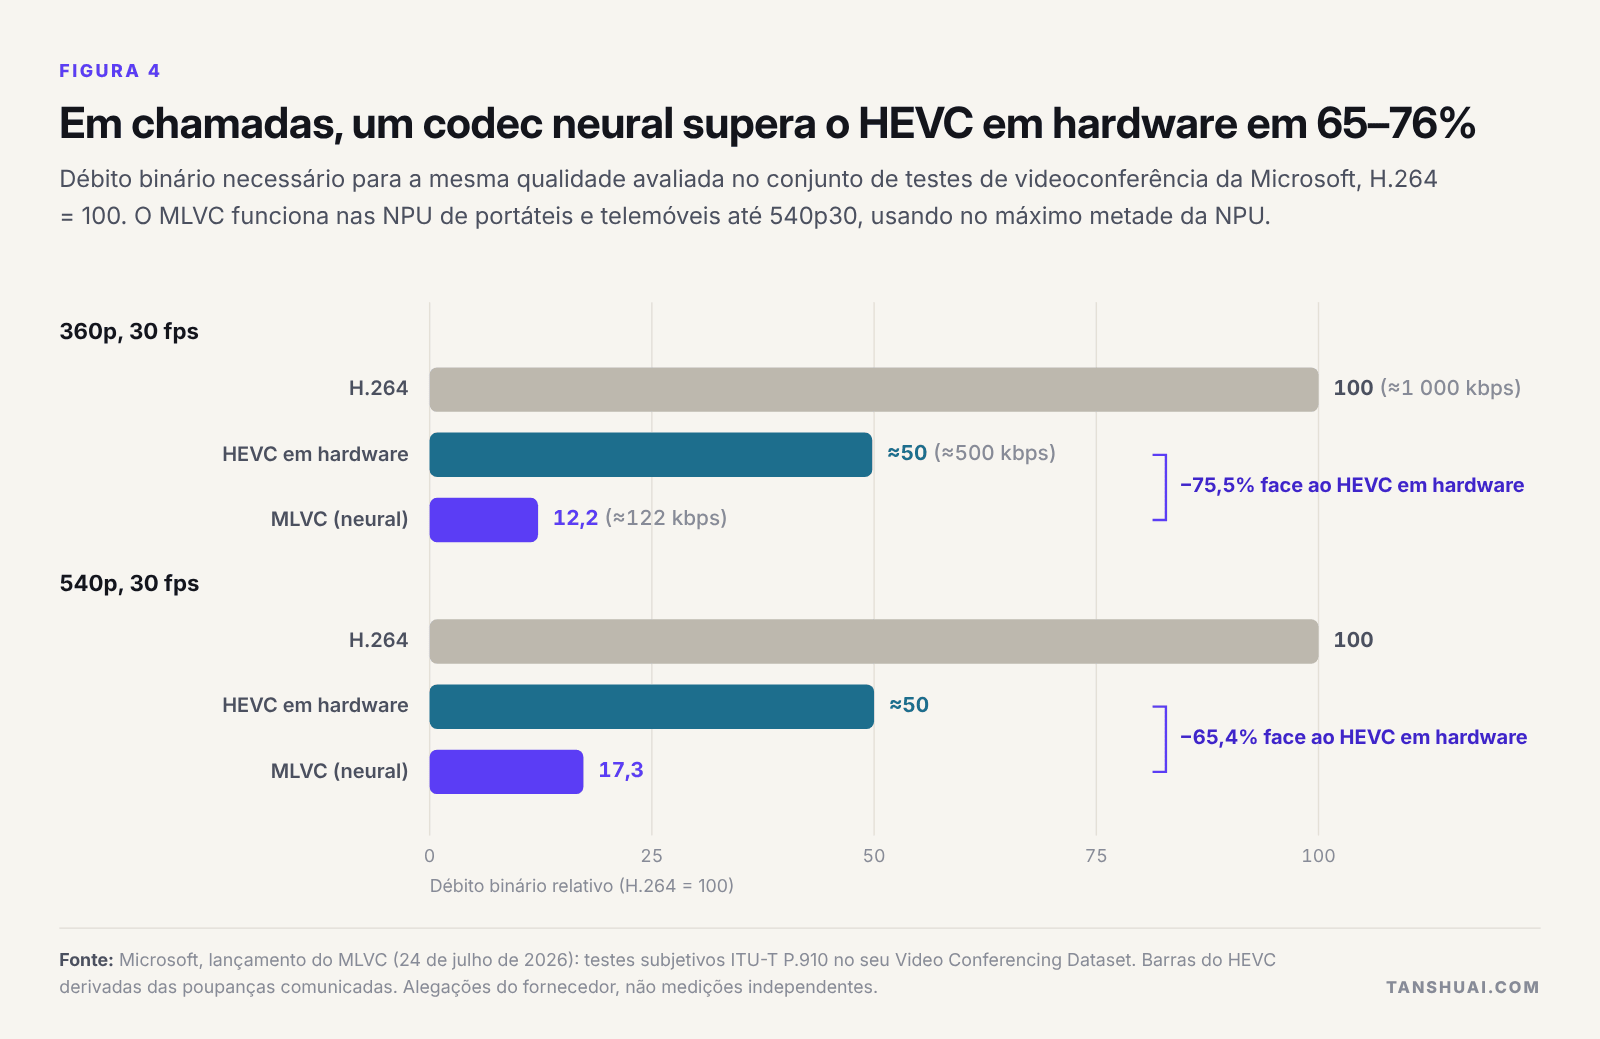 Figura 4. Em chamadas, um codec neural supera o HEVC em hardware em 65–76%, no conjunto de testes da própria Microsoft.
O valor de destaque, 88%, é face ao H.264; face ao HEVC em hardware que os mesmos portáteis já têm, é de 65–76%, o que continua a ser muito. O MLVC funciona a 540p e 360p usando no máximo metade da NPU, e abdicou de alguma compressão para descodificar de forma idêntica em hardware que não é da Microsoft.
Nem todos escolheram este caminho. O Opus acrescentou aprendizagem profunda em 2024, como extras opcionais e retrocompatíveis. A Meta criou o MLow, um codec de voz clássico, porque mais de 20% das suas chamadas correm em telemóveis ARMv7 antigos e dezenas de milhões de chamadas de WhatsApp por dia correm em telemóveis com mais de dez anos. Os codecs neurais chegam primeiro ao mercado onde os dispositivos são novos e um só fornecedor controla as duas pontas.
IA generativa: a maior implantação a que ninguém chama codec
Todos os modelos de voz e de vídeo assentam num codec aprendido. Os modelos de voz leem e escrevem os tokens de codecs de áudio neurais como o Mimi, da Kyutai, a 12,5 tramas por segundo e 1,1 kbps. Os geradores de vídeo trabalham no espaço latente de autocodificadores de vídeo como o do LTX-Video, que comprime 1:192. Nenhum deles é um formato que mais alguém descodifique, mas provam que a compressão aprendida funciona em grande escala quando uma empresa é dona do codificador, do descodificador e do hardware. Para quem serve vídeo generativo, a eficiência do tokenizador é uma linha de custo direta.
Jogos: a reconstrução neural está generalizada, os recursos neurais estão a começar
O DLSS da NVIDIA renderiza menos píxeis e menos fotogramas e deixa uma rede reconstruir o resto. A compressão neural de texturas chegou ao mercado em Assassin's Creed Mirage, usada só em recursos selecionados devido ao seu custo em tempo de execução.
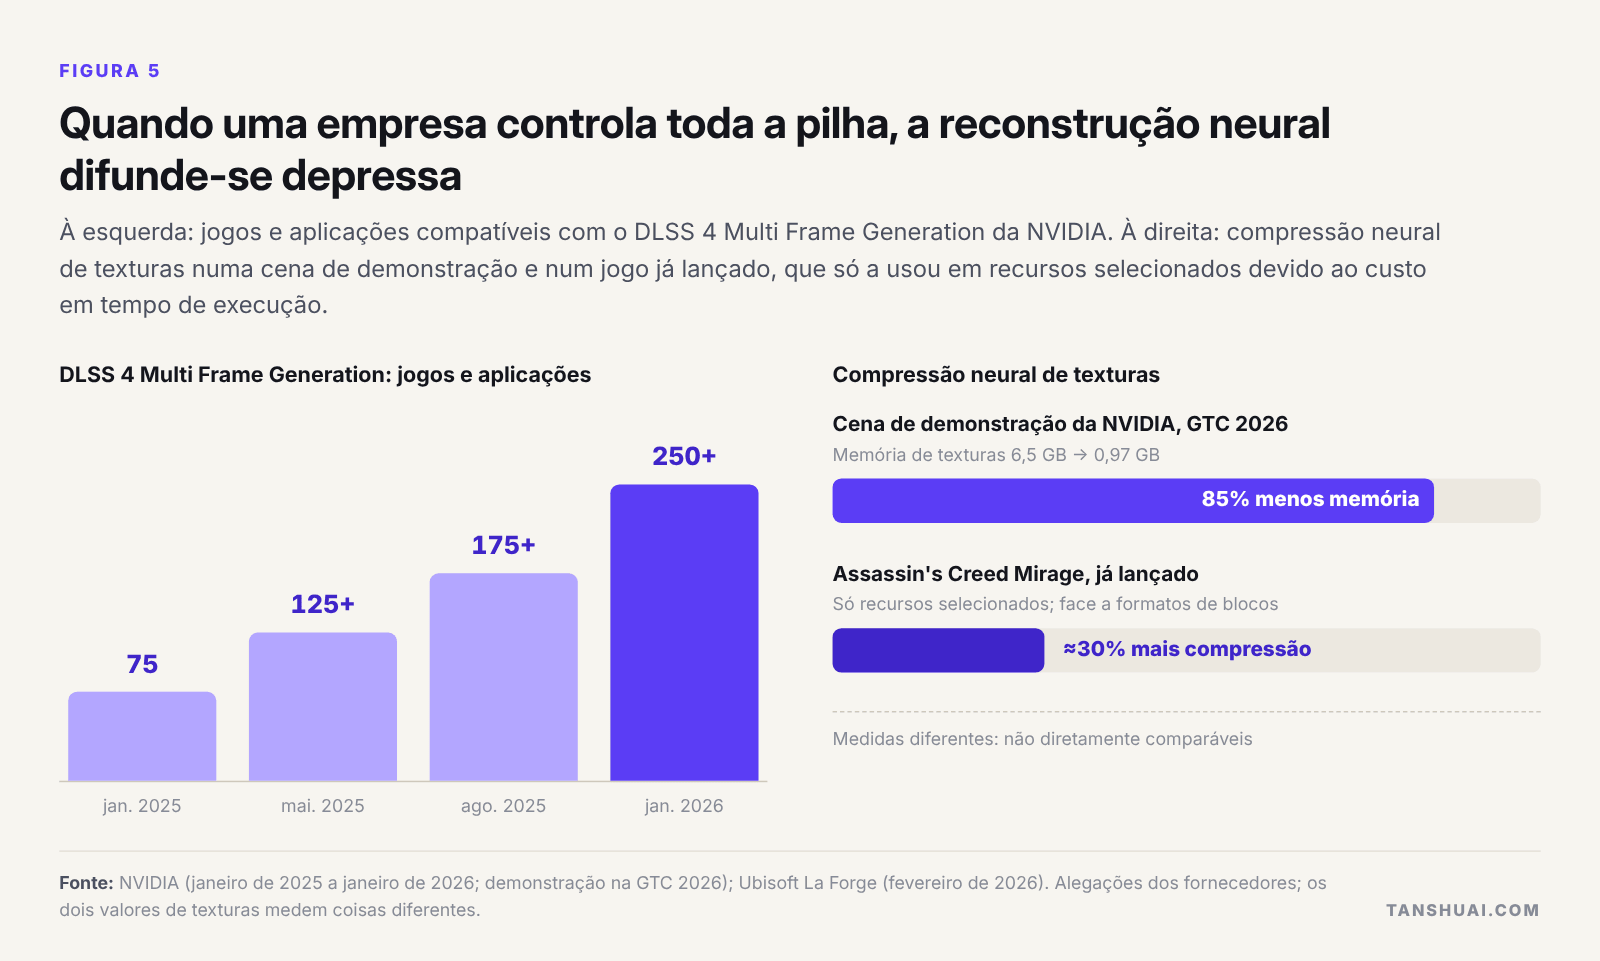 Figura 5. Quando uma empresa controla toda a pilha, a reconstrução neural difunde-se depressa.
As ligações de satélites, drones e robôs são, tecnicamente, onde os codecs neurais de ponta a ponta melhor se adequam, mas são um mercado pequeno e cada vez mais sujeito a controlos de exportação dos dois lados: as regras chinesas de exportação de drones, em vigor a partir de 18 de novembro de 2026, chegam a indicar a compressão semântica de imagem como limiar.
A perspetiva do silício
É aqui que a minha experiência mais conta. Uma equipa de chips faz quatro perguntas sobre qualquer codec novo: joules por píxel, tráfego de DRAM por píxel, portas lógicas e se todos os descodificadores do mundo calculam exatamente os mesmos bits. Nas quatro, um descodificador neural está em 2026 onde o HEVC em hardware estava antes dos primeiros chips.
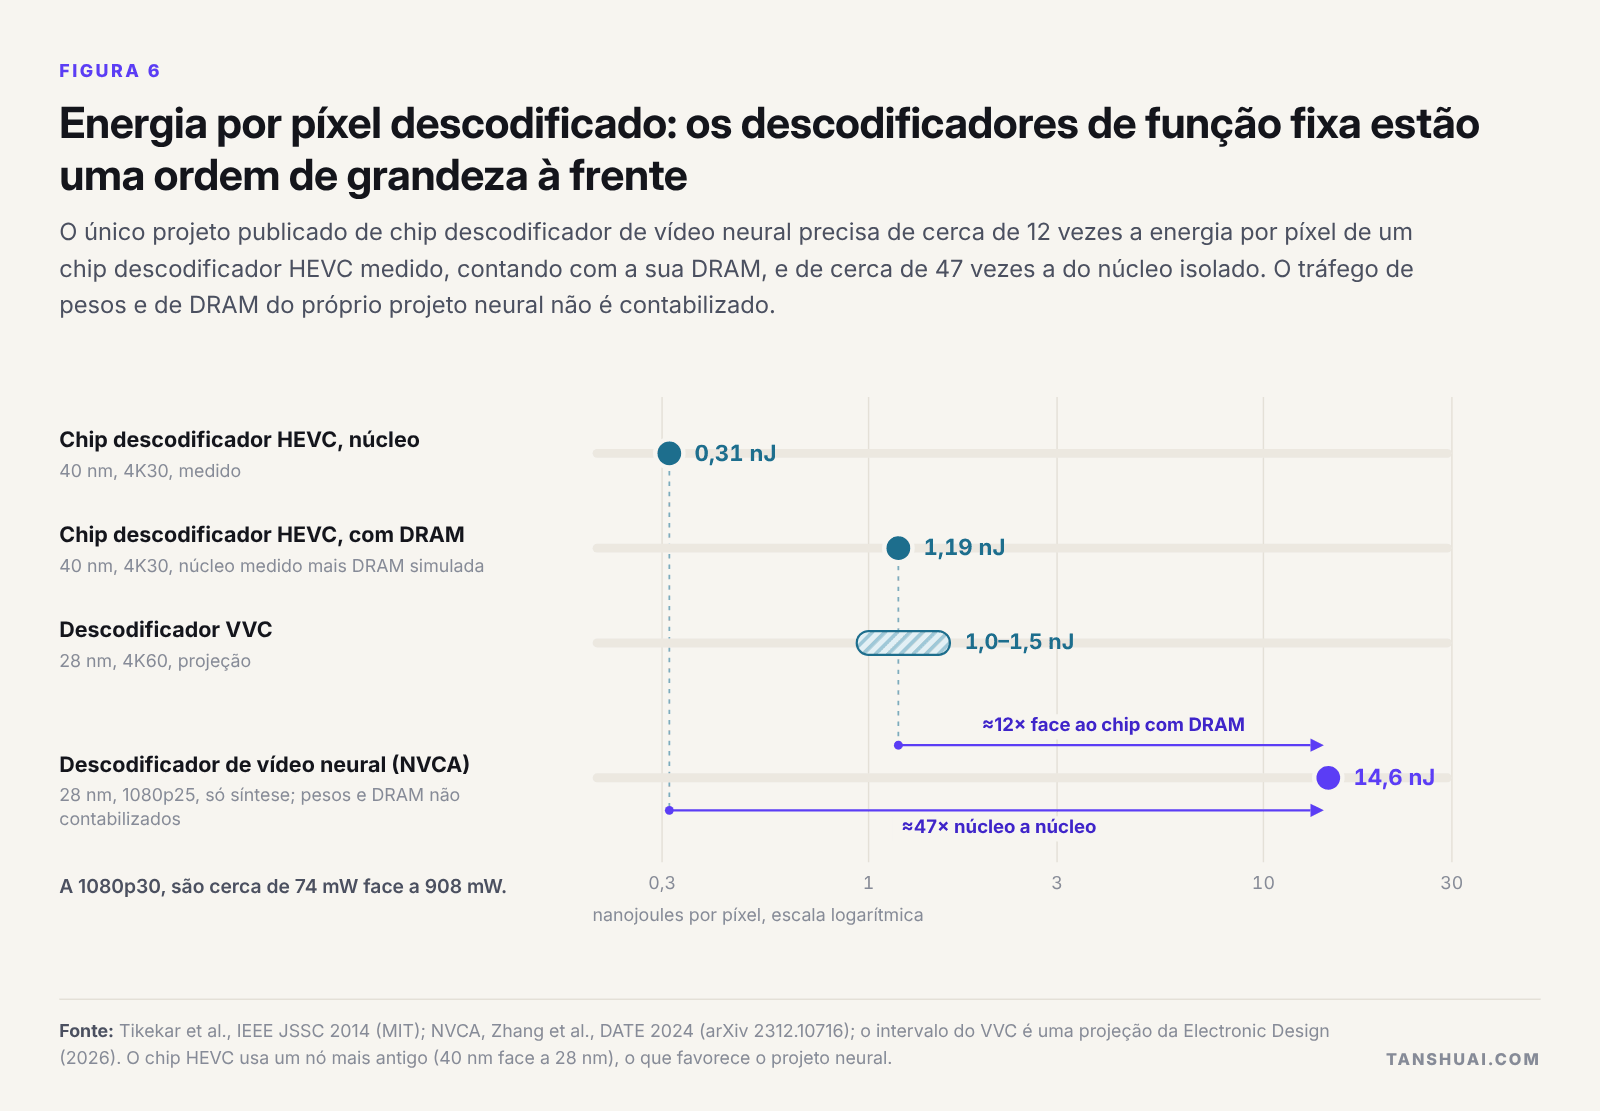 Figura 6. Energia por píxel descodificado: os descodificadores de função fixa estão uma ordem de grandeza à frente.
O único projeto publicado de chip descodificador de vídeo neural, o NVCA, precisa de 14,6 nJ por píxel; o chip descodificador HEVC do MIT precisa de 1,19 com a DRAM e de 0,31 no núcleo. A 1080p30, são aproximadamente 900 mW face a 74 mW. O DCVC-RT, o codec de investigação rápido da Microsoft, precisa, segundo a minha soma dos valores da sua própria tabela por módulo, de cerca de 175 mil MAC por píxel descodificado, ou cerca de 22 TOPS a 1080p30: metade dos 40 TOPS que definem um PC com IA, para um único fluxo.
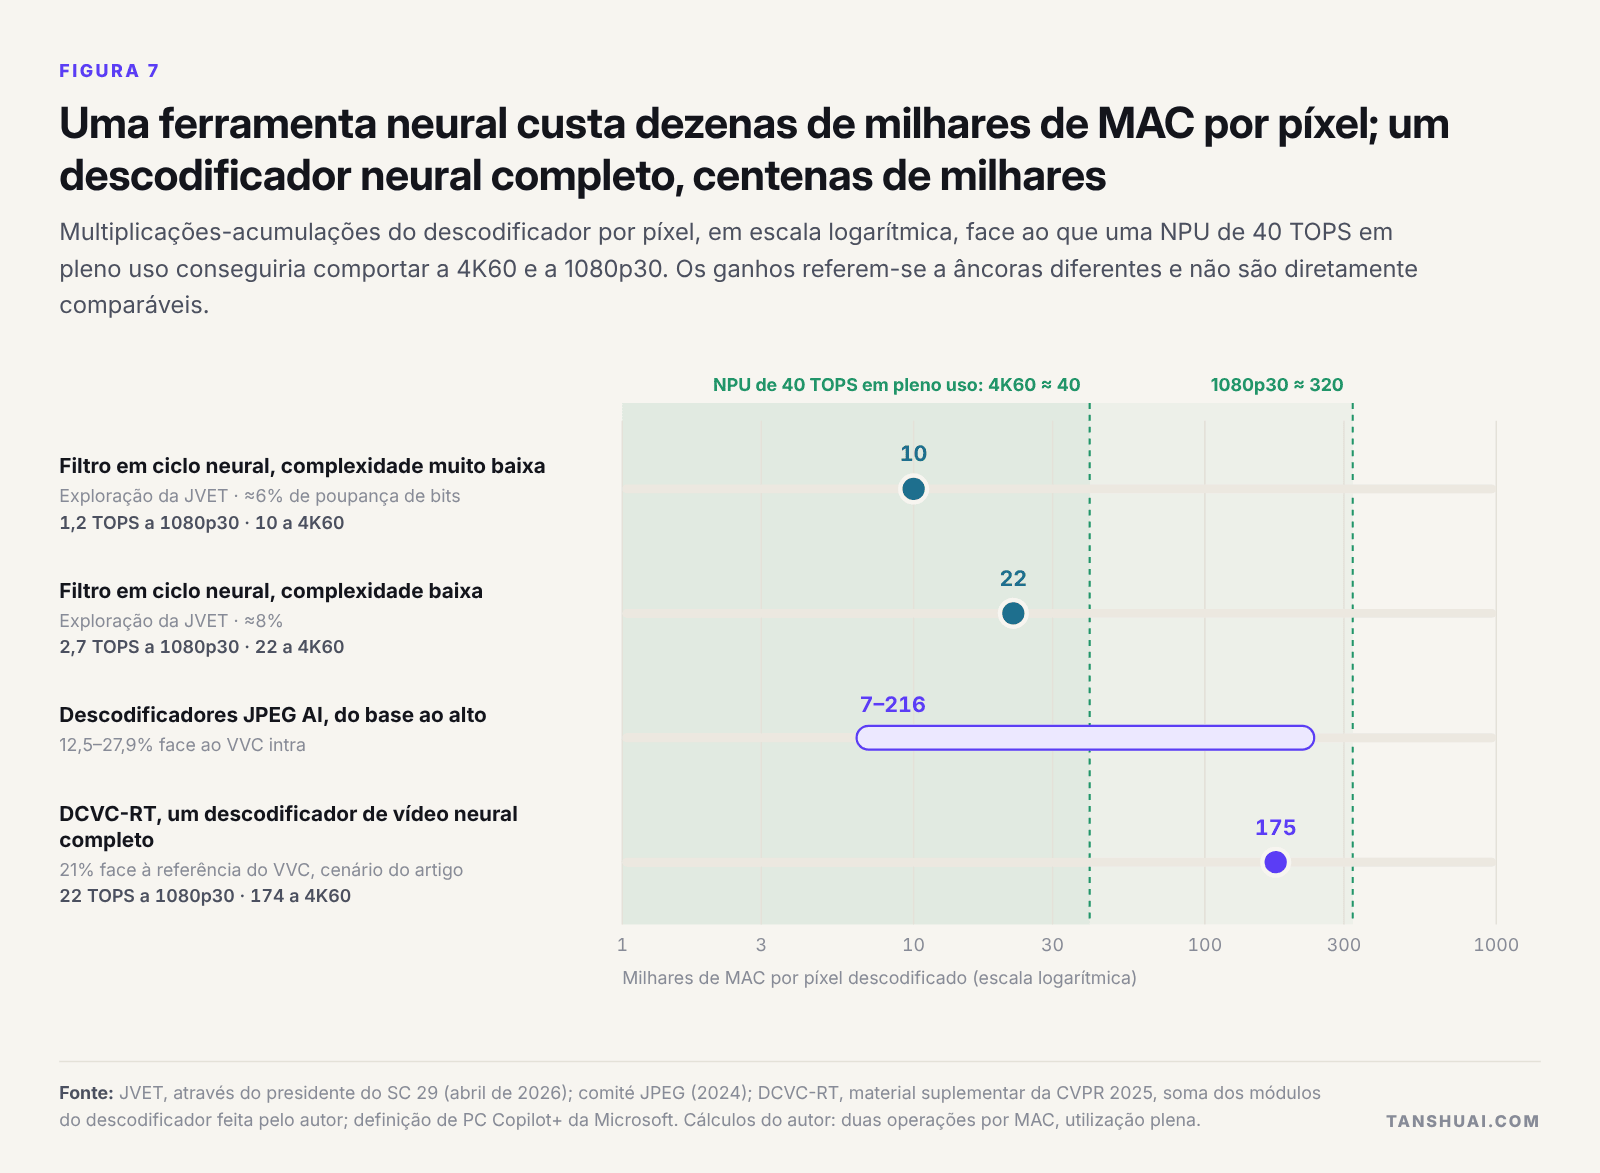 Figura 7. Uma ferramenta neural custa dezenas de milhares de MAC por píxel; um descodificador neural completo, centenas de milhares.
Há mais dois custos que contam. A memória: no chip do MIT, cerca de três quartos da energia do sistema vão para a DRAM, e os descodificadores neurais transportam grandes mapas de características entre fotogramas. A exatidão: a descodificação entrópica falha se dois dispositivos calcularem uma probabilidade de forma diferente, e é por isso que todos os codecs neurais sérios usam hoje aritmética inteira e que o MLVC troca compressão por descodificação idêntica.
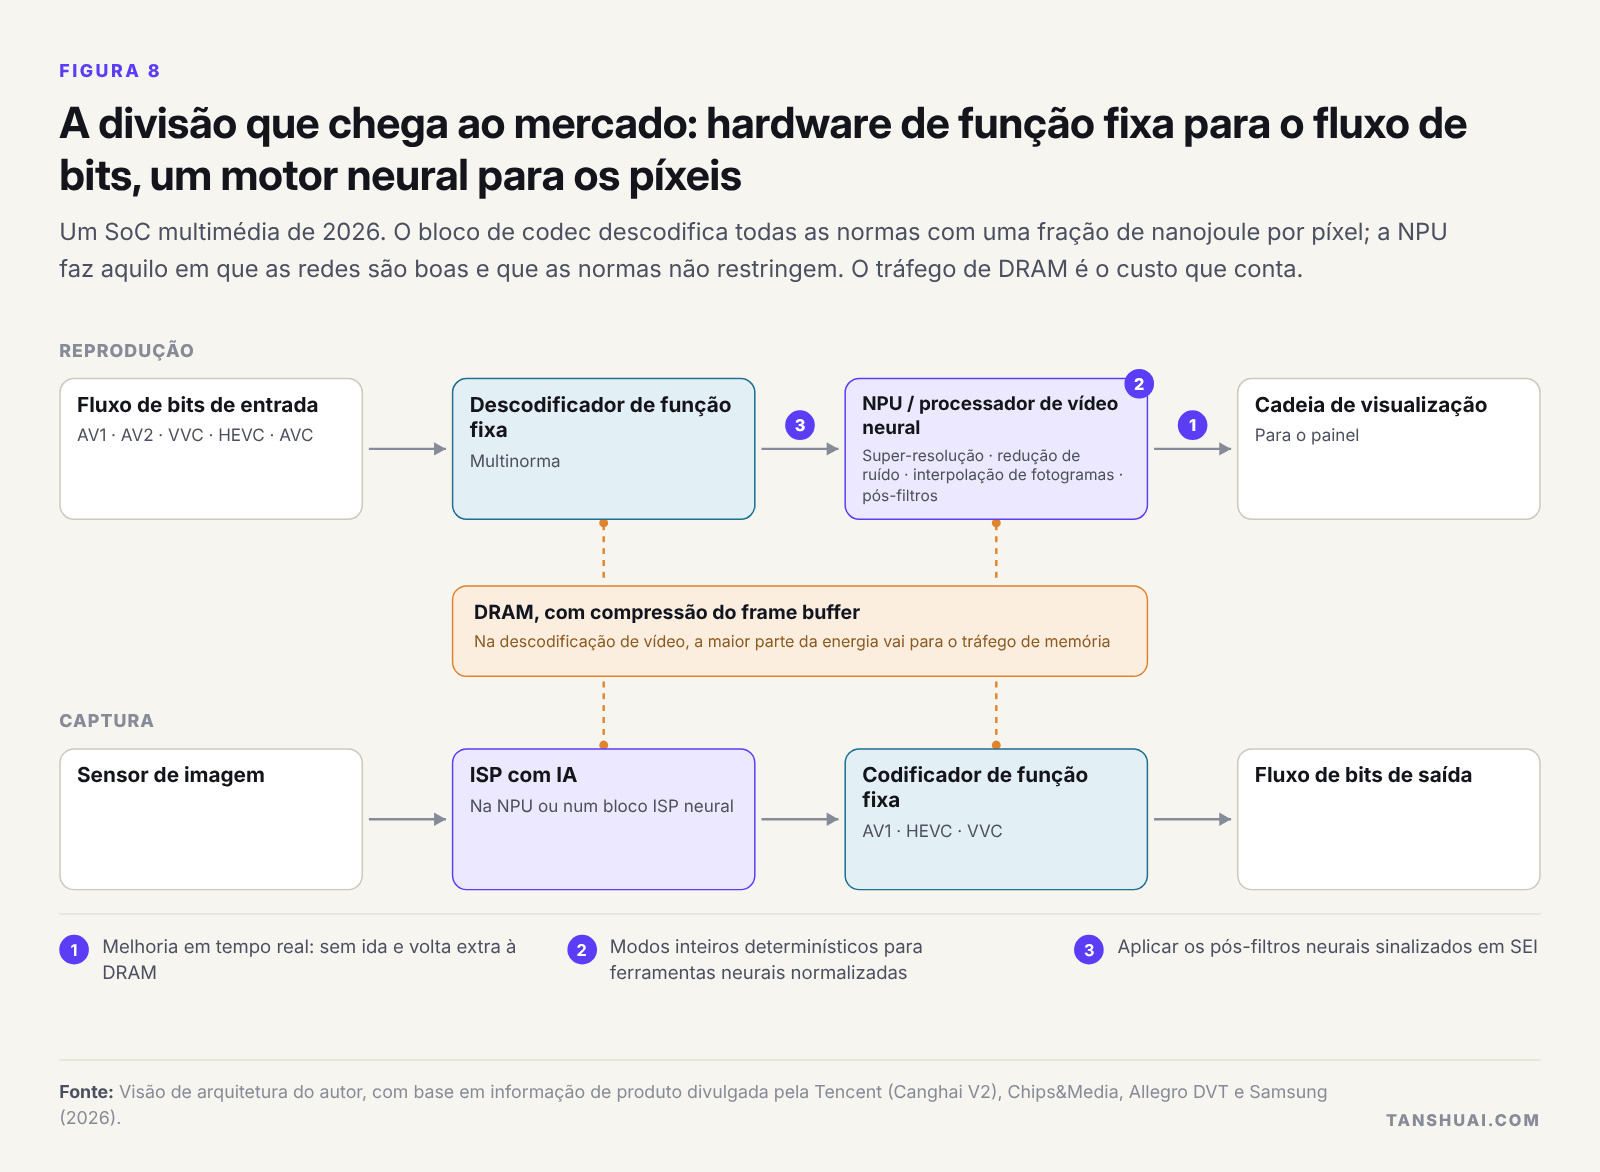 Figura 8. A divisão que chega ao mercado: hardware de função fixa para o fluxo de bits, um motor neural para os píxeis.
O silício que vende junta os dois. A Tencent tem mais de 100 000 chips de codec Canghai, de conceção própria, implantados, e a segunda geração acrescenta o H.266 e super-resolução no chip; os fornecedores de IP vendem blocos de codec e NPU de vídeo lado a lado. Se estivesse hoje a planear um SoC multimédia: descodificadores de função fixa para todas as normas que é preciso reproduzir, incluindo o AV2; uma NPU dimensionada para melhoria à resolução do ecrã, sem uma passagem extra pela DRAM; modos inteiros determinísticos; e o H.267 como início de projeto depois de 2029.
Quem ganha dinheiro, e onde uma empresa pode apostar
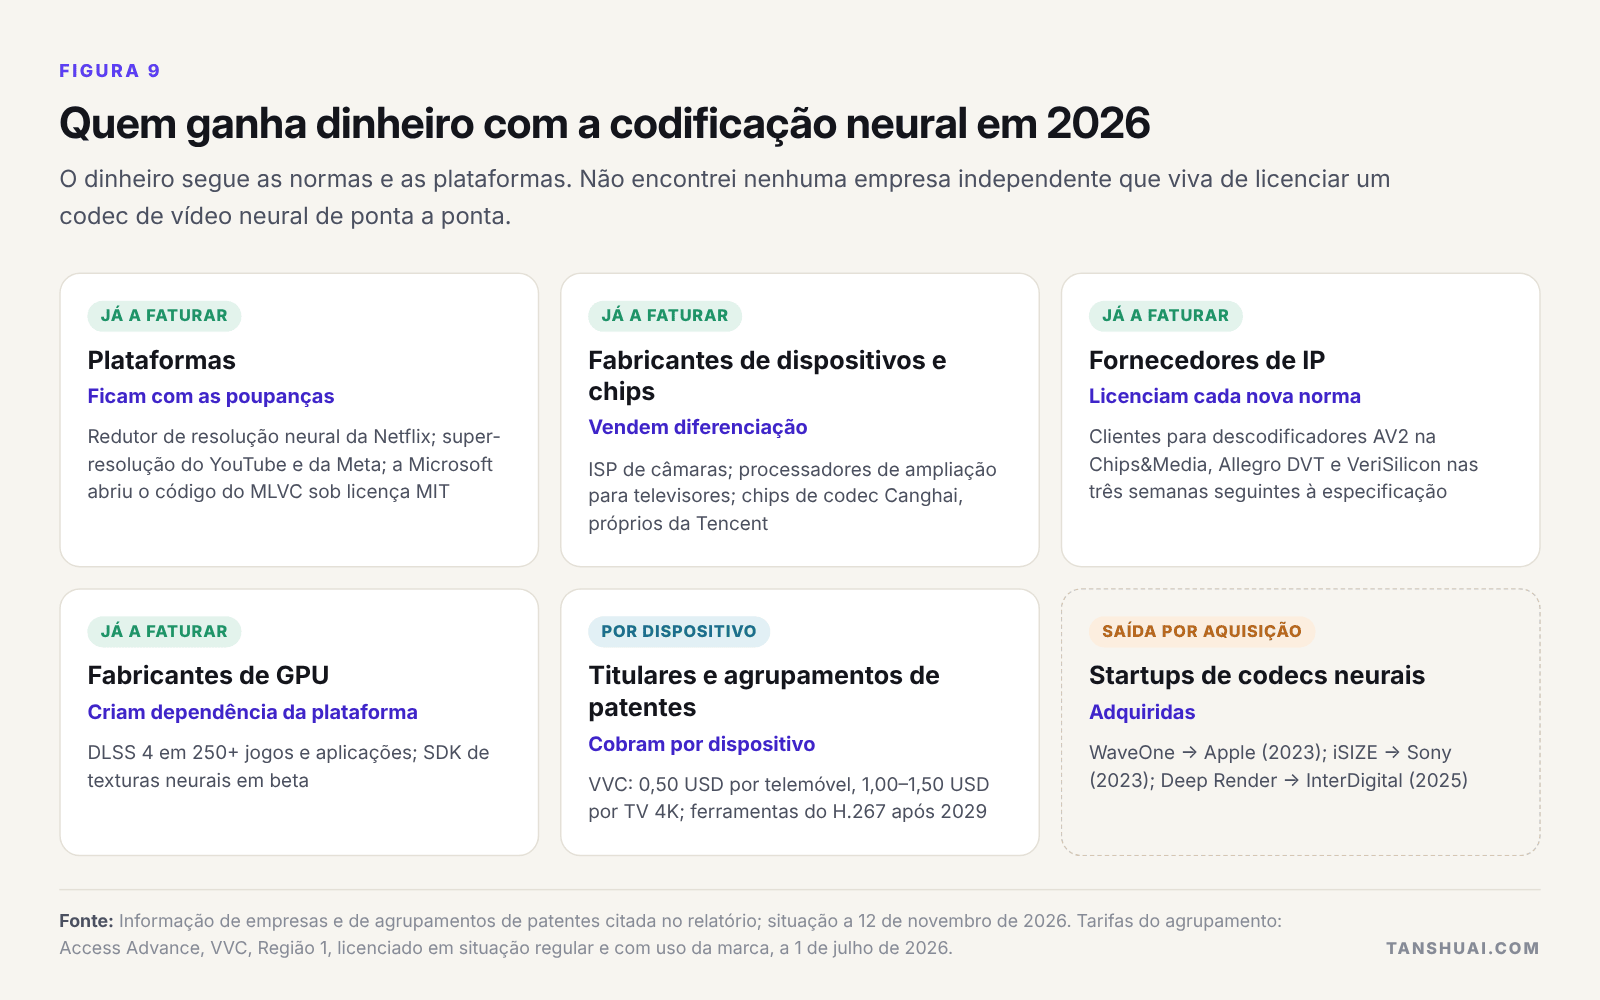 Figura 9. O dinheiro segue as normas e as plataformas.
As plataformas ficam com as poupanças e, por vezes, oferecem o código, como a Microsoft fez com o MLVC. Os fornecedores de IP licenciam descodificadores para cada nova norma. Os agrupamentos de patentes cobram por dispositivo: no VVC, 0,50 dólares por telemóvel e 1,00–1,50 dólares por televisor 4K nos EUA e nos outros mercados da Região 1. A WaveOne foi para a Apple, a iSIZE para a Sony e a Deep Render para a InterDigital. Não encontrei nenhuma empresa independente que viva de licenciar um codec de vídeo neural de ponta a ponta.
Para uma empresa, as apostas em aberto são o pré-processamento neural para serviços de vídeo, a melhoria do lado do ecrã para fabricantes de chips, os codecs neurais em circuito fechado para videoconferência e ligações privadas, o silício que junta codec e NPU, e as ferramentas de avaliação e de conformidade de que vai precisar quem lançar ferramentas neurais. O trabalho de normalização no H.267 exige paciência e uma estratégia de licenciamento.
Alegações a desvalorizar, e o que acompanhar
Exija quatro coisas a qualquer alegação sobre codecs neurais: a âncora, a métrica, a resolução e o custo de descodificação. «88% de poupança» é face ao H.264 a 360p; «85–96% menos memória de vídeo» é uma cena de demonstração, contra 30% no jogo já lançado; «o JPEG AI é uma norma» ainda não tem nenhum produto por trás.
As datas que contam: a avaliação do H.267 em janeiro de 2027, as primeiras emissões AV2 do YouTube no início de 2027, o primeiro modelo de teste do H.267 no segundo semestre de 2027, se o MLVC se espalha para além do Teams, o primeiro produto que use o JPEG AI por predefinição, e os orçamentos de NPU nos telemóveis e nos PC. A versão 1 do H.267, no final de 2029, inicia o ciclo de silício para as ferramentas neurais na reprodução para o grande público.
Descarregar o relatório completo e os diapositivos
O relatório completo aborda cada domínio com mais pormenor, as contas do silício, as normas e as patentes, uma tabela de alegações confrontadas com a evidência e todas as fontes.
- Codificação neural em 2026: relatório completo (PDF)
- Codificação neural em 2026: diapositivos (PDF)
- Edição em inglês: relatório completo · diapositivos
Esta é uma tradução da edição em inglês, que prevalece em caso de divergência.
Questões em aberto
Algumas questões ainda não têm resposta pública, e são as que acho mais interessantes do ponto de vista técnico: até que ponto um descodificador neural se consegue aproximar de uma aritmética inteira exata ao bit em NPU de fornecedores diferentes antes de perder a vantagem de compressão; quanto custa o pós-processamento neural em tráfego de DRAM por píxel; a partir de que custo por píxel uma ferramenta neural deixa de compensar num descodificador H.267; que sistemas fechados, além das chamadas, podem adotar primeiro codecs neurais de ponta a ponta; e como medir a fidelidade quando um descodificador gera detalhe em vez de o reconstruir.
São áreas que podemos explorar juntos nos próximos anos, através de intercâmbio técnico e de colaboração técnica: i@tanshuai.com.
Sobre o autor
Tan Shuai é tecnólogo e fundador, com mais de vinte anos de trabalho em chips, hardware e software de sistema, e 20 patentes concedidas. Tem muitos anos de I&D e de gestão de chips fabless, incluindo conceção full-custom de caminhos de dados de ASIC e projetos de chips multimédia para câmaras, como aceleradores de codecs de vídeo. O seu trabalho levou-o a passar por Silicon Valley, Nova Iorque, Chicago, Taiwan, a Área da Grande Baía (Shenzhen e Hong Kong), o Vietname e a Malásia. Hoje trabalha como investigador e programador de IA.
Discussão técnica: i@tanshuai.com.