
Нейросети уже формируют почти каждое видео, которое вы смотрите, но работают они на обоих концах стандартного кодека, а не вместо него. Ниже — где нейросетевое кодирование применяется в 2026 году, во что оно обходится в кремнии и кто на нём зарабатывает, а также полный отчёт и слайды.
Аннотация
Нейросетевое кодирование в 2026 году уже стало мейнстримом, но оно работает вокруг стандартных кодеков, а не заменяет их. Нейросети формируют картинку до кодирования (в камерах телефонов и в конвейере кодирования Netflix) и исправляют её после декодирования (в YouTube Super Resolution, в Meta и в ТВ-процессорах); битовый поток между ними — по-прежнему AV1, HEVC, AVC или VVC, и декодируют его аппаратные блоки на жёсткой логике. Сквозные нейросетевые кодеки применяются только в замкнутых системах, где одна компания контролирует оба конца: MLVC от Microsoft в звонках Teams, токенизаторы внутри каждой голосовой и видеомодели, нейросетевые текстуры в одной игре. Массовое воспроизведение нейросетевых битовых потоков ждёт H.267, который ожидается в конце 2029 года, и следующего за ним цикла разработки микросхем. Причина — в чипе: единственному опубликованному проекту нейросетевого видеодекодера нужно примерно в 12 раз больше энергии на пиксель, чем измеренному декодеру HEVC, а быстрому исследовательскому кодеку для 1080p30 нужно около 22 TOPS. Деньги идут вслед за стандартами и платформами; самые известные стартапы нейросетевых кодеков были куплены.
Почему я этим занялся
Каждые несколько месяцев мне говорят, что ИИ-кодеки вот-вот заменят H.264, HEVC и AV1. Большая часть того, что я об этом читаю, исходит либо из научных статей, где ставятся рекорды сжатия, либо от поставщиков. Ни те ни другие почти ничего не говорят о том, что реально внедряется, для кого и какой ценой.
За моими плечами много лет НИОКР и руководства в fabless-разработке микросхем, включая полностью заказное проектирование трактов данных ASIC и проекты мультимедийных чипов для камер, например ускорителей видеокодеков, поэтому я посмотрел на тему так, как оценивал бы чип: энергия на пиксель, трафик памяти, что стандарт позволяет зафиксировать в кремнии и кто платит. Я прочитал документы стандартов и отчёты о заседаниях JVET, MPEG, JPEG, AOMedia и IETF, инженерные блоги компаний, статьи о чипах, тарифы патентных пулов, тексты правил экспортного контроля и прессу. Все числа ниже приведены по состоянию на 12 ноября 2026 года, суммы — в долларах США. Полный отчёт со всеми источниками — в конце.
Результаты вкратце
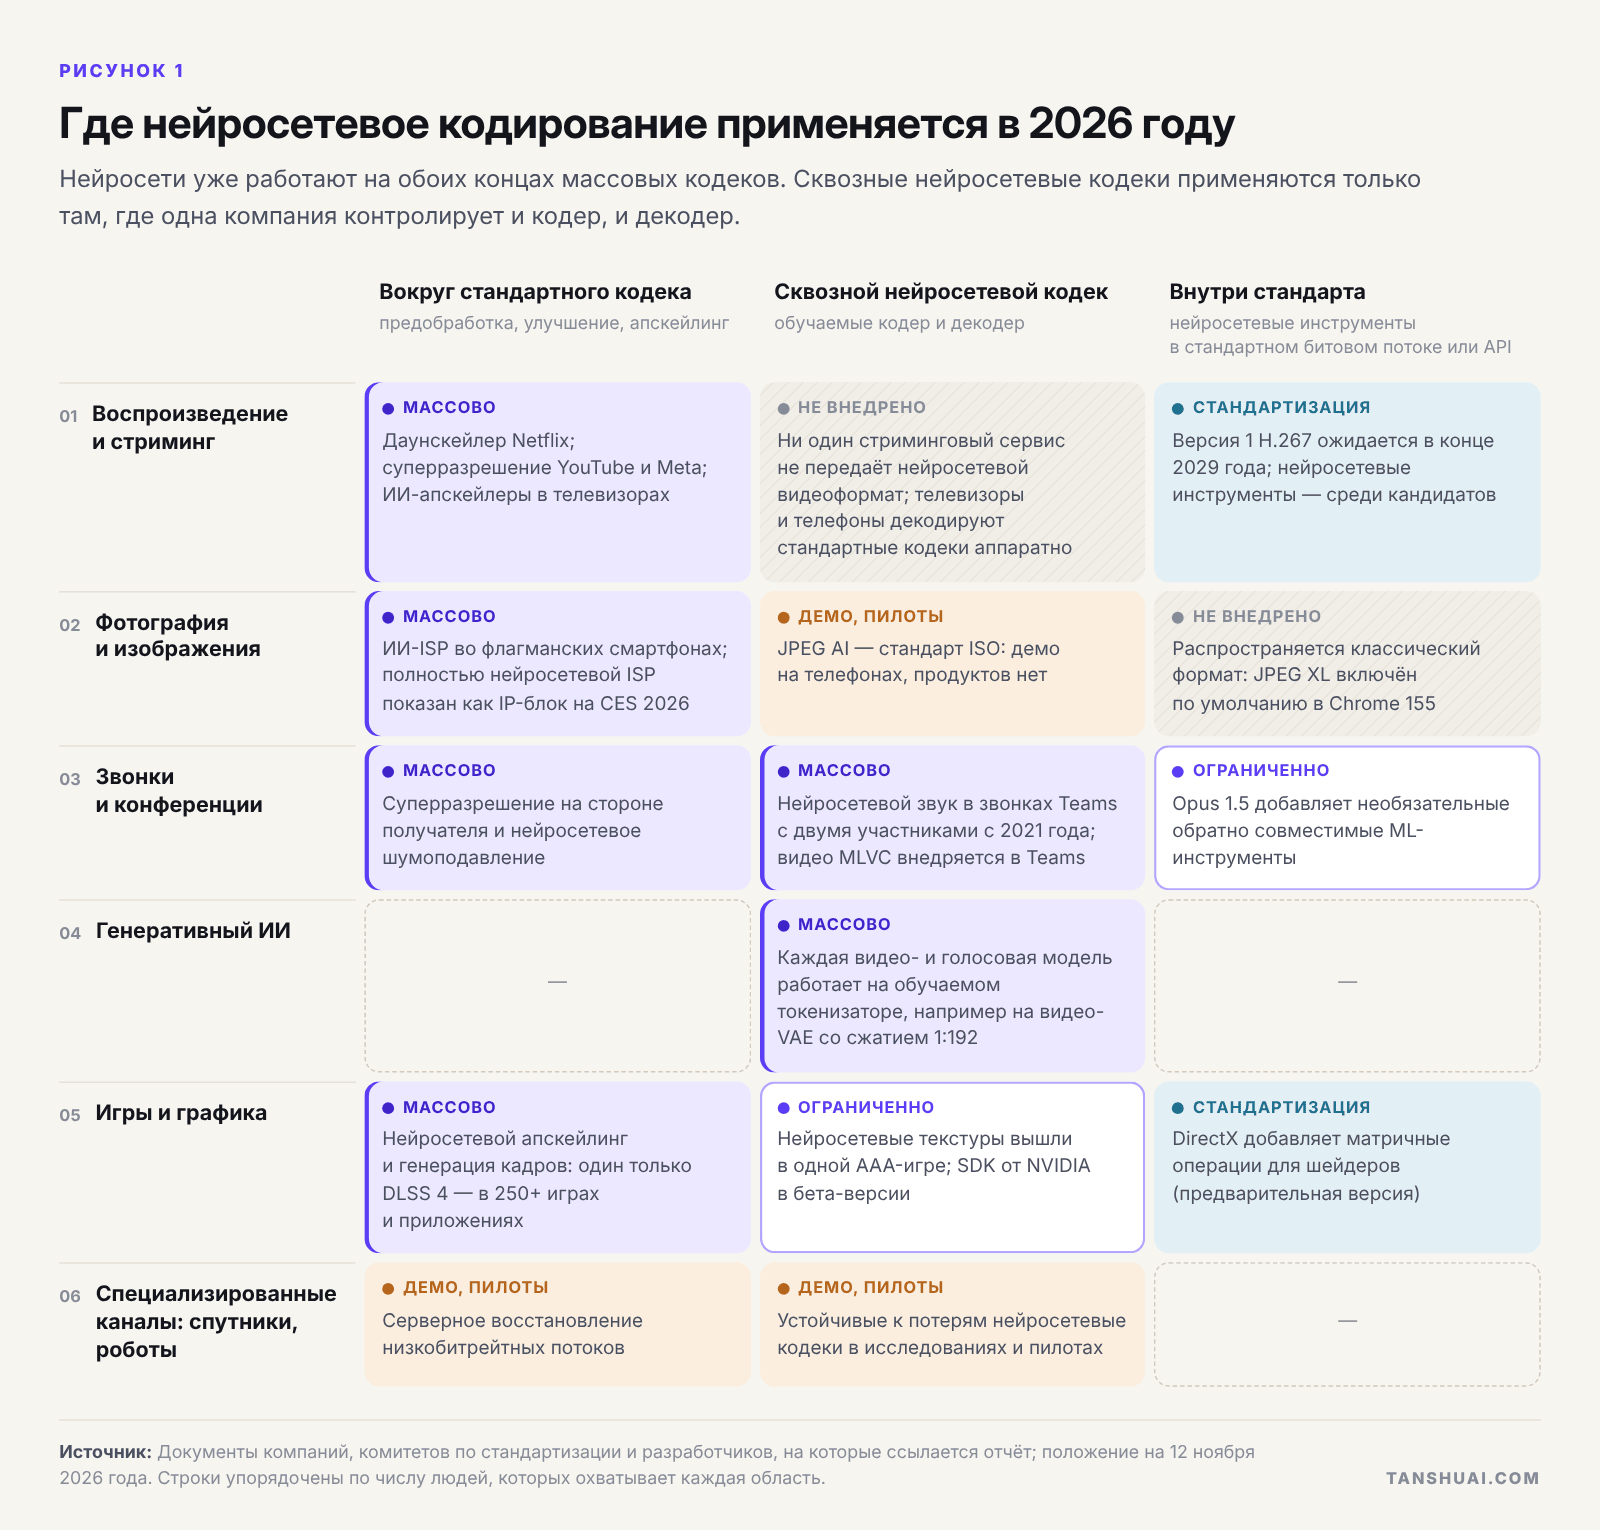 Рисунок 1. Где нейросетевое кодирование применяется в 2026 году. Строки упорядочены по числу людей, которых охватывает каждая область.
| Вопрос | Коротко |
|---|---|
| Где нейросетевое кодирование применяется массово? | Вокруг кодека: ISP камер, даунскейлинг на стороне кодера, суперразрешение при воспроизведении. Сквозные кодеки — только в замкнутых системах: звонки, игровые ассеты, токенизаторы генеративного ИИ |
| Заменят ли нейросетевые кодеки AV1, HEVC и VVC в воспроизведении? | Не раньше H.267 (версия 1 — в конце 2029 года) и следующего за ним цикла обновления устройств; массово — в середине 2030-х, по моей оценке |
| Во что это обходится в кремнии? | Примерно в 12 раз больше энергии на пиксель, чем у аппаратного декодера HEVC, плюс трафик памяти и требование побитово точного декодирования |
| Кто зарабатывает? | Платформы оставляют экономию себе; поставщики IP-блоков и патентные пулы получают плату за каждый проект и с каждого устройства; стартапы нейросетевых кодеков были куплены |
| Где есть место для компании? | Нейросетевая пред- и постобработка, продукты для замкнутых систем, микросхемы «кодек плюс NPU», а также работа по оценке и стандартизации между ними |
Три способа войти
«Нейросетевое кодирование» обозначает три разные вещи, и большинство споров о нём возникает из-за того, что их смешивают. Сеть может работать вокруг стандартного кодека, обрабатывая пиксели до кодирования или после декодирования, а битовый поток остаётся стандартным. Она может находиться внутри стандарта как инструмент, который обязан выполнять каждый декодер, а значит, её нужно специфицировать точно. Или она может заменить кодек от начала до конца — обучаемыми кодером и декодером, которые работают только в паре.
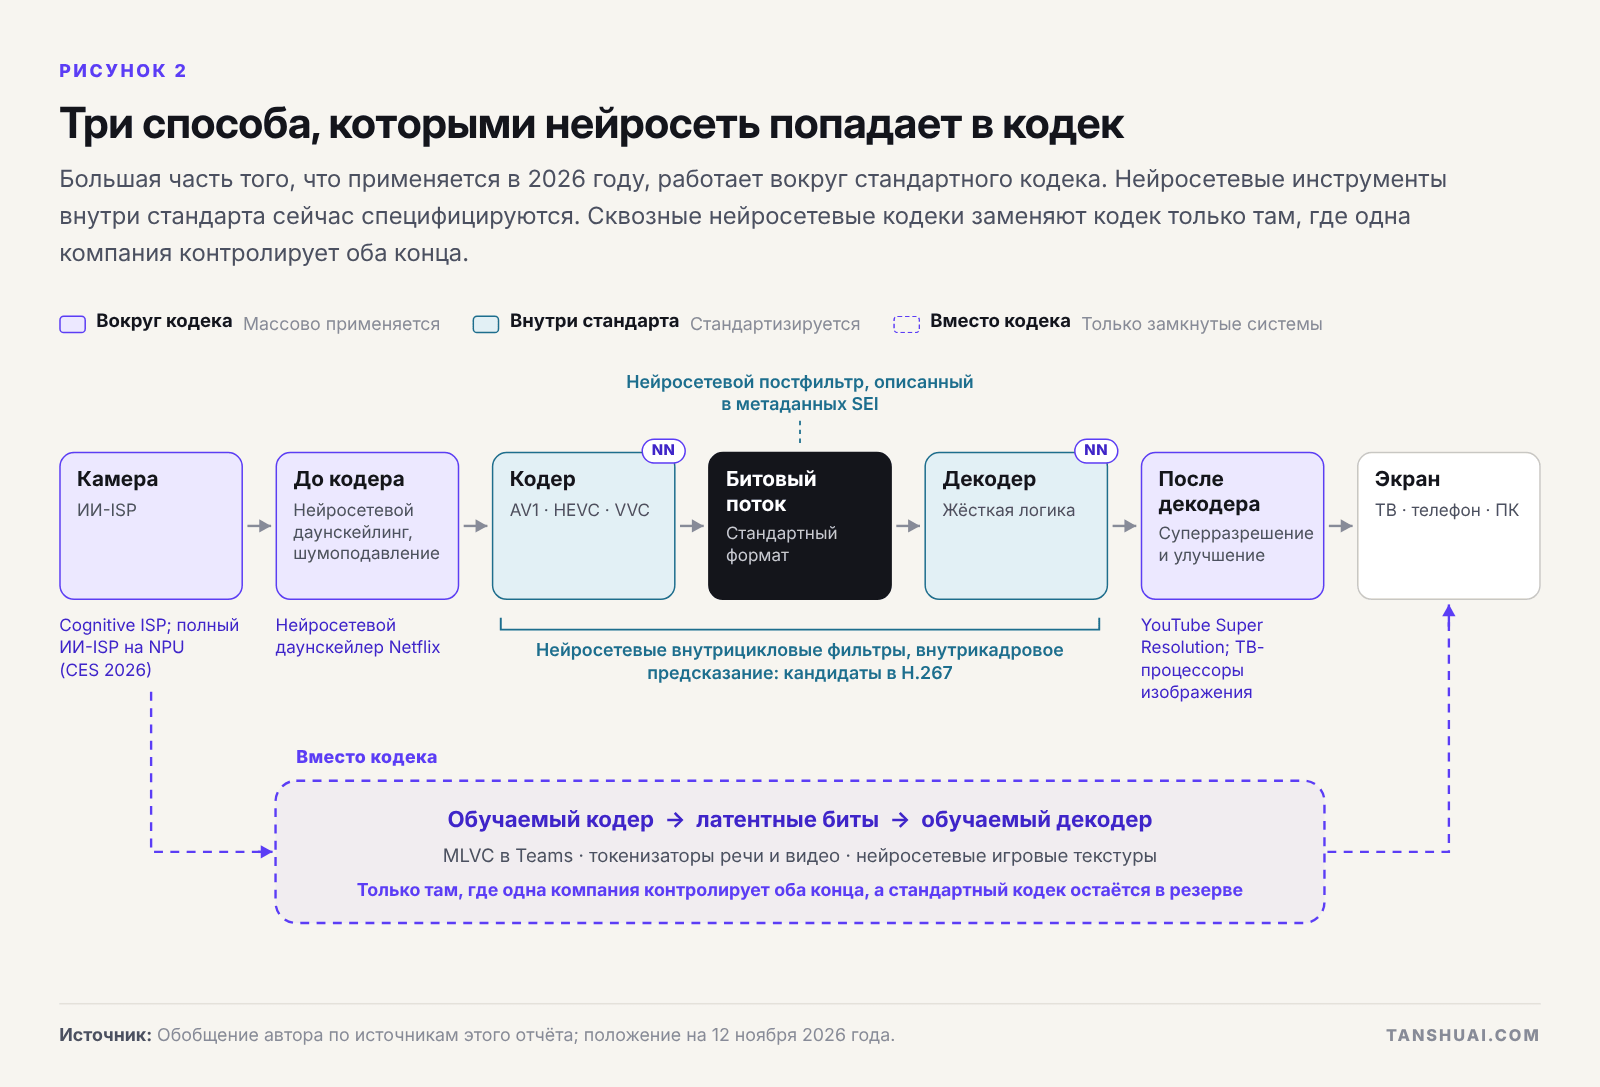 Рисунок 2. Три способа, которыми нейросеть попадает в кодек. Большая часть того, что применяется в 2026 году, относится к первому.
Первому не нужно ничьё разрешение. Второму нужен стандарт. Третьему — контроль над обоими концами. Именно в таком порядке они доходят до людей.
Воспроизведение и стриминг: нейросети на обоих концах, стандарт посередине
Крупные сервисы завершили один переход между кодеками и начинают следующий, и ни в одном из них нет нейросетевого декодера. В декабре 2025 года Netflix сообщила, что на AV1 приходится около 30 % её просмотров; YouTube говорит, что более 90 % его каталога, взвешенного по времени просмотра, доступно в AV1. Работа над AV2 завершилась 28 мая 2026 года: он сжимает примерно на 30 % лучше AV1, и в течение трёх недель Chips&Media, Allegro DVT и VeriSilicon объявили о заказчиках своих декодеров AV2. Бразильская система TV 3.0 в июне 2026 года начала коммерческое вещание в VVC.
Нейросетевая часть — на обоих концах. С 2022 года Netflix использует для даунскейлинга мастер-копий небольшую нейросеть вместо обычного фильтра; это не требует изменений ни на одном устройстве, и в тестах Netflix её результат предпочли около 77 % зрителей. YouTube на телевизорах с помощью машинного обучения повышает разрешение видео, загруженных в разрешении ниже 1080p, Meta применяет суперразрешение на своих серверах и на телефонах, а флагманский ТВ-процессор Samsung рекламирует 768 нейросетей для апскейлинга.
Чего не существует, так это нейросетевого битового потока на массовых экранах, и причина — время. Формат воспроизведения должен декодироваться на каждом устройстве, которое когда-либо будет его воспроизводить. AV1 понадобилось почти восемь лет от готовой спецификации до 30 % просмотров Netflix.
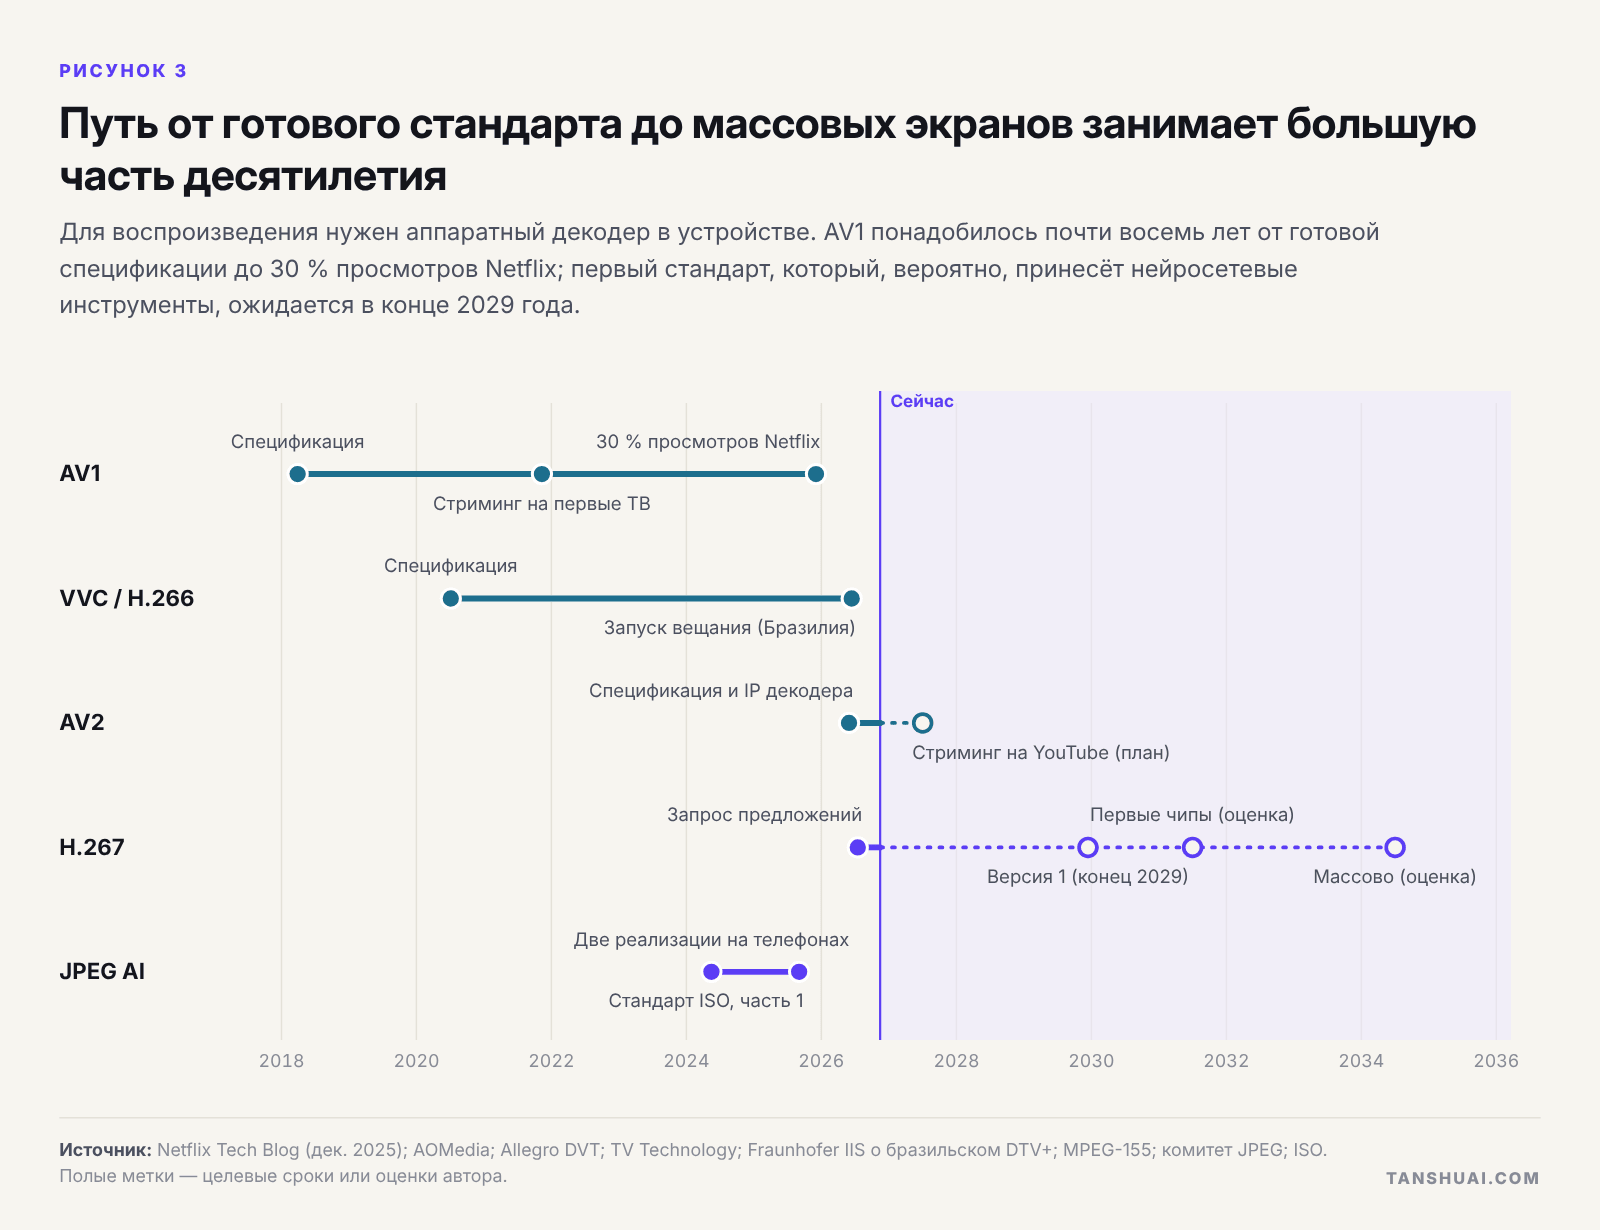 Рисунок 3. Путь от готового стандарта до массовых экранов занимает большую часть десятилетия.
Стандарт, который мог бы донести нейросетевые инструменты до каждого экрана, — это H.267, рабочее название преемника VVC. JVET опубликовала запрос предложений в июле 2026 года; ответы оценят в январе 2027 года, а первая версия ожидается в конце 2029 года. Классический трек уже экономит около 28 % относительно VVC, тогда как нейросетевые внутрицикловые фильтры JVET экономят 6–14 % при стоимости в декодере от 10 тыс. MAC на пиксель и выше. Я ожидаю классическое ядро с несколькими нейросетевыми инструментами там, где сэкономленные биты оправдывают затраты.
Фотография: нейросети внутри камеры, классика в вебе
Каждый снимок с недавнего флагманского телефона, прежде чем сохраниться, проходит через нейросети. Cognitive ISP от Qualcomm с 2023 года выполняет семантическую сегментацию в реальном времени, а на CES 2026 Chips&Media и Visionary.ai показали полноценный ISP, целиком работающий на NPU. Затем результат сохраняется в JPEG или HEIF.
JPEG AI, первый стандарт обучаемого кодирования изображений, опубликован в 2025 году: выигрыш 12,5–27,9 % относительно внутрикадрового кодирования VVC при стоимости декодера от 7 до 216 тыс. MAC на пиксель. Я не нашёл ни одной камеры, приложения-галереи или браузера, которые использовали бы его по умолчанию. Формат, который веб принял в 2026 году, классический: Chrome 155 включил JPEG XL 6 октября, с быстрым и безопасным по памяти декодером, который работает на любом CPU. Нейросетевое кодирование выигрывает внутри конвейера одной компании; форматы, которые должны открываться везде, остаются классическими.
Звонки: где применяются сквозные нейросетевые кодеки
Звонок — это замкнутая система: на обоих концах работает одно и то же приложение, и посреди звонка можно переключиться на стандартный кодек. Поэтому первые массовые сквозные нейросетевые кодеки появились именно здесь. Речевой ИИ-кодек Satin от Microsoft с 2021 года работает во всех звонках Teams и Skype с двумя участниками. В июле 2026 года Microsoft открыла исходный код MLVC — нейросетевого видеокодека, который сейчас внедряется в одноранговых звонках Teams.
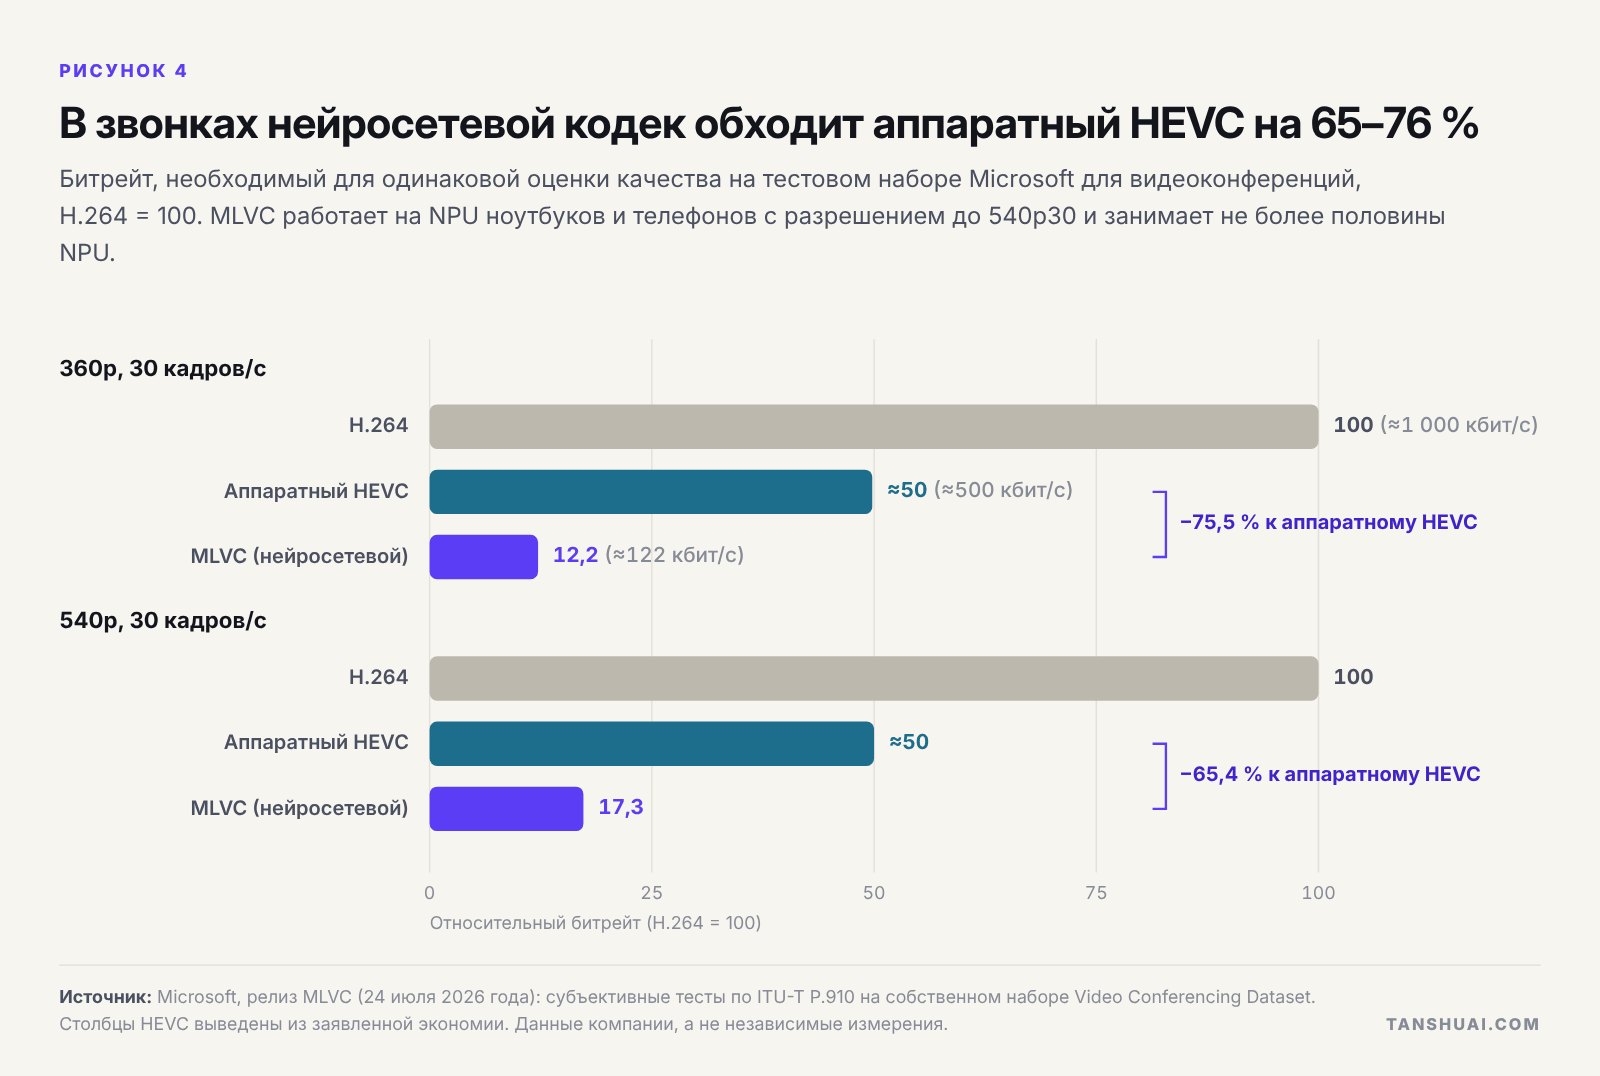 Рисунок 4. В звонках нейросетевой кодек обходит аппаратный HEVC на 65–76 % — на собственном тестовом наборе Microsoft.
Громкие 88 % — это относительно H.264; относительно аппаратного HEVC, который уже есть в тех же ноутбуках, выходит 65–76 %, что всё равно много. MLVC работает при 540p и 360p, занимая не более половины NPU, и пожертвовал частью сжатия, чтобы одинаково декодироваться на оборудовании, которым Microsoft не владеет.
Не все выбрали этот путь. Opus в 2024 году добавил глубокое обучение в виде необязательных, обратно совместимых дополнений. Meta создала MLow — классический речевой кодек, потому что более 20 % её звонков идут со старых телефонов на ARMv7, а десятки миллионов звонков WhatsApp в день — с телефонов старше десяти лет. Нейросетевые кодеки появляются сначала там, где устройства новые, а оба конца контролирует один поставщик.
Генеративный ИИ: крупнейшее внедрение, которое никто не называет кодеком
Каждая голосовая и видеомодель работает на обучаемом кодеке. Речевые модели читают и пишут токены нейросетевых аудиокодеков, таких как Mimi от Kyutai, с частотой 12,5 кадра в секунду и битрейтом 1,1 кбит/с. Видеогенераторы работают в латентном пространстве видеоавтокодировщиков, например автокодировщика LTX-Video со сжатием 1:192. Ни один из них не является форматом, который декодирует кто-то ещё, но они доказывают, что обучаемое сжатие работает в больших масштабах, когда одна компания владеет кодером, декодером и оборудованием. Для любого, кто обслуживает генеративное видео, эффективность токенизатора — прямая статья затрат.
Игры: нейросетевая реконструкция — мейнстрим, нейросетевые ассеты только начинаются
DLSS от NVIDIA отрисовывает меньше пикселей и кадров и поручает нейросети восстановить остальное. Нейросетевое сжатие текстур вышло в Assassin's Creed Mirage, где его применили только к отдельным ассетам из-за затрат во время выполнения.
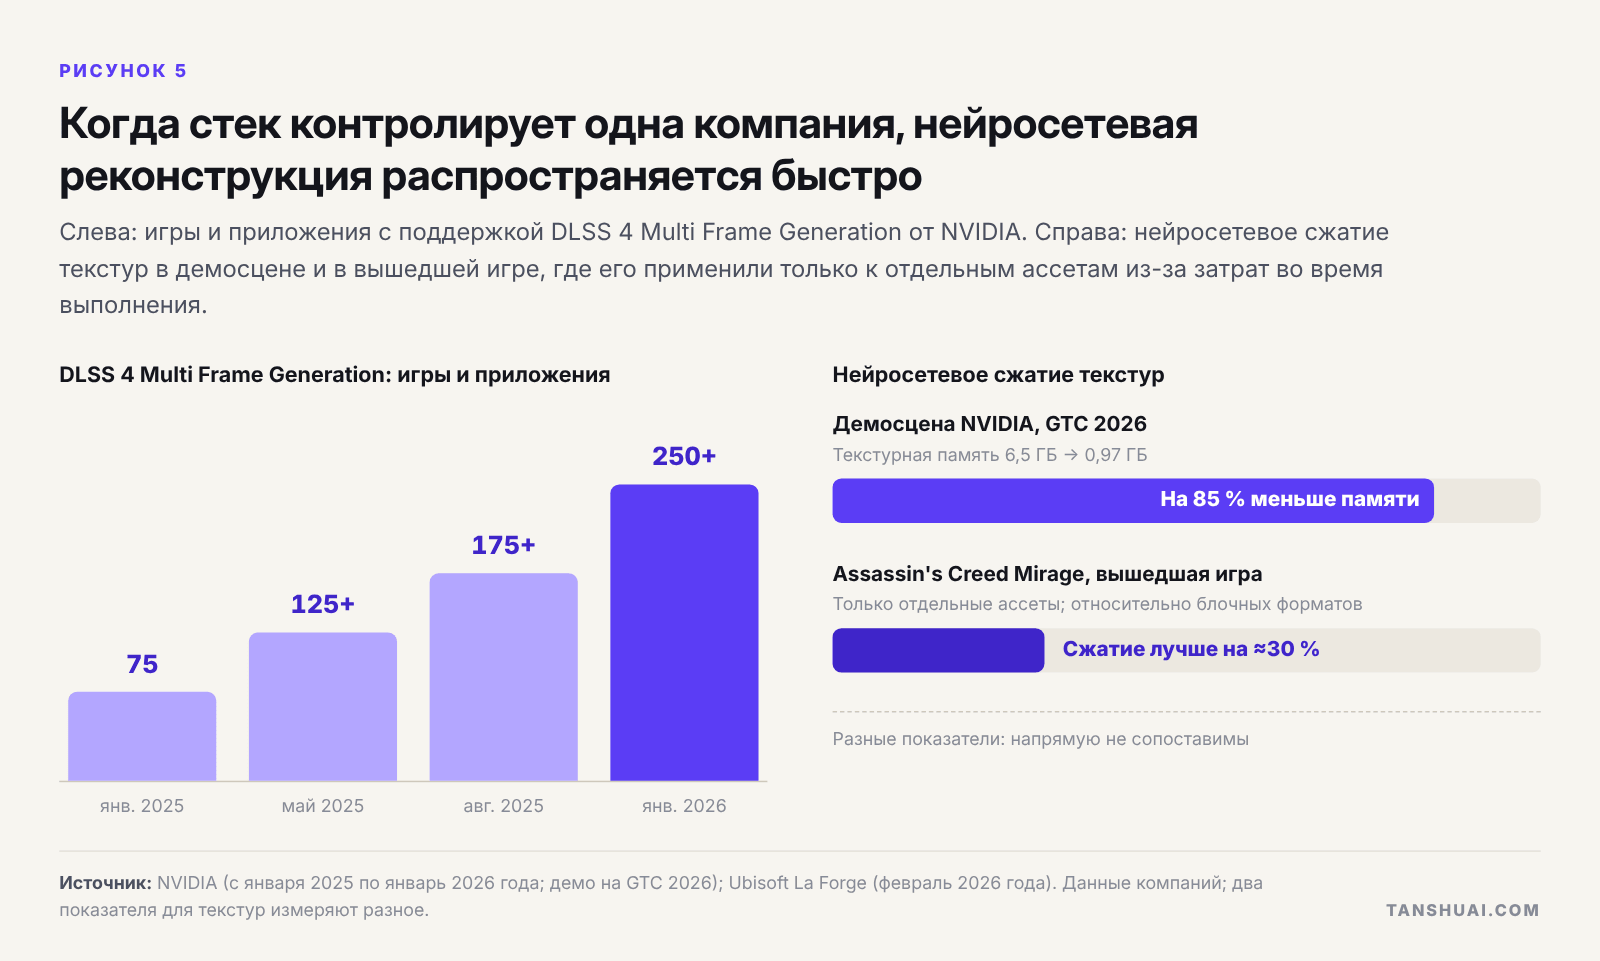 Рисунок 5. Когда стек контролирует одна компания, нейросетевая реконструкция распространяется быстро.
Каналы связи спутников, дронов и роботов технически лучше всего подходят для сквозных нейросетевых кодеков, но это небольшой рынок, к тому же всё сильнее ограниченный экспортным контролем с обеих сторон: китайские правила экспорта дронов, действующие с 18 ноября 2026 года, даже используют семантическое сжатие изображений как пороговый параметр.
Взгляд разработчика микросхем
Здесь мой собственный опыт важнее всего. О любом новом кодеке команда разработчиков чипа задаёт четыре вопроса: сколько джоулей на пиксель, сколько трафика DRAM на пиксель, сколько вентилей и вычисляет ли каждый декодер в мире в точности одни и те же биты. По всем четырём пунктам нейросетевой декодер в 2026 году находится там, где был аппаратный HEVC до первых чипов.
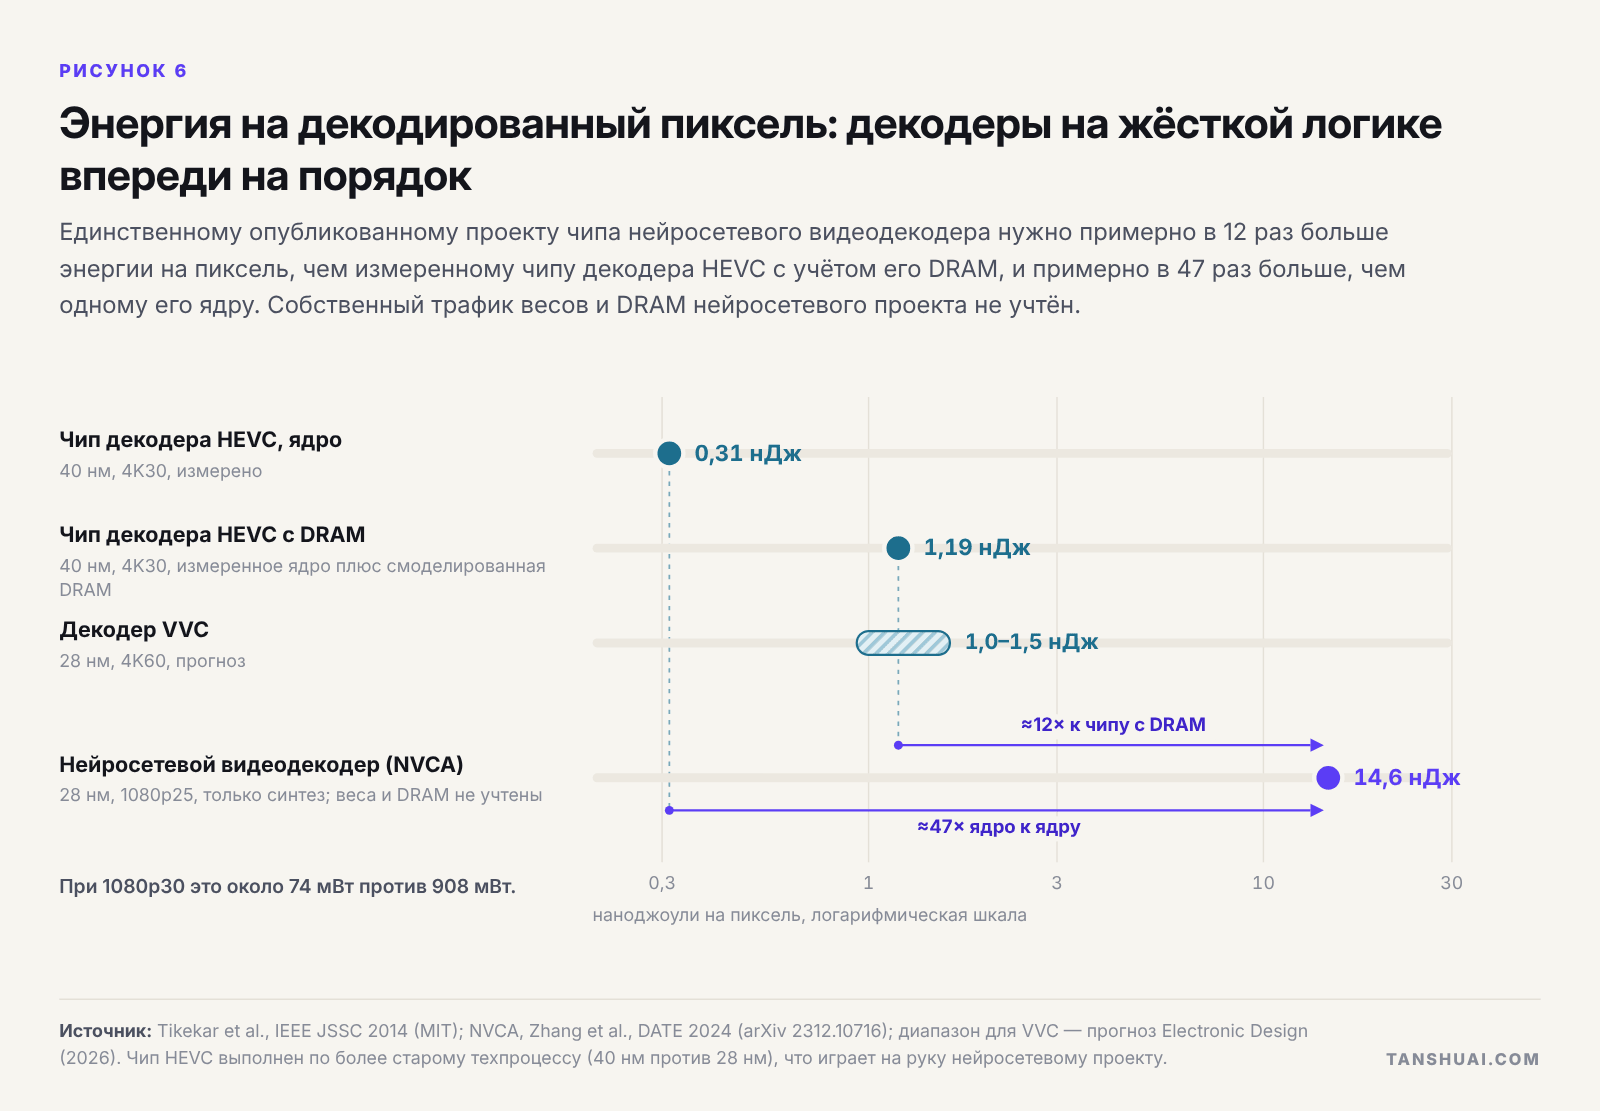 Рисунок 6. Энергия на декодированный пиксель: декодеры на жёсткой логике впереди на порядок.
Единственному опубликованному проекту чипа нейросетевого видеодекодера, NVCA, нужно 14,6 нДж на пиксель; чипу декодера HEVC от MIT — 1,19 с учётом DRAM и 0,31 для ядра. При 1080p30 это примерно 900 мВт против 74 мВт. Быстрому исследовательскому кодеку Microsoft DCVC-RT, по моей сумме из его собственной таблицы по модулям, нужно около 175 тыс. MAC на декодированный пиксель, или около 22 TOPS при 1080p30: половина из 40 TOPS, которыми определяется ИИ-ПК, — на один поток.
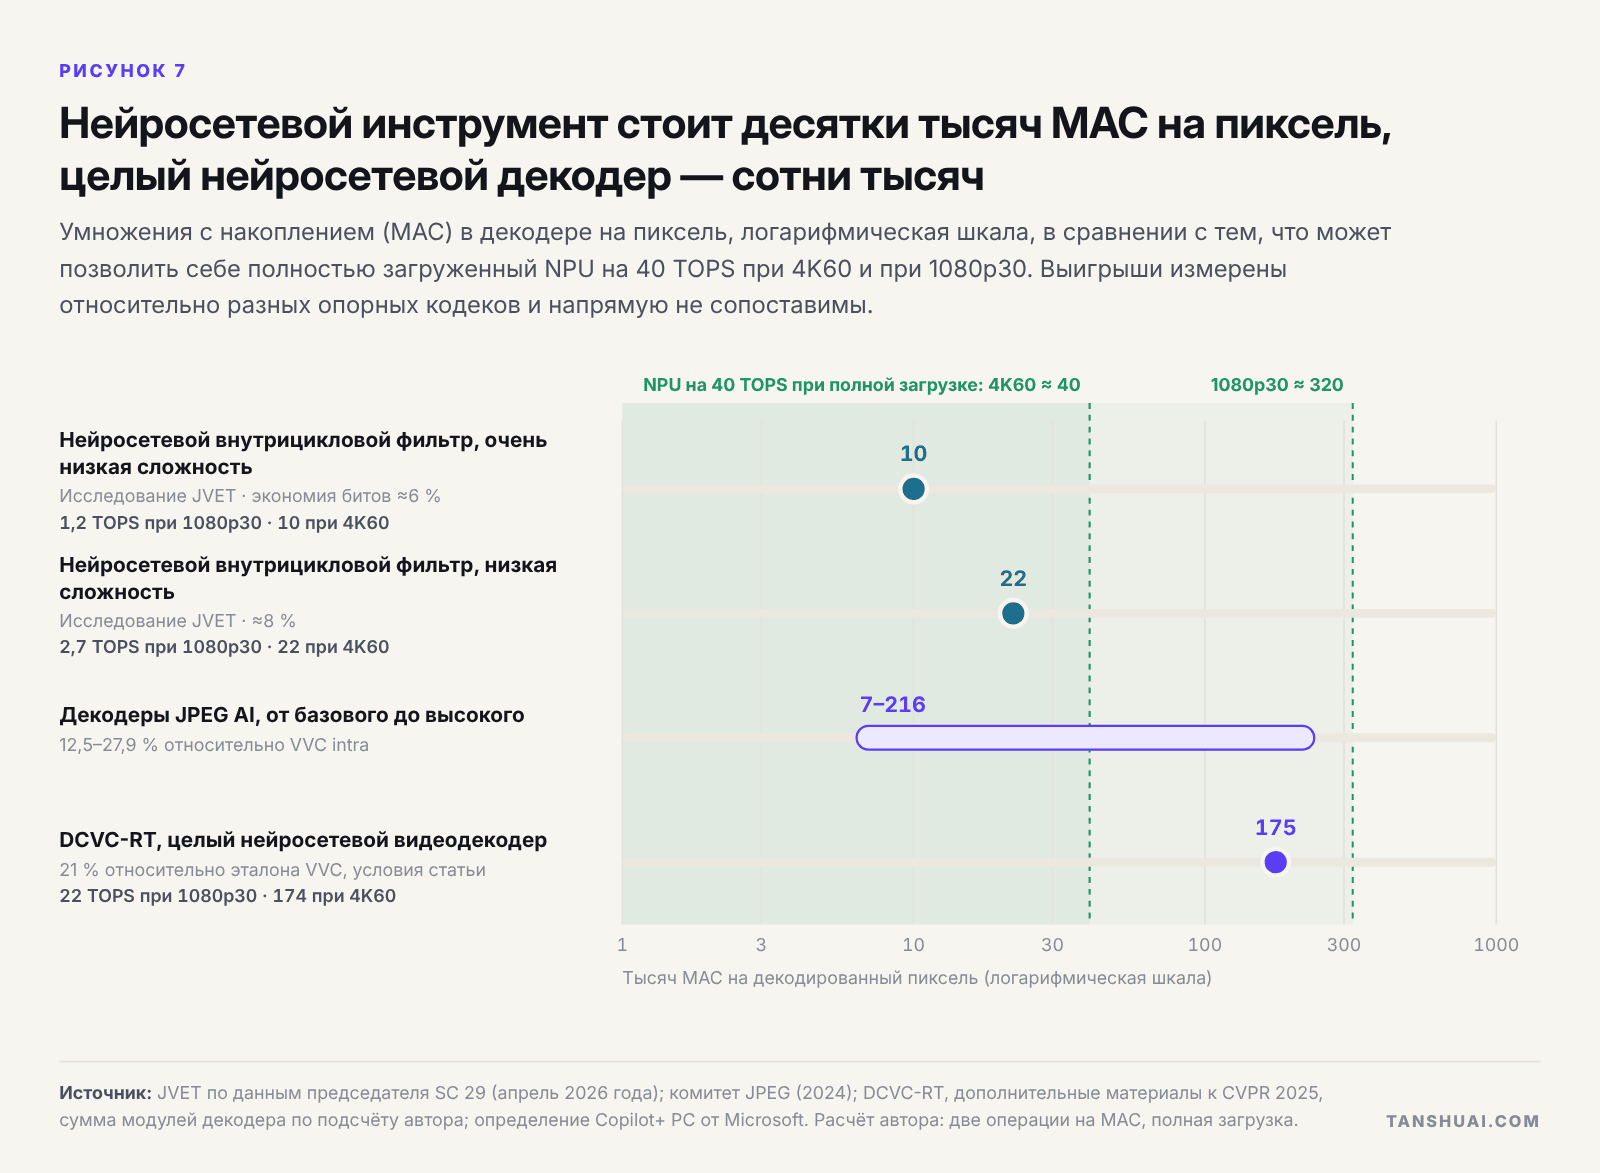 Рисунок 7. Нейросетевой инструмент стоит десятки тысяч MAC на пиксель, целый нейросетевой декодер — сотни тысяч.
Важны ещё две статьи затрат. Память: в чипе MIT около трёх четвертей энергии системы уходит на DRAM, а нейросетевые декодеры переносят между кадрами большие карты признаков. Точность: энтропийное декодирование ломается, если два устройства вычисляют вероятность по-разному, — поэтому каждый серьёзный нейросетевой кодек теперь использует целочисленную арифметику, а MLVC жертвует сжатием ради одинакового декодирования.
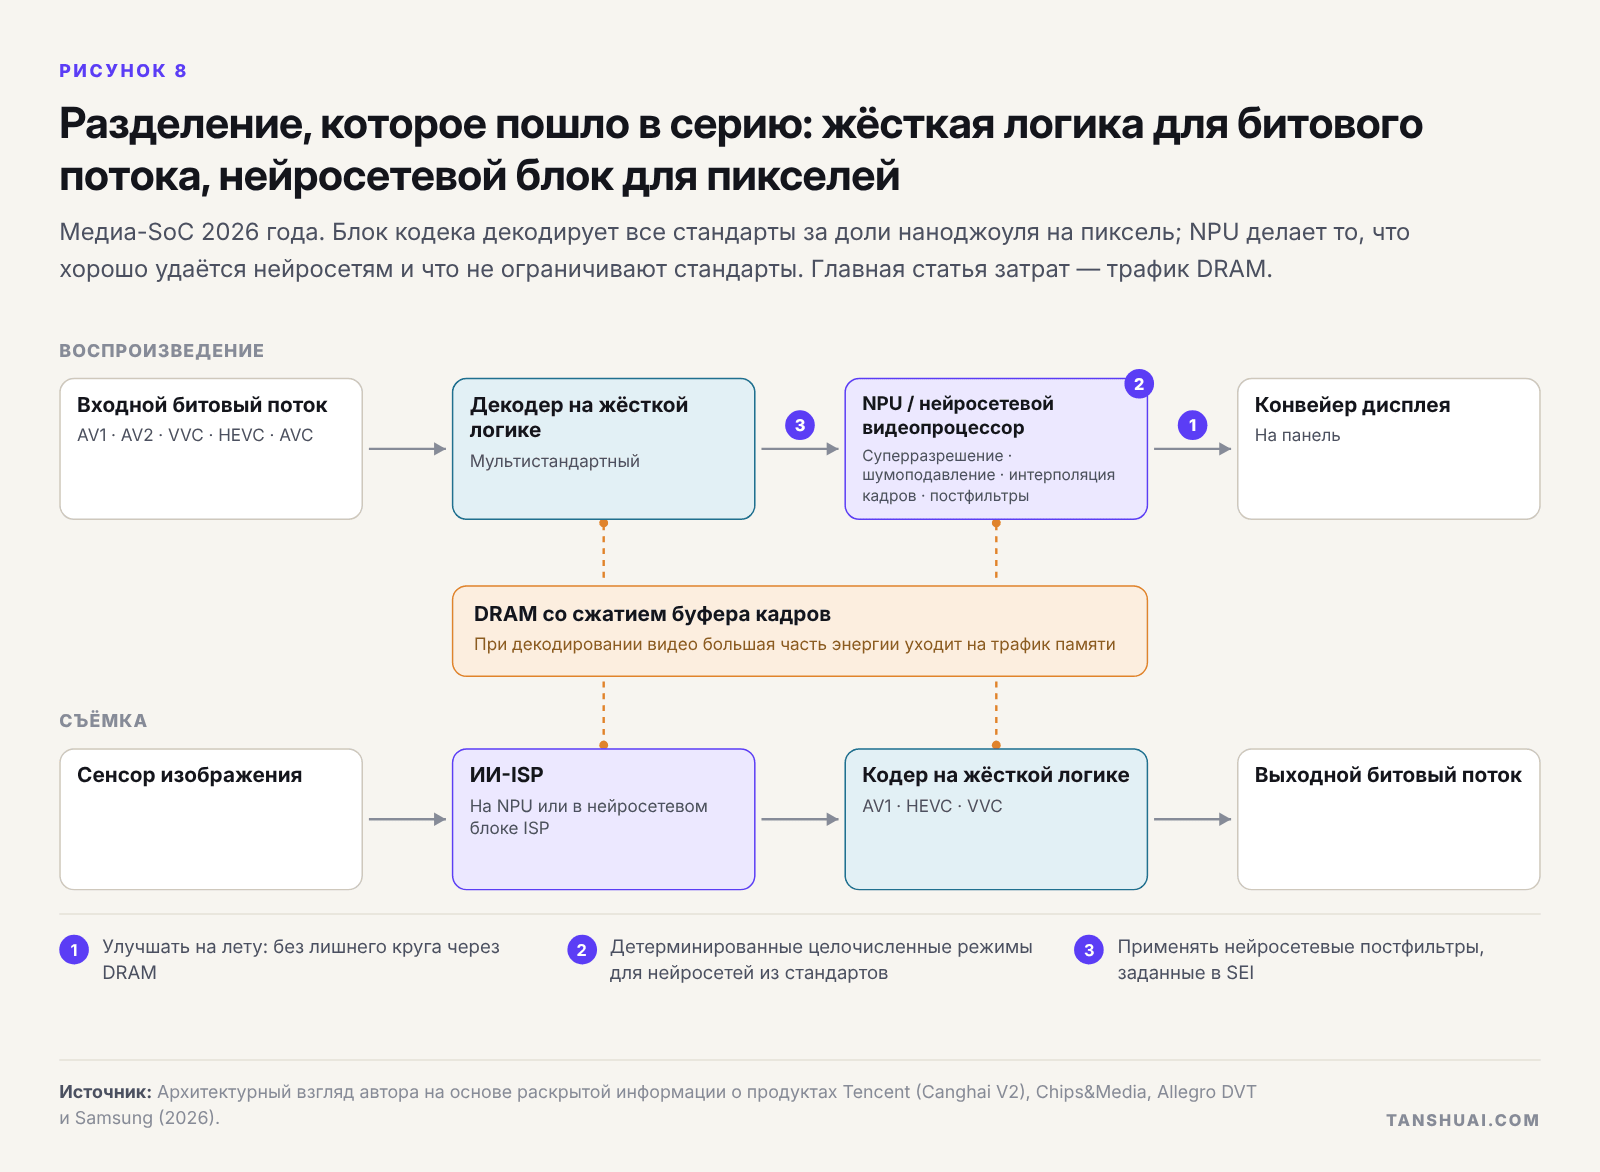 Рисунок 8. Разделение, которое пошло в серию: жёсткая логика для битового потока, нейросетевой блок для пикселей.
Продаются микросхемы, которые сочетают и то и другое. У Tencent развёрнуто более 100 000 собственных чипов кодеков Canghai, а второе поколение добавляет H.266 и суперразрешение на кристалле; поставщики IP продают блоки кодеков и видео-NPU бок о бок. Если бы я сейчас планировал медиа-SoC: декодеры на жёсткой логике для каждого стандарта, который нужно воспроизводить, включая AV2; NPU, рассчитанный на улучшение в разрешении дисплея без лишнего круга через DRAM; детерминированные целочисленные режимы; и H.267 как начало проектирования после 2029 года.
Кто зарабатывает и где есть место для компании
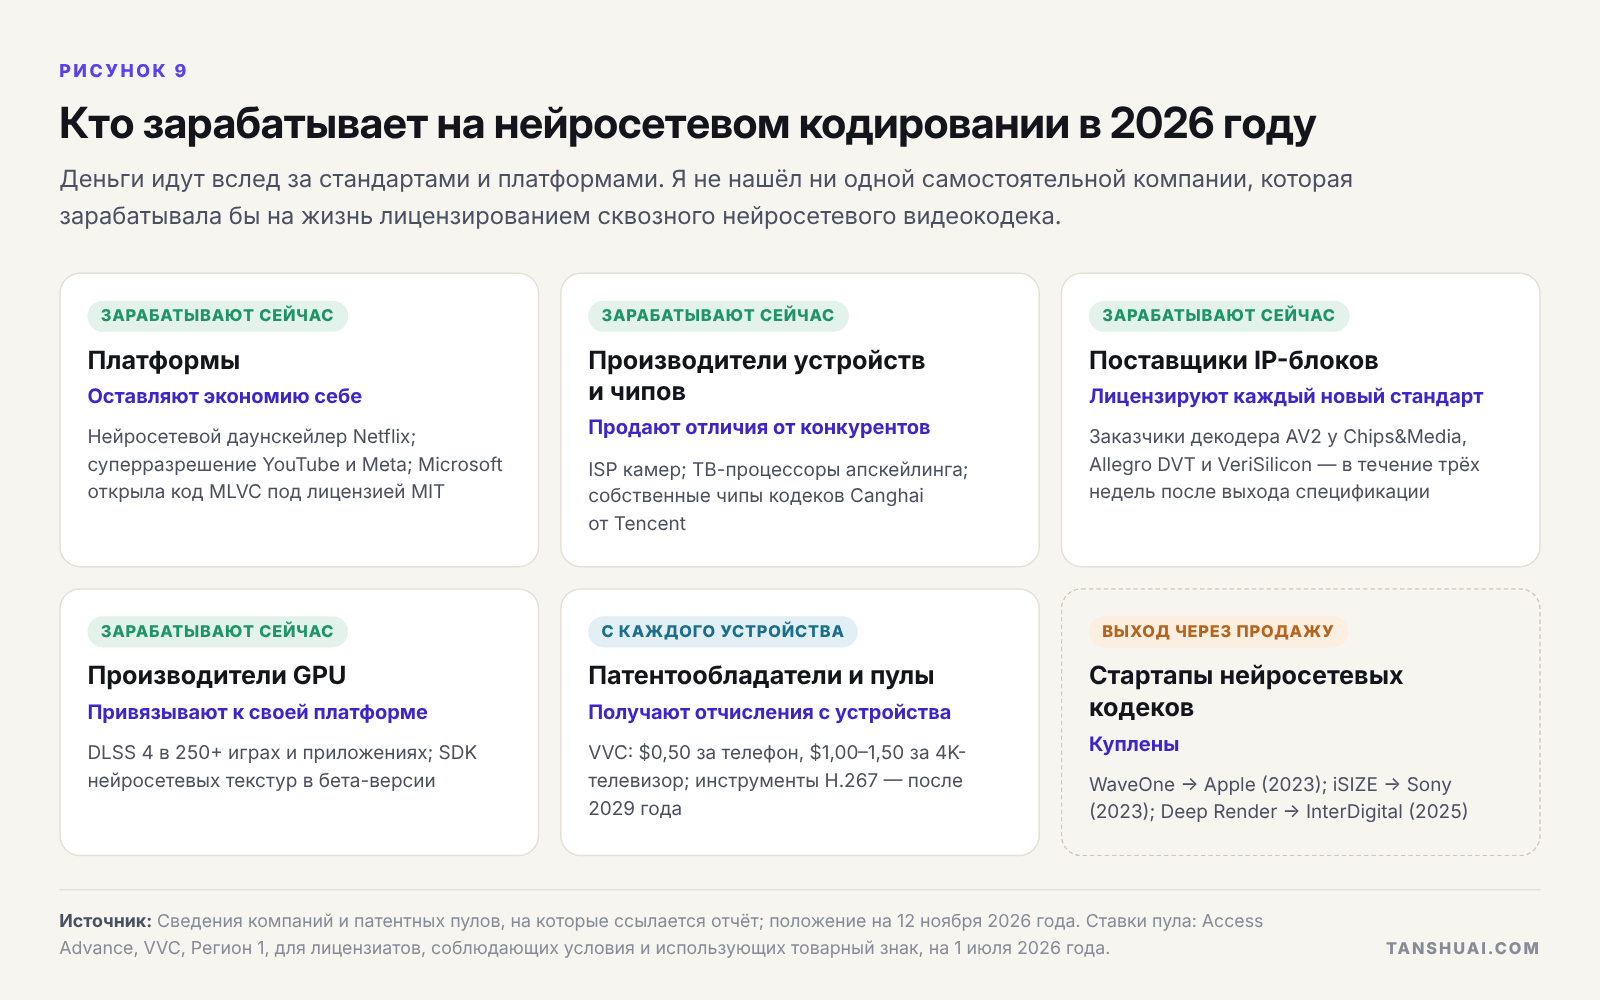 Рисунок 9. Деньги идут вслед за стандартами и платформами.
Платформы оставляют экономию себе, а иногда отдают код бесплатно, как Microsoft с MLVC. Поставщики IP лицензируют декодеры для каждого нового стандарта. Патентные пулы собирают плату с каждого устройства: для VVC — $0,50 за телефон и $1,00–1,50 за 4K-телевизор в США и на других рынках Региона 1. WaveOne досталась Apple, iSIZE — Sony, Deep Render — InterDigital. Я не нашёл ни одной самостоятельной компании, которая зарабатывала бы на жизнь лицензированием сквозного нейросетевого видеокодека.
Для компании открыты такие направления: нейросетевая предобработка для видеосервисов, улучшение на стороне дисплея для производителей чипов, нейросетевые кодеки для замкнутых систем — конференций и частных каналов связи, микросхемы «кодек плюс NPU», а также инструменты оценки и проверки соответствия, которые понадобятся всем, кто выпускает нейросетевые инструменты. Работа над стандартом H.267 требует терпения и стратегии лицензирования.
Заявления, на которые стоит делать скидку, и за чем следить
Требуйте от любого заявления о нейросетевом кодеке четырёх вещей: опорного кодека, метрики, разрешения и стоимости декодирования. «Экономия 88 %» — это относительно H.264 при 360p; «на 85–96 % меньше видеопамяти» — это демосцена, против 30 % в вышедшей игре; за фразой «JPEG AI — это стандарт» пока не стоит ни одного продукта.
Важные даты: оценка ответов по H.267 в январе 2027 года, первые потоки AV2 на YouTube в начале 2027 года, первая тестовая модель H.267 во втором полугодии 2027 года, выйдет ли MLVC за пределы Teams, первый продукт, использующий JPEG AI по умолчанию, и бюджеты NPU в телефонах и ПК. Версия 1 H.267 в конце 2029 года запустит цикл разработки микросхем для нейросетевых инструментов в массовом воспроизведении.
Скачать полный отчёт и слайды
Полный отчёт подробнее рассматривает каждую область, расчёты для микросхем, стандарты и патенты, а также содержит таблицу заявлений и фактов и все источники.
- Нейросетевое кодирование в 2026 году: полный отчёт (PDF)
- Нейросетевое кодирование в 2026 году: слайды (PDF)
- Английская версия: полный отчёт · слайды
Это перевод английской версии; при расхождениях преимущественную силу имеет английский текст.
Открытые вопросы
На некоторые вопросы здесь пока нет публичного ответа, и именно они кажутся мне самыми интересными технически: насколько близко нейросетевой декодер может подойти к побитово точной целочисленной арифметике на NPU разных производителей, прежде чем потеряет своё преимущество в сжатии; во что нейросетевая постобработка обходится в трафике DRAM на пиксель; при какой стоимости на пиксель нейросетевой инструмент перестаёт окупаться в декодере H.267; какие замкнутые системы, кроме звонков, первыми смогут перейти на сквозные нейросетевые кодеки; и как измерять достоверность, когда декодер генерирует детали, а не восстанавливает их.
Эти направления мы можем исследовать вместе в ближайшие годы — через технический обмен и техническое сотрудничество: i@tanshuai.com.
Об авторе
Тан Шуай — технологический эксперт и основатель компаний; более двадцати лет он работает в области микросхем, аппаратного и системного программного обеспечения, у него 20 выданных патентов. За его плечами много лет НИОКР и руководства в fabless-разработке микросхем, включая полностью заказное проектирование трактов данных ASIC и проекты мультимедийных чипов для камер, например ускорителей видеокодеков. Его работа проходила в Кремниевой долине, Нью-Йорке, Чикаго, на Тайване, в районе Большого залива (Шэньчжэнь и Гонконг), во Вьетнаме и Малайзии. Сегодня он исследователь и разработчик в области ИИ.
Для технического обсуждения: i@tanshuai.com.